FG²-GDN:用双重细粒度控制增强长上下文门控 Delta 网络
作者: Pingwei Sun、Yuxuan Hu、Jianchao Tan(通讯作者)、Xue Wang、Jiaqi Zhang、Yifan Lu、Yerui Sun、Yuchen Xie、Xunliang Cai(Meituan)
所读版本: arXiv:2604.19021v3,2026-11-06 获取;本地论文 PDF
发表: 已发表于 EMNLP 2026,ACL Anthology 论文编号 2026.emnlp-main.2242,页码 51013–51023;会议论文集页面
代码: 截至 2026-11-06,未查到作者提供的公开实现或可核实的第三方复现。
论文总览
线性注意力把历史压缩进固定大小的矩阵状态,推理复杂度随序列长度线性增长。Delta 规则让状态对当前 key–value 关联执行一次在线校正;Gated DeltaNet(GDN)和 Kimi Delta Attention(KDA)进一步加入可控遗忘。KDA 已经把遗忘率 α 做到逐通道,但写入率 β 仍是每个 token 一个标量。本文问的是:能否也让不同通道自行决定每次更新写多深,同时不丢掉 KDA 的高效并行算法?
论文提出 FG²-GDN,以逐通道向量 β 同时缩放 key 与 value;FG²-GDN+ 再把 key 侧 βᵏ 和 value 侧 βᵛ 分开,让擦除旧记忆与写入新值拥有独立控制。关键技巧是用 √β 对 key、value 做对称缩放,保留 delta 转移中的 tied diagonal-plus-rank-1 结构,因此可沿用 KDA 的 chunkwise 并行计算。
在 340M 和 1.3B 参数混合模型上,FG²-GDN 提高了语言建模平均准确率;在 1.3B 的 LongBench 上,FG²-GDN 单独使用并未超过 KDA,但加入 key/value 分离的 FG²-GDN+ 将平均分从 16.4 提到 18.3。RULER 的平均分也在 4K、8K、16K 三种长度上由 FG²-GDN+ 领先。额外参数和架构 FLOPs 不到 1%;在 H800 上,32K prefill 吞吐是 MLA 的约 1.7–1.9 倍,FG²-GDN 相对 KDA 的速度损失不到 5%。
结构地图
| 原文位置 | 内容 | PDF 页码与证据 |
|---|---|---|
| §1 Introduction | 线性注意力记忆、GDN/KDA 缺口及贡献 | pp. 1–2 |
| §2 Preliminary | Delta 规则、遗忘门及 per-coordinate learning rate 动机 | pp. 2–3,公式 (3)–(9) |
| §3 Gated Delta Net with Fine-grained Beta | FG²-GDN、FG²-GDN+、门控参数化、chunkwise 训练、混合架构 | pp. 3–5,公式 (10)–(14),图 1 |
| §4.1 Language Modeling | 两种规模上的 LAMBADA 与常识任务 | pp. 5–6,表 1 |
| §4.2 Long-Context Evaluation | RULER 与 LongBench | pp. 5–7,表 2–3 |
| §4.3 Learned Writing-Rate Analysis | 学到的 β 是否呈现通道差异 | p. 7,图 2 |
| §4.4 Ablation Study | 分别检验向量 β 与 key/value 分离 | p. 7,表 4 |
| §4.5 Efficiency | 不同上下文/批量设置下的 prefill 吞吐与延迟 | pp. 7–8,图 3 |
| §5–6 与 Limitations | 相关更新规则、结论及适用边界 | pp. 8–9,表 5 |
| Appendix A | 模型与训练配置 | p. 11,表 6 |
一、动机:遗忘可按通道,写入却仍共用一个速率
线性注意力将过往的 key–value 关联累计进状态矩阵 (S_t\in\mathbb{R}^{d_k\times d_v}),并用 (o_t=S_t^\top q_t) 读取。Delta 规则把状态视作快速联想记忆:每个 token 都使状态朝着当前映射 (k_t\mapsto v_t) 校正一次。这样比单纯累加更能纠正错误关联,但若所有通道使用同一个更新幅度,模型仍无法按维度调节当前信息的写入。
方法演进可概括为两个控制轴:
| 方法 | 遗忘率 α | 写入率 β | 作用 |
|---|---|---|---|
| GDN | 每头/标量 | 每头/标量 | 整体衰减状态,并以 delta 规则更新 |
| KDA | 按通道向量 | 标量 | 不同记忆通道有不同衰减,但写入幅度共享 |
| FG²-GDN | 按通道向量 | 按通道向量 | 同时细化遗忘和写入 |
| FG²-GDN+ | 按通道向量 | βᵏ、βᵛ 两个向量 | 再分开 key 侧擦除控制和 value 侧写入控制 |
由此,FG²-GDN 延伸的是 KDA 的另一个轴:通道级写入;FG²-GDN+ 则解开擦除强度与 value 写入强度的绑定。
二、方法:对称缩放写入率以保留 KDA 的并行结构
2.1 从 Delta 规则到 KDA
Delta 规则针对重构误差
$$\mathcal{L}_t(S)=\tfrac12\lVert S^\top k_t-v_t\rVert^2$$做一步在线梯度更新:
$$S_t=(I-\beta_t k_tk_t^\top)S_{t-1}+\beta_t k_tv_t^\top. \tag{6}$$这里 (k_tk_t^\top S_{t-1}) 先取出旧状态对当前 key 的预测,更新再把该预测向目标 (v_t) 拉近。GDN 在状态转移上加入遗忘系数;KDA 将标量遗忘扩展为对角矩阵 \(\mathrm{Diag}(\alpha_t)\),使各通道可以有不同保留率,但 \(\beta_t\) 仍为标量(§2.2,PDF pp. 2–3,公式 (7)–(9))。
2.2 FG²-GDN:共享一个通道向量控制 key 与 value
如果只把 \(\beta_t\) 替换成向量,并写成 \(\mathrm{Diag}(\beta_t)k_tk_t^\top\),修正项虽仍为 rank-1,但左右因子不再相同,会破坏 KDA 专用 chunkwise 算法所用的 tied/对称形式。本文改为对 key 和 value 同时乘逐通道的平方根:
$$\tilde{k}_t=\sqrt{\beta_t}\odot k_t,\qquad \tilde{v}_t=\sqrt{\beta_t}\odot v_t,$$$$S_t=(I-\tilde{k}_t\tilde{k}_t^\top)\,\mathrm{Diag}(\alpha_t)S_{t-1}+\tilde{k}_t\tilde{v}_t^\top,\qquad o_t=S_t^\top q_t. \tag{11}$$\(\odot\) 表示逐元素乘法,平方根逐通道计算。这样,遗忘由 \(\alpha_t\) 决定;写入项中第 (i,j) 个通道对的缩放为 \(\sqrt{\beta_{t,i}\beta_{t,j}}\)。因此 β 虽然按通道变化,但不同通道之间仍通过对称的 rank-1 结构耦合;它不是为状态矩阵每个元素提供任意独立学习率。这个结构约束换来对 KDA 高效并行路径的兼容(§3.2–3.3,PDF p. 3,公式 (10)–(12))。
2.3 FG²-GDN+:拆开擦除与写入
FG²-GDN 的同一个 β 同时参与 key 侧的擦除项与 value 侧的写入项。FG²-GDN+ 分别预测 \(\beta^k_t\) 和 \(\beta^v_t\):
$$\hat{k}_t=\sqrt{\beta^k_t}\odot k_t,\qquad \tilde{v}_t=\sqrt{\beta^v_t}\odot v_t,$$$$S_t=(I-\hat{k}_t\hat{k}_t^\top)\,\mathrm{Diag}(\alpha_t)S_{t-1}+\hat{k}_t\tilde{v}_t^\top. \tag{13}$$key 侧 \(\beta^k_t\) 控制 delta 修正的擦除项及写入项的 key 因子;value 侧 \(\beta^v_t\) 单独调节写入内容的幅度。模型将 β 投影末层输出从 (H d_k) 个值扩为 (H(d_k+d_v)) 个值,再拆分为两组向量。论文报告 1.3B 模型相对 KDA 多 8.8M(0.62%)和 13.6M(0.96%)参数(§3.4–3.5,PDF p. 4)。
2.4 Chunkwise 并行与计算开销
转移项可展开为
$$\mathrm{Diag}(\alpha_t)+a_tb_t^\top,\quad a_t=-\tilde{k}_t,\quad b_t=\tilde{k}_t\odot\alpha_t,$$即仍为 diagonal-plus-rank-1。论文据此复用 KDA 的 WY 表示与 UT 变换:序列按长度 (C) 分块,块内并行累积转移,块间传播状态。若序列长度为 (L)、头维为 (d),训练复杂度仍是 \(O(Ld^2+LCd+LC^2)\);新增平方根与逐元素缩放为 \(O(Ld)\),在 \(d_k=d_v=128\) 时,作者估算约为主要状态更新算术的 0.8%。门控投影的额外 FLOPs 已计入模型架构统计;实测吞吐还受内核调用和内存流量影响(§3.6、§4.5,PDF pp. 4、7–8)。
2.5 混合架构
纯线性注意力受固定状态容量限制,难以精确保存任意长上下文中的所有细节。实验模型因此按 3:1 交替使用线性注意力与 Multi-head Latent Attention(MLA):三层线性注意力后接一层 MLA;MLA 提供完整 token 间交互,线性注意力承担高效递归记忆。作者沿用 Kimi Linear 的混合比例,只替换线性注意力单元,以控制对比条件(图 1,PDF p. 5)。
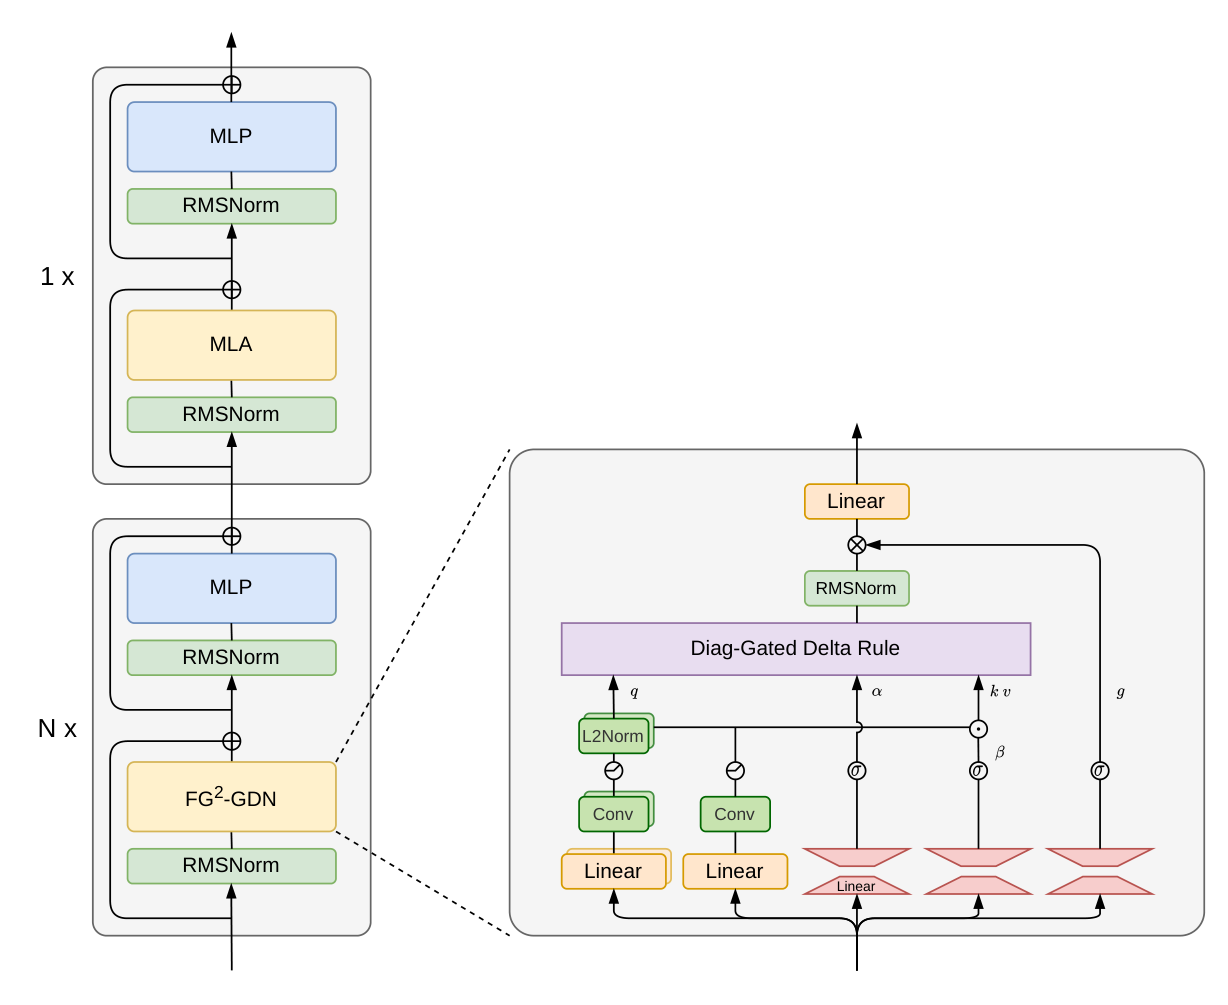
图 1 左边是层间交替的 MLA/FG²-GDN 主干,右边展开 FG²-GDN 单元;通道 β 进入 delta 记忆更新,α 负责通道遗忘。原图 1,PDF p. 5。
三、实验:固定训练配方,只替换线性注意力单元
所有方法使用相同的 3:1 MLA/线性注意力混合主干、SlimPajama 训练数据、训练调度和超参数;比较变量是线性注意力单元。模型分别为 340M(20 层、隐藏维 1024)和 1.3B(24 层、隐藏维 2048),每种配置只预训练一次。两者均为 16 个注意力头、线性头维 128,训练序列长 8192、BF16、AdamW、余弦学习率调度,峰值学习率 \(3\times10^{-4}\) 降至 \(3\times10^{-5}\)(§4 Setup 与 Appendix A,PDF pp. 5、11)。
| 配置 | 340M | 1.3B |
|---|---|---|
| 训练 token | 15B | 100B |
| warmup token | 0.5B | 1B |
| 每步 token | 0.5M | 2M |
| 层数 / 隐藏维 | 20 / 1024 | 24 / 2048 |
| 序列长度 / 精度 | 8192 / BF16 | 8192 / BF16 |
语言建模评估包含 LAMBADA 困惑度和 7 项准确率分数(LAMBADA accuracy、ARC-E、ARC-C、BoolQ、HellaSwag、PIQA、WinoGrande)的平均值。长上下文实验在 1.3B 模型上进行:RULER 含 13 类检索任务,在 4K、8K、16K 评估;LongBench 覆盖单/多文档问答、摘要、few-shot 与代码任务。效率测试在 NVIDIA H800-80G、BF16 上进行,固定总 token 数为 32,768,通过改变序列长度和 batch size 测量 prefill 吞吐/延迟(附录 A、表 2–3、图 3)。
四、结果:收益主要来自完整的 key/value 分离版本
4.1 语言建模
下表摘录表 1 的关键分数。零样本平均准确率越高越好;LAMBADA perplexity 越低越好。
| 规模 | 方法 | 平均准确率 ↑ | LAMBADA PPL ↓ |
|---|---|---|---|
| 340M | GDN | 43.51 | 39.86 |
| KDA | 43.14 | 41.30 | |
| FG²-GDN | 44.88 | 38.27 | |
| FG²-GDN+ | 44.84 | 37.93 | |
| 1.3B | GDN | 52.79 | 14.01 |
| KDA | 53.19 | 13.80 | |
| FG²-GDN | 53.95 | 13.09 | |
| FG²-GDN+ | 53.40 | 13.91 |
向量 β 在两种规模都提高了平均准确率。1.3B 上 FG²-GDN 比 KDA 高 0.76 个百分点,LAMBADA PPL 从 13.80 降到 13.09;FG²-GDN+ 平均准确率为 53.40,仍高于 KDA,但低于 FG²-GDN。最佳模型取决于指标:FG²-GDN 的平均准确率和 1.3B PPL 最优,FG²-GDN+ 在 340M PPL 最优(表 1,PDF p. 6)。
4.2 长上下文:RULER 与 LongBench
RULER 的宏平均准确率如下。FG²-GDN+ 在三种长度上均领先;模型训练长度是 8K,因此 16K 结果是超出训练长度的外推评估。
| 方法 | RULER 4K ↑ | 8K ↑ | 16K ↑ |
|---|---|---|---|
| GDN | 61.6 | 51.0 | 42.4 |
| KDA | 61.5 | 55.0 | 44.9 |
| FG²-GDN | 64.8 | 57.3 | 44.6 |
| FG²-GDN+ | 67.2 | 61.4 | 48.9 |
FG²-GDN+ 在 16K 比 KDA 高 4.0 个百分点。单项任务并非全线领先:例如 KDA 在 4K 单键 NIAH 的 S3 为 93.8%,FG²-GDN+ 为 88.0%;FG²-GDN+ 的可变跟踪(VT)分数在 4K 为 21.2%,低于 FG²-GDN 的 47.1%。因此最稳妥的总结是宏平均提升,而不是每类检索都改善(§4.2、表 2,PDF pp. 5–6)。
LongBench 总分进一步显示拆分控制的价值:FG²-GDN 为 16.0,略低于 KDA 的 16.4;FG²-GDN+ 达到 18.3。分项上,FG²-GDN+ 在多文档 QA 三项、摘要中的 QMS/MNs,以及 few-shot 三项领先;代码补全两项则仍由 KDA 领先。故完整版本提升了总体分布上的表现,但并未在每个子任务上占优(表 3,PDF p. 7)。
4.3 消融:逐通道写入和 key/value 解耦提供互补增益
1.3B 消融逐一开关遗忘向量 α、写入向量 β 与分离的 \(\beta^{k/v}\)。
| 模型 | α 按通道 | β 按通道 | 分离 βᵏ/βᵛ | LM 平均准确率 ↑ | PPL ↓ | LongBench ↑ |
|---|---|---|---|---|---|---|
| GDN | 52.79 | 14.01 | 15.1 | |||
| FGBGDN(α 标量、β 向量) | ✓ | 53.25 | 13.96 | 16.8 | ||
| KDA | ✓ | 53.19 | 13.80 | 16.4 | ||
| FG²-GDN | ✓ | ✓ | 53.95 | 13.09 | 16.0 | |
| 标量 βᵏ/βᵛ 分离 | ✓ | ✓ | 53.9 | 13.56 | 16.7 | |
| FG²-GDN+ | ✓ | ✓ | ✓ | 53.40 | 13.91 | 18.3 |
相对 GDN,只把 β 改为向量的 FGBGDN 将平均准确率从 52.79 提到 53.25、LongBench 从 15.1 提到 16.8;在已经有通道级 α 的 KDA 上增加通道级 β,则平均准确率从 53.19 提到 53.95,LAMBADA PPL 从 13.80 降到 13.09。这支持写入粒度与遗忘粒度互补。单独做标量 key/value 分离也使 LongBench 达到 16.7;叠加向量 β 的 FG²-GDN+ 达到最高 18.3(§4.4、表 4,PDF p. 7)。
4.4 学到的 β 确实保留通道差异
作者在 1.3B FG²-GDN 检查点的 1,408 个留出 token 上统计 β 投影。上图显示均值和 5–95 百分位区间;下图显示 token 内通道变异系数(橙)和时间平均通道均值的变异系数(绿)。灰带是没有 β 的 MLA 层。18 个线性注意力层都保留明显通道差异:token 内 CV 均值 0.55(层范围 0.45–0.67),时间平均通道均值 CV 为 0.36,平均第 5/95 百分位数为 0.04/0.96。也就是说,β 并未塌缩为一个近似相同的标量(§4.3,图 2,PDF p. 7)。
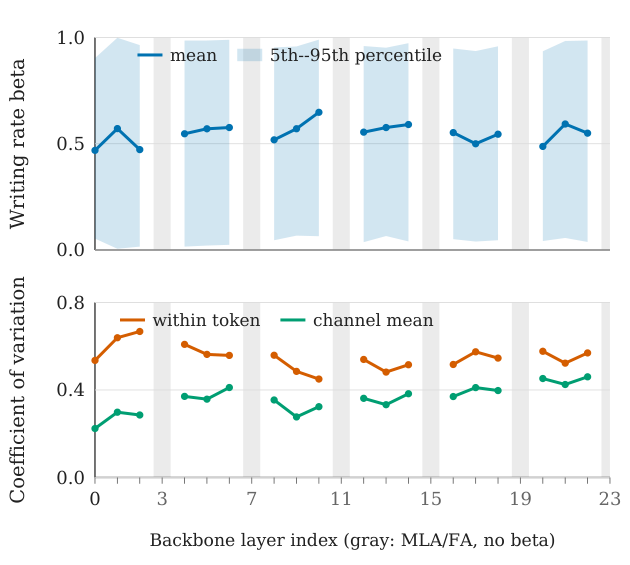
4.5 Prefill 效率
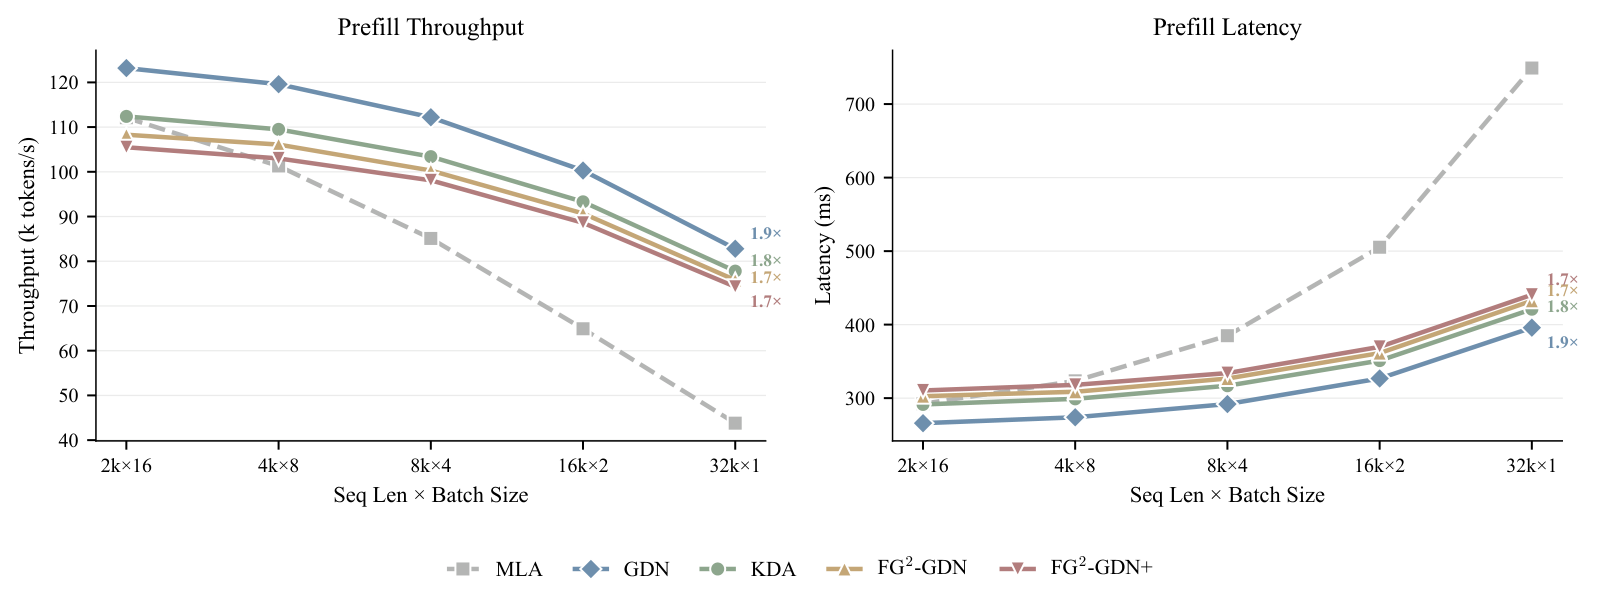
图 3 左图是吞吐,右图是延迟;横轴从 2K×16 到 32K×1,保持总 token 数不变。论文报告在 32K 时,线性注意力变体的 prefill 吞吐约为 MLA 的 1.7–1.9 倍;随着序列增长,MLA 吞吐下降更快。FG²-GDN 相对 KDA 的吞吐开销在所有测试设置下小于 5%;FG²-GDN+ 因额外的 value-rate 投影而略慢,但仍接近 KDA。线性注意力变体从 2K×16 到 32K×1 的吞吐比例约为 0.70,MLA 为 0.39(§4.5、图 3,PDF pp. 7–8)。
五、结论与适用边界
本文的主要贡献不是增加更大的记忆状态,而是把已有 delta 更新中的写入率细化到通道,并用对称平方根缩放保持计算结构。消融支持通道 β 在通道 α 之外提供独立增益;β 激活统计也显示其没有退化成常数。进一步把 key/value 两侧分开后,FG²-GDN+ 在 RULER 与 LongBench 的总体长上下文表现最好,额外参数少于 1%,prefill 效率仍接近 KDA。
证据目前来自 340M 和 1.3B 的稠密 3:1 MLA 混合模型,每种设置只训练一次;没有跨随机种子方差、方法专属调参、7B 以上规模、MoE 架构或从 KDA 检查点热启动的结果。效率证据是 H800 上的 prefill 测量,论文没有展示 decode 服务系统的端到端验证。作者指出,线性注意力的固定递归状态需要不同于 KV cache 的管理方式,推测解码还需处理草稿 token 被拒绝后的状态回滚(Limitations,PDF p. 9)。
来源
- Sun et al., “FG²-GDN: Enhancing Long-Context Gated Delta Networks with Doubly Fine-Grained Control,” arXiv:2604.19021v3, 2026-08-31. arXiv 页面 · 本地 PDF
- 正式发表记录:ACL Anthology / EMNLP 2026