The Topological Trouble With Transformers:中文精读笔记
作者:Michael C. Mozer、Shoaib Ahmed Siddiqui、Rosanne Liu(Google DeepMind)
版本:arXiv:2604.17121v5,2026 年 9 月 1 日更新
研读日期:2026 年 10 月 19 日
原文:arXiv v5 · 本地论文 PDF · 英文汇报 PDF
论文总览
论文讨论的是一个具体的架构问题:已经在深层形成的状态,怎样及时参与后续输入的计算? 标准因果 Transformer 可以保存并检索很长的历史,但如果新状态必须由上一个计算出的状态继续更新,信息依赖就会沿层级向上移动。固定深度限制了这种计算链;即使尚未耗尽深度,后续 token 的浅层也可能来不及使用早先 token 的深层判断。
作者据此区分深度循环、跨输入步循环和潜在思维反馈,提出“循环轴 × 每次循环处理的输入 token 数”的分类,并讨论增强状态空间模型、粗粒度循环和分阶段训练等方向。题名中的“拓扑”指计算图里的连接与信息可达性。
这是一篇立场与综合分析论文。它的主要贡献是问题解释、架构分类和研究方向;依据来自对话案例、已有机制研究和既有表达能力结果,未提出一套新模型及统一基准实验。最有用的判断是:要同时看状态反馈路径、更新函数和计算预算,不能仅凭模型名中有“recurrent”就推断其状态追踪能力。(原文 Secs. 1–6,PDF pp. 1–10。)
原文结构地图
| 原文章节 | 论证作用 | PDF 页码与图表 |
|---|---|---|
| 1 Introduction | 从动力系统引出递推状态与历史检索的取舍 | p. 1 |
| 2 State tracking | 对话失败、状态上移、浅层不可达和 CoT 反馈 | pp. 2–4;Figs. 1–3,Fig. 3 排在 p. 5 |
| 3 Recurrent architectures | 区分层、输入步与执行步;展开循环并分类 | pp. 4–8;Figs. 4–7,Table 1 |
| 4 Architectural limitations and workarounds | 解释 CoT、历史回看、并行组合与状态分解 | pp. 8–9 |
| 5.1 Enhanced State-Space Models | 转移矩阵结构与增强线性递推 | p. 9 |
| 5.2 Approximating state tracking in feedforward transformers | 训练目标与结构先验 | p. 9 |
| 5.3 Coarse recurrence | 按块或句子传递记忆 | pp. 9–10 |
| 5.4 Leveraging representational alignment | 利用跨层、跨输入步的表示对齐 | p. 10 |
| 5.5 Efficient training of recurrence | 后期引入循环、截断梯度和循环反向传播 | p. 10 |
| 6 Conclusions | 从显式思维痕迹转向隐式激活动力学的倡议 | p. 10 |
| References | 被引用工作 | pp. 11–16 |
一、动机:能查到历史,为什么还会失去一致性?
1.1 状态是对历史计算后的摘要
论文用下面的递推刻画状态更新:
$x_t$ 是第 $t$ 步的新输入,$s_t$ 是整合该输入后的状态,$f$ 是更新函数。状态可以是当前事实集合,也可以是对多个可能世界的概率分布,即信念状态(belief state)。这里没有规定统一的向量维度。
检索回答“之前出现过什么”,状态更新回答“所有相关事件发生以后,现在是什么情况”。例如,物体经过数次转移后,某个旧位置仍会出现在历史中,但已经不再是当前状态。模型既要找到事件,也要按依赖关系组合事件。
RNN 将历史不断压缩进状态,获得直接的更新路径,同时承担信息瓶颈和长期梯度传播的困难。Transformer 保存更丰富的历史,把一部分整合工作推迟到查询发生时。这种设计非常适合回看,但不能自动保证所有状态计算都能在给定深度内完成。(Sec. 1, p. 1;Sec. 2, pp. 2–3。)
1.2 猜数字案例暴露的是约束维护失败
原文展示 Gemini 3 Fast 在用户依次猜 60、41、70 时,依次回答“更小、更小、更大”。若目标是 1–100 中的整数,前两次回答已经把合法范围缩到 $[1,40]$,第三次回答却要求目标大于 70,约束交集变成空集。
这个例子不要求模型预先秘密选定一个数;只要维护一个非空的合法区间,就能保持一致。另一个案例中,Gemini 3 Thinking 已在思考文本中选了 42,却在用户猜 42 时继续回答“更小”。因此,把状态写进上下文只是提供了可检索的信息,后续计算仍要正确使用它。(Sec. 2, PDF p. 2。)
这些是论文展示的失败实例,没有给出统一采样协议、失败率或模型排名。作者也说明一些更新模型更少出现特定错误;案例的作用是让状态维护问题具体可见。
二、机制:为什么递推状态会沿深度上移?
2.1 因果计算图限制了反馈方向
下面是解释 Fig. 1 的教学记法,不是原文编号公式。令 $h_t^{(\ell)}$ 表示位置 $t$ 在第 $\ell$ 个完整 Transformer block 后的表示,隐藏维度为 $d$。标准因果 block 的依赖可以概括为
注意力跨位置读取的,是进入该 block 的表示;当前 block 还要完成注意力、残差和前馈计算。若一个计算结果只在 $h_{t-1}^{(\ell)}$ 中形成,后续位置通常要到更高的 block 才能消费这个结果。标准结构没有把它直接送回后续位置浅层的边。
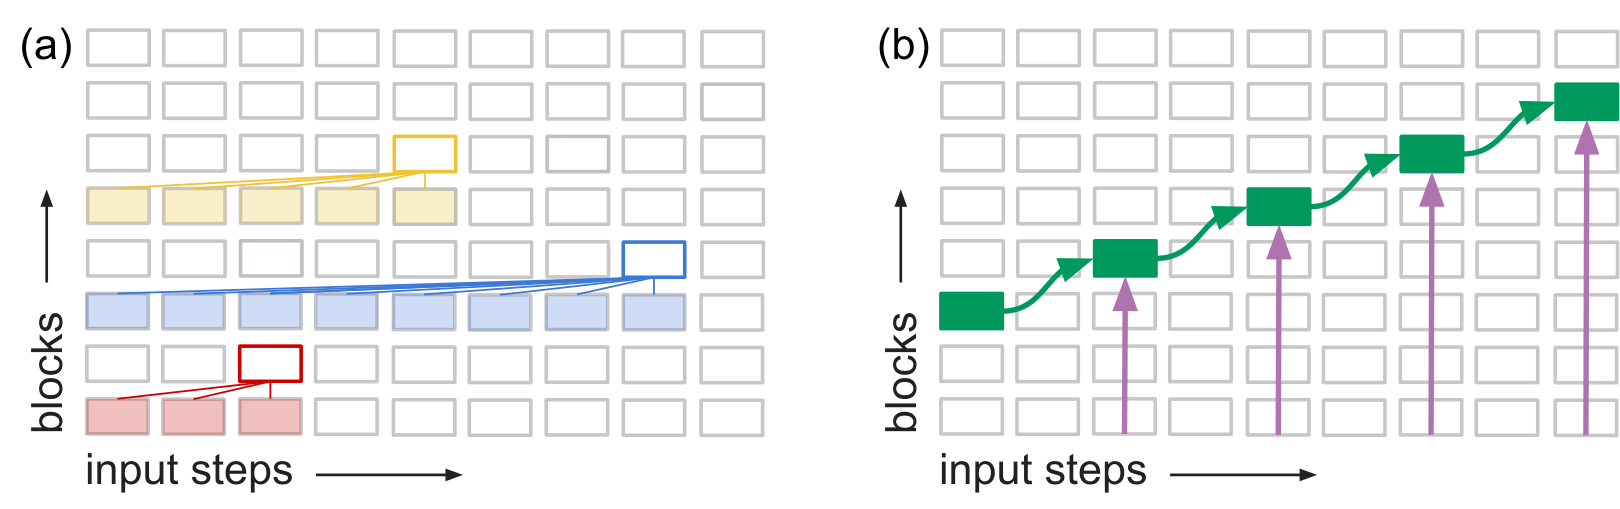
原文 Fig. 1,PDF p. 3。横轴是输入步,纵轴是 block,向上表示更深。左图的彩色区域表示所选 block 可以受到哪些较浅位置的影响;右图绿色框表示不断更新的状态,紫色箭头表示新输入。沿前一计算状态继续更新时,绿色状态轨迹逐步上移。
这张图解释的是直接承接前一个状态的计算链。若任务存在并行组合或历史重算算法,不必沿这条链逐个更新,因此不能读成“$L$ 层模型最多处理 $L$ 个 token”。原文随后专门讨论了这种替代算法。(Sec. 2, pp. 3–4。)
KV cache 也没有改变这条依赖关系。它保存的是过去位置在各层已经算出的键和值,减少重复计算;扩大缓存提供了更多历史材料,却没有增加深层到浅层的反馈连接。缓存中的历史表示也不会因为新事件到来而自动改写成最新状态。
2.2 状态已经形成,也可能来不及被使用
原文的 bank 对话先给出钓鱼语境,模型采用“河岸”解释;随后用户问附近是否有 ATM,模型又直接转向“银行”解释。作者借用 Lepori 等人的机制研究说明:上下文化与答案形成可能发生竞争。
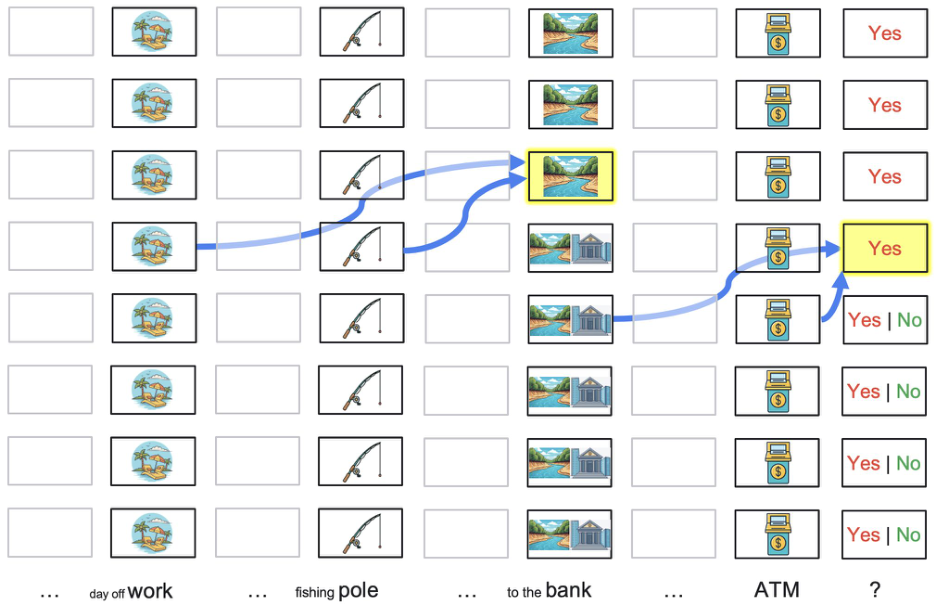
原文 Fig. 3,PDF p. 5,改编自 Lepori et al. (2025)。从下向上读,每列对应输入中的一个位置。bank 的河岸含义在较深处才确定,而末端位置可能已经在较浅层使用“银行—ATM”的关联,形成肯定回答。
原文以“第六个 block 完成消歧、前五个 block 无法使用该结果”作图示解释。这是示意层号,不能当作所有模型的实测阈值。文章提到被引用研究分析了 Gemma2-9B;对话展示所用的 Gemini 2.5 Flash 与该机制研究对象也应区分。(Sec. 2, PDF pp. 2–4;Fig. 3, p. 5。)
这里的问题比“总层数不够”更细:一个表示可能存在于网络中,却出现在后续决策已经使用其他信息之后。探针能够读出某个事实,并不自动说明答案计算在正确时机使用了它。
2.3 CoT 把深层结果重新送到输入端
思维链(chain of thought,CoT)提供了一条执行层面的反馈路径:
这使下一轮浅层可以读取被外显的中间结果。潜在思维(latent thought)可以用连续向量承担类似角色,避免把每一步都编码为自然语言。
作者的效率质疑集中在日常微小状态更新:如果维护人物关系、词义选择等信息也必须反复生成解释性文本,会增加串行计算和上下文占用。潜在反馈仍可能需要多次前向传播及额外缓存位置;具体成本取决于实现。本文没有给出与隐式循环在相同预算下的统一成本测量。(Sec. 2, p. 4;Sec. 4, pp. 8–9。)
三、架构分类:循环沿哪里发生,每次接收多少输入?
3.1 三种顺序需要分别计数
| 顺序 | 含义 | 容易混淆的地方 |
|---|---|---|
| 层级 $\ell$ | 表示由浅入深经过 block | 共享权重重复运行会增加有效深度 |
| 输入位置 $t$ | 序列中的 token 或输入事件 | 多个位置可以在一次层计算中并行处理 |
| 执行中的循环步 $r$ | 一次状态反馈完成后才能继续的计算 | 不一定与一个输入 token 一一对应 |
Teacher forcing 提供真实 token,因此普通 Transformer 训练时可以并行计算各输入位置;它没有提供模型运行中形成的隐藏状态。若下一块需要上一块实际计算出的记忆,即便所有 token 已知,该隐藏状态依赖仍存在。普通模型推理时逐 token 解码,也不能单凭执行顺序就视为拥有任意隐藏状态更新。(Sec. 3, PDF p. 6。)
3.2 每循环输入量决定了状态更新粒度
把原文的比例记成 $\rho$,便于说明:
- $\rho>1$:一次循环接收多个 token,例如块级循环。
- $\rho=1$:每个输入 token 对应一次状态更新。
- $\rho<1$:处理下一个输入之前,先进行多次内部更新。
以下按原文 Table 1 的实际单元格整理;它是架构导航,未给出各单元格性能排序。
| 循环轴 | $\rho>1$ | $\rho=1$ | $\rho<1$ |
|---|---|---|---|
| Depth | Looped Transformer、Universal Transformer、RINS | Recirculation | 原表留空 |
| Step | Block-Recurrent Transformers | Linear Attention、DeltaNet、Mamba、Canon Layers、PaTH Attention、RWKV-7、Test-Time Regression | DeltaProduct、FSRM |
| Depth + Step | Recurrent Memory Transformer、RINs、Sentence Gestalt | Feedback Transformer、Full-Bandwidth Transformer、T²MLR | COCONUT、Hierarchical Reasoning Model、CYB |
来源:Table 1, PDF p. 8。RINS 与 RINs 是原表列出的不同工作。
原文这里有几处不一致,使用分类时应以具体数据流判断:p. 7 将 Fig. 5c 与深度循环一起描述,Table 1 则把它放在 Depth + Step;p. 8 把“每输入多次循环”写作 $\rho>1$,按表头定义应为 $\rho<1$;同页关于空白格的说明也没有完全随表格更新,Step、$\rho<1$ 一格已经有例子。另外,p. 7 脚注把循环步严格解释为阻止序列并行的依赖,与表内部分可用扫描算法训练的递推并不完全一致。下文将逻辑状态依赖与训练算法的并行程度分开讨论。
3.3 相似的反馈箭头,可以展开成不同计算
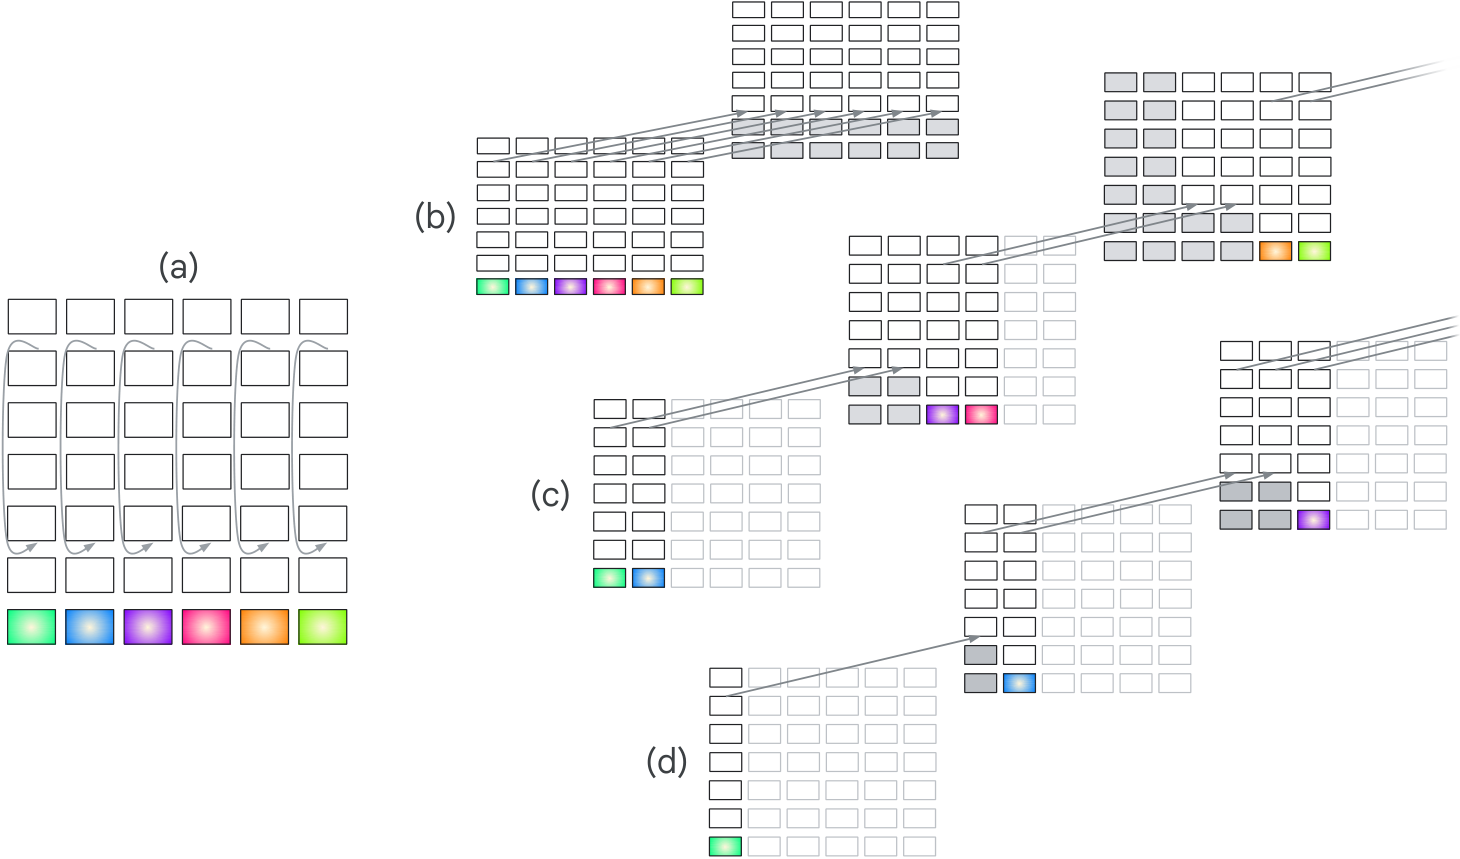
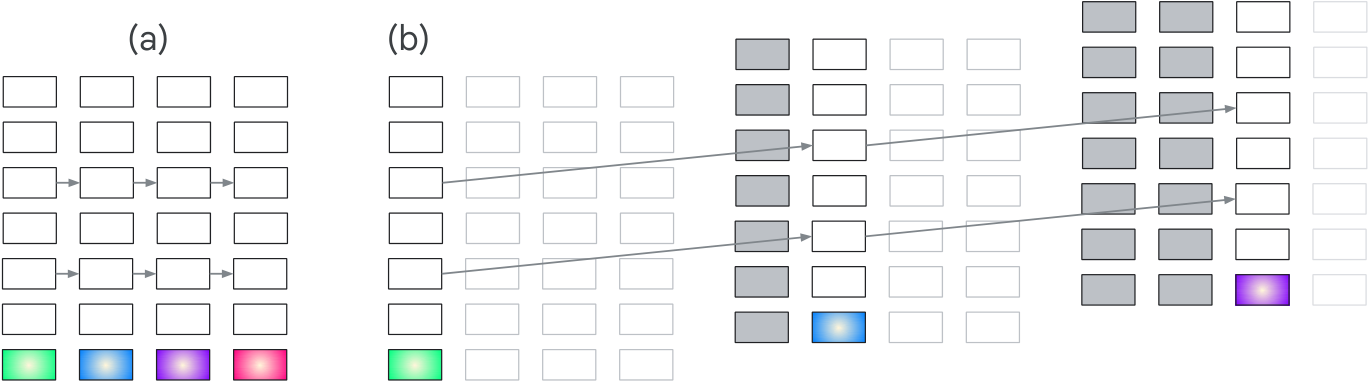
原文 Fig. 5,PDF p. 6。每个矩形代表完整 block;彩色底部框代表不同输入 token;灰色实心框是已固定、可由 KV cache 替代的计算;淡灰空框是当前步未处理的位置。
Fig. 5b:沿深度展开。 对同一批输入重复执行层或层组,增加有效深度。若每组有 $L$ 个 block,运行 $K$ 轮,简单情形下有效深度为 $KL$,但固定 $K$ 仍是有限预算。权重共享减少参数,不会自动让上一输入的最终状态出现在下一输入的浅层。允许 $K$ 随序列长度增长,则可以扩大可表达的任务范围,第四部分会具体说明。
Fig. 5c:块间传递记忆。 图中一次接收两个 token,块内并行,然后把状态交给后续块。其关键是上一块的计算结果成为下一块的实际输入。用教学记法可写成
其中 $X_b$ 是第 $b$ 块输入,$m_b$ 是块后记忆,$Y_b$ 是块内输出。这样可在每个块边界重新使用计算栈,而不用把所有更新都堆在一条固定的层轴上。收益依赖记忆保留了什么,以及块内需要多复杂的计算。
Fig. 5d:带持续更新的反馈。 每个执行步引入一个新输入,历史深层激活继续影响浅层,部分历史位置还会更新。作者指出它可能产生吸引子动力学(attractor dynamics):激活反复调整,直到相关历史状态达到稳定。这里“可能”很关键,本文没有证明这种结构必然收敛。
不同箭头还可以对应不同算子:复制缓存、以深层表示作 cross-attention 的键和值、线性映射、MLP 或适配器。分类图没有替这些实现规定统一更新函数。(Sec. 3, PDF pp. 6–8。)
3.4 潜在思维与层内状态递推
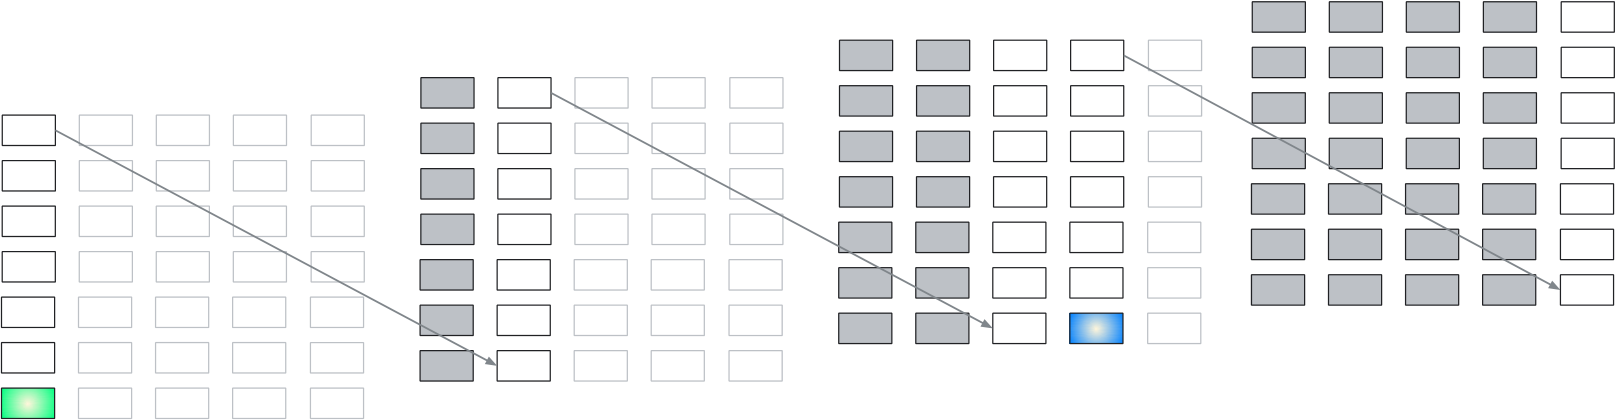
原文 Fig. 6,PDF p. 7。模型先把潜在输出多次反馈为输入,再接收蓝色标出的下一个外部 token。内部计算步数因此多于外部输入步数。判断能否跨事件维护状态,还要看潜在状态是否被传递到下一个输入阶段;原文特别提醒,表中部分潜在思维模型仍不具备所讨论的状态追踪能力。
原文 Fig. 7,PDF p. 7。左图在同层增加横向连接,右图展示展开后的依赖。这条路径允许同一层在下一输入步直接使用先前状态。不过,递推路径解决信息如何到达,更新函数决定到达以后能做什么;线性、对角、一般矩阵和非线性递推不能混为一类。
四、理论与证据:这条论证支持到哪里?
4.1 证据分别回答不同问题
| 依据 | 本文实际呈现 | 对主线的支持 |
|---|---|---|
| 猜数字、bank 对话 | 个别不一致输出 | 把需要维护的约束或语义状态具体化 |
| Fig. 2 的既有研究图 | 随输入推进而上移的计算轨迹 | 支持状态计算消耗深度这一机制解释 |
| Lepori 等人的上下文化研究 | 深层消歧与后续答案计算的依赖 | 说明状态可解码与状态可及时利用的区别 |
| 表达能力文献 | 有限深度、动态深度及 SSM 的形式化结果 | 确定计算资源和更新结构的重要性 |
| Table 1 与 Sec. 5 | 分类和研究方向 | 帮助选择新的反馈路径与训练取舍 |
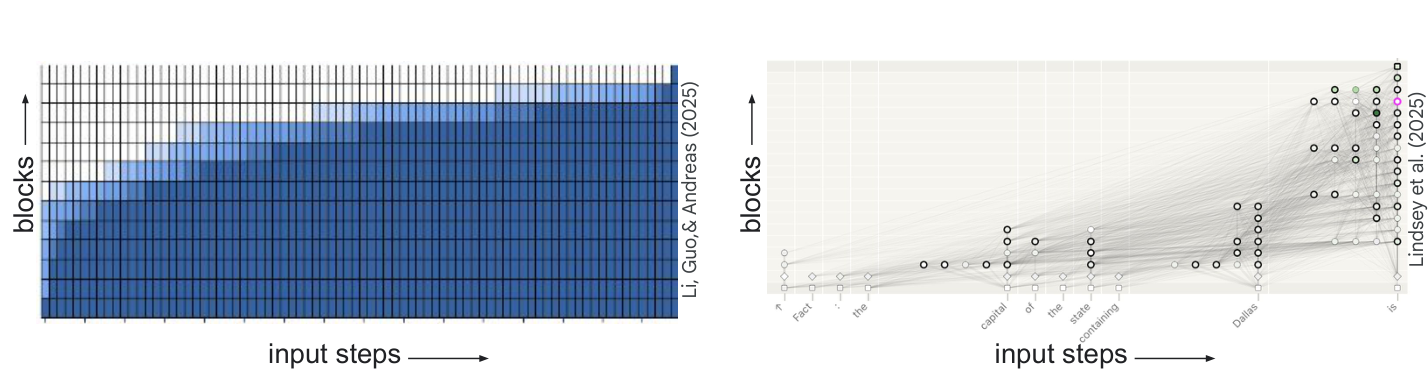
原文 Fig. 2,PDF p. 4,来自 Li et al. (2025a) 与 Lindsey et al. (2025)。两幅图都把输入步放在横向、block 放在纵向;本文关注的是依赖向更深处传播的形状,没有把它们作为一组统一量化比较。因此,这里不从线条位置反推出准确率或通用的每步层数。
4.2 有可组合结构时,可以缩短串行链
原文明确承认,某些状态更新可以改写为
关键在于 $g$ 是否能由较浅、可学习的计算实现。数学上能写出复合函数,不代表能廉价执行它。
Sec. 4 用奇偶性作例子:把相邻两位做异或,再合并四位、八位的奇偶性。对 $n=2^k$ 个输入,这种树形构造需要 $k=\log_2 n$ 级组合。它是论文给出的可行构造,不是所有 Transformer 奇偶性算法的通用下界。(PDF p. 9。)
教学例子:对 1,0,1,1,0,0,1,0,逐对异或得到 1,0,0,1,下一层得到 1,1,最后得到 0。八个输入中有四个 1,因此结果为偶数。递推写法是 $s_t=s_{t-1}\oplus x_t$;树形写法利用异或的结合律,避免依次完成八次状态更新。
另外两种替代策略也很重要。第一,长间隔保存一个早期比特的 latch 任务,可以转成对原输入的检索;不必把这个比特逐步接力。第二,状态可以分解成多个变量:不同人物的位置若彼此独立,就能异步更新,没必要维护一条整体状态链。(Sec. 4, PDF p. 9。)
4.3 动态深度有效,固定深度结论需保留条件
原文援引 Merrill 与 Sabharwal 的对数深度结果。该工作构造随输入长度增长的循环 Transformer,在其形式化模型中用 $\Theta(\log n)$ 深度处理正则语言识别、图连通性;与固定深度模型的分离依赖标准复杂度猜想。构造采用理想化注意力等设定,不能直接读作任意现实模型的能力保证。原始论文,Secs. 2、4–5。
因此,主论文 Sec. 3 的“深度循环不能无限追踪”应结合预算解读:固定展开预算不会自动获得持续状态更新;随长度增加计算深度,可以解决某些任意长度任务。 批量重算整个前缀与在线传递一个状态,还具有不同的成本。本文批评的重点是后者缺乏直接路径,不能据此排除前者的表达能力。
另一条引用需要修正。主论文 pp. 3–4 将 Fagnou 等人的实体追踪层数写成 $\log n+1$;原论文 Theorem 1 的公式为
其中 $\operatorname{depth}(G)$ 是依赖图最长路径长度,并假设每个注意力层在任务依赖图中的感受野为 1。这是带结构假设的结果,不能当作所有 Transformer 的无条件层数下界。Fagnou et al., Theorem 1,PDF p. 4,印刷页 13177;假设讨论见 Appendix B。
4.4 线性递推的表达能力取决于矩阵结构
主论文 Sec. 4 用了较宽的“线性 SSM 不比 Transformer 更强”的表述,而 Sec. 5.1 又讨论了增强 DeltaNet 的例外。应把前一判断限于被引结果所覆盖的模型。
被引的《The Illusion of State in State-Space Models》分析了对数精度下的 S4、S6/Mamba 等结构,包括输入无关转移、对角或同时可对角化转移的情形;在相应假设下给出 $\mathsf{TC}^0$ 上界。它还明确讨论输入相关的一般矩阵如何增强表达能力并保留可并行算法。因而,“对隐藏状态是线性的”本身不足以决定表达能力。原论文 Theorems 4.2、4.4、4.6 及 Sec. 5,PDF pp. 6–7。
下面用教学推导解释主论文 Sec. 5.1 提到的负特征值。采用 $S_t\in\mathbb R^{d_k\times d_v}$、$k_t\in\mathbb R^{d_k}$、$v_t\in\mathbb R^{d_v}$ 的方向约定,DeltaNet 更新可写为
这里键 $k_t$ 决定读写方向,值 $v_t$ 是期望写入内容,$\beta_t$ 是更新率。第一种写法是“根据预测误差修正记忆”,第二种写法把状态转移矩阵显式分离出来。该形式见主论文引用的 Grazzi et al., Table 1,PDF p. 3。
若 $\|k_t\|_2=1$,则
当 $\beta_t\in[0,1]$ 时,沿键方向只能保持、衰减或抹除;当 $1<\beta_t\leq2$ 时,该方向的特征值落在 $[-1,0)$,可以发生符号翻转。允许负特征值因此改变可表达的状态动态。一个最小教学例子是
此时 $z_t=1$ 表示偶数个 1,$z_t=-1$ 表示奇数个 1。它说明持续的离散翻转与单纯正向衰减有本质区别;复杂状态转换还依赖矩阵结构及每个输入允许执行多少次更新。
4.5 有状态依赖,不等于只能逐 token 串行训练
对于 $S_t=A_tS_{t-1}+B_t$,若 $A_t,B_t$ 由本层输入决定、可先行计算,两步仿射变换可以合并:
这个组合具有结合律。于是,可以通过树形前缀扫描计算多个位置的状态;序列级组合树有 $O(\log n)$ 个阶段,但每个阶段的矩阵计算成本仍取决于维度与结构。这是本次分析给出的代数解释,用来理解主论文 Sec. 5.1 的“增强状态追踪且可并行训练”。
对一般非线性 $f$,函数复合虽然在数学上也满足结合律,却未必有固定大小、低成本的组合表示。扫描优势来自可高效表示的闭合运算结构。因此需要区分三个问题:模型是否维护递推状态、该状态更新能表达什么、用什么算法执行更新。它们不能压缩成“能否并行”这一个判断。
五、结果与研究方向:作者希望改变什么?
本文没有可整理为新模型排行榜的实验结果。它的产出是前面的机制解释和分类,以及 Sec. 5 的五条方向。
5.1 增强 SSM:同时保留递推和可计算结构
作者强调负特征值 DeltaNet、RWKV-7、PaTH Attention 等方向,以及线性递推与标准注意力混合的潜力。共同思路是扩大可表达的状态变化,同时利用结构化计算控制成本。这里的关键设计对象是转移算子,而不仅是增加状态大小。主论文的效果判断来自所引用的工作,没有在本文中进行统一训练比较。(Sec. 5.1, PDF p. 9。)
5.2 用训练目标改善前馈模型的状态估计
专门的训练目标和结构先验可能鼓励模型学会更好的回看、组合和信念状态表示。它们保持现有架构的并行优势,改善有限任务上的状态估计;作者尤其希望进一步研究可分解、可组合的状态表示。(Sec. 5.2, PDF p. 9。)
5.3 按块或句子更新,降低反馈频率
粗粒度循环在一段输入处理完成后才传递记忆。除固定 token 块外,句子边界可能更符合语义状态变化。作为成本直觉,若固定块长为 $B$,长度 $n$ 的序列约有 $\lceil n/B\rceil$ 次块级更新;这只是在数更新次数,不是实测加速比。更大块减少块间串行步骤,却把更多状态整合留给块内有限深度。(Sec. 5.3, PDF pp. 9–10。)
5.4 利用残差表示的对齐
作者从某些模型仅微调、甚至不训练就能重复利用层的现象,推测残差连接形成了有利于跨层沟通的表示对齐。若这种对齐可被更系统地利用,增加反馈路径的适配成本可能较低。这是研究假说,尚不是本文验证过的统一迁移方法。(Sec. 5.4, PDF p. 10。)
5.5 把昂贵循环放到较晚的训练阶段
作者提出先做标准并行预训练,再引入循环;随后考虑截断梯度、适合吸引子动态的循环反向传播,以及提高算术强度的实现。需要共同考虑的是:前向状态可以持续多久、梯度传递多远、每次更新的硬件效率。截断梯度能减少训练负担,但不会自动教会模型利用任意长依赖。(Sec. 5.5, PDF p. 10。)
六、结论与研究启发
本文最强的解释力来自“状态何时可被下一次计算使用”。它把深度循环、缓存、潜在思维和在线递推放到同一个计算图视角下,指出增加参数复用次数、保存更多历史和增加状态反馈路径,分别改变了不同的资源。
其架构倡议值得保留,论证边界也需要具体化:固定深度与随长度增长的深度应分开;特定 SSM 的表达能力上界不能扩展到一切线性递推;案例与机制证据尚不能确定哪一种循环方案在大规模训练中最划算。
据此,本次分析建议研究状态架构时优先检验以下问题:
- 更新是否可持续使用? 在长序列中反复查询和修改同一变量,测量每步状态正确率及首次失效位置,避免只检查最终答案。
- 任务依赖能否被绕过? 分开评估静态检索、独立变量更新和相互耦合的状态变化,观察模型采用了何种计算。
- 新路径是否真的传递了状态? 对反馈状态做替换或阻断,检查后续行为,而不只看探针能否解码某个变量。
- 收益付出了什么成本? 同时报告长度外推、延迟、训练吞吐和内存;在可比预算下比较固定深度、动态深度、CoT 与跨步循环。
这些是从本文推导出的评估建议。作者最终倡导的是:让持续状态更新更多地由隐式激活动力学承担,并与 Transformer 擅长的历史检索结合;哪种组合最有效,仍需要具体任务与资源预算下的验证。