Parcae: Scaling Laws For Stable Looped Language Models:中文研读笔记
- 作者:Hayden Prairie、Zachary Novack、Taylor Berg-Kirkpatrick、Daniel Y. Fu;UC San Diego / Together AI。
- 原文:arXiv:2604.12946v1,2026-04-14 提交;获取与研读日期:2026-09-16。
- 材料:本地原论文 PDF、同版本作者
main.tex、macros.tex、全部实际引用的sections/*.tex与appendix/*.tex。源码获取成功。已阅读正文 1–7 节及附录 A–R;参考文献用于定位,未逐篇阅读被引论文。 - 页码均指 PDF 物理页码(本论文与印刷页码一致),共 44 页。以下是分析笔记,不是全文译文,也不是训练复现。
论文总览
核心问题:能否在基本不增加存储参数的条件下,通过反复运行同一组 Transformer 层,稳定且可预测地提高语言模型质量?
Parcae 的贡献分成两层。首先,它把循环模型的残差传递拆成线性状态传递、输入注入和非线性 Transformer 更新,通过负对角参数化约束线性传递,再配合输入归一化与逐序列深度采样,改善训练稳定性。其次,在这个较稳定的平台上,研究“训练数据量—训练循环深度—推理循环深度”的经验缩放关系。
最有证据支持的结果是:1.3B 档模型在同档参数、同数据量的对比中,Core 从 25.45 到 28.44,Core-Extended 从 15.90 到 17.08;增加训练循环次数与数据量可以共同改善质量,而仅在推理时无限增加循环并不能无限提高效果。前者不是等 FLOPs 比较;后者的缩放律主要在 140M 和 370M 模型上拟合。[Sec. 5,PDF pp. 7–11,Table 5、Figs. 4–8]
结构地图
| 原文章节 | 作用 | PDF 页码与主要证据 |
|---|---|---|
| 1 Introduction | 参数存储约束下的计算扩展动机 | pp. 1–3,Fig. 1 |
| 2 Background | 中间层循环、LTI 系统、缩放律拟合 | pp. 3–4 |
| 3 Understanding Instability in Looped Architectures | 残差爆炸的线性代理分析 | pp. 4–5,Figs. 2–3,Tables 1–2,Eq. (2) |
| 4 Parcae: A Stable Looped Architecture | 负对角参数化与训练算法 | p. 6,Eq. (3) |
| 5.1 Parcae Improves End-to-End Quality | 对 RDM、Transformer 的质量对比和消融 | pp. 7–8,Tables 3–5 |
| 5.2 Looping as an Orthogonal Scaling Axis in Training | 固定参数与 FLOPs,平衡循环和数据 | pp. 8–9,Figs. 4–6,Table 6 |
| 5.3 Test-Time Scaling Laws of Parcae | 饱和、指数拟合、统一缩放律 | pp. 10–11,Figs. 7–8,Eq. (4) |
| 6 Discussion and Future Work;7 Conclusion | 适用范围与未来方向 | p. 11 |
| A–E | 符号、相关工作、推导、FLOPs、算法 | pp. 20–23 |
| F–J | 学习率、采样、截断反传、Prelude Norm 消融 | pp. 23–34,Figs. 9–24 |
| K–L | 训练/推理拟合细节与外推验证 | pp. 35–38,Tables 11–14,Figs. 25–26 |
| M–R | 评估、扩展结果、实验设置、模型、超参数、分词器 | pp. 38–44,Tables 15–22 |
一:动机——用重复计算提高参数利用率
普通 Transformer 通过增加宽度或层数提高容量,通常同时增加参数存储。循环深度模型(recurrent depth model, RDM)则保留一组共享参数,令隐状态多次经过同一模块。其有效计算深度可以增长,而实际权重数量基本不变。
本文聚焦 middle-looped 结构:输入先通过 Prelude,中间 Recurrent 模块运行多次,最后通过 Coda 输出 token 预测。它讨论的是隐状态的层间循环,不是生成更多文字形式的思维链,也不是在序列时间维度上替代注意力的 RNN。虽然背景讨论了隐式停止与自适应计算,主实验实际按指定的 $T$ 评估,没有验证一套新的逐 token 路由器。[Sec. 2.1,PDF p. 3;App. B,pp. 21–22]
困难在于共享更新被反复施加后,残差的放大也会累积。已有方法通过 Pre-Norm 与 Post-Norm 结合来归一化残差,但学习率仍敏感,训练后期还可能出现 loss spikes。作者先解决这一问题,才继续研究循环是否具有可规划的计算收益。
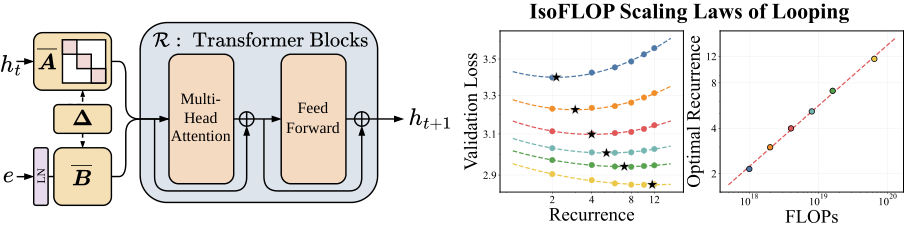
来源:Fig. 1,PDF p. 2;作者原图,按原 TeX 去掉左侧空白。左侧是状态、输入注入与 Transformer 残差更新,右侧展示各预算的循环最优点及其随预算增长的趋势。右图的“最佳循环次数”来自经验拟合,不是架构保证。
二:方法——稳定状态传递,加上正确的深度采样
2.1 输入、输出与符号
| 符号 | 含义 |
|---|---|
| $s\in V^n$ | 长度 $n$ 的输入 token 序列 |
| $e=\mathrm{LN}(\mathcal P(s))$ | 归一化后的 Prelude 输出,序列维上通常为 $n\times d_e$ |
| $h_t$ | 第 $t$ 次循环后的隐状态,通常为 $n\times d_h$ |
| $\mathcal P,\mathcal R,\mathcal C$ | Prelude、完整 Recurrent、Coda 模块 |
| $\overline{\mathcal R}$ | 非线性模块相对注入状态的残差贡献,不等于完整循环模块 |
| $A,\overline A$ | 连续、离散状态传递;$A\in\mathbb R^{d_h\times d_h}$ |
| $B,\overline B$ | 输入注入;一般形式 $B\in\mathbb R^{d_h\times d_e}$ |
| $C$ | 读出投影,$d_c\times d_h$;与 Coda 的 $\mathcal C$ 区分 |
| $\Delta$ | 可学习离散步长,按通道作用 |
| $\mu_{\mathrm{rec}},\mu_{\mathrm{bwd}},T$ | 训练平均前向深度、反传截断长度、某次实际循环次数 |
| $D,\mathbf N(\mu),C_{\mathrm{FLOPs}}$ | 训练 token 数、展开后的有效参数量、计算预算 |
论文按单 token 列向量表示矩阵乘法;对整个序列只是逐位置作用,不应机械地把 $n\times d$ 张量左乘 $d\times d$ 矩阵。[Sec. 2–4,App. A]
2.2 从残差更新到线性代理
普通注入可以写成 $u_t=W_1h_t+W_2e$。定义 Transformer 的相对残差贡献后,完整更新可精确改写为:
其中 $\overline A=W_1$、$\overline B=W_2$;$\overline{\mathcal R}(h_t,e)$ 是把对 $u_t$ 的依赖简写。丢掉非线性贡献,得到作者用来分析的线性时不变(LTI)代理:
$$h_{t+1}=\overline A h_t+\overline B e. \tag{对应原文 Eq. 2}$$教学推导: 固定输入时,展开为
$$h_T=\overline A^T h_0+\sum_{k=0}^{T-1}\overline A^k\overline B e.$$此处上标 $T$ 表示矩阵的 $T$ 次幂,不是转置。当谱半径 $\rho(\overline A)<1$,初始状态的影响衰减,几何级数收敛至 $(I-\overline A)^{-1}\overline B e$。加法注入对应 $\overline A=I$,此时恒定非零输入会逐步累加;无约束拼接投影则允许学到放大状态的矩阵。[Sec. 3,PDF p. 5;App. C,p. 22]
理论边界: 原文把“删除非线性项”称作 linearization,它是代理分析,并不是对完整网络 Jacobian 的局部线性化。一般矩阵的谱半径与谱范数不是同一概念:$\|\overline A\|_2<1$ 是充分条件,$\rho(\overline A)<1$ 才是离散线性系统渐近稳定的标准判据。原文两者用词混用;在 Parcae 的对角设计中二者一致。无约束参数化只是允许不稳定,并不意味着每个无约束矩阵都不稳定。
对完整非线性更新,仅控制 $\overline A$ 不能直接保证收敛;还需要控制非线性贡献或完整 Jacobian。例:标量 $\overline A=0.5$、$\overline{\mathcal R}(h,e)=h$ 时,整体更新仍有 $1.5h$ 的放大。这个例子是本次分析,不是论文实验。因此这里应读成“有启发性的机理分析与实证稳定化”,而非“任意非线性循环网络的全局稳定性定理”。
2.3 Parcae 的参数化与前向过程
$A$ 的特征值被约束为负;若每个 $\Delta_i>0$,则 $\overline A_{ii}=\exp(-\Delta_i\exp(a_i))\in(0,1)$,从而约束线性记忆传递。论文对 $\overline A$ 用零阶保持(ZOH),对 $\overline B$ 用 Euler;不要误写成两个矩阵都使用完整 ZOH 公式。
需要留意:Sec. 4.1 仅把学习步长写成 $\Delta\in\mathbb R^{d_h}$,正文与所读附录未明确给出保证其正值的实现。负 $A$ 配合任意实数步长不足以推出稳定。这里的正步长是推导所需条件,不能擅自声称作者用了某种 softplus 实现。
完整前向是:
$h_0$ 为随机初始化;$\overline B$ 不作同样的收缩约束,因此另加 Prelude 输出归一化来限制输入幅度。Parcae 保留 Pre-Norm Transformer 块,但不再依赖已有 RDM 的残差 Post-Norm。[Sec. 4.1,PDF p. 6;App. P,pp. 40–42]
教学例子: 忽略非线性项,$h_{t+1}=0.8h_t+0.2e$ 会趋近 $e$;若变成 $1.1h_t+0.2e$,重复计算会放大状态。真正模型仍靠注意力和 MLP 学习任务,不能把它理解成只做指数平滑。
2.4 逐序列深度采样与截断反传
训练目标对样本与深度同时求期望:
$$\min_\theta\ \mathbb E_{(x,y)\sim\mathcal D,\ T\sim\Lambda} [\ell(f_\theta(x;T),y)].$$同一 micro-batch 全部用一个深度,会让本次梯度对深度分布的覆盖较窄。作者让每条序列独立采样 $T_i$,在同一 batch 中覆盖多个深度。
实现采用“末尾对齐”:设 $T_{\max}=\max_iT_i$,短序列先等待 $T_{\max}-T_i$ 步,然后开始更新,因此所有样本在末尾结束。只对最后 $\min(T_i,\mu_{\mathrm{bwd}})$ 个有效更新保留梯度。比如 $T_i=(2,4,6)$,先分别等待 $(4,2,0)$ 步;等待时必须保持原状态。这是便于理解的例子,实际代码仍须正确处理掩码和 detach。[App. E,PDF p. 23,Algorithms 1–2]
另一个改动是先采样完整前向深度,再决定反传范围:
$$T\sim\Lambda(\mu_{\mathrm{rec}}),\quad n=\max(T-\mu_{\mathrm{bwd}},0),\quad k=\min(T,\mu_{\mathrm{bwd}}).$$旧方法先采样无梯度段,再固定加上反传段,使实际深度分布变成平移、缺少低深度样本的分布。作者的修正把分布与反传截断解耦;主实验的 RDM baseline 也采用此修正,不能把全部对比收益归给这项改动。主实验取 $\mu_{\mathrm{bwd}}=\lceil\mu_{\mathrm{rec}}/2\rceil$;这是消融支持的启发式选择,不是已证明的计算最优值。[Sec. 4.2;App. H–I,PDF pp. 27–30]
三:实验——必须分开的三种预算口径
3.1 与已有 RDM 的对比
使用 Huginn 数据与分词器;100M、350M 是档位名,实际模型参数约 114M、379M。Prelude/Coda 各一层,中间分别一层、两层;$\mu_{\mathrm{rec}}$ 分别为 16、8,反传深度 8、4。模块使用 causal attention、SwiGLU、RoPE 和 RMSNorm,词表 65,536。RDM 是残差归一化版本;Parcae 使用上述稳定化方案。学习率先为 baseline 搜索,Parcae 沿用。该组主比较训练 token 总数在所读配置说明中未明确列出,不应借用其他消融的 10B。[Table 3;App. P.1、Q.1]
验证集与 WikiText 用困惑度(perplexity, PPL),越低越好;下游表为六个零样本任务的分数及平均值,越高越好。PPL 与自然对数交叉熵的关系为 $\mathrm{PPL}=e^{\mathrm{loss}}$,不可把 loss 的相对变化当成 PPL 的相对变化。
3.2 与 Transformer 的对比
使用简化 nanochat 配方,FineWeb-Edu、共同自训 32,768 词表 BPE、2,048 上下文、batch 256、BF16、AdamW + Muon。各档分别训练 11.2B、29.6B、61.6B、104B tokens。Transformer 有 6/12/18/24 层;Parcae 把相同层数均分为 Prelude/Recurrent/Coda,中间三分之一循环,$\mu_{\mathrm{rec}}=8$、$\mu_{\mathrm{bwd}}=4$,表中用 $T=8$ 测试。[Tables 18–21,PDF pp. 42–44]
参数是近似匹配:Parcae 增加约 0.83%、0.54%、0.42%、0.35% 的参数,来自额外模块。同参数档位、同 token 数不等于同 FLOPs 或同延迟。 例如教学上的层数计数,140M 档 Transformer 跑 6 层,Parcae 在 $T=8$ 时跑 $2+8\times2+2=20$ 层;该计算只是层调用数,不能直接当精确运行时间比。
Core / Core-Extended 是原文采用的聚合下游分数,越高越好;后者涵盖更多理解、知识、常识、符号/数学、阅读与安全任务。Table 15 逐项给出 MC/S/LM 计分方式与 shot 数。本文未完整展开聚合归一化公式,不把它当成单一任务准确率,也不混同 RDM 表的六任务 Avg.。每项评估运行三种 seed,改变初始循环状态和 few-shot 示例;这不是三次独立预训练。原文未清楚定义表中 $\pm$ 是标准差还是标准误,因此保留其误差条,不重新解释成置信区间。[App. M,pp. 38–39]
3.3 等 FLOPs 与测试时缩放
| 实验 | 固定项 | 变化项与范围 | 目的 |
|---|---|---|---|
| isoFLOP 训练 | 参数档、训练 FLOPs | $\mu\in\{2,4,6,8,10,12\}$,相应调整 $D$ | 循环与更多数据如何分配预算 |
| 推理饱和拟合 | 参数档、11.2B tokens | 训练 $\mu$ 同上,推理 $T=1,\ldots,24$ | 测量深度外推与饱和 |
| 跨四个规模的推理 | 各档 Table 5 模型、训练 $\mu=8$ | $T=1,\ldots,16$ | 验证饱和趋势是否持续 |
| 统一缩放拟合 | 140M / 370M 分别拟合 | isoFLOP 模型的十种 $T$,另测留出模型 | 联合预测训练与推理效果 |
140M 的训练预算是 $\{1,2,4,8,16,64\}\times10^{18}$ FLOPs,共 36 个循环配置;370M 是 $\{32,64,128\}\times10^{18}$,共 18 个。另有 $\mu=1$ 的固定深度 Parcae 对照。[App. O,pp. 38–40]
原文计算预算近似:
$$C_{\mathrm{FLOPs}}=(2\widehat N_1+6\widehat N_2)D+\text{attention FLOPs estimate}.$$$\widehat N_1$ 是不反传的有效展开参数,$\widehat N_2$ 是会反传的部分;不计 embedding、计 unembedding,并另计 attention。因此有效参数 $\mathbf N(\mu)$ 不等于实际独立参数,简单的 $6ND$ 或 $C\propto\mu D$ 不能直接替代本文口径。[App. D,PDF p. 22]
四:结果——按原文的论证顺序
4.1 稳定性和端到端质量(Sec. 3、5.1)
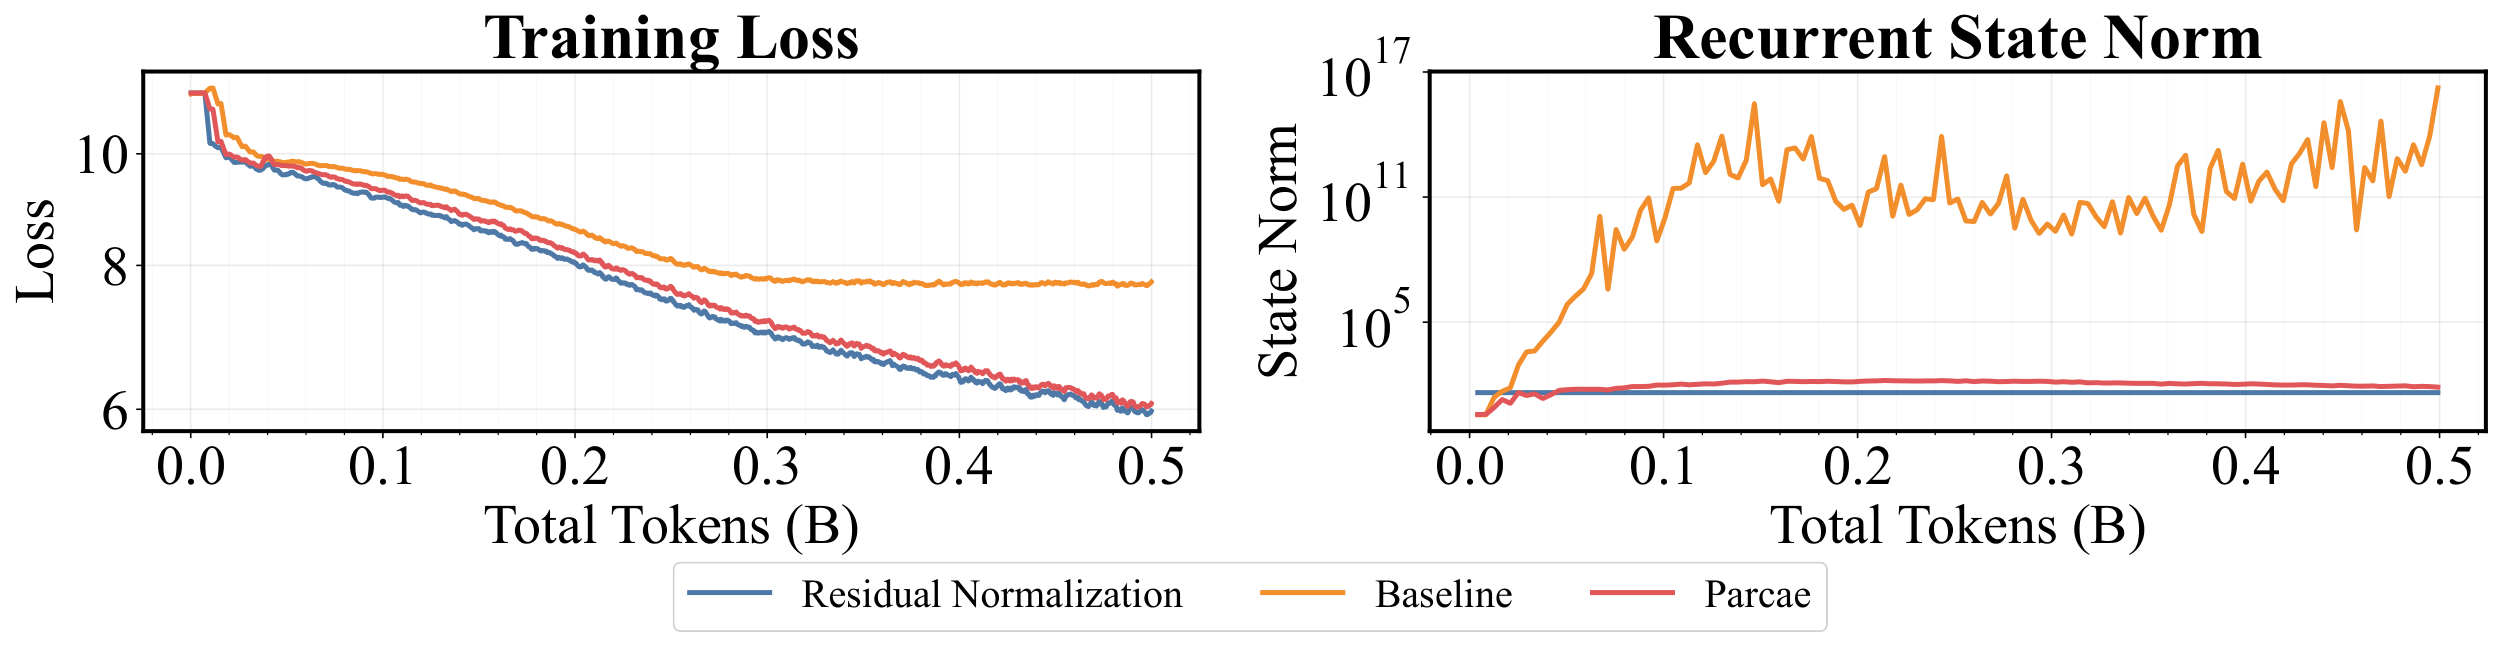
来源:Fig. 2,PDF p. 4。横轴是训练 token 数;左图为训练 loss,右图为状态范数,对数纵轴显示发散运行的巨大幅度。颜色区分 baseline、残差归一化、Parcae。它把损失发散与状态爆炸联系起来,但单凭这张图不能推导任意网络的因果定理。
Table 2(p. 5)的五档学习率中,基础 Pre-Norm RDM 仅在 $2\times10^{-4}$ 收敛,残差归一化 RDM 在 $2,4\times10^{-4}$ 收敛,Parcae 五档均收敛;这说明在已测网格里鲁棒性更好,不表示任意学习率都稳定。
| RDM 设置 | 验证 PPL:RDM → Parcae | WikiText PPL | 六任务 Avg. |
|---|---|---|---|
| 100M,$T=16$ | 14.23 → 13.59 | 63.27 → 60.33 | 45.03 → 46.83 |
| 350M,$T=8$ | 10.76 → 10.09 | 41.31 → 37.53 | 49.45 → 50.12 |
来源:Table 3,PDF p. 7。350M 验证 PPL 相对降低 $(10.76-10.09)/10.76\approx6.23\%$,WikiText 降低约 9.15%;100M 平均下游分数增加 1.80 点。任务并非全部改善:100M 的 SciQ 从 72.50 降至 71.50,350M 的 BoolQ 从 61.53 降至 60.73。
| Transformer 设置 | 验证 PPL:Transformer → Parcae | Core | Core-Extended |
|---|---|---|---|
| 140M,11.2B tokens | 21.48 → 19.06 | 13.00 → 14.04 | 8.80 → 9.67 |
| 370M,29.6B tokens | 15.79 → 14.49 | 17.46 → 20.00 | 11.71 → 12.75 |
| 770M,61.6B tokens | 13.08 → 12.49 | 22.42 → 25.07 | 14.20 → 15.19 |
| 1.3B,104B tokens | 11.95 → 11.42 | 25.45 → 28.44 | 15.90 → 17.08 |
来源:Table 5,PDF p. 8。此处为紧凑比较省略误差条;1.3B 原值为 Core $25.45\pm0.08\to28.44\pm0.28$,Core-Extended $15.90\pm0.23\to17.08\pm0.09$。提高是 2.99 和 1.18 个分数点,不是 2.99% 与 1.18% 的相对增益。Lambada PPL 同样改善,1.3B 从 17.26 到 14.71。
87.5% 的正确读法: 作者算的是“弥合与下一档大模型之间差距的比例”。例如 770M Core:
$$\frac{25.07-22.42}{25.45-22.42}\approx87.46\%.$$这既不是节省了 87.5% 参数,也不是大模型绝对得分的 87.5%。770M Parcae 接近 1.3B Transformer 的 Core,但实际参数约 777M 对 1,334M,相差约 1.72 倍;“两倍大小”是宽泛叙述。跨档比较的数据量也不同,不能借它声称严格的等数据、等计算大模型替代。
4.2 三项改动各自贡献什么?
140M nanochat 设置的累加消融如下:
| 配置 | $T=1$ Val. loss | $T=4$ | $T=8$ |
|---|---|---|---|
| 原始 RDM | 发散 | 发散 | 发散 |
| 约束 $\overline A$ | 8.99 | 3.15 | 2.97 |
| 再加逐序列采样 | 3.38 | 3.01 | 2.98 |
| 再加 Prelude Norm | 3.28 | 2.97 | 2.95 |
来源:Table 4,PDF p. 7。约束传递让训练可用,但不能自动保证浅层推理;逐序列采样的主要收益在低 $T$;Prelude Norm 继续降低验证 loss。不要说“每项修改让每个下游指标单调提高”:$T=8$ Core-Extended 从逐序列采样的 9.9 到加入归一化后的 9.7,且有评估误差条。
附录补充的关键证据:
- 逐序列采样(G,pp. 25–26): 350M 在 $T=1$ 时 PPL 从 per-batch 的 167.61 降为 17.92;$T=8$ 是 10.40→10.09。作者报告预训练 wall-clock 增加 1.8%,这是该采样实现相对 per-batch 的开销,不能当成整个循环模型相对 Transformer 的开销。
- 深度分布修正(H,pp. 27–28): 100M、10B tokens、$\mu_{rec}=\mu_{bwd}=8$,三种方案在 $T=8$ 近似,而修正后的分布在 $T=4$ 等其他深度更接近完整反传的结果。说明训练中是否见过浅层深度很关键。
- 反传长度(I,pp. 29–30): 固定反传长度时,增加前向循环可能无益;固定 $\mu_{rec}=20$ 后增加反传长度改善深层结果,支持主实验让反传长度随前向深度增长。早期实验发生在分布修正前,不能将其当作最终训练配方的严格最优性实验。
- 输入归一化(J,pp. 31–34): 1.3B 的早期方案后期失稳。作者检查 $\overline A,\overline B,C$、真实激活放大率、首次循环和 Prelude 各层,发现异常主要由输入 $e$ 注入引起;加 Prelude Norm 后完成稳定训练。对“改善 Prelude 梯度”的解释,作者也注明未直接证明。
4.3 训练阶段:循环和数据应共同增长(Sec. 5.2)
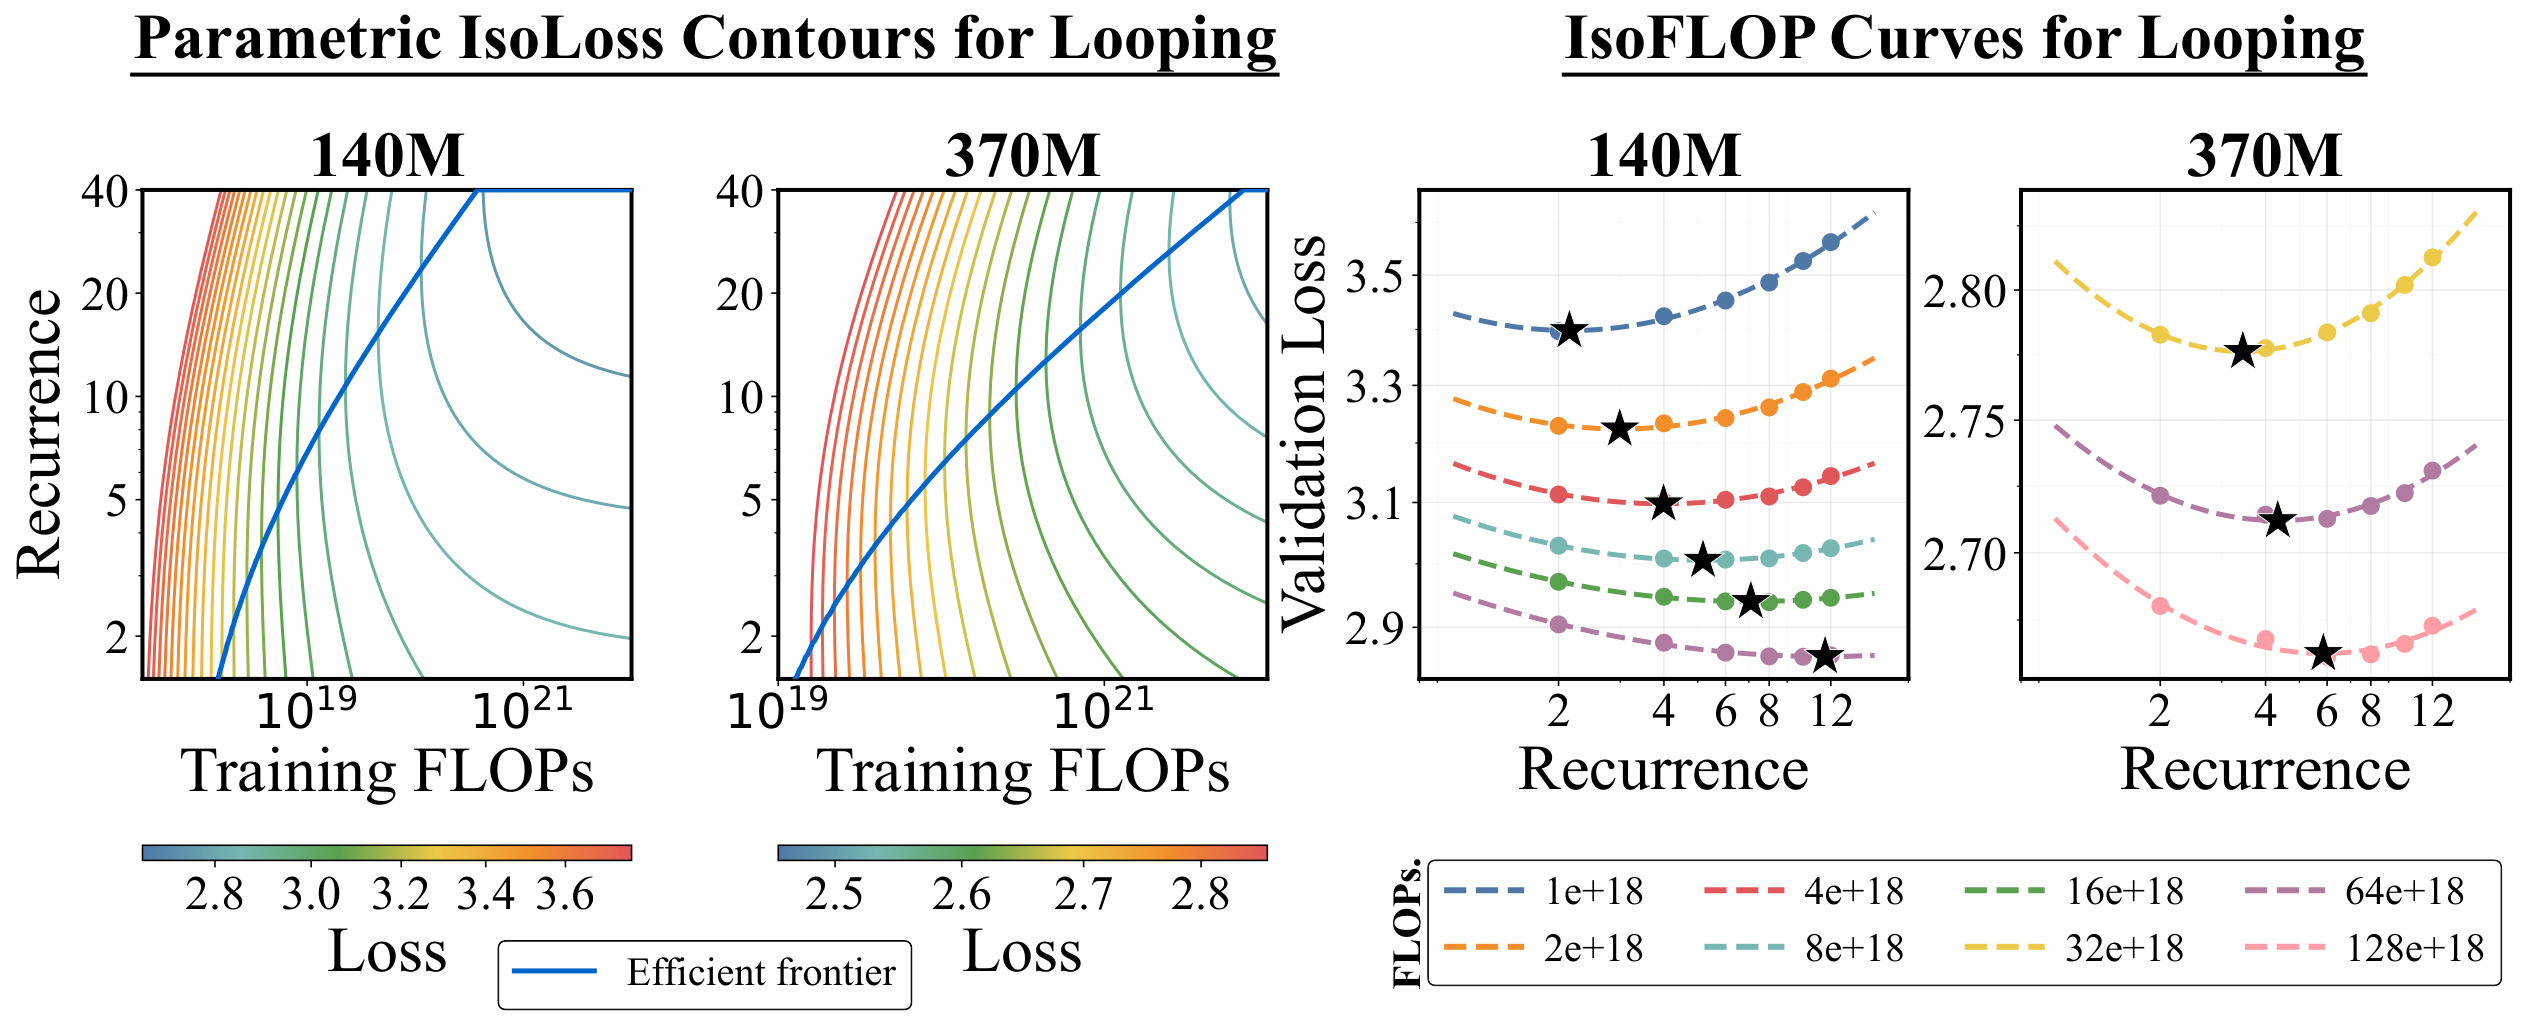
来源:Fig. 4,PDF p. 8。左两面板的实际横轴是 Training FLOPs,纵轴是 recurrence,颜色表示预测 loss,蓝线为效率前沿;虽然 caption 描述的是循环与数据的关系,不应把这里的横轴误读成 tokens。右两面板横轴循环深度,纵轴验证 loss;不同曲线为不同 FLOP 预算,星号为拟合最小值。曲线呈 U 形:循环过少没有充分利用重复计算,过多则挤占数据预算。
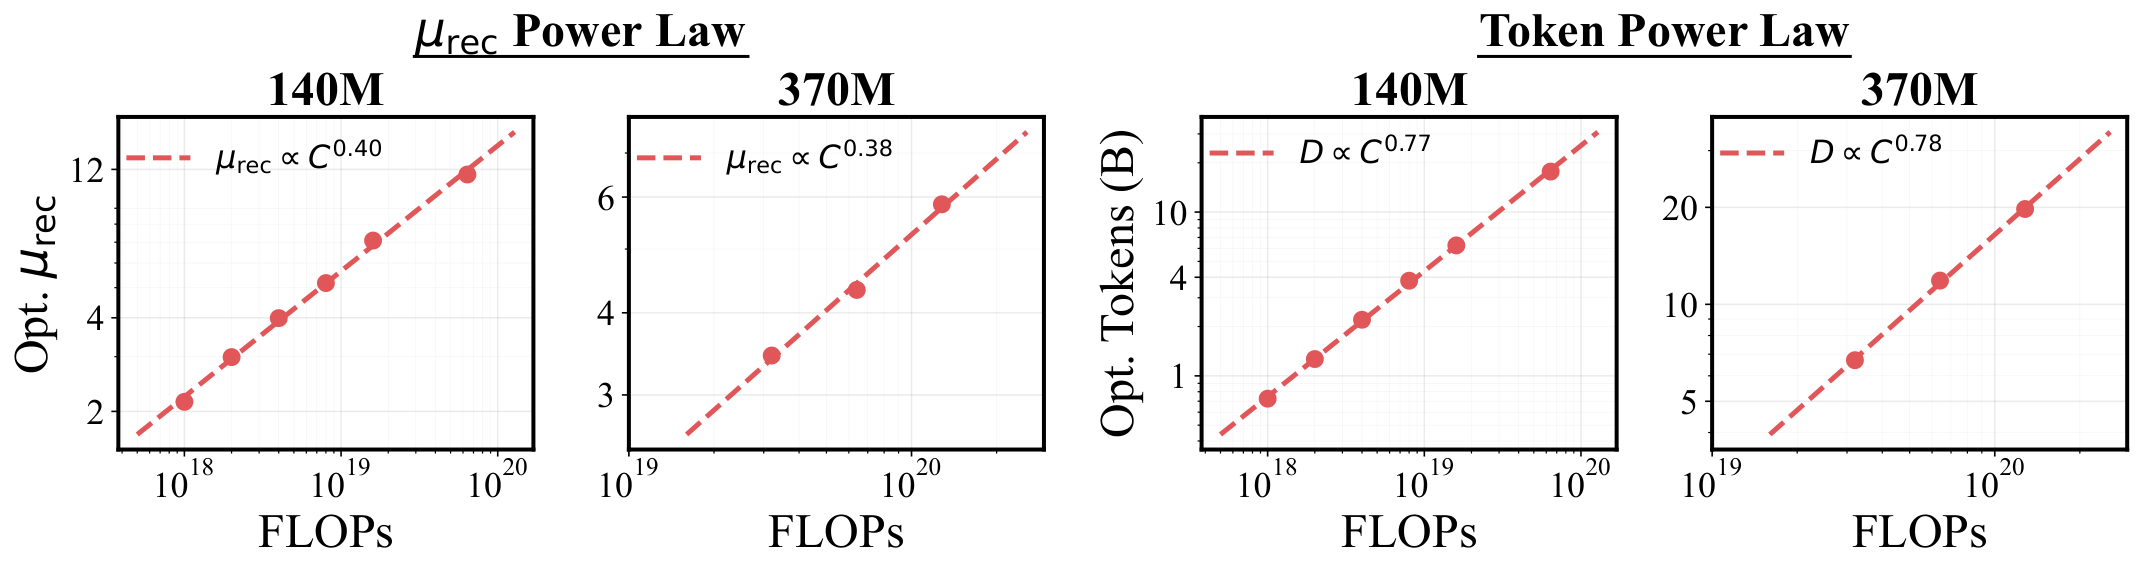
来源:Fig. 5,PDF p. 9。横轴均为 FLOPs;左侧两图纵轴为最优 $\mu_{rec}$,右侧为最优 tokens。图中精确标注为:
| 档位 | $\mu_{rec}^*$ 的预算指数 | $D^*$ 的预算指数 |
|---|---|---|
| 140M | 0.40 | 0.77 |
| 370M | 0.38 | 0.78 |
这些是有限范围内分别拟合的经验指数;不是普适常数。指数和不等于 1,不应强塞进纯乘积 $C\propto\mu D$;作者的成本模型含固定模块、截断反传和 attention 项。本文也没有证明这些拟合能无限外推。
参数化训练律为:
$$\widehat{\mathcal L}_{train}(\mu,D) =E+X\mathbf N(\mu)^{-x}+YD^{-y}.$$它用展开参数量代理有效计算深度,对 log loss 的 Huber 目标做 L-BFGS;训练律拟合用 500 次随机重启。App. K 的系数用 $A,a,B,b$ 记号,对应这里的 $X,x,Y,y$,不要与动态系统矩阵 $A,B$ 混淆。140M/370M 的 $x$ 为 0.771/0.775,$y$ 为 0.525/0.448;留出主实验模型的 loss 预测误差分别约 1.3%/0.8%。这是 loss 误差,不是下游准确率误差。[PDF p. 35,Table 11;Sec. 5.2]
等 FLOPs 下,下游收益有条件。 Table 6 / Table 16 的部分关键行:
| 档位与预算(FLOPs) | 最优循环 | Core:循环 / 固定深度 | 解释 |
|---|---|---|---|
| 140M,$2\times10^{18}$ | 2 | 9.0 / 10.5 | 固定深度更好 |
| 140M,$8\times10^{18}$ | 6 | 10.5 / 11.8 | 中等预算也非全面获胜 |
| 140M,$16\times10^{18}$ | 8 | 14.6 / 13.0 | 循环开始表现出收益 |
| 140M,$64\times10^{18}$ | 10 | 16.2 / 15.0 | +1.2 点 |
| 370M,$32\times10^{18}$ | 4 | 15.2 / 16.8 | 固定深度更好 |
| 370M,$128\times10^{18}$ | 6 | 20.1 / 18.1 | +2.0 点 |
来源:PDF pp. 9、40。这里的固定深度 baseline 是 $\mu=1$ 的 Parcae,与 Table 5 的标准 Transformer 不同。原文“严格更好的 loss 前沿”不能扩张成“每个预算每个下游任务都更好”;最优点本身也由验证 loss 选择,并非按 Core 调优。
4.4 推理阶段:饱和指数,而非无限幂律(Sec. 5.3)
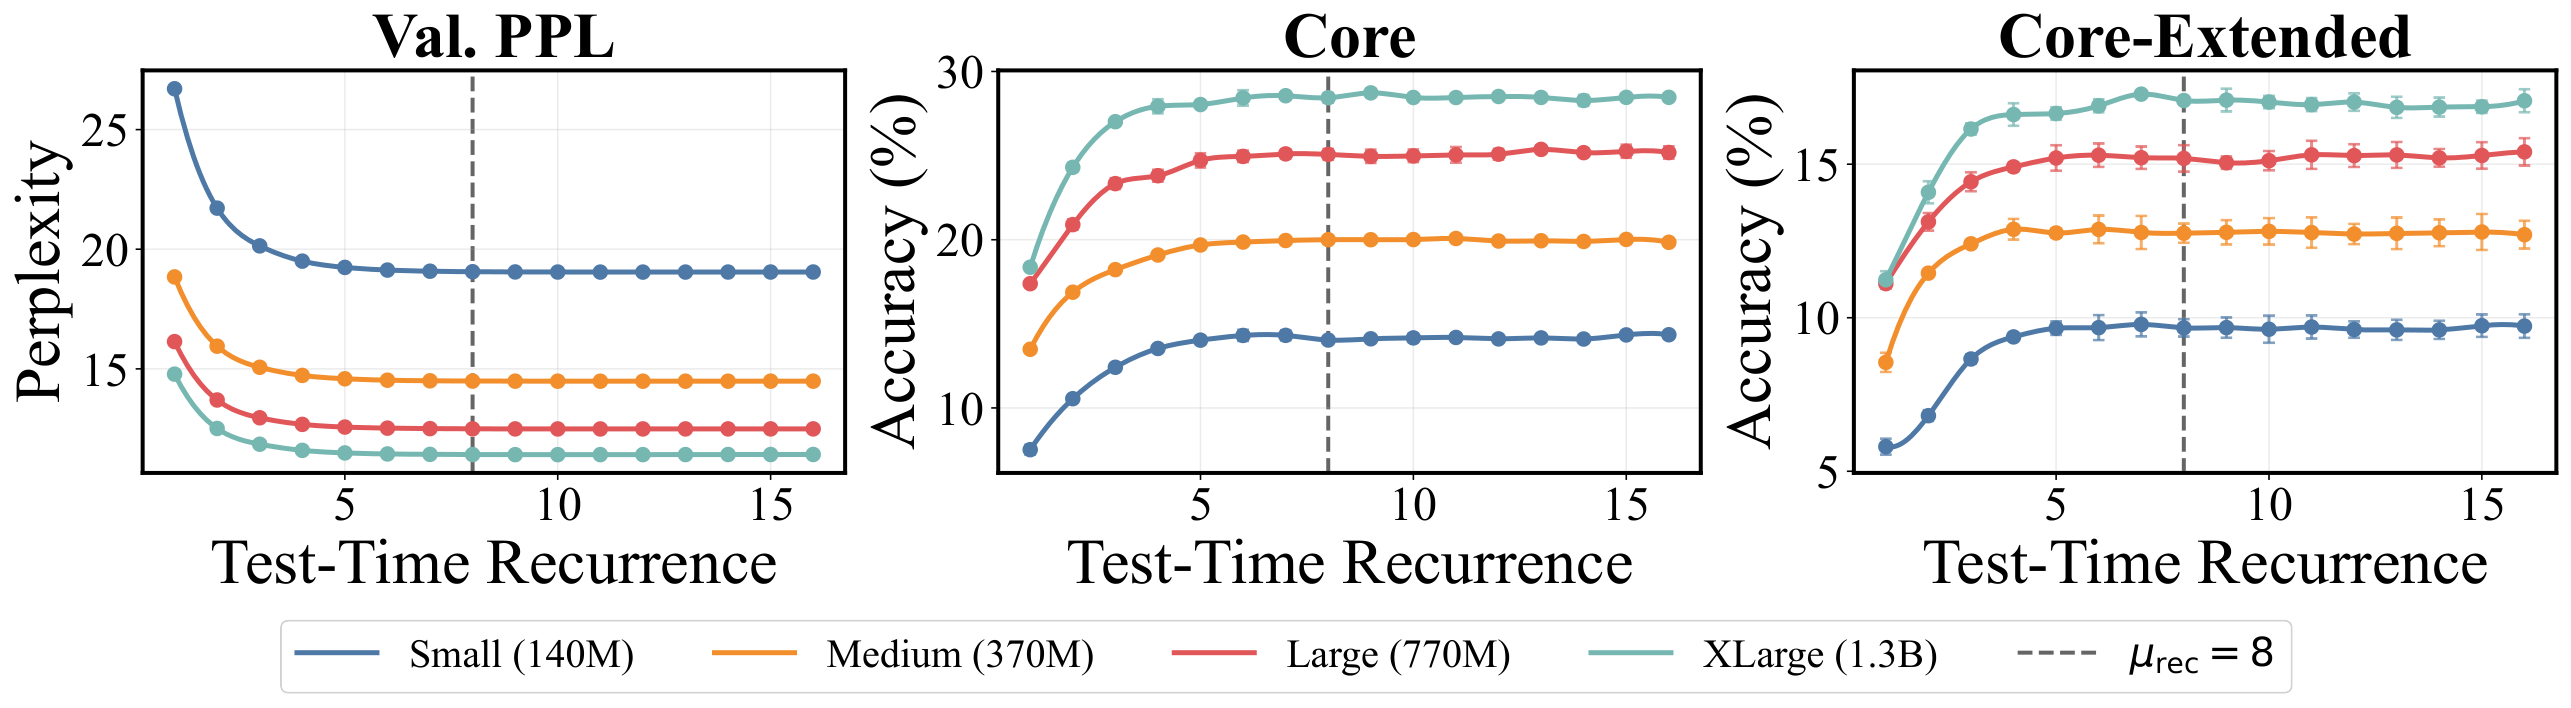
来源:Fig. 7,PDF p. 10。横轴为测试时循环 $T$,三个面板分别是 PPL、Core、Core-Extended;颜色是模型规模,竖虚线为训练平均深度 8。质量改善主要发生在较小 $T$,接近训练深度后趋于平台。图中误差条并不代表多次预训练的波动。
对单个已训练模型,拟合:
$$\mathcal L(T)=\mathcal L_\infty+Z\exp(-zT).$$$\mathcal L_\infty$ 是该训练配置的经验渐近 loss;$Z$ 控制起始差距、$z$ 控制趋近速度。它不是语言任务跨一切模型的不可约熵。
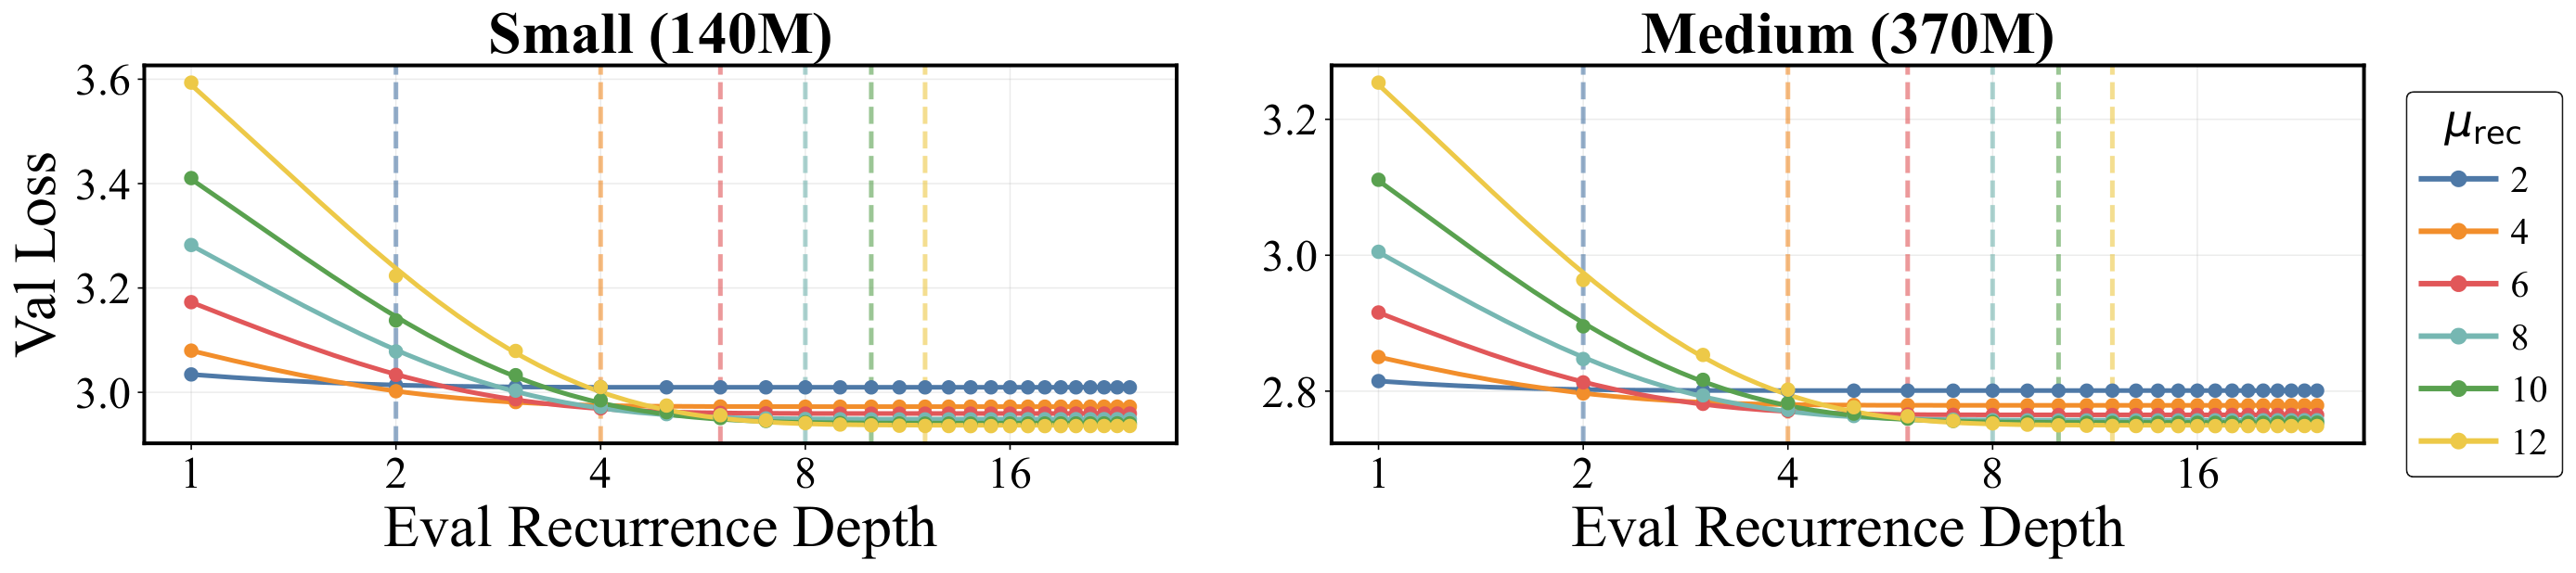
来源:Fig. 8,PDF p. 10。左右是 140M/370M,颜色表示训练 $\mu$,横轴为测试深度(图中为对数间距),纵轴为验证 loss;每个训练深度各有自己的平台。图注标题写了 Power Laws,但正文、拟合曲线和附录明确比较后采用指数衰减。
App. L(Table 12,p. 36)还检验“只用 $T\le\mu$ 拟合,再预测 $T>\mu$”:
| 模型 | 指数+平台 | shifted power+平台 | power+平台 | 无平台 power |
|---|---|---|---|---|
| 140M 外推 | 3.18 | 21.41 | 43.99 | 397.90 |
| 370M 外推 | 2.29 | 18.51 | 38.68 | 369.83 |
单位为平均 Huber loss $\times10^{-7}$,越低越好。指数形式在这些候选和观测范围中最佳,不构成数学上的唯一性证明。作者把状态收敛与 loss 指数衰减联系起来时,明确称其为推测;稳定线性状态的指数收敛并不自动等同于交叉熵的指数收敛。
4.5 统一训练与推理的经验规律
来源:Eq. (4),PDF p. 11;App. L 的 Eq. (8),p. 37。$T/\mu$ 衡量测试深度相对训练深度的比例。作者还比较了可学习 $\mu^{-\gamma}$:拟合 $\gamma$ 为 1.19/1.17,但在留出模型上与固定 $\gamma=1$ 差别很小,故选择更简单形式。
拟合平台与 $T=\mu$ 的经验 loss 的平均相对差为 0.16%/0.05%,支持近似替代,不是严格相等。代入统一公式后,$T=\mu$ 处仍有 $Ze^{-z}$,不能说公式在该点恒等恢复训练律。[Table 13,p. 36]
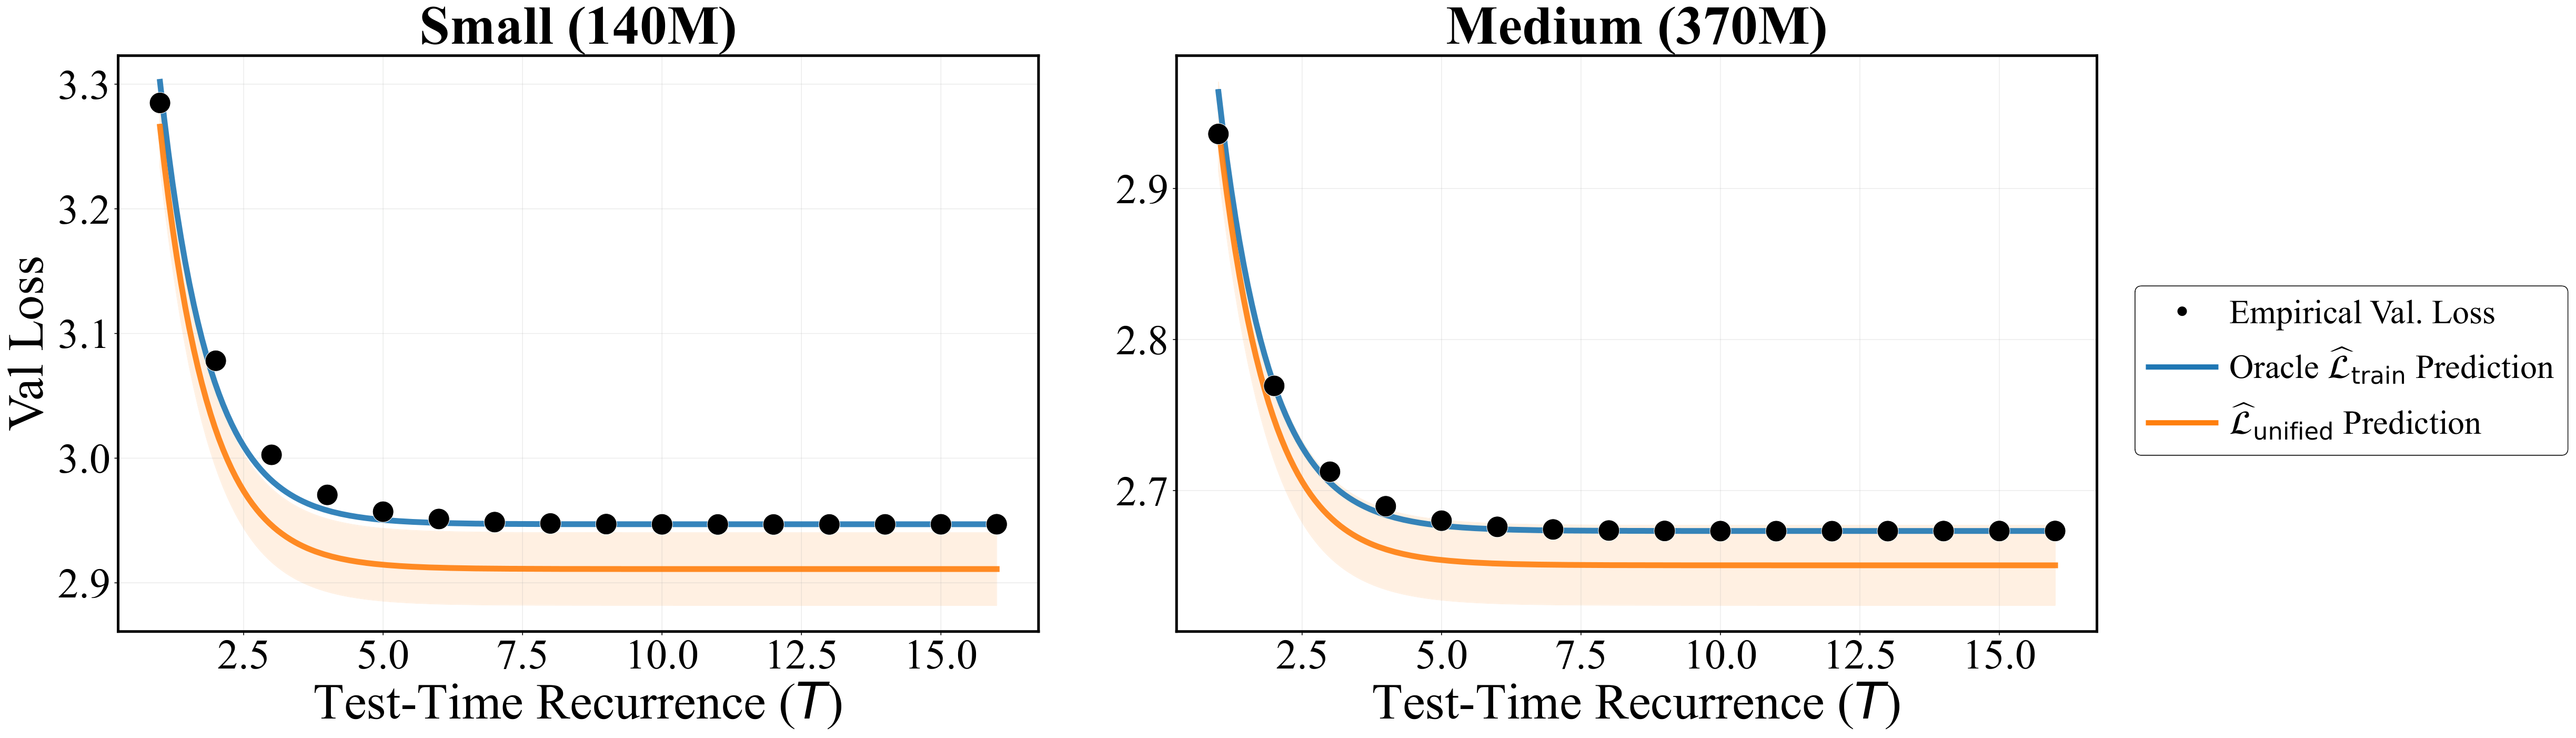
来源:Fig. 26,PDF p. 38。横轴 $T$,纵轴 loss;黑色散点是真实验证结果,橙色为统一预测,蓝色把训练律下限替换为实测值。完整预测平均误差 0.85–1.31%;使用实测下限后是 0.10–0.17%。后一数字使用了额外目标模型测量信息,是诊断性 oracle,不能当完全无测量的预测精度。误差下降表明训练下限的外推是主要误差来源之一。
五:结论、适用范围与阅读时应保留的疑问
5.1 可以带走的结论
Parcae 展示了一个可行配方:约束循环状态传递、归一化输入、改善深度采样,能使循环模型在作者测试规模中更稳定,并改善参数利用率。循环还可作为固定权重预算下的一个训练计算分配方向;在较大预算区域,应同时增加循环与数据。部署时增加循环可以改善浅层结果,但逐渐触及由训练配置决定的平台。
对实际模型设计而言,本次分析认为最值得借鉴的是“训练分布应覆盖部署的深度范围”与“前向深度增长需要匹配足够的反传深度”。这两点比单独记住某个幂律指数更有可迁移性,但跨架构效果仍须重新验证。
5.2 不能据此认定的事情
- 不能认定完整非线性网络具有全局稳定性保证;线性代理没有覆盖完整更新。
- 不能认定循环在所有预算都比更多数据好;Table 6 给出多项反例。
- 不能认定参数效率等于吞吐、延迟或端到端内存效率。主表没有给出完整的部署延迟、KV cache 与激活内存对比。
- 不能把 140M/370M 的经验缩放律直接当大模型规律;质量实验最多到 1.3B,联合参数、数据、循环三轴的计算最优性尚未解决。
- 不能认定更多测试时循环自动产生更强泛化推理。主要证据来自预训练语言建模和聚合任务,未验证无限深度、任意任务或复杂代理工作流。
5.3 原文一致性与复现注意事项
以下是阅读原文时发现的具体问题,不影响表格的直接读取,但会影响复现或二次引用:
- 相对改善口径: 摘要称验证 PPL 最多降 6.3%,Table 3 的两位小数计算约 6.23%,正文写 6.2%。Table 5 的四档验证 PPL 降幅约 11.27%、8.23%、4.51%、4.44%,与正文所述 4.3–9.2% 不一致;本笔记保留原始数值。
- 稳定性术语和步长: Sec. 2.2 混用谱范数与谱半径;Sec. 4.1 的 $\Delta$ 未说明正值约束。稳定性声明必须保留对应条件。
- RDM 学习率: App. Q.1(pp. 42–43)先写 100M/350M 为 $4\times10^{-3}/2\times10^{-3}$,随后说搜索最优是 $4\times10^{-4}/2\times10^{-4}$,相差十倍。本文无法确认实际运行值。
- 反传长度消融: App. I,Fig. 15 caption 说固定 $\mu_{bwd}=8$,正文与 Table 9 caption 写 4;这里只采用“反传长度与前向深度相互影响”的定性结论,不擅自裁定图的实际配置。
- 拟合配置计数: App. O 报告 36/18 个 isoFLOP 模型、每个评估十个深度,按其列出的配置应对应 360/180 点,却又写每个规模约 540 点;还称联合拟合 8 个参数,而最终 $\gamma=1$ 公式显式只有 $E,X,x,Y,y,Z,z$ 七个。可能与总点数或可学习 $\gamma$ 版本混用有关,但原文不足以确认。
- 算法记号: App. E 的 Algorithm 1 在更新右侧写当前 $h_t$,正文 Eq. (3) 是以上一状态显式更新;Algorithm 2 对短于反传窗口的样本需要“等待优先”的有效步掩码。复现应按正文语义明确实现,不照搬伪代码的歧义。
5.4 可继续讨论的问题
- 对非线性块增加 Jacobian 或 Lipschitz 控制,能否在不损害表达能力的情况下给出更强稳定性条件?
- 在固定部署延迟而非固定权重规模时,循环相对增加宽度/深度是否仍然有效?
- 联合优化 $N,D,\mu_{rec},\mu_{bwd}$ 后,本文的经验前沿会如何移动?
- 是否能用蒸馏或自适应早停,以更少推理循环接近深层训练模型的平台?
材料与交付
- 英文组会幻灯片 PDF;可编辑 Beamer TeX;构建脚本(本地核验附件)。
- 图件均来自同版本作者源码,无生成式实验图;图件来源表 记录原图号与页码。
- 本文数值与证据全部来自上述 v1 PDF/TeX;教学推导、反例和研究建议已明确标记。未运行作者训练代码,未独立复现训练曲线。