LangFlow:连续扩散如何追近离散扩散语言模型
论文:LangFlow: Continuous Diffusion Rivals Discrete in Language Modeling
作者:Yuxin Chen、Chumeng Liang、Hangke Sui、Ruihan Guo、Chaoran Cheng、Jiaxuan You、Ge Liu(UIUC)
版本:arXiv:2604.11748v3,2026-04-15 修订;本次获取与研读日期:2026-10-14。
链接:arXiv · 原文 PDF · 作者项目 · 英文汇报 PDF · 可编辑 TeX
论文总览
LangFlow 要解决的问题是:保留连续嵌入空间的生成轨迹,同时把语言建模质量提升到强离散扩散模型附近。 它将 token 嵌入加上高斯噪声,让 Transformer 输出每个位置的词表概率,用交叉熵训练;再把预测概率映射回嵌入期望,构造连续流的去噪方向。这样,训练目标仍然直接对应“猜对哪个词”,生成过程却能在连续空间中逐步移动。
论文的贡献串成三层:先用 Bregman 散度解释交叉熵为何能学到流匹配所需的后验均值;再为有限噪声区间上的 ODE 模型推导负对数似然上界;最后用信息变化驱动的 Gumbel 噪声调度和自条件(self-conditioning,SC)改善训练及采样。后两项设计尤其决定实测表现,不能只把 LangFlow 理解为“把 MSE 换成 CE”。
约 130M 参数、训练 1M 步时,主表报告 LM1B 的 PPL 上界为 30.0,优于 MDLM 的 31.0;OpenWebText(OWT)为 24.6,仍高于 MDLM 的 23.2。OWT 的生成困惑度为 36.5,接近 AR 的 35.9,并低于表中扩散基线。题名中的 rivals 更适合理解为:连续扩散在这组规模与协议下进入了强离散扩散的竞争区间。域内 PPL 最好的模型仍是 AR。(Sec. 5,PDF pp. 9–10,Table 2)
结构地图
以下页码均为从 1 开始的 PDF 页码,与本文印刷页码一致。
| 原文章节 | 在论证中的作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 连续语言扩散的表示、目标和评价瓶颈 | pp. 1–3 |
| 2 Preliminaries | 仿射高斯路径、边缘速度场与去噪器 | p. 3,Eqs. (1)–(6) |
| 3.1 Training Flow Matching on Language | logNSR 路径、Bregman 后验匹配、CE 与嵌入期望 | pp. 4–5,Eqs. (7)–(19) |
| 3.2 ODE Sampling and the Bound for Negative Log Likelihood | ODE 生成和似然下界 | pp. 5–6,Fig. 1、Theorem 3.1 |
| 4.1 Noise Scheduler | 信息均匀原则与 Gumbel 调度 | pp. 7–8,Fig. 2、Eq. (21) |
| 4.2 Self-Conditioning | 连续与离散扩散中的不同收益 | pp. 8–9,Table 1 |
| 5 Experiments | 域内建模与零样本语料迁移 | pp. 9–10,Tables 2–3 |
| 6 Additional Related Work;7 Conclusion | 方法定位与低样本熵问题 | pp. 10–11 |
| A LangFlow | 训练、采样算法和变分解释 | pp. 15–16,Algorithms 1–2 |
| B Proofs | ODE 似然界推导 | pp. 16–17,Eqs. (30)–(43) |
| C Experimental Details | 架构、训练、Plaid、嵌入几何及评价 | pp. 17–19,Table 4、Fig. 3 |
| D Additional Experiments | SC 动态、采样步数、熵和生成实例 | pp. 20–30,Fig. 4、Tables 5–7 |
一:动机——连续语言扩散卡在哪里
离散扩散直接在 token 状态之间跳转,masked diffusion 的典型过程是逐步恢复被遮蔽的位置。连续扩散则可以把一段文本表示为一组向量,从高斯噪声逐步恢复这些向量。作者希望保留后者的连续轨迹,以便将来使用轨迹编辑、ODE 求解和蒸馏等工具。
这里有两种连续表示。若在词表大小的 one-hot 或概率单纯形空间中扩散,每个位置面对的是高维且稀疏的目标;若使用维数较小、可学习的词嵌入,连续状态的维度更紧凑。LangFlow 选择后者,但仍输出完整的词表概率,因此它压缩的是扩散状态,并没有消除词表输出层的计算。
嵌入空间也引入了新的困难。直接回归嵌入可能通过改变嵌入几何来降低误差;照搬图像噪声调度会把大量步骤放在已经容易识别 token 的区域;采用 ODE 采样后,还需要与该连续模型对应的似然评价方法。论文分别从训练目标、时间分配和评价公式解决这些问题。(Secs. 1、3,PDF pp. 1–6)
二:方法——从离散监督构造连续生成轨迹
2.1 输入、输出与状态
| 符号 | 含义与维度 |
|---|---|
| $\mathbf{x}=(x^{(1)},\ldots,x^{(L)})$ | 长度为 $L$ 的 token 序列 |
| $V,D$ | 词表大小、嵌入维度;LangFlow 的 $D=768$ |
| $\mathbf{E}\in\mathbb{R}^{V\times D}$ | 可学习嵌入矩阵,第 $k$ 行为 $\mathbf e_k^\top$ |
| $\mathbf z\in\mathbb{R}^{L\times D}$ | 干净序列嵌入,第 $i$ 行对应 $\mathbf e_{x^{(i)}}$ |
| $\gamma=\log(\sigma^2/\alpha^2)$ | 对数噪声信号比(logNSR),越大越嘈杂 |
| $\hat{\mathbf x}_\theta\in\mathbb{R}^{L\times V}$ | 每个位置对干净 token 的预测概率 |
| $\hat{\mathbf z}_\theta\in\mathbb{R}^{L\times D}$ | 将概率加权嵌入后得到的去噪预测 |
| $a,b$ | 有限噪声区间的干净端与噪声端,$a |
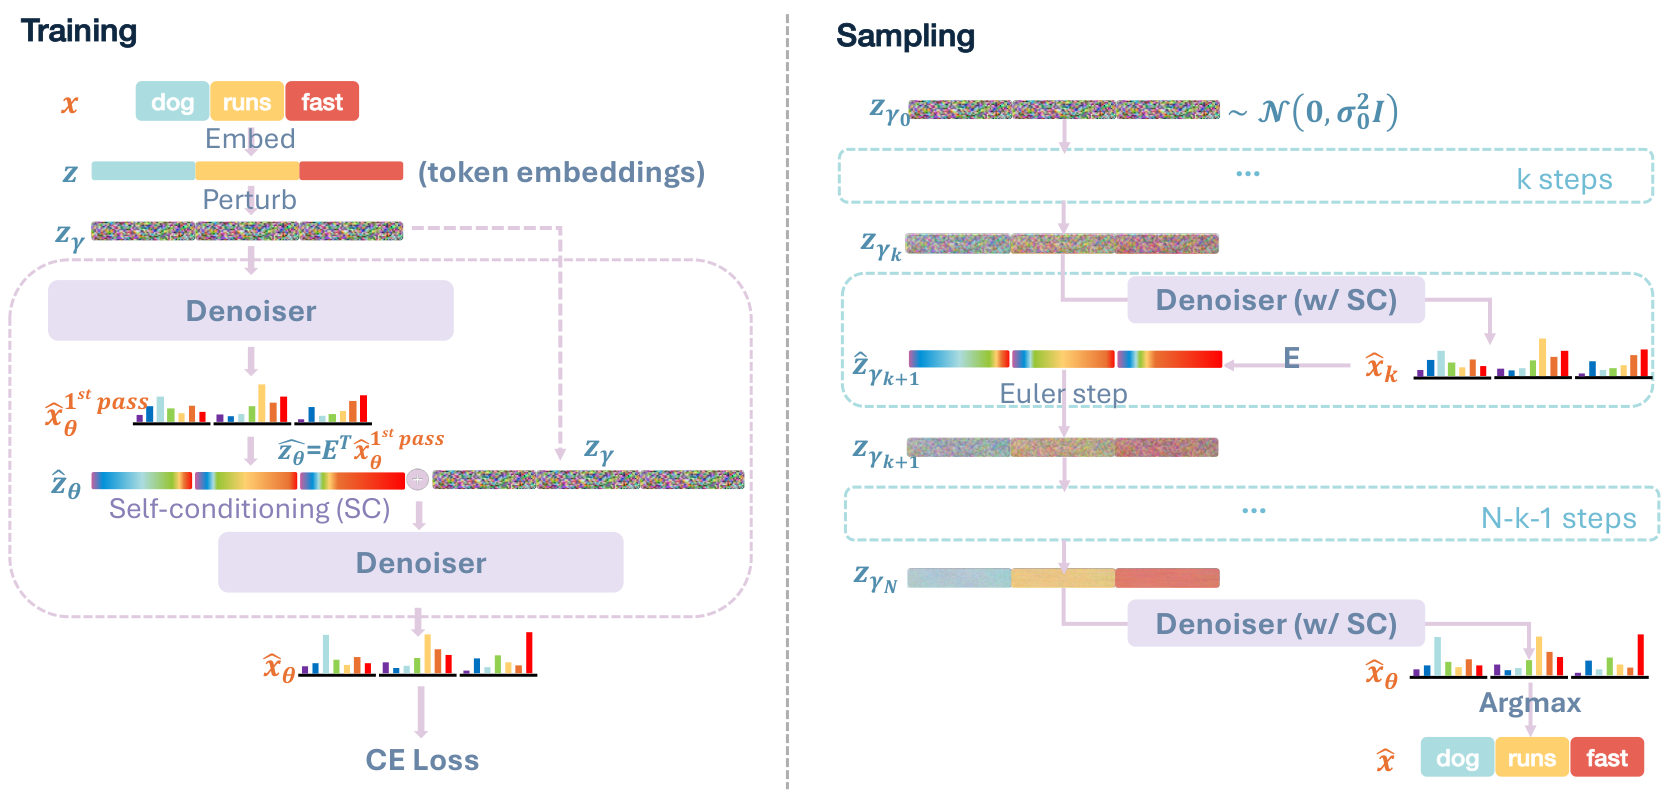
来源:Fig. 1,PDF p. 6,作者原始图件。左侧从真实 token 出发,加噪后预测概率并计算 CE;可选的第一遍预测用于 SC。右侧从高斯噪声出发,用预测嵌入逐步更新整段状态,最后才用 argmax 产生 token。
2.2 用噪声水平而非任意时间编号作为条件
论文采用方差保持(variance-preserving,VP)路径:
当 $\gamma\to+\infty$ 时趋近纯噪声;当 $\gamma\to-\infty$ 时趋近干净嵌入。因此生成沿着 $\gamma$ 下降的方向进行。网络直接接收 $\gamma$,使相同信噪条件具有一致的含义,也把原先集中在很小时间区间里的困难区域展开。(Sec. 3.1,PDF p. 4,Eqs. (7)–(8))
更换时间坐标本身不会增加模型的信息;真正改变训练资源分配的是后文的采样分布 $\pi(\gamma)$。如果只是对同一积分换元,需要保留 Jacobian;主动改变 $\pi$ 则会改变有限容量模型的损失权重。
2.3 交叉熵为什么足以学习连续流
给定当前嵌入和噪声状态,令 $\mathbf p=\mathbf1_{x^{(i)}}$ 为真实 token 的 one-hot 向量,$\mathbf q$ 为模型预测。Bregman 散度定义为:
对随机目标取条件期望,可以把训练误差分成一个后验匹配项和一个与预测 $\mathbf q$ 无关的项:
所以后验概率向量 $\mathbb E[\mathbf1_{x^{(i)}}\mid\mathbf z_\gamma]$ 是最优预测;对 CE 对应的严格凸函数,预测的最优分布被唯一确定。这里的论证针对给定数据表示时的后验匹配,并不意味着联合学习嵌入时所有附加项都与嵌入参数无关。(Sec. 3.1,PDF pp. 4–5,Eqs. (9)–(15))
取 $f(\mathbf p)=\sum_k p_k\log p_k$,散度变成 KL;one-hot 目标下只剩下正确 token 的负对数概率:
连续去噪器则由概率的嵌入期望构造:
关键桥梁:如果 token 后验正确,这个加权和就是 $\mathbb E[\mathbf z^{(i)}\mid\mathbf z_\gamma]$;仿射高斯路径的条件速度对干净嵌入是线性的,因此这个条件均值足以恢复边缘速度场。它说明 CE 与所需的流估计具有一致的理想目标,而非声称 CE 数值等于速度 MSE 或最终生成模型的精确 NLL。(Sec. 2,PDF p. 3,Eq. (6);Sec. 3.1,PDF p. 5,Eqs. (17)–(19))
教学例子:若一个位置对三个候选 token 的概率为 $(0.6,0.3,0.1)$,当前目标是 $0.6\mathbf e_1+0.3\mathbf e_2+0.1\mathbf e_3$。保留这种软目标,可以让后续步骤继续修正;立即取 argmax 会提前丢失另两个候选的信息。
附录 A.3 还把相同目标写为分解式变分后验 $q_\theta(\mathbf x\mid\mathbf z_\gamma)=\prod_iq_\theta^{(i)}(x^{(i)}\mid\mathbf z_\gamma)$ 的负对数似然。各位置都能观察整段噪声序列;这种输出因子分解不等于假设自然语言各位置相互独立。(PDF p. 16,Eqs. (24)–(29))
2.4 ODE 如何真正生成文本
去噪器与速度场的关系是:
这里的点表示对 $\gamma$ 求导。令 $\alpha_k=\alpha_{\gamma_k}$、$\sigma_k=\sigma_{\gamma_k}$,把每个小区间内的去噪预测视为常量,得到:
这是对 $\mathbf z/\sigma$ 关于 $\alpha/\sigma$ 的一阶积分;它不是简单地对原坐标写一个固定步长的 $\mathbf z+\Delta\gamma\,\mathbf v$。初始化 $\mathbf z_0\sim\mathcal N(0,\sigma_b^2\mathbf I)$,从 $b$ 积分到 $a$,最后额外前向一次并逐位置 argmax。(Appendix A.1–A.2,PDF pp. 15–16,Algorithm 2、Eq. (22))
ODE 给出的是有限端点之间的连续确定性传输。最终 token 解码是多对一映射,因此不能把连续轨迹的可逆性直接套到离散文本上。作者提出未来可借此做少步蒸馏;本篇实验没有进行蒸馏。
2.5 ODE 似然界:评价的到底是什么
需要区分两件事:生成样本时最后取 argmax;似然推导则使用概率解码器
因此定理针对的是“ODE 连续隐变量分布 + 概率解码器”定义的文本模型,不能直接视作最终确定性 argmax 样本分布的精确似然。
从真实序列构造 $\mathbf z_a\sim\mathcal N(\alpha_a\mathbf z,\sigma_a^2\mathbf I)$,沿与生成相反的方向从 $a$ 积分到 $b$。Theorem 3.1 给出:
范数对整段 $L\times D$ 状态展开计算。右边包含四项:维度常数、映射至噪声端后的高斯能量、干净端的 token 重建概率,以及沿轨迹的体积变化。散度是去噪器关于当前连续状态的 Jacobian 迹。(Sec. 3.2,PDF p. 6,Eq. (20))
证明可以抓住三个步骤:
- 以 $\mathbf z_a$ 为隐变量,对高斯编码分布使用 Jensen 不等式,得到重建项、隐变量密度项和编码器熵。
- 用连续变量变换公式 $\frac{d}{d\gamma}\log p_\gamma(\mathbf z_\gamma)=-\nabla\cdot\mathbf v_\theta$,将 $p_a$ 换成可计算的噪声端高斯密度。
- 展开 $\nabla\cdot\mathbf v_\theta=LD\,\dot\sigma/\sigma-(\alpha/2)\nabla\cdot\hat{\mathbf z}_\theta$;其中积分出的 $\log\sigma$ 项与高斯熵中的尺度项抵消,留下上式。
这解释了为什么最后是对数似然下界、NLL 上界、进而 PPL 上界。PPL 需先按 token 归一化 NLL,再取指数。不同扩散方法的上界松紧可能不同,因此表中的 PPL 上界不是精确似然排行榜。(Appendix B.1,PDF pp. 16–17)
实际评价使用 128 步 Heun-2 积分,以及 Hutchinson 迹估计;采样用的一阶求解器与这里的评价求解器不同。理论上界对应理想积分和期望,有限步数与随机迹估计会带来数值误差。(Appendix C.4,PDF p. 19)
还有一个实现层面的衔接需留意:定理将去噪器写作当前状态与 $\gamma$ 的函数,而 Algorithm 2 的 SC 另带上一轮预测。原文没有展开这一历史输入在似然计算中的状态定义、反向轨迹和散度求导处理。若复现带 SC 的 PPL,应明确这些细节;这一问题不同于上面的连续流公式推导本身。
2.6 信息均匀调度:把步骤放到信息发生变化的位置
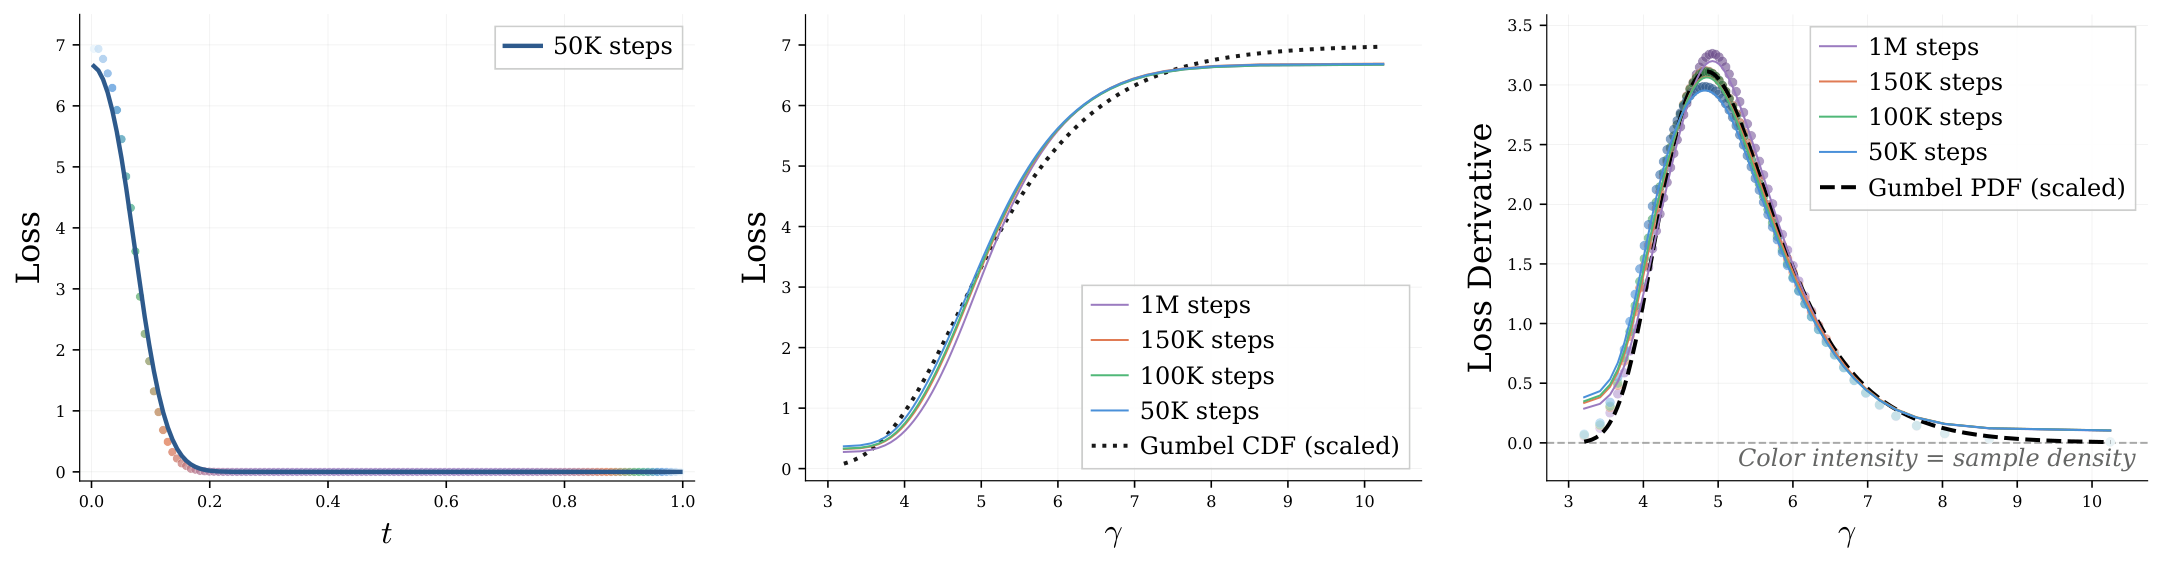
来源:Fig. 2,PDF p. 8;由作者的三个原始面板并排组合,未改变数据。左图横轴为 OT 时间 $t$、纵轴为 CE;中图横轴为 $\gamma$、纵轴为不同训练检查点的损失;右图展示损失对 $\gamma$ 的导数,虚线是拟合的 Gumbel 密度。
左图显示,在作者的时间约定下,$t>0.2$ 的大部分区域已经几乎没有去噪损失。有限个分离的 token 嵌入可以在尚有噪声时就被辨认出来,所以均匀地分配时间步会过多访问容易的区域。中图显示,不同训练阶段的 CE 曲线接近;作者据此把损失当作后验熵的近似:
熵分解是恒等式;“KL 已很小、损失主要反映不可约后验熵”是作者基于训练曲线采用的近似。曲线接近本身并不单独测出 KL 的大小。
生成沿 $\gamma$ 下降,信息增加对应熵下降。若希望每个采样区间带来接近的熵变化,应让区间密度满足
这与按损失大小分配预算有区别:最嘈杂区域可能损失很高,但如果曲线已经饱和,导数很小,继续密集布点收益有限。LangFlow 关注“从不知道转向知道”的过渡区。
作者发现经验导数右偏,使用 Gumbel 的累积分布函数拟合熵:
训练从对应 Gumbel 分布采样 $\gamma$;调度器通过
学习 $H_{+\infty},P_\mu,P_\beta$。采样得到的 $\gamma$ 也停止梯度,让主模型的 CE 和调度器拟合各自更新,避免模型通过移动噪声水平来直接降低当前 CE。(Sec. 4.1,PDF pp. 7–8;Algorithm 1,PDF p. 15)
由反函数得到采样节点:
于是每一段具有相近的 Gumbel 概率质量,在熵拟合成立时也有相近的信息变化量。$a,b$ 对应 $10^{-5}$ 和 $1-10^{-5}$ 分位点。信息均匀是设计原则,Gumbel 是经验拟合选择;论文没有证明它对所有文本分布和模型容量都最优。
原文 Fig. 2 图注将 OT 时间写为 $t=\operatorname{sigmoid}(\gamma/2)$,与 Sec. 3.1 中“$t$ 增大时噪声减小”的方向相反。按从噪声到数据的线性 OT 路径 $\alpha=t,\sigma=1-t$,可推得 $t=\operatorname{sigmoid}(-\gamma/2)$。这里统一使用正文和 Algorithm 2 的方向:大 $\gamma$ 为噪声,生成时递减。
2.7 自条件如何在训练和采样中进入模型
训练时,以 $p_{\rm SC}=0.25$ 的概率先在相同噪声输入上前向一次,把概率变成嵌入预测,停止梯度后作为第二遍的辅助输入;其余情况辅助输入为零。采样时始终启用 SC,第一步为零,之后沿用上一步的嵌入预测。辅助输入提供了模型自己的候选解释,供下一次计算修正。(Sec. 4.2,PDF p. 8;Algorithm 1,PDF p. 15)
在 DiT 前,输入更新为:
两个投影零初始化。此外,嵌入归一化到半径 $\sqrt D$ 的球面,使其尺度与单位高斯噪声匹配。logits 还加入一个已知高斯似然偏置,对每个候选 token $k$ 为
系数 $r$ 在前 5000 步从 0 升至 1。这个偏置把单位置上已知的高斯去噪信息直接交给输出层;Transformer 仍可利用上下文修正候选概率。(Appendix C.1,PDF pp. 17–18,Eq. (44))
三:实验——比较协议决定数字的含义
3.1 数据、模型与训练
| 配置 | LM1B | OWT |
|---|---|---|
| 序列长度 | 128 | 1024 |
| tokenizer | bert-base-uncased | gpt2-large |
| 训练步数 / batch size | 1M / 512 | 1M / 512 |
| 主表生成步数 | 128 | 1024 |
| Gen. PPL 评价样本数 | 1024 | 1024 |
| LangFlow 训练硬件 | 4 张 NVIDIA RTX 6000 | 32 张 NVIDIA A100 |
共同设置为约 130M 参数的 DiT 风格 Transformer、RoPE、hidden size 768、12 heads;Sec. 5 和 Appendix C.1 均写 12 层。优化器 AdamW,学习率 $3\times10^{-4}$,2500 步学习率 warmup,之后保持常数;EMA decay 0.9999,bfloat16。(Sec. 5,PDF p. 9;Appendix C.1–C.2,PDF pp. 17–18)
层数存在原文冲突:Table 4(PDF p. 18)写的是 16 / 768,而同页 C.1 和正文写 12 层。本文按正文叙述介绍模型,但若重建配置,应对照作者实现确定层数。
3.2 三种指标分别回答什么
| 指标 | 测量对象 | 如何解读 |
|---|---|---|
| 验证集 PPL | 模型为真实语料分配的概率 | 越低越好;扩散模型报告上界,AR 报告其似然对应 PPL |
| Gen. PPL | GPT-2 Large 为模型生成文本打分 | 越低表示参考模型认为更自然;不是生成器自身的 PPL |
| 样本熵 | 每段生成序列的经验 token 频率分布 | 描述词频多样性;不是模型分布熵,也不应单独最大化 |
样本熵先对每条序列的 token 计数归一化,再计算 $-\sum_v f_v\log f_v$。它会同时受到重复、主题词集中、序列长度和 tokenizer 的影响;适合在相同协议下与数据参照值比较。(Sec. 5,PDF p. 9;Appendix C.4,PDF p. 19)
3.3 baseline 的比较角色
AR 是标准从左到右建模的参照。MDLM 与 SEDD Absorb 代表强 masked/absorbing-state 扩散;UDLM、Duo、SEDD Uniform 代表 uniform-state 离散扩散;Plaid、Diffusion-LM、并行工作的 FLM 提供连续模型比较。
LM1B 中 AR、SEDD、MDLM、UDLM、Duo 和 Plaid 由作者重新训练;OWT 部分基线来自 Duo 代码库提供的 checkpoint,另一些结果来自文献。Plaid 保留原架构:108M 参数、嵌入维度 16,不能当作和 LangFlow 完全相同架构下的单因素消融。FLM 的 LM1B Gen. PPL 使用 1024 步,而其他主要比较行使用 128 步。零样本表中的 Plaid 和 D3PM Absorb 使用了 1.3M 训练步。(Sec. 5,PDF pp. 9–10;Tables 3–4)
四:结果——哪些证据支持哪些结论
4.1 调度和自条件:最关键的内部改进
Sec. 4.1 报告,改善噪声调度后 Gen. PPL 从约 1000 降至 154.2。这个结果体现调度的重要性,但正文没有提供与主表同样完整的独立比较表,适合视为设计分析中的粗粒度增益。(PDF p. 8)
Table 1 的 LM1B 消融更直接:
| 模型 / 设置 | Gen. PPL ↓ | PPL ↓ |
|---|---|---|
| MDLM,无 SC | 103.9 | 31.0 |
| MDLM,有 SC | 94.9 | 32.7 |
| LangFlow,无 SC | 154.2 | 49.0 |
| LangFlow,有 SC | 81.5 | 30.0 |
来源:Sec. 4.2,PDF p. 8,Table 1。对 LangFlow,SC 同时降低两种困惑度,PPL 绝对降低 19.0,约为 38.8%;MDLM 的生成困惑度变好,但验证集 PPL 反而变差。这个结果说明,离散扩散评价中关闭 SC 的习惯不适合直接搬到连续模型。
这里的 81.5 与主表 Table 2 的 92.2 不同;Table 5 的 128 步结果为 92.24,与主表一致。原文没有交代两个 Gen. PPL 的协议差异。因此保留 81.5 作为该消融表的数值,使用 92.2 进行主模型跨方法比较。
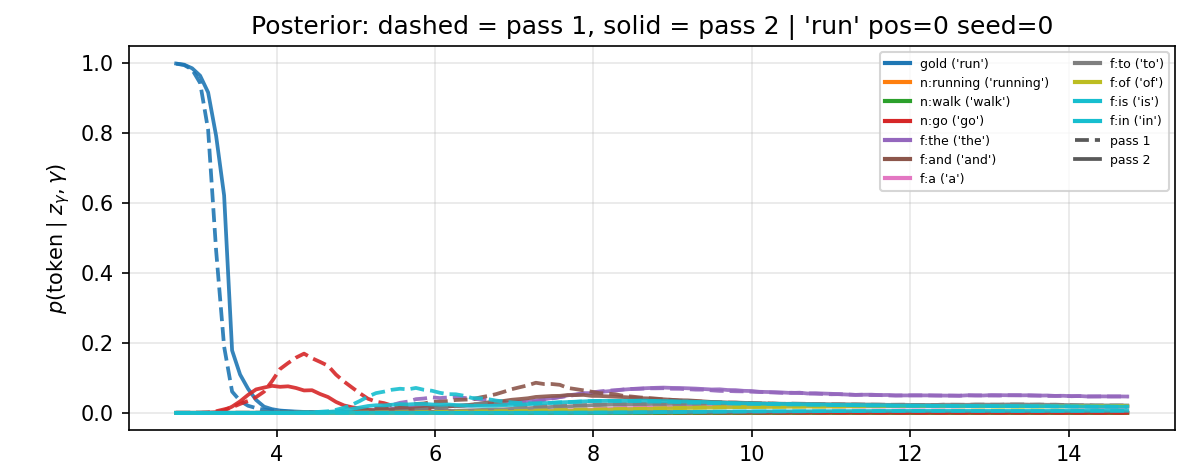
来源:Fig. 4,PDF p. 20。横轴 $\gamma$ 越往右越嘈杂,纵轴是候选 token 概率;虚线为无 SC 的第一遍,实线为带 SC 的第二遍。真实 token 为 run:随噪声增加,概率由正确词向相关词,再向常见功能词转移。作者据此解释 SC 可能抑制向高频但语义较弱的候选漂移。这是一个位置的动态示例,机制解释的主要定量支撑仍是 Table 1。
4.2 域内语言建模:LM1B 领先,OWT 接近
| 模型 | LM1B PPL ↓ | LM1B Gen. PPL ↓ | OWT PPL ↓ | OWT Gen. PPL ↓ |
|---|---|---|---|---|
| AR Transformer | 22.8 | 66.7 | 17.5 | 35.9 |
| MDLM | 31.0 | 103.9 | 23.2 | 104.9 |
| SEDD Absorb | 32.0 | 115.9 | 24.1 | — |
| Plaid | 32.4 | 77.3 | — | — |
| UDLM | 33.8 | 99.8 | 27.4 | — |
| Duo | 33.6 | 97.6 | 25.2 | 77.6 |
| FLM | — | 96.9* | — | 62.2 |
| LangFlow | 30.0 | 92.2 | 24.6 | 36.5 |
来源:Sec. 5,PDF p. 9,Table 2,选取关键行;所有扩散 PPL 为上界。*FLM 在 LM1B 使用 1024 采样步,其余这些扩散行使用 128 步;OWT 使用 1024 步。
LM1B 上,LangFlow 的 PPL 比 MDLM 低 1.0,约改善 3.2%,是表中扩散模型最佳;Gen. PPL 在扩散模型中仅次于 Plaid。OWT 上,LangFlow 的 PPL 排在 MDLM、SEDD Absorb 之后,差距分别为 1.4、0.5;其 Gen. PPL 则低于表中所有扩散模型,与 AR 仅差 0.6。
由此可以支持“连续扩散已具备竞争力”,但不能把 OWT 的 Gen. PPL 接近 AR 改写为“域内概率建模达到 AR”:后者的 PPL 是 17.5,仍明显低于 24.6。两种指标各自测量的对象不同。
4.3 零样本迁移:四项胜过 AR 指的是语料 PPL
所有模型先在 OWT 训练,再直接评价其他语料的困惑度;这里的 Lambada 也报告 PPL,并非末词预测准确率。
| 目标语料 | AR | MDLM | LangFlow | LangFlow 的比较结果 |
|---|---|---|---|---|
| PTB | 82.05 | 95.26 | 81.20 | 优于二者 |
| Wikitext | 25.75 | 32.83 | 32.28 | 优于 MDLM |
| LM1B | 51.25 | 67.01 | 68.21 | 不及二者 |
| Lambada | 51.28 | 47.52 | 46.93 | 优于二者 |
| AG News | 52.09 | 61.15 | 69.41 | 不及二者 |
| Pubmed | 49.01 | 41.89 | 46.74 | 优于 AR |
| Arxiv | 41.73 | 37.37 | 38.47 | 优于 AR |
来源:Sec. 5,PDF p. 10,Table 3;越低越好,扩散数值为上界。LangFlow 胜过 AR 的四项是 PTB、Lambada、Pubmed、Arxiv;胜过 MDLM 的三项是 PTB、Wikitext、Lambada。改善分布并不均匀,例如 AG News 仍明显落后。
4.4 CE 与 MSE:嵌入几何提供什么解释
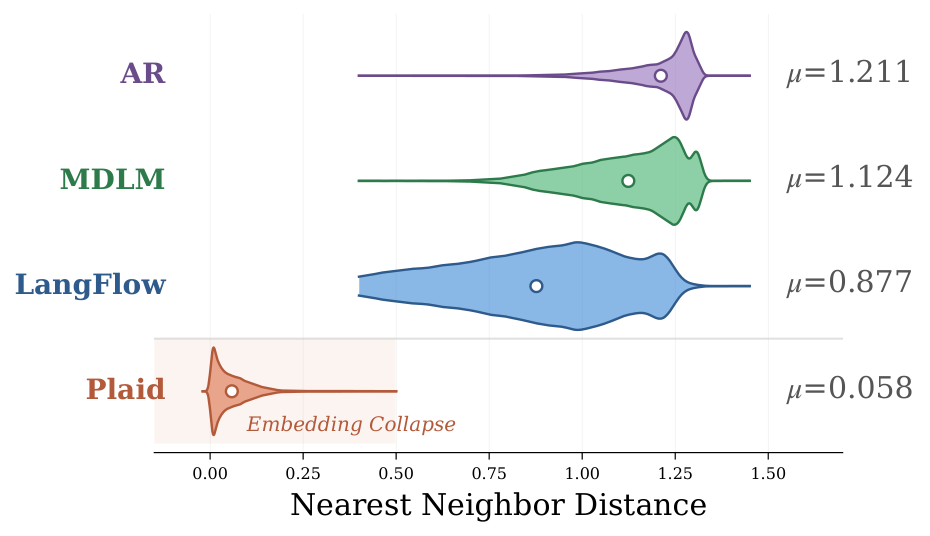
来源:Fig. 3,PDF p. 19。横轴为将嵌入归一化到单位球面后的最近邻球面距离;每一行是一种模型的分布。图中均值分别为 AR 1.211、MDLM 1.124、LangFlow 0.877、Plaid 0.058。Plaid 的 token 向量之间更接近。
作者认为,MSE 联合更新嵌入时存在一种降低误差的捷径:不仅改好 token 概率,也让预测混合向量和目标嵌入互相靠近,收缩 token 间的距离。一个便于理解的局部推导是,暂时固定预测概率 $q$,令 $\mathbf r=\mathbf E^\top q-\mathbf e_x$,则
这个式子只展示经过嵌入加权和与目标的直接梯度路径,并不包含 $q$ 对嵌入的间接依赖。CE 直接监督正确 token 的概率,避免把“缩短向量距离”本身当作主要任务目标。(Appendix C.3,PDF pp. 18–19,Eqs. (45)–(46))
Fig. 3 是跨模型观察:Plaid 的嵌入维度为 16,其余为 768,架构也有区别。因此它支持作者对表示收缩的担忧,但没有单独隔离 MSE 的因果作用;“换 CE 必然避免所有嵌入退化”超出了这些证据。
4.5 减少采样步数:质量仍随预算显著变化
LM1B 上,同一个 LangFlow checkpoint 未经蒸馏,减少步骤的结果如下:
| 论文标注 NFE | Gen. PPL ↓ | 样本熵 |
|---|---|---|
| 128 | 92.24 | 4.31 |
| 64 | 104.83 | 4.32 |
| 32 | 127.32 | 4.33 |
| 16 | 179.60 | 4.35 |
来源:Appendix D.2,PDF p. 20,Table 5;数据熵 4.32。步数从 128 降到 16 后,Gen. PPL 约为原来的 1.95 倍,词频熵却变化不大。
OWT 上与两种关键基线的比较为:
| 论文标注 NFE | LangFlow Gen. PPL ↓ | LangFlow 熵 | Duo Gen. PPL ↓ | MDLM Gen. PPL ↓ |
|---|---|---|---|---|
| 1024 | 36.53 | 5.25 | 77.69 | 104.85 |
| 512 | 41.52 | 5.31 | 78.14 | 104.43 |
| 256 | 49.24 | 5.37 | 78.62 | 112.70 |
| 128 | 60.09 | 5.43 | 80.02 | 120.77 |
| 64 | 80.34 | 5.51 | 85.62 | 143.88 |
来源:Appendix D.2,PDF p. 21,Table 6,节选;数据熵参照值 5.44,离散基线来自 Duo 文献。LangFlow 在这些预算下都优于所列离散比较模型,但降到 64 步后与 Duo 的差距明显缩小。在 128 步时,其熵 5.43 接近数据参照值,Gen. PPL 仍优于表内离散基线。
原文将这些预算标为 NFE,但 Algorithm 2 在 $N$ 次积分前向后还增加一次最终解码前向。因此这里保留论文的预算标签;计算严格网络调用数时应核实末次前向是否计入。论文没有给出相应的端到端延迟对比,步数也不能直接换算成相对 AR 的速度提升。
4.6 样本熵与实例:生成自然度还需看局部内容
OWT 的 1024 步 LangFlow 样本熵为 5.25,低于数据参照 5.44,也低于 Table 6 中的离散基线。作者认为一部分差距来自跨句分布的主题词反复出现:Table 7 中,展示的 LangFlow 样本里 health 出现 11 次,样本熵为 5.3375;MDLM 实例中 Mitchell 出现 13 次,熵为 5.2111。这张表描述所选实例,不是对 1024 条样本重复率的总体统计。(PDF p. 21,Table 7)
附录展示的 LangFlow OWT 样本能形成局部主题,但仍有造词、语法错误、语义矛盾和话题跳转;其他模型的展示样本也存在缺陷。部分跨段跳转还与 packed 文本设定有关。因此这些例子更适合说明“单个词频熵无法完整描述文本质量”,而不足以单独确认低熵完全不影响语义连贯性。(Appendix D.3,PDF pp. 21–30;OWT 的 LangFlow 实例始于 p. 26)
五:结论——这篇论文最值得带走什么
第一,离散监督与连续生成可以清楚衔接。 每个位置的 token 后验一旦学好,其嵌入期望就给出流所需的去噪均值。这个桥梁让模型能够用熟悉的 CE 训练,同时保留连续状态的演化。
第二,噪声预算应与任务的信息几何匹配。 对有限 token 嵌入,容易恢复的区域可能很大;按后验熵变化集中分配步骤,比照搬均匀时间调度更有针对性。Gumbel 的意义在于贴合本文观察到的曲线,而不是一种脱离数据的普遍最优分布。
第三,自条件及其评价协议足以改变连续扩散的排名。 Table 1 的改进很大,表明应把它视为方法的一部分。相应地,带 SC 的历史状态如何进入 ODE 似然计算,是复现时需要仔细对齐的环节。
在约 130M 参数、LM1B/OWT 和有限长度的实验范围内,LangFlow 提供了连续扩散具备强竞争力的证据。进一步工作的重点是:将当前质量保持到更大模型与更长上下文;把确定性轨迹的蒸馏潜力转化为实际少步质量和延迟收益;在改善 Gen. PPL 的同时更直接地测量连贯性、重复和多样性。原文报告的低样本熵及部分配置冲突,也应在这些后续比较中得到澄清。