LightMem:用小语言模型管理智能体记忆
论文题名:Lightweight LLM Agent Memory with Small Language Models
作者:Jiaquan Zhang、Chaoning Zhang、Shuxu Chen、Zhenzhen Huang、Pengcheng Zheng、Zhicheng Wang、Ping Guo、Fan Mo、Sung-Ho Bae、Jie Zou、Jiwei Wei、Yang Yang。
版本:arXiv:2604.07798v3,2026-04-22 修订;arXiv 页面注明 ACL 2026 main 接收。
研读与获取日期:2026-09-27;本次成品 r1。
原始材料:arXiv 页面 · 本地 PDF · 作者主 TeX · 源码清单。
配套成品:英文幻灯片 PDF · 可编辑 TeX。
本次以同版本作者 main.tex 为结构依据,结合全部正文和实质性附录、16 页最终 PDF 核验公式、图表和定位。源码仅有一个正文 TeX 入口,无需跟随其他章节文件;未执行作者源码。注释掉的表格、未引用图件不作为正式实验结果。以下页码均为从 1 开始的 PDF 文件页码,不使用推测的印刷页码。相关论文仅按本文说明定位,不代表另行精读了参考文献。
论文总览
LightMem 研究的问题是:如何在长对话中保留有用记忆,同时控制每次查询的模型调用与上下文成本? 作者把高频操作拆成小模型可完成的查询规划、候选筛选和摘要写入,把跨轮知识抽象与图结构维护交给异步运行的大模型。
最有证据支持的贡献,是一个组合式系统设计:短期上下文、用户私有的中期情景记忆、共享的去标识化长期语义知识各司其职;在线先粗检索约 $2K$ 条候选,再由小模型选出不超过 $K$ 条。它同时改进检索输入、筛选过程和记忆写入,并非只把原来的大模型换小。
表 2 中,LightMem 在六个模型分组、五类问题的全部 30 个 F1 单元格上均高于 A-MEM。对这些差值等权平均,本次复算为 +2.454 个 F1 分数点,与摘要的“约 +2.5”相符;这不是相对提升 2.5%,也不是按测试样本数加权的总体 F1。GPT-4o-mini 分组的有效上下文从 2,520 降到 1,150 tokens。表 4 报告检索 P50 为 83 ms、端到端 P50 为 581 ms,但后者包括远端 GPT-4o-mini API,因此不能理解成全部由本地 1B 模型完成的推理时间。[表 2,PDF p.6;表 4,PDF p.8]
结构地图
| 原文章节 | 阅读作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 效率与记忆质量的矛盾、设计主张 | pp.1–2,图 1 |
| 2 Related Work / 2.1 LLM Memory Systems | 检索式记忆与模型驱动记忆操作 | pp.2–3 |
| 3.1–3.2 Problem Setup / Memory Stores | 输入输出、STM/MTM/LTM 的边界 | p.3 |
| 3.3 Intent Modeling and Retrieval Control | HQ 查询与元数据约束 | p.3,式 (1) |
| 3.4 Two-Stage Retrieval | 固定候选量、语义选择 | pp.3–4,式 (2)–(5);图 2 在 p.4 |
| 3.5–3.6 Memory Writing / Offline Consolidation | 容量控制、增量知识整合 | pp.4–5,式 (6) |
| 4.1 Experimental Setup | 数据、模型、指标、部署 | p.5,表 1 |
| 4.2 Performance | LoCoMo 与 DialSim 主结果 | pp.6–7,表 2–3 |
| 4.3 Ablation Study | 各模块的增量作用 | p.7;图 3 在 p.8 |
| 4.4 Scalability and Latency | 检索与端到端时间口径 | pp.7–8,表 4 |
| 4.5 Performance Stability under MTM Growth | 同一轨迹中的容量增长 | p.8,表 5 |
| 4.6 Error Injection Stress Test | 查询、筛选、写入错误 | pp.8–9,表 6 |
| 4.7 Update Gap Stress Test | 离线更新间隙的跨记忆推理 | p.9,表 7 |
| 5–7 Conclusion / Limitations / Acknowledgements | 结论、作者自述局限与致谢 | p.9 |
| References | 引用来源 | pp.9–11 |
| 8.1 Complete Algorithm and Process Specifications | 数据结构、三条算法、解耦主张 | pp.11–12,算法 1–3 |
| 9.1–9.2 Statistical Significance / Failure Analysis | 显著性与意图分解失败 | pp.12–13,表 8 |
| 10 Full Prompt Templates and Control Interface Definitions | 四类模型的职责与输出约束 | pp.13–14 |
| 11 LTM Graph Schema and Maintenance Dynamics | 图类型、更新成本 | pp.14–16,表 9–10 在 p.16 |
| 12 Declaration of AI Use | 作者披露 AI 用于润色 | p.15 |
一:动机
长对话超出上下文窗口后,直接重放全部历史会消耗大量 tokens;把历史压缩进外部记忆又带来另一个问题:向量相近的条目未必回答当前问题。例如“项目时间”可能召回一般计划建议,而用户真正要的是上次确定的截止日期。
作者区分两条路线:检索式系统在线成本较低,却依赖查询质量和候选过滤;反复调用大模型做规划、写入和检索控制的系统更灵活,却会累积时延。LightMem 的假设是,许多高频决策属于输入输出受限的局部任务,小模型可以胜任,而跨交互抽象适合稍后集中处理。[Sec.1–2,PDF pp.1–3]
这里的创新主要是任务分工、检索预算和记忆生命周期的共同设计。论文没有提出新的语言模型架构,也没有证明仅靠增加记忆层数就必然获得这些收益。
二:方法
2.1 三种记忆保存不同性质的信息
| 层 | 保存内容与访问方式 | 所属范围与限制 |
|---|---|---|
| 短期记忆(STM) | 当前会话最近若干轮,直接放在上下文 $C_t$ 中 | 不持久化,也不作为外部检索库 |
| 中期记忆(MTM) | 压缩的交互摘要、时间信息、访问统计、向量与用户标识 | 个性化情景记忆的唯一载体;按用户隔离,容量有上限 |
| 长期记忆(LTM) | 离线抽象出的稳定事实、领域规律和共享语义关系 | 全局共享、去标识化;不应保存原始个人情景或用户标识 |
因此,“长期”不等于“更久以前的个人聊天记录”。个人经历仍属于 MTM;LTM 改变了知识的抽象层级。明确的依据是 Sec.3.2 与附录 8.1.1,不能把引言中泛称“每个记忆单元带用户标识”的句子套用到所有 LTM 节点。[PDF pp.2–3、11]
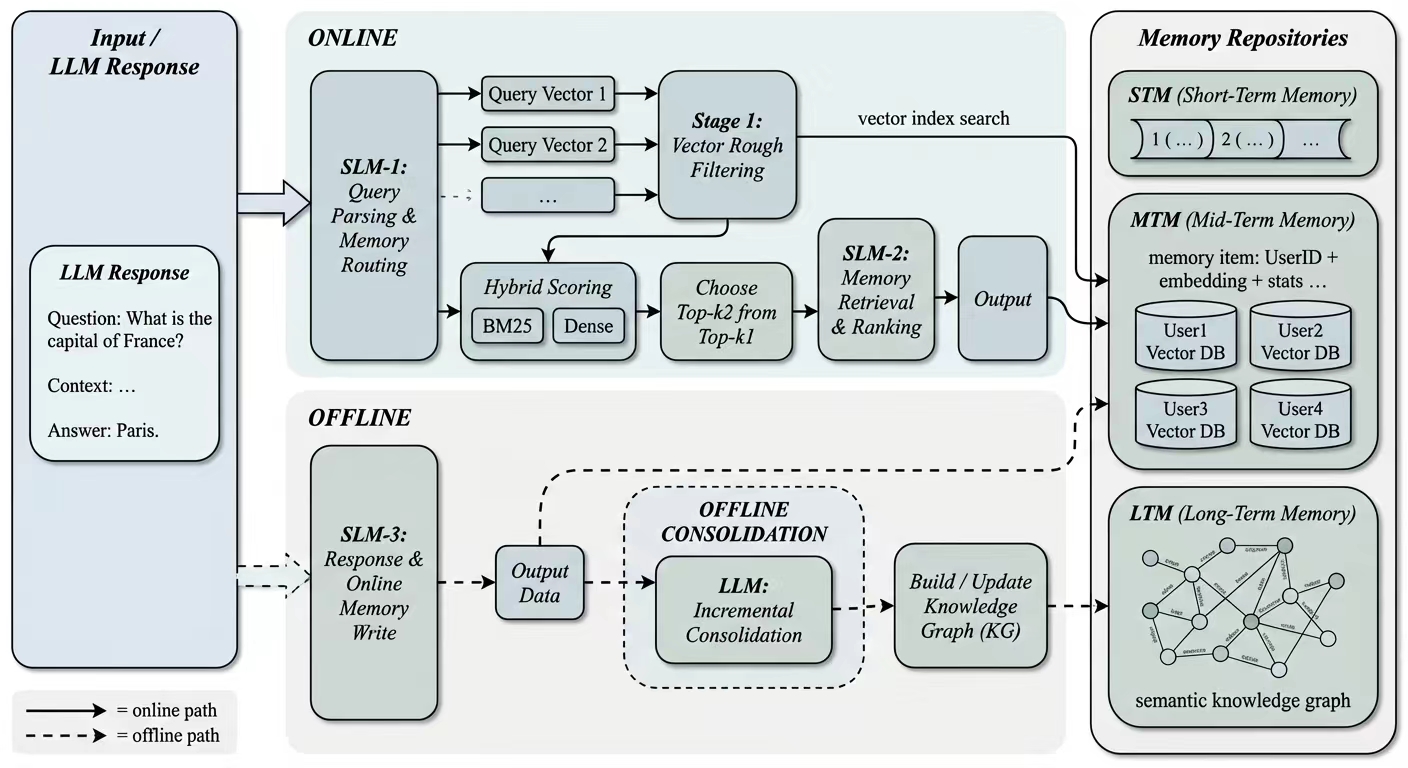
图源:作者图 2,PDF p.4,原图未改动。阅读顺序是左侧输入、上方在线查询和筛选、右侧记忆库,以及下方知识整合。图文有细节差异:图中出现 BM25/Dense 混合评分,并把 SLM-3 放在标为 OFFLINE 的区域;正文与算法 2 则把 SLM-3 称为在线写入模块,检索说明以向量粗检索为主。下文依照正文及算法解释,不将图中标签补写为已充分说明的实现。
2.2 输入、输出与符号
| 符号 | 含义 |
|---|---|
| $u,t$ | 用户与交互轮次 |
| $x_t,y_t$ | 当前用户输入、最终生成回答 |
| $C_t$ | 截断后的近期上下文;注意与候选集合 $C$ 不同 |
| $M_u^{\mathrm{MTM}},M^{\mathrm{LTM}}$ | 用户私有 MTM、全局 LTM |
| $q_t^{(i)},n$ | 第 $i$ 个假设查询(Hypothetical Query, HQ)及查询数 |
| $\phi_t$ | 元数据约束:用户、时间窗口、类型等 |
| $K,B$ | 最终返回条目上限、每用户 MTM 条目容量上限;均不是 token 数 |
| $C^{(i)},C,R_t$ | 单个 HQ 的候选、合并候选、最终记忆集合 |
输入 $(x_t,C_t)$ 经查询规划和检索得到 $R_t$;回答模型读取当前输入、近期上下文及所选记忆产生 $y_t$,之后才写入本轮记忆。三个 SLM 是三种功能模块,不能仅凭命名推断它们是三套独立预训练模型。[Sec.3.1;附录 8.1,PDF pp.3、11–12]
2.3 SLM-1:把含糊问题变成可执行检索计划
控制器先识别个性化程度、近期或长期信息需求,以及省略的实体和时间,再生成一个或多个 HQ,附上目标记忆层和元数据约束。式 (1) 将请求写为:
例如论文表 1 的“推荐晚餐地点”,可分成去 MTM 找个人饮食偏好、去 LTM 找一般餐馆知识。这个例子展示路由职责,并不证明 LTM 具有实时餐馆信息。SLM-1 只规划,不直接检索或回答,附录要求输出 JSON。[Sec.3.3、表 1、Sec.10.1,PDF pp.3、5、13]
2.4 两阶段检索:先保证覆盖,再抑制噪声
第一阶段在元数据约束下做向量粗检索。正文用均分预算表示各 HQ 的候选数:
之后合并候选:$C=\bigcup_i C^{(i)}$。第二阶段由 SLM-2 根据 HQ 与候选摘要判断语义支持关系,最终满足:
式 (3)–(5) 的作用是约束昂贵的语义选择所见的候选量。这里“压缩”主要指淘汰条目:附录 Sec.10.2 明确禁止 SLM-2 改写记忆、生成新内容或扩展检索,不能误解为它再生成一段摘要。[PDF pp.3–4、13–14]
实现细节有一个需要保留的边界:式 (4) 写成 $|C|=2K$,但不同 HQ 可能取回重复条目,也可能检索不足。算法 1 改用 $\lceil 2K/n\rceil$,合并后超额再截断;它没有规定不足时补齐。因此实际应理解为固定候选预算,而非永远恰好 $2K$ 个不同条目。[算法 1,PDF p.11]
教学例子,非原实验配置:设 $K=5,n=2$,两个 HQ 各取最多 5 条,再对并集做语义选择,返回最多 5 条。若用户只问某次项目决策,把一半候选预算分给一般项目管理知识,会挤占真正相关的个人记录。这解释了为什么查询扩展必须与意图和预算一起设计。
2.5 SLM-3:写入与容量维护
回答完成后,SLM-3 从 $(x_t,y_t,C_t)$ 提取以后可能复用的信息,生成简短、可独立理解的语义摘要。系统将摘要写入对应用户 MTM,合并重复项,利用时间与证据强度处理冲突,并满足:
达到容量限制时,淘汰陈旧或低效用项,并进一步压缩冗余。正文没有给出效用函数、冲突阈值或衰减率的具体实现。算法 2 描述整个维护过程,但 SLM-3 的提示词输入仅列当前交互,并禁止其自行搜索记忆;因此哪些维护步骤由宿主程序完成、旧条目如何提供给模型,仍需实现层补充。[Sec.3.5,式 (6);算法 2;Sec.10.3,PDF pp.4、12、14]
2.6 离线 LLM:从交互证据提炼共享知识
离线巩固(offline consolidation)使用增量批次,处理新写入、被检索再激活,以及容量压力下标记的 MTM 条目。大模型先去除个人与会话特征,形成可复用知识,再在 LTM 找到相近语义锚点,局部插入、连接、合并或更新节点;弱证据知识会衰减、降权或删除。[Sec.3.6;算法 3,PDF pp.4–5、12]
图结构包含 Entity、Concept 两类节点,以及 IsA、HasProperty、RelatedTo、Implies 四类边。作者希望它支持关联访问和多跳推理,但没有完整说明查询时的图遍历深度、扩展预算或路径评分。[Sec.11,表 9,PDF pp.15–16]
表 10 报告约每 10–15 轮触发一次更新,平均每 4 轮新增一个节点,每批离线处理约 3.5 秒。这意味着离线工作移出了当前回答的等待链路,总计算成本并未消失。按所报间隔粗略摊销约为每轮 0.23–0.35 秒后台处理量;这是本次算术估计,不是在线延迟或论文报告的计费成本。
2.7 训练、推理与复杂度要分开看
SLM-1 的 HQ 依靠结构化提示,SLM-2 则明确用 2,000 条构造的 (Query, Subgraph, Path) 样本进行 LoRA 微调。论文未报告 SLM-1/SLM-3 另行训练的具体流程,也未给出 LoRA 超参数、数据构造及划分细节。不能把整个系统称为完全无需训练。[Sec.4.1.4,PDF p.5]
附录 8.1.6 声称在线检索成本受 $O(K)$ 约束。更稳妥的解读是:固定了后续选择阶段的候选条目数。向量索引查询仍取决于索引与库大小,小模型成本还依赖条目长度、HQ 数及上下文长度,后台更新可能竞争硬件资源。论文没有给出覆盖全部这些因素的复杂度证明或大规模并发测量。[PDF p.12;本次分析]
三:实验
3.1 数据、对照和指标分别检验什么
LoCoMo 检验长对话问答,按单跳、多跳、时间推理、开放域和对抗五类报告;本文称平均对话约 9K tokens。DialSim 来自电视剧的长期多方对话,本文称有 1,300 个会话。前者有利于观察不同问题类型,后者补充长期交互中的回答语义一致性。[Sec.4.1.1,PDF p.5]
| Baseline | 在本文比较中的角色 |
|---|---|
| LoCoMo baseline | 直接使用长对话上下文;与同名数据集区分 |
| ReadAgent | 压缩为 gist 后按需找回内容 |
| MemoryBank | 保存、更新并检索摘要式记忆 |
| MemGPT | 在上下文与外部存储之间管理记忆;本文实现使用的有效上下文较长 |
| A-MEM | 通过模型生成笔记与关联来组织记忆,是主要记忆系统对照 |
F1、BLEU-1 关注与参考回答的词元重合;ROUGE-L 衡量序列重合,ROUGE-2 关注二元组;METEOR 纳入较灵活的匹配;SBERT 用句向量衡量语义相似。它们均为越高越好,但不是同一种量纲。表中 SBERT 23.40 不应说成“准确率 23.40%”。词面指标可能惩罚正确改写;句向量相似也不等于事实证据正确或真实用户满意度。[Sec.4.1.3,表 3,PDF pp.5、7;后两点为指标边界分析]
3.2 能确认的配置及复现缺口
| 项目 | 原文报告 |
|---|---|
| 在线小模型 | 默认量化 Llama-3.2-1B-Instruct,通过 Ollama 部署;另评估 Qwen2.5-1.5B-Instruct |
| 回答生成器 | Sec.4.1.4 与附录 8.1.3 称固定 GPT-4o-mini |
| 表 2 模型分组 | GPT-4o-mini、GPT-4o、Qwen2.5-1.5B/3B、Llama-3.2-1B/3B |
| 嵌入 | all-MiniLM-L6-v2,384 维 |
| 检索预算 | 实现描述为粗检索 top-10;方法定义最终 $K$、粗候选 $2K$ |
| MTM 容量 | 每用户 $B=10^4$ 条目 |
| SLM-2 训练 | 2,000 条构造样本,LoRA 微调 |
| 延迟测量 | 单张 RTX 4090 24 GB;回答涉及远端 GPT-4o-mini |
| 离线模型 | 大上下文 LLM,具体模型名称未报告 |
协议歧义:正文宣称固定回答生成器,同时又将表 2 解释为跨 backbone 泛化,未清楚交代各分组究竟更换哪些组件。这里保留“表中模型分组”的说法,不自行解释为全部只换回答模型或全部只换记忆模型。粗检索 top-10 若严格等于全局 $2K$,可推得 $K=5$,但论文未充分说明所有实验均采用此映射,故不将其写成统一已确认配置。[Sec.4.1.2、4.1.4、4.2、附录 8.1.3,PDF pp.5–7、11]
未报告或不足以复现的信息还有:量化位宽、精确软件版本、上下文截断策略、LoRA rank/学习率/轮数、离线模型与服务资源、检索索引和图访问配置,以及完整的去重/冲突/遗忘参数。附录 10 给出职责与 JSON 输出要求,但没有列出完整 JSON 字段模式。在本次下载的源码包与正文中未发现实现仓库链接;TeX 源码的可获得性不等于系统代码可复现。
四:结果
4.1 主结果:相对 A-MEM 稳定提升,但并非每项全场最佳
下面按表 2 的 GPT-4o-mini 分组摘录 F1,单位是原表分数,越高越好。
| 问题类型 | A-MEM | LightMem | 绝对增量 |
|---|---|---|---|
| Single-hop | 44.65 | 45.81 | +1.16 |
| Multi-hop | 27.02 | 28.85 | +1.83 |
| Temporal | 45.85 | 46.28 | +0.43 |
| Open-domain | 12.14 | 13.52 | +1.38 |
| Adversarial | 50.03 | 54.57 | +4.54 |
同组 BLEU-1 也从 37.06/20.09/36.67/12.00/49.47 提升到 38.24/21.43/37.15/12.96/52.19,表明改善不限于 F1。这里的时序结果 46.28 采用主表数值,与后面的显著性表分开保留。
为了检查“跨模型约 +2.5”的统计口径,下面对每个分组的五类 F1 差值取简单平均,并同时列出有效上下文长度。
| 表中模型分组 | 五类平均 F1 增量(本次复算) | A-MEM tokens | LightMem tokens |
|---|---|---|---|
| GPT-4o-mini | +1.868 | 2,520 | 1,150 |
| GPT-4o | +2.084 | 1,216 | 685 |
| Qwen2.5-1.5B | +2.142 | 1,300 | 728 |
| Qwen2.5-3B | +3.116 | 1,137 | 611 |
| Llama-3.2-1B | +2.792 | 1,376 | 754 |
| Llama-3.2-3B | +2.722 | 1,126 | 642 |
六行再平均得到 +2.454,与作者约数一致。GPT-4o-mini 的上下文相对 A-MEM 减少 54.4%,相对 LoCoMo baseline 的 16,910 tokens 减少 93.2%。这些是模型输入的有效上下文长度变化,不是整个记忆数据库、显存或磁盘存储的压缩率。[表 2,PDF p.6;衍生值为本次计算,原始选定数据见 build/verified-results.json]
更高的平均表现也有明确例外:GPT-4o-mini 对抗类中,LoCoMo baseline 为 69.23,高于 LightMem 的 54.57;GPT-4o 单跳中,LoCoMo baseline 为 61.56,高于 LightMem 的 49.87。因此论文证据支持相对 A-MEM 的一致改进,不能扩大成“所有模型和任务都优于完整历史”。
4.2 DialSim:词面与语义指标方向一致
| 指标(均 ↑) | A-MEM | LightMem | 绝对增量 |
|---|---|---|---|
| F1 | 3.45 | 4.12 | +0.67 |
| BLEU-1 | 3.37 | 3.95 | +0.58 |
| ROUGE-L | 3.54 | 4.20 | +0.66 |
| ROUGE-2 | 3.60 | 4.15 | +0.55 |
| METEOR | 2.05 | 2.48 | +0.43 |
| SBERT | 19.51 | 23.40 | +3.89 |
表 3 使用 GPT-4o-mini,LightMem 在所列方法和六项指标中均最高。SBERT 的相对变化为 +19.9%,F1 相对变化为 +19.4%;这些百分比与上表的绝对增量不可混用。作者解释为更有效利用对话历史,且收益不只是复现参考答案措辞。不过这里没有人工评估、事实支持率或检索 recall 指标来独立检验这一机制。[Sec.4.2,表 3,PDF pp.6–7]
4.3 消融:个性化情景层与语义筛选都有作用
| Llama-3.2-1B 记忆配置 | DialSim F1 | 相对完整系统下降 |
|---|---|---|
| 完整 LightMem | 4.12 | — |
| 去掉语义重排 | 3.83 | 0.29 |
| 去掉 HQ 与路由 | 3.87 | 0.25 |
| 去掉 MTM | 3.75 | 0.37 |
| 去掉离线巩固 | 3.96 | 0.16 |
精确数值取自 Sec.4.3 正文,PDF p.7。去掉图结构时,正文还报告 SBERT 从 23.40 降到 22.82。Qwen2.5-1.5B 面板展示相同方向的变化。结论是这些模块在该组合内有增量作用,其中去掉 MTM 对所报 F1 的影响最大;这不是全因子实验,不能据此证明模块间具有统计意义上的协同。
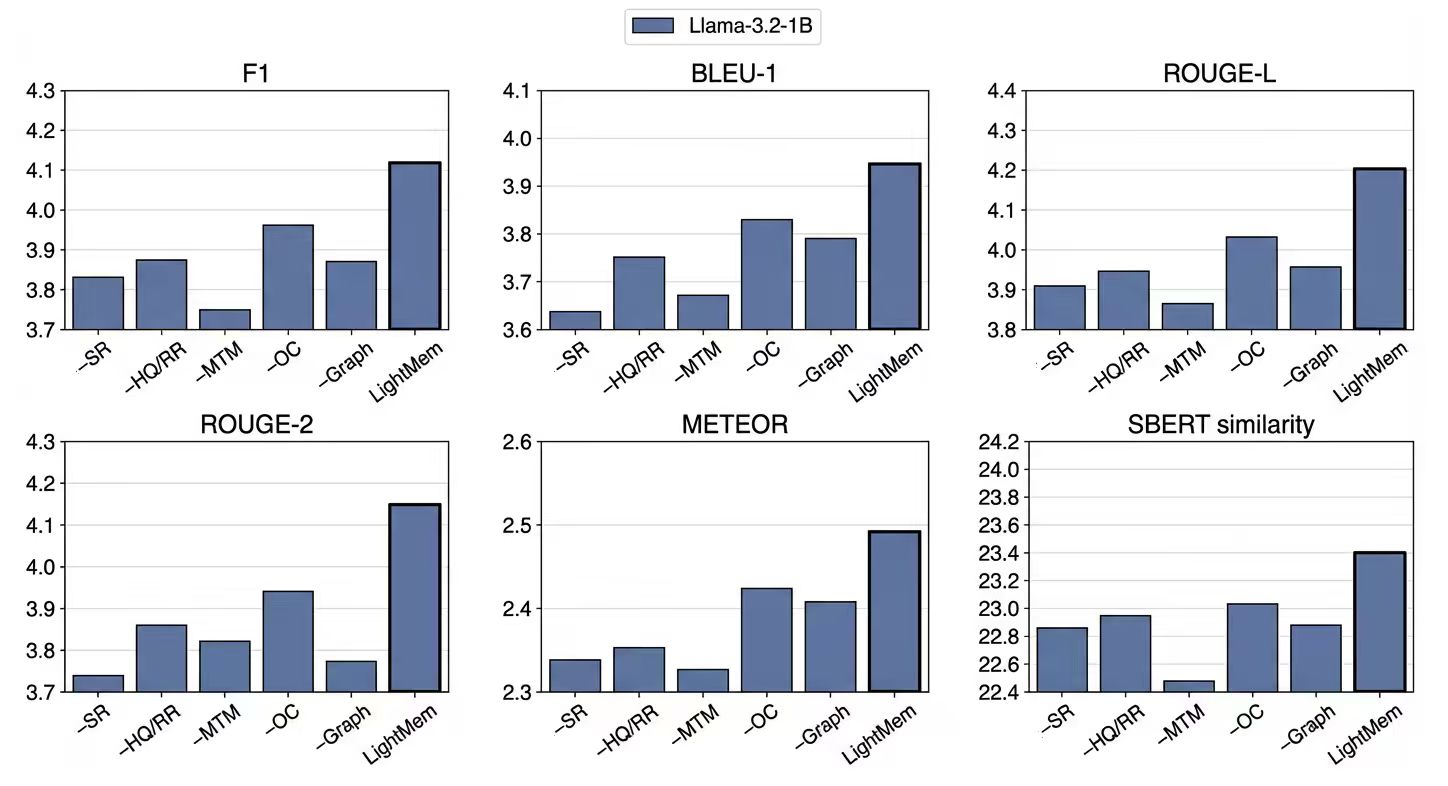
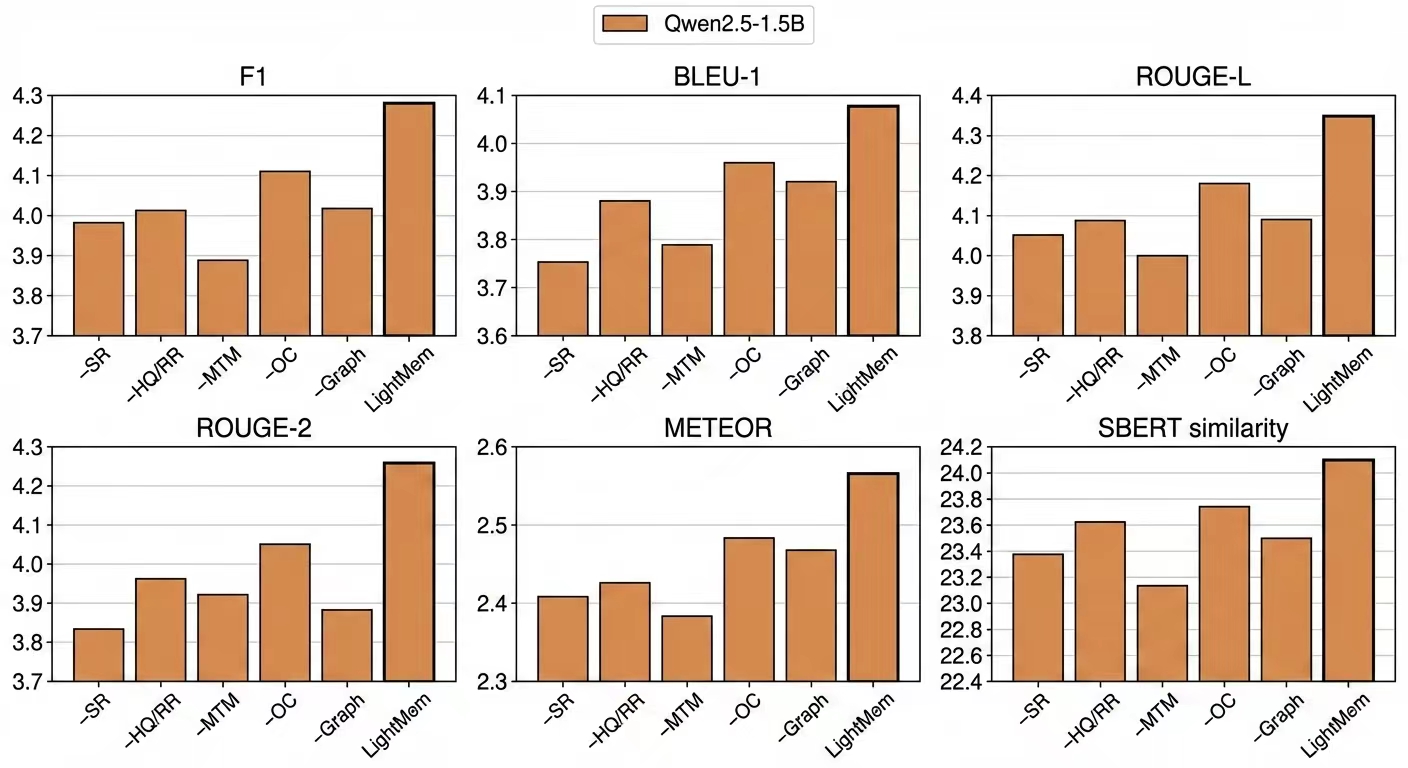
图源:作者图 3(a)(b),PDF p.8。每个面板横轴是去掉不同模块及完整系统,纵轴为标题指定的指标;SR=语义重排,HQ/RR=查询构造与检索路由,OC=离线巩固。纵轴均截断且量程各异,不能直接比较柱长比例。由于图上无逐柱数字标签,本笔记不从柱高臆造精确的小数或引用源码中已注释掉的旧表。
4.4 延迟:明显快于 A-MEM,仍有更快的弱基线
| 方法 | 检索 P50/P95(ms)↓ | 端到端 P50/P95(ms)↓ |
|---|---|---|
| LoCoMo baseline | 0 / 0 | 2,054 / 3,658 |
| ReadAgent | 34 / 97 | 614 / 1,027 |
| MemoryBank | 16 / 51 | 439 / 1,047 |
| MemGPT | 143 / 451 | 2,087 / 3,451 |
| A-MEM | 856 / 1,583 | 914 / 3,682 |
| LightMem | 83 / 167 | 581 / 1,325 |
检索时间从接收问题计到完成检索及构造最终 prompt,包含本地计算,排除远端生成;端到端还包含远端 API 传输、排队、推理和解码。P50 是中位数,P95 是 95 分位数。LoCoMo 的 0 表示没有外部记忆检索,不代表不花生成时间。[Sec.4.4,表 4,PDF pp.7–8]
相对 A-MEM,LightMem 检索 P50 降低 90.3%,端到端 P50 降低 36.4%,端到端 P95 降低 64.0%。但 MemoryBank 的端到端 P50 更低,ReadAgent/MemoryBank 的 P95 也更低。因此卖点是更好的质量与延迟组合,不能称为全部方法中延迟最低。
另外,不能用两个分位数相减来还原某一阶段的典型耗时:例如 $914-856$ 并不等于 A-MEM 的中位生成时间。论文也没有在这组表中拆出写入时间、离线 GPU/API 成本、吞吐量或并发资源竞争,故 581 ms 不能解释成包含全生命周期维护的总成本。
4.5 MTM 增长:趋势支持抗噪,但不是独立容量消融
| MTM 条目数 | 纯向量检索 F1 | LightMem F1 | 差值 |
|---|---|---|---|
| 约 100 | 3.95 | 3.98 | +0.03 |
| 约 1,000 | 3.90 | 4.05 | +0.15 |
| 约 5,000 | 3.86 | 4.09 | +0.23 |
| 10,000 | 3.83 | 4.12 | +0.29 |
这是 DialSim、Llama-3.2-1B 沿同一条完整对话轨迹自然增长时的累计 F1。它支持“记忆越多,语义筛选越有帮助”的解释,但对话阶段、已见证据和题目组成也在变化,不能单独归因于容量增加;也没有测到超过容量上限后的无限扩展能力。[Sec.4.5,表 5,PDF p.8]
4.6 错误注入:单点有韧性,级联会显著退化
| 扰动 | F1 ↑ | SBERT ↑ |
|---|---|---|
| 完整系统 | 4.12 | 23.40 |
| SLM-1:50% 无关 HQ | 3.95 | 23.08 |
| 移除 SLM-2 重排 | 3.83 | 22.56 |
| SLM-3:50% 写入替换为噪声 | 3.78 | 22.45 |
| 三者同时发生 | 1.85 | 11.20 |
固定最终 Top-$K$ 后,查询规划错误、缺少筛选和污染写入均使指标下降。三种错误叠加时,F1 较完整系统下降 2.27 分,相对下降 55.1%。这说明模块化并没有消除错误传播;写错的记忆会继续参与未来检索,长期系统需要关注写入质量。[Sec.4.6,表 6,PDF pp.8–9]
这些是人为构造的强扰动,不代表真实部署的错误率,也不能由它们推断所有自然错误的因果路径。表 6 的无重排 SBERT 为 22.56,应与图 3 消融的图形信息分开引用,不能擅自视作完全相同的一次运行。
4.7 更新间隙:同时读 MTM 与 LTM 有帮助
离线巩固之间,新事实已进入 MTM,却尚未进入 LTM;多跳问题可能需要同时连接新旧证据。LoCoMo 多跳子集、GPT-4o-mini 的结果如下。
| 检索设置 | Multi-hop F1 ↑ |
|---|---|
| 完整系统,正常更新间隙 | 28.85 |
| 只读 LTM | 19.45 |
| 只读 MTM | 20.12 |
| MTM 被大量噪声填充 | 23.10 |
双层检索分别比只读 LTM/MTM 高 9.40/8.73 分,但噪声饱和仍使其下降 5.75 分。作者解释为无关近期记录占用了固定预算,使尚未巩固的最新事实更难被选中。这是合理的机制解释,本文没有提供检索轨迹分析来逐项证明。间隙时长、噪声饱和构造和子集筛选细节也不完整。[Sec.4.7,表 7,PDF p.9]
4.8 显著性与失败案例补充
附录报告三个随机种子,并对评估实例做 1,000 次配对 bootstrap,给出差值的 95% 置信区间和双侧 p 值。
| 类别 | A-MEM F1 | LightMem F1 | 差值与 95% CI | p 值 |
|---|---|---|---|---|
| Multi-hop | 27.02 ± 0.31 | 28.85 ± 0.28 | +1.83;[1.24, 2.41] | 0.001 |
| Temporal | 45.85 ± 0.37 | 46.20 ± 0.34 | +0.35;[0.12, 0.58] | 0.008 |
表 8 的时序均值是 46.20,表 2 是 46.28;前者可能采用另一汇总方式,但作者未解释,本笔记不自行修正。表 8 的 caption 未单独写出 backbone,数值对应表 2 的 GPT-4o-mini 分组;这是本次根据数值作出的对应判断。统计证据支持所列两项差异,不宜推广成所有任务、消融和时延均已验证显著。[Sec.9.1,表 8,PDF p.12]
Sec.9.2 的失败案例是“提醒我之前对项目时间线做了什么决定”。控制器除了查询 MTM 的决策记录,还生成 LTM 的一般计划建议查询。在预算固定时,这会让回答偏离具体回忆,出现多余建议。作者称多数时候关键事实仍正确、语义相似度稳定,但未报告该失败模式的发生率或分项统计。[PDF pp.12–13]
五:结论与讨论
5.1 可以带走的贡献
LightMem 表明,把查询规划、选择与写入做成小模型可处理的有限任务,并把昂贵抽象移到异步路径,在所报长对话基准上能够同时改善 A-MEM 的问答分数和部分延迟指标。三层记忆的价值不只在时间尺度:MTM 保留个人经历,LTM 保存共享抽象,二者通过不同访问规则和更新节奏互补。
尤其值得借鉴的是“固定候选预算 + 语义选择”的接口:粗检索负责覆盖,选择器负责排除虽然相似却不支持当前问题的条目。与此同时,SLM-1 的路由本身会决定什么证据有机会进入候选集,SLM-2 无法找回第一阶段完全漏掉的事实。这是整个流水线的关键依赖。[基于 Sec.3 与消融的本次分析]
5.2 局限及需要保留的证据边界
作者在 Sec.6 只明确承认:替代巩固策略与控制策略尚未充分探索。结合全文,本次研读还识别出以下边界:
- 模型分工仍有协议歧义。 多 backbone 分组与固定 GPT-4o-mini 生成器的描述需要对齐,才适合复现“跨模型泛化”。
- 系统成本尚不完整。 中位检索时延不是平均时延;表 10 将约 83 ms 称为 average,但表 4 明确是 P50,应以明确口径为准。后台计算、写入与高并发成本未被端到端表完整覆盖。
- 去标识化不等于已经验证隐私保障。 MTM 的用户过滤与 LTM 的去标识化是设计约束,论文没有跨用户泄漏测试、隐私攻击评估或形式化保证。
- 鲁棒性有实测上限。 级联污染和更新间隙噪声均明显降分,不能将固定预算理解为对错误累积的保证。
- 机制仍有可复现缺口。 图结构消融支持其在组合内有用,但查询时图遍历、SLM-3 维护职责、离线模型和训练配置仍不完整。
这些问题限制的是结论的范围与复现程度,并不抹去主表中相对 A-MEM 的一致数值改善。阅读时应同时保留收益和条件。
5.3 组会可讨论的问题
- 若固定同一回答模型、同一候选 token 预算和同一 SLM 规模,收益分别有多少来自 HQ、重排、摘要和图结构?
- 若只处理个人记忆,去标识化 LTM 的额外价值有多大?怎样避免把局部经历错误泛化成共享事实?
- 用独立重跑的容量设置,而非同轨迹累计 F1,还会观察到相同增长趋势吗?
- 计入写入、离线模型、并发竞争及真实网络负载后,每轮总成本与尾延迟会如何变化?
以上是后续检验建议,不是论文已完成的实验。
材料与构建说明
原文:arXiv:2604.07798v3,Jiaquan Zhang 等,2026。复用图 2、图 3(a)(b) 均来自作者同版本源码包,归属原作者,原论文许可证为 CC BY-NC-SA 4.0。图号、PDF 页码及复制来源记录在 图件来源清单。本研读以独立分析为主,不是全文译稿。
幻灯片面向约 25 分钟组会,附补充页;所有证据定位采用上述 v3。可在本目录运行 python3 build_slides.py slides.en.tex,使用本地 pdflatex 重建 PDF。阅读笔记需与 figures/ 一起分享,以保留本地图片。