Mixture-of-Depths Attention:中文研读笔记
- 论文:Mixture-of-Depths Attention(MoDA)
- 作者:Lianghui Zhu、Yuxin Fang、Bencheng Liao、Shijie Wang、Tianheng Cheng、Zilong Huang、Chen Chen、Lai Wei、Yutao Zeng、Ya Wang、Yi Lin、Yu Li、Xinggang Wang;华中科技大学与 ByteDance Seed。
- 版本:arXiv:2603.15619v1,提交于 2026-03-16;获取与研读日期:2026-09-17。
- 原始材料:arXiv · 本地 PDF · 作者 TeX · 作者所列代码仓库。本次未运行或审计仓库代码。
- 阅读范围:已阅读作者主 TeX 的全部正文、算法与表格,并结合 18 页 PDF 核对身份、编号和关键图表。正文为 PDF pp. 1–15,参考文献为 pp. 16–18;该版本无独立附录。页码均从 PDF 第 1 页开始,与印刷页码一致。没有执行作者源码。
论文总览
核心问题:深层 Transformer 能否在保留普通残差通路的同时,显式检索浅层保存的信息,而不必把整个深度历史都压进当前隐藏状态?
MoDA 为每个注意力头增加一条“沿深度读取记忆”的路径:当前 token 既读取当前层中因果可见的序列 KV,也读取同一 token 位置在先前层保存的深度 KV;两类候选在同一个 softmax 中竞争概率。默认方案复用注意力层已有的 KV,并用额外投影保存 FFN 输入的 KV。与之配套的融合内核通过在线 softmax、按块布局和 GQA 组内复用降低开销。
最有力的证据是同参数的 700M 消融:仅复用深度 KV,669.0M 参数不变,下游平均分从 56.93 到 58.10。默认完整方案在 1.5B 档、400B token 训练下,下游平均分从 62.28 到 64.39(+2.11 个百分点),十领域平均 PPL 从 13.67 到 13.47。后两项来自 Table 4–5(p. 11)。它支持“显式深度检索值得做”,尚不能证明任意大模型、任意深度和真实服务场景都具有相同收益。
结构地图
| 原文章节 | 内容与论证作用 | PDF 定位 |
|---|---|---|
| 首页与摘要 | 网络结构、可见关系、主要结论 | p. 1,Fig. 1 |
| 1 Introduction | 深度扩展、信息稀释、动态跨层检索 | pp. 2–3;Fig. 2 在 p. 2 |
| 2.1 Preliminary | 标准注意力与 GQA 符号 | p. 3,Eq. (1)–(2) |
| 2.2 Stacking Transformers Along the Depth Stream | read/operate/write 比较及 MoDA | pp. 3–6;Fig. 3 p. 4,Eq. (3)–(6),Table 1 p. 5 |
| 3.1 Preliminary | GPU 计算和存储背景 | p. 7 |
| 3.2 Hardware-aware Considerations for MoDA | 三步布局与计算优化 | pp. 7–8;Fig. 4 p. 7 |
| 3.3 Hardware-Efficient MoDA Implementation | 融合在线 softmax、掩码和索引 | pp. 8–9;Algorithm 1 提前排在 p. 6 |
| 3.3.1 Efficiency Comparison | 长度、GQA 组大小、深度扫描 | p. 9,Table 2 |
| 4.1 Experimental Setups | 训练与评测设置 | p. 10 |
| 4.2.1 MoDA Variants | KV 来源和额外投影消融 | pp. 10–11,Table 3 p. 10 |
| 4.2.2 Scaling MoDA with Model Size | 700M/1.5B 下游和领域 PPL | pp. 11–12,Table 4–5 p. 11 |
| 4.3.1 Analyzing MoDA with Layer Number | 24/48 层与归一化消融 | pp. 12–13,Table 6 p. 12 |
| 4.3.2 Analyzing MoDA with Attention Visualization | 序列/深度概率分配 | p. 13;Fig. 5 p. 14 |
| 4.3.3 Analyzing MoDA with Efficiency | 内核优化逐项消融 | pp. 13、15,Table 7 p. 13 |
| 5 Conclusion;6 Discussion | 总结、工业训练与有界深度缓存 | p. 15 |
一:动机
1. 残差加法留下了什么瓶颈?
原文把 Transformer 堆叠解释为 read、operate、write 三步。普通残差层读取当前状态,用 attention 或 FFN 变换,再通过加法写回。Eq. (3)(p. 3)表达的是不断叠加历史更新。它给梯度提供了较短路径,但旧信息与新信息仍混合在一个固定宽度的状态中。
作者认为这会产生信息稀释(information dilution):浅层有用特征在多次更新后难以恢复。这是架构动机,并非论文通过独立信息论指标严格测得的因果机制。深度密集连接保存各层状态,再将它们线性混合,能保留更多历史,但论文所分析的宽度投影方案带来较高成本。
2. 四种方案的差别
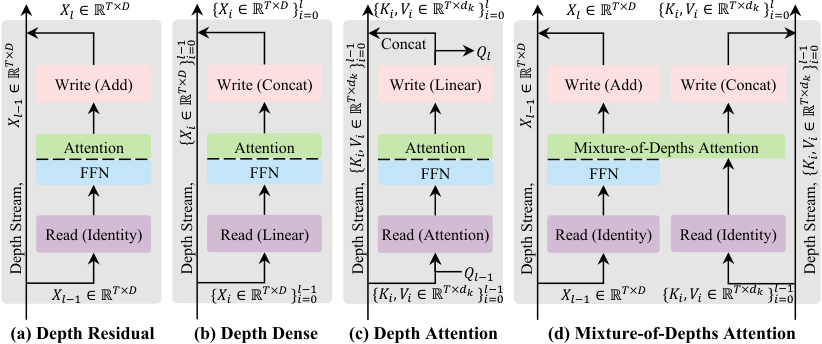
来源:Fig. 3,PDF p. 4,作者原始图件。按从左到右阅读:Depth Residual 以加法覆盖当前流;Depth Dense 拼接隐藏状态并线性读取;Depth Attention 将历史变成 KV 并用内容相关的权重读取;MoDA 则保留残差流,同时把深度 KV 检索融合进序列注意力。
MoDA 不等于跳过层的计算路由:本文没有按 token 选择只运行部分层;它改变的是注意力可访问的记忆集合。也不等于让当前 query 访问“所有历史层的所有 token”,其深度支路只访问相同 token 位置。
二:方法
1. 符号、输入与输出
| 符号 | 含义 |
|---|---|
| $T,D$ | 序列长度、隐藏维度 |
| $H_q,H_k,d$ | query 头数、KV 头数、每头维度 |
| $G=H_q/H_k$ | 每个 KV 头对应的 query 头数量;$D=H_qd$ |
| $l,L$ | 当前层索引、层数;内核中 $L$ 表示可访问的深度槽数 |
| $K_i,V_i$ | 历史层/深度槽保存的 KV;加入 FFN 槽时需注意槽数与 Transformer block 数不总相同 |
| $C$ | 查询块大小;group-aware 处理中按展开后的 query 行计数 |
标准 GQA 投影为 $Q=XW_Q$、$K=XW_K$、$V=XW_V$。$Q$ 的形状是 $T\times(H_qd)$,$K,V$ 为 $T\times(H_kd)$。query 头 $h$ 通过 $\phi(h)=\lceil h/G\rceil$ 共享相应 KV 头。来源:Sec. 2.1,Eq. (1)–(2),p. 3。
2. 用一个 softmax 联合读取两类记忆
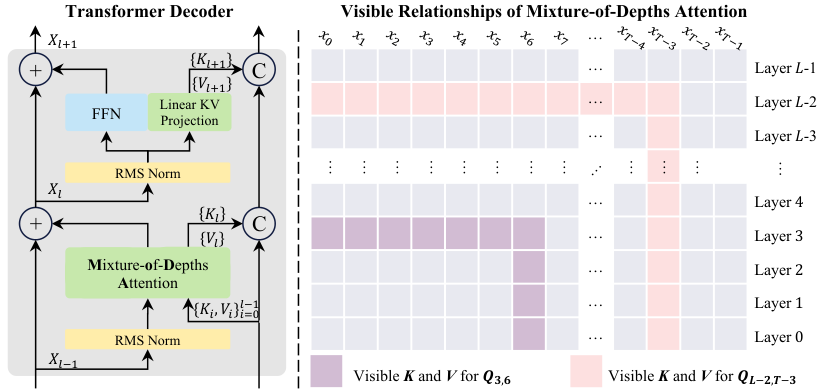
来源:Fig. 1,PDF p. 1。左侧保留残差与 FFN,并将 KV 写入历史流;右侧横轴为 token 位置,纵轴为深度。着色的横向段表示当前层因果可见的 token,竖向段表示同位置的浅层 KV。图中两种颜色对应两个示例 query。
为把 Sec. 2.2 与 Algorithm 1 写得更直观,下面给出本次研读的等价展开式,不是原文另一个编号公式。固定当前层 $l$、位置 $t$、一个 query 头,省略头映射:
$\mathcal H_l$ 是当前层之前已写入的深度槽集合。每个 value 和单头输出都是 $d$ 维;多头输出拼接回 $D$ 维。两类 logits 共用分母,因此模型可按 query 自适应地分配“看其他 token”与“读自己的浅层记忆”的总权重。分别 softmax 后直接相加,不是同一个运算。
教学例子(位置从 1 开始编号):位置 $t=3$ 的 query 在当前层有 3 个因果候选,若已有 4 个深度槽,则它对 7 个候选统一归一化,而不是对 $3\times4$ 个跨层 token 全连接。若所有 logits 相等,深度分支获得 $4/7$ 的概率质量;这也提醒我们,热图中的深度质量不仅与内容有关,也与槽数有关。
同位置的浅层状态只依赖因果允许的输入,因此增加该通路不自动引入未来 token 泄漏。它提供额外信息读取路径,但不缩短逐层计算的依赖链。
3. 深度 KV 从哪里来?
- 注意力支路:默认复用浅层序列注意力已经生成的 KV,不额外建立深度 query 或独立注意力 KV 投影。
- FFN 支路:以 FFN 的输入 $X$ 为对象增加 KV 投影,供后续注意力使用。这一点以 Table 3 的定义和 Sec. 4.2.1 为准,不能笼统写成“缓存 FFN 输出”。
- 写入与生命周期:随着层计算推进追加深度 KV;后续层在相同位置读取。常规训练/prefill 需处理所有位置,逐 token decoding 的额外深度工作区围绕当前 token。论文没有给出完整生产级缓存管理实现与服务测量。
独立 Depth Attention 的 Eq. (5)–(6) 是解释设计空间的中间方案,含额外 query 写入投影;最终 MoDA 复用了序列 query,不应把中间方案的额外投影全部算到 MoDA 上。
4. 复杂度:消掉宽度平方项,但深度计算仍是平方累计
以下为 Table 1(p. 5)的主导阶,比较的是深度流机制,不是整模型总成本。
| 项目 | Depth Dense | Depth Attention | MoDA |
|---|---|---|---|
| 参数 | $O(L^2D^2)$ | $O(LD^2)$ | $O(LD^2/G)$ |
| 解码深度缓存 | $O(LD)$ | $O(LD/G)$ | $O(LD/G)$ |
| Prefill 深度缓存 | $O(TLD)$ | $O(TLD/G)$ | $O(TLD/G)$ |
| 解码深度 FLOPs | $O(L^2D^2)$ | $O(L^2D)$ | $O(L^2D)$ |
| Prefill 深度 FLOPs | $O(TL^2D^2)$ | $O(TL^2D)$ | $O(TL^2D)$ |
这里不包括常规序列注意力随上下文增长的 KV cache、序列 attention 和 FFN 的完整成本。特别是“解码缓存没有 $T$”只针对额外深度流,不能据此宣称整个自回归模型的 cache 与上下文无关。MoDA-only attention KV 复用变体甚至无新增投影参数;表中的参数阶应结合启用的额外投影理解。
5. 从正确算子到高效内核
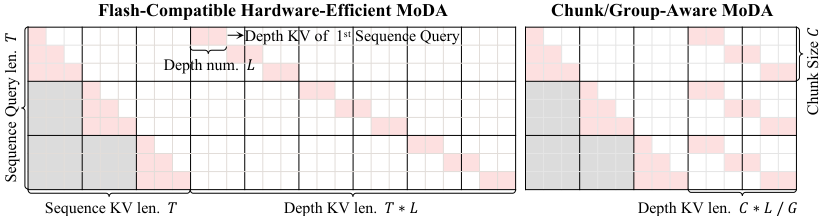
来源:Fig. 4,PDF p. 7。纵向为 query 行,横向先是序列 KV,再是深度 KV。深度区只有同位置块有效;把整条 $TL$ 轴密集算完再 mask,会浪费大量计算。
Sec. 3.2–3.3 的优化链条为:
- Flash-compatible:将每个位置的 $L$ 份 KV 连续存放,展开成长度 $TL$ 的轴,以规则块读取代替不连续 gather。若密集计算全部深度轴,有效项比例仅 $1/T$。
- Chunk-aware:query 按大小 $C$ 分块,仅访问块覆盖位置对应的深度区,有效比例变为 $1/C$。
- Group-aware:在 query 行按 GQA 组展开的表示下,$G$ 行共享同一个 base-time。一个 $C$ 行块只涉及 $C/G$ 个不同位置,深度跨度缩为 $(C/G)L$,有效比例为 $G/C$。要求块边界与 $G$ 对齐。
索引关系为 $T_q=GT_{kv}$,$t_{base}(i_q)=\lfloor i_q/G\rfloor$。因果 mask 为 $\lfloor i_q/G\rfloor\ge i_k$,深度 mask 为 $\lfloor i_q/G\rfloor=\lfloor j_d/L\rfloor$。例如 $G=4$、query 行 8–15,只对应位置 2、3;展开并没有把真实文本长度增加四倍。
统一在线 softmax:各 query 块在片上维护运行最大值 $m$、归一化分母 $acc$ 和未归一化输出 $o$。先处理序列块,再处理深度块,沿用同一组状态,最后只除一次 $acc$。按自然指数书写的标准更新为:
这解释了“不物化整个拼接注意力矩阵”仍可精确保持共同分母。Algorithm 1(p. 6)实际用 $2^x$,却仍把 score 写成 $QK^\top/\sqrt d$;若要和 Eq. (2) 的自然指数 softmax 等价,需乘 $\log_2e$。这是伪代码的书写缺项,不能仅据此判断仓库实现错误。另外其循环条件把 block index 与 token 范围直接比较,实际实现须显式处理块起点、跨度和尾块。
三:实验
1. 三套设置要分开
| 实验 | 数据/模型 | 核心设置与评价 |
|---|---|---|
| 主实验及变体 | OLMo2 数据的 400B-token 子集;700M、1.5B 档 | bf16、全局 batch 1024、上下文 4096;PPL 与十项下游成绩 |
| 层数与 norm | FineWeb-Edu;24/48 层小模型 | $D=384,H_q=6,H_k=2$;额外 held-out split 上的 validation loss |
| 内核基准 | 单张 A100;合成固定形状 | bf16,forward + backward 耗时;扫描 $T,G,L$,另做逐项优化 |
主实验的表注报告 $D=1024,G=2,T=4096$。700M 变体给出 36/38 层、具体参数与 FLOPs;1.5B 的精确层数、实际参数量和 FLOPs 对照未在对应表中列出,不能自行补齐。700M 消融学习率为 2k 步 warmup 到 $3\times10^{-4}$,再 cosine 降至 $3\times10^{-5}$;其他细节援引 OLMo2 实现。小模型深度实验没有单独完整报告训练 token 数。
2. 对照组与指标
OLMo2 是主要训练基线。36 层版本检验“同结构、同参数加入深度 KV”;38 层版本为额外 FFN KV 投影提供近似参数/算力匹配。Depth Dense/Depth Attention 主要用于概念与复杂度比较,没有在主结果中形成同规模实测对照。
困惑度 PPL 越低越好;十领域平均 PPL 是各领域报告值的平均,不等同于把全部样本混在一起重新计算的语料 PPL。下游平均分越高越好,为十项百分数成绩的平均。论文未完整列出每项任务的 few-shot 设置、评测 harness 版本、acc/acc_norm 选择,也未报告多随机种子方差或置信区间。因此下文描述的是报告点值差异,不作统计显著性保证。
四:结果
1. Sec. 4.2.1:真正有用的是哪部分 KV?
Table 3,p. 10;均为 700M 档、400B token。FLOPs 的 T 是表中数量级单位,不是符号表中的序列长度;论文未把该表的完整计数口径展开到足以独立复现。
| 方案 | 层数 | 参数 M | FLOPs T | Train PPL ↓ | C4 PPL ↓ | 下游均分 ↑ |
|---|---|---|---|---|---|---|
| OLMo2 | 36 | 669.0 | 8.01 | 14.49 | 18.59 | 56.93 |
| OLMo2,增加两层 | 38 | 700.5 | 8.41 | 14.27 | 18.31 | 57.11 |
| 复用 attention KV | 36 | 669.0 | 8.02 | 14.08 | 18.48 | 58.10 |
| 再加 FFN KV(默认) | 36 | 705.7 | 8.33 | 13.90 | 18.21 | 58.87 |
| 再加独立 attention KV 投影 | 36 | 742.4 | 8.63 | 13.83 | 18.17 | 58.97 |
第一、三行同参数,下游 +1.17 个百分点,FLOPs 约 +0.12%,是深度通路有效的较干净证据。第三到第四行,FFN KV 再带来 +0.77 个百分点。默认方案比 38 层基线多 5.2M 参数、少 0.08T FLOPs,下游 +1.76 个百分点,说明收益并非简单等价于多堆两层。第五行付出额外 36.7M 参数,却只再改善 0.10 个百分点,因而不是默认方案。
2. Sec. 4.2.2:规模扩展与跨域泛化
Table 4,p. 11。下面差值均为 MoDA 减去同档 OLMo2,单位为百分点。
| 任务 | 700M OLMo2 → MoDA | 差值 | 1.5B OLMo2 → MoDA | 差值 |
|---|---|---|---|---|
| PIQA | 73.72 → 73.39 | −0.33 | 76.55 → 76.82 | +0.27 |
| HellaSwag | 58.77 → 59.19 | +0.42 | 65.86 → 66.24 | +0.38 |
| WinoGrande | 55.33 → 60.22 | +4.89 | 63.22 → 65.59 | +2.37 |
| OpenBookQA | 35.60 → 37.20 | +1.60 | 38.80 → 41.60 | +2.80 |
| BoolQ | 56.24 → 59.33 | +3.09 | 63.61 → 67.34 | +3.73 |
| SciQ | 89.50 → 89.60 | +0.10 | 90.60 → 92.10 | +1.50 |
| ARC-E | 66.84 → 67.37 | +0.53 | 72.98 → 72.81 | −0.17 |
| ARC-C | 33.44 → 34.78 | +1.34 | 42.47 → 46.82 | +4.35 |
| COPA | 77.00 → 82.00 | +5.00 | 81.00 → 85.00 | +4.00 |
| MMLU | 24.69 → 25.61 | +0.92 | 27.73 → 29.59 | +1.86 |
| 原表均分 | 57.11 → 58.87 | +1.76 | 62.28 → 64.39 | +2.11 |
摘要写“2.11%”,按表格应读为 2.11 个百分点;相对于 62.28,约为 3.39% 的相对提升。每个规模各有一个任务下降,因此“平均改善”不能改写成“每项任务都改善”。
Table 5,p. 11:
| 验证领域 | 700M OLMo2 → MoDA | 1.5B OLMo2 → MoDA |
|---|---|---|
| C4 | 18.32 → 18.29 | 16.16 → 15.97 |
| ICE | 17.43 → 17.24 | 15.37 → 15.08 |
| m2d2-s2orc | 24.37 → 23.64 | 21.10 → 20.92 |
| Pile | 9.53 → 9.48 | 8.45 → 8.33 |
| Wiki-text | 12.26 → 12.06 | 10.41 → 10.16 |
| Dolma Books | 16.78 → 16.58 | 14.19 → 13.95 |
| Dolma CC | 20.53 → 20.52 | 18.13 → 17.88 |
| Dolma peS2o | 9.17 → 9.14 | 8.19 → 8.09 |
| Dolma Reddit | 23.84 → 23.75 | 21.21 → 20.85 |
| Dolma Stack | 3.93 → 3.90 | 3.57 → 3.52 |
| 原表平均 | 15.61 → 15.46 | 13.67 → 13.47 |
两个规模的十领域 PPL 点值均降低。700M 最大降幅为 m2d2-s2orc 的 0.73;1.5B 的 Reddit 降低 0.36。这是跨领域语言建模改善的证据,但不测量开放式生成体验或长上下文检索准确性。
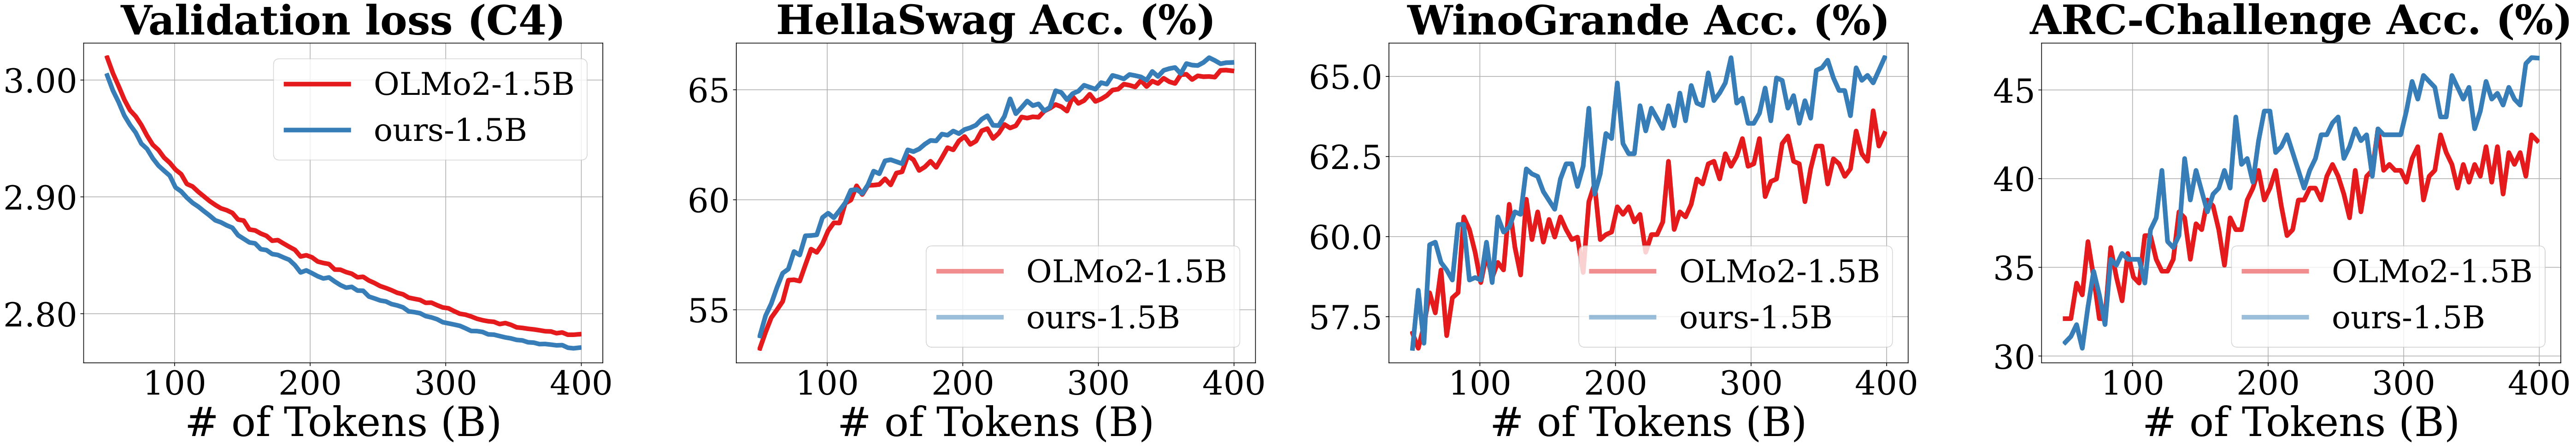
来源:Fig. 2,p. 2。横轴为训练 token 数(B);四个面板依次为 C4 validation loss、HellaSwag、WinoGrande、ARC-C。红线为 OLMo2,蓝线为 MoDA;第一个越低越好,后三个越高越好。曲线显示 1.5B 训练过程中的趋势,精确终值以 Table 4–5 为准,不从图中插值制造新数字。
3. Sec. 4.3.1:深度和 post-norm 的关系
Table 6,p. 12,验证集为 FineWeb-Edu;下面均为 loss,非 PPL。
| 层数 / norm | OLMo2 | 加 Depth KV | 再加 FFN KV |
|---|---|---|---|
| 48 / pre-norm | 3.3800 | 3.3759 | 3.3656 |
| 48 / post-norm | 3.4062 | 3.3653 | 3.3484 |
| 24 / post-norm | 3.4740 | 3.4537 | 3.4338 |
在 48 层中,仅 Depth KV 的 loss 改善,pre-norm 为 0.0041,post-norm 为 0.0409。未加深度通路时 post-norm 更差,加入后反而更好,这支持二者存在互补。加 FFN KV 后的最优值为 3.3484。
48 层模型由 123.38M/136.61G 变为默认方案 128.11M/144.00G;24 层由 71.35M/78.19G 变为 73.72M/81.24G。因此表格不是严格固定参数/算力的深度扩展曲线,也不能将小模型的 norm 结论无条件推到更大规模。
4. Sec. 4.3.2:注意力热图说明了什么?
来源:Fig. 5,p. 14;分析文字在 p. 13。模型为 700M、400B token。四列是第 0、11、23、35 层,四行为各层随机选取的头,不表示同一个 head 沿层追踪。纵轴为 query,横轴为 sequence KV 后接 depth KV,红虚线为分界;第一列没有历史深度块。
中后层的 depth 区明显获得概率,证明该通道被使用。部分头在序列上仍保持对角模式,同时读取深度槽;另一些头更明显依赖深度块。作者观察到与典型 attention sink 不同的分配方式,但没有配套的基线同条件热图、汇总统计或因果干预;图也没有供跨面板定量对比的统一数值色标。因而合理结论是“深度通路被使用、概率分配改变”,而不是“已证明解决 attention sink 并因此提升性能”。
5. Sec. 3.3.1 与 4.3.3:高效率在哪些条件下成立?
Table 2,p. 9:A100、bf16、forward + backward,$B=1,d=64,C=64,G=8,H_q=64,H_k=8,L=64$,仅改变序列长度。下面同时列出原表百分比与本次按通常基线分母重算的耗时增幅。
| $T$ | FA2 Triton ms | MoDA Triton ms | 原表 Extra Time | 相对 FA2 耗时增幅 |
|---|---|---|---|---|
| 4096 | 7.970 | 10.750 | 25.86% | 34.88% |
| 8192 | 28.700 | 35.427 | 18.99% | 23.44% |
| 16384 | 116.700 | 127.661 | 8.59% | 9.39% |
| 32768 | 459.854 | 480.914 | 4.38% | 4.58% |
| 65536 | 1831.668 | 1883.026 | 2.73% | 2.80% |
分母核验:原表数值与 $(t_{MoDA}-t_{FA2})/t_{MoDA}$ 一致;通常“比 FA2 多花多少时间”使用 $(t_{MoDA}-t_{FA2})/t_{FA2}$。所谓 97.3% 对应 $1831.668/1883.026\approx97.27\%$,是该内核基准的耗时比,不是 GPU 利用率,也不是整模型吞吐测量。
固定 $T=16384,L=64,H_k=8$,$G$ 从 2 到 32,深度有效比例从 3.12% 到 50%,原表额外时间从 27.07% 到 2.84%;但 $H_q$ 同时从 16 到 256,序列计算量也变了,不能读作同一模型无代价提速。固定 $T=16384,G=8$,$L$ 从 64、128 到 256,MoDA 耗时依次为 127.661、138.224、167.958 ms,FA2 均为 116.700 ms;深度历史更长,开销确实会上升。
Table 7,p. 13,$T=1024$,其他配置为 $B=1,G=8,H_q=64,H_k=8,d=64,L=64,C=64$:
| 逐步优化 | forward + backward ms ↓ |
|---|---|
| naive PyTorch | 2128.900 |
| Flash-compatible | 13.102 |
| 再加 chunk-aware | 6.286 |
| 再加 group-aware | 1.460 |
最后一步相对 6.286 ms 提速约 4.31 倍;完整方案相对未经优化的 PyTorch 约 1458 倍。这个巨大倍率用于说明 naive 实现极差,不能替换成“相对 FlashAttention 提速 1458 倍”。这些时间包含该算子的 forward/backward,不是完整训练 step,更没有提供 decoding latency、峰值显存或多机通信的完整评测。
6. 原文中应保留的报告差异
- 700M C4 不一致:Table 3 的近匹配 baseline/default 为 18.31/18.21;Table 5 为 18.32/18.29。原文没有解释检查点或评测口径变化。上述两表分别忠实保留,不能拼成一个更好看的统一数字。
- 摘要 3.7% FLOPs:摘要把它与 1.5B 结果一并陈述,但主文没有给出对应 1.5B 的完整 FLOPs 对照。700M Table 3 的默认方案相对 36 层 baseline 是 $(8.33-8.01)/8.01\approx4.00\%$,相对 38 层 baseline 则约 −0.95%。3.7% 应标为作者摘要报告值,不能由这些表值直接复核。
- 表格单位与措辞:下游的 +2.11 为百分点;运行时间百分比的分母如上;Sec. 4.1 的 SciQA 命名与引用和结果表 SciQ 不完全一致,此处结果使用表中的 SciQ,不把它们当成新增两个任务。
- 伪代码与实现:Algorithm 1 的指数底数和 block/element 索引简写需要实现层验证;本次没有运行代码,故只指出可核验的书写问题。
五:结论
可依赖的贡献
MoDA 的价值在于把“沿深度保存历史”和“按内容读取历史”纳入原本已有的注意力算子。其设计不是单纯加大容量:同参数复用 KV 的消融已显示收益;FFN KV 的增益与独立 attention KV 投影的低边际收益,又给出了具体的设计取舍。系统部分把统一 softmax 和适合 GPU 的数据布局共同设计,使这个通路在长序列内核基准中具有较低相对开销。
适用边界与局限
证据集中于 700M/1.5B 语言模型、两种小模型深度以及 A100 Triton 基准。论文没有证明更大模型的规模律,没有长上下文质量评测,未测量生产级训练总吞吐、解码速度与峰值显存,也缺少多次重复实验的误差统计。信息稀释与 attention sink 的改善主要是架构解释和定性观察,其因果角色尚未隔离。
Sec. 6.1 提出的 CUDA pipeline、存储调度及通信重叠属于后续工业工程。Sec. 6.2 的固定 $S\ll L$ 深度槽缓存,包括 top-$S$、滑窗和混合选择,也属于未来方案,没有在本文实验中验证。多模态、视觉和世界模型扩展同样是展望。
本次分析建议优先追问的问题
- 固定参数与训练总 FLOPs,并报告多种子区间后,FFN KV 的收益是否仍稳定?
- 在相同权重下屏蔽部分深度槽,是否能定位真正有用的层与 FFN 信息?
- $S$ 槽有界缓存对质量、显存、吞吐的 Pareto 曲线如何?
- 增加 depth slots 的概率预算效应与内容检索效应,能否用统一/分离 softmax 消融区分?
- 用真实 4K 训练和逐 token 服务测量时,内核开销、缓存开销和完整模型收益如何变化?
组会一句话:MoDA 让每个 token 在同一个注意力归一化中选择“当前层的序列信息”与“自己的浅层记忆”;现有实验支持这种显式深度检索的价值,而大规模缓存和真实系统收益仍需要继续验证。