RAM-Net:稀疏可寻址状态的线性时间序列建模——中文研读笔记
原题:RAM-Net: Linear-Time Sequence Modeling with Sparsely Addressable State
作者:Kaicheng Xiao、Haotian Li、Liran Dong、Guoliang Xing
原文:arXiv:2602.11958v2 · 本地 PDF
研读日期:2026-11-03;以下页码均指从 1 开始的 PDF 页码。
发表:已接收 NeurIPS 2026(arXiv v2 的作者声明;会议官方列表)。
代码:作者官方公开实现,仓库包含模型、算子、示例与测试。
论文总览
线性注意力用固定大小的递归状态替代随序列增长的 KV cache,但不同 token 的信息叠加在同一状态里,查询也密集读取该状态,细粒度长程回忆容易相互干扰。RAM-Net 把固定状态拆成许多独立槽位:key 产生稀疏写地址,query 产生稀疏读地址,每步只接触少数槽位。它用乘积 Softmax + 精确 Top-$K$ 前缀搜索在大地址空间中定位槽位,用 CAPE 将位置纳入地址,用**门控稀疏更新(GSU)**只修改被写到的槽位。(Sec. 1–4,PDF pp. 1–6)
主要证据来自两档语言模型:340M 参数/10B 训练 token 与 1.3B 参数/100B token,均用 4K 训练上下文。RAM-Net 在合成关联回忆和 RULER S-NIAH 的平均分上显示明显优势,同时保持有竞争力的语言建模与常识任务表现;但在真实文档回忆上仍低于 Transformer++,在 16K 的困难 S-NIAH-2/3 上也很弱。所谓低“活跃状态”是每 token 触及的状态元素数,不能直接等同于总显存或全部计算量。(Table 1–3、Fig. 4–5,PDF pp. 7–9)
结构地图
| 原文章节 | 论证作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 固定状态中的叠加干扰与稀疏访问思路 | pp. 1–2 |
| 2 Background | 全注意力、线性注意力的状态粒度与访问方式 | pp. 2–3,Fig. 1 |
| 3 RAM-Net | 槽位阵列、地址解码器、CAPE、GSU | pp. 3–6,Fig. 2–3,Eq. (4)–(8) |
| 4 Implementation | 精确前缀搜索与按槽位并行执行 | p. 6 |
| 5 Experiments | 语言建模、MQAR、S-NIAH、真实文档回忆、推理吞吐 | pp. 7–9,Table 1–3,Fig. 4–5 |
| 6–8 Related Work / Limitations and Future Work / Conclusion | 与相关设计区分、主要适用边界 | pp. 9–10 |
| Appendix A–C | 训练配置、消融、访问轨迹 | pp. 14–18,Table 4–5,Fig. 6–8 |
一:动机——固定状态为何仍难精确回忆
全注意力把每个历史 token 的 key/value 保存在独立 KV 条目里,当前 query 对所有 key 评分、经 Softmax 聚焦相关条目,因此有精细选择能力;代价是缓存随长度 $t$ 增长。典型线性注意力把历史写入固定矩阵,例如 $\mathbf S_t=\mathbf S_{t-1}+\phi(\mathbf k_t)^\top\mathbf v_t$,再由 $\phi(\mathbf q_t)\mathbf S_t$ 读取。不同 token 的贡献在矩阵中相加,且读取覆盖整个矩阵,目标信息与无关信息容易一起进入输出。作者把差异归纳为“状态如何分隔”和“每步如何访问”两条设计轴。(Sec. 2,PDF pp. 2–3)
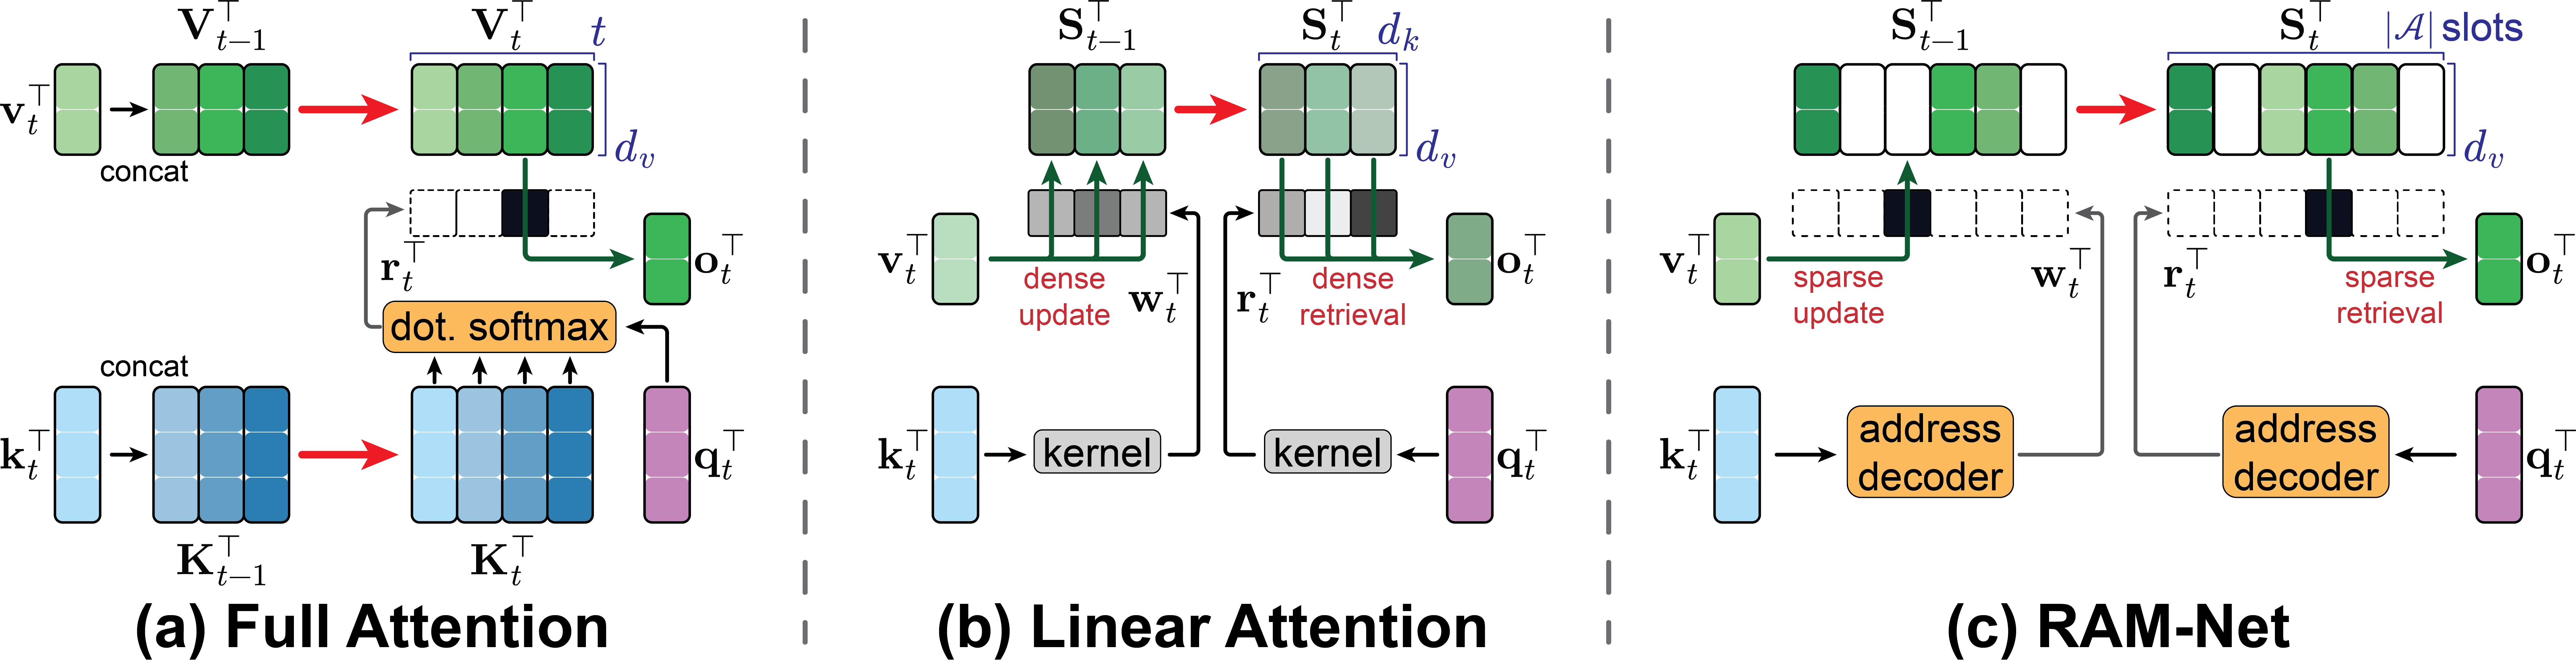
原文 Fig. 1,PDF p. 3。 左侧全注意力保留逐 token 条目;中间线性注意力密集读写共享状态;右侧 RAM-Net 在固定槽位阵列中稀疏读写。图中的“固定”指槽位数量在一次推理中不随上下文长度增长,并不表示总状态容量可以无成本增加。
二:方法——地址、位置与更新
2.1 数据流与符号
每个 RAM-Net block 是预归一化残差的 RAM-Net 层加 FFN。对一个注意力头,输入 $\mathbf x_t$ 投影为 key $\mathbf k_t$、query $\mathbf q_t$、value $\mathbf v_t$ 和遗忘调制量 $\gamma_t$。key 解码出稀疏写权重 $\mathbf w_t$,query 解码出稀疏读权重 $\mathbf r_t$;位置变换之后,GSU 更新写地址对应的槽位,再由读地址加权汇总输出。(Sec. 3.1、3.4,PDF pp. 3–6,Fig. 2)
| 符号 | 含义 |
|---|---|
| $\mathcal A$,$M= | \mathcal A |
| $U$,$d_p$ | 地址位数与每位候选数;key/query 维度 $d_k=Ud_p$ |
| $K$ | 每次读或写保留的 Top-$K$ 地址数,$K\ll M$ |
| $\mathbf s_t[a]\in\mathbb R^{1\times d_v}$ | 时刻 $t$ 的槽位 $a$ 内容;$\mathbf S_t$ 堆叠成 $M\times d_v$ 状态 |
| $m_t[a]$ | 槽位 $a$ 的历史写入质量;与内容一同递归保存 |
| $w_t[a],r_t[a]$ | 对槽位 $a$ 的写、读权重;未保留的地址权重为零 |
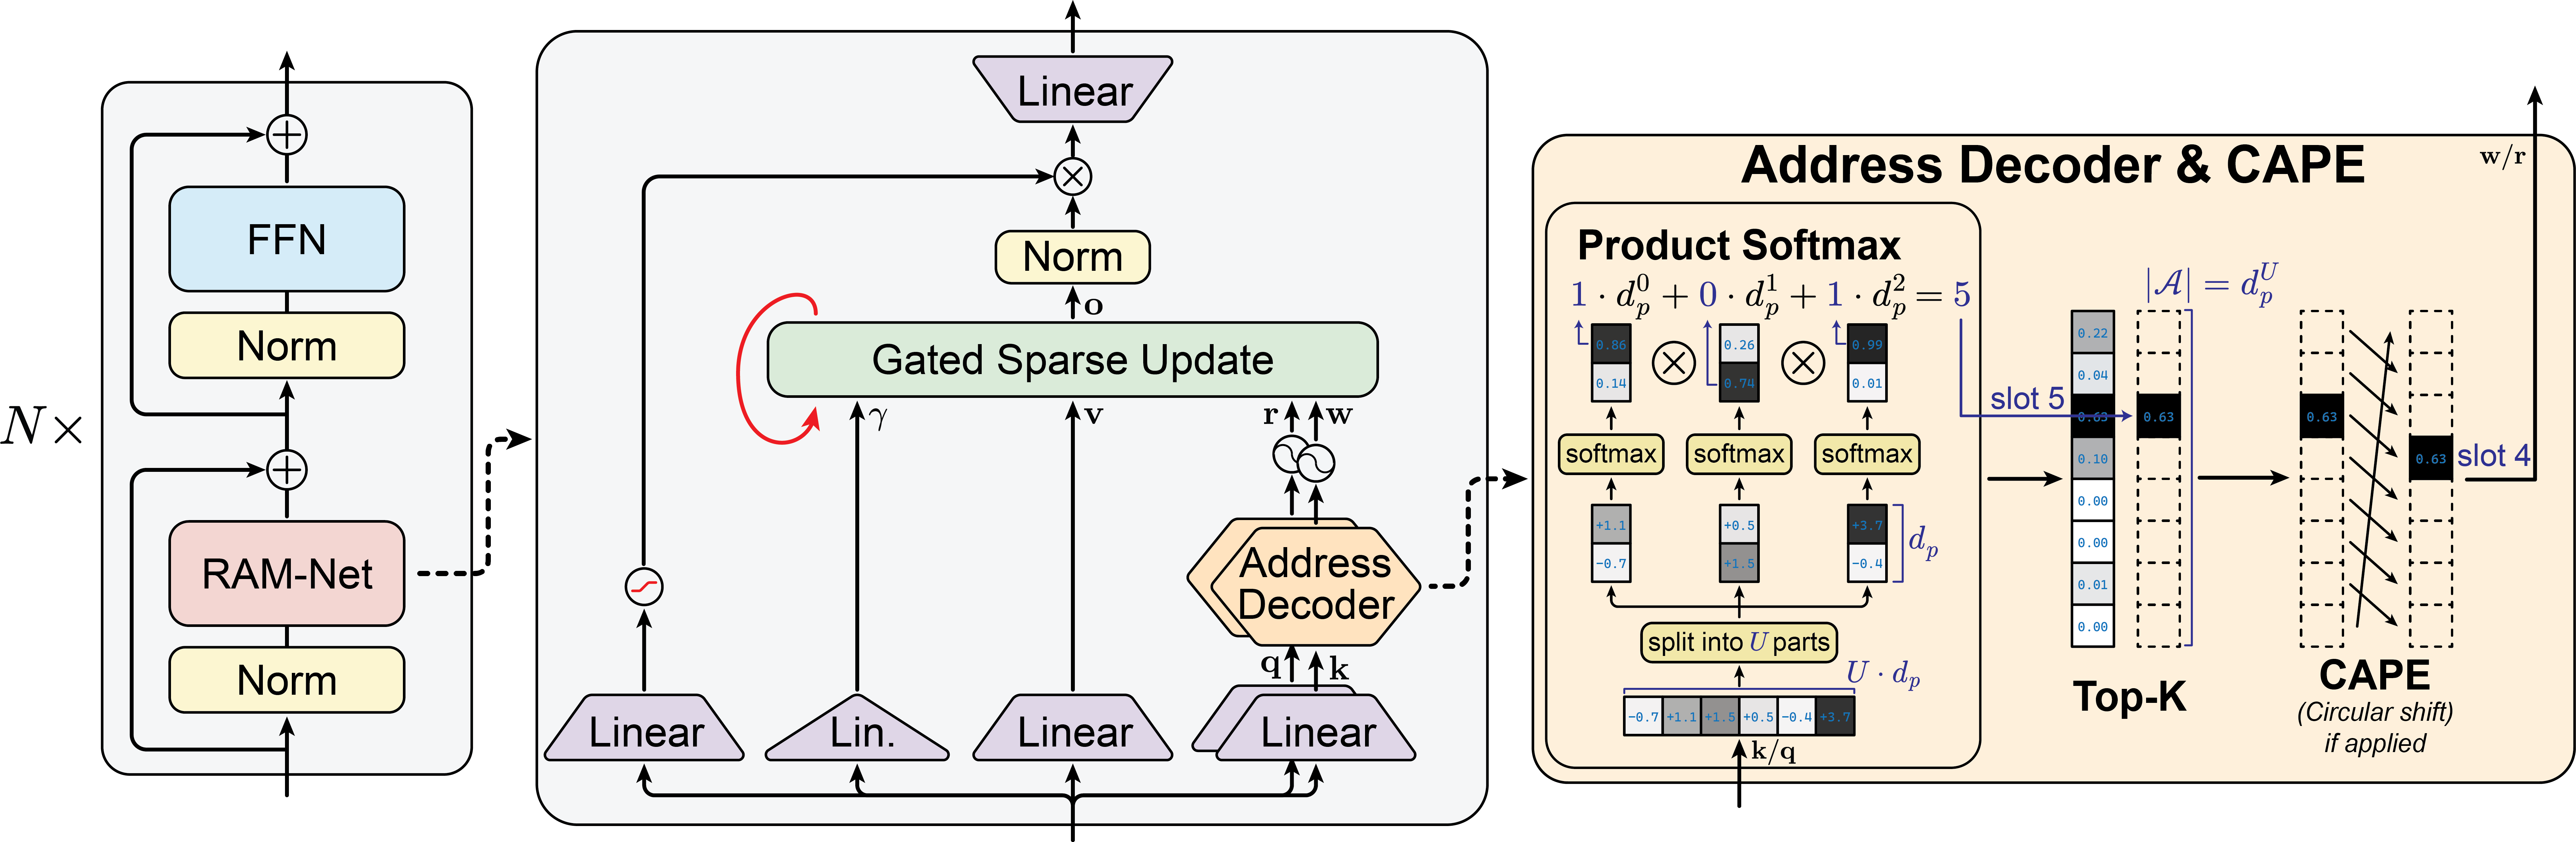
原文 Fig. 2,PDF p. 4。 右图只用 $K=1$、8 个槽位解释 CAPE;实验模型使用的槽位与 $K$ 见后文。
2.2 地址解码器:大状态,少量寻址计算
直接为 $M$ 个槽位输出 $M$ 个分数会使投影参数、Softmax 与 Top-$K$ 扫描都随 $M$ 增长。作者把地址写成 $U$ 位的 $d_p$ 进制数 $a=\sum_{u=0}^{U-1}a^{(u)}d_p^u$;第 $u$ 个 key 子向量经过 Softmax 后给出该位的概率 $p_t^{(u)}$。完整地址概率是各位概率之积:
query 走同样的解码路径。$\mathcal T_K$ 只保留最大 $K$ 个权重并把其余设零;默认不对保留权重重新归一化。例如 $U=5,d_p=4$ 时,每头用 $d_k=20$ 个 key/query 维度可寻址 $4^5=1024$ 个槽位。每一级前缀只扩展当前最优的至多 $K$ 项;由于后续位分布对所有前缀相同,被淘汰前缀无法重新进入最终 Top-$K$,所以这不是近似搜索。实现采用 log 概率,地址搜索代价为 $\mathcal O(UKd_p+Ud_p\log d_p)$,而不是 $\mathcal O(M)$。(Sec. 3.2、4,PDF pp. 4–6,Eq. (4)–(5))
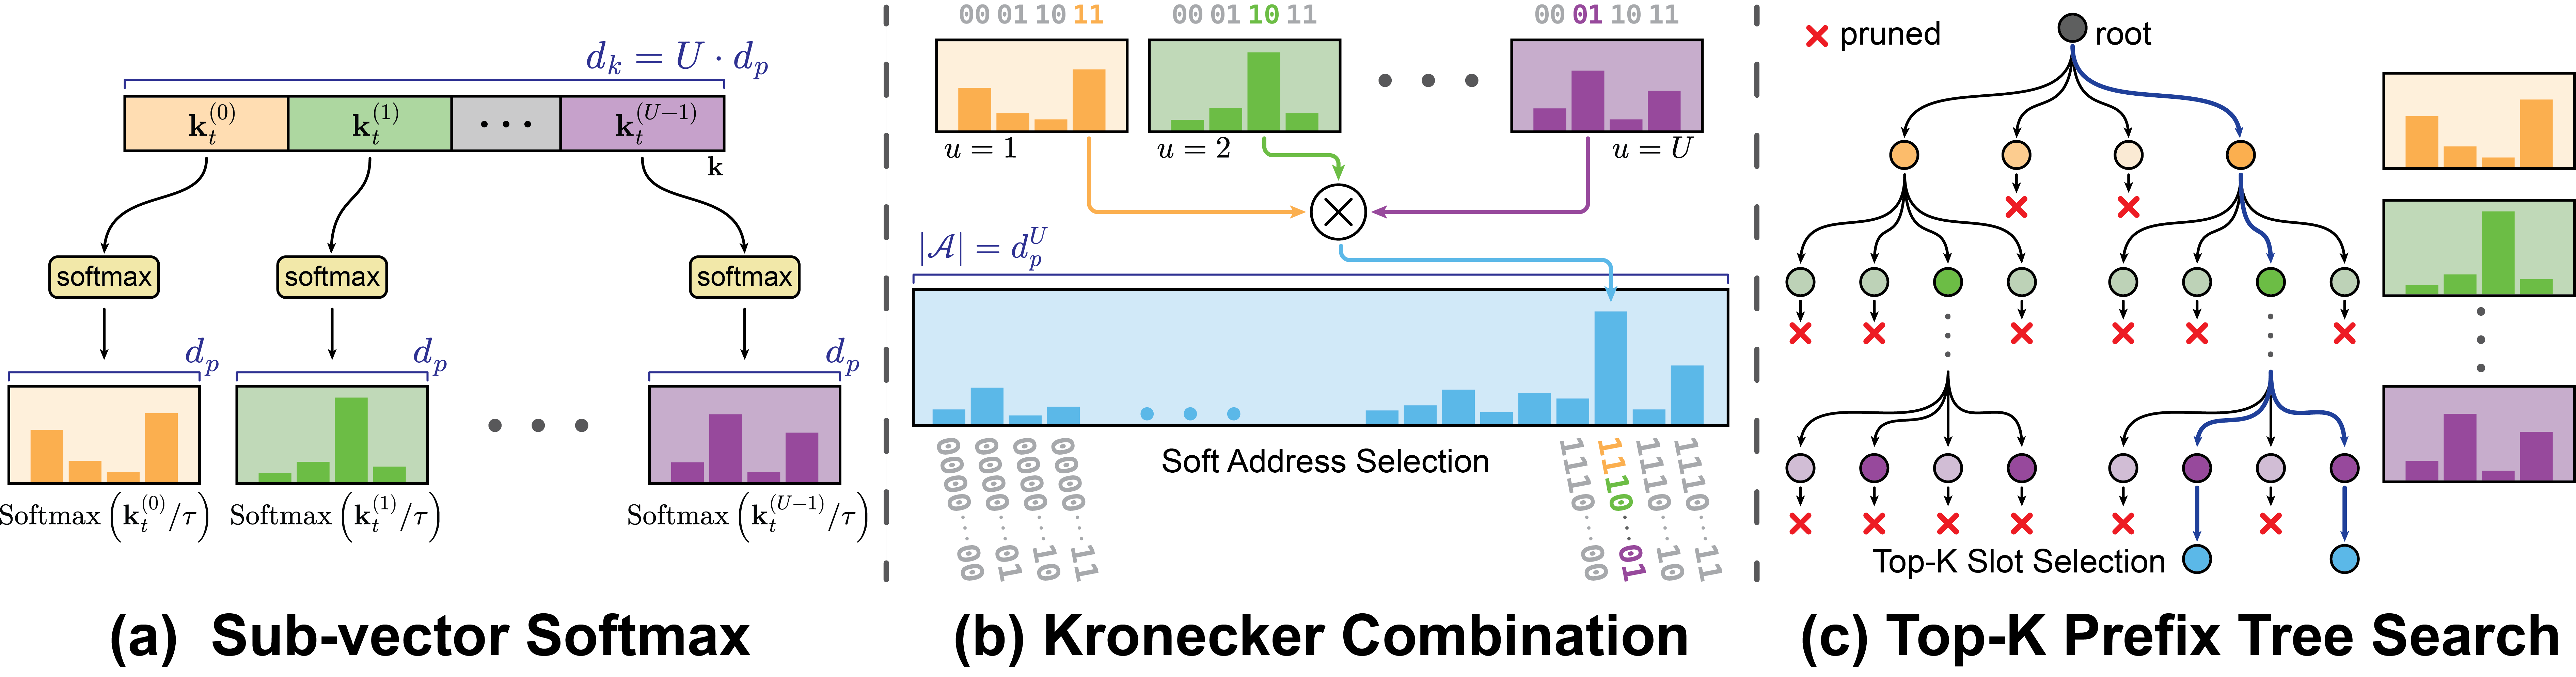
原文 Fig. 3,PDF p. 5。 左侧每个子向量给一位分布,中间用 Kronecker 积定义整组地址概率,右侧只搜索最优前缀。乘积结构也让选中槽位的梯度流向它用过的各个“地址位”,从而缓解直接 $M$ 维 Top-$K$ 的稀疏学习信号问题;这是作者对优化收益的解释,附录 Fig. 6 给出相应消融。
2.3 CAPE:让槽位重合表达相对位置
仅凭内容得到的地址不区分 token 位置。CAPE 对选中地址施加循环位移 $\pi_t(a)=(a-t)\bmod M$:
一个较早写入 $s$ 与当前读取 $t$ 是否落到同一槽位,同时取决于内容地址与相对距离 $t-s$。论文将部分头设为 CAPE,其他头不加位置变换(NoPE),分别处理位置相关模式与内容直接查找。附录给出逐层 CAPE 头数:340M 模型从浅层 $16$ 头逐级降到深层 $0$ 头;1.3B 模型从 $32$ 头降到每层 $2$ 头。(Sec. 3.3、Appendix A,PDF pp. 5、14)
2.4 GSU:只对被寻址的槽位写入和遗忘
普通全局遗忘门会触及所有槽位,破坏稀疏访问。GSU 对每个槽位单独保存内容 $\mathbf s[a]$ 与写入质量 $m[a]$:
初始 $m_0[a]=1/M$、$\mathbf s_0[a]=0$;$\epsilon>0$。若 $w_t[a]=0$,按极限 $\lambda_t[a]=1$ 且 $\eta_t[a]=0$,未寻址槽位保持不变。若当前写权重较大或 $\gamma_t$ 较大,保留因子下降,旧质量减少,内容更快转向 $\mathbf v_t$。因为 $0\le\eta_t[a]<1$,内容仍是旧值和新 value 的凸组合。把每槽内容视为在线参数时,最后一式也是对 $\frac12\|\mathbf s-\mathbf v_t\|_2^2$ 做一次步长 $\eta_t[a]$ 的梯度更新。(Sec. 3.4,PDF p. 6,Eq. (7)–(8))
读取为 $\mathbf o_t=\sum_a r_t[a]\mathbf s_t[a]$,随后施加逐头 RMSNorm、sigmoid 输出门与投影。训练/预填充时,作者先并行解码所有地址,再按槽位组织读写事件,使同一槽位内按时间顺序执行、不同槽位并行;自回归解码直接处理当前 token 的选中槽位。地址计算随 $U,K,d_p$ 增长,状态存储仍需 $M(d_v+1)$ 量级的内容与质量空间;模型关于序列长度的线性时间主张建立在固定架构超参数上。(Sec. 3.4–4,PDF p. 6)
三:实验设置——比较了什么
语言模型对照包括 Transformer++、Mamba2、GLA、GSA 和 Gated DeltaNet;MQAR 还加入线性注意力、SWA、H3 与 DeltaNet。语言模型用 FineWeb-Edu、Llama 2 tokenizer、4,096 token 上下文,340M/1.3B 分别训练 10B/100B token,使用 Flame 框架与 AdamW;不同规模的学习率与 warmup 详见原文 Table 4。主要指标是 WikiText-103 困惑度(越低越好)、零样本常识任务平均准确率、MQAR 准确率、RULER S-NIAH 准确率、真实文档回忆平均分与单卡解码 tokens/s(后四项越高越好)。(Sec. 5、Appendix A,PDF pp. 7–9、14)
“活跃状态”统计每步实际接触的状态元素;对 Transformer++,Table 1 在长度 2,048 测量。RAM-Net 的总状态在 340M/1.3B 分别为 26.2M/52.4M,表中 0.4M、1.6M 等是活跃状态,不能混作总容量或显存占用。(Table 1 脚注,PDF p. 7)
四:结果——回忆优势、质量与代价
4.1 语言建模与常识任务
| 规模/模型 | WikiText ppl ↓ | 常识平均准确率 ↑ | 活跃状态/步 ↓ |
|---|---|---|---|
| 340M Transformer++ | 26.81 | 49.4 | 100.7M |
| 340M Mamba2 | 26.23 | 50.6 | 12.9M |
| 340M Gated DeltaNet | 26.85 | 50.1 | 8.5M |
| 340M RAM-Net Top-8 | 26.89 | 50.3 | 0.4M |
| 340M RAM-Net Top-32 | 25.87 | 50.9 | 1.6M |
| 1.3B Transformer++ | 17.08 | 56.0 | 201.3M |
| 1.3B Mamba2 | 15.96 | 57.8 | 26.0M |
| 1.3B RAM-Net Top-16 | 15.90 | 57.8 | 1.6M |
原文 Table 1,PDF p. 7。 在论文给定的训练预算下,RAM-Net Top-32/Top-16 各自在对应规模获得最低困惑度,常识平均分与强对照接近或持平。Top-8 在 340M 的困惑度略高于 Mamba2;增大 $K$ 改善质量,也按比例提高活跃状态访问。以 340M 的 Top-8 对 Mamba2 为例,$12.9/0.4\approx32$ 倍是状态元素访问量之比,不是已测得的吞吐提升倍数。
4.2 合成关联回忆 MQAR
MQAR 要求模型在受控序列中记住 key–value 对并按查询 key 找回 value,各模型在该任务上从头训练。Fig. 4 的横轴是状态大小(对 RAM-Net 分别标总状态与活跃状态),纵轴是 MQAR 准确率。RAM-Net Top-8/16 在总状态大小比较下接近散点上包络,且同等准确率附近的活跃访问明显更少,支持“槽位分隔减少干扰”的设计解释。(Sec. 5,Fig. 4,PDF p. 7)
原文 Fig. 4,PDF p. 7。 对 RAM-Net 同一配置的浅色点代表活跃状态、深色点代表总状态;读图时不能把浅色点的位置当成模型实际只存有那么大的状态。
4.3 长上下文 S-NIAH:平均分高,困难尾部长程仍弱
RULER 单针任务包含 S-NIAH-1(重复填充文本)与更难的 S-NIAH-2/3(多样自然文本填充),从 1K 测到 16K,最长是 4K 训练窗口的四倍。Table 2 的平均分汇总了三种任务、五种长度的 15 个准确率。(Sec. 5,PDF p. 8)
| 规模 | Transformer++ | 最强所列递归对照 | RAM-Net 最优配置 | 该配置的 S-NIAH-2/3 @16K |
|---|---|---|---|---|
| 340M | 48.6 | Gated DeltaNet 51.3 | Top-32 72.9 | 4.0 / 1.0 |
| 1.3B | 56.4 | Mamba2 62.4 | Top-16 70.1 | 18.7 / 6.3 |
原文 Table 2,PDF p. 8;数值为准确率百分数,最后一列也为百分数。 RAM-Net 在 S-NIAH-1 中直到 16K 仍近乎满分,作者将其与重复填充内容反复写入相近地址、较少扰动针信息联系起来;这是机制解释。多样化填充使槽位冲突和查询错址更难避免:340M Top-32 在 S-NIAH-2 的 8K 为 56.3、16K 仅 4.0,在 S-NIAH-3 的 16K 为 1.0。平均优势因此不能替代逐任务、逐长度的判断。
4.4 真实文档回忆与解码吞吐
真实文档回忆使用 FDA、SWDE、NQ 的 512/1K 设置及 SQuADv2、TriviaQA、DROP 全文设置,共九列求平均。340M 的 RAM-Net Top-32 得 32.0,高于最强所列递归对照 Mamba2 的 26.9,但低于 Transformer++ 的 35.1;1.3B 的 RAM-Net Top-8 为 40.6,高于 Gated DeltaNet 的 39.5,却仍低于 Transformer++ 的 49.8。这里的落差表明“固定槽位加稀疏寻址”尚未取代逐 token KV 保存对真实文档细节的优势。(Table 3,PDF p. 8;Sec. 5,PDF p. 9)
在单张 RTX 5090 上,论文测量 340M 模型的自回归解码,横轴为 1K–32K 上下文,纵轴为 tokens/s。Top-8 RAM-Net 曲线约 51–53 tokens/s,与 GLA 相近,高于图中的 Mamba2、DeltaNet 和 Gated DeltaNet;这里的速度结论针对所报告的模型、实现与硬件。(Fig. 5,PDF p. 9)
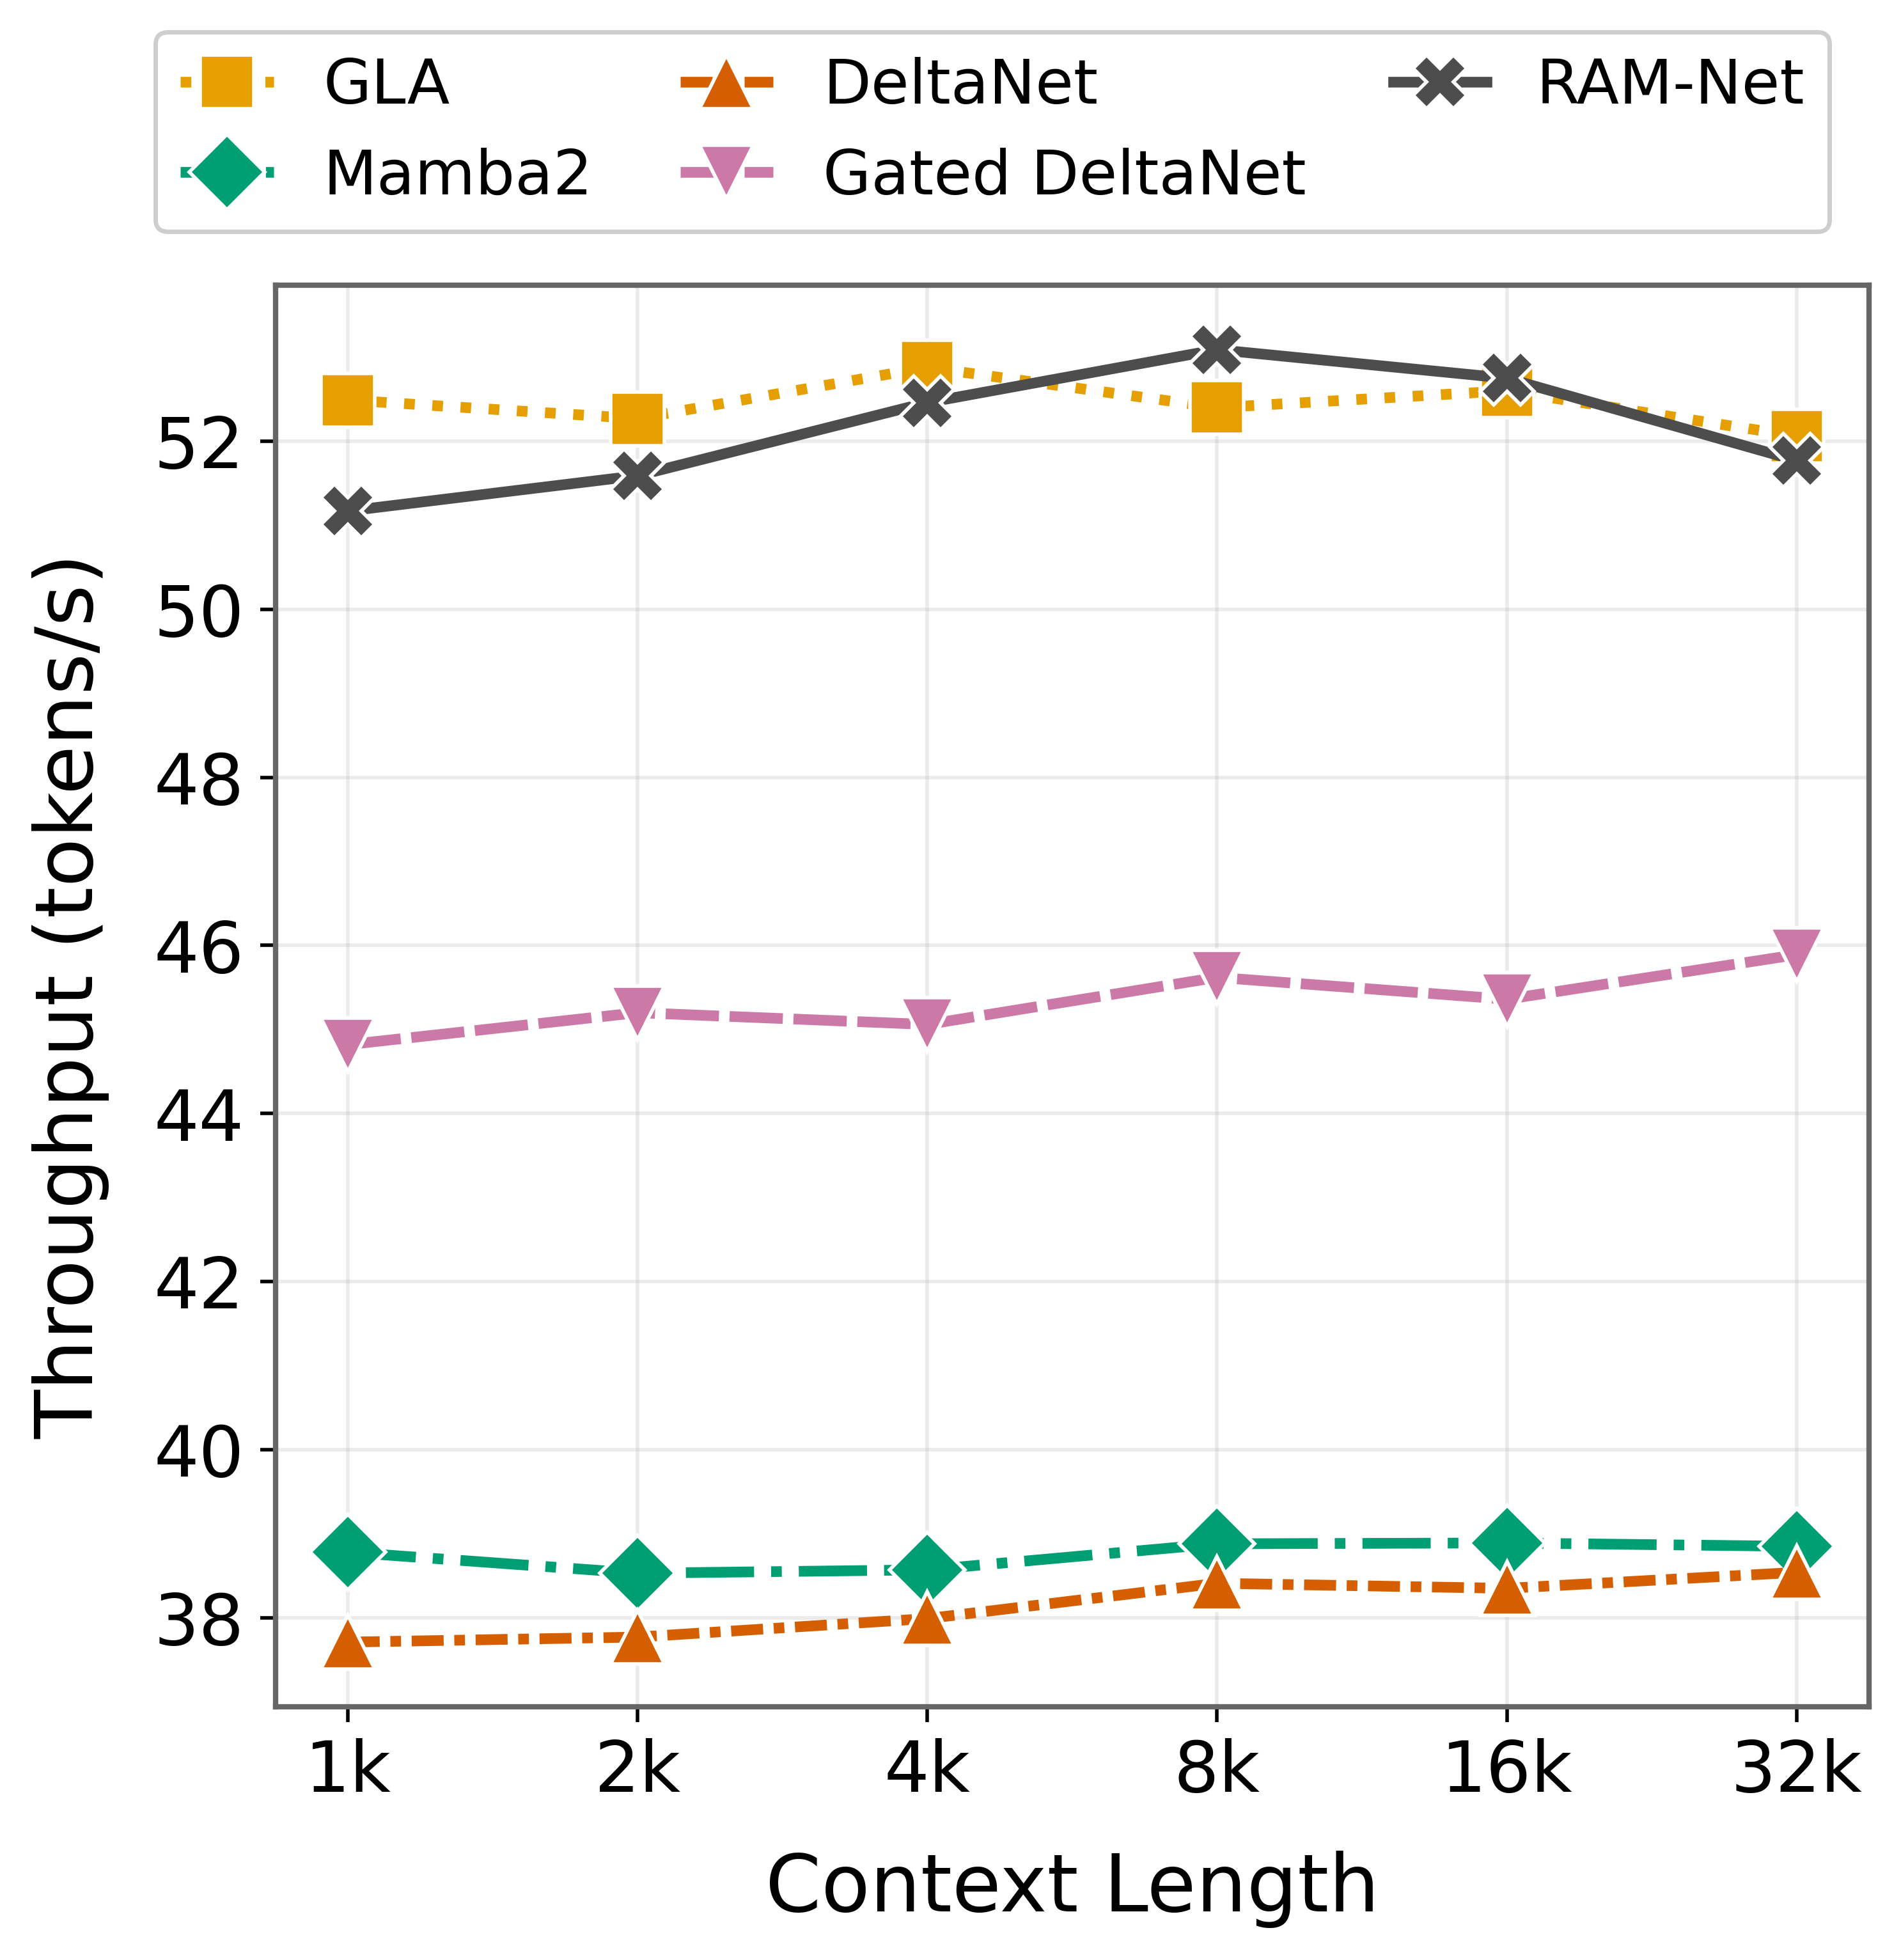
原文 Fig. 5,PDF p. 9。 GLA 因总状态较小而快,RAM-Net 则以较大的总状态、较少的每步槽位访问取得相近曲线;图中未画 Transformer++。
4.5 消融与访问轨迹解释了什么
附录 Fig. 6 在 MQAR 中分别改变乘积 Softmax 的阶数 $U$ 与槽位数:较大的 $U$ 通常提高准确率,尤其在较大槽位空间中,1024 槽的最佳点接近 0.98。该图支持乘积分解有助于训练大地址空间,而不只是减少搜索计算。(Appendix B,PDF pp. 14–15)
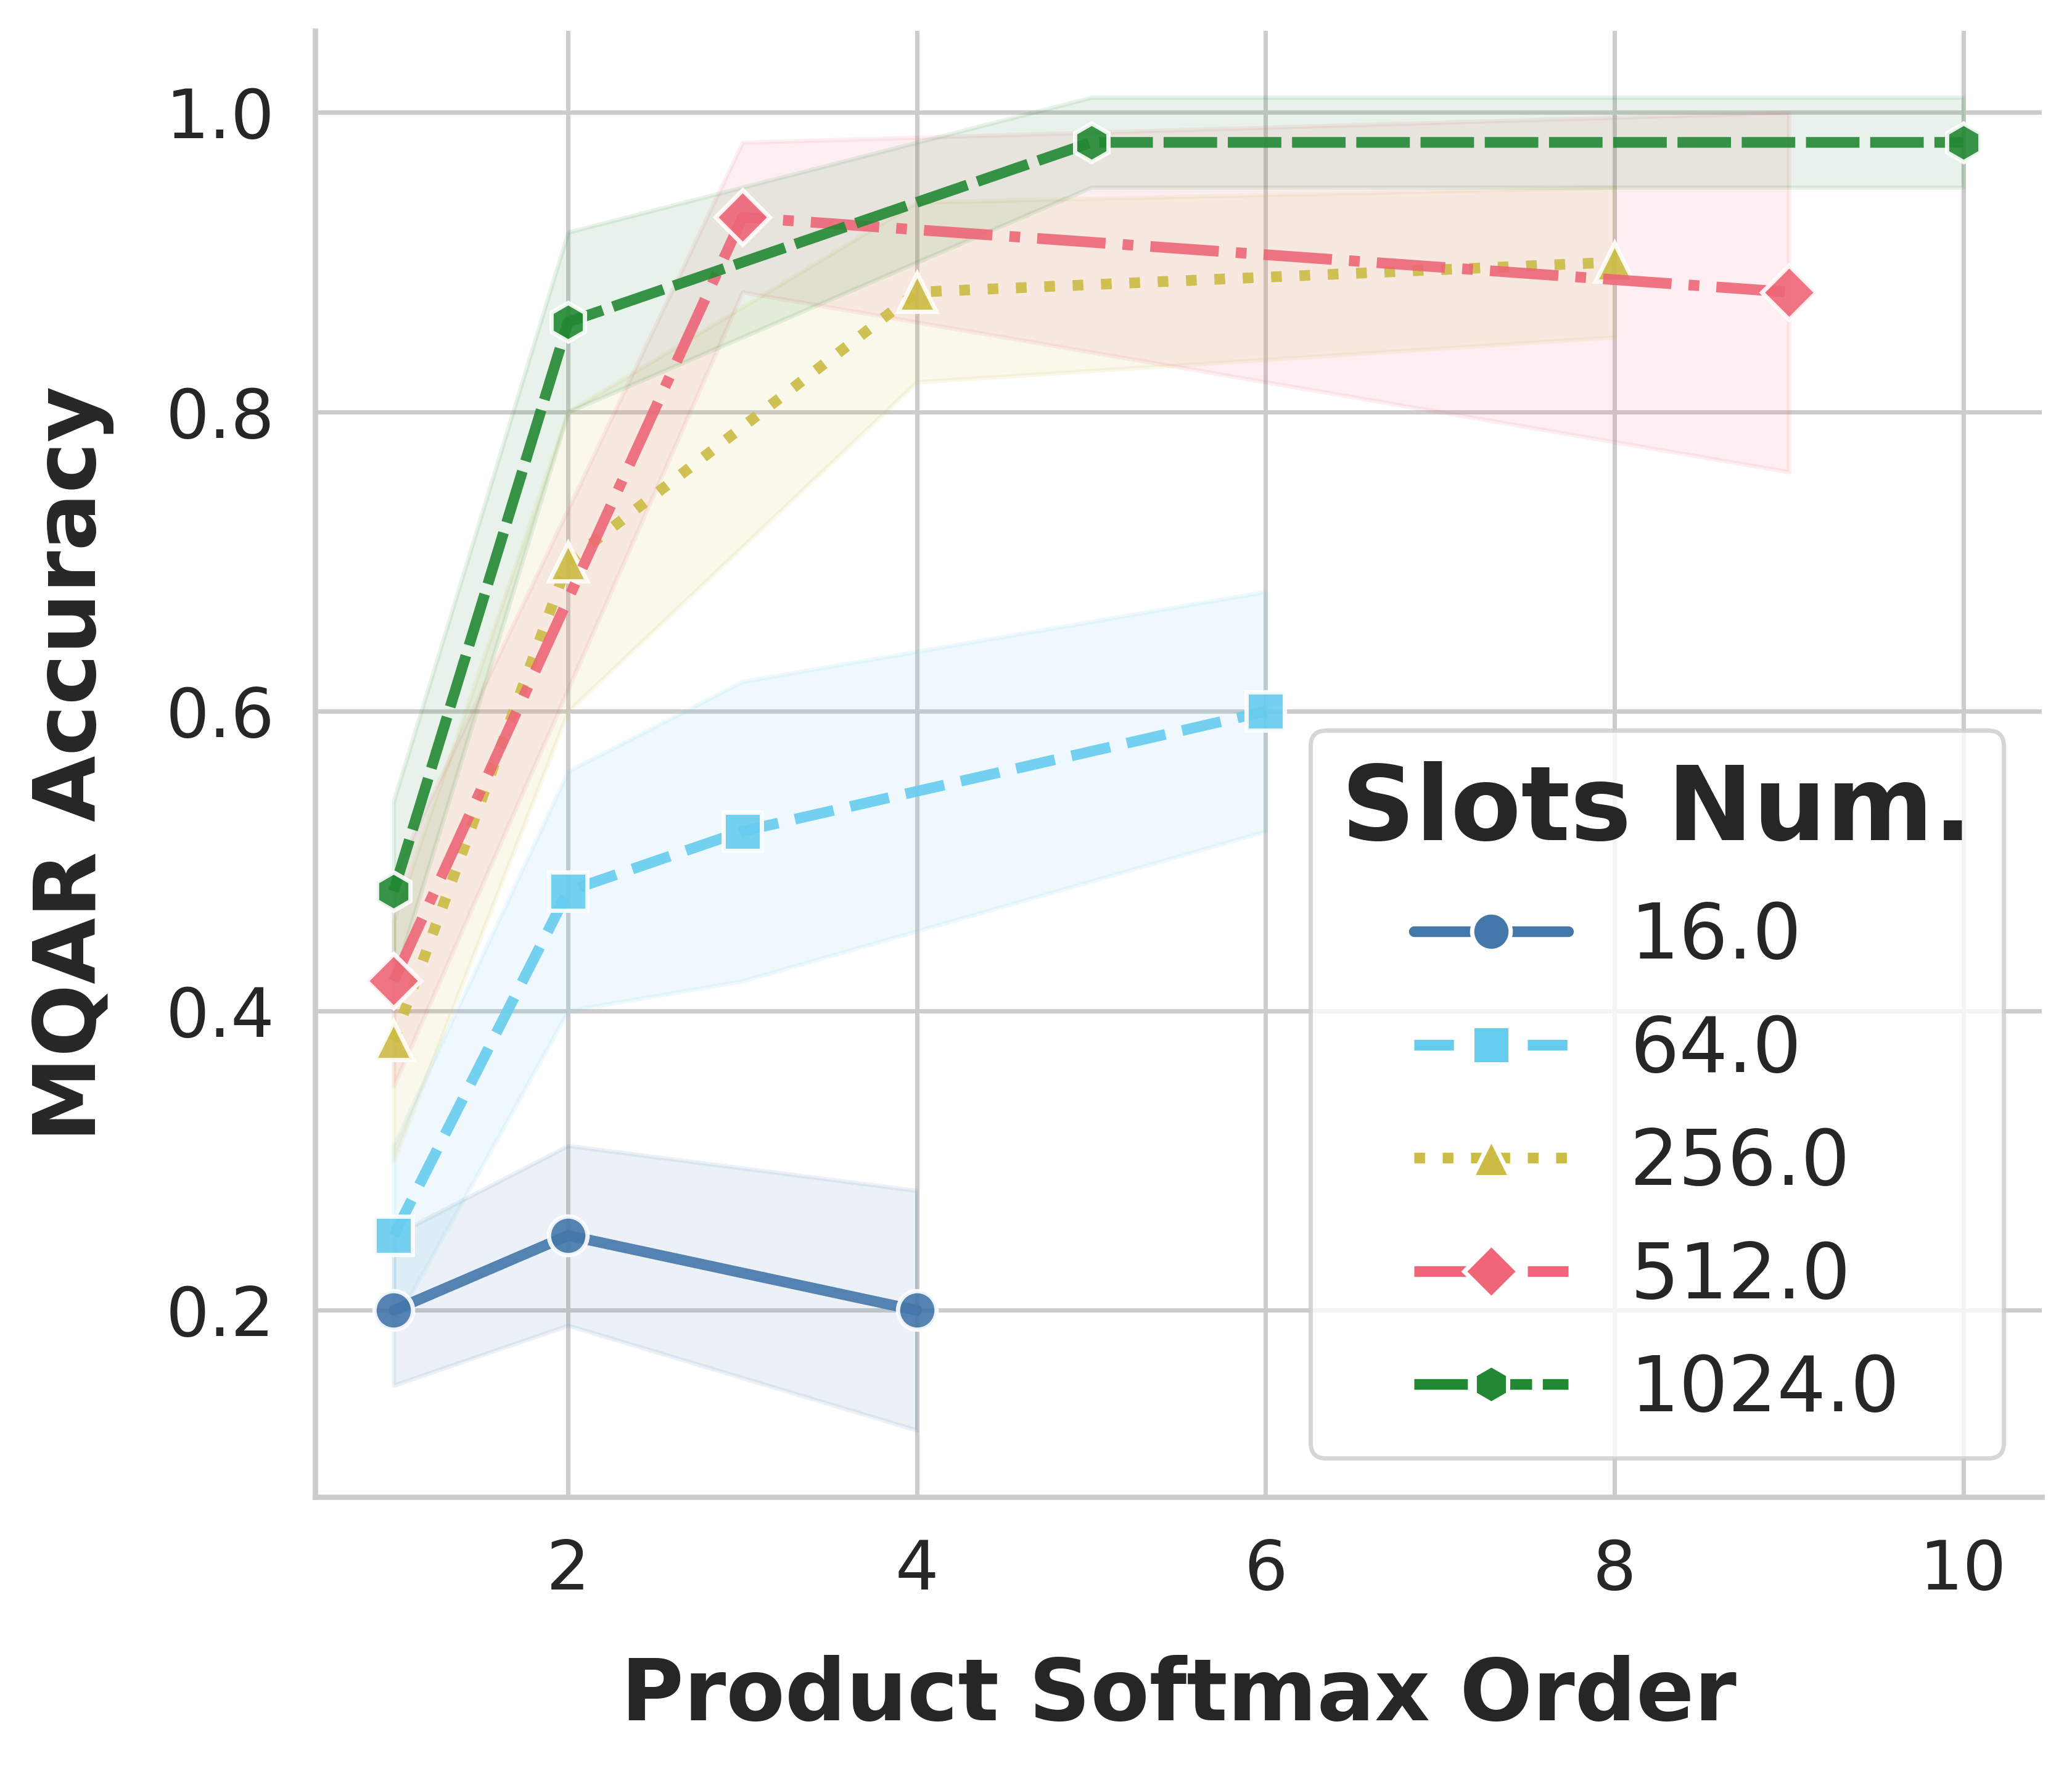
原文 Fig. 6,PDF p. 15。 横轴 $U$,不同线代表槽位数;阴影是原图给出的波动区域。
在 340M、4K S-NIAH 消融中,Top-8 到 Top-32 使 Wiki 困惑度由 26.89 降为 25.87,S-NIAH-2/3 的 4K 准确率由 83.7/18.3 升到 94.0/44.7。去掉输出 RMSNorm,S-NIAH-2 从 83.7 降到 16.3;全部头改 NoPE,S-NIAH-2/3 降到 43.0/8.7;对 Top-$K$ 权重重归一化也降到 63.7/12.0;加入槽位均衡损失降到 11.3/5.7。这些比较显示读出幅度、位置混合方式和非均匀槽位使用都是效果的一部分,不能把收益全部归于槽位数。(Table 5,PDF pp. 15–16)
附录 Fig. 7–8 的访问轨迹中,CAPE 头出现斜向访问带,NoPE 头出现固定槽位的集中带(Fig. 7 中为竖向,交换坐标轴的 Fig. 8 中为横向);部分 NoPE 槽位被大量 token 共用,其他槽位更有选择性。轨迹与 CAPE 的位移公式和内容寻址设计吻合,也提示常用槽位可能适合缓存优化。(Appendix C,PDF pp. 16–18)
五:结论与研究启发
RAM-Net 的关键不是单纯增大固定状态,而是把状态组织粒度与每步访问量解耦:$M=d_p^U$ 个槽位提供较大地址空间,Product Softmax 和精确前缀搜索只挑少数地址,CAPE 管位置相关重合,GSU 保证未寻址槽位不受写入与遗忘影响。这样的设计在论文评测的长程精细检索中取得优势,语言模型质量也保持竞争力。(Sec. 3–5,PDF pp. 3–9)
实际取舍集中在地址是否正确重合:减少槽位共用能抑制干扰,但相关内容若没有被 query 选中便无法读出。16K 的困难 S-NIAH 与真实文档回忆结果已经显示这一点。总状态存储仍随槽位数增加;作者只测试至 1.3B 参数,且稀疏随机访问在 GPU 上需要按槽位组织事件的专门实现。后续可研究按输入自适应的读写 $K$、更强的联合槽位更新,以及如何利用观察到的槽位访问偏斜安排存储层级。(Sec. 6–8、Appendix C,PDF pp. 9–10、17–18)