ParisKV:面向长上下文 LLM 的快速、抗漂移 KV Cache 检索——中文精读
原文:Yanlin Qi、Xinhang Chen、Huiqiang Jiang、Qitong Wang、Botao Peng、Themis Palpanas,ParisKV: Fast and Drift-Robust KV-Cache Retrieval for Long-Context LLMs,ICML 2026,arXiv:2602.07721v3。本次获取:2026-10-26。本地原文 PDF · 作者代码
论文总览
问题:自回归解码时,每个新 query 都要读取越来越长的 KV cache。只保留少数历史 token 可以节省带宽,但解码时才出现的新 key 会使预填充(prefill)阶段学到的聚类中心过时;把完整 KV 放到 CPU 后,CPU 检索和搬运又可能吃掉节省的时间。
做法:ParisKV 把完整精度 KV 留在 CPU,把每个 key 的方向中心编号、4-bit 方向码和校正权重留在 GPU。GPU 先用固定的、与训练数据无关的球面方向中心做多子空间碰撞筛选,再用压缩码估计原始 query–key 内积,对候选重排;最后只通过统一虚拟寻址(UVA)读取选中的 Top-$100$ 个 KV。Sink 和近期 Local token 仍在 GPU 做密集注意力。(Sec. 4,PDF pp. 3–6,Figs. 2、4、5)
结果:三组长生成推理模型 × 任务组合中,ParisKV 有 7/9 项准确率达到或超过全注意力;在 Llama3.1-8B、1024K 上下文、batch 1 的效率实验中,解码约 $49$ ms/step,相比 MagicPIG 的 $830$ ms/step 与 PQCache 的 $2179$ ms/step,分别约快 $16.9\times$ 与 $44.4\times$。后一个比较发生在全注意力已 OOM 的规模;不同方法采用论文推荐的检索预算,不能解释成等 Top-$k$ 的算法单独比较。(Sec. 5,PDF p. 7;Appendix D,PDF pp. 18–20)
结构地图
| 原文章节 | 解决的问题 | PDF 位置 |
|---|---|---|
| 1 Introduction;2 Related Work | 动机、漂移现象、与丢弃/检索方法的关系 | pp. 1–3,Fig. 1 |
| 3 Background and Problem Formulation | 全注意力与 Top-$k$ 近似目标 | p. 3,Eqs. (1)–(3) |
| 4 The ParisKV Framework | 预处理、中心、量化重排、在线更新、UVA 与复杂度 | pp. 3–6,Figs. 2–5,Eqs. (4)–(12) |
| 5 Experimental Evaluation;6 Conclusions | 准确率、效率、消融和结论 | pp. 6–8,Tables 1–3,Figs. 6–10 |
| Appendix B、D | 量化先验、碰撞打分、重排推导、完整实验 | pp. 14–20,Eqs. (15)–(21),Tables 4–7,Fig. 11 |
一:动机与检索目标
对一个注意力头,令当前 query 为 $\mathbf q\in\mathbb R^D$,历史 key/value 为 $(\mathbf k_i,\mathbf v_i)_{i=1}^{n_t}$。全注意力使用所有 $n_t$ 个 key 的分数 $s_i=\langle\mathbf k_i,\mathbf q\rangle$,即 $\mathbf o=\sum_i\operatorname{softmax}(s)_i\mathbf v_i$。ParisKV 要找一个小集合 $\mathcal C(\mathbf q)$,只对集合内的原始完整精度 KV重新计算 softmax 和输出。检索的关键是覆盖真正重要的高分 key;只是找到几个方向相近的向量还不够。(Sec. 3,PDF p. 3,Eqs. (1)–(3))
论文把难点归为三个相连的环节:便宜的粗检索召回差;基于 prefill keys 学出的中心随长时间解码变旧;CPU 侧检索和搬运让稀疏注意力失去延迟优势。Fig. 1(a) 的 AIME 示例中,ParisKV、MagicPIG、PQCache 的 Recall@100 分别标为 $81.9\%$、$2.6\%$、$10.0\%$;Fig. 1(b) 展示仅用 prefill keys 聚类得到的中心与用 prefill+decode keys 得到的参照中心分离。它是作者提出抗漂移设计的经验动机,不能单凭中心图断定全部性能差距都由漂移造成。(Sec. 1,PDF p. 1,Fig. 1)
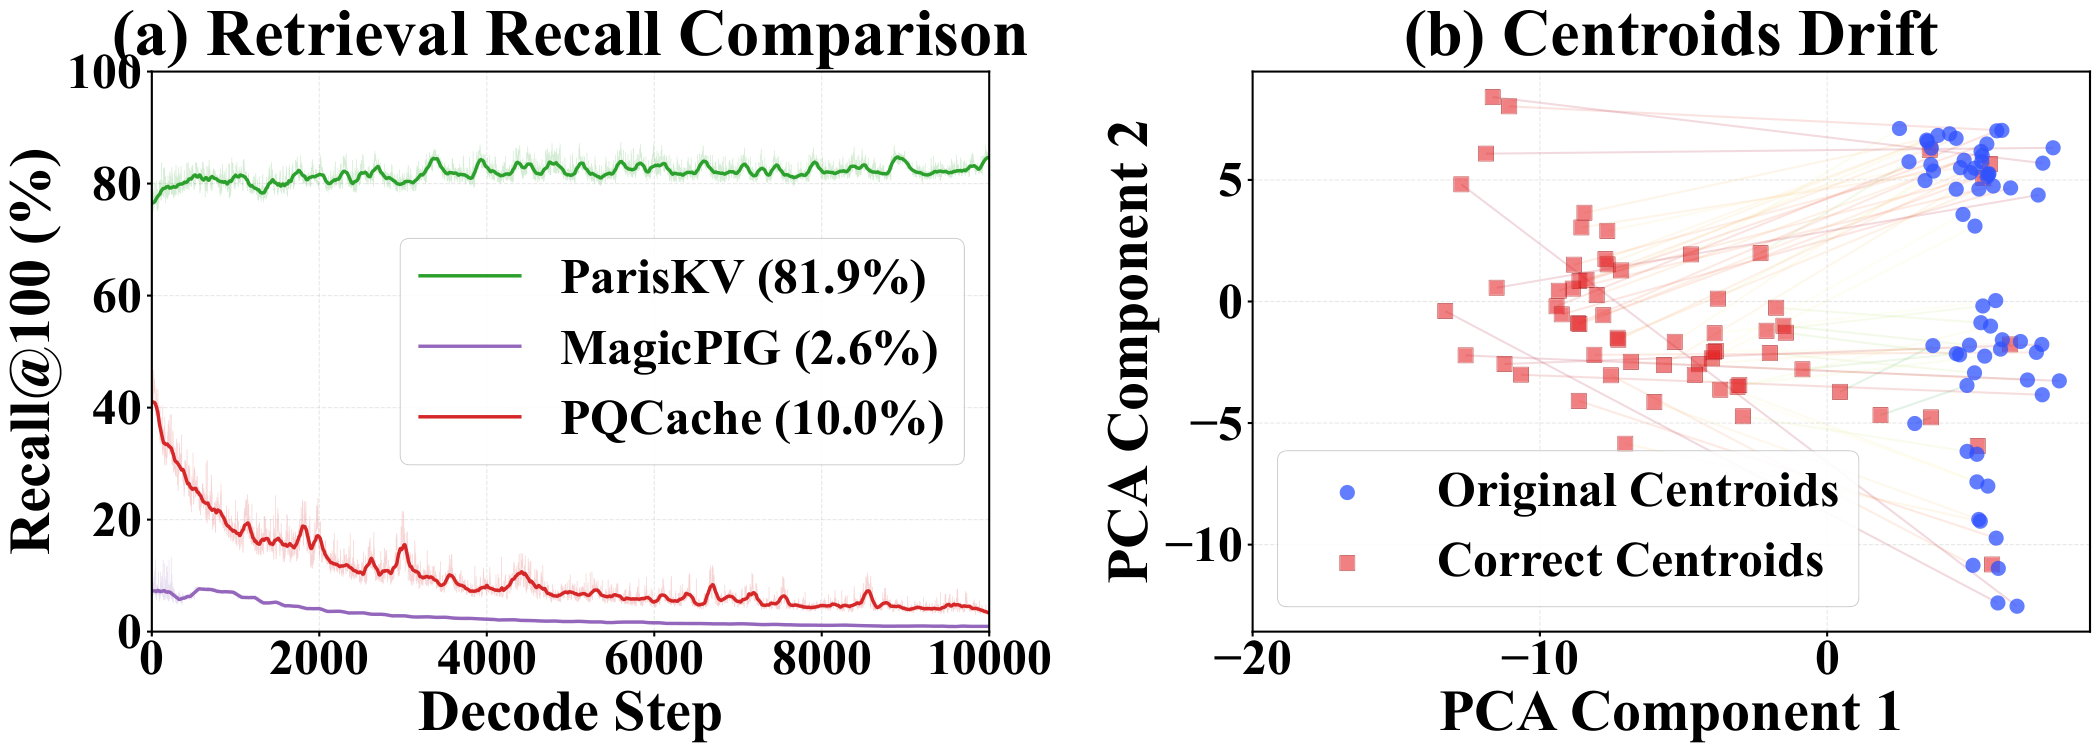
原文 Fig. 1,PDF p. 1。左图横轴是解码步数、纵轴是 Recall@100;右图比较两套聚类中心的位置。
二:方法
2.1 两种存储与两段检索
预填充阶段为每个历史 key 生成 GPU 常驻元数据,同时将完整精度 $(\mathbf k_i,\mathbf v_i)$ 异步移入 CPU 内存。解码阶段,GPU 先按中心编号给历史 key 投票,留下约 $\beta n$ 个候选;再用 4-bit 码对候选估计原始注意力分数,挑出 $k=100$ 个;UVA 内核按需取回这些 KV 做注意力。新增 token 先进入 GPU Update Buffer,窗口满时才批量编码并移入 Retrieval 区。(Sec. 4,PDF pp. 3–6,Figs. 2、5)
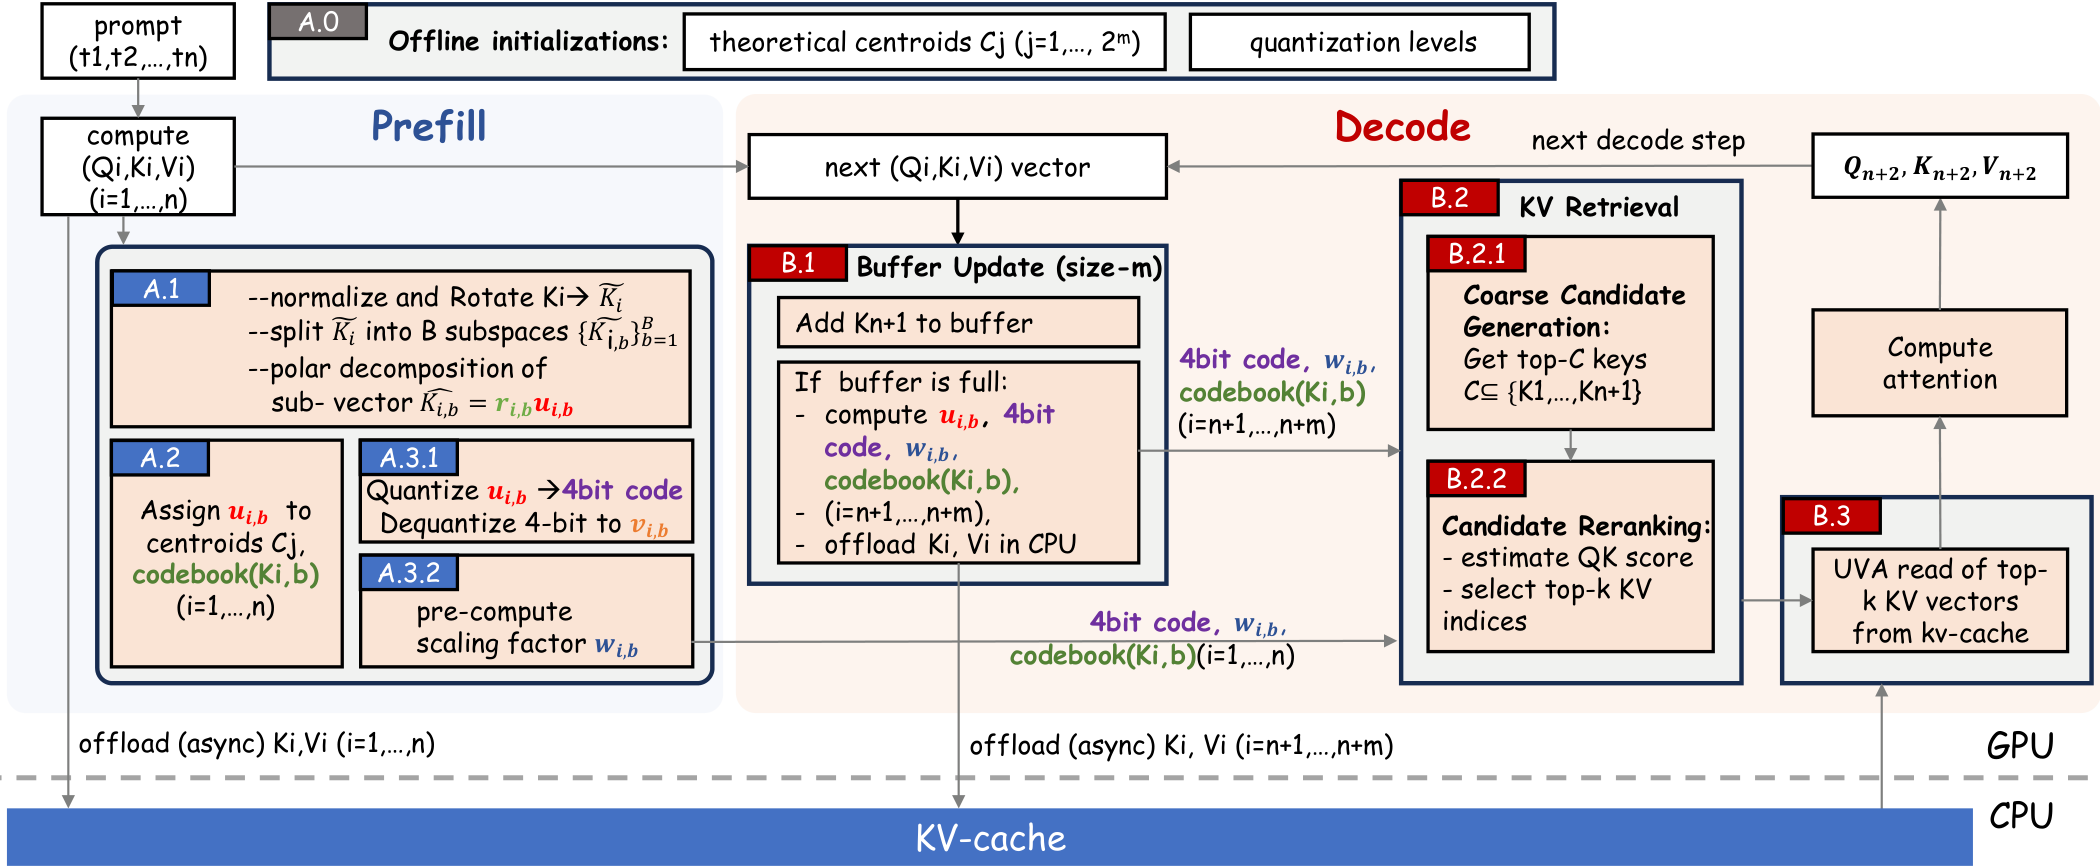
原文 Fig. 2,PDF p. 4。蓝色 prefill 路径产生压缩索引;红色 decode 路径完成筛选、重排、取回。虚线以下是 CPU 中的完整 KV。
2.2 归一化、旋转与固定方向中心
先把 key/query 分别归一化为 $\hat{\mathbf k}_i=\mathbf k_i/\|\mathbf k_i\|_2$、$\hat{\mathbf q}=\mathbf q/\|\mathbf q\|_2$,再用共享正交变换 $R$ 得到 $\tilde{\mathbf k}_i=R\hat{\mathbf k}_i$、$\tilde{\mathbf q}=R\hat{\mathbf q}$。由于 $R^\top R=I$,归一化内积不变;解码时要估计原始 $\mathbf k_i^\top\mathbf q$,所以后面必须把两者的模长乘回去。实现采用快速的 SRHT 旋转,意图是把坐标分布摊平,使固定中心对新 key 也可用。(Sec. 4.1.1,PDF pp. 3–4)
把维度 $D$ 切成 $B$ 个 $m=D/B$ 维子空间。每个子空间的方向中心固定为
它们覆盖全部正负号模式,无需在 prefill 数据上重新聚类。对单位方向 $\mathbf u_{i,b}=\tilde{\mathbf k}_{i,b}/r_{i,b}$($r_{i,b}=\|\tilde{\mathbf k}_{i,b}\|_2$),存储使 $\mathbf u_{i,b}^\top\boldsymbol\omega$ 最大的中心编号。教学例子:$m=3$ 时有立方体八个顶点方向,符号为 $(+,+,-)$ 的向量自然落到对应象限中心。固定码本免除了“旧中心不代表新 key”的问题,但不意味着所有方向都能被无误差地表示。(Sec. 4.1.2,PDF pp. 4–5,Eqs. (5)–(6))
2.3 第一阶段:多子空间碰撞筛选
对每个子空间 $b$,用 query 与 key 所属中心的廉价相似度挑出排名前 $\rho$ 比例的 key;入选者按相似度档位领 $6,5,4,3,2,1$ 中的整数加分,其余记零。跨 $B$ 个子空间相加得到
$T_b(\rho)$ 是子空间 $b$ 中入选的 key,$\ell$ 为档位。六档在前 $\rho$ 内按 $5\%,15\%,30\%,50\%,75\%,100\%$ 的累计百分位划分。比单纯的“碰撞次数”多几档,可减少大量 key 同分,使 Top-$\beta$ 截断稳定;实现用小整数直方图和前缀扫描的 bucket_topk,避免全量排序。通常 $\beta=5\%$–$10\%$,并设 $\rho\ge\beta$;$\beta$ 仍需随 KV 长度调整,因为短 cache 若取很小比例,候选可能容不下真正的 Top-$100$。(Sec. 4.2.2;Appendix B.2.1,PDF pp. 5、15,Eq. (15);Fig. 9,p. 8)
2.4 第二阶段:4-bit 方向码重排
每个子空间的单位方向 $\mathbf u_{i,b}$ 按坐标使用 1 bit 符号 + 3 bit 幅值编码,反量化为 $\mathbf v_{i,b}$。幅值的八个重建值来自离线 Lloyd–Max 标量量化。作者从随机旋转的先验推导:若 $R$ 是 Haar 随机正交矩阵,则子空间能量 $r_b^2\sim\mathrm{Beta}(m/2,(D-m)/2)$,单位子空间方向单坐标的平方 $(u_b)_j^2\sim\mathrm{Beta}(1/2,(m-1)/2)$。因此幅值 $|(u_b)_j|$ 的理论分布只依赖 $m$,可以共享量化阈值。实际 SRHT 只近似这种各向同性;这一步是理论先验指导的工程近似。最终系统不量化半径,而把精确子空间半径吸收入下式权重。(Proposition 4.1,PDF p. 6,Eqs. (11)–(12);Appendix B.1,PDF p. 14)
设 $\alpha_{i,b}=\langle\mathbf v_{i,b},\mathbf u_{i,b}\rangle$ 衡量量化方向与真方向的对齐。作者采用 $\langle\mathbf u_{i,b},\tilde{\mathbf q}_b\rangle\approx\langle\mathbf v_{i,b},\tilde{\mathbf q}_b\rangle/\alpha_{i,b}$;这是一种重排估计式,不是对任意 query 的恒等式。将 key 的模长、子空间半径和校正项预计算为 $w_{i,b}=\|\mathbf k_i\|_2r_{i,b}/\alpha_{i,b}$ 后,在线分数为
它仍在估计 softmax 前的原始内积,因此不同 key 的范数会影响排序。只有最终 Top-$100$ 才取回完整 KV;重排本身不需要访问 CPU 原始 key。作者把候选收集、解码和打分融合成 CUDA 内核。(Sec. 4.1.3、4.2.2,PDF pp. 5–6,Eqs. (7)–(10);Appendix B.2.2,PDF pp. 15–16)
2.5 在线窗口与复杂度
Sink 区保存早期高关注 token,Local 区保存近邻 token,二者在 GPU 做密集注意力;Retrieval 区保存历史完整 KV 的 CPU 副本和 GPU 索引;Update Buffer 暂存最新生成 token,按窗口大小批量转入 Local,同时把被挤出的旧 Local 编码并迁往 Retrieval。作者说明这样分摊逐 token 更新索引的成本;实验中 Update 为 256 或 512 token。(Sec. 4.2.1,PDF p. 5,Fig. 5;Table 1,p. 6;Appendix D.2,p. 19)
论文给出的代价分解是:原本对 $|S|+n$ 个 key 做完整维度 $D$ 的密集评分,变成对 $|S|$ 做密集注意力、对历史 $n$ 的压缩元数据做碰撞筛选、对 $C=\lceil\beta n\rceil$ 个候选做 4-bit 重排,再取回 $k\ll C$ 个 KV。加速并非把历史扫描完全消掉;候选数仍随 $n$ 增长,优势来自更少的字节、融合内核、按需取回以及固定小范围整数排序。(Sec. 4.3,PDF p. 6)
三:实验设计与比较口径
准确率实验覆盖三类模型(Qwen3-4B-Thinking-2507、DeepSeek-R1-Llama-8B、Qwen3-8B)和两类任务:长生成推理 GPQA-Diamond、MATH500、AIME25,以及长输入理解 LongBench-V2;附录另给 Llama3.1-8B 在 128K 的 RULER。GPQA-Diamond、MATH500 报 pass@1,AIME25 报 pass@8;LongBench-V2 按总体准确率及长短/难易分组。指标均是越高越好。(Sec. 5.1,PDF pp. 6–8,Tables 2–3;Appendix D,pp. 17–19,Tables 5–6)
ParisKV 在全部准确率实验固定取回 Top-$100$;PQCache 用论文推荐的 $20\%$ 压缩率,MagicPIG 用随长度变化的策略。作者尽可能让其他方法的有效检索预算不小于 ParisKV,并用各实现的推荐配置。长生成比较时,作者修改了 MagicPIG,使解码新增的 key 也进入 Top-$k$ 候选,而不是像原实现那样总留在全注意力内;因此比较的是该评估改版。(Sec. 5 开头;Appendix D.1,PDF pp. 6、16–17)
效率实验采用 Llama3.1-8B、Qwen3-8B,以 LongBench-V2 的 easy+long 样本构造 64K–1024K 上下文;batch 扩展实验与单 batch 长上下文实验分开。单 batch 基线包含全注意力(FlashAttention-2)、MagicPIG、PQCache;PQCache 无多 batch 吞吐实现,因此批量扩展图只与全注意力比。效率设置的 Sink=128、Local=512;这与准确率 Table 1 中按任务变化的 Local/Update 配置不是同一组参数。报告预填充时间(s)、解码 TPOT(ms/step)和吞吐(tokens/s)。(Appendix D.1.2,PDF p. 18)
四:结果与解释
4.1 长生成:增益在 AIME25 最明显
| 模型 | 全注意力 | PQCache | MagicPIG | ParisKV |
|---|---|---|---|---|
| Qwen3-4B | 86.67 | 3.33 | 6.67 | 80.00 |
| DS-R1-Llama-8B | 50.00 | 13.30 | 13.30 | 53.30 |
| Qwen3-8B | 83.33 | 16.67 | 10.00 | 73.33 |
AIME25 pass@8,单位为百分数,越高越好;原文 Table 2,PDF p. 7。AIME 最长生成约 38.9K token(Table 1,p. 6)。
ParisKV 相比 PQCache 在三行分别高 $76.67$、$40.00$、$56.66$ 个百分点。Qwen3-4B 的 GPQA-Diamond / MATH500 为 $72.22/92.80$,PQCache 为 $38.38/58.80$,全注意力为 $64.14/88.60$。按 Table 2 九个“模型 × 推理任务”单元统计,ParisKV 在 7 项达到或高于全注意力;两项低于全注意力的是 Qwen3-4B 与 Qwen3-8B 的 AIME25。论文把长生成优势解释为稳定检索减轻了逐步积累的错误,Fig. 1 与 Fig. 10 的召回趋势支持这一机制。(Sec. 5.1,PDF p. 7,Table 2)
4.2 长输入:在基线中领先,但不总高于全注意力
| LongBench-V2 总准确率 | 全注意力 | PQCache | MagicPIG | ParisKV |
|---|---|---|---|---|
| Qwen3-4B | 25.84 | 17.91 | 16.70 | 24.60 |
| Qwen3-8B | 33.59 | 25.50 | 10.34 | 33.07 |
| DS-R1-Llama-8B | 13.12 | 19.90 | 13.92 | 28.43 |
LongBench-V2 with CoT,总体准确率(%),越高越好;原文 Table 3,PDF p. 8。
ParisKV 在三组中均胜过 PQCache 和 MagicPIG;但 Qwen3-4B、Qwen3-8B 的总体分数分别比全注意力低 $1.24$、$0.52$ 个百分点。DS-R1-Llama-8B 的 $28.43$ 明显高于全注意力的 $13.12$;这只是该实验设置下的观察,论文没有把“稀疏注意力为何在该模型上提升准确率”单独验证为因果机制。附录扩展基线后,ParisKV 在 DS 模型仍是最高总体分数,Qwen 两组则只是接近较强方法。(Sec. 5.1,PDF p. 8;Appendix D.1.1,PDF p. 19,Table 5)
RULER 128K 的 Llama3.1-8B 结果进一步显示:ParisKV 平均 $83.49$,全注意力 $84.12$,高于列出的其他稀疏/检索方法(如 ShadowKV $80.29$);但个别子任务仍有较大差距,如 fwe 为 $56.25$ 对全注意力 $71.18$。(Appendix D.1.1,PDF p. 19,Table 6)
4.3 系统效率:大上下文的带宽与内存优势
在 Llama3.1-8B、batch 1、1024K 上下文,Fig. 8(a) 与正文给出下表;这些是单步解码延迟,不是预填充时间。纵轴为对数刻度,数值越低越好。(Sec. 5.2,PDF pp. 7–8,Fig. 8;Appendix D.2,p. 20)
| 方法 | 解码延迟(ms/step) | 相对 ParisKV |
|---|---|---|
| ParisKV | 49 | 1.0× |
| MagicPIG | 830 | 16.9× |
| PQCache | 2179 | 44.4× |
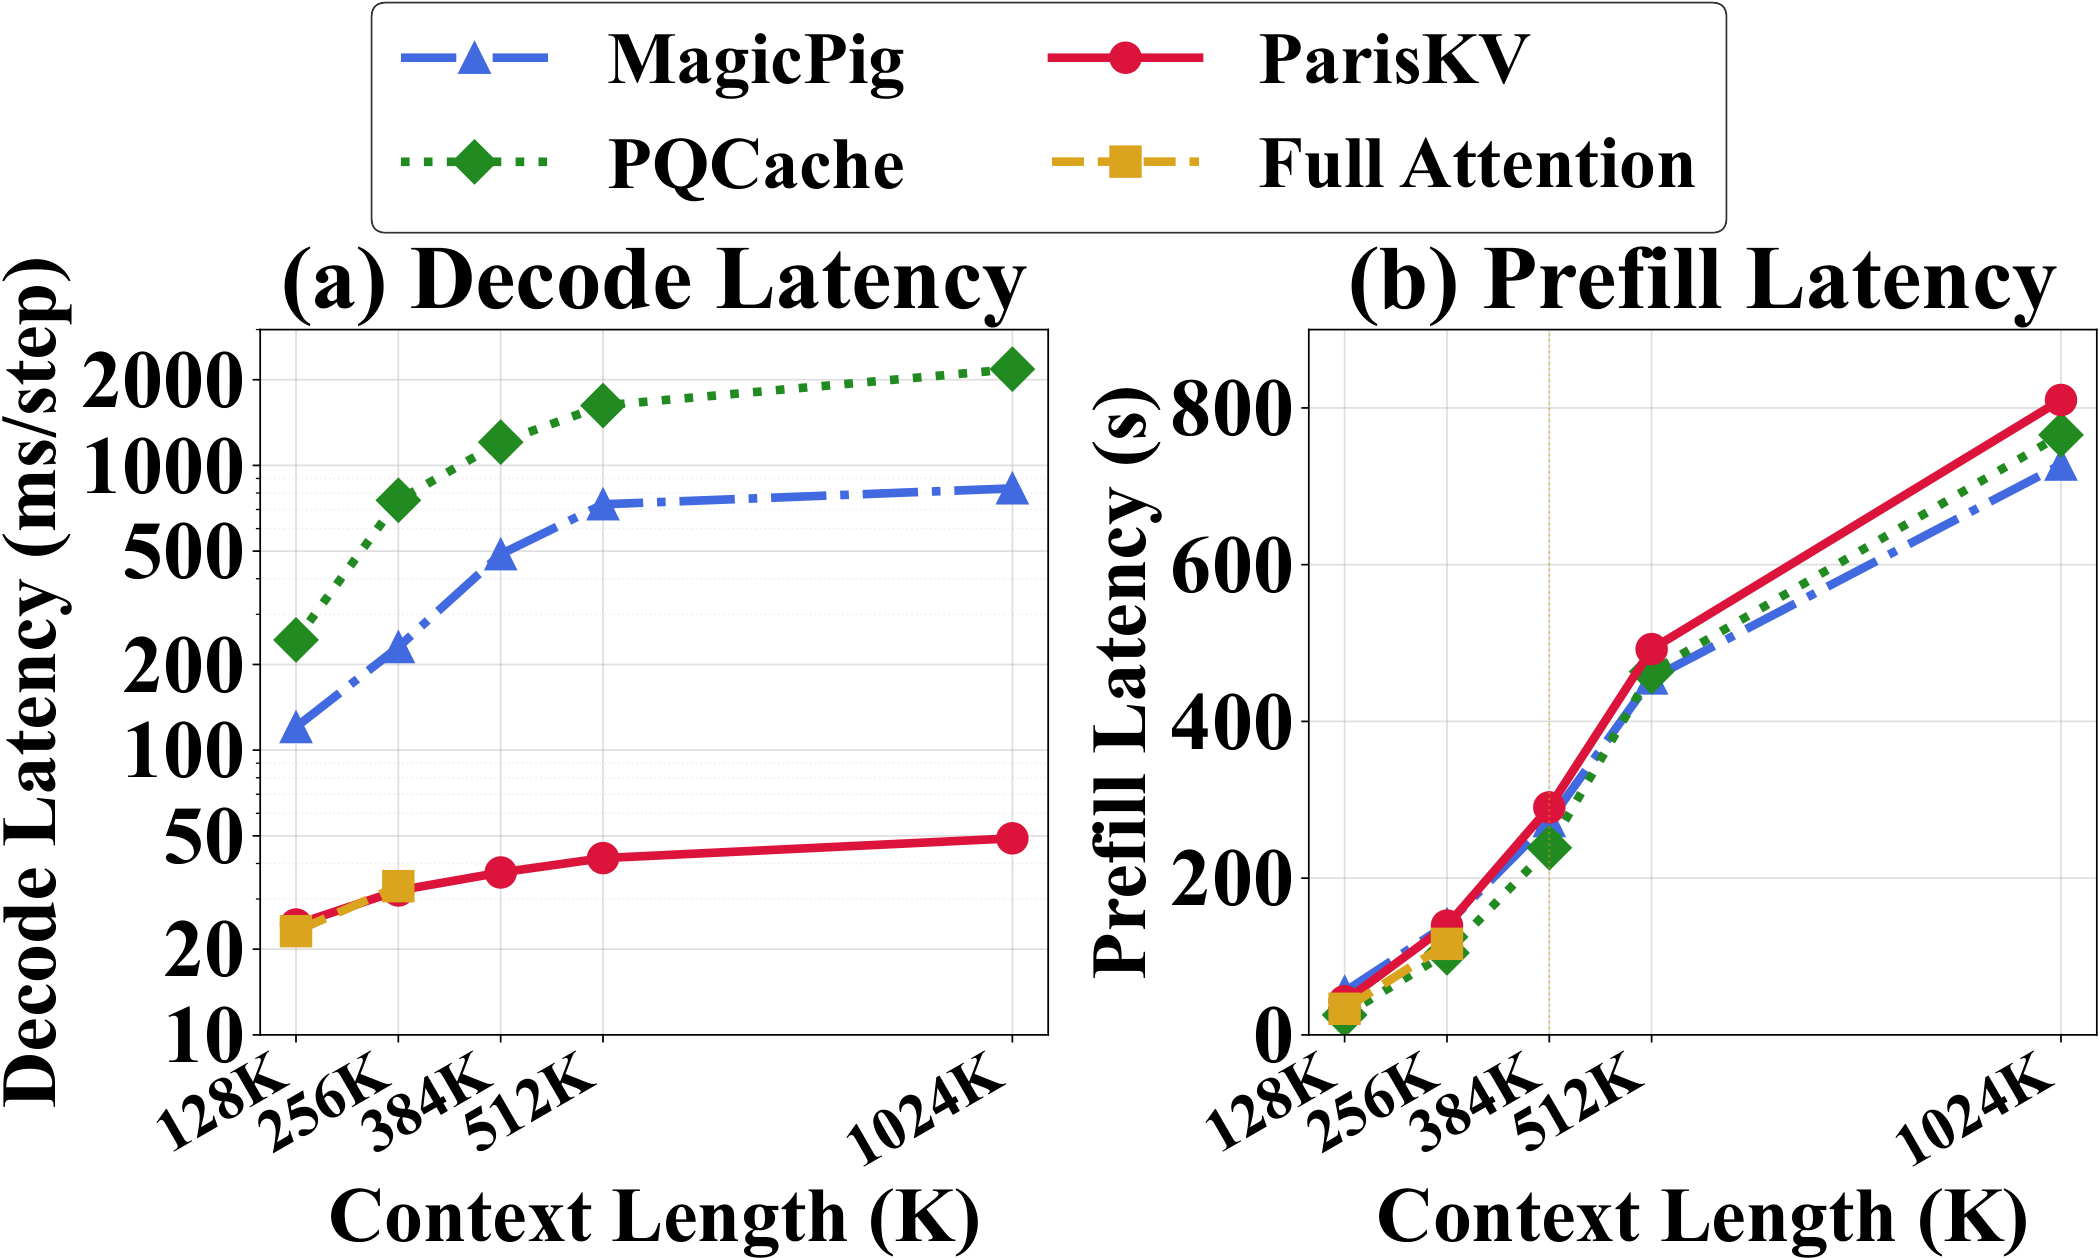
原文 Fig. 8,PDF p. 8;左图对数纵轴为解码 ms/step,右图线性纵轴为 prefill s。ParisKV 的预填充曲线并非最低,解码节省会随生成长度累计。
吞吐图在 64K/128K/256K 的可比较规模上报告相对全注意力的峰值提升:Llama3.1-8B 为 $2.3/2.1/2.7\times$,Qwen3-8B 为 $2.3/2.2/2.8\times$;这组“峰值”比较的是各自可运行 batch 的最高吞吐。128K 时全注意力 batch $\ge4$ OOM,而 ParisKV 可到 batch 8;256K 时全注意力 batch $\ge2$ OOM,而 ParisKV 到 batch 5;384K 时全注意力 batch 1 已 OOM。Fig. 6 的微基准还报告碰撞内核在 256K 比 Torch 实现快 $9.2\times$、UVA 取回约快 $40\times$、融合重排约快 $3$–$4\times$,它们与端到端提升不能直接相乘。(Fig. 6–7,PDF p. 8;Appendix D.2,PDF p. 19)
批量外的延迟比较也有条件差别:Appendix Table 7 的 128K、batch 1 设置中 ParisKV 解码 $24.42$ ms/step,全注意力 $23.13$,而 256K 时为 $32.16$ 对 $33.29$。因此“batch 1 不慢于全注意力”不是该论文每个测量点都成立;其主要效率优势发生在更长上下文、更大 batch 或全注意力 OOM 时。(Appendix D.1.2,PDF p. 20,Table 7)
4.4 机制检验:召回提升与候选预算
Fig. 10 把固定/学习中心的粗筛与归一化 + 旋转 + 理论中心的组合对比。10K 解码步轨迹上,粗阶段 Recall@100 平均从 $6.0\%$ 到 $16.1\%$,两阶段最终 Recall@100 从 $36.5\%$ 到 $64.3\%$;论文把它用作抗漂移设计的消融证据。注意它衡量的是特定实验中的 Top-$100$ 检索召回,与生成任务 pass@8 不是同一指标,也与 Fig. 1 的不同设置不能直接拼成同一组统计。(Sec. 5.3,PDF pp. 7–8,Fig. 10)
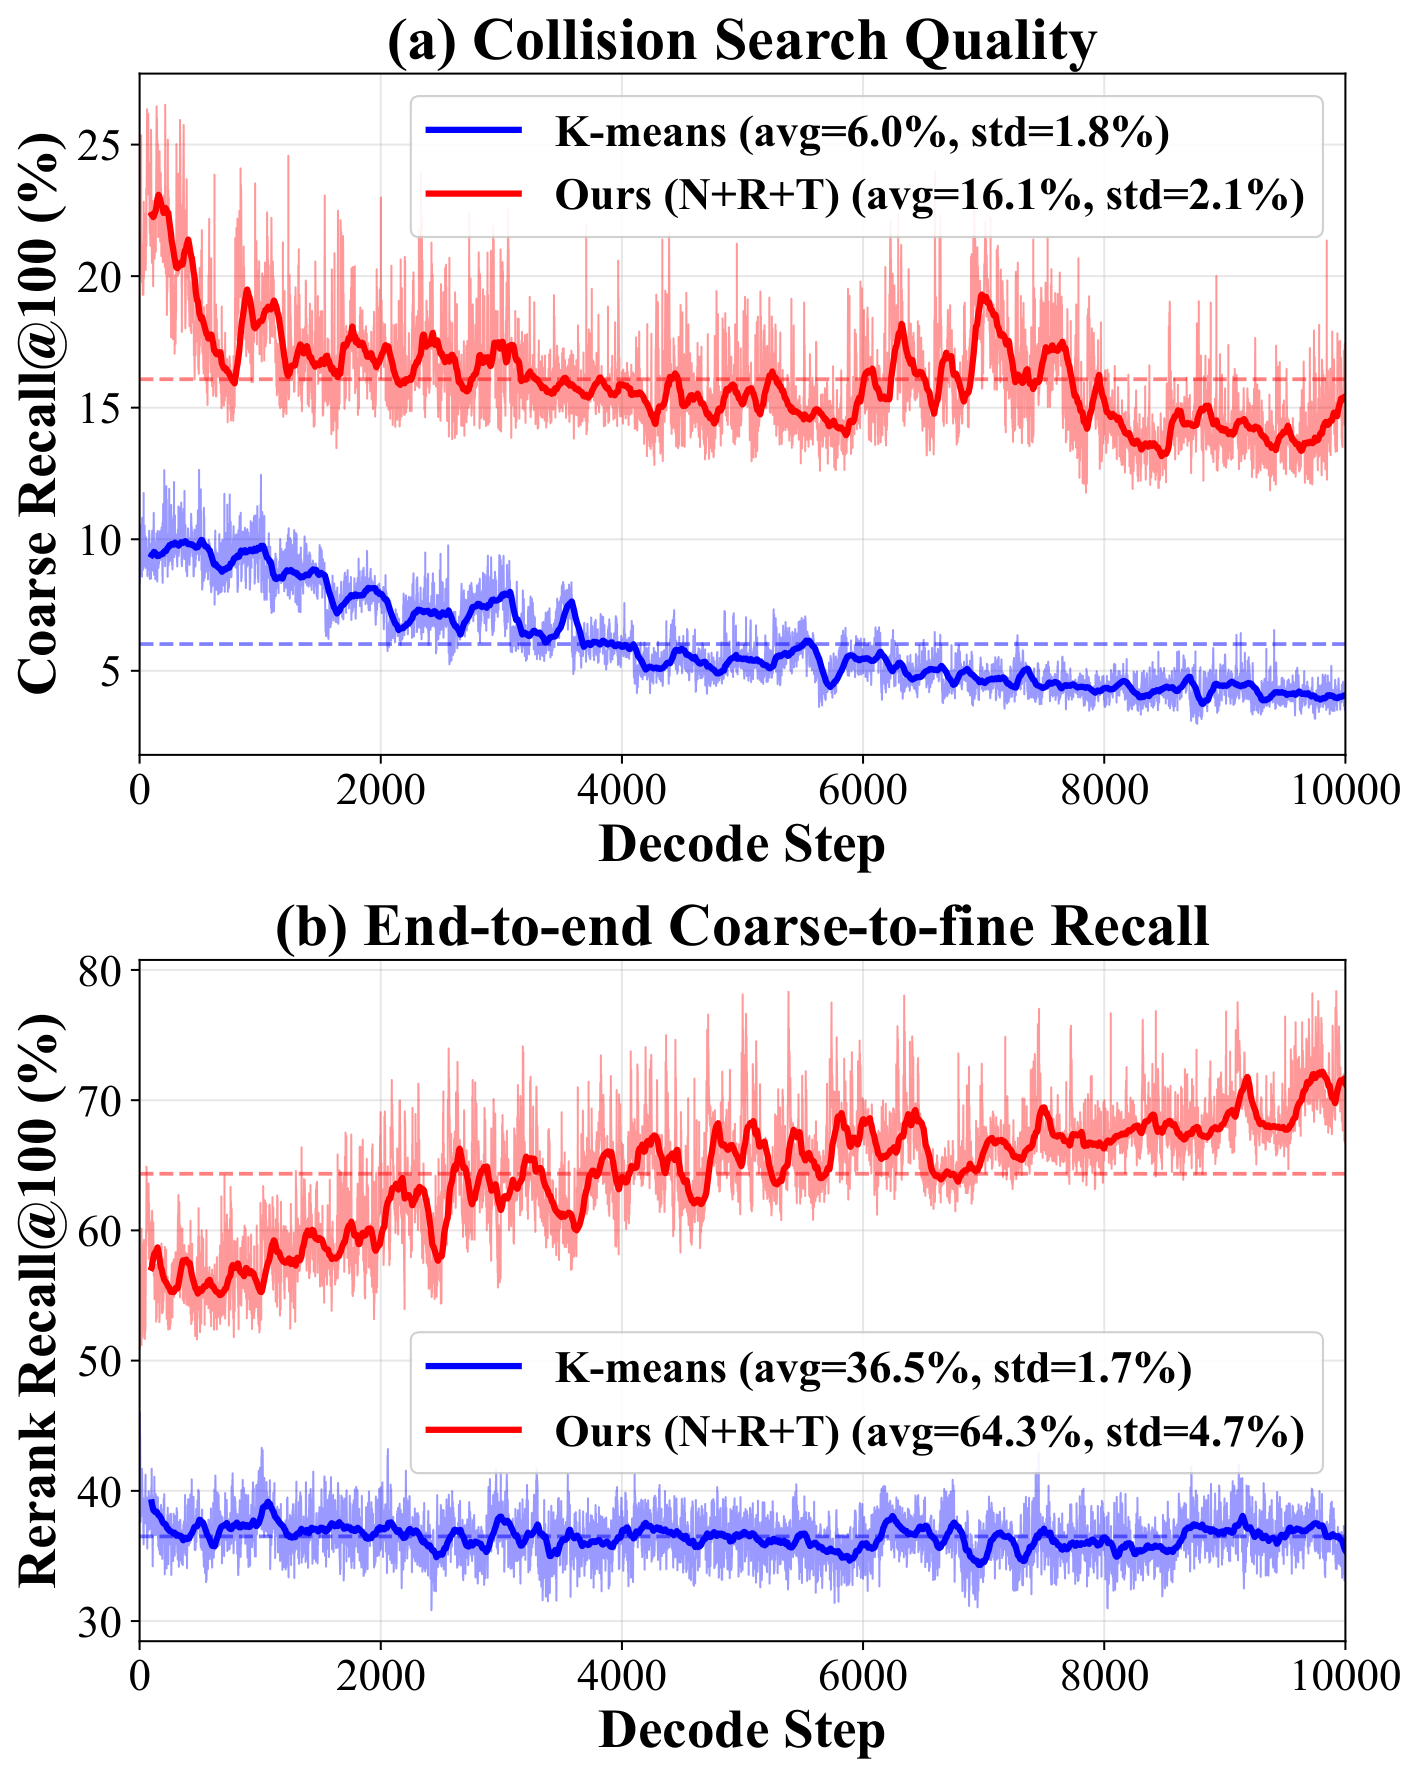
原文 Fig. 10,PDF p. 8。红色为归一化 + 旋转 + 理论中心;蓝色为 K-means。上面是粗筛召回,下面是两阶段召回;图例中的均值和标准差来自该条轨迹的统计。
Fig. 9(a) 显示候选比例 $\beta$ 越大,召回越高、重排成本也越大;(b) 显示同一目标召回所需 $\beta$ 随 KV 长度变化。这解释了为何作者给 $5\%$–$10\%$ 的常用候选范围,而不把它视为不变常数。(PDF p. 8,Fig. 9;Appendix B.2.1,p. 15)
五:结论与阅读判断
ParisKV 的有效组合是:固定球面方向中心避免随 prefill 数据过时,GPU 上的碰撞 + 4-bit 校正重排保持较高 Top-$k$ 召回,CPU 容量 + UVA 只按需搬运最终 KV。 这种设计针对长解码与超长输入的内存瓶颈,在论文报告的模型和预算下同时取得明显延迟优势与较强任务准确率。
理解和复现时有三处关键边界。其一,Beta 先验严格推导针对 Haar 随机旋转;实现用 SRHT,依赖近似各向同性。其二,“完整 KV 在 CPU”仍需足够 CPU 内存和预填充/迁移时间;作者报告 384K 批量扩展受可用 CPU 内存约 167GB 限制,Table 7 的预填充也有额外成本。其三,检索质量不是无损:Fig. 10 的最终 Recall@100 平均 $64.3\%$,LongBench 两组 Qwen 和 RULER 某些子任务仍低于全注意力。应用时应按目标模型、输入/生成长度和任务关注的是准确率还是首 token 延迟来选预算。(Appendix B.1、D.2,PDF pp. 14、19–20;Tables 3、6、7)
原文记号核对:Appendix Table 4(PDF p. 17)同时写 $D=256$、$B=16$、$m=D/B=8$,三者算术不一致;正文公式只需要 $D=Bm$,不宜据该表直接设实现维度。Appendix B 开头(PDF p. 14)有一处“centroid learned on prefill stage”,与正文固定解析中心的定义和算法主线相冲突,按 Sec. 4.1.2 的明确公式解读。Sec. 4.2.1 的“buffer reaches $m$ tokens”也沿用了表示子空间维度的字母,而 Table 1 的 Update 是按任务设的 256/512 token;实现时应按 Update 窗口配置理解。