NAtS-L:按块选择记忆方式的混合注意力
论文:Neural Attention Search Linear: Towards Adaptive Token-Level Hybrid Attention Models
作者:Difan Deng、Andreas Bentzen Winje、Lukas Fehring、Marius Lindauer(Leibniz University Hannover / L3S)
版本:arXiv:2602.03681v2,2026-06-02 修订;2026-10-15 获取与研读
材料:arXiv · 本地原文 PDF · 作者 TeX · 英文幻灯片
论文总览
NAtS-L 的核心问题是:同一序列中,哪些历史信息需要保留为可直接检索的 KV,哪些可以压缩进固定大小的递归状态? 作者让模型在每层、每个头组内,将连续 token 块分配给 softmax 注意力或门控 DeltaNet(Gated DeltaNet,GDN),由语言建模损失联合训练路由器和模型参数。
这里有两个不同的决定。块级路由决定历史 KV 如何存储;token 级融合权重决定当前 query 从两种记忆中各读取多少。每个 query 都可以获得两个分支的输出。实验的路由粒度是 64 tokens/块,并非每个 token 独立选择一个算子。(Sec. 4,PDF pp. 4–6)
主要收益体现在检索与长上下文。在约 800M 参数、50B 训练 tokens、4,096 训练长度下,NAtS-L Hybrid 的六项检索均分为 45.07,GDN Hybrid 为 37.30;16K RULER 检索均分为 0.21,GDN 为 0.04。128K 输入下,作者报告相对 Transformer 的预填充加速 5.4×、解码加速 2.3×。这些结果对应不同实验,不能把 128K 的速度测试解释为 128K 检索质量的验证。(Table 1–2、Fig. 4,PDF pp. 7–8)
最值得借鉴的设计是将“长期 KV 保留”“带遗忘的状态更新”“query 条件化读取”分开学习。其取舍也很明确:需要维护两种记忆和块内临时状态;没有 softmax 预算约束,仍保留可能随序列长度平方增长的计算项。
结构地图
下文页码均指从 1 开始的 PDF 页码,本版与页脚页码一致。
| 原文章节 | 论证作用 | PDF / 关键图表 |
|---|---|---|
| 1. Introduction | 固定状态与完整 KV 的取舍 | pp. 1–2,Fig. 1 |
| 2. Related Work | 稀疏注意力、线性注意力、层间混合、NAtS | pp. 2–3 |
| 3. Background: Attention Operations | 并行、递归、分块形式 | pp. 3–4,Eq. (1)–(7) |
| 4.1. Chunk-wise Hybrid Attention | 块路由、列掩码、生成时提交与回退 | p. 4,Eq. (8)–(14) |
| 4.2. Optimizing for the Optimal Operation Combinations | 掩码梯度与省略未选分支梯度 | pp. 4–5,Eq. (15)–(17) |
| 4.3. Hybrid Architecture as Token Mixer | GDN、衰减、共享投影、输出融合 | pp. 5–6,Fig. 2、Eq. (18)–(22) |
| 5.1. Language Modelling | 常识、检索、外推、延迟 | pp. 6–8,Table 1–3、Fig. 3–4;Table 3 在 p. 9 |
| 5.2. Token Type Distribution | 数据、层、头与时间上的分工 | pp. 7–8,Fig. 5–6;Fig. 6 在 p. 9 |
| 5.3. Ablation Study | 块内算子、衰减、归一化、权重与粒度 | pp. 8–9,Table 4 |
| 6. Conclusion and Future Work | 扩展搜索空间与预算约束 | p. 9 |
| A. Experiment Details | 模型和训练超参数 | p. 15 |
| B. Comparison with other Sparse Attention and Hybrid Attention Architectures | 小模型稀疏基线对比 | pp. 15–16,Table 5、Fig. 7 |
| C.1–C.2 | 380M 结果与 Mamba2 扩展 | pp. 16–18,Table 6–9、Fig. 8 |
| C.3–C.5 | RULER 分任务、LongBench 长区间、路由与融合分布 | pp. 17–21,Table 10–11、Fig. 9–12 |
一:动机——把历史信息分配给两种记忆
完整 softmax 注意力保留历史 KV,当前 query 可以重新比较所有历史键。其训练和预填充的注意力计算随长度 $L$ 呈二次增长;逐 token 解码的计算和 KV 存储随历史长度增长。FlashAttention 改善中间矩阵的存储与访存,但不会消除所有 query–key 配对的算术量。
线性注意力把历史压缩到状态 $S$。以单头的键维度 $d_k$、值维度 $d_v$ 表示,状态通常是一个 $d_v\times d_k$ 矩阵,大小与序列长度无关。代价是有限状态必须同时承载许多关联,旧信息可能被衰减、覆盖或相互干扰。本文主要关注这对延迟检索的影响。
按层交替使用两类注意力能补足能力,但每个完整 softmax 层仍然保存整条序列。NAtS-L 将选择下移到层内:同一个头组可以把某些块写入 GDN 状态,把另一些块保留为 softmax KV。选择依赖当前块的内容,比例不预先固定。(Sec. 1–3,PDF pp. 1–4)
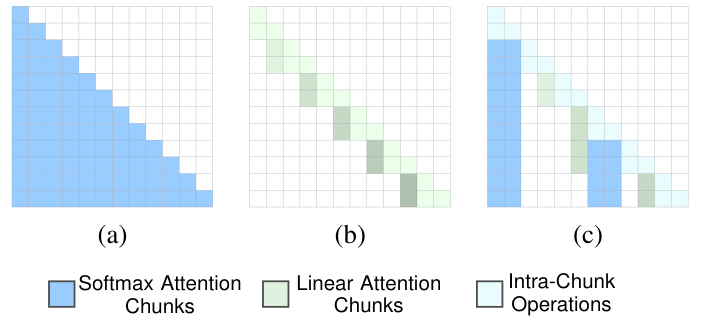
原文 Fig. 1,PDF p. 2。横向对应历史键位置,纵向对应 query 位置;蓝色表示可直接读取的 softmax KV,绿色表示线性状态的传播,浅青色是块内计算。右图中,只保留部分跨块蓝色列,其余历史通过状态参与后续输出;绿色区域应理解为递归信息通路,而不是完整 softmax 矩阵的等价稀疏化。
二:方法——路由写入,按 query 融合读取
2.1 符号与分块计算
| 符号 | 含义 |
|---|---|
| $X\in\mathbb R^{L\times d}$ | 当前层的输入特征 |
| $C$、$X_{[t]}$ | 块大小,以及第 $t$ 块的 $C\times d$ 特征 |
| $Q,K,V$ | 共享的 query、key、value 投影;Q/K 在进入两条分支前分别归一化 |
| $S_{[t]}\in\mathbb R^{d_v\times d_k}$ | 第 $t$ 块开始时的 GDN 历史状态 |
| $t_{la},t_{nla}$ | 分别分配给线性和 softmax 注意力的块集合 |
| $\alpha_i,\beta_i$ | GDN 的衰减门与写入强度 |
| $w_i^{la},w_i^{nla}$ | 第 $i$ 个 query 的逐头输出混合权重 |
| $L_{la},L_{nla}$ | 分配给两种历史存储方式的 token 数量 |
线性注意力的分块实现将计算分成两部分:块内用并行计算求局部输出;块间用状态递推传递历史。论文 Eq. (6)–(7) 用抽象函数 $g_1,g_2$ 表示更新和局部变换。FlashAttention 也按块加载 KV,因此两者可以共享一个按 KV 块调度的计算结构。这里统一的是调度与输出接口,不是声称 softmax 可以精确压成同样的固定状态。
2.2 块级打分与列路由
对每个头组,路由器先对块内输入做均值池化,再用线性层产生两个分数:
单个块的分数是长度为 2 的向量;把全部块堆叠后,形状为 $(L/C)\times2$。原文 Eq. (8) 将堆叠维度写在了单块分数之后,这里将两者区分。(Eq. (8)–(9),PDF p. 4)
路由作用在 key/value 的列 上。所有 query 都能读取被保留的 softmax KV;所有 query 也读取由线性块形成的状态。若以 $c(j)$ 表示 token $j$ 所属的块,已完成历史块的 softmax 掩码可清楚地写成:
这是对 Eq. (12)–(13) 意图的整理;原文分段式的零分支未列全条件。当前块的块内项另行处理,两种操作都计算,所以这两个历史掩码不能直接当作完整实现。
softmax 分支的直觉形式是
分母也只在该分支可见的 KV 上归一化。线性分支则将选中块的贡献递归写入状态。两者分别计算后,再执行后文的归一化与加权融合。(Eq. (10)–(14),PDF p. 4)
2.3 整块池化如何与自回归因果性兼容
均值池化需要看到完整块。如果用这个决定控制块内较早位置的输出,会引入未来信息。论文的处理是:块内先同时计算两种因果操作,块结束后才提交对未来块有效的存储选择。 因此,路由器看到的完整块只用于决定之后怎样记住这个块。(Sec. 4.1,PDF p. 4)
下面是教学伪代码,概括文中的逐 token 生成过程:
进入一个新块:保存块开始时的 GDN 状态,开始累计块输入
逐 token 生成:
    暂存当前块 KV,暂时更新 GDN 状态
    两条分支都按因果规则计算输出,再由当前 query 的权重融合
完整块可用后:
    计算该块、该头组的路由
    若选 GDN:保留 GDN 更新,移除该块的临时 softmax KV
    若选 softmax:保留该块 KV,撤销该块的 GDN 内容写入
                  但仍保留该块经过的衰减效应
这意味着它有块内双路径开销与状态回退开销。论文 p. 4 的一般描述将 softmax 块的线性状态恢复到块起点;用于 GDN 的最终版本还必须结合 Eq. (20) 的衰减规则理解。
一个教学例子:若四个已完成块依次被路由为 softmax、GDN、GDN、softmax,后续 query 从第 1、4 块的显式 KV 中检索,并从含第 2、3 块写入贡献的 GDN 状态中读取。它不需要依据“自己属于什么类型”只走一个分支。
2.4 GDN 的 delta 更新与持续衰减
本文采用的 GDN 更新为
其中 $k_i\in\mathbb R^{d_k}$、$v_i\in\mathbb R^{d_v}$ 按列向量记。可以将其等价展开为
第二式是本次教学展开:先衰减旧状态,再根据“当前值与旧状态沿该键方向预测的差”修正记忆。$\beta_i$ 控制修正强度,$\alpha_i$ 控制旧记忆保留程度。(原文 Eq. (18)–(19),PDF p. 5)
即使一个块被分配给 softmax,GDN 状态也仍然随时间衰减:
这让线性状态的“时间”不会因为某些块交给 softmax 而暂停。作者希望 GDN 偏向较近的信息,把需要长期精确检索的内容交给显式 KV。消融中去掉这一衰减后,检索均分从 33.49 降到 32.24。(Eq. (20),PDF p. 5;Table 4,PDF p. 9)
2.5 两条输出为什么要分别归一化
softmax 的 value 权重为非负且和为 1;GDN 输出的尺度受到状态与 query/key 范数影响。直接相加可能使一个分支仅因数值尺度占据主导。因此作者先分别 RMSNorm,再按当前 query 生成的逐头权重融合:
两权重非负且和为 1。用 $q_i$ 生成权重,与“这次查询需要什么记忆”相匹配;用池化后的 $X_{[t]}$ 生成路由,则对应“这个历史块应如何存储”。这两个控制信号有不同粒度和功能。(Eq. (21)–(22),PDF p. 6)
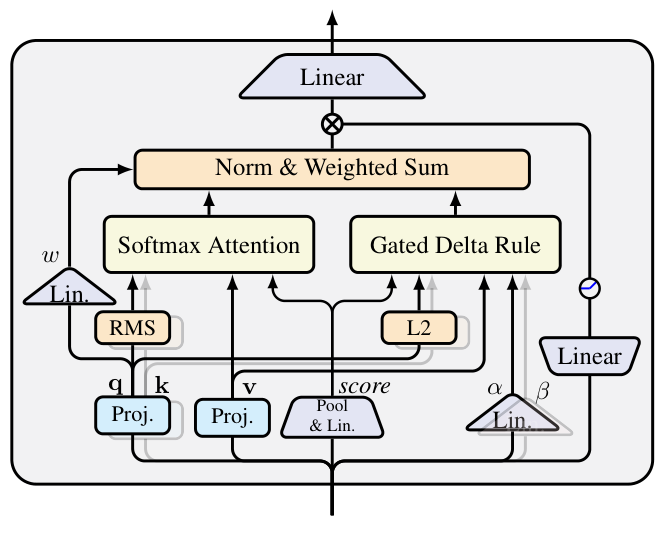
原文 Fig. 2,PDF p. 5。自下而上读取:输入生成共享 Q/K/V、路由分数和 GDN 门;softmax 的 Q/K 使用 RMSNorm,GDN 的 Q/K 使用 L2 归一化;分支输出分别归一化并融合,最后经过输出门和线性投影。Q/K/V 投影包含线性层、短深度卷积与 SiLU,图中以 Proj. 简写。
为适配不同头宽,800M 模型有 6 个 GDN 头、18 个 softmax 头,每 3 个 softmax 头共享一个 GDN 头对应的路由掩码;380M 对应 6 与 12,每组 2 个。共享的是路由分组,不能直接等同于所有细节都采用标准 GQA 的 KV 共享实现。(Sec. 4.3、Appendix A.1,PDF pp. 5–6、15)
2.6 路由器怎样训练,以及省掉了什么
主任务只有语言建模损失,没有用于固定 softmax 比例的辅助损失。作者为掩码计算梯度,再把同一 KV 块的列梯度聚合到块分数中。(Sec. 4.2,PDF pp. 4–5)
为理解 Eq. (15),把掩码暂时视为连续变量,令
则有教学推导
它衡量增加一列权重时,额外读到的 value 相对当前输出能否降低损失。将属于同一块的梯度在 query 和 key 位置上求和,就得到原文 Eq. (16) 的块级信号;线性分支使用 Eq. (17) 中状态梯度与状态的内积聚合。
关键计算取舍在于:如果连未选中的分支都计算分数梯度,softmax 仍须遍历被跳过的 KV,训练会恢复 $O(L^2+L_{la})$ 的开销。作者将未激活块对应的分数梯度置零,使前后向保持相同量级的稀疏计算。这是一种省略候选分支信号的梯度近似,不是完整评估两个选择后再更新。
此外,硬 $\arg\max$ 本身不可直接用普通导数训练。论文写出了掩码梯度和分数聚合,但未完整展开从硬选择到路由参数的代理梯度链路;上述连续掩码推导只解释梯度信号,不补设原文未明确给出的 straight-through 或 Gumbel 机制。
2.7 复杂度与缓存的真实含义
论文在隐藏维度与块大小固定的记号下给出
softmax 仍要让全部 query 与保留的 KV 交互。令 $\rho=L_{nla}/L$,其主项就是 $O(\rho L^2)$。只要 $\rho$ 随长度保持为正的常数比例,渐近复杂度仍是二次的;NAtS-L 并未证明 $L_{nla}$ 有固定上限。(Sec. 4.1,PDF p. 4)
若显式保留单头维度 $d_h$,本次分析的粗略成本拆分是
后两项概括每个 query 的状态读取、状态处理和块内计算;跳过一部分内容写入不会消除所有 token 的读取成本。解码存储可概括为
分别来自固定矩阵状态、已保留 KV 和当前块的临时 KV,另有常数份状态快照与短卷积状态。因此其缓存比完整 KV 更有选择性,但不具有纯递归模型那样关于历史长度的固定内存保证。
三:实验——比较对象和评价口径
3.1 两档预训练与六种架构
所有主模型在 FineWeb-Edu 上从头训练,训练上下文均为 4,096。380M 档使用 15B tokens,800M 档使用 50B tokens。训练采用 AdamW,峰值学习率 $3\times10^{-4}$,起止学习率 $3\times10^{-5}$,cosine schedule;有效 batch 为 0.5M tokens,两档 warmup 分别为 0.5B、1B tokens。训练使用 4 或 8 张 NVIDIA H100 PCIe 80GB。(Sec. 5、Appendix A.1,PDF pp. 6、15)
| 800M 档架构 | 组成 / 参数量 | 比较角色 |
|---|---|---|
| GDN | 21 个 GDN 层,793M | 固定状态的递归基线 |
| Mamba2 | 48 层,801M | 另一种高效递归骨干 |
| Transformer | 24 层,778M,RoPE | 完整 softmax 检索基线 |
| GDN Hybrid | 17 GDN + 5 Transformer 层,802M | 固定层间混合 |
| NAtS-L | 21 个 NAtS-L 层,794M;softmax 分支用 RoPE | 每层都进行块级混合 |
| NAtS-L Hybrid | 15 GDN + 6 NAtS-L 层,793M;softmax 分支不加位置编码 | 层间混合中再嵌入块级混合 |
这两种 NAtS-L 变体必须分开看:Hybrid 的 softmax 仅存在于 6 个层内,并且位置编码设置不同。论文用“3:1”概括层间混合设计,实际层数应以上表为准。NAtS-L 的默认块大小为 64;短卷积核大小为 4;两档模型宽度为 1,024 / 1,536。(PDF pp. 6、15)
3.2 每组实验回答什么
| 实验 | 检验问题 | 口径与条件 |
|---|---|---|
| 常识与短文本语言建模 | 换注意力是否损失基础建模能力 | Wiki、LAMBADA 的 PPL 越低越好;7 项常识任务准确率及均值越高越好 |
| 真实文本检索 | 能否从上下文取回对应信息 | SWDE、SQD、FDA、TQA、NQ、DROP;上下文截到 4,096;按原表的 acc 与六任务平均分报告 |
| 长文本 PPL | 训练长度之外能否继续利用历史 | PG19、CodeParrot、NarrativeQA;测试至 65,536;越低越好 |
| RULER 检索子集 | 不同长度下的针检索与关联检索 | 4K / 8K / 16K;均分使用 0–1 尺度,越高越好 |
| LongBench-e 子集 | 长文本问答、摘要、分类与代码任务 | 11 项任务,按长度区间;各自评分越高越好,不能全部称作准确率 |
| 推理延迟 | 选择性 KV 保留能否转化为实际速度 | 输入长度扫描至 128K;prefill 为秒,decode 为毫秒 |
| 路由分布与消融 | 哪些部件带来收益、分工是否随内容改变 | 按层 / 头 / 数据集 / 时间可视化;检索任务做单项设计替换 |
CodeParrot 的单样本通常较短,作者拼接多个样本构造 65,536 长输入。因此它的长长度 PPL 曲线包含较多短程关联,不能和单篇长故事的远程依赖完全等同。(Sec. 5.1,PDF p. 7)
四:结果——收益集中在哪里
4.1 基础语言能力接近,检索差异明显
下表摘录 Table 1(PDF p. 8)的不同列,所有数值保留原文报告口径。
| 模型,约 800M | Wiki PPL ↓ | LAMBADA PPL ↓ | 常识均分 ↑ | 六项检索均分 ↑ |
|---|---|---|---|---|
| GDN | 19.54 | 16.77 | 51.02 | 31.22 |
| Mamba2 | 19.28 | 17.54 | 51.38 | 29.94 |
| Transformer | 19.27 | 17.89 | 50.78 | 33.66 |
| GDN Hybrid | 18.83 | 16.41 | 51.52 | 37.30 |
| NAtS-L | 19.17 | 16.17 | 50.84 | 39.75 |
| NAtS-L Hybrid | 18.52 | 15.16 | 51.41 | 45.07 |
常识均分落在 50.78–51.52,NAtS-L Hybrid 没有全面提高所有短上下文任务。检索差异更大:相对 GDN Hybrid 增加 7.77 个百分点,相对 Transformer 增加 11.41 个百分点。这支持其主要收益来自更合适的上下文记忆与读取方式。
| 检索任务 | GDN | Transformer | GDN Hybrid | NAtS-L | NAtS-L Hybrid |
|---|---|---|---|---|---|
| SWDE | 34.47 | 58.42 | 54.64 | 53.02 | 62.38 |
| SQD | 35.05 | 3.25 | 39.54 | 37.87 | 40.01 |
| FDA | 22.69 | 43.47 | 31.13 | 51.54 | 67.70 |
| TQA | 56.87 | 56.69 | 57.11 | 55.75 | 57.64 |
| NQ | 17.10 | 18.28 | 19.64 | 17.42 | 21.86 |
| DROP | 21.13 | 21.85 | 21.75 | 22.90 | 20.84 |
NAtS-L Hybrid 在完整六模型对照中赢得 5/6 项,尤其 FDA 的提升较大。DROP 则由全 NAtS-L 获得最佳值,说明两种混合深度的取舍会随任务改变。
4.2 长文本 PPL:Hybrid 可以继续利用更长上下文
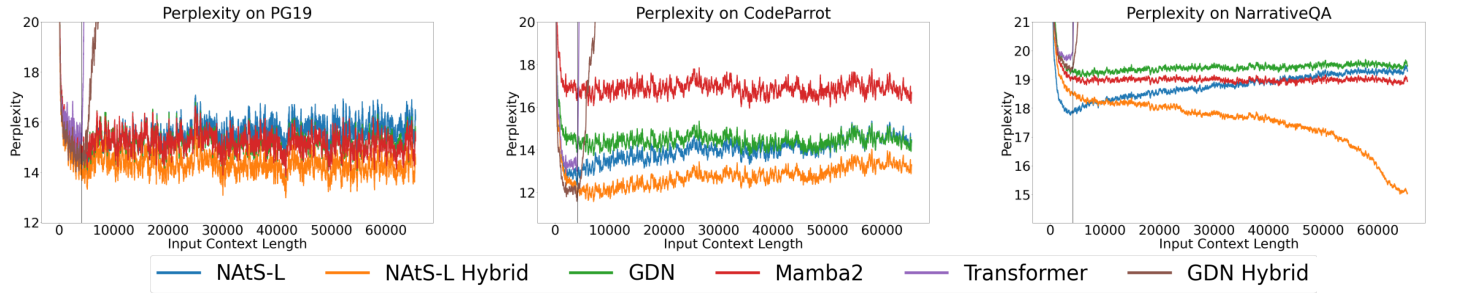
原文 Fig. 3,PDF p. 8。三幅图依次是 PG19、CodeParrot、NarrativeQA;横轴为输入位置 / 上下文长度,纵轴为 per-token PPL,黑色竖线标出训练长度 4,096。橙色为 NAtS-L Hybrid,蓝色为 NAtS-L。
Transformer 和 GDN Hybrid 越过训练长度后,PPL 很快超出图中范围;NAtS-L 两种变体保持更稳定。NarrativeQA 上,Hybrid 随上下文变长继续下降,到约 64K 时接近 15,而其它能稳定外推的模型大多在约 19 左右。这里的近似值来自曲线及作者正文解释,不能当成未报告的精确评测点。
作者据此认为 Hybrid 更能利用长程信息。比较时要同时看到位置编码差异:全 NAtS-L 用 RoPE,Hybrid 的 softmax 分支不用位置编码。因此这组结果支持整套配置的外推能力,但没有单独隔离路由、层布局和位置编码各自的贡献。(Sec. 5.1,PDF p. 7;配置见 p. 6)
4.3 RULER:外推更好,但绝对检索成绩仍下降
| 模型,约 800M | 4K ↑ | 8K ↑ | 16K ↑ |
|---|---|---|---|
| GDN | 0.25 | 0.14 | 0.04 |
| Mamba2 | 0.18 | 0.09 | 0.04 |
| Transformer | 0.45 | 0.00 | 0.00 |
| GDN Hybrid | 0.47 | 0.02 | 0.00 |
| NAtS-L | 0.39 | 0.13 | 0.05 |
| NAtS-L Hybrid | 0.49 | 0.32 | 0.21 |
来源:Table 2,PDF p. 8。Hybrid 在三个长度都领先,16K 比 GDN 高 0.17 个绝对分数单位。同时它从 4K 的 0.49 降至 16K 的 0.21;应将结论理解为退化更缓,而非长度增加时检索能力保持不变。
Appendix C.3 的 Fig. 9(PDF p. 17)进一步拆分任务。优势在单针检索上尤为清楚,多键、多值和多查询任务仍有明显难度。本文报告的是 RULER 的检索子集,不能把这组均分称作整个 RULER 的综合成绩。
4.4 LongBench:优势有任务选择性
Table 3(PDF p. 9)中,800M Hybrid 在低于 4K 的 11 个任务中赢得 5 项。下表选择有代表性的强项和弱项,显示原文最有信息量的取舍。
| 低于 4K 的任务 | GDN Hybrid | NAtS-L Hybrid | 该列最佳模型 / 分数 |
|---|---|---|---|
| HotpotQA | 7.02 | 7.45 | NAtS-L Hybrid / 7.45 |
| MultiFieldQA-En | 13.17 | 15.12 | NAtS-L Hybrid / 15.12 |
| GovReport | 12.54 | 17.26 | NAtS-L Hybrid / 17.26 |
| TriviaQA | 20.10 | 29.79 | NAtS-L Hybrid / 29.79 |
| SAMSum | 16.21 | 24.98 | NAtS-L Hybrid / 24.98 |
| Qasper | 4.28 | 2.40 | Mamba2 / 4.79 |
| TREC | 41.00 | 17.00 | GDN Hybrid / 41.00 |
| LCC | 20.11 | 9.43 | Mamba2 / 20.68 |
| RepoBench-P | 16.43 | 15.21 | NAtS-L / 20.82 |
其它两项中,2WikiMultihopQA 由 Mamba2 最佳(12.04),MultiNews 由 GDN Hybrid 最佳(13.90)。因此不能用“5/11 获胜”代替整张表的任务分化。
附录 Table 10–11(PDF p. 19)给出更长输入结果。Table 10 标题写“below 8k”,C.4 的上下文把它作为超过 4K 的补充区间,按 LongBench-e 分桶可理解为 4K–8K;表题本身没有写清下界。Table 11 明确是 超过 8K,不是固定长度 16K 测试。
| 800M,任务 | Table 10:Hybrid / 最佳其它模型 | Table 11:Hybrid / 最佳其它模型 |
|---|---|---|
| TriviaQA | 32.17 / GDN 22.43 | 28.60 / NAtS-L 23.29 |
| GovReport | 13.46 / NAtS-L 8.07 | 9.10 / NAtS-L 7.92 |
| MultiFieldQA-En | 13.92 / Mamba2 13.47 | 13.36 / NAtS-L 13.09 |
| LCC | 10.28 / Mamba2 21.68 | 13.31 / Mamba2 18.85 |
| RepoBench-P | 13.82 / Mamba2 21.94 | 11.54 / Mamba2 21.24 |
长区间下,Hybrid 的问答与部分摘要优势仍在,而代码补全并非其强项。Table 10 中它还赢得 2WikiMultihopQA、HotpotQA,总计 5 项;Table 11 中赢得 3 项。原文没有给这些列合成的 LongBench 总分,本笔记也不额外制造一个跨任务均值。
4.5 延迟:长输入收益更大,短输入有额外成本
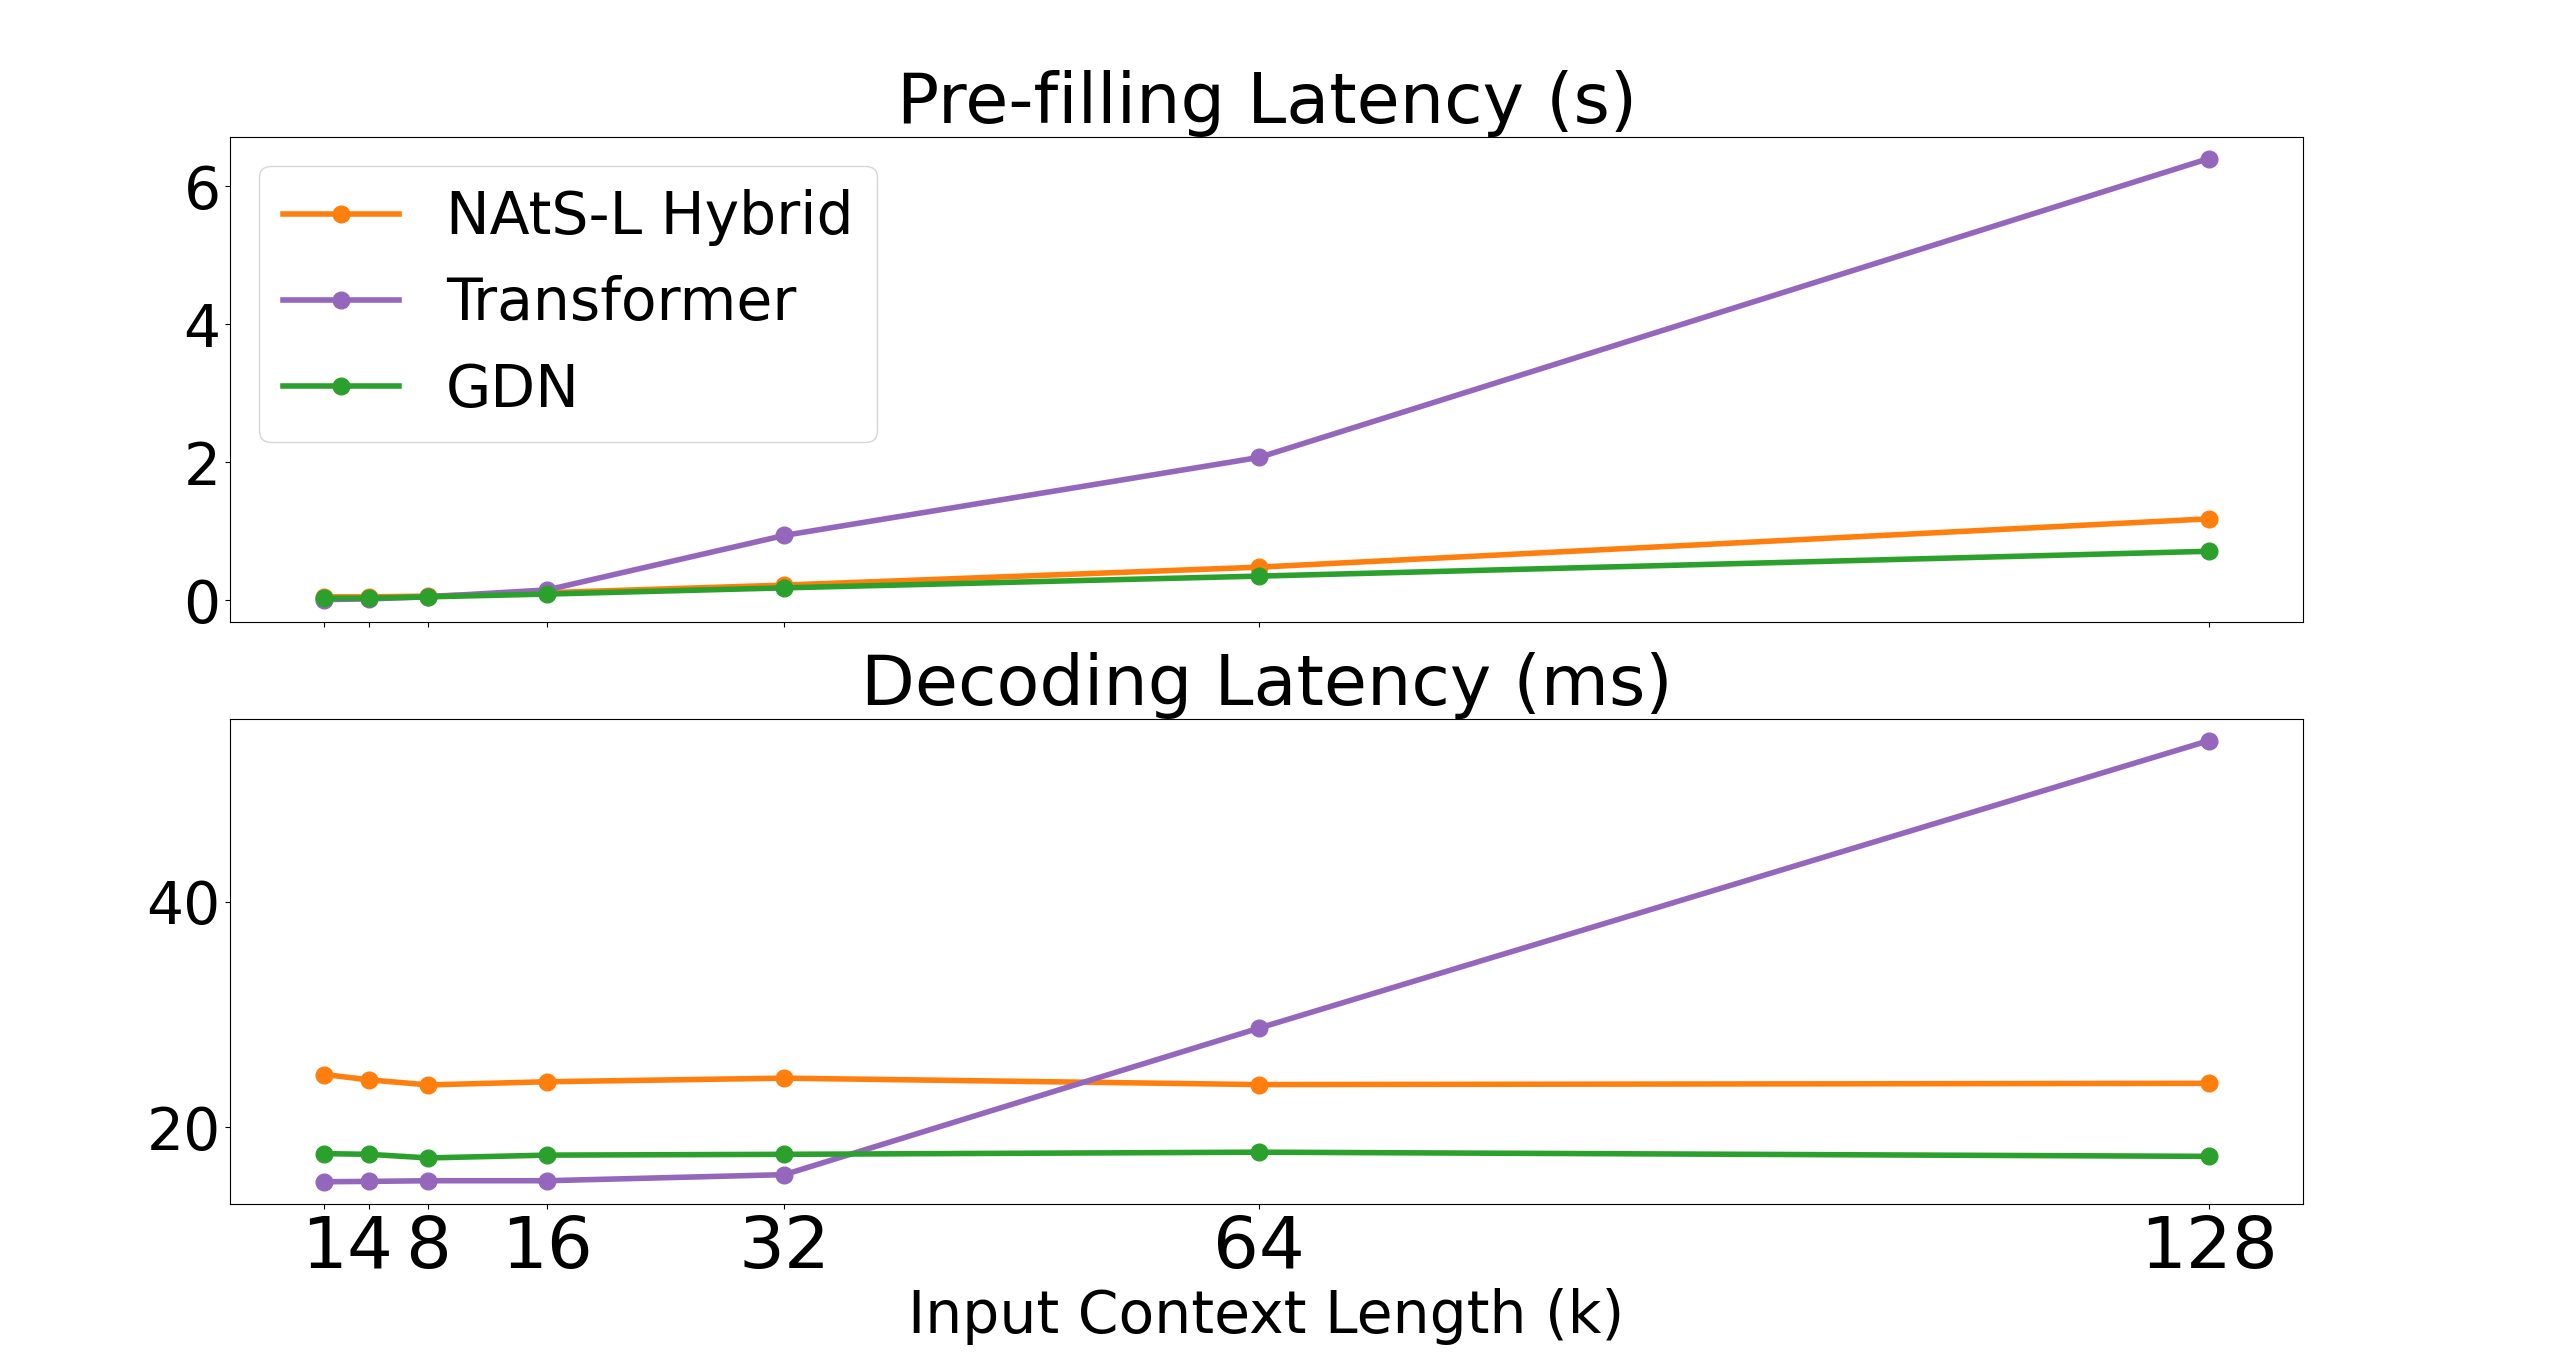
原文 Fig. 4,PDF p. 8。横轴为输入长度(K);上图纵轴是预填充延迟(秒),下图是解码延迟(毫秒)。图例只比较 NAtS-L Hybrid、Transformer、GDN。
在最长 128K 输入处,作者报告 Hybrid 的预填充相对 Transformer 5.4× 加速,但耗时仍是 GDN 的 1.66 倍;解码相对 Transformer 2.3× 加速。短输入下,解码曲线中 Hybrid 反而高于 Transformer 和 GDN,说明双分支处理、路由与临时状态管理存在固定成本。(Sec. 5.1,PDF p. 7)
这些是原文特定实现的延迟结果。正文没有完整列出延迟测试的 batch、生成步数与计时细节,不能把 2.3× 换写为任意部署条件下的 token/s 提升,也不能由图反推出未报告的显存缩减倍数。
4.6 路由和融合权重学到了不同的分工
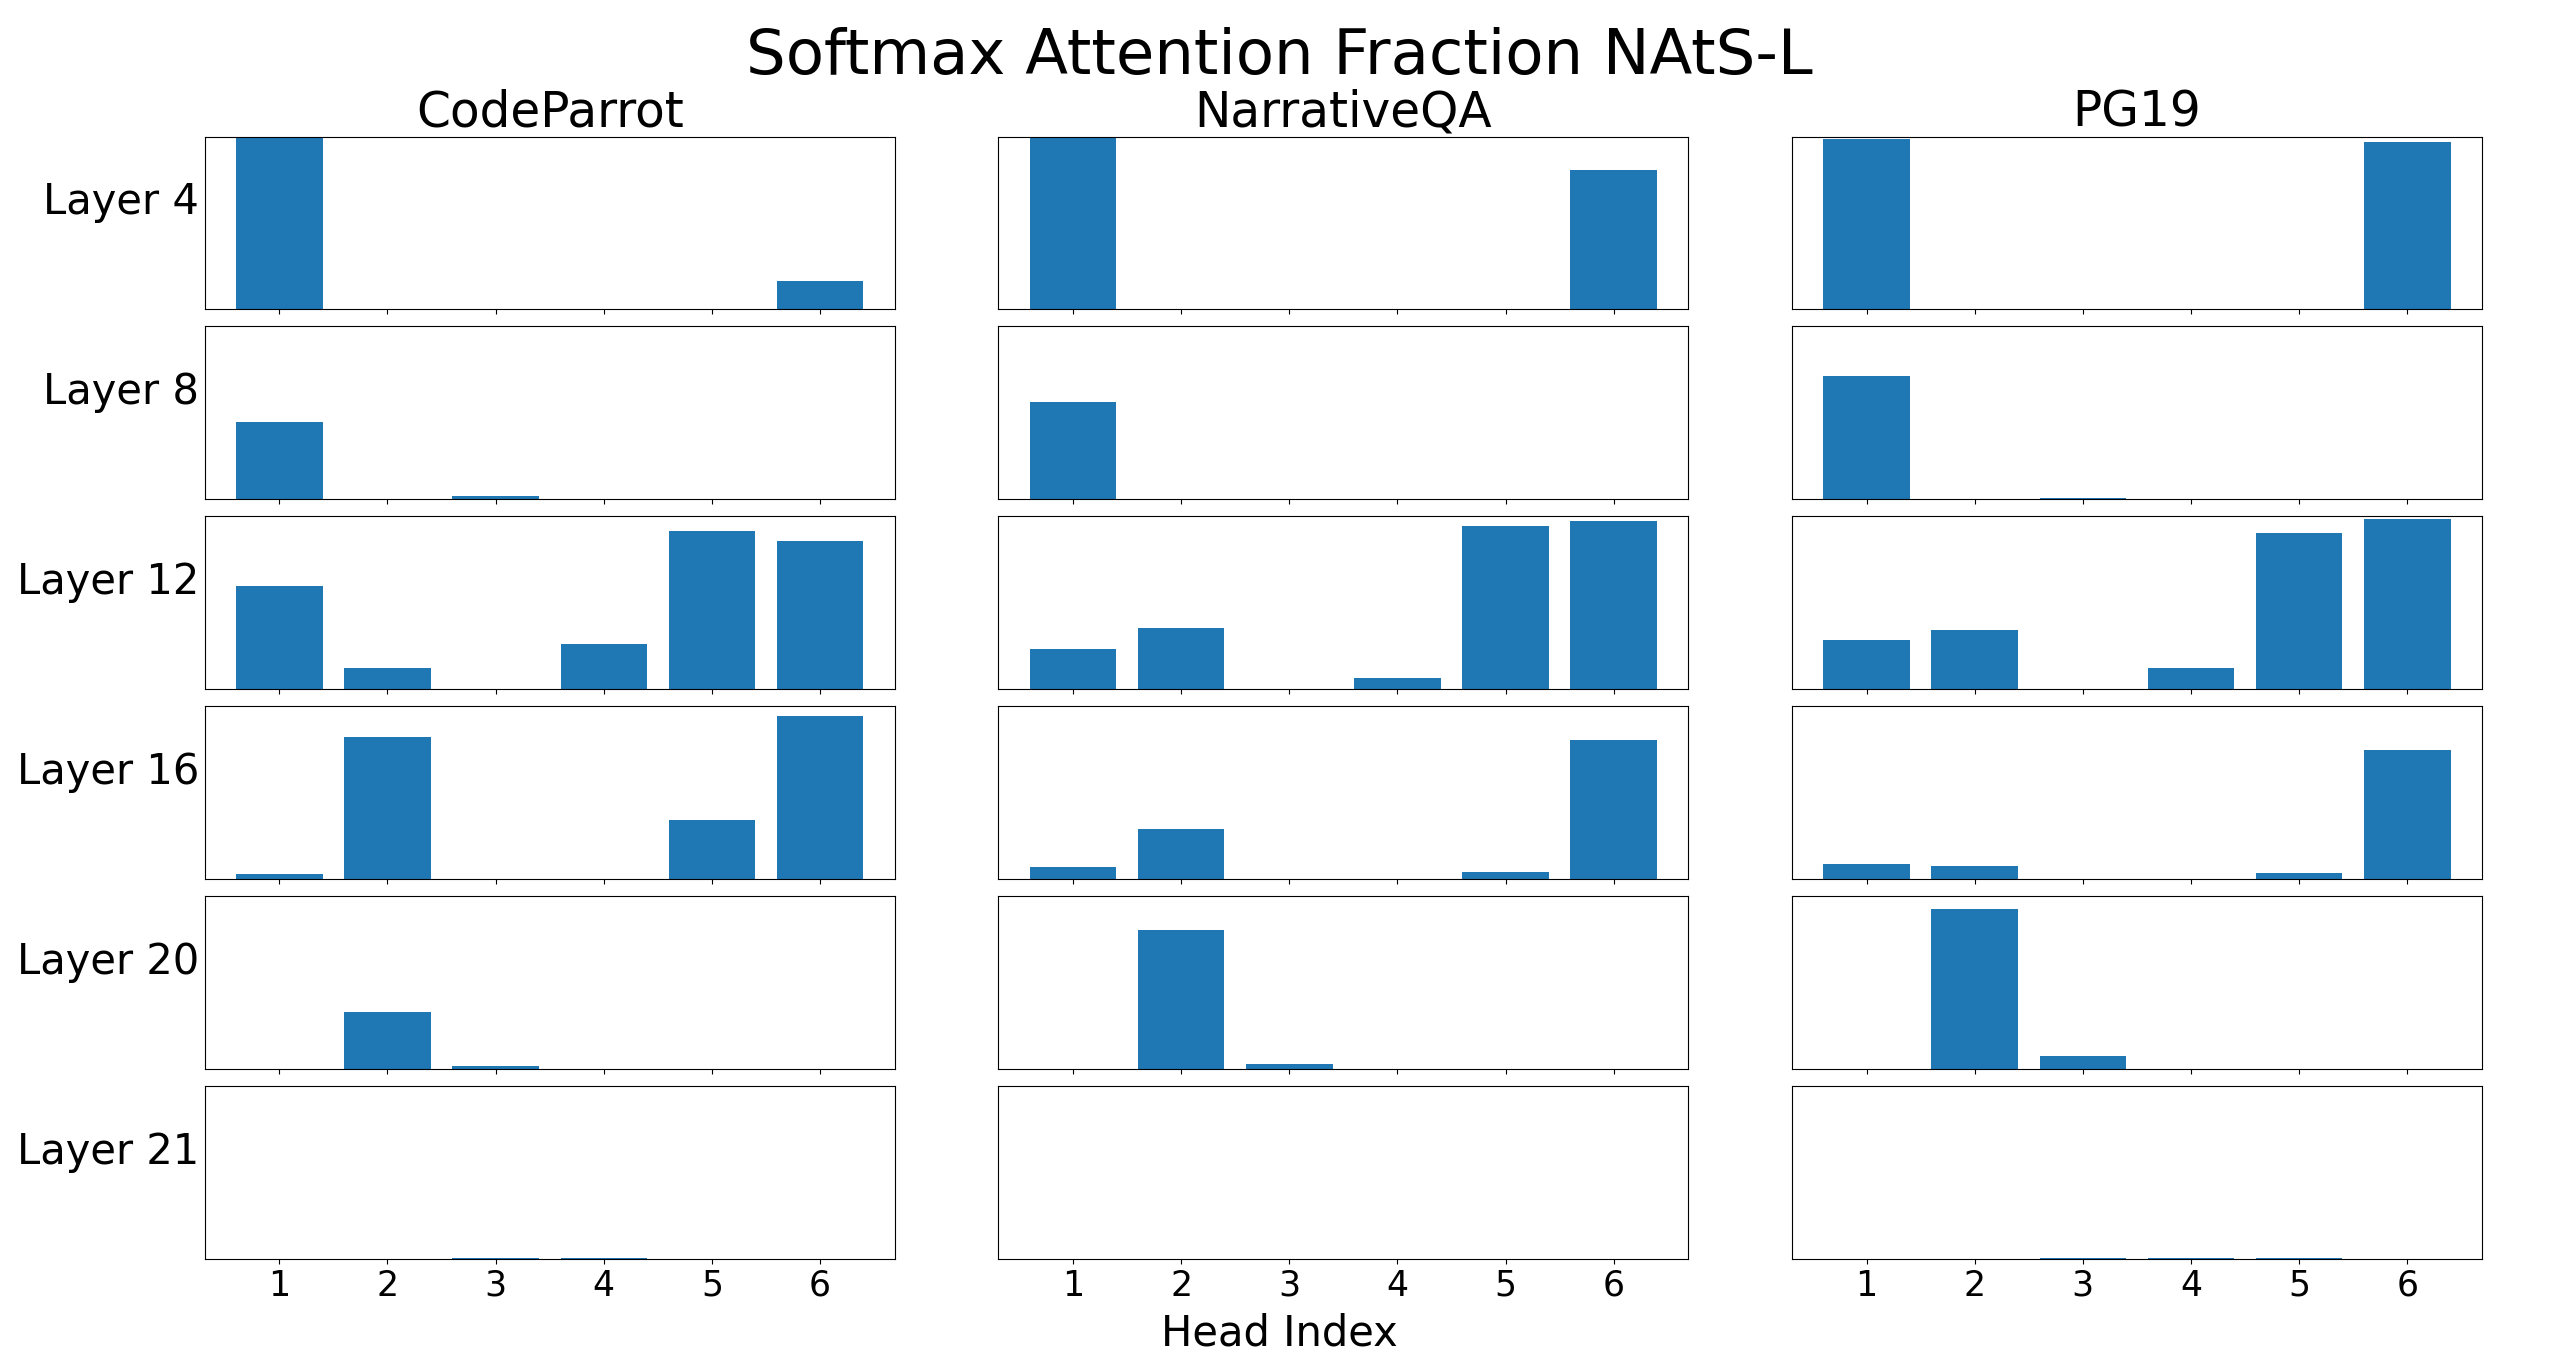
原文 Fig. 5,PDF p. 8,对应 NAtS-L Hybrid。三列是 CodeParrot、NarrativeQA、PG19;每行是一个混合层,每个小图横向是 6 个路由头组,柱高表示 softmax token 比例。PG19 与 NarrativeQA 的分布较相近,代码分布有所不同,例如第 4 层第 6 头组在文本任务中使用更多 softmax。部分头组几乎只用 GDN,作者观察到没有完全只用 softmax 的头组。
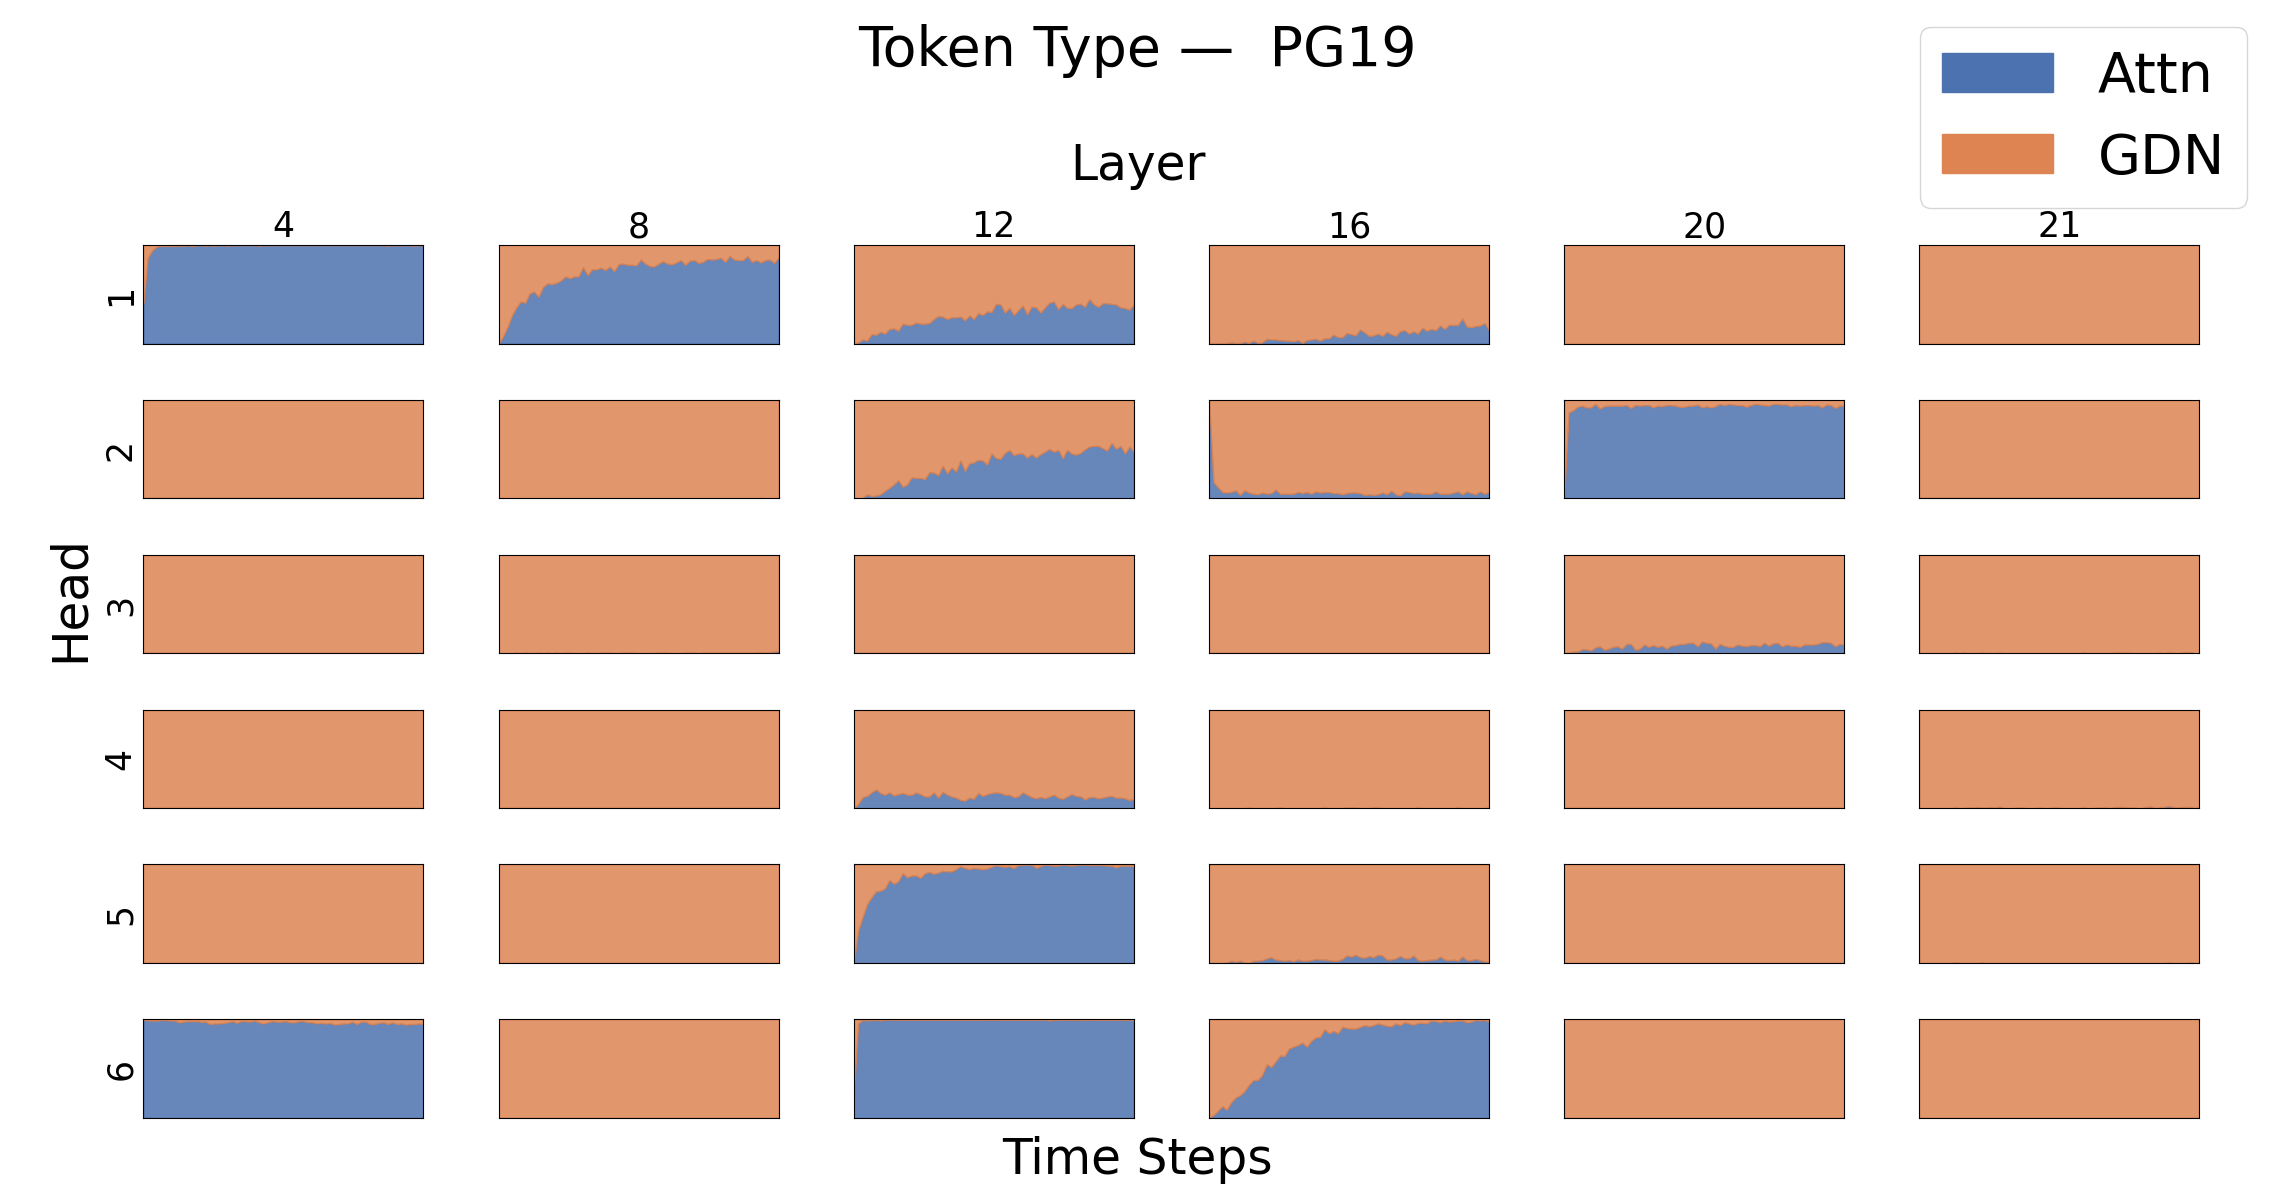
原文 Fig. 6,PDF p. 9。列对应层,行对应头组;每个小格内横轴是时间,蓝色与橙色分别为 softmax 与 GDN 占比。多数头组较稳定,少数随上下文积累改变,例如第 8 层第 1 头组逐渐增加 softmax 比例。
Appendix C.5 补充了三点(PDF pp. 18、20–21):
- 全 NAtS-L 的 Fig. 10 中,较浅层更偏线性处理,中深层出现更多 softmax 头。作者据此提出将全局注意力放在较深层的架构假设,尚未通过新的层布局实验验证。
- Fig. 11 的 NarrativeQA 与 CodeParrot 在部分混合头上的时间趋势不同,说明分配会随输入内容变化。
- Fig. 12 的输出权重也因头和时间而变化。少量 softmax KV 可以获得很大的读取权重,因此 softmax token 占比不等于 softmax 输出贡献占比;后者也不能单由归一化权重推断全部因果影响。
这些图支持“模型学到了条件化分工”,但没有直接标注保留的词是否确实属于某种语义类别,不能进一步宣称路由已经学会可靠识别所有长期重要信息。
4.7 消融:分开归一化、query 权重和块粒度都重要
Table 4(PDF p. 9)的基准行与 Appendix C.1 的 380M 结果一致,基准均分是 33.49,不可与 800M 的 45.07 混用。下表中的变化由原表分数相减得到。
| 变体 | 六项检索均分 ↑ | 相对默认的变化 | 所检验的设计 |
|---|---|---|---|
| 默认 NAtS-L Hybrid | 33.49 | — | 块内双操作、持续衰减、独立归一化、query 权重、C=64 |
| Attn Out | 30.87 | −2.62 | 块内只用 softmax 的局部相关项 |
| GDN Out | 26.98 | −6.51 | 块内只用 GDN 的局部相关项 |
| w/o LAttn Decay | 32.24 | −1.25 | softmax 块经过时不衰减线性状态 |
| w/o Attn Norm | 29.59 | −3.90 | 先相加,再统一归一化 |
| w/o Attn Weights | 32.34 | −1.15 | 去掉动态融合权重 |
| Sigmoid Weights | 30.02 | −3.47 | 两权重改用 sigmoid |
| Linear Weights | 30.57 | −2.92 | 权重不加归一化激活 |
| Weights From X | 27.64 | −5.85 | 用输入 X 替代 query 生成权重 |
| Chunk 128 | 27.85 | −5.64 | 将路由块大小从 64 增至 128 |
这些结果连接起方法设计:两条路径需要保留各自的块内能力;输出尺度需要先对齐;当前 query 比原始输入更适合控制读取比例;更粗的路由块降低了选择灵活性。注意 Attn Out / GDN Out 改的是块内局部项,并非移除整个模型的另一条历史通路。
4.8 小模型与稀疏注意力对比
380M、15B tokens 的主结果(Table 6、8,PDF pp. 17–18)保持了检索优势:
| 380M 模型 | 六项检索均分 ↑ | RULER 4K / 8K / 16K ↑ |
|---|---|---|
| GDN | 20.78 | 0.15 / 0.07 / 0.02 |
| Mamba2 | 19.25 | 0.09 / 0.03 / 0.02 |
| Transformer | 21.71 | 0.19 / 0.00 / 0.00 |
| GDN Hybrid | 24.97 | 0.21 / 0.07 / 0.00 |
| NAtS-L | 27.16 | 0.19 / 0.08 / 0.03 |
| NAtS-L Hybrid | 33.49 | 0.36 / 0.30 / 0.12 |
Hybrid 的短上下文常识均分为 43.04,Transformer 为 43.26;优势依然集中于上下文检索。小模型 PPL 曲线也呈现类似外推趋势(Fig. 8)。Table 7 的低于 4K LongBench 中,Hybrid 在 MultiFieldQA、Qasper、LCC、RepoBench-P 上最佳,和 800M 的优势项目并不完全相同;Table 10–11 中,380M Hybrid 在两个更长区间分别赢得 6 项和 5 项,说明模型规模也会改变任务分工。
Appendix B(PDF pp. 15–16)的 Table 5 将 NAtS-L 与 NSA、MOBA、GDN+1024 滑动窗口、FlexPrefill 和数种 KV 淘汰方法比较。稀疏基线被要求使用 50% 计算预算;NAtS-L 没有统一固定的 softmax 比例,因此这不是严格等预算的完整前沿比较。
| Table 5 中的架构 / 方法 | 六项检索均分 ↑ |
|---|---|
| Transformer | 22.99 |
| NSA / MOBA | 22.05 / 21.98 |
| GDN SWA | 8.53 |
| FlexPrefill | 20.71 |
| SnapKV / AdaKV / PyramidKV | 18.64 / 17.96 / 18.41 |
| NAtS-L / NAtS-L Hybrid | 28.48 / 34.19 |
原文两张表的 NQ 列存在未解释的差异。 Table 5 中 Transformer / NAtS-L / Hybrid 的 NQ 分别为 17.68 / 18.02 / 20.72,而 Table 6 中为 10.01 / 10.14 / 16.53;对应均分也不同,其它五项相同。以上两张摘录分别保留原表数据,仅在各自表内比较,不将 34.19 当成 Table 6 或消融的基准。
Fig. 7(PDF p. 16)还比较了 FlexPrefill 预填充与 SnapKV 解码。Hybrid 在图示 128K 处仍具有速度优势,但短输入解码同样存在固定开销;该图没有给出可直接引用的精确加速倍数。
4.9 将 GDN 换成 Mamba2:框架可以迁移,但任务收益不均匀
Appendix C.2、Table 9(PDF pp. 17–18)将线性分支改为 Mamba2。NAtS-L Mamba2 的检索均分为 25.34,Mamba2 为 19.25,提高 6.09 个百分点。SWDE 从 13.77 升到 32.58,FDA 从 4.26 升到 32.30;SQD、TQA、DROP 则下降。
它说明“显式 KV + 压缩状态”的块级选择能够用于另一种递归骨干。这个补充实验没有搜索多个线性算子,也没有证明扩展算子集合后必然更优;扩大搜索空间属于作者的后续方向。
五:结论——可借鉴的机制与尚未分离的因素
NAtS-L 的贡献是把混合注意力从固定层布局推进到输入条件化的历史存储:被选中的 KV 保留为可检索记录,其余块通过 GDN 更新和遗忘进入矩阵状态;当前 query 再决定两条路径的读取比例。块内双路径、持续衰减、输出独立归一化和 query 条件权重共同组成了可用方案,消融显示这些细节对结果有实质影响。
从证据看,NAtS-L Hybrid 是这篇论文最有力的配置。它兼顾了 4K 训练下的检索、测试长度外推和长输入延迟,但没有在所有 LongBench 任务上胜出,也没有消除随长度增长的检索退化。
进一步判断或复用该设计,最需要关注以下具体问题:
- 预算是否可控。 当前路由只优化语言建模损失,没有约束 KV 数量;应用需要固定延迟或显存上限时,还需要预算机制。作者也将比例正则化列为未来方向。
- 外推收益怎样分解。 两个 NAtS-L 变体同时改变混合层数量与位置编码。保持位置编码、层数和参数量一致的对照,才有助于分离块级路由本身的贡献。
- 更细粒度选择与硬件效率怎样平衡。 C=128 明显弱于 C=64,但论文没有完整的块大小—质量—速度曲线。更小块也可能增加调度碎片和路由成本。
- 路由梯度能否在相同成本下更充分。 省去未激活分支梯度减少计算,也减少了比较候选存储方式的信号;这与内容适应性、长期训练稳定性的关系尚未由专门消融回答。
对架构研究最直接的启发是:显式 KV 与矩阵状态可以按输入内容协作,而其“写入选择”和“读取权重”应分别建模。下一步有价值的验证是将预算、位置编码和调度成本分别控制住,测清这种内容选择在什么质量与长度范围内最划算。