A Provable Expressiveness Hierarchy in Hybrid Linear-Full Attention:中文精读笔记
作者:Xiaowei Ye、Xiaoyu He、Chao Liao、Chen Wu、Pinyan Lu;前两位为共同第一作者。
版本:arXiv:2602.01763v1,2026-02-02 提交。研读日期:2026-10-15。
原文:arXiv 页面 · 本地论文 PDF · 英文汇报 PDF · 可编辑 TeX。下文页码均为从 1 开始的 PDF 页码,与本版本印刷页码一致。
论文总览
这篇论文研究一个具体问题:在有限状态、有限精度和因果信息流的约束下,大量循环层能否补偿全注意力层数量不足造成的多步检索能力损失? 作者将混合网络转成通信协议,用“不可区分分解”构造两类输入:模型得到的全部相关消息相同,但任务要求的答案不同。
主定理针对专门构造的 $L$ 步顺序函数复合任务。令 $H$ 为头数、$d$ 为每头维度、$p$ 为精度位数、$n$ 为输入 token 数,当
由 $L-1$ 个全注意力层组成、每个后面接 $2^{3L^2}$ 个线性注意力层的网络,仍不能在所有合法输入上正确完成任务;已有工作给出 $L+1$ 个全注意力层、$Hdp=\operatorname{polylog}(n)$ 的解法。这里比较的是表示任务所需的容量与层数,表 1 中的“complexity”不能读成运行时间或 FLOPs。(Theorem 1.1,pp. 1–2;Table 1,p. 2。)
最有价值的直觉是:全注意力可以在查询形成后直接访问原有 token;循环层向后续位置传递的是在未来查询出现前形成的有限状态。加深循环计算能处理已有信息,但仍要受跨位置通信容量的限制。证明必须同时控制这两条通路,因此比单纯的“状态装不下输入”计数更复杂。
论文还给出线性、log-linear 和块稀疏注意力的检索下界。v1 中稀疏定理的参数范围、2-Sum 数值域,以及混合协议加强版本的基步存在需要澄清的地方;下文在对应结果旁说明。全文为理论研究,没有训练实验、实测精度或吞吐结果。
结构地图
| 原文章节 | 在论证中的作用 | PDF 定位 |
|---|---|---|
| 1 Introduction;1.1 Our result;1.2 Organization and overview;1.3 Related work | 主分离结果、既有深度下界与通信复杂度背景 | pp. 1–3;定理 1.1、1.2,表 1、2 |
| 2 Preliminaries;2.1 Transformer with full attention;2.2 Linear attention, RNN, and hybrid attention | 有限精度模型、循环状态容量、混合层布局 | pp. 3–4;定义 2.1、2.3,引理 2.2 |
| 2.3 Sparse attention;2.4 Tasks | 块压缩和选择;函数复合与 2-Sum | pp. 4–5;定义 2.4–2.6 |
| 3 Hybrid communication model | 用两类消息模拟全注意力与循环层 | p. 5 |
| 4 Hybrid Communication Lower Bound;4.1 Parameters and strateggy;4.2 The Initial step;4.3 Inductive step | 不可区分分解与归纳证明主线 | pp. 5–8 |
| 5 Lower bound for sparse attention;6 Conclusion | 稀疏通信模型与架构启发 | p. 8 |
| A.1–A.4 | log-linear 定义、函数求值和排列复合下界、CoT 扩展 | pp. 12–15;定理 A.3–A.8 |
| A.5–A.6 | 2-Sum 的循环与稀疏下界 | pp. 15–16;定理 A.9、定理 1.2 的证明 |
| B.1–B.3 Hybrid Communication Lower Bound | 具体参数、基步、矩形提取和归纳 | pp. 17–23;定理 B.2,引理 B.1–B.13 |
| C Upper bound for full attention;D Some Missing Proof | 检索头构造;线性注意力到 RNN 的转换 | pp. 23–24 |
一、动机:层数为什么不能只按总量计算
已有工作已经给出纯 Transformer 的深度—宽度权衡:对特定 $L$ 步复合任务,$L$ 个因果全注意力层需要随 $n$ 多项式增长的容量,而 $L+1$ 层只需要多对数容量。本文问:如果保留少量全注意力,加入非常多的便宜循环层,这个障碍是否会消失?
关键困难来自查询依赖前一步答案。在第二步检索地址尚未形成时,模型不能只提前读取那一个最终需要的位置;如果想提前准备所有可能答案,就必须携带大量信息。全注意力层提供一次新的、由当前表示决定的全局访问机会,循环层则压缩和传播前缀。
这解释了论文为何选择函数表倒序出现的输入:后续要访问的函数表已经位于很早的 token,起始值和查询却在最后。这样就不能顺着一次从左到右的扫描,按照实际需要的顺序直接完成所有函数计算。(Sec. 2.4,pp. 4–5。)
本文没有提出一个新模型或训练算法。“Hybrid-Hierarchy”仅为本笔记的主题归档名。主要贡献是把既有的不可区分分解方法扩展到同时包含全注意力消息和循环状态消息的模型。
二、模型、任务与计算机制
2.1 符号和容量口径
| 符号 | 含义 |
|---|---|
| $n$ | 输入 prompt 的 token 数 |
| $H,d,p$ | 头数、每头表示维度、每个数的精度位数;完整 token 表示维度为 $Hd$ |
| $L$ | 主问题中函数复合的步数;在一般网络定义中也用于全注意力层数,须按上下文区分 |
| $a_\ell$ | 第 $\ell$ 个全注意力层之后的循环层数 |
| $Hdp$ | 定理使用的表示容量尺度;不等于整个网络的参数数目 |
| $C=Hd(d+1)p$ | 标准线性注意力每层跨 token 边界的状态位数 |
| $m,n_\ell,N_\ell$ | 函数复合任务的初始域大小、检索范围扩展因子、累计域大小 |
| $B,k$ | 稀疏模型的块大小和被选中的块数 |
有限精度非常关键:如果一个实数允许承载无限多信息,基于“消息共有多少种”的计数就不再适用。论文把局部逐 token 运算放得很宽,MLP 可为任意函数,并允许利用前层表示和注意力输出。因此,障碍主要来自跨 token 信息如何传递,而非某个具体激活函数不够强。(Sec. 2.1–2.2,pp. 3–4。)
2.2 全注意力:查询形成后访问前缀
省略层和头的索引,写成常见列向量约定:
$Q,K,V\in\mathbb R^{d\times Hd}$,$y_i\in\mathbb R^d$。这里“full”指对全部可见前缀做注意力,仍然使用因果掩码。下一层的 $q_i$ 可以包含上一层检索得到的中间答案,于是新的全注意力层可以针对新的地址再次访问函数表。(原式 (1),p. 3。)
2.3 线性注意力:状态容量为 $d^2+d$
令 $\varphi:\mathbb R^d\to\mathbb R^d$ 为特征映射。用列向量统一原文的外积方向,可写为
因此一个头只需携带矩阵 $S_i$ 和向量 $Z_i$,共 $d^2+d$ 个数;$H$ 头共占 $Hd(d+1)p$ bits。原文引理 2.2 将其视为 RNN,RNN 的状态更新和读出可为任意函数。(pp. 4、24。)
这一抽象允许讨论更广的循环架构。作者将 Mamba、RWKV、DeltaNet 等纳入讨论,其共同点是因果递推和受限状态。将定理用于具体实现时,应代入该实现实际需要保存的全部状态位数;“可以写成 recurrence”本身并不意味着状态容量恰好等于 $Hd(d+1)p$。
2.4 混合架构的准确层数
定义 2.3 中的 $(r,a_1,\ldots,a_r)$ 混合网络按如下顺序运行:
其中 $F$ 为一个全注意力层,$R^{a}$ 为 $a$ 个循环层,总深度为 $r+\sum_j a_j$。这里临时用 $r$ 表示全注意力层数,以避免与任务步数 $L$ 混淆。
主定理令 $r=L-1$、每个 $a_j=2^{3L^2}$,所以循环层总数是 $(L-1)2^{3L^2}$。摘要中的指数层数应结合这个定义理解,不能把每个区段的层数误读为全网络总数。(定义 2.3,p. 4;定理 1.1,p. 1。)
2.5 顺序函数复合:表、地址和输出
任务给定 $L\ge2$、初始值 $z_0\in[m]$、函数表 $z_1,\ldots,z_L$,以及查询
定义
计算为
最后输出 $i_L$。二元组 $(w_\ell,i_\ell)$ 通过固定双射编码进 $[N_\ell]$;因为 $N_\ell=n_\ell N_{\ell-1}$,其范围正好匹配下一张表的定义域。正文式 (2) 的乘积下标有笔误,上式采用附录式 (7) 的一致写法。(定义 2.5,p. 4;式 (7),p. 17。)
输入排列为
每张函数表的每个表项占一个 token,$z_0,w$ 各占一个,因此
下面是本次构造的教学例子,取 $L=3,m=3,n_1=n_2=2$,选取表项 $z_1(2)=3$、$z_2(2,3)=5$、$z_3(1,5)=9$,其他表项可任意合法填充。它展示计算依赖,不是定理使用的巨大困难实例。
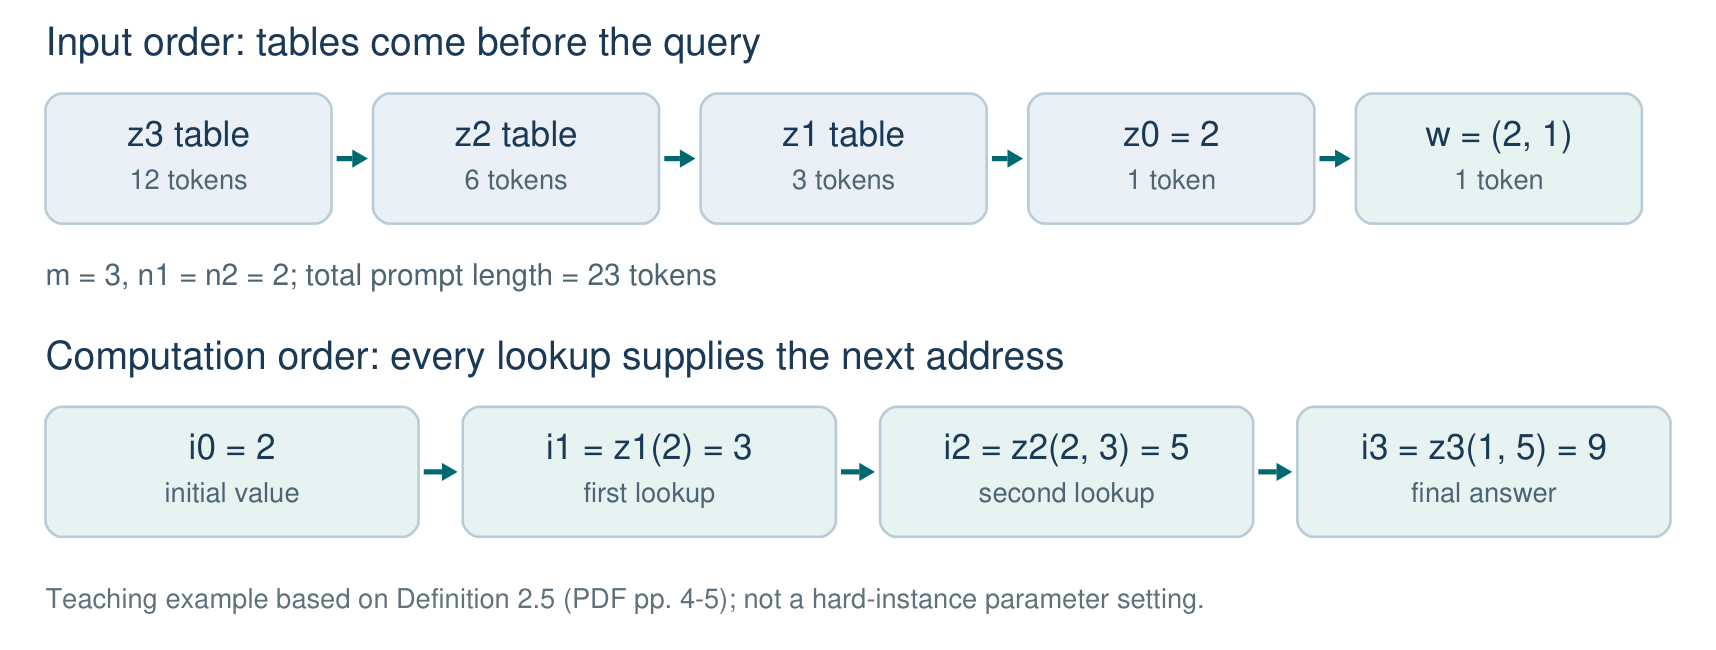
图为根据定义 2.5(pp. 4–5)绘制的教学示意,非论文原图。上排是因果输入顺序,下排是从 $z_0=2,w=(2,1)$ 出发的检索链,答案为 9。
2.6 为什么 $L+1$ 个全注意力层够用
在最终查询 token 上,先用一层拿到 $z_0$,随后用 $L$ 层依次检索 $z_1$ 到 $z_L$。中间的 MLP 将 $w_\ell$ 和刚拿到的 $i_\ell$ 合成下一个地址。这里“先取初值,再做 $L$ 次查表”解释了 $L+1$ 的来源。
附录 C 给出单层检索头:为表项附上二进制地址,匹配地址的点积得分高于其他地址,放大 softmax 前的得分间隔后,再利用有限精度或局部阈值运算恢复离散值。地址位宽和所需精度都只随 $\log n$ 增长。本文表 1 中完整的 $L+1$ 层上界归于 Chen、Peng、Wu 的既有结果;附录 C 具体展开的是函数求值和排列复合检索头。(Table 1,p. 2;App. C,pp. 23–24。)
三、主定理与证明:从网络转成通信问题
3.1 定理到底分离了什么
令 $A=2^{3L^2}$。作者报告的比较如下,$L$ 视为固定常数:
| 架构 | $L$ 步复合所需容量 | 来源 |
|---|---|---|
| $L$ 层因果全注意力 | 多项式级必要容量 | 既有工作;本文表 1 |
| $L+1$ 层因果全注意力 | 多对数级容量足够 | 既有工作;本文表 1 |
| $L-1$ 层全注意力,每层后接 $A$ 层循环 | $Hdp\le n^{2^{-4L-2}}$ 时不能对所有输入正确 | 本文定理 1.1 |
“不能解决”是确定性、最坏情况、精确计算意义下的表达能力下界:对每个符合预算的网络,都有合法输入使其出错。它不提供随机数据上的错误率,也不讨论训练能否找到上界构造。
指数循环深度与容量条件必须一起读:
| $L$ | 每段循环层数 $2^{3L^2}$ | $Hdp$ 上限 |
|---|---|---|
| 2 | 4,096 | $n^{1/1024}$ |
| 3 | 134,217,728 | $n^{1/16384}$ |
| 4 | 281,474,976,710,656 | $n^{1/262144}$ |
这是渐近分离。比如本次代入 $L=2,n=2^{20}$,容量条件仅允许 $Hdp\le2^{20/1024}\approx1.0136$,已低于证明采用的 $Hdp\ge2$。所以这个具体定量下界不能直接用来预测百万 token 上实际大模型的表现。
正文 Sec. 4.1 还讨论较强布局 $(L,0,A,\ldots,A)$:增加一个全注意力预处理层,但第一层之后不接循环层。主定理自身比较的是 $L-1$ 对 $L+1$ 个全注意力层;若要讲“少一层”,必须说明使用的是上述加强布局。(p. 6。)
3.2 两类消息对应两类注意力
设 $L+2$ 个玩家,编号 $L,L-1,\ldots,0,-1$,分别持有 $z_L,z_{L-1},\ldots,z_0,w$。较大的编号对应 prompt 中较早的部分。玩家 $i\ge1$ 持有 $m_{(i)}=N_{i-1}$ 个 token,玩家 $0,-1$ 各持有一个。
全注意力轮。 接收者 $i$ 将当前信息发给前面的玩家 $j>i$;对方针对查询返回 soft transcript $\Pi_{j,i}^{(\ell)}$。返回内容可以是局部 softmax 分子与归一化分母,再由接收者汇总。每个接收 token 的成本为 $O(Hdp)$,论文采用
发送查询的一方可以提供自己的整个当前信息,这使通信模型比实际网络更宽松;证明这个模型仍做不到,才可推出网络下界。前面的玩家会忘掉用于回应的后方查询,从而保持因果状态不受未来 token 改写。(Sec. 3,p. 5。)
循环轮。 状态按
传递,每条边携带一个 $C=Hd(d+1)p$ bits 的 linear transcript $\Sigma$。前缀发送的状态不依赖尚未出现的后方输入;每个玩家可以在收到状态后用自己的全部局部表项更新它。
一个 epoch 模拟“一个全注意力层 + $a_\ell$ 个循环层”。关键差别不是哪一种消息天然更长,而是:soft transcript 可依赖接收者的当前查询,循环边界状态则必须预先概括前缀。
3.3 为什么需要“不可区分分解”
只证明两个前缀在一次压缩后碰撞还不够:后面的全注意力层可能再次访问原始前缀,把它们区分开。归纳证明需要构造在多轮交互后仍无法区分的大输入族。
在第 $\ell$ 步,选取
其中 $A_\ell$ 是函数 $z_\ell$ 的全部可能取值集合。固定任意较后方输入 $z_{<\ell}\in Z_{<\ell}$,当较前方输入在 $R_{\ge\ell}$ 中变化时,流向后方的相关 soft 和 linear transcripts 在前 $\ell$ 个 epoch 完全相同。
同时保留两种规模:
$\mathcal I$ 是仍可到达的中间函数值集合。第一个条件说剩下的前缀函数仍然很多,第二个条件说后方查询仍能触及很多地址。只有两者都大,才能迫使“同一可见信息”对应不同正确答案。(定义 4.1,p. 6;定义 B.4、引理 B.5–B.7,pp. 18–19。)
3.4 归纳如何保住足够多的输入
基步 $\ell=2$。 固定所有查询下玩家 1 给查询玩家的首轮 soft transcript。消息模式总数有限,由抽屉原理可留下很大的函数集合。从中选取 $Z_1$,使 $z_1(Z_0)$ 仍覆盖很多输出;随后依次固定其他 soft transcripts 和从玩家 2 向后传递的循环边界状态,取一致性集合最大的模式。留下的集合成为 $R_{\ge2}$。(Sec. 4.2,p. 7;App. B.2,pp. 20–21。)
归纳步 $\ell\to\ell+1$。 从 $R_{\ge\ell}$ 中提取矩形子集 $S_1^{(\ell)}\times S_2^{(\ell)}$,令 $Z_\ell=S_2^{(\ell)}$。矩形意味着 $Z_\ell$ 中每个选择都可与 $S_1$ 中每个前缀组合。继承已有固定消息,固定下一 epoch 的 soft transcripts,然后固定新的循环边界消息。参数选择保证每次筛选后仍留下足够大的集合。(引理 B.9–B.13,pp. 21–23。)
本文相对先前证明的关键补充是引理 B.11:不仅要说明 soft 消息不随 $z_\ell$ 改变,还要沿玩家顺序递推,证明已经固定的循环消息不会把 $z_\ell$ 的差异重新泄漏给后方玩家。这样后方玩家的新查询也相同,下一轮 soft 响应才可以统一计数。(p. 22。)
3.5 最后一步矛盾的直观计数
以下是对引理 B.5 的教学展开。到 $\ell=L$ 时,令 $N=N_{L-1}$,$R_{\ge L}$ 中有许多可能的最终函数 $z_L:[N]\to[N]$。末个检索地址由 $(w_{L-1},i_{L-1})$ 构成;由于 $w_{L-1}$ 尚未参与前面的计算,可触及至少
个地址。若协议始终正确,由不可区分性,这些最终函数必须在所有 $t$ 个地址上取相同值。
总共 $N^N$ 张函数表;在 $t$ 个位置上固定值后,最多剩下 $N^{N-t}$ 张。而归纳保留了至少 $N^N/\Delta_L$ 张。参数保证
因此剩下的函数多到不可能全部在这些地址上一致,产生矛盾。这就是“保留很多函数”和“保留很多可访问位置”两个不变量的共同作用。(引理 B.5,p. 19;参数式 (10)–(11),p. 17。)
3.6 指数多个循环层怎样被计入预算
附录 B 使用如下参数,其中令 $c=Hdp$ 仅为缩写:
$x_\ell$ 控制保留集合 $Z_\ell$ 的大小;损失因子和覆盖下界为
定理 B.2 的主要循环消息预算条件是
左边是需要固定的循环边界消息总位数,右边是计数中能够承受的信息损失。若有 $s$ bits 的消息,至多有 $2^s$ 种模式;固定最大的模式,最多损失这个因子。于是循环层增多的影响被显式加进指数,而困难实例的域大小增长得更快,仍能保住归纳不变量。(式 (5)–(12),pp. 17–18。)
引理 B.1 再把困难实例总长度控制在 $n\le c^{4\cdot16^L}$;作者由此给出主定理的容量指数 $1/(4\cdot16^L)=2^{-4L-2}$。这些夸张参数用于存在性证明,没有实际网络的超参数调优含义。
3.7 v1 主证明中值得区分的两处问题
第一 epoch 的循环层。 正文 Sec. 4.1(p. 6)采用 $(L,0,A,\ldots,A)$;附录定理 B.2(pp. 17–18)却允许 $a_1\le1$。在基步 p. 20,作者认为固定 $\Pi_{1,-1}^{(1)}$ 后,查询玩家的 $X_{-1}^{(1)}$ 不再依赖 $z_1$。对 $a_1=0$,这个理由与正文布局一致;对 $a_1=1$,循环链还可以把依赖 $z_1$ 的 $\Sigma$ 传给查询玩家,而该段论证尚未固定这部分信息。因此,这一更强版本的基步需要额外解释。
这是本次阅读定位到的证明问题,并不是对主定理的反例。主定理所需的 $L-1$ 个全注意力层可通过添加一个恒等全注意力预处理层,嵌入 $a_1=0$ 的布局;本笔记用这一布局解释主线,不把附录 $a_1=1$ 的加强说法当作已无缺口的推论。
状态位数的一个代数笔误。 引理 B.3(p. 18)写出 $C\sum a_r\le2cL2^{3L^2}$,其中把 $d+1$ 因子漏掉了。对正整数 $H,d,p$,有 $d\le c$,所以可改用
该处可用已有的大常数余量修正,性质与上一处需要补充信息流论证的问题不同。
四、其他理论结果及其含义
4.1 函数求值:一个查询也可能需要保存整张表
$\mathsf{Eva}(f,x)$ 的 prompt 是 $f(1),\ldots,f(n),x$,答案为 $f(x)$。Alice 持有前面的函数表,Bob 持有最后的查询。在因果 RNN 中,Alice 产生的边界状态不依赖 $x$;$L$ 层、$H$ 头、每头 $m$ 个状态数,总共最多给 Bob $LHmp$ bits。
共有 $n^n$ 张不同函数表。如果
必有 $f_1\ne f_2$ 产生同样的全部消息。选一个使 $f_1(x)\ne f_2(x)$ 的查询,Bob 就无法保证正确。代入线性注意力的 $m=d(d+1)$,得到定理 A.3;任意状态更新与读出并不能消除这个碰撞。(定理 A.3、A.4,pp. 12–13。)
这里的“整张表”是对所有可能查询必须精确回答的通信需求。单个特定查询当然只返回一个值,但发送摘要时还不知道未来会问哪一个位置。
4.2 排列复合与 log-linear 注意力
$\mathsf{PerCom}(\sigma,\tau)$ 的输入依次给出两个排列,输出 $\sigma(\tau(1)),\ldots,\sigma(\tau(n))$。Alice 持有 $\sigma$,Bob 持有 $\tau$;因为 $\tau$ 遍历所有地址,正确的输出要求区分 $n!$ 个 $\sigma$。同样的通信计数给出 $LHmp\ge\log_2(n!)$。(定义 A.2,p. 12;定理 A.6、A.7,p. 14。)
log-linear 注意力保留多个尺度的矩阵状态,附录 A.3–A.4 的通信证明采用每层 $O(Hd^2p\log n)$ bits。因此检索下界少了一个对数因子,但仍随 $n$ 线性增长。下表统一写成成功所必需的容量,并与单层 full attention 的充分容量相比较:
| 任务 | 标准线性注意力的必要条件 | log-linear 的必要条件 | 全注意力充分条件 |
|---|---|---|---|
| $\mathsf{Eva}$ | $LHd(d+1)p\ge n\log_2n$ | $LHd^2p=\Omega(n)$ | 一层,$Hdp=\operatorname{polylog}(n)$ |
| $\mathsf{PerCom}$ | $LHd(d+1)p\ge\log_2(n!)$ | $LHd^2p=\Omega(n)$ | 一层,$Hdp=\operatorname{polylog}(n)$ |
来源:定理 A.3–A.8,pp. 12–15;附录 C,pp. 23–24。原文使用“$<\Theta(n)$ 时不可解”的写法;表中转为渐近必要下界,避免把未给出的常数当作精确阈值。
附录 A.1(p. 12)另有特殊递推仅需 $3d^2$ 个状态数的表述,但后续证明实际按 $O(\log n)$ 个矩阵状态计费。该“只有三个可能非零状态”的说法与展示的递推并不普遍一致:按其规则从零状态依次更新到 $i=15$,$r=0,1,2,3,4$ 均可非零。本笔记采用后续下界证明真正使用的对数状态预算。
4.3 CoT 为什么没能绕过这些检索下界
在附录的 CoT 模型里,第三位玩家 Charles 模拟在原输入之后生成的全部思维链 token。他获得的信息完全来自 Bob 已经拿到的状态和输出。Bob 如果拥有所有这些信息,也可以本地模拟 Charles 的计算。
因此,追加再多 token 也无法恢复压缩摘要已经丢失、且没有新通道读回原始前缀的区别。这个结论覆盖附录的纯循环/log-linear 检索模型及其信息访问规则;它不意味着能重新注意到原始 token 的 Transformer CoT 也无效。主混合定理本身讨论单次前向传播,没有给出一般混合架构任意 CoT 的相同下界。(App. A.2–A.4,pp. 13–15。)
4.4 块稀疏注意力:选择前的摘要也有代价
论文的 $(B,k)$ 模型先把每 $B$ 个 token 压缩成一个表示,再根据当前查询和压缩表示选 top-$k$ 个块,组合压缩通路和选中块通路。下界使用一个更宽松的协议:$q=n/B$ 个玩家各持有一块,每个先发送 $Hdp$ bits 的摘要;查询玩家随后可完整读取其中 $k$ 块。(定义 2.4,p. 4;Sec. 5,p. 8;App. A.6,p. 16。)
2-Sum 要求在每个位置判断前缀中是否存在满足
的值。设两个块 $a,b$ 含有不同的值集合,却得到同一个摘要。取 $v\in a\setminus b$,查询为 $-v\bmod M$,让所有被读取的块都为 $b$。只要有一个未被读取的块,将它从 $b$ 换成 $a$ 就会翻转正确答案,而查询玩家看到的全部信息不变。
所以在该共享压缩函数、仅由摘要驱动选择的模型下,为保证精确成员查询,摘要必须区分所有可能的块值集合。作者在 $M=n$ 的情形得到计数
原文包含空集项 $j=0$,对非空定长块实际可实现的是 $j\ge1$,不影响渐近分析。原文定理 1.2 据此声称 $Hdp=\Omega(B\log n)$,与单层全注意力的 $H=1,d=3,p=\log n$ 作比较。(p. 2、p. 16;该 full-attention 上界在本文引用 Sanford 等人的结果。)
该结论需要把范围写完整。
- 单头模型至少要有未读块,即 $k
- 对 $1\le B\le n/2$,上述计数的尺度为 $\Theta(B\log(n/B))$。在 $B\le n^{1-\varepsilon}$、固定 $\varepsilon>0$ 时,它可推出 $\Omega(B\log n)$。若 $B=\Theta(n)$,集合信息量只有 $\Theta(n)$ bits,不能把 $B\log n$ 作为所有块大小下的统一结论。
- 原文采用共享的块压缩映射和依赖压缩表示的选择函数;若选择过程能另行检查所有原始 token,就已经增加了这个协议没有计入的访问通道。
前两点可直接从附录 A.6 的反例和组合数表达式看出。这里区分作者的简写结论和计数本身支持的范围,对理解稀疏化的代价至关重要。
4.5 附录 2-Sum 下界中的数值域冲突
定义 2.6(p. 5)规定 $M=O(n)$;定理 A.9 的证明(p. 15)却明确取 $M=n^2$,用
得到线性注意力总状态的 $\Omega(n\log n)$ 下界,并据每层额外的 $\log n$ 因子得到 log-linear 的 $\Omega(n)$ 下界。证明过程中还交替使用 $\bmod n$ 与 $\bmod M$。
对扩大后的域 $M=n^2$,统一采用模 $M$ 后,这个集合计数支持上述尺度;但 $M=n^2$ 不满足正文的 $M=O(n)$。
若坚持正文的域大小,前缀值集合最多有 $2^M=2^{O(n)}$ 种,所以该集合计数最多提供 $O(n)$ 量级的信息需求。取允许的 $M=n$,确实能构造 $2^{\Theta(n)}$ 个不同集合,于是同一论证给出线性注意力 $LHd(d+1)p=\Omega(n)$,以及 log-linear $LHd^2p=\Omega(n/\log n)$ 的必要条件。这里是对原文计数方法的域一致性分析,不能把不同 $M$ 下的下界放到同一个比较栏里。
4.6 检索头上界的一个可读构造
附录 C 的核心可用如下统一缩放解释。令地址 $a_i,a\in\{0,1\}^D$,将其扩展为
则
唯一匹配地址比其他位置至少高 $\lambda$ 分,匹配位置的概率满足
取 $\lambda=\Theta((\log n)^2)$,误差很快小于多项式精度阈值,局部读出可恢复离散的 $b_i$。这说明“查表所需的选择性”能够用多对数维度和精度实现。
这是对原文机制的教学重写。原文 p. 24 同时把 $Q$ 和 $K$ 放大 $\log^2 n$,却将点积写成 $\log^2 n$ 量级,代数上应为 $\log^4 n$;用上述 $\sqrt\lambda$ 约定即可统一。更强的缩放仍产生匹配间隔,但不应照抄不一致的等式。
五、结论与研究启发
这篇论文提供的主要思想是:按当前查询重新访问输入的轮数,与有限循环状态的计算深度,是两种不同的资源。 不可区分分解将这种差别落实为可计数的信息流约束,并解释了为什么在专门构造的顺序检索任务上,大量循环层仍可能不足。
对混合架构的实际启发是同时考虑全注意力层的数量、位置,以及循环状态的真实位容量。全文没有提供最佳层比例或实际模型准确率的验证;其很弱的 $n$ 指数和巨大的任务域,使它更适合作为架构能力的存在性边界,而非工程阈值。
对论文结果应保留三个层次:主混合定理的正式陈述;围绕 $a_1=0$ 布局可以清楚解释的通信与归纳主线;以及 v1 中仍需澄清的加强基步、稀疏参数范围和 2-Sum 数值域。把这些层次分清后,既能理解核心贡献,也能准确使用各个下界。
值得继续研究的具体问题包括:能否改进 $Hdp$ 与 $n$ 的指数关系,使下界在较现实的长度上具有约束力;能否在固定总状态预算下刻画全注意力层的位置;以及允许近似答案、分布假设或额外检索通道后,不可区分分解还能保留多强的结论。这些是由本文引出的研究问题,论文尚未给出对应结果。
参考文献
- Xiaowei Ye, Xiaoyu He, Chao Liao, Chen Wu, Pinyan Lu. A Provable Expressiveness Hierarchy in Hybrid Linear-Full Attention, arXiv:2602.01763v1, 2026。本笔记的主要来源。
- Lijie Chen, Binghui Peng, Hongxun Wu. Theoretical limitations of multi-layer Transformer, arXiv:2412.02975v1。本文使用的顺序函数复合问题、全注意力深度比较及不可区分分解的前序工作;本文参考文献列为 FOCS 2025。
- Clayton Sanford, Daniel Hsu, Matus Telgarsky. Representational Strengths and Limitations of Transformers, NeurIPS 2023。本文对 2-Sum 全注意力上界的引用来源。