Mixture-of-Top-k Attention:中文精读笔记
- 论文:Mixture-of-Top-k Attention: Efficient Attention via Scalable Fast Weights。
- 作者:Qishuai Wen、Zhiyuan Huang、Wei He、Xianghan Meng、Chun-Guang Li(按 PDF 首页顺序;arXiv 摘要页将中间两人顺序互换)。
- 版本:arXiv:2602.01219v5,修订于 2026-05-09;获取与研读日期:2026-09-21。
- 材料:原文 PDF、作者主源码、源码原始 PDF 图件。TeX 获取成功;正文均在
main.tex,已阅读正文 §1–5 与附录 A–D,结合 17 页 PDF 核验。参考文献用于定位,并未逐篇外延阅读;未运行作者代码或复现实验。 - 成品:英文幻灯片 · 可编辑 TeX。以下页码均为从 1 开始的 PDF 页码,与本版印刷页码一致。
论文总览
MiTA 的研究问题是:能否保留对原始 key–value 的精细读取,同时避免每个 query 都独立搜索全部 keys?作者用少量代表性查询(landmark queries)先构建可复用的 top-k 键值集合,让所有 query 路由到这些集合;同一批 landmarks 又生成全局压缩记忆。最终每个 query 对“压缩记忆 + 一个被选中的原始键值集合”做一次联合 softmax。
这篇论文最有价值的设计是将稀疏模式的构建与使用解耦:每个输入生成 $m$ 个模式,再供 $N$ 个 query 复用。这里的 expert 是动态键值子集,不是额外训练的 FFN 参数。它把纯压缩的细节损失与纯路由的全局信息不足放到同一框架内处理。
证据最明确的效率结果来自 LRA:五任务平均准确率从标准注意力的 58.19% 变成 58.91%,总训练时间从 10.6 小时降至 2.4 小时(约减少 77.4%)。这不等于每项任务都更准,也不等于比所有高效注意力都快。ImageNet 基础 MiTA 接近而未超过全注意力;ADE20K 在减少计算的同时损失 1.2–2.8 个 mIoU 百分点。正文若干较强表述应结合这些具体结果理解。
结构地图
| 原文位置 | 主要作用 | PDF 页码与证据 |
|---|---|---|
| §1 Introduction | 快速权重视角、五维分类与贡献 | pp.1–3;表1、图1–2 |
| §2 Related Work;§2.1 Fast-Weight Scaling;§2.2 MoE-Inspired Sparse Attention;§2.3 Deformable Attention | 区分压缩、块路由、逐 query top-k | pp.3–4 |
| §3.1 Efficient Attention as Scaling Fast Weights | 注意力与快速权重 MLP 的形式对应 | pp.4–5;式(1)–(4) |
| §3.2 Mixture-of-Top-k Attention (MiTA) | 专家构建、压缩、路由、联合归一化及实现 | pp.5–6;式(5)–(12)、图3 |
| §4.1 Image Classification | 基础机制与附加模块分开比较 | p.8;表2–3、图4在 p.7 |
| §4.2 Semantic Segmentation | 高分辨率下的计算—精度取舍 | pp.8–9;表4在 p.8 |
| §4.3 Evaluation on Long Sequences | LRA 与实际吞吐 | p.9;表5、图5 |
| §5 Conclusion | 概念框架与方法贡献 | pp.9–10 |
| Appendix A: Ablation Study | landmark 提取、$m,k$、双分支消融 | pp.14–15;表6、图6 |
| Appendix B: Fit MiTA into the Fast-Weight Scaling Taxonomy | 专家拓扑、重叠分析、伪代码 | pp.15–16;图7–8、算法1 |
| Appendix C: Algorithmic Generalization | 固定权重替换、超参数变化、再微调 | p.17;图9–10在 p.16,表7在 p.17 |
| Appendix D: Limitations | 领域与资源限制 | p.17 |
一:动机
1.1 序列增长意味着临时记忆容量与读取开销同时增长
慢权重是训练得到、推理时通常固定的模型参数;快速权重(fast weights)则是当前输入诱导出的临时计算状态。对一个注意力头,$N$ 组 key–value 可以被看成一个宽度为 $N$ 的两层网络。序列越长,它能保存的细粒度信息越多,但每个 query 的读取也越贵。处理 $N$ 个 query 的全注意力因此有二次计算开销。
作者把已有办法分成两条路线:压缩是将整个记忆概括成小模块,路由是每次只读取原始记忆的一部分。前者有信息瓶颈;后者保留被选中条目的原始内容,却可能漏掉未选中的全局信息。原文 p.5 所谓路由“lossless”应限于被选中的 K/V 未被压缩,不能理解成相对全注意力输出无损。
1.2 MiTA 要解决两种粒度问题
- 固定块专家:MoBA 等以连续块构建专家,硬件友好,但一个语义对象可能跨越多个块,块内也可能混有无关 token。
- 逐 query 的 top-k:更细致,却需要为 $N$ 个 query 各自形成一个稀疏集合,专家数随 $N$ 增长,集合之间还可能高度重复。
- MiTA:以 $m$ 个 landmarks 搜索内容相关的 K/V,每个集合可以跨位置、与其他集合重叠,然后让 query 选择并复用集合。位置只用于提取初始 landmark,并不限制最终专家的形状。
五维分类分别是扩展策略、专家数量、专家类型、专家构建方式和路由拓扑(§3.1、表1)。它是设计和比较工具,而非“所有注意力方法已经被严格等价统一”的定理。MiTA 有 $m$ 个路由专家,外加 1 个共享专家;共享专家内部宽度为 $m$,不要将其误数为另 $m$ 个专家。
二:方法
2.1 符号与快速权重表达
| 符号 | 含义与维度 |
|---|---|
| $N,d$ | 当前序列长度、单头特征维数 |
| $Q,K,V\in\mathbb R^{d\times N}$ | 列为 token 的 query、key、value;沿用作者列向量约定 |
| $\tilde Q,\tilde V\in\mathbb R^{d\times m}$ | landmark queries 及其汇聚得到的 values |
| $m,k,s$ | 路由专家数、每专家 K/V 条目数、每 query 选中的路由专家数 |
| $\mathcal I_i$ | 第 $i$ 个专家的 $k$ 个原始位置索引 |
| $e_j(q)$ | query $q$ 路由得分排第 $j$ 的专家编号 |
| $K^\star,V^\star$ | 某个 query 实际访问的 $m+ks$ 个条目 |
全注意力(式(1),p.4)是
作者令 $\hat K=K/\sqrt d$,$Z(q)=\sum_{j=1}^N\exp(\hat k_j^\top q)$,$\hat V=V/Z(q)$,得到
这对应隐藏宽度 $N$、指数激活、零偏置的两层表达(式(3)–(4),p.5)。注意:$\hat V$ 仍依赖当前 $q$ 的归一化项,所以这是注意力的精确代数重写,不是仅给定 K/V 后、对所有 query 都有同一组固定权重的普通逐元素激活 MLP。也可以直接把 softmax 当作整体激活来理解 K/V 的“网络权重”角色。
2.2 第一步:少量 landmarks 同时负责选细节与做摘要
默认对二维 query 网格做平均池化,得到 $\tilde Q$。每个 landmark $\tilde q_i$ 对所有 keys 打分:
从第 $i$ 列取 top-k 索引,形成专家:
专家自身对 query 的读取是 $\mathcal E_i(q)=\operatorname{Atten}(q,K^{(i)},V^{(i)})$。top-k 的常数缩放不影响排名,因此原文式(7)省略 $1/\sqrt d$。这里选中的 K/V 是原始条目,并非平均值;“deformable”指位置集合按内容变化,不涉及预测几何偏移或插值。依据:式(5)–(7),p.6。
同一打分矩阵沿 $N$ 个 keys 做 softmax,又得到全局摘要:
一个 landmark 对应一个全局加权汇聚 value。共享专家用 $\tilde Q$ 作为 keys,$\tilde V$ 作为 values:
这解释了为什么省去了额外的专家中心计算。选 top-k 与形成摘要共享 $K^\top\tilde Q$;共享专家与路由又共享 $\tilde Q^\top Q$。依据:式(8)–(9),p.6。
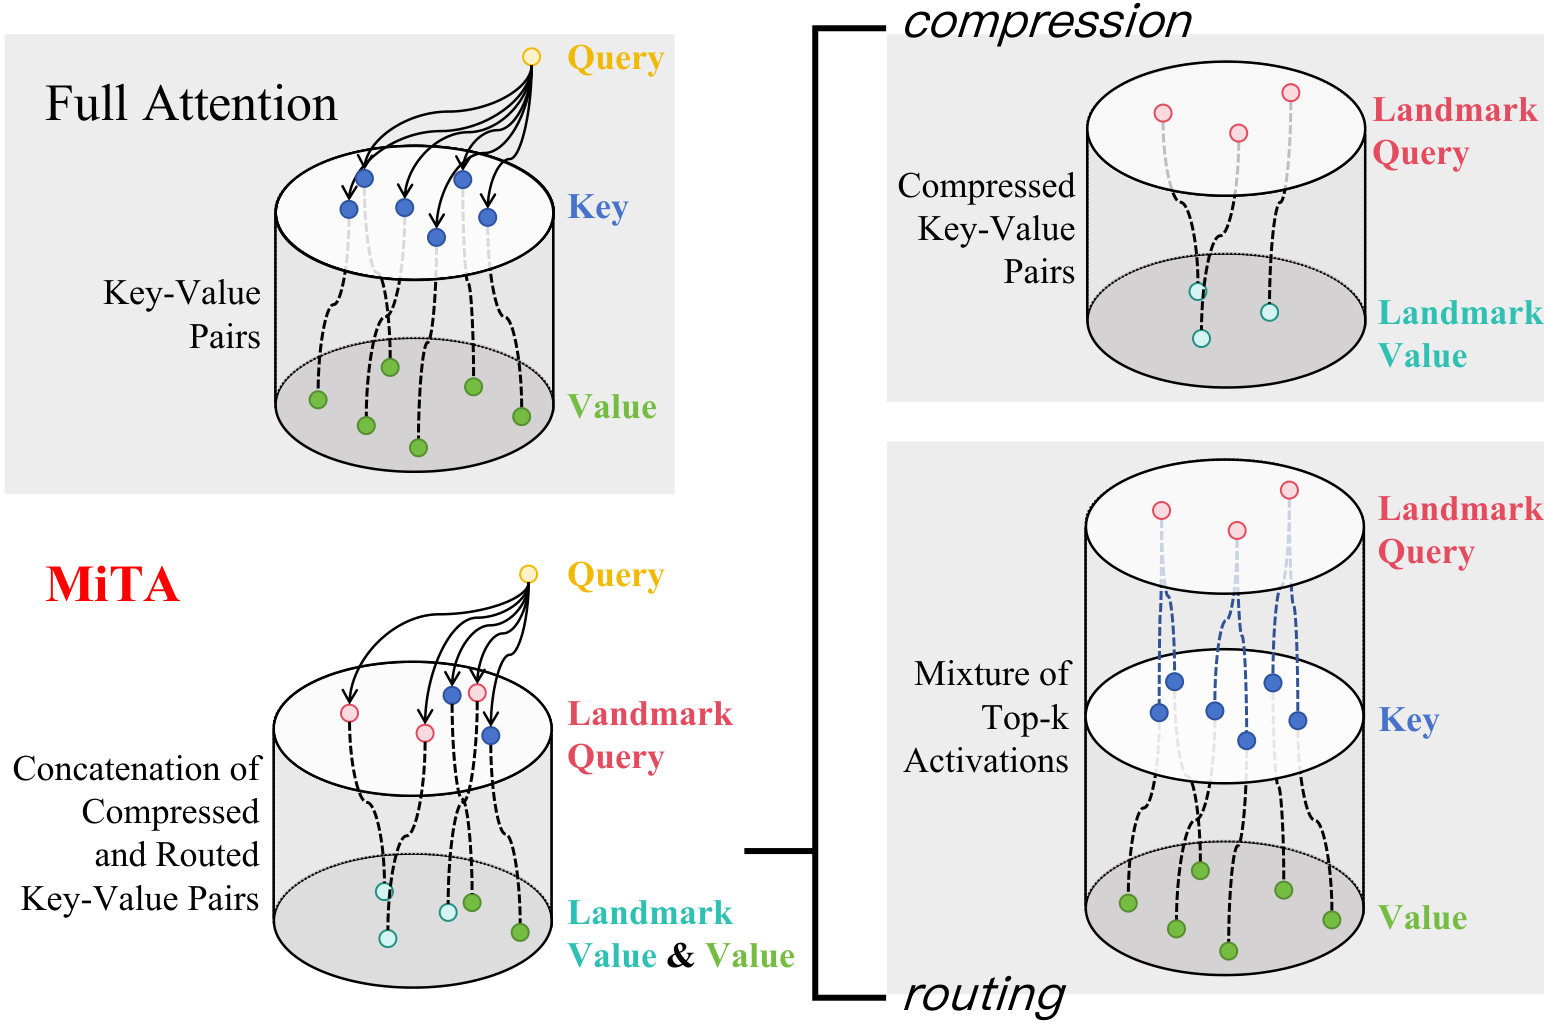
原图2,PDF p.3,直接来自作者 mita_v9.pdf。右侧上半部是压缩,下半部是按 landmark 收集原始条目;左下的读取把两类条目拼接。示意的 3 个压缩条目和 2 个原始条目是教学规模,不是实验配置。
2.3 第二步:query 选择专家,再联合归一化
对 $q$,用 $\tilde Q^\top q$ 选择得分最高的 $s$ 个专家。所有实验采用 $s=1$。最终计算为
来源:式(10)–(12),p.6。关键不只是有两个分支,而是在压缩条目与原始条目之间进行统一 softmax 竞争。这与给两个已经归一化的输出简单求和不同。
若分别计算共享与路由分支,设其输出为 $o_c,o_r$,softmax 分母为 $Z_c,Z_r$,则联合输出是
实现可利用每个分支的 log-sum-exp 做稳定融合,这是依据原公式补充的推导。在线 softmax 的作用是恢复同一归一化结果,而非近似平均。不同 query 即便复用同一个 K/V 集合,仍分别计算自己的注意力分布,不会被强制产生相同输出。
教学例子:令 $N=8,m=2,k=3,s=1$。两个 landmarks 分别选出 $\{1,4,7\}$ 和 $\{2,4,8\}$。若 $q_5$ 路由到第一个专家,它读取两个压缩条目加上原始位置 1、4、7,共 5 个条目;另一个 query 可复用同样的五条记忆,但其权重不同。原始位置 4 可以属于多个专家,并非互斥聚类。
2.4 实现、训练与复杂度
算法1(p.16)先构建专家,再按专家编号排序 queries,利用变长 FlashAttention 处理各组,最后融合共享分支。训练与推理采用同一注意力结构;论文没有在 MiTA 内加入 TTT 式测试时梯度更新,也没有详述 top-k 离散索引的特殊梯度估计或负载均衡损失,不应自行补造。
作为复现参考,算法1有两点必须澄清:第13行的 ArgSort(ArgMax(...)) 得到的是 query 排列,而第14行 BinCount 应统计排序前的专家标签;若按排列计数,就不能得到各专家 query 数。伪代码也未明确列出把路由输出恢复原 query 顺序的逆排列。这里是对伪代码的检查,未审核 GitHub 实现,不能断言代码存在同一问题。
作者明确称式(10)本身的复杂度为 $O(N(m+ks))$,省略 $d$。加入构建和摘要,主要矩阵乘法仍为 $O(Nmd+Nksd)$ 的同阶量,但完整运行还包括 top-k、排序、gather、内存传输和在线融合。固定 $m,k,s,d$ 时,其注意力矩阵乘法对 $N$ 线性;若调参让它们随 $N$ 增长,就不能继续无条件称整体线性。例如 $m\approx k\propto\sqrt N$ 时,矩阵乘法项为 $O(N^{3/2}d)$,这是本次分析,不是论文另行证明的界。
硬件瓶颈主要是离散 gather 的随机访存。低 FLOPs 不自动意味着高吞吐。论文的长序列测量必须与具体实现、设备和 batch 设置一起解释。
三:实验——问题、协议与比较角色
| 实验 | 检验问题与设置 | 对照及指标 |
|---|---|---|
| ImageNet-1K,表2 | 统一 DeiT recipe,从头训练;224×224,patch 16;$m=k=25,s=1$,每 query 读50条 | 标准注意力;Linear/PolaFormer/MHLA/FLatten 为压缩类;BRA 为路由对照;Agent 为压缩对照;Acc.↑、参数量、FLOPs↓ |
| ImageNet-1K,表3 | 采用 ViT-5 架构改动与其他完整模型比较 | 包括 ViT-5、DeiT-III、SViTE、Sparsifiner、InLine 等;架构与训练配置不同,不是纯注意力受控消融 |
| ADE20K,表4 | ImageNet-21K 预训练 ViT,替换注意力后用于分割训练;§4.2称预训练384、patch16;$m=k=49,s=1$ | 相同 CBT head 的 backbone 配对最可比;mIoU↑、FLOPs↓;512²或640²输入 |
| LRA,表5 | 跟随 Nyströmformer 训练配置;五任务;$m=k=128,s=1$ | 标准注意力使用 PyTorch fused/FlashAttention;Reformer 等经典方法、Agent、MoBA路由变体;准确率↑、steps/s↑、小时↓ |
| 极长序列,图5 | RTX4090 24GB;3层、embedding128;每个 run 单独调 batch 使吞吐最大 | 标准注意力;samples/s↑;图例给出 $mk\approx N/4$,不是固定128配置 |
| 附录A,表6、图6 | landmark提取、$m,k$、共享/路由分支;表6与表2同设置;图6为CIFAR-100 | 准确率↑;图6有OOM导致的未覆盖配置 |
| 附录C,图9–10、表7 | 固定权重替换注意力/超参数,与50 epoch AdamW微调分开 | 固定模型准确率、预训练权重可迁移性 |
精度表主要为点估计,未给出足以判定统计显著性的多随机种子均值、标准差或置信区间。LRA不是自回归大语言模型任务;论文也未报告 LLM 解码实验。
四:结果——逐组理解证据
4.1 图像分类:基础机制接近全注意力,额外模块有独立贡献
表2(p.7)重点数值如下;括号中的差为相同尺度标准注意力的准确率百分点差。
| 模型/设置 | Tiny Acc. | Small Acc. | Small FLOPs |
|---|---|---|---|
| 标准 DeiT | 72.2 | 79.9 | 4.6G |
| Agent,无附加项 | 70.3 | 78.5 | 4.4G |
| Agent + Bias | 71.1 | 79.1 | 4.4G |
| MiTA,无附加项 | 71.1(−1.1) | 79.8(−0.1) | 4.4G |
| MiTA + DWC | 73.4(+1.2) | 80.6(+0.7) | 4.4G |
| MiTA + DWC + Gate | 未报告 | 81.2(+1.3) | 4.7G |
Tiny 中 MiTA 比 Agent 提高0.8个百分点,比 Linear Attention 的68.0提高3.1个百分点。Small 的基础 MiTA 比 Agent 高1.3个百分点。但基础 MiTA 并未超过标准注意力;73.4/80.6/81.2应归因于包含附加设计的完整模型,不能全部算作“稀疏注意力本身”的收益。DWC+Gate 的4.7G也超过标准 DeiT-S 的4.6G。
表3(p.7)中,ViT-5-S为82.2%、4.7G,MiTA-ViT-5-S为81.3%、4.5G,加入DWC后81.7%、4.5G。支持“较少计算下接近所列强基线”,不支持“击败ViT-5”。
4.2 专家可视化与 token pruning 的准确含义
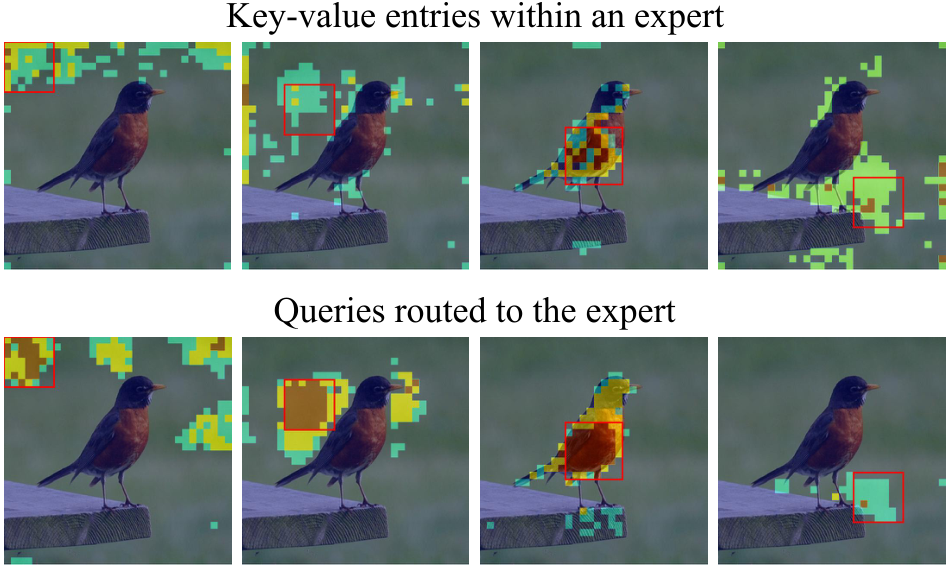
原图3,p.5。红框表示初始平均池化区域;上排是收集的 K/V,下排是被路由的 queries,热图跨注意力头平均。两者均可越过红框,说明局部取 landmark 并不等于局部注意力。
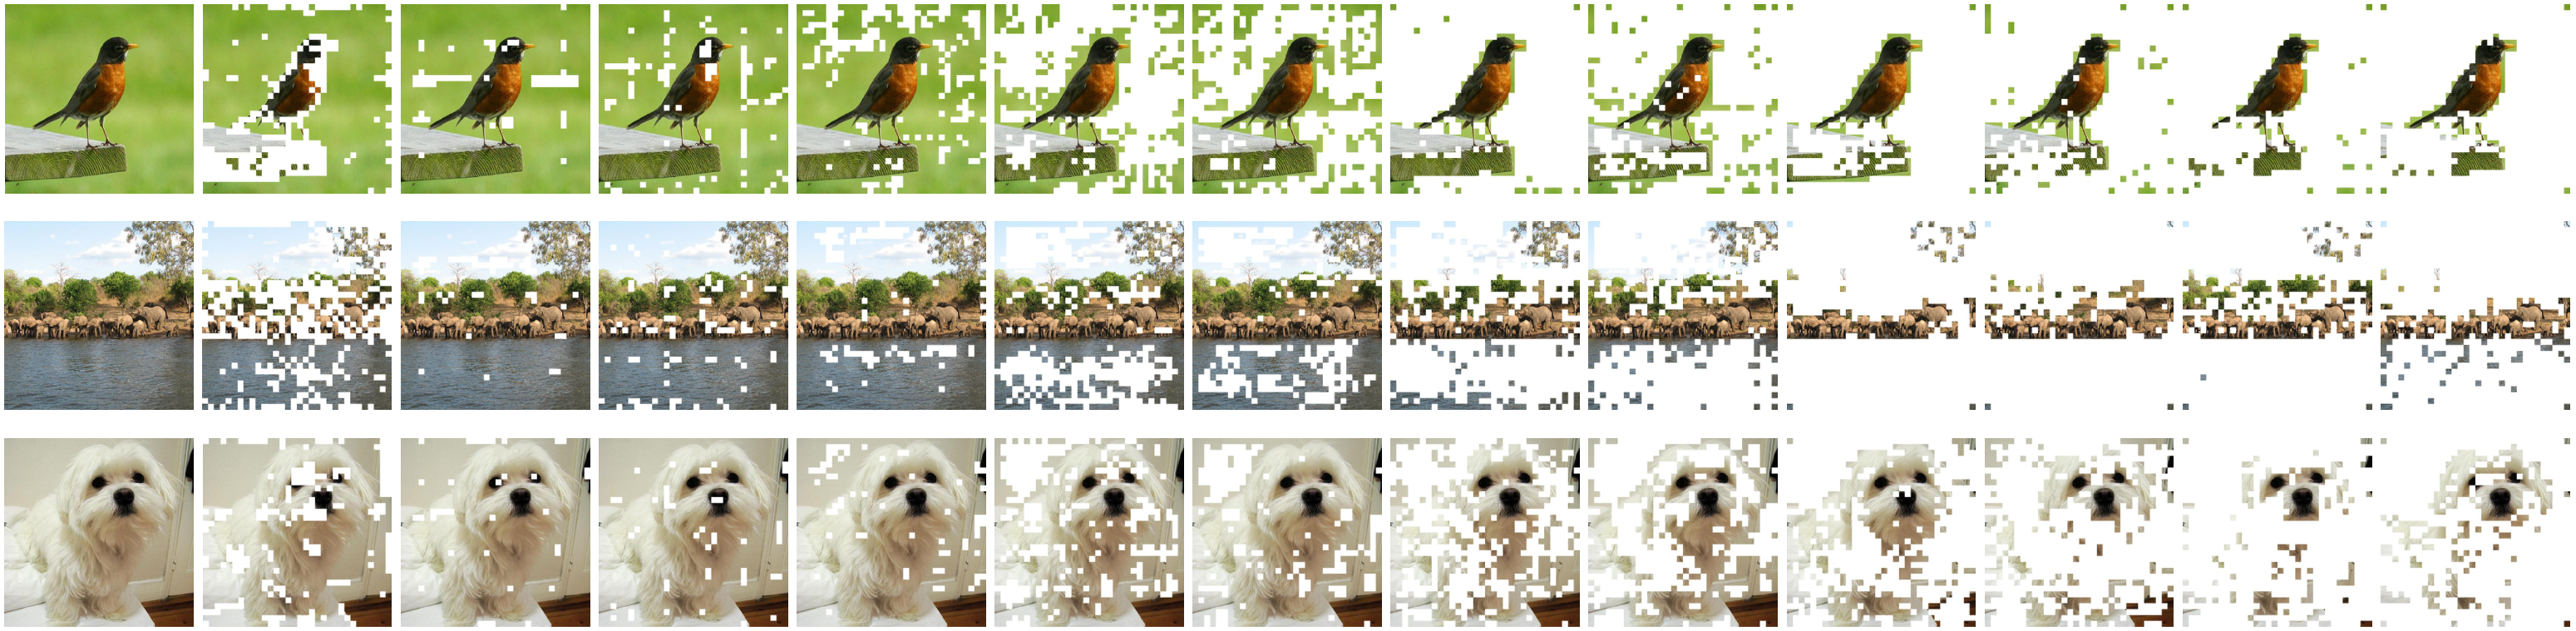
原图4,p.7。每行左端是训练集输入图像,后续列为逐层被专家选中的原始 K/V 位置,跨头聚合。后层更多集中于类别相关区域。这里的“剪枝”只指未进入路由专家集合:共享分支仍从全部 K/V 生成摘要,query 序列也未被直接删除。它不是整个网络 token 数已经减少的测量,也没有提供通用剪枝率或因果语义定位验证。
附录B图8(p.15)进一步测量专家 K/V 位置集合与路由 query 位置集合之间的 mIoU,均值跨专家和头计算。低重叠支持路由不等同于位置相同的硬聚类;不能由此证明所有 query 都保留了需要的精确信息。
4.3 语义分割:计算下降真实,精度损失也不能隐藏
以下只比较 CBT head 相同的配对,来自表4(p.8)。
| Backbone / 分辨率 | 标准→MiTA FLOPs | 标准→MiTA mIoU | mIoU变化 |
|---|---|---|---|
| Tiny / 512² | 12G→7G(约−42%) | 39.1→36.5 | −2.6 pp |
| Small / 512² | 33G→25G(约−24%) | 45.8→44.5 | −1.3 pp |
| Base / 512² | 111G→95G(约−14%) | 49.3→48.1 | −1.2 pp |
| Large / 640² | 622G→508G(约−18%) | 53.3→50.5 | −2.8 pp |
mIoU是类别交并比的平均,越高越好。每个 query 从原来的1024或1600个空间条目减至98个,但整体模型仍有投影和FFN,故模型FLOPs不会按注意力条目比同比下降。MiTA backbone不是原生以该机制预训练,这是比较的重要限制;该实验不是“固定分割模型零训练直接替换仍保持精度”。
4.4 长序列:需分开准确率、训练吞吐和推理吞吐
表5(p.9)中,标准注意力与MiTA的逐任务结果为:
| 任务(长度) | 标准Acc.→MiTA Acc. | 标准→MiTA steps/s | 吞吐倍数 |
|---|---|---|---|
| ListOps(2K) | 37.35→37.20 | 12.7→52.5 | 4.1× |
| Text(4K) | 63.63→63.47 | 3.8→37.7 | 9.9× |
| Retrieval(4K) | 79.90→79.88 | 1.9→19.6 | 10.3× |
| Image(1K) | 40.38→40.72 | 5.7→13.6 | 2.4× |
| Pathfinder(1K) | 69.68→73.26 | 5.7→15.3 | 2.7× |
平均准确率+0.72个百分点,提升主要来自Pathfinder,而前三项略降。训练总时间10.6→2.4小时,是汇总墙钟时间,不能把各任务吞吐倍数简单平均来替代。
| 方法 | 平均Acc.↑ | 总训练小时↓ |
|---|---|---|
| 标准注意力 | 58.19 | 10.6 |
| Agent Attention | 58.22 | 1.9 |
| MoBA route-only | 56.74 | 4.6 |
| MiTA route-only | 58.81 | 5.5 |
| MiTA完整 | 58.91 | 2.4 |
完整MiTA比自身route-only更快,且平均精度略高。移除共享分支时,通过增加 $k$ 保持每 query 访问条目数不变(256条);更大的离散gather仍可能更慢。Agent总时间1.9小时则比MiTA更短,准确率低0.69个百分点,因此不能声称MiTA支配所有方法。
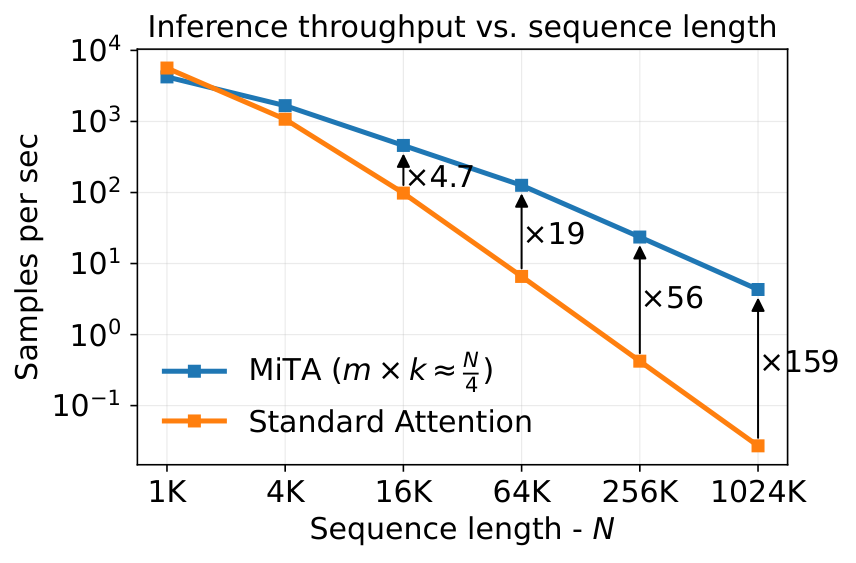
原图5,p.9。横轴序列长度,纵轴samples/s采用对数刻度;蓝色MiTA与橙色标准注意力比较。标注在16K、64K、256K、1024K处分别约4.7×、19×、56×、159×。这是小型3层、embedding128模型在RTX4090上的吞吐测试,各run独立调batch;不是延迟、固定batch、完整LLM或同精度的百万token任务比较。
尤其注意,图例明确是 $m\times k\approx N/4$,而§4.3同页正文给出 $m=k=128$。后者适用于表5的LRA设置,不能无说明推广至图5所有长度。图中未逐点完整列出 $m,k$,因此不宣称这些点全部采用固定128,也不由该图推断严格线性实测扩展。
4.5 消融:路由最关键,压缩补充有效
表6、图6(p.14)提供三组证据:
- landmark提取:二维平均池化71.1,随机选择70.6,一维平均池化70.4;可学习参数66.3,卷积67.0,深度卷积68.8;ToMe为71.3。简单池化是有竞争力的默认值,但不是精度最高。这里“DWC提取landmark”与表2额外DWC模块不是同一个消融位置。
- 预算分配:$(16,25)$为71.0,$(25,16)$为70.5;$(25,36)$为71.7,$(36,25)$为71.2。相同 $mk$ 下,把预算更多给 $k$ 在这两组里更好,支持复用少量较宽专家的思路。原表将71.2写成“71·2”,这里按小数排版解释。作者建议先固定 $mk/N$,从$m=k$开始再探索$k>m$,这是经验规则,不是优化保证。
- 分支:完整71.1,compress-only70.3,route-only70.8。原始K/V访问的增益更大,共享摘要仍有补充价值。0.3个百分点差没有多次试验误差支持,不能声称统计显著。
图6横轴$k$、纵轴$m$、颜色/数字为CIFAR-100准确率,总体增加预算有益,但不是逐点严格单调,且有OOM未测试区域。作者关于landmark同时充当压缩key与router可能造成梯度冲突的解释属于机制假设,没有直接梯度冲突实验。
4.6 算法泛化:固定权重替换与微调要严格区分
图9(p.16)的横轴是训练注意力,纵轴是推理注意力。按图中坐标实际读取:
| 方向 | DeiT-T | DeiT-S |
|---|---|---|
| Standard训练→Standard推理(图内参考) | 72.1 | 80.0 |
| Standard训练→MiTA推理 | 58.7 | 71.3 |
| MiTA训练→Standard推理 | 66.6 | 76.7 |
| MiTA训练→MiTA推理 | 71.1 | 79.8 |
原文内部不一致:p.17声称尤其Standard→MiTA保留原性能95%以上,但图9给出的比例为58.7/72.1≈81.4%、71.3/80.0≈89.1%。反方向为66.6/71.1≈93.7%、76.7/79.8≈96.1%,也并非两者都超过95%。图注声称省略对角线,图中实际上保留了对角线数字;图9标准模型72.1/80.0还与表2的72.2/79.9略有不同。没有额外说明时,应保留图中读数并标记冲突,不能替作者推测实验或轴标有误。
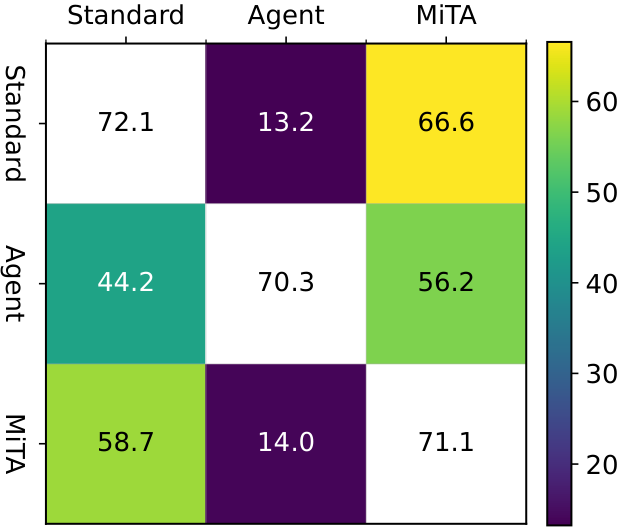
原图9(a),p.16,横轴训练、纵轴推理;颜色/单元格均为准确率。它与正文95%的文字存在上述冲突。就现有证据,MiTA与Standard的互换通常优于涉及Agent的互换,但绝不意味着可无损直接替换。
图10(p.16)测试固定权重、只改变推理$m,k$,横轴$k$、纵轴$m$;红框为训练配置,橙边界为超过原精度,蓝边界为达到原精度99%。Tiny@512与Large@224均存在比训练预算更好的配置,也存在预算增加后精度下降的区域,因此这是可调取舍而非单调保证;这里的99%是准确率比例,不是99%绝对准确率。
表7(p.17)则是不同实验:ImageNet-21K预训练模型替换注意力后,在ImageNet-1K上以AdamW微调50 epochs。
| 注意力 | Tiny | Small | Base | Large |
|---|---|---|---|---|
| 标准 | 76.9 | 81.2 | 84.4 | 85.9 |
| Linear | 73.2 | 78.6 | 79.8 | 80.7 |
| Agent,49 landmarks | 74.6 | 79.7 | 81.4 | 83.5 |
| Agent,64 landmarks | 74.7 | 79.9 | 81.5 | 83.8 |
| MiTA | 75.6 | 80.9 | 82.8 | 85.5 |
MiTA比Agent更好接续标准模型预训练权重,但仍比标准注意力低1.3、0.3、1.6、0.4个百分点。不能用这张经过微调的表支撑“固定权重直接替换无损”。附录C实现说明把224预训练配置指向表4,而§4.2对表4写的是384,两处存在交叉引用/配置冲突;本笔记分别保留原文描述,不擅自统一。
五:结论、边界与后续问题
5.1 可以可靠带走什么
MiTA提出了一种可复用的、依赖query与keys内容的稀疏记忆组织方式;共享压缩与原始细节读取复用打分,并用统一softmax融合。其优势不是“没有信息损失”,而是在可控预算内提供比纯压缩更好的细粒度访问,并避免每个query独自构建专家。
分类、分割与LRA共同支持一种有实际效率收益的精度—成本取舍。不能据此直接推断大模型自回归解码、固定batch延迟、多GPU通信或百万token任务准确率。附录D明确未评估LLM解码。
5.2 原文需带着限定阅读的三类表述
- 形式等价:快速权重MLP重写中的归一化依赖query,不能当成普通固定参数MLP等价证明。
- 退化为全注意力:附录A称$m=k=N$恢复全注意力,但式(10)仍拼入共享分支。即使路由分支含全部原始K/V,也不能一般推出联合输出恰等于原全注意力;需要额外条件或去掉共享分支。本文没有提供这些条件的证明。
- 算法泛化:图9与“95%以上”文字不一致;表7又涉及50轮微调。这些结果的性质应分开报告。
上述第二点可用一个本次构造的标量反例理解:取$d=1,N=m=k=2,s=1,Q=K=[1,0],V=[1,0]$,池化不改变Q。对$q=1$,全注意力输出约0.7311;共享values为$[0.7311,0.5]$,与全部原始K/V拼接后的式(10)输出约0.7000,故并不相等。这是公式检查,不是论文的实验结果。
5.3 有针对性的后续研究
- 因果与缓存:当前landmarks和全局摘要可访问整段输入;迁移到自回归模型需设计无未来信息泄漏的构建、增量更新和缓存失效策略,并重新计入成本。
- 专家覆盖与预算:固定$m$对长序列中更多样语义是否形成瓶颈?需要同质量约束下比较$m,k$,以及专家重叠、负载分布和实际gather开销。
- $s>1$的收益:附录B提出组合数$\binom ms$的潜在选择,但当前实证只用$s=1$。不同专家若重叠,拼接还可能重复计数同一K/V;组合数不等于有保证的独立表达能力。
- 更稳定的landmarks:用直接实验检验“压缩与路由梯度冲突”,而非只根据参数化提取器效果较差推断原因。
阅读后的判断:MiTA最值得借鉴的是“少量可复用的细粒度检索集合 + 全局摘要”的组织方式。其效果与代价已有跨任务证据,但精度损失、复杂度的参数条件以及原文图文不一致都应作为结论的一部分保留下来。