You Need Better Attention Priors:中文研读笔记
作者:Elon Litman、Gabe Guo(Stanford University)
论文:arXiv:2601.15380v2,2026-08-23 修订,ICML 2026
研读日期:2026-10-10
原文:arXiv v2 · 本地 PDF · 作者代码链接
配套汇报:英文幻灯片 · 可编辑 TeX
论文总览
GOAT(Generalized Optimal transport Attention with Trainable priors)的核心是把注意力路由分成两部分:当前内容提供的证据,以及位置结构提供的先验。标准 softmax attention 可以写成一个以均匀分布为参照的 KL 正则化优化问题;把均匀分布换成可学习先验,最优解仍是 softmax,只需在内容分数上加上对数先验。作者随后把这个加法偏置分解进 Q/K 的专用位置维度,使其能通过一次普通的缩放点积注意力(SDPA)计算,无需显式构造位置偏置矩阵。
先验由两部分组成:有限个正弦/余弦模态表示相对距离,key-only 偏置表示默认关注位置、近期偏好和 attention sink。位置项不再依赖内容向量的范数,因此可以在内容信号弱时提供默认路由,在内容证据强时让语义匹配覆盖默认偏好。
最有说服力的实证结果来自 v2 新增的 1.23B FineWeb 实验:训练长度为 2K,GOAT 和 RoPE 的困惑度分别为 20.75 和 20.82;测试到 16K 时分别为 24.77 和 417.43。论文还报告了合成长检索、DNA 建模、图像分辨率外推和空间 VQA 的收益。方法仍计算稠密注意力,主要贡献是先验的表达与实现方式,以及在所测设置中的外推表现。(Sec. 4;Table 1,PDF pp. 3–5、8。)
结构地图
下文页码均为从 1 开始的 PDF 页码,与本版印刷页码一致。Sec. 6 的结果按段落标题组织,没有独立的 6.1、6.2 编号。
| 原文章节 | 论证作用 | PDF 页码与关键证据 |
|---|---|---|
| 1. Introduction | 提出从隐式均匀先验到可学习先验的动机 | pp. 1–2;Fig. 1 |
| 2. Preliminaries: Attention as Entropic Optimal Transport | 标准 attention 的单侧熵正则最优传输解释 | p. 2;Eq. (2) |
| 3. Generalizing the Attention Prior | 推导 KL 先验与加法 logit 偏置 | pp. 2–3;Eqs. (4)–(10) |
| 4. Parameterizing the Prior With GOAT | Fourier 相对项、sink、二维扩展与 SDPA 实现 | pp. 3–5;Eqs. (11)–(27)、Algorithm 1 |
| 5. Attention Sinks in the EOT View | 弱信号极限与 value 扰动敏感性 | pp. 5–6;Theorems 5.1、5.4 |
| 6. Experiments | 先验可解释性、语言建模、检索、DNA、图像 | pp. 6–9;Figs. 1–5、Table 1 |
| 7. Conclusion | 汇总先验、外推与实现的贡献 | p. 8 |
| A–D. Related Work / EOT Proof / Spectral Factorization / Spectral Representation | 相邻方法、基本推导和 Fourier 动机 | pp. 12–14 |
| E–F. Stability Proofs / Priors vs. Positional Encodings | 稳定性证明与位置编码的关系 | pp. 14–16 |
| G. Why This Prior Parameterization Is Optimal Under Our Constraints | 有限维相对先验分类、最大熵 recency、rank-one sink | pp. 16–22 |
| H–J. C4 Setup / Ablations and Convergence / FineWeb Setup | 训练协议、频率与初始化消融、扩展实验 | pp. 23–24;Tables 2–8 |
| K–L. Spatial VQA / ImageNet Training Configuration | 空间泛化结果及视觉训练配置 | pp. 24–25;Tables 9–11 |
一:动机——默认路由应当由什么决定?
1.1 标准 attention 把结构要求压进内容分数
当 query 与所有 key 都缺乏明确语义关系时,纯 softmax 会趋向均匀分配概率。但任务通常有更合理的默认选择,例如关注最近位置、序列开头、某种周期距离,或图像上的局部邻域。
不同位置编码提供了不同处理方式。RoPE 通过旋转内容 Q/K 让点积依赖相对位置;位置效应仍由内容向量共同决定。ALiBi 直接加入随距离线性衰减的偏置,结构明确,但形状固定。可学习的绝对位置表灵活,却需要另外处理训练范围之外的位置。GOAT 希望同时获得可学习结构、连续位置函数和标准注意力内核支持。(Sec. 1、Appendix A,PDF pp. 1–2、12。)
1.2 “先验”与“位置编码”是两个观察角度
从算法实现看,GOAT 也是一种位置编码:它构造含位置特征的 Q/K。从优化解释看,它把位置项视为路由分布的先验。Appendix F 明确承认这两种描述在最终 logits 上可以代数同构。
因此,这篇论文值得关注的具体设计是:位置贡献以可分离的加法项出现,而且该加法项能用固定维度的点积精确实现。EOT 推导给出这种设计的解释,并不单独证明均匀先验“不合法”,也不唯一决定后续采用的频率网格。(Appendix F、G,PDF pp. 15–17。)
二:方法——从 KL 目标到一次 SDPA
2.1 单侧 EOT:只约束每个 query 的概率和
固定一个 query,令 $s_j$ 为它与第 $j$ 个 key 的未缩放内容点积,$p_j$ 为分配给该 key 的注意力质量,$\tau>0$ 为温度。标准 attention 对应
这里的“传输”是从一个 query 向多个 key 分配单位质量。约束只有 $p_j\ge0$、$\sum_jp_j=1$,没有跨 query 的 key 边际约束,因此不需要 Sinkhorn 迭代。利用
可以把熵项理解为偏离均匀先验的代价。(Eqs. (2)–(3),PDF p. 2;Appendix B,p. 12。)
换成固定先验 $\pi$,目标成为
对允许访问的 key 取 $\pi_j>0$。一阶条件给出
归一化后得到
注意力因此可以理解为“内容指数权重 × 先验权重”的重新归一化。因果不可见位置由 mask 排除;若使用零先验,则优化也应限制在先验支持集上。(Proposition 3.1、Eqs. (4)–(10),PDF p. 3。)
一个教学例子:两个 key 的先验比为 $9:1$,但第二个 key 的缩放后内容分数比第一个高 $\log 9$,则后验恰好各占一半。固定先验的作用不是阻止内容覆盖它,而是规定覆盖它需要多大证据。
2.2 GOAT 实际计算什么?
从 Sec. 4 起,论文把 $s_{ij}$ 用作已缩放的分数:
$\mathcal A_i$ 是 query $i$ 可以访问的 key 集合。$\mathcal K$ 是未归一化对数先验;严格地说,$\log\pi_{ij}=\mathcal K_{ij}-\log\sum_{k\in\mathcal A_i}\exp\mathcal K_{ik}$。二者相差行常数,所以放进 softmax 后等价。
| 符号 | 含义与维度 |
|---|---|
| $d_h$ | 注意力头的总维度 |
| $R$、$d_p=2R+2$ | Fourier 模态数,以及包含 sink 和对齐补零的位置维度 |
| $d_c=d_h-d_p$ | 内容 Q/K 的维度,必须为正 |
| $q_{c,i},k_{c,j}\in\mathbb R^{d_c}$ | 输入内容的学习投影 |
| $q_{\mathrm{rel},i},k_{\mathrm{rel},j}\in\mathbb R^{2R}$ | 相对位置特征 |
| $u_h(j)\in\mathbb R$ | 每头的 key-only 位置偏置 |
| $v_j,o_i\in\mathbb R^{d_h}$ | 全头维度的 value 与输出 |
核心分解是
位置项只改变如何混合 value,value 本身仍来自内容。(Sec. 4、Algorithm 1,PDF pp. 3–5。)
2.3 Fourier 相对先验:两维实现一个有方向的模态
相对部分写成
$\alpha_r$ 控制偶对称结构,$\beta_r$ 控制反对称结构,因此可以区分前后方向。由于参数化对象是 log-prior,系数可以为负;指数化以后仍得到非负概率,无需要求 $\mathcal K$ 是正定核。默认固定频率为
对每个模态设置
由和差角公式,二者点积恰好等于一个目标模态。拼接 $R$ 组就得到整个相对偏置。这是位置 logit 的精确分解,没有对 softmax attention 做线性化近似。(Eqs. (12)–(19),PDF pp. 3–4;Appendix C–D,pp. 12–14。)
这里的外推能力来自:位置函数对训练范围之外的坐标仍有定义,且有限三角和的幅度有界。但周期结构也会再次出现,相对先验本身不能保证远处相似位置不会混淆;内容分数仍要完成区分。
2.4 一个额外维度承载默认位置与 recency
每个头使用
$\phi_{\mathrm{abs}}$ 包含正弦特征、$j/L_{\mathrm{train}}$ 和 $\log(1+j)/\log(1+L_{\mathrm{train}})$;$g_h$ 是近零初始化的单隐层 SiLU MLP。三项分别提供 key 位置的线性趋势、可学习的绝对结构,以及可选的首 token 偏好。
只需给 query 增加常数 $1$、给 key 增加 $u_h(j)$,就有 $1\cdot u_h(j)=u_h(j)$。对应矩阵为 $U=\mathbf1u^\top$,非零时秩为 1。这说的是未加 mask 的 logit 偏置;因果 mask 和归一化后,每行可访问的集合不同,实际概率分布不必相同。(Eqs. (21)–(22),PDF p. 4;Appendix G.4,p. 22。)
线性项与 ALiBi 的关系尤其直接。因果条件下,
$-mi$ 对当前 query 是行常数,所以 $mj$ 与 ALiBi 的距离惩罚产生相同的 softmax 分布。对有限 lag 集合,在固定平均 lag 的约束下最大化熵,会得到 $q_d\propto e^{-\lambda d}$;只有当 $\lambda>0$ 时才偏好近期。它解释了线性 recency 的来源,但没有把固定斜率变成所有任务的最佳先验。(Appendix G.3,PDF pp. 20–21。)
2.5 缩放与拼接:让标准内核得到正确 logits
SDPA 默认使用 $1/\sqrt{d_h}$,而我们希望内容项使用 $1/\sqrt{d_c}$,先验项保持原幅度。作者构造
于是
最后调用标准 attention 内核即可。尾部的 $0$ 用于维度对齐;正文 Eqs. (23)–(24) 省略了它,Algorithm 1 明确列出。(PDF pp. 4–5。)
训练时,内容投影、谱系数和绝对偏置网络共同学习;默认频率固定。推理时在实际 token 坐标上求同样的特征,新位置无需扩充可学习查表。自回归缓存需要保留正确的位置索引,公式没有免除历史 K/V 的存储。
维度取舍是实际代价。 例如按主文参数化,$d_h=64,R=4$ 时 $d_p=10,d_c=54$;$R=8$ 时 $d_p=18,d_c=46$。增加位置表达能力会减少内容 Q/K 的维度。方法避免了额外的 $L\times L$ 位置偏置存储,但稠密注意力计算仍随 $L^2$ 增长,位置特征和 MLP 也有自身成本。保持同一内核接口并不意味着整个模块没有额外操作。
2.6 二维坐标:学习结构的形状
图像 patch 使用坐标 $(y_i,x_i)$,将频率分给两个轴,并相加:
这是依据一维定义和“按轴拼接”的文字恢复的表达式:原文 Eq. (20) 在两轴的 cosine 与 sine 项之间均漏写了加号,PDF 与 TeX 均如此;若照字面把二者相乘,就不再对应前述特征构造。
这个设计预先规定了相对分量的二维平移等变性,训练学习的是其中的局部偏好和方向权重。它是按轴相加的可分离结构,没有表达所有任意二维耦合项。多模态实验让图像 token 使用规范二维坐标、文本 token 使用一维因果位置。(Sec. 4,PDF p. 4;Appendix K,pp. 24–25。)
2.7 有限 Fourier 家族的理论依据及其范围
Appendix G.2 的分类论证依赖三个条件:在整个整数位置轴 $\mathbb Z$ 上成立;相对偏置能用固定有限维特征点积表示;相对位移函数 $\kappa(i-j)$ 平移等变且有界。
证明主线是:所有平移后的序列 $\kappa(\cdot-j)$ 落在有限维空间;移位算子作用在该空间上,一般解由“多项式 × 指数序列”组成;在正负两个方向都要求有界,会排除模不为 1 的指数以及非常数多项式,剩下有限个单位圆频率。因此有限三角和是这组约束下自然的函数族。(Theorem 2,PDF pp. 17–19。)
它没有选出 $B=10{,}000$,也没有证明固定的几何频率能表示该家族的每个成员。并且有界条件只针对相对项,完整 $u_h(j)$ 中的线性趋势和绝对位置 MLP 不受该结论保护。
本次分析发现一个维度计数的边界问题。 原定理同时写出 $R\le\lfloor d_p/2\rfloor$,但整数域上的 Nyquist 模态 $\kappa(d)=(-1)^d$ 只需一维:$(-1)^{i-j}=(-1)^i(-1)^j$。取 $d_p=1$,它非恒定,却被原界强制为 $R=0$。严谨计数应把常数频率和 $\pi$ 频率单独处理:普通非退化频率每组需要两维,常数与 $(-1)^d$ 各最多一维。这不改变 GOAT 所用普通 Fourier 模态的构造,但限制了原文“最一般形式”的字面表述。(Eq. (73),PDF p. 17。)
三:理论分析与实验设计
3.1 弱内容信号时,attention 回到先验
用 Sec. 4 的已缩放分数定义动态范围
令所有分数减去最小值后落在 $[0,\omega_i]$,则归一化常数满足 $1\le\sum_k\pi_{ik}e^{s'_{ik}}\le e^{\omega_i}$。因此
当 $\omega_i\to0$,$p_i\to\pi_i$。这是 Theorem 5.1 的实质:当内容无法区分候选 key 时,先验决定路由。若先验均匀,极限也是均匀;要得到 sink,还需要先验本身有峰值。该定理解释给定先验的行为,不证明训练一定会学出某个 sink。(Eq. (28),PDF p. 5;Appendix E.1,p. 14。)
3.2 sink 的敏感性界需要多大的 margin?
选定 sink $j^*$,把其他 key 记作 $\mathcal C$。固定 Q/K,只扰动这些位置的 value,且 $\|\Delta v_k\|_2\le\varepsilon$,则
若先验提供 margin
弱信号极限下就有
其中 $L$ 应理解为当前 query 能访问的 key 数量。均匀先验下 $\Psi=1-1/L$;有峰值先验能在固定 $L$ 下通过增加 $\delta$ 减小该上界。(Theorem 5.4、Eqs. (31)–(34),PDF p. 6;Appendix E.2,p. 15。)
不能丢掉上界中的长度依赖。 固定 $\delta$ 时,上界仍随 $L\to\infty$ 趋近 1。由该界保证 $\Psi\le\eta$ 的充分条件是
例如要保证至少 90% 的注意力留给 sink,在弱信号假设下,2,048 个 key 需要 $\delta\ge9.82$,16,384 个 key 需要 $\delta\ge11.90$;这是由上式计算的教学例子。增加 8 倍长度大约需要再增加 $\log8$ 的优势,训练好的位置函数不自动保证这一点。
本次分析还可直接扩展到有限内容信号:总 margin 至少为 $\delta-\omega_i$,因而
这也说明为什么强内容证据可以覆盖默认先验。原定理另外限定长度小于先验周期;对于多频率及含绝对 MLP 的完整实现,不能把这个说法直接当作已证明的统一外推长度。
这套“稳定性”衡量的是固定 Q/K 时,对非 sink 的 V 扰动的最坏情况响应。它没有覆盖同时改变 Q/K 的扰动,也没有把 sink 的 value 变成零。GOAT 是给 sink 单独的表达渠道,不能理解为删除 sink 或自动关闭注意力输出。作者关于高范数 content key 的解释说明一种学习路径,而“所有 query 都必须靠增大范数才能构造 sink”并不是上述定理的结论。
3.3 各实验回答什么问题?
| 实验 | 数据与对象 | 对照和指标 | 要检验的问题 |
|---|---|---|---|
| Copy-mixture | 首 token 拷贝、前一 token 拷贝、随机噪声混合的合成序列 | 学到的先验分解 | 全局默认与相对结构能否分开表达? |
| C4 语言建模 | 125M;4B tokens;训练长度 2048 | RoPE、ALiBi;PPL 越低越好 | 训练窗口质量与长度外推的折中 |
| FineWeb 扩展 | 1.23B;所选 GOAT checkpoint 约 3.13B tokens;训练长度 2048 | 匹配训练设置的 RoPE;PPL | 收益能否扩展到十亿参数级? |
| Passkey / NIAH | 单个 8 位数字 key;改变上下文长度和 needle 深度 | RoPE、位置插值 RoPE、ALiBi、正弦绝对位置;span-token accuracy | 远距离内容能否覆盖位置默认? |
| DNA | 人类参考基因组;125M decoder LM | RoPE;NLL、bits/base、吞吐、峰值显存 | 不同序列模态上的质量与成本 |
| ImageNet-1k | ViT-Small;224 分辨率训练;更高分辨率直接测试 | 可学习绝对位置编码;Top-1 accuracy | 二维位置先验能否外推到更多 patch? |
| Spatial VQA | CIFAR-10 四图场景;训练未见的图像 token 扫描顺序 | No PE、RoPE;答案 NLL 和精确答案准确率 | 几何坐标能否减少对序列化顺序的依赖? |
C4 为 12 层、12 头、宽度 768 的 pre-norm decoder,使用 GPT-2 tokenizer 和 AdamW,学习率从峰值 $10^{-4}$ 余弦衰减至 $3\times10^{-5}$。FineWeb 为 22 层、32 头、宽度 2048、FFN 5632 的 Llama-style decoder,GPT-2 BPE,batch 128 个长度 2048 的序列,峰值学习率 $3\times10^{-4}$。两者训练窗口相同,但规模、数据和预算不同,不能把两组 PPL 横向解释成同一数据上的缩放曲线。(Tables 2、8,PDF pp. 23–24。)
四:结果——哪些证据支撑哪些结论?
4.1 先验分解学到全局默认和周期结构
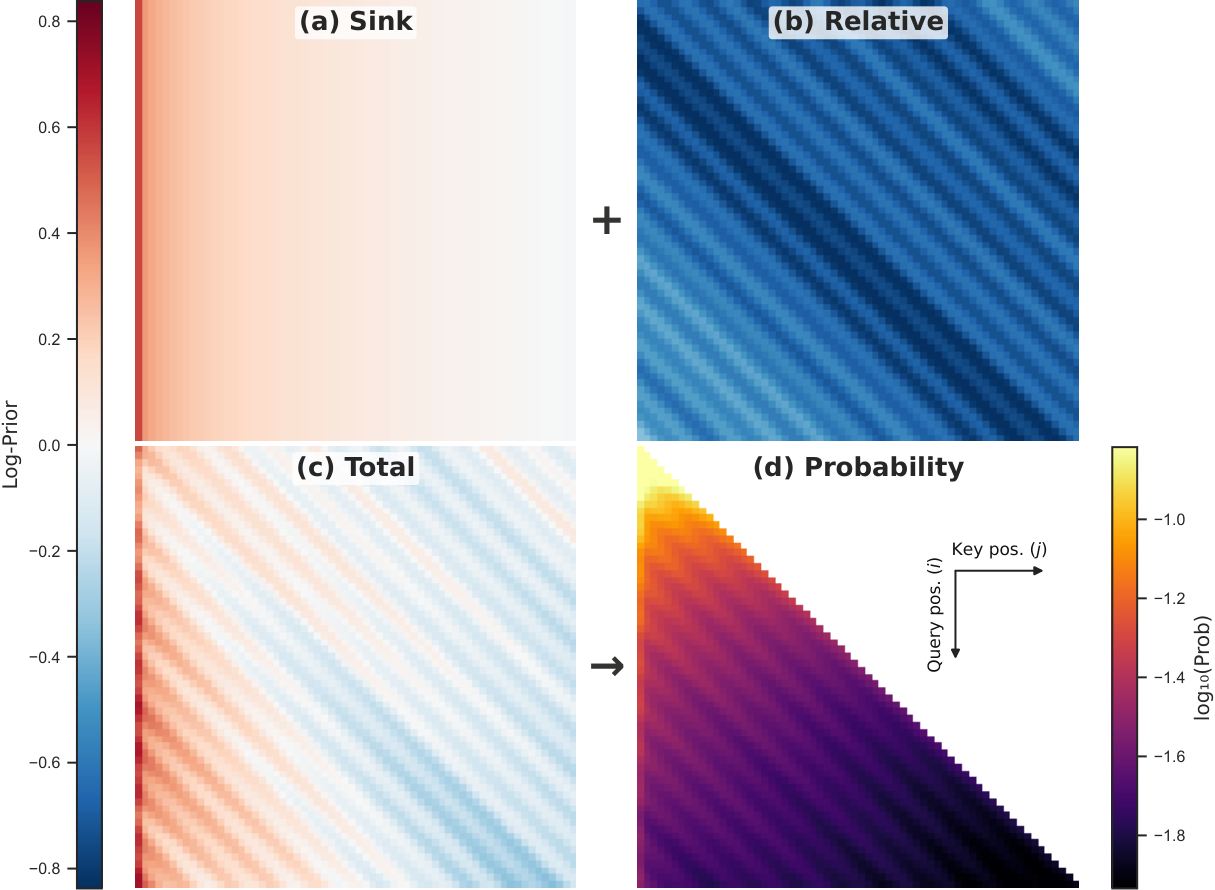
来源:Fig. 1,PDF p. 1;实验说明见 Sec. 6,p. 6。横向是 key 位置,纵向是 query 位置;(a) 显示 key-only 结构,(b) 显示相对距离条纹,(c) 是行中心化后的总 log-prior,(d) 是加因果 mask 并归一化后的先验,色条使用概率的对数。
左侧列状偏好对应序列开头,斜向条纹对应相对距离。图支持两个组件分工的解释;条纹具有重复性,最终仍需内容项在周期候选中选择正确 token。这幅图是合成任务上学到的先验,不是完整内容注意力矩阵。
4.2 C4:窗口内更好,长区间与 ALiBi 存在取舍
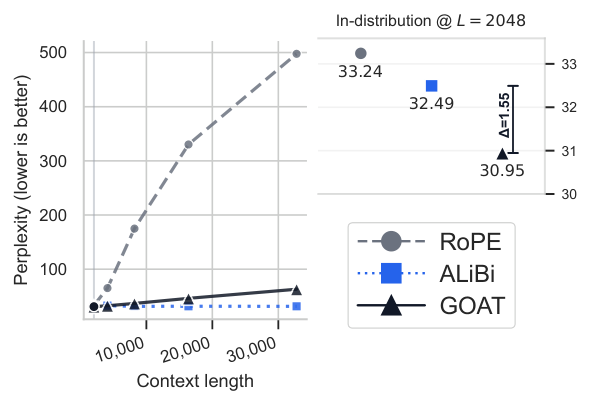
来源:Fig. 2(a),PDF p. 7。横轴是测试长度,纵轴是 PPL,越低越好;插图放大训练长度 2048 处的数值。
| 模型 | 2048 处 PPL,按图中标签 |
|---|---|
| RoPE | 33.24 |
| ALiBi | 32.49 |
| GOAT | 30.95 |
主图显示 RoPE 在外推时迅速恶化,GOAT 到约 32K(16 倍训练长度)仍保持较平缓的退化。ALiBi 的长区间曲线更平坦,GOAT 并非每个测试长度都最低;主要优势是窗口内质量与外推之间的折中。正文称比 ALiBi 改善 1.55 PPL,图中两位小数相减为 1.54,因此宜表述为“约 1.55”。
Fig. 2(b) 中的 $u(j)$ 在首位置和训练窗口末端较高,中间较低。它是绝对 key 位置曲线;末端上升与因果裁剪共同产生近期偏好,不能直接把曲线当作对任意 query 都相同的相对距离函数。Fig. 2(c) 的横轴是内容信号动态范围,纵轴是各方法定义的默认位置质量;GOAT 随信号增强更充分地退出默认路由,符合其加法先验可被内容分差覆盖的机制。
4.3 FineWeb 1.23B:外推优势保留,窗口内基本持平
| 模型 | 2K PPL | 4K PPL | 8K PPL | 16K PPL |
|---|---|---|---|---|
| RoPE | 20.82 | 28.53 | 89.45 | 417.43 |
| GOAT | 20.75 | 21.04 | 22.69 | 24.77 |
来源:Table 1,PDF p. 8;设置见 Table 8,p. 24。
这组结果把贡献定位得很清楚:窗口内只有 0.07 PPL 的差异,而外推到 4–8 倍训练长度后的差异显著扩大。实验比较的是该训练协议下的 RoPE 与 GOAT,并未覆盖各种经过长上下文扩展训练的 RoPE 方案。1.23B 模型使用约 3.13B tokens 的所选 GOAT checkpoint,结论应放在这个训练预算内理解。
4.4 长检索:要分清 token 正确率和整串正确率
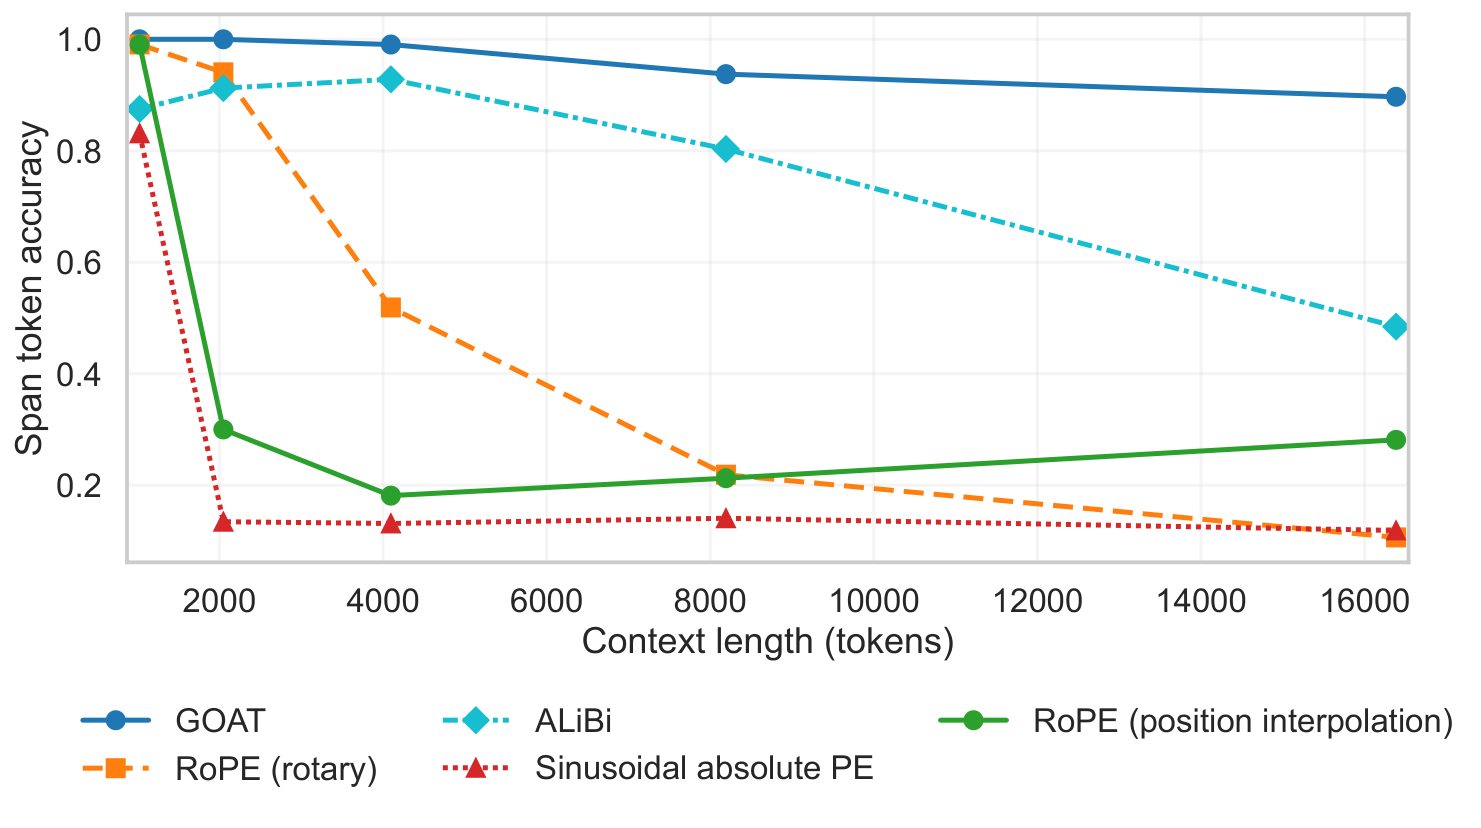
来源:Fig. 3(a),PDF p. 7。横轴是上下文 token 数,纵轴是目标 span 内的 token 准确率。任务在上下文中插入一次 8 位 passkey,要求在末尾复述。图注以 $L_{\mathrm{train}}=1024$ 为示例训练窗口;精确训练配置在正文中没有完整展开。
从曲线读数看,GOAT 在约 16K 时仍有 约 90% 的 span-token accuracy;ALiBi 约 48%,RoPE 约 11%,位置插值 RoPE 约 28%。这些是图读近似值。90% 的 token 准确率不能直接解释为 90% 的 8 位 passkey 全部正确。
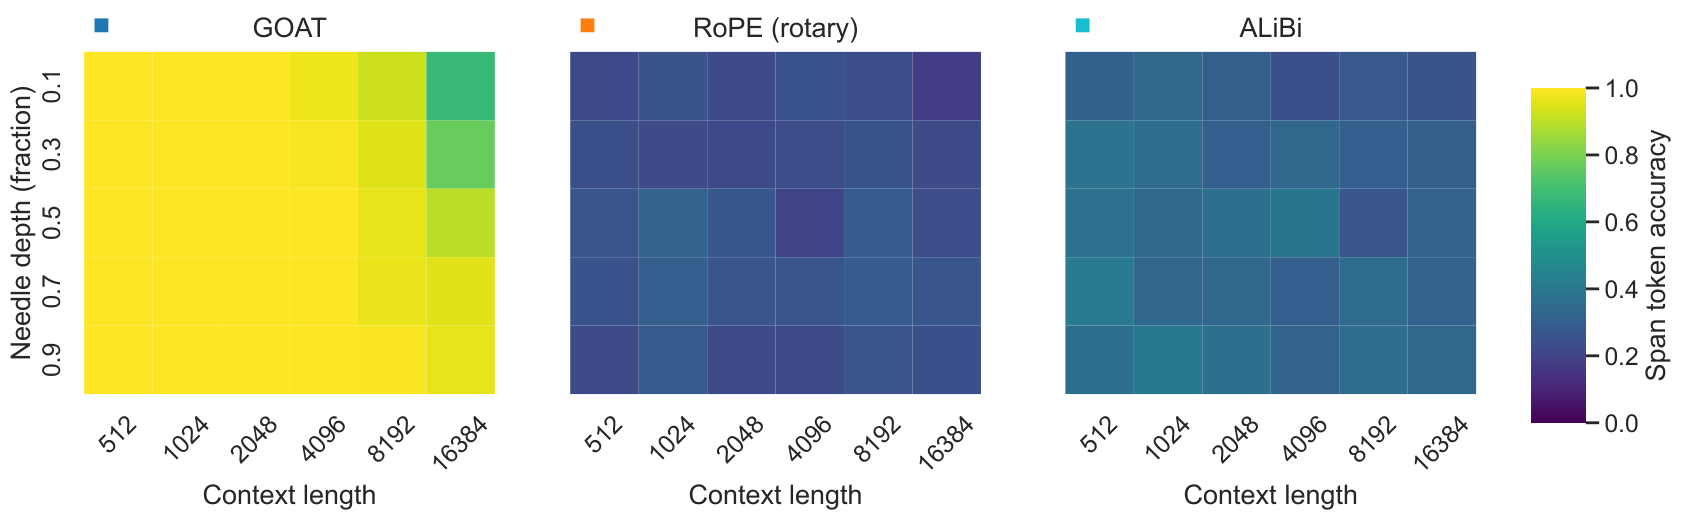
来源:Fig. 3(c),PDF p. 7;选取原图 GOAT、RoPE、ALiBi 三个面板及共同色条,数据未重绘。横轴是长度,纵轴是 needle 在上下文中的相对深度,颜色越黄表示 span-token accuracy 越高。
GOAT 在大多数长度和深度上明显领先;最长 16K 列、特别是浅位置已出现退化,因此“所有长度与深度都近乎完美”比图本身更强。ALiBi 的固定距离惩罚可能压制远处候选,这是作者给出的解释。Fig. 3(b) 另外展示先验在因果 mask 前后的变化,说明 key 位置偏好可以在截断归一化后变成沿对角线的近期偏好。
4.5 DNA:损失更低,显存下降,吞吐接近
| 指标 | RoPE | GOAT | 变化 |
|---|---|---|---|
| 验证 NLL,nats/token ↓ | 1.2054 | 1.1294 | 降低 0.0760,约 6.30% |
| 验证 bits/base ↓ | 1.7390 | 1.6294 | 降低 0.1096 |
| 训练吞吐,tokens/s ↑ | 139,886 | 138,171 | GOAT 低约 1.23% |
| Peak CUDA allocated memory,GB ↓ | 2.86 | 1.83 | 降低约 36.01% |
来源:Fig. 4(a)–(b),PDF p. 9。NLL 与 bits/base 是同一预测质量的不同单位表达,不能算作两项独立性能提升。
原图使用双纵轴,实心柱表示 NLL 或吞吐,斜线柱表示 bits/base 或峰值显存。结论是该 125M DNA 实验中质量与显存改善、吞吐基本接近;图中吞吐没有提高。缺少覆盖设备、内核和不同序列长度的系统基准,因此 36% 不应作为 GOAT 的固定显存节省比例。
Fig. 4(c) 给出一个 200 nt prompt 后的 200 nt 续写例子,指标平均于 $N=3$ 个续写:GC% MAE 为 9.32 对 10.18,GC% RMSE 为 11.87 对 13.50,GC 轨迹 Pearson 相关为 0.466 对 0.320,碱基准确率为 27.0% 对 26.5%。GC 曲线采用 25 长度窗口。它支持局部组成统计更接近真实片段的观察,属于小样本生成分析。
4.6 ImageNet:更高分辨率下退化较小
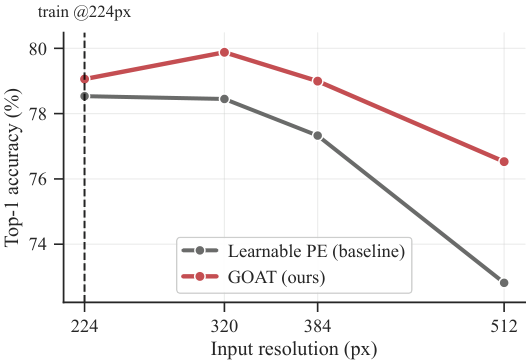
来源:Fig. 5(a),PDF p. 8。横轴是输入分辨率,纵轴是 Top-1 accuracy;训练固定在 $224\times224$,更高分辨率测试没有微调。
图读值显示,GOAT 在 224 处约 79.1%,绝对位置基线约 78.5%;到 512 时约为 76.6% 对 72.8%,差约 3.8 个百分点。GOAT 在 320 附近略有提升,随后也会退化。更准确的描述是“较基线更能保持精度”,而不是分辨率越高越好。
模型为 ViT-Small 的 SwiGLU 变体,12 层、6 头、宽度 384、patch $16\times16$,训练 150 epochs、batch 1024。Fig. 5(b) 的中心 patch 相对 log-prior 显示局部和方向结构;二维等变性来自参数化设计,局部权重形状来自学习。(Table 11,PDF p. 25。)
4.7 空间 VQA:规范坐标缓解扫描顺序变化
| 方法 | Answer NLL ↓ | 精确答案准确率 ↑ |
|---|---|---|
| No PE | 0.359 | 17.2% |
| RoPE | 0.367 | 16.5% |
| GOAT | 0.350 | 20.3% |
来源:Table 9,PDF p. 24;配置见 Table 10,p. 25。
场景把四张 CIFAR-10 图像安排在规范 $2\times2$ 网格上,任务包括绝对位置问题和相对关系问题。训练/测试分别为 50k/10k 场景,测试使用训练未见的扫描顺序;图像经 $4\times4$ patch 和 512 大小的 k-means 码本离散化。模型为 12 层、8 头、宽度 416 的 decoder,使用验证答案 NLL 选 checkpoint。
GOAT 相比 RoPE 增加 3.8 个百分点,相比 No PE 增加 3.1 个百分点。规范二维坐标让同一几何关系不必随 token 序列化顺序改变,结果支持这一设计。不过绝对准确率仍只有 20.3%,因此改善与任务已被解决是不同判断。
4.8 消融:模态数比频率基数更影响外推
| 模态数 $R$ | 位置维度 $d_p$ | 2K PPL | 4K PPL | 8K PPL |
|---|---|---|---|---|
| 1 | 4 | 35.49 | 34.81 | 38.28 |
| 2 | 6 | 35.52 | 34.95 | 38.64 |
| 4 | 10 | 35.49 | 34.57 | 35.97 |
| 8 | 18 | 35.18 | 34.15 | 35.15 |
来源:Table 3,PDF p. 23。更强的位置容量主要改善长区间;从 $R=2$ 到 $R=8$,8K PPL 降低 3.49,而 2K 降低 0.34。这也说明内容维度和结构维度的预算分配是重要设计变量,不能把 $R$ 当作无成本增加的参数。
| 消融项 | 设置 | 2K PPL | 8K PPL |
|---|---|---|---|
| 频率 | $B=1{,}000$ | 35.48 | 38.42 |
| 频率 | $B=10{,}000$ | 35.52 | 38.64 |
| 频率 | $B=100{,}000$ | 35.62 | 38.51 |
| 频率 | 可学习频率 | 35.39 | 37.99 |
| 初始化 | 全零 | 35.52 | 38.64 |
| 初始化 | 随机 | 35.54 | 38.88 |
| 初始化 | ALiBi warm start | 35.56 | 38.48 |
来源:Tables 4–5,PDF p. 23。固定频率基数跨两个数量级变化,结果变化较小;学习频率有温和改善,ALiBi 初始化也仅带来小幅外推收益。由此更合理的优先级是先选择合适的位置容量,再精调频率和初始化。
Table 6(PDF p. 24)显示,1.23B 模型的 704 个头中,287 个头的谱幅度超过 1.0;662 个头的反对称系数占优,$|\beta|/|\alpha|$ 中位数为 1.84。第 0 层平均谱幅度为 2.04、活跃头 28/32;第 21 层为 0.70、活跃头 5/32。学习到的位置结构偏向方向性,并且在浅层更强,但这些统计不等于对正弦项必要性的消融。
Table 7 的训练 loss 检查点中,GOAT 均略低于 RoPE。例如 C4 的 15,000 步为 3.520 对 3.535,FineWeb 的 10,000 步为 2.993 对 3.003。它支持所报告 run 没有明显早期收敛惩罚的判断。(PDF p. 24。)
C4 的数值口径需要区分。 Fig. 2 主图的 GOAT 2K PPL 为 30.95,消融表中的常用设置为 35.52;论文没有完整解释两者如何对应。Table 2 的 $d_{\mathrm{pos}}=12$、Pos Rank 2 与主文 $d_p=2R+2$ 的命名也没有直接衔接。因此应在各自实验组内比较,不把主图和消融表拼成一张同配置排名。复现时还需澄清 Table 2 的 batch 32 与 Table 7 隐含约 262k tokens/step 之间的有效 batch 关系。
五:结论——贡献、取舍与值得继续验证的地方
GOAT 的可迁移思想是把路由中的结构偏好变成独立、可学习的 log-prior,并为它选择可以直接进入标准点积内核的函数形式。Fourier 相对项处理距离与方向,rank-one key-only 项处理默认位置,缩放拼接把两者精确组合起来。理论解释与工程实现能够对上,是这篇论文最完整的部分。
实验证据中,1.23B 模型在训练窗口内与 RoPE 接近、在更长上下文中退化明显更慢,是主线最清楚的结果。C4、检索、DNA 与视觉结果进一步说明这一设计有跨任务价值;不同任务仍保留各自的取舍,例如 ALiBi 的极长区间 PPL、GOAT 的内容维度占用,以及 DNA 中相近而非更高的吞吐。
理论上的“稳定”需要保留具体含义:在固定 Q/K、弱内容信号和足够先验 margin 下,对非 sink value 扰动的响应较小。固定 margin 不提供任意长度保证;位置函数连续可求值,也不等于整个模型必然在所有新长度上保持质量。附录的有限三角族论证说明一种约束下的表达形式,不能代替对频率、完整绝对项和训练数据的选择。
沿着本文继续研究,最值得做的比较是:在相同内容维度或相同总参数预算下比较先验收益;对比经过适配的长上下文位置方案;分别移除方向项、key-only 项和首 token bump,观察质量、sink 行为和长度外推如何联动。这样的实验能够进一步分清收益来自哪部分结构,以及这些结构应占用多少模型容量。