Low-Rank Key Value Attention:中文研读笔记
作者: James O’Neill、Robert Clancy、Mariia Matskevichus、Fergal Reid(Intercom AI Group)
论文: arXiv:2601.11471v3,2026-04-07 修订;本次研读日期:2026-10-15。
材料与成品: 原文 PDF · 英文汇报 PDF · 可编辑 Beamer 源文件。下文页码均为从 1 开始的 PDF 页码,与本文印刷页码一致。
论文总览
LRKV(Low-Rank Key-Value Attention)把每个注意力头的 K/V 投影写成“所有头共享的稠密矩阵 + 每头独立的低秩残差”:
它希望保留 MQA 的共享效率,同时通过残差恢复不同头的表达能力。训练时还原完整 K/V 计算注意力;解码时只缓存共享特征和低维残差特征。在线性投影的设定下,利用矩阵乘法结合律可以直接计算注意力,缓存占 MHA 的比例为 $1/H+r/d_h$。
原文 Table 1 报告 LRKV 在 128M、1.2B、2.5B、6.3B 四个规模上均取得最低预训练交叉熵,主配置的缓存报告值约为 MHA 的 45%–53%。Table 2 中,经过相同监督式 midtraining 后,LRKV 的五项任务平均分也最高,但代码生成等单项存在回退。这个结果支持一个有价值的架构思路:跨头共享公共部分,把额外存储留给每个头的差异。(Sec. 3–4,pp. 3–9,Tables 1–2)
理解这篇论文需要同时保留三个具体条件:低秩关联计算的公式本身成立;完整 RoPE 能否直接作用于压缩缓存还需要额外条件;正文与附录的一些容量、配置和消融数字互不一致。因此,“共享加残差”的设计值得研究,但“完整 RoPE 无额外代价”“全面优于 MLA 的性能—内存前沿”“已经验证的部署加速”并不能直接从本文推出。下面把方法、作者报告的实验及影响结论的矛盾分别讲清楚。
结构地图
| 原文章节 | 核心作用 | PDF 页码与主要证据 |
|---|---|---|
| 1. Introduction | KV 冗余与头特异性的矛盾 | pp. 1–2,Fig. 1 |
| 2. Related Work | 与 MQA/GQA、MLA、LoRA 等比较 | pp. 2–3 |
| 3. Methodology | 分解、缓存、关联计算与复杂度 | pp. 3–4,Eqs. (1)–(10) |
| 4.1 Pretraining Results | 跨规模损失、收敛步数、8K 训练 | pp. 5–6,Table 1,Figs. 2–4 |
| 4.2 Downstream Task Performance | 监督式 midtraining 后的任务表现 | pp. 6–7,Table 2 |
| 4.3 Why Low-Rank Key-Value Attention Works | 秩消融、双线性形式、头多样性、幅值 | pp. 7–9,Figs. 5–8 |
| 5. Discussion / 6. Conclusion | 作者对容量与共享的解释 | pp. 9–10 |
| A. Related Work (Full Version) | 相关工作补充 | pp. 13–14 |
| B. Shared Subspaces, Spectral Bias, and Information Structure | 谱结构和分解几何的解释 | pp. 14–15 |
| C. Principled Head Diversity Analysis via PCA in Bilinear Form Space | 中心化 Gram 矩阵、谱、热图与局限 | pp. 15–22,Table 3,Figs. 9–18 |
| D. Experimental Setup (Full Details) | 模型、训练、baseline、秩与长上下文 | pp. 22–26,Tables 4–9 |
| E. Pretraining-Downstream Correlation Analysis | 预训练质量与下游分数的关联 | pp. 26–27,Fig. 19 |
| F. Additional Experimental Details and Computational Analysis | 优化器和计算开销比较 | pp. 27–28,Table 10 |
| G. KV Cache Memory Measurements | 缓存形状及容量统计 | pp. 28–29,Tables 11–12 |
| H. Limitations and Future Work | 规模和系统实现的适用条件 | p. 29 |
一:动机——共享什么,保留什么
标准多头注意力(Multi-Head Attention,MHA)为每个头保存一份历史 K/V。设上下文长度为 $L$、头数为 $H$、头维度为 $d_h$,每层需要 $2LHd_h$ 个缓存元素。上下文、批量和层数的增加都会线性放大这部分存储。
多查询注意力(Multi-Query Attention,MQA)让全部头共享 K/V,仍保留独立的 Q;分组查询注意力(Grouped-Query Attention,GQA)在组内共享 K/V。两者通过减少 KV 头数节省内存,但共享越强,可用于表达头间差异的 KV 参数越少。LRKV 提出中间方案:公共部分只保存一次,每个头再携带一个较小的残差。
| 机制 | 每层、每 token 缓存元素数 | 头间自由度来自哪里 |
|---|---|---|
| MHA | $2Hd_h$ | 每头独立的完整 K/V |
| MQA | $2d_h$ | Q 独立,K/V 完全共享 |
| GQA | $2n_{kv}d_h$ | 组间 K/V 独立、组内共享 |
| 本文采用的简化 MLA | $d_c$ | 共享 latent 经每头不同上投影 |
| LRKV | $2(d_h+Hr)$ | 共享稠密 K/V 与每头秩 $r$ 残差 |
这里以 $n_{kv}$ 表示 KV 头数,避免原文不同位置对 $G$ 使用“组数”和“组大小”两种含义。MLA 的缓存公式也沿用本文单一联合 latent 的口径,不包含另行设计的位置编码缓存。(Sec. 2–3;Tables 4、11,pp. 23、28)
与 LoRA 的关系。 两者都有低秩加法结构,但 LRKV 在预训练中联合学习共享基座和所有头的残差,并把激活缓存布局一起改变。它不是把一个训练好的 MHA 做低秩微调,也不是对已生成的 KV 做事后截断。
与 MLA 的区别。 按原文自己的公式,MLA 的 $Z=XW_{\mathrm{down}}$ 保留每个 token,只降低每个 token 的特征维度。原文把它多次称为沿 token 维压缩,这种说法容易被误读为减少序列位置。更准确的比较是:MLA 通过一个共享低维 latent 产生各头 K/V;LRKV 保留一个不受秩约束的共享基座,仅约束各头相对于它的差异。两者都不必删除历史 token。
二:方法——从参数分解走到实际缓存
2.1 符号与表达能力
| 符号 | 形状或含义 |
|---|---|
| $X$ | $L\times d$,当前层输入;$d=Hd_h$ |
| $W_h^Q$ | $d\times d_h$,每头独立查询投影 |
| $W_{\mathrm{shared}}^{K,V}$ | 各为 $d\times d_h$,所有头共享、无低秩约束 |
| $U_h^{K,V}$ | 各为 $d\times r$,产生残差 latent |
| $B_h^{K,V}$ | 各为 $d_h\times r$,把残差 latent 映回头空间 |
| $R_h^{K,V}=XU_h^{K,V}$ | 各为 $L\times r$,需要缓存 |
| $N,b,s$ | 层数、批量、每个元素字节数;与单头因子 $B_h$ 区分 |
以 K 为例,原文 Eqs. (2)–(5) 给出:
V 完全类似。低秩约束落在差分 $W_h-W_{\mathrm{shared}}$ 上,而非整个 $W_h$ 上。 所以单头有效投影可以是满列秩;但这不表示有限 $r$ 下能够表示任意一组彼此独立的 MHA 投影。跨头约束仍然存在,它正是共享带来的归纳偏置。(Sec. 3,p. 3)
$r=0$ 时退化为 MQA 式共享;当 $r\ge d_h$ 时,残差足以表示任意 $d\times d_h$ 矩阵差,从表达能力上可以覆盖 MHA。取 $r=d_h$ 且仍使用原来的分解缓存时,其容量比为 $1+1/H$,反而大于 MHA。提高秩增加表达能力,却不会一直增加内存收益。
2.2 训练:共同学习,而不是固定公共基座
共享 K/V 使用常规 Kaiming 初始化;$U_h,B_h$ 使用小幅随机初始化,作者描述初始残差范数约为共享部分的 0.1 倍。两条路径在预训练中都更新,Q 保持每头独立的完整投影。训练时先构造完整的 $K_h,V_h$,再执行通常的注意力计算。(Sec. 3,p. 3)
这意味着本文的主要缓存收益出现在自回归解码阶段。训练收敛需要更少步数,是另一条实验结论;不能把解码缓存缩小理解为训练显存也按同样比例缩小。
2.3 解码:缓存特征,不缓存投影矩阵的副本
每来一个新 token $x_t$,每层追加:
共享 K/V 各存一份,每个头的残差 latent 各存一份。$B_h^K,B_h^V$ 是模型参数,所有位置共用,不应计入逐 token 缓存。这里共享的是 $XW_{\mathrm{shared}}$ 的输出;附录 D.3 把缓存对象简写成 $W_{\mathrm{shared}}$,应结合 Sec. 3 的定义理解。
2.4 两次结合律,避免展开历史 K/V
对当前头的行向量查询 $q_h\in\mathbb R^{1\times d_h}$,原文 Eq. (6) 为:
第一项是当前查询对共享键的匹配;第二项先把当前查询投到 $r$ 维,再与所有历史残差 latent 匹配。两项相加后,统一除以 $\sqrt{d_h}$ 并执行带因果约束的 softmax,得到 $a_h\in\mathbb R^{1\times L}$。
原文 Eq. (7) 接着计算:
值分支先将历史 latent 按注意力权重汇总为一个 $r$ 维向量,最后只对这个向量升维。无需先为全部 $L$ 个位置恢复 $d_h$ 维 V。输出仍是 $d_h$ 维,随后像普通 MHA 一样拼接各头并作输出投影。(Sec. 3,p. 4,Eqs. (6)–(7))
下面是上述线性投影设定的教学伪代码;位置编码和归一化的处理见 2.7。
每层处理新 token x:
  追加 x WsharedK、x WsharedV 到共享缓存
  对每个头 h:
    追加 x UhK、x UhV 到残差缓存
    q = x WhQ
    logits = q Kshared^T + (q BhK) (RhK)^T
    a = softmax(logits / sqrt(dh) + causal_mask)
    out[h] = a Vshared + (a RhV) (BhV)^T
返回 concat(out) Wo这里的“精确”指:同一个 LRKV 模型中,分解计算与显式展开计算相同。 它不保证小秩 LRKV 与任意另一个 MHA 模型等价。softmax 也没有被线性化,解码仍需要扫描历史位置,完整序列的稠密注意力依然有二次的交互规模。
2.5 缓存预算:45%–53% 是剩余比例
每层缓存元素数与相对比例分别为:
总字节数为 $2sNbL(d_h+Hr)$;bfloat16 时 $s=2$。满足 $r 按 Table 7 的秩重算,得到下表。它们是由配置得到的理论值,不是端到端服务测量: 例如 $H=18,d_h=128,r=55$ 时,每 token 每层从 $4608$ 个元素降到 $2236$ 个元素,比例为 48.52%,即节省 51.48%。摘要的“使用 45%–53% 缓存”与正文部分位置的“减少 45%–53%”口径不同,应区分剩余比例和减少比例。 标准注意力解码时,每头的主要历史扫描代价是 $O(Ld_h)$。LRKV 多出残差匹配、残差聚合以及两个小投影,额外代价为: 长上下文下,额外扫描项相对主要注意力扫描约为 $r/d_h$。因此压缩缓存可能减轻带宽压力,同时增加算术操作;能否降低时延取决于融合内核、共享缓存的实际复用和硬件瓶颈。(Sec. 3,p. 4) K/V 参数量为: 若 $d=Hd_h$,其比例是 $1/H+(r/d_h)(1+1/H)$,与缓存比例不同。这只统计 K/V 参数,不等于整个模型的参数缩减比例。(Eq. (10),p. 4) 附录 F 给 MLA 记入历史 latent 展开的 $O(Ld_cd_h)$ 开销,却让 LRKV 使用关联计算,这个比较口径不统一。它在同一附录中也讨论了 MLA 的关联计算:若定义 $K=ZW_{\mathrm{up}}^K$、$V=ZW_{\mathrm{up}}^V$,则可用 $(q(W_{\mathrm{up}}^K)^\top)Z^\top$、$(aZ)W_{\mathrm{up}}^V$ 避免展开,这里将转置按矩阵维度写全。故不能把“MLA 必须重构历史 K/V”作为 LRKV 的普遍优势;公平的时延比较需要对双方使用对应的优化实现。(pp. 27–28,Table 10) Sec. 3 在 p. 4 声称可以先对低维残差 latent 做 RoPE,再乘 $B_h^\top$,从而保持原来的缓存和开销。以下是本次分析:该交换对任意可学习 $B_h$ 一般不成立。 为方便说明,改用列向量:令某位置残差键为 $B_hz_t$,完整头空间中的旋转为 $P_t\in\mathbb R^{d_h\times d_h}$。正确旋转是: 若想只在 $r$ 维缓存空间旋转,必须存在 $\widetilde P_t\in\mathbb R^{r\times r}$,使: 这要求 $B_h$ 的列空间在相应旋转下保持不变。线性性允许旋转分配到两个加项,却不会自动允许旋转穿过一个任意矩形矩阵。 一个二维教学反例就能看清问题:令 $B=e_1$,残差只能沿第一坐标轴变化;90° 旋转后 $PB$ 的方向是第二坐标轴,而任意标量 latent 经同一个 $B$ 都只能回到第一坐标轴。更直接地写,$PB=e_2$,不存在标量 $\widetilde P$ 使 $e_2=e_1\widetilde P$。该反例说明“任意 $B$ 都可交换”的主张缺少条件,并非声称所有受约束的 RoPE 兼容分解都不可行。 如果约束 $B_h$ 选择完整旋转平面、改变位置编码方案,或保留更丰富的位置相关状态,可能构造兼容方案;这些都需要重新给出表达能力、缓存和计算的推导。本文没有给出这条完整论证。因此不能把 Eqs. (6)–(7) 的纯线性恒等式直接升级为“任意完整 RoPE 下的同成本精确解码”。 另一个需衔接的实现细节是 Sec. 4.3 提到的投影后 RMSNorm。它对共享项与残差项的和做归一化,属于依赖每个头、每个 token 的非线性缩放,不能把两项分别归一化后相加。精确实现可能需要保存或计算额外的缩放因子;本文的缓存推导没有说明这一处理。该问题不否定线性分解恒等式,但影响从恒等式走向完整模型推理的实现。(p. 9,Fig. 8) 所有模型使用 FineWeb-Edu,自回归 decoder-only 架构,基准为 MHA、GQA、MQA、MLA;只更换注意力模块,其余组件固定。规模标签指 MHA 基础架构 的参数量,不代表不同机制严格等参数。(Sec. 4,pp. 4–5;App. D.1,pp. 22–23) 训练使用单节点 8×H200、bfloat16;矩阵参数用 Muon、embedding 用 AdamW。作者列出的矩阵、embedding、unembedding 学习率分别为 0.02、0.2、0.004,采用余弦衰减、2000 步 warmup、weight decay 0.1、梯度裁剪 1.0。较大模型用物理 batch 8、累积 2 步;128M 用 batch 16,8K 组用 batch 4。(Tables 5–6,p. 23;App. F.1,p. 27) GQA 的 KV 头数随规模变化:128M/1.2B/2.5B/6.3B 分别为 3/4/6/2;MLA 的 $d_c$ 分别为 128/256/384/1024。因此主表的比较同时改变了缓存预算,不能仅凭这一组结果判断等缓存下谁最好。(Table 7,p. 24) 配置表有两处影响复现的矛盾:Table 5 把 512M 与 1.2B 都列为 24 层、1536 宽;把 2.5B 列为 18 层,而 Figs. 7、8、14 的 2.5B 分析横轴覆盖 36 层。以下保留论文的规模标签,不自行推定实际训练用了哪套架构。 本文对下游评测只笼统写采用标准 zero-shot 或 few-shot 协议,未逐任务明确 shot 数、代码采样和工具使用细节。比较应限定在作者报告的这一套评测中,尤其 GSM8K 的训练混合中包含 calculator tool use。(App. D.2、D.6,pp. 24、26) 预训练后,用约 568K 样本做一个 epoch 的监督训练:460K SmolTalk 对话、100K MMLU auxiliary train、8K GSM8K。上下文长度 2048,batch 为 524,288 tokens;不同注意力机制使用相同设置。原文称之为 midtraining,实际描述的是监督式指令/任务适应,所以 Table 2 应读成 该训练阶段之后的表现。(App. D.2,p. 24) 下表完整保留 Table 1 的 CE;同一列内比较,越低越好。 来源:Table 1,p. 5。LRKV 相对 MHA 的 CE 降幅按表中数字计算,依次约为 0.34%、0.83%、0.54%、1.34%。对应 LRKV 的 BPB 为 0.872、0.758、0.719、0.692;MHA 为 0.878、0.765、0.723、0.701。主表支持跨规模损失改善,但没有显示严格单调的相对改善趋势。 特别是 6.3B,MQA 的 CE=2.304 已优于 MHA 的 2.319,LRKV 再降到 2.288。因此“减少 KV 自由度一定降低预训练质量”并不符合该实验;参数化和优化带来的归纳偏置也在影响结果。 收敛步数与训练速度要分开。 Fig. 3(b) 在 2.5B 上比较 LRKV 达到各 baseline 最终损失所需的训练量:相对 MHA、MLA、GQA、MQA,分别少约 18.7%、21.4%、24.5%、29.7%,平均 23.6%。这些是达到目标损失所需步数/token 的节省。 原图 Fig. 3,p. 6。左图横轴是相对 MHA 缓存占比,纵轴为最终 BPB;越靠左下越好。右图纵轴是 LRKV 达到对应 baseline 最终损失所节省的训练量,越高表示越早达到目标。原图用“compute savings”命名;p. 5 脚注明确限定为 sample efficiency,并说明机制特定的 FLOPs 修正来自推理口径。故它不能作为每步训练更快或实际训练墙钟时间减少 23.6% 的证据。 来源:Table 9,p. 26;512M 标签、8192 上下文、50B tokens,LRKV $r=51$。使用表中的未四舍五入到两位小数的 CE,改善为 $(2.740-2.665)/2.740\approx2.74\%$。所有压缩方法都优于 MHA;作者将其解释为可能存在隐式正则化作用。 原图 Fig. 4,p. 6。下方横轴为训练 token,上方是作者标注的训练计算量,纵轴为测试 CE;红色 LRKV 曲线最后最低。这检验的是固定 8K 上下文下的语言建模训练,而非更长上下文外推或专门的长距离检索能力。该组 BPB 与短上下文表的 CE/BPB 比例不同,原文没有给出统一换算细节,因此不跨组直接比较 BPB 大小。 Table 2 给出的 Combined 如下,单位均为百分数: 来源:Table 2,p. 6。6.3B LRKV 的五个公开单项分数平均得到 40.36%,与表中 40.2% 不一致;上表保留原报告值。这一误差不改变该表内的领先排序,但汇报时不应把 40.2% 当作已经对齐单项的精确均值。 2.5B 的细分结果更能说明收益来自哪里: LRKV 在科学问答和知识任务上收益较明显,但 HumanEval 在 2.5B 就低于 MHA,6.3B 也从 MHA 的 14.6 降为 12.8。128M 的 GSM8K 只有 0.3,低于 MHA 的 1.0。应把摘要的下游优势理解为平均表现优势,而不是五项任务、各个规模全部第一。 MQA 的 HumanEval 分别为 2.4、3.7、4.3,明显低于其他主要方法。作者认为这是完全共享 KV 限制头特异性的结果;当前比较支持这一解释,但没有通过单独控制头多样性的干预来确定因果关系。 附录 E 的 Fig. 19 将 2.5B 五个架构的预训练 BPB 与 Combined 作散点图,报告 $R^2=0.786$。它支持这五个模型中更好的预训练质量通常伴随更好的下游表现;不能仅凭相关性断言整个下游差值完全由 BPB 改善导致。(pp. 26–27) Table 8 在 128M、100B tokens、$H=6,d_h=128$ 下给出: 来源:Table 8,p. 25。MLA-192 的表格印成“12-5%”,这里按 $192/(2\times6\times128)=12.5\%$ 写出。LRKV 内部随着秩增大,CE 单调降低;$r=32$ 已超过 MHA,而 $r=128$ 的最好损失伴随着更大的缓存。 根据原文 Table 8(p. 25)重绘。 横轴为缓存占比,纵轴为最终 CE,越靠左下越好。图中没有用原文 Fig. 5 的散点读数替换表值。 为什么要区分图表?Fig. 5(p. 7)把 MLA-$d_c=128$ 画在约 16.7% 缓存、CE≈2.947 的位置,而 Table 8 给的是 8.3%、2.901;MLA-$d_c=384$ 的图表位置也不一致。按表值,MLA-384 比 LRKV-32 缓存更少且 CE 更低,所以不支持正文声称的 LRKV 在全范围支配 MLA 前沿。LRKV-64 的 CE 更低,但需要 66.7% 缓存,是明确的容量取舍。 主配置的 $r=46$ 与消融的 $r=64$ 也不能混用:前者在 Table 1 的 128M CE/BPB 为 2.893/0.872,后者在 Table 8 为 2.888/0.875,CE 与 BPB 的排序不同。因此讨论跨表的小差距时,以同一张表、同一指标为单位更可靠。Sec. 4.3 另把 CE=2.877 对应的 4.156 标成 BPB;其数值接近 CE/$\ln2$,更像每 token 比特数,不应与 Table 8 的 0.873 BPB 混合。 不带位置旋转和额外非线性时,注意力 logit 可写成 $x_iA_hx_j^\top$,其中: 如果 Q/K 同时右乘一个正交矩阵 $R$,$A_h$ 不变。这使它比单独比较 $W_h^K$ 更适合衡量这种参数坐标变换下的头差异。内积可以用小矩阵计算: 无需显式构造每个 $d\times d$ 的 $A_h$。附录 C.1 使用范数归一化后的相似度构成 Gram 矩阵 $G$,再用 $J=I-\mathbf1\mathbf1^\top/H$ 中心化: 特征值越均匀,有效秩越高;方差越集中在少数方向,有效秩越低。这里的 $r_{\mathrm{eff}}$ 是头算子集合的谱统计,与投影残差的秩 $r$ 是两个不同概念。(Sec. 4.3,pp. 7–9;App. C.1,p. 15) Table 3 报告的百分数按 $r_{\mathrm{eff}}/H$ 归一化: 来源:Table 3,p. 16。未纳入表中带星号的 128M GQA 数字,因为作者明确说明它们是根据 2.5B 趋势估计,而非同样方式得到的实测结果。2.5B GQA 的 PCA 值为 91.7%。 本次推导:中心化后的上限不是 $H$。 因为 $G_c\mathbf1=0$,其秩至多为 $H-1$,有效秩同样至多为 $H-1$。所以按作者的除以 $H$ 口径,128M 的上限是 $5/6=83.33\%$,2.5B 的上限是 $17/18=94.44\%$。LRKV 的 83.0% 和 93.5% 已接近各自上限。两个规模之间约十个百分点的差异很大程度来自归一化上限变化,不能直接理解成较小模型丢失更多头功能。 这个上限也改变了对“中心化前后差值”的解释:即使 $H$ 个归一化算子完全正交,未中心化有效秩也会从 $H$ 变为中心化后的 $H-1$。因此 MHA/LRKV 的约 4.8–4.9 个百分点下降不能全部归因于某种共享结构。MQA 中心化后有效秩反而升高,与去掉较强公共方向、剩余方向更均匀的解释相符;它并不表示中心化这个分析操作改变了模型。 原图 Fig. 14,p. 19。两面板横轴为层索引,纵轴分别为未中心化和中心化的有效秩;右图的上限是 17。LRKV 与 MHA 在多数层相近,MQA 在中心化后更接近其他方法。该图显示 36 层,与 Table 5 的 18 层不一致,因此无法仅凭论文把这些分析检查点和主实验配置严格对应起来。 附录 C 的谱图(Figs. 10–13、16–17)进一步显示,LRKV 与 MHA 的谱较接近,解释较高累计方差需要多个主成分;热图(Figs. 6、18)展示的是对应的成对相似度。这些是同一 Gram 谱结构的不同视图。作者据此解释:共享 K 不会消除独立 Q,MQA 可通过 Q 的差异保留相当多的算子多样性;LRKV 又增加了 KV 残差自由度。 这一指标分析的是参数中潜在的差异,不直接统计具体输入上的注意力行为,也没有包含 V 与输出投影。完整 RoPE 会在 logit 中引入依赖相对位置的旋转,投影后 RMSNorm 还会引入输入相关缩放,因而静态 $A_h$ 不能独自描述整个实际注意力函数。另一个图示问题是 Fig. 9 虽标为 PCA,纵轴曲线接近 6,超过 6 个头中心化后上限 5;不应以它单独确认中心化数值。(App. C,pp. 15–22) Fig. 8 比较 K 投影的 Frobenius 范数,LRKV 总投影明显大于 MHA,两个面板标出约 4.2 倍和 5.1 倍。作者认为加法分解让共享与残差路径都能在训练中增长,而投影后的 RMSNorm 降低了对整体幅值的敏感性。(Sec. 4.3,p. 9) 原图 Fig. 8,p. 9。横轴是层号,纵轴是 K 投影范数;灰色为 MHA,其他曲线为 LRKV 的共享、残差与总投影。该图用于解释训练得到的参数状态,不是关于训练稳定性或时延的实验。 论文还报告共享项与残差项约 0.2–0.4 的余弦相似度,把它解释为共同学习出的分工。它们没有被显式施加正交约束,因此“共享基座抓住公共结构,残差补充特殊方向”是合理的机制解释,而不是严格成立的谱分解定理。附录 B 讨论了与截断 SVD 的关系,但没有给出可核实的逼近误差表或最优性定理。 附录 B 所说“任意 $\Delta$ 都能在共享与残差间平移”也需保留秩约束:$U_hB_h^\top-\Delta$ 未必仍为秩 $r$。始终存在的是因子内部的基变换自由度 $U_h\to U_hC$、$B_h\to B_hC^{-\top}$($C$ 可逆),它不改变残差矩阵。几何解释应建立在允许的变换上。(pp. 14–15) 附录 G.1 的“测量”是按指定形状创建缓存张量,通过 Table 12 声称使用 $r=64$,但其字节值与百分数不一致: 来源:Table 12 与 App. G.4,p. 29;重算值为本次分析。可见表中容量之比实际上更接近 $r=64$ 的公式,而括号百分数近似来自更小秩的主配置。App. G.4 把 $1/6+64/128$ 直接写为 0.526,同样是算术错误。 绝对容量也与 Table 5 不能全部对齐。例如按其 2.5B 配置 $N=18,H=18,d_h=128$、$L=2048,b=1$、bfloat16 计算,MHA 应为 324 MiB;Table 12 写 648 MB,相差约两倍,不能用 MB/MiB 单位差异解释。本文可以明确给出的结论是:分解布局的理论容量公式成立,但所报告的配置、秩和容量测量表尚未形成一致的复现口径。 LRKV 的贡献在于把跨头冗余写成一种清楚的参数化和缓存布局:公共 K/V 占一份,每个头只为自己的差异支付额外空间。它不改变稠密 softmax 的基本行为;对于线性 K/V,关联计算又能避免完整展开历史残差。残差秩因此同时控制表达能力、缓存容量与额外计算,是一个易于解释的架构参数。 作者的结果表支持“这些训练设置下,适当秩的 LRKV 改善预训练损失和平均下游表现”。消融也支持较大的残差容量通常带来较低 CE;MQA 的 Q 补偿现象则提醒我们,K/V 共享与注意力头功能坍缩不是一回事。 若把这项工作用于实际模型改造,最关键的三件事是:为位置编码和 Q/K 归一化给出与缓存布局一致的精确实现;把训练检查点、残差秩、层数和容量表对齐;在相同缓存预算下比较优化后的 GQA、MLA、LRKV,并测量真实解码时延。这些问题直接决定本文的架构收益能否转化为服务收益。 我的判断: 共享基座加头特异低秩残差是有启发性的设计;当前 v3 更适合作为一个值得实现并验证的架构假设。尤其完整 RoPE 的交换问题、缓存表的内部矛盾及 MLA 消融图表冲突,应在把它视为可直接替换现有注意力的方案之前解决。 主要来源:Low-Rank Key Value Attention,arXiv v3;详细定位已随公式、图表和结论给出。原文规模标签 $H$ $d_h$ Table 7 的 $r$ 按 Eq. (9) 重算的剩余缓存 128M 6 128 46 52.60% 512M / 1.2B 12 128 51 48.18% 2.5B 18 128 55 48.52% 6.3B 32 128 54 45.31% 2.6 计算与参数:缓存小,不代表每步 FLOPs 更少
2.7 完整 RoPE 的兼容性:线性不足以保证可交换
三:实验——比较对象与预算
3.1 预训练协议
实验组 上下文长度 训练 token 有效 tokens/batch 用途 128M 2048 100B 32,768 基础比较与秩消融 1.2B、2.5B、6.3B 2048 各 50B 32,768 跨规模比较 512M 长上下文 8192 50B 32,768 8K 训练 3.2 指标
3.3 监督式 midtraining
四:结果——哪些结论由哪些证据支持
4.1 预训练:四个规模的最终 CE 都更低
方法 128M / 100B 1.2B / 50B 2.5B / 50B 6.3B / 50B MHA 2.903 2.530 2.389 2.319 GQA 2.918 2.536 2.397 2.354 MQA 2.929 2.573 2.408 2.304 MLA 2.901 2.564 2.392 2.377 LRKV 2.893 2.509 2.376 2.288 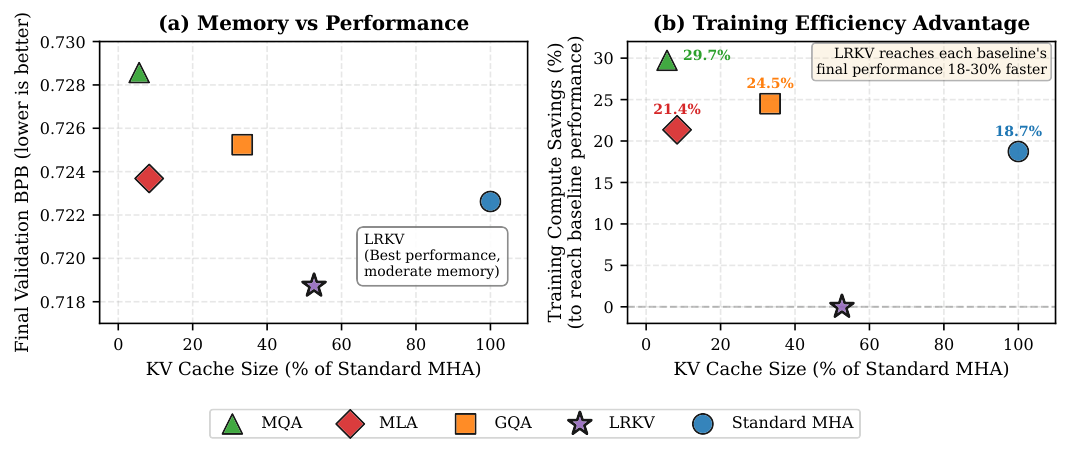
4.2 8K 上下文:报告的 CE 改善扩大
方法 缓存占比(原文) CE ↓ BPB ↓ MHA 100% 2.740 0.494 GQA 33.3% 2.704 0.488 MQA 8.3% 2.728 0.492 MLA 8.3% 2.714 0.489 LRKV 48.2% 2.665 0.481 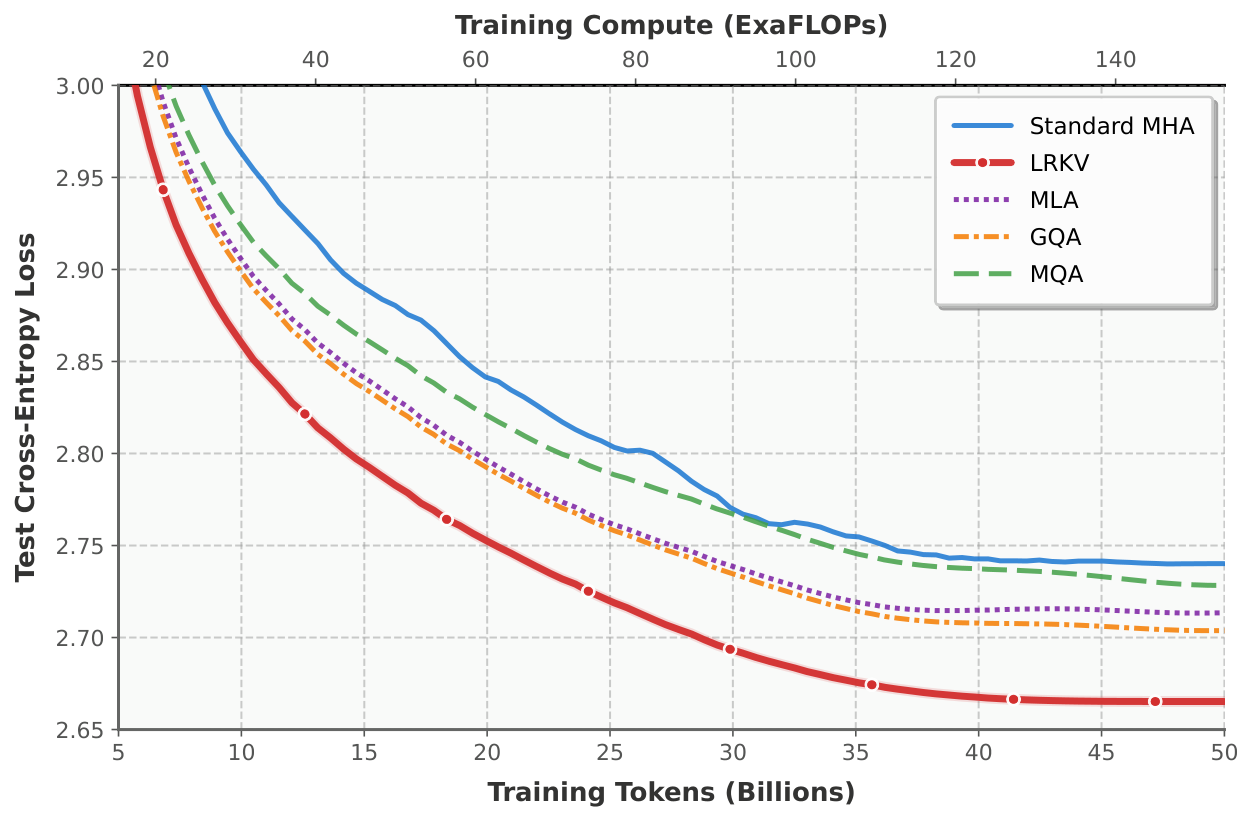
4.3 下游:平均表现更好,代码生成存在取舍
方法 128M 2.5B 6.3B MHA 17.9 35.3 38.8 GQA 16.8 35.8 36.3 MQA 17.3 33.3 33.4 MLA 18.0 36.9 36.9 LRKV 18.9 37.9 40.2 任务 MHA LRKV LRKV − MHA(百分点) ARC-Easy 66.6 70.7 +4.1 ARC-Challenge 47.1 53.8 +6.7 MMLU 39.3 42.2 +2.9 GSM8K 10.2 11.3 +1.1 HumanEval 13.4 11.7 −1.7 4.4 秩消融:容量—缓存曲线有用,“全面支配 MLA”不成立
配置 缓存占比 CE ↓ BPB ↓ LRKV $r=8$ 22.9% 2.908 0.881 LRKV $r=16$ 29.2% 2.905 0.880 LRKV $r=32$ 41.7% 2.896 0.877 LRKV $r=64$ 66.7% 2.888 0.875 LRKV $r=128$ 116.7% 2.877 0.873 MLA $d_c=128$ 8.3% 2.901 0.876 MLA $d_c=192$ 12.5% 2.898 0.876 MLA $d_c=384$ 25.0% 2.894 0.875 MHA 100.0% 2.903 0.878 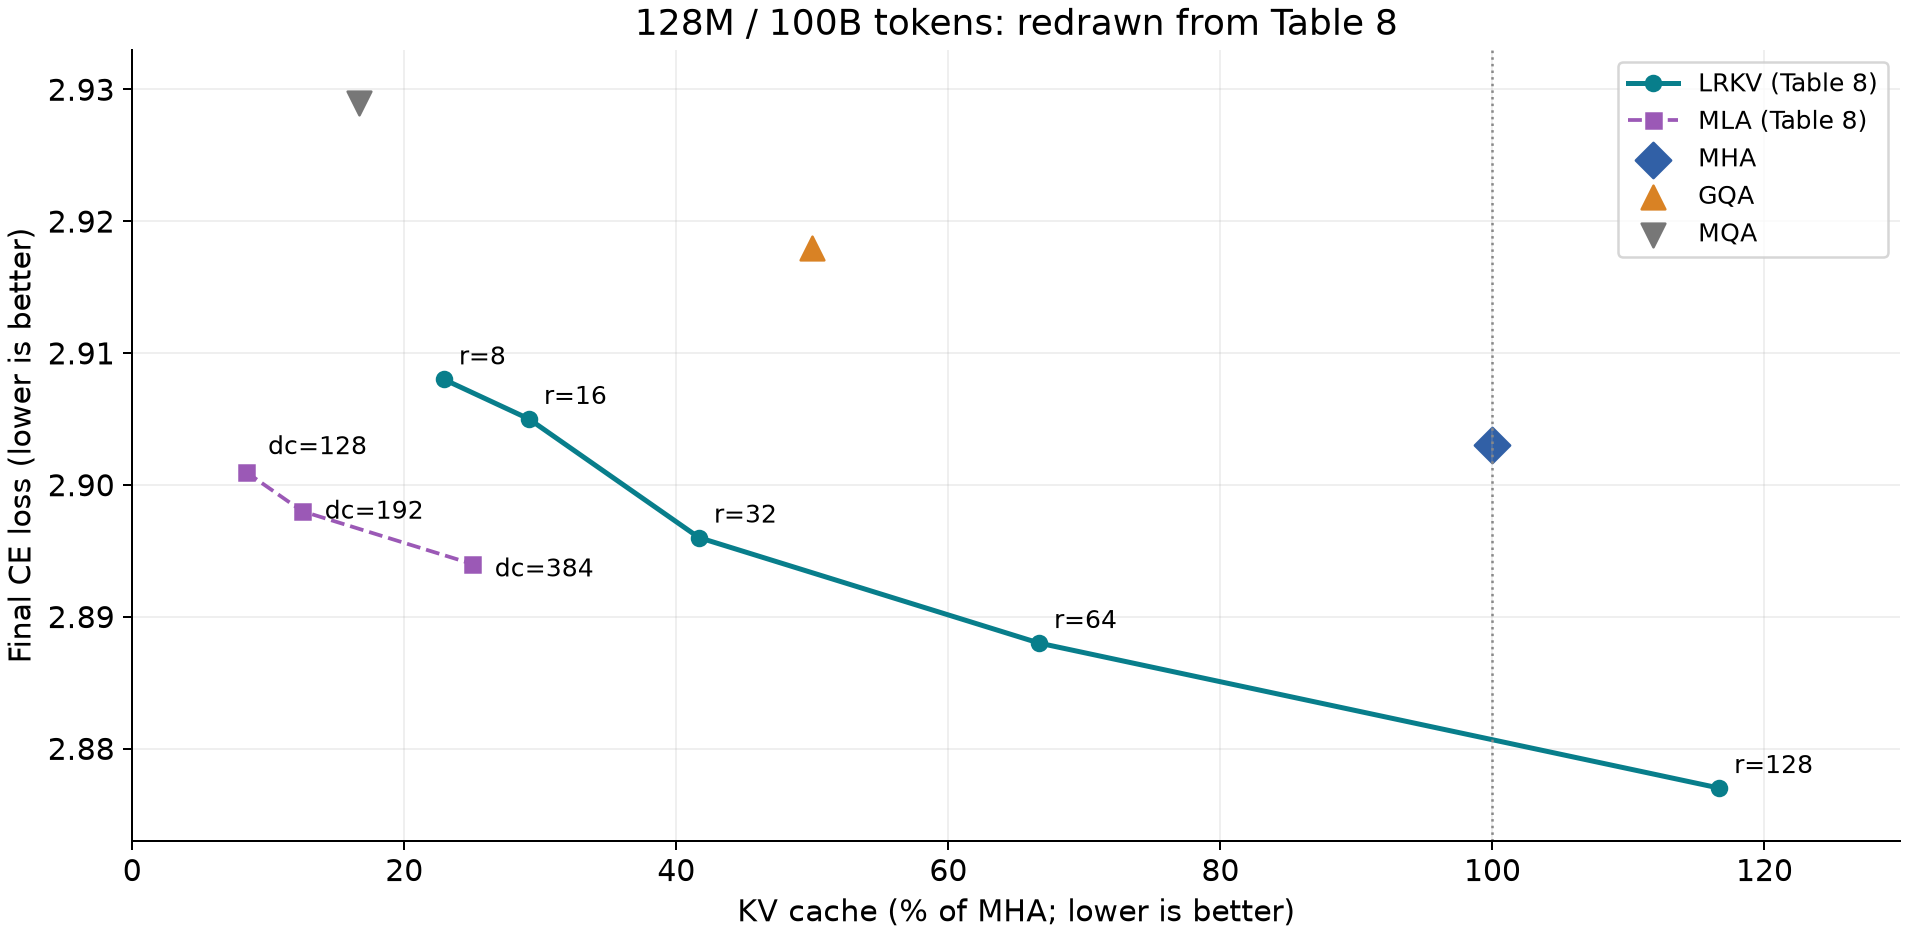
4.5 头多样性:比较双线性算子,而不只比较 K
模型 128M 未中心化 128M PCA 2.5B 未中心化 2.5B PCA MHA 95.4% 82.4% 98.9% 94.0% LRKV $r=64$ 96.2% 83.0% 98.3% 93.5% MQA 72.6% 78.4% 86.2% 91.0% MLA 83.9% 78.5% 92.7% 91.6% 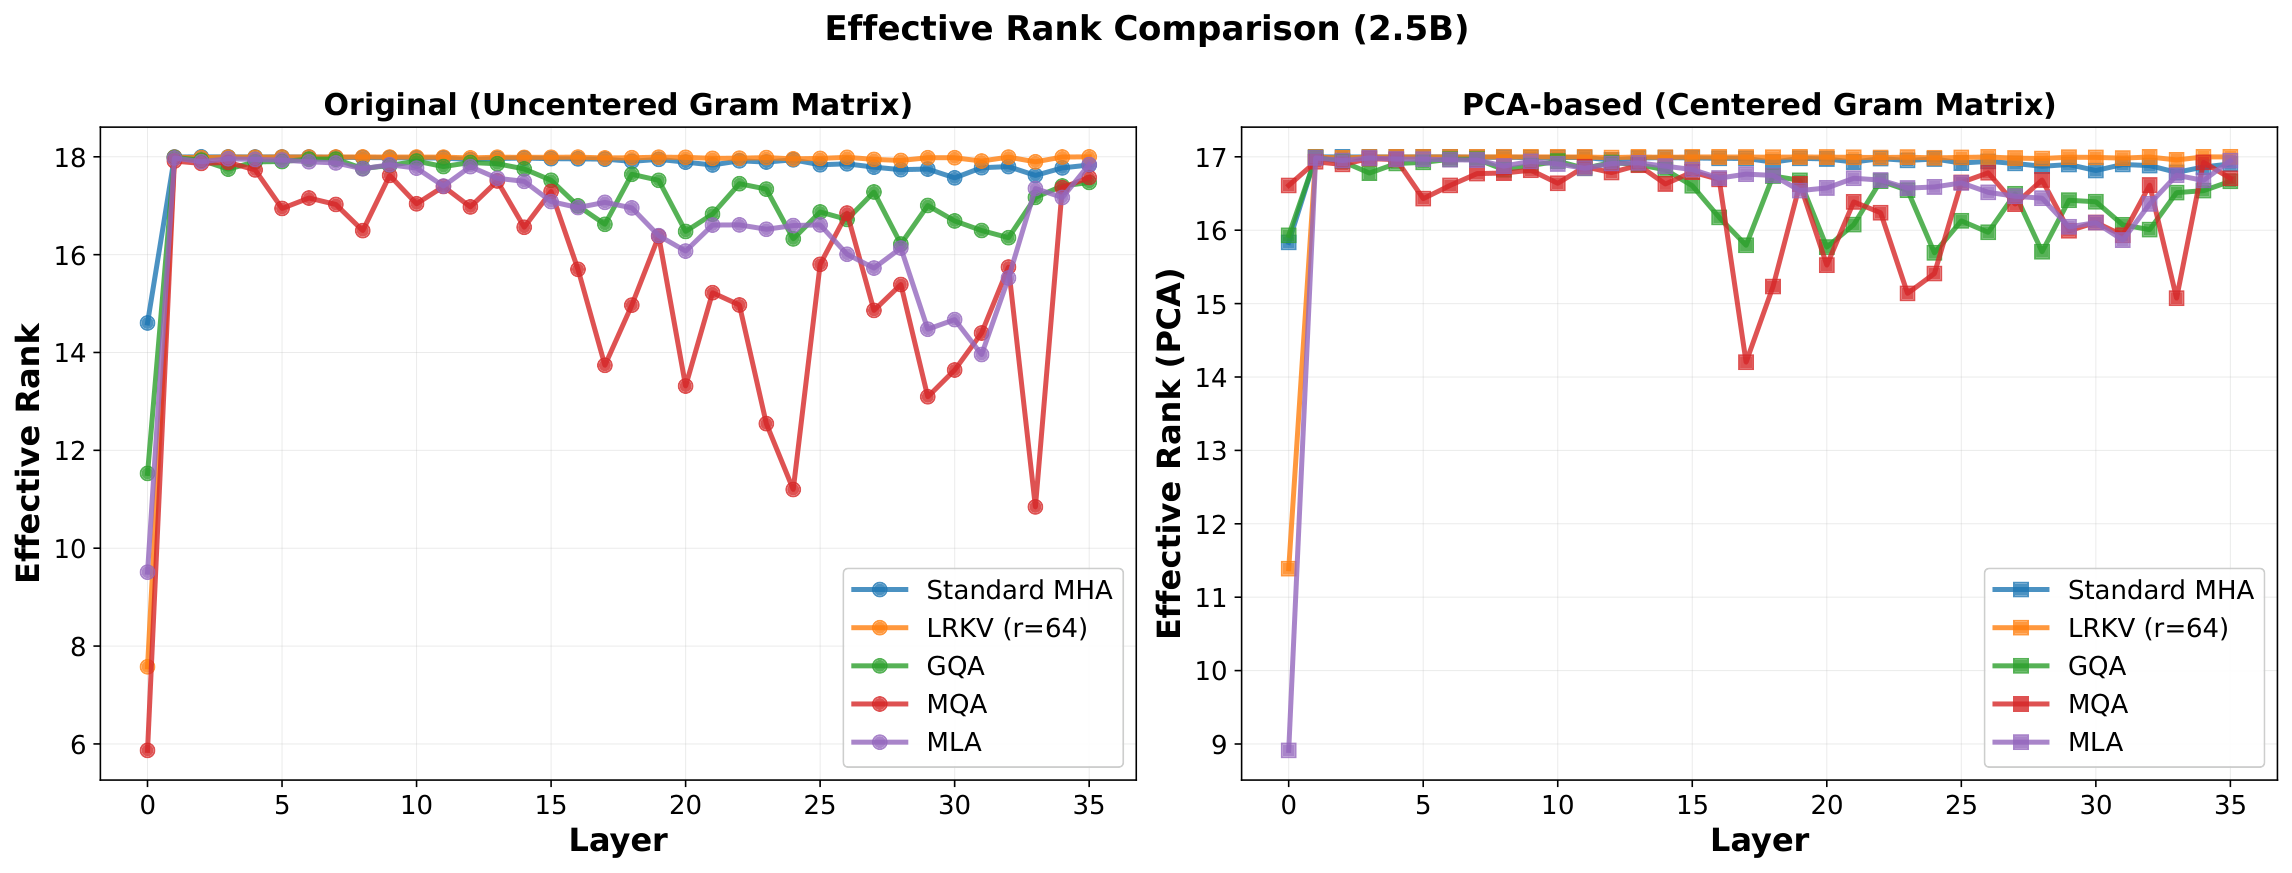
4.6 幅值与共享—残差几何
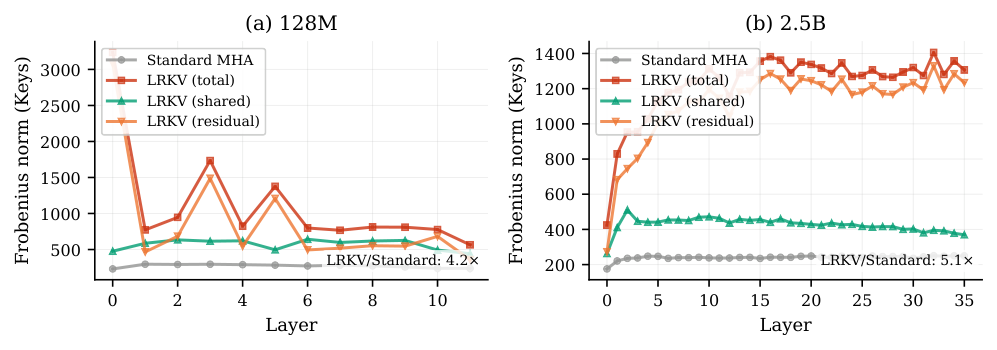
4.7 缓存测量:公式清楚,附录数值尚未对齐
numel() 与 element_size() 计算占用。它度量所定义张量的容量,没有包含实际解码吞吐、临时缓冲、融合内核工作空间或整机峰值显存。(p. 28)规模 表中 MHA / LRKV 容量 容量相除的比例 表中写出的比例 $r=64$ 按 Eq. (9) 的比例 128M 72 / 48 MB 66.67% 52.6% 66.67% 2.5B 648 / 360 MB 55.56% 48.4% 55.56% 6.3B 1152 / 612 MB 53.13% 45.1% 53.13% 五:结论——值得保留的思想与实际取舍