Fast-weight Product Key Memory:中文精读笔记
- 作者:Tianyu Zhao、Llion Jones(Sakana AI)。
- 版本:arXiv:2601.00671v2,arXiv 修订日期 2026-02-22;PDF 首页标示 2026-02-24,两者原样区分。
- 材料获取:2026-09-15;研读完成:2026-09-16。
- 原文:本地 PDF;作者源码入口;作者代码仓库。本次未运行作者代码或复现实验。
- 阅读范围:主 TeX 实际引用的全部正文及附录 A–E,与 33 页 PDF 核对;源码包获取成功。下文页码均指 PDF 页码,与本稿印刷页码一致。
论文总览
核心问题:能否让语言模型在推理时记住大量新的上下文关联,同时只读写少量参数?
FwPKM 将乘积键记忆(Product Key Memory, PKM)的稀疏寻址与测试时训练(Test-Time Training, TTT)的在线更新结合:使用两个小键表定位一个大值表,每个 token 只读取 8 个值槽;处理完一个块后,用局部重构误差更新访问过的值槽,用寻址目标调整键表。普通慢权重负责语料中学到的知识,快权重承接输入流中的临时关联。
最有支持的结论是:大容量稀疏快记忆可以补充 GDN/局部注意力的长程检索能力,且能跨 4K 片段保留有用信息。 4K 训练后在 128K NIAH 上的高准确率依赖具体模型及重读次数;LongBench 测的是答案 token 困惑度,并非正式问答准确率。总参数/存储成本增加,真实训练吞吐下降,跨域长期保留问题也未解决。
结构地图
| 原章节 | 作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 容量与计算矛盾、贡献 | pp.2–3 |
| 2 Preliminary | Top-k 记忆与乘积键寻址 | pp.3–4,式(1)–(7) |
| 3 Fast-weight Product Key Memory | 检索、写入、寻址、实用设计 | pp.4–6,图1,式(8)–(18) |
| 4.1 Training Setting | 架构、数据、对照 | pp.6–7 |
| 4.2 PPL Evaluation | 语义/情景记忆互补与门控竞争 | pp.7–9,图2–3 |
| 4.3 Needle-in-a-Haystack Evaluation | 重读和长度外推 | pp.9–10,图4 |
| 4.4 Longbench Evaluation | 真实长文本的答案概率 | pp.9–11,图5 |
| 4.5 Continual Learning Evaluation | 跨域适应与遗忘 | pp.10–12,图6 |
| 5 Interpretability Analyses | 槽追踪与门控案例 | pp.12–14,图7–8 |
| 6 Cost Analyses | 参数、FLOPs、实际吞吐 | pp.14–15,表1 |
| 7 Related Work / 8 Conclusion | 研究定位及限制 | pp.15–17 |
| A / B / C | 实现、算法、训练配置 | pp.22–26,算法1,表2 |
| D Ablation Study | 组件、冻结快权重、寻址统计 | pp.27–31,图9–14,表3–4 |
| E More Visualization Examples | 跨片段 PPL 与额外门控案例 | pp.32–33,图15–16 |
一:动机——记忆容量与每次访问成本能否分开?
完整注意力为每个历史 token 留存键值,整个序列的注意力计算通常随长度平方增长;这里的平方说法指处理全序列,不应误写成单步解码的复杂度。GDN 等递归模块将历史压入固定状态,访问高效,但状态容量有限。密集 TTT 的快权重网络可以增大,然而每次读写整个网络的成本也随参数量增加。
PKM 的切入点是“存得多、每次只取一点”。传统 PKM 作为通道混合器,其值表是训练后固定的慢参数;FwPKM 通过在线改写键值表,使其成为跨时间传递信息的 token 混合组件。作者的“语义记忆/情景记忆”是功能类比,不意味着获得了严格的认知科学分解。
二:方法——先读旧记忆,再写新关联
2.1 参数、形状及数据流
| 符号 | 含义 | 本文默认配置 |
|---|---|---|
| $h_t$ | 主干隐藏状态 | 维度 768 |
| $q_t,v_t$ | 慢投影产生的查询及值表示 | $d_k=d_v=512$ |
| $g_t$ | sigmoid 标量门 | $(0,1)$ |
| $K^{(1)},K^{(2)}$ | 两个快键表 | 各 $512\times256$ |
| $V$ | 快值表 | $262144\times512$ |
| $k$ | 每 token 最终访问槽数 | 8,单头 |
| $C$ | 写入块大小 | 训练及 PPL 为 512 |
| $\phi,\theta$ | 慢权重、快权重 | $\theta=\{K^{(1)},K^{(2)},V\}$ |
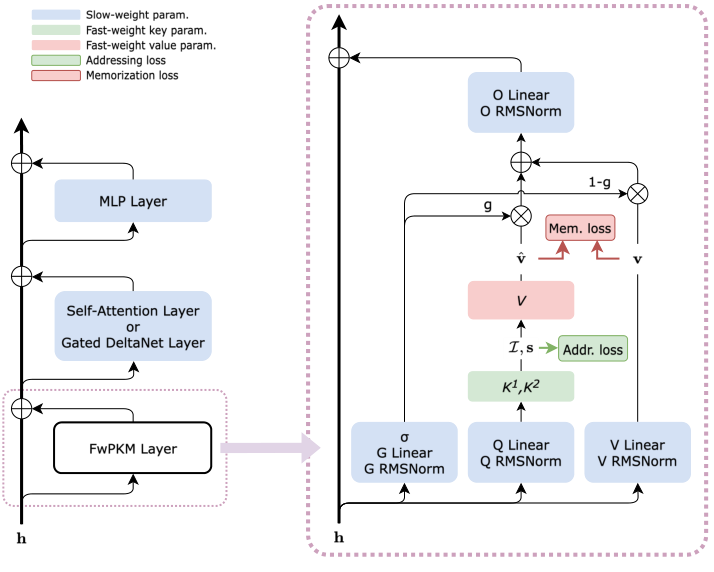
图1(PDF p.4)的架构部分裁切,保留图例。FwPKM 插入 token mixer 前,后续仍有 GDN/注意力和 MLP。蓝色为慢参数,绿/红为快键/快值。图中局部输出经投影后还进入主干残差路径,不要把门控混合本身当作完整主干残差。
每个块的顺序是:慢投影构造 $q,v,g$ → 从块开始时的快权重检索 → 输出给后续网络 → 块结束后改写快权重。训练时慢权重由全局语言建模目标学习;训练和推理时都可执行局部快权重更新。论文附录 C 特别说明:FwPKM/FwMLP 的 mini-batch 内序列共享快权重,LaCT/TTT 则按序列保有独立快权重。这会影响比较与部署中的状态隔离。
2.2 乘积键:避免扫描全部值槽
把查询分成 $q^{(1)},q^{(2)}$。每个子查询分别给 512 个子键打分,取各自 Top-8,再从 $8^2=64$ 个候选组合中取最终 Top-8。组合分数是两项子分数之和,索引 $(i,j)$ 映射到值表的一行。
$s'$ 是最终选中槽上的 softmax 权重。默认并不是朴素点积,而是对子键应用逆距离权重(IDW):
距离近得分高,softmax 后相当于归一化的逆平方距离权重。作者认为这比单靠增大键范数提高点积分数更稳定,点积替换常出现槽塌缩/损失发散,因此未列入正式消融。
复杂度边界(本次分析):固定记忆规模时,每 token 的这部分操作不随历史长度增长;但增大槽数 $N$ 仍会增加约 $\sqrt N$ 量级的子键评分工作,大值表存储仍为 $O(Nd_v)$。不能将“固定 per-token compute”理解为记忆规模任意增长也完全免费,更不能推广为含 FA 的整个混合模型都线性。
2.3 门控决定何时使用与写入记忆
$g_t$ 高时依赖检索,低时依赖当前 token 的投影值。门还加权写入误差:读记忆收益大的位置也更强地参与写入。这是一个由全局语言建模任务学出的使用策略,不是人工指定的实体缓存规则。(Sec.3.2–3.3,p.5,式(11)–(15))
2.4 写入:对已访问值槽做残差修正
正文首先解释同位置重构;实际默认用前瞻目标(lookahead):
目标值沿特征维 z-score 归一化。损失对 token 和特征求和,而不是均值,避免步长额外缩小 $1/(Cd_v)$。设 $N_i^{\rm read}$ 为槽 $i$ 在块内被读取次数,值更新为:
只对访问过的槽执行;未访问槽无需除以零。固定寻址权重时,梯度是 $g_t s'_{t,i}(\hat v_t-v_{t+1})$ 的累加,方向是补上重构残差。共享槽的多个 token 竞争写入,按访问次数平均可限制反复覆盖造成的过大步长,但不能消除互相冲突的信息。
教学例子:若只有一个被访问槽、门和检索权重均为 1,且该槽只被访问一次,则一步更新将该槽写成目标。真实 Top-8 混合、门小于 1、多次共享槽时,并不保证一次就完全记住。这解释了重读为何可能继续降低记忆误差。
因果性:读完块之后才用块内已经看见的 $v_{t+1}$ 写入,所以这些目标不影响同块已产生的预测。训练时每个 512-token 块丢弃最后一个无法在块内配对的位置,4096-token 序列共 8 个;推理通过缓存积累可用配对。(附录 A.1–A.5,pp.22–23,式(19))
2.5 寻址优化与原文符号问题
对子键 Top-k 概率向量在一个块上求平均 $\bar p^{(1)},\bar p^{(2)}$,作者希望提高平均使用分布的熵,缓解仅使用少数槽的塌缩。
原文不一致:Sec.3.4、PDF p.6 的式(17)先写 $-H(\bar p^{(1)})-H(\bar p^{(2)})$,但下一行展开成 $-\sum p\log p$,后者按标准定义是正熵。最小化它会降低熵,与文字和算法1(p.24)的“最大化熵”相反。源码与 PDF 均如此。
按文字和伪代码意图,负熵应展开为:
这属于基于数学定义的符号校正解释,不是已核验作者代码的实现结论。实现时不能照抄原文展开式。另一个边界是:两个边缘分布均匀不代表联合值槽访问必然均匀;表4也显示实际覆盖远未均匀。
三:实验——先分清训练、流式评估和重读
3.1 训练与比较对象
12 层、隐藏维度 768,基线约 112M 参数;10B 训练 token,由 LC64 与 Fineweb-Edu 各 5B 组成;所有模型训练长度 4096。训练使用 4 张 H100,20000 步,全局 batch 128、micro-batch 8,学习率上下限 0.001/0.0001,warmup 100,weight decay 0.1。FwPKM 用 FP32,其他模块通常 BF16。长于 4096 的评估采用 YaRN 调整 RoPE,不能称为完全没有长度适配。(Sec.4.1;附录 C,表2,pp.25–26)
| 对照 | 要回答的问题 |
|---|---|
| GDN | 固定状态递归基线能记多少? |
| GDN+SWA | GDN 与 512 窗口注意力按 3:1 混合,局部注意力是否足够? |
| GDN+FA / FA | 完整注意力是否替代快记忆? |
| PKM@2,6,10 | 扩大慢权重的语义容量有什么收益? |
| FwPKM@2,6,10 | 插入动态稀疏记忆有什么收益? |
| PKM@6 + FwPKM@2,10 | 静态与动态记忆能否互补? |
| FwMLP | 使用密集快权重替代稀疏记忆的效果? |
| LaCT | 独立强 TTT 基线;选用 512 块、2048 注意力窗口 |
PKM 替换 MLP,FwPKM 插在 token mixer 前,位置和参数预算不完全相同。PKM 有 4 头×32 槽,FwPKM 1 头×8 槽;二者均有 $512^2$ 值槽。FwMLP 使用密集 MSE 均值、学习率 0.1,不能将它与 FwPKM 的比较理解为只有稀疏性一个因素改变。
3.2 四类评估协议
| 评估 | 数据/规模 | 状态与更新 | 指标 |
|---|---|---|---|
| PPL | Fineweb-Edu、LC64、LAMBADA,各 8M token | batch=1,4K 片段按原顺序,不在相邻片段间清空快权重;块512 | PPL,越低越好 |
| NIAH | 基础集500例;4K、8K、32K、128K;每例5条键值针,4字符键和6位值 | 每遍完整 haystack 后更新一次,$C$ 等于上下文长度;重读1–4遍;生成答案时不更新 | 检索准确率,越高越好 |
| LongBench | 5个QA任务,共950例,平均17421、最长81616 token | 读完上下文后更新一次;答案生成时不更新;多个参考仅取第一个 | 仅答案 token PPL,越低越好 |
| 持续学习 | Pile 的6个域,每域互不重叠的4M适应/4M评估 token | 依次适应6域,只更新快权重;每阶段测所有域 | 相对初始的 $\Delta$NLL,负值表示改善 |
注意:LAMBADA 在本文按上述语料 PPL 评估,不等同于标准最后词准确率。论文没有在主要结果图中给多随机种子误差条或显著性检验,不能自行宣称统计显著。
四:结果——收益成立的条件
4.1 PPL 与门控竞争(Sec.4.2,图2–3,p.8)
以下数值读自图2;所有列均是 PPL↓。
| GDN 主干变体 | Fineweb-Edu | LC64 | LAMBADA |
|---|---|---|---|
| 基线 | 19.73 | 10.12 | 32.91 |
| PKM@2,6,10 | 18.27 | 9.27 | 29.97 |
| FwPKM@2,6,10 | 18.09 | 8.89 | 26.73 |
| PKM@6 + FwPKM@2,10 | 17.39 | 8.54 | 25.91 |
混合方案相对 GDN 的 LC64 PPL 降低 1.58(约15.6%),LAMBADA 降低 7.00(约21.3%);百分比是本次据图计算,不是百分点或准确率提升。GDN+SWA 的 LC64 也从9.20降至8.27。
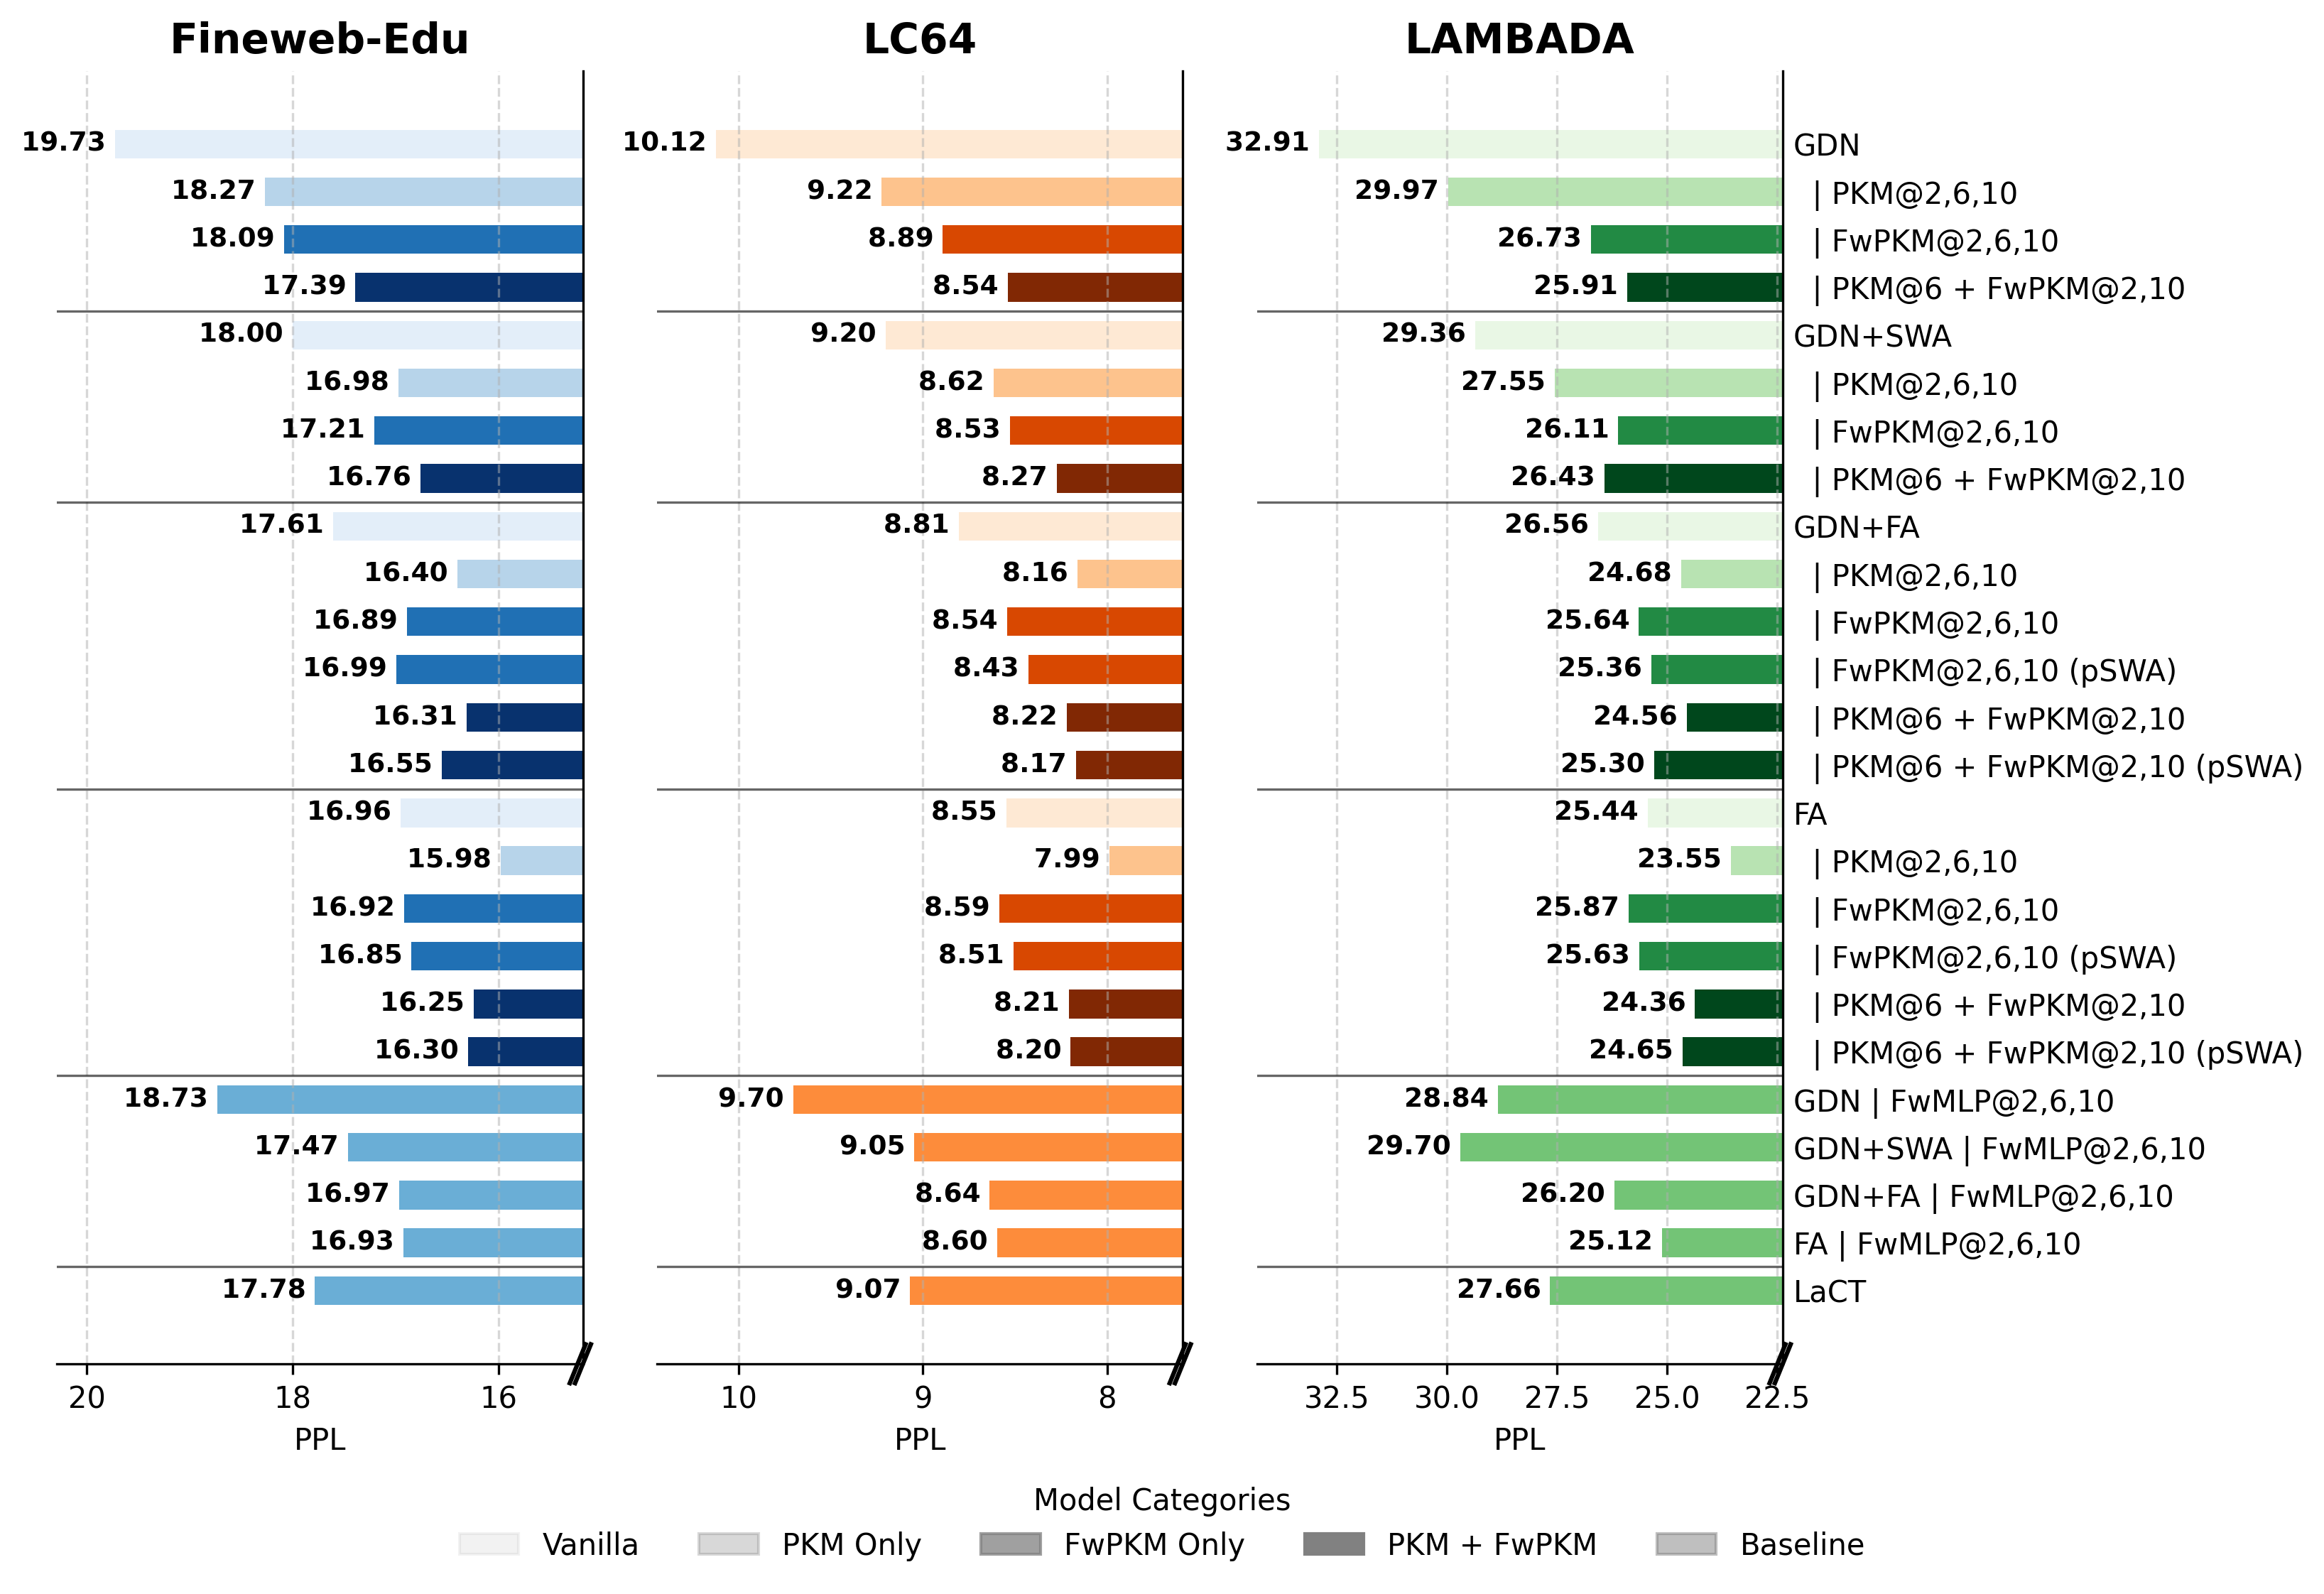
图2,PDF p.8。三列分别是三套语料,行按主干和记忆变体组织;横轴越小越好。收益并非所有主干一致:FA/GDN+FA 中完整注意力容易使门值靠近0,即模型少用 FwPKM。作者用 pSWA 在训练时以0.9概率将完整注意力限制到512窗口,提高快记忆使用程度;它对 PPL 的影响有限,对后续检索影响更明显。
因此,功能分工不是只靠装上模块就自然出现,还取决于训练时各信息路径的竞争。正文说 PKM 对 Fineweb-Edu 提供最大收益,应理解为总体趋势,不能盖过图2中某些具体模型的例外。
4.2 NIAH:外推与重读必须同时报告(Sec.4.3,图4,p.10)
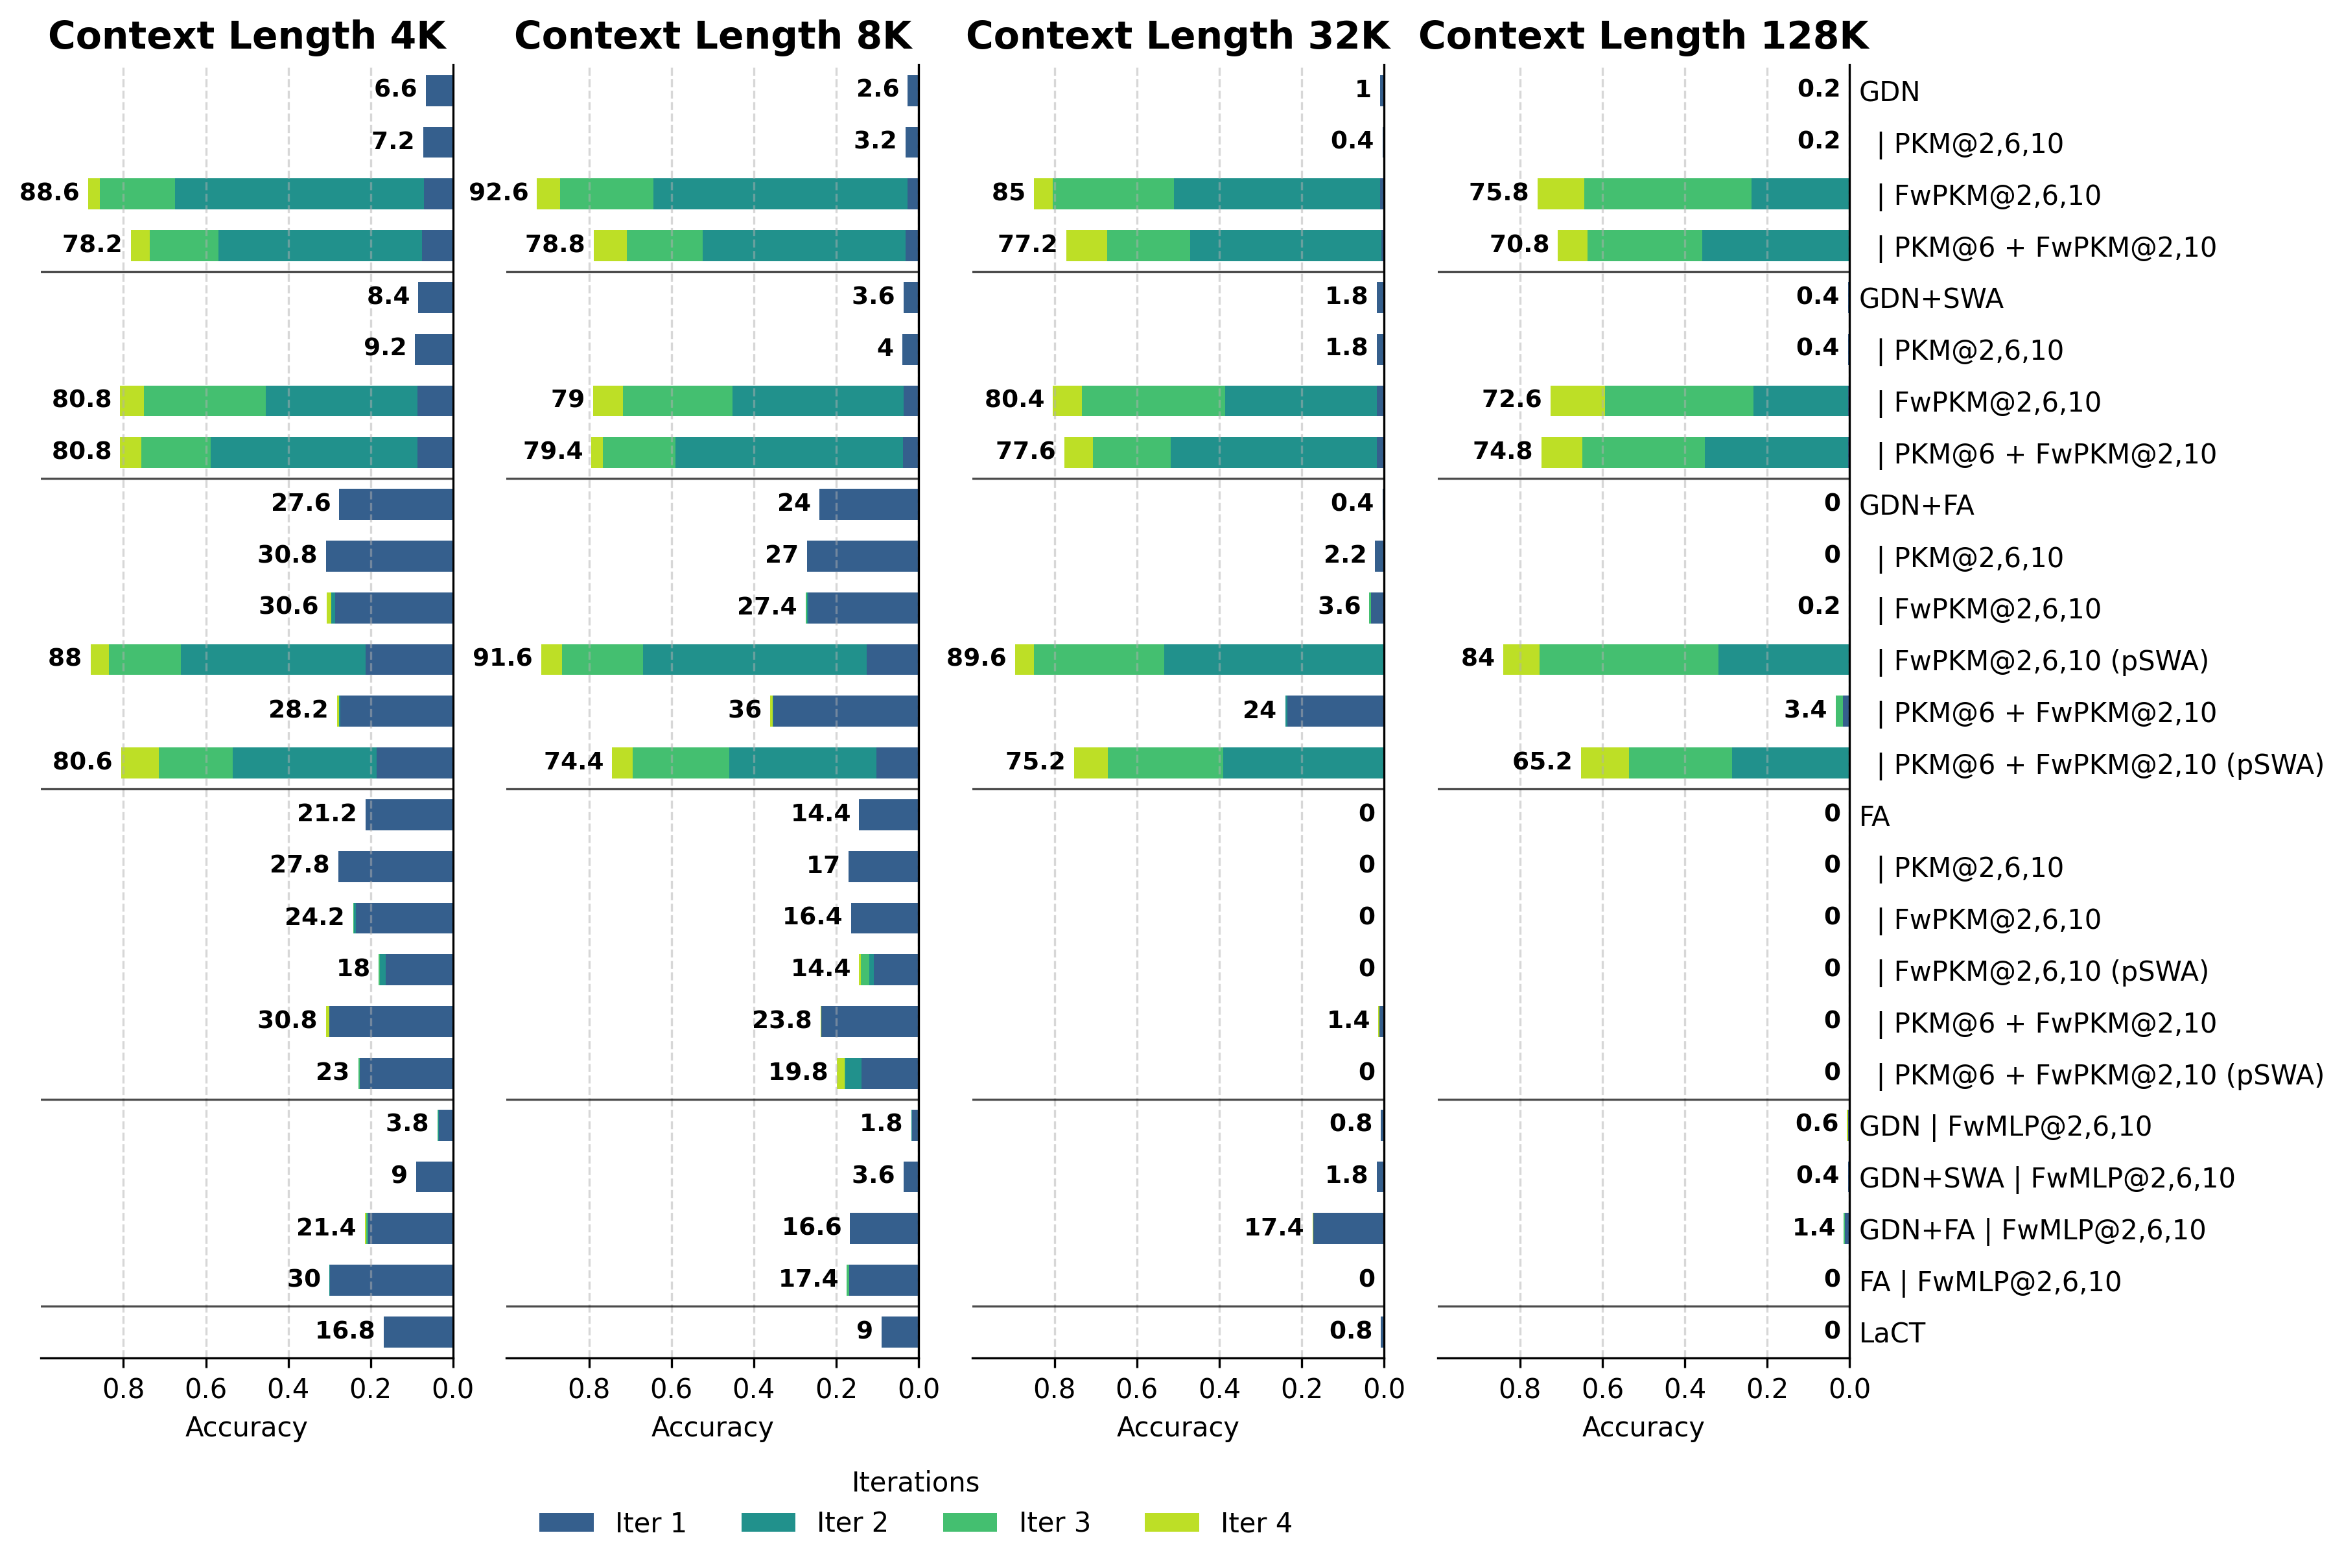
图4,PDF p.10。四列对应上下文长度;颜色区分第1–4遍读取,堆叠条的终点是相应累计重读预算下的准确率,不能将各段视为独立准确率再相加。读取更长上下文时,并非沿用训练的512块,而是整段读完才更新。
选取图中最终 4遍读取 的结果:
| 模型 | 4K | 128K |
|---|---|---|
| GDN + FwPKM@2,6,10 | 88.6% | 73.8% |
| GDN+SWA + PKM@6 + FwPKM@2,10 | 80.8% | 74.8% |
| GDN+FA + FwPKM@2,6,10(pSWA) | 85.0% | 84.0% |
作者概括多种情形下从首遍不足10%,第二遍超过50%,更多遍超过70%。这些不是所有配置、长度的统一数字。4K→128K 是32倍长度外推,得到的是在所测 passkey 任务上的能力;不能据此声称128K复杂推理或单遍80%检索已经解决。额外重读也增加推理计算预算,与单遍注意力并非等时延比较。
4.3 LongBench:预测正确答案的概率改善(Sec.4.4,图5,p.11)
GDN 在 2WikiMultihopQA 的答案 PPL 从19.50降至12.69,HotpotQA 从36.25降至21.00(PKM@6 + FwPKM@2,10,图5)。这支持记忆对真实任务有帮助;但没有正式 F1/EM 结果,不能换算成问答得分提升。LaCT 因 PPL>100 未展示,省略不等于不存在该比较对象。
4.4 持续学习:能吸收,不等于能长期保留(Sec.4.5,图6,p.11)
域依次为 DM Mathematics、FreeLaw、PhilPapers、PubMed Central、Ubuntu IRC、USPTO Backgrounds。图6横轴为适应阶段,线条颜色与域匹配,背景表示当前适应域,纵轴 $\Delta$NLL 越负越好。相应域在被适应后下降,但经过后续域后多数收益回退。证据支持快速在线适应,同时直接揭示跨域保留不足;本工作没有实现持久记忆巩固。
4.5 可解释性:可追踪的槽与门控(Sec.5,图7–8,pp.12–14)
图7追踪4K、4遍读取下生成6位值时,层2/10各8个槽的最近写入内容;多数槽包含正确目标,少数噪声槽未阻止该例正确生成。它是具体成功案例,不是全测试集的检索精度统计;“最近写入来源”也不等于当前槽只包含这一来源,因为槽值是多次加权更新后的结果。
图8将 Sakana AI 文本的门值着色:蓝为低层、红为高层,颜色深表示更依赖快记忆;可视化特意改成每32 token更新。高层对名字、罕见实体较敏感,低层更普遍激活。这支持作者的层分工解释,但仅凭案例还不足以证明独立的普适新颖性检测器。附录 E.2 的论文引言提供另一案例。
4.6 消融与寻址(附录 D,pp.27–31)
- Lookahead 最关键:图11中去掉前瞻目标,128K最终检索从74.8%降至1.8%,4K从80.8%降至8.2%。注意图9的PPL变化远小于检索崩溃,平均语言建模指标可能掩盖记忆功能退化。
- 寻址与门加权:去掉寻址目标时改用MSE同时更新键和值,并非简单冻结键;128K检索37.2%。去掉门控对写入损失的加权时为19.4%。移除门本身和只移除损失加权是不同干预。
- Top-k/多头:扩大有效读取槽数有时改善任务指标,却不是一致改善;表3中默认21.06 samples/s,1头Top-32为20.96,4头Top-8为17.08。
- 归一化:有助稳定;其移除对部分PPL/任务变化有限,不能说所有组件都同样重要。
- 冻结快权重(图14):GDN+SWA 混合方案的LC64 PPL由8.27变8.77,LAMBADA由26.43变28.07,而Fineweb-Edu为16.76→16.97。支持长程收益至少部分来自动态更新,而非仅增加参数。
寻址统计每32K token计算、再跨8M token与两层平均。碰撞率是落在多次访问槽上的访问次数比例;覆盖率为被访问槽占比;KLD衡量相对均匀分布的偏离。
| LC64,表4 p.31 | 碰撞率↓ | 覆盖率↑ | KLD↓ |
|---|---|---|---|
| 默认混合方案 | 85.2% | 28.4% | 2.1 |
| 去掉寻址损失 | 96.4% | 8.0% | 5.4 |
| 1头Top-32 | 95.4% | 55.0% | 1.9 |
增加Top-k会改变总访问次数,碰撞率不能跨这些配置机械解释为好坏。默认仍远未均匀访问;更均匀也不保证任务准确率单调提高。附录 E.1 图15中跨片段累计PPL差值的锯齿变化提供补充证据,但作者将其成因表述为假设,冻结实验比曲线形状本身更直接。
4.7 计算量与真实速度(Sec.6,表1,p.15)
单H100、全局batch 8、100训练步的剖析结果如下;不是解码时延测试。
| GDN 变体 | 总参数M | 激活参数M | FLOPs T | samples/s↑ |
|---|---|---|---|---|
| 基线 | 112.11 | 112.11 | 22.04 | 54.44 |
| PKM@2,6,10 | 509.08 | 106.62 | 20.92 | 42.90 |
| FwPKM@2,6,10 | 519.12 | 116.48 | 22.74 | 19.04 |
| PKM@6 + FwPKM@2,10 | 515.77 | 113.19 | 22.14 | 21.27 |
FwPKM-only 总参数约4.63倍、激活参数约1.04倍、理论FLOPs约1.03倍;吞吐只剩约35.0%(约2.86倍训练时间/样本,按表计算)。稀疏访问不代表大值表无存储成本。作者把速度差主要归因于稀疏读写内核成熟度不足;优化后能否追平尚未验证。
五:结论与可迁移启示
- 架构贡献明确:将大容量静态PKM变成由局部学习规则驱动的动态稀疏记忆;容量与活跃参数量部分解耦。
- 训练目标与使用策略共同决定记忆是否有效:前瞻目标、门控写入和寻址均衡比简单“加大记忆表”更关键,完整注意力会产生路径竞争。
- 任务收益有边界:支持流式PPL与合成检索改善,LongBench答案概率也受益;尚未证明大模型、普适长上下文推理、等时延优势或长期跨域保留。
- 复现优先项(本次分析):核验式(17)符号和实际代码;明确快状态初始化/重置与batch共享语义;对齐重读计算预算和总存储;区分训练512块与检索整段块;补多随机种子及正式问答指标。
可讨论的问题:能否用更小的重读预算保留同样检索收益?能否把反复有用的快记忆巩固到慢权重?如何在提高槽覆盖时避免破坏已经写入关联的地址?这些是由论文结果引出的后续方向,不是本文已解决的能力。
交付与核验说明
中文笔记与英文幻灯片基于同一v2材料。表中数字分别标注原图/表来源,衍生比例标为本次计算;未估造缺失误差条。幻灯片由本地pdfLaTeX编译;环境与视觉检查记录见同目录 verification.md。