Efficient-DLM:从自回归模型到高效扩散语言模型
论文:Efficient-DLM: From Autoregressive to Diffusion Language Models, and Beyond in Speed
作者:Yonggan Fu、Lexington Whalen、Zhifan Ye、Xin Dong、Shizhe Diao、Jingyu Liu、Chengyue Wu、Hao Zhang、Enze Xie、Song Han、Maksim Khadkevich、Jan Kautz、Yingyan (Celine) Lin、Pavlo Molchanov
版本:arXiv:2512.14067v2,2026-04-29 修订;本次获取与研读日期:2026-10-14
原文:arXiv v2 · 本地 PDF · 英文汇报幻灯片
论文总览
Efficient-DLM 研究的是:怎样利用已有自回归语言模型(autoregressive language model,AR LM)的能力,训练出支持并行生成、又能实际提速的扩散语言模型(diffusion language model,dLM)?
作者给出的训练方案有两个关键点。第一,采用块间因果、块内双向的注意力,并让每个受污染的块只读取已经完整呈现的前文。这样既支持原生 KV cache,也让新的计算结构更接近 AR 预训练时的结构。第二,训练时不再等概率地选择遮罩位置,而是根据噪声水平,适度提高块后部被遮罩的概率,以贴近推理中“前部较早确定、后部较晚确定”的现象。
论文的主要价值是把注意力模式、干净前文、预测位置、训练块大小、遮罩分布与训练预算放进同一套转换实验中,解释它们如何共同决定准确率—吞吐量取舍。块扩散、干净前文和置信度解码均有前作基础;本工作的贡献集中于 AR→dLM 转换的系统分析、位置相关遮罩,以及据此训练出的 1.5B/4B/8B 模型。
一个能代表最终结果的点是:在单张 H100、batch size 1 的报告设置下,Efficient-DLM 8B 在平均 TPF=3.27 时达到 130.71 token/s、12 任务平均分 70.65;Qwen3 4B 为 47.13 token/s、67.97。按主表计算,吞吐量为 2.77 倍,准确率高 2.68 个百分点。与同规模 Qwen3 8B 相比,则是约 3.07 倍吞吐量、低 0.93 个百分点。准确率几乎持平的 TPF=1 设置本身没有提速,必须把解码工作点一起看。(Sec. 5.1,PDF p. 8,Table 3)
结构地图
以下页码均为从 1 开始的 PDF 页码。
| 原文章节 | 解决的问题 | 位置与主要证据 |
|---|---|---|
| 1. Introduction | 为什么并行生成潜力尚未转成实际速度优势 | pp. 1–2,Fig. 1 |
| 2. Efficient-DLM: Attention Pattern Analysis | 注意力、干净前文、token shift、块大小如何影响转换 | pp. 2–5,Eq. (1),Table 1,Figs. 2–5 |
| 3. Efficient-DLM: Position-dependent Token Masking | 遮罩分布的训练—推理差异及修正 | pp. 5–7,Eq. (2),Table 2,Figs. 6–7 |
| 4. Training Dynamics Analysis | 继续训练如何改变并行解码能力 | pp. 7–8,Fig. 8 |
| 5. Efficient-DLM: A New Family of Efficient dLMs | 最终模型、综合基准、灵活解码、文本嵌入和组件消融 | pp. 8–10,Tables 3–5,Fig. 9 |
| 6. Related Work;7. Conclusion | 与既有方法的关系及研究结论 | pp. 9–10 |
| Appendix A–B | 评测协议与逐任务结果 | pp. 13–14,Table 6 |
| Appendix C | 加速后的 dLM 对手与大 batch 条件 | pp. 13–14,Figs. 10–11 |
| Appendix D–F | 学习率、位置损失分布、LoRA 转换 | pp. 14–15,Tables 7–8,Fig. 12 |
一:动机——并行解码为什么还需要重新设计训练
1. AR 的长处和速度瓶颈
AR 模型把序列概率写成逐 token 条件概率的乘积。预测下一个 token 时,前文已经确定,因此历史 key/value 可以缓存。问题在于,一个请求通常每次前向只新增一个 token。在小 batch、显存带宽受限的场景里,反复读取模型权重,却只产出少量新 token,限制了硬件利用率。
遮罩扩散模型通过反复恢复 [MASK] 来生成文本,一次前向可以确定多个位置。可并行并不自动意味着更快:如果每轮都重算整段双向注意力,或者每轮最终只接受一个 token,额外计算会吞掉并行收益。作者因此同时追求两个条件:可复用前文计算,以及能够可信地一次接受多个预测。(Sec. 1,PDF pp. 1–2)
2. 为什么从 AR 模型转换仍然困难
直接把预训练 AR 模型改成全双向去噪模型,会同时改变可见上下文、预测任务和输入污染程度。尤其对靠后的 token,原来完整可用的前文现在也可能被遮罩。模型不仅要学习使用右侧信息,还要适应大面积缺失的左侧信息。论文观察到,这种转换伴随更大的权重偏移和更差的任务保留。
Efficient-DLM 的设计原则是:保留跨块的因果结构,把主要的双向适应和污染限制在当前块内。 这里存在适应新任务与保留旧能力的平衡;权重完全不变无法完成转换,变化过大又容易损失原有能力。后续块大小与学习率实验都围绕这一平衡展开。(Sec. 2,PDF pp. 2–5;Appendix D,pp. 14–15)
二:方法——训练结构、遮罩分布与并行生成
2.1 输入与输出:整段序列按块组织
设训练序列为 $\mathbf{x}=(x_1,\ldots,x_L)$,划分为 $B$ 个连续块,每块长度 $L'=L/B$。
| 符号 | 含义 |
|---|---|
| $\mathbf{x}^b$ | 第 $b$ 个干净块 |
$\mathbf{x}^{| 第 $b$ 块之前的全部干净块 | |
| $\tilde{\mathbf{x}}_t^b$ | 在噪声水平 $t$ 下遮罩后的第 $b$ 块 |
| $t\in(0,1]$ | 噪声水平,越大表示遮罩越多 |
| $\theta$ | 从预训练 AR 模型初始化、继续训练的参数 |
| $\beta,\lambda$ | 控制块内位置偏置的等价参数 |
训练时,模型输入包含受污染的序列和干净序列,通过特殊注意力掩码,把每个去噪任务限制为“恢复当前块,条件是当前块的可见 token 和完整前文”。推理时,先完成前面的块,再逐步去噪当前块;块内可以同时确定多个位置,完成一个块后进入下一个块。
2.2 三种注意力模式的区别
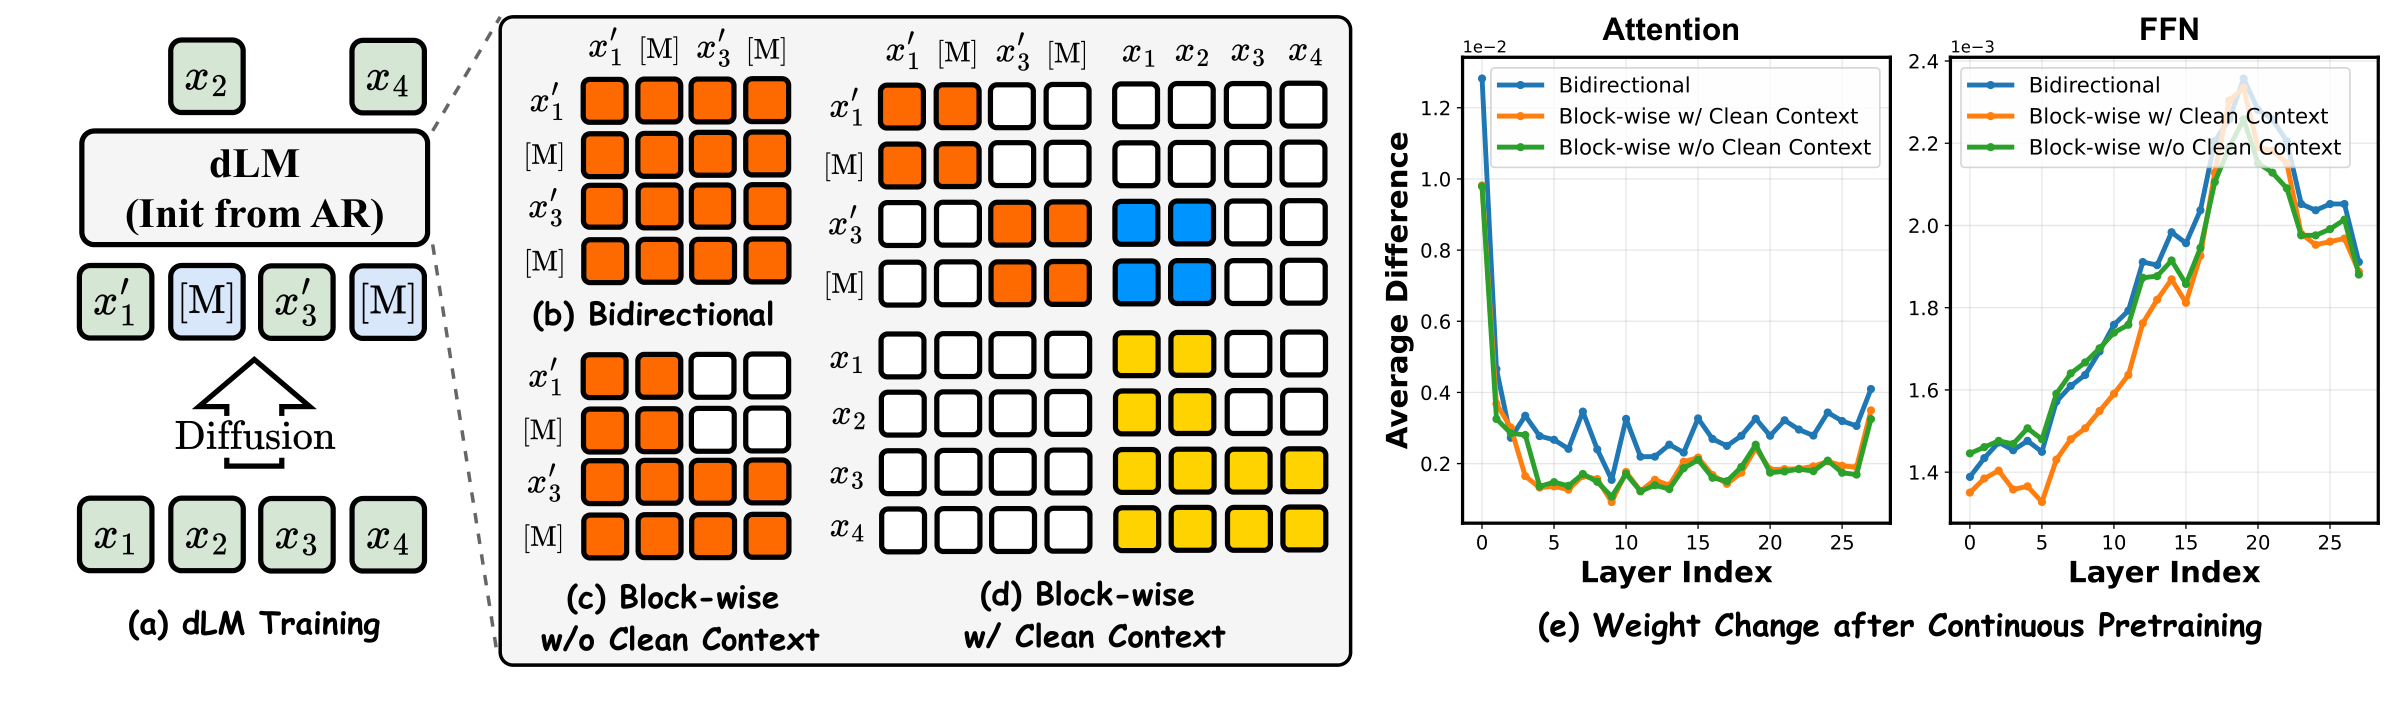
原图 Fig. 2,PDF p. 3。左侧 (a) 表示 AR 初始化后的遮罩去噪训练;(b)–(d) 的矩阵按“行是 query、列是 key”阅读。橙色表示噪声 token 间的可见关系,蓝色表示读取干净前文,黄色表示干净分支自身的注意力。右侧 (e) 横轴为层号,纵轴为平均权重差异,attention 与 FFN 使用不同纵轴量级。
| 模式 | 当前块能读取什么 | 主要影响 |
|---|---|---|
| 全双向 | 整个受污染序列 | 改变完整序列的因果结构,精确复用 KV 较困难 |
| 分块,但前文也被污染 | 当前块与较早的受污染块 | 保留块间因果,但训练前文仍有 [MASK] |
| 分块,条件为干净前文 | 当前受污染块与较早的干净块 | 同时支持块内双向、块间缓存和无遮罩前文 |
第三种模式通过拼接 noisy tokens 与 clean tokens 实现。关键不是让模型任意读取后半段干净答案,而是限制可见边:去噪第 $b$ 块时,只能读取干净分支的第 $1,\ldots,b-1$ 块,不能读取当前块的干净副本或未来块。干净分支也不读取噪声分支,避免答案通过间接路径泄漏。
教学例子:把 [A B | C D | E F] 分为三个块。若第二块的噪声输入是 [C MASK],该块可以使用干净的 [A B] 以及块内的 C,但不能使用干净副本里的 D 或未来块 [E F]。恢复第三块时,则以干净的 [A B C D] 为前文。训练可借助掩码并行处理这些任务,不必真的顺序跑三次。
推理中的 clean context 指已经没有遮罩的生成前文;其内容仍可能预测错误。它与训练时使用的真实前文具有相同的遮罩状态,但并不等同于“推理前文必然正确”。由于后续块不能反向影响之前块的表示,已经完成的前文适合缓存。(Sec. 2.1,PDF pp. 2–3)
2.3 去噪目标:保持前文,学习恢复当前块
原文 Eq. (1) 为:
其中 $q$ 是遮罩污染过程,$p_\theta$ 表示在当前噪声块与干净前文条件下恢复该块的模型预测。$1/t$ 对不同噪声水平的损失进行加权;低噪声输入中被遮罩的位置较少,权重相应较大。公式用块级条件概率简写去噪任务,理解时应关注需要恢复的遮罩位置,而不是把模型当成额外逐 token 展开的 AR 解码器。
与之比较,原 AR 目标为:
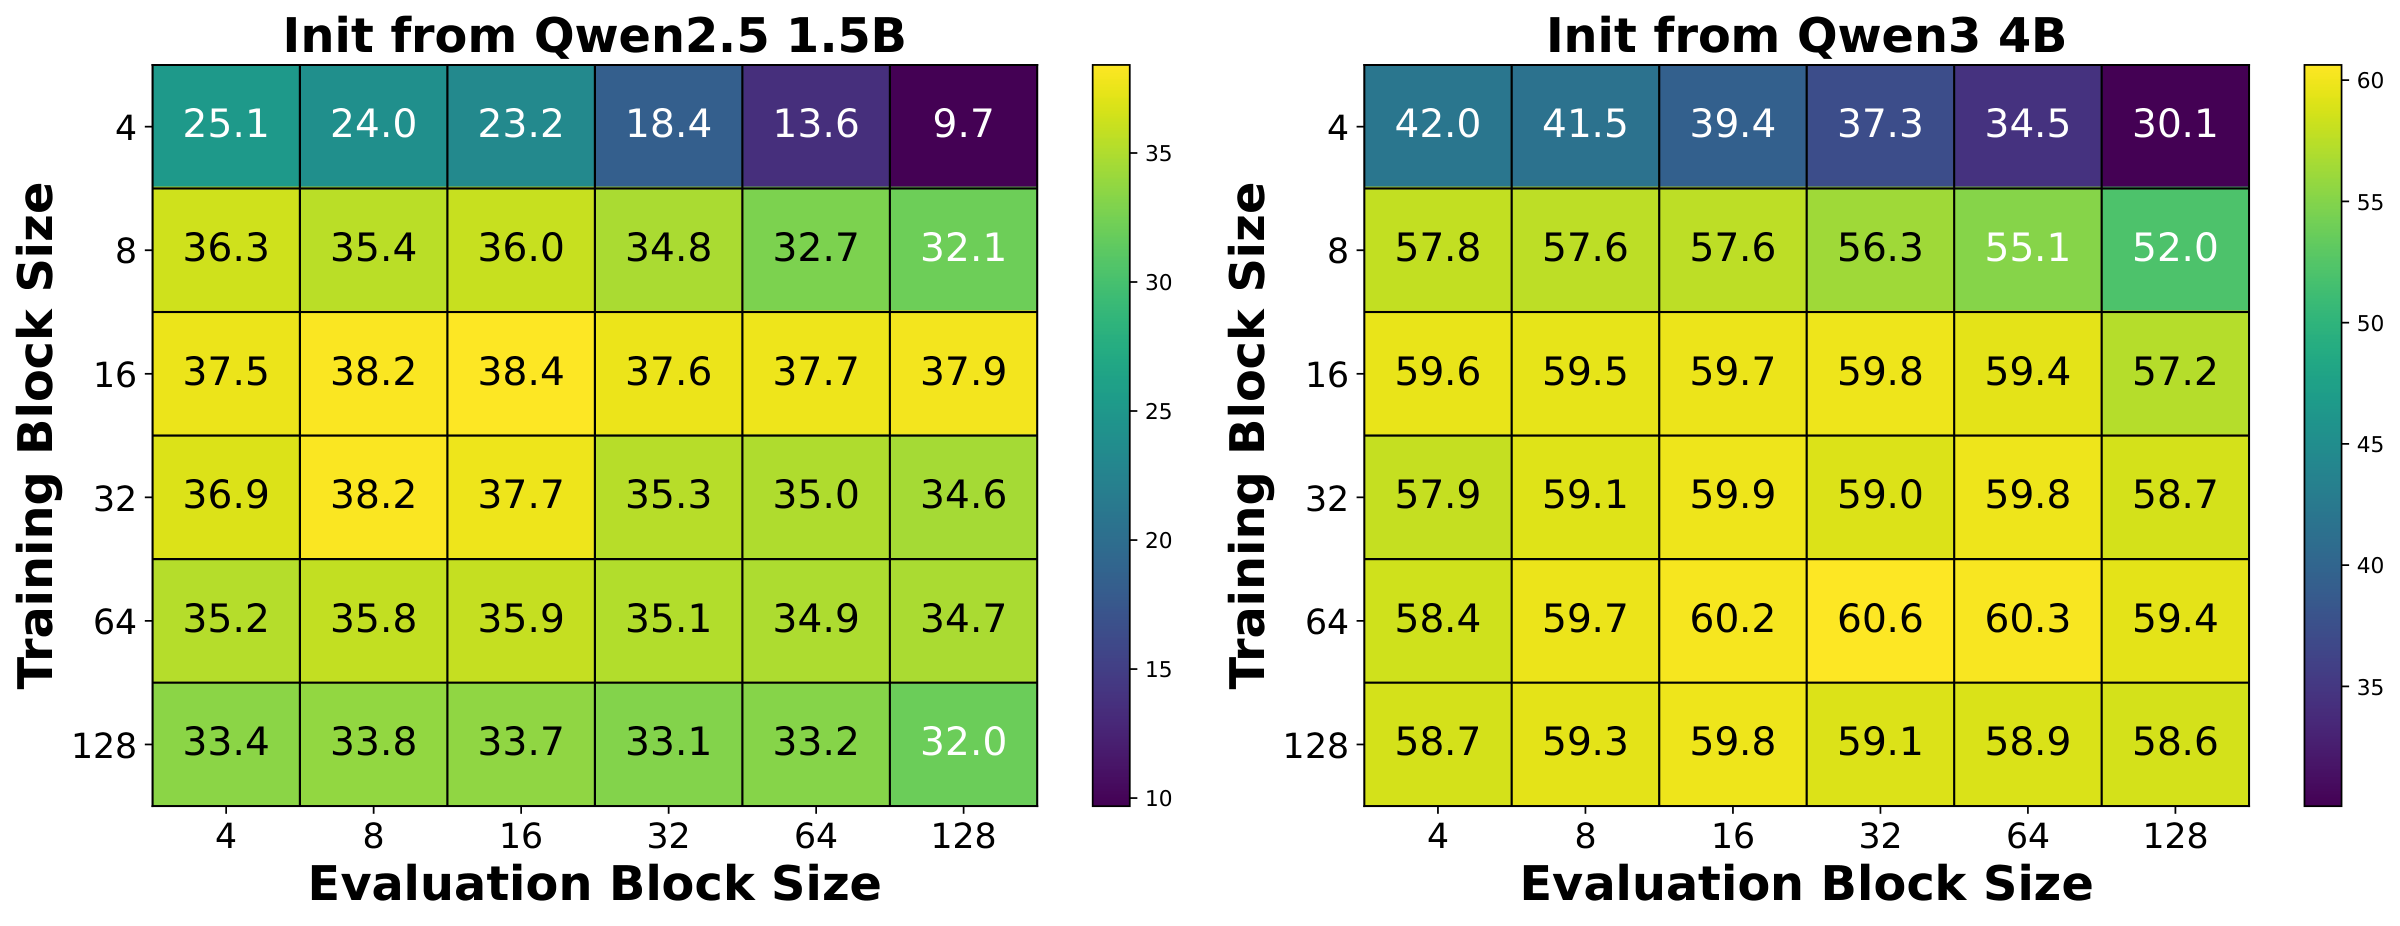
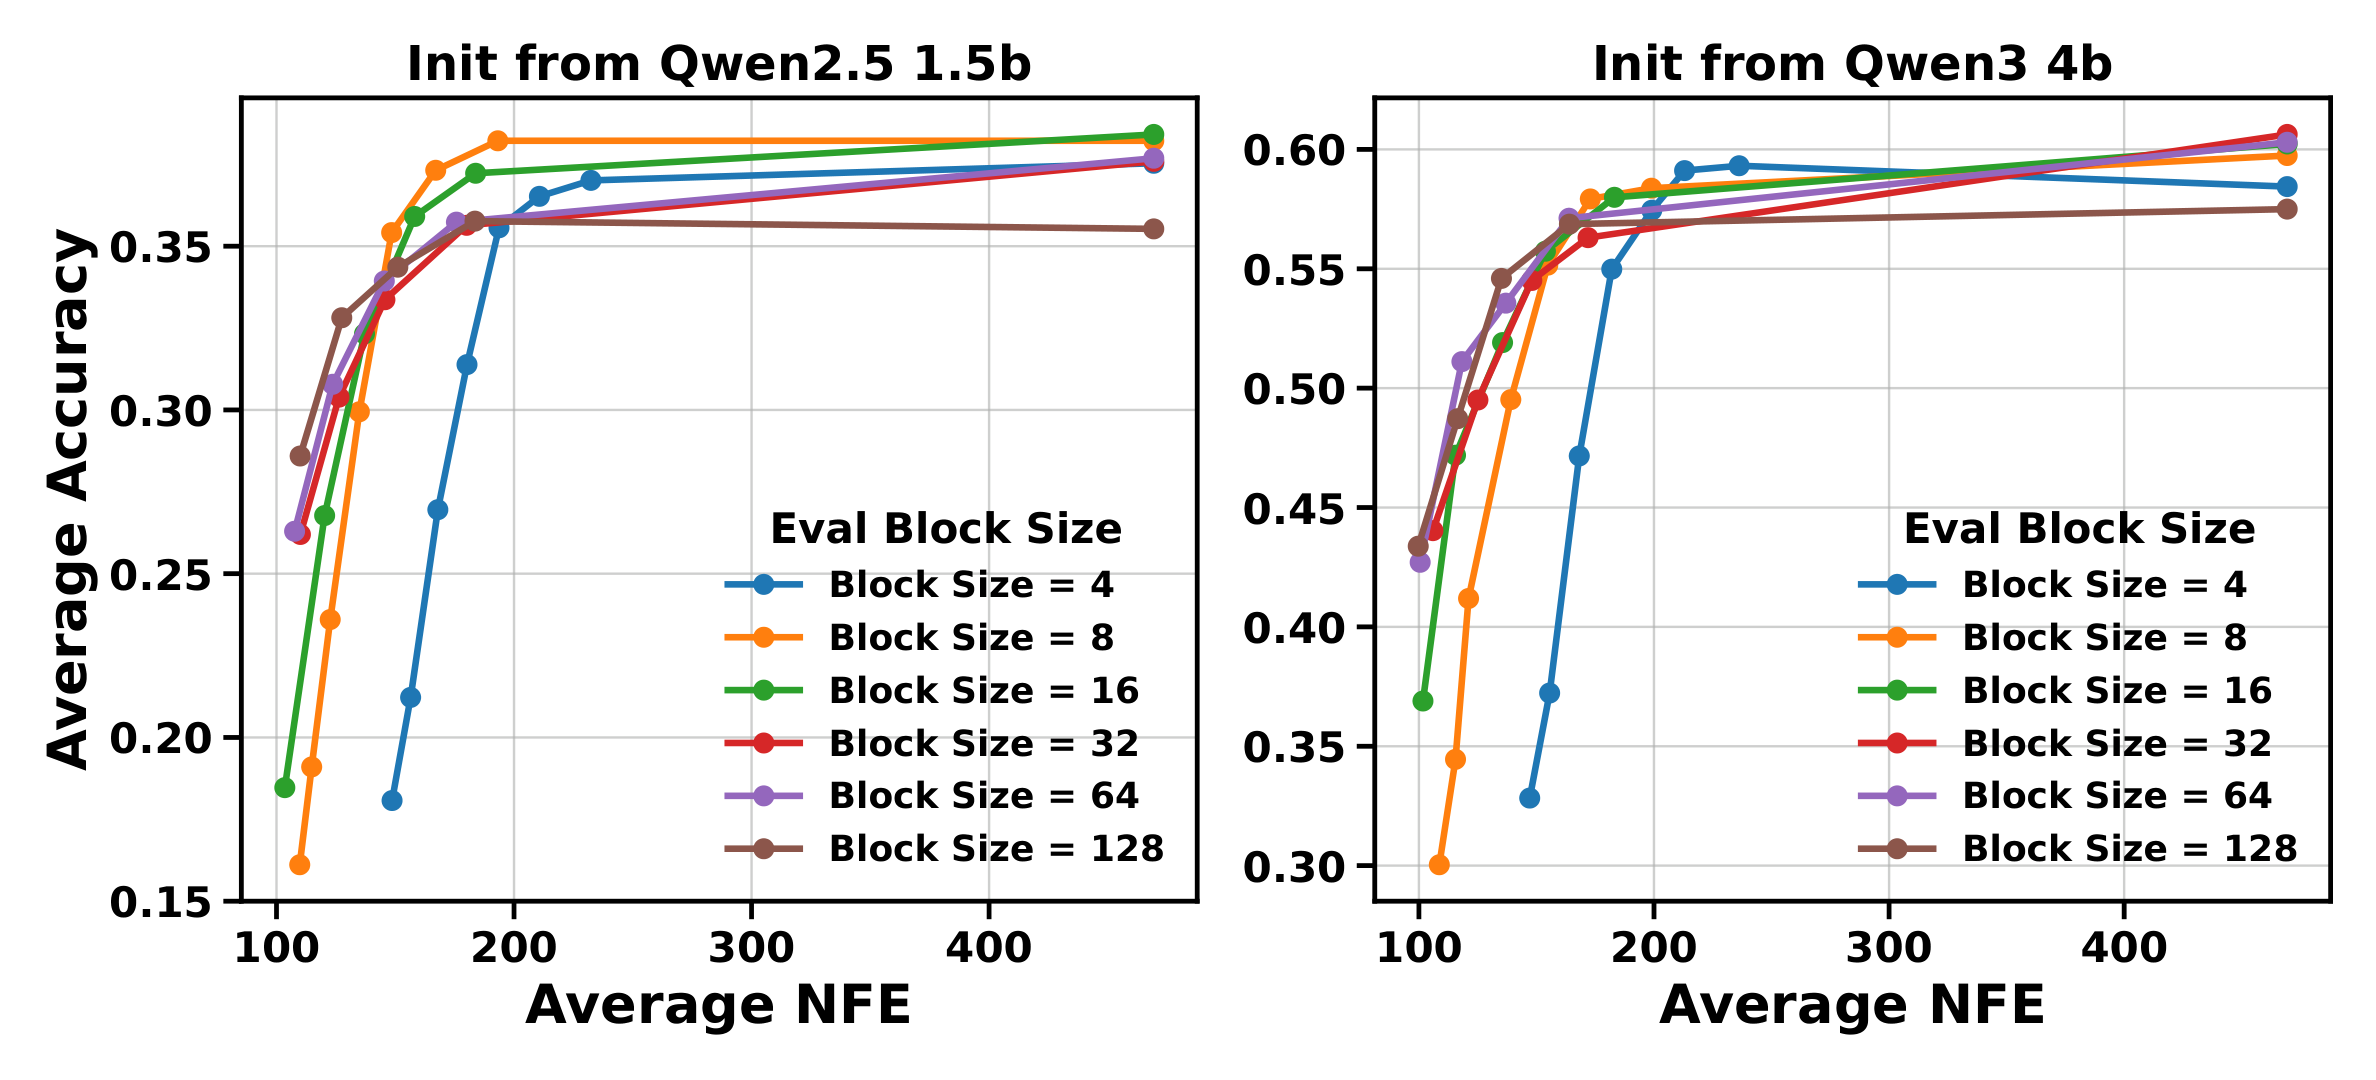
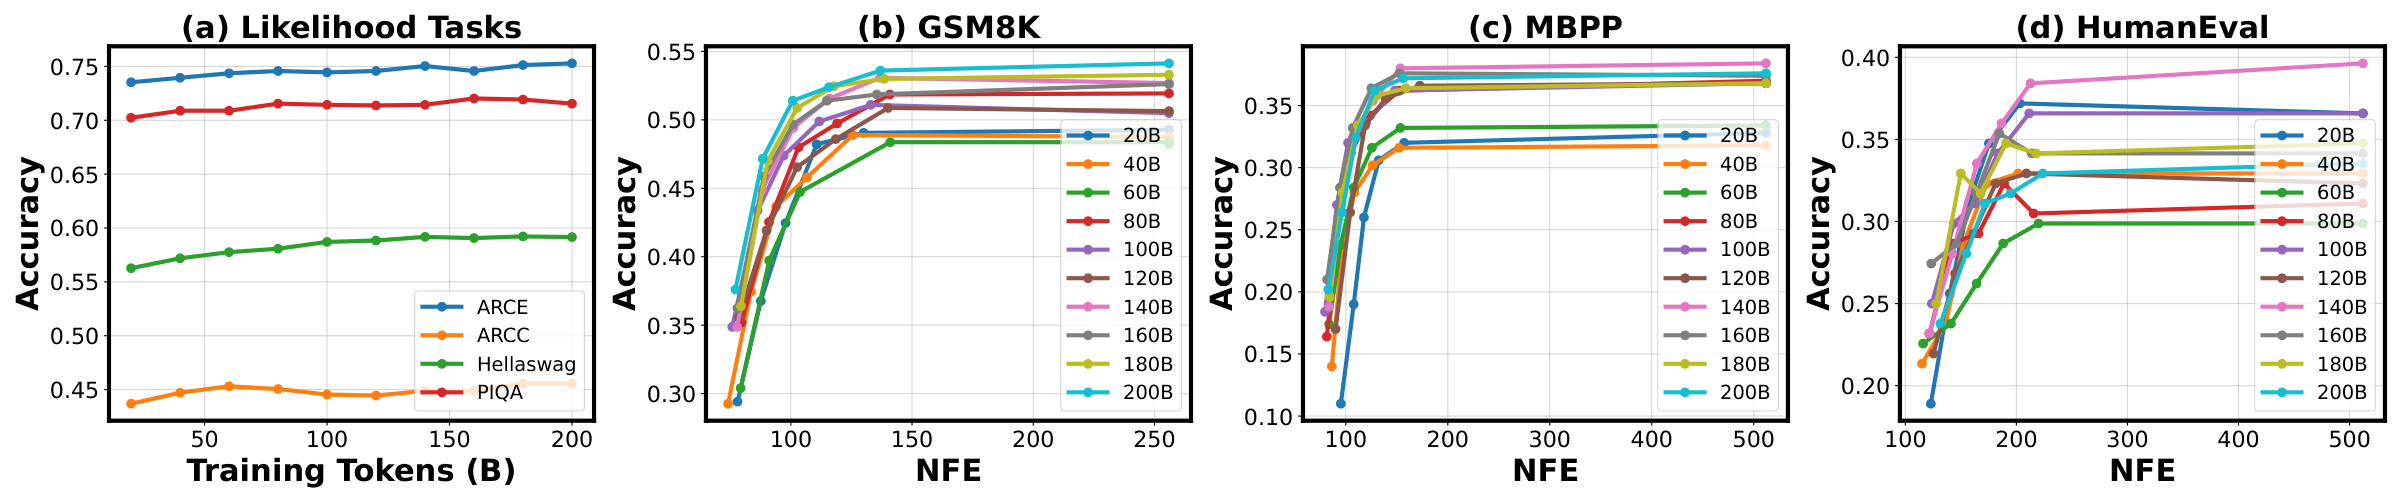
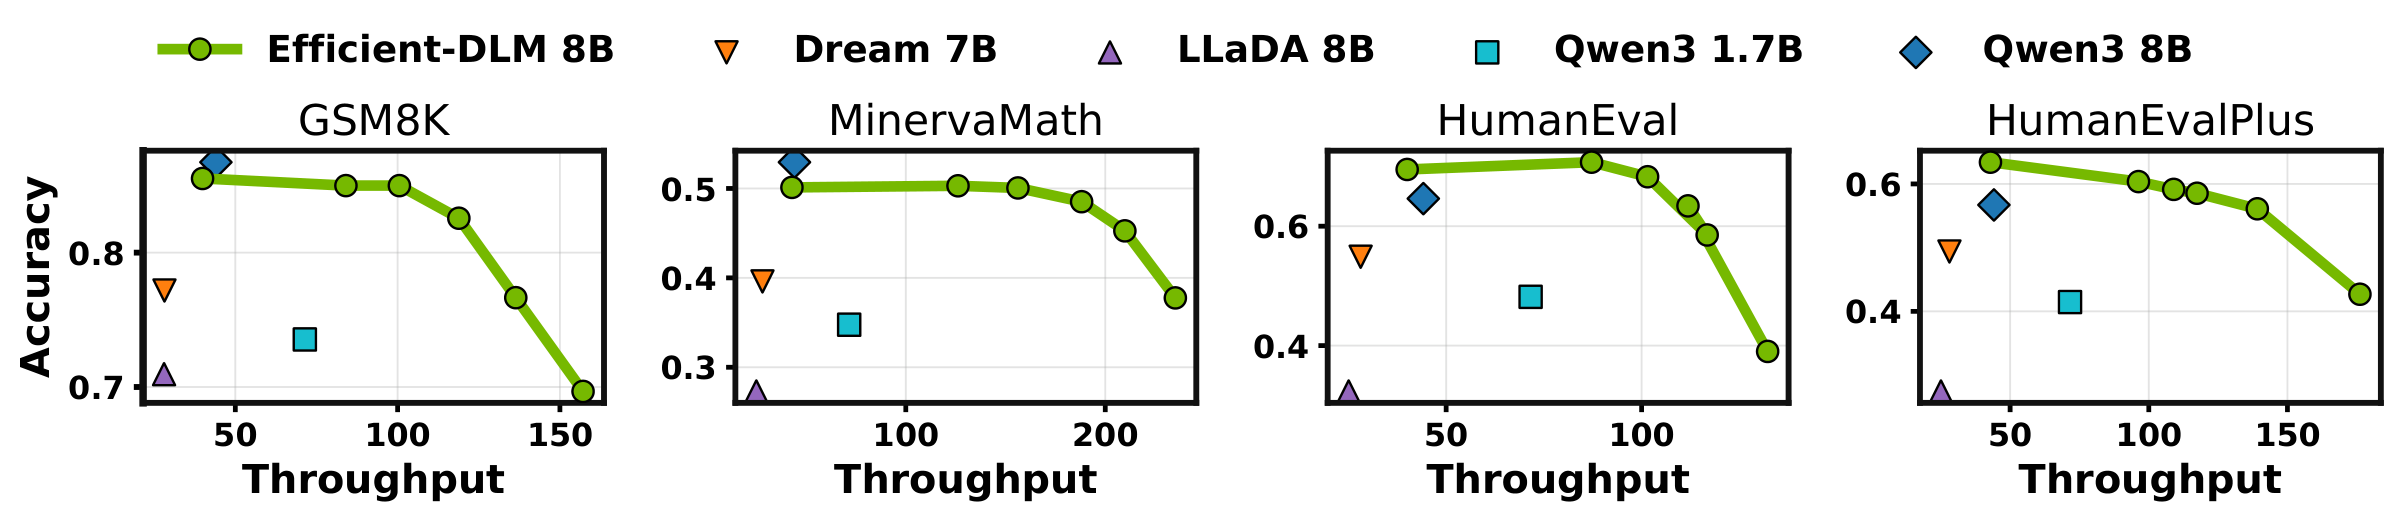
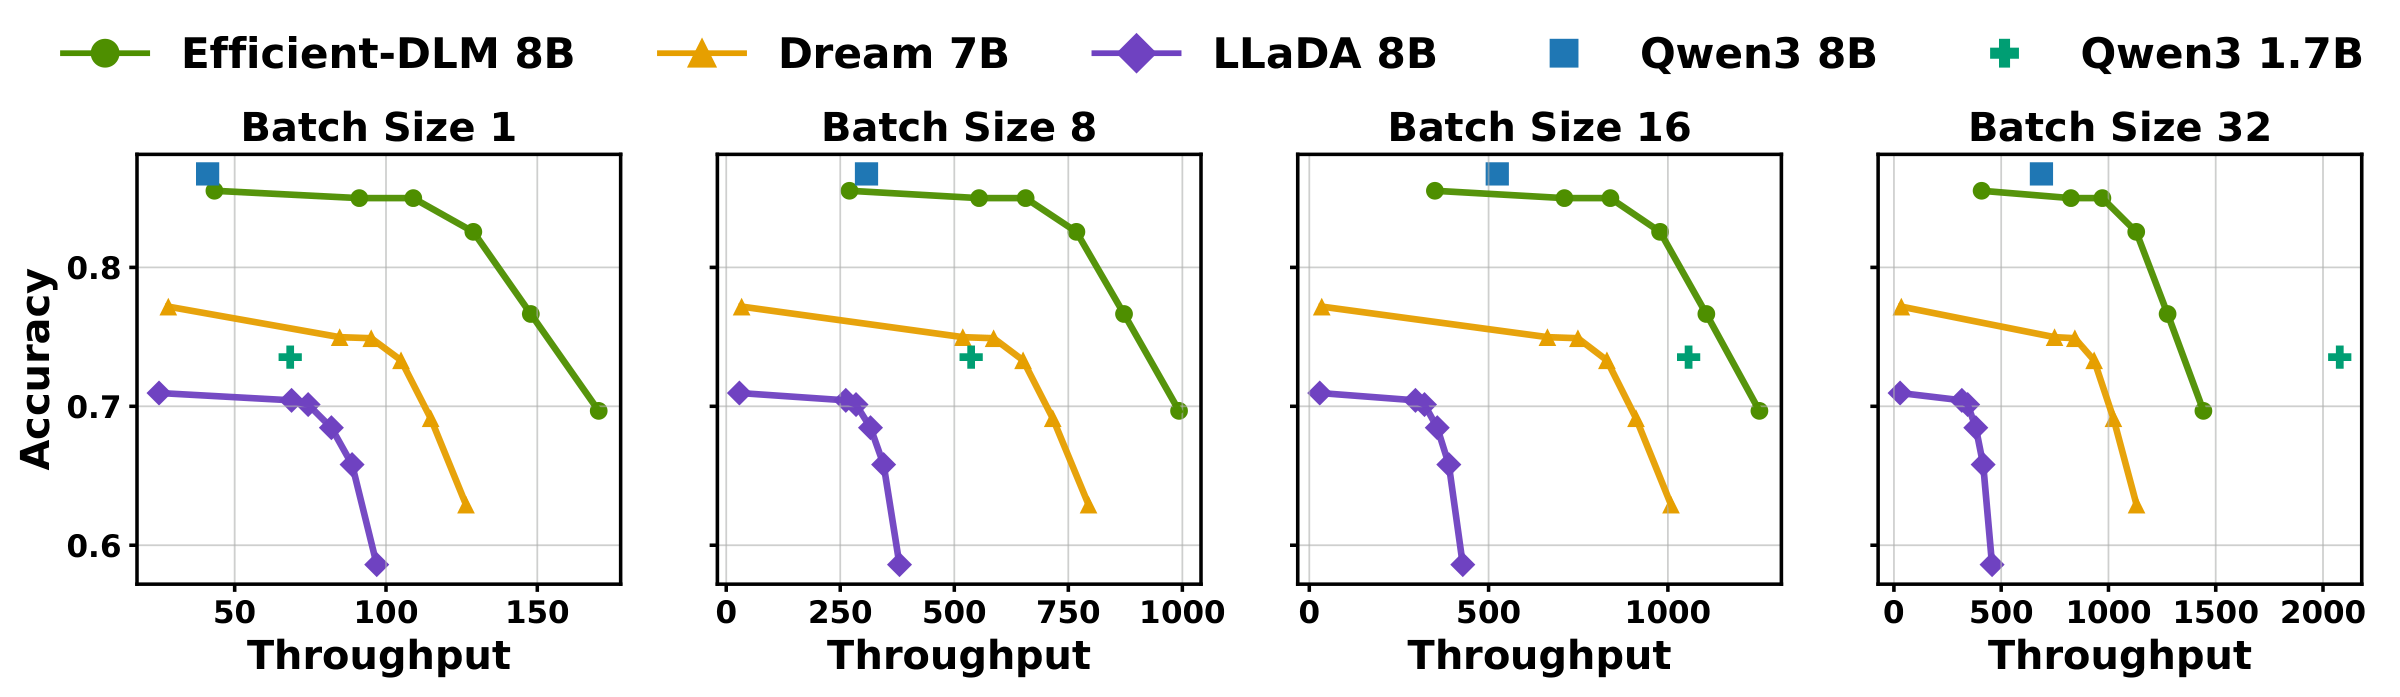
转换保留了“依赖前文”的结构,又允许利用当前块内部的右侧可见信息。若把 Eq. (1) 中的 $\mathbf{x}^{ AR 训练的 token shift 是用位置 $i$ 的输出预测位置 $i+1$。一些 AR→dLM 方法延续这种对齐方式,以贴近初始化模型。Efficient-DLM 则直接用遮罩位置的输出恢复该位置的 token。 论文在两类注意力设置中都观察到,去掉 shift 后平均准确率略有提升。作者解释是,预测遮罩位置本身比在被遮罩的位置上继续预测下一个 token 更直接,后者可能同时要求推断当前缺失内容及其后继。这个解释与消融结果一致,但实验主要证明的是此处的设计选择有效。(Sec. 2.2,PDF pp. 3–4,Table 1) 传统训练在给定噪声水平后,通常不区分 token 位置;而推理会根据预测置信度,优先接受比较确定的 token。论文在 GSM8K 上发现,块内靠前的位置平均更早完成,靠后的位置需要更多去噪步。因此,去噪接近结束时,剩余 原图 Fig. 6,PDF p. 6。面板 (a) 横轴为块内位置,纵轴为该位置被确定所需的平均步数;“None”表示每步只确定一个 token,0.9 表示置信度阈值。面板 (b) 给出单个样本随去噪步变化的置信度,红框标出被确定的位置。面板 (c) 是位置平均损失,统计 200 个样本的各块:块尾损失更高。三者共同说明,训练应让模型更常遇到“前面已恢复、后面仍缺失”的状态,同时保留其他遮罩形态。 这一倾向并不要求推理严格按从左到右的顺序执行;同一轮仍可接受多个不相邻的位置。论文利用的是统计上的位置偏好。(Sec. 3.1,PDF pp. 5–6) 原文 Eq. (2) 定义块内位置 $i\in\{1,\ldots,L'\}$ 的权重: 先归一化这些权重,再用 Gumbel-top-$k$ 无放回采样选取遮罩位置,其中 需要区分采样权重与每个位置最终被遮罩的概率。$w_i(t)$ 可以大于 1,因此不是直接使用的伯努利概率;固定选择 $k$ 个位置后,各位置的入选事件也不是独立的。当 $k>1$ 时,归一化后的 $w_i$ 同样不能直接视为边际入选概率。 它有两个直观极限:$t\to1$ 时,$(1-t)$ 接近 0,位置权重接近相同;$t\to0$ 时,噪声少、位置偏置强,更倾向把剩余遮罩放在块后部。$\beta=0$ 恢复均匀位置采样。 作者用半衰长度比例参数化偏置: 这里的含义是,在最大位置偏置 $t\to0$ 时,沿块移动 $\lambda L'$ 个位置,权重改变两倍。$\lambda$ 越小,偏置越强。最终模型使用 $\lambda=0.1$;训练块长 64 时,对应约 6.4 个位置的两倍权重尺度。 由公式可直接得到以下教学推导: 例如 $L'=16,\lambda=0.25,t=0.5$ 时,整块选 8 个遮罩位置,相隔 8 个位置的权重比为 2。这个例子描述采样偏好,并不表示后一个位置的实际遮罩概率严格为前一个的两倍。 为理解 Gumbel-top-$k$,可把选择过程等价地写成“为每个位置加入独立 Gumbel 噪声 $g_i$,选取 $\log w_i(t)+g_i$ 最大的 $k$ 个位置”。随机性保留了多样化双向上下文;极端 $\lambda\to0$ 则趋向总是遮住最右侧 $k$ 个 token,论文发现这种极端方案效果很差。(Sec. 3.2–3.3,PDF pp. 6–7,Eq. (2),Table 2) 每轮模型对当前块中的遮罩位置产生预测,根据置信度阈值确定本轮接受哪些 token。阈值较高时,一轮接受的数量通常较少;阈值降低时,并行程度提高,但误接受风险增加。完成当前块后,再生成下一块。 论文使用三个相关但不同的效率量: 固定输出长度、忽略额外开销时,可用“输出 token 数/NFE”理解 TPF。但更大的块会改变每次前向成本,缓存更新与其他开销也会影响时间,因此不能用 NFE 减少倍数直接代替实测提速倍数。(Sec. 2.3,PDF p. 5;Appendix A,p. 13) 最终模型配置如下。B 在模型大小处表示十亿参数,在训练预算处表示十亿 tokens。 三者使用干净前文、无 token shift、$\lambda=0.1$。最终训练使用 128 张 H100、AdamW 和初始学习率 $10^{-5}$ 的余弦衰减。较早的注意力消融明确给出衰减至 $3\times10^{-6}$;最终模型段落没有重新给出终止学习率。训练数据混合引用 Nemotron Nano 相关数据、MegaMath,以及数学与代码预训练数据重写工作,未给出足以独立重建混合分布的完整比例。 论文中“约 10B 量级 tokens 可大幅恢复能力”来自训练动态的观察,不能当作最终发布规模模型的训练成本。最终模型实际追加了 300B–500B tokens。(Sec. 2.2–4,PDF pp. 3–8;Sec. 5,p. 8;Appendix A,p. 13) 六个生成任务覆盖四个代码基准 HumanEval、HumanEval Plus、MBPP、MBPP Plus,以及两个数学基准 GSM8K、Minerva Math。完整基准另外加入 MMLU 和 ARC-E、ARC-C、HellaSwag、PIQA、WinoGrande,共 12 项。 生成任务考察答案或代码通过评测的比例,分数越高越好。似然类选择任务则通过候选项的模型似然估计进行选择。主表的总平均按 12 个任务等权汇总,等价于对四个类别按任务数加权: 主表的 TPF 和 TPS 却是六个生成任务上的平均。因而改变并行阈值时,数学和代码分数会变,MMLU 与常识类分数在表内保持不变;12 任务总平均会弱化生成子集的精度变化。比较解码算法时,应同时看生成任务曲线。 AR 对手包括 Qwen、Llama、SmolLM 系列,既用于同规模能力保留比较,也用于不同模型大小的吞吐—准确率比较。LLaDA 8B 和 Dream 7B 是扩散对手;主表给出的两者均为 TPF=1,附录 C 另比较启用 Fast-dLLM 缓存与并行解码的版本。 主基准吞吐量使用单张 NVIDIA H100、batch size 1。附录 A 给出 GSM8K 8-shot、Minerva Math 4-shot、HumanEval/Plus 0-shot、MBPP/Plus 3-shot;生成长度上限一般为 512,GSM8K 为 256。AR 基准用 lm-evaluation-harness,LLaDA 与 Dream 用官方评测代码。(Sec. 5.1,PDF p. 8;Appendix A,p. 13) 下表保留 Table 1 的配置和六个生成任务平均准确率。除行 e 外,转换实验使用 Qwen2.5 1.5B、50B tokens。 分块结构有明显优势。 固定保留 shift,b→d 从 18.10 升至 28.23,提高 10.13 个百分点。原文还比较 c→d,得到 8.94 个百分点,但这两行同时改变了注意力与 shift,不能完全归因于一个因素。完整方案 g 相对全双向无 shift 的 c 提高 19.12 个百分点。 干净前文是决定性组件。 d→f 仅加入干净前文,提升 9.46 个百分点。由于拼接 noisy/clean 两份输入会增加训练序列长度,作者还给噪声前文方案两倍 token 预算作为对照;e 的 27.73 仍明显低于 f 的 37.69,说明简单延长噪声前文训练无法替代正确的条件结构。这是预算补偿实验,不宜进一步解释成所有算子和墙钟时间都严格相等。 去掉 shift 的收益较小但一致。 b→c 提高 1.19 个百分点,f→g 提高 0.72 个百分点。最终 g 仍比该实验中原始 AR 的 41.79 低 3.38 个百分点,因此这组 50B 消融展示的是能力保留明显改善,尚未完全恢复基线水平。Table 1 与最终主表的评测数值应分别引用,不跨表替换基线。(Sec. 2.2,PDF pp. 3–4,Table 1) Fig. 2(e) 提供机制线索:全双向转换通常伴随更大的 attention 权重变化,而不使用干净前文的分块方案在 FFN 中也有更明显的偏移。这支持作者“兼顾新结构适应与旧能力保留”的解释。图中的纵轴是平均权重差异,并非直接测得的遗忘率;参数变化和准确率的关系在这里是实验关联。 原图 Fig. 3,PDF p. 4。两个热图分别对应 Qwen2.5 1.5B 和 Qwen3 4B 初始化。横轴是推理块大小,纵轴是训练块大小;每格为六个生成任务平均准确率。沿一行看跨推理块长泛化,沿一列看训练块长选择。 1.5B 的适宜训练块长约为 16,4B 可以承受更大的训练块,后续采用 64。训练块太小,模型能利用的块内双向线索较少;训练块太大,当前块中的污染更多、需要改变的注意力行为也更大。Fig. 4 中 FFN 等层的权重变化随块大小增大而总体增加,为这个取舍提供补充证据。 训练块大小不必与推理块大小相同。合适训练块长的行往往在多个推理列上保持较高分数。比如 1.5B 训练块长 16 时,图中不同推理块长的平均分约在 37.5–38.4;训练块长 4 却在大推理块下明显退化。最终 4B/8B 的训练块长为 64,主基准推理块长为 32,正是这种可迁移性的应用。 原图 Fig. 5,PDF p. 5。横轴为平均 NFE,越靠左表示调用模型越少;纵轴是六任务平均准确率,曲线颜色表示推理块长。低 NFE 区域,较大的推理块一般能提供更多可选择的高置信位置,因而有更好的准确率;较高 NFE 区域,中等块长的结果接近,没有一个块长始终占优。该图比较调用次数,实际吞吐还需考虑每次前向成本。(Sec. 2.3,PDF pp. 4–5,Figs. 3–5) 下表来自 Qwen3 4B、25B tokens、训练块长 64 的 Table 2,数字为六个生成任务平均准确率。 在这组测试中,$\lambda=0.1$ 最好。相对均匀遮罩,它在四个并行设置下分别提高 1.75、1.67、2.64、4.38 个百分点。较激进并行时收益更大,但 TPF=5.6 的绝对平均分仍只有 38.37,不能只看提升幅度忽略精度代价。 偏置强度与结果并非单调关系:$\lambda$ 从 0.25 降到 0.1 有利,再降到 0.05 已回落;极端只遮右端尤其差。作者的解释是,过强偏置削弱了多样化双向上下文的训练,模型被迫反复处理特定的困难后缀。更合理的理解是:训练分布应向实际推理状态倾斜,同时保留足够的上下文形态。(Sec. 3.3,PDF pp. 6–7,Table 2,Fig. 7) 原图 Fig. 8,PDF p. 7。面板 (a) 横轴为训练 token 数,纵轴是不同似然任务准确率;(b)–(d) 横轴为 NFE、纵轴为任务准确率,颜色表示 20B–200B 的训练 checkpoint。每条曲线最右侧接近逐 token 去噪,向左则并行更激进。 作者观察到,转换早期即可恢复相当一部分能力,而继续训练的价值还体现在低 NFE 区域:模型更能在少量前向中完成可靠生成。论文将其解释为更好的似然估计带来更可靠的置信度判断,进而改善基于置信度的并行采样。 曲线也显示,不能把“训练越久”理解成每个任务、每个工作点都单调上涨;例如 HumanEval 在不同 checkpoint 间存在明显波动。论文比较有力的结论是,评估 dLM 时应看整条准确率—计算量曲线,仅看 TPF=1 的任务分数会遗漏并行能力这一维度。(Sec. 4,PDF pp. 7–8) 以下摘取 Table 3 的核心结果。准确率为 12 任务平均,TPS 与 TPF 为六个生成任务平均;硬件是单张 H100,batch size 1。 与原始同规模 8B 比较:TPF=1 时平均准确率为 71.62,相对 Qwen3 8B 的 71.58 高 0.04 个百分点,但速度是 39.99 对 42.51 token/s,略慢。TPF=3.27 时达到 130.71 token/s,按表计算为原 AR 的 3.07 倍,准确率则低 0.93 个百分点。这体现的是一条有用的速度—质量曲线。 与较小的 AR 模型比较:同一个 8B 快速工作点相对 Qwen3 4B 有 2.77 倍吞吐量和 2.68 个百分点优势。8B 使用更多参数,却能在该小 batch 条件下同时更快、更准,是论文部署价值的重要例证。 与主表中的 Dream 7B 比较:准确率提高 5.35 个百分点。这里原文存在一处数值不一致:Sec. 5.1 写吞吐为 4.50 倍,但 Table 3 的 $130.71/28.11$ 为 4.65 倍。此外,附录 Table 6 把 Qwen3 4B 吞吐列为 44.99,而主表为 47.13。本文上述所有倍率统一由 Table 3 计算,不混用主表与附录的不同吞吐值。 1.5B 的能力保留相对弱一些:Qwen2.5 1.5B 为 54.47 分、73.03 token/s;Efficient-DLM 1.5B 在 TPF=2.33 时为 52.04 分、158.89 token/s,即约 2.18 倍吞吐量但低 2.43 个百分点。论文并未在所有规模上都达到无损转换。(Sec. 5.1,PDF pp. 8–9,Table 3;Appendix B,p. 14,Table 6) 原图 Fig. 9,PDF p. 9。四个面板分别为 GSM8K、Minerva Math、HumanEval 和 HumanEval Plus;横轴是吞吐量,纵轴是准确率。绿色曲线来自同一个 Efficient-DLM 8B,工作点变化通过置信度阈值实现;其他标记为比较模型。 图展示了同一组权重如何覆盖多个速度需求,无需为每个工作点重新训练模型。阈值降低至非常激进时,曲线明显下弯,说明高吞吐端有实质质量代价。部分任务的高精度端也不始终优于同规模 AR,例如 Minerva Math 中 Qwen3 8B 的点略高。因此,“更好的取舍”应按任务和可接受误差来选择,而不是把整个曲线视为无条件压过所有对手。(Sec. 5.2,PDF p. 9) 作者在 MTEB 的 15 个数据集、六类任务上做零样本评测,直接使用预训练权重,不再微调。序列表示来自最后一层所有 token 隐状态的平均池化。Qwen 使用因果掩码,Efficient-DLM 在此任务中使用全双向掩码,而非生成时的块因果掩码;作者报告直接给 Qwen 切换全双向反而会降低效果。(Sec. 5.3,PDF p. 9;Appendix A,p. 13) Table 4 的平均按六个类别得分等权汇总,与生成主表的 12 任务平均口径不同。六类分别为检索、重排序、聚类、配对分类、分类与语义相似度,内部使用各任务相应评分,不能统一称为“分类准确率”。平均分提升分别为 7.71 和 9.91 分,其中配对分类增益很大;1.5B 检索却下降 2.02 分,说明收益并不在所有类别上均匀发生。该实验支持转换后的模型更能利用双向上下文生成表示,同时比较中也包含额外预训练与注意力掩码的变化。(Table 4,PDF p. 9) Table 5 从 Qwen3 4B、25B tokens 的 Dream 式双向转换开始,逐步加入组件;数字为六个数学与代码任务平均准确率。 最大的平均提升来自结构修改。位置相关遮罩和延长训练进一步改善结果,但增益也具有任务差异:加入位置遮罩这一行中,GSM8K 从 82.87 降至 81.12,Minerva Math 从 47.02 降至 45.92,代码侧的提升使总平均上涨。该表是按顺序加入组件的实验,各增量不应理解成不依赖其他组件的固定收益。(Sec. 5.4,PDF pp. 9–10,Table 5) Fast-dLLM 加速对手。 主表中的 LLaDA/Dream 是 TPF=1。附录 C 进一步让它们使用 Fast-dLLM 的 dual cache 与并行解码,并扫描置信度阈值。Fig. 10 在 GSM8K 上仍显示 Efficient-DLM 8B 更好的准确率—吞吐取舍。这补上了“是否只是与未加速 dLM 比”的问题,但该补充图仅覆盖 GSM8K,不是另一个完整 12 任务总平均。(PDF p. 13,Fig. 10) 大 batch 是具体边界。 原图 Fig. 11,PDF p. 14,任务为 GSM8K。四个面板分别为 batch 1、8、16、32;横轴仍为吞吐,但各面板范围不同。图例中的绿色曲线为 Efficient-DLM 8B,橙色和紫色为比较 dLM,其他标记为 AR 模型。随着 batch 增大,AR 可以同时处理更多请求,其硬件利用率提高,dLM 在单个请求内并行的相对收益缩小。作者报告优势可延续到 batch 16,而 batch 32 时 Efficient-DLM 8B 的吞吐落后于 Qwen3 1.7B。这使本文最清晰的部署结论落在小 batch 场景。(Appendix C,PDF pp. 13–14) 学习率也有适宜区间。 Qwen3 4B、25B tokens 的 Table 7 中,初始学习率 $10^{-4}$、$3\times10^{-5}$、$10^{-5}$、$3\times10^{-6}$、$10^{-6}$ 对应平均准确率分别为 50.95、56.59、60.63、60.11、54.56。较大的学习率可能损害原始能力,过小则适应不足;$10^{-5}$ 是本组最佳值,$3\times10^{-6}$ 也接近。结果再次支持“保留与适应”的平衡。(Appendix D,PDF pp. 14–15,Table 7) 损失随块边界呈周期变化。 Fig. 12 比较训练序列前 256 个位置的平均损失。AR 在序列起始处损失较高,之后较平稳;分块 dLM 除序列起始效应外,还呈块内逐渐升高、到下一块重新下降的周期。这与块尾能利用的干净左上下文相对不足、Fig. 6(c) 中块尾较难的观察一致,解释了位置偏置为何是值得考虑的训练维度。(Appendix E,PDF p. 14,Fig. 12) LoRA 能做转换,但仍损失明显。 作者在 attention/FFN 的全部线性层加入低秩适配(LoRA),同时保持 embedding、normalization 和最终输出 head 可训练,其余参数冻结。Qwen2.5 1.5B 的 Table 8 中,rank 16 得到 27.93,rank 64 得到 30.78;完整方案全参数训练为 38.41。rank 64 超过全双向全参转换及无干净前文的分块对照,却仍比同方案全参训练低 7.63 个百分点。因此,小幅权重漂移不意味着用低秩更新就能无损完成转换。(Appendix F,PDF pp. 14–15,Table 8) Efficient-DLM 给出的核心认识是:AR→dLM 转换的效率,取决于训练条件与最终解码过程是否协调。 跨块因果结构保留可缓存的前文;干净前文让训练更接近逐块推理;块内双向注意力提供并行恢复空间;位置相关遮罩让模型更多学习实际推理晚期会遇到的残余遮罩状态。继续训练则进一步改善置信度解码可达到的速度—准确率曲线。 从实践优先级看,实验支持先确定注意力和上下文条件,再选择块大小、移除 shift、调整遮罩偏置,最后考虑更大训练预算。在已报告设置里,注意力结构与干净前文带来的增益最大;位置偏置属于稳定推进取舍曲线的训练改进,其强度需要验证。 本文最终训练用了 300B–500B tokens,且缺少相同数据和预算下继续训练 AR 模型的直接对照,因此最终跨模型分数不能全部归因于扩散机制。其最直接的证据来自同预算的组件消融,以及固定一个转换模型后扫描解码阈值的性能曲线。实际部署还应把 batch、可接受的生成任务误差和模型大小一起纳入判断;12 任务总平均本身不足以决定阈值。 有针对性的后续问题是:能否按层或按样本调节块大小与遮罩偏置,改善当前固定配置的取舍;能否在大 batch 下保持并行收益;能否找到比现有 LoRA 更适合这种结构转换的参数更新方式。论文已经给出这些问题的实验起点,但尚未给出对应解决方案。2.4 去掉 token shift:在被遮罩的位置预测它自己
2.5 第二个训练—推理差异:剩余遮罩并非均匀分布
[MASK] 更可能集中在块尾。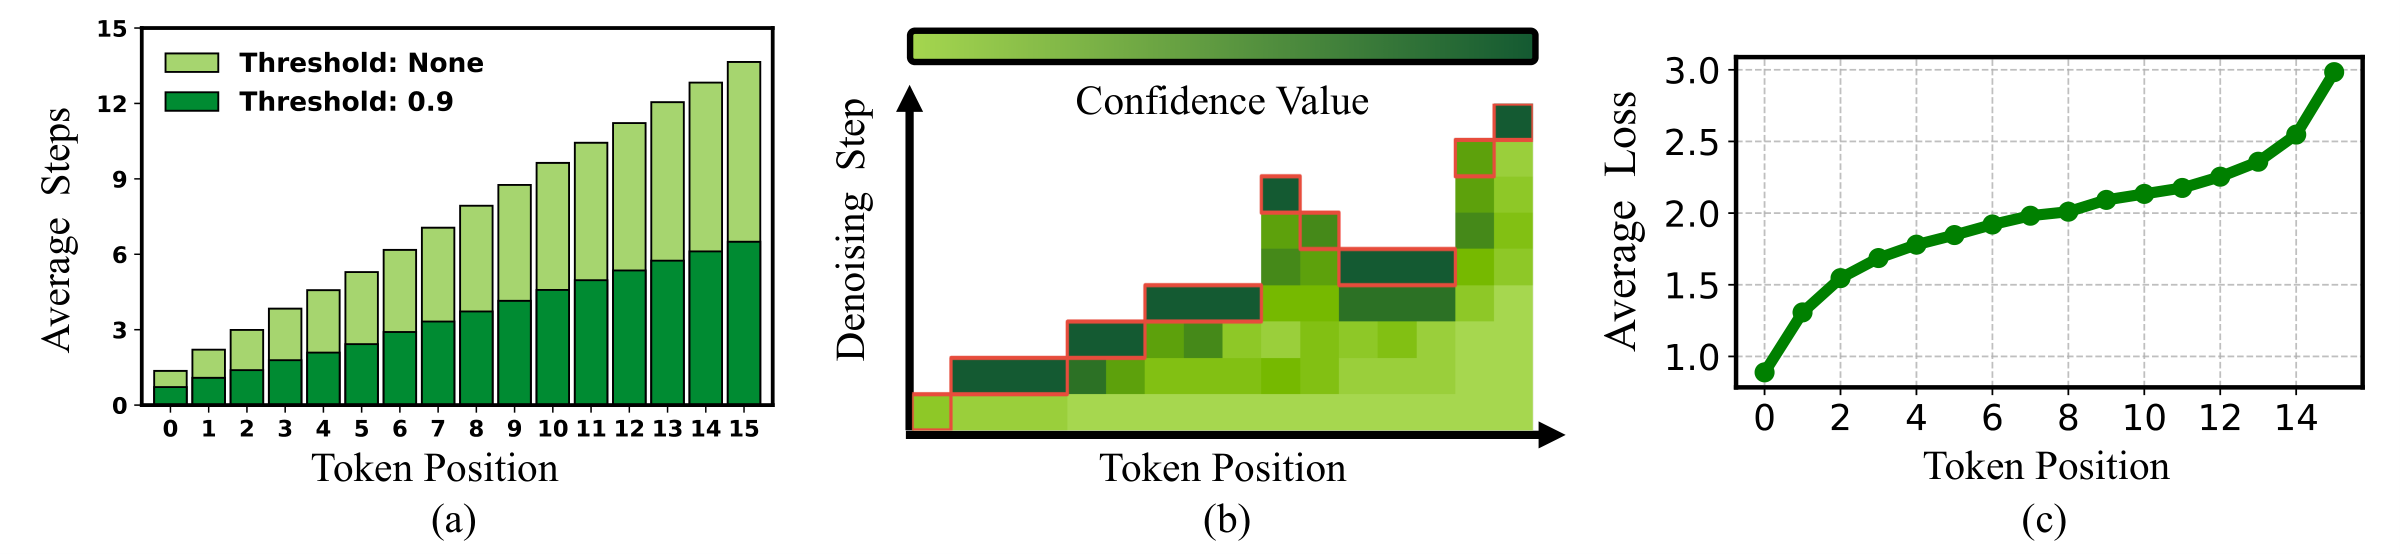
2.6 位置相关遮罩:改变选哪些位置,保持遮罩数量
2.7 推理:置信度阈值控制准确率—速度工作点
指标 定义与阅读方式 NFE(number of function evaluations) 去噪所需的模型调用次数;在相近生成长度下越少,通常表示越激进的并行 TPF(tokens per forward) 每次前向平均确定多少个 token;越高表示解码并行度越大 TPS(tokens per second) 实测每秒生成 token 数,直接反映报告硬件和 batch 下的吞吐量 三:实验——哪些比较回答哪些问题
3.1 训练预算与最终模型配置
实验 初始化与预算 主要控制因素 注意力模式比较 Qwen2.5 1.5B,50B tokens 块长 16;前文是否干净;是否 shift;另有噪声前文 100B 对照 训练/推理块大小 Qwen2.5 1.5B 训练 50B;Qwen3 4B 训练 25B 训练块长 4、8、16、32、64、128,再跨块长评测 遮罩策略比较 Qwen3 4B,25B tokens 训练块长 64;改变 $\lambda$ 与解码 TPF 训练动态 Qwen2.5 1.5B,训练至 200B tokens 比较不同 checkpoint 的准确率—NFE 曲线 最终模型 Qwen2.5 1.5B/Qwen3 4B/Qwen3 8B 完整训练方案与更长训练预算 模型 AR 初始化 继续预训练 tokens 训练块长 主基准推理块长 Efficient-DLM 1.5B Qwen2.5 1.5B 300B 16 16 Efficient-DLM 4B Qwen3 4B 300B 64 32 Efficient-DLM 8B Qwen3 8B 500B 64 32 3.2 任务、对手与统计口径
四:结果——沿论文的实验链理解证据
4.1 注意力与干净前文:大部分收益首先来自训练结构
原表行 注意力 干净前文 Token shift 平均准确率 a 原始 AR — 有 41.79 b 全双向 — 有 18.10 c 全双向 — 无 19.29 d 分块 无 有 28.23 e 分块,100B tokens 无 有 27.73 f 分块 有 有 37.69 g 分块 有 无 38.41 4.2 块大小:训练最优值与推理最优值不同
4.3 遮罩位置先验:适度偏置胜过均匀和极端偏置
遮罩策略 TPF=1 TPF=2.8 TPF=4 TPF=5.6 均匀 60.27 57.12 51.11 33.99 $\lambda=0.25$ 60.41 58.56 50.97 34.55 $\lambda=0.1$ 62.02 58.79 53.75 38.37 $\lambda=0.05$ 60.51 57.68 53.06 37.38 总是遮住最右侧 $k$ 个位置 38.21 27.55 18.60 14.13 4.4 训练动态:单步生成分数相近,并不代表并行能力相同
4.5 最终模型:准确率保留与提速要按同一工作点比较
模型 TPF TPS(token/s) 平均准确率 Qwen3 1.7B 1.00 71.59 59.39 Qwen3 4B 1.00 47.13 67.97 Qwen3 8B 1.00 42.51 71.58 LLaDA 8B 1.00 25.04 54.92 Dream 7B 1.00 28.11 65.30 Efficient-DLM 4B 1.00 44.13 67.54 Efficient-DLM 4B 2.52 119.33 67.39 Efficient-DLM 4B 3.01 130.24 67.18 Efficient-DLM 8B 1.00 39.99 71.62 Efficient-DLM 8B 2.74 109.78 70.93 Efficient-DLM 8B 3.27 130.71 70.65 4.6 同一模型的灵活性:阈值是部署时的控制量
4.7 文本嵌入:双向能力带来另一个收益,但评测掩码不同
模型 六类平均分 配对分类 检索 Qwen2.5 1.5B 29.54 24.59 20.69 Efficient-DLM 1.5B 37.25 56.76 18.67 Qwen3 4B 30.79 33.94 19.46 Efficient-DLM 4B 40.70 65.59 20.17 4.8 累积组件消融:先修结构,再修分布,最后扩大训练
累积方案 平均准确率 相对上一行变化(百分点) 双向转换基线 44.59 — +块注意力与干净前文 59.01 +14.42 +移除 token shift 60.27 +1.26 +位置相关遮罩 62.02 +1.75 +训练至 300B tokens 64.05 +2.03 4.9 附录:更强对手、大 batch、学习率与低秩适配
五:结论——这篇论文提供了怎样的可用认识
论文与模型链接