Masked Diffusion Models are Secretly Learned-Order Autoregressive Models:中文精读笔记
作者:Prateek Garg、Bhavya Kohli、Sunita Sarawagi。
论文版本:arXiv:2511.19152v1,2025-11-24 提交;EurIPS 2025 PriGM Workshop。
获取与研读日期:2026-10-14;本次研读修订 r1。
材料:arXiv 论文页 · 原文 PDF · 英文汇报 PDF · 可编辑幻灯片。以下页码均为从 1 开始的 PDF 页码。
论文总览
这篇论文研究一个具体问题:既然掩码扩散模型的训练可理解为在多种生成顺序上训练自回归模型,能否让模型在训练时就学习哪些顺序更合适? 作者为每个位置设置独立的、可学习的噪声调度,将连续时间扩散损失改写为由调度决定权重的自回归损失期望。对不显式输入时间的去噪网络,这种对应尤为直接。(Sec. 3,PDF p. 3,Proposition 3.1)
核心链条是:
实验方法称为 MDM(LS),其中 LS 表示 learned schedules。它用约 86K 参数在六个表格数据集上验证这一思路。与固定线性调度的 MDM 相比,学习调度在 4/6 个数据集上取得更低的最佳验证损失;生成数据的保真度收益则混合,尤其 β-Recall 只在 1/6 个数据集上提高。论文的主要价值是把“学习噪声调度”解释为“学习训练和生成时的顺序分布”。(Sec. 4–5,PDF pp. 4–5,Fig. 2a、Tables 1–3)
这里学到的是与样本状态无关的随机顺序分布:不同样本可以抽到不同顺序,但抽取概率不根据当前已生成的内容重新调整。标题中的“自回归”指按顺序分解的预测机制,并不限定为从左到右,也不要求网络采用标准因果 Transformer。
结构地图
| 原文章节 | 论证中的作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 无天然顺序的数据;均匀训练顺序与启发式推理顺序的差异 | pp. 1–2 |
| 2 Background | 吸收式遮罩过程、反向后验、连续时间损失 | pp. 2–3;Fig. 1,Eqs. (1)–(4) |
| 3.1 Reframing ELBO as Loss over Orders | 将损失分解为不同顺序上的自回归损失 | p. 3;Proposition 3.1,Eqs. (5)–(7) |
| 3.2 Relationship between Decoding Order and Noise Schedules | 跳变时间分布及顺序采样 | pp. 3–4;Proposition 3.2,Algorithm 1 |
| 4 Experiments / 4.1 Results | 幂函数调度、RLOO、六数据集比较 | pp. 4–5;Eq. (8),Tables 1–3,Fig. 2 |
| 5 Discussion and Future Work | 收益有限,提出训练方差解释和结构发现问题 | p. 5 |
| A Related Work | 与状态依赖顺序、值依赖噪声等工作的区别 | p. 9 |
| B Proofs | 跳变时间 CDF 和轨迹分组证明 | pp. 9–11;Eqs. (9)–(27) |
| C.1 Performance Metrics and Baseline Comparisons | 均值、标准差与结果来源 | pp. 11–12;Tables 4–7 |
| C.2 Visualisation of Learned Schedules | TabDiff 复现实验与 MDM(LS) 的调度图 | pp. 12–13;Figs. 3–5 |
一、动机:训练时为什么应该关心生成顺序?
标准自回归模型先选一个顺序,再按条件概率的乘积生成所有变量。对表格中的年龄、职业、收入等列,列号通常不是天然的因果或生成顺序;对图和图像 token 也有类似问题。给定有限模型容量,不同条件预测任务的难度可能不同,因此顺序会影响学习效果。
固定单一调度的 MDM 表面上只是在随机遮罩后恢复 token,实际训练目标却平均覆盖所有顺序。已有推理策略可以优先恢复高置信度或容易预测的位置,但训练时仍对全部顺序等权。这是作者希望缩小的训练与推理差异:如果推理时希望偏好某些顺序,训练目标是否也能把更多权重分给它们?(Sec. 1,PDF pp. 1–2)
作者的选择是让位置决定噪声调度。每一列都有一个自己的时钟,时钟相对快慢决定它在其他列之前或之后被恢复的概率。这保留了独立遮罩过程的简单形式。附录 A 将它与两种方案区分:按 token 的具体取值设计调度会使目标更复杂;按当前生成内容动态选择下一位置则是状态依赖的顺序模型。(Appendix A,PDF p. 9)
二、方法:从独立遮罩到可学习的顺序
2.1 符号与时间方向
| 符号 | 含义 |
|---|---|
| $\mathbf{x}_0^{1:L}$ | 一条完整数据,含 $L$ 个离散位置或表格列 |
| $\mathbf m$ | 特殊 mask 状态 |
| $t\in[0,1]$ | 正向噪声时间:$0$ 为干净数据,$1$ 为全遮罩端 |
| $\alpha_{t,\ell}$ | 位置 $\ell$ 在时间 $t$ 仍保留原值的概率 |
| $\mu_\ell^{x_0^\ell}(\mathbf{x}_t,t;\theta)$ | 去噪网络在位置 $\ell$ 给真实值分配的概率 |
| $T_\ell$ | 位置 $\ell$ 跳变时对应的噪声时间坐标;对应原文 $t_\ell^*$ |
| $\pi$ | 本笔记统一用作反向生成顺序,先生成 $\pi(1)$ |
| $w_\ell>0$ | 幂函数调度的可学习参数 |
最容易混淆的是时间方向:正向加噪按 $t:0\to1$ 运行,反向生成按 $t:1\to0$ 运行。因此,同一条轨迹中最后被遮住的变量,最先被恢复。
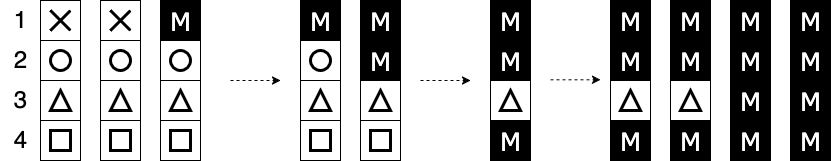
原图 Fig. 1,PDF p. 2。横向从左到右是正向加噪,黑色 M 表示 mask;四行是四个位置。沿图中状态变化,遮罩次序为 $1\to2\to4\to3$,反向恢复次序为 $3\to4\to2\to1$。图示的是一条随机轨迹,而不是固定的全局次序。
原文记号提醒。 Eq. (7) 把 $\Omega_\pi$ 写为跳变时间的升序区域,但 Eq. (5)–(6) 使用“已生成前缀 $\pi(
2.2 正向过程只做一次吸收式遮罩
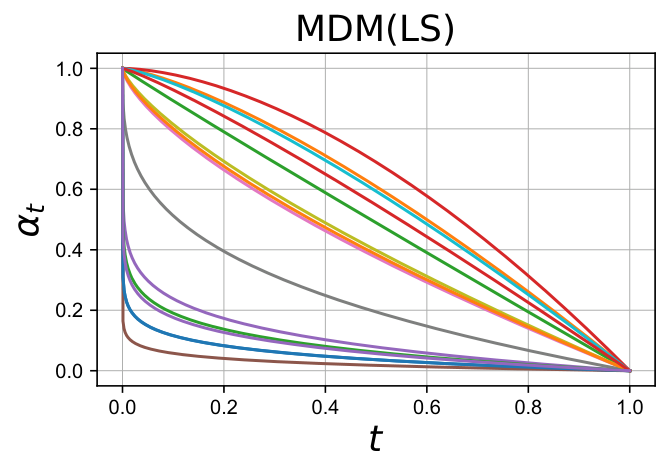
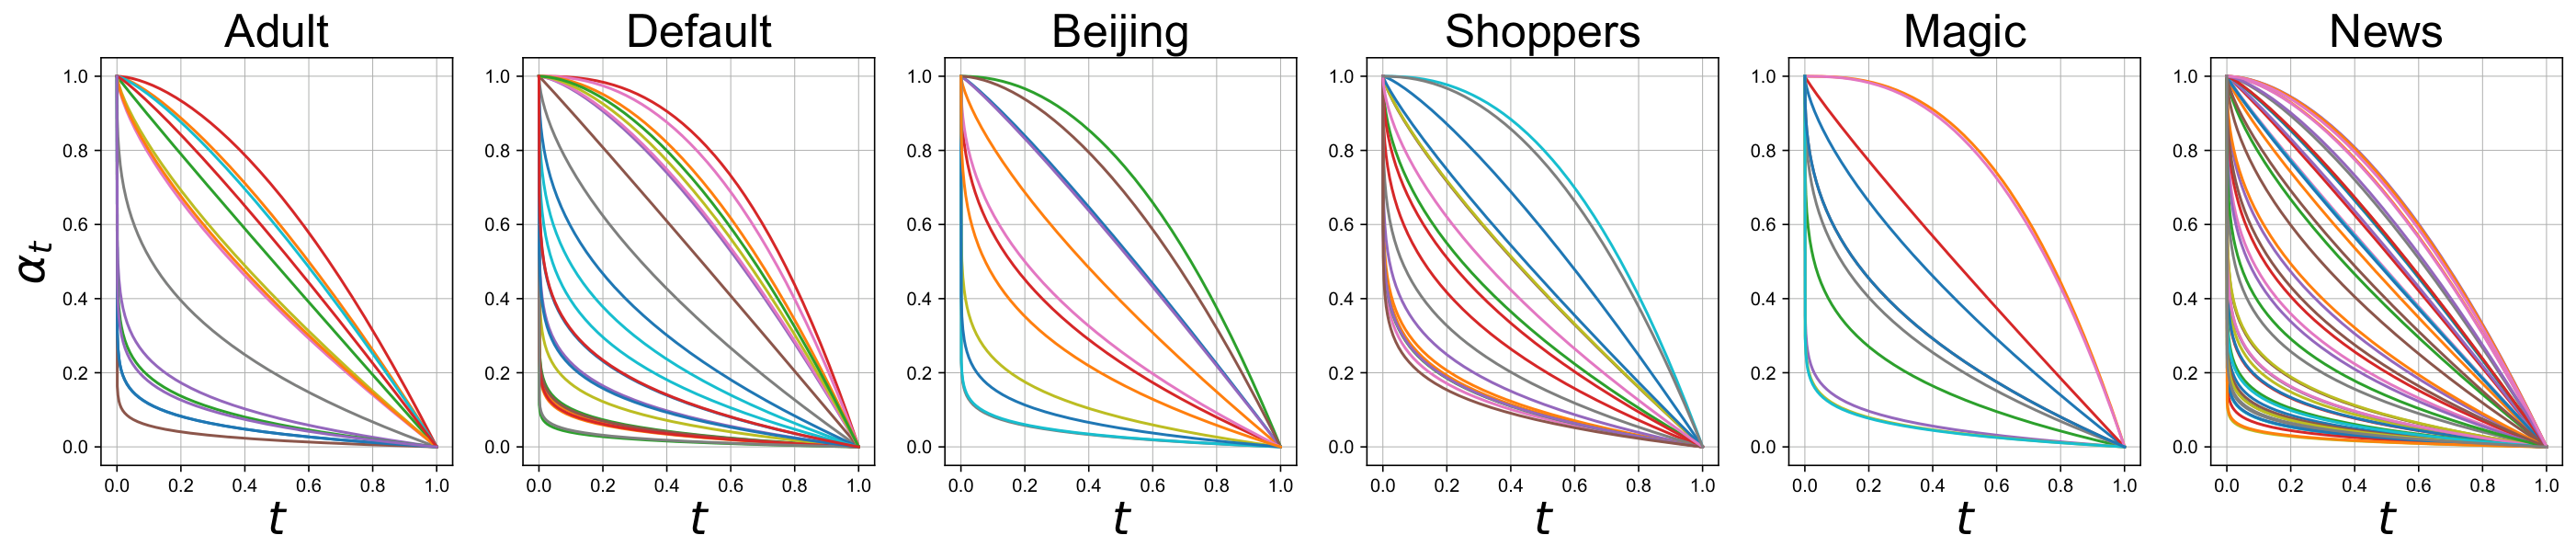
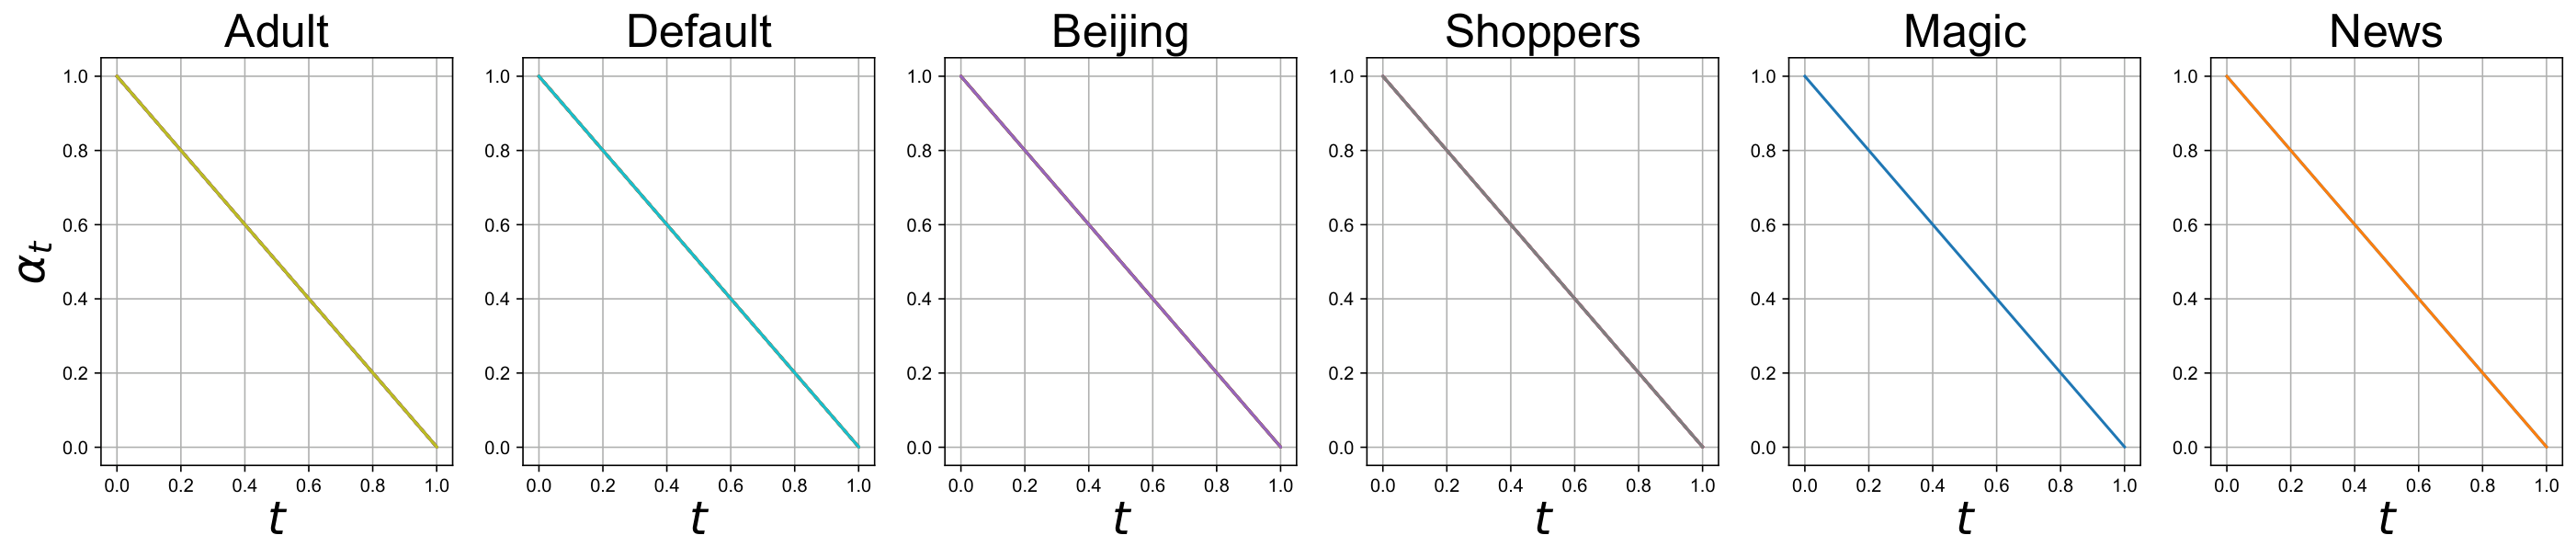
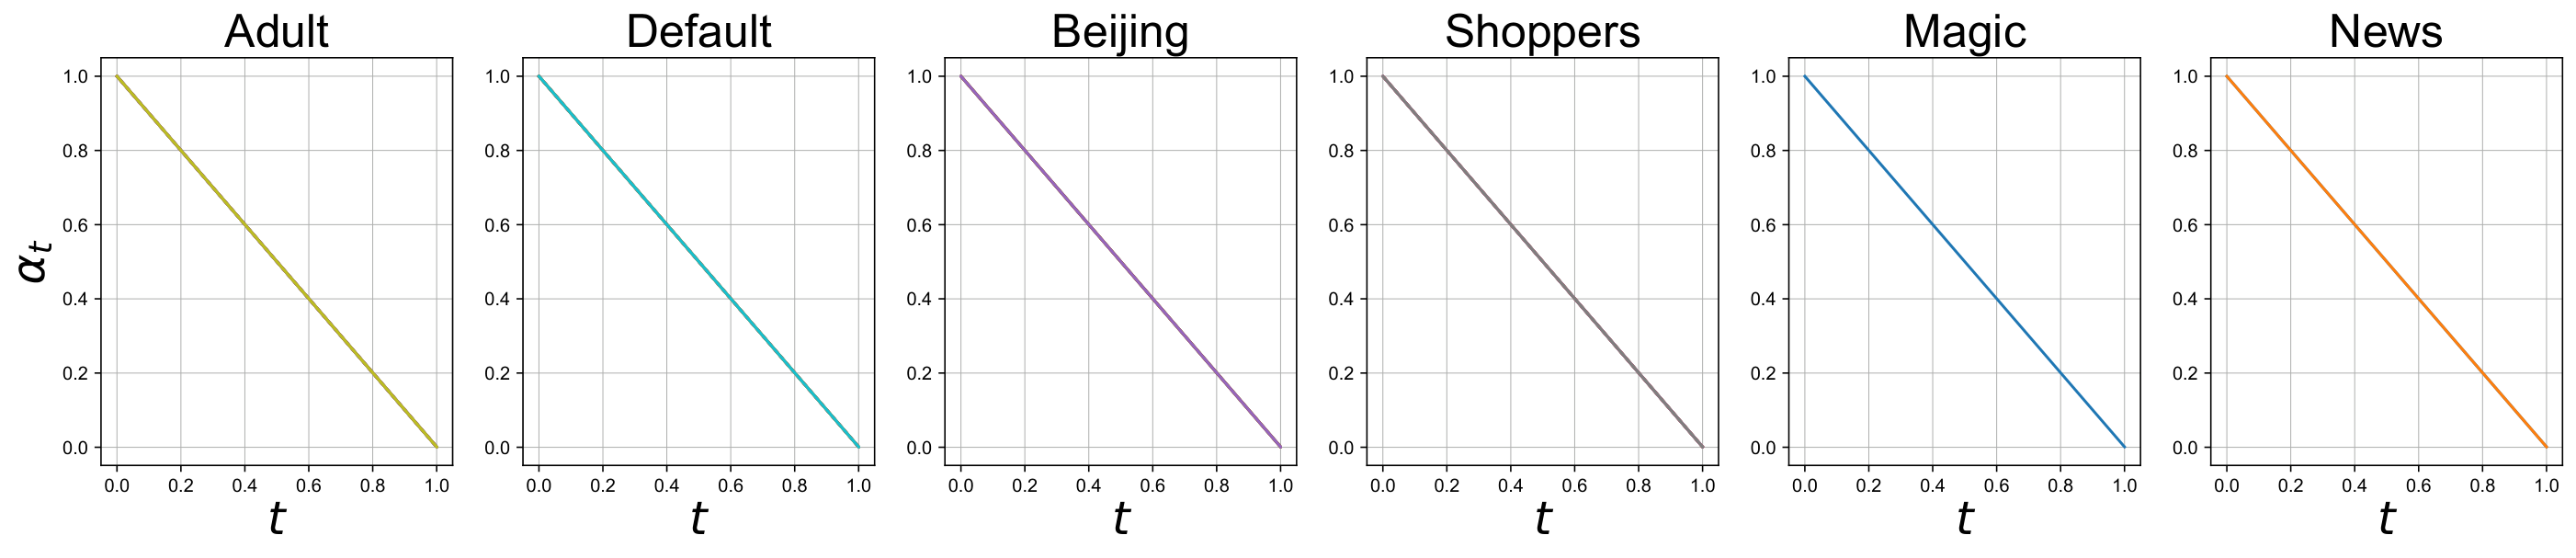
对于单一位置和 $s $\alpha_t$ 随 $t$ 递减。未遮罩的 token 要么保留,要么进入 mask;已遮罩的 token 不再变化。多变量版本对各位置独立执行这一过程,但使用不同的 $\alpha_{t,\ell}$。独立的是给定完整数据的加噪过程,并不假设真实数据各列独立。 给定真实值,反向一步的后验为原文 Eq. (2): 生成时不知道 $\mathbf{x}_0$,所以用网络的预测分布替换 $\delta_{\mathbf{x}_0}$。调度决定“何时解除遮罩”,网络决定“解除后填什么值”。已经填好的位置保持不变。(Sec. 2,PDF p. 2) 在理想端点 $\alpha_{0,\ell}=1$、$\alpha_{1,\ell}=0$ 下,Proposition 3.2 给出 这可以从正向过程直接理解:到时间 $t$ 已进入 mask,恰好等价于 $T_\ell\le t$。它也与反向过程相容:恢复事件发生在相同的噪声坐标,只是沿相反方向访问。(Sec. 3.2,PDF p. 3;Appendix B,pp. 9–10) 各位置的跳变时间相互独立,故生成顺序概率为 这里补全了原文积分中的各变量与积分测度,并将区域改成反向生成对应的降序。如果坚持采用原文的升序,则所得是正向遮罩顺序,生成时需将它反转。 共同调度使 $T_1,\ldots,T_L$ 独立同分布;连续时间下没有并列跳变,各排列等可能,因此 $P_{\mathrm{dec}}(\pi)=1/L!$。不同位置使用不同调度后,排列的对称性被打破。 原文 Eq. (8) 为 这里 $\alpha'_{t,\ell}<0$,$\log\mu\le0$,所以乘积是非负损失。为显式显示被预测的位置,可以令 并等价地写成 未遮罩位置在反向过程中直接复制,不承担恢复损失;若用原文不带指示函数的写法,就要将这一 carry-over 约定包含在 $\mu$ 的定义里。权重是对仍被遮罩位置的恢复事件率,而非正向遮罩事件率。 实验采用 所以学习 $w_\ell$ 同时改变两件事:哪些遮罩上下文更常出现,以及相应恢复任务的损失权重。固定线性调度 MDM 对应所有 $w_\ell=1$。(Sec. 4,PDF p. 4) 遮罩是离散采样;只对显式权重 $w_\ell/t$ 反向传播,会漏掉 $w$ 对遮罩分布的影响。作者采用 REINFORCE leave-one-out(RLOO)估计调度梯度。其一般原理可以用下面的教学展开说明,论文没有给出这一具体展开式: 在同一数据、同一 $t$ 下采样 $K>1$ 个独立遮罩,用 替换第二项中的基线,即使用 $(g_w(M_k)-b_{-k})\nabla_w\log q_w(M_k)$。基线不依赖第 $k$ 个采样,可降低方差而保持该 score-function 项无偏。实现这一估计时,基线及乘在 score 前的损失应按估计器语义停止梯度;显式的 $\nabla_w g_w$ 单独计算。 论文只明确说使用 RLOO,没有交代样本数 $K$ 和完整训练伪代码。因此上述公式帮助解释为何需要离散梯度估计,不代表复原了作者的全部实现。(Sec. 4,PDF p. 4;原文引用 Kool et al., 2019) Algorithm 1 通过逆调度采样跳变时间:$u_\ell\sim U(0,1)$,$T_\ell=\alpha_\ell^{-1}(u_\ell)$。由于 $\alpha$ 递减,$\Pr(\alpha^{-1}(U)\le t)=\Pr(U\ge\alpha(t))=1-\alpha(t)$,与上面的 CDF 一致。 对幂函数调度,$T_\ell=(1-u_\ell)^{1/w_\ell}$;也可用分布相同的 $u_\ell^{1/w_\ell}$。下面是按反向时间方向整理的教学伪代码: 排序本身需要 $O(L\log L)$ 工作;逐事件生成有 $L$ 次填值。这里的 $L$ 次事件不是整个算法的浮点计算复杂度:每次网络评估仍有成本。论文只比较采样步数与参数量,没有给出等硬件吞吐测试。(Algorithm 1,PDF p. 3;Sec. 4.1,p. 4) 原文证明沿轨迹展开 ELBO,让调度的对数项望远镜抵消,最后仅保留每个 token 在跳变处的预测损失。下面给出与 Eq. (8) 相连的补充推导,更容易看清权重的含义。 令 $r_\ell(t)=-\alpha'_{t,\ell}/(1-\alpha_{t,\ell})$。因为 “在随机时刻仍被遮罩的概率 × 恢复事件率”恰好等于该位置的跳变时间密度。其他位置的独立跳变时间决定此刻能看到哪些变量:在 $T_\ell=t$ 时,$T_j>t$ 的位置已经在反向过程中生成。 于是每条连续时间轨迹对应一个顺序;按相同顺序把轨迹合并,就得到 Proposition 3.1 的内容: $x_{\pi( 这就是作者的主要结论。所有顺序共享同一个去噪网络,调度改变各个条件预测任务被重视的程度。(Sec. 3.1,PDF p. 3,Eqs. (5)–(6);Appendix B,pp. 10–11) 精确分解使用连续时间、各位置独立的吸收式遮罩,以及完全干净和完全遮罩的理想端点。连续、无原子的跳变时间使不同位置同时跳变的概率为零;有限步采样若一次填多个相互依赖的位置,就不再直接对应这里逐 token 的精确分解。原文背景写端点“约等于”0/1,证明则按精确端点计算;若实际截断端点,需要处理对应边界项。 当网络显式输入时间时,Eq. (5) 仍保留条件时间期望;不能直接把它替换为 Eq. (6)。实验 Eq. (8) 使用的是不显式输入时间的网络写法。 另外,$\mathcal L$ 是负 ELBO,即负对数似然的上界。对无时间输入、按顺序逐 token 采样的模型,定义 则由 Jensen 不等式有 这是本笔记对 Eq. (6) 的进一步解释:不同顺序的负对数似然平均,与对顺序求和后的混合模型负对数似然,一般并不相等。 因而不能把“训练目标等于 AR 损失期望”解读成已经精确计算了边缘似然。 原文附录还存在应避免照抄的符号问题:PDF p. 10 的 $p/q$ 转移表中,调度项的归属与 Eqs. (1)–(2) 不一致;Eqs. (23)–(24) 丢失了损失前的负号,最终 Eq. (27) 又恢复了负号。上面的事件率推导与主结论的负对数形式一致。 对同一个、不显式输入时间的网络,只要所有位置共享一个连续调度,跳变时间的排名始终均匀,因此 共同调度可以让跳变更集中于某个时间区间,但不会改变变量之间的排名概率;完整积分的目标不变。位置间的相对调度改变时,$P_{\mathrm{dec}}(\pi)$ 才发生变化,损失因而可以变化。对目标积分的有限样本估计仍可能有不同方差;Sec. 5 正是沿这一方向解释实验收益有限。(PDF p. 5) 以下是教学例子,数值并非原文实验。设 $\alpha_{t,1}=1-t^{w_1}$、$\alpha_{t,2}=1-t^{w_2}$。位置 1 先生成意味着 $T_1>T_2$,所以 若 $(w_1,w_2)=(1,3)$,则先生成位置 2 的概率为 $3/4$,目标变成 较大的 $w_\ell$ 使该位置在正向过程中更晚被遮住,也使其在反向过程中更可能先生成。模型依然会抽样顺序;它没有被迫固定在一个排列上。 由 $F_\ell(t)=t^{w_\ell}$,作变量变换 $Z_\ell=-\log T_\ell$,得到 按 $T$ 降序生成等于按 $Z$ 升序选择。独立指数时钟的竞争和无记忆性给出 这正是 Plackett–Luce 形式。这是本笔记从作者调度族导出的结论,原文没有展开这一闭式分布。 它说明实验学习的是一个受结构约束的顺序族:每步按剩余位置的相对权重选下一列,无法自由设置全部 $L!$ 个排列的概率。将全部 $w$ 同乘正常数不会改变顺序分布,也不会改变无时间输入网络的精确积分损失。 六个数据集为 Adult、Default、Beijing、Shoppers、Magic、News,任务是合成与原数据统计性质相近的表格。 作者报告自己的两个方法使用相同超参数组;Appendix C.1 的均值和标准差来自 10 runs。其他方法的性能数值取自 TabDiff 论文,而不是在本工作中全部重训。Appendix C.2 另外做了 TabDiff 的调度可视化复现实验,应与引用的基线分数分开理解。(Sec. 4.1,p. 4;Appendix C.1–C.2,pp. 11–13) 原文将指标细节指向 TabDiff, Appendix A.2:Shape 基于数值列的 KS 距离和类别列的总变差距离;Trend 基于相关性与列联分布;另外两项分别评价保真度和覆盖度。这里比较的是目标论文报告的质量分数,不能把它们当成“原始距离越小越好”的口径。指标里的 $\alpha,\beta$ 与扩散调度符号没有关系。 本文没有具体交代数值列如何表示、如何还原,也没有给出足以复现的完整网络和训练配置。尤其 Fig. 5 强调所有列都使用 masked diffusion,数值列的处理方式会直接影响 Shape 等指标,不能直接用 TabDiff 的混合连续/离散实现替代作者方法。(Fig. 5,PDF p. 12) 来源:Fig. 2a,PDF p. 5;差值由本笔记相减得到。这些数值是作者标注的 best validation losses,不要混同于附录生成指标的“均值 ± 标准差”。学习调度的优势主要体现在 Default、News;Beijing 和 Shoppers 的验证损失反而更高。 来源:Table 1,p. 4;Table 4,p. 11。$\pm$ 为原文报告的跨 run 标准差;本节后续表格口径相同。LS 在 4/6 数据集上提高均值,但 TabDiff 在六个数据集上均更高。例如 Default 的 TabDiff 为 0.9745,仍高于 LS 的 0.9705;Magic 中 LS 的退步最大。约 86K 与 10M 参数的比较说明小模型有一定参数效率,但没有控制模型容量与完整训练预算。 来源:Table 2,p. 4;Table 5,p. 11。改善与退步的数据集分组和 Trend 相同。LS 没有取得任一数据集的最高 Shape;News 中 LS 高于 TabDiff 的 0.9765,但仍低于 TabSyn 的 0.9794。只看某一个基线会遗漏这一点。 来源:Table 3,p. 5;Tables 6–7,p. 12。表中差值是分数的绝对差,不是相对百分比。 News 的 LS $\alpha$-Precision 为 0.9872,在全部参评方法中最高;但其 β-Recall 为 0.3473,低于 TabSyn 的 0.4301 和 TabDiff 的 0.4210。模型可以生成更像真实数据的样本,同时覆盖的数据区域仍然较少。对直接消融而言,β-Recall 在其余五个数据集上均下降。 Magic 特别能说明训练目标与评测目标的差异:LS 的最佳验证损失更低,四个保真度指标却全部下降。因此,“损失下降”不能直接替代“合成表格更有用”的测量。这是对原文结果的横向比较,不是作者已确认的具体失败机制。 来源:Fig. 2b,PDF p. 5。横轴 $t$ 从 0 到 1,纵轴 $\alpha_t$ 是未遮罩概率,彩色曲线对应各列。曲线不再全部重合于 $1-t$,说明训练确实改变了各列跳变时间分布。较高曲线表示在同一正向时刻更可能保留原值,相应位置在反向生成时倾向于更早恢复。原图没有列名图例,因此不能据颜色判断“收入”或“年龄”的具体先后。 来源:Fig. 5,PDF p. 12。六个面板从左到右为 Adult、Default、Beijing、Shoppers、Magic、News;坐标与上一图相同。不同曲线形状支持“各列采用不同调度”的观察,尚未给出变量依赖结构或因果顺序的识别结果。 来源:Figs. 3–4,PDF p. 12;解释见 Appendix C.2,p. 13。作者复现中的 TabDiff 类别列调度基本重合,随机初始化没有改变这一现象。应将结论限定在文中这组复现实验;TabDiff 的混合连续/离散框架与这里对所有列使用 masked diffusion 的设计不同,图本身也没有隔离出差异的唯一原因。 论文建立了有用的机制对应:独立的连续跳变时钟定义顺序分布,按这些顺序训练共享的条件预测器,就得到多变量调度 MDM 的目标。时间无关参数化使其精确化为加权自回归损失。对无天然顺序的结构化数据,这提供了一个简单的训练期顺序学习入口。 实证结果支持“调度可以被学习”,对“质量是否因此改善”则给出混合答案:最佳验证损失改善 4/6,Trend、Shape、$\alpha$-Precision 各改善 4/6,β-Recall 仅改善 1/6。论文没有确立新的整体最优表格生成方法。 作者提出的解释是学习调度可能提高损失估计方差,使理论上的目标灵活性难以转化为稳定收益;这是 Sec. 5 的假设,而非直接测得的因果结果。一个有针对性的后续实验是固定网络和训练预算,比较统一调度、固定非均匀调度、学习调度,并同时报告梯度方差、顺序分布与四类质量指标,从而区分“选到了更合适的顺序”和“优化噪声发生了变化”。 本笔记的额外推论进一步收紧了理解:$1-t^{w_\ell}$ 实际对应 Plackett–Luce 顺序族,只依赖相对列权重。更灵活的调度、按生成状态调整的顺序,以及降低离散调度梯度方差,是三个不同的改进方向;不能只通过增加 $w$ 的训练时间就把它们视为已经解决。 从链式法则还可看出一个理想极限:若同一模型能对所有遮罩上下文精确表示真实条件分布,则每个完整顺序都对应同一个真实联合分布,各顺序在数据期望下的损失相同。因此,顺序学习的实际价值主要体现在有限容量、有限数据及优化条件下如何分配学习任务。这也解释了为何一个精确的理论等价关系,并不自动带来一致的实验提升。2.3 一个调度就是一个随机跳变时间分布
2.4 训练目标:恢复损失及其调度权重
2.5 为什么需要 RLOO?
2.6 生成:先抽取各列时钟,再依次填入值
对每个位置 ℓ:采样 Tℓ = Uℓ^(1/wℓ)
π = 按 Tℓ 降序排列的位置索引
x = 全部为 MASK
对 i = 1,...,L:
    ℓ = π(i)
    从 μℓ(x; θ) 采样该位置的值
    将该值写回 x,之后保持不变
返回 x三、理论分析:为何等于加权自回归训练?
3.1 从恢复事件率直接得到按顺序分组的损失
3.2 等价式里的假设决定它能说明什么
3.3 单一调度为何不影响目标,多变量调度又改变了什么?
3.4 两变量例子:一个参数如何改变顺序概率?
3.5 补充推导:实验调度对应 Plackett–Luce 顺序分布
四、实验与结果:顺序确实能学,质量收益需要逐项看
4.1 实验对象、对照与指标
比较对象 本实验中的角色 MDM 固定线性调度,约 86K 参数;检验学习调度作用的直接对照 MDM(LS) 相同超参数组,约 86K 参数;每列学习 $w_\ell$,用 RLOO 优化 STaSy、CoDi、TabDDPM、TabSyn 已有表格生成方法,提供生成质量的外部参照 TabDiff 更大规模的强基线;本文称约 10M 参数,也包含可学习调度 指标 关注的问题 本文表中方向 Trend 合成数据是否保留真实数据的列间两两相关关系 越高越好 Shape 单列的边缘分布是否吻合 越高越好 $\alpha$-Precision 合成样本是否落在真实数据分布的合理区域 越高越好 $\beta$-Recall 合成样本是否覆盖真实数据分布 越高越好 4.2 最佳验证损失:4 个改善,2 个变差
数据集 MDM MDM(LS) 差值 LS − MDM,越负越好 Adult 13.1861 13.1524 −0.0337 Default 19.4247 18.3272 −1.0975 Beijing 16.7610 17.0060 +0.2450 Shoppers 16.4246 16.4604 +0.0358 Magic 12.6114 12.4712 −0.1402 News 49.9699 48.9401 −1.0298 4.3 Trend:相关性保真度小幅改善,仍落后于 TabDiff
数据集 MDM MDM(LS) LS − MDM Adult 0.9747 ± 0.0020 0.9778 ± 0.0023 +0.0031 Default 0.9642 ± 0.0016 0.9705 ± 0.0028 +0.0063 Beijing 0.9773 ± 0.0034 0.9743 ± 0.0038 −0.0030 Shoppers 0.9703 ± 0.0027 0.9710 ± 0.0038 +0.0007 Magic 0.9724 ± 0.0026 0.9628 ± 0.0070 −0.0096 News 0.9766 ± 0.0016 0.9781 ± 0.0017 +0.0015 4.4 Shape:边缘分布已有较高基准,进一步改善有限
数据集 MDM MDM(LS) LS − MDM Adult 0.9851 ± 0.0015 0.9878 ± 0.0016 +0.0027 Default 0.9787 ± 0.0010 0.9830 ± 0.0007 +0.0043 Beijing 0.9866 ± 0.0006 0.9841 ± 0.0009 −0.0025 Shoppers 0.9829 ± 0.0011 0.9832 ± 0.0018 +0.0003 Magic 0.9822 ± 0.0018 0.9750 ± 0.0044 −0.0072 News 0.9785 ± 0.0004 0.9787 ± 0.0004 +0.0002 4.5 $\alpha$-Precision 与 $\beta$-Recall:质量和覆盖出现分离
数据集 MDM:$\alpha$-Precision LS:$\alpha$-Precision LS − MDM Adult 0.9756 ± 0.0032 0.9909 ± 0.0028 +0.0153 Default 0.9717 ± 0.0030 0.9839 ± 0.0019 +0.0122 Beijing 0.9592 ± 0.0022 0.9744 ± 0.0034 +0.0152 Shoppers 0.9827 ± 0.0033 0.9818 ± 0.0048 −0.0009 Magic 0.9804 ± 0.0023 0.9623 ± 0.0034 −0.0181 News 0.9779 ± 0.0016 0.9872 ± 0.0012 +0.0093 数据集 MDM:$\beta$-Recall LS:$\beta$-Recall LS − MDM Adult 0.4595 ± 0.0022 0.4534 ± 0.0020 −0.0061 Default 0.3810 ± 0.0030 0.3781 ± 0.0012 −0.0029 Beijing 0.5309 ± 0.0031 0.5162 ± 0.0027 −0.0147 Shoppers 0.4583 ± 0.0067 0.4435 ± 0.0060 −0.0148 Magic 0.3894 ± 0.0042 0.3852 ± 0.0057 −0.0042 News 0.3405 ± 0.0022 0.3473 ± 0.0033 +0.0068 4.6 调度可视化:确实学到了不同的列时钟
五、结论与启发