Equivalence of Context and Parameter Updates in Modern Transformer Blocks:中文精读
作者:Adrian Goldwaser、Michael Munn、Javier Gonzalvo、Benoit Dherin
原文:arXiv:2511.17864v3 · 本地 PDF
版本与阅读日期:v3(2026-07-06 修订);2026-10-26 阅读
论文总览
这篇论文研究一个精确的表示问题:给定某个查询 token 和它前面的上下文,能否删去上下文、只修改模型参数,仍得到同一个下一 token 输出?作者先对带门控 MLP、前置 RMSNorm 和后置 RMSNorm 的 Gemma 式残差块给出显式解,再用逐层归纳覆盖深层模型,最后把构造概括为输入可控性(input controllability)与输出可控性(output controllability)。它解释了上下文作用如何在单次计算中表示成参数补丁;这些补丁依赖当前 token 与生成历史。〔Sec. 1、3、5,PDF pp. 1–2、3–4、8–9〕
核心技巧分为两步:用秩至多为 1 的输入矩阵补丁,使删去上下文后的 MLP 内部激活与原来相同;再修改 MLP 输出端,补回注意力残差路径少掉的向量。对 Gemma,后一处是 RMSNorm 的可训练缩放向量 $\mathbf m$;对 Llama/Falcon 一类块,可以是输出矩阵。精确等式有非零激活等条件;在有限精度中,直接更新 $\mathbf m$ 会遇到数值问题。〔Thm. 1、3 与 Table 1,PDF pp. 3、8〕
结构地图
| 原文章节 | 作用 | PDF 定位 |
|---|---|---|
| 1 Introduction;2 Background | 解释已有单层 vanilla 证明与现代无偏置、门控、归一化架构之间的缺口 | pp. 1–2 |
| 3 Results: Implicit Updates in Modern Transformers | Gemma 单块公式、深层归纳与逐层构造算法 | pp. 2–5;Fig. 1–2、Thm. 1–2 |
| 4 Experimental Validation | 比较有上下文原模型与无上下文补丁模型的逐 token 输出 | pp. 4–7;Alg. 1、Fig. 3–5 |
| 5 A General Framework for Implicit Updates | 可控性定义、统一定理、架构实例及反例入口 | pp. 6–9;Table 1、Thm. 3 |
| 6 Conclusion | 解释逐 token 等价的用途与实际范围 | p. 9 |
| Appendices A–E | 可控性引理、稳定更新、扩展实验、固定后置 RMSNorm 反例及梯度形式 | pp. 12–25 |
一:动机——为什么原有补丁公式不够
先前工作已证明,单个常规 Transformer 块的上下文效应可由 MLP 输入矩阵的秩 1 更新和输出偏置更新表示。直观地说,注意力读入上下文,改变了进入 MLP 的向量;输入矩阵补丁可重现改变后的隐藏激活,输出偏置可补回残差路径。然而 Gemma 和 Llama 等现代模型常去掉 MLP 偏置,并加入门控与归一化;原证明需要的输出偏置不存在。论文的问题就是在这些具体结构中找到能承担两种补偿的参数,并把单层结论提升为多层结论。〔Sec. 1–2,PDF pp. 1–2〕
作者研究的是固定输入与历史上的函数值等价:在这一查询点上,有上下文的原模型和无上下文、已补丁的模型输出相同。这个问题有助于分析上下文诱发的局部权重变化;生成实验每步都重新求补丁。〔Sec. 3.1、4.1、6,PDF pp. 2–3、5、9〕
二:方法——把上下文拆成输入变化与残差变化
2.1 单个 Gemma 式块
令 $C$ 为完整上下文,$C\setminus Y$ 为删去片段 $Y$ 的上下文。$A(C,\mathbf x)=\mathbf x+\operatorname{Attn}(C,\mathbf x)$ 包含注意力和它的残差连接。定义
以及前置归一化后的 $\mathbf z_C=N_{\rm RMS}(\mathbf v_C)$、$\mathbf z=N_{\rm RMS}(\mathbf v)$。Gemma 式 MLP 子层的输出可写成
其中 $W_{\rm gate}$ 与 $W_{\rm up}$ 是两条输入投影,$f(\mathbf a,\mathbf b)=N_{\rm RMS}'\!\left(W_{\rm down}(\operatorname{GeLU}(\mathbf a)\odot\mathbf b)\right)$ 包含门控、输出矩阵和未乘缩放向量的后置 RMSNorm;$\mathbf m$ 是后置 RMSNorm 的可训练缩放向量。$\mathbf v$、$\mathbf m$ 与 $f$ 的输出同属残差流维度。〔Sec. 3.1、Eq. (1)、Fig. 1,PDF pp. 2–3〕
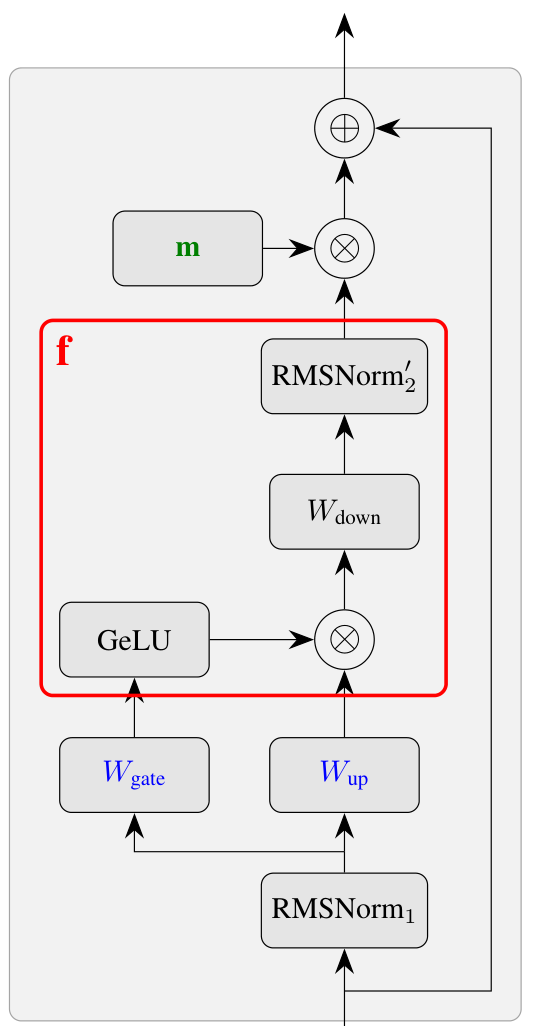
图中蓝色的两条输入矩阵路径负责恢复 MLP 内部激活;绿色 $\mathbf m$ 路径负责补偿最后的残差差值。红框 $f$ 已包含 $W_{\rm down}$ 和无缩放的后置 RMSNorm。〔原文 Fig. 1,PDF p. 3〕
2.2 单块定理的显式补丁
对 $i\in\{\rm gate,up\}$,先定义
于是 $(W_i+\Delta W_i)\mathbf z=W_i\mathbf z_C$。两个投影的输入都对齐后,门控和 $W_{\rm down}$ 等后续计算也恢复成有上下文时的值。设这个共同输出为 $\mathbf h=f(W_{\rm gate}\mathbf z_C,W_{\rm up}\mathbf z_C)$,再令
代回可得 $\mathbf v+(\mathbf m+\Delta\mathbf m)\odot\mathbf h=\mathbf v_C+\mathbf m\odot\mathbf h$,因此两个块的输出逐坐标相等。$\Delta W_i$ 是一个列向量与一个行向量的外积,秩至多为 1;它不是对所有可能输入都成立的同一权重变换。若 $h_j=0$ 且所需 $\Delta v_j\ne0$,该直接缩放公式无法补偿第 $j$ 个坐标。〔Thm. 1、Eq. (2)–(4),PDF p. 3〕
2.3 从单块到深层模型
多层证明使用归纳:假设第 $l$ 层前,有上下文原模型与无上下文补丁模型的当前 token 隐藏向量相同;对这一共同输入应用单块定理,令本层输出也相同。第 1 层以相同的查询 token 表示开始,依次处理到第 $L$ 层,就得到最终输出等价。作者的算法先用完整上下文跑一遍,记录每层目标激活;第二遍在删去上下文的路径上逐层计算补丁,并把实际补丁输出传给下一层,从而吸收有限精度累积的误差。〔Sec. 3.2–3.3、Thm. 2、Alg. 1,PDF pp. 4–6〕
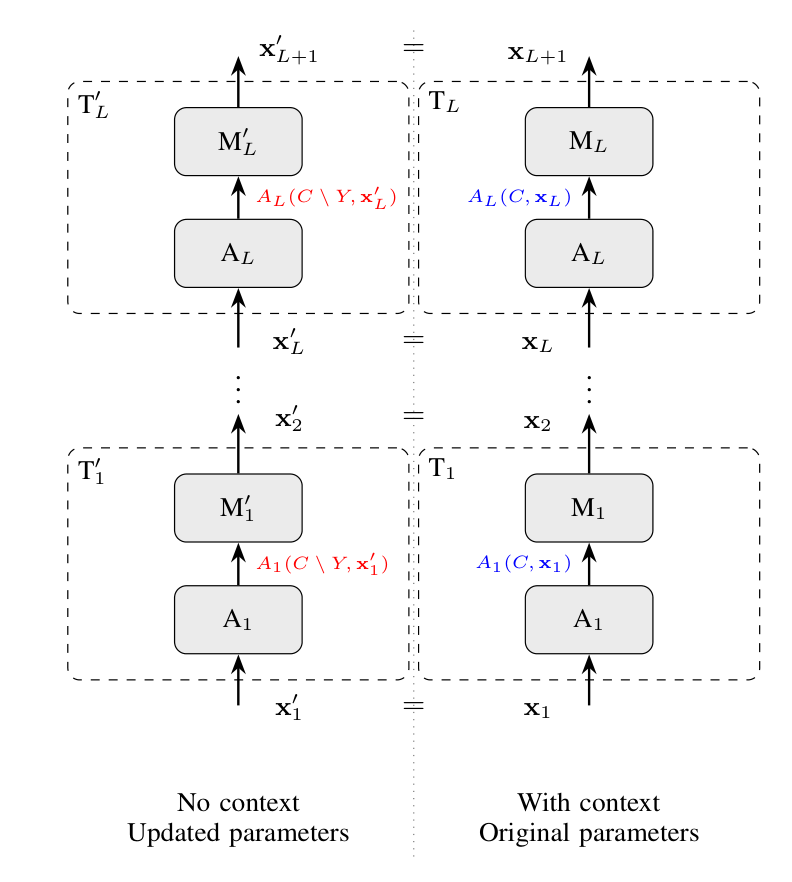
图 2 的等号连接每一层的当前 token 隐藏状态。左侧的 $\mathbf x'_l$ 是应用此前各层补丁后的状态,不是简单地用原参数删除上下文后得到的状态。〔原文 Fig. 2,PDF p. 4〕
2.4 统一定理:什么架构能这样做
把残差块写作 $T(C,\mathbf x)=A(C,\mathbf x)+g(f(A(C,\mathbf x);\theta_f);\theta_g)$。若能通过改变 $f$ 的参数使较小输入产生较大输入原本会产生的内部状态,称 $f$ 输入可控;若能通过改变 $g$ 的参数,为固定内部状态制造任意所需的输出差值,称 $g$ 输出可控。两者同时满足且相应激活非零时,先对齐 $f$,再让 $g$ 增加 $\Delta\mathbf v$,即可构造上下文等价补丁。这是充分条件。〔Sec. 5、Definitions 1–2、Thm. 3,PDF pp. 7–8〕
| 架构部件 | 补偿参数与构造 | 关键条件 |
|---|---|---|
| 常规或门控 MLP 的输入线性投影 | 对每个输入矩阵使用 $\Delta W_i=W_i\Delta\mathbf z\,\mathbf z^\top/\|\mathbf z\|^2$ | $\mathbf z\ne0$ |
| 前置归一化 | 令 $\Delta\mathbf z=N(\mathbf v_C)-N(\mathbf v)$ 后仍补输入矩阵 | $N(\mathbf v)\ne0$ |
| 外层偏置 | $\Delta\mathbf b=\Delta\mathbf v$ | 偏置可修改 |
| 外层输出矩阵,如无后置归一化的块 | $\Delta W_{\rm out}=\Delta\mathbf v\,\mathbf h^\top/\|\mathbf h\|^2$ | $\mathbf h\ne0$ |
| 后置 RMSNorm 可训练缩放 | $\Delta\mathbf m=\Delta\mathbf v\oslash\mathbf h$ | $h_j\ne0$,逐坐标 |
| MoE | 将所需差值分给可控专家并按路由权重求和 | 相应专家可控,门值和 $S\ne0$ |
| 并行注意力与 MLP | MLP 输出端直接吸收注意力差值 | MLP 输出端可控 |
〔原文 Table 1、Appendix A,PDF pp. 8、12–13〕
这个判据也给出一个明确的失败情形:固定缩放向量的后置 RMSNorm 输出范数受限,不能提供任意大的残差补偿,因此一般不满足输出可控性。附录 D 给出了上界 $\|g(\mathbf z')-g(\mathbf z)\|_2\le2\sqrt d\|\mathbf m\|_\infty$ 与可放大的注意力差值之间的反例。〔Sec. 5.1、Appendix D,PDF pp. 9、19–20〕
2.5 为什么还需要稳定更新
Gemma 的直接公式要按坐标计算 $\Delta\mathbf m=\Delta\mathbf v\oslash\mathbf h$。即使理论上 $h_j\ne0$,很小的 $h_j$ 仍会放大更新与舍入误差。附录 B 的稳定版本先求目标 MLP 输出 $\mathbf g=\Delta\mathbf v+\mathbf m\odot N(\mathbf h_{{\rm down},C})$,再找一个固定 RMS 大小的 $\mathbf h_{\rm target}$,使 $\mathbf m\odot N(\mathbf h_{\rm target})$ 尽量接近 $\mathbf g$。随后用秩 1 的 $\Delta W_{\rm down}$ 把门控激活送到 $\mathbf h_{\rm target}$,最后仅用 $\Delta\mathbf m$ 补剩余误差。这样将主要补偿交给矩阵,通常缩小对 $\mathbf m$ 的更新。〔Appendix B,PDF pp. 13–15〕
这里的 RMSNorm 反演是一个受 $\operatorname{RMS}(\mathbf h_{\rm target})=C$ 约束的最小二乘问题;附录给出拉格朗日乘子的坐标公式与一维求根形式。反演本身求的是最佳近似,最后的 $\Delta\mathbf m$ 才使理想算术中的输出严格匹配;其坐标除法仍需非零条件。〔Appendix B.1–B.2,PDF pp. 13–15〕
三:实验——如何检验这一构造
主实验以指令微调 Gemma 3 1B 的文本生成与 Gemma 3 4B 的图像上下文为例;附录还在 Falcon-7B 上复核。文本例子要求“略显不耐烦的机器人”写一句火星天气预报,另有四个不同提示。基线是有完整上下文的原模型;对照是在每个生成步重新计算各层补丁、不给显式上下文的模型。补丁吸收初始提示,也吸收此前已生成 token 的历史。若两路选出的 token 分叉,实验记录不匹配,但在下一步强制对照沿基线历史继续,以便在相同历史上比较 logits。〔Sec. 4.1、Appendix C.1、C.3,PDF pp. 5–6、16–19〕
比较指标是:argmax token 是否一致(越高越好)、logits 的 $L_\infty$ 差值(越低越好),以及概率分布的全变差距离 $\mathrm{TVD}(p,q)=\frac12\|p-q\|_1$(越低越好)。因此实验检验的是输出匹配精度与数值稳定性。〔Sec. 4.2,PDF p. 6〕
四:结果——理论等价怎样落到有限精度
4.1 Gemma 文本:精度和稳定构造决定实际吻合度
| 设置 | 论文报告/图示的结果 | 证据 |
|---|---|---|
| Gemma 3 1B,float32,直接补丁 | token 匹配为 100%,TVD 接近零 | Fig. 3–4;PDF pp. 5、7 |
| Gemma 3 1B,bfloat16,直接补丁 | 主文举出的较差设置仅 87.5% token 匹配,且 logits/TVD 明显偏大 | Sec. 4.2、Fig. 3;PDF pp. 5–6 |
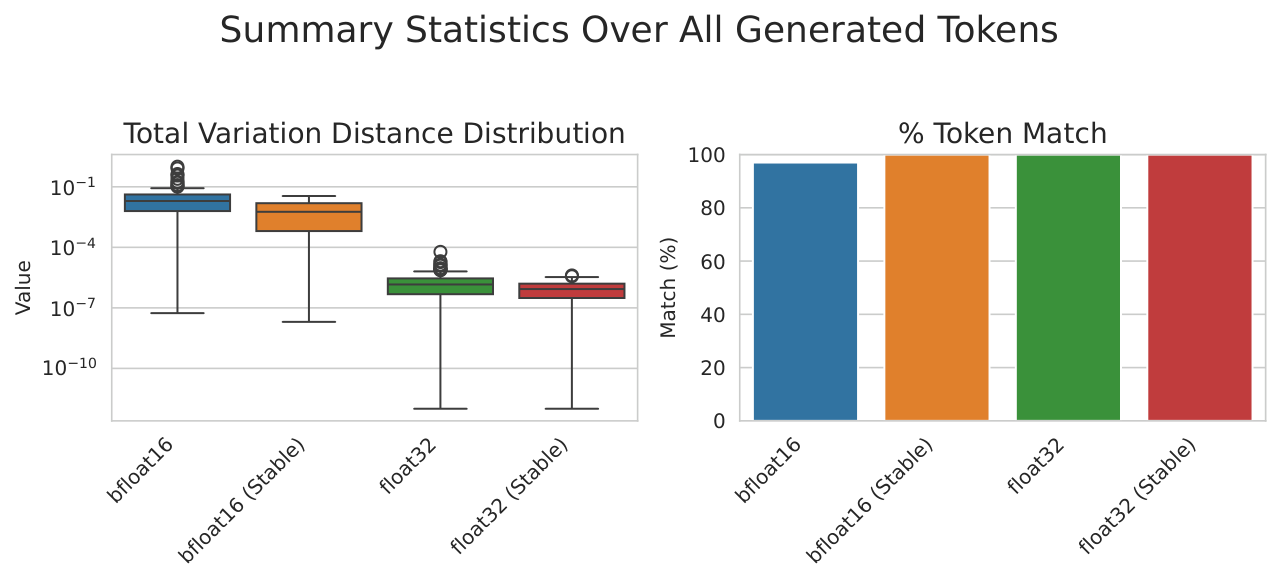
| Gemma 3 1B,bfloat16,稳定补丁 | 主文报告提升到 100% token 匹配;分布差距仍高于 float32 | Sec. 4.2、Fig. 4;PDF pp. 6–7 |
这里的 87.5% 是主文报告的低精度较差案例;Fig. 4 另汇总五次文本生成,不应把单案例百分比直接当作五次的合并统计。Fig. 3 的红叉标出直接 bfloat16 补丁的 token 分叉,Fig. 4 的箱线图显示稳定更新把分布距离压低,同时维持完全的 token 匹配。〔PDF pp. 5–7〕
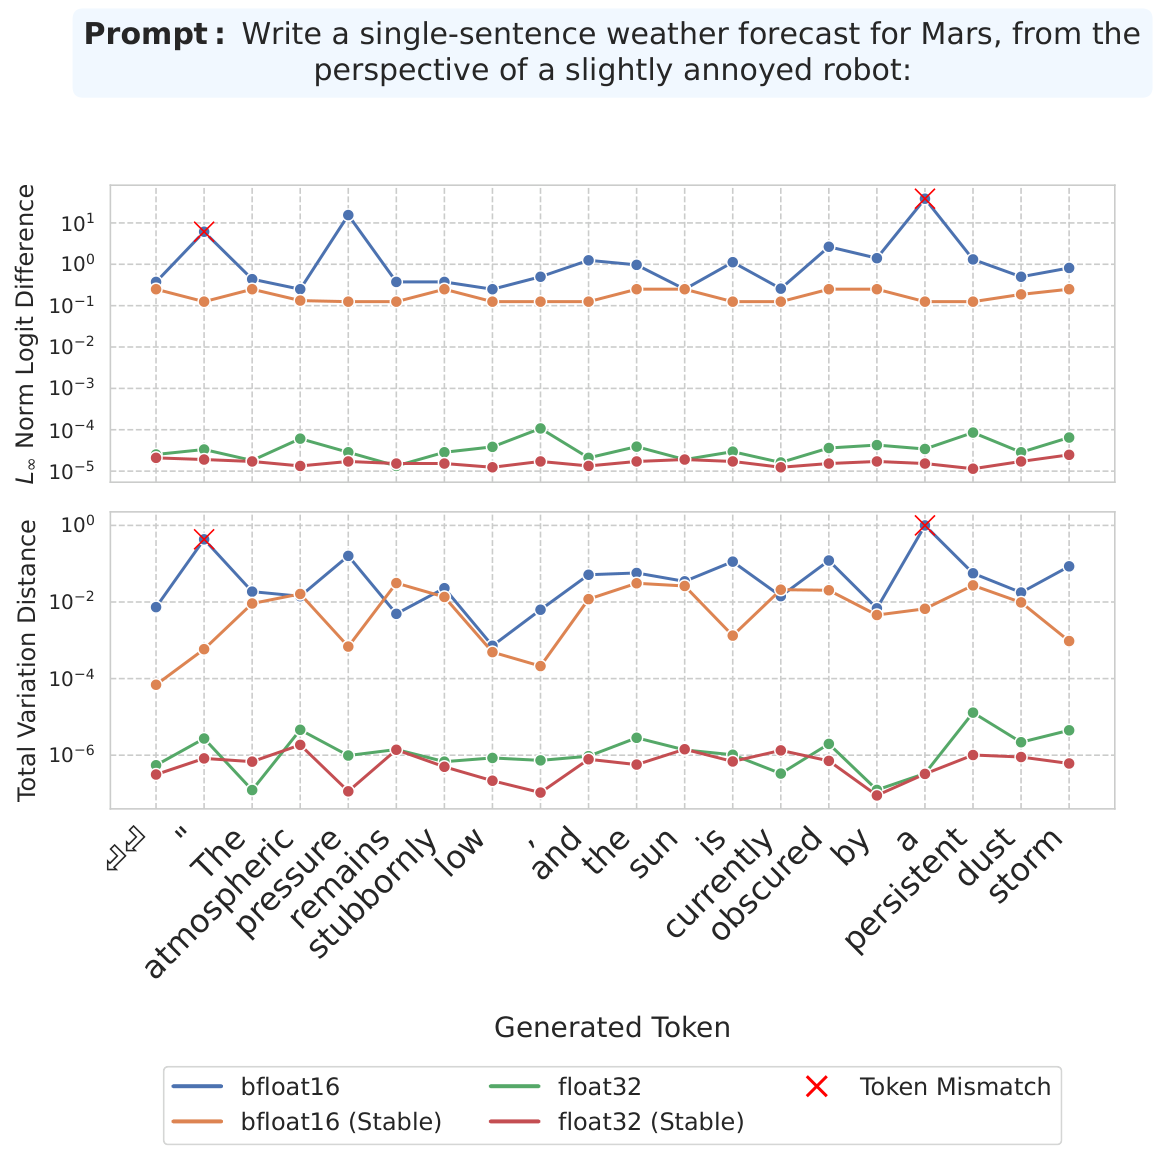
图 3 横轴是按生成顺序排列的 token,纵轴都是对数刻度;蓝色为直接 bfloat16,橙色为稳定 bfloat16,绿/红分别为 float32 两种更新。红叉标出 token 不一致位置。稳定方案在 bfloat16 下改善两种距离;float32 的两条曲线保持在更低量级。〔原文 Fig. 3,PDF p. 5〕
4.2 图像上下文与 Falcon:同一构造跨输入和架构有效
Gemma 3 4B 的图像例子让模型描述一张猫的照片。原文 Fig. 5 显示,float32 两种补丁在该例的 token 选择上保持一致;直接 bfloat16 出现分叉,稳定版本显著缩小 logit/TVD 差距。这个实验说明构造可以把含图像的上下文纳入当前 token 的等价计算。〔Sec. 4.2、Fig. 5,PDF p. 7〕
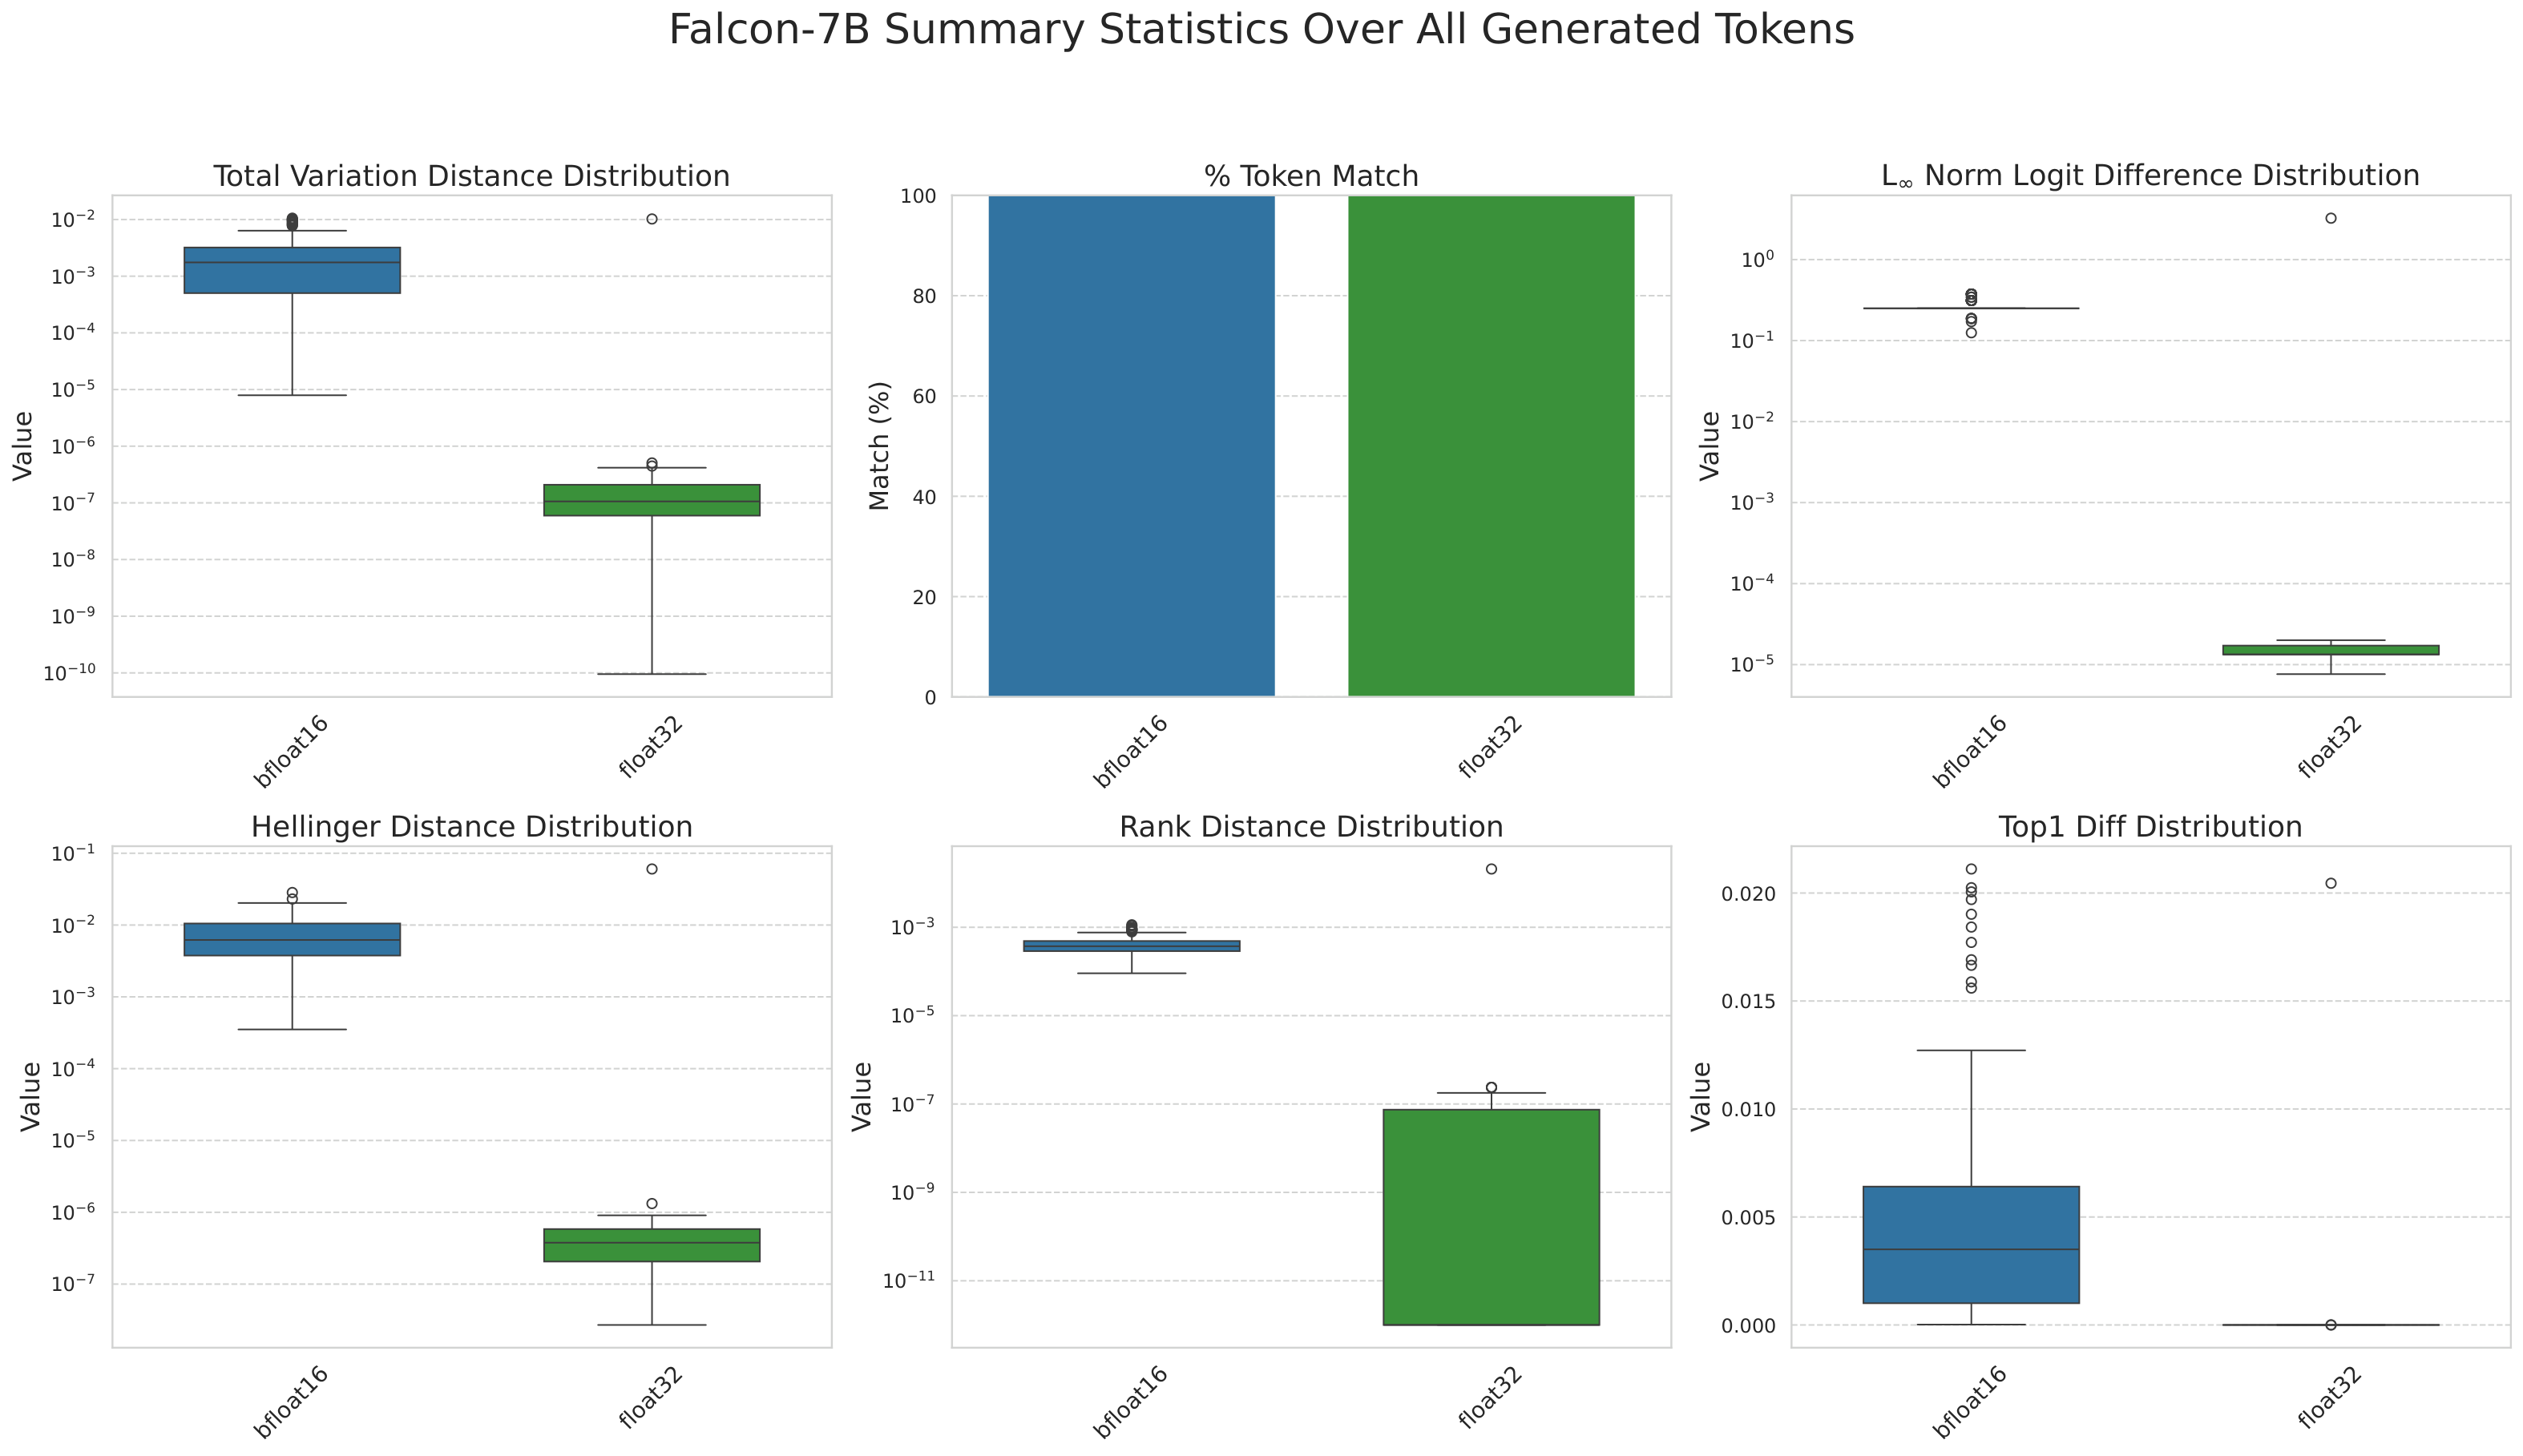
Falcon-7B 没有 Gemma 式后置归一化缩放,论文用外层输出矩阵承担补偿。附录的五个提示汇总图中,bfloat16 和 float32 都达到 100% token 匹配;float32 的 TVD 与 logit 差值更小。它直接支持输出可控参数可随架构改变这一论点。〔Appendix C.3、Fig. 9,PDF pp. 17–18〕
4.3 消融:补丁放在哪里也影响数值表现
从最后一层才开始补丁在理论上可能足够,但附录 C.4 的实验中,只更新最后一层会降低匹配精度;允许前面若干层分担补偿后,准确度通常恢复。稳定方案从更早层开始还降低了尺度向量补丁的范数。附录 C.5 比较直接、稳定与缩放目标等更新策略,显示不同构造虽都基于同一等价目标,低精度误差和补丁范数仍明显不同。〔Appendix C.4–C.5、Fig. 11–13,PDF pp. 17–18、23–25〕
五:结论与理解
论文的主要贡献是一个逐查询、逐层的构造性等价:现代 Transformer 的上下文效应,在输入投影可控且输出端可补任意残差差值时,可以表示为参数补丁。Gemma 的推导给出具体矩阵/向量更新;统一定理解释为什么无偏置的 Llama/Falcon、MoE 和并行块也可分析。实验在指定模型、提示与精度下检验补丁计算的数值吻合度。〔Sec. 3–6,PDF pp. 3–9〕
这一等价的主要实际取舍是token 依赖性:生成历史一变化,目标激活与补丁也变化,故算法要为每一步重新计算。论文并未给出把一次补丁固定后用于任意后续查询的通用算法。另一个取舍是输出端的非零/可控条件以及低精度下小分母导致的误差;稳定版本缓解但仍保留最终按坐标除法。〔Sec. 4.2、6、Appendix B,PDF pp. 6、9、13–15〕
附录 E 将补丁写成某个迹形式目标的一步梯度更新:先按期望补丁定义线性伪损失,再选逆范数步长,求梯度便得到相同外积公式。这提供了与“隐式学习”语言相连的代数表示;该目标是根据要得到的补丁构造出来的。〔Appendix E,PDF pp. 20–22〕