ExplicitLM:以显式记忆库解耦知识与参数
论文:ExplicitLM: Decoupling Knowledge from Parameters via Explicit Memory Banks
作者:Chengzhang Yu、Zening Lu、Chenyang Zheng、Chiyue Wang、Yiming Zhang、Zhanpeng Jin
版本:arXiv:2511.01581v1,2025-11-03 提交;获取与研读日期:2026-10-08
原文:arXiv · 在线 PDF · 本地 PDF
汇报材料:英文幻灯片 · 可编辑 TeX
论文总览
ExplicitLM 尝试把一部分事实知识从分散的网络权重中分离出来,存成可寻址、可解码的 token 序列。Transformer 的不同层读取同一个百万条目记忆库:先利用乘积键缩小检索范围,再通过 Gumbel-Softmax 和直通估计器学习离散选择。记忆库默认把 20% 的条目用于训练时冻结的事实,另 80% 用于可更新的模式。可读的条目提供检查和编辑知识的入口,学习到的检索器负责把这些条目接入模型计算。(Sec. 3,PDF pp. 3–6)
最明确的实验发现是:在测试事实预先位于记忆库的设置下,ExplicitLM 比没有记忆库的 Transformer 更擅长知识召回,尤其是在监督样本较少时。50k 样本的对象预测准确率从 30.23% 提高到 73.90%,即 +43.67 个百分点;10k 样本时从 7.86% 提高到 28.42%,准确率是基线的 3.62 倍。前者不是相对提升 43.67%,后者也不是所有任务的平均增益。(Table 1,PDF p. 7)
这篇论文最有启发的地方是把“存什么”和“如何读出来”放进同一架构。但实验主要支持的是已有外部事实的利用能力。它没有直接测量修改事实之后的知识更新成功率,也没有通过等知识访问条件的 RAG 对照来分离架构收益和信息可用性的收益。
结构地图
下文页码均为从 1 开始的 PDF 页码,本版本与印刷页码一致。
| 原文章节 | 作用 | PDF 页码及主要证据 |
|---|---|---|
| 1 Introduction | 知识陈旧、参数存储与可解释性动机 | pp. 1–3 |
| 2 Related Work;2.1 LLM architecture development;2.2 Knowledge Editing and Updating | 与模型架构、知识编辑、记忆增强方法的关系 | p. 3 |
| 3.1 Memory Theory | 显式事实与隐式模式的划分 | pp. 3–4 |
| 3.2 Storage Architecture | token 条目与共享记忆库 | p. 4,Fig. 1 |
| 3.3 Knowledge Allocation Strategy | 冻结比例、固定容量和 EMA 更新 | pp. 4–5 |
| 3.4 Memory Retrieval Mechanism | 乘积键筛选、离散选择与梯度 | p. 5 至 p. 6 开头,Fig. 2、Eq. (1) |
| 3.5 Joint Optimization Objective | 语言建模、相关性与多样性损失 | p. 6,Eqs. (2)–(4) |
| 4.1 Dataset Construction;4.2 Evaluation Task Design | 语料、三个任务及知识划分 | pp. 6–7 |
| 4.3 Comparison of Different Data Volumes | 监督数据量与效果 | p. 7,Table 1 |
| 4.4 Memory Bank Hit Rate Analysis | 命中率与正确性的关系 | pp. 7–8,Fig. 3 |
| 4.5 Impact of Freeze Rate on Performance | 冻结比例消融 | pp. 8–9,Fig. 4 |
| 4.6 Impact of Perfect Retrieval on Model Performance | 注入正确记忆的干预实验 | p. 9,Table 2 |
| 5 Conclusion | 贡献及自动维护知识的后续方向 | p. 10 |
| References;A Appendix | 文献;复现与 AI 辅助声明 | pp. 10–12;附录 p. 12 |
一:动机——为事实建立可寻址的存储位置
参数化模型学到一个事实后,没有天然对应的数据库记录可供查看和改写。本文希望同时获得三种能力:查看存储内容、定点修改条目、追踪一次预测访问过的事实。作者据此提出把知识保存为 token ID 序列,由网络学习检索和使用这些序列。(Sec. 1,PDF pp. 1–3)
作者以双系统认知理论区分两类知识:事实和实体关系适合显式存储,语法、表达习惯和语义关联适合从数据中学习。这里应把这种划分理解为设计动机和容量分配规则。论文没有单独测量可更新条目是否确实只承载语法,或冻结条目是否完全承担事实知识;主干参数也仍然存在。(Sec. 3.1,PDF pp. 3–4)
与在输入前拼接检索文档的方式相比,本文的设计重点是让各层共享并访问记忆库,再用训练目标调整选择行为。文中多次把 RAG 描述为检索组件冻结的系统,这是作者用来组织对比的设定;本文实验的实际对照只有无记忆库 Transformer,不能由此得出对整个 RAG 方法类别的性能结论。
二:方法——可读条目、可训练寻址与固定容量更新
2.1 从输入到输出的数据流
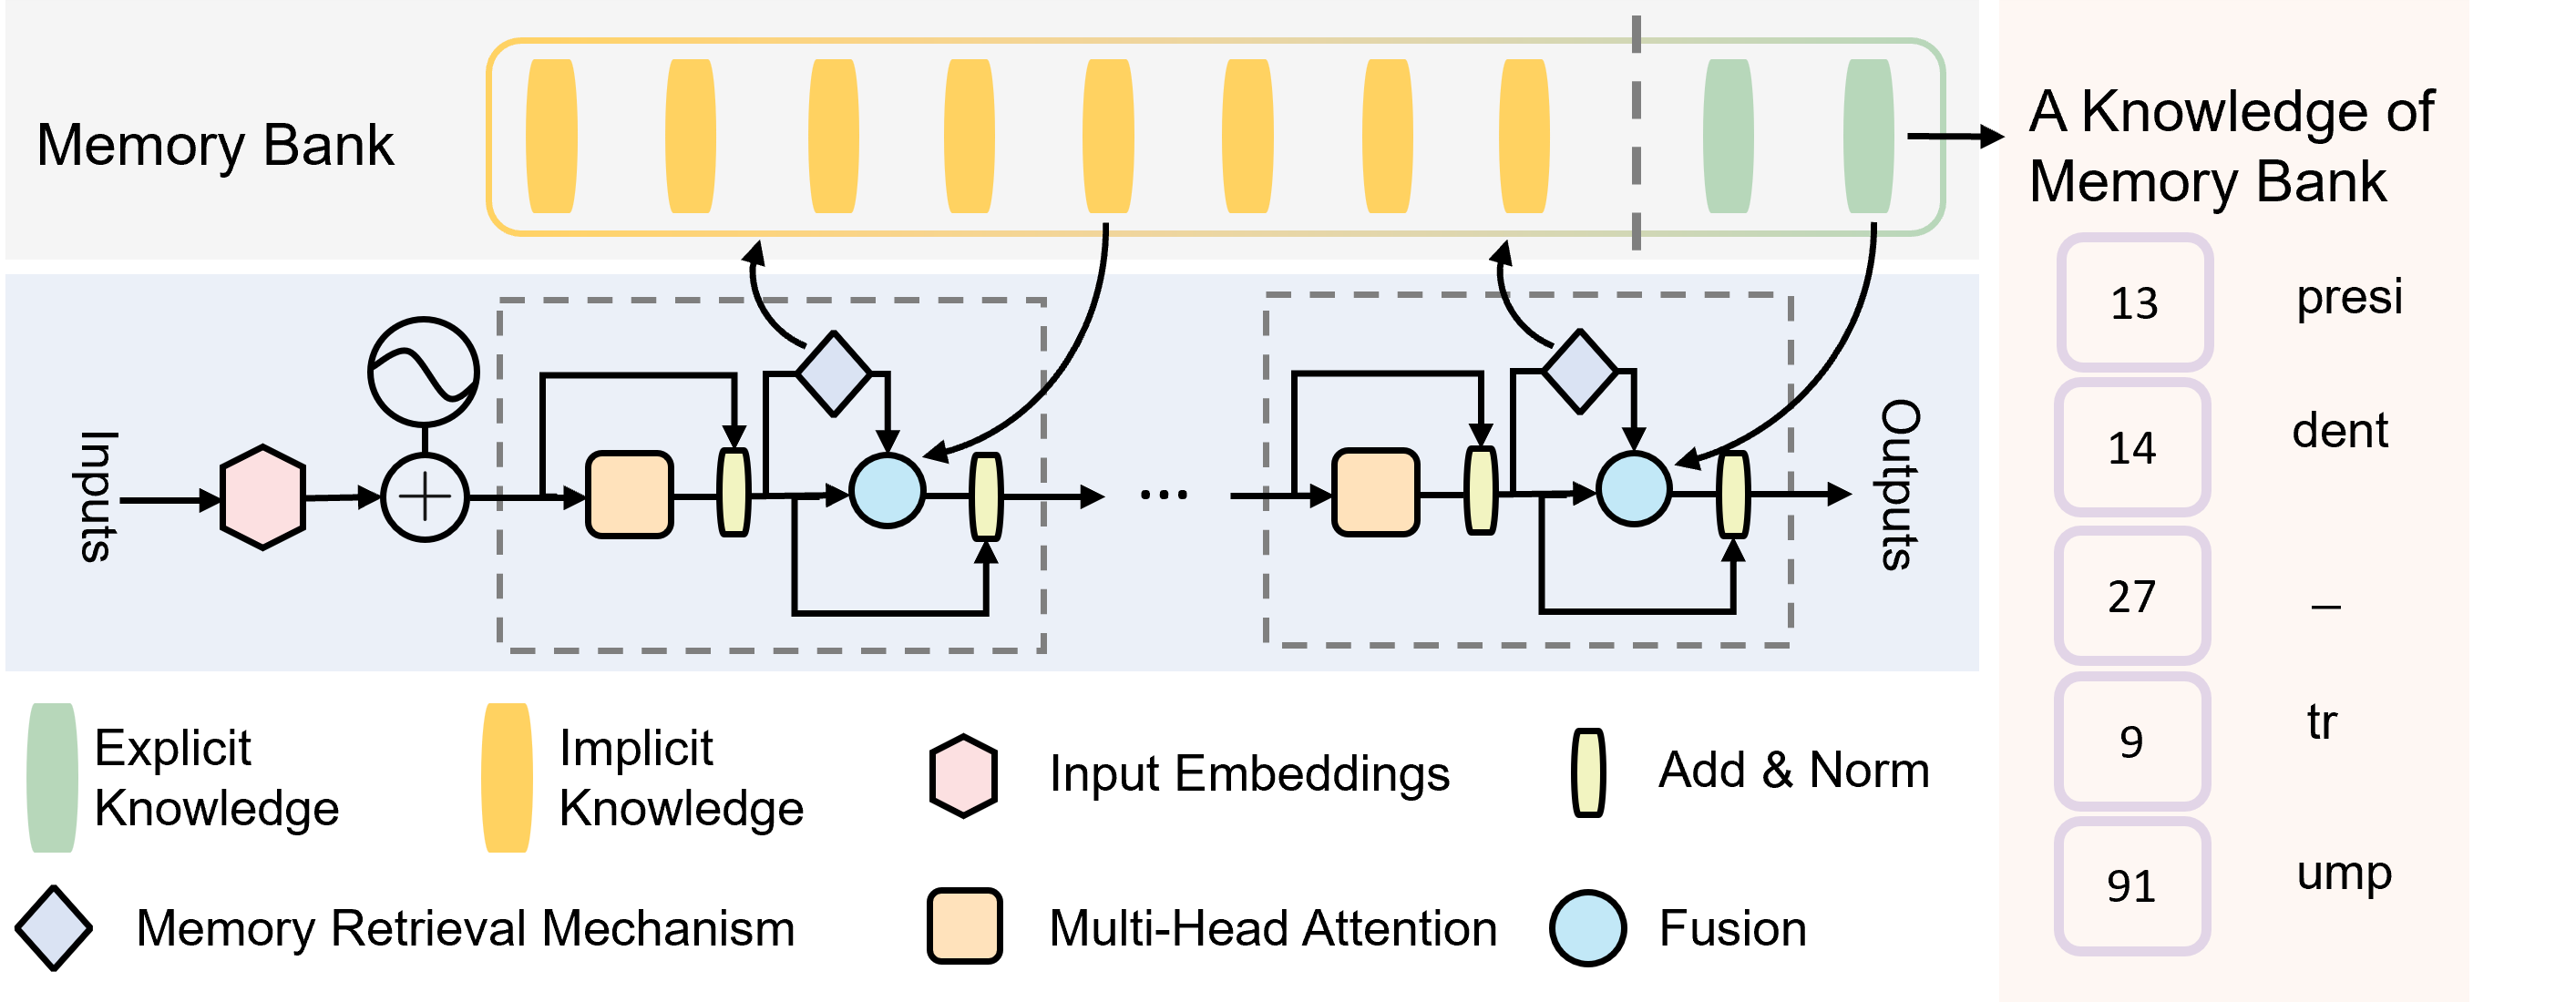
原图 Fig. 1,PDF p. 4。先看下方蓝色网络,再看上方灰色共享记忆库:绿色条目表示显式知识,黄色条目表示隐式知识;右侧示例说明一条记忆是 token ID 序列,可以解码成文本。图中的 Fusion 模块把检索结果引入层内计算。
一次读取可以概括为:
- 网络根据当前输入表示生成查询 $q(x)$。
- 在共享记忆库的键空间中筛出候选索引集合 $I$。
- 对候选打分并选择一个条目 $\mathbf m_{\hat i}$。
- 将该条目的 token ID 映射为嵌入,接入网络的融合模块。
- 后续网络计算产生预测,训练损失进一步调整检索相关参数。
“共享”指各层访问同一记忆库,不是每层各自保存一百万条事实。原文画出了融合模块,但没有给出融合算子、完整层块或逐 token 调用细节,因此不宜把它具体化成某一种门控加法、交叉注意力或确定的 FFN 替换实现。
2.2 记忆到底存什么
| 符号 | 含义与已知规格 |
|---|---|
| $\mathcal M$、$N$ | 记忆库及条目数;$N=10^6$ |
| $\mathbf m_i$、$L$ | 第 $i$ 条 token ID 序列;最大长度 $L=16$ |
| $\mathcal V$ | token 词表/码本,条目元素取自其中 |
| $d$ | 嵌入维度;正文未给具体数值 |
| $\mathbf E_i$ | 条目嵌入,按原文定义为 $d\times L$ 矩阵 |
| $\mathbf k_i$、$q(x)$ | 检索键和查询,均属于 $\mathbb R^d$ |
| $I$、$K$ | 候选集合;本笔记用 $K=\lvert I\rvert$ 简化解释 |
| $\rho$ | 冻结比例,默认 0.2 |
存储与嵌入过程为:
离散 ID 决定可以检查的文字内容;连续嵌入供模型计算使用。检索键 $\mathbf k_i$ 和存储内容 $\mathbf m_i$ 是不同对象:能够解码存储条目,不代表检索键本身是文本,也不代表一次检索完整解释了后续推理。(Sec. 3.2,PDF p. 4)
固定容量意味着始终保留 $N$ 个槽位,通过原位更新改变内容。一个有助于理解规模的估算是:若每个 ID 使用 32 位整数,仅 $10^6\times16$ 个 ID 约占 64 MB(十进制)。这是本次分析的存储量估算,不是论文的显存实测;键、词嵌入、训练状态和访问开销都未计入。
2.3 冻结区与更新区
默认 $\rho=0.2$,对应 20 万条冻结记忆、80 万条可更新记忆。冻结区初始化为经过筛选的事实,训练时不改写这些条目的内容;可更新区由训练适应数据中的模式。“冻结”是对训练过程的约束,与以后人工修改外部事实条目的设想并不冲突,也不意味着检索这些条目的所有相关参数都被冻结。(Sec. 3.3,PDF pp. 4–5)
作者提出借鉴 VQ-VAE 的指数移动平均(EMA),让新旧表示平滑过渡,避免直接覆盖造成突变。但这里有一个影响实现的缺口:存储对象是离散 token ID,EMA 通常作用于连续统计量。原文没有写出 EMA 更新方程、统计量的定义、衰减系数,或连续结果重新量化成 token ID 的过程。不能简单地对 token 编号取平均后认为得到了有意义的新知识。这个缺口也影响对“可学习条目始终人类可读”的判断。
2.4 第一阶段:乘积键把全库搜索拆成两个小搜索
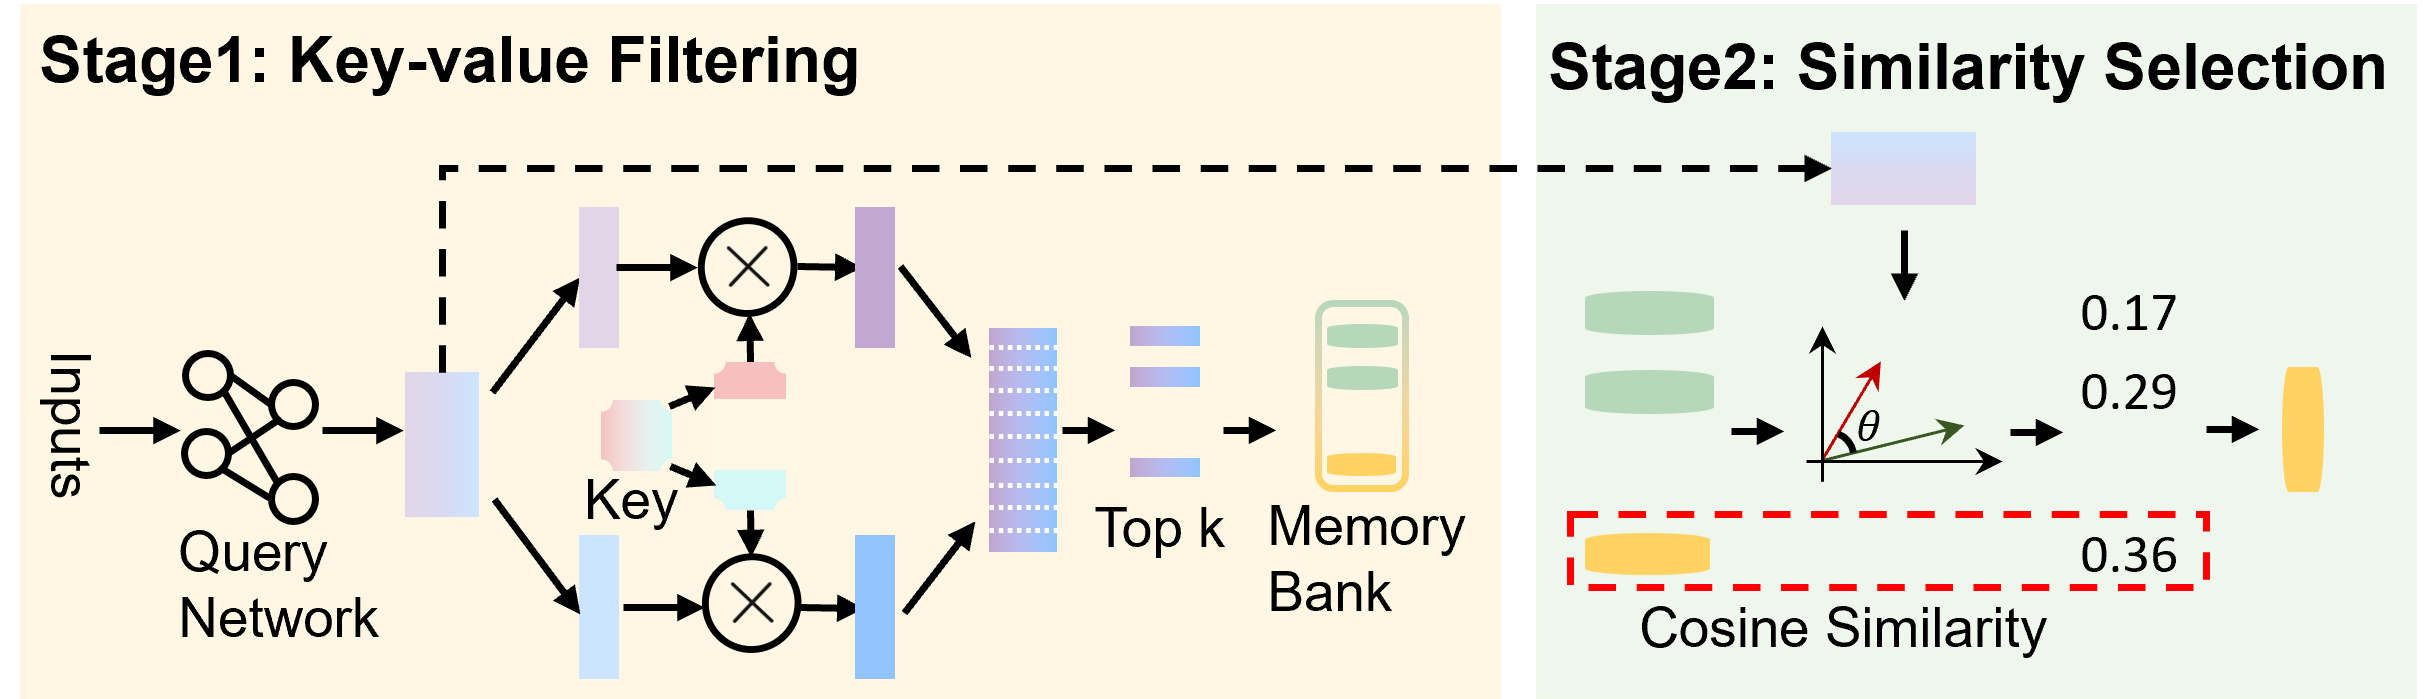
原图 Fig. 2,PDF p. 5。左侧先拆分 query/key 并生成 Top-k 候选;右侧在候选中比较相似度、选择条目。图中画的是选择直觉,训练时的随机扰动由 Eq. (1) 定义。
原文的候选选择目标是:
作者把完整键构造成两个子键集合的笛卡尔积:
以下为便于理解的展开,而非论文另列的算法:将 $q=[q^{(1)};q^{(2)}]$ 拆开后,
因此可以先计算两组子键分数,再组合高分项。对于 $N=10^6$,两个子键集合各有 1000 个元素,组合后可寻址一百万个槽位。若各自保留 $K$ 个高分子键,组合池有 $K^2$ 对;在可加打分且妥善处理并列分数的条件下,可从中选出全局 Top-$K$。Sec. 4.6 的干预实验明确提到 16 个候选,此时组合池为 256 对,16 个候选与每条记忆的 16 个 token 是两个独立概念。
论文报告复杂度由 $O(N|I|)$ 降为 $O(\sqrt N|I|)$。理解时应把它视为作者给出的检索阶段简化表达。按上面的计算展开,子键点积约需 $O(\sqrt N d)$,还需候选组合、Top-$K$ 选择及后续条目处理。它不构成端到端延迟提升的实测,更不能直接解释为整模型加速 1000 倍。(Sec. 3.4,PDF p. 5)
2.5 第二阶段:硬选择与软梯度
候选的余弦分数及 Gumbel 扰动为:
论文 Eq. (1) 定义:
前向读取 $\mathbf m_{\hat i}$,保留可追踪的离散条目;反向使用软分布的梯度。$\tau>0$ 是温度,较低温度使软权重更尖锐。对于给定分数和噪声,正温度不改变 $\arg\max$ 的位置;它主要改变软分布及反向梯度。训练中加入了噪声,因此前向选择也不一定是未经扰动的余弦最大项。(Sec. 3.4,PDF p. 5)
直通估计的教学写法。 令 $h_i$ 是选中条目的 one-hot 权重,$\operatorname{sg}$ 表示停止梯度:
这里 $v_i$ 暂指用于融合的条目向量,属于补充解释中的符号,并不假定作者使用了某个具体池化器。前向 $z_i=h_i$,所以 $y=v_{\hat i}$;反向保留 $p_i$ 对打分和查询的依赖。固定候选集合、噪声和条目向量时,关键 Jacobian 是:
原文随后给出的 $\partial\mathcal L/\partial q(x)=\sum_i p_i\,\partial\mathcal L/\partial\mathbf m_i$ 省略了这些链式导数,并把离散 ID 当作求导对象,不能直接当作可实现的梯度公式。此外,第二阶段的软化并没有消除第一阶段 Top-$K$ 候选索引的离散性。更准确的理解是:对已选候选内的选择使用梯度近似,而不是全库所有地址都获得光滑梯度。
原文没有明确说明推理时是否去掉 Gumbel 噪声、温度如何设置,因此“推理确定性取余弦最大项”只能是可能的实现选择,不是论文已确认的协议。
2.6 联合目标:回答正确、记忆相关、候选多样
总损失为:
语言建模损失要求使用上下文和记忆预测下一个 token:
相关性损失鼓励选择与 query 相近的记忆:
多样性损失鼓励候选之间不要全部相似:
这三项对应不同目标:语言建模损失负责最终预测,相关性损失把查询与内容对齐,多样性损失缓解反复访问少数相近记忆的倾向。多样性过强又会与相关性竞争,所以权重会影响实际折中。(Sec. 3.5,PDF p. 6)
上述公式有两个实质性的表达问题。第一,Sec. 3.2 把 $\mathbf E_i$ 定义为 $d\times L$ 矩阵,Eq. (3) 却把它当作能与 $d$ 维 query 计算标量余弦的向量;需要一个聚合或编码步骤,但原文没有定义。第二,Eq. (4) 的双重求和遍历有序对,系数 $2/[K(K-1)]$ 会得到通常成对平均余弦的两倍;标准平均应使用无序对配该系数,或有序对配 $1/[K(K-1)]$。这不改变正则项的优化方向,但会影响其有效权重。原文也没有给出两个 $\lambda$ 的取值。
2.7 一个贯穿机制的例子
以下是教学例子:若记忆保存“France — capital — Paris”,问题是“法国首都是哪里”,query 应把相关条目召回到候选集合,再选择其嵌入帮助输出 Paris。人工把某个可变事实条目的内容改掉,是存储层面的操作;模型能否立即采用新内容,仍取决于键是否匹配、融合是否有效、参数中旧知识是否干扰。这也解释了为什么“能够编辑条目”与“已经验证可靠知识更新”是两个需要分别评测的能力。
三:实验——测试模型能否使用库内事实
3.1 语料与知识来源
作者构建 1000 万条(10M-entry) 多来源预训练语料,不应把这个数字读成 1000 万 token。Wikipedia 提供带实体三元组的百科知识,也是记忆库初始化的唯一来源;Project Gutenberg 提供文学与历史文本;OpenWebText 提供当代网络表达。条目通过 UUID 关联来源,筛选时考虑信息密度、事实可靠性和领域覆盖。(Sec. 4.1,PDF p. 6)
因此需要区分三个规模:预训练语料 10M 条、记忆库 1M 条、实验变化的 SFT 数据量 10k–100k 个样本。前两者不是 Table 1 中横向变化的变量。
3.2 三个任务与评价口径
| 任务 | 输入与输出 | 衡量能力与指标 |
|---|---|---|
| 对象预测(Object Prediction) | 给定主语、关系,预测对象;原文称含 5 个干扰项 | 精确事实召回;准确率,越高越好 |
| 关系推断(Relation Reasoning) | 给定实体对,推断语义关系 | 实体关系识别;准确率,越高越好 |
| 事实验证(Fact Verification) | 判断陈述真伪,负样本由 token 替换构造 | 二分类;正负比例 50:50,准确率越高越好 |
来源:Sec. 4.2,PDF p. 7。作者把关系任务解释为组合推理探针,但给出的任务定义主要是实体对到关系,没有展示多跳推理基准或完整推理链。
数据划分利用冻结区:测试样本只来自 $\mathcal M_f$,训练按原文表述排除这些条目的 token。作者意图隔离训练事实和测试事实,但没有细化这一约束在预训练与 SFT 各阶段的执行方式。测试事实仍作为检索内容提供给 ExplicitLM,因而实验主要考察模型能否取用外部记忆所提供的知识。这种协议符合记忆增强系统的用途;要进一步判断层内检索是否优于别的取用方式,需要让对照模型也能访问同一知识库。
对象预测的计分还有一个需要澄清的细节:如果“5 个干扰项”意味着标准六选一,均匀随机准确率应为约 16.67%,而 10k 基线报告 7.86%。这个数字本身不能证明实验错误,但候选构造、输出约束或 token 计分方式需要更完整说明,才能解释这组低数据结果。
3.3 对照和可解释范围
Table 1 比较无记忆库 Transformer 和 ExplicitLM,作者称两者采用相同优化过程,并改变 SFT 数据量。论文没有给出足以确认参数量或计算预算匹配的模型规格,也没有 RAG、仅冻结记忆、去除某项辅助损失等对照。已提供的主要消融是冻结比例和 oracle 记忆替换。(Sec. 4.3–4.6,PDF pp. 7–9)
附录 A.1 说明实验使用 NVIDIA A100,并给出一个匿名代码仓库地址。正文和附录没有列出模型参数量、优化器设置、温度日程、EMA 细节、测试集大小和多次训练误差条。因此,结果适合用来判断作者所构造任务上的趋势,尚不足以量化大规模部署的速度、资源或稳定性收益。
四:结果——召回收益最强,检索质量仍有影响
4.1 数据量变化:对象预测在全部规模上获益
下表复列 Table 1 的准确率(%,越高越好);每格为“基线 → ExplicitLM”。
| SFT 样本量 | 对象预测 | 关系推断 | 事实验证 |
|---|---|---|---|
| 10k | 7.86 → 28.42 | 38.27 → 70.02 | 61.71 → 66.03 |
| 25k | 22.16 → 63.12 | 79.99 → 87.85 | 71.49 → 79.79 |
| 50k | 30.23 → 73.90 | 83.80 → 90.41 | 83.34 → 86.25 |
| 75k | 40.64 → 79.76 | 87.66 → 92.12 | 86.40 → 88.74 |
| 100k | 56.80 → 80.94 | 91.91 → 92.73 | 88.92 → 89.75 |
来源:Sec. 4.3、Table 1,PDF p. 7。
对象预测的优势最持续。 绝对增益依次为 20.56、40.96、43.67、39.12、24.14 个百分点。50k 的差值最大,但 10k 的准确率比值最大:$28.42/7.86\approx3.62$。这与外部记忆适合精确读取实体事实的解释一致;“低数据收益大”应区分倍数和百分点两种口径。
关系推断的优势随监督数据增加明显收窄。 10k 时提高 31.75 个百分点,准确率是基线的约 1.83 倍;100k 时仅提高 0.82 个百分点。事实验证的差值总体更小,100k 时为 0.83 个百分点。也就是说,不能把对象预测的最大增益代表成每个任务在充分数据下都能获得的收益。
两个数值细节会影响引用:摘要“43.67% improvement”对应 $73.90-30.23=43.67$ 个百分点,相对基线的增幅实际约为 144.46%;Table 1 的 25k 事实验证红字标为 8.33%,但按两行准确率计算应为 $79.79-71.49=8.30$ 个百分点。这里保留原始准确率,差值按其计算。
4.2 命中率:读到相关事实的样本更容易答对
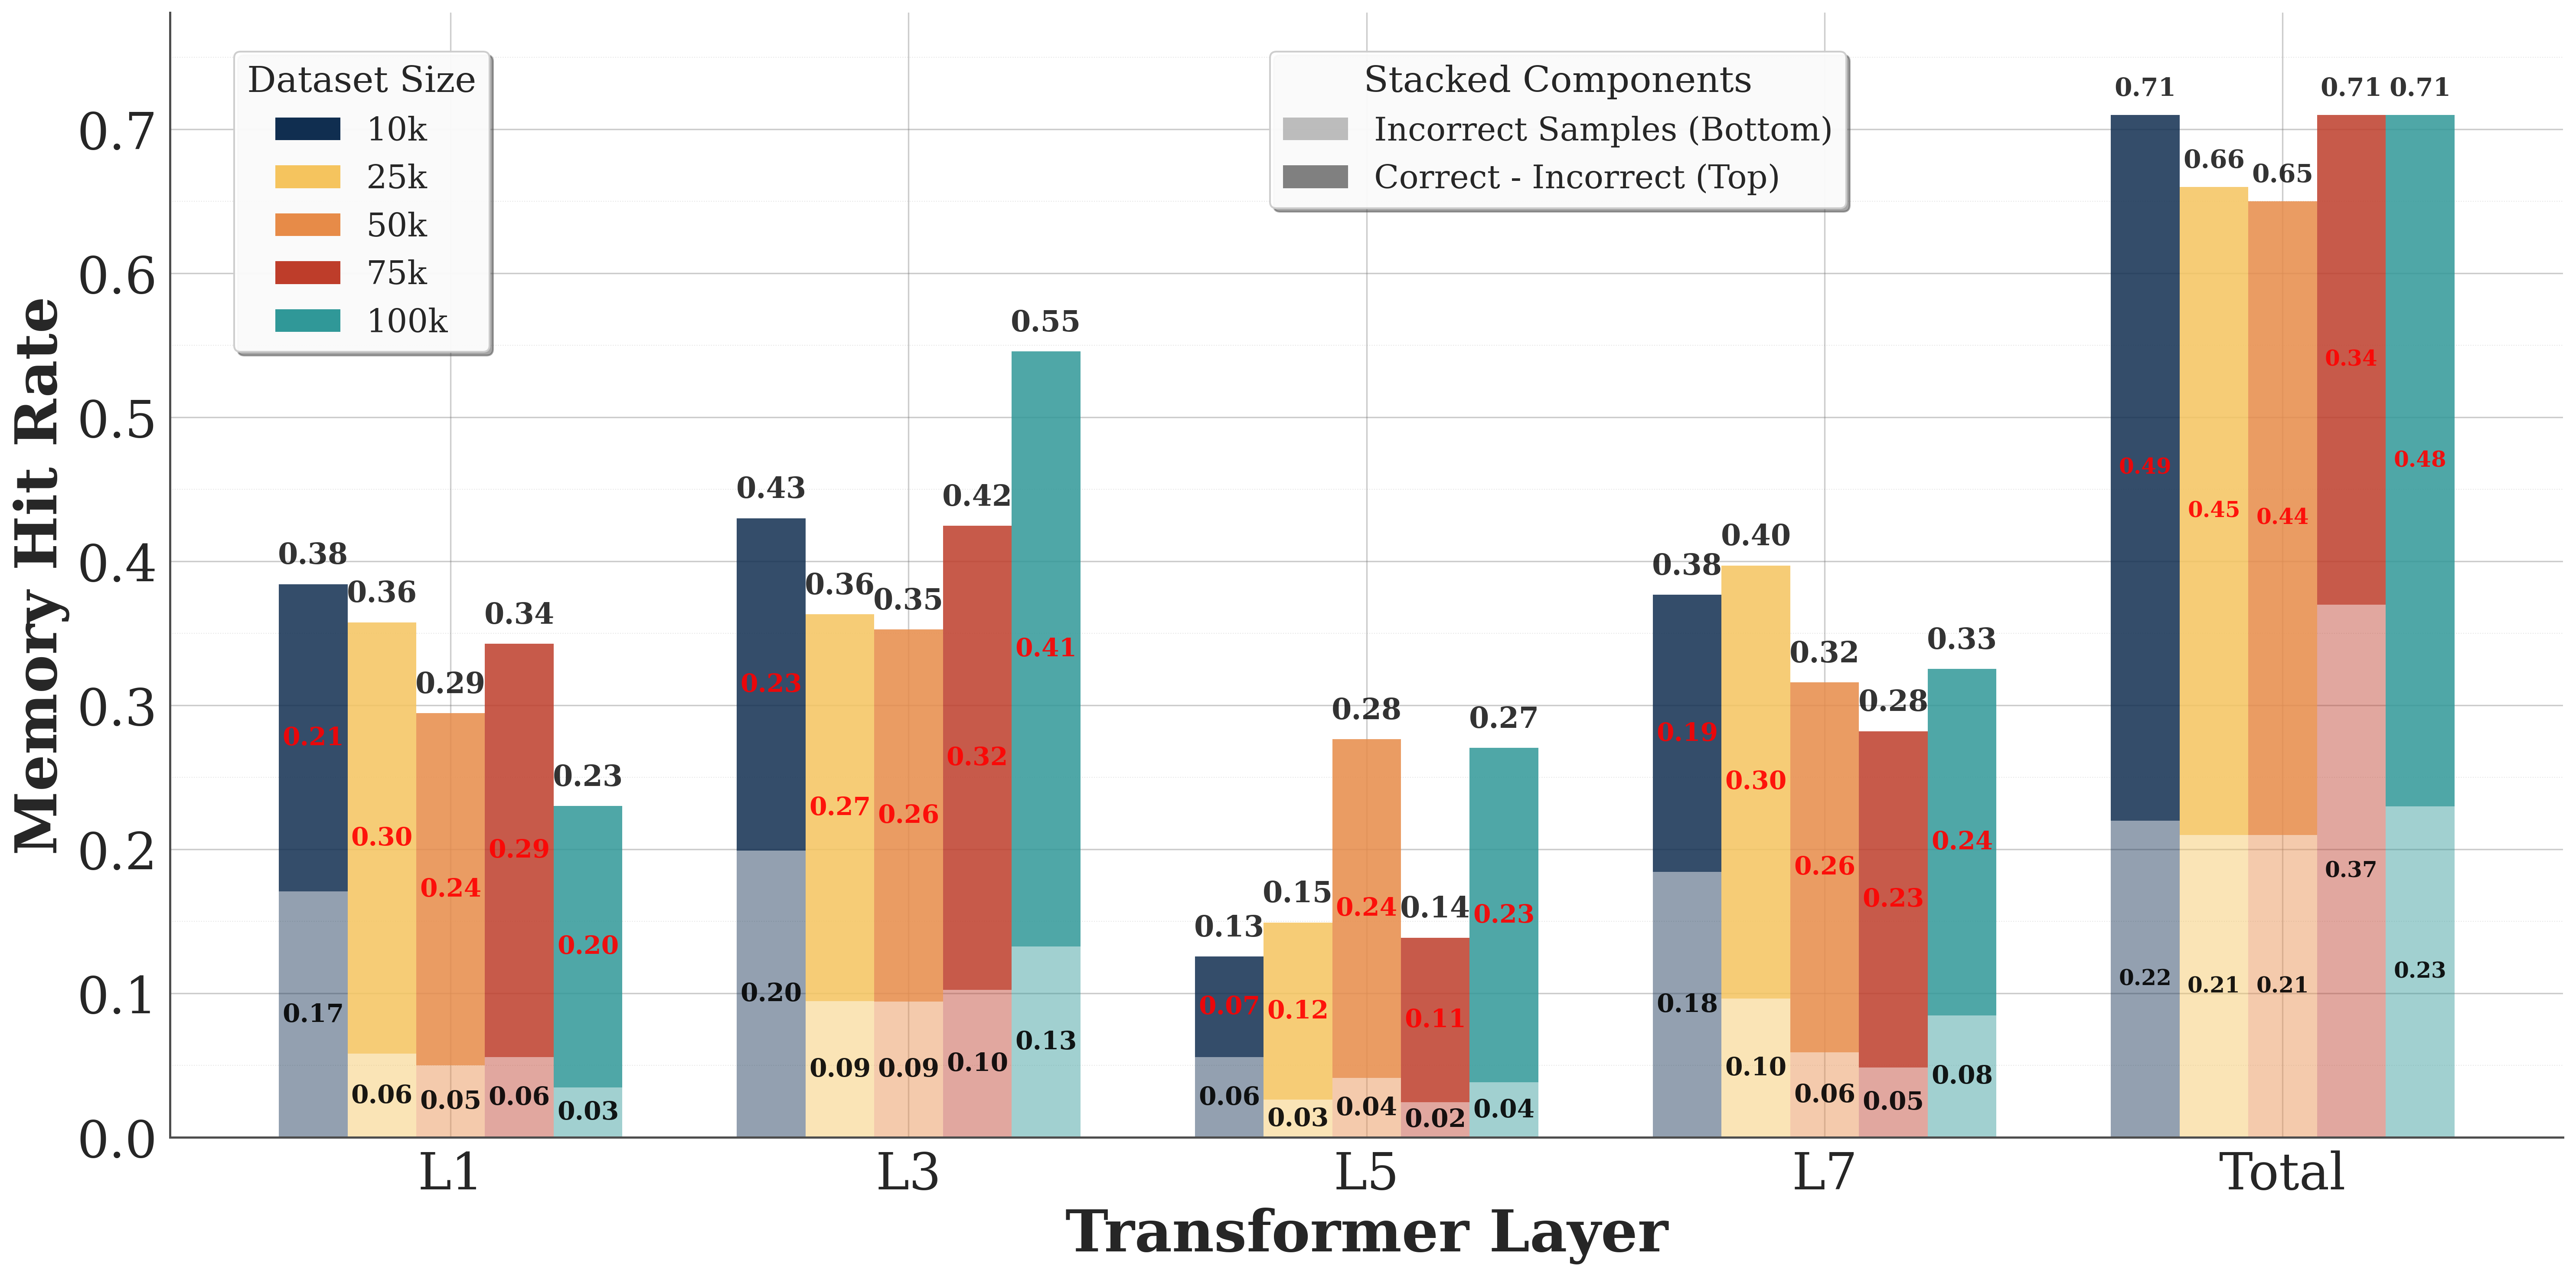
原图 Fig. 3,PDF p. 8。横轴是 L1、L3、L5、L7 和 Total,纵轴是命中率,颜色区分数据量。按图内图例,柱子的下部表示错误样本命中率,上部表示“正确减错误”的差值,因此整根柱子的高度才是正确样本命中率。这是两个条件比例的比较,不应把两个色段理解为两类样本所占比例。Total 指至少一层命中,不是各层命中率的平均或相加。
按图内标签读取 Total:
| SFT 样本量 | 正确样本命中率 | 错误样本命中率 | 差值(百分点) |
|---|---|---|---|
| 10k | 71% | 22% | 49 |
| 25k | 66% | 21% | 45 |
| 50k | 65% | 21% | 44 |
| 75k | 71% | 37% | 34 |
| 100k | 71% | 23% | 48 |
需要以图为准处理两个原文不一致:Sec. 4.4 的文字把最后一组写成 5k,而图例是 75k;图注的透明度说明也与图内“底部是错误样本、顶部是差值”的图例不一致。上述表格采用图中数据量标签和数值标注,不将其说成另有一组 5k 实验。
摘要中的“49% higher hit rates”对应 10k 的 49 个百分点。这些数据估计的是 $P(\mathrm{hit}\mid\mathrm{correct})$ 和 $P(\mathrm{hit}\mid\mathrm{incorrect})$,不是命中后准确率 $P(\mathrm{correct}\mid\mathrm{hit})$;比较支持检索与正确性的相关性,因果作用还需看下一组干预实验。
作者强调 L1 和 L3 的知识整合作用。图中 L3 对 100k 正确样本确实达到 0.55,但 L7 在 25k 达到 0.40,高于该组 L1 的 0.36 和 L3 的 0.36。因此较稳妥的观察是不同深度的检索行为有差异,L3 较突出,关键层模式并非所有设置完全一致。(Sec. 4.4,PDF pp. 7–8)
4.3 冻结率:默认 0.2,多个设置在 0.4 更好
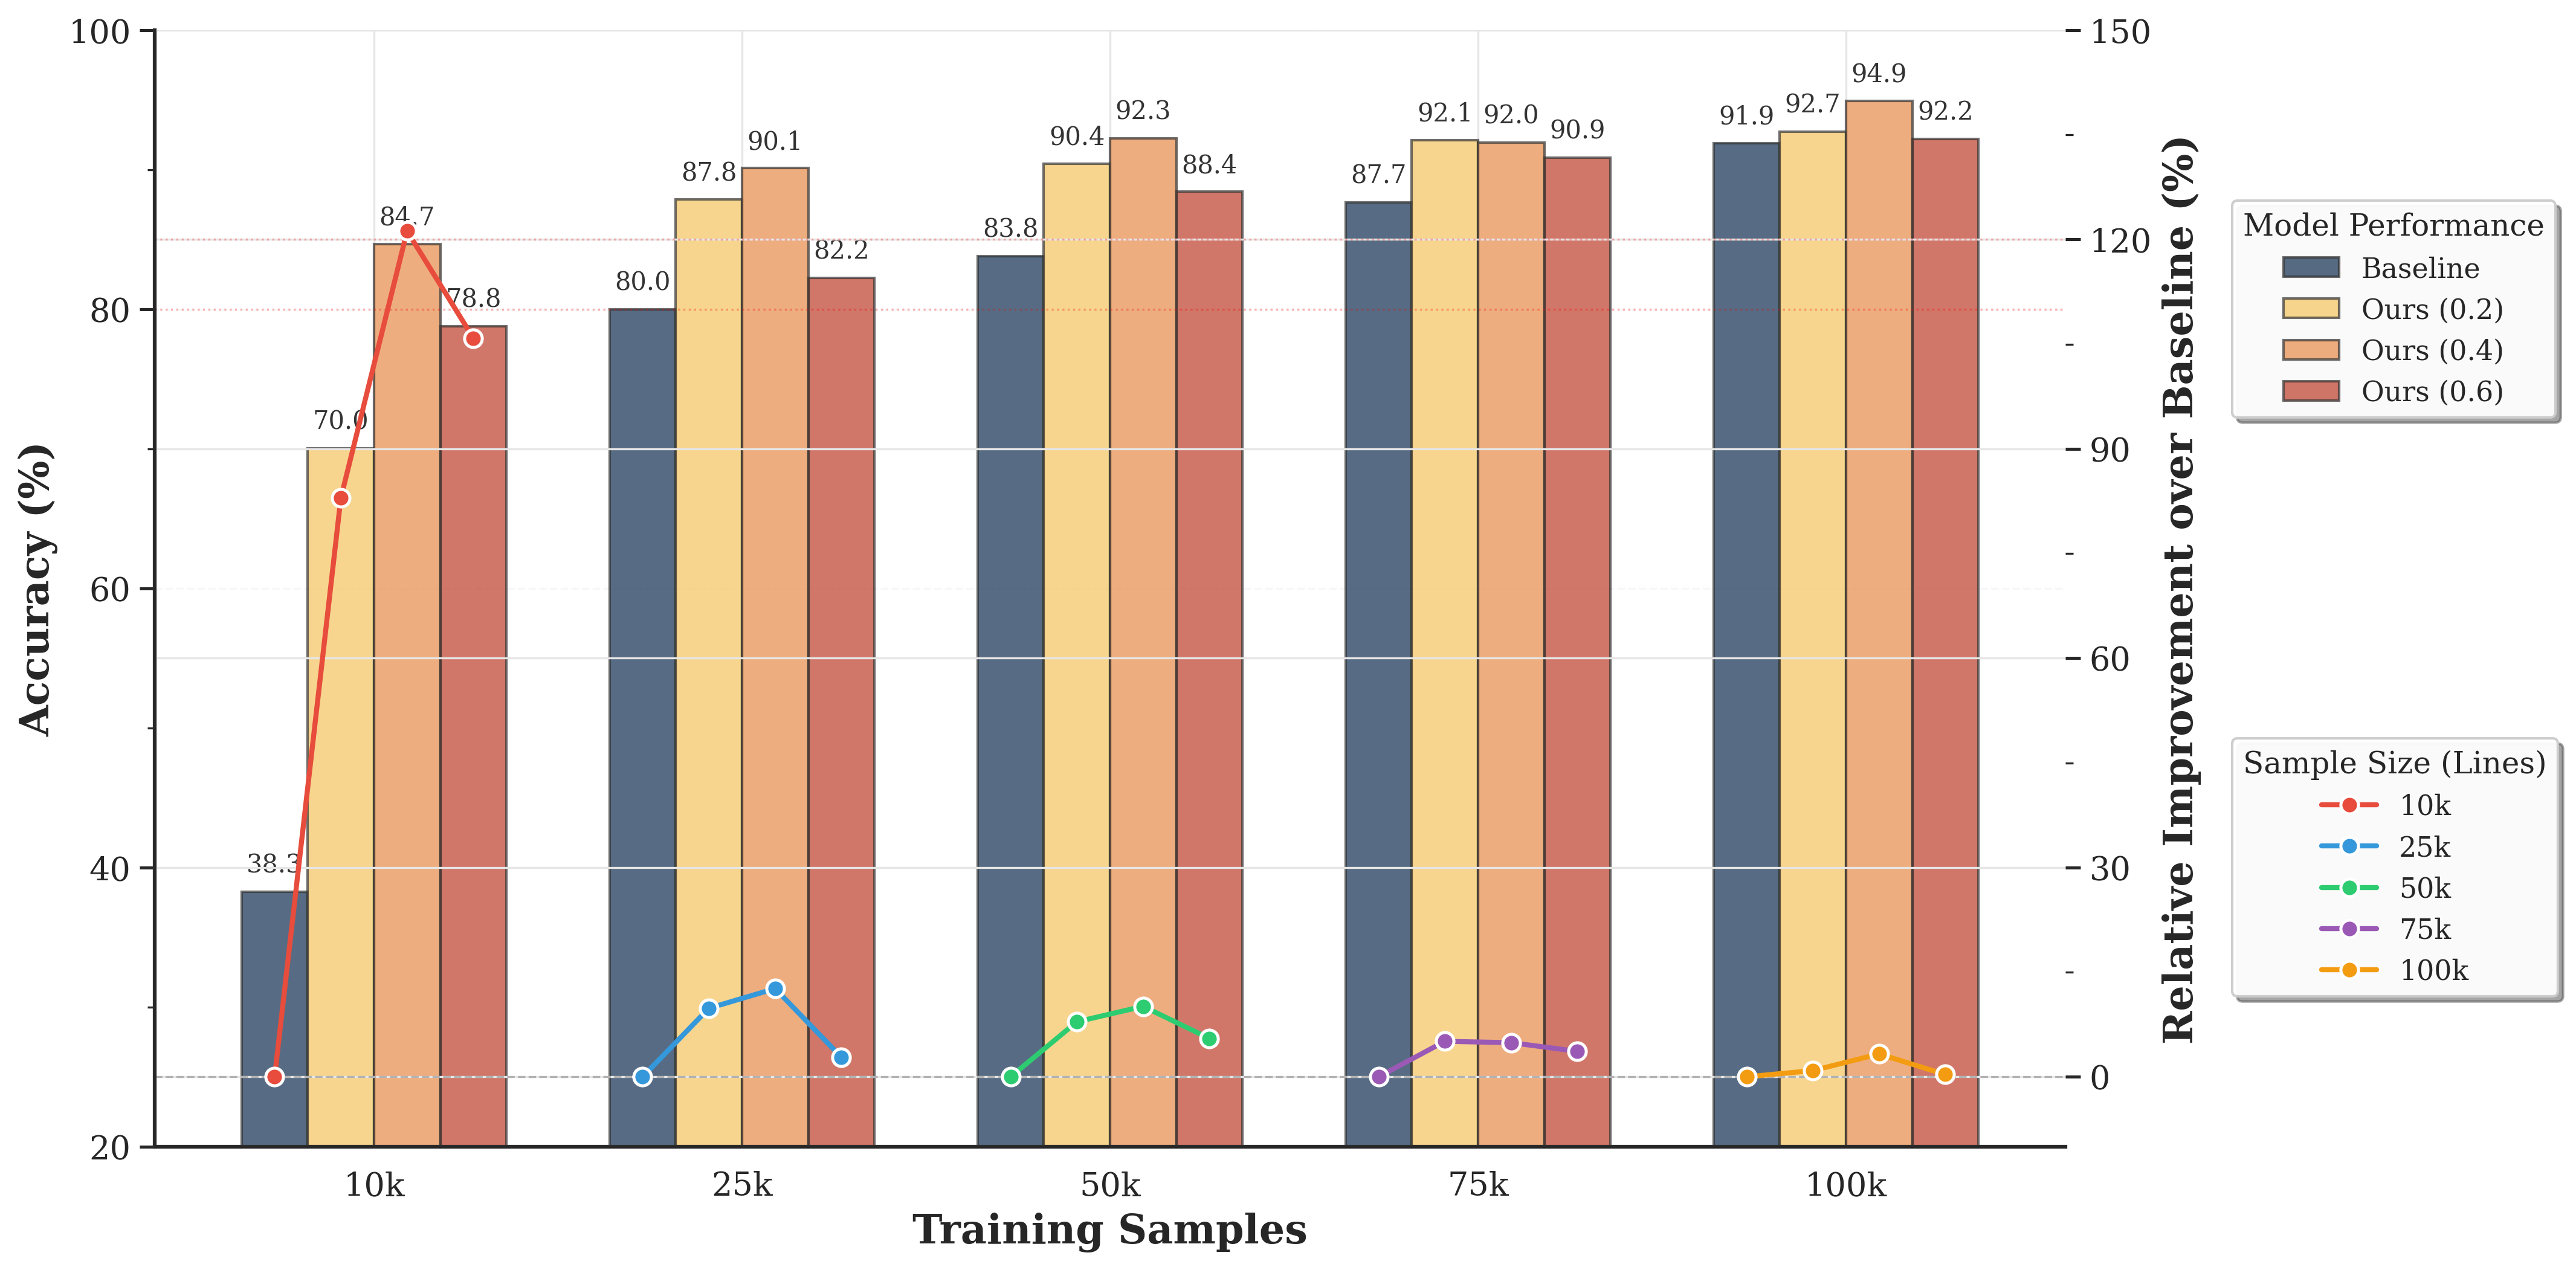
原图 Fig. 4,PDF p. 9。横轴按训练样本量分组;左轴柱形是准确率,颜色对应基线和 $\rho=0.2,0.4,0.6$;右轴折线是相对基线提升百分比。折线的相对百分比不能与 Table 1 的准确率差值混用;左轴从 20% 开始,视觉比较应结合数字。
以下数值直接取自图中一位小数标签,精度不同于 Table 1。
| SFT 样本量 | 基线 | $\rho=0.2$ | $\rho=0.4$ | $\rho=0.6$ |
|---|---|---|---|---|
| 10k | 38.3 | 70.0 | 84.7 | 78.8 |
| 25k | 80.0 | 87.8 | 90.1 | 82.2 |
| 50k | 83.8 | 90.4 | 92.3 | 88.4 |
| 75k | 87.7 | 92.1 | 92.0 | 90.9 |
| 100k | 91.9 | 92.7 | 94.9 | 92.2 |
全部展示的记忆配置优于各自基线,0.4 在五个数据规模中的四个最好;75k 下 0.2 略高。10k 时,0.4 比默认 0.2 高 14.7 个百分点,说明冻结比例在低数据设置下具有实质影响,不能仅因所有设置都胜过基线就称其对超参数不敏感。(Sec. 4.5,PDF pp. 8–9)
作者把非单调关系解释为“保存稳定知识”与“保留可学习空间”的折中,这是与架构一致的解释。一个实验设计上的未决点是:Sec. 4.2 让测试事实来自 $\mathcal M_f$,改变 $\rho$ 同时改变冻结容量。论文没有说明冻结率消融是否始终保持同一个测试集和相同事实覆盖,所以曲线不能完全归因于优化稳定性。
4.4 正确记忆替换:更好的检索确实还能带来收益
实验在 L1 和 L3,把 16 个检索候选中的最高排名项换成与正确答案最相关的 oracle 条目。Retain 保留原检索,Replace 使用上述干预。它测量的是已知正确知识注入后的表现变化。(Sec. 4.6、Table 2,PDF p. 9)
| SFT 样本量 | 对象预测:Retain → Replace | 关系推断:Retain → Replace | 事实验证:Retain → Replace |
|---|---|---|---|
| 50k | 70.87 → 74.49 | 89.87 → 92.12 | 85.12 → 87.24 |
| 75k | 77.12 → 79.85 | 90.25 → 91.87 | 88.00 → 90.25 |
| 100k | 79.12 → 81.00 | 90.50 → 92.25 | 90.37 → 91.12 |
九个比较的平均增益为 2.11 个百分点。50k 时平均提高 2.66 个百分点,其中对象预测提高 3.62;100k 时平均增益降至 1.46 个百分点。这个干预比命中率相关性更直接地支持“改善检索内容能够改善预测”。
两点限定决定其解释。首先,Table 2 的 Retain 不等于 Table 1 同数据量的 ExplicitLM,例如 50k 对象预测分别是 70.87% 和 73.90%,原文未解释配置或运行差异,因此应在 Table 2 内配对比较。其次,该干预只替换两个层的一个候选,依赖已知正确答案来指定 oracle;它是一个有利检索条件下的诊断,不是对所有可能检索器的严格性能上界。
更好的记忆输入只带来有限增益,也提醒我们注意后续知识使用过程:检索到事实以后,融合模块、任务映射和输出过程仍会影响最终正确率。作者把高数据量下收益缩小解释为模型学会补偿检索误差,这是一种可能机制,实验未把该机制单独分离出来。
五:结论——架构方向有价值,证据重心是知识取用
ExplicitLM 提供了一种清晰的设计组合:用 token 序列建立可查看的知识槽位,用乘积键控制百万条目的候选搜索成本,用直通 Gumbel-Softmax 连接离散选择与训练目标,并通过冻结区保留外部提供的事实。它把“事实放在哪里、何时读出、如何影响预测”变成了可以分别研究的问题。
实验中最扎实的证据是三个库内知识任务的准确率提升,以及 oracle 替换带来的进一步增益。论文标题中的“解耦”更适合理解为把部分事实移到独立存储接口:主干网络和可更新记忆仍会携带知识,实验没有测量解耦程度;检索轨迹提供了可观察的访问记录,但尚未验证完整推理解释的忠实性。
下一步最能加强论文主张的实验有三类:
- 同知识条件比较。 让 RAG、上下文拼接或其他记忆层访问完全相同的事实,匹配主干和预算,分离额外信息与检索架构的贡献。
- 实际编辑实验。 固定模型参数,替换某条旧事实,测试目标回答是否更新、相关改写问题是否一致,以及其他事实是否受损;这比只测“读到已有事实”更直接对应知识更新动机。
- 补全实现并测量代价。 明确 EMA 如何回写 token、条目如何聚合与融合,再报告检索延迟、显存、规模变化以及辅助损失的消融,检验可读性、效率和学习能力能否同时保留。
作者在结论中也承认显式条目仍依赖人工整理,并把自动抽取、自动更新且保持可读性作为后续方向。对研究者而言,这篇论文适合用作“可编辑文本记忆嵌入网络计算”的原型思路,其数据更充分地展示了取用预置事实的效果。(Sec. 5,PDF p. 10)