How Reinforcement Learning After Next-Token Prediction Facilitates Learning:中文精读笔记
作者:Nikolaos Tsilivis、Eran Malach、Karen Ullrich、Julia Kempe
论文:arXiv:2510.11495v2,2025-12-16 修订;本次获取:2026-10-25
原文:本地 PDF · arXiv PDF
论文总览
论文问的是:为什么少量正确的长推理示范已经存在于训练数据中时,下一词预测(next-token prediction, NTP)仍可能给出糟糕的贪心答案,而随后的强化学习(reinforcement learning, RL)却能很快提升正确率并使回答变长? 作者用短答案与完整计算轨迹的混合分布建立可分析的模型。对于 $d$ 位奇偶校验任务,预训练先学会长轨迹中的逐步计算,但在长轨迹比例 $p_{\mathrm{cot}}<1/3$ 时,贪心解码偏向短而错误的路线。对模型生成的正确答案施加奖励后,正确长轨迹比正确短答案更容易出现,于是它们在下一轮训练中的权重上升;长度增长和准确率跃升由此相连。理论在一个逐位置线性自回归模型上证明这一机制;从零训练的 Transformer、乘法任务和 Llama 数学基准提供相应的实验证据。这里的理论保证适用于简化模型与特定奖励,不能直接代入一般 LLM 的 GRPO 训练。原文 §1–§5,PDF pp. 1–12
结构地图
| 原文部分 | 作用 | PDF 定位 |
|---|---|---|
| §1 Introduction | 提出稀有长示范、预训练与 RL 的问题 | pp. 1–3;图 1 在 p. 2 |
| §2 Setup: Mixture of Long and Short Sequences Encoding Parity | 定义奇偶校验数据、模型、两类奖励 | pp. 3–4 |
| §3 Experiments on Parity | 比较预训练和后训练,解释长度增长 | pp. 4–7;图 2 p. 5、图 3 p. 6 |
| §4 Theory | 线性自回归模型、定理 1/2 与 $1/3$ 门槛 | pp. 7–9;定理 1 p. 8、定理 2 p. 9 |
| §5 Experiments with Mathematical Reasoning Benchmarks | 乘法、GSM8K 与 MATH | pp. 9–12;图 5 p. 11 |
| §6 Discussion | 贡献与适用条件 | p. 12 |
| Appendix A–D | 算法、实验配置、补充实验和证明 | pp. 17–81;正式证明 pp. 53–81 |
一:动机与研究问题
作者把训练分为两段:先用教师给出的答案序列做下一词预测,再按生成结果的正确性做奖励驱动的更新。核心简化是假设训练数据对同一任务已有少量正确、完整的推理轨迹。这一假设让“RL 是否发现新算法”变成更精确的问题:模型是否已经从少量长示范学会逐步求解,但因训练混合比例与解码选择,暂时无法在常用的贪心推理中表现出来?如果是,奖励怎样改变输出的长短比例?§1,PDF pp. 1–3
奇偶校验特别适合分辨两种作用。对 $x_i\in\{-1,+1\}$,目标 $f(x)=\prod_{i=1}^{d}x_i$。一步从全部输入直接预测这个乘积,对所研究的训练方式很难;有中间结果 $s_j=\prod_{i=1}^{j}x_i$ 时,只需反复计算 $s_j=s_{j-1}x_j$。而且奇偶校验本身可由浅层 Transformer 表示,因此实验中预训练失败主要指向有限训练样本下的学习难度,而非该任务必然需要长输出才能被网络表示。乘法与数学题再检验更深的逐步计算场景。§2、§3.1、§5,PDF pp. 3–6、9–12
二:混合分布、训练与机制
2.1 同一输入的两种正确示范
令 $Z\sim\operatorname{Ber}(p_{\mathrm{cot}})$,$x_i$ 独立均匀取 $\pm1$。论文中的 $\mathcal D(p_{\mathrm{cot}})$ 产生两类输出:
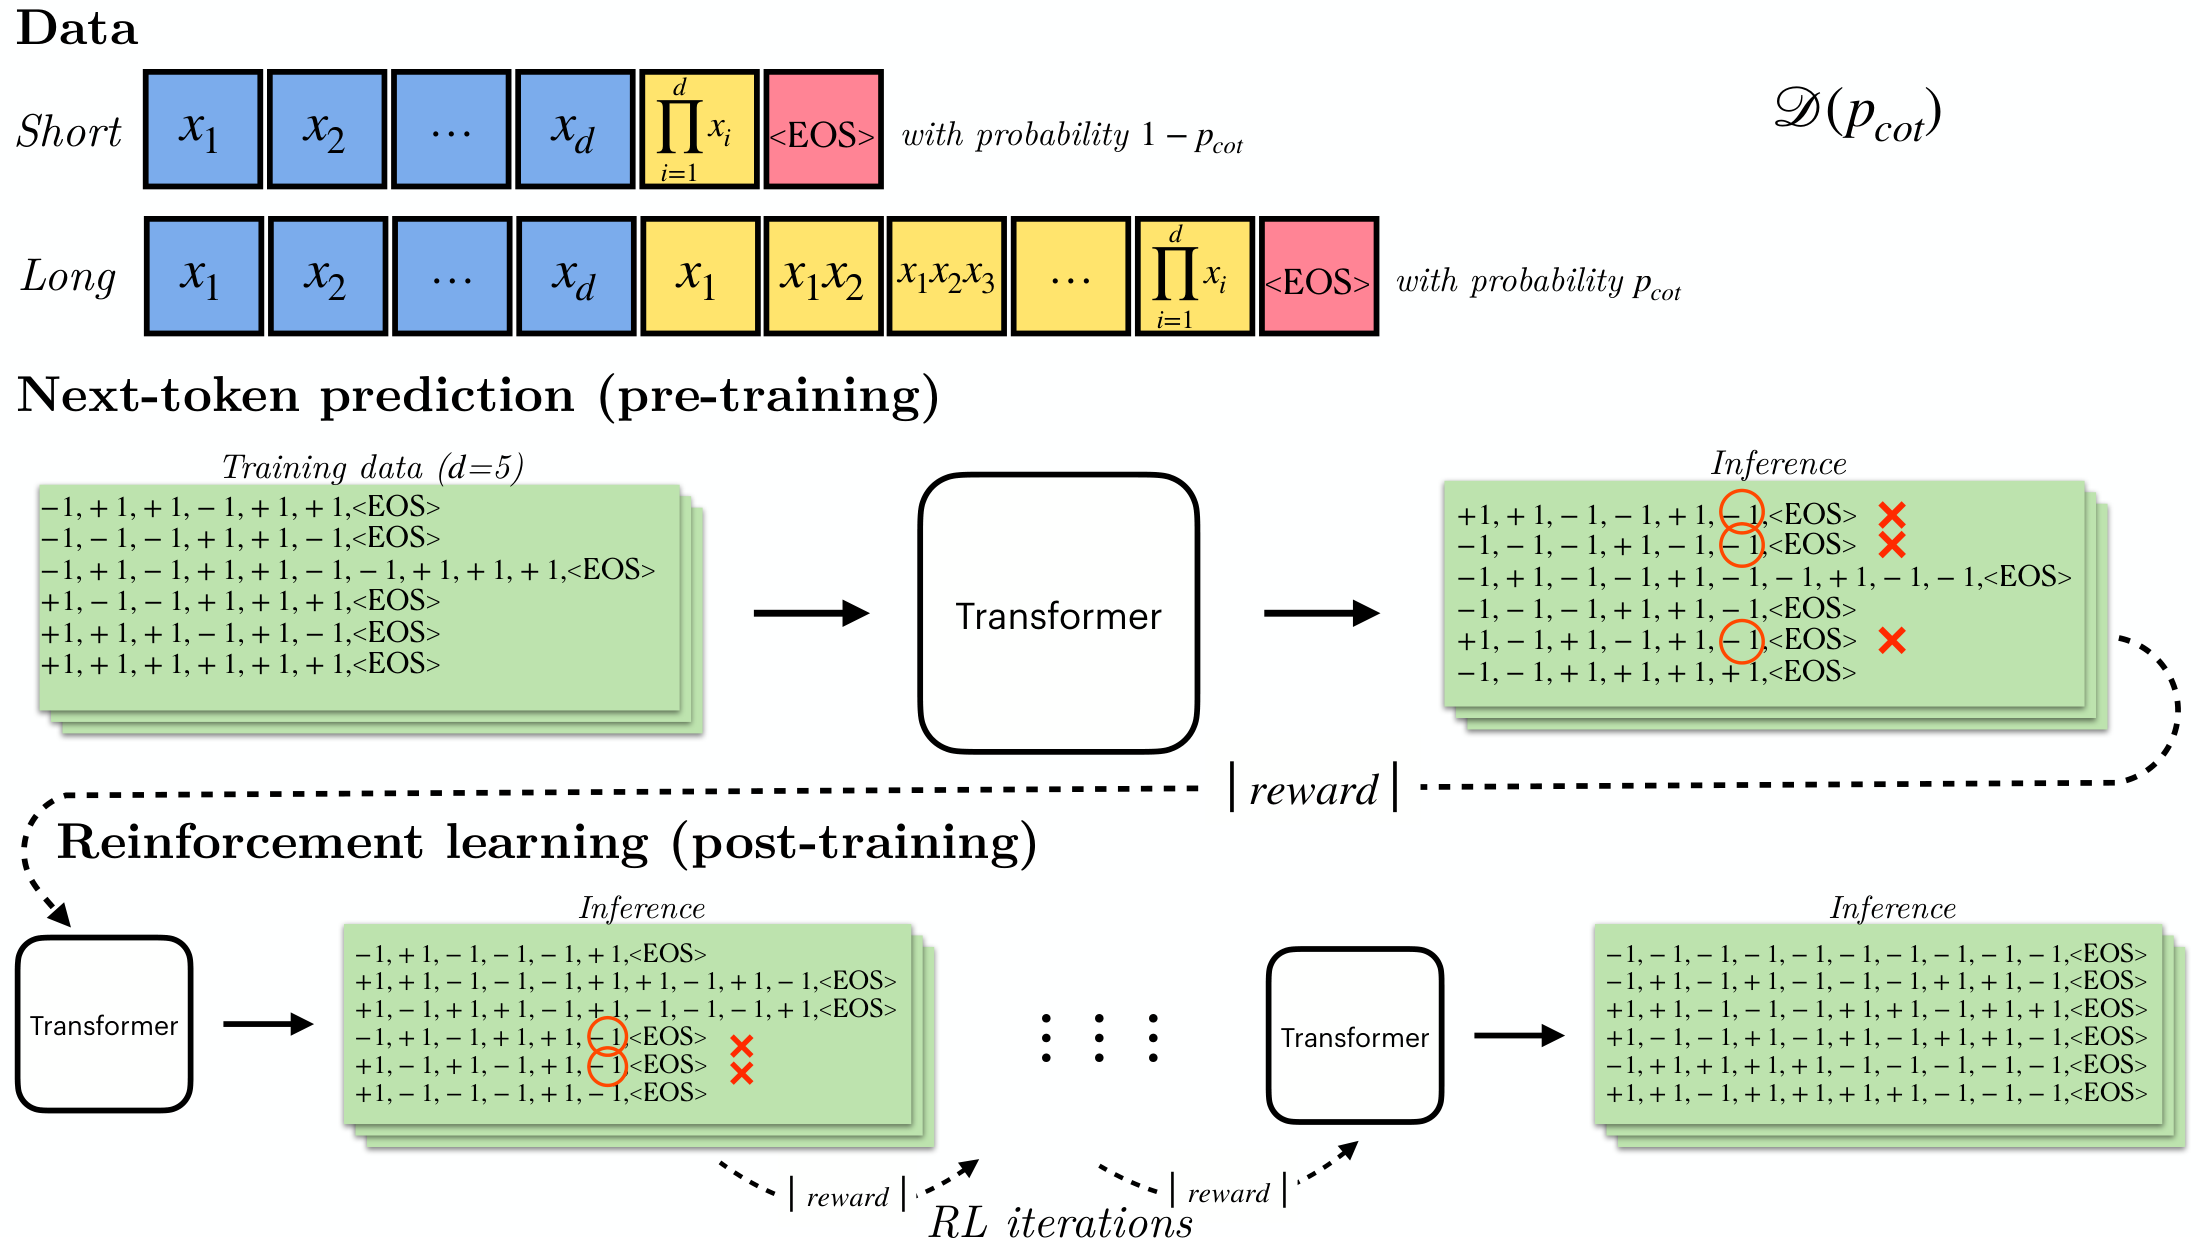
短、长响应分别含 1、$d$ 个答案 token(不计结束符)。例如 $x=(+1,-1,+1,-1,+1)$ 的长轨迹为 $(+1,-1,-1,+1,+1)$,短答案只有 $+1$。两种训练标签都正确;难点在于模型能否学会它们。图 1 左边直观展示这一数据与训练流程。§2,PDF pp. 3–4;图 1,p. 2
2.2 NTP 与奖励究竟优化什么
预训练最小化输出位置的交叉熵:
输入位本身均匀随机,因此不纳入损失。后训练有两种验证函数:$r_{\mathrm{e2e}}(x,y)$ 只检查结束符前的最终答案,$r_{\mathrm{cot}}(x,y)$ 只接受完全正确的短答案或逐步正确的完整长轨迹。实验比较 STaR、REINFORCE 与 GRPO;理论定理 2 专门分析用 $r_{\mathrm{cot}}$ 的 STaR。STaR 每轮采样模型回答,保留奖励为 1 的序列,再对这些序列做 NTP。这使其目标等价于在“本轮生成且验证通过”的条件分布上训练。§2;Appendix A,PDF pp. 4、18–19
2.3 预训练已会“走长路”,贪心却会过早停止
在该任务中,模型更容易从长示范学会局部乘法,而短示范要求一次拟合全部位的奇偶性。若模型按训练混合比例生成长轨迹,并且长轨迹几乎总正确、短路线约一半正确,则采样解码的期望准确率为
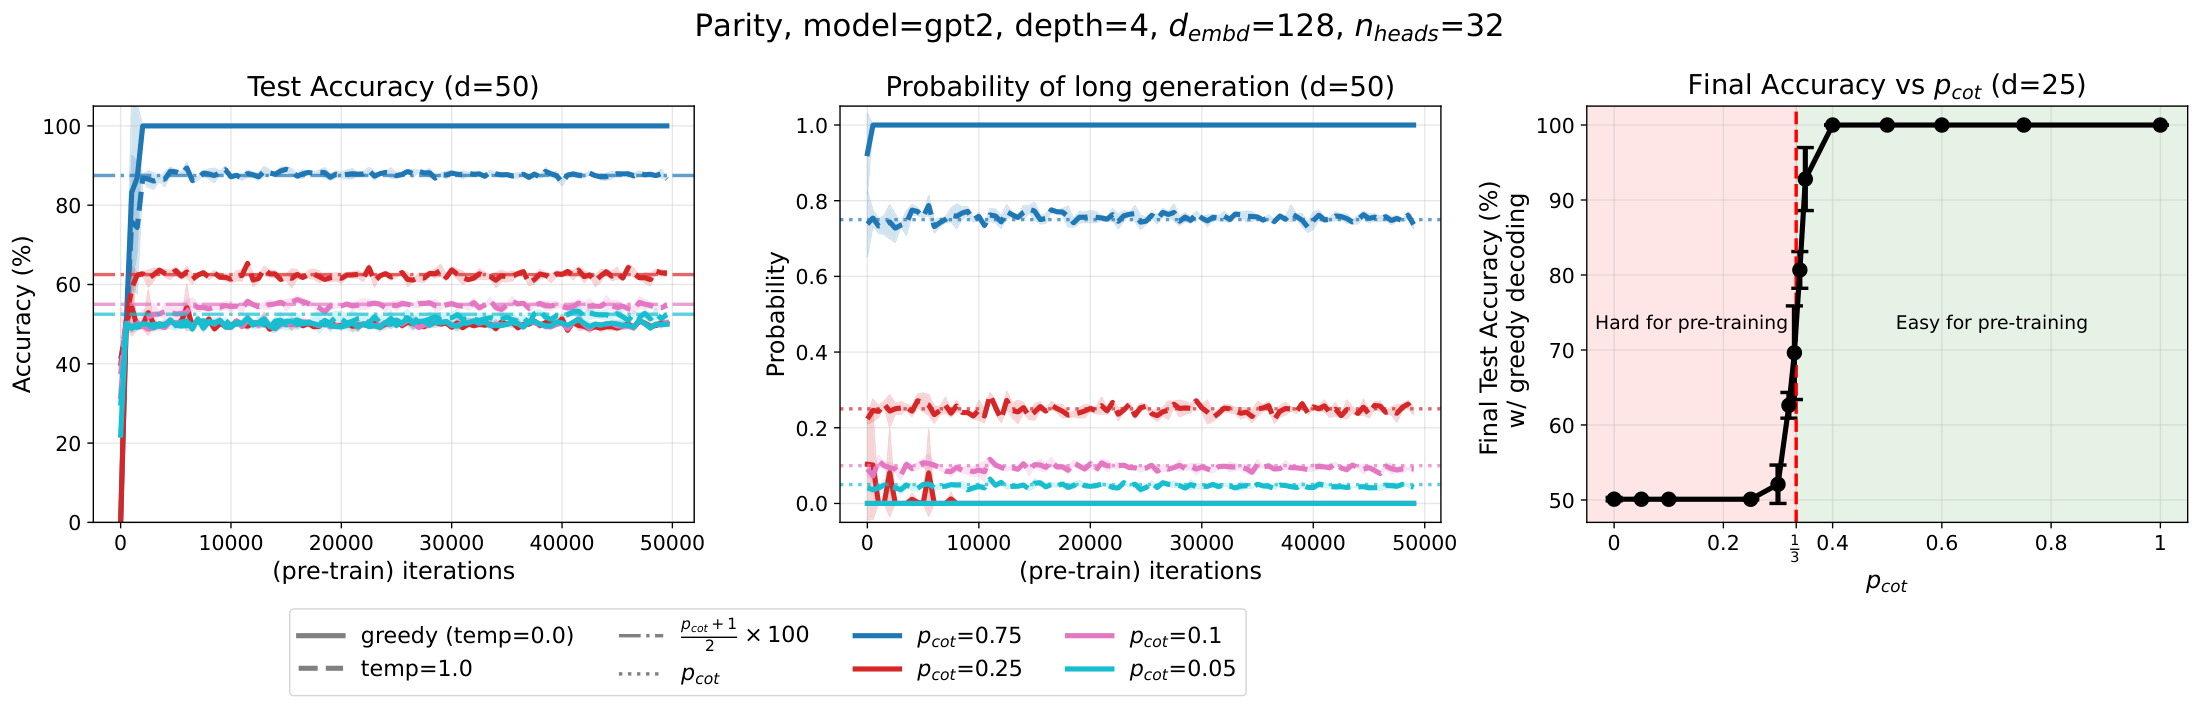
这说明 $p_{\mathrm{cot}}=0.25$ 时,采样准确率约 $62.5\%$,即便贪心准确率仍约 $50\%$。图 2 左边是实线贪心、虚线温度 1 采样;中间虚线显示长响应概率接近 $p_{\mathrm{cot}}$;右边给出随比例变化的贪心准确率。左、中面板是 $d=50$,右面板是 $d=25$,不可把三个面板当成完全相同的实验。§3.1–3.2;图 2,PDF pp. 5–6
2.4 为什么门槛是 $1/3$
理论模型没有直接表示完整奇偶性的首 token 特征时,第一步对长轨迹的 $x_1$ 有轻微偏好,贪心输出 $x_1$。给定这个第一 token,第二步继续输出 $x_1x_2$ 与立即停止的条件概率分别是
当 $2p_{\mathrm{cot}}<1-p_{\mathrm{cot}}$,即 $p_{\mathrm{cot}}<1/3$,模型在第二步选择结束。生成的短序列是 $(x_1,\mathrm{EOS})$,并非真正短答案 $(s_d,\mathrm{EOS})$;它对随机输入只有约一半正确。这个推导依赖受限预测器无法在第一步学到完整奇偶性的假设,并非任意网络在所有训练阶段的恒等式。§4;Appendix D.2,PDF pp. 8、60
2.5 RL 通过成功条件筛选提高长轨迹占比
预训练末期,长且正确的生成概率约为 $p_0=p_{\mathrm{cot}}$;短且正确的概率约为 $(1-p_0)/2$。STaR 只保留正确生成,因而保留集合中的长轨迹占比近似为
因此正确长轨迹与正确短答案的赔率每轮翻倍。理想递推的闭式为 $p_n=2^np_0/(1-p_0+2^np_0)$。从 $p_0=0.25$ 出发,理想的第一轮即得 $p_1=0.4>1/3$;这是解释门槛的教学计算,实际定理还控制采样和优化误差。跨过门槛后,贪心解码倾向完整长轨迹,测试时生成更多 token,并获得正确答案。RL 增加推理时计算量在这里是由训练选择压力产生的。§3.2、§4;Appendix D.4,PDF pp. 7–9、77–81
三:理论分析与验证
3.1 定理 1:预训练的校准与贪心失效
理论模型是逐输出位置的线性自回归预测器,而非实验中的 Transformer。第一位置用线性类 $\mathcal H_1$;第二位置分成“停或不停”与“输出 $\pm1$”两个分类器;后续位置用包含最后 token 与输入位二阶乘积的特征 $\phi_\ell$。这样,局部更新 $s_\ell=s_{\ell-1}x_\ell$ 可由线性头学习,而直接从输入抽取完整 $d$ 位奇偶性不会被特征映射轻易给出。各头使用带 $\ell_2$ 正则的逻辑损失和 SGD。§4;Appendix D.1,PDF pp. 7–8、55–58
定理 1 在 $d\ge2$、$0
3.2 定理 2:STaR 的有效混合分布逐轮移动
定理 2 从 $p_0<1/3$ 的预训练模型出发,还要求校准误差 $\varepsilon$ 足够小,约为 $O(p_0/(1-p_0))$,并用严格的完整轨迹奖励 $r_{\mathrm{cot}}$。证明先说明第 $n$ 轮 STaR 的条件训练目标等价于对新混合分布 $\mathcal D(q_n)$ 做 NTP;再控制 $|q_n-p_n|\lesssim 2^n\varepsilon$。经过 $n^\star=O(\log((1-p_0)/p_0))$ 轮、多项式级每轮 SGD 迭代后,贪心输出完整正确轨迹。若 $p_0\in\Omega(d^{-\kappa})$,总 SGD 迭代数仍为 $\operatorname{poly}(d)$。定理 2,PDF p. 9;Appendix D.4,pp. 77–81
这里有两层证据:正式定理只证明线性自回归模型 + STaR + 完整轨迹验证;Transformer 上的 GRPO/REINFORCE 效果来自实验。定理给出该设置下 NTP 后接奖励筛选的正面学习保证和有限轮预训练贪心行为,不能将“普通 NTP 对所有 Transformer 必需指数样本”读作它已证明的一般下界。
四:实验结果
4.1 奇偶校验:可采样能力与贪心表现分离
模型从零训练 GPT-2/Mistral 风格解码器,在线采集独立的 $d$ 位输入。主要图 2 的 GPT-2 设置用批量 256、最多 50,000 次预训练迭代,并用 3 个随机种子;评价的是结束符前最终 token 的正确率与生成长度。$p_{\mathrm{cot}}=0.75$ 时,模型在预训练阶段就走长轨迹并趋近满分。$p_{\mathrm{cot}}=0.25$ 时,长轨迹可在温度 1 采样中出现,但贪心输出短响应,测试准确率约 $50\%$;图 2 右侧的经验转折点约 $1/3$。50,000 次迭代对应约 1,280 万条训练序列,论文据此展示该配置的显著样本差距,而不是宣称无限训练时 NTP 绝无可能成功。§3.1;Appendix B.1;图 2,PDF pp. 5、19–20
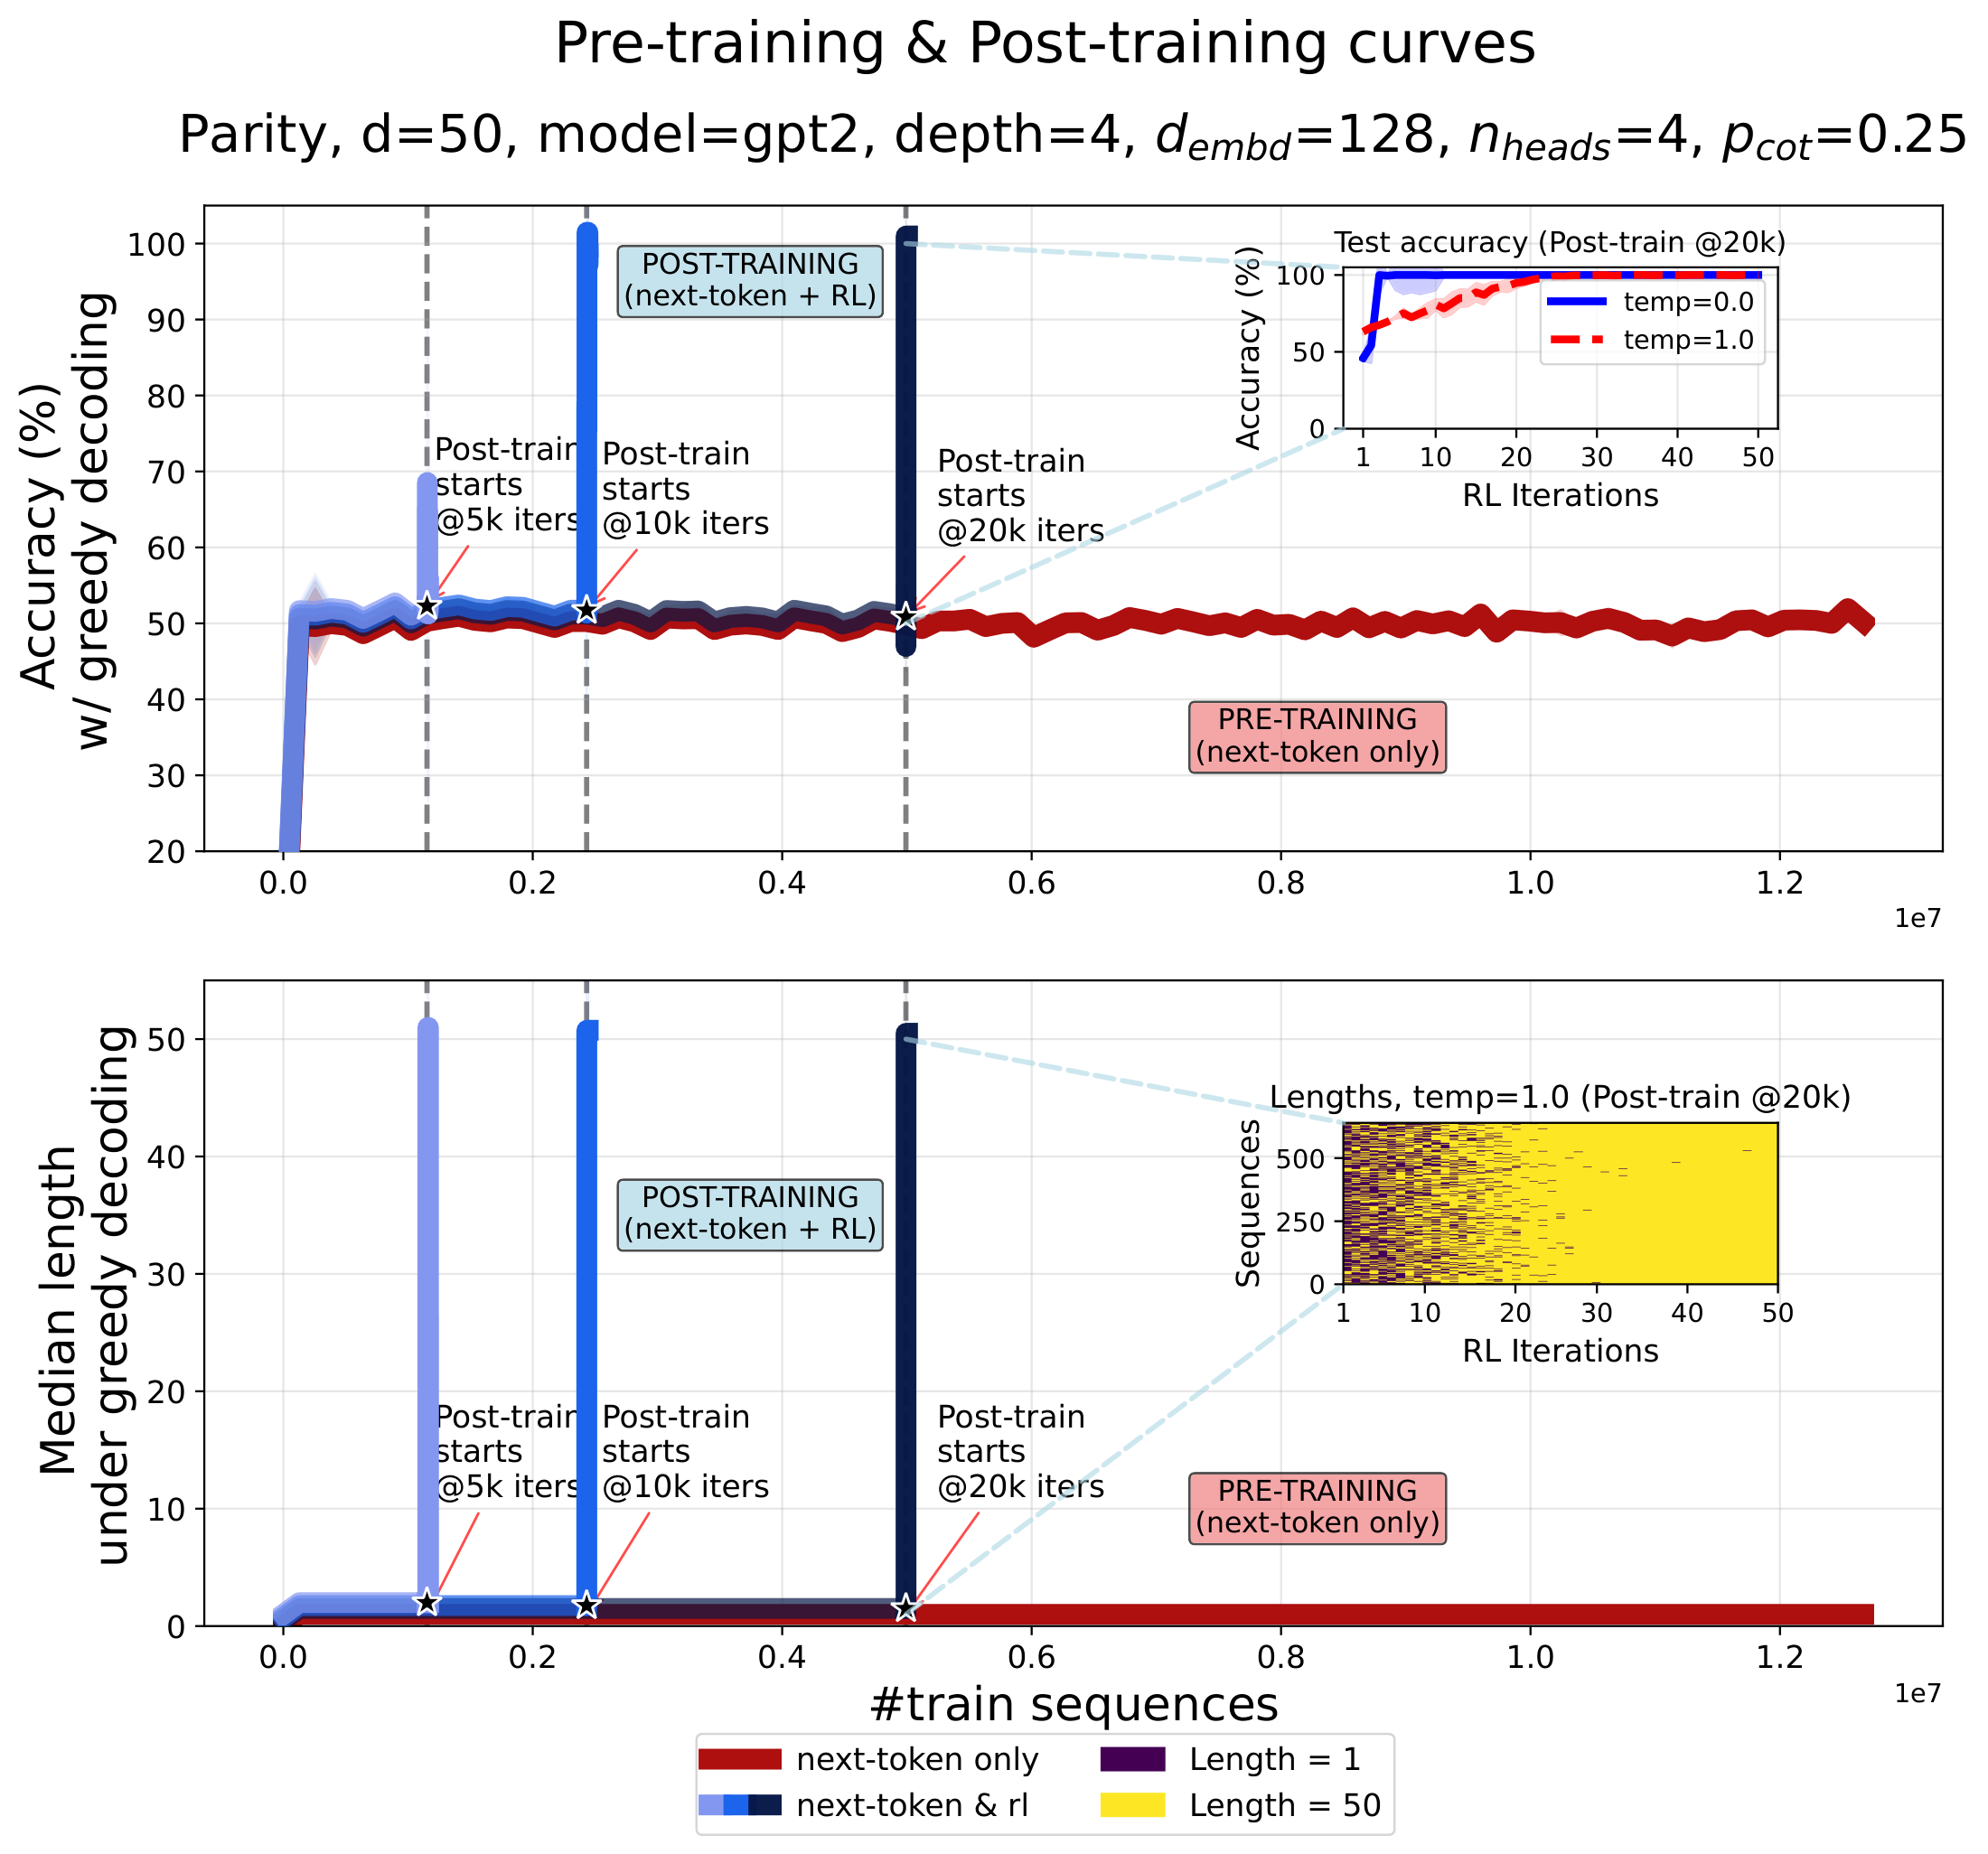
在 $d=50,p_{\mathrm{cot}}=0.25$ 时,GRPO 从较晚预训练检查点启动后,贪心正确率与生成长度都迅速上升;从很早的检查点启动,即使长度变长也可能不泛化。图 1 右侧是预训练与 GRPO 共用“训练序列数”横轴的比较;图 3 则比较不同 RL 算法和采样温度。图 3 的 STaR 每轮使用 3,200 个生成,而 GRPO/REINFORCE 每步为 64 个,因此图 3 横轴迭代次数不可直接当成相同样本预算。高温度、仅最终答案奖励的 STaR 也存在不稳定情形。§3.1–3.2;图 1、3,PDF pp. 2、5–7
补充实验改变网络深度、头数、位置编码与 $p_{\mathrm{cot}}$;Mistral 预训练更不稳定。长样本更稀少时,对预训练成熟度的要求提高:$p_{\mathrm{cot}}=0.1$、20k 次预训练后,多种 RL 配置多数能成功;$p_{\mathrm{cot}}=0.05$、20k 次后不可靠,延长至 50k 后成功概率提高。小维度 $d=11,12$ 下,单独 NTP 最终也可能学会短路求解。包含第三种“中等长度”轨迹时,较晚检查点可支持长度惩罚,在保持准确率的同时减少生成长度;同样的惩罚施于过早检查点会使 RL 失败。含噪补充实验中,部分噪声设置仍能经 RL 泛化,但成功更依赖算法与采样温度。Appendix C.1–C.4,PDF pp. 23–35
4.2 多位数乘法:长轨迹提供计算深度
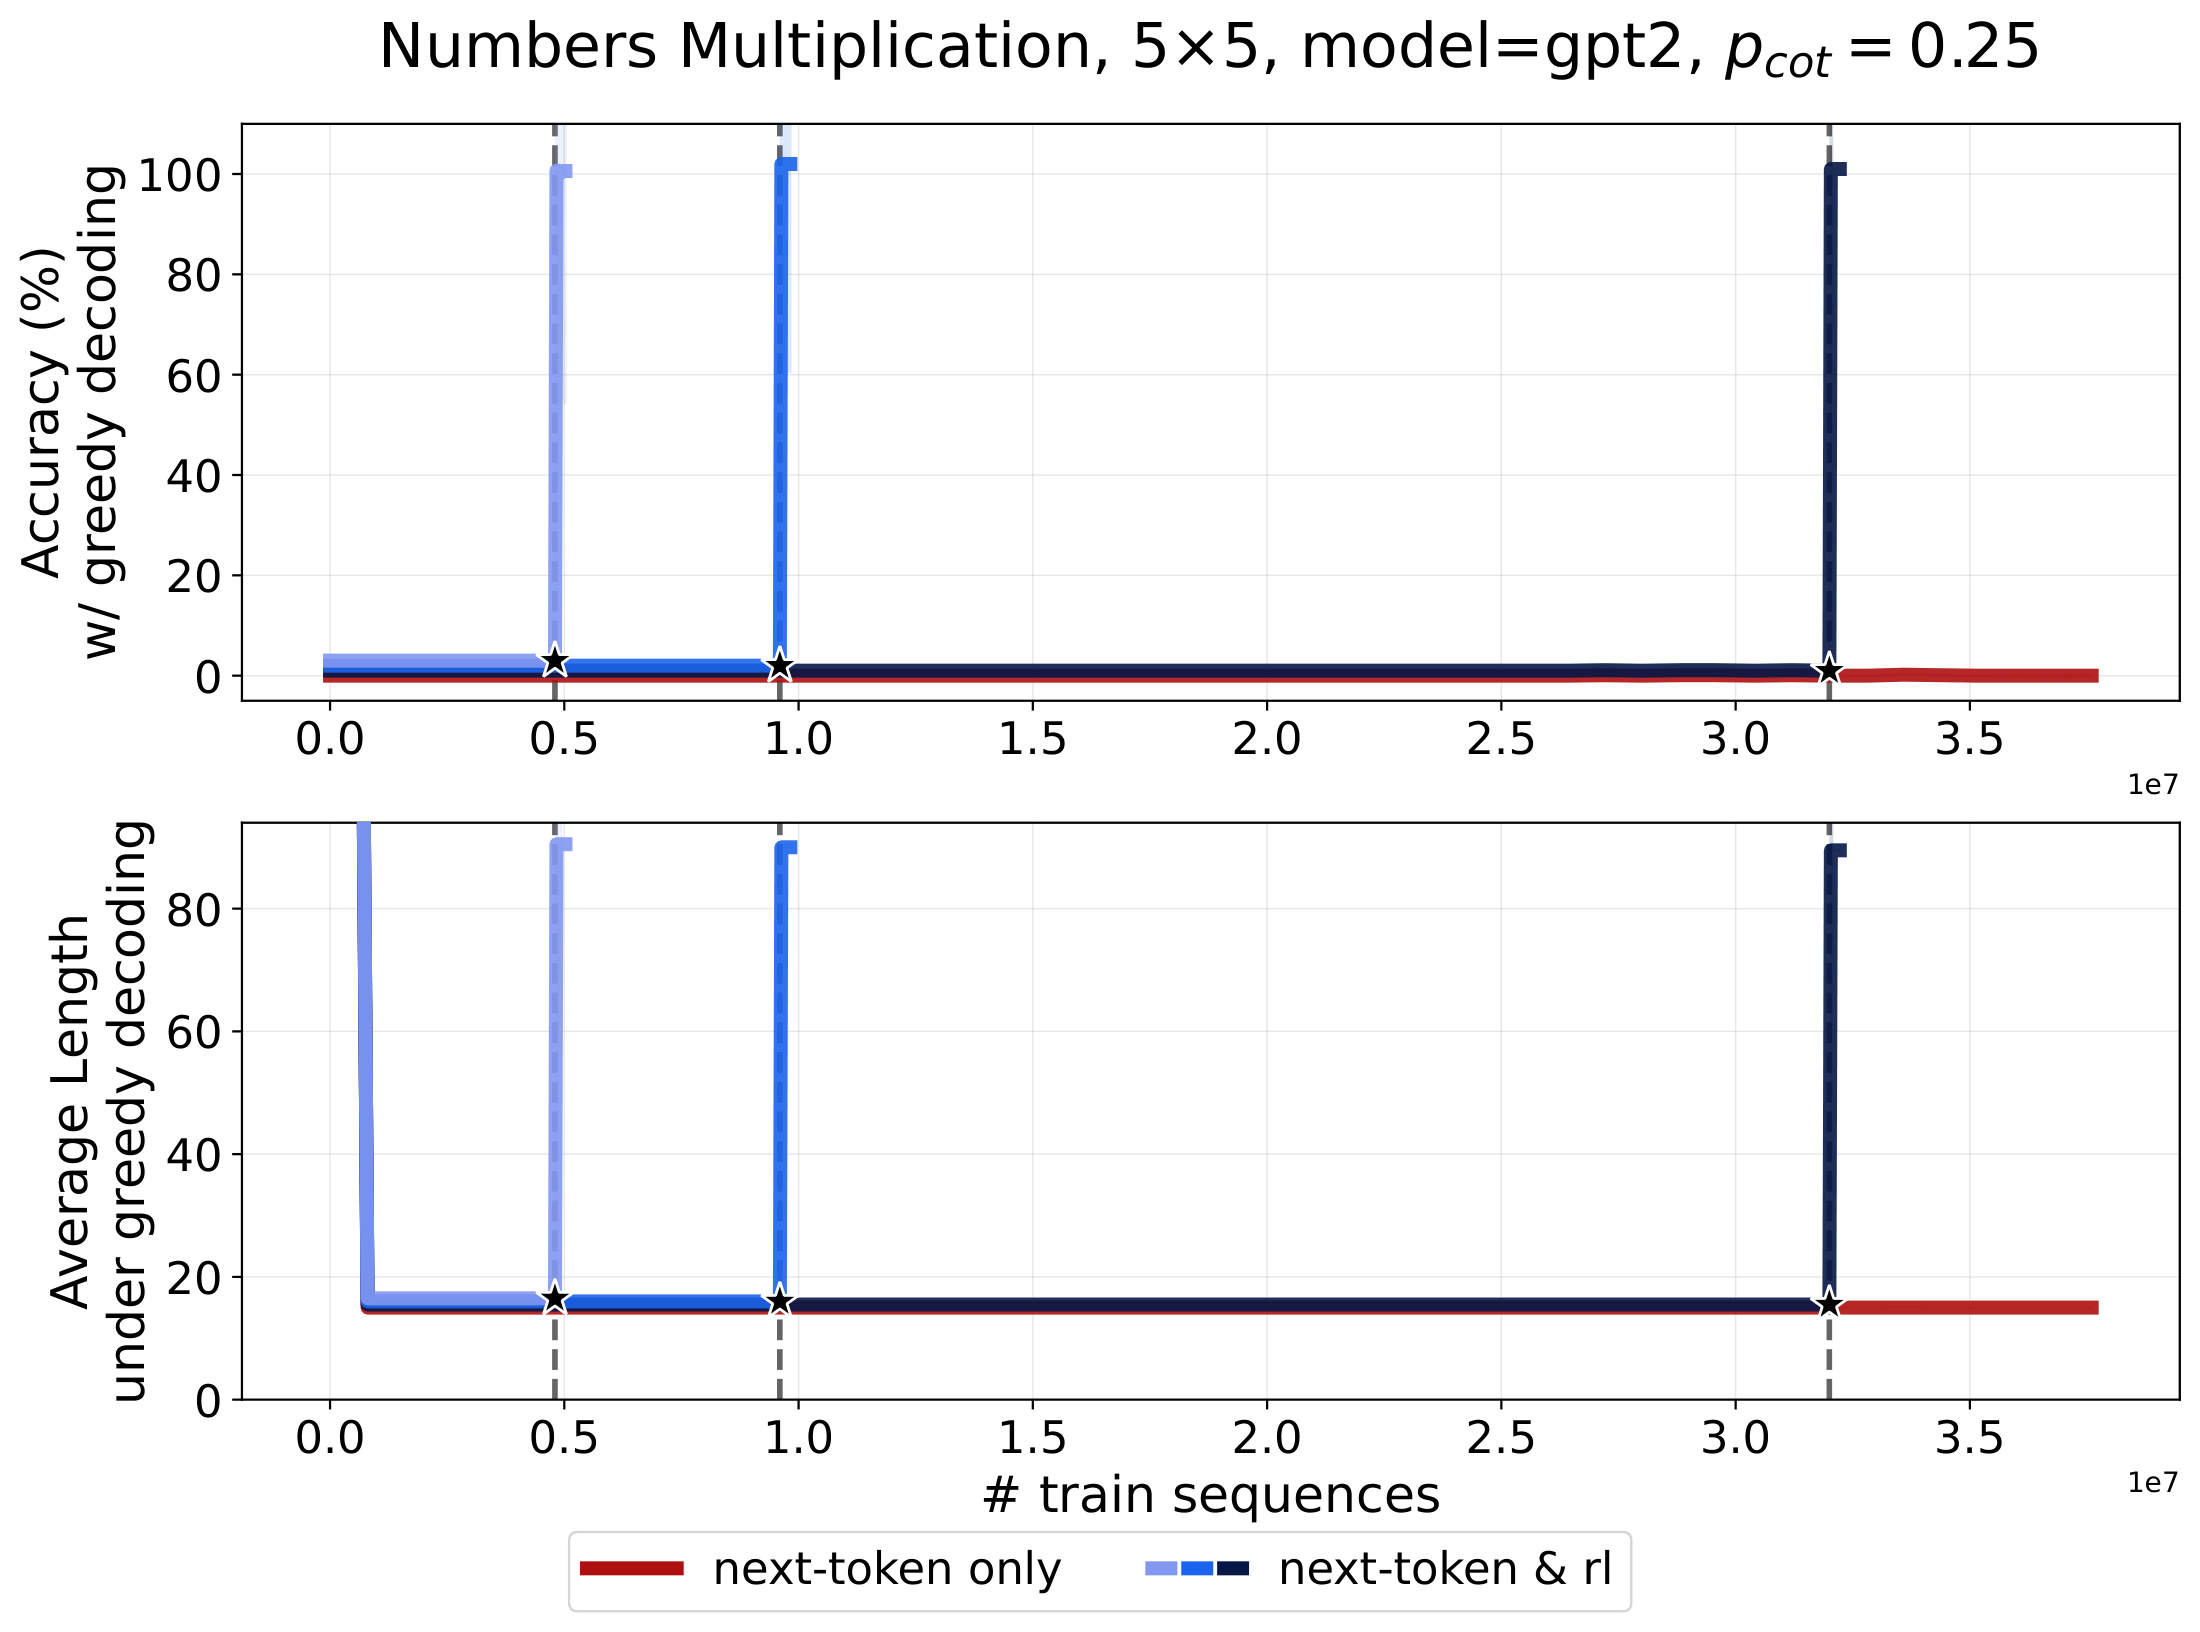
作者构建 $4\times4$、$5\times5$、$7\times7$ 位数乘法数据;长样本包含小学竖式的中间计算,短样本只保留答案。从零训练约 1.24 亿参数的 GPT-2,每个任务 808,000 个唯一训练样本,跨 epoch 重用;随后用 GRPO 和完整数字匹配奖励训练。图 5 左侧 $5\times5,p_{\mathrm{cot}}=0.25$ 的 NTP 贪心准确率几乎为 0,合适检查点切到 RL 后接近 100%,同时输出变长。$7\times7,p_{\mathrm{cot}}=0.1$ 在 3 个随机种子下预训练未学到可用的长轨迹,RL 因而未成功:奖励放大需要模型先能产生一些有效答案。§5.1;图 5,PDF pp. 10–11;Appendix B.2/C.5,pp. 20–21、36–39
4.3 GSM8K:少量长示范,Llama 的 SFT 与 GRPO
在 GSM8K 上,作者使用 Llama 3.2 3B base。数据拆成两半,前半用于混合长短答案的 SFT,后半用于 GRPO;奖励同时检查格式标签与答案。图 5 右侧展示 $p_{\mathrm{cot}}=0.05$:星号是不同 SFT epoch 的检查点,彩色线从各检查点启动 RL;黑色虚线是全长 CoT 的 SFT 基线。早期 SFT 检查点的准确率和长度低,后训练迅速提高,达到并随后超过图中的 SFT 基线,生成长度也增长。附录的回答实例显示,早期 RL 响应由短且常错,转向接近训练中长示范的详细回答;更晚阶段的回答风格再发生变化。作者把前一阶段解释为利用混合数据中的长示范,把后一阶段推测为预训练知识带来的分布外收益;后者是解释性假设。§5.2;图 5,PDF p. 11;Appendix C.6,pp. 40、43–46
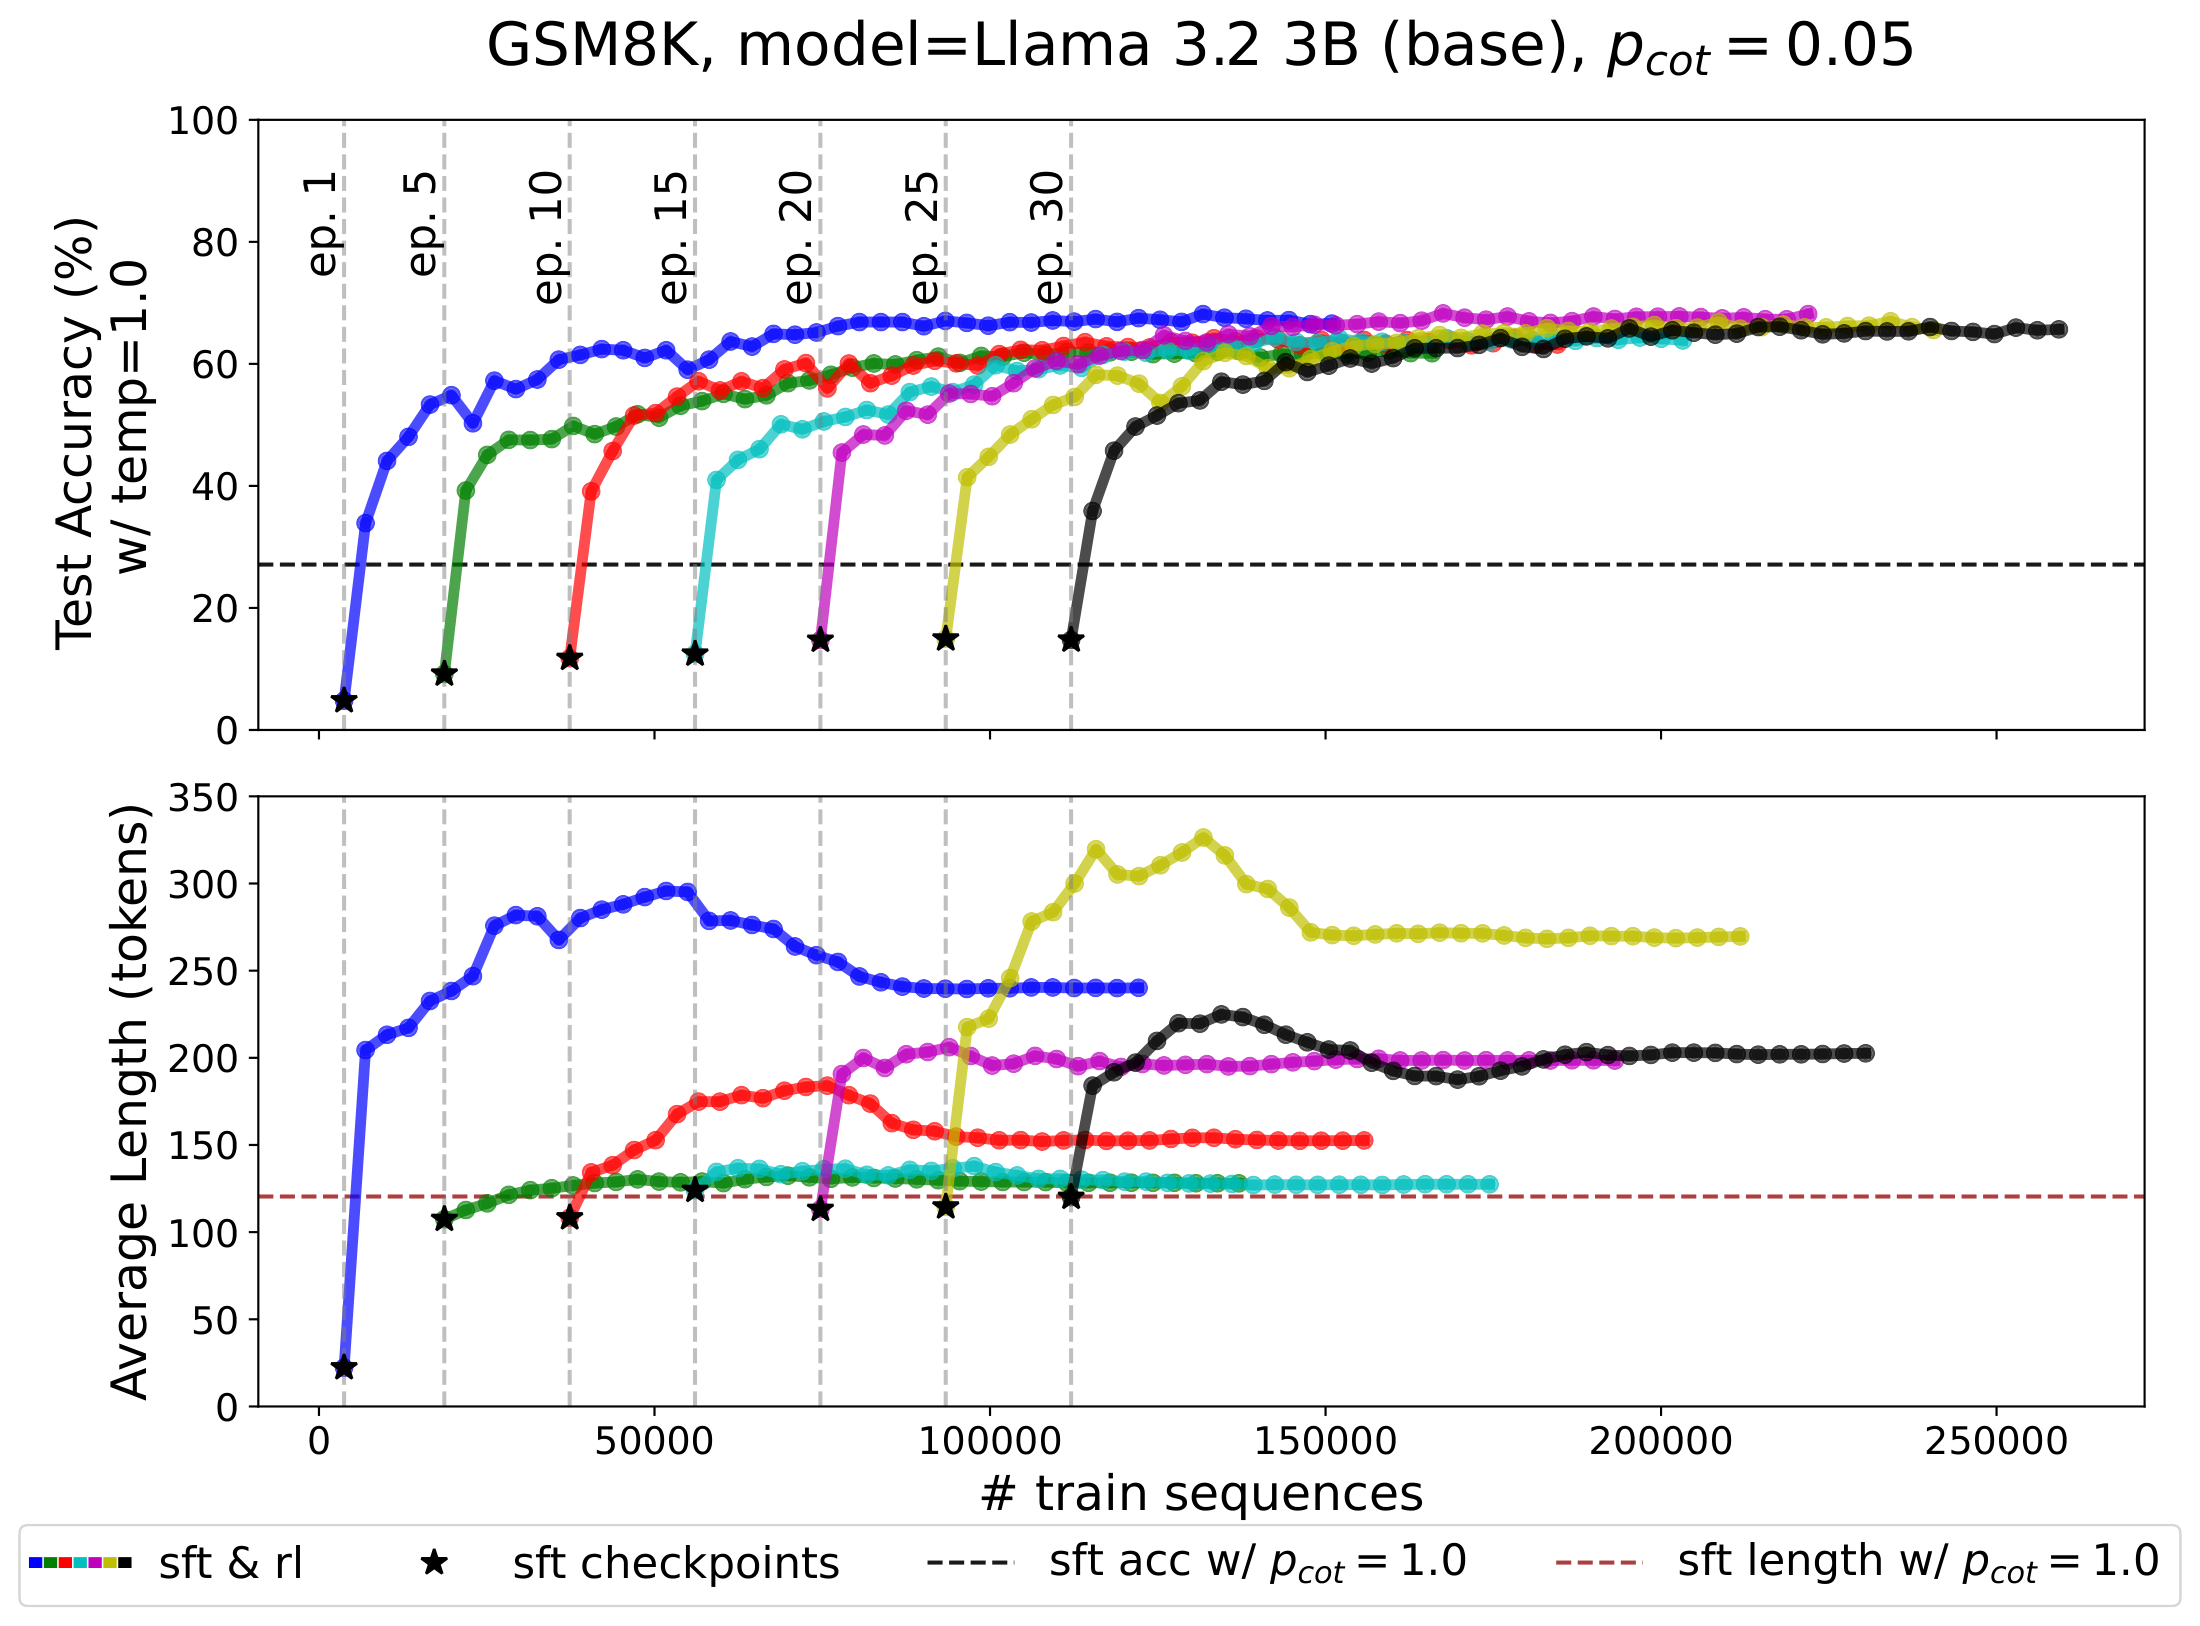
图 5 的横轴统计训练序列:SFT 在多个 epoch 中重复使用同一批样本,RL 中对同一输入的多次生成也计入横轴。因此它适合读“在此协议下达到基线的训练轨迹”,但不能只按横坐标直接比较不同阶段的独立题目数。图上约 $65\%$ 的后期准确率是从曲线读出的近似值,不是论文给出的单独汇总表。图 5 图注,PDF p. 11
4.4 MATH:相同趋势与更强的归因混杂
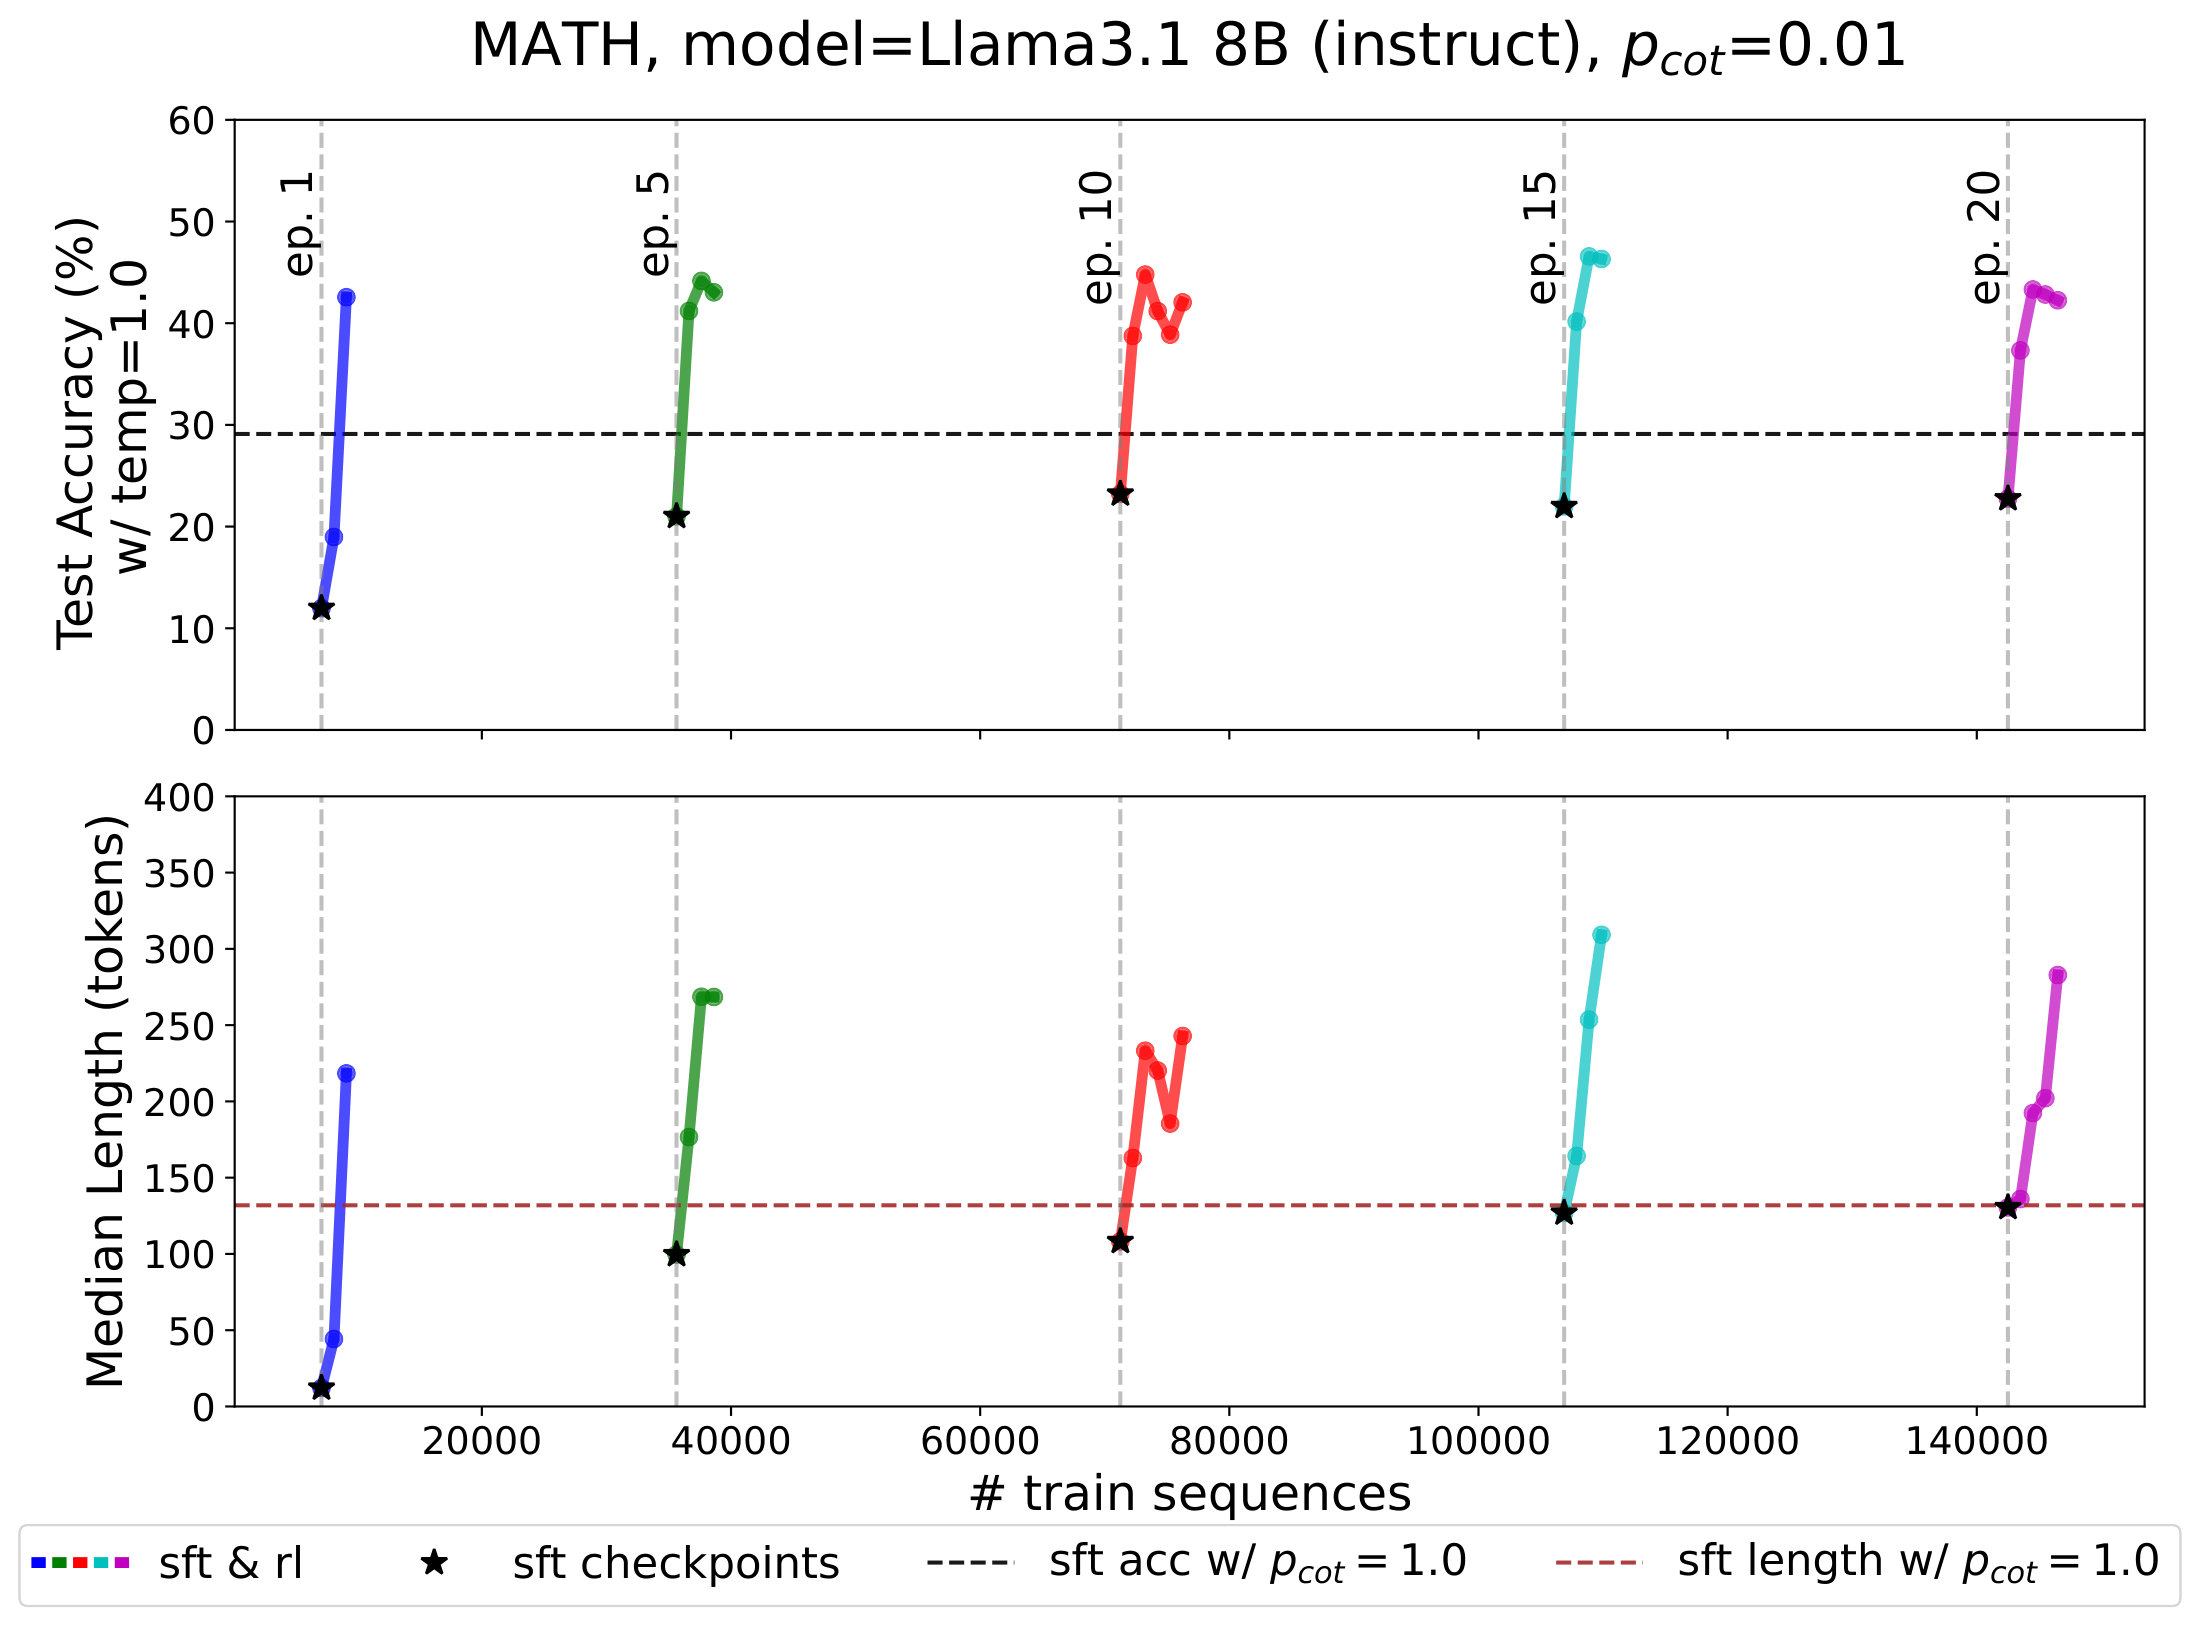
MATH 实验使用 Llama 3.2 3B instruct 与 Llama 3.1 8B instruct。小 $p_{\mathrm{cot}}$ 的 SFT 检查点经 GRPO 后常同时提高准确率和输出长度;附录图 28/29 展示不同保留比例,其中 8B、$p_{\mathrm{cot}}=0.01$ 的例子可见这种快速跃升。作者从生成实例发现,有的模型不再遵循 SFT 长示范的格式,因而不能把所有收益归因于“筛选并放大训练集中的长链”;他们认为模型在 MATH 发布前可能已经接触相关数据。这个疑虑尤其影响从真实预训练 Llama 外推理论机制时的因果解释。§5.2,PDF pp. 11–12;Appendix C.6,pp. 41–42、47–52
原文符号歧义:§5.2 与 Appendix B.3/B.4 的几处文字写作“以 $p_{\mathrm{cot}}$ 概率删除 CoT”;这与 §2 的定义、图 5/附录图中 $p_{\mathrm{cot}}=1$ 表示全长 CoT 的基线相反。上文统一按数学定义和图例把 $p_{\mathrm{cot}}$ 解释为保留长示范的概率。该文字不一致需要在复现实验时核对作者实际构造代码。§2、§5.2;Appendix B.3/B.4,PDF pp. 4、10–11、21–22
五:结论与可迁移的认识
论文最有价值的区分是:模型会在采样中给出正确长解,与默认贪心解码会选择该长解,是两个不同命题。预训练可能已经掌握局部计算,却被短样本占比压在错误的输出路径上。验证奖励使较易正确的长路径在成功样本中富集,随后的训练把长输出从“可采样”推向“贪心可选”,于是测试时花费更多 token 并提高正确率。$1/3$ 阈值是论文特定混合分布、受限特征和解码规则的精确结果,不是一般推理模型的固定临界点。§3–§4,PDF pp. 5–9
理论贡献在于给出带条件、带误差控制的优化路径:当正确长示范至少有多项式小的比例,线性自回归模型的 NTP+STaR 可用多项式 SGD 步学会奇偶校验。实践启示则是:后训练依赖一个已经能够偶尔生成可验证长解的起点;检查点成熟度、奖励是否能识别真正正确的轨迹、以及长度成本都会影响效果。乘法的失败设置、部分链和噪声实验体现了这些取舍。真实 Llama 任务中的额外预训练知识使后期收益机制更复杂,作者也将噪声链与预训练/后训练目标不同的情形留作后续研究。§5–§6;Appendix C,PDF pp. 10–12、23–52