Context Length Alone Hurts LLM Performance Despite Perfect Retrieval:中文精读笔记
作者:Yufeng Du、Minyang Tian、Srikanth Ronanki、Subendhu Rongali、Sravan Bodapati、Aram Galstyan、Azton Wells、Roy Schwartz、Eliu A Huerta、Hao Peng
原文:arXiv:2510.05381v1 · 本地 PDF · 获取与研读日期:2026-11-03
发表:已发表于 Findings of EMNLP 2025(ACL Anthology,页 23281–23298,DOI: 10.18653/v1/2025.findings-emnlp.1264)。
代码:截至 2026-11-03,未查到该论文的公开实现。
论文总览
论文质疑一种常见直觉:只要大模型从长输入中找对了全部相关信息,后续解题就应与短输入一样容易。作者把短题拆为证据和问题,中间插入不同长度的无关内容;另用逐字复述测试证据能否被找回,再测原题的解答准确率。两项能力出现明显分离:例如 Llama-3.1-8B-Instruct 的 MMLU 在加入 30K 篇章填充后,逐字检索仍为 97.0%,答题准确率却从 63.2% 降到 39.0%,下降 24.2 个百分点。作者进一步把填充换为空白、移动证据位置、对填充施加注意力掩码,性能下降仍存在;最后提出先复述证据、再用短提示解题的两阶段缓解方案。其最清楚的实际启示是:检索能力与长上下文中的信息使用能力需要分别评估。(§3–5,PDF pp. 4–9;附录表 6,p. 16)
这里的“检索”指模型从给定上下文中注意并复述文本,不是检索增强生成(RAG)的外部搜索。论文把检索与解题放在两个不同提示中分别测量,因此“完美检索”是同题证据在独立复述测试中可被准确找回,并非逐次证明答题调用内部确已读取全部证据。这个定义决定了结果的解释范围。(§1 脚注、§3.1,PDF pp. 1、4–5)
结构地图
| 原文部分 | 作用 | PDF 定位 |
|---|---|---|
| §1 Introduction;§2 Background and Related Work | 提出“能找回”与“能用好”的差别 | pp. 1–3;图 1 在 p. 2 |
| §3.1 A Long-Context Synthetic Benchmark | 构造证据—填充—问题,并定义逐字检索 | pp. 3–5;表 1 p. 4、图 2 p. 5 |
| §3.2 Performance Drops Despite Perfect Retrieval | 篇章填充下比较检索率与准确率 | pp. 5–6;图 3 p. 6、附录表 6 p. 16 |
| §4.1 Performance Degradation with Minimum Distraction | 空白填充、闭源模型、证据位置控制 | pp. 6–7;表 2 p. 6、图 4 p. 7、附录表 7–8 p. 17 |
| §4.2 Eliminating Distraction Completely with Masking | 屏蔽填充位置的注意力 | p. 7;表 3 p. 7、附录表 9 p. 17 |
| §5 Shortening Input Through Retrieval: A Simple Fix | 两阶段缓解及 GSM8K、RULER 结果 | pp. 8–9;图 5、表 4 p. 8,表 5 p. 9 |
| §6 Discussion;§7 Conclusion;Limitations;Appendix | 解释、边界、提示模板与详细数据 | pp. 8–18;提示 p. 13–15 |
一:动机——找到证据之后仍可能答错
长上下文任务通常同时要求定位证据和根据证据推理。若只测“针藏草堆”式的定位能力,答题下降很容易被归因于找错或遗漏。本文用同一组原题分别测逐字复述和解答,并把证据放在连续片段、默认置于输入开头,主动降低检索难度。这样,若复述率基本保持而答题率大跌,就能看到仅提高检索指标无法解释的性能缺口。(§1、§3.1,PDF pp. 2、4–5)
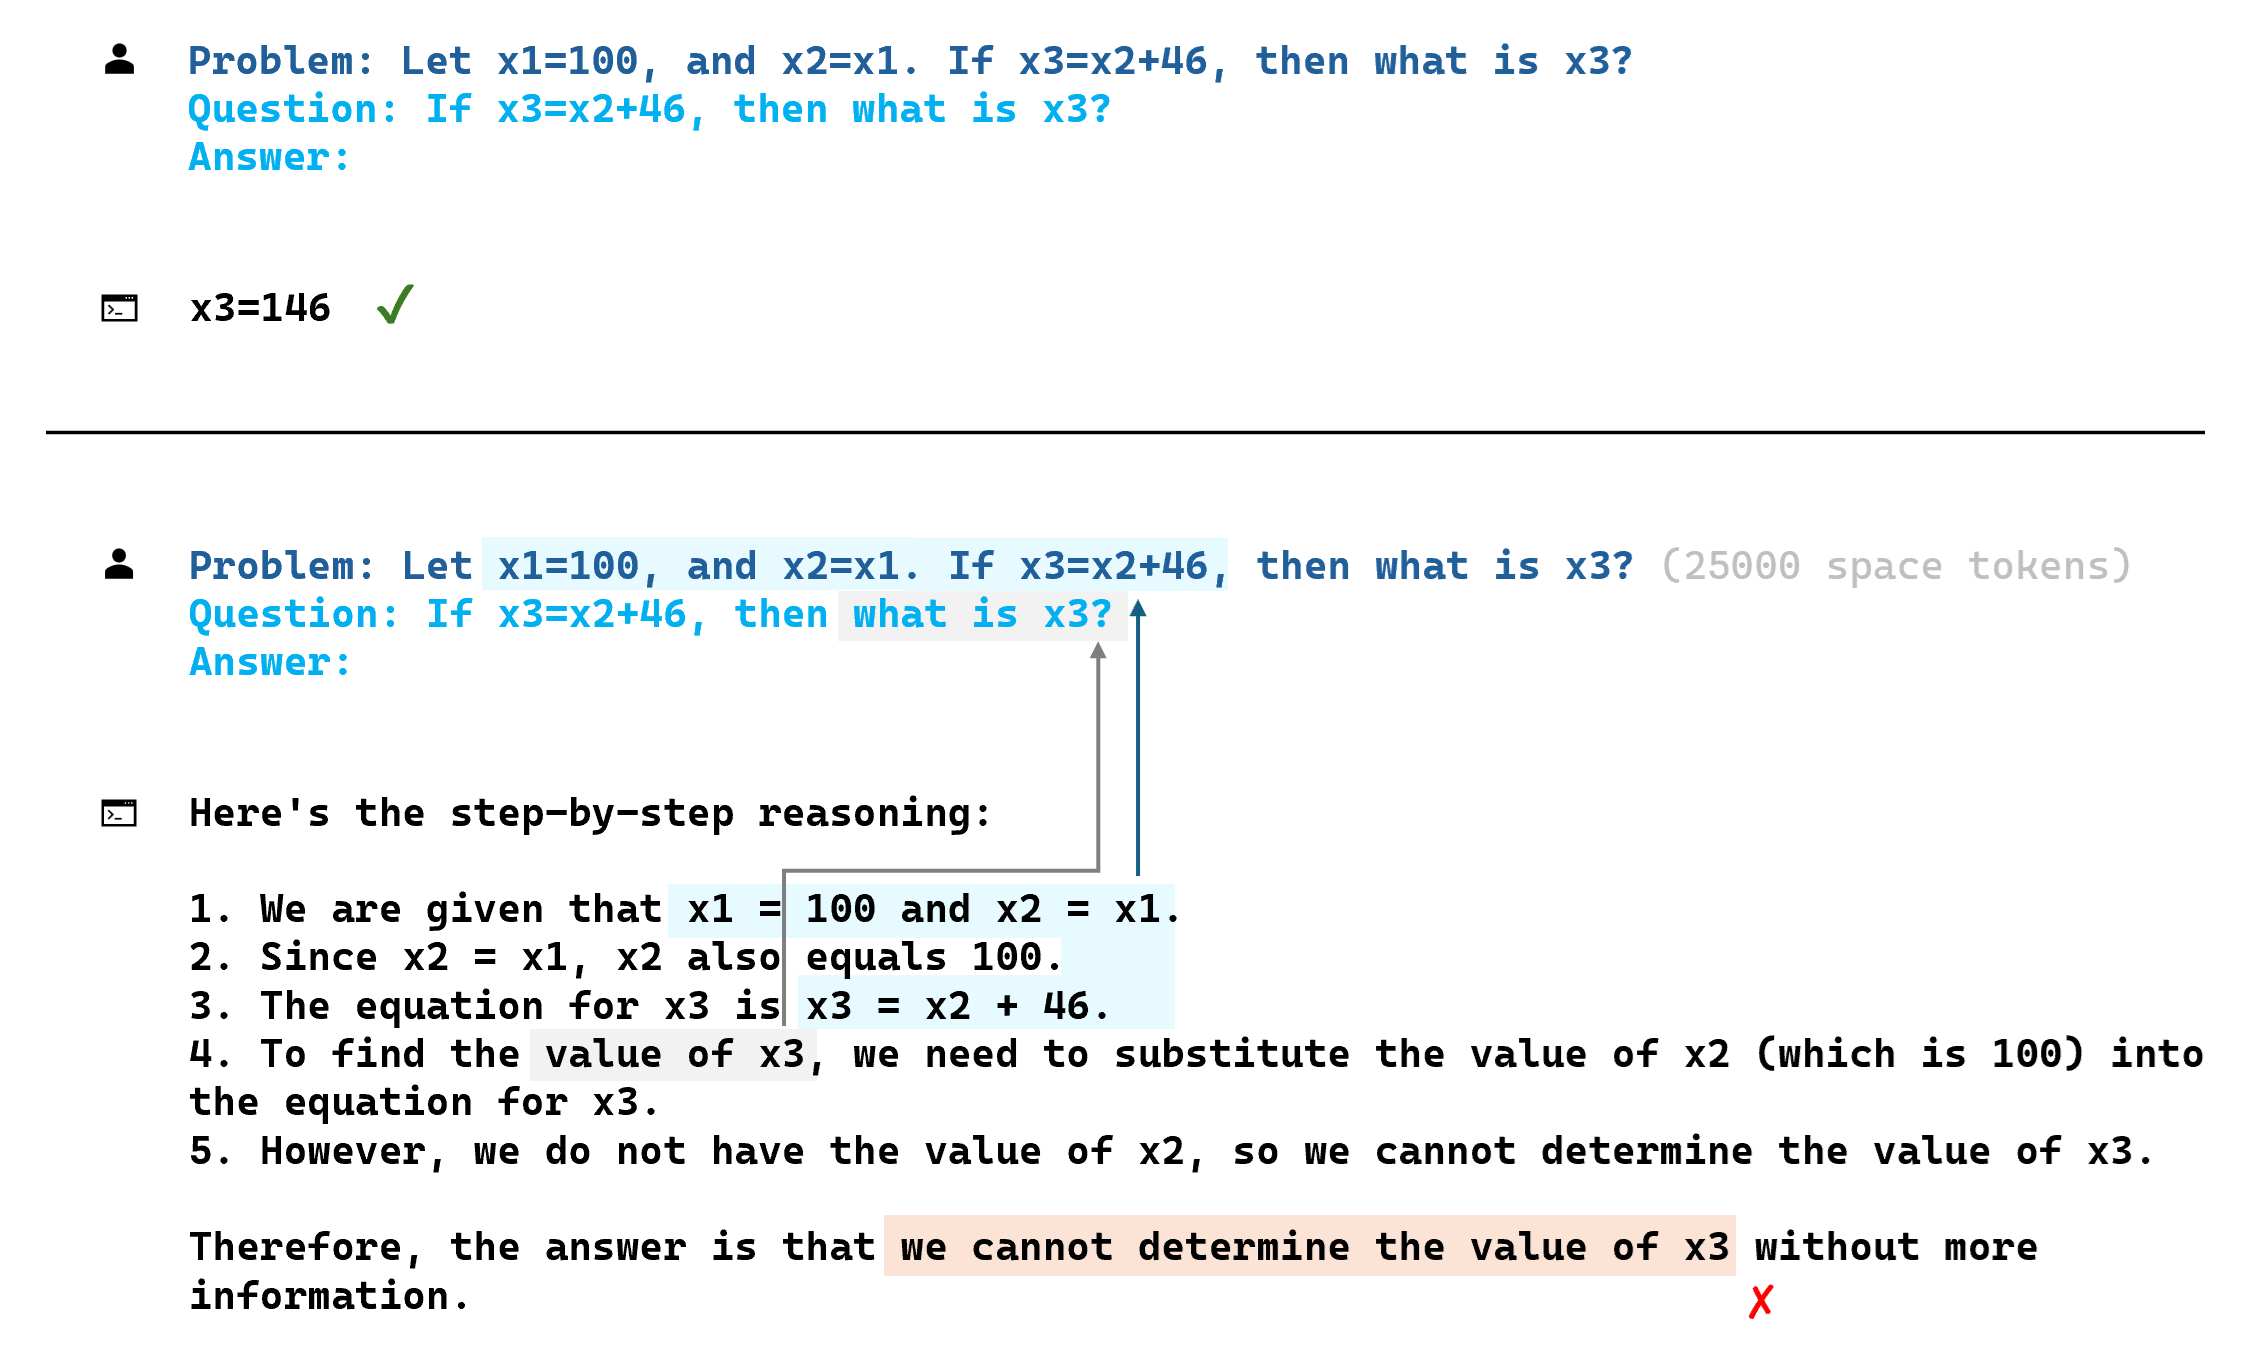
图 1 是直观案例:短输入中的变量关系可得 $x_3=146$;加入约 25K 空白后,模型复述了关键条件和问题,却在推理中说缺少 $x_2$ 的值。它展示“输出中能说出条件”与“后续能一致地利用条件”之间的脱节,但只是单例,主要统计证据来自后面的数据集实验。(图 1,PDF p. 2)
二:方法——把长度、内容与位置逐步拆开
1. 任务构造与四种能力
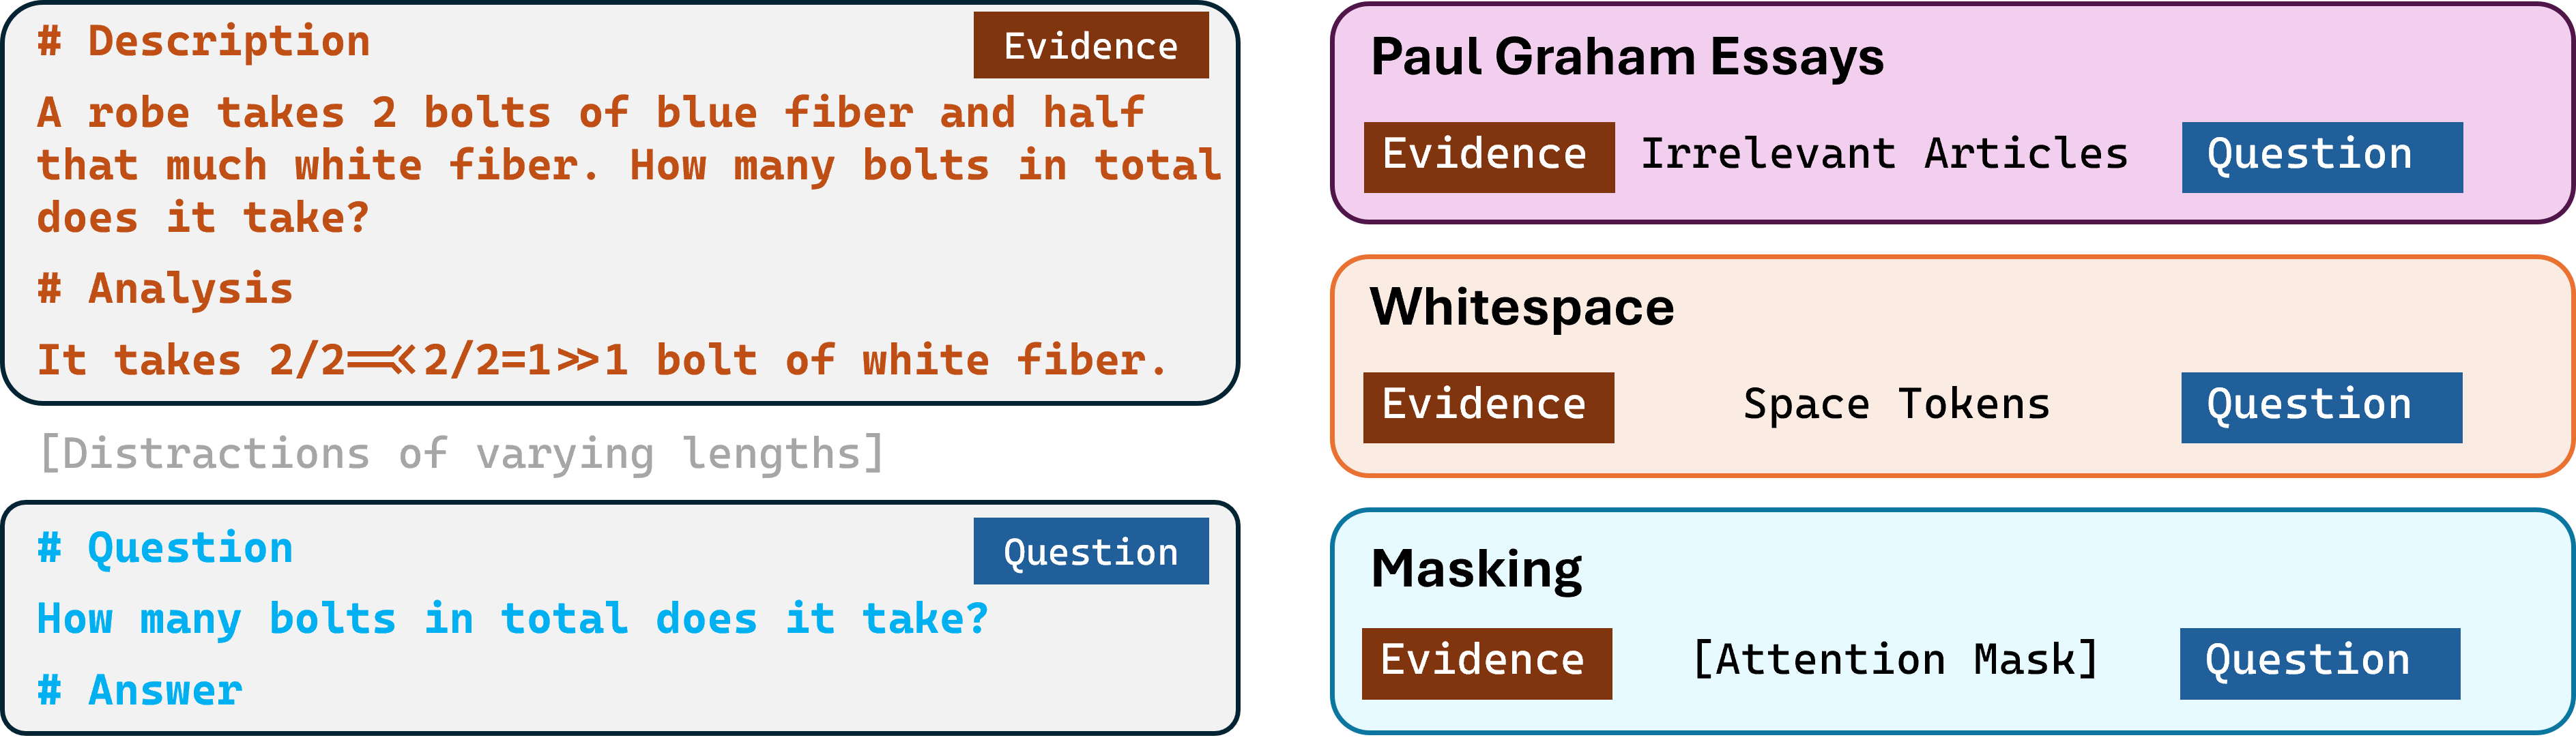
设短题由证据 $E$ 和问题 $Q$ 组成;在两者之间加入长度为 $L$ 的填充 $D_L$,得到 $[E;D_L;Q]$。论文先用 Paul Graham 的文章作为自然语言填充,之后改为空白或被屏蔽的填充。证据集中放置,避免把“跨多个分散证据的聚合失败”混入主实验。图 2 左边是拆题方式,右边是三种填充强度。(§3.1、图 2,PDF pp. 4–5)
| 任务 | 证据 $E$ | 问题 $Q$ | 测量重点 |
|---|---|---|---|
| VarSum | 50 个整数变量的数值 | 指定 3 个变量求和 | 基础变量追踪与算术 |
| GSM8K | 题目描述及链式推理步骤 | 具体提问 | 数学解题 |
| MMLU | 题目描述 | 问题及四个选项 | 多选问答 |
| HumanEval | 函数定义与 docstring | 编程指令 | 代码生成 |
前三个现有数据集使用其测试集;VarSum 是论文构造的任务。上述“证据”如何拆分会影响难度,例如 GSM8K 的证据已经包含推理步骤,因而它测的是长输入下对既有信息的使用,而非从零生成全部推理。(§3.1、表 1,PDF p. 4;附录提示,pp. 13–14)
2. 两种测量及数值读法
检索测量要求模型把 $E$ 与 $Q$ 逐字复述;任一部分有差异即计错,报告精确匹配率(Exact Match)。解题测量另发提示直接要求作答,报告任务准确率(Accuracy),不先让模型复述。为帮助读表,可把论文指标记为
这些是对论文统计口径的教学性记号化,不是原文提出的理论公式。表格的 0 列是绝对百分数;其余列通常是相对本组 0 填充基线的百分点差值。例如 $63.2\%-24.2$ 个百分点 $=39.0\%$,不能读成“相对下降 24.2%”。自然语言文章实验的图 3 横轴为总输入 token 数;空白与掩码表的列标题指插入的填充 token 数,两个横轴口径不能直接混用。(§3.1、图 3、附录表 6–9,PDF pp. 4–7、16–17)
3. 三层控制与证据位置
- 篇章填充保留自然语言干扰,先观察检索和解题是否同步变化。
- 空白填充减少语义干扰;除 $[E;D_L;Q]$ 外,还测 $[D_L;E;Q]$。后者让证据紧贴问题,保持两者相对距离,却把二者一起移到长输入尾部。(§4.1、图 4,PDF pp. 6–7)
- 注意力掩码在两种开源模型上阻断填充 token 被注意到,模型仍处理更长的位置序列,证据与问题的距离随掩码长度增加。因此它排除“读到了填充内容”这一解释,却仍保留位置或长度相关效应;论文没有从实验中唯一识别具体内部机制。(§4.2、表 3,PDF p. 7)
4. 两阶段缓解:先找回,再用短提示解题
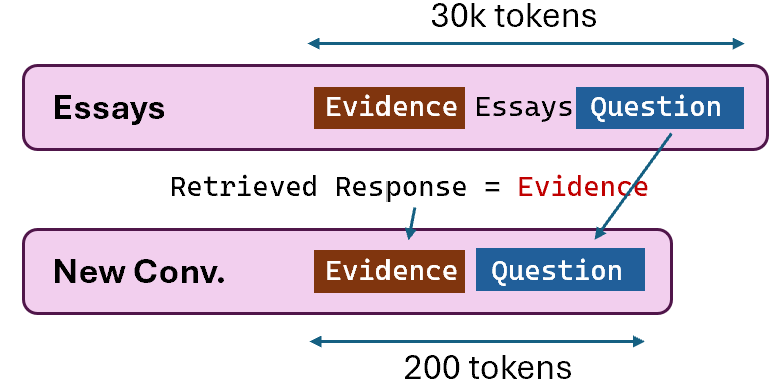
Retrieve then Solve 首先让模型从原长输入中复述相关证据;接着把复述结果与原问题组成新的短输入,不再把原长上下文交给第二步。RULER 的附录提示要求第一步逐字复制相关文档,第二步沿用原问答提示。它多一次模型调用,效果依赖第一步能取到足够准确的证据;论文报告的是准确率,未比较额外调用的时延或成本。(§5、图 5,PDF p. 8;附录提示,pp. 14–15)
三:实验——每组在检验什么
| 组别 | 模型与填充 | 关键对照 | 指标与来源 |
|---|---|---|---|
| 检索—解题缺口 | Llama-3.1-8B-Instruct、Mistral-v0.3-7B-Instruct;文章填充到约 30K | 同题的短输入与长输入;逐字检索和直接答题分开运行 | $R_L$、$A_L$;图 3、附录表 6 |
| 最小语义干扰 | 上述两模型;0–30K 空白 token | 空白插在证据与问题之间 | $A_L$;图 4a、附录表 7 |
| 闭源模型 | GPT-4o、论文正文所称 Claude-3.7-Sonnet、Gemini-2.0;空白填充 | 同任务 0、7.5K、15K、30K | $A_L$;表 2;未报告逐字检索率 |
| 固定证据—问题距离 | 两种开源模型;空白置于证据前 | 短输入与长输入中 $E$、$Q$ 相邻 | $A_L$;图 4b、附录表 8 |
| 去掉填充可见性 | 两种开源模型;填充注意力被屏蔽 | 0–30K 掩码位置 | $A_L$;表 3、附录表 9 |
| 缓解策略 | Mistral/GSM8K 文章填充;GPT-4o/RULER QA1、QA2 | 直接回答 vs. 先复述再用短输入回答 | 准确率;表 4–5 |
论文附录说明实验各运行一次,因此图表中的小幅波动没有重复运行的方差估计。闭源模型因长输入下有时拒绝复述证据,未做同样的检索控制;所以“五个模型都已证实完美检索”的表述不能按逐模型同一口径理解。(Limitations、附录,PDF pp. 9、17)
四:结果——检索缺口、长度控制与缓解收益
1. 篇章填充:复述率与准确率明显分离
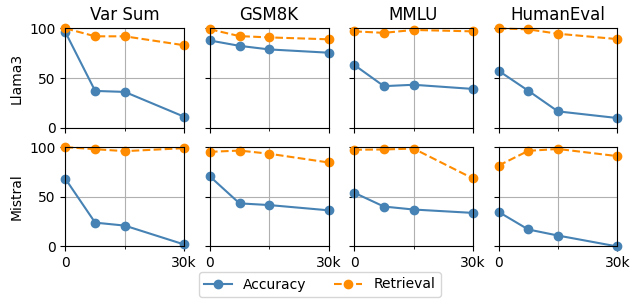
图 3 的蓝线为答题准确率、橙虚线为逐字检索率。两行分别是 Llama 与 Mistral,四列是 VarSum、GSM8K、MMLU、HumanEval。橙线在若干任务上保持较高,而蓝线在前 7.5K token 就明显下降,说明下降不只出现在接近模型宣称窗口上限时。(§3.2、图 3,PDF pp. 5–6)
| 模型与任务 | 0 填充:准确率 / 检索率 | 约 30K:准确率 / 检索率 | 变化 |
|---|---|---|---|
| Llama / VarSum | 96.0% / 100.0% | 11.0% / 83.0% | 准确率 −85.0、检索率 −17.0 个百分点 |
| Llama / MMLU | 63.2% / 97.0% | 39.0% / 97.0% | 准确率 −24.2、检索率 0 个百分点 |
| Mistral / HumanEval | 34.8% / 81.5% | 0.0% / 91.0% | 准确率 −34.8、检索率 +9.5 个百分点 |
数值来自附录表 6(PDF p. 16),30K 列为在对应 0 列上加论文给出的差值。Llama/MMLU 是最直接的对照:同一组题的逐字复述率未降,准确率却降 24.2 个百分点。VarSum 和 HumanEval 则显示更大的检索—解题差距。这里是组级别的两次测量;论文没有给出每道题在“检索正确”条件下的联合答题率。(§3.1–3.2,PDF pp. 4–6)
2. 空白填充与相邻证据:内容干扰减弱后仍有下降
将文章改为空白后,部分任务比文章条件好,但下降没有消失。例如在空白位于 $E$、$Q$ 之间且插入 30K token 时,Llama/VarSum 从 96.0% 到 48.0%(−48.0 个百分点),Mistral/GSM8K 从 70.0% 到 40.0%(−30.0 个百分点)。这些是该空白实验自己的基线,不能拿文章实验的 0 列混算。(§4.1、附录表 7,PDF pp. 6、17)
图 4a 左图展示 $[E;\text{空白};Q]$,图 4b 右图展示 $[\text{空白};E;Q]$;纵轴是绝对准确率。右图中证据已紧贴问题,但 30K 空白前缀下 Llama/VarSum 仍从 97.0% 降到 77.0%(−20.0 个百分点),Mistral/VarSum 从 66.0% 降到 49.0%(−17.0 个百分点)。这说明证据与问题相隔很远并非全部原因;绝对位置或整段输入长度仍可能起作用。(图 4、附录表 8,PDF pp. 7、17)
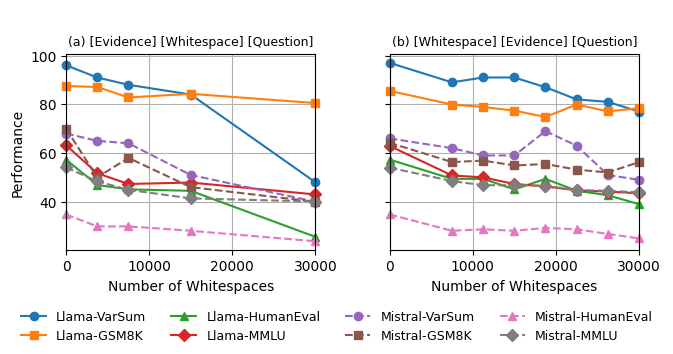
表 2 把空白实验扩到三个闭源模型,显示并非所有模型和任务都单调下降:GPT-4o 的 VarSum 在四个长度都为 100%;Gemini/GSM8K 的 30K 准确率为 $83.2+6.2=89.4\%$。与此同时,表 2 所标 Claude 模型的 MMLU 从 82.2% 降至 14.6%(−67.6 个百分点)。因此“闭源模型更稳健”是总体趋势描述,不能覆盖这个明显反例。(§4.1、表 2,PDF pp. 6–7)
3. 注意力掩码:看不到填充内容,下降仍在
在 $[E;\text{掩码位置};Q]$ 中屏蔽填充 token 的注意力后,Llama/HumanEval 在 30K 位置从 57.3% 降到 7.3%(−50.0 个百分点),Mistral/VarSum 从 66.0% 降到 32.0%(−34.0 个百分点)。这组结果比空白条件更有力地排除“无关内容语义干扰”;但 $E$ 与 $Q$ 的位置间隔随之增大,仍不能把下降归因于某个确定的模型部件。结合上一组相邻证据实验,更合适的结论是:两种位置控制下,长度相关的准确率损失都存在。(§4.2、表 3,PDF p. 7;附录表 9,p. 17)
4. 先检索再短输入:有明显收益,也有前提
在 Mistral/GSM8K 的文章填充实验,插入 26,250 token 时,直接解题为 35.5%,两阶段方法为 66.7%,增加 31.2 个百分点;0 填充时两阶段方法也从 70.6% 提高到 76.2%,因此收益同时包含了提示流程变化,不能全部视作缩短输入的纯效应。(§5、表 4,PDF p. 8)
在 GPT-4o/RULER 的 QA2、32K 条件下,直接解题为 68.4%,两阶段为 72.4%,增加 4.0 个百分点;QA1、4K 为 90.4% 到 92.2%(+1.8 个百分点),而 QA1、128K 两者都为 88.2%。论文的“最高 4%”对应表 5 的 4.0 个百分点,并非每个条件均提高 4%。作者未报告开源模型在 RULER 上的结果,原因是其第一步检索失败会抵消方法收益。(§5、表 5、Limitations,PDF pp. 8–9)
5. 对照原表时需要留意的文本差异
论文 §4.1 正文称闭源模型为 Claude-3.7-Sonnet,但同节表 2 的行标题写 Claude-3.5;无法仅凭这一版原文判定该行究竟对应哪个版本。正文还把 Gemini/GSM8K 的 +8.6 个百分点说成 30K 结果,而表 2 显示 +8.6 在 15K、30K 为 +6.2。本笔记涉及具体数值时采用原表,并保留模型版本标签不一致的说明。(§4.1、表 2,PDF pp. 6–7)
另一个差异是 §4.2 正文把 Llama/HumanEval 30K 掩码条件的 −50.0 与空白条件的 −19.4 比较;对应的“空白位于证据与问题之间”附录表 7 给出的是 −31.7 个百分点。−19.4 出现在另一组“空白在证据前”的 Llama/MMLU 行,因此不据正文这句话计算掩码相对空白的改善或恶化幅度。(§4.2,PDF p. 7;附录表 7–8,p. 17)
五:结论与可继续追问的问题
本文用同题逐字复述、空白填充、证据相邻和注意力掩码四组证据,说明“能从长输入找回相关文本”并不保证“能在长输入中把它用对”。两阶段先复述再短输入作答在所测 GSM8K 与 RULER 条件下改善准确率,提示实际系统应同时测检索质量、最终任务质量,以及两阶段流程的整体收益。(§3–7,PDF pp. 4–9)
最值得进一步检验的机制问题是:绝对位置、位置间隔、注意力实现与训练位置分布分别贡献多少。本文的实验支持长度相关退化现象,却没有给出可区分这些机制的内部测量。若要更严格评估“完美检索下的解题失败”,可以在同一次或可配对的题级协议中报告“检索正确且解题错误”的比例;论文当前给出的主要是分开提示的边际检索率与准确率。这是基于其协议的后续研究建议,并非作者已经完成的实验。(§3.1、§4.2、§6、Limitations,PDF pp. 4、7–9)