RACE Attention:用可微哈希桶实现线性注意力
论文:RACE Attention: A Strictly Linear-Time Attention Layer for Training on Outrageously Large Contexts
作者:Sahil Joshi、Agniva Chowdhury、Amar Kanakamedala、Ekam Singh、Evan Tu、Anshumali Shrivastava(Rice University)
版本:arXiv:2510.04008v5,2026-04-18 修订;获取与研读日期:2026-10-15。
链接:arXiv · 本地原文 PDF · 作者代码 · 英文幻灯片 · 可编辑 TeX。下文页码均为从 1 开始的 PDF 页码,与本版本印刷页码一致。
论文总览
RACE Attention 的核心是把“查询与所有键逐一匹配”改写成“查询读取少量桶中的汇总统计”。它先选用可由随机超平面哈希碰撞概率表示的幂次角度核,再用可微的软桶分配近似硬哈希。每个桶保存键的总质量和对应值的加权和,查询通过这两类统计得到归一化输出。RACE 全称为 Repeated Arrays-of-Count Estimators,即重复计数数组估计器。
固定哈希表数 $L$ 和每表超平面数 $P$ 时,桶数 $R=2^P$ 固定,注意力核心计算为 $O(LNRd)$:对序列长度 $N$ 和每头维度 $d$ 均为线性。因果版本把桶统计换成前缀累加,具备固定大小的递归状态。(Sec. 3.2,p. 7;Algorithm 2,p. 27。)
最有代表性的任务结果是:WikiText-103 的 1024-token 自回归建模中,RACE 与 FlashAttention2 的困惑度均为 20.9;64K Arxiv 分类中,RACE $(P,L)=(3,3)$ 达到 97.92%,训练每轮 584 秒,对照 FlashAttention2 的 97.00%、1645 秒。另一方面,GPU 1200 万 token、CPU 7500 万 token 来自单层一次前向—反向压力测试,代表算子容量与运行时间,任务效果的最长测试仍是 64K。(Tables 1、4,p. 9;Fig. 4,p. 10。)
理论分析解释了软化偏差与哈希采样误差的来源,但附录归一化引理遗漏了软哈希偏差项。本文读法因此是:把可计算的桶机制、任务结果和作者提出的误差界分别理解,并检查误差界成立所需条件。
结构地图
| 原文章节 | 论证作用 | PDF 位置 |
|---|---|---|
| 1 Introduction | 二次复杂度瓶颈、已有线性方法及 RACE 思路 | pp. 1–4;Fig. 1;Eqs. (1)–(2) |
| 2.1 Locality-Sensitive Hashing (LSH) | 相似向量更容易哈希碰撞 | p. 4 |
| 2.2 RACE Sketch | 用碰撞计数估计核密度和 | p. 4;Lemma 1 |
| 3.1 Softmax-Like Similarities that Admit Linear-Time Estimation | 归一化相似度、幂次角度核、与 YOSO 的关系 | pp. 5–6;Eqs. (3)–(4);Figs. 2–3 |
| 3.2 The Final Algorithm | 软分桶、桶聚合、全局归一化和复杂度 | pp. 6–7;Algorithm 1 位于 p. 5 |
| 3.3 Theoretical Analysis of Algorithm 1 | 非因果输出误差界及假设 | pp. 7–8;Theorem 2 |
| 4 Experiments | 分类、语言建模、CPU/GPU 极长序列测试 | pp. 8–11;Tables 1–4;Figs. 4–5 |
| 5 Conclusion | 贡献与 KV 缓存、因果理论等后续方向 | p. 12 |
| 5.1 Additional Notes on Experiments | 数据构造、训练设置、更多任务与维度扩展 | pp. 15–17;Tables 5–10;Fig. 6 |
| 6.1 Setup and assumptions | 单位范数 Q/K、目标核及随机特征定义 | pp. 17–18 |
| 6.2 Kernel construction with the bias term | 矩阵集中界、软哈希偏差 | pp. 18–23;Theorem 6;Lemma 8 |
| 6.3 From kernels to attention (numerator vs. denominator) | 从核误差传播到归一化输出误差 | pp. 23–27;Lemmas 9–12;Theorem 13 |
| 6.4 Causal Race Attention | 前缀桶更新和实现说明 | pp. 27–29;Algorithm 2;Figs. 7–8 |
一:动机——改变注意力的计算对象
标准注意力为
FlashAttention 通过分块与融合减少存储和访存开销,但精确注意力仍需处理 $N^2$ 个查询—键相互作用。RACE 要减少的是相互作用的数量:每个查询只与 $LR$ 个桶统计交互。
论文的设计分成两个问题。第一,怎样选一种仍能突出相似 token 的非负核?第二,怎样在不生成 $N\times N$ 矩阵的情况下计算归一化加权和?它用幂次角度核回答前者,用软哈希特征和结合律回答后者。
在论文的比较框架中,Linear Attention 用简单正特征映射重排乘法;Performer 用随机特征;Linformer 用序列维投影;YOSO 则与 RACE 共用幂次角度核,但采用硬哈希与替代梯度。RACE 的差异在于软分桶可以直接求导,同时显式估计分子和分母。(Secs. 1、3.1,pp. 2–3、6。)
这里需要保留复杂度参数:一个 $m$ 维特征映射的线性注意力,核心乘法一般是 $O(Nmd)$;只有 $m$ 随 $d$ 增长时才成为 $O(Nd^2)$。因此,论文对某些基线维度扩展较差的观察,不能概括为所有随机特征方法对 $d$ 必然二次。RACE 的特征宽度同样要付费,只是它由 $L2^P$ 控制。
二:方法——从角度碰撞到可微的桶记忆
2.1 先区分三个不同的注意力对象
对任意非负相似度,论文 Eq. (3) 定义
标准 softmax 对应指数点积核;Angular Attention 对应下式;RACE Attention 则用随机软哈希特征近似该角度核,再计算归一化输出:
角度核在夹角为 $0,\pi/2,\pi$ 时分别为 $1,1/2,0$。取幂后,正交向量的相似度变成 $2^{-\gamma}$,高相似与低相似之间的比例被拉大。例如两个角度核值为 $0.9$ 和 $0.6$,其比值从 $1.5$ 变成 $1.5^4\approx5.06$;这是幂次锐化的直觉。(Eq. (4),p. 6;数字例子为教学解释。)
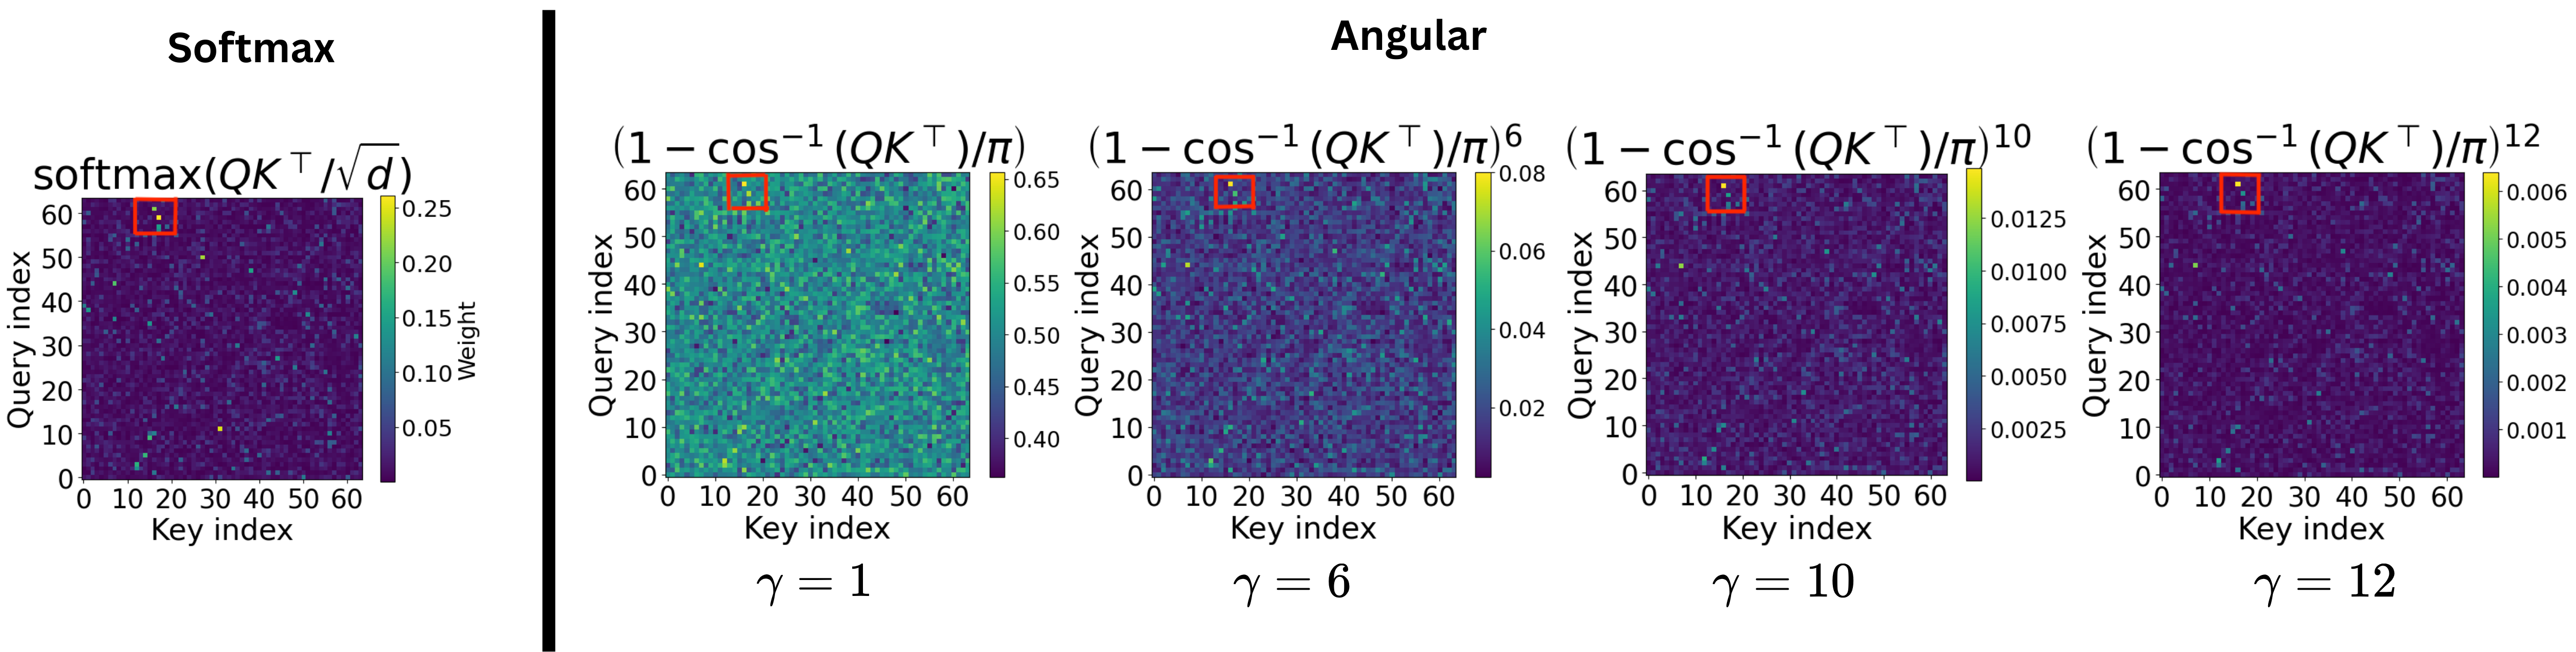
原文 Fig. 3,p. 6。横轴为 key index,纵轴为 query index;从左到右为 softmax,以及 $\gamma=1,6,10,12$ 的角度核。高次幂让高相似位置更突出。各面板色条范围不同,适合比较注意力集中位置,不能仅凭颜色判断数值相等。Fig. 2(p. 5)的误差曲线也仅支持所展示设置下的近似效果。
角度核对正的尺度缩放不变,而指数点积核会随范数变化,二者并无一般等价关系。论文的输出误差定理以 Angular Attention 为参照;实验中的 Angular $(\gamma=8)$ 仍显式计算两两相似度,其开销是二次的。
2.2 符号和维度
| 符号 | 含义 | 维度/关系 |
|---|---|---|
| $N,d$ | token 数、算法中的每头维度 | $Q,K,V\in\mathbb R^{N\times d}$ |
| $L$ | 独立哈希表数 | 控制重复估计次数 |
| $P$ | 每表随机超平面数 | 同时决定硬碰撞核的幂次 |
| $R$ | 每表桶数 | $R=2^P$ |
| $W^{(\ell)}$ | 第 $\ell$ 张表的高斯投影 | $P\times d$ |
| $v_r$ | 第 $r$ 个超立方体顶点 | $v_r\in\{\pm1\}^P$ |
| $\beta$ | 软分桶的锐化系数 | 越大越接近硬哈希;实验中可学习 |
| $\Phi_Q^{(\ell)},\Phi_K^{(\ell)}$ | Q/K 的桶概率矩阵 | $N\times R$ |
| $A^{(\ell)},B^{(\ell)}$ | 桶质量、桶值和 | $R$、$R\times d$ |
后文理论中 $A=D^{-1}S$ 表示注意力矩阵,与带上标的桶质量 $A^{(\ell)}$ 不同。原文 Table 5 的 $d$ 用作模型配置字段,不能直接与单头算法维度混用。
2.3 硬哈希为什么对应幂次角度核
取 $w\sim\mathcal N(0,I_d)$,按 $\operatorname{sign}(w^\top x)$ 分为两侧。随机超平面把两个向量分开的概率等于夹角除以 $\pi$,故
串联 $P$ 个独立符号位,得到 $2^P$ 个桶;所有位同时相同的概率为 $\kappa_{\rm ang}(q,k)^P$。因此 RACE 算法的目标幂次是 $\gamma=P$。增加 $P$ 不只是增加近似预算,也改变了目标核的锐度;增加 $L$ 才是在保持目标幂次下重复估计。(Sec. 2.2,p. 4;Sec. 3.2,p. 7。)
经典 RACE 用多张表的碰撞计数估计核和。硬哈希的计数估计可以无偏,但经过有限温度软化后会出现偏差,而且“无偏的分子、分母”本身也不保证其比值无偏。
2.4 软分桶怎样让训练可微
Algorithm 1 的特征定义为
每个 token 对全部 $R$ 个桶分配非负且和为 1 的质量。原文把 $\beta$ 称为 temperature,但它乘在 logits 上,按通常参数化更接近逆温度:$\beta$ 增大使分布变尖;$\beta\to0$ 时所有桶趋于等概率。这里的 softmax 作用于小桶集合,不作用于 $N$ 个 token。
当 $\beta\to\infty$,概率集中到 $\operatorname{sign}(Wx)$ 对应的顶点,恢复硬哈希。有限 $\beta$ 则允许梯度通过 $\tanh$ 和桶概率传播到 Q/K。实验明确把 $\beta$ 作为可学习参数;随机投影的数学分析依赖独立高斯表。(Algorithm 1,p. 5;Sec. 4,p. 8。)
一个有用的分解来自附录证明。设顶点第 $t$ 位为 $v_{r,t}$,则
因此一张表是在组合 $P$ 个“软符号位”。但 Algorithm 1 仍形成 $2^P$ 个桶,不能因存在因子分解就把其聚合代价写成 $O(P)$。(Sec. 6.2,p. 22。)
2.5 聚合与读取:算法真正节省的位置
先让所有键写入桶:
其中 $A_r^{(\ell)}=\sum_j\phi_r^{(\ell)}(K_j)$ 是桶总质量,$B_r^{(\ell)}=\sum_j\phi_r^{(\ell)}(K_j)V_j$ 是桶值和。随后查询读取:
展开后等价于使用
实现中不构造 $\widehat S$,而是利用结合律先计算 $\Phi_K^\top V$。这一步将两两交互变成“写桶—读桶”。所有表的分子、分母分别求和后才相除;逐表归一化再平均,或先把每个桶除以自己的质量再混合,都不是上述定义。(Algorithm 1,p. 5。)
教学例子。 单张表、两个桶,设两个键的分配分别为 $(0.8,0.2)$、$(0.1,0.9)$,标量值为 $2,10$,查询分配为 $(0.75,0.25)$。则 $A=(0.9,1.1)$、$B=(2.6,9.4)$,分子为 $4.3$、分母为 $0.95$,输出为 $4.5263$。等价的两个键权重为 $0.65,0.30$,归一化后得到同一结果。桶质量不可省略。
原文 Fig. 7(p. 28)将流程画成桶内归一化再混合,未显式展示 Algorithm 1 的查询相关分母;两者若按字面执行一般不等价。理解数学定义时应以 Algorithm 1 的全局比值为准。
2.6 因果版本:把全局桶换成前缀桶
自回归位置 $t$ 只聚合 $j\le t$:
Algorithm 2 先写入当前键值、再读取,因此包含当前位置。固定随机特征映射时,递归状态只需 $LR(d+1)$ 个标量,单步核心计算与已有序列长度无关。训练中的全部激活和反向计算另计,不能把递归状态大小当作整段训练峰值内存。论文用 OpenMP/CUDA 实现前缀扫描;完整解码系统与 KV 缓存收益在结论中列为后续工作。(pp. 27–28;Sec. 5,p. 12。)
2.7 “严格线性”的条件和代价
每表投影、桶 logits、写入与读取的代价依次为
合计 $O(LN(dP+PR+Rd))$;在论文使用的小 $P$、固定 $L,R$ 设置下简写为 $O(LNRd)$。这里给定 Q/K/V,未把上游稠密 QKV 投影、FFN 的 $d^2$ 开销归入注意力核心。
| $(P,L)$ | 每表桶数 $R$ | 总桶数 $LR$ | 含义 |
|---|---|---|---|
| $(2,2)$ | 4 | 8 | 小状态、低常数 |
| $(3,3)$ | 8 | 24 | 中间预算 |
| $(4,4)$ | 16 | 64 | 更锐的目标核、更大状态 |
| $(8,4)$ | 256 | 1024 | 仅作复杂度例子,非论文主实验配置 |
正文给出的特征/桶工作空间为 $O(L(NR+Rd))$,完整输入输出还含 $O(Nd)$,反向激活依赖实现。即使使用 RACE,也不能消除每个 token 的输出向量。
本次分析:固定桶数同时限制表示能力。 把各表特征拼接后,非因果近似核的秩至多为 $LR$;非零对角行归一化不会改变这一秩上界。RACE 因而也属于具有有限特征容量的近似。它的贡献是特征构造、可微哈希及归一化机制,而不是绕开固定容量与精度的取舍。因果掩码会改变矩阵结构,不能把这个全局秩界直接搬到因果注意力矩阵。
2.8 理论:误差被分为软化偏差与采样波动
Theorem 2(p. 8)声明,非因果情况下以概率至少 $1-\delta$ 有
参照输出 $O$ 来自 $P$ 次角度核。该界揭示的设计方向是:增大 $\beta$ 减少软化偏差,增大 $L$ 减少独立表之间的采样波动。
完整证明还依赖以下条件:
- Sec. 6.1(p. 17)假设 Q/K 为单位向量。有限 $\beta$ 的 $\tanh(Wx)$ 会受输入范数影响,因此不能把目标角度核的尺度不变性自动赋予软特征。
- (A1) 要求 $s_{\min}=\min_i\sum_jS_{ij}\ge C_1N$。它要求平均核质量有正下界,强于“分母非零”;锐化后 $C_1$ 可能变小,并进入隐藏常数。
- (A2) 为 $\|S\|_2\le C_2N$,因 $S_{ij}\in[0,1]$ 可取 $C_2=1$。
- Theorem 13(p. 26)保留行和扰动条件 $\|E\|_2\le s_{\min}/2$。p. 27 在 $L\ge\log(2N/\delta)$ 时才把 $\log(2N/\delta)/L$ 项吸收到平方根项中。
证明主线是:先定义 $\widetilde B=\mathbb E\widehat S^{(\ell)}-S$,用软概率偏离硬顶点的质量给出 $\|\widetilde B\|_2=O(NP/\beta)$;再对独立表使用矩阵 Bernstein 不等式,控制 $\widehat S-\mathbb E\widehat S$;最后通过归一化扰动恒等式把核误差传到输出。
核层面的显式界为(Theorem 6,pp. 19–20)
正文所谓“取 $L=\Theta(\log N)$ 控制方差”指上述界的参数系数;这样选择时计算量变为 $O(N\log N\,Rd)$。固定 $L$ 的严格线性运行时间与随 $N$ 调整预算的误差控制,是两个不同的说法。另外右端含 $\|V\|_F$,当每个值向量大小固定而 $N$ 增大时,它一般会随 $\sqrt N$ 增长。
2.9 归一化引理中的偏差漏项
以下是本次分析。 Lemma 10(p. 24)声称,只要 $L\ge(2/C_1^2)\log(2N^2/\delta)$,便可高概率保证 $\|E\|_2\le s_{\min}/2$。其证明把每表软核的均值写成 $S_{ij}$,但 Sec. 6.2 已定义非零偏差 $\widetilde B$;Hoeffding 应围绕 $\mathbb E\widehat S_{ij}$ 集中。
令 $b=\max_{ij}|\mathbb E\widehat S_{ij}-S_{ij}|$。保留该偏差后,同样的逐元素集中与 union bound 给出
要令它不超过 $C_1/2$,必须同时控制 $b$ 与 $L$。例如充分条件是 $b\le C_1/4$ 且 $L\ge(8/C_1^2)\log(2N^2/\delta)$;其中 $b$ 又受 $P,\beta$ 控制。
一个确定性的反例说明这不是无关紧要的省略。取所有 Q/K 都为同一单位向量,$P=2$、$\beta=0.1$。此时目标核全为 1,$s_{\min}=N$。由于每个软桶 logit 位于 $[-0.2,0.2]$,任意桶概率至多 $e^{0.4}/4<0.373$,所以每表的 $\widehat S^{(\ell)}_{ij}=\|\phi^{(\ell)}(x)\|_2^2<0.373$。平均后仍满足同一上界,任意 $L$ 都有 $\|E\|_2>0.627N>N/2$,与引理声明冲突。
这指出的是 Lemma 10 及其用于主定理证明的条件缺口;在该反例中归一化后的输出仍可完全一致,不能据此声称所有输出误差结论都被反驳。较稳妥的理解是:核层面的偏差—方差分解有明确依据,向归一化输出传播时需要补上偏差相关条件。因果版本则由作者明确列为尚无对应理论保证。(Sec. 3.3,p. 8。)
三:实验——分别检验任务质量与算子扩展
3.1 任务、对照和指标
| 问题 | 数据与长度 | 指标/对照意义 |
|---|---|---|
| 更换注意力能否保留常规任务效果 | CIFAR-10、FashionMNIST、QNLI、Yahoo、IMDB、SST-2 | 分类准确率,越高越好 |
| 是否支持双向语言训练 | Tiny Stories,512/1024 | 掩码语言建模 PPL,越低越好 |
| 是否支持因果预测 | WikiText-103 @1024、PTB @128 | 自回归 PPL,越低越好 |
| 长序列中是否兼顾质量和时间 | Arxiv 16K/32K/64K;Food-101 16K | 准确率与每 epoch 的训练/测试秒数 |
| 长程任务表现 | LRA ListOps @2000、Text Retrieval @8000 | 准确率 |
| 算子能处理多长输入 | 单个注意力层、batch 1、4 heads、报告的 $d=128$ | 一次前向+反向的墙钟时间与最长运行长度 |
FlashAttention2 提供精确 softmax 对照;Linear、Performer-256、Linformer-128 分别代表简单特征、随机特征和序列投影近似;Angular $(\gamma=8)$ 用于观察替换相似度函数后的任务效果;YOSO-16 提供硬哈希相关对照。Angular 的 $\gamma=8$ 与主实验 RACE 的 $P=2,3,4$ 不一致,这些任务分数不能直接当成固定同一目标核下的近似误差测量。
所有质量实验在单张 A100 上完成,结果取最佳验证 checkpoint。AdamW 与学习率设置见 Table 5(p. 15);通常前 1% 更新 warmup、之后线性衰减,学习率低于 $2\times10^{-4}$ 时使用恒定学习率。Tiny Stories 使用 20,000 个故事。困惑度(perplexity,PPL)是所评估位置上平均负对数似然的指数;值越低,说明模型给目标词分配的概率越高。掩码建模与因果建模评估的预测条件不同,PPL 不宜跨任务横比。
3.2 决定比较含义的数据构造
Arxiv:先筛选较长文档,再按类别把同类文档依次拼接到目标 token 长度。16K、32K、64K 的训练/测试样本数分别是 1947/209、3650/520、3882/384。不同长度下数据集本身也发生变化,因此跨长度准确率上升同时包含样本构造的影响。该任务更接近同类文档集合的分类,不能用它单独说明远距离精确检索能力。(Sec. 5.1,pp. 15–16。)
Food-101:删除 50 个类别,保留 51 类;20,000 张训练图像、2500 张测试图像。图像分辨率 $512\times512$,patch 与 stride 均为 4,得到 $128^2=16384$ 个 token。RACE 和 FlashAttention2 用 batch 8;Linear、Linformer、Performer 因 OOM 改用 batch 1。于是后三者与 RACE 的每 epoch 时间差同时包含 batch size 与显存限制的影响。(Table 3 说明,p. 9;Sec. 5.1,p. 16。)
3.3 关键模型设置
| 实验 | 层/头/模型配置 $d$ | batch;训练轮数 | 其他关键设置 |
|---|---|---|---|
| WikiText-103 | 8/8/512 | 16;100 | lr $6\times10^{-4}$,dropout 0.1 |
| PTB | 1/2/128 | 16;70 | lr $6\times10^{-4}$,dropout 0.3 |
| Tiny Stories | 6/4/384 | 32;150 | 20,000 stories |
| Arxiv | 4/4/256 | 2;100 | lr $3\times10^{-4}$,梯度累积 16 |
| Food-101 | 8/8/512 | RACE/FA2 为 8;100 | lr $3\times10^{-4}$,梯度累积 4 |
| LRA Text Retrieval | 4/2/384 | 1;20 | lr $2\times10^{-4}$ |
来源:Table 5,p. 15。它们与单层压力测试的 batch 1、4 heads、$d=128$ 是独立设置。
四:结果——质量相近,扩展收益随长度增加
4.1 常规分类与掩码语言建模
| 方法 | CIFAR-10 @1024 Acc.% ↑ | QNLI @2048 Acc.% ↑ | Tiny Stories @1024 PPL ↓ |
|---|---|---|---|
| RACE (2,2) | 63.7 | 60.7 | 4.2 |
| RACE (3,3) | 62.5 | 60.7 | 3.2 |
| RACE (4,4) | 65.9 | 61.1 | 2.6 |
| FlashAttention2 | 61.44 | 61.1 | 2.7 |
| Angular ($\gamma=8$) | 61.69 | 61.7 | 2.5 |
| Linear | 60.0 | 60.7 | 7.0 |
| Linformer-128 | 63.7 | 60.6 | 3.7 |
| Performer-256 | 64.9 | 61.0 | 10.0 |
| Sigmoid | 57.2 | 61.1 | 3.7 |
来源:Table 2,p. 9。RACE (4,4) 在 CIFAR-10 比 FA2 高 4.46 个百分点;QNLI 持平;Tiny Stories PPL 低 0.1。RACE (2,2) 在 Tiny Stories 上的 PPL 仍为 4.2,说明极小桶预算存在任务损失,不能把最佳配置结果赋给所有预算。
4.2 因果语言建模与参数预算
| 方法/配置 | WikiText-103 @1024 PPL ↓ |
|---|---|
| RACE (2,2) | 23.9 |
| RACE (2,3) | 23.4 |
| RACE (3,3) | 21.9 |
| RACE (3,4) | 21.5 |
| RACE (4,4) | 20.9 |
| FlashAttention2 | 20.9 |
| Angular ($\gamma=8$) | 19.0 |
来源:Table 4,p. 9。保持 $P=2$ 或 $P=3$ 时增加一张表,PPL 分别下降 0.5、0.4;增大整体预算后 RACE 达到 FA2 水平。Angular 的 19.0 更好,但仍付出两两相似度开销,且目标幂次不同。
PTB @128 上 RACE (2,2)、(3,3)、(4,4) 分别为 54.7、54.2、53.4,FA2 为 55.4,Linear 为 73.2;Angular $\gamma=8,12$ 为 58.8、57.6。RACE (4,4) 比 FA2 降低 2.0 PPL,约 3.61%。这些结果验证因果机制可训练,其质量验证长度为 128 和 1024。(Table 8,p. 16。)
4.3 Arxiv:64K 任务中的质量—时间取舍
以下固定使用 RACE (3,3),避免每个长度另选最优配置:
| 长度 | RACE Acc.% ↑ | FA2 Acc.% ↑ | RACE 训练 s/epoch ↓ | FA2 训练 s/epoch ↓ | FA2/RACE 时间比 |
|---|---|---|---|---|---|
| 16K | 71.3 | 69.8 | 82.4 | 95.7 | 1.16× |
| 32K | 90.6 | 89.7 | 289 | 471 | 1.63× |
| 64K | 97.92 | 97.00 | 584 | 1645 | 2.82× |
来源:Table 1,p. 9;比值根据表中秒数计算。在 64K 上准确率高 0.92 个百分点,训练时间减少约 64.5%;测试每轮为 22.5 秒 vs 47 秒。更小的 RACE (2,2) 训练为 561 秒、准确率 97.14%;最大配置 (4,4) 为 594 秒、97.4%,质量并不单调增加。
64K 的其他对照为:Linear 96.35%、591 秒,Linformer 97.4%、616 秒,Performer 96.61%、952 秒。Linformer 测试时间 15.2 秒,快于 RACE,说明训练速度、测试速度与准确率形成不同取舍。
4.4 Food-101 子集:同 batch 的 FA2 对照更易解释
| 方法 | batch | 训练 s/epoch ↓ | 测试 s/epoch ↓ | Acc.% ↑ |
|---|---|---|---|---|
| RACE (2,2) | 8 | 891 | 37 | 42.4 |
| RACE (3,3) | 8 | 950 | 40 | 43.5 |
| RACE (4,4) | 8 | 1042 | 42 | 40.3 |
| FlashAttention2 | 8 | 2600 | 95 | 42.1 |
| Linear | 1 | 1166 | 44 | 41.4 |
| Linformer-128 | 1 | 1250 | 49 | 20.2 |
| Performer-256 | 1 | 2546 | 105 | 42.4 |
来源:Table 3,p. 9。RACE (3,3) 相对同 batch 的 FA2,准确率高 1.4 个百分点,训练时间比为 2.74×。RACE (4,4) 反而掉到 40.3%,说明更大状态并不自动带来更好的优化结果。
4.5 附录任务:收益与不单调性都值得看
| 任务 | 表中最佳 RACE 配置 | RACE | FA2 | 其他关键对照 |
|---|---|---|---|---|
| FashionMNIST @784,Acc.% ↑ | (2,5) | 87.7 | 87.2 | Linformer 87.7 |
| Tiny Stories @512,PPL ↓ | (5,4) | 2.7 | 3.1 | Angular 2.9 |
| ListOps @2000,Acc.% ↑ | (2,2) | 41.9 | 41.4 | Angular 42.2;YOSO 41.0 |
| Text Retrieval @8000,Acc.% ↑ | (4,4) | 80.9 | 80.5 | Performer 80.8;YOSO 80.2 |
| Yahoo @256,Acc.% ↑ | (4,4) | 67.2 | 67.2 | Linear 66.9 |
| IMDB @512,Acc.% ↑ | (3,3)/(4,4) | 81.3 | 80.0 | Performer 81.0 |
| SST-2 @1024,Acc.% ↑ | (4,4) | 79.4 | 78.5 | Linear 78.0 |
来源:Tables 6、7、9、10,p. 16。此表明确逐任务选择最佳报告配置,不能理解成一个固定模型同时取得所有数值。LRA 增益较小,且 Angular 在 Text Retrieval 上 OOM。
Tiny Stories @512 的 $P=5,L=4$ 为 2.7,但只把 $L$ 改为 5 就变成 5.1;FashionMNIST 从 (2,5) 的 87.7% 变到 (4,5) 的 85.7%。减少固定输入下的采样误差,与训练后任务指标改善并非同一命题,表中配置扫描没有显示一致单调性。
4.6 GPU 压力测试:最大长度取决于桶预算
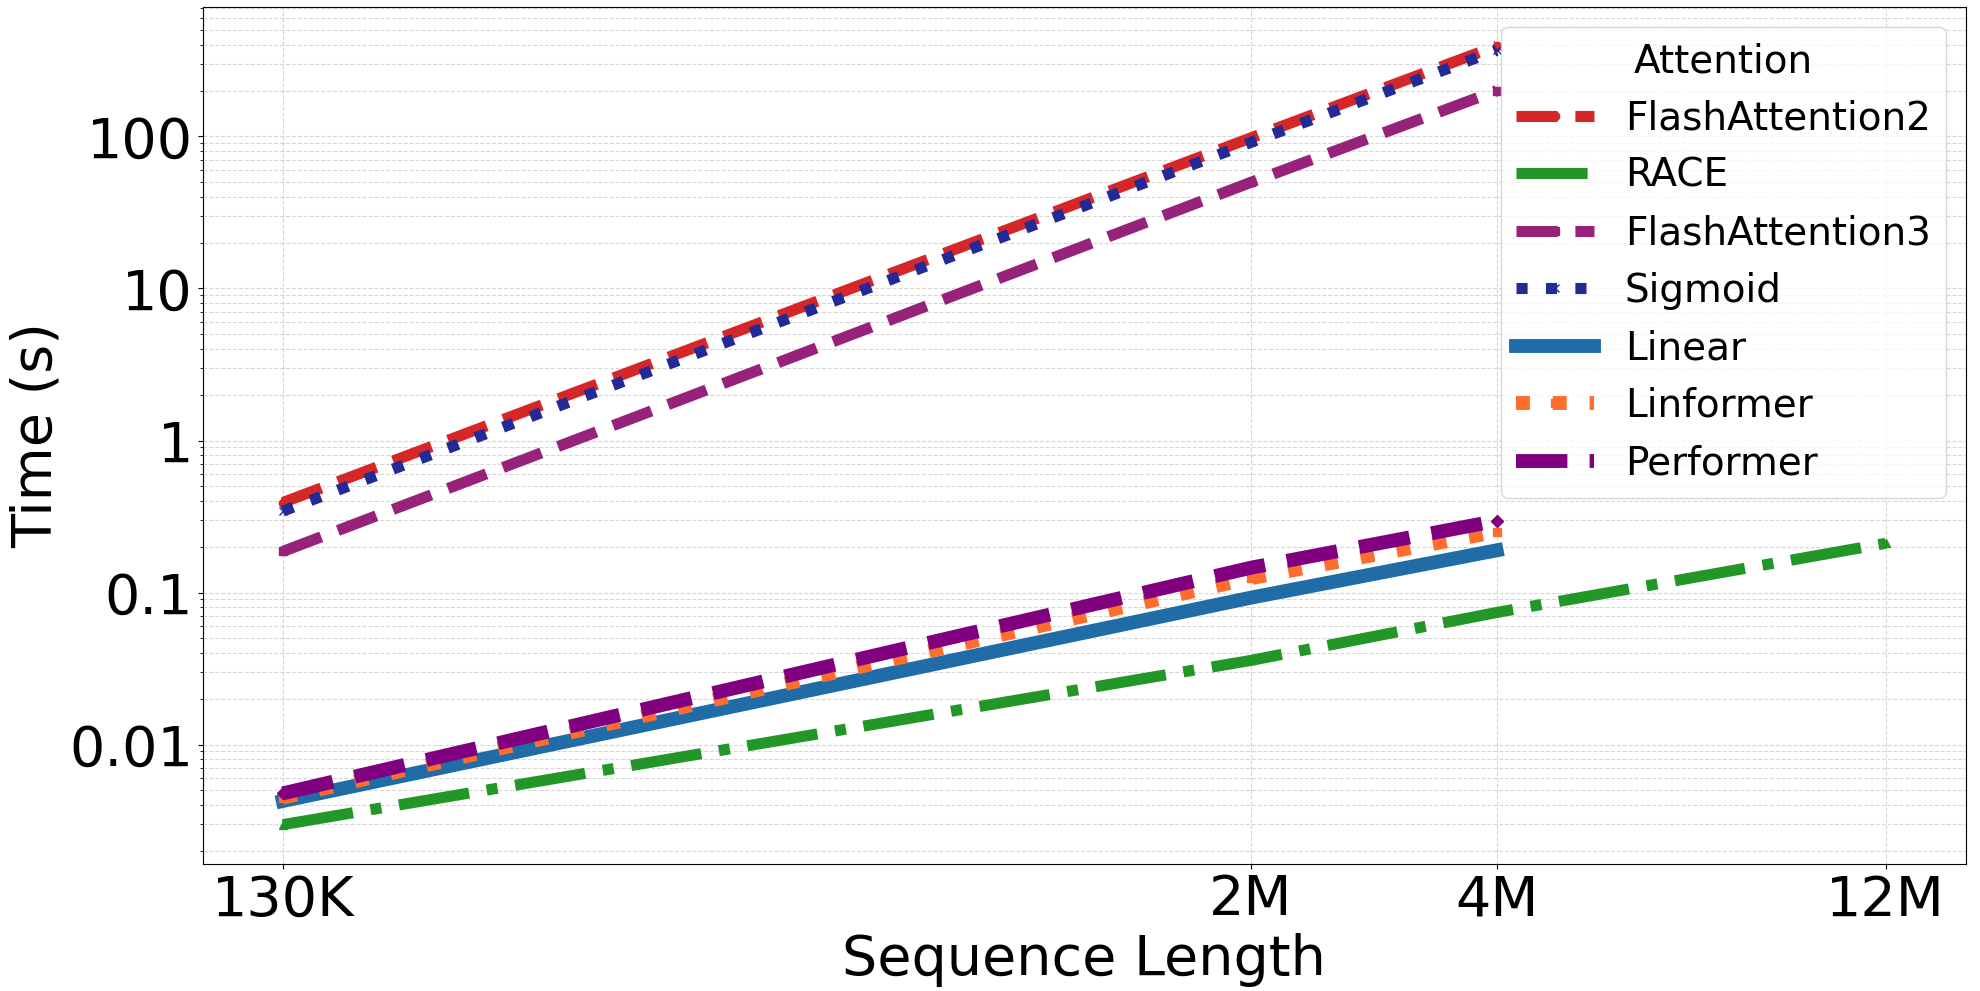
原文 Fig. 4d,p. 10。横轴为序列长度,纵轴为一次前向—反向时间(秒),本面板为对数坐标。绿色 RACE 曲线随长度增长较缓,FA2/FA3/Sigmoid 的两两交互开销更快增长。硬件为 GH200、96 GB,设置为单层、batch 1、4 heads、报告的 $d=128$。
Fig. 4a–c 的最大展示长度分别为:RACE (2,2) 约 12M、(3,3) 约 10M、(4,4) 约 7M。最大 12M 因此对应较小桶预算,不能与 (4,4) 的最佳语言建模成绩直接拼成同一配置的能力声明。
正文在约 4M token 处报告 RACE 约 0.1 秒,FA2 约 550 秒,即约 5500×;相对 FA3 和 Sigmoid 分别约 2600×、5000×。(p. 11;Fig. 5a。)这些是作者报告的注意力算子时间比,整模型训练还包括投影、FFN、参数更新与其他激活。
论文将 FA2/FA3 的不可用范围概括为约 4M。按这些近似端点,12M/4M 为约 3 倍;正文另写“3.5× longer”,缺少精确端点时不宜把 3.5 当作由这些概数直接算出的比值。
4.7 CPU、跨硬件比较与维度扩展
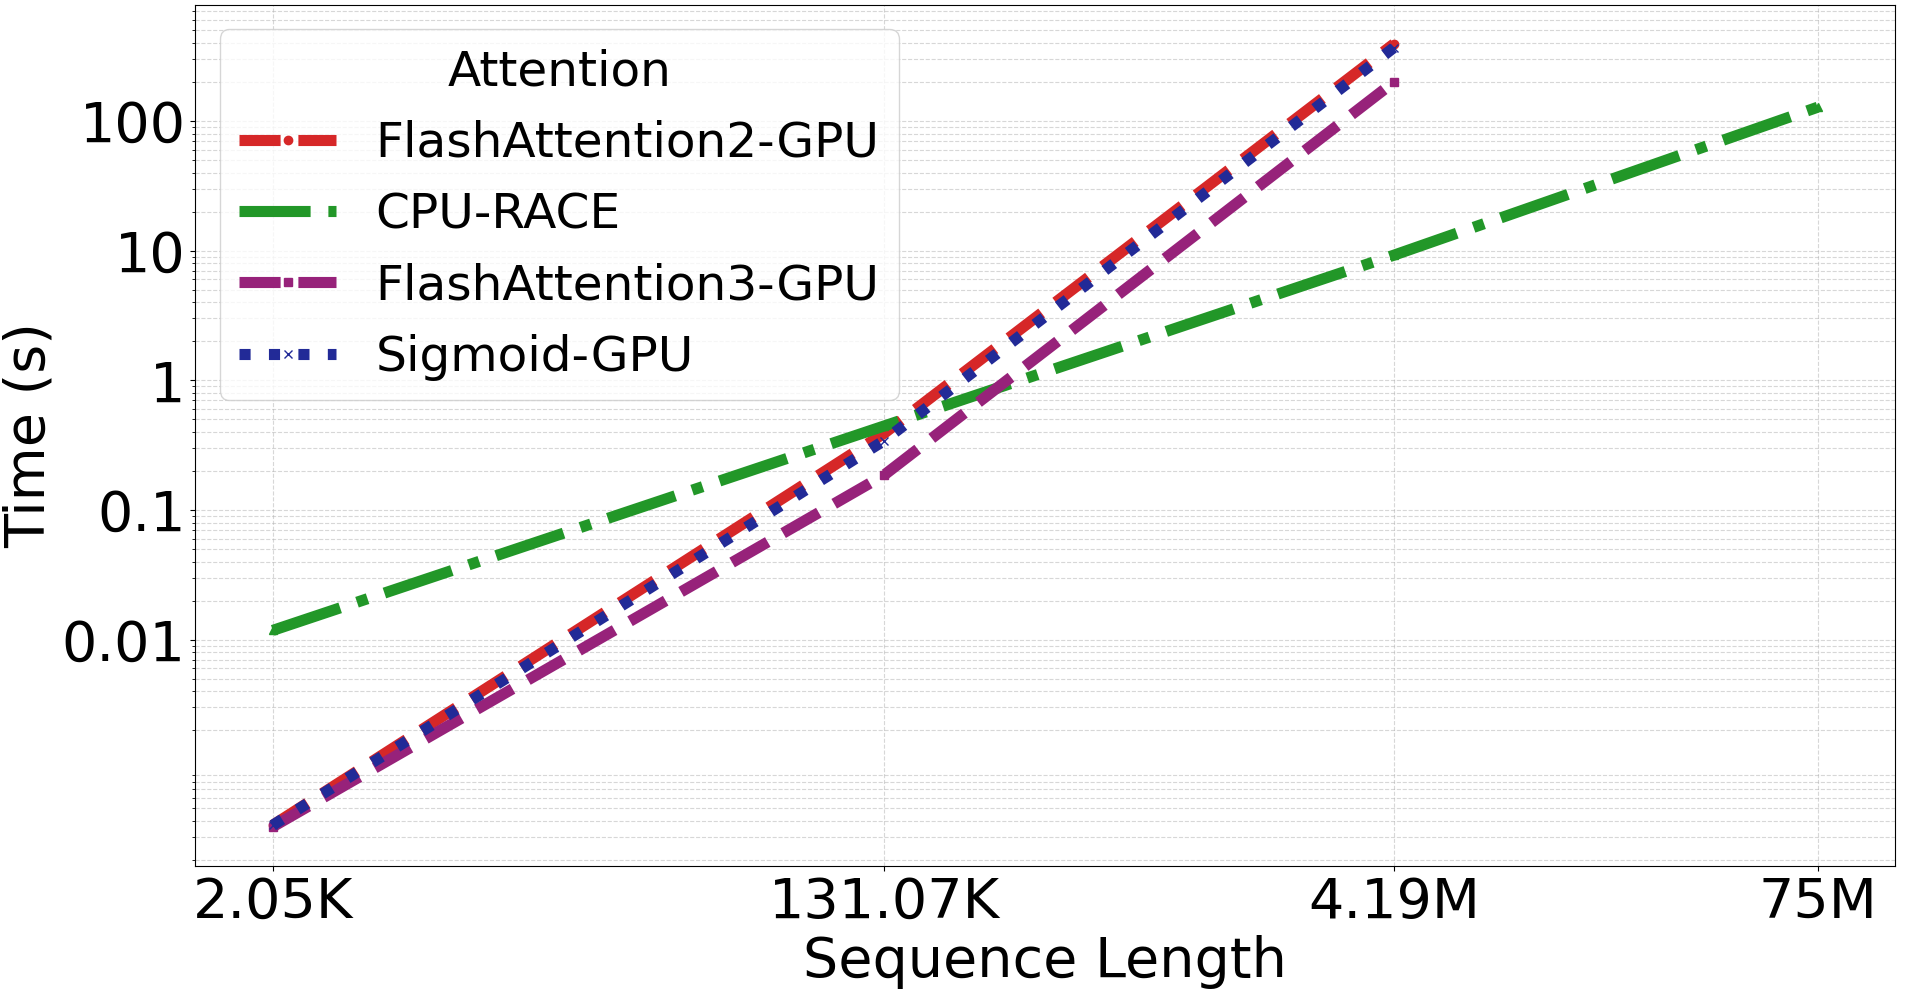
原文 Fig. 4e,p. 10。横轴为序列长度、纵轴为秒,均为对数坐标。绿色曲线在 Intel Xeon Gold 5220R CPU 上运行,其余曲线在 GH200 GPU 上运行。短序列 GPU 更快,长度约超过 131K 后 RACE 的算法复杂度优势开始占优;约 4M 处,正文报告 CPU-RACE 对 GPU-FA2/Sigmoid 约 40×、对 GPU-FA3 约 20×。(p. 11;Fig. 5b。)
CPU 上最长展示到 75M,约百秒量级。CPU 同硬件图中的“FlashAttention”实际是 PyTorch F.scaled_dot_product_attention,不能理解为在 CPU 上运行 FlashAttention-2/3 的 CUDA kernel。(Sec. 4,p. 10;Fig. 4f。)
有一处运行时间叙述需要保留疑问:p. 11 称 CPU-RACE 在约 33M token 时少于 10 秒,但 Fig. 4f 与 Fig. 6b 在约 32M 附近的曲线明显高于 10 秒;CPU softmax 基线的已绘制曲线也未延伸到 33M。因此本文不把同段的“CPU 33M 超过 10000×”作为可靠的直接同点比较。可稳定读出的证据是长序列扩展趋势、已展示运行端点,以及图表和正文一致的跨硬件比较。
Fig. 5c(p. 11)中,所用 YOSO-16 CUDA 实现在超过约 32K 后遇到内存限制。Fig. 6a–c(p. 17)展示 CPU 上不同桶预算的时间;Fig. 6d 固定 $N=65536$,横轴增大 embedding dimension,RACE 比所比较的 Linear Attention 增长更缓。后者反映该实验中固定桶宽与随维度增长的状态宽度之差。
五:结论——最值得吸收的是状态构造与归一化
RACE 的方法贡献在于把可哈希的角度相似度做成可微、可聚合、可递归更新的注意力。它用一个有限桶集合同时保存归一化所需的质量和内容,让非因果计算可通过矩阵结合律重排,因果计算可通过前缀状态更新。
实验最直接支持的是:在论文的小型与中型任务模型中,合适预算的 RACE 可以达到接近或优于 softmax 的任务分数;在长序列注意力算子层面,它具有明显的扩展优势。对使用者而言,$P$ 关联目标核锐度和指数增长的桶数,$L$ 关联重复估计预算,$\beta$ 关联软硬分配及优化行为,需要联合选择。
若继续研究,优先级最高的三个问题是:补上归一化证明中的偏差条件,并扩展到因果前缀;在固定数据、目标核与状态容量下区分近似误差和训练效果;用长上下文因果任务及完整训练/解码链路检验大长度算子收益能保留多少。它们分别对应理论条件、实验归因和实际系统价值。