Local Linear Attention:中文研读笔记
论文:Yifei Zuo、Yutong Yin、Zhichen Zeng、Ang Li、Banghua Zhu、Zhaoran Wang,Local Linear Attention: An Optimal Interpolation of Linear and Softmax Attention For Test-Time Regression。
原文:arXiv:2510.01450v1 · 本地 PDF · 2025-10-01 提交;本次于 2026-11-03 研读。
发表:已发表于 ICLR 2026 主会论文集。
代码:作者官方实现 FlashLLA。
论文总览
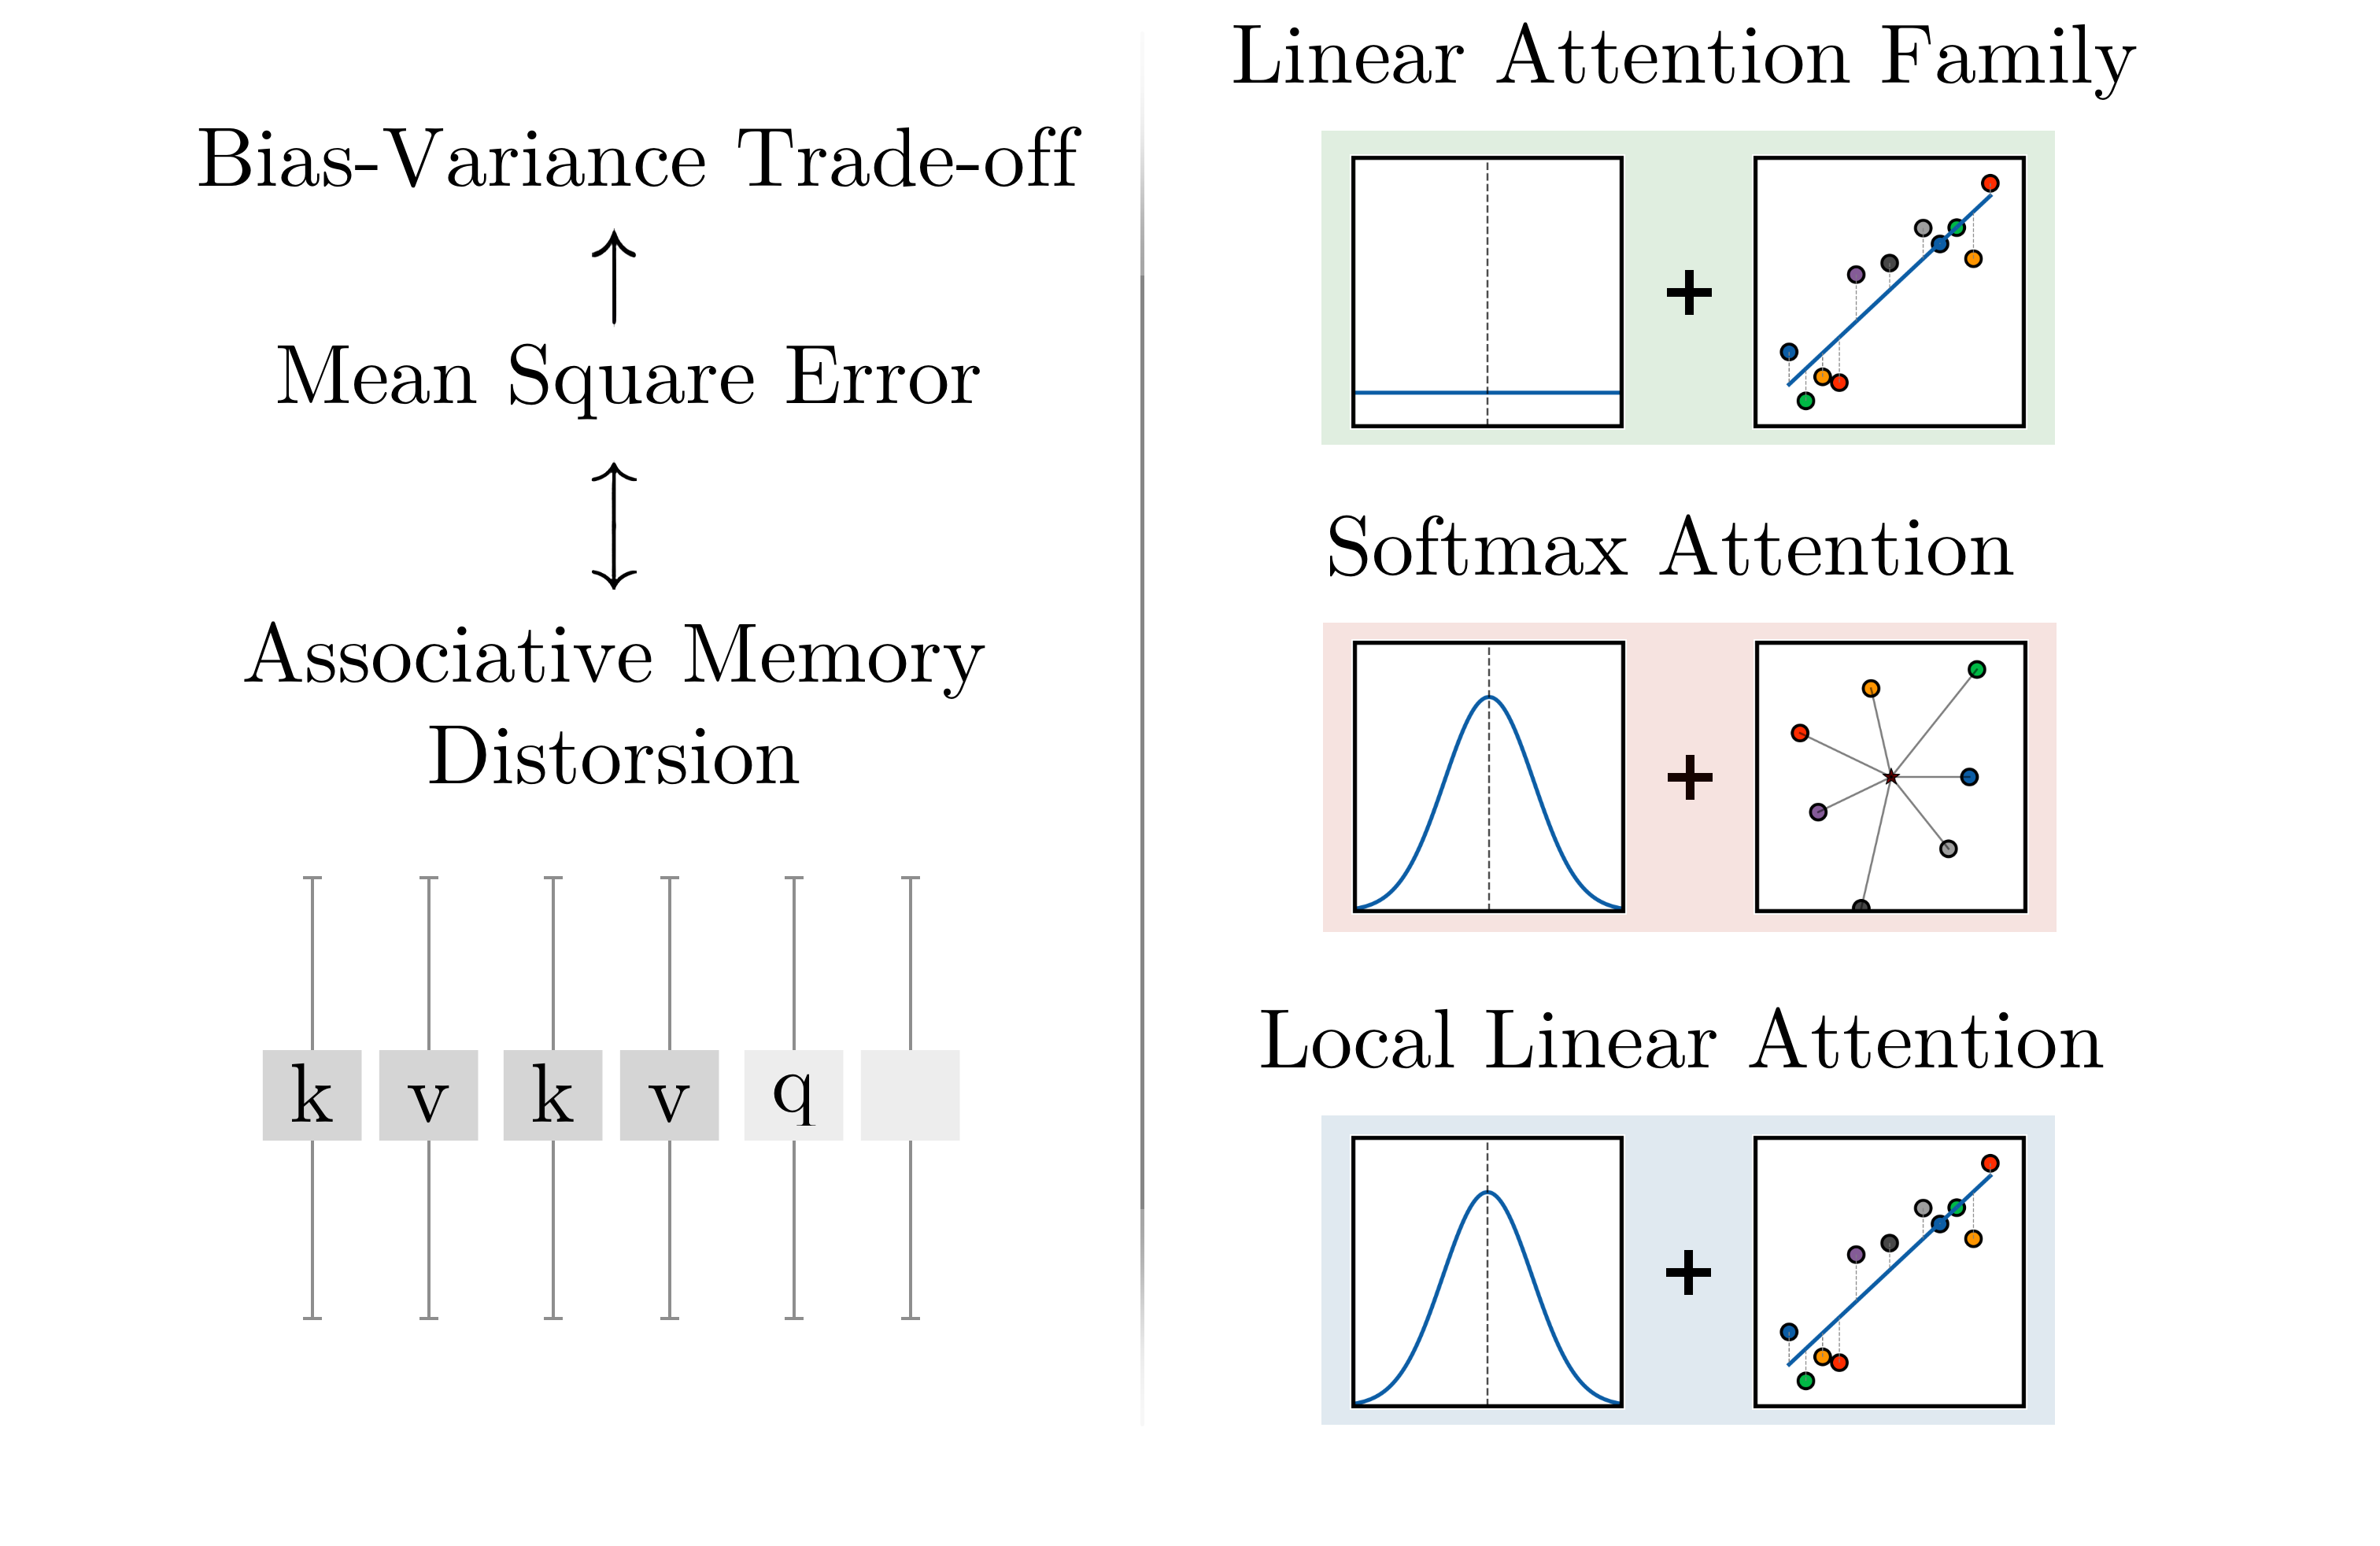
注意力可看成在推理时利用历史的键值对 $(k_j,v_j)$ 拟合函数,再对当前查询 $q_i$ 预测。全局线性注意力将所有历史压进一个线性映射,遇到分段变化的关系会产生模型偏差;Softmax 注意力在查询附近对值取加权平均,局部性更强,但在数据支撑集边界会有局部常数估计的偏差。**Local Linear Attention(LLA)**对每个查询做核加权的局部线性回归:既利用邻近样本,又估计邻域内的一阶变化。预测值是该局部直线在查询点的截距。
论文的证据有三层:在平滑统计模型下,局部线性估计比局部常数估计有更快的积分均方误差收敛率;FlashLLA 通过重写成对差分和无矩阵共轭梯度求解,把朴素实现的工作内存降至随序列长度线性增长;合成任务中,它在非平稳回归和长序列关联回忆上表现强,但在置换状态跟踪上与 Softmax 接近,低于 Gated DeltaNet。这里的“最优插值”指对所设局部加权平方损失求最优解及其“线性预测 + 局部残差校正”分解,并非把两种注意力输出做一个固定比例的凸组合。(Sec. 2–4,PDF pp. 3–10)
结构地图
| 原文章节 | 回答的问题 | PDF 定位 |
|---|---|---|
| 1 Introduction | 为何要超越局部常数估计 | pp. 1–3,Fig. 1 p. 2 |
| 2 Beyond Local Constant Estimate | 回归视角、统计比较与 LLA 定义 | pp. 3–5,Props. 2.1–2.2,Eqs. (6)–(9) |
| 3 Practical Algorithm | 怎样避免成对差分与逐查询矩阵的内存开销 | pp. 6–8,Algorithm 1、Fig. 2 p. 7 |
| 4 Empirical Results | 四类任务上有哪些收益与失败 | pp. 8–10,Figs. 3–6 |
| 5 Limitations and Future Directions | 计算、数值与大模型问题 | pp. 10–11 |
| Appendices A–E | 统计证明、CG、反传、数据与训练配置 | pp. 15–29,Figs. 7–8 |
一:动机——三种回归视角
在第 $i$ 个位置,历史数据为 $\mathcal D_i=\{(k_j,v_j)\}_{j\le i}$,$k_j\in\mathbb R^d$ 是特征,$v_j\in\mathbb R^d$ 是标签,$q_i$ 是待预测的输入。这是一种**测试时回归(test-time regression)**视角;模型训练时学到的投影如何形成这些向量,是另一个层次的问题。(Sec. 2.1,PDF pp. 3–4)
| 机制 | 在每个查询处做什么 | 主要取舍 |
|---|---|---|
| 全局线性模型,例如 MesaNet | 用整段历史拟合一个 $W$;$\hat f(q_i)=W_iq_i$ | 可用 $O(d^2)$ 状态更新;真实关系非全局仿射时有不可消失的近似误差 |
| Softmax / Nadaraya–Watson | 用相似度权重对 $v_j$ 局部平均 | 能适应局部变化;边界处对不对称的邻居取平均,出现一阶偏差 |
| LLA | 用相似度权重对邻域拟合截距和斜率 | 改善边界估计;需逐查询求解线性系统,计算和 KV 缓存更贵 |
Softmax 的局部常数估计是 $\hat f(q_i)=\sum_{j\le i}\bar w_{ij}v_j$,其中 $\bar w_{ij}=w_{ij}/\sum_{l\le i}w_{il}$。若对 $q,k$ 做归一化,RBF 权重 $\exp(-\lVert k_j-q_i\rVert^2/h)$ 与点积 Softmax 权重在公共因子相消后对应;论文用这一联系解释 Softmax,而非声称任意点积注意力都严格等同于固定带宽 RBF。(Eq. (4),PDF p. 4)
边界偏差的直觉是:在支撑集内部,对称邻域的正负方向贡献可相消;在边界附近,邻居只来自一侧,局部平均随函数斜率偏移。局部直线把斜率显式拟合出来,再在 $q_i$ 处取值,因而能消掉主要的一阶偏差。Fig. 1 的两幅原图分别画出三类估计器及分段关系的示意;它们是机制示意,不是模型在真实语料上的评测。(Sec. 1–2,PDF pp. 2–5)
二:方法——局部线性注意力与 FlashLLA
2.1 每个查询求一个截距
令 $z_{ij}=k_j-q_i$,$w_{ij}\ge0$ 为查询相关的核权重。LLA 在当前位置求解
$b\in\mathbb R^d$ 是查询点的预测,$W\in\mathbb R^{d\times d}$ 是局部斜率,$\lambda$ 稳定斜率估计。定义
消去斜率后,论文给出的输出形式为
分母是局部加权回归正规方程的 Schur 补;当 $\lambda>0$ 且 $\omega_i>0$ 时求解稳定。$\sum_js_{ij}=1$,但 $s_{ij}$ 可以为负:局部线性估计需要外推/纠偏,不再是 Softmax 那样的纯凸加权平均。若 $\lambda\to\infty$,则 $\rho_i\to0$,权重退化为 $w_{ij}/\omega_i$,即相同核权重下的局部常数估计。(Sec. 2.3,Eqs. (6)–(8),PDF p. 5)
论文还把最优截距写为
这说明计算可以理解为“线性模型的预测 + 查询附近的残差平均”:当全局线性拟合有系统偏差时,局部残差负责修正;当斜率不可靠时,局部平均仍提供基线。此式也允许用近似或递归的 $\hat W_i$ 设计后续变体,但本文实际 LLA 使用局部优化解。MesaNet 的原式省略截距,不能简单说 LLA 在某个参数下与它逐项相等。(Eq. (9),PDF p. 5)
2.2 内存原语与分块执行
朴素实现需要保存全部 $z_{ij}\in\mathbb R^d$,代价 $\Theta(n^2d)$;每个查询若显式保存 $\Sigma_i\in\mathbb R^{d\times d}$,代价 $\Theta(nd^2)$。作者先利用
把成对差分拆为键与查询的普通矩阵乘法;再用**共轭梯度(CG)**求 $\Sigma_i\rho_i=\mu_i$,每轮只计算 $\Sigma_ip$,不用显式逆矩阵。$\lambda$ 也帮助前几个 token 的低秩系统保持正定;附录 C 讨论了按输入自适应的正则化和提前停止。反向传播所需的其他线性系统及梯度表达在附录 D。(Sec. 3.1,Eqs. (10)–(12),PDF p. 6;Appendices C–D,pp. 24–27)
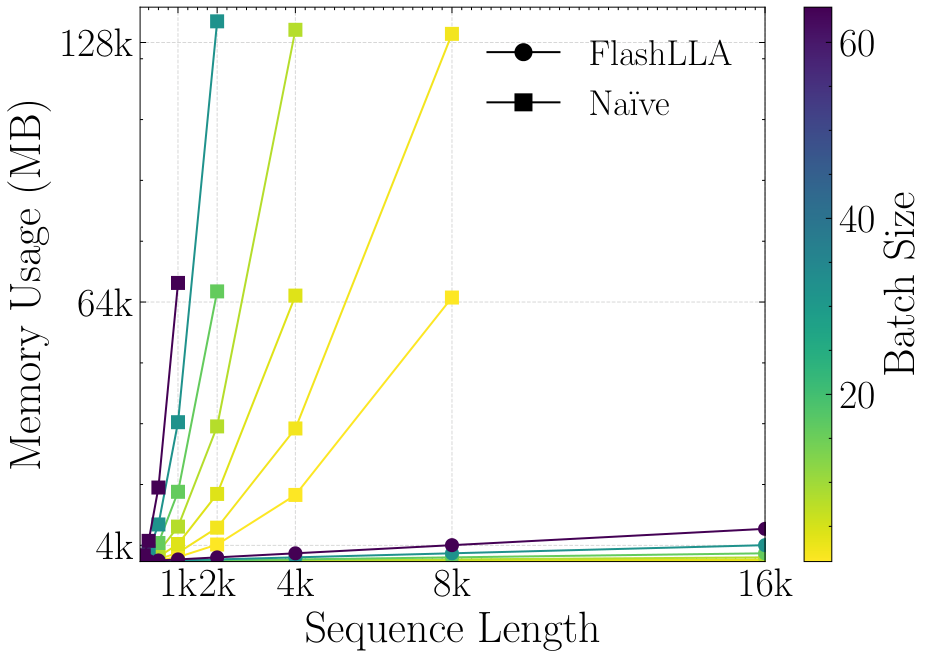
FlashLLA 对查询分块,每块依次:(1) 扫描键块并用在线最大值积累 $\omega_i,\mu_i$;(2) 运行矩阵自由 CG;(3) 再扫描键值块计算 $\sum_j s_{ij}v_j$。成对 $n\times n$ 权重只在块内临时存在,工作内存降为 $\Theta(nd)$,仍保留与 Softmax 类似的 $\Theta(nd)$ KV 缓存。节省内存不等于计算便宜:每轮 CG 还需读键块,迭代次数及矩阵条件数决定额外成本;论文没有给出全面的端到端速度优势。Fig. 2 仅报告单张 NVIDIA H200、$d=128$ 的峰值内存:朴素实现很快达到设备上限,FlashLLA 随序列长度缓慢增长。(Sec. 3.2,Algorithm 1、Fig. 2,PDF pp. 7–8)
2.3 理论优势的条件和来由
Proposition 2.1 比较全局仿射估计和局部常数估计:当真函数不是全局仿射时,前者的积分 MSE 有 $\Omega(1)$ 的近似误差下界;在规定的平滑条件下,后者有 $O(n^{-3/(d+3)})$ 的上界。Proposition 2.2 进一步要求真函数沿支撑集边界的法向梯度足够大,此时局部常数估计有 $\Omega(n^{-3/(d+3)})$ 下界,而局部线性估计有 $O(n^{-4/(d+4)})$ 上界。(PDF pp. 4–5;证明在 pp. 15–24)
这些指数来自偏差与方差的平衡。令带宽半径为 $h$,边界层体积为 $O(h)$;局部常数在该层的点态偏差为 $O(h)$,所以积分偏差平方为 $O(h^3)$。局部线性消掉一阶项,积分偏差平方为 $O(h^4)$;两者方差同阶 $O((nh^d)^{-1})$。分别平衡得到 $h_{\rm NW}\asymp n^{-1/(d+3)}$、$h_{\rm LL}\asymp n^{-1/(d+4)}$,对应上述误差率。对 $d>0$,$4/(d+4)>3/(d+3)$。(Appendices A–B,PDF pp. 15–24)
适用域:附录证明针对独立同分布样本、平滑函数和密度、$C^2$ 边界、紧支撑径向核及最优带宽的经典 NW/局部线性估计。实际 LLA 使用点积指数权重和岭惩罚;分段合成任务在段界也不满足同样的全局平滑假设。因此理论给的是设计动机与特定统计模型下的分离,而非所报告神经网络实验的直接误差保证。附录把若干 $O_p$ 界推进到期望界的步骤也未单独给出一致可积性论证;若需把命题当作严格的期望界使用,这一步值得补全。(Secs. 2.2–2.3、Appendices A–B)
三:实验——四个问题、四类指标
| 任务 | 数据与对照 | 指标及方向 | 主要图 |
|---|---|---|---|
| 测试时分段回归 | $L=1024$;无训练投影;LLA、Softmax、MesaNet、普通 LA、随机预测;$d=8$–128、$S=8$–1024 | 位置 MSE,越低越好;图纵轴为 Loss/Dim | Figs. 3–4,p. 8;Fig. 7,p. 27 |
| 上下文分段回归 | 带参数的两层、无 MLP 模型;Softmax、Mamba、GLA、Hyena、Gated DeltaNet;$d_x=d_y=32$,模型 $d=128$、2 头 | 测试查询 MSE,越低越好 | Fig. 5(a),p. 9 |
| MQAR 关联回忆 | 词表 8,192;长度 64–512;KV 数 $L/16,L/8,L/4$;禁用所有模型的短卷积与 feature map | 测试回忆准确率,越高越好 | Fig. 5(b),p. 9;Fig. 8,p. 29 |
| 置换状态跟踪 | 初始化排列、执行随机交换、查询最终物品;同类模型对照 | 测试准确率,越高越好 | Fig. 6,p. 10 |
前一任务直接测试注意力层的测试时拟合,不训练 Q/K/V 投影,1 万条独立序列取平均;后三项训练参数化模型,Fig. 5 的每个点是各训练超参中最好表现、3 个随机种子的均值。因此 Fig. 3 与 Fig. 5 的误差不能当成同一个训练协议的成绩。附录 E 说明上文回归每种子用 10 万训练例、1 千测试例,训练噪声 $\delta=0.1$、测试无噪声,AdamW 最多 100 epoch。(Sec. 4、Appendix E,PDF pp. 8–9、27–29)
四:结果——何时收益,何时不收益
4.1 非平稳测试时回归:分布一变,局部拟合更稳
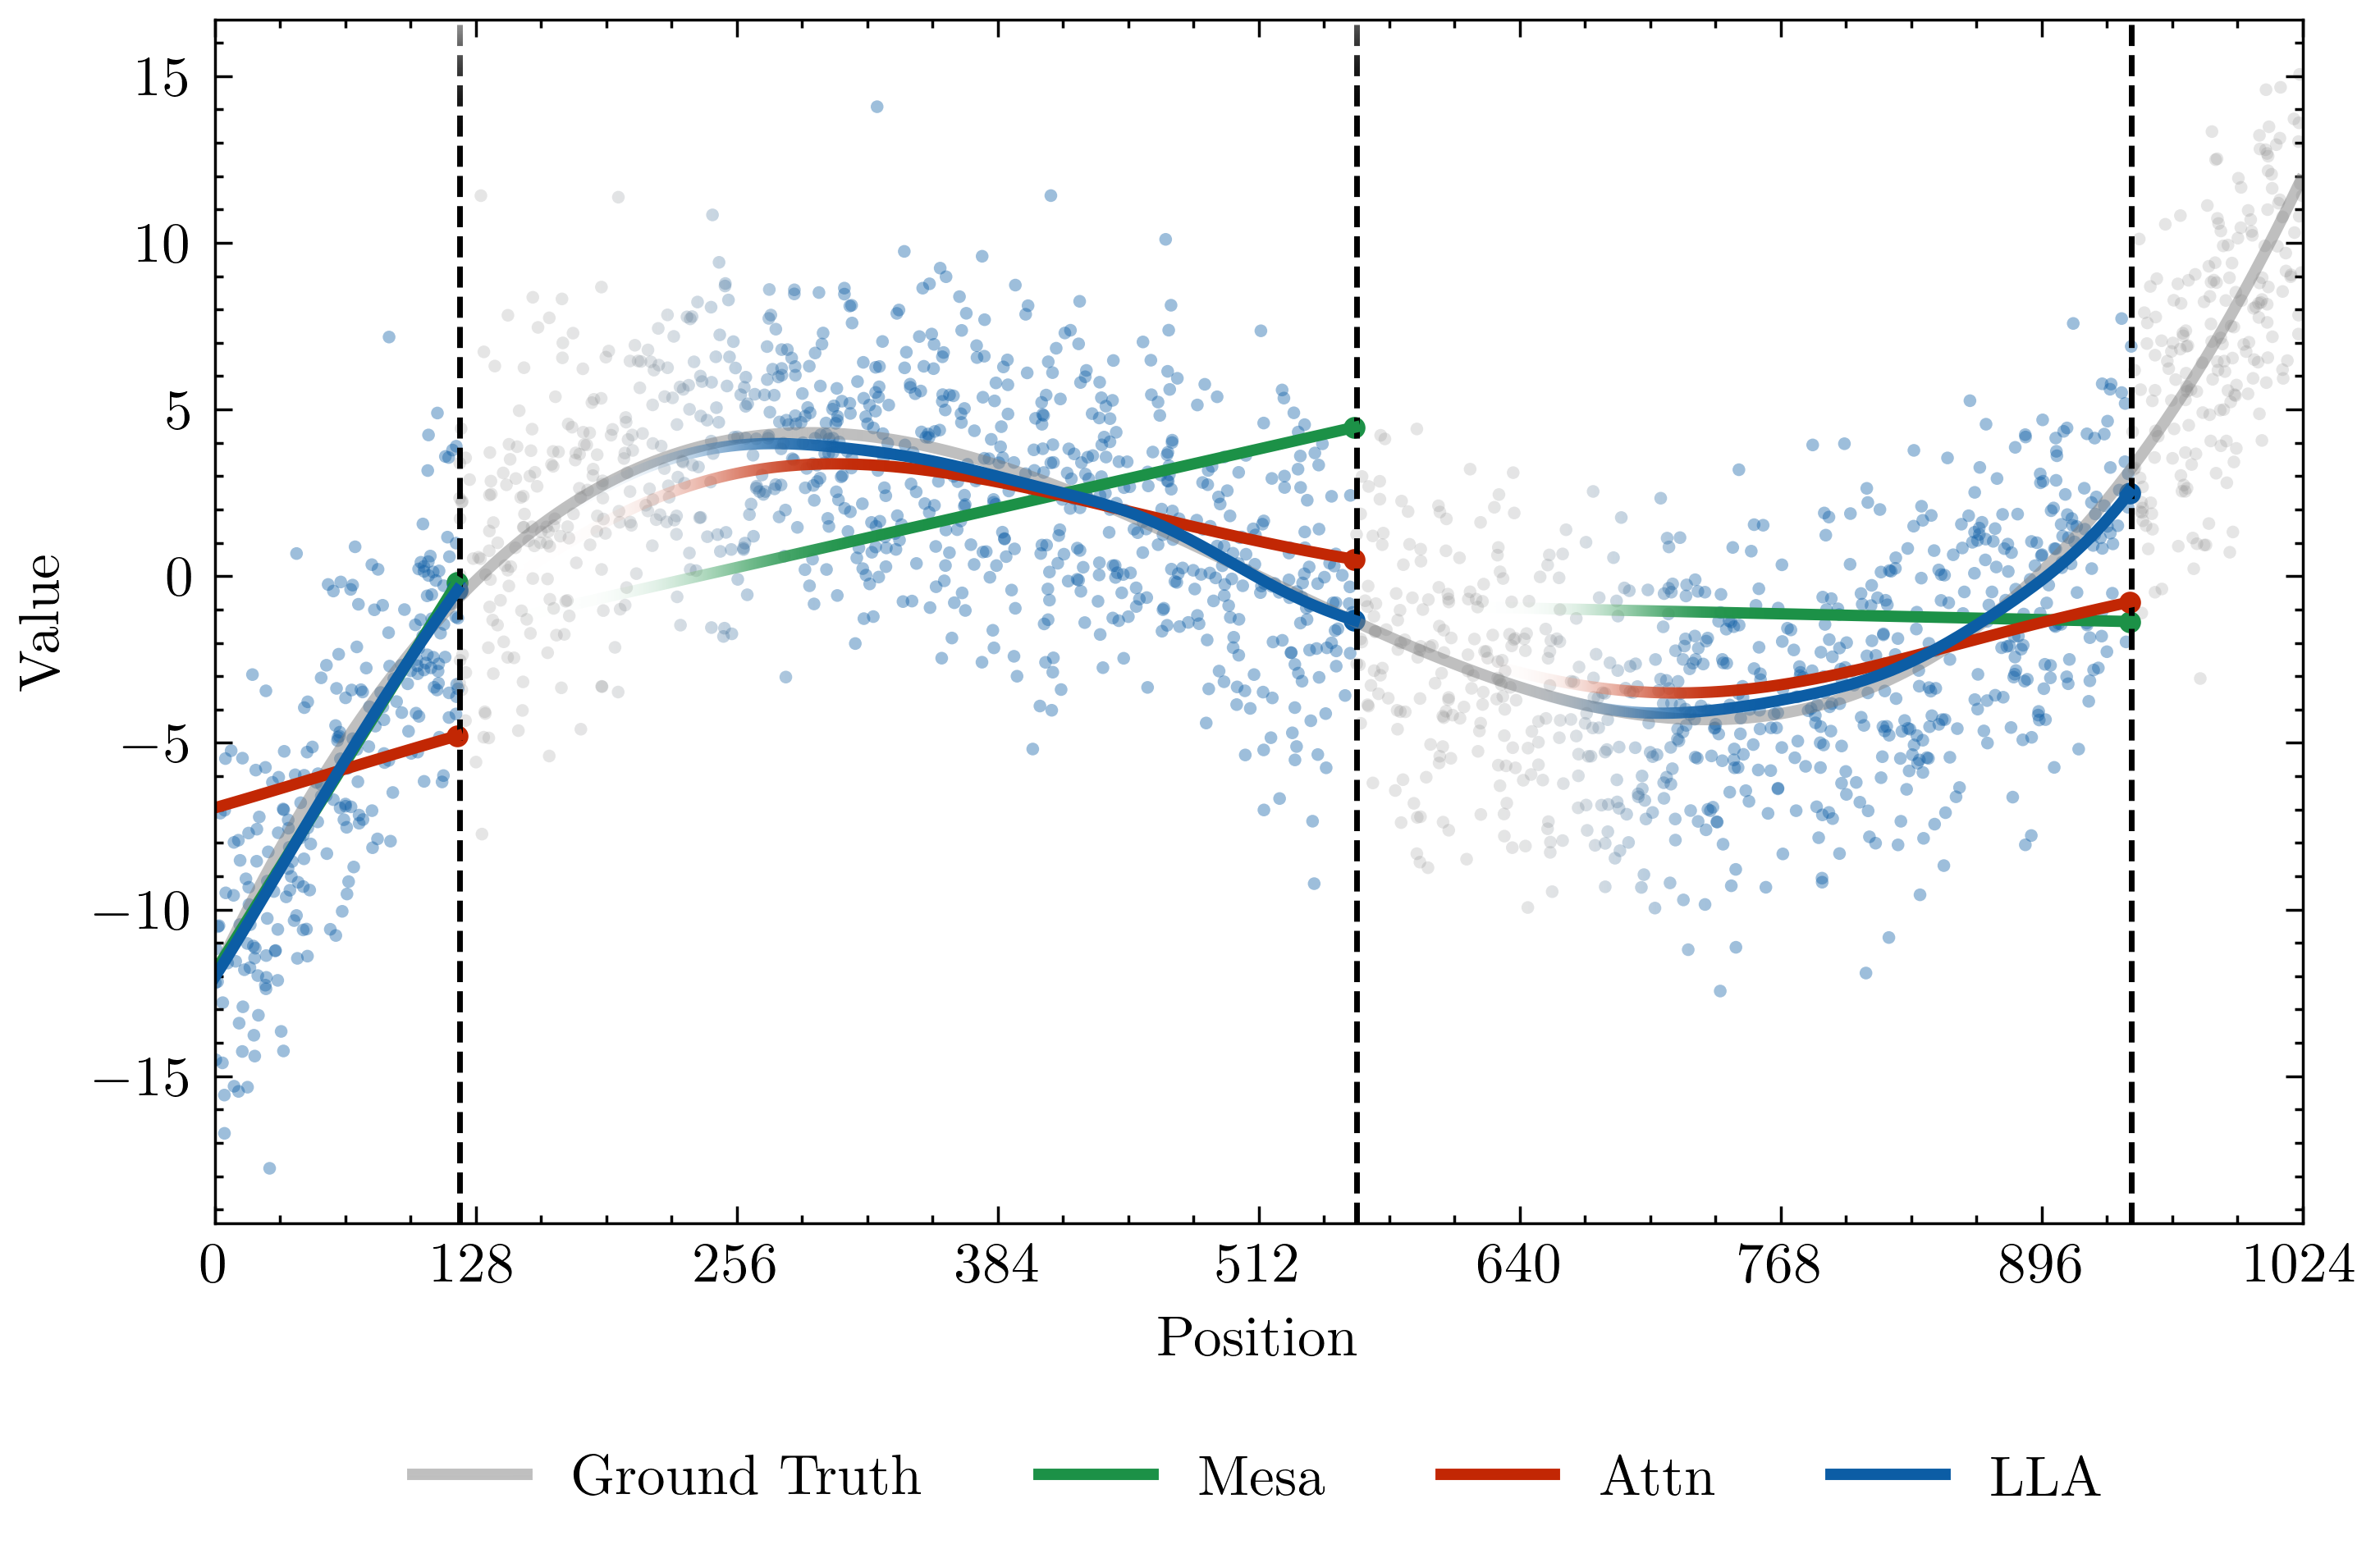
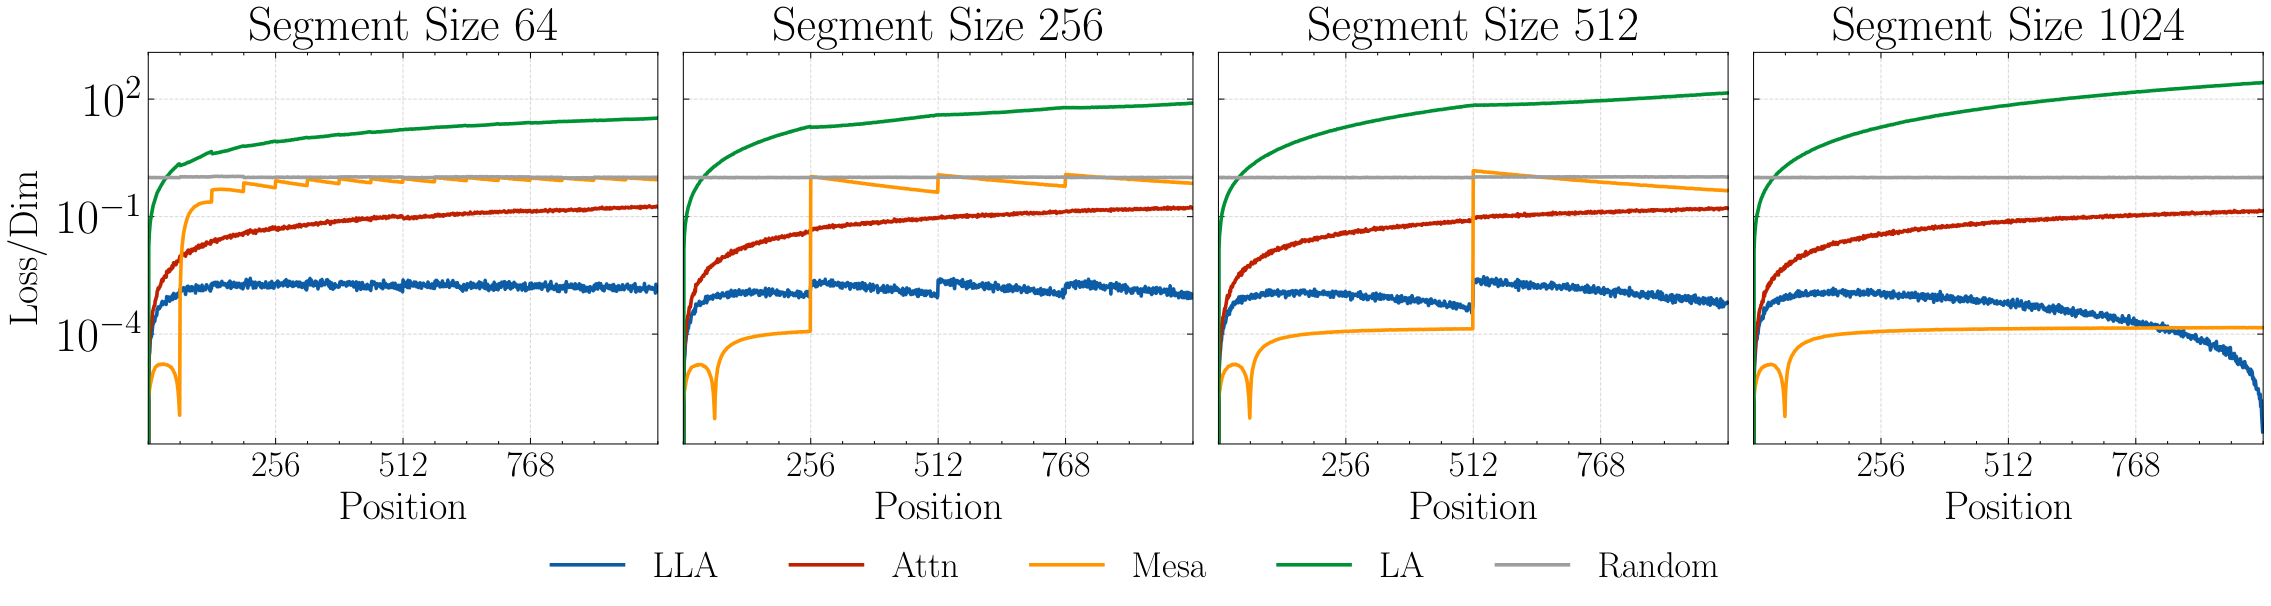
每个长度 $S$ 的片段从不同的锥形分布抽样,标签由该片段自己的 $A_ck_i+\epsilon_i$ 产生。Fig. 3 的四个面板均固定 $d=64,L=1024$,纵轴是对数刻度的每维损失。MesaNet 在没有变化的最初片段可优于 LLA;切换后其累计的全局映射会暂时失配,而 LLA 利用查询相关的邻域更快恢复。Softmax 也能局部选样,但其局部常数估计继续存在精度差距。Fig. 4 把“模型总 MSE / LLA 总 MSE”画成比值,随 $d$ 增大总体上升;比值小于 1 的点仍表示对应模型优于 LLA,图中低维、长片段的 MesaNet 有这样的例子。(Sec. 4,Figs. 3–4,PDF p. 8)
4.2 上下文回归:训练后的优势在更频繁换段时最明显
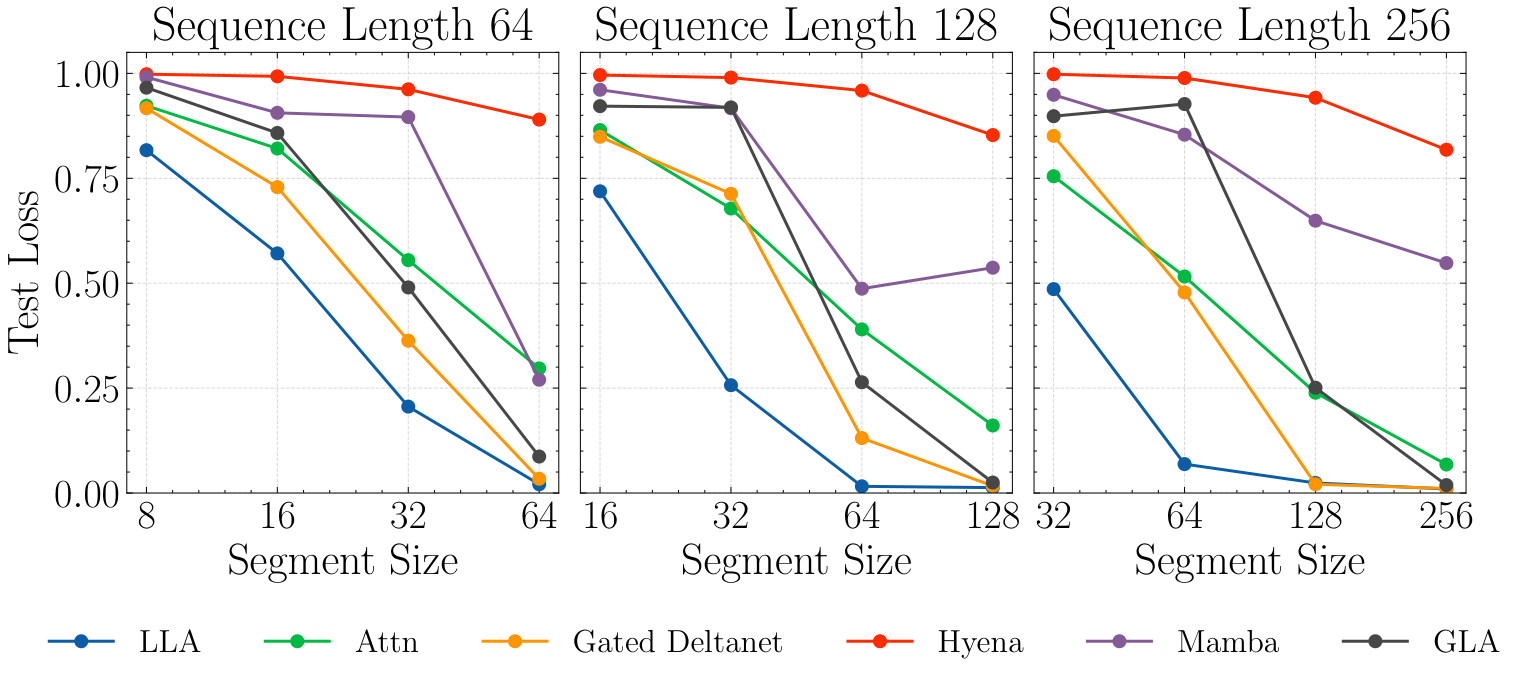
输入把 $L$ 个打乱的 $(x_i,y_i)$ 配对与 16 个只给 $x'$ 的查询拼在同一上下文里,模型学习预测查询标签。Fig. 5(a) 对长度 64、128、256 的绘制设置,LLA 的测试误差均最低;例如 $L=256,S=64$ 时,按图读数约为 0.07,Softmax 约 0.52,Gated DeltaNet 约 0.48。这是图上的近似读数,不是论文另列的精确表格。随着 $S$ 增大,关系更接近单段线性,基线差距缩小。(Sec. 4,Fig. 5(a),PDF p. 9)
4.3 关联回忆:长序列中优势大,短序列并非处处第一
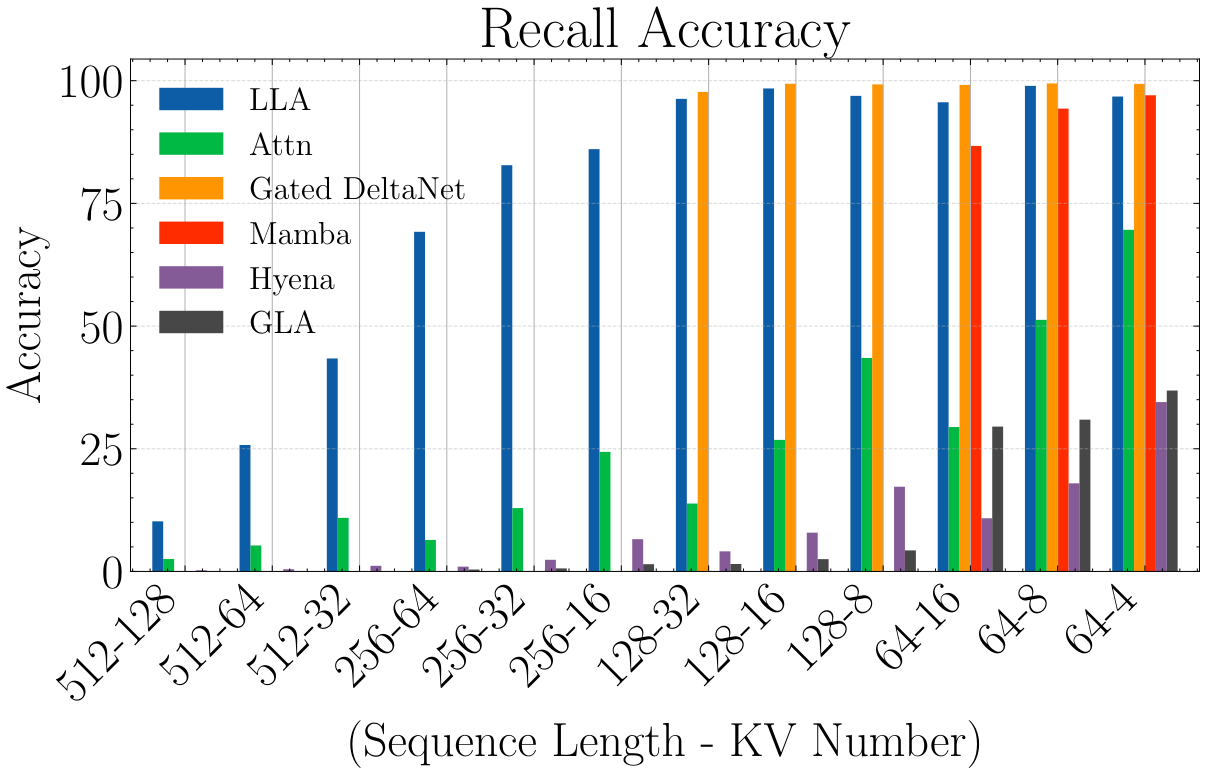
MQAR 要从上下文中取回键对应的离散值。Fig. 5(b) 以“长度–KV 数”作为横轴,从 512–128 到 64–4 排列。长序列难例中,LLA 的蓝柱明显高于 Softmax 和多数其他基线;例如 512–32 的准确率图读数约 43% 对 11%(Softmax)。在一些较短/较容易的设置,Gated DeltaNet 已接近或略高于 LLA,因此论文图注中“LLA 最高”的概括不宜逐点理解。附录 Fig. 8 还显示 Gated DeltaNet 在多个种子上可能先长时间平台、后陡升;LLA 曲线较平滑。(Sec. 4、Appendix E.3,PDF pp. 9、29)
4.4 状态跟踪:局部回归不能替代顺序状态更新
任务先给位置到物品的映射,再给 $S\sim\mathrm{Uniform}(N/6,N/3)$ 条交换指令,最后查询交换后的物品。Fig. 6 中,LLA 与 Softmax 接近;在 $N=48$ 时约 52%,$N=96$ 时约 61%,而 Gated DeltaNet 分别约 98%、75%。论文把这解释为:LLA 的查询相关一阶修正仍由常数层数的并行代数步骤组成,不形成处理任意长交换链所需的递归状态更新。这是该任务和所用架构下的机制解释。(Sec. 4,Fig. 6,PDF p. 10)
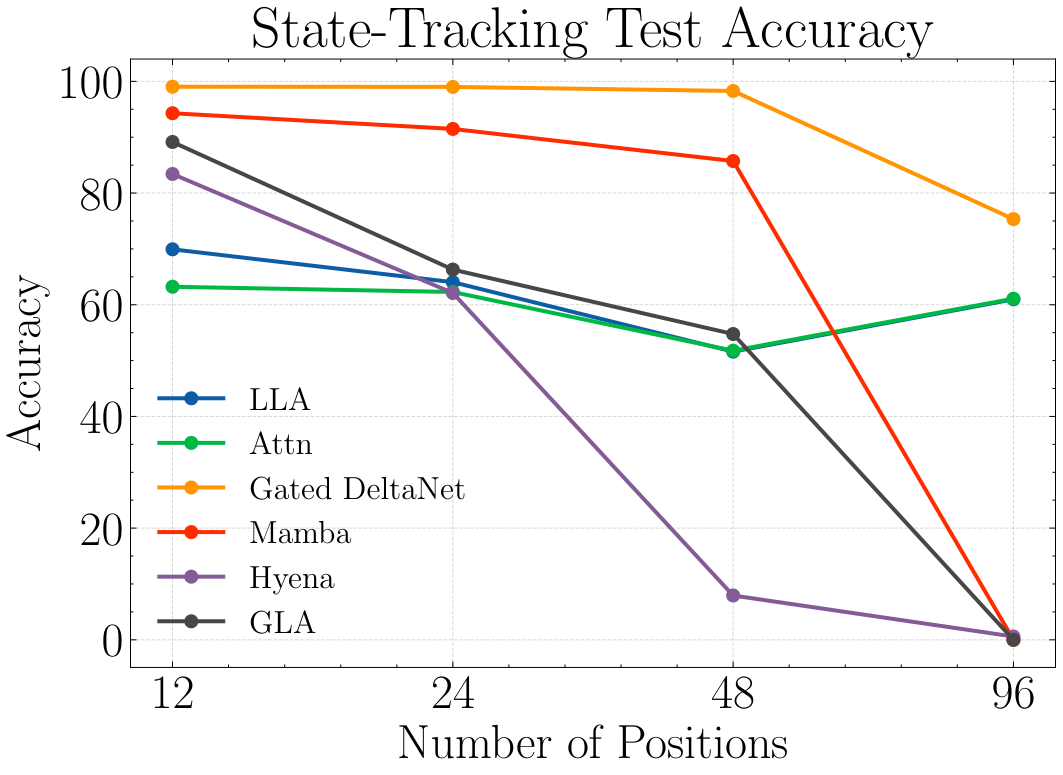
复核配置时有一处需要留意:Fig. 6 横轴首点标为 $N=12$,附录 E.2 却把测试位置数写为 $N\in\{16,24,48,96\}$。不应把这两处默认为同一配置;上文只引用无歧义的 $N=48,96$ 观察。(PDF pp. 10、28)
五:结论与后续问题
LLA 的核心贡献是把注意力里的相似度加权与局部一阶拟合放在同一个可求解目标中,并给出可按块执行的实现。论文支持它在所测非平稳回归和关联回忆合成任务中的收益,也说明更强的局部估计本身没有解决需逐步执行交换的状态跟踪。(Secs. 2–4,PDF pp. 3–10)
实际采用时要同时考虑求解代价与数据条件。FlashLLA 解决的是内存工作集问题;CG 的反复扫描、矩阵条件数与低精度稳定性仍使计算和 I/O 比 Softmax 更重。论文尚未在大语言模型预训练或真实语言基准上验证收益,结论中的“大模型潜力”应视为待检验方向。若继续研究,最有价值的是测量固定质量/计算预算下的端到端收益,并验证近似斜率求解是否保留非平稳任务优势。(Sec. 5,PDF pp. 10–11)