DAT:延迟注意力训练如何改善 Transformer–RNN 混合模型的长度泛化
论文:Delayed Attention Training Improves Length Generalization in Transformer–RNN Hybrids
作者:Buu Phan、Reza Ebrahimi、Sanjay Haresh、Roland Memisevic;University of Toronto / Qualcomm AI Research
版本:arXiv:2510.00258v1,提交于 2025-09-30;获取与研读日期:2026-10-13
原文:arXiv · 本地 PDF
配套汇报:英文幻灯片 · 可编辑 TeX
论文总览
这篇短论文研究一个很具体的问题:当任务同时要求持续更新状态和按内容查回信息时,把 LSTM 与注意力拼在一起,能否保留两者各自的优势?作者构造了“所有数值求和后模 10 + 根据键找回对应值”的合成任务。普通混合模型在训练长度内几乎全对,超过训练长度后却迅速失效;单任务实验进一步表明,加入注意力后,原本可外推的 LSTM 状态追踪能力也会丢失。
作者提出延迟注意力训练(Delayed Attention Training,DAT):先停用注意力模块的贡献,让循环路径先学习;1500 个 epoch 后再启用注意力,与循环模块一起训练。训练完成后的模型仍使用完整混合架构。这个干预把“模块是否具备所需能力”推进到“训练是否让模块形成有效分工”的问题。
在原文报告的长度尺度上,分布内边界为 25。长度 75 时,五种 DAT 混合模型的联合准确率为 80%–95%,其中四种超过 90%;对应普通训练仅为 5%–12%。长度 100 时,DAT 仍有 56%–88%,说明改进显著,但更长长度下的退化尚未消失。摘要中的“三倍长度超过 90%”适用于部分结构,不能扩展成五种结构都满足。(Sec. 2,PDF p. 2,Fig. 1)
结构地图
| 原文章节 | 论证作用 | PDF 定位 |
|---|---|---|
| Abstract;1 Introduction | 状态追踪与关联召回的互补性;提出混合模型的训练问题 | p. 1 |
| 2 Methods and Results — Experimental Setup | 合成序列与两项任务同时答对的评价口径 | pp. 1–2 |
| 2 — Architectures / Delayed Attention Training | 模型组成、停用注意力的训练策略 | p. 2,Fig. 1 左 |
| 2 — Results | 普通训练与 DAT 的长度泛化比较 | p. 2,Fig. 1 右 |
| 3 Conclusion | 总结贡献;提出向语言建模扩展 | p. 2 |
| References | 背景工作 | p. 3 |
| A Hybrid Architectures | 学习率与训练阶段;五种混合结构 | p. 4 |
| B Additional Results | 分开训练、测试的 recall-only 和 modulo-only 实验 | p. 4,Table 1、Table 2 |
一:动机——可用的循环路径为什么没有被充分利用?
1.1 两种能力对记忆的要求不同
**状态追踪(state tracking)**要求每读入一个新值就更新已有状态。对模 10 求和,只需保存一个余数;无论前面有多少个值,都可以重复同一个更新规则。LSTM 的逐步递推结构适合表达这种计算。
**关联召回(associative recall)**要求看到查询键后,找回先前与它绑定的值。序列变长会引入更多需要区分的键值关联。LSTM 要把这些信息压入固定维度状态;注意力则可以直接访问历史位置,按查询内容选择相关信息。
由此产生一个合理设想:循环路径负责累积状态,注意力负责查找历史。但任务要求模型给出正确答案,并不自动指定模块分工。若训练长度较短,模型可能依赖只在这个范围内有效的计算方式。作者把这种现象解释为捷径学习(shortcut learning)。(Sec. 1,PDF p. 1)
1.2 论文最有价值的反常现象
在单独的模 10 任务上,LSTM 在所有报告长度上都达到 1.00;把注意力加入混合架构后,普通训练的模型在较长序列上却降到约 0.10。这个现象说明,在架构中保留递推能力,还需要训练过程让模型实际采用可外推的递推解。DAT 正是通过改变模块参与训练的先后顺序来干预这一点。(Appendix B,PDF p. 4,Table 2)
二:方法——任务、混合结构与训练顺序
2.1 一个样本同时考两种计算
原文的序列形式为:
| 符号 | 含义 |
|---|---|
| $k_i,v_i$ | 第 $i$ 个键、值 token;值具有可求和的数值含义 |
| $n$ | 前缀中的键值对数 |
| $m$ | 所有值之和对 10 取模的答案 |
| $k_j$ | 从序列中的键随机选择的查询键 |
| $v_j$ | 该键对应的召回答案 |
| $d$ | 模型嵌入维度,实验固定为 256 |
| $L$ | 本笔记对原文结果表“sequence length”一列的记号 |
其中模运算目标可以写为:
这里展示的是含答案位置的完整样本格式。modulo 后的 $m$ 与查询键后的 $v_j$ 是待预测答案,不能把整串都当成已知查询输入。原文没有给出损失掩码或解码协议的实现细节。(Sec. 2,PDF pp. 1–2)
教学例子:前缀为 A 7 B 8 C 4,查询键为 B。模运算应回答 $19\bmod10=9$,召回应回答 $8$;只有两个答案都正确,该样本才计为正确。
将原文评价规则形式化,联合准确率为:
$N_{\mathrm{eval}}$ 是评测样本数,数值越高越好。这一指标同时受到两个子任务影响;它不是两个准确率的平均,也不能用另行训练的两个单任务模型准确率相乘来还原。
长度口径:原文将 $L\le25$ 标为分布内、$L>25$ 标为分布外,但未明确解释结果表中的长度与 $n$、完整 token 数的换算。因此本文沿用报告的 $L$,不把“长度 25”写成“25 tokens”,也不补造训练长度的采样分布。
2.2 一个可外推的状态追踪解是什么样?
以下是对任务的教学解释,不是作者报告的隐藏状态分析:
状态 $s_i$ 只需取十种值。上述例子中,状态依次为 $0\rightarrow7\rightarrow5\rightarrow9$。只要模型学会并持续执行同一更新,处理更多键值对就继续重复该规则。这也解释了为何该任务适合检验长度泛化。
召回则需要保留 B 与 8 的关联,单独的模 10 状态并不包含这个信息。混合架构因而需要让两类信息在表示与读出中共同存在。
2.3 五种混合方式,注意复合顺序
原文以 $\mathrm{Attn}$ 表示包含多头注意力与 MLP 的模块。函数复合从右向左计算,因此 $\mathrm{LSTM}\circ\mathrm{Attn}$ 表示先注意力、后 LSTM。$X$ 是嵌入后的输入序列,$H,Z,Y$ 表示各阶段的序列特征;下表保留原文公式。(Appendix A,PDF p. 4)
| 架构 | 计算路径 | 可能承担的分工:本次分析 |
|---|---|---|
| Attention-on-LSTM:$\mathrm{Attn}\circ\mathrm{LSTM}$ | $H=\mathrm{LSTM}(X),\ Z=\mathrm{Attn}(H)$ | 先编码历史,再从循环特征中读取 |
| LSTM-on-Attention:$\mathrm{LSTM}\circ\mathrm{Attn}$ | $H=\mathrm{Attn}(X),\ Z=\mathrm{LSTM}(H)$ | 先形成上下文化特征,再逐步更新状态 |
| Parallel:$\mathrm{LSTM}+\mathrm{Attn}$ | $Z=H_{\mathrm{lstm}}+H_{\mathrm{attn}}$ | 两条路径并行,经逐元素相加合并 |
| Hybrid Block | 在同一残差结构中整合 LSTM、MHA、MLP | 用残差通路保留循环信息,并加入注意力变换 |
| Sandwich:$\mathrm{LSTM}\circ\mathrm{Attn}\circ\mathrm{LSTM}$ | $H=\mathrm{LSTM}(X),\ Z=\mathrm{Attn}(H),\ Y=\mathrm{LSTM}(Z)$ | 注意力前后各有循环处理 |
Sec. 2 写“四种”混合结构,但 Fig. 1 与 Appendix A 实际列出上述五种;结果分析以实际列出的五种为准。所有模型嵌入维度为 256,默认位置编码为旋转位置编码(RoPE);附录称 Transformer 部分默认采用 4 个 block、Post-LayerNorm 设置。图注具体说红框中的注意力模块重复四次,不宜据此推断整个含 LSTM 的图块也重复四次。
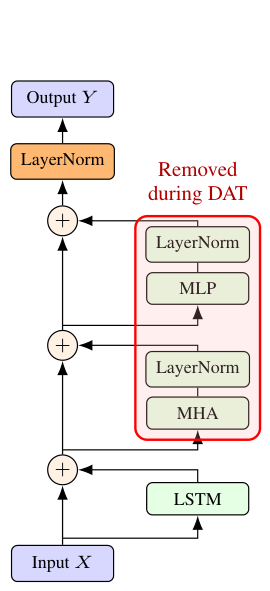
来源:Fig. 1 左,PDF p. 2,原图裁切。由下向上阅读:输入先经过含 LSTM 的残差更新,再经过注意力与 MLP 相关分支,最后得到输出。红框圈出的区域包括 MHA、MLP 及其 LayerNorm;早期训练移除的是图中所示模块贡献。图示与正文的 Post-LayerNorm 文字不足以确定一份逐层实现,复现时仍需明确各归一化与旁路的位置。
2.4 DAT 的两个阶段
| 阶段 | 模块行为 | 作者报告的学习率与时长 |
|---|---|---|
| 前期 | 停用注意力模块贡献,训练 LSTM 组件 | 1500 epochs,$10^{-4}$ |
| 后期 | 启用注意力梯度,与循环模块联合训练 | 前 500 epochs 为 $10^{-4}$,随后 $10^{-5}$ |
作者的设计理由是:先让循环路径建立状态追踪机制,再允许注意力参与内容检索。后期的 LSTM 仍参加联合训练。(Sec. 2,PDF p. 2;Appendix A,PDF p. 4)
这里的关键是前向贡献也被停用。仅把注意力参数的梯度设为零,若它的输出仍进入网络,仍会改变循环模块的输入或读出,这与原文描述不同。具体旁路需适配结构:串联模块停用时,应保留信息向后传递;并联加法分支停用时,应去掉该分支的贡献。这是根据“停用贡献”做出的实现解释,论文没有提供统一的旁路伪代码。
论文也没有说明 DAT 前期改用“仅 modulo”损失。因此应将 DAT 理解为原文明确描述的模块参与日程,不额外写成已验证的任务切换课程。推理时所有模块恢复使用,论文没有声称 DAT 减少推理期注意力成本。
三:实验——哪些比较能回答哪些问题?
3.1 共同配置与预算
| 项目 | 原文报告 |
|---|---|
| 优化器 | Adam |
| 每个 epoch | $2^{14}=16\,384$ 个随机生成样本 |
| 普通端到端训练 | 前 500 epochs 学习率 $10^{-4}$,随后 $10^{-5}$ |
| DAT | 前期 1500 epochs;恢复注意力后另有 500 epochs 的 $10^{-4}$ 阶段,随后 $10^{-5}$ |
| 报告长度 | 5、10、15、20、25、30、35、40、45、50、75、100 |
| 主要指标 | 复合任务的联合准确率;附录单任务的各自准确率 |
来源:Fig. 1,PDF p. 2;Appendix A,PDF p. 4。
由上述配置可算出,DAT 前期处理了 $1500\times2^{14}=24\,576\,000$ 个生成样本。原文没有报告两种方案的最终总 epoch 或等总样本/等算力对照。因此,现有结果显示这套阶段训练有效,但不足以单独分离“延迟模块参与”与完整训练预算变化各自的贡献。论文也没有给出重复运行数和误差条,以下按报告值解读,不推断种子间稳定性。
3.2 三组实验的角色
- 复合任务:Transformer-only 与 LSTM-only 暴露两种基本瓶颈;五种混合结构的普通训练与 DAT 成对比较,检验训练顺序是否改善联合长度泛化。
- Recall-only:模型只在召回任务上训练、评测,检验注意力是否带来检索优势,以及该优势在更长长度下是否保持。
- Modulo-only:模型只在模 10 任务上训练、评测,检验加入注意力后状态追踪是否仍可外推。
附录两个表没有 DAT 行。它们是另行训练的单任务实验,不能当作 Fig. 1 中同一个 DAT 模型的错误分解。(Appendix B,PDF p. 4)
四:结果——从总体失效到机制线索
4.1 复合任务:训练范围内高分掩盖了不同的解法
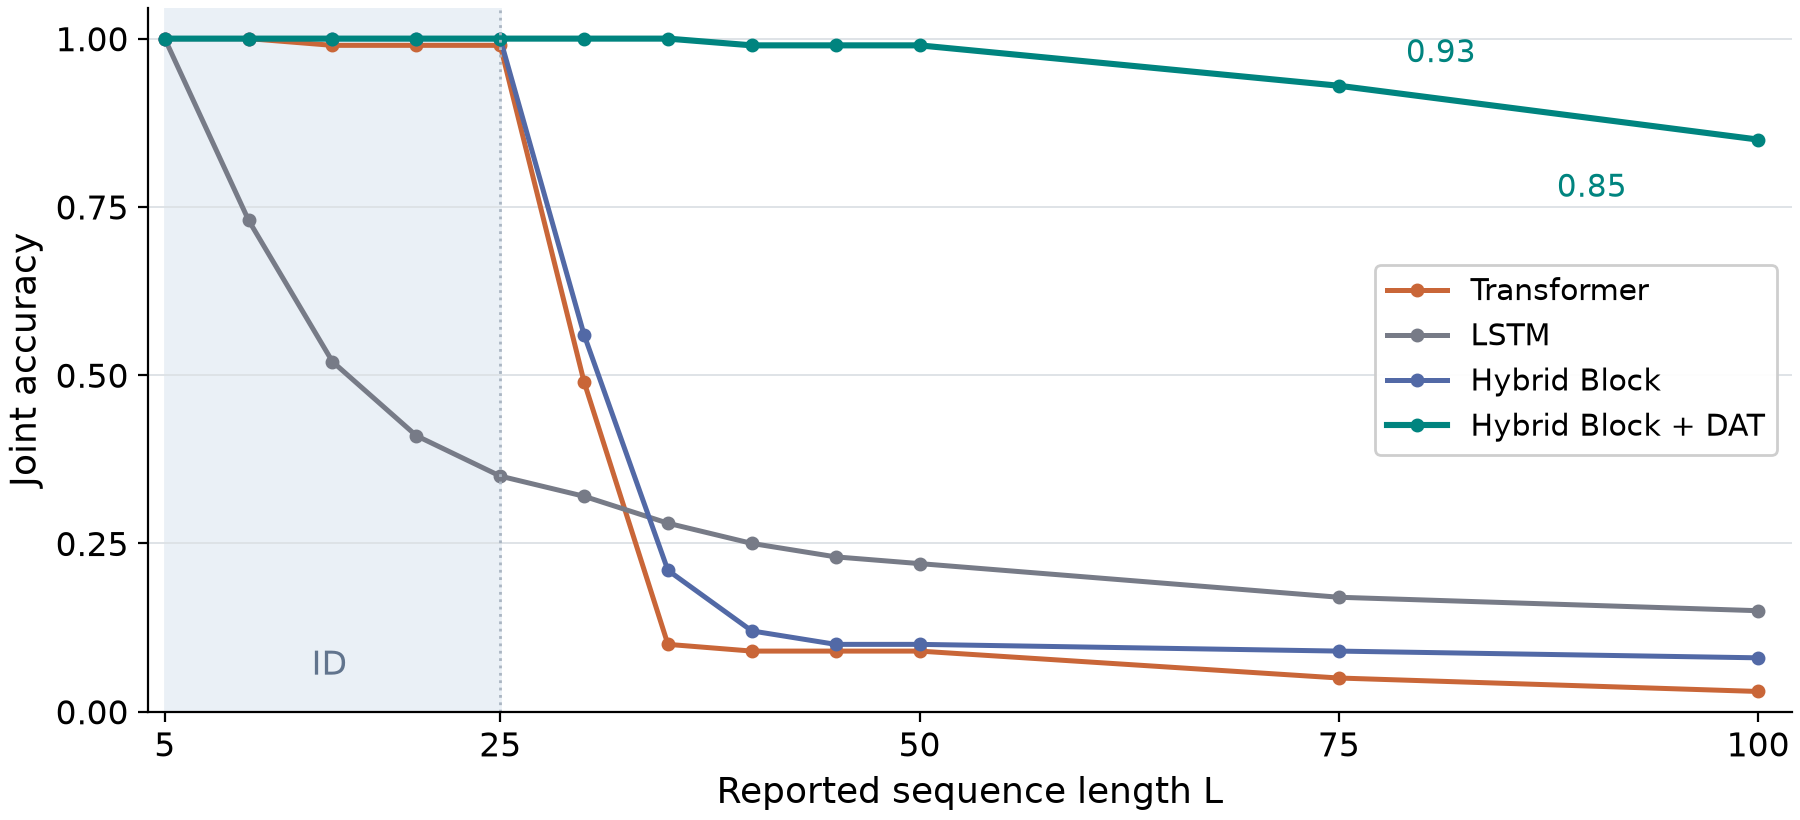
根据原文 Fig. 1 右(PDF p. 2)重绘;选取 Transformer、LSTM、Hybrid Block 及其 DAT 版本。横轴为原文报告长度,纵轴为两项任务同时答对的准确率;阴影标出分布内范围,折线仅连接原文采样点。
在 $L=25$,Transformer 联合准确率为 0.99,Hybrid Block 为 1.00,但 LSTM 已降到 0.35。长度增加到 50 后,Transformer 和普通 Hybrid Block 分别降到 0.09 与 0.10,DAT Hybrid Block 则为 0.99。仅看训练范围内表现,很难看出模型是否学到了可外推的计算过程。
4.2 DAT 大幅改善五种结构,但结构差异仍然存在
下面同一格中的“普通 / DAT”分别表示普通端到端训练和 DAT,全部为联合准确率,范围 0–1,越大越好。
| 架构 | $L=25$ | $L=50$ | $L=75$ | $L=100$ |
|---|---|---|---|---|
| $\mathrm{LSTM}\circ\mathrm{Attn}$ | 0.99 / 1.00 | 0.09 / 0.99 | 0.05 / 0.93 | 0.04 / 0.88 |
| $\mathrm{Attn}\circ\mathrm{LSTM}$ | 0.99 / 1.00 | 0.09 / 0.99 | 0.07 / 0.80 | 0.05 / 0.56 |
| Hybrid Block | 1.00 / 1.00 | 0.10 / 0.99 | 0.09 / 0.93 | 0.08 / 0.85 |
| $\mathrm{LSTM}\circ\mathrm{Attn}\circ\mathrm{LSTM}$ | 1.00 / 1.00 | 0.07 / 0.99 | 0.06 / 0.91 | 0.06 / 0.80 |
| $\mathrm{LSTM}+\mathrm{Attn}$ | 1.00 / 1.00 | 0.16 / 0.99 | 0.12 / 0.95 | 0.08 / 0.85 |
来源:Fig. 1 右,PDF p. 2。
在 $L=50$,所有 DAT 结构都达到 0.99;在三倍边界长度 $75=3\times25$,并联结构达到最高的 0.95,相比对应普通训练的 0.12 提升 83 个百分点。Hybrid Block 从 0.09 升到 0.93,提升 84 个百分点。
五种结构中,$\mathrm{Attn}\circ\mathrm{LSTM}$ 在 $L=75$ 只有 0.80,因此不符合摘要的“超过 90%”;其余四种为 0.91–0.95。到 $L=100$,最高值转为 $\mathrm{LSTM}\circ\mathrm{Attn}$ 的 0.88,而 $\mathrm{Attn}\circ\mathrm{LSTM}$ 降到 0.56。这个结果提示注意力与递推模块的位置会影响更远的外推,但论文没有进一步实验来解释这一排序。
4.3 Recall-only:注意力缓解了检索瓶颈
| 模型 | $L=25$ | $L=50$ | $L=75$ | $L=100$ |
|---|---|---|---|---|
| LSTM | 0.83 | 0.53 | 0.37 | 0.28 |
| Transformer | 1.00 | 0.99 | 0.90 | 0.80 |
| Hybrid Block | 1.00 | 0.99 | 0.98 | 0.92 |
来源:Appendix B,PDF p. 4,Table 1;选取三种代表结构,均为单独训练的召回任务。
LSTM 的召回准确率随长度增加持续下降;含注意力的模型在长度 50 时都保持约 0.99,在长度 100 时仍达到 0.76–0.92。这支持注意力承担内容检索的角色,也解释了复合任务中纯 LSTM 为什么会成为短板。
4.4 Modulo-only:普通混合训练破坏了可外推表现
| 模型 | $L=25$ | $L=30$ | $L=50$ | $L=100$ |
|---|---|---|---|---|
| LSTM | 1.00 | 1.00 | 1.00 | 1.00 |
| Transformer | 0.98 | 0.51 | 0.10 | 0.10 |
| Hybrid Block | 1.00 | 0.45 | 0.10 | 0.10 |
| $\mathrm{Attn}\circ\mathrm{LSTM}$ | 1.00 | 0.63 | 0.10 | 0.10 |
来源:Appendix B,PDF p. 4,Table 2。其余混合结构在长度 50 与 100 也为 0.10。
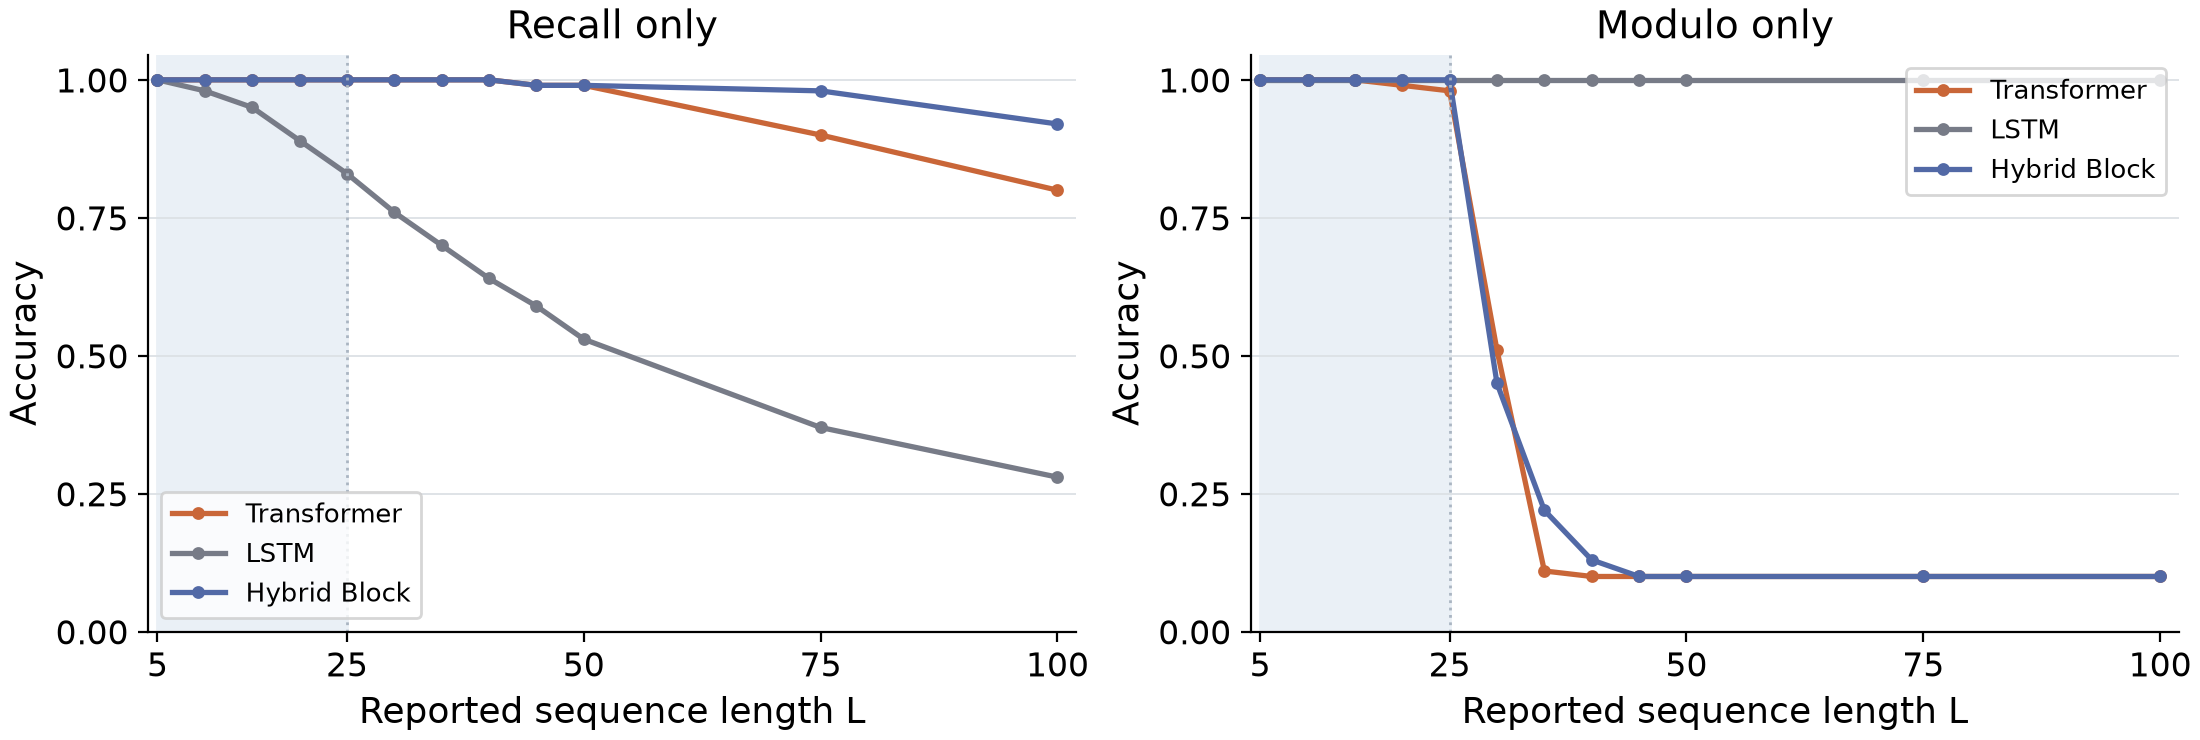
根据原文 Table 1、Table 2(PDF p. 4)重绘。两幅图依次为 recall-only 与 modulo-only;横轴均为报告长度,纵轴为对应单任务准确率。蓝色 Hybrid Block 在左图接近满分,却在右图的训练边界外迅速退化;灰色 LSTM 呈现相反优势。
这组对照支持作者的判断:普通混合训练没有自然形成预期分工,注意力的参与与状态追踪外推失败相伴。DAT 的干预进一步表明,改变早期可用路径能够改善最终表现。论文没有展示隐藏状态解码、具体捷径算法或注意力模式分析,因此“注意力诱导捷径”应作为作者对这些行为结果的机制解释。
4.5 长度 100 的退化:softmax 锐度解释有多强?
作者把长度 100 的下降归因于注意力 softmax 变得不够尖锐,并引用 Table 1 中长长度召回下降的结果。(Sec. 2,PDF p. 2)一个有助于理解的教学推导是:设候选位置数 $N\ge2$,查询对应的正确位置得分为 $a$,其余 $N-1$ 个候选都为 $b$,且分数已经包含实际使用的缩放。记分差 $\Delta=a-b$,正确位置的注意力权重为:
若 $\Delta$ 固定,候选数 $N$ 增加会降低正确位置的权重;若要求 $p_\star\ge\rho$,其中 $0<\rho<1$,则需要:
这里的 $N$ 是注意力候选位置数,不是前文的评测样本数。该推导说明“候选增多会稀释检索权重”的可能机制,并非论文对模型内部量的实测。权重下降也不必然导致答案改变,还取决于 value 表示与后续读出。Table 1 只提供单任务性能,没有 softmax 锐度测量或温度干预,所以现有证据支持长序列检索退化,却不能据此把 DAT 在长度 100 的全部错误归因于这一因素。
五:结论——训练顺序是混合模型设计的一部分
DAT 的核心贡献是一个简单且有效的训练干预:先让循环路径在缺少注意力帮助的条件下学习,再恢复完整混合模型联合训练。在这个同时要求模运算与召回的合成任务上,它显著改善了五种混合结构的长度泛化,也说明最终架构相同的模型,可以因训练过程不同而学到很不一样的计算方式。
最值得带走的启发是:设计混合模型时,应同时考虑各模块何时参与优化,以及训练目标是否鼓励期望的能力分工。该论文的证据集中在嵌入维度 256 的 LSTM–Transformer 合成任务,尚无语言建模实验。附录排除了 Mamba 等状态空间模型;作者关于这些模型的预期不是本文的实测结论。
若继续研究这条路线,最有信息量的三类实验是:
- 控制训练预算并扫描延迟长度:对齐总样本数或算力,比较不同延迟点与普通训练,分离阶段顺序和预算贡献。
- 直接检验模块分工:在同一个复合任务模型上分别统计两项正确率,并解码循环状态是否追踪余数;对注意力做阶段性干预,定位其实际作用。
- 检验长长度检索解释:记录注意力分差、熵和目标位置权重,再用温度等干预测试长度 100 的失败是否随检索锐度改变。
这些是由本文结果提出的后续实验建议,不是作者已经完成的结果。