从预训练到后训练追踪语言模型的表示几何:精读笔记
原题:Tracing the Representation Geometry of Language Models from Pretraining to Post-training
作者:Melody Zixuan Li、Kumar Krishna Agrawal、Arna Ghosh、Komal Kumar Teru、Adam Santoro、Guillaume Lajoie、Blake A. Richards
版本:arXiv:2509.23024v1,2025 年 9 月 27 日提交;本次研读于 2026 年 10 月 25 日完成。
原文:本地 PDF(下文页码均从 PDF 首页算起)。
论文总览
一句话:训练损失大致单调下降,但语言模型最后一层、最后一个 token 的表示协方差谱呈现“初期塌缩 → 扩张 → 各向异性压缩”;这些变化与短上下文统计拟合、问答能力和后训练的行为取舍同步出现。
作者把一批输入送入每个训练检查点,收集最后一个 token 的隐藏状态,计算协方差的特征值分布。有效秩 RankMe 衡量方差分布实际占用了多少维;谱衰减指数 $\alpha_{\mathrm{ReQ}}$ 衡量方差是否集中在前几个方向。两者共同揭示 OLMo-2 和 Pythia 预训练中的非单调变化。作者再用 $\infty$-gram、SciQ、TriviaQA、简化交叉熵模型,以及 Tülu 3.1 的 SFT/DPO/RLVR 检查点,关联谱变化与行为变化。(Fig. 1–6,PDF 第 2–11 页)
| 阶段 | RankMe | $\alpha_{\mathrm{ReQ}}$ | 论文观察到的行为对应 |
|---|---|---|---|
| warmup | 快速下降 | 上升 | 初期重复、缺乏上下文的输出 |
| entropy-seeking | 上升 | 下降 | 与语料 $\infty$-gram 统计的对齐增强 |
| compression-seeking | 下降 | 上升 | $\infty$-gram 对齐趋平,TriviaQA 准确率主要在此阶段上升 |
这里的“熵”是归一化协方差特征值的熵,不是训练目标的交叉熵,也不是生成文本的熵。“压缩”指方差分配更不均匀,并不表示表示只剩少数几个有用方向;后文的主成分消融恰恰显示尾部方向也很重要。
结构地图
| 原文章节 | 作用 | PDF 定位 |
|---|---|---|
| 1. Introduction | 提出损失与能力变化的错位和谱分析视角 | 第 1–3 页;Fig. 1 第 2 页 |
| 2. Methods | 定义谱指标、$\infty$-gram 对齐与后训练评价 | 第 3–5 页;Eq. (1)–(4) |
| 3.1. Phases of pretraining | 在 OLMo-2/Pythia 检查点识别三阶段 | 第 5–7 页;Fig. 2–3 |
| 3.2. Memorization & beyond | 连接统计对齐、SciQ/TriviaQA 与谱变化 | 第 7–8 页;Table 1–2、Fig. 4 |
| 3.3. Role of learning objective and optimization | 用线性交叉熵模型解释相似动态 | 第 9–10 页;Fig. 5 |
| 3.4. Representation geometric changes during Post-Training stages | 比较 SFT、DPO、RLVR | 第 10–12 页;Fig. 6 |
| 4–6. Related Work / Discussions / Conclusion | 对结果的解释、限制与总结 | 第 12–14 页 |
| 附录 A–C | 配置、理论推导、稳健性与对照实验 | 第 19–33 页;Table 3–9、Fig. 7–14 |
一:研究动机
交叉熵损失告诉我们模型预测训练文本的平均质量,却不直接说明内部特征如何重新分配,或为什么某些下游能力突然加快提升。作者因此观察隐藏表示的方向结构:如果方差在很多主方向上较均匀,模型使用的有效维度高;如果少数方向占据大部分方差,则谱更陡、有效维度低。这个量化视角可以在同一条训练轨迹上追踪几何变化,而不是只比较起点与终点。(Sec. 1,PDF 第 1–3 页)
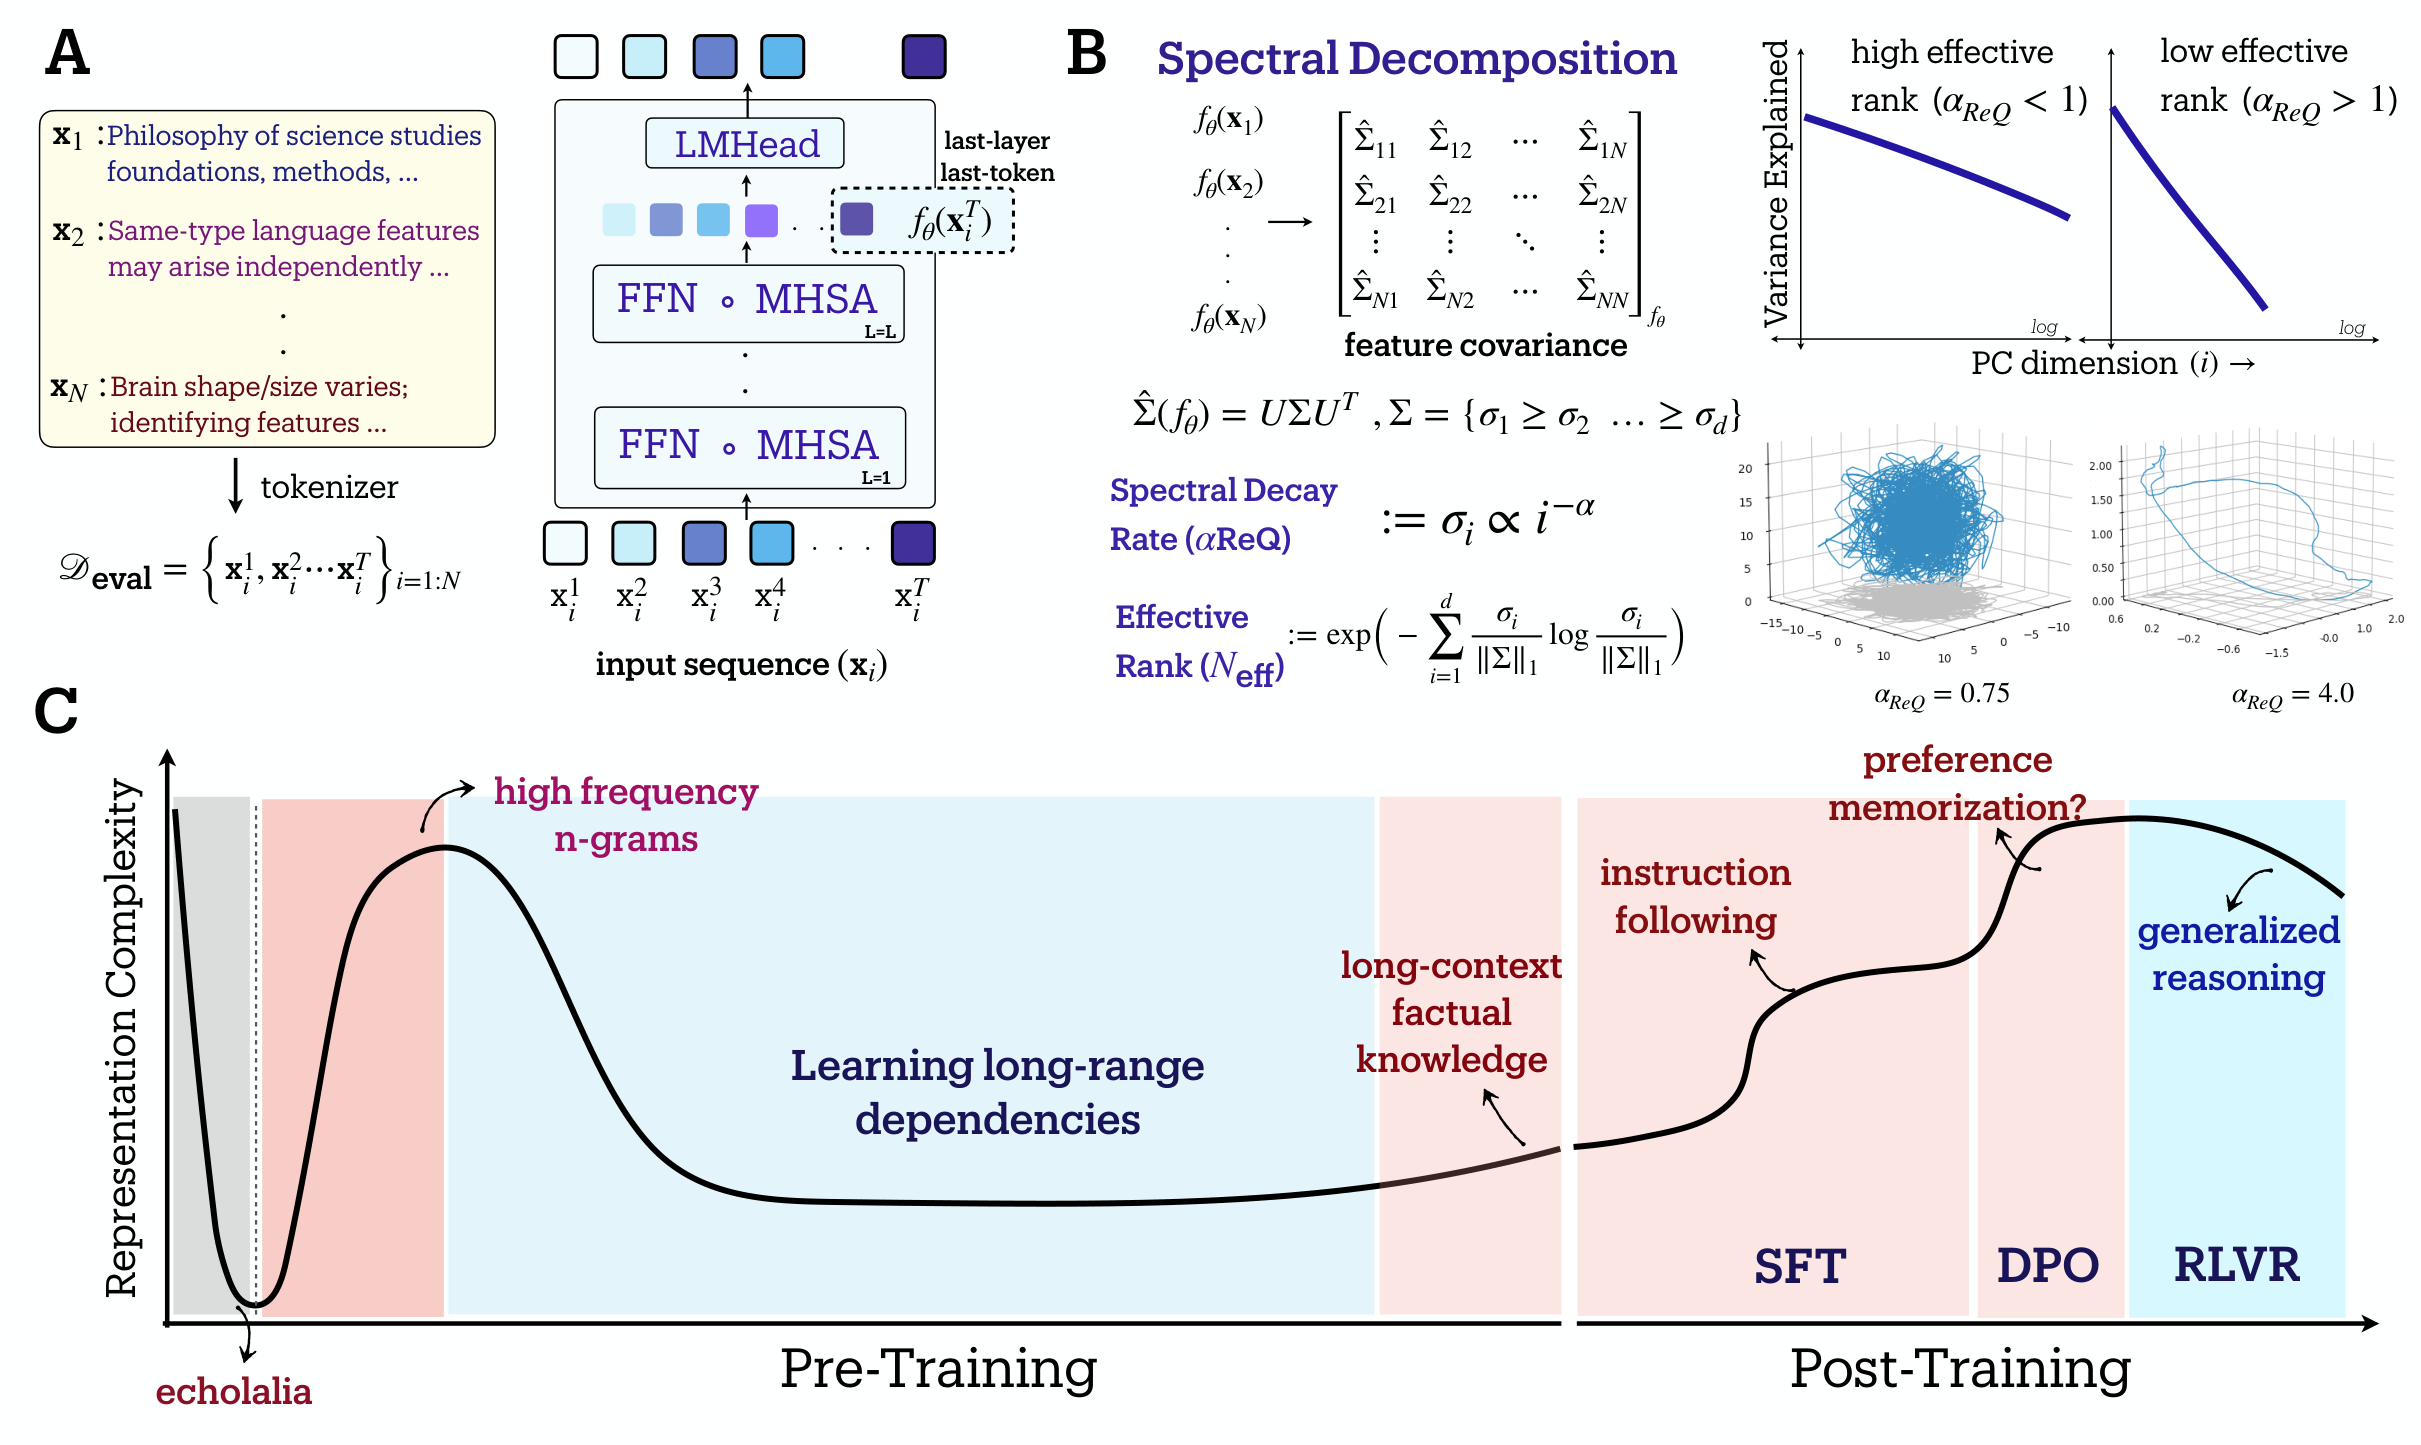
原文 Fig. 1,PDF 第 2 页。上半部分是实际测量流程和谱指标,下半部分是作者提出的阶段示意;曲线是概念图,不是一次训练的原始数据。
二:方法与机制
2.1 从隐藏状态到两个谱指标
给定 $M$ 条输入序列,对每条序列取模型最后一层的最后一个 token 表示 $f_\theta(x_i)\in\mathbb R^d$,去中心化后叠成 $F\in\mathbb R^{M\times d}$。论文使用经验协方差
$\lambda_i$ 是协方差特征值,$p_i$ 是第 $i$ 个主方向所占总方差的比例。只要总方差非零,RankMe 从 1(一个方向独占方差)到 $d$($d$ 个方向均匀分布);它衡量有效维数,不是矩阵的代数秩。对所有特征同时乘一个常数不改变 $p_i$,所以它关注方差的相对分布。(Sec. 2.1,Eq. (1),PDF 第 3 页)
作者同时拟合按大小排序的谱 $\lambda_i\propto i^{-\alpha_{\mathrm{ReQ}}}$。$\alpha_{\mathrm{ReQ}}$ 大,谱衰减快、方差更集中;小则更平缓。它与 RankMe 往往反向变化,但前者是谱斜率,后者是整个归一化谱的熵,二者不能数值互换;论文也指出 RankMe 随隐藏维度的上界变化,$\alpha_{\mathrm{ReQ}}$ 相对便于跨维度比较。(Sec. 2.1,PDF 第 3–4 页)
测量条件:预训练主图在 FineWeb 的 15,000 条序列上计算,每条最长 512 token、batch size 16;检查点来自 OLMo-2 1B/7B 和 Pythia 多种规模。FineWeb 是谱分析的探针文本;Pythia 的训练语料是 The Pile,OLMo-2 是 OLMoStack,不能把探针数据误称为它们共同的训练集。(Sec. 3、附录 A.1/A.3,PDF 第 5–6、19、21 页)
2.2 把短程语料统计与问答表现分开
$\infty$-gram 模型从语料中寻找最长可匹配前缀;找不到时逐步回退。论文把它和 LLM 对 TriviaQA 目标答案赋予的联合概率作 Spearman 排名相关,定义分布式记忆指标 $\mathrm{Mem}_\infty$。它测的是概率排序与语料局部统计的一致性,不是逐字复现训练样本的比例,也不是独立的泛化分数。(Sec. 2.2,Eq. (2),PDF 第 4 页)
在该实验中,$\infty$-gram 实际采用的后缀长度有 88.73% 不超过 5(25.41% 为 $\le3$、46.61% 为 4、16.71% 为 5)。因此作者将其作为偏向短至中等上下文统计的比较对象。(Table 1,PDF 第 7 页)
2.3 后训练目标与指标
SFT 用指令—回答对做负对数似然训练;DPO 比较偏好答案 $y_w$ 和非偏好答案 $y_l$,其损失写作
其中 $\pi_{\rm ref}$ 是参考策略。将 sigmoid 展开,会得到一个偏好答案对一个非偏好答案的二项对比形式;这是作者把 DPO 与表示扩张联系起来的动机,不是对 DPO 谱变化的数学证明。RLVR 则根据可验证奖励更新策略。其数学题表现用 $N=512$ 个采样估计
$c_i$ 是题目 $P_i$ 的正确样本数;低 $k$ 更关注少量采样命中,高 $k$ 还反映模型能否探索到较少见的正确解。(Sec. 2.3,Eq. (3)–(4),PDF 第 4–5 页;Sec. 3.4,Eq. (5),第 11 页)
2.4 简化模型为什么会出现扩张后压缩
作者的教学性理论模型令特征提取器线性化:输入批次 $X$ 经过 $F=X\Theta\in\mathbb R^{b\times d}$,再由 $W\in\mathbb R^{d\times |\mathcal V|}$ 产生 logits $FW$。设 $P=\operatorname{softmax}(FW)$、$Y$ 为独热标签、$A=P-Y$;在附录的样本行正交假设下,梯度动力学可写为
这给出 $\frac{d}{dt}(F^\top F-WW^\top)=0$。若初始化满足 $F^\top F=WW^\top$,两者的非零奇异值保持配对;对第 $i$ 个奇异值 $s_i$,附录进一步得到 $\dot s_i=-\eta g_i s_i$,其中 $g_i$ 由残差矩阵与当前奇异向量决定。直觉是:已有较大的方向可能获得较大幅度的更新。更新方向由 $g_i$ 的符号决定,单靠该式不能推出所有方向必然增长或必然压缩。(附录 B.1–B.4,PDF 第 23–27 页)
作者的玩具实验进一步加入类别频率不均和表示瓶颈 $d<|\mathcal V|$:高频类别先分开;随后多个方向扩张;低频类别开始分开时,瓶颈促使已有方向被重复使用,最大特征值增长得更快,有效秩下降。将类别改为均匀、去掉瓶颈,或把交叉熵换成 MSE 后,玩具实验不再出现相同的压缩阶段。这说明这些条件能在该简化设置中产生相似曲线,尚未证明真实 Transformer 由完全相同的路径驱动。(Sec. 3.3,Fig. 5,PDF 第 9–10 页;附录 Fig. 12–13,第 31–32 页)
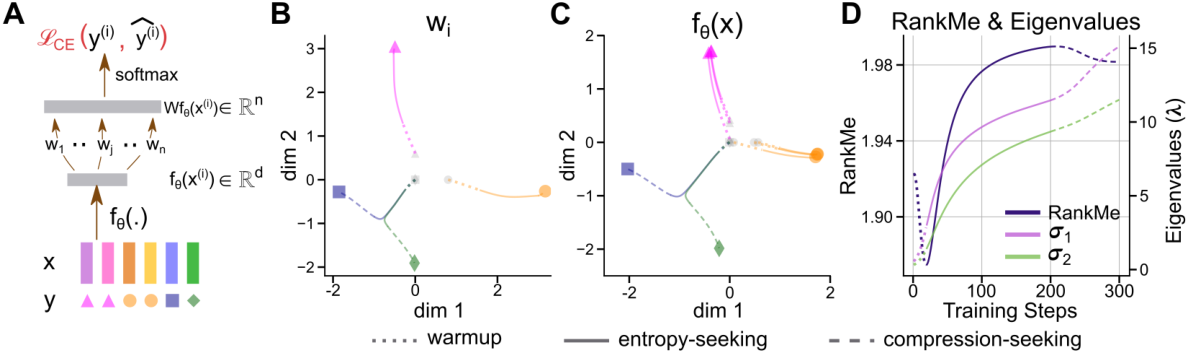
原文 Fig. 5,PDF 第 9 页。A 为线性模型;B/C 是权重和特征的位置轨迹;D 同时显示 RankMe 与两个特征值,压缩阶段最大特征值增长相对更快。
三:实验设计
| 检验问题 | 对象与比较 | 读数与方向 |
|---|---|---|
| 训练过程是否真的非单调? | OLMo-2 1B/7B、Pythia 70M–12B 的中间检查点;主图以 OLMo-2 7B 与 Pythia 1B–12B 展示 | RankMe 上升表示使用更多方向;$\alpha_{\mathrm{ReQ}}$ 上升表示更集中。对照训练损失、梯度范数与学习率。(Fig. 2–3,第 5–6 页) |
| 几何阶段是否对应不同能力? | Pythia 检查点;$\infty$-gram 对齐、SciQ 零样本选择题、TriviaQA 零样本事实问答 | 对齐越高越接近语料局部统计;两项准确率越高越好。(Fig. 4,第 8 页) |
| 只有前几个主方向够用吗? | 对 Pythia/OLMo-2 保留或移除前 10/50 个特征方向 | 比较 SciQ 准确率;保留前 $k$ 与移除前 $k$ 是两种不同干预。(Table 2,第 7 页) |
| 后训练怎样改变几何及行为? | Llama-3.1-8B → Tülu-3.1 的 SFT/DPO/RLVR;另用 OLMo-2-1B 的 Anthropic-HH 与 AlpacaFarm SFT 做迁移检验 | RankMe/$\alpha_{\mathrm{ReQ}}$、域内/域外损失、AlpacaEval 胜率、AMC-23 pass@$k$。(Fig. 6,第 11 页;附录 Fig. 14,第 33 页) |
附录对样本数、序列长度、探针数据集和网络层进行稳健性比较;主结论中的三阶段形状大致保留,但 RankMe 的绝对值会随探针数据集变化。(Fig. 3、Fig. 8–11,PDF 第 6、29–30 页)
四:逐项结果与证据
4.1 预训练:谱指标先塌缩、再扩张、再集中
OLMo-2 7B 的损失随训练下降,而 RankMe 在 warmup 后迅速上升,在中间检查点达到高点,随后明显回落;$\alpha_{\mathrm{ReQ}}$ 基本呈反向轨迹。Pythia 1B–12B 出现相似的谷—峰—回落形状;小于 1B 的 Pythia、其他层和其他探针数据集也给出对应形状。OLMo-2 晚期还有再次上升的迹象,因此“三阶段”是主要序列,而非训练之后永远不再变化的定律。(Sec. 3.1,Fig. 2–3,PDF 第 5–7 页;附录 Fig. 8–11,第 29–30 页)
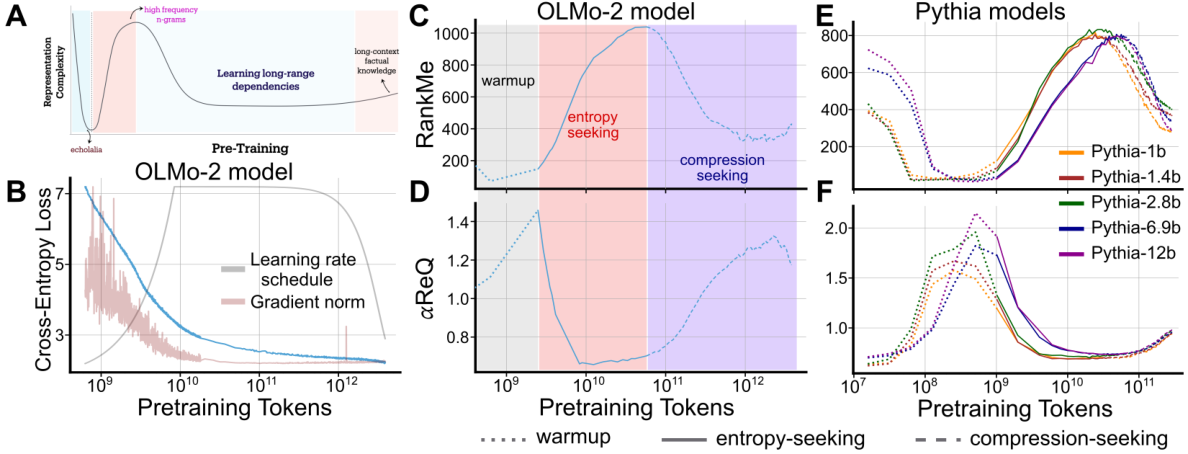
原文 Fig. 2,PDF 第 5 页。B 是优化指标,C/D 为 OLMo-2 7B 的 RankMe/$\alpha_{\mathrm{ReQ}}$,E/F 为 Pythia;横轴为预训练 token 数,注意采用对数刻度。
4.2 扩张阶段对齐局部统计;压缩阶段继续提升问答
在五个 Pythia 规模上,$\infty$-gram 对齐在 entropy-seeking 阶段增长,接近阶段末尾达到峰值,压缩阶段趋平或小幅回落。SciQ 准确率在两个阶段都继续提高;TriviaQA 的显著提升主要发生在压缩阶段。由此得到较稳妥的读法:局部语料统计的拟合与某些问答能力的提升并不同步。作者进一步把 TriviaQA 的晚期提升解释为更好地利用长程信息;此实验并未通过改变证据上下文长度直接隔离这一因素。(Sec. 3.2,Fig. 4,PDF 第 7–8 页)
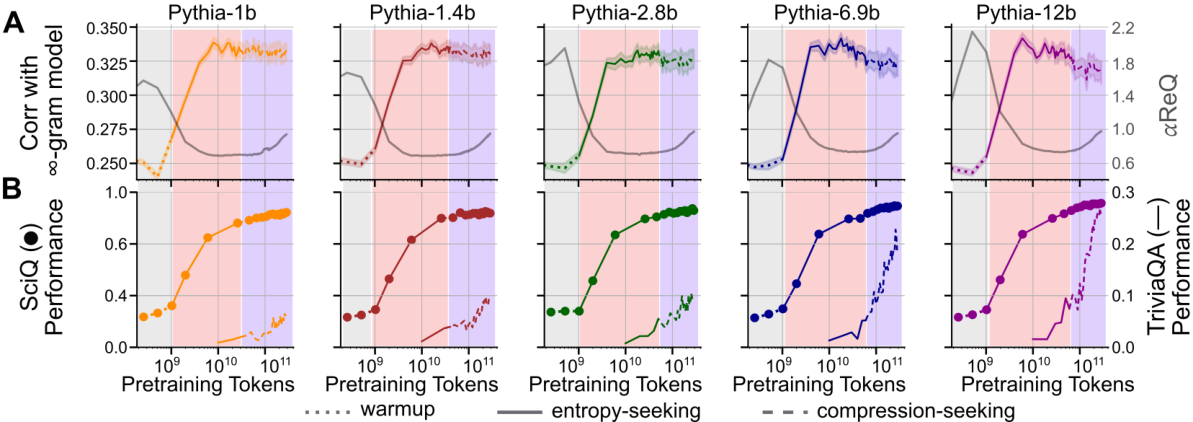
原文 Fig. 4,PDF 第 8 页。每列是一种规模;上排彩线是 $\infty$-gram 相关、灰线是 $\alpha_{\mathrm{ReQ}}$;下排圆点为 SciQ、细线为 TriviaQA。
附录 Table 9 还报告 SciQ 准确率与 $\alpha_{\mathrm{ReQ}}$ 正相关、与 RankMe 负相关,例如 Pythia-1B 分别为 0.810 和 −0.759,Pythia-12B 为 0.836 和 −0.839。这是沿训练检查点的相关性,说明谱能追踪能力变化;表本身不能判定谱变化是能力变化的直接原因。(附录 Table 9,PDF 第 30 页)
4.3 各向异性不等于只靠头部主成分
主成分消融给出一个重要反例:Pythia-1B 的 SciQ 准确率原为 0.838,只保留前 10 个方向时降至 0.225,移除前 10 个方向却为 0.849;OLMo-2-7B 分别是 0.970、0.155 和 0.966。前几个高方差方向不是任务所需信息的全部;尾部方向仍承载可用信息。因此压缩阶段更准确的说法是方差分配变得不均衡,不能说模型只依赖少数维度。(Table 2,PDF 第 7 页;Sec. 5,PDF 第 12–13 页)
4.4 后训练:SFT/DPO 扩张,RLVR 收缩
Tülu-3.1 8B 的连续后训练检查点中,SFT 与 DPO 伴随 RankMe 增长、$\alpha_{\mathrm{ReQ}}$ 下降;RLVR 使 RankMe 下降。三种阶段在同一模型训练配方中呈现不同方向的几何变化。DPO 损失有二项对比形式,作者以此解释它与 SFT 同样表现为扩张;这个解释主要是类比与经验观察。(Sec. 3.4,Fig. 6A,PDF 第 10–11 页)
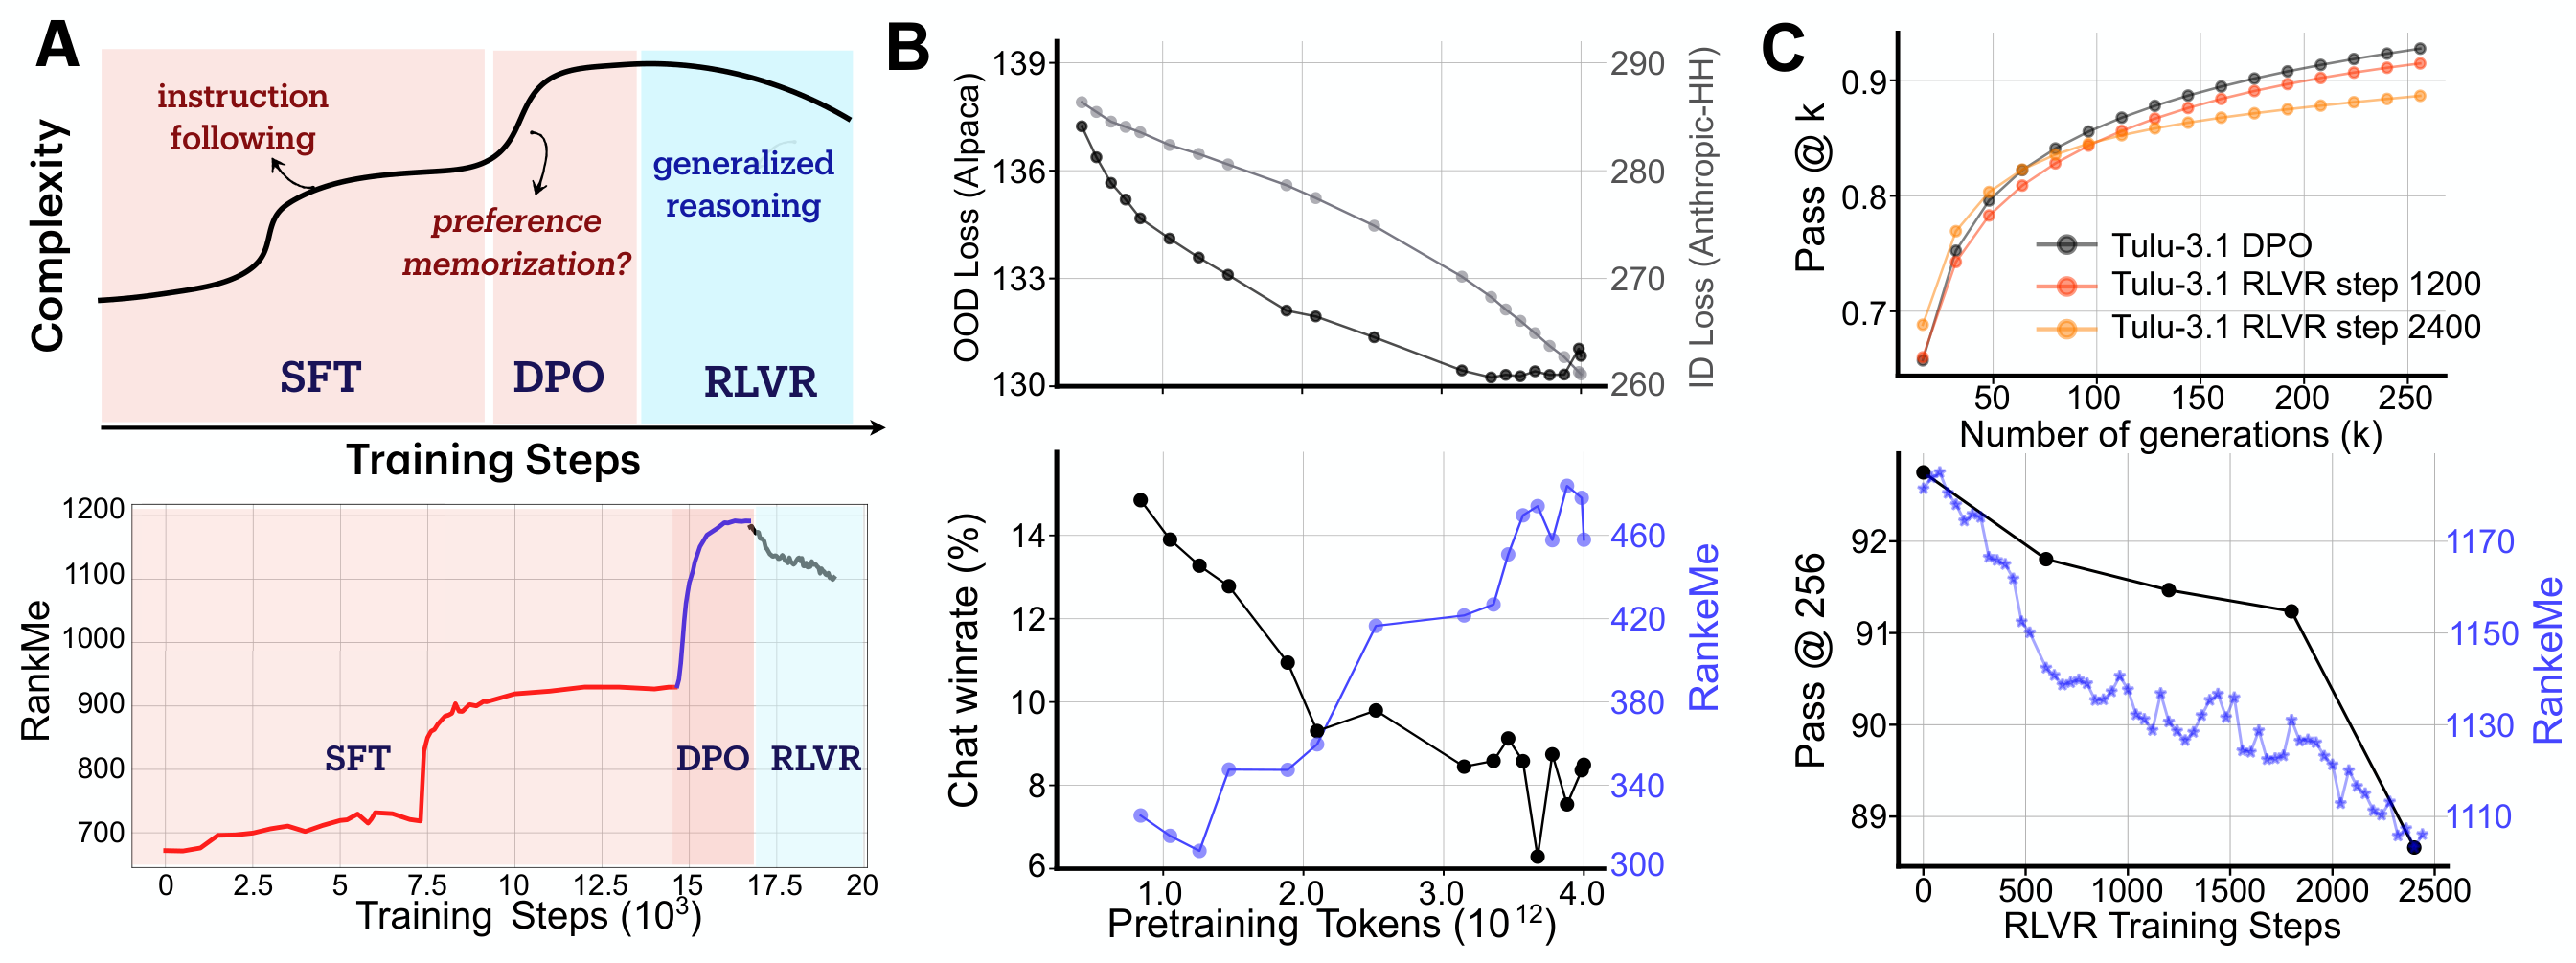
原文 Fig. 6,PDF 第 11 页。A 是 Tülu 连续阶段的 RankMe;B 用 OLMo-2-1B 的 SFT 检查域内/域外表现;C 为 Tülu 在 AMC-23 的 pass@$k$。
对 OLMo-2-1B 的额外 SFT 实验,Anthropic-HH 作为域内数据,AlpacaFarm 作为域外数据。随着基础模型预训练更久,Anthropic-HH SFT 后的域内损失继续下降;AlpacaFarm 损失先下降,后趋于饱和并在末尾略回升。以 AlpacaFarm-SFT 模型为参照、由 LLM 裁判在 AlpacaEval 上比较时,Anthropic-HH-SFT 模型的胜率从文中概述的约 14% 降到约 9%,显示 SFT 数据选择对输出的影响变大。(Sec. 3.4,Fig. 6B,PDF 第 10–11 页;附录 Fig. 14,第 33 页)
这里有一处原文表述需要辨明:Sec. 3.4 的正文写“域外损失增加”,但 Fig. 6B 和 Fig. 14 的曲线显示它总体下降,末段趋平或略反弹;两幅图的说明文字也写“saturates / gets slightly worse”。因此图支持的是域外收益弱于域内、后期敏感性增加,不能概括成域外损失在整段预训练中持续恶化。
AMC-23 上,RLVR 训练到约 2400 步后,少量采样的 pass@16 比 post-DPO 起点更好,而大量采样的 pass@256 比起点和中间检查点更低;RankMe 同时下降。作者据此提出 RLVR 改善常见解的命中,但缩小可探索的解空间。pass@$k$ 是行为证据,表示秩与多样性的因果联系仍需进一步干预验证。(Sec. 3.4,Fig. 6C,PDF 第 11 页;$N=512$ 的估计设置见 Eq. (4),第 5 页)
五:结论与可复用的认识
这篇论文最有用的贡献,是给训练过程提供一个可以跨检查点持续测量的表示几何坐标系:RankMe 告诉我们方差分布用了多少方向,$\alpha_{\mathrm{ReQ}}$ 告诉我们谱尾部衰减有多快。在论文研究的英语、标准预训练目标和 70M–12B 模型中,它们揭示了损失曲线掩盖的阶段变化;在后训练中,它们又标示了 SFT/DPO 与 RLVR 的不同表示更新方向。
对使用这些结果的人,有三个边界尤其重要。第一,谱—能力对应主要来自同一训练轨迹上的相关性;玩具模型能产生相似动态,但不能把线性模型证明直接搬到 Transformer。第二,TriviaQA 的跃升与压缩同步,却不足以单独证明模型已经学会更长上下文的机制。第三,SFT 的域外损失图支持“增益趋于饱和/末段略变差”,比正文的笼统说法更窄。作者也明确指出规模最高到 12B、主要考察英语模型,计算谱指标需要约一万条样本且随隐藏维度增加而变贵。(Sec. 5,PDF 第 12–13 页)
组会讨论切入点:若要检验压缩本身是否帮助泛化,可在相近损失和训练预算的检查点中,定向扰动谱尾部或改变上下文长度,再比较任务表现;这属于后续实验设想,不是本文已完成的结论。