EG-MLA:以 token 嵌入门控换取更紧凑的 KV 缓存
论文:EG-MLA: Embedding-Gated Multi-head Latent Attention for Scalable and Efficient LLMs
作者:Zhengge Cai、Haowen Hou;广东省人工智能与数字经济实验室(深圳)、深圳大学。
版本:arXiv:2509.16686v1,2025-09-20 提交;获取与研读日期:2026-09-14。
材料:arXiv 版本页 · 本地论文 PDF · 作者主 TeX · 源码清单 · 英文幻灯片。
本笔记是分析性精读,不是全文译稿。已阅读 main.tex 实际引用的 1_introduction.tex 至 7_appendix.tex,覆盖全部正文、附录 A–H、伪代码及关键参考文献条目,并结合 16 页 PDF 核验最终图表与公式。作者源码获取状态为 available;未执行作者代码,未重新训练或复现实验。以下页码均为从 1 开始的 PDF 页序。正文在最终 PDF 中没有章节编号,定位使用原节标题;附录公式重新从 (1) 编号,需与正文公式区分。
论文总览
研究问题:MLA 已经用一个低维潜在向量保存共同的 K/V 信息,再压缩这个向量会损失容量。能否利用不随上下文长度增长的额外参数,弥补随序列增长的 KV 状态容量?
核心思路:为每一层增设按 token ID 索引的嵌入表,将取出的嵌入投影成门控向量,与从低维 KV 潜在向量上投影得到的 K/V 特征逐元素相乘,再做 LayerNorm。上下文相关信息来自隐状态,token 身份先验来自查表;两路通过乘法交互。
最有依据的结果:在 Base、50B 训练 token 设置下,EG-MLA-kv64 的 12 任务平均准确率为 44.33%,MLA-kv256 为 43.84%,差 +0.49 个百分点;全模型每 token 的理论 KV 元素数由 3,840 降到 1,536,精确减少 60.0%。代价是总参数从 120M 增至 274M,其中 154M 为门控嵌入参数。这是静态容量与动态缓存之间的交换,不能直接解释为总显存减少 60%。(表 1,p.5;表 10,p.13)
阅读判断:门控设计和归一化消融值得关注;“所有任务都更好”“等总参数更好”“无需额外计算”“已证明 MLA 无法进一步压缩”均超出了这里的证据。正文对 1.2B 模型缓存比例的描述还与配置表存在矛盾,下文分别保留原文数字与重算结果。
结构地图
| 原文标题 | 论证作用 | PDF 位置与证据 |
|---|---|---|
| Introduction | 缓存瓶颈与贡献概览 | pp.1–2;图 1 p.2 |
| Related Works | 将工作放在 MHA/MQA/GQA/MLA 与门控研究中 | pp.2–3 |
| Embedding Gated MLA / Core Formulas | 两路投影、乘法门控、归一化 | p.3;图 2、正文式 (1)–(5) |
| Rationale behind Embedding Gating | 二阶交互解释 | pp.3–4;正文式 (6)–(8) |
| Performance Evaluation | 数据、压缩、嵌入容量、消融与 1B 扩展 | pp.4–5;表 1–4 分布在 pp.5–7 |
| Efficiency Evaluation | 缓存公式、时延、分片与层共享 | pp.5–8;表 5–6、图 3–5 |
| Conclusion | 总结与展望 | p.8 |
| References | 文献条目 | pp.8–9 |
| A. Hyper-parameters | 架构和训练超参数 | p.10;表 7 |
| B. Why Reducing KV Cache Size Matters | 参数与动态状态的内存区别 | p.10 |
| C. Detailed Architecture and Full Formulas | 完整 Q/K/V、RoPE 与输出 | pp.10–11;附录式 (1)–(14),图 6 在 p.16 |
| D. More Experimental Results | 三数据集 PPL 的压缩与嵌入扫描 | p.11;表 8–9 |
| E. PyTorch Code | 实现层面的形状与归一化细节 | pp.12–13;Listing 1 |
| F. Comparison Between Attention Mechanisms | 具体参数量和缓存账本 | p.13;表 10 |
| G. More Scaling Experiment | 中等/较大模型及损失曲线 | pp.13–14;图 7、表 11–12 |
| H. Compression through Layer Grouping | 层间共享的质量代价 | pp.14–15;表 13–14,p.16 为图 6 |
一:动机
1. KV 缓存为何值得压缩
自回归生成时,历史 token 的键和值被保留,以避免反复处理整个前缀。固定模型下,设批大小为 $B$、序列长度为 $T$、层数为 $l$、头数为 $n_h$、每头 K/V 维度均为 $d_h$、每元素占 $s$ 字节,则 MHA 的缓存约为
这是根据原文表 5 扩展的内存核算式。KV 缓存对 $T$ 是线性增长;p.1 将其描述为关于序列长度的二次增长不准确,应与完整注意力分数矩阵的 $T\times T$ 大小区分。权重内存主要随模型结构固定,KV 内存则随并发和上下文增长,因此降低后者可能扩大可承载的批量或上下文,但不会自动让所有推理场景更快。
2. 各个比较对象解决什么问题
| 方法 | 存储策略 | 在本论文中的比较角色 |
|---|---|---|
| MHA | 每个头存独立 K、V | 缓存占用参照;没有与主结果配套的同协议准确率表 |
| MQA | 所有查询头共享一组 K、V | 理论缓存参照 |
| GQA | 每组查询头共享一组 K、V | 理论缓存参照 |
| MLA | K/V 共享低维潜在表示,另存位置分支 | 主要实测质量与速度 baseline |
| EG-MLA | MLA 压缩路径加 token 身份门控 | 待检验的方法 |
原表 5 的 “Strong/Moderate/Weak/Stronger” 是作者定性标签,不是同预算、同数据实验得出的通用能力排序。正文说 MLA 已接近压缩极限,但主表没有提供 MLA-kv128/64/16 的完整对应扫描,因此该说法应理解为作者动机,而不是此论文已经独立证明的结论。
二:方法
1. 先看输入、数据流和输出
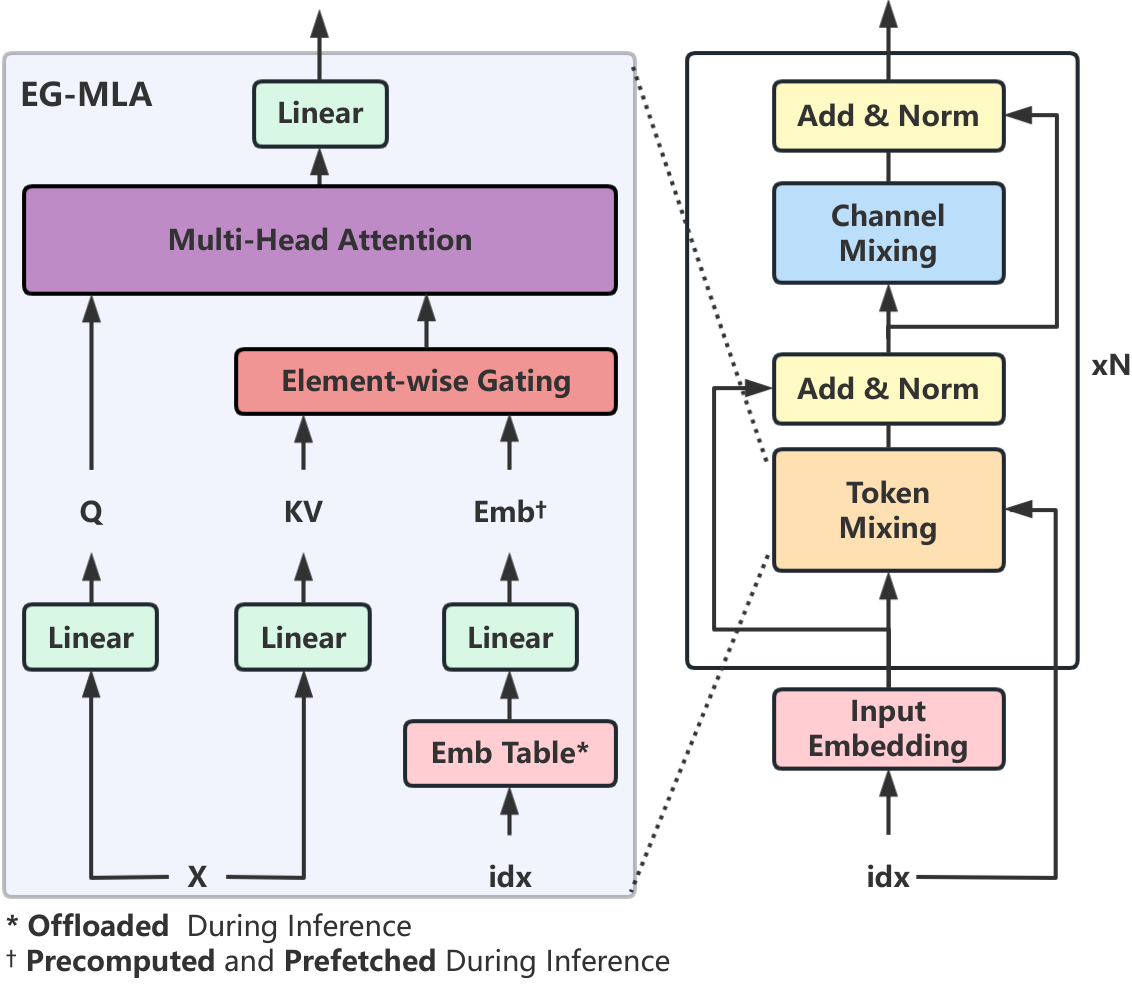
来源:作者图 2,PDF p.3,复用原始图件。先看右侧普通 Transformer 层,再看左侧 EG-MLA 展开:$X$ 提供上下文相关特征,idx 从另一条路径读取嵌入;两条路径在逐元素门控处结合。图中的卸载、预计算与预取属于推理组织方式,不等于免除这些参数的存储。
对每层、每位置 $t$:
- 输入隐状态 $\mathbf{x}_t$ 经降维得到小向量 $\mathbf{c}^{KV}_t$。
- 将小向量上投影,得到所有头的位置无关 K/V 特征。
- 用原始 token ID $i_t$ 查询本层嵌入表,投影成相同维度的门控信号。
- 将两路逐元素相乘并归一化,再分成 K 和 V。
- 查询 Q 和共享位置键走 MLA 风格的解耦 RoPE 路径,执行因果 softmax attention,拼接各头并输出投影。
位置容易看错:尽管摘要说门控发生在潜在空间,正文式 (2)–(5) 和伪代码都表明乘法发生在 KV 上投影之后,不是直接对 $d_c$ 维的小缓存向量做门控。这个区别关系到计算成本和 MLA 的投影吸收是否仍适用。
2. 符号和维度
下表按列向量约定整理;$d_e$、$D_{KV}$ 是本笔记为讲解补充的记号。
| 符号 | 含义与形状 |
|---|---|
| $\mathbf{x}_t\in\mathbb R^{d_{\rm model}}$ | 第 $t$ 个 token 在当前层的隐状态,依赖上下文 |
| $i_t$ | token 的词表索引,不是位置编号 |
| $\mathbf{c}^{KV}_t\in\mathbb R^{d_c}$ | 当前模型实际采用的 KV 潜在维度 |
| $W^{DKV}\in\mathbb R^{d_c\times d_{\rm model}}$ | KV 降维投影 |
| $W^{UKV}\in\mathbb R^{D_{KV}\times d_c}$ | KV 上投影,$D_{KV}=n_h(d_h+d_v)$ |
| $\mathbf e_t\in\mathbb R^{d_e}$ | 本层、该 token 身份对应的可学习嵌入 |
| $W^{UE}\in\mathbb R^{D_{KV}\times d_e}$ | 嵌入到门控空间的投影 |
| $\mathbf g_t\in\mathbb R^{D_{KV}}$ | 未使用 sigmoid 限幅的门控向量 |
| $d_h,d_h^R,d_v$ | 每头位置无关 Q/K、RoPE Q/K、V 的维度 |
表 5 使用 $d_c/r$ 表示 EG-MLA 压缩后的维度,其中 $d_c$ 指 MLA 参照维度;方法公式中的 $d_c$ 则可理解为当前模型的实际潜在维度。不能将这两种口径混用。
3. 五个核心公式
正文式 (1)–(5),p.3:
第一路回答“当前上下文中应表达什么”,第二路回答“这个 token 身份倾向如何调整各通道”。同一层里,相同 token ID 得到相同 $\mathbf e_t$ 和 $\mathbf g_t$;但 $\mathbf c_t^{KV}$ 随上下文变化,所以最终 K/V 仍然依赖上下文。这里的“动态”是随输入 token 身份选择参数,并非门控自身根据完整上下文计算。
教学例子(非论文实验):上投影特征为 $(2,-1,3)$,门控为 $(0.5,2,-1)$,乘积是 $(1,-2,-3)$,之后再统一归一化。门控既可改变相对幅度,也可改变符号;它不是把值限制在 $[0,1]$ 的开关。LayerNorm 使通道相对结构更关键,不能只把门控理解成放大整个向量。
4. 完整注意力与源码细节
附录 C 式 (6)–(14),pp.10–11,先切分 $\widetilde{\mathbf{kv}}_t^C$ 得到 $\mathbf k_t^C,\mathbf v_t^C$;构造内容查询 $\mathbf q_{t,h}^C$,再拼接位置分支:
这里 $h$ 表示注意力头,避免与词表索引 $i_t$ 混淆。仍然是因果、归一化的 softmax 注意力,没有把注意力改成线性递归模型。
附录 E 伪代码还揭示三个正文简式省略的细节:
kv_norm是 RMSNorm,位于 KV 降维之后、上投影之前;门控之后的ln_emb则是 LayerNorm,两者不能混同。q_lora_rank == 0时直接做查询投影;表 7 的列出模型采用该配置,附录 C 的低秩 Q 公式是更一般写法。- RoPE 作用在 Q 和共享的 K 位置分支,V 不做 RoPE。附录 C 开头文字说对 “keys and values” 应用 Partial RoPE,与公式和伪代码不一致,应以后二者解释计算。
5. 二阶交互:有用的直觉,但不是容量无损定理
正文式 (6)–(8),p.4,对单个输出通道:
因此乘法能建立内容特征与 token 嵌入之间的二阶交互,而相加只是合并两路一次项。无需显式形成 $d_1d_2$ 个乘积特征,所以比显式外积特征高效。
本次分析:每个输出通道对应的双线性系数矩阵 $w_1w_2^\mathsf T$ 秩至多为 1,各个交叉项不能独立取任意系数;输出通道数也没有变成 $d_1d_2$。这不是任意二阶映射的表达能力证明,也不能证明压缩没有信息损失。固定 token 身份、忽略 LN 时,该路径对 $\mathbf x_t$ 仍是一个秩受潜在维度约束的线性映射,只是不同 token 选择不同的映射。正文把 $W_1,W_2$ 的维度写成 $d_1\times d,d_2\times d$,与左乘列向量不符;本笔记按 $d\times d_1,d\times d_2$ 解读。
6. 训练、推理和缓存必须分开理解
训练:嵌入表与其投影需要学习,增加权重、梯度与优化器状态。表 10 中 Base-kv64 的总参数为 274M,其中 154M 是嵌入表;论文的 120M“激活参数”采用把该表分开列出的口径,不能当成完整模型参数量。
推理预计算:EG-MLA-A 在加载时预先算出每个 token 的投影嵌入,推理时查表并预取。可将其理解为预计算 $G[i]=W^{UE}\operatorname{Emb}(i)$。它只省去这一路投影,未省去整个注意力计算;预计算表宽为 $D_{KV}$,原始嵌入表宽为 $d_e$,若前者更大,表存储也更大。卸载会把部分需求转移到主机内存与传输带宽。
缓存表示:表 5 假设历史 token 保存压缩潜在向量和 RoPE 键即可。由于门控可由 token ID 再生,门控向量不一定要全部存进随序列增长的缓存,但历史 ID、潜在向量到实际 K/V 的重建及读取路径仍需实现。
关键实现边界(本次分析):普通 MLA 的上投影可利用共享线性矩阵做吸收/重排;这里上投影后出现 token 特定乘法和 LN,不能未经证明照搬原来的固定矩阵吸收。附录 E 只展示完整序列的 scaled_dot_product_attention,没有增量 KV-cache 接口或压缩缓存解码内核。因此论文的缓存账本、时延测量和这个教学伪代码之间仍存在实现细节缺口;不能用该伪代码声称已经复现压缩缓存推理,也不能据此断言压缩存储在原则上不可实现。
三:实验
1. 训练与评测设置
| 项目 | 论文实际报告 |
|---|---|
| 训练数据 | ClimbMix,总池 400B token;主要实验各训练 50B token |
| 训练目标 | decoder-only 模型的下一 token 预测 |
| 消融预算 | 表 3 为 10B token,不能与 50B 结果混比 |
| 混合数据调优 | 使用 PIQA、ARC-E、HellaSwag 验证集调数据混合,再在对应测试集评估 |
| 评测工具 | LM-Evaluation Harness;MMLU 5-shot,其余任务 0-shot |
| Base | 12 层,隐藏维度 768;非位置 Q/K 64,RoPE 64,V 64;KV 潜在维度扫描 256/128/64/16 |
| Large / XLarge | MLA 为 12/24 层、隐藏维度 2048;非位置 Q/K 128,RoPE 64,V 128;附录 G 标注上下文 2048/4096 |
| 批量 / 学习率 | 批量 0.39M token;Base $6.0\times10^{-4}$,Large $2.5\times10^{-4}$,XLarge $2.0\times10^{-4}$ |
| 推理硬件 | 单张 NVIDIA A800 80GB;对比 120M MLA 与 274M EG-MLA |
来源:Experimental Settings,p.4;表 7,p.10;附录 G,pp.13–14;Efficiency Evaluation,pp.5–6。表 7 最后两行 Large 的参数量/维度与表 11–12 不一致,不能据此给出唯一确定的复现配置。
论文没有完整报告优化器、学习率调度、warmup、权重衰减、随机种子数量、误差条、tokenizer 配置、评测 harness 版本/任务配置、每个任务采用 acc 还是 acc_norm,以及时延实验的精度、生成长度与计时细节。未以领域惯例补全这些信息。数据混合使用过部分基准验证集,这些任务上的最终表现应放在该调优流程下理解;不能据此直接指控测试集泄漏。
2. 指标如何读
- Accuracy,越高越好:表 1、2、4、11、13 的百分数。任务包括 PIQA、ARC-C/E、HellaSwag、WinoGrande、SIQA、MMLU、OpenBookQA、BoolQ、RACE、TruthfulQA、LAMBADA。它们横跨常识选择、知识问答、阅读理解和续词,不能把所有提升都归结为同一种“推理能力”。表中 Avg 是对 12 列任务分数的等权平均,非按测试样本数合并准确率;具体任务 scorer 未充分说明。
- Validation loss,越低越好:表 3 的训练目标验证损失。可比较同一实验中的变化;论文没有详细声明单位和归一化口径,不能自行补成某个确定单位。
- PPL,越低越好:表 8、9、12、14 的困惑度。通常用于衡量语言模型对真实 token 的预测不确定性;表中 Avg 是三个数据集 PPL 的算术平均,不能当成拼接语料的总体困惑度。
- KV elements/token,越低越好:表 5、10 包含所有层,不含 $B,T$;K 为十进制约千元素,尚未换算字节。
- Latency / throughput:prefill、decode 时延越低越好,tokens/s 越高越好;表 6 的训练步时延不能与图 4 的推理时延直接比较。
四:结果
1. Towards Compact KV Cache:Base 的平均质量可以保持
同为 50B 训练 token,EG 模型固定 $d_e=256$。下表把表 1(p.5)与表 10(p.13)合并;缓存采用维度精确重算值。
| 模型 | 激活/总参数 | KV 元素/token | 12 任务 Avg ↑ | 相对 MLA 的差值 |
|---|---|---|---|---|
| MLA-kv256 | 120M / 120M | 3,840 | 43.84% | — |
| EG-MLA-kv256 | 125M / 279M | 3,840 | 44.46% | +0.62 个百分点 |
| EG-MLA-kv128 | 122M / 276M | 2,304 | 44.14% | +0.30 个百分点 |
| EG-MLA-kv64 | 120M / 274M | 1,536 | 44.33% | +0.49 个百分点 |
| EG-MLA-kv16 | 119M / 273M | 960 | 44.10% | +0.26 个百分点 |
发现:kv256→kv64 把 EG 的潜在维度缩到四分之一,但总缓存还含固定 64 维位置键,所以缓存并非缩到四分之一。kv16 的平均准确率仍略高于 MLA-kv256,支持 Base 设置下可以大幅压缩。
边界:kv64 相对 MLA 的 PIQA 为 71.60 vs 69.48、ARC-C 为 29.61 vs 26.45;但 WinoGrande 为 51.14 vs 52.33、BoolQ 为 55.05 vs 58.10。平均提升掩盖了部分任务下降。表 1 的同缓存比较 EG-kv256 vs MLA-kv256 是 8 项提高、4 项降低;也不应写“全部任务提高”。未报告多种子波动,+0.49 个百分点不是统计显著性结论。
语言建模交叉检查:附录 D 表 9,p.11:
| 模型 | ClimbMix-val PPL ↓ | Wiki PPL ↓ | LAMBADA PPL ↓ | 原报平均 PPL ↓ |
|---|---|---|---|---|
| MLA-kv256 | 15.45 | 15.63 | 49.88 | 26.99 |
| EG-kv256 | 14.32 | 14.26 | 37.12 | 21.90 |
| EG-kv128 | 14.49 | 14.34 | 35.73 | 21.52 |
| EG-kv64 | 15.32 | 14.58 | 38.94 | 22.95 |
| EG-kv16 | 15.13 | 15.08 | 43.76 | 24.66 |
各 EG 配置在这三列中都优于唯一列出的 MLA-kv256,说明收益不限于任务准确率。但 EG 自身过度压缩后 PPL 会变差,且没有展示相同小潜在维度 MLA 的完整对照,不能确定收益中多少来自额外参数容量。
2. Scaling Law for Embedding Size:收益递减,参数并不便宜
固定 KV 潜在维度 64,50B token。表 2,p.6;表 7,p.10;表 8,p.11:
| $d_e$ | 嵌入参数 | 总参数 | Avg accuracy ↑ | 原报 Avg PPL ↓ |
|---|---|---|---|---|
| 64 | 38M | 155M | 43.36% | 27.78* |
| 128 | 77M | 195M | 44.33% | 25.06 |
| 256 | 154M | 274M | 44.33% | 22.95 |
| 512 | 309M | 433M | 44.91% | 20.51 |
| 1024 | 618M | 752M | 45.06% | 21.01 |
| 2048 | 1236M | 1389M | 45.17% | 20.56 |
从 512 到 2048,嵌入参数增加 927M,准确率仅增 0.26 个百分点,PPL 也没有超过 512 的最佳值。128–256 维已有较好收益,但 64 维的平均准确率低于 MLA 的 43.84%,不能说任意嵌入预算都有效。这组扫描是经验容量曲线,没有给出拟合的 scaling-law 指数或严格缩放定律。
*原文表 8 的 emb64 三项 PPL 为 15.47、15.49、50.38,算术平均应为 27.11,而 Avg 列写 27.78。上表保留原报值并标注,不静默纠正。图 5(a) 也沿用原报趋势。因此讲解精确平均值时以明示的重算为准。
3. Ablation on Embedding Gating:LayerNorm 是决定性组件
表 3,p.6;固定 kv256,10B token:
| 配置 | 验证损失 ↓ | 相对完整 EG 的变化 |
|---|---|---|
| MLA | 3.2156 | +0.0547 |
| EG:乘法 + LayerNorm | 3.1609 | — |
| EG:去掉 LayerNorm | 3.2573 | +0.0964 |
| EG:乘法改相加 | 3.1901 | +0.0292 |
去掉门控后的 LayerNorm,结果不只差于完整 EG,还差于 MLA。乘法比相加更好,但相加仍比 MLA 好 0.0255。由此可以说乘法交互与归一化共同有效;不能把全部收益单独归因于二阶项。该消融没有分别隔离额外嵌入参数量、LN 本身和 token 身份信号,也未给出重复实验误差。
4. Scaling to 1B:平均小幅增加,但缓存比例有原文矛盾
表 4,p.7;两者均训练 50B token:
| 模型 | 激活参数 | 嵌入参数 | 总参数 | Avg accuracy ↑ |
|---|---|---|---|---|
| MLA-1.2B | 1188M | 0 | 1188M | 49.61% |
| EG-MLA-1.2B | 1182M | 618M | 1800M | 49.95% |
平均提高 0.34 个百分点。BoolQ 增加 6.30 个百分点,LAMBADA 增加 2.23;MMLU 下降 1.50,TruthfulQA 下降 2.49,SIQA 下降 1.20。12 个任务为 4 胜、7 负、1 平,所以应概括为平均质量接近、任务间有取舍,而非普遍提升。
正文 p.5 声称缓存只用 MLA 的 40.1%;但表 7 与表 11 给出的 XLarge 配置为 MLA-kv512 与 EG-kv128,RoPE 维度均为 64,同为 24 层。按表 5 公式:
因此“40.1%”不能由这组配置直接复算,可能涉及作者未说明的实现口径或文字误写;本次不能替作者选择原因。对 Base 的 59.9%/60.0% 缓存节省有清晰账本,不能把它直接移到 1.2B 的配置上。
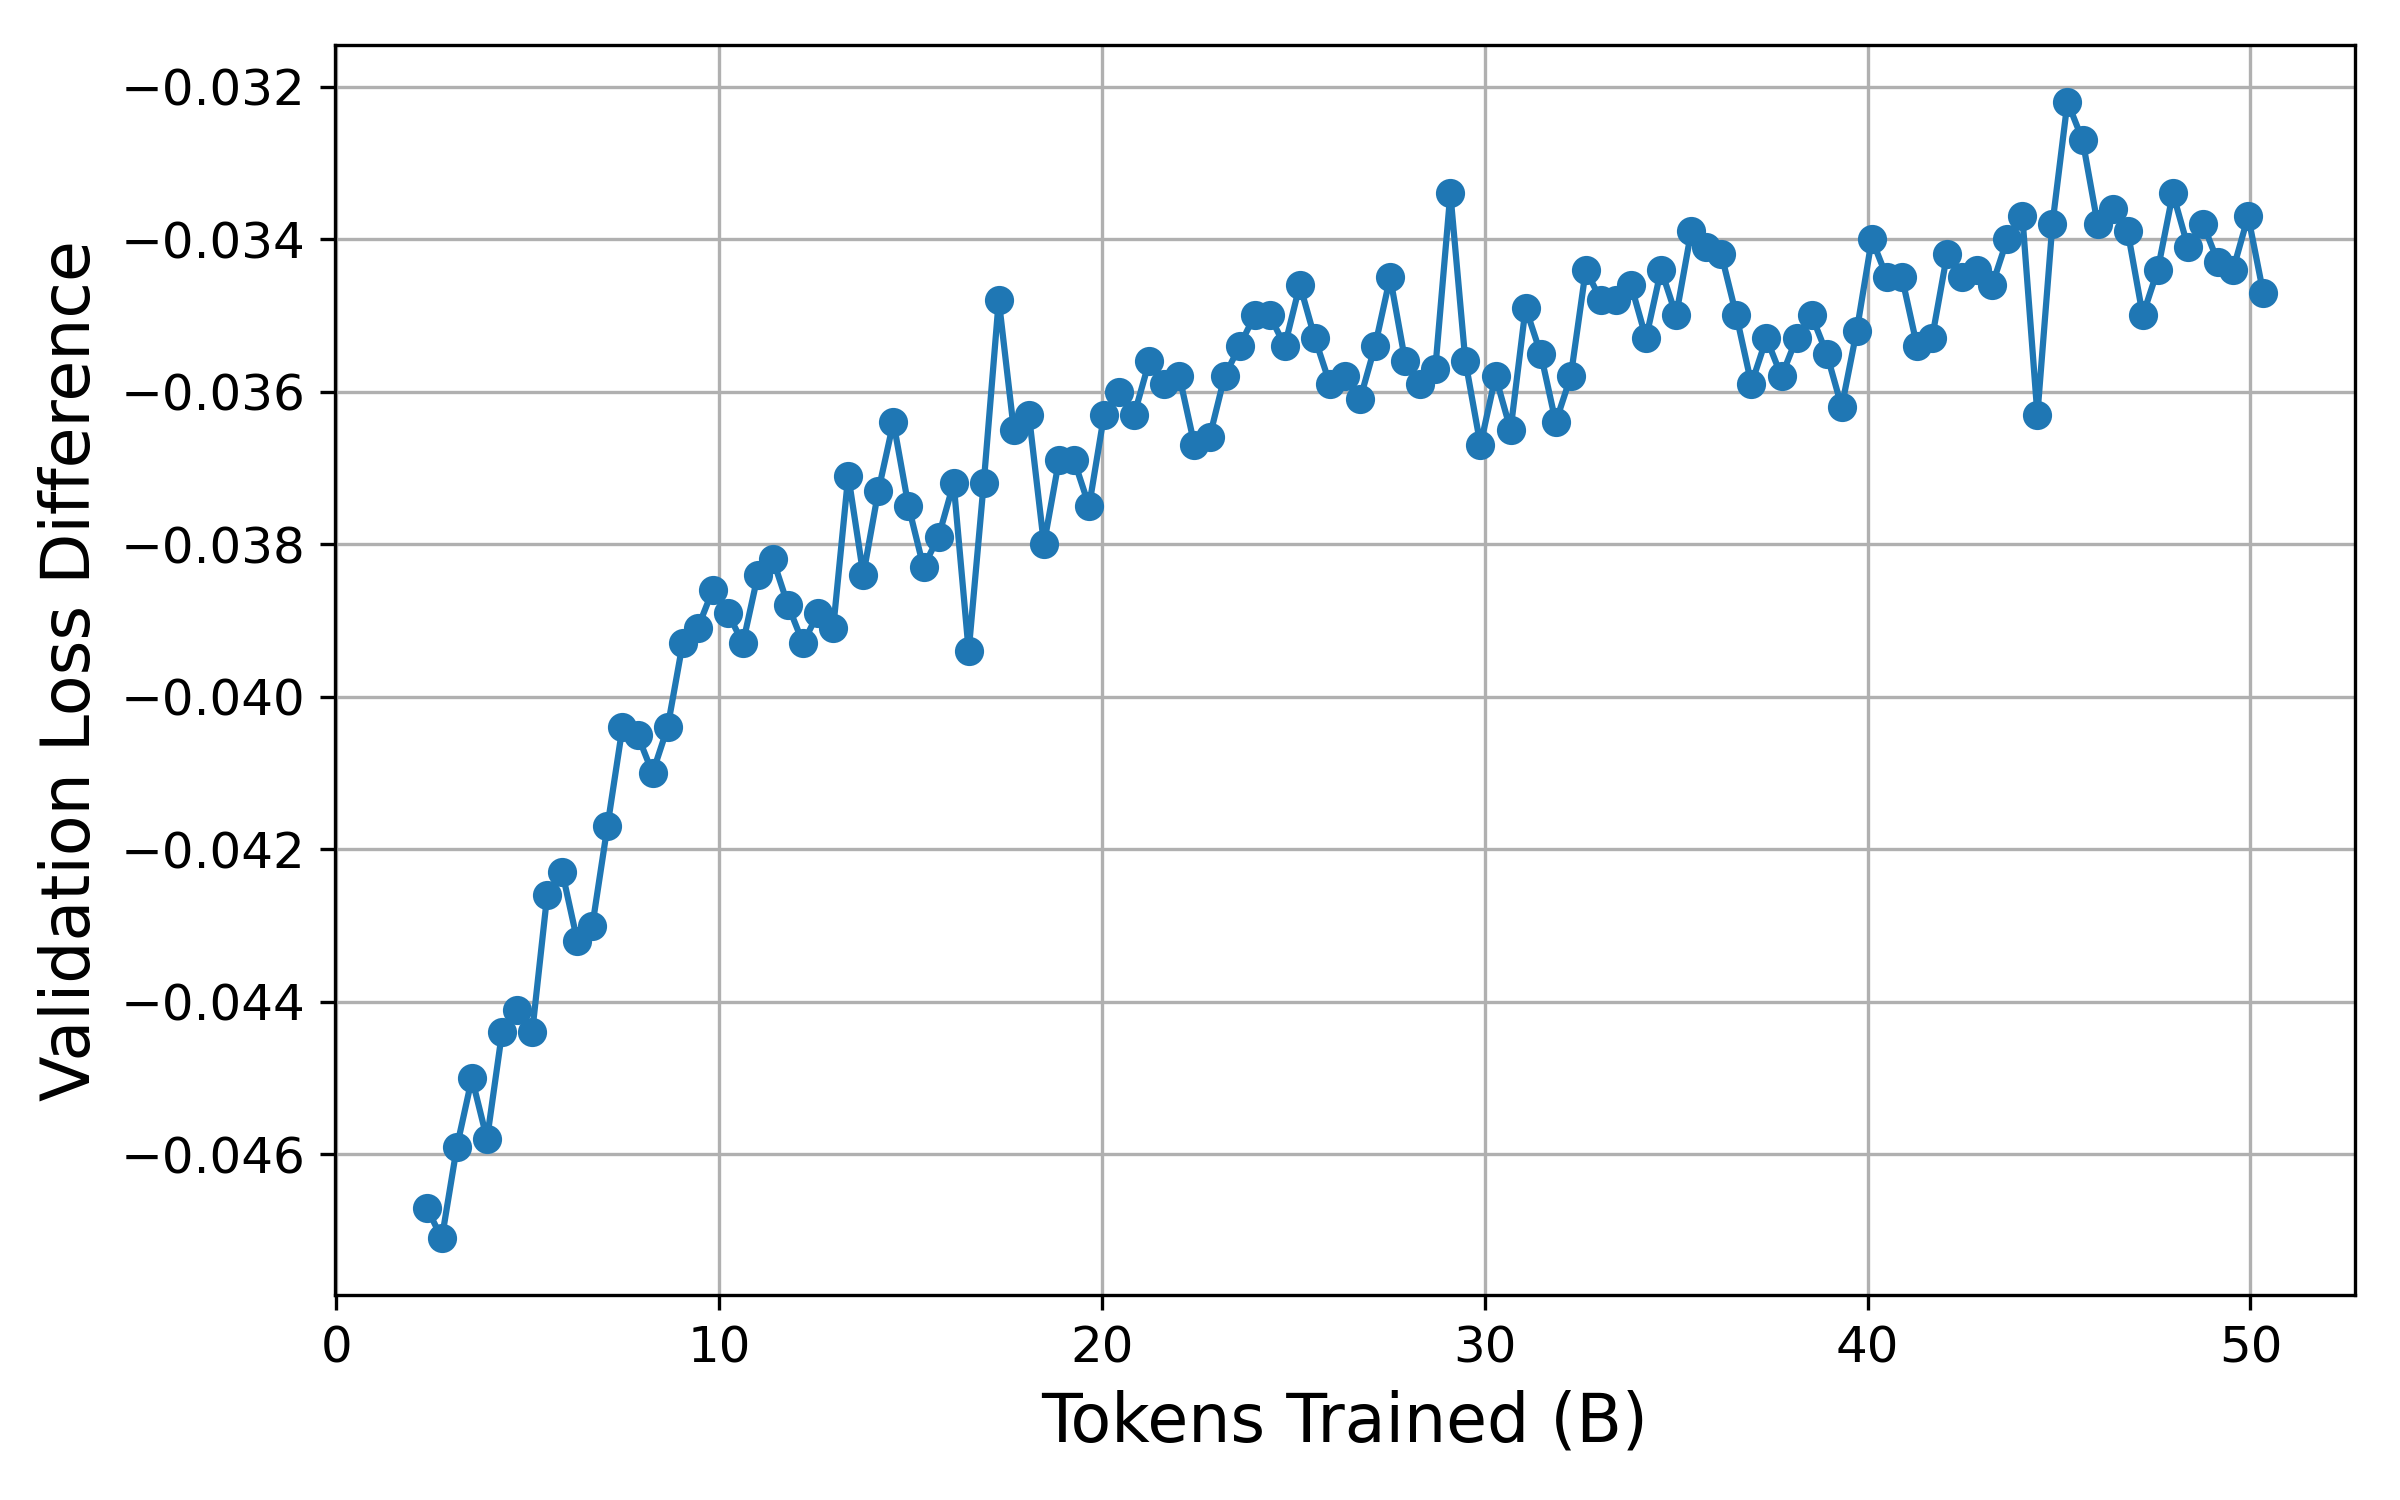
来源:作者图 7,PDF p.14。横轴为训练 token 数(十亿),纵轴为 EG-MLA 减 MLA 的验证损失差,负值意味着 EG 的损失更低。该图展示训练过程中验证损失的比较,不是下游准确率差,也不能证明所有任务泛化更好。
5. More Scaling Experiment:中等规模反例必须保留
附录 G,表 11–12,p.14;均 50B token。Large 上下文 2048,XLarge 上下文 4096,不能跨组归因于某一个因素。
| 模型配置 | 总参数(嵌入参数) | Avg accuracy ↑ | Avg PPL ↓ |
|---|---|---|---|
| Large MLA-kv512 | 645M(0) | 49.53% | 12.09 |
| Large EG-kv128-emb512 | 951M(309M) | 48.66% | 12.18 |
| Large EG-kv256-emb512 | 961M(309M) | 48.71% | 11.56 |
| XLarge MLA-kv512 | 1188M(0) | 49.61% | 12.23 |
| XLarge EG-kv128-emb512 | 1800M(618M) | 49.95% | 10.77 |
Large 的 kv128 平均准确率下降 0.87 个百分点,平均 PPL 也略差;kv256 的 PPL 改善但平均准确率仍下降 0.82 个百分点。论文标题中的“可扩展”得到 1B 级训练可行性的支持,尚不支持质量随规模始终改善。
6. Analytical Comparison:把 91.6% 和 59.9% 算清楚
表 5(p.7)给出全模型每 token 元素数:
Base 表 10,p.13,对应 MHA $2\times12\times64\times12=18,432$,MLA $(256+64)\times12=3,840$,EG-kv64 $(64+64)\times12=1,536$。
- 相对 MHA:$1-1536/18432=91.6667\%$。
- 相对 MLA:$1-1536/3840=60.0\%$。
- 论文使用 18.43K、3.84K、1.54K 等舍入数,写成 91.6% 与 59.9%;这一处属于舍入口径,可解释。
- kv16 为 960 元素,相对 MHA 精确减少约 94.79%;相对 MLA 为 75%。因此摘要的“up to 59.9%”其实对应选定 kv64 折中点,不是所有表列配置的最大缓存节省。
固定 RoPE 分支构成压缩下限:即使内容潜在维度趋近 0,Base 仍有 $64\times12=768$ 个元素/token。把 $d_c$ 缩小 16 倍,不等于把整个缓存缩小 16 倍。
教学内存例子(非原文测量):假设权重与缓存都是 2 字节,所有额外嵌入都驻留 GPU,忽略激活、工作区、优化器、预计算表膨胀和微小参数差异。EG-kv64 相对 MLA 每个历史 token 省 $2304\times2=4608$ 字节,但多 154M 嵌入参数约 308MB。需约 $154\times10^6/2304\approx66,840$ 个合计缓存 token 才抵消这部分静态权重;这里合计 token 约为 $BT$,并非必须单序列达到该长度。卸载会改变 GPU 收支,也引入主机存储与带宽成本。这说明为何不能直接把 KV 比例当成端到端显存比例。
7. Empirical Comparison of Efficiency:prefill 可获益,decode 并非统一加速
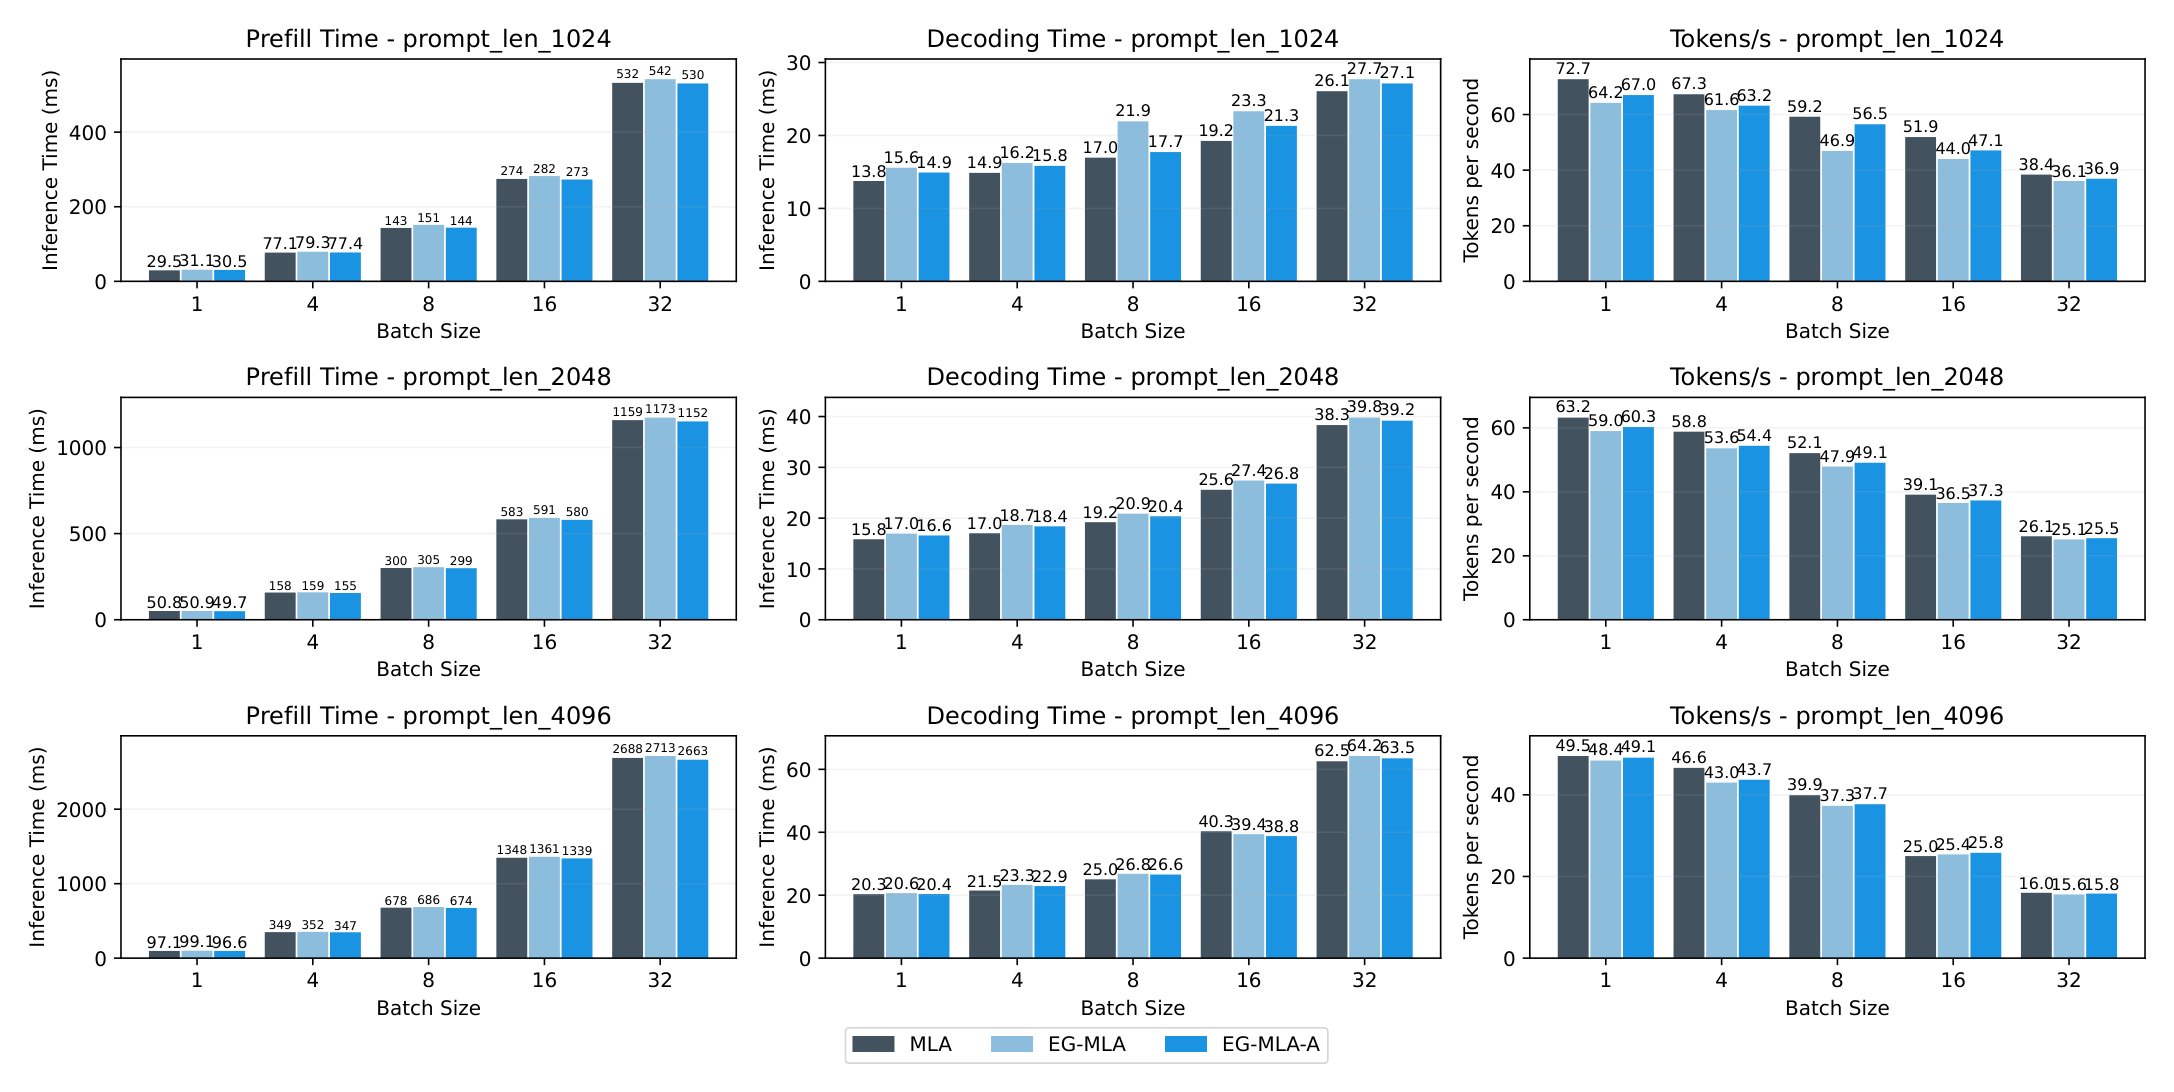
来源:作者图 4,PDF p.7。各行对应输入长度 1024、2048、4096;各列依次为 prefill 时延、decode 时延、tokens/s。横轴为 batch size(1、4、8、16、32),颜色区分 MLA、EG-MLA、EG-MLA-A。时延面板越低越好,吞吐面板越高越好。对同一行、同一 batch size 比较,避免把不同负载下的条形混为同一个实验。
正文报告,在 batch size > 8 的配置中,EG-MLA 平均 prefill 比 MLA 少 5.6 ms,decode 多 0.91 ms;batch size=32 时,EG-MLA-A 与 MLA 的平均 decode 差约 1 ms。这些是作者文字汇总,部分与图中数据不符,不能作为已复算结论。图 4 的 15 个配置中,普通 EG 的 prefill 均慢于 MLA。例如 prompt=1024、batch=32 时,MLA/EG/EG-A 的 prefill 为 532/542/530 ms,decode 为 26.1/27.7/27.1 ms。可见此处是 EG-A 有小幅 prefill 改善,普通 EG 没有。decode 在 prompt=4096、batch=16 时 EG/EG-A 有优势,但其他大多数配置更慢。EG-A 在 batch=32、三个 prompt 长度的 decode 差为 1.0、0.9、1.0 ms,支持文字中的“约 1 ms”。
图中 tokens/s 数值近似 $1000/\text{decode(ms)}$,如 38.4 对应 26.1 ms,即没有显式乘 batch size;这是根据图数值的推断。论文未说明它是否按单序列归一,不能直接当作全 batch 的总吞吐。结论应是预计算能缓解部分开销,具体收益依赖负载。
EG-MLA-A 的预计算和预取很关键,意味着系统实现是结果的一部分。本文未给出 1.2B 同等详细的时延扫描,也未报告足以还原全部测量条件的内核、生成长度、精度、卸载带宽和端到端峰值显存。
8. Embedding Parallelism:训练时缓解嵌入表成本
表 6,p.7:
| 方法 | 节点数 | 峰值内存 MB ↓ | 吞吐 tokens/s ↑ | 平均步时 ms ↓ | 通信 ms |
|---|---|---|---|---|---|
| vanilla | 2 | 13,950 | 42,528 | 385.25 | 未列 |
| dimension-wise | 2 | 12,233 | 86,743 | 188.88 | 16.25 |
| vanilla | 4 | 13,950 | 80,114 | 409.02 | 未列 |
| dimension-wise | 4 | 11,759 | 175,031 | 187.21 | 24.38 |
作者将嵌入维度在 $W$ 个 worker 之间切分,局部维度 $d_{kv}/W$,最后聚合门控向量;图 3(p.6)说明该流水线。2 节点下峰值内存减少约 12.3%,吞吐提高约 104.0%,步时缩短约 51.0%。这些是同节点数下的表内比较,不能声称所有训练总内存都按节点数线性缩小。
实现解释的边界:正文说局部嵌入先投影,再通过拼接/all-gather 得到最终门控。若仅切分输入嵌入维度、每个局部投影都产出完整输出维度,数学上应求和而不是拼接;拼接需要输出分片等额外布局。论文未给出完整并行代码,因此其分片定义与聚合方式仍需实现层面澄清。
9. Toward Greater Efficiency / Layer Grouping:省算力会损伤质量
作者进一步共享相邻层的部分 KV 投影及中间结果,以 lgz 控制组大小。参数共享意味着约束不同层使用同一变换;复用中间激活还意味着不再针对每层不同隐状态重新计算,因此对质量的影响需要独立测量。
附录 H 表 13(p.15)、表 14(p.15),Large-ctx2048-kv256-emb512:
| 层组大小 | Avg accuracy ↑ | 相对无共享差值 | Avg PPL ↓ |
|---|---|---|---|
| 无共享 | 48.71% | — | 11.56 |
| 2 | 48.53% | −0.18 个百分点 | 11.90 |
| 4 | 48.15% | −0.56 个百分点 | 12.54 |
| 6 | 47.80% | −0.91 个百分点 | 13.52 |
轻度共享的准确率代价较小,但 PPL 已变差;更大组有持续损失。原表 13 的 −0.37%、−1.15%、−1.87% 是相对百分比,不是百分点。表 14 将 PPL 恶化标为负的 Diff;若按 PPL 数值变化计算,则是 +2.94%、+8.48%、+16.96%(由已舍入均值重算),不要误解为 PPL 降低。
正文 p.7 推荐 emb=512, lgz=2,附录 H 推荐 lgz=3;表里只有 2、4、6,没有 3 的测量行。因而可以说作者认为小组共享可能是折中,不能说实验证明 3 最优;当前表也没给出各 lgz 对应的实测时延和完整内存账本。
五:结论、局限与讨论
1. 这篇论文真正带来的认识
EG-MLA 给 MLA 增加了一个独立的容量来源:每层按 token ID 读取的静态嵌入,经过乘法作用于上下文相关的 K/V 特征。它展示了 动态缓存变小、静态参数变大 的可行方向。Base 的压缩扫描和 10B 消融支持门控与 LayerNorm 的实用价值,1.2B 实验支持该架构能训练到十亿激活参数级。
更稳妥的适用判断是:当部署受 KV 状态内存限制、可以容纳或卸载额外嵌入参数,并能处理门控重建与预取时,该设计可能改善质量与缓存之间的取舍。对于短上下文、小批量、总内存很小或卸载带宽受限的设置,现有论文不能保证净收益。
2. 需要保留的证据限制
| 问题 | 影响与来源 |
|---|---|
| 比较多为近似等激活参数,非等总参数 | Base 120M vs 274M,XLarge 1188M vs 1800M;表 4、10 |
| 缺少小维度 MLA 完整对照 | 无法严格分离门控优势与额外容量;表 1、9 |
| 缺少多种子/误差条 | 小幅平均增益不能称统计显著;表 1、4 |
| 中等规模模型准确率下降 | “始终优于 MLA”与表 11 不符 |
| 缓存理论和解码实现未完整衔接 | 附录 E 无增量缓存接口;门控和 LN 影响线性吸收 |
| 1.2B 缓存比例自相矛盾 | p.5 的 40.1% 与表 5、7、11 可推算的 33.3% 不同 |
| 数据/超参数信息不完整 | 表 7 的 Large 行不一致,部分评测口径缺失 |
| 推理文字与图表不一致 | pp.5–6 声称普通 EG prefill 加速,图 4 各配置不支持;预计算版须单独比较 |
| 层共享建议不同 | 正文选 2、附录选 3,未列 3 的数据 |
| 细节表述和排版错误 | p.1 的二次 KV 增长、附录 C 的 V-RoPE 文字、表 8 平均数等 |
正文 p.5 还声称在 base 与 fine-tuned 场景都匹配 MLA,但文中未给出独立微调流程和对应结果表;不能将此当成已充分验证的指令微调结论。作者展望的稀疏注意力、多模态、指令模型与自适应门控均属于未来工作。
3. 组会中值得追问的三个问题
- 门控真的补偿了多少压缩损失? 补齐 MLA 在相同 kv64/128 的结果,并增加等总参数或等训练 FLOPs 对照,才能区分 token 条件化和单纯加容量。
- 小缓存怎样以可接受的算力解码? 需要展示历史潜在向量如何重建 gated K/V、LN 如何处理、预计算表大小、GPU/CPU 放置和内核带宽,并同时测总显存与长上下文时延。
- token 身份先验是否能迁移? 当前门控与词表绑定;不同语言、tokenizer、领域与指令数据下的行为仍需实测。不能从词表查表机制直接推出强泛化或弱泛化。
4. 阅读与复现入口
- 先看原文 图 2 + 式 (1)–(5),理解门控确切位置;再对照附录 E 的两个归一化步骤。
- 以 表 1 + 表 10 同时读准确率、总参数和 KV 状态,避免只记住摘要百分比。
- 用 表 3 判断设计组件,再用 表 11–14 检查缩放与共享的边界。
- 用 图 4 评估时延是否适合目标负载;不要把吞吐或缓存的单项改善当成全面系统收益。
引用信息:Cai, Zhengge, and Haowen Hou. 2025. EG-MLA: Embedding-Gated Multi-head Latent Attention for Scalable and Efficient LLMs. arXiv:2509.16686v1。本文观点解释均来自该版本,明确标注的重算、教学例子与实现分析属于本次研读。