Decoupling the “What” and “Where” With Polar Coordinate Positional Embeddings:中文研读笔记
作者:Anand Gopalakrishnan、Róbert Csordás、Jürgen Schmidhuber、Michael C. Mozer
论文:arXiv:2509.10534v3,2026-06-08 修订;本次获取与研读:2026-10-28;本地原文 PDF
发表:已发表于 ICML 2026,PMLR 306:36197–36214。会议出版题名使用单数 Embedding,所读 arXiv v3 摘要页题名使用复数 Embeddings。
代码:作者官方公开实现 PoPE。
论文总览
Transformer 的注意力分数同时决定“匹配什么内容”和“匹配哪个相对位置”。论文指出,旋转位置编码(RoPE)把内容相关的二维向量相位与位置旋转相加,使内容能改变每个频率通道偏好的相对距离。作者提出极坐标位置编码(Polar Coordinate Positional Embedding, PoPE):每个原始实数特征经 softplus 变为非负幅值,复数相位只由位置决定;可学习的相位偏置则在训练后为每个注意力头、频率通道提供固定的相对位置偏好。这样,一个通道的贡献可写成“内容幅值乘积 × 相对位移的余弦响应”。
最能说明设计意图的证据是间接索引:给定一个字符和相对位移,预测目标字符。PoPE 在三次随机种子的测试准确率为 94.82% ± 2.91%,RoPE 为 11.16% ± 2.45%。在音乐、基因组和 OpenWebText 自回归建模上,PoPE 的报告损失或困惑度也较低;在 OpenWebText 预训练 1,024 token 后,PG-19 上的长度外推曲线显示 PoPE 在最长 10,240 token 时仍相对稳定。文中各项收益应连同具体任务、模型规模和额外注意力计算一起理解。(Sec. 4,PDF pp. 4–8;App. A.2,pp. 12–13)
结构地图
| 原文章节 | 论证作用 | PDF 页码与证据 |
|---|---|---|
| 1. Introduction | 提出“内容—位置”耦合问题 | pp. 1–2;Fig. 1 跨 p. 3 |
| 2. Background | 将 RoPE 分数写成极坐标形式 | p. 2,Eqs. (1)–(2) |
| 3. Method | 定义 PoPE、相位偏置及实现 | pp. 2–4,Eqs. (3)–(10),Fig. 1 |
| 4. Results | 间接索引、三个建模领域、消融、下游任务、长度外推与频率分析 | pp. 4–8,Tables 1–6,Figs. 2–3 |
| 5. Related Work;6. Conclusion | 与 RoPE 扩展和其他位置编码比较,归纳结论 | pp. 6–8 |
| Appendix A–D | 推导、开销、数据与训练配置、补充对照和可视化 | pp. 12–18,Tables 7–9,Figs. 4–7 |
一:动机——RoPE 的内容为什么会移动位置峰值
令查询位置为 $t$、键位置为 $s$,每个注意力头的实向量维度为 $d$。RoPE 把相邻两维组成一个二维分量 $c$,分别旋转 $t\theta_c$ 和 $s\theta_c$。旋转矩阵满足 $R(t\theta_c)^\top R(s\theta_c)=R((s-t)\theta_c)$,因此注意力分数只显式依赖相对位移 $s-t$,具有平移等变的结构。(Sec. 2,PDF p. 2,Eq. (1))
关键是每个二维内容分量本身也有极角。写 $q_{tc}=\mu_{q,tc}(\cos\phi_{q,tc},\sin\phi_{q,tc})$、$k_{sc}=\mu_{k,sc}(\cos\phi_{k,sc},\sin\phi_{k,sc})$,则原文 Eq. (2) 等价于
幅值 $\mu$ 表示相应特征的强度;相位差 $\phi_{k,sc}-\phi_{q,tc}$ 却随当前内容变化。于是同一频率通道在不同内容对上达到最大响应的相对距离也会移动。需要先按内容定位锚点、再按位移读取另一位置时,这种耦合可能妨碍形成稳定的“定位再读取”规则。这是作者的机制假说,间接索引实验直接检验了它的实际后果。(Sec. 2,PDF p. 2;App. A.1,p. 12)
二:方法——幅值承载内容,相位承载位置
从实数查询和键构造复数特征
PoPE 对每个原始实数通道 $c=1,\ldots,d$ 单独处理,而 RoPE 对 $d/2$ 个二维通道处理。设 $\sigma(x)=\ln(1+e^x)$ 为 softplus,查询和键的非负幅值分别为 $\tilde\mu_{q,tc}=\sigma(q_{tc})$、$\tilde\mu_{k,sc}=\sigma(k_{sc})$;复数特征写成
其中 $\omega_c$ 是固定的频率,$\delta_c$ 是学习到的、对该注意力头和通道固定的偏置,不随这次查询或键的内容变化。取复数内积的实部,得到
这同时说明两点:每个通道的内容强度通过幅值乘积影响得分;位置调谐曲线的峰值由相对位移、固定频率和训练后的固定偏置决定。一个实数通道扩展为复数的实部与虚部,所以频率数从 $d/2$ 增至 $d$,注意力乘法也相应增加。(Sec. 3,PDF pp. 2–3,Eqs. (3)–(6))
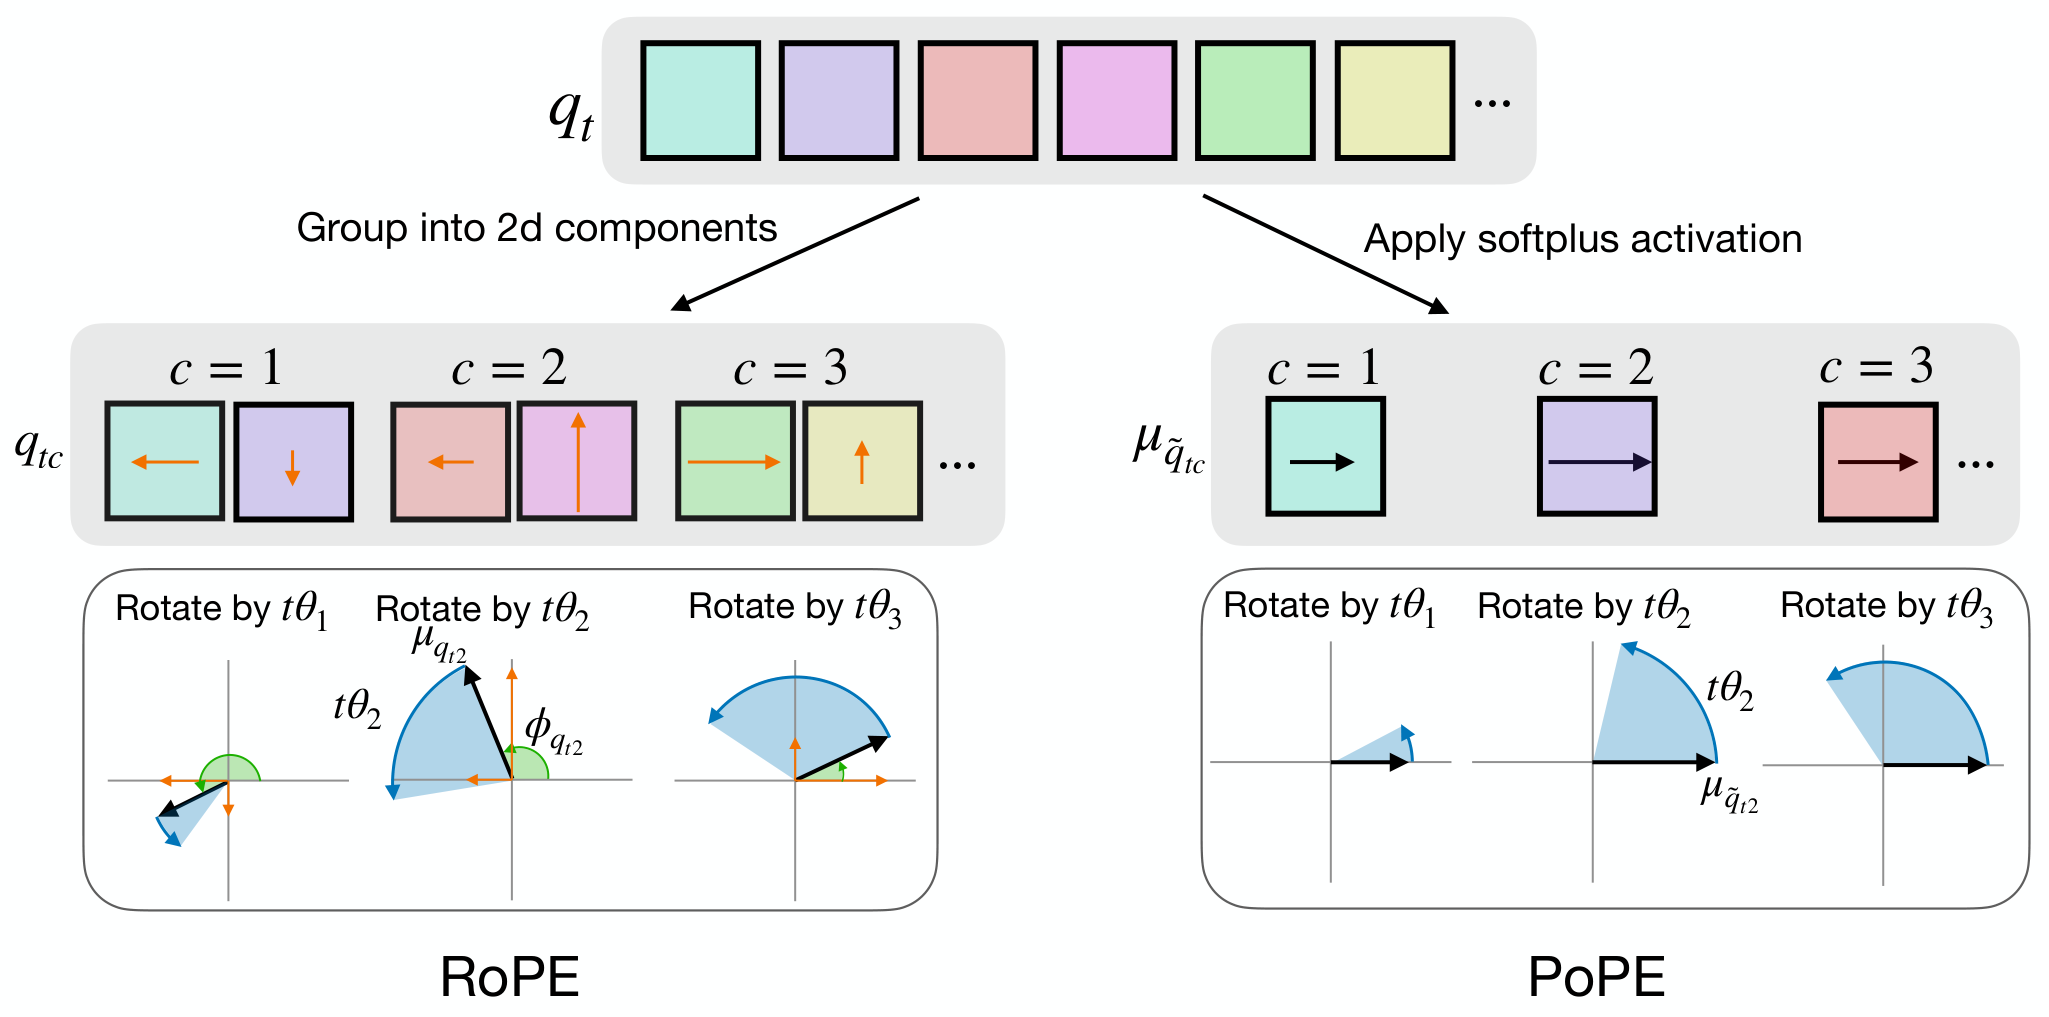
原文 Fig. 1,PDF p. 3。左图中二维内容向量已有绿色标出的初始相位;右图中的单通道幅值先沿实轴放置,随后只按位置旋转。原图顶部“2d components”应按图意理解为二维分组。
相位偏置与方向性
作者比较了 $\delta_c=0$ 与从 $[-2\pi,0]$ 随机初始化,并将训练中的偏置限制在该区间;零初始化对长度泛化尤其重要,随机初始化的分布内结果略好。由上式还可直接推得:若 $\delta_c=0$,单通道的 $\cos((s-t)\omega_c)$ 对正负位移对称;非零 $\delta_c$ 能让左右两个相同距离的位移获得不同响应,同时保持这种偏好对内容稳定。这是公式的教学性推论,论文没有单独给出“左右对称性”实验。(Sec. 3,PDF p. 3,Eq. (6))
原文记号需留意。 v3 的 PDF p. 2 在 Eq. (4) 后把 PoPE 频率印为 $\theta^{(c-1)/d}$,而作者实现的频率计算为 $\theta^{-(c-1)/d}$(基数 10,000);这里用 $\omega_c$ 表示固定频率,讨论频率排列时按实现理解。PDF p. 3 描述限制相位偏置时又误写了对 $\theta_c$ 的裁剪;实现实际裁剪的是 $\delta_c$。这两处不改变上面的内容—位置分离机制,但直接照印刷公式实现会不同。
计算与代价
PoPE 可将复数查询和键转成实部、虚部,在注意力核中计算 $\sum_c(x_{q,c}x_{k,c}+y_{q,c}y_{k,c})$,无需生成完整复数注意力矩阵。作者基于 Triton/FlashAttention 2 写了核。附录按模型宽度 $D$、序列长度 $L$、MLP 扩张倍数 4 估算额外前向 FLOPs 比例为 $L/(12D+2L)$;在 $D=1280$ 时,$L=1024$ 约 5.88%,$L=4096$ 约 17.39%。该式是主导项计算量估算,正文还指出当前通用实现为复数查询/键付出额外内存带宽,尚未采用在核内旋转以减少读写的优化。(Sec. 3,PDF pp. 3–4,Eq. (10);App. A.2,pp. 12–13)
三:实验——每组比较在检验什么
所有主实验使用因果掩码的仅解码器 Transformer,并在对应任务中让 RoPE/PoPE 模型共享架构和训练超参数;位置编码是主要改动。模型用 RMSNorm。表中“相同架构”不表示计算成本相同,PoPE 的复数注意力有上述开销。(Sec. 4,PDF p. 4;App. B.2–B.3,pp. 14–15)
| 检验问题 | 数据与协议 | 对照与指标 |
|---|---|---|
| 能否先找锚点再按位移取字符? | 20–40 个不重复大小写字母;位移在 $[-15,15]$;训练/验证/测试 100万/1万/1万;目标字符位置施加交叉熵 | RoPE 主对照;测试目标字符准确率,越高越好,3 个种子;附录另有半通道 RoPE、半头 ALiBi、可学习与正弦绝对编码 |
| 能否改善精确序列建模? | JSB、MAESTRO 符号音乐,最长 2,048;Human Reference Genome,最长 1,000 token | 同规模 RoPE;测试集最佳 NLL,越低越好 |
| 自然语言规模扩大时是否仍有效? | OpenWebText,1,024 token 预训练;124M/253M/774M 参数 | 同规模 RoPE;验证困惑度,越低越好;六项零样本任务准确率,越高越好 |
| 能否外推到训练长度以外? | 上述预训练模型在 PG-19 测试集上评估 1,024–10,240 token | RoPE、无需微调的 PoPE、YaRN 与 PoPE+ft;测试困惑度,越低越好。YaRN 和 PoPE+ft 在 OpenWebText 的 4,096 长度上各微调 500 步 |
数据来源:Sec. 4,PDF pp. 4–7;App. B.1–B.3,pp. 13–15。六项零样本任务为 LAMBADA、BLiMP、CBT、HellaSwag、PIQA、ARC-E,表 6 的 Avg. 是六项准确率均值。
四:结果——从诊断任务到长度外推
4.1 间接索引确实放大了两种编码的差异
任务输入形如“源字符串,源字符,相对偏移”,模型预测目标字符;例如教学例子 ABCDE, D, -2 → B 表示先定位 D,再左移两格读取 B。原文表 1 给出 PoPE 94.82% ± 2.91%,RoPE 11.16% ± 2.45%,相差 83.66 个百分点(3 个种子的测试准确率均值与标准差)。附录表 9 的半通道 RoPE 为 28.50% ± 6.10%,半头 ALiBi 为 27.35% ± 10.77%:保留一部分不旋转或不同偏置头有所帮助,但仍远低于 PoPE。这个结果直接支持作者关于“内容—位置分离有利于组合式索引”的解释。(Sec. 4,PDF p. 4,Table 1;App. C,p. 15,Table 9)
4.2 音乐与基因组序列的测试 NLL 更低
| 测试集最佳 NLL,越低越好 | RoPE | PoPE | 原文位置 |
|---|---|---|---|
| JSB Chorales | 0.5081 | 0.4889 | Table 2,PDF p. 4 |
| MAESTRO | 1.501 | 1.486 | Table 2,PDF p. 4 |
| Human Reference Genome | 4.217 | 4.152 | Table 3,PDF p. 5 |
音乐的节拍、音高关系与基因组局部顺序都使精确相对位置有意义;三个数据集上的方向一致。原文在这些表中给的是各模型的最佳测试 NLL,并未像间接索引表那样列出多种子的离散程度。(Sec. 4,PDF pp. 4–5)
4.3 OpenWebText:困惑度收益稳定,下游平均收益较小
| 参数量 | 验证困惑度 RoPE → PoPE ↓ | 六项零样本准确率均值 RoPE → PoPE ↑ |
|---|---|---|
| 124M | 21.55 → 21.33 | 45.33% → 46.19% |
| 253M | 18.88 → 18.55 | 48.76% → 48.78% |
| 774M | 15.85 → 15.45 | 51.80% → 52.46% |
三个规模的验证困惑度均较低;六项任务的平均准确率也均较高,但 253M 的平均差仅 0.02 个百分点。表 6 的单任务结果并非全面领先:例如 124M 的 LAMBADA、HellaSwag、PIQA 仍以 RoPE 较高,因而“下游改进”应理解为报告的六任务平均值,而非每项任务都优于 RoPE。(Sec. 4,PDF pp. 5–6,Tables 4、6)
消融把 124M/253M 的完整 PoPE 困惑度 21.33/18.55 与去掉 softplus 的 21.57/18.93、改用 ReLU 的 21.55/18.90、去掉 $\delta$ 的 21.42/18.57 比较。前两项都抹掉或明显削弱了收益;相位偏置进一步改善结果,但 253M 上只差 0.02。正幅值映射与固定可学习偏置各有贡献,幅值映射在这组消融中更关键。(Sec. 4,PDF p. 5,Table 5)
4.4 PG-19:长于预训练窗口时曲线差异扩大
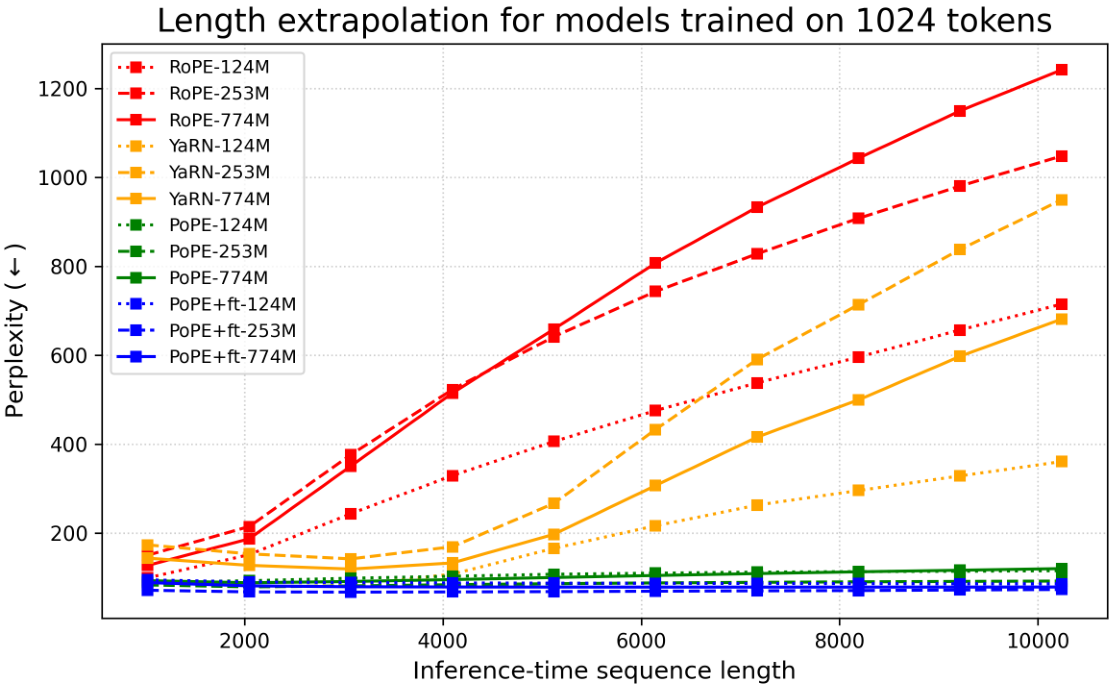
原文 Fig. 2,PDF p. 7。横轴是推理序列长度(token),纵轴是 PG-19 测试困惑度,越低越好;线型分别对应 124M/253M/774M。绿色 PoPE 未经长上下文微调,红色 RoPE 也未微调;橙色 YaRN 和蓝色 PoPE+ft 都在 4,096 token 上微调。
模型的预训练窗口是 1,024 token。图 2 显示,RoPE 曲线在超出窗口后迅速上升;YaRN 在其 4,096 token 微调窗口内缓和退化,继续延长后上升;PoPE 无需微调或频率插值,在最多 10 倍预训练长度的测试范围仍保持较平缓的曲线,PoPE+ft 进一步降低困惑度。这一比较同时涉及 OpenWebText 预训练与 PG-19 测试的语料差异;图支持本实验设置下的长度外推优势,未给出其他模型家族或更大规模的保证。(Sec. 4,PDF pp. 5–7,Fig. 2)
4.5 频率使用图提供一种机制线索
作者统计 OpenWebText 预训练模型各层查询和键的通道范数:124M 的 RoPE 在少数频率行上集中较高值,PoPE 在更多频率、尤其高频行上有较显著响应;253M 的附录图 4–5 呈现类似趋势。下图颜色条是各图自己的平均范数刻度,适合比较同图内的频率分布,不宜把两图颜色直接当成相同数值尺度。该观察与 PoPE 能利用更丰富相对位置模式的解释一致,但频率范数本身不测量最终的任务准确率。(Sec. 4,PDF pp. 6–8,Fig. 3;App. D,p. 16,Figs. 4–5)
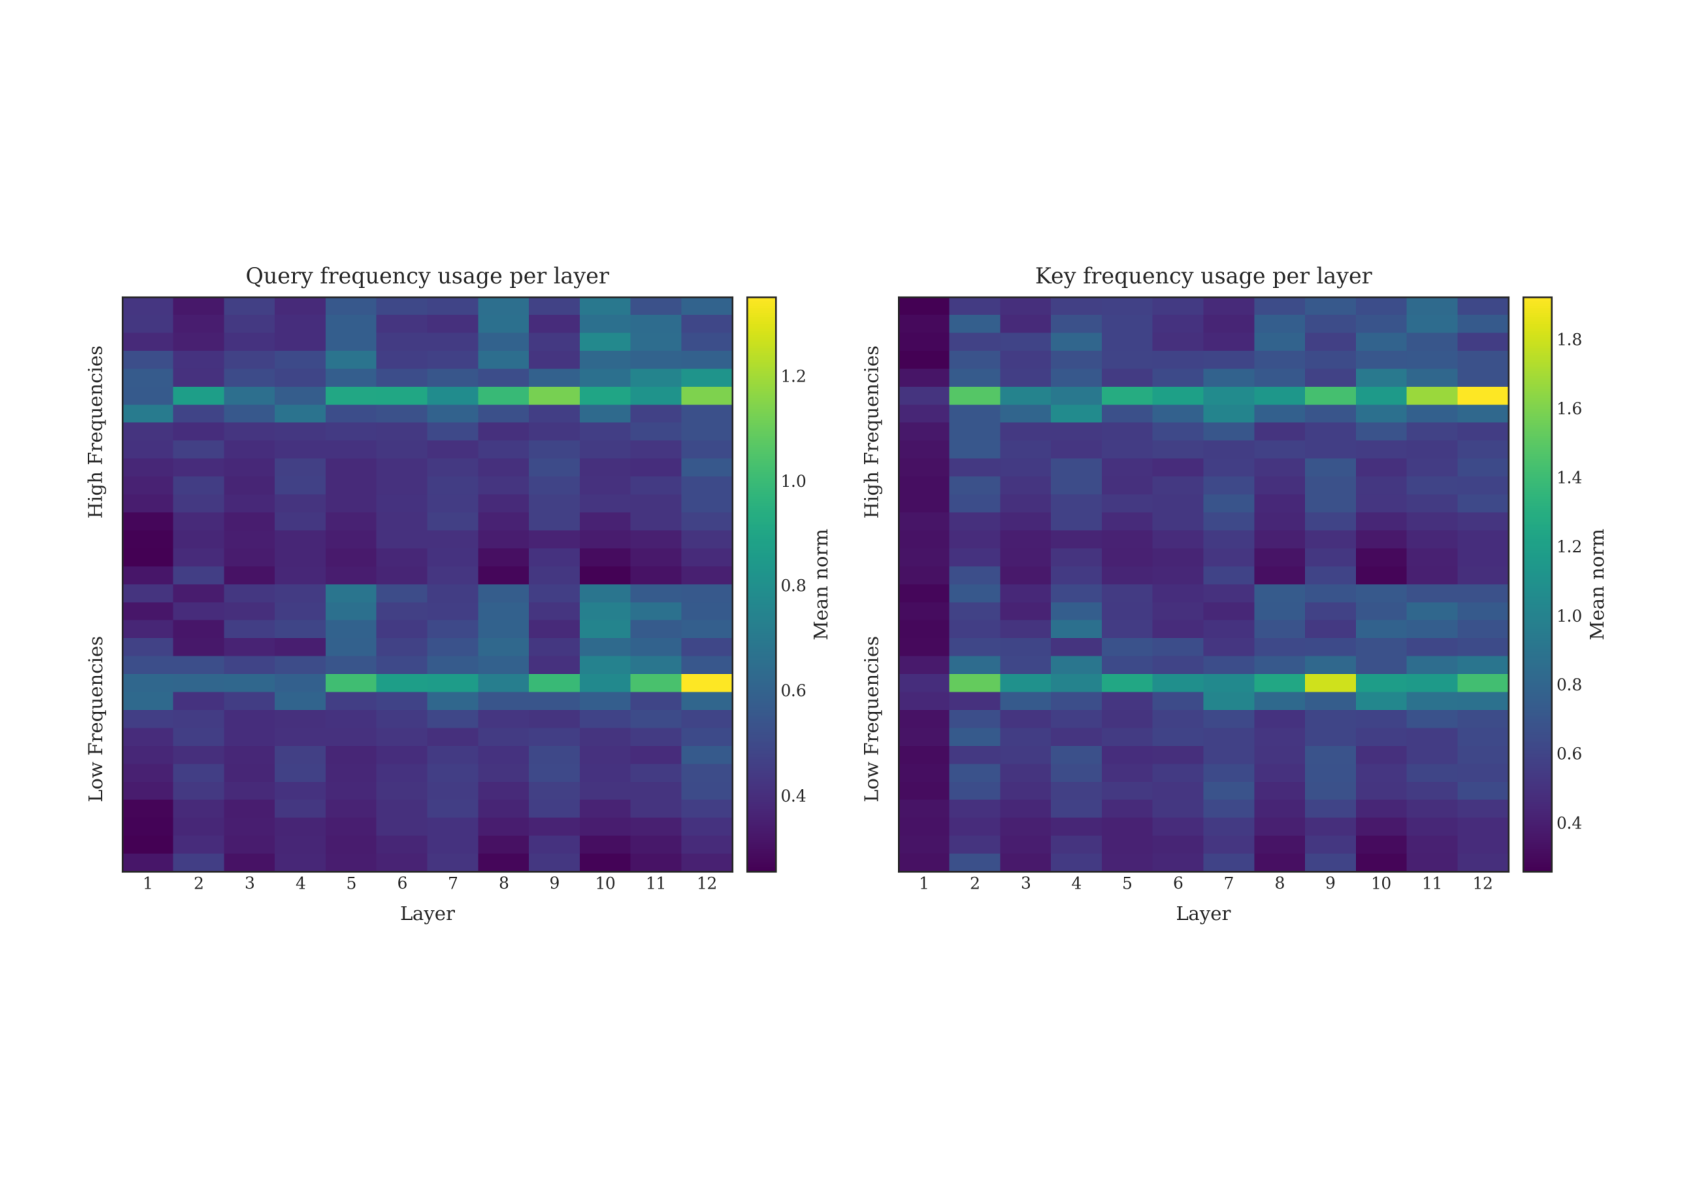
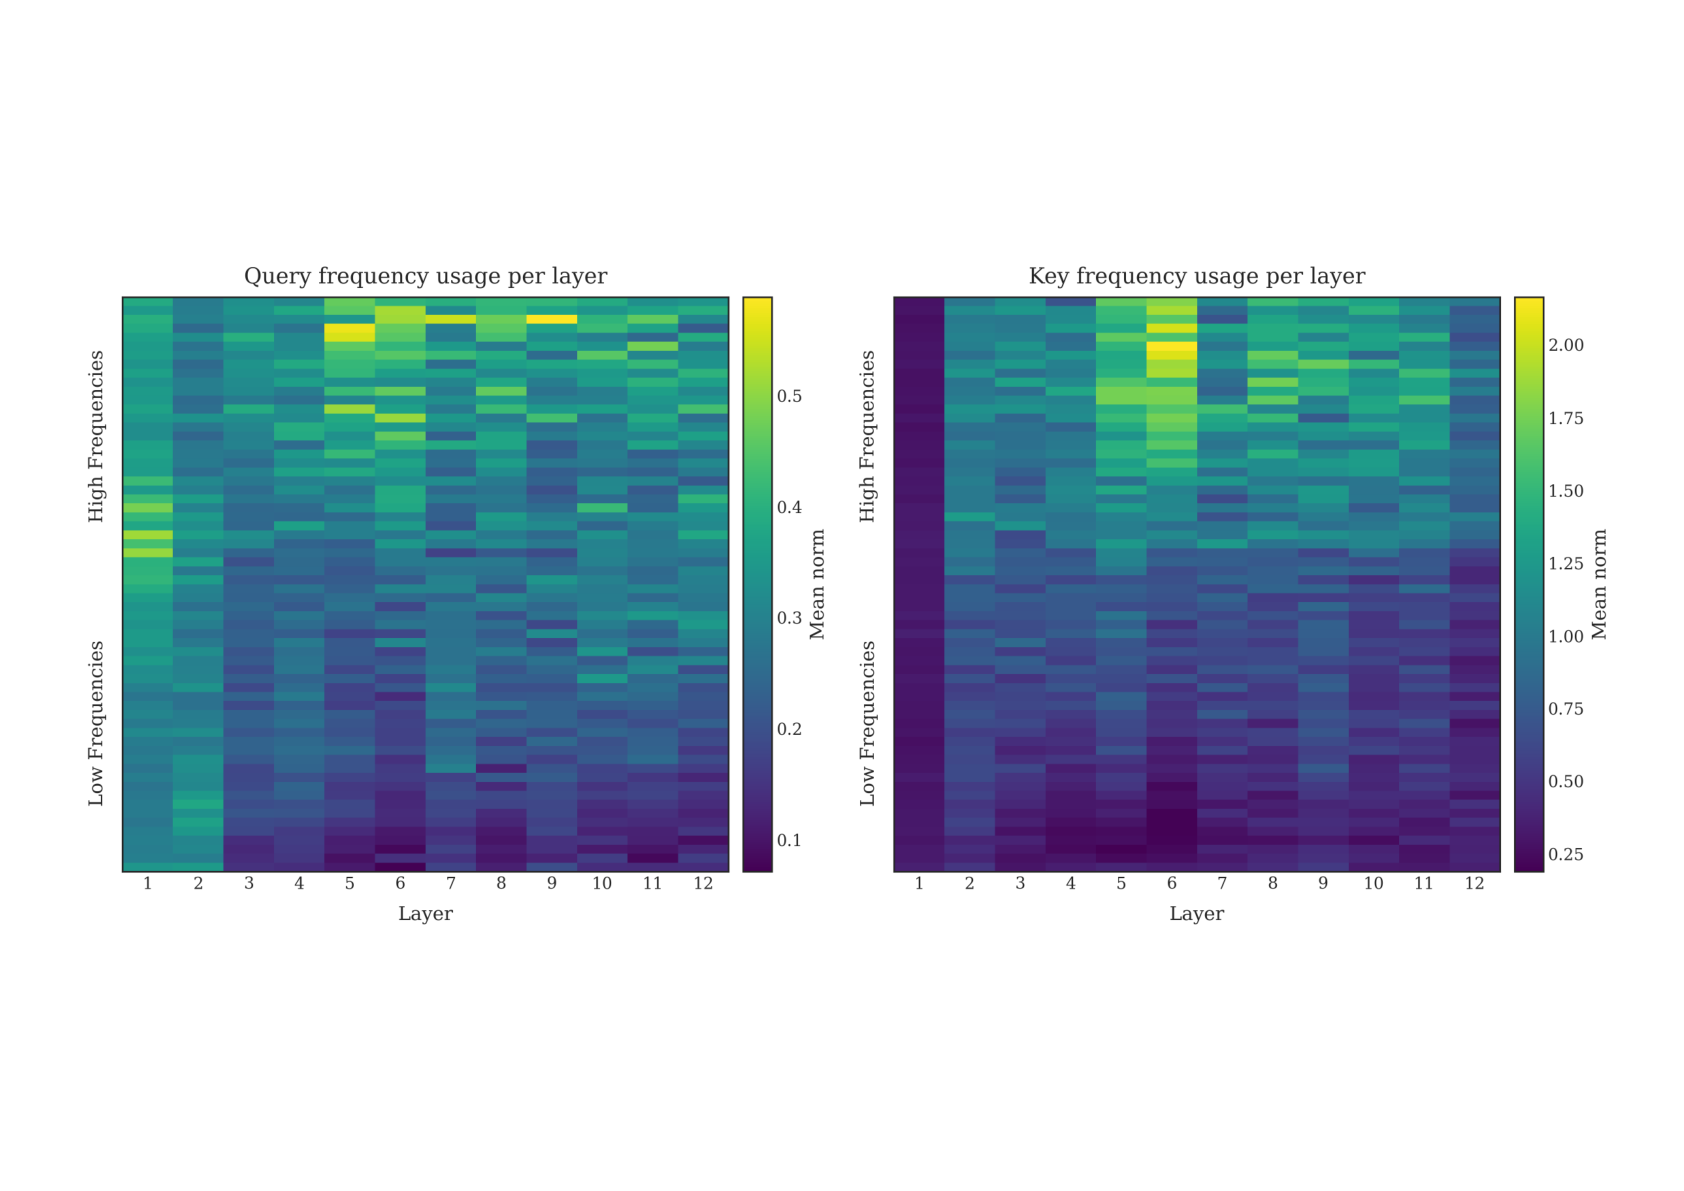
原文 Fig. 3a/3b,PDF p. 8;横轴是层,纵轴从高频到低频;分别展示查询(左)和键(右)。PoPE 的频率行数是 RoPE 的两倍。附录 Fig. 6–7 还显示零初始化后的偏置主要在较高频通道偏离零,低频通道多保持接近零。(PDF pp. 17–18)
五:结论与实际取舍
PoPE 的核心贡献是一种明确的注意力归纳偏置:把内容相关幅值与位置相关相位分开,再用每头每通道固定学习的 $\delta_c$ 表达位置偏好。它在间接索引这一针对性诊断上显示很大的优势;在所报告的音乐、基因组、OpenWebText 和 PG-19 设置中,收益延伸到建模损失、部分零样本表现和长度外推。
实际采用时需权衡复数注意力增加的乘加与内存读写,且文中提供的是主导项 FLOPs 估算、不是跨硬件的实测吞吐比较。最有说服力的诊断任务使用三种子,其他主要表格多为单点最佳值或均值而未列方差;尤其 253M 的六任务平均提升非常小。下一步值得在相同训练与推理预算、更多规模和真实长上下文任务中检验这些收益,并测量核内旋转优化能否抵消当前实现的带宽开销。(Sec. 4,PDF pp. 4–8;App. A.2,pp. 12–13)