GraphKV:用图上的相似度衰减改善 KV 缓存选择
原题:GraphKV: Breaking the Static Selection Paradigm with Graph-Based KV Cache Eviction
作者:Xuelin Li、Xiangqi Jin、Linfeng Zhang;上海交通大学 EPIC Lab
研读版本:arXiv:2509.00388v1,2025-08-30 提交;获取与研读日期:2026-11-12
原文:本地 PDF · 作者 TeX
发表:已发表于 EMNLP 2025 主会论文集,pp. 21899–21909,DOI:10.18653/v1/2025.emnlp-main.1112。以下分析仍以 arXiv v1 为准。
代码:作者官方仓库已公开;截至研读日,可见内容主要为图件及 longbench_eval.py 评测脚本,尚未见核心图传播实现及其依赖的 pyramidkv 目录,属于部分代码发布。
论文总览
GraphKV 研究一个集合选择问题:缓存预算有限时,单独看每个 token 的重要性并取最高分,可能把很多表达相似信息的 token 一起留下。作者保留已有方法的初始分数,用高分 token 作为图的源节点,再降低与它们相似的邻居的分数,最后重新取最高分。目标是同时保留“与任务相关”和“彼此提供不同信息”的 KV 条目。
它的贡献集中在初始评分与最终保留之间的相似度重排。模型权重、key/value 向量和已有预算策略不需要因此重新训练;图传播更新的是选择分数。论文以 key 的余弦相似度作为默认边权,在三个 7B–8B 模型上,将这一框架接入 KNorm、SnapKV 和 PyramidKV。LongBench 的 512-token 缓存主表中,接入 GraphKV 的每组方法平均分均提高,但强 baseline 的提升较小:Llama3-8B 的 SnapKV 为 39.97→40.35,PyramidKV 为 39.58→40.09。更显著的结果出现在 128-token 缓存的 Needle 检索:两者分别提高 8.2 和 6.6 个百分点。(Sec. 4–5,PDF pp. 4–6,Table 1、Fig. 4)
这篇论文最有启发性的观点是:token 的独立重要性不等于它对已选集合的新增信息量。不过,具体算法是一个经验性的重排规则,没有给出集合目标函数、最优性保证或完整的理论推导。
结构地图
以下页码均从原文 PDF 第 1 页开始,与本版本印刷页码相同。
| 原文章节 | 论证作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 从高分 token 的重复性引出图重排 | pp. 1–2;Fig. 1 |
| 2 Related works | KV eviction 方法及其评分方式 | pp. 2–3 |
| 3 Observation | 对比原始 top-10 与重排后的 key 相似度 | pp. 3–4;Fig. 2 |
| 4.1 Problem Formulation | 定义每层压缩 KV 与预算 | p. 4 |
| 4.2 Sparse Graph Building | 选择源节点并计算相似度 | pp. 4–5;Eqs. (1)–(2)、Fig. 3 |
| 4.3 Decay Signal Propagation | 邻居选择、多源乘法衰减、最终 top-budget | p. 5;Eqs. (3)–(5) |
| 5.1 Experimental Setup | baseline 及接入方式 | p. 5 |
| 5.2 Evaluation on LongBench | 三模型、16 任务、512 缓存的主结果 | pp. 5–6;Table 1 |
| 5.3 Evaluation on Needle In a Haystack | 8K 输入内的事实检索 | p. 6;Fig. 4 |
| 6.1–6.3 Ablation | 源节点数、邻居数、传播轮数 | pp. 6–7;Figs. 5–6 |
| 7.1–7.3 Discussion | 其他边权、传播信号及延迟 | pp. 7–8;Figs. 7–8、Tables 2–3 |
| 8 Conclusion / 9 Limitation | 贡献与经验参数、规模限制 | pp. 8–9 |
| A.1 Implementation Details | 硬件、解码、数据集与指标 | p. 10;Table 4 |
| A.2 More Related Works 及附录后续材料 | 图方法背景、缓存内存、逐任务消融、算法 | pp. 10–11;Tables 5–6、Algorithms 1–2 |
一:动机——高分缓存为什么仍会浪费预算?
1.1 长上下文的瓶颈与选择对象
自回归解码复用历史 key/value,避免每步重新计算全部历史表示。代价是 KV 缓存随上下文长度增长。Token eviction 直接删除部分历史位置的 key/value,保留较小子集,因而需要判断哪些位置最值得占据预算。
已有方法提供了不同的重要性依据:SnapKV 利用观察窗口内的注意力,PyramidKV 进一步安排不同层的预算,H2O 利用累计注意力,CAKE 考虑时空维度的注意力和层偏好,KNorm 则基于 key 的范数。这些依据各有价值,但从一组分数直接得到 top-budget 集合时,没有显式扣除集合内的重复性。(Sec. 2、5.1,PDF pp. 2–3、5)
这里的“静态”针对一次选择中直接按原始分数排序的规则。H2O 本身可以随解码累计更新分数;GraphKV 的比较并不要求 baseline 的分数在整个推理过程中恒定。
1.2 原文观察:高分 token 在 key 空间中相似
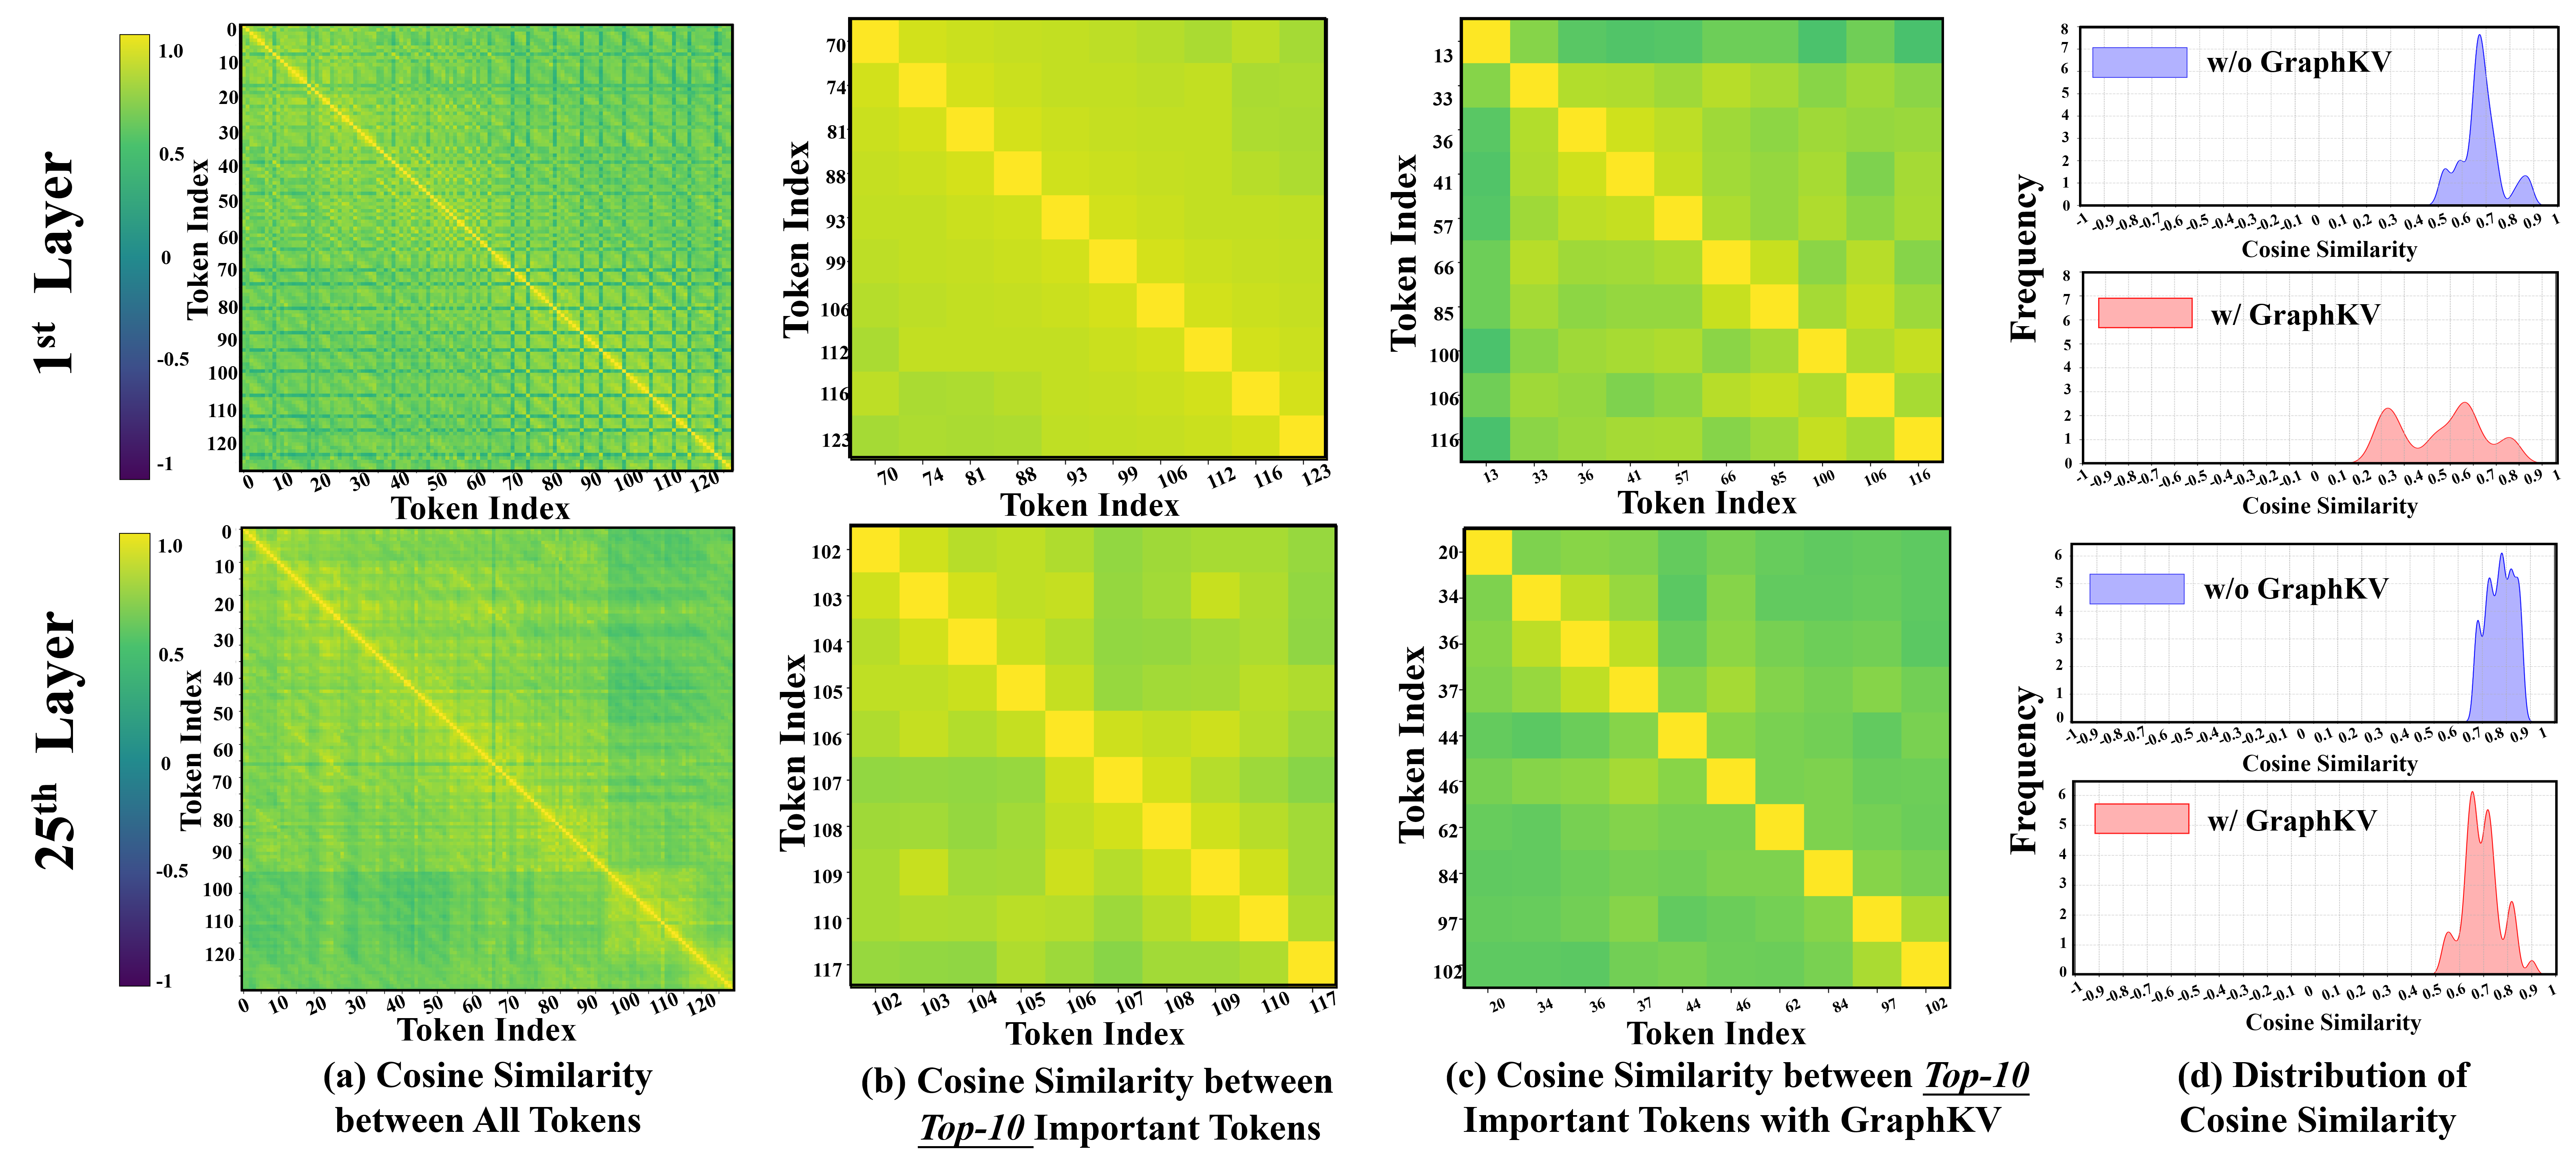
原图 Fig. 2,PDF p. 3。取 Llama3-8B 在 HotpotQA 一个样本中的 128 个截断 token;上下两行分别展示第 1 层与第 25 层。从左至右读:(a) 全部 token 的相似度,(b) 原始最高分的 10 个 token,(c) GraphKV 后最高分的 10 个 token,(d) 对应相似度分布。热图更黄表示更相似,对角线是 token 与自身的相似度 1。
原始 top-10 的非对角区域普遍较亮;重排后颜色变暗,右侧分布也总体向较低相似度移动。作者据此将高分条目的相似性视为潜在冗余,并尝试让中等分数但较不相似的 token 获得保留机会。这是后续算法的经验动机。Key 相似度衡量的是模型内部表示的接近程度,作为语义重复的代理;图中展示的是样本和层的局部现象。
二:方法——先选源节点,再衰减相似邻居
2.1 输入、输出及符号
在第 $l$ 层,论文记完整缓存为 $\mathbf K^l,\mathbf V^l\in\mathbb R^{n\times d}$,压缩后为 $\mathbf K_s^l,\mathbf V_s^l\in\mathbb R^{k_l\times d}$。论文用这一简化矩阵记法说明位置选择,未在此展开多头张量轴。(Sec. 4.1,PDF p. 4)
| 符号 | 含义 |
|---|---|
| $n$ | 本次参与选择的输入 token 数 |
| $M,l$ | Transformer 层数、当前层索引 |
| $k_l$ / $B$ | 当前层最终缓存预算;消融图用 $B$ 表示预算 |
| $k$ | 用于发出衰减信号的源节点数,与最终预算 $k_l$ 不同 |
| $k_i$ | token $i$ 的 key 向量;这里下标形式的 $k_i$ 不是节点数 |
| $s_i$ | 由已有 eviction 方法给出的初始重要性分数 |
| $e_{ij}$ | 源节点 $i$ 与 token $j$ 的余弦相似度,无单位 |
| $m$ | 每个源节点选择的邻居数 |
| $T$ | 对分数执行衰减更新的轮数 |
输入是原始 KV、初始分数和上述超参数;输出是位置索引集合,再按相同索引取出 key 和 value。论文希望压缩后的任务分数接近完整缓存,但没有把这一目标写成可直接优化的训练损失。整个过程在推理时执行,无需额外训练。
2.2 图的构建:用高分节点限制计算量
首先,依照已有分数取 $k$ 个源节点:
这是原文 Eq. (2)。然后只计算源节点到其他 token 的余弦相似度,而不计算全部 $n^2$ 个 token 对:
这是 Eq. (1),PDF p. 4。余弦忽略向量长度,侧重方向是否接近。因此,初始分数负责“代表性”,边权负责识别与高分代表相似的条目。尽管余弦本身对称,只有被选中的源节点发出更新,传播关系在使用时有方向性。
对每个源节点,保留余弦最大的 $m$ 个邻居:
这是 Eq. (3),PDF p. 5,$e_{i(m)}$ 是排第 $m$ 的边权。原式用阈值集合描述,存在并列时集合可能超过 $m$;附录算法用 top-$m$ 表达同一意图。
“稀疏”包含两层含义:先只由少量源节点计算到全部 token 的候选边,再仅向每个源节点最相似的邻居传播。初始低分节点仍可能作为接收者,不能据此理解为所有低分节点都完全隔离。
2.3 传播:将相似性转换为分数折扣
最清楚的正式定义是 Eq. (5):
与一个源节点越相似,乘子 $1-e_{ij}$ 越小;同时接近多个源节点,就接受多个折扣。没有入边的节点保持原分数。最后选 $s_j^{(T)}$ 最高的 $k_l$ 个位置,并保留相应的 KV。(Sec. 4.3,PDF p. 5)
在 $s_j\ge0$ 且参与传播的边满足 $0\le e_{ij}\le1$ 时,这一规则确实只会降低分数。例如相似度为 0.8,单条边会让分数变为原来的 20%。余弦的完整取值范围是 $[-1,1]$:如果邻域里出现负边,乘子会大于 1。原文没有给出负边裁剪或单独阈值,因而“所有更新必然衰减”需要正相似度这个条件。
注意两个算法特征。第一,源节点由初始分数选出,正式定义没有规定每轮重新挑源节点、重算 key 或重新建图。第二,源节点最终仍受 top-budget 排序决定;公式没有要求将全部源节点强制加入最终缓存,源节点也可能成为其他源节点的邻居。这使它区别于“逐个锁定代表、永不撤销”的贪心选择。
2.4 一个可计算的教学例子
下表为按 Eq. (5) 构造的教学例子,不是原文实验数据。假设预算 $k_l=2$,初始分数为 $s_A=1.0,s_B=0.9,s_C=0.7,s_D=0.6$;只取 $A$ 为源节点,邻域为 $B,C$,边权分别为 0.9、0.1。
| token | 初始分数 | 一轮后的计算 | 更新分数 |
|---|---|---|---|
| A | 1.0 | 不接受衰减 | 1.00 |
| B | 0.9 | $0.9(1-0.9)$ | 0.09 |
| C | 0.7 | $0.7(1-0.1)$ | 0.63 |
| D | 0.6 | 不在邻域内 | 0.60 |
原始 top-2 为 $A,B$,传播后的 top-2 为 $A,C$。算法让代表 $A$ 已经覆盖的近邻 $B$ 降低优先级,腾出预算给不同方向的 $C$。这解释了它如何在不改变初始评分器的情况下改变集合组成。
2.5 多轮传播的含义与原文记法问题
本次分析的直接推导:如果源节点、邻域和边权都固定,令
于是增加轮数就是把相同折扣反复作用,增强对相似邻居的抑制。按这个正式公式,不能自动把 $T$ 解释成消息传播到 $T$ 跳远的节点,也不能认为 key 的表示被传播更新了。图的结构、表示与被选条目的权重应区分开。
原文存在会影响实现的记法不一致,需在理解机制时保留:
- Eq. (4) 和 Algorithm 2 有多余乘号;这里依据清楚的多源乘积 Eq. (5),单边更新理解为 $s_j\leftarrow s_j(1-e_{ij})$,不补造未定义的衰减系数。
- Fig. 3(PDF p. 4)画出初始 0.7 的条目变为 $-0.07$。对非负初始分数和余弦范围内的边权,Eq. (5) 的乘积不会产生负分数,因此该图不能作为式 (5) 的精确数值演算。
- Algorithm 2(PDF p. 11)在源节点循环内反复以 $s_j^{(t-1)}$ 赋值,字面执行会覆盖同一轮前一源节点的更新;Eq. (5) 则明确累计多个源节点的折扣。复现时需要明确采用哪种语义。
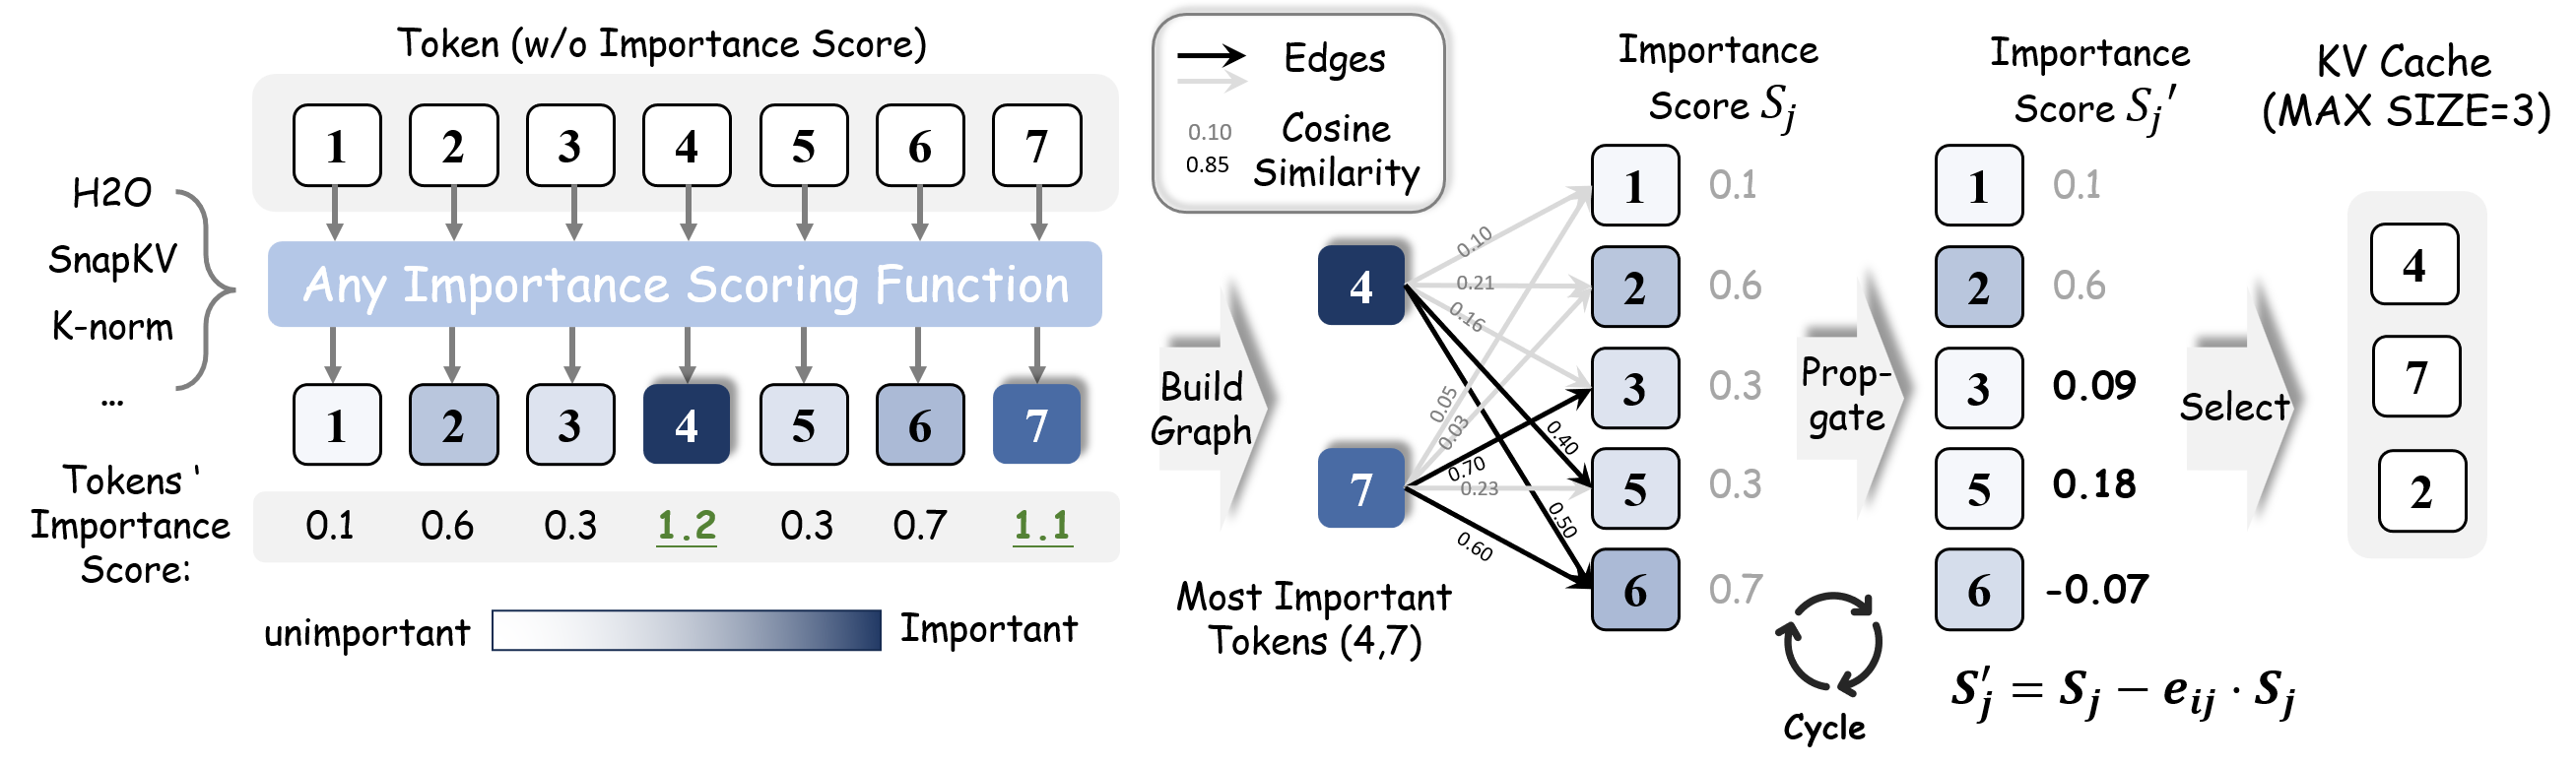
原图 Fig. 3,PDF p. 4。按“初始评分→选择源节点并计算相似度→传播分数折扣→最终选择”的顺序阅读。该图展示流程;其具体负分数示例与上述乘法公式的差异已在前文说明。
2.6 计算复杂度与实际内存
原文把相似度开销写成 $O(nk)\approx O(n)$,成立的语境是 $k\ll n$,且 $k$ 随固定预算保持有限。若把 key 维度 $d$ 显式计入,相似度点积需要 $O(nkd)$,对 $T$ 轮、每源 $m$ 个邻居的分数更新需要约 $O(Tkm)$;此外还有分数和邻居的 top-$k$/top-$m$ 选择开销。存储完整源节点—候选边分数时需 $O(nk)$,仅存筛后邻接边时为 $O(km)$。(原文 Sec. 1、4,PDF pp. 2、4–5;显式维度分析为本次推导)
如果缓存预算也随输入长度成比例增长,则 $k\propto k_l\propto n$,相似度计算不再对 $n$ 保持线性。因此“线性”需要连同固定预算条件理解。论文的延迟实验将在结果部分单独讨论,不能由渐近表达直接得出零开销。
三:实验——分别检验平均能力、检索和设计选择
3.1 运行设置与 baseline 角色
附录 A.1(PDF p. 10)报告使用一张 NVIDIA H20 GPU,解码采用 beam search。评测模型为 Llama2-7B-Chat、Llama3-8B-Instruct 和 Mistral-7B-Instruct-v0.2。主表统一标注 KV size 512;PyramidKV 保留其层间预算分配的设计,不能把这个数字重新解释为所有方法每一层都完全同形的缓存布局。
主结果比较 KNorm、SnapKV、PyramidKV 各自接入前后的变化;Full 是不压缩的参考。CAKE 和 H2O 额外出现在传播轮数实验中,用于观察初始评分来源不同是否仍能受益。GraphKV 的作用是更换选择逻辑,因而最有信息的比较是同一个基础方法、相同预算、接入前后。
3.2 LongBench:16 项任务与不同指标
| 任务组 | 数据集 | 指标及含义 |
|---|---|---|
| 单文档 QA | NarrativeQA、Qasper、MultiFieldQA-en | F1:生成答案与参考答案的词级重合 |
| 多文档 QA | HotpotQA、2WikiMultihopQA、MuSiQue | F1:跨文档问题的答案匹配 |
| 摘要 | GovReport、QMSum、MultiNews | ROUGE-L:基于最长公共子序列的摘要重合 |
| Few-shot | TREC、TriviaQA、SAMSum | 分别为分类准确率、F1、ROUGE-L |
| 合成任务 | PassageCount、PassageRetrieval-en | 精确匹配准确率:计数或找段落 |
| 代码 | LCC、RepoBench-P | 编辑相似度:生成代码与参考续写的接近程度 |
全部指标越高越好。Table 1 的 Avg. 是不同任务分数的平均,不能称作一个统一“准确率”。附录 Table 4(PDF p. 10)中大多数任务为 200 条,MultiFieldQA-en 为 150 条,两个代码任务各 500 条;因此平均也不是把所有样本混在一起计算的总体正确率。
附录的平均长度对英语/代码用词数计量,例如 NarrativeQA 18,409、QMSum 10,614、LCC 1,235,不能直接当成模型实际输入 token 数。论文提及 LongBench 原始数据很长,主实验并未由此证明所有模型都实际处理了 100K token。
3.3 Needle 与消融各回答什么问题?
Needle 实验使用 Llama3-8B、上下文长度最高约 8,000 token、缓存预算 128。它在不同输入长度和 needle 插入深度下衡量事实检索成功情况。原文实际展示的是事实检索热图,没有给出多针推理的独立结果。(Sec. 5.3,PDF p. 6)
设计消融依次改变源节点数、邻居数与轮数;讨论部分进一步更换边的相似度定义、比较衰减/增强/直接淘汰信号,并在 QMSum、预算 512 时测量解码延迟。这些实验的预算和任务范围不同,应分别解读。
四:结果——收益存在,但大小依赖基线和任务
4.1 LongBench 主表:强基线上的平均提升温和
下表摘录 Table 1(PDF p. 6)的 16 任务平均分,括号为本次按表内数字计算的绝对分数差;Full 列为完整缓存参考。
| 模型 | Full | KNorm → +GraphKV | SnapKV → +GraphKV | PyramidKV → +GraphKV |
|---|---|---|---|---|
| Llama2-7B-Chat | 33.13 | 13.03 → 25.20(+12.17) | 31.95 → 32.35(+0.40) | 32.04 → 32.25(+0.21) |
| Llama3-8B-Instruct | 41.65 | 20.64 → 29.76(+9.12) | 39.97 → 40.35(+0.38) | 39.58 → 40.09(+0.51) |
| Mistral-7B-Instruct-v0.2 | 42.49 | 14.91 → 16.50(+1.59) | 40.24 → 40.60(+0.36) | 40.16 → 40.50(+0.34) |
最稳定的结果是平均分改善:三个模型、三个初始方法均出现正向变化。KNorm 的 Llama2/3 提升很大,但它接入后仍低于 SnapKV/PyramidKV;不能只看相对提升就认为 KNorm 成为最佳方案。对于强 baseline,平均改善约 0.2–0.5 分,而完整缓存的总体平均分仍更高。
Llama3-8B 上,SnapKV 的相对平均增益为 $0.38/39.97\approx0.95\%$,PyramidKV 为 $0.51/39.58\approx1.29\%$。引言中的“约 3%”更接近六项 QA 的均值:从 Table 1 前六列计算,SnapKV 为 30.207→31.078(相对 +2.89%),PyramidKV 为 29.702→30.522(相对 +2.76%)。这解释了 QA 口径与全任务口径的区别。引言另写 KNorm 提高 45.88%,但主表 Llama3 全任务均值给出约 +44.19%,六项 QA 又约为 +102.54%;该 45.88% 的精确统计口径无法由这些列直接重建,故不将其作为核心结果复述。
任务级别呈现更丰富的取舍:
| Llama3-8B,预算 512 | 接入前 → 接入后 | 结果含义 |
|---|---|---|
| SnapKV,Qasper F1 | 23.37 → 25.37 | 文档问答改善明显 |
| PyramidKV,HotpotQA F1 | 42.51 → 44.13 | 超过 Full 的 43.56 |
| SnapKV,RepoBench-P 编辑相似度 | 53.87 → 56.10 | 也超过 Full 的 52.38 |
| SnapKV,LCC 编辑相似度 | 59.50 → 58.42 | 同属代码任务,也存在下降 |
| PyramidKV,NarrativeQA F1 | 24.59 → 24.12 | 并非每项问答都提高 |
这组结果支持“重排可以改善有限预算的选择”,也说明降低相似性存在任务取舍。原文“少量预算超过 Full”的例子应定位到具体数据集,不能扩展为全任务整体超过 Full。其“10% full budget”说法没有提供每项任务统一的实际 token 长度分母,固定 512 也不意味着各样本都恰好保留 10%。
4.2 Needle:小缓存条件下,检索覆盖改善更明显
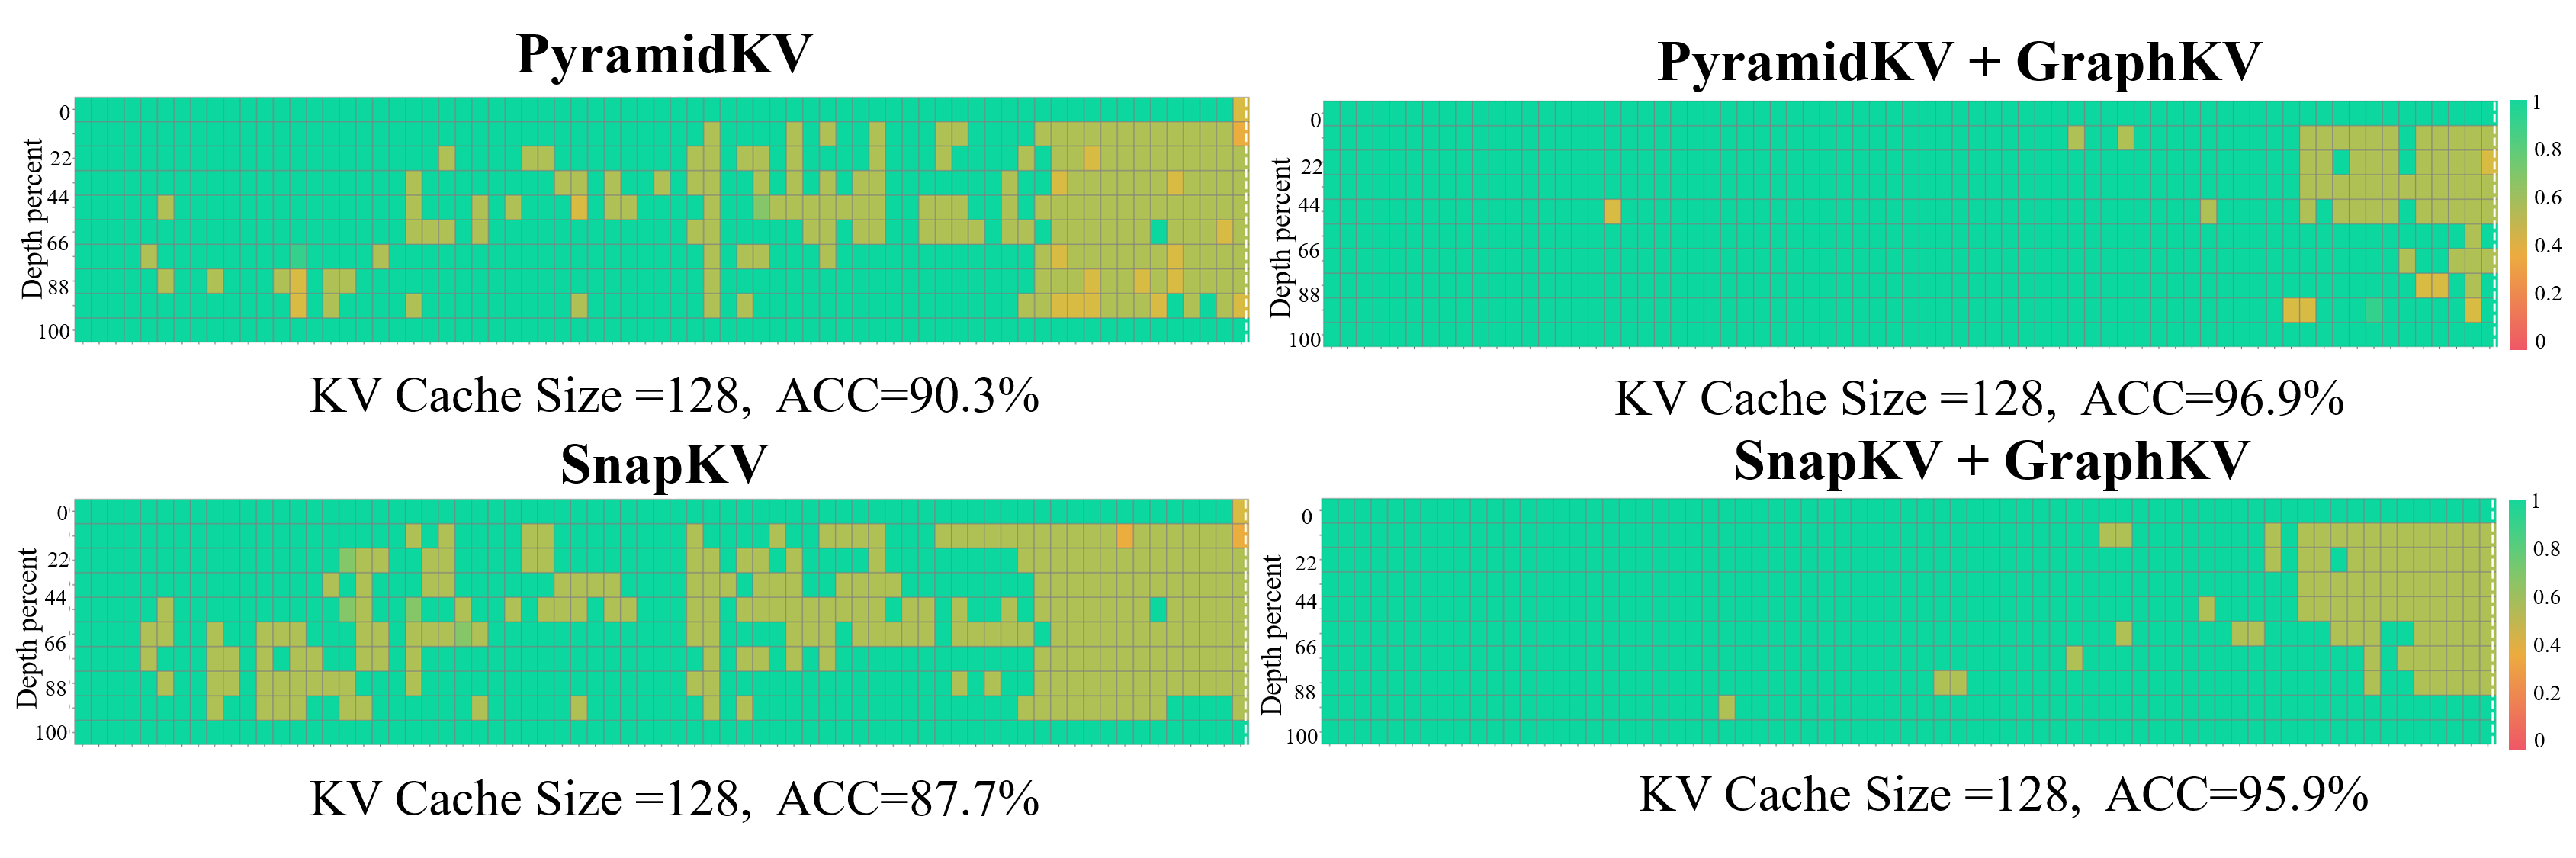
原图 Fig. 4,PDF p. 6。横轴为输入 token 长度,纵轴为 needle 插入深度百分比;四个面板分别比较 PyramidKV 和 SnapKV 接入前后。按色条,绿色接近成功,向红色移动表示检索得分更低;接入后失败色块减少。
| Llama3-8B,缓存 128,最高约 8K 输入 | 原方法 | +GraphKV | 绝对变化 |
|---|---|---|---|
| PyramidKV | 90.3% | 96.9% | +6.6 个百分点 |
| SnapKV | 87.7% | 95.9% | +8.2 个百分点 |
这是检索成功率的百分点差,分别对应相对约 +7.31% 和 +9.35%。小预算下避免重复代表占位,能让不同位置的重要信息获得缓存空间,符合方法动机。正文提到 KNorm,但该图实际只有两组方法;这里仅报告可见的两组结果。
4.3 源节点和邻居:传播范围并非越大越好
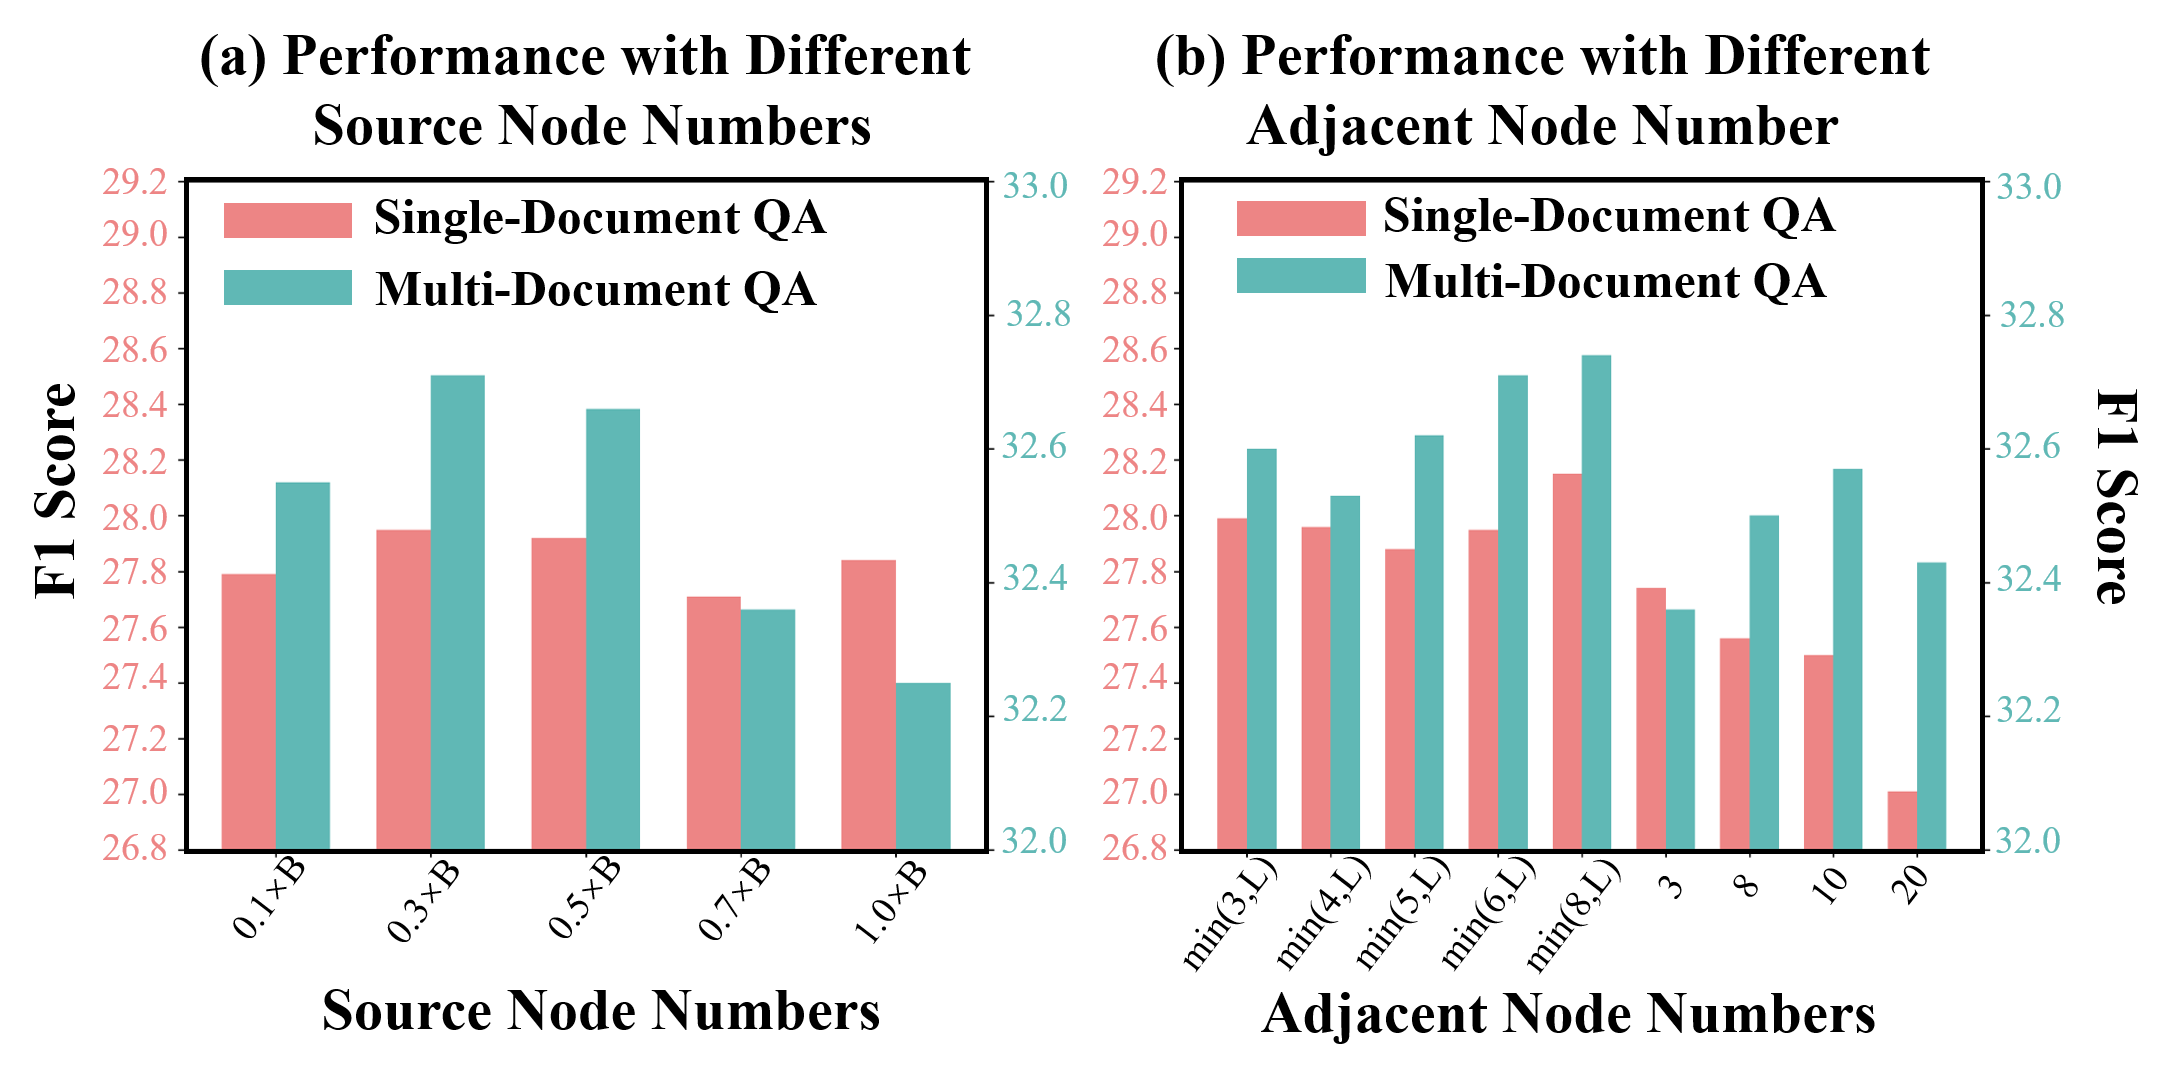
原图 Fig. 5,PDF p. 7。左图横轴是源节点数与缓存预算 $B$ 的比例;右图比较输入长度自适应邻居数和固定邻居数。粉色柱读左侧单文档 QA 的 F1 轴,青色柱读右侧多文档 QA 的 F1 轴,不能直接比较两种颜色的柱高。右图的 $L$ 按图注表示输入 token 长度乘 $10^{-3}$,标签如 $\min(3,L)$。
源节点数(Sec. 6.1):图 5 的单文档和多文档聚合分在 $0.3B$ 左右较好,增加到 $0.7B$、$1.0B$ 并不继续提高。作者解释为影响的节点过多,给原始重要性分布引入噪声。
附录 Table 6(PDF p. 11)显示逐任务最优点并不相同:Qasper 在 70% 源节点时为 25.20,MultiFieldQA-en 在 100% 时为 36.82,而 HotpotQA 在 10% 时为 43.91。$0.3B$ 是图中聚合口径的经验选择,不能当成每个任务的统一最优超参数。
邻居数(Sec. 6.2):图中自适应的 $\min(c,L)$ 配置整体优于一些固定大邻域,过多邻居会削弱本来重要的条目。正文用“预设值与 query length 的最小值”描述,而图注对 $L$ 的定义是输入长度的千分之一。复现时需要明确长度单位,不能直接把图里的 $L$ 当成问句 token 数。
4.4 轮数与 PCA:第一轮有用,后续存在波动
Fig. 6(PDF p. 7)纵轴为任务 F1,横轴为轮数 $T$。图中的数值与 HotpotQA 对照相符,正文没有在该段完整标明所有运行配置;应作为该消融设置的结果,而非 16 任务平均。
| 初始方法 | $T=0$ | $T=1$ | $T=2$ | $T=3$ |
|---|---|---|---|---|
| CAKE | 46.49 | 46.86 | 46.47 | 46.76 |
| H2O | 40.91 | 41.75 | 42.14 | 42.15 |
| PyramidKV | 42.51 | 44.48 | 43.97 | 44.67 |
| SnapKV | 42.60 | 43.03 | 43.04 | 43.38 |
第一轮四种方法均改善,PyramidKV 提高 1.97 分;但 CAKE 的第二轮为 46.47,略低于其无传播的 46.49。正文声称第二轮仍超过 baseline,与图中的 CAKE 数字不符。轮数带来的效果并不严格单调,符合重复折扣可能抑制过强的机制。
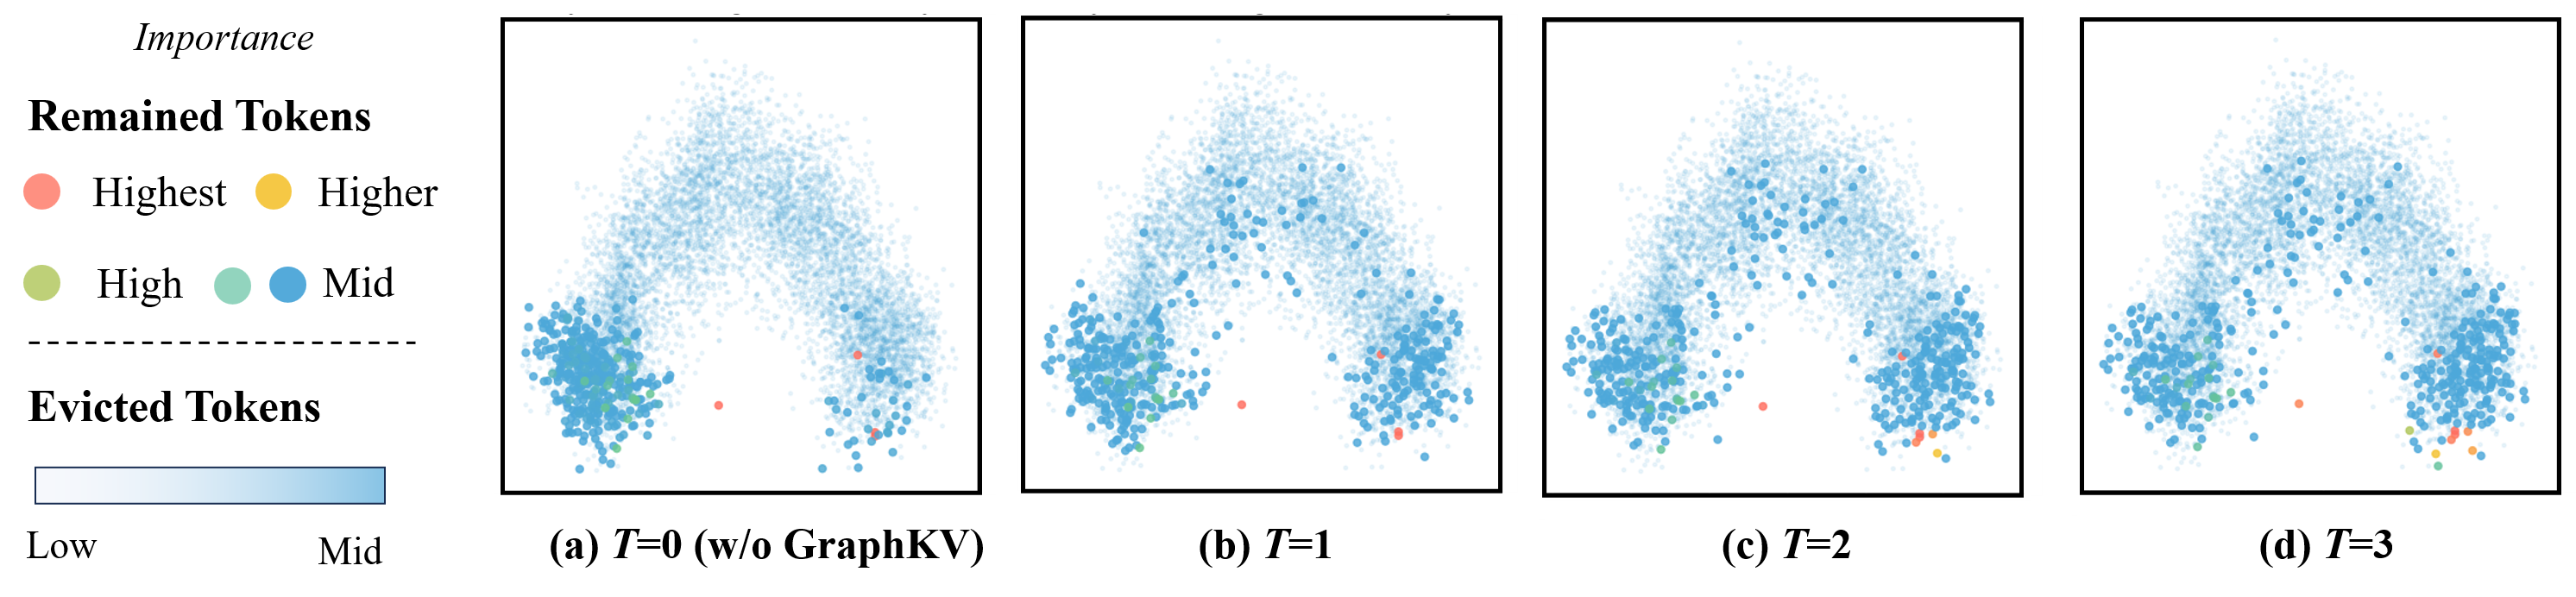
原图 Fig. 7,PDF p. 8。横纵轴为二维 PCA 投影,颜色及较大标记突出高分/保留条目,面板从 $T=0$ 到 3。传播后高分标记不再集中于同一区域,支持分数更分散的解释。算法更新分数而不更新 key 向量,所以应理解为哪些点获得高分发生变化,而非图传播把向量本身推远。
4.5 边权:key–key 并非唯一有效选择
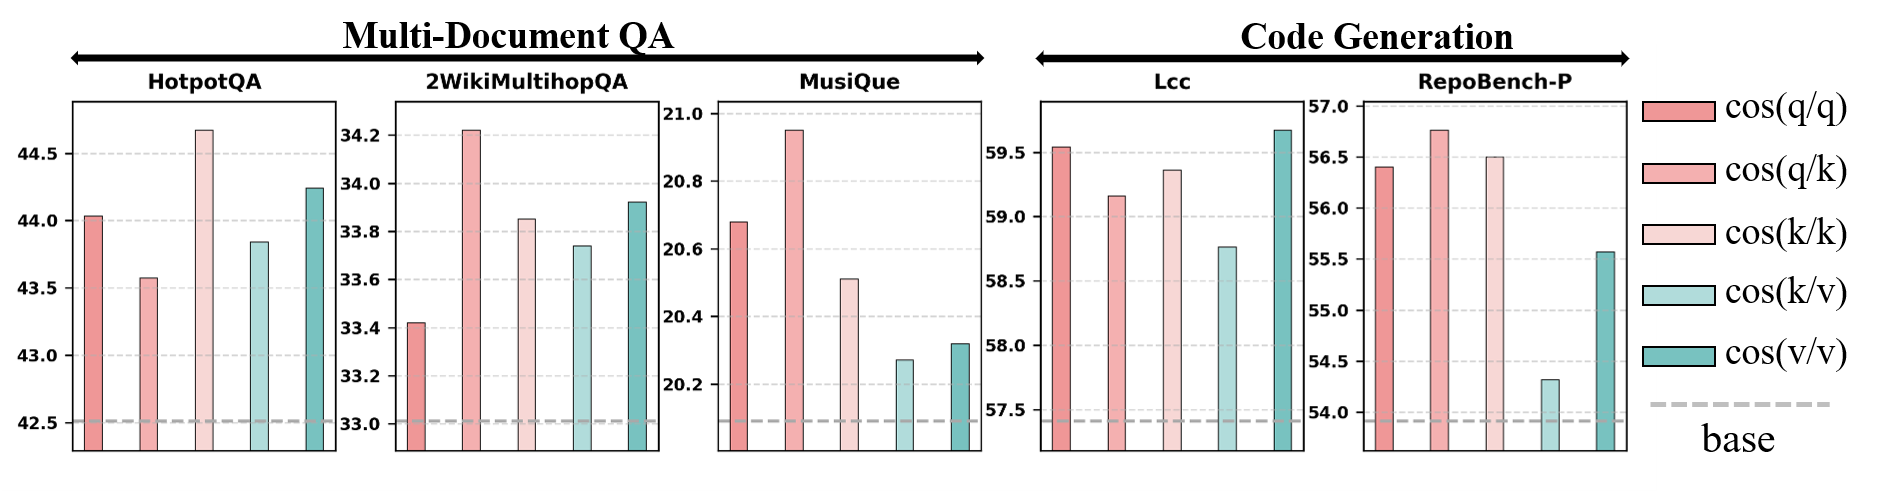
原图 Fig. 8,PDF p. 8。五个面板从左到右是 HotpotQA、2WikiMultihopQA、MuSiQue、LCC 和 RepoBench-P;每个面板按图例依次比较 query–query、query–key、key–key、key–value、value–value 的余弦,虚线为各自 baseline。QA 的纵轴是 F1,代码任务是编辑相似度,面板间轴范围也不同。
图中多种边权都高于对应虚线,但最优边权随任务变化:例如 HotpotQA 的 key–key 较好,2Wiki/MuSiQue 的 query–key 较好,LCC 的 value–value 较好。这支持“按相关性抑制重复条目”比某一种特定表示更一般的设计方向。把 query 引入该图时,原文并未详细展开其对齐和全部实现细节;不能从概念图自行补成一个完整的 Q/K/V 多图融合算法。
4.6 传播信号:软衰减优于把近邻全部删掉
Table 2(PDF p. 7),缓存预算 128,在所列十项任务上比较三种信号。以下是原表报告的平均分,分数混合了各任务指标:
| 信号 | 平均分 | 相对无传播的绝对差 |
|---|---|---|
| 无传播 baseline | 38.61 | — |
| 衰减(Decay,$-$) | 39.84 | +1.23 |
| 增强(Enhanced,$+$) | 38.67 | +0.06 |
| 直接淘汰邻居(Evicted,$-\infty$) | 18.80 | −19.81 |
相似的邻居往往仍然包含有用信息,因此需要降低其优先级,不能一概删除。直接淘汰大幅退化,而增强相似邻居几乎没有平均收益,是支持“代表性与多样性要折中”的最直接对照。它也有逐任务例外:MuSiQue 上增强为 19.78,略高于衰减的 19.68;衰减在 PassageCount 为 68.92,低于原表 baseline 69.50。表头把指标概括为 F1/accuracy,但所列任务还包含摘要和代码;这里沿用“任务平均分”表述。
4.7 效率:实际延迟有升有降
Table 3(PDF p. 8)在 QMSum、缓存预算 512 下报告解码延迟,单位为秒,越低越好。
| 方法 | 原方法 | +GraphKV | 变化 |
|---|---|---|---|
| PyramidKV | 5.133 s | 5.265 s | +2.5% |
| SnapKV | 5.474 s | 4.912 s | −10.2% |
| KNorm | 6.031 s | 5.095 s | −15.5% |
这组实测支持“在所测任务上开销可控,有些组合总解码时间更短”,但不支持正文笼统的“不增加推理延迟”,因为 PyramidKV 确实增加了 2.5%。作者将变快解释为回答改善后减少过长生成;这是作者提出的可能原因。表中没有固定输出长度的逐 token 延迟或独立构图计时,所以不能据此推断 GraphKV 的每步计算更少。
附录 Table 5(PDF p. 11)另给不同缓存长度的内存估算,但说明只列了 32 个注意力头、128 维和 BF16,未清楚交代与数值对应的层数及 KV 头数。本次分析的通用估算为
其中因子 2 对应 K 与 V,$b$ 是每个标量的字节数。需要用 KV 头数而非总查询头数;采用分组查询注意力(GQA)时两者不同。原表的内存值不宜直接移植为这三个模型在任意上下文下的实测总显存。
五:结论——把独立评分变成考虑集合冗余的评分
GraphKV 的主要贡献是一个可插入现有缓存方法的选择框架:沿用初始重要性,利用源节点与邻居的相似度施加折扣,再选择最终 KV。它把“重要 token 是否彼此重复”纳入决策,并用 LongBench、小预算检索、传播信号及超参数消融提供了相互补充的实证证据。
对使用者最有意义的取舍是:若已有 SnapKV/PyramidKV 这类强评分器,平均收益通常是小幅改善;当预算极紧、重复条目挤占不同信息时,检索改善可能更明显。传播范围和次数需要控制,硬删除邻居的失败说明多样性不能压倒原有的重要性。
决定进一步应用的具体问题有三点。首先,作者在 Sec. 9(PDF p. 9)也承认参数选择主要靠经验,评测集中于 7B–8B 模型;更大模型的有效范围需要单独验证。其次,Eq. (5)、流程图及附录算法存在不同更新语义,核心代码的部分发布状态使精确复现仍需澄清。最后,端到端延迟受生成长度影响,需要固定解码长度的计时才能分离选择计算开销。
本次分析最值得继续追问的是:能否把初始相关性与冗余折扣写成一个明确的集合目标,使源节点选择、邻居范围和衰减强度具有共同依据?论文已经展示了经验折扣的价值,而这个目标仍可帮助解释何时该保留多个相似条目,以及何时该把预算留给不同的信息。