MLP Memory:将检索行为预训练为参数记忆
论文:MLP Memory: A Retriever-Pretrained Memory for Large Language Models
作者:Rubin Wei、Jiaqi Cao、Jiarui Wang、Jushi Kai、Qipeng Guo、Bowen Zhou、Zhouhan Lin。
版本与日期:arXiv:2508.01832v4(2026-02-27);本次获取与研读:2026-11-11。PDF 首页内部日期仍为 2025-10-23。
原文:arXiv v4 · 本地 PDF。下文页码均为从 1 开始的 PDF 页码。
- 发表:已发表于 ICLR 2026 正式论文集,查证日期 2026-11-11。
- 代码:作者官方实现,已有训练、检索库构建、推理与评测代码,README 提供模型及数据链接。
论文总览
论文提出:可以把昂贵的“根据上下文向量,在语料库里查邻居并统计下一词”过程,预先学习为一个独立 MLP。语言模型(LM)负责生成上下文表示和原始词分布;MLP Memory 从中间层表示直接预测检索式词分布,两者在概率空间混合。训练时仍需构建 kNN 数据库、离线检索并缓存监督,部署时则无需访问该数据库。
真正的设计重点是改变记忆分支的监督任务:它既学习真实下一词,也学习邻近上下文提供的软标签分布,而不是再训练一个普通语言模型。记忆分支没有注意力和跨位置混合,但输入向量已经由 Transformer 编码了上下文。它是离线训练的语料知识模块,而非推理中不断写入的对话记忆。
主要证据是:Mistral 五项 QA 平均分从 32.12 升至 36.06(+3.94 分,相对 +12.3%);九项一般 NLP 任务平均分从 67.86 升至 73.07(+5.21 分);图 1 中首 token 延迟从 RAG 的 67 ms 降至 27 ms。收益并不意味着所有任务上都胜过 RAG;例如 Mistral 的 HotpotQA,RAG 为 29.77,MLP Memory 为 24.14。HaluEval 衡量的是幻觉识别准确率,且 v4 的主表与附录存在列值冲突,须分别阅读。
结构地图
| 原文章节 | 论证作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 提出效率、知识利用与遗忘的取舍 | pp. 1–4,图 1–3 |
| 2 Preliminary: k-nearest neighbors language model | 检索库及词分布插值 | p. 4,式 (1)–(3) |
| 3 MLP Memory:3.1 Architecture、3.2 Training、3.3 Inference | 独立 MLP、软目标训练及概率融合 | pp. 5–7,图 4、式 (4)–(7) |
| 4 Experimental Setup | 数据、骨干、训练预算和基线 | p. 7 |
| 5 Experimental Results:5.1–5.5 | Scaling、QA、一般 NLP、HaluEval、消融 | pp. 8–11,图 5–6、表 1–3 |
| 6 Related Work;7 Conclusion | 与检索、记忆模型和全 MLP 联系 | p. 12 |
| A–C | 实现、插值敏感性及计算量 | pp. 18–20,表 4–6、式 (10) |
| D–F | 输出分布、教师来源及邻居数 | pp. 20–23,图 7–8、表 7–9 |
| G–J | 案例、token 概率、结构和记忆容量 | pp. 23–27,图 9–12、表 10–13 |
一:动机——为什么要把检索学进一个网络
RAG 先检索文档,再把文档放进上下文。它可以即时读取外部材料,却增加检索和长上下文预填充的成本;检索到了正确材料,也可能因干扰信息而答错。kNN-LM 更细粒度:直接根据隐藏向量检索训练 token 的邻居,对邻居的后继词投票。代价是保存大量高维向量,并在生成每个 token 时搜索。
继续预训练(CPT)和 LoRA 将新语料写入模型权重,部署直接,但作者担心领域学习会损害原有能力。MLP Memory 把新增学习放在独立分支,在主要部署实验中保持骨干参数不变。这个结构避免了直接覆盖骨干权重,输出仍会受到混合系数影响,因此验证集选择插值强度是实际方法的一部分。
作者将语言处理与记忆分工联系到神经科学;支撑算法的是检索蒸馏与任务实验,脑区类比不是方法有效性的证据。与扩展上下文窗口的 memory tokens 不同,这里的“长期”指训练语料的信息保存在固定参数中。
二:方法——从 kNN 软标签到 MLP 词分布
2.1 教师是什么:kNN-LM
设上下文为 $c_t=(w_1,\ldots,w_{t-1})$,真实下一词为 $w_t$,骨干在选定层的上下文编码为 $f(c_t)\in\mathbb R^d$。训练语料构成键值库(式 (2),p. 4):
键是上下文表示,值是实际下一 token。检索查询 $q=f(c)$ 的邻居集合 $\mathcal N$ 后,对同一个候选词的邻居权重相加(式 (3)):
这是把原文比例式写成归一化形式。$d$ 通常是平方欧氏距离;候选 token 没有出现在邻居中时,其检索概率为零。原文此式未显式写温度;实验基线 kNN-LM 另给出 $\tau=10$,不能把这个基线配置直接视为所有训练目标的温度。
2.2 学生是什么:没有 token mixing 的记忆分支
MLP Memory 学习映射 $\mathcal M:\mathbb R^d\to\mathbb R^{|V|}$,经 softmax 输出 $p_{MLP}(\cdot\mid c)$。每个位置只需处理一个向量,所以不再设置注意力层。图中包含堆叠的前馈、残差与归一化;上下文交互由骨干完成,MLP 在已经编码的表示上做知识映射。
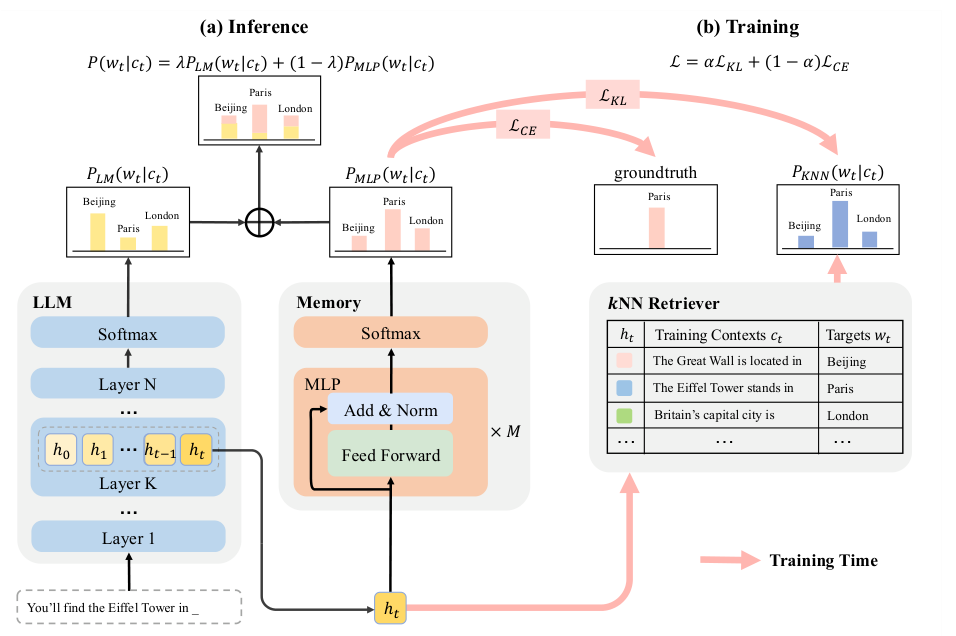
原图 4,PDF p. 5。左侧是部署:骨干中间层向量分给记忆网络,两路输出在词表上混合;右侧粉色路径仅在训练构造监督时需要。注意:图中写成 $\lambda p_{LM}+(1-\lambda)p_{MLP}$,与正文式 (7) 的权重定义相反。本文统一采用正文定义,$\lambda$ 为记忆权重。
Llama2/Mistral 实验使用各自原模型的 MLP 模块初始化,堆叠 8 层,隐藏维 4096,中间维分别为 11008、14336(附录 I、表 11,pp. 26–27)。作者约称 1B 参数,且明确排除 embedding 参数;不应将这理解为每种配置连输出头都精确为 1B。
2.3 离线训练:邻居软标签与真实标签共同约束
先固定骨干,遍历语料收集上下文表示和下一词;再对训练查询做检索,排除查询自身,避免直接查回自己而把目标退化为真实词的近似 one-hot;最后缓存 $(f(c_t),p_{kNN}(\cdot\mid c_t))$ 对,训练 MLP。
原文式 (4)–(6),p. 6:
KL 的方向是教师到学生:鼓励学生覆盖教师分配概率的后继词;CE 则纠正邻居标签与当前真实后继词的偏差。$\alpha$ 是训练损失权重,与推理权重 $\lambda$ 不同。
一个有用的教学推导:固定教师时,去掉与学生无关的教师熵项,该目标等价于用混合标签 $\tilde p(y)=\alpha p_{kNN}(y)+(1-\alpha)\mathbb I[y=w_t]$ 做交叉熵。因此,网络不是必须精确复制检索器;它还保留了 60% 的真实词监督。举例而言,若检索器给 Paris 0.5、London 0.3、Beijing 0.2,真实词为 Paris,则 $\alpha=0.4$ 时混合训练标签为 0.8、0.12、0.08。此例是教学构造,非论文实验。
2.4 推理:输出概率融合
正文式 (7),p. 7:
这在 softmax 之后做线性混合,与平均 logits 不等价。$\lambda=0$ 退回原骨干,$\lambda=1$ 只使用记忆分支;论文按各任务验证集调参。部署不再使用检索库,但仍运行完整骨干和额外 MLP。固定模块规模后,分支计算不随原语料 token 数增长;增加语料并不自动保证同容量网络能保持压缩质量。
结构可微允许未来联合优化,但主要实验的训练过程是骨干与记忆分支分别训练,不能把“可微”直接读成已验证联合训练的收益。语料知识更新也需要重新训练或调整参数,无法像检索库一样只替换文档即可即时生效。
三:实验——每组比较实际在衡量什么
| 实验 | 数据与模型 | 比较和指标 |
|---|---|---|
| Scaling | WikiText-103 约 100M token;Web 混合语料约 600M;GPT2-small/medium/large/xl | 对照继续训练 GPT-2;横轴计骨干+记忆总参数;测试 PPL 越低越好 |
| QA | Wikipedia-2021;Llama2-7B、Mistral-7B-v0.3,各配独立约 1B 记忆 | NQ/WebQA/TriviaQA/HotpotQA 用 EM;TruthfulQA 用 MC1/MC2/MC3 平均;得分越高越好 |
| 一般 NLP | Mistral;WikiText、Amazon Reviews、CC-NEWS、IMDB 混合库 | 9 项分类/蕴含任务;用 domain-conditional PMI 评分选择类别,报告分类表现 |
| HaluEval | 直接复用 QA 训练的记忆;Dialogue、QA、Summarization | 判断生成内容中的事实错误,报告识别 accuracy,不是自由生成幻觉率 |
| 消融 | 三种 GPT-2 规模,WikiText-103 | 损失配比、接入层、记忆大小、教师质量、邻居数 |
实现使用 32 张 A800 80GB。正文称各实验训练预算相当于训练 7B 模型 1 epoch;附录 A 列出记忆训练为 AdamW、学习率 $4\times10^{-4}$、linear scheduler、warmup 0.03、5 epochs、每卡 batch 4、梯度累积 4、最多 33M samples(p. 18,表 4)。预算表述没有细分离线建库和检索的成本,不能据此断言整个方法从数据到成品的训练成本与基线严格相同。
对照方法的角色不同:RAG 用 BGE 检索 top-5 文档,测试显式文档增强;kNN-LM 用 $\lambda=0.1,\tau=10$,测试 token 级检索;CPT 更新全部权重;LoRA 作用于 Q/K/V 和 MLP 层,调 rank 以匹配记忆模块参数量。MLP Memory 的 $\lambda$ 则按任务验证集选择,属于比较时应保留的调参条件。QA 各方法使用同一 Wikipedia-2021,但新增参数、推理上下文与训练方式不相同。
四:结果——收益、机制证据与具体边界
4.1 Scaling:17.5% 和 24.1% 指的是指数改善
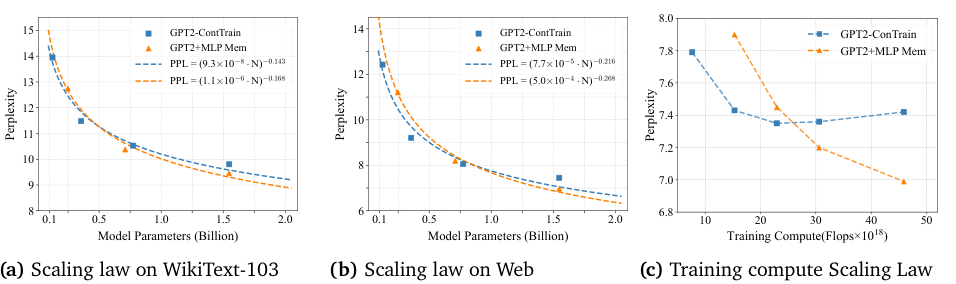
原图 5,PDF p. 8。左、中图横轴是总参数量(B),纵轴是 PPL;虚线是幂律拟合。右图固定在 GPT2-xl 对应规模,横轴训练 FLOPs,纵轴 PPL,观察更多计算是否仍带来收益。
论文拟合 $PPL=(\beta N)^\gamma$,得到:
| 数据 | Decoder-only 的 $\gamma$ | 骨干+记忆的 $\gamma$ | 指数绝对值相对增加 |
|---|---|---|---|
| WikiText-103 | −0.143 | −0.168 | $(0.168-0.143)/0.143=17.5\%$ |
| Web | −0.216 | −0.268 | $(0.268-0.216)/0.216=24.1\%$ |
这里的百分比不是“PPL 下降 17.5%/24.1%”,也不是 QA 增益。曲线在所测范围随参数增大下降更快;由于拟合点数量有限、语料最多 600M token,它提供该范围的经验趋势。右图中继续训练 decoder 的 PPL 后段趋平并回升,而记忆架构仍下降,支持不同监督目标能继续利用计算量的解释。(式 (8)–(9),p. 8;图 5。)
4.2 QA:平均更好,单项有分工
表 1(p. 9)的平均得分:
| 方法 | Llama2-7B | Mistral-7B-v0.3 |
|---|---|---|
| Base | 32.81 | 32.12 |
| RAG | 32.94 | 33.38 |
| kNN-LM | 33.16 | 32.57 |
| CPT | 29.66 | 30.53 |
| LoRA | 31.34 | 32.28 |
| MLP Memory | 35.38 | 36.06 |
Mistral 平均提高 3.94 分,相对提高约 12.3%;Llama2 提高 2.57 分,相对约 7.8%。平均包含 EM 与 TruthfulQA 的多选指标,是跨任务得分平均,不是把所有问答样本合并后的准确率。
| Mistral 的单项 | Base | RAG | MLP Memory | Memory 相对 Base 的绝对增益 |
|---|---|---|---|---|
| NQ | 20.63 | 22.56 | 25.20 | +4.57 |
| WebQA | 29.28 | 24.90 | 37.45 | +8.17 |
| TriviaQA | 57.65 | 54.21 | 60.99 | +3.34 |
| TruthfulQA | 32.09 | 35.47 | 32.54 | +0.45 |
| HotpotQA | 20.96 | 29.77 | 24.14 | +3.18 |
收益主要来自 NQ 和 WebQA;显式检索在 TruthfulQA、HotpotQA 更强。CPT、LoRA 虽平均较弱,但在 Mistral TriviaQA 上分别达到 61.21、61.60,超过 Memory 的 60.99。因此正文所谓它们“所有任务都下降”与表 1 不符;正确说法是出现明显的任务间退化,平均表现和稳定性不及记忆分支。灾难性遗忘是作者解释,实验没有单独剥离所有可能影响因素。
4.3 一般 NLP:九项均高于骨干,平均增加 5.21 分
表 2(p. 10)中 Memory 为 73.07,Base 为 67.86;RAG 70.79、CPT 70.58、LoRA 67.88、kNN-LM 68.50。Memory 九个任务均超过 Base,其中 HYP 55.42→64.15(+8.73)、CR 62.30→75.95(+13.65)、CB 69.64→76.79(+7.15)、RTE 59.57→64.62(+5.05)。它并非每项最高:例如 CR 的 CPT 为 82.60,RTE 的 RAG 为 66.43。
这一组使用专门的混合领域语料训练记忆,不是直接把 Wikipedia 的 QA 记忆未经变化地搬到九项任务。结果支持记忆分支可改善一般语言理解任务,同时保留原有骨干;具体诱因可能包括分布校准和领域标签偏好,不能仅从分类分数将改善全部归于事实记忆。
4.4 HaluEval:主表可重算,但与附录的任务列冲突
表 3(p. 10)按原列名给出:
| 方法 | Dialogue accuracy | QA accuracy | Summarization accuracy |
|---|---|---|---|
| Base | 57.18 | 53.99 | 50.27 |
| RAG | 59.06 | 65.09 | 未评测 |
| MLP Memory(主表) | 66.86 | 64.07 | 52.41 |
| 相对 Base 的绝对变化 | +9.68 | +10.08 | +2.14 |
主表差值算术一致,且 QA 上 RAG 高于 Memory。但附录 B、表 5(p. 19)写 Dialogue 的最佳值为 64.07,$\lambda=0.45$,QA 最佳值为 66.86,$\lambda=0.55$,两列最优值与主表正好交换。按附录计算,增益应为 Dialogue +6.89、QA +12.87;摘要的“约 10 分”与主表一致,不能同时当成附录的结果。这里保留两处证据,无法凭 v4 判定哪一组任务标签是作者本意。
附录仍明确说明插值强度影响结果:中间区间较好;$\lambda=0.9$ 时 Dialogue 49.71、Summarization 46.67,低于 Base。摘要任务 $\lambda=0.6$ 已降至 49.79,也低于 Base 50.27。因而“0.3–0.6 全部稳健改善”的宽泛表述应收窄。这组证据说明模型更善于识别给定内容的幻觉,不能直接换算成开放生成中的幻觉发生率下降。
4.5 消融:软标签有用,中后层输入较好
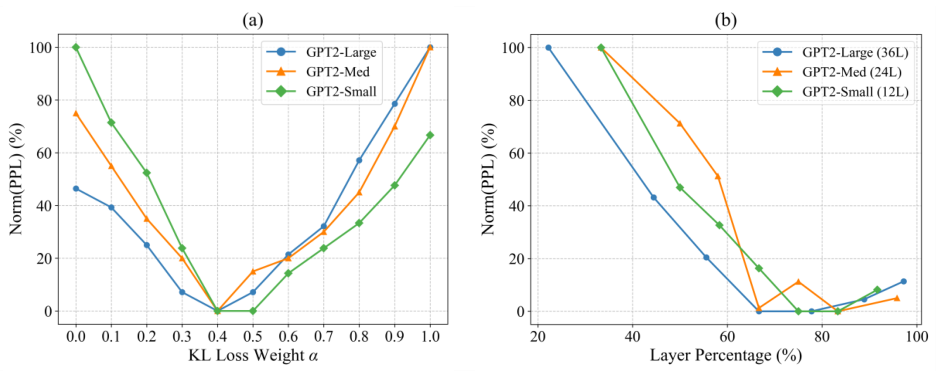
原图 6,PDF p. 11。左图横轴是 KL 权重 $\alpha$,右图是接入层的相对深度;纵轴都是每条曲线 min-max 归一化的 PPL,0 表示该曲线最好。不能跨模型把图中百分数理解为绝对 PPL 或提升百分比。
三个 GPT-2 规模均在 $\alpha\approx0.4$ 较好,纯 CE(0)和纯 KL(1)较差,支持混合监督。正文对高 $\alpha$ 的解释称“过拟合语言模型目标”,与定义相冲突:高 $\alpha$ 实际意味着更强的 kNN 监督;可靠的结论是两端均不佳,不能照抄该因果解释。
作者概括约 70% 深度的表示最佳,图中不同规模的低谷分布在约 70%–90%,不是所有模型在同一个精确百分位达到最低。相较浅层和通常使用的最终层,较深的中间表示更适合这个蒸馏映射。附录 I/J(pp. 26–27)进一步显示在 GPT2-large 上,8 层 221M Memory 将 PPL 从 15.81 降到 11.41;15 层 359M 为 11.35,36 层 772M 为 11.25。扩容有收益,但边际改善明显变小。
4.6 效率:把搜索和额外上下文移出部署
图 1(p. 1)直接读数:
| 方法 | TTFT,ms ↓ | TPS,token/s ↑ |
|---|---|---|
| Base LM (7B) | 22 | 42 |
| RAG top-5 | 67 | 24 |
| kNN-LM | 151 | 6 |
| MLP Memory(约 1B) | 27 | 36 |
RAG 与 kNN-LM 都用 Wikipedia-2021;kNN 已做 4096→256 降维。由柱值计算,RAG/Memory 的 TTFT 比约 2.48,kNN/Memory 约 5.59;Memory/RAG 的 TPS 比为 1.5,Memory/kNN 为 6。相对 Base,TTFT 增加约 23%,TPS 降低约 14%。论文的“2.5× 更快”主要对应首 token 延迟,不能笼统作为整个生成过程的统一加速比。
附录 C(pp. 19–20)用相同层数和维度的 Transformer、MLP 非 embedding FLOPs 得到 $F_t/F_m\approx1+n_{ctx}/(12d_{model})$;它说明去掉注意力的计算差异,不是“完整骨干+记忆”相对骨干的加速定理。论文约称 5B token 的 kNN 库为 40TB、1B 参数记忆为 4GB(p. 3);这是按其表示和参数存储口径的部署对比,不能理解成信息无损压缩,也不包括训练时离线建库缓存。
4.7 附录机制证据:分布锐化、教师与案例
附录 D(pp. 20–21)在 20,000 个测试样本上统计输出分布。LM 和 MLP 都给 50,257 个词非零概率,kNN 平均只有 251 个;超过 $10^{-6}$ 的 token 数分别为 1760、1151、217。累计 99% 概率需要 LM 617 个、MLP 308 个、kNN 126 个 token;累计 80% 时 MLP 仅需 13 个,反而少于 LM 的 23 和 kNN 的 22。这说明 MLP 有更集中的头部和更平滑的尾部,不能用单一“介于两者之间”描述所有阈值。
附录 E(p. 22,图 8)保持 GPT2-small 骨干和小记忆不变,更大模型构造的 kNN 目标让最终 PPL 从约 12.91 改善到 12.84,large 教师为 12.85。收益存在但较小,表明教师检索空间质量可影响学生。附录 F(pp. 22–23,表 9)考察 kNN-LM 教师自身:$k=1$ 为 10.30,1024 为 9.43,2048 为 9.42;作者据此统一选 1024。这个表不是把不同 $k$ 的 Memory 逐个训练后的学生成绩。
附录 G 的案例(pp. 23–25)展示 RAG 受到干扰、相关文档利用失败的情况;它们解释一种可能机制,不能代替总体任务比较。附录 H(p. 26,表 10)给目标 token 概率:Bradley 在 Base/kNN/Memory 下分别为 0.01/0.74/0.75,Mexico 为 0.01/0.07/0.45;功能词 in 为 0.65/0.01/0.44,and 为 0.45/0.06/0.53。个例支持记忆对稀有实体和语言连贯性的互补作用,同时 in 的 Memory 概率仍低于 Base。
五:结论——值得借鉴的任务分工
MLP Memory 的贡献在于将检索器变成离线教师,把“相似上下文有哪些合理后继词”编译成可直接前向计算的参数分支。它在输出端与骨干结合,使记忆能力可以单独训练和部署;混合软目标的推导也解释了为何最终网络能偏离检索器,取得比原 kNN-LM 更好的部分结果。
适合它的场景是语料相对稳定、可以承担离线建库和训练、推理延迟又很重要的知识增强。需要即时更新、逐条来源引用或明确删除特定文档知识时,文档检索保留了不同的操作优势。论文未展示在线写入或可靠的知识删除机制,当前参数记忆也与特定骨干的隐藏空间和词表绑定。
实验最有说服力的是跨两种 7B 骨干的平均 QA 改善、九项任务对 Base 的一致增益,以及单独列出的 TTFT/TPS 取舍。后续研究最值得检验的是:把离线建库成本计入全生命周期后何时摊平成本;新语料持续到来时怎样增量更新;在保持来源可追踪性的同时,能否根据问题动态决定使用记忆还是显式检索。HaluEval 的具体任务数值需先澄清 v4 的表格冲突。