Understanding and Improving Length Generalization in Recurrent Models:中文精读笔记
作者:Ricardo Buitrago Ruiz、Albert Gu(Carnegie Mellon University / Cartesia AI)
论文:arXiv:2507.02782v2,修订于 2025-10-12
材料获取:2026-10-12;本次研读与版本确认:2026-10-13;成品修订:r2
文件:原文 PDF · 英文汇报 PDF · 可编辑 Beamer 源文件
论文总览
循环模型能在计算上持续更新状态,却可能在超过训练长度后迅速失去预测能力。本文把这个问题解释为训练与长序列推理之间的状态分布偏移:反复从零状态开始处理短序列,使模型适应了有限的一组状态;运行得更久时,它会遇到没有充分学习过的可达状态。
作者提出“未探索状态假说”(unexplored states hypothesis),并用两类诊断与四种训练干预构成证据链。诊断包括比较完整上下文和截断上下文的输出分布,以及跟踪状态统计量;干预则逐步让初始状态接近实际运行产生的状态。最直接的状态传递(State Passing,SP)把另一条序列的终态用作当前序列的初态,计算和反向传播仍在短序列内完成。
关键结果要分开理解:
| 检验内容 | 设置与主要发现 | 原文位置 |
|---|---|---|
| 四种干预的同预算比较 | Mamba-2 370M / 780M / 1.3B,100 步后训练;SP 与 TBTT 在 32K 上表现最稳健 | Fig. 5,PDF p. 7 |
| 更长的语言建模外推 | Fig. 1 曲线延伸到约 128K;Mamba-2、GLA 使用 500 步 SP,Mamba-1 使用 1000 步 | Fig. 1,PDF p. 2 |
| 需要远距离信息的任务 | BABILong 上改善长序列准确率;780M 的 passkey 专项微调在 256K 上达到作者报告的满准确率 | Figs. 6–7,PDF pp. 9–10 |
| 复制长度外推 | 45M 模型由长度 50–100 训练到长度 300 测试,字符准确率由 $0.27$ 提高到 $0.47$ | Table 1,PDF p. 10 |
这篇论文最有价值的改变,是把“训练上下文有多长”进一步拆成“模型在训练中经历了什么状态”。其主要论证来自干预实验;非零初态的代数推导解释了实现方式,未探索状态假说本身并没有被写成带充分条件的泛化定理。
结构地图
以下均为从 1 开始的 PDF 页码,本版与印刷页码一致。
| 原文章节 | 在论证中的作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 提出循环模型的长度外推问题与总体结果 | pp. 1–3;Fig. 1 在 p. 2 |
| 2 Preliminaries | 统一状态递推、初态和符号 | p. 3;Eq. (1) |
| 3 Analyzing the Length Generalization Failure of Recurrent Models | 定义指标,研究训练条件、前缀敏感性与状态偏移 | pp. 3–6;Figs. 2–4,Eqs. (2)–(3) |
| 4 Training Interventions to Enable Length Generalization | 非零初态展开与四种干预 | pp. 7–9;Fig. 5,Eqs. (4)–(6) |
| 5 Performance of Interventions on Long Context Tasks | BABILong、passkey、synthetic copying | pp. 9–10;Figs. 6–7,Table 1 |
| 6 Related Work | 与改动状态更新机制、LongSSM 等工作的关系 | p. 11 |
| 7 Conclusion and Future Work | 归纳分布视角,提出其他架构和任务方向 | p. 11 |
| A Extended Related Work;B Training recipes | 背景与各实验训练协议 | pp. 16–17;Table 2,Fig. 8 |
| C Distribution of the State at Given Heads and Layers Over Time;D Position-wise Perplexity for RWKV-v6 | 逐头状态统计与另一种架构 | pp. 17–18;Figs. 9–10 |
| E Impact of the Warm-Up Period on Length Generalization;F Impact of the Standard Deviation on the Random Gaussian Initial State Intervention | warm-up 与噪声尺度消融 | pp. 19–20;Figs. 11–12 |
| G Ablation on the Choice of Distance for Effective Remembrance;H Derivation of SSM Equations for Non-Zero Initial State;I State Passing Pytorch Pseudocode | 距离消融、公式展开、实现细节 | pp. 20–21;Figs. 13–14 |
一:动机——能持续递推,为什么仍会在长序列上失效?
状态空间模型(state space model,SSM)与线性注意力用固定大小的状态压缩历史。对固定模型,处理长度为 $L$ 的序列所需计算随 $L$ 线性增长,流式推理保存的循环状态大小也不随 $L$ 增长。因此,从接口上看,只需继续递推就能处理超出训练长度的输入。
但状态更新和读出函数是通过有限长度数据学到的。即使每一步使用同一组参数,它收到的状态仍会随运行时间改变。图 1 的基线中,Mamba-1/2 在 2K、GLA 在 512 的训练长度之外出现困惑度上升,部分曲线快速发散。固定状态的存在只解决了计算形式,预测质量还依赖所访问的状态。
此前方法包括跳过部分 token 的状态更新、强制遗忘、调整 Mamba 的离散化,以及使用长序列训练。本文希望找到更容易迁移的训练办法:让已有架构学会处理更广的状态分布,推理时继续使用通常的模型计算。
这里需要准确归属创新。作者在 Sec. 6 明确承认,LongSSM 已讨论零初态问题,并提出过 State Passing / TBTT 预训练。因此,本文的贡献重点是状态分布解释、Effective Remembrance 诊断、不同初态分布的系统对比,以及低预算后训练和跨任务验证。(Sec. 1,PDF pp. 1–3;Sec. 6,PDF p. 11)
二:方法——从状态分布到训练干预
2.1 统一递推及其含义
原文先使用单通道形式:
| 符号 | 含义与维度 |
|---|---|
| $x_t,y_t\in\mathbb R$ | 单通道输入与输出;语言模型中的一个内部变换 |
| $h_t\in\mathbb R^N$ | 时刻 $t$ 的隐状态 |
| $A_t\in\mathbb R^{N\times N}$ | 旧状态的保留、衰减或变换 |
| $B_t,C_t\in\mathbb R^{N\times 1}$ | 将输入写入状态,以及从状态读出 |
| $h_{-1}$ | 处理第一个 token 前的初始状态 |
| $T_{\mathrm{train}}$ | 训练上下文长度 |
| $\mathcal D_t$ | 对输入序列分布取样后,运行至位置 $t$ 所诱导的状态分布 |
实际模型含多个层、头和通道,$A_t,B_t,C_t$ 的参数化及其对输入的依赖随架构变化。通常训练从 $h_{-1}=0$ 开始,等价于没有历史上下文。本文的实验证据来自 Mamba-1、Mamba-2、GLA、RWKV-v6;文中把 xLSTM 等不直接符合该形式的模型留作后续研究。(Sec. 2.2,PDF p. 3,Eq. (1))
2.2 先定义“长度泛化”
逐位置困惑度(position-wise perplexity)为:
它在同一位置跨样本平均负对数似然,再取指数;越低越好。不能把它计算成样本困惑度的算术平均。
令 $p^\star$ 为训练区间内的最低逐位置困惑度,$t^\star$ 为达到该值的位置。原文 Definition 3.2 要求:
直觉是:已拥有足够上下文后,继续增加长度不应使预测变差。这个定义比“能接受更长输入”强,但单靠它仍不能判断模型是否能检索很久以前的信息。一个只依赖近期窗口的模型也可能保持良好的语言建模困惑度,因此作者另外设置了长距离任务。(Sec. 3.1,PDF p. 4;Sec. 5,PDF p. 9)
2.3 Effective Remembrance 测量什么?
有效记忆(Effective Remembrance,EffRem)比较相同结尾的两次预测:
固定预测位置 $T$,横轴 $t$ 表示删掉多少前缀。第一次从 $x_0$ 开始运行;第二次从 $x_t$ 重新开始,只保留后缀 $x_{t:T}$。默认距离为总变差:
原文 Eq. (3) 右侧误写为 $q(x)-q(x')$;这里按其“两个分布间的总变差”定义修正为 $q(v)-q'(v)$。(Sec. 3.4,PDF p. 5,Eqs. (2)–(3))
如果很小的 $t$ 就带来很大的距离,说明即便删去很远的少量前缀,也会显著改变最后的预测。图 1 中较大的 Mamba-2 基线正表现出这种敏感性;SP 后曲线明显降低。对这些自然文本样本,这支持“早期上下文留下的状态影响破坏了后续预测”的解释。
EffRem 是整段前缀被移除后的输出敏感性,不是某一个 token 的贡献,也不是准确率。$t=0$ 时两次输入相同,距离应为零;随 $t$ 增大,值不必严格单调,也不必最终达到 1。远处如果真的包含必要信息,高敏感性可以是有用的记忆,因此它要与任务表现一起解释。
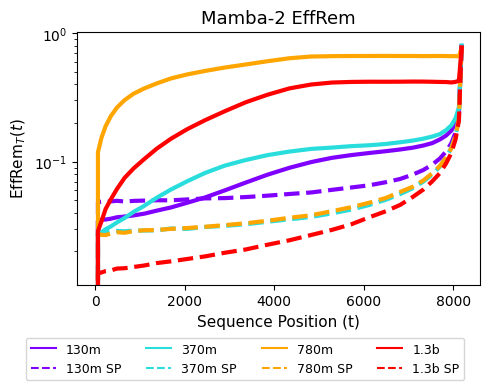
图源:原 Fig. 1(e),PDF p. 2。横轴为后缀起点 $t$,纵轴为对数刻度的 EffRem;颜色区分模型规模,实线是基线,虚线是 SP,固定 $T=8192$。780M 与 1.3B 基线在较早的 $t$ 已有很大差异,而 SP 后远前缀对输出的影响减小。
2.4 未探索状态假说
将输入序列记为随机过程 $X$,则:
从零状态、长度 $T_{\mathrm{train}}$ 的序列训练,只让模型接触 $\mathcal D_0,\ldots,\mathcal D_{T_{\mathrm{train}}-1}$。推理时却可能进入 $\mathcal D_{T_{\mathrm{train}}},\mathcal D_{T_{\mathrm{train}}+1},\ldots$。若后者与训练分布明显不同,读出和更新函数就面临分布外输入。
作者假设许多文本任务在初始部分之后,输入 token 的边际分布随位置变化较小,从而把注意力集中到状态分布。这解释了两类观察:更长训练上下文覆盖更多状态;在短上下文上训练得更久,则可能更深地适应那一小部分状态。(Sec. 3.6,PDF p. 6)
教学例子:状态方差有界也会出现这种偏移。 考虑 $h_t=a h_{t-1}+x_t$,$h_{-1}=0$,$x_t$ 独立同分布、均值为零、方差为 1,且 $|a|<1$。有
取 $a=0.99$,处理 32 个 token 后的方差只达到稳态方差的约 47.4%;处理 512 个 token 后则已接近稳态。递推本身稳定,短序列仍未覆盖长运行时的状态尺度。这个例子用于解释分布偏移,并非作者的模型拟合或实验。
2.5 非零初态为何容易接入?
定义有序乘积
空乘积为单位矩阵。展开递推得到:
对给定的 $A,B,C$ 序列,只需在零初态计算之外加入初始状态的传播项;可使用相同类型的扫描或分块计算。学习参数会随着后训练改变,但模型不需要在推理时额外采样噪声或保存其他文档的状态。(Sec. 4.1,PDF p. 7,Eq. (4))
有两个实现细节直接影响公式是否正确。首先,一般矩阵不可交换,必须保持上述时间顺序;原附录 H 的中间展开交换了乘法次序,不能照搬到一般稠密矩阵。其次,附录 I 的伪代码只适用于对角转移,其 $\exp(\operatorname{cumsum}(A))$ 运算要求代码中的量应理解为转移系数的对数或相应的离散化指数,而不能直接塞入 Eq. (1) 的离散转移矩阵。该函数返回的是完整终态及“初态对输出的增量”,后者还需加回零初态的输出。(Appendices H–I,PDF pp. 20–21)
2.6 四种初态分布
| 干预 | 初态从哪里来 | 保留的结构 | 实验中的关键区别 |
|---|---|---|---|
| Random Noise | 每个元素独立取 $\mathcal N(0,\sigma^2)$ | 统一尺度 | 需要调 $\sigma$,没有层/头差异 |
| Fitted Noise | 每层每头拟合均值、方差后独立采样 | 层/头的边际统计 | 不保留状态元素之间的相关性 |
| State Passing | 随机打乱序列后,传递上一批的终态 | 实际运行产生的完整状态结构 | 来源序列与当前序列不要求连续 |
| TBTT | 同一长序列的上一块终态 | 状态结构及真实上下文连续性 | 数据加载器必须维持块间顺序 |
拟合噪声(Fitted Noise)。 对每层 $l$、每头 $i$ 的终态统计做动态更新:
均值和方差在该头的通道维与状态扩展维 $N$ 上计算,再用对应高斯分布独立采样初态。这里新统计量权重是 0.9,历史权重是 0.1,应按原公式理解,而不是套用另一种常见的 EMA 参数约定。高斯初态只用于训练,验证从零开始;原文指出验证时加噪声会损害最初 token 的预测。(Sec. 4.2–4.3,PDF pp. 7–8,Eqs. (5)–(6))
状态传递(SP)。 利用打乱后上一批序列的终态作为下一批初态,并以 $p=0.1$ 的概率把状态清零,以保留从无历史开始预测的能力。下面是教学性的训练流程,强调跨批次状态与梯度的区别:
state = 0
for each shuffled batch x:
    initial = optionally_zero(state, probability=0.1)
    predictions, final = model(x, initial_state=initial)
    update_parameters(loss(predictions, targets))
    state = stop_gradient(final)
它让后续短序列的计算从不同的实际状态出发。跨批次保留前向状态,并不要求反向图跨所有历史批次展开。不断传递与偶尔重置,也使训练不再局限于每次刚从零出发的一段轨迹。具体张量需要为每层、每头和 batch 槽位维护对应的状态。(Sec. 4.4,PDF p. 8)
截断时间反向传播(TBTT,沿用原文缩写)。 将一条长序列分块,下一块接收上一块终态,块边界切断梯度。它与 SP 的关键差别是前向上下文是否连续。两者相近的 Pile 结果说明,在这些实验中,获得合适的初态分布本身就很有帮助,并不总要使用真实连续的长文档。(Sec. 4.5,PDF p. 9)
三:实验——每组对照在回答什么问题?
3.1 语言建模与诊断协议
主要语料为 The Pile。作者从头训练的模型使用 GPT-NeoX-20B tokenizer;附录 B.1 给出的训练配方包括每批约 0.5M tokens、Adam 的 $(\beta_1,\beta_2)=(0.9,0.95)$、梯度裁剪 1.0、余弦学习率调度、10% warm-up、最低学习率 $10^{-5}$、RMSNorm,以及无 linear bias。模型规模对应不同峰值学习率。(Appendix B.1 / Table 2,PDF p. 16)
需要按实验分别使用配置:Fig. 2 主动改变训练上下文,不能把附录的默认 Mamba 2048 / GLA 512 套到所有曲线上。Fig. 2 的 Mamba-2 45M、85M、125M 分别使用 22.5B、34B、25B tokens;GLA 70M 使用 34B tokens。Fig. 3 则固定 Mamba-2 85M、上下文 1024,只比较训练中间检查点。
后训练四种干预使用同一基本配方,峰值学习率降为表中对应值的十分之一。Fig. 5 的共同预算是 100 步;Fig. 1 的长曲线另外使用 500 / 1000 步。文中的“约 0.02% / 0.1% 预训练预算”是相应后训练设置的量级,不能套用到全部下游实验。
| 指标或对照 | 检验的问题 | 解读方式 |
|---|---|---|
| 逐位置 PPL | 超过训练长度后,预测质量是否变坏? | 越低越好;看转折位置与长区间走势 |
| EffRem | 远前缀是否显著改变当前输出? | 距离大小表示敏感性,不代表答案对错 |
| 状态统计量 | 超过训练长度后,所访问状态是否改变? | 看随位置的变化及层/头差异 |
| 四种非零初态 | 状态的真实性与结构是否影响干预效果? | 在同样 100 步预算下比较 |
| Base / SP / TBTT | 连续长文档是否是必要条件? | SP 打乱序列,TBTT 保持块顺序 |
3.2 下游任务的训练设置
| 任务 | 模型与训练 | 比较组 | 测试指标 |
|---|---|---|---|
| BABILong | Mamba-2 780M;训练/任务微调上下文 2048;qa1–qa10;任务微调 1 epoch | 官方 Base、先在 Pile 上 SP、先在 Pile 上 TBTT;分别 few-shot 与任务微调评测 | 准确率,越高越好 |
| Passkey retrieval | Mamba-2 370M / 780M;上下文 2048;专项微调 1000 步;峰值学习率为表中十分之一 | 零样本、普通微调、拟合噪声微调 | 按序列长度和 passkey 深度展示的检索准确率 |
| Synthetic copying | Mamba-2 45M 随机初始化;100 万条长度 50–100 的训练序列 | 普通训练、SP 训练 | 在长度 300 上的字符准确率 |
BABILong 的第二阶段任务微调对所有组都不再使用 SP 或 TBTT,因此结果检验的是先前学到的能力能否保留。Passkey 微调仅对 passkey 对应 token 计算损失;每样本随机化埋入深度,并在答案后加句号以减少重复输出。(Appendices B.3–B.4,PDF p. 17)
四:结果——证据怎样支持状态分布解释?
4.1 短上下文与持续训练共同暴露外推问题
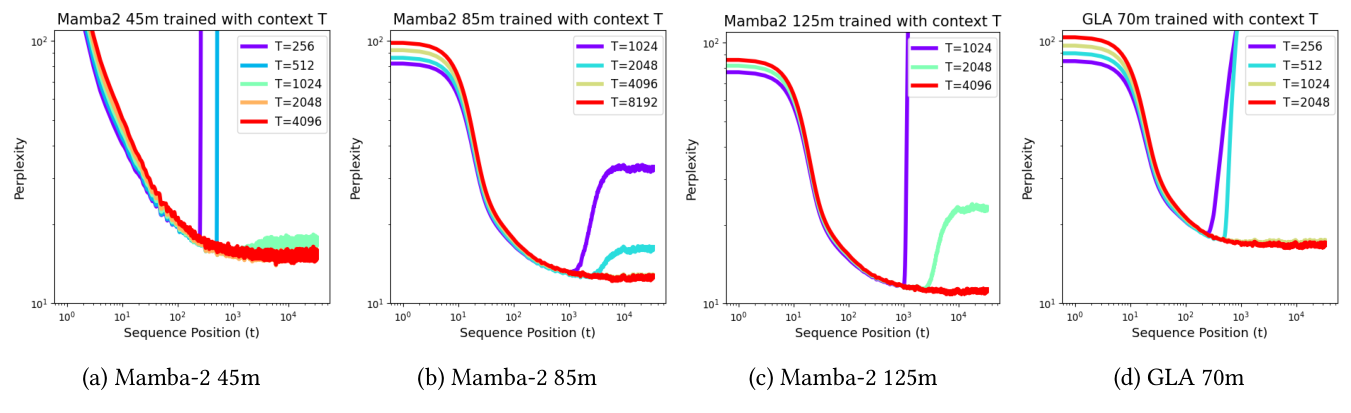
图源:原 Fig. 2,PDF p. 4。四个面板分别是 Mamba-2 45M、85M、125M、GLA 70M;颜色是训练上下文长度,横轴为对数刻度的测试位置,纵轴为 PPL。较短上下文的曲线在进入长序列后上升,而足够长上下文的曲线更稳定。例如 125M 的 $T=1024$ 明显失效,$T=2048$ 后期仍上升,$T=4096$ 更稳定。
同一模型在相同 token 预算下,仅改变序列分块长度就会改变外推行为。这支持状态经历对泛化的作用。不同规模模型的 token 预算也不同,因此图中的“更大模型往往需要更长上下文”应理解为这些设置下的观察。
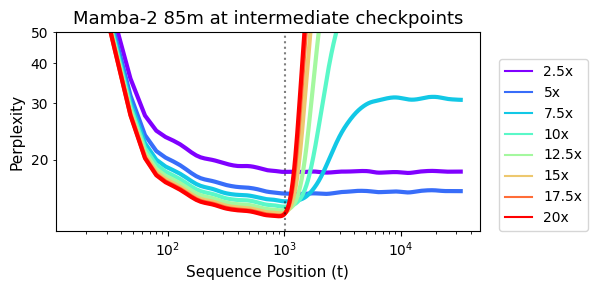
图源:原 Fig. 3,PDF p. 4。固定 Mamba-2 85M 与 $T=1024$,检查点覆盖 4.25B–34B tokens,图例是相对 Chinchilla 配额的倍数。随着训练进行,训练长度内 PPL 改善,长度外却逐渐上升;约在 7.5 倍配额附近开始出现明显退化,后续更严重。原文正文与图注对“至少 / 超过 7.5 倍”的措辞略有差别,曲线更适合支撑这一趋势,而非精确通用阈值。(Secs. 3.2–3.3,PDF pp. 4–5)
4.2 异常来自随位置变化的状态,而非统一的“大状态”
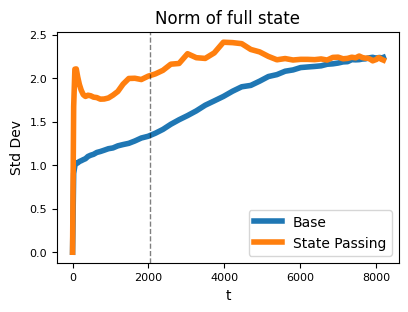
图源:原 Fig. 4,PDF p. 6。横轴为位置 $t$,竖虚线对应训练长度 2048;蓝色为 Base,橙色为 SP。基线状态统计量在训练区间之后继续升高,SP 则更早进入较稳定的范围,而且很多位置上 SP 的数值比基线更大。
原图标题和正文使用“norm”,纵轴及图注又使用“Std Dev”。因此,这里将它作为状态尺度随位置变化的诊断,不把它解释成定义清楚的全状态 L2 范数。图 9 的逐头分析提供了更具体的证据:
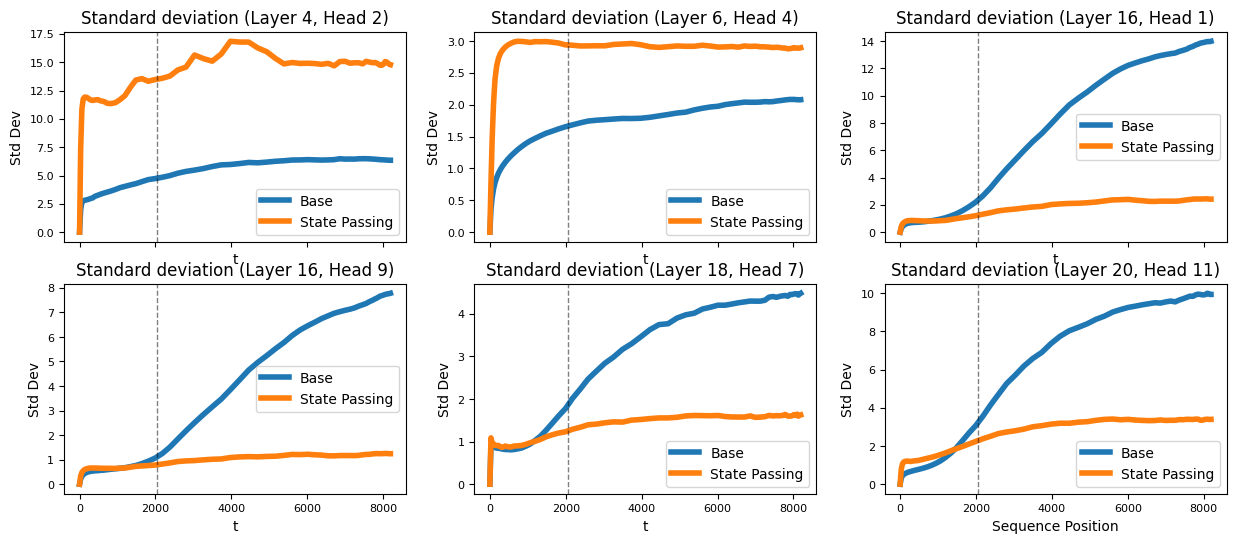
图源:原 Fig. 9,PDF p. 18。六个面板是作者挑选的变化较明显的层/头。SP 抑制了部分头在长序列上的持续增长,同时 Layer 4 / Head 2、Layer 6 / Head 4 的标准差比原模型更高。多数其他头没有这种异常。因此,证据支持关注分布相对训练阶段如何改变,而不是一律压小状态数值。(Sec. 3.5,PDF p. 6;Appendix C,PDF pp. 17–18)
4.3 100 步对照:初态接近真实运行状态时效果更好
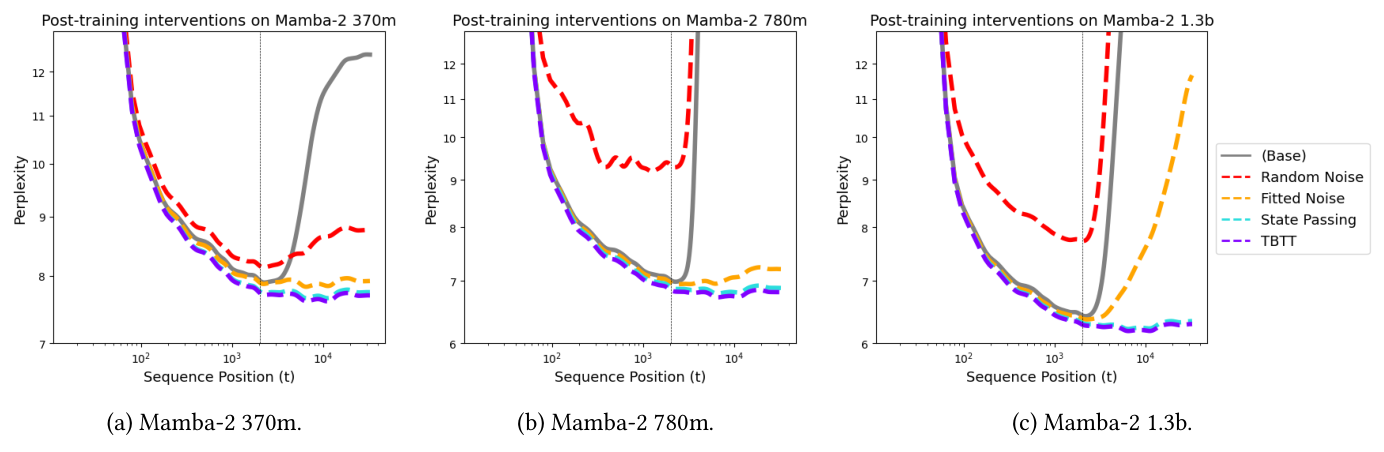
图源:原 Fig. 5,PDF p. 7。横轴为位置,纵轴为 PPL,三个面板分别对应 370M、780M、1.3B。灰色是 Base;红色、橙色、青色、紫色虚线分别是 Random Noise、Fitted Noise、SP、TBTT。所有干预均训练 100 步,测试到 32K。
| 干预 | 370M | 780M | 1.3B |
|---|---|---|---|
| 统一高斯噪声 | 有限改善 | 未修复长位置失效 | 未修复长位置失效 |
| 分层分头拟合噪声 | 明显改善 | 明显改善 | 长位置仍明显上升 |
| SP | 长位置 PPL 稳定得多 | 长位置 PPL 稳定得多 | 长位置 PPL 稳定得多 |
| TBTT | 与 SP 接近 | 与 SP 接近 | 与 SP 接近 |
两组差异尤其重要。第一,任意加噪声并不足够,拟合边际统计量明显更好。第二,1.3B 上独立高斯采样仍失败,而完整终态传递成功。作者据此推测,大模型状态的相关结构更重要。这是与实验一致的解释,文中没有直接测量这些相关性。
SP 与 TBTT 接近,则使“只是因为读到了真实连续长文档”难以成为唯一解释:SP 用的是另一条随机序列的终态,也能起作用。(Secs. 4.2–4.5,PDF pp. 7–9)
4.4 更长测试与其他架构
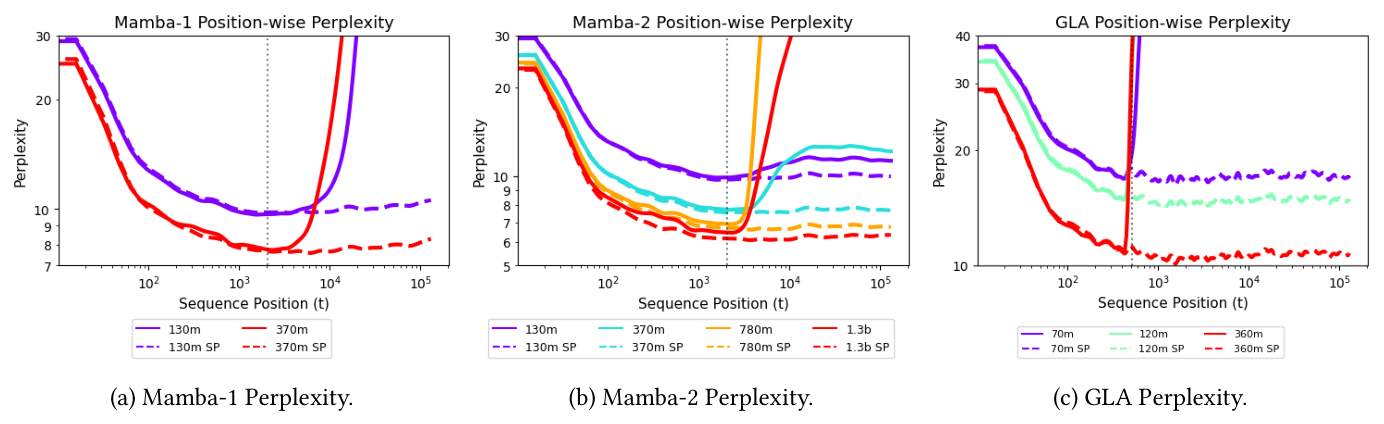
图源:原 Fig. 1 上排,PDF p. 2。实线为基线,虚线为 SP;从左至右为 Mamba-1、Mamba-2、GLA。后训练明显缓解长位置上的 PPL 退化,图中测试扩展到约 128K。各曲线仍可能有缓慢变化,原文的严格定义与带有估计波动的实验曲线应区分理解。
| 证据 | 训练上下文 | 干预预算 | 长度范围 / 说明 |
|---|---|---|---|
| Fig. 5:Mamba-2 三种规模 | 2048 | 100 步 | 测试到 32K |
| Fig. 1:Mamba-2 | 2048 | 500 步 SP | 曲线到约 128K |
| Fig. 1:Mamba-1 | 2048 | 1000 步 SP | 曲线到约 128K |
| Fig. 1:GLA | 512 | 500 步 SP | 曲线到约 128K |
| Fig. 10:RWKV-v6 70M | 256 | 250M tokens SP | 预训练为 35B tokens;长位置退化显著缓解 |
RWKV-v6 的后训练 token 数约为其预训练的 $250\mathrm M/35\mathrm B\approx0.71\%$,这是按原图注计算的比例,和摘要中的约 0.1% 不是同一设置。(Appendix D,PDF pp. 17–18,Fig. 10)
在 EffRem 上,SP 后不同架构也没有变成同一种“记忆窗口”。GLA 对超过约 512 距离的前缀影响较小,在更近区域迅速变得敏感;Mamba 的变化较平缓。这提示,相同训练干预可以修复分布偏移,同时保留不同架构的上下文利用特点。(Fig. 1 下排;Sec. 4.4,PDF p. 8)
4.5 BABILong:改进长文档任务,但准确率仍随长度下降
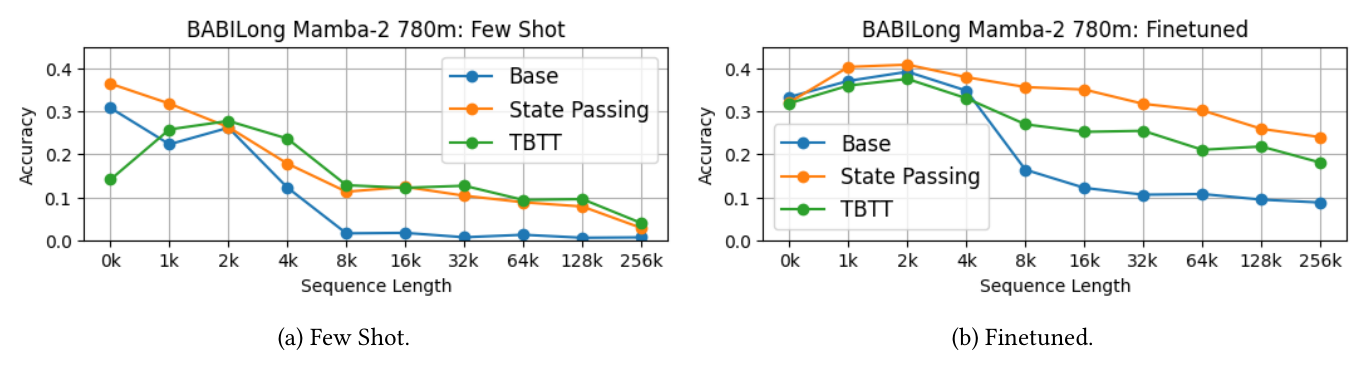
图源:原 Fig. 6,PDF p. 9。横轴是序列长度,纵轴是准确率;蓝、橙、绿分别是 Base、SP、TBTT。左图为 few-shot,右图为任务微调,均使用 Mamba-2 780M。
Few-shot 的基线在 8K 后接近零,SP / TBTT 延缓了下降;但到 256K 时三者的绝对准确率都很低。任务微调后的结果更有代表性:SP 在长区间优于 Base 和 TBTT,256K 时按曲线目测约为 0.24,TBTT 约为 0.18,Base 约为 0.09。这里是读图近似值,并非原文提供的精确数据表。
这个实验说明,Pile 上的初态干预能带来下游收益,而且随后在 2K 数据上进行普通任务微调并没有完全抹去它。与此同时,“测试到 256K”表示在该长度上观察到改善,并不表示长文档推理已经接近满准确率。(Sec. 5.1,PDF p. 9;Appendix B.3,PDF p. 17)
4.6 Passkey:使用拟合噪声,780M 在 256K 上达到满准确率
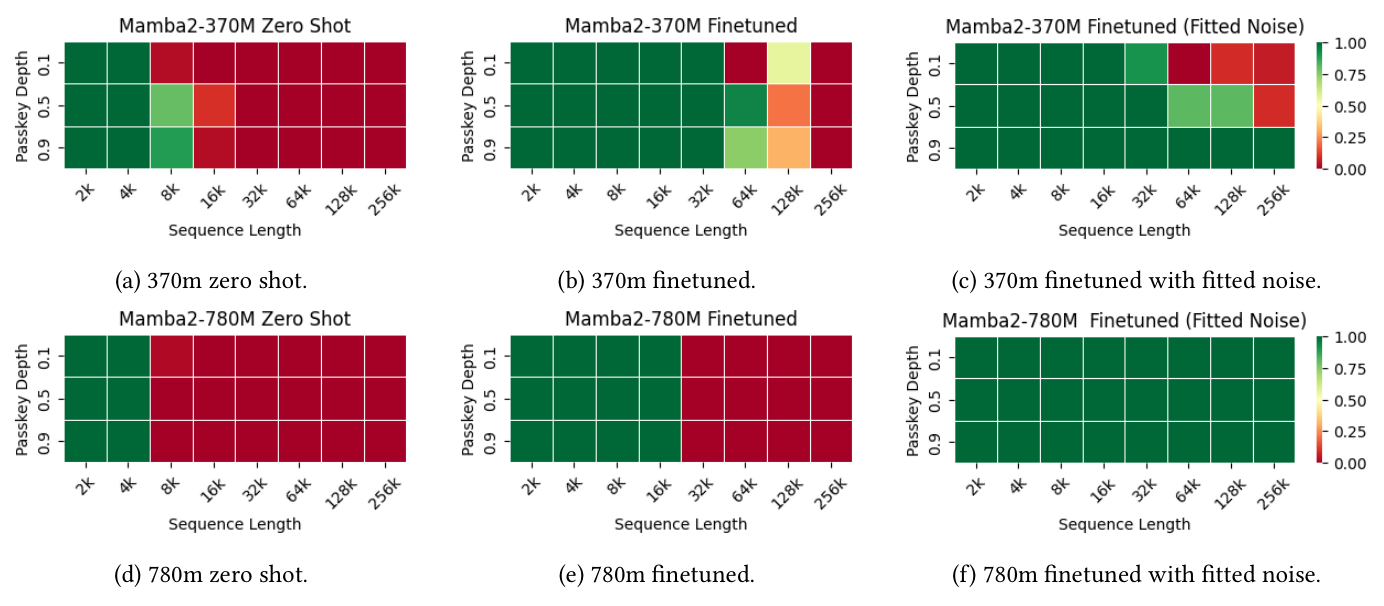
图源:原 Fig. 7,PDF p. 10。上排为 370M,下排为 780M;三列为 zero-shot、普通微调、拟合噪声微调。横轴是 2K–256K 的输入长度,纵轴是 passkey 埋入深度,颜色从红色 0 到绿色 1。
任务要求在填充文本中记住一个 passkey,并在结尾输出。相比普通 2K 微调,拟合噪声在同样 2K 长度上训练能把成功检索范围继续推远;780M 的右下图在全部展示深度与长度上均为满准确率,正文明确报告 256K 结果。370M 也改善,但越长、埋入越早时仍出现失败。这说明修复效果与模型及任务配置有关。
为什么这里不用 SP? Passkey 的输入结构明显不平稳:序列结尾刚输出过答案,其终态未必适合充当下一条样本的初态。拟合噪声保留状态尺度信息,同时不原样携带上一条任务的答案相关状态。这个选择揭示了“真实终态”也必须考虑它与下一段输入是否相容。(Sec. 5.2,PDF p. 10;Appendix B.4,PDF p. 17)
正文将任务描述为五位 passkey,而附录 Fig. 8 的示例使用四位数;这里沿用正文任务描述,不把该示例当成精确生成规则。正文指向 Fig. 8 的结果引用也有编号错位,性能热图实际是 Fig. 7。
4.7 Synthetic copying:较难外推上的局部成功
| 方法 | 长度 300 上的字符准确率 |
|---|---|
| Mamba-2 | $0.27\pm0.03$ |
| Mamba-2 + SP | $0.47\pm0.11$ |
来源:原 Table 1,PDF p. 10。两组都是随机初始化的 45M 模型,训练数据为 100 万条长度 50–100 的序列;测试长度是训练最大长度的 3 倍。按表中中心值计算,SP 带来 20 个百分点提升,而不是“20% 相对提升”。
这里衡量的是逐字符准确率,并非整串完全复制成功率;0.47 也表明任务尚未解决。原文没有说明“$\pm$”的统计定义或重复次数,因此不能据此宣称显著性。它提供的是 SP 能改善更难长度上的复制行为的证据。(Sec. 5.3,PDF p. 10)
4.8 补充消融如何完善主线?
| 消融 | 设置与发现 | 对主线的作用 |
|---|---|---|
| warm-up 长度 | Mamba-2 45M,$T=1024$,9B tokens;25% warm-up 的长度外 PPL 比 10% 更差 | 相同架构的外推表现还受训练配方影响 |
| 统一噪声尺度 | 125M,100 步;较大 $\sigma$ 会抬高 PPL,过小噪声也可能不足以修复 | 扩大状态范围必须兼顾与真实运行的相容性 |
| EffRem 距离选择 | Mamba-2,$T=8192$;TV、Jensen–Shannon 形式、$1-\cos$ 的曲线趋势相似 | 输出敏感性的主要观察不依赖单一距离 |
来源:Appendices E–G,Figs. 11–13,PDF pp. 19–20。Fig. 12 图轴为 PPL,按该指标解读;附录正文一次称为 cross entropy。Jensen–Shannon 在正文与图注分别称 distance / divergence,缺少实现细节时不混用其绝对数值。$1-\cos$ 也不是严格的度量。
五:结论——怎样理解这项贡献?
5.1 可以从证据中带走的结论
本文给出了一条连贯的解释链:短上下文零初态训练限定状态经历;长运行暴露新的状态分布;具有实际状态结构的初态干预能够用很少后训练缓解失效。SP 的价值在于它直接复用模型已经产生的状态,数据组织简单;TBTT 保留连续上下文,但需要更严格的块顺序;拟合噪声更方便控制初态,却只保留部分统计信息。
长任务补上了语言建模指标的不足。Passkey 展示了超出训练长度的实际检索,BABILong 展示了下游推理收益,copying 展示了算法性任务的改进。三个任务的绝对成功程度不同,因此评价一种循环模型时,应同时看稳定预测、远距离检索和更复杂的任务能力。
5.2 哪些限制会改变实践判断?
基线的继续训练预算并不对齐。 Fig. 5 的四种干预各训练 100 步,但 Base 是原始官方检查点,图中没有同样 100 步、保持零初态的普通继续训练对照。因此,四种初态方案之间的差异更直接检验状态分布设计;SP 相对 Base 的全部收益不能单独归因于状态传递操作。
状态统计稳定只是间接证据。 少数均值、标准差或尺度稳定,不能确定高维状态分布已经一致。1.3B 的 fitted-noise 失败尤其提示,边际统计量不足以描述全部结构。后续若要验证机制,可直接比较更多状态分布特征,并与任务错误关联。
初态必须与输入阶段相容。 作者以输入分布随位置变化较小来支撑状态视角;passkey 的方法选择正好说明结构化、分阶段任务需要额外考虑。进一步说,决定预测的是状态和输入的联合分布,不能只要求某个状态本身“在模型里出现过”。这是由本文结果引出的分析。
泛化修复不会自动增加状态容量。 递推更稳定有助于利用已有表示能力,但复杂检索或精确复制仍受有限状态、模型训练与任务结构约束。这里的 256K passkey 满分,不能直接替代对多事实推理或整串复制能力的评估。
对循环架构研究最直接的启发是:观察到长度外崩溃时,可以先检验训练时的状态覆盖,而不急于把失败归因于架构无法处理长序列。本文支持把初态分布作为一个明确的训练设计变量;是否适用于其他数据分布、S4、混合模型和不满足本文递推形式的架构,仍是作者提出的后续方向。(Sec. 7,PDF p. 11)