DSLA / DSLA-Serve:双状态线性注意力与动态逐层转换
论文:On-the-Fly Adaptive Distillation of Transformer to Dual-State Linear Attention。PDF 题名另含副标题 for Long-Context LLM Serving。
作者:Yeonju Ro、Zhenyu Zhang、Souvik Kundu、Zhangyang Wang、Aditya Akella。
版本:arXiv:2506.09316v3,2025-06-17;获取与研读日期:2026-10-08。
材料:arXiv · 本地原文 PDF · 作者代码入口 · 英文汇报 PDF · 可编辑 TeX。下文页码均为原文 PDF 页码。
论文总览
这篇论文把两个问题联系起来:线性注意力怎样减少遗忘较早的 token,以及服务系统怎样在显存吃紧时降低注意力成本。前者由 **双状态线性注意力(Dual-State Linear Attention,DSLA)**解决:两个状态共享当前 key/value 写入,使用不同的遗忘门,并以逐层学习的权重混合;后者由 DSLA-Serve 处理:离线准备替代模块,按敏感度排序和链式微调,在推理时选择替换多少层。
最重要的区分是:训练发生在离线,在线执行的是已训练模块的转换与调度。标题中的 “on-the-fly” 不能理解为每个服务请求都触发反向传播。附录 A 和图 8 对离线蒸馏、在线服务的划分很明确。
实验呈现出一个有用但有代价的折中。Llama2-7B 替换 25% 层后,HotpotQA 从 5.63 到 11.07,2WikiMQA 从 10.24 到 14.20,但代码补全和部分短任务下降;替换 50% 时下降更大。在增强版 Azure 轨迹回放中,按长度设定转换上限,端到端按 token 归一化的平均延迟从 93.64 ms 降至 40.83 ms,即 2.29 倍加速、约 56.4% 延迟降低。这组系统结果与静态 25%/50% 模型的质量评测要分别理解。(Sec. 5.1–5.4,pp. 6–7,Tables 1–4。)
结构地图
| 原文章节 | 论证作用 | PDF 页码与关键定位 |
|---|---|---|
| 1. Introduction | 长上下文成本、静态混合模型的不足、贡献 | pp. 1–2 |
| 2. Background | 线性注意力、GLA、蒸馏与混合架构 | p. 2 |
| 3. Motivational Analyses | 近期偏置与服务负载不均 | pp. 2–3;Figs. 1–2,Eqs. (1)–(3) |
| 4.1 Dual-State Linear Attention (DSLA) | 双状态递推与输出混合 | pp. 3–4;Eqs. (4)–(8) |
| 4.2 Specializing the Two Hidden States | 教师对齐与门控差异化 | p. 4;Eqs. (9)–(10) |
| 4.3 Adaptive Layer-wise Conversion with DSLA-Serve | 敏感度排序、资源与质量约束 | pp. 4–5;Eq. (11) |
| 4.4 Chained Fine-Tuning for Seamless Conversion | 使训练结构匹配逐步替换结构 | p. 5;Fig. 3 |
| 4.5 Batched Inference Considerations | 混合请求的分批与合批 | pp. 5–6 |
| 5.1 Long-Context Understanding | QA、代码、少样本、困惑度和摘要 | pp. 6–7;Tables 1–2 |
| 5.2 Short-Context Benchmarks | 七项短上下文任务 | pp. 6–7;Table 3 |
| 5.3 Inference Efficiency | 预填充、解码、KV 成本 | pp. 6–7;Fig. 4 |
| 5.4 End-to-end System Performance | 动态服务回放 | p. 7;Table 4 |
| 5.5 Further Investigation and Ablation Studies | 状态分工、状态数、敏感度、跨模型比较和局限 | pp. 8–9;Figs. 5–7,Tables 5–8 |
| 6. Conclusion | 方法与系统贡献 | p. 9 |
| A–B. System Overview / Detailed Experimental Setup | 离线与在线流程、训练和硬件细节 | p. 14;Fig. 8 |
| C–E. Serving Trace Information / Serving of Mixed Batch / Latency Fluctuation | 轨迹构造、混合批处理、分配延迟 | pp. 14–16;Figs. 9–12 |
| F–G. Further Discussion on Sensitivity Metric / Additional Related Work | 敏感度指标取舍、相关研究位置 | pp. 16–17;Fig. 13 |
一:动机——记忆压缩与服务压力同时存在
1.1 单状态为什么容易偏向近期
GLA 将历史压缩进固定大小的矩阵状态。原文 Eqs. (1)–(2) 为:
其中 $\odot$ 是逐元素乘法。每来一个 token,先对旧状态施加遗忘门,再写入当前 key/value 外积。若相应门值持续小于 1,越早写入的信息经过的乘法越多,衰减就越明显。这里的“近期偏置”是门控衰减、容量压缩和训练目标共同作用的现象,不能仅从“计算复杂度为线性”推出。
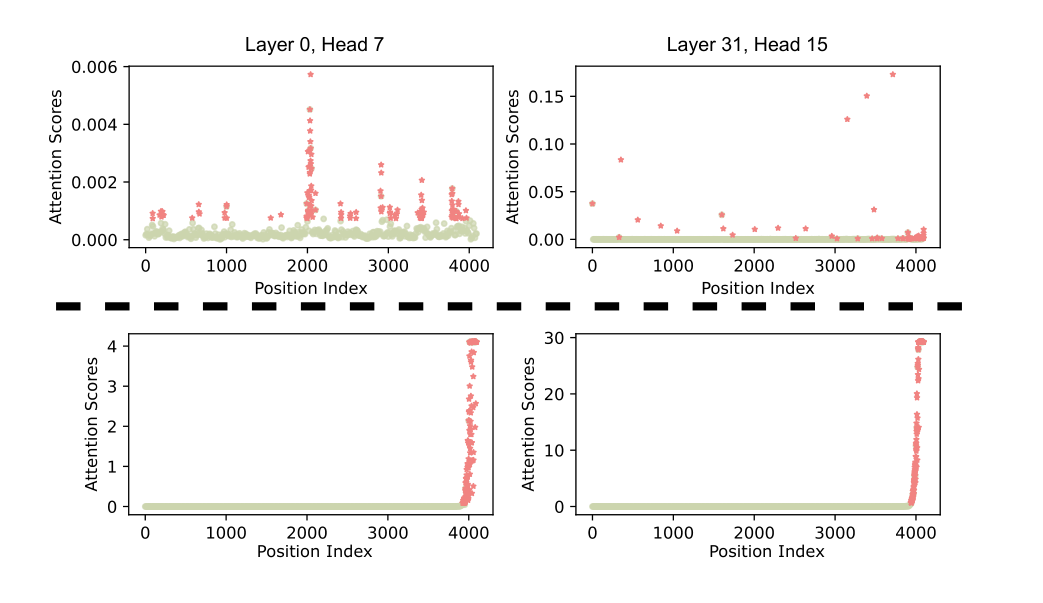
原文 Fig. 1,p. 3。横轴是过去 token 的位置,纵轴是最后一个 query 对这些位置的注意力分数。上排为 Llama2-7B,下排为以 1B tokens 蒸馏得到的 GLA;数据为 C4 的 16 个长度 4096 的样本,展示选取的层/头。GLA 的分数在最右侧近期 token 处集中,而 Transformer 保留更多中远位置峰值。上下排的数值尺度不同,因此应比较位置分布,不能把峰值高度当成同一归一化概率比较。
1.2 固定混合架构为什么还不够
保留部分 self-attention 能帮助模型读取精确历史,但静态比例无法同时适应短请求、长请求和多轮会话。长会话的 KV cache 随历史增长,绑定同一 GPU 的会话又会导致空间上的负载不均。图 2 的横轴是时间、纵轴是各节点内存需求,某些节点会出现明显热点。(Sec. 3,p. 3。)
DSLA-Serve 把“替换层数”作为运行时可调参数:资源充足时使用更多原始注意力,压力上升时优先转换影响较小的层。其收益必须同时覆盖替代模块的计算、双状态缓存、额外权重,以及混合批处理的调度开销。
二:方法——两条记忆轨道与一条转换顺序
2.1 输入、输出和符号
下面以单头、key/value 维度均为 $d$ 的记法解释原文;多头分别维护相应状态。
| 符号 | 含义与形状 |
|---|---|
| $t,T$ | 当前位置、最后一个 query 的位置 |
| $\mathbf q_t,\mathbf k_t,\mathbf v_t$ | 行向量,$1\times d$ |
| $\mathbf S_t^1,\mathbf S_t^2$ | 历史/近期两个状态,各为 $d\times d$ |
| $\mathbf G_t^1,\mathbf G_t^2$ | 数据依赖的逐元素遗忘门,各为 $d\times d$ |
| $\gamma$ | 每层学习一个输出混合系数 |
| $\lambda$ | 门控差异化损失的权重 |
| $r,n$ | 被替换层的比例、总层数 |
Q/K/V/O 投影由教师模型对应权重初始化。当前 token 产生 query、key、value 和两组门,更新两份状态,再读出一个注意力模块输出。DSLA 改变的是注意力计算,不是把整个 Transformer block 的所有组件都删掉。(Sec. 4.1,pp. 3–4;App. B,p. 14。)
2.2 双状态递推:相同写入,不同遗忘
按“两条独立历史”的机制,递推可整理为:
公式说明:原文 Eq. (4),p. 4,两条递推的旧状态都写成没有分支上标的 $\mathbf S_{t-1}$;上式根据双状态描述和 Eqs. (7)–(8) 的独立门乘积补全上标,是本笔记的解释性修正。输出式对应原文 Eq. (5)。
两份状态都看到所有 token,并没有显式的“前半段/后半段”分区。分工来自不同的遗忘速度、初始化和正则约束。$\gamma$ 是逐层学习的参数,论文没有将其定义为每个 token 重新预测的路由器,也没有给出足以确认其数值约束的完整参数化。
作者把历史门的初始化描述为“接近单位矩阵”,近期门随机初始化。这里要区分门控层的参数矩阵和真正乘到状态上的 Hadamard 门值:若直接把后者设成单位矩阵,会清掉状态的非对角元素;逐元素保留全部旧状态的中性门应是全 1 矩阵。App. B 使用的是“history gating layer”措辞,因此不能直接把原文描述翻译成 $\mathbf G=I$ 的实现。(Sec. 4.1,p. 4;App. B,p. 14。)
2.3 展开递推后,双状态改变了什么
令 $\mathbf P_{t\to T}^{a}$ 为分支 $a\in\{1,2\}$ 从 $t+1$ 到 $T$ 的逐元素门乘积,空乘积为全 1;设初始状态为零,则:
这是由递推直接得到的教学推导。为了避免原文 Eqs. (6)–(8) 中向量“注意力分数”与 value 的乘法歧义,按输出分量 $j$ 写为:
同一个历史 token 现在有两条保留路径。论文将两个分支贡献混合后的向量范数作为可视化的 attention score;它不是 softmax 注意力那样天然归一化的概率。
一个标量教学例子可以说明其效果:假设两条路径的门恒为 $g_1=0.999$、$g_2=0.9$,且 $\gamma=0.5$。距今 $\Delta$ 个位置的衰减部分为:
两条路径的半衰期分别约为 693 和 6.6 个 token。第一条保留较长历史,第二条快速响应近期变化;这里未计入 query/key 的内容匹配。例子展示的是机制直觉,数值不来自论文训练参数。
2.4 损失函数如何避免两个状态学成一样
原文 Eqs. (9)–(10),p. 4:
教师对齐项使混合后的输出接近原始 self-attention;门之间的余弦相似度惩罚鼓励差异化。这个 “contrastive” 项是直接降低两组门的相似度,正文没有定义正负样本或 InfoNCE 对比批次。
复现所需的具体缺口是:一般注意力输出向量并不是概率分布,而文中没有交代 KL 之前如何归一化、是否使用温度,以及 $\lambda$ 的具体设置。因此可以准确解释训练目标的用途,但不能仅凭该式得到唯一的数值实现。余弦惩罚也只约束门不同,历史/近期的功能分工还要看后面的注意力图与消融证据。
2.5 离线准备与在线转换
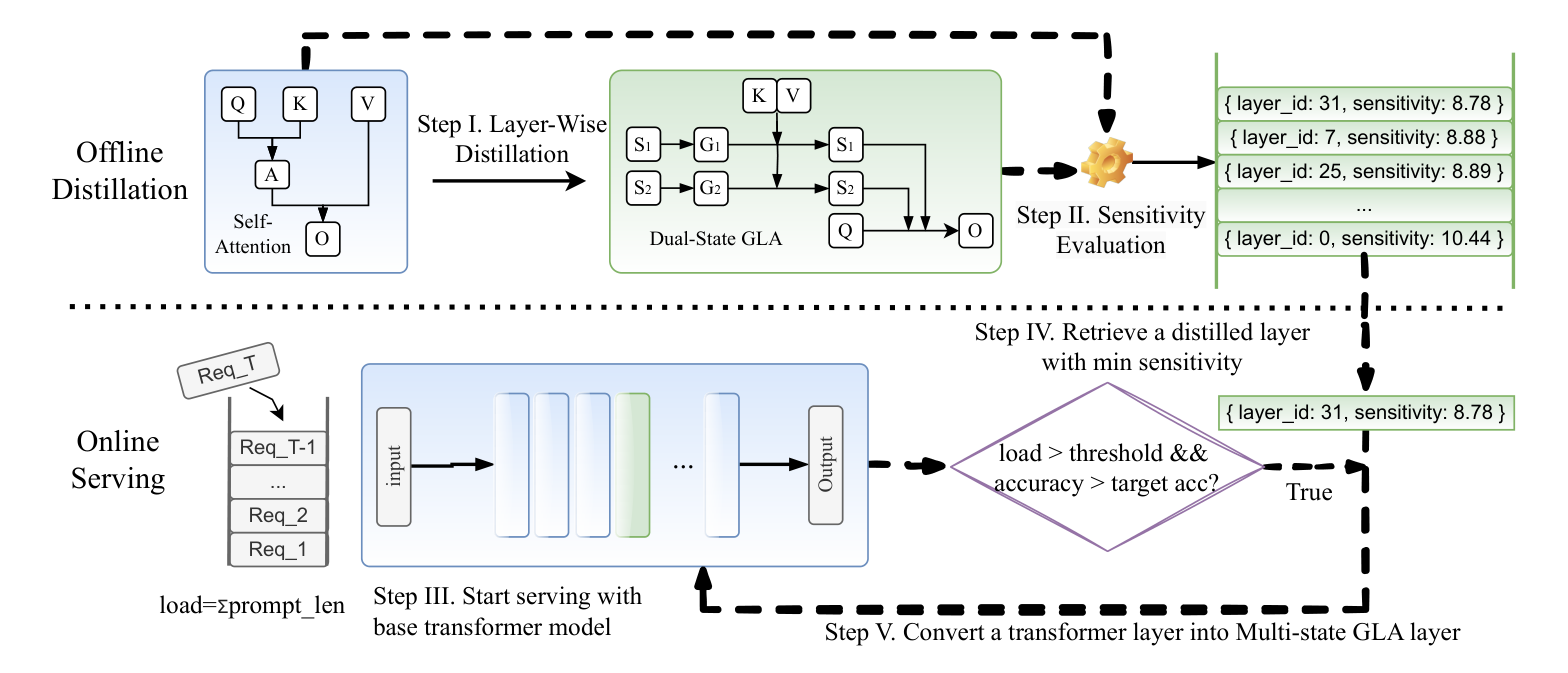
原文 Fig. 8,App. A,p. 14。上半部分离线蒸馏并评估层敏感度;下半部分根据请求负载和质量目标选择已经训练好的替代层。
离线阶段:先形成各层替代模块和敏感度估计,再沿固定顺序逐层微调。在线阶段:监测显存和 prompt 长度,从低敏感度层开始增加转换,达到内存目标或质量上限即停止;长请求优先。论文用困惑度、BLEU 等举例说明质量 SLO,但没有给出一个无需标签即可实时测量所有请求质量的完整控制器。理解端到端实验时,应采用其实际报告的“按长度设转换上限”策略。(Sec. 4.3,pp. 4–5;Sec. 5.4,p. 7。)
2.6 敏感度排序:直觉、度量与符号问题
作者考察单层替换后的验证性能变化,并用注意力熵作为较便宜的代理:注意力较集中、所需记忆位置较少的层可能较容易线性化。Fig. 7 横轴为被替换的层,左轴为 WikiText-2 困惑度,右轴为注意力熵;论文通过曲线与柱状图的一致趋势支持该选择。(Sec. 4.3,p. 5;Sec. 5.5,pp. 8–9。)
原文 Eq. (11) 写成:
标准 Shannon 熵则是 $H(\mathbf A)=-\sum_i A_{T,i}\log A_{T,i}$。正文“较低熵意味着更集中”的解释与标准 $H$ 相符,与原文少负号的式子方向相反;Fig. 7 也画出正值熵。实际复现排序必须明确负号及排序方向,不能原样抄式后再升序排列。
附录 F 比较了熵、outlier 比例和下游任务性能。直接用下游分数更贴近目标任务,但要先完成蒸馏评测,而且摘要 ROUGE 与 WikiText 困惑度不总一致。图示支持将熵作为实用启发式,文中没有提供其相关系数或排序最优性定理。(pp. 16–17,Fig. 13。)
2.7 链式微调匹配一族嵌套结构
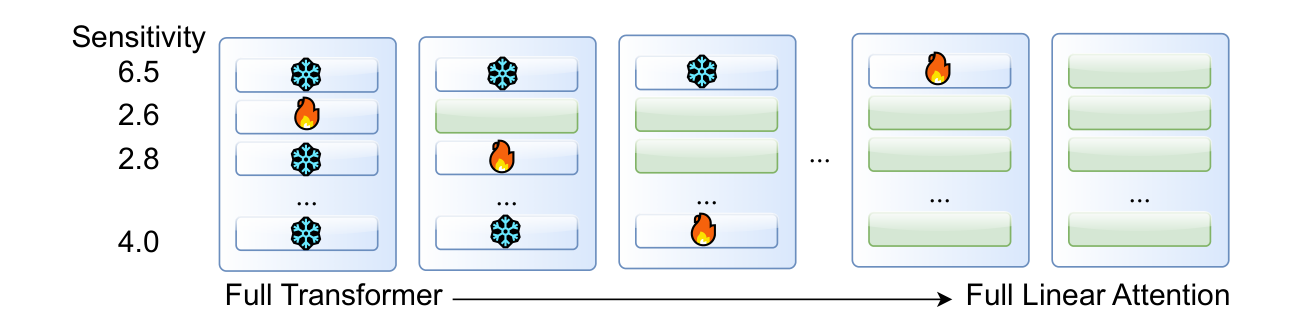
原文 Fig. 3,p. 5。每一步只训练新替换层,其余层冻结;已完成的替代层保留在网络中,因此后续训练看到的是更新后的混合结构。
假设敏感度顺序为 $\pi=(\pi_1,\ldots,\pi_n)$,训练得到的结构依次为:
例如四层的顺序是 $(3,1,4,2)$,直接对应的配置为 $\varnothing$、$\{3\}$、$\{3,1\}$、$\{3,1,4\}$、全替换。原文宣称可以支持 “any partial combination”,但此训练程序直接覆盖的是固定顺序的前缀配置,并未逐一训练全部 $2^n$ 个子集。按同一顺序在线增加替换才与其动机一致。(Sec. 4.4,p. 5;本段集合例子为教学解释。)
2.8 混合批处理和状态切换的成本
同一批请求可能处于不同转换比例:有些在某层走 DSLA,另一些走 self-attention。共享层仍能合批;出现分歧的层需要拆成两个子批次,之后再合并。这里涉及不同权重和计算路径,不能把整个过程视作一个统一 GEMM。作者称显存节省能覆盖重分批成本,但未单列调度开销的数值分解。(Sec. 4.5,pp. 5–6;App. D,pp. 15–16,Fig. 11。)
若要在同一条已经解码的序列中途切换,新的 DSLA 状态还必须包含此前历史。文中没有充分交代这些状态是持续维护、重放历史还是从旧缓存构建,也没有量化相应成本。这是把动态层选择落实到服务系统时需要补齐的关键环节。
2.9 时间和显存:固定状态不等于混合模型全为线性
单个 DSLA 头每步状态更新/读取约为 $O(d^2)$,两份状态只是增加常数,状态空间不随序列长度 $s$ 增长。若保留 $(1-r)n$ 层 self-attention,整网仍含二次预填充项和随历史长度增加的解码成本。Fig. 4 中 25%/50% 模型的解码曲线也仍有斜率,收益主要是降低成本与增长幅度。
原文 p. 7 给出的 KV 公式为:
这里 $b$ 是 batch size,$h$ 是头数,$d_h$ 是每头维度,$B_{byte}$ 是每个元素的字节数。式子含 $n$,所以是这些层的总 KV,而非该段文字所称的“每层”。在两份 $d_h\times d_h$ 状态、同样头数和存储精度的教学假设下:
取 $n=32,h=32,d_h=128,b=1,s=4096$,BF16 为 2 字节:原 KV 为 2 GiB,替换 25% 层去除 0.5 GiB KV,新增双状态约 16 MiB,净减约 0.484 GiB/请求。这是明确假设下的估算,未计额外权重和运行时缓冲。原文 Sec. 5.1 声称 4K/8K 分别节省 1GB/2GB,但没有在那里明确精度和状态扣除口径,不能把它当作所有 BF16 配置的结论。
三:实验——先分清模型、任务与系统设置
3.1 训练配置与比较角色
主模型由 Llama2-7B 蒸馏,使用 SlimPajama 的 1.6B tokens,样本截断到最多 4K;使用 AdamW,weight decay 0.01,前 5% 步数升温至 $10^{-4}$,随后余弦衰减至 $5\times10^{-5}$,复用 GLA 的 Triton kernel。(Sec. 5,p. 6;App. B,p. 14。)
| 对照/设置 | 在实验中回答的问题 |
|---|---|
| Llama2-7B | 转换前的教师质量与系统成本 |
| GLA-7B、Mamba-7B、RetNet-6.7B | 与线性复杂度架构比较;RetNet 只列部分短任务 |
| Zamba-7B | 与静态混合架构比较 |
| DSLA 25% / 50% | 同一教师下两个转换比例的质量取舍 |
| Llama3-8B / LoLCATs / DSLA | 换教师后比较线性化方案,Table 7 |
| Phi-1.5 / Phi-Mamba / DSLA | 较小模型上的迁移结果,Table 8 |
表格中的 “Cost” 混合了预训练 token 数和额外蒸馏 token 数。例如教师的 2T 与 DSLA 的 1.6B 不是两个从零训练模型的等预算比较;DSLA 继承了教师训练成果。App. B 报告“单层、1B tokens、4×A100、约 5 小时”,不能直接当成全模型链式蒸馏的总费用。附录的“0.07% 预训练成本”也缺少足够统一的总层数与计算量口径来支持全流程比较。
3.2 各实验协议不要混用
| 实验 | 配置与指标 |
|---|---|
| 长上下文任务 | LongBench 的多文档 QA、代码补全、少样本任务;原表分数越高越好 |
| 语言建模 | WikiText-2、Lambada 的 perplexity,越低越好;Lambada 列按本论文标注解释为 PPL |
| 摘要 | CNN/DailyMail、XSum;ROUGE-1 与 ROUGE-L,越高越好 |
| 短上下文 | WG、HS、PIQA、ARC-E、ARC-C、MMLU、LogiQA;任务得分/准确率,越高越好 |
| 状态数消融 | Llama-3.2-1B-Instruct,先在 CoLA 上监督微调,再替换并重训;验证准确率,不是 CoLA 常见的 MCC |
| 单模型延迟 | A100 80GB;预填充时延与逐 token 解码时延,Fig. 4 |
| 服务回放 | A6000,原文记为 49GB;增强的 Azure 2023 轨迹,Table 4 |
QA 分数衡量回答与参考答案的匹配;LCC/RepoBench 对应代码补全质量,并非代码通过率;TREC 是分类,SAMSum 是对话摘要,TriviaQA 是问答。ROUGE-1 看 unigram 重叠,ROUGE-L 看最长公共子序列。短任务中 WG 是 Winogrande,HS 是 HellaSwag。不同列不宜直接解释为同一种“准确率”,论文也没有为主表逐项详列所有 shot 数、prompt 模板和解码设置。
四:结果——质量、效率与机制证据
4.1 长上下文:QA 受益,代码和少样本存在损失
原文 Table 1,p. 7;将其拆成窄表以便比较。
| 模型 | WikiText-2 PPL ↓ | Lambada PPL ↓ | HotpotQA ↑ | 2WikiMQA ↑ |
|---|---|---|---|---|
| Llama2-7B | 8.79 | 4.13 | 5.63 | 10.24 |
| GLA-7B | NaN | 4.98 | 3.61 | 6.89 |
| Mamba-7B | 10.55 | 4.05 | 1.23 | 0.80 |
| Zamba-7B | 10.25 | 3.74 | 7.90 | 7.97 |
| DSLA 25% | 9.26 | 4.14 | 11.07 | 14.20 |
| DSLA 50% | 9.89 | 6.19 | 10.61 | 13.64 |
25% 配置相对教师在两个多文档 QA 列分别提高 5.44 和 3.96 分,与此同时 WikiText-2 PPL 从 8.79 到 9.26,Lambada 基本持平。50% 时 Lambada PPL 升至 6.19,说明质量损失并非只有特别高的转换比例才出现。
| 模型 | LCC ↑ | RepoBench ↑ | TREC ↑ | SAMSum ↑ | TriviaQA ↑ |
|---|---|---|---|---|---|
| Llama2-7B | 69.83 | 56.88 | 59.00 | 39.10 | 86.19 |
| GLA-7B | 41.26 | 44.24 | 28.50 | 16.94 | 57.68 |
| Mamba-7B | 17.56 | 10.54 | 11.00 | 4.55 | 15.23 |
| Zamba-7B | 40.70 | 43.20 | 64.00 | 37.74 | 82.19 |
| DSLA 25% | 66.91 | 51.53 | 55.00 | 38.66 | 87.46 |
| DSLA 50% | 61.68 | 49.84 | 46.00 | 37.28 | 81.99 |
DSLA 25% 的 LCC、RepoBench 分别低于教师 2.92、5.35 分,50% 时差距进一步扩大。相对其他线性架构的优势不能全部归因于双状态本身,因为教师继承、训练语料和转换比例也不同。更直接检验状态数的实验见 4.5。
原文将 TriviaQA 相对 Mamba 的提升写成“72.23%”。表中实际是 $87.46-15.23=72.23$ 个分数点;若用 Mamba 分数作分母,相对增幅约 474.3%。因此应引用 增加 72.23 分,而不是 72.23% 的相对提升。(Sec. 5.1,p. 6;Table 1,p. 7。)
4.2 摘要和短任务:25% 更接近教师
原文 Table 2,p. 7。下表均为 ROUGE 百分制分数。
| 模型 | CNN/DM R-1 ↑ | CNN/DM R-L ↑ | XSum R-1 ↑ | XSum R-L ↑ | 原表平均 ↑ |
|---|---|---|---|---|---|
| Llama2-7B | 30.13 | 27.63 | 30.07 | 24.51 | 28.09 |
| GLA-7B | 18.55 | 17.62 | 24.65 | 20.92 | 20.44 |
| Mamba-7B | 22.13 | 21.04 | 27.92 | 23.49 | 23.65 |
| Zamba-7B | 31.34 | 28.67 | 28.41 | 23.09 | 27.88 |
| DSLA 25% | 30.01 | 27.10 | 30.10 | 24.70 | 27.98 |
| DSLA 50% | 29.29 | 26.42 | 29.88 | 23.73 | 27.33 |
25% 配置的四列平均只下降 0.11 分,50% 下降 0.76 分。Zamba 在 CNN/DM 更强、DSLA 25% 在 XSum 略强,摘要结果支持的是相近质量下的效率折中。
原文 Table 3,p. 7,主配置的七项短任务如下;数值为百分制。
| 任务 | Llama2-7B | DSLA 25% | DSLA 50% |
|---|---|---|---|
| Winogrande | 69.3 | 69.9 | 68.1 |
| HellaSwag | 57.1 | 56.5 | 55.4 |
| PIQA | 79.6 | 78.7 | 75.0 |
| ARC-E | 76.4 | 74.9 | 71.6 |
| ARC-C | 43.3 | 43.2 | 40.4 |
| MMLU | 45.3 | 46.2 | 43.2 |
| LogiQA | 30.6 | 24.9 | 25.4 |
| 原表 Avg. | 57.2 | 56.3 | 54.2 |
25% 在 MMLU、Winogrande 略升,在 LogiQA 下降 5.7 分;不能概括为“短任务完全无损”。原表平均值中,教师 57.2 与所列七项的简单均值约 57.37 有小幅不一致;DSLA 两项简单均值约 56.33、54.16。无论采用哪一种口径,25% 更接近教师、50% 退化较多的结论一致。其他模型的原表平均为 GLA 54.5、Mamba 55.5、Zamba 56.9,RetNet 因有缺失项未给平均。
4.3 单模型效率:长预填充和解码更受益
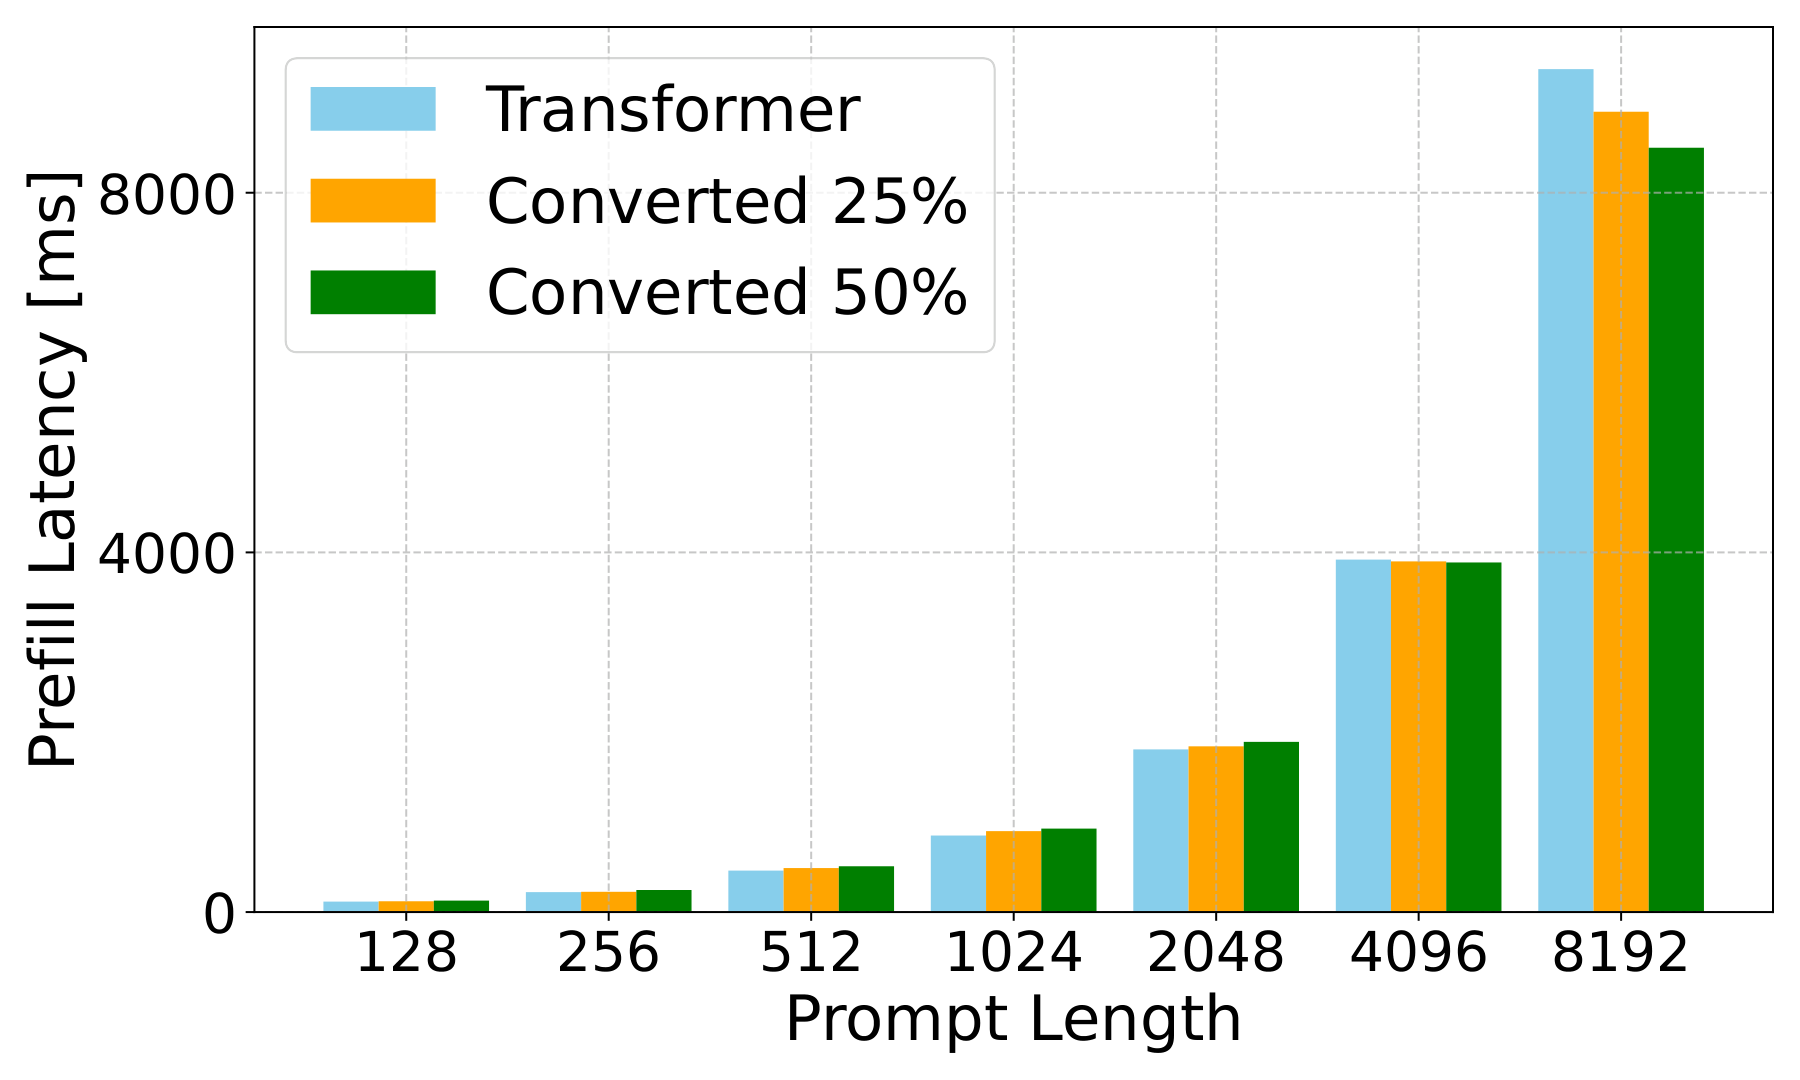
原文 Fig. 4 左面板,p. 7。横轴为 prompt 长度,纵轴为预填充延迟(ms)。颜色分别表示 Transformer、25% 和 50% 转换。原文报告 2K 以下 Transformer 更快,超过 2K 后转换配置开始有利,说明双状态和门计算具有短序列下不能忽略的固定成本。
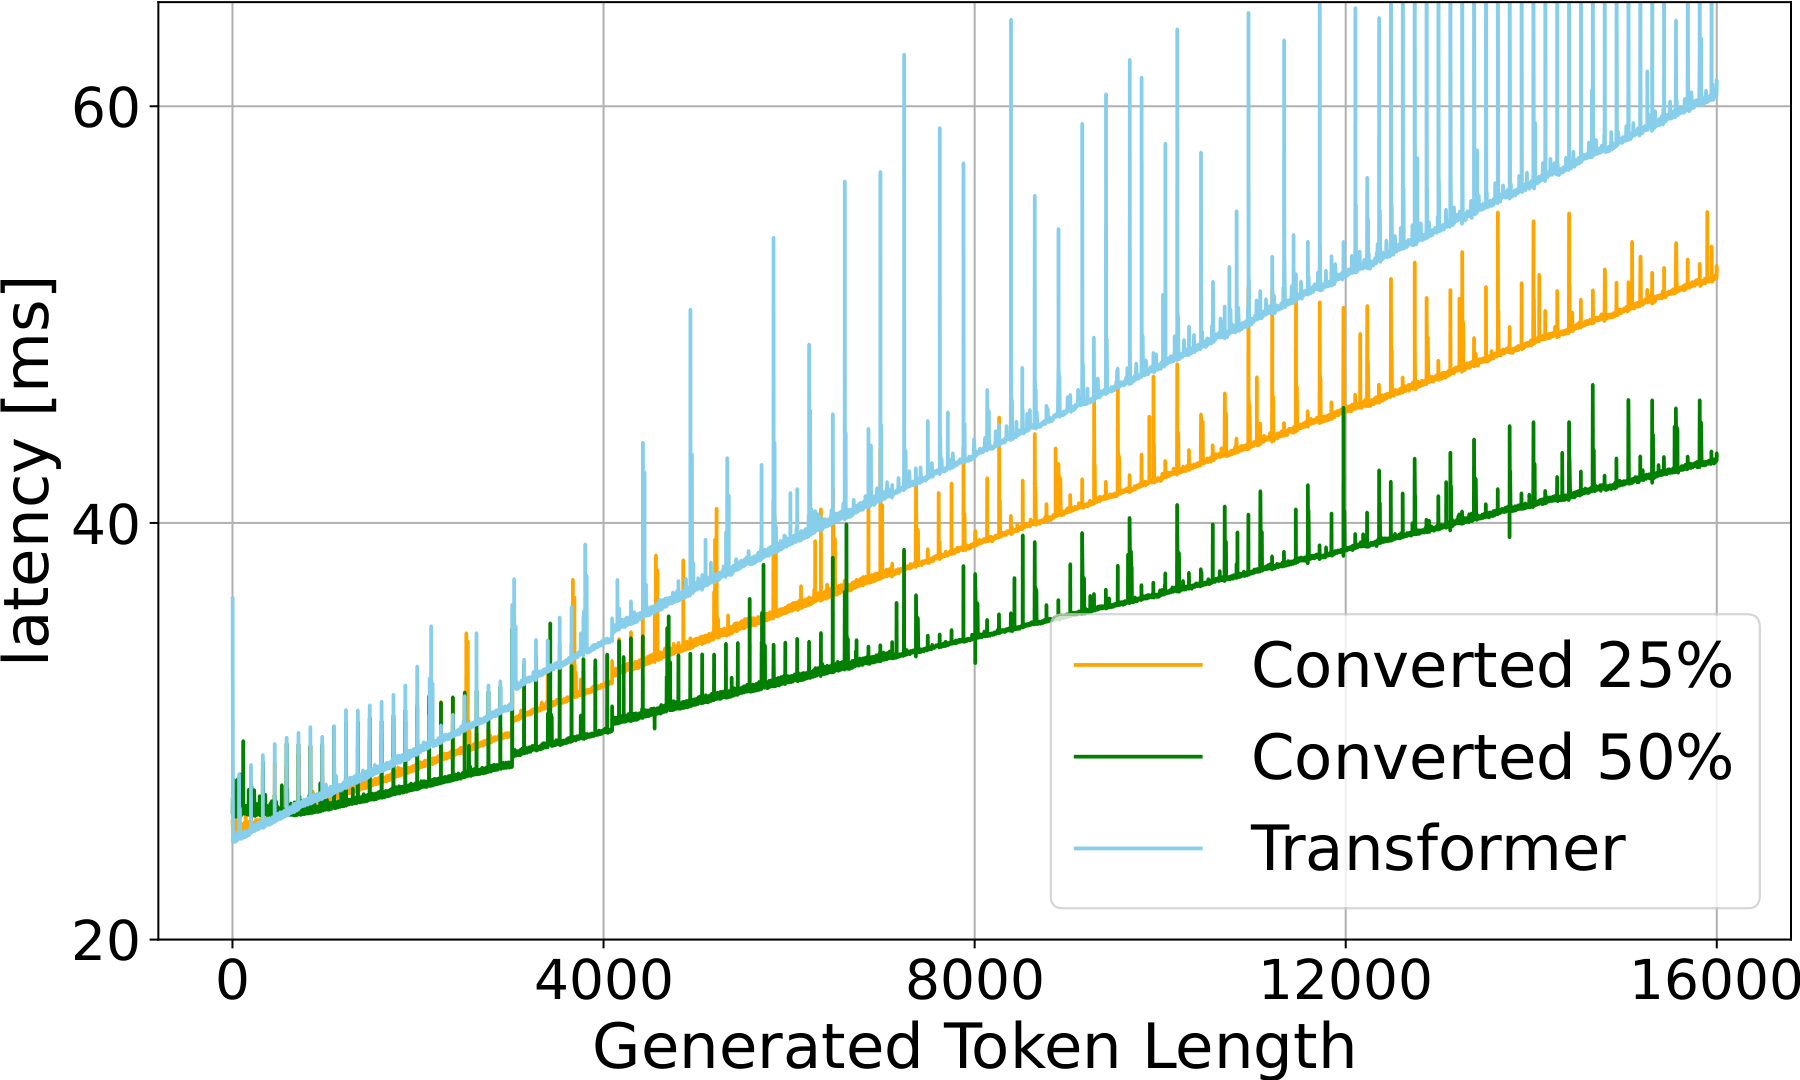
原文 Fig. 4 右面板,p. 7。横轴为已生成 token 数,纵轴为单 token 延迟(ms)。25% 和 50% 曲线更低,但仍随生成长度上升,因为剩余的 self-attention 仍要读取增长中的 KV。
作者还在 A6000 上重复生成 2048 tokens,发现某些分配操作伴随尖峰,profiling 报告间歇性 cudaMalloc 达 300–1000 ms。减少 KV 压力有助于缓解该实现中的尖峰;这部分实验与 A100 的 Fig. 4 设置不同。App. E / Fig. 12 的曲线本身不能代替上述分配操作的耗时分解。(pp. 15–16。)
4.4 端到端回放:2.29 倍来自指定轨迹与转换策略
Azure 原始轨迹只有时间戳、输入长度、输出长度。作者增加生成的文本 prompt 和 session ID,按 Poisson($\lambda=3$) 模拟会话轮次,再拼接历史以模拟多轮对话。这是真实长度/到达信息基础上的增强轨迹,并非带有真实会话正文的生产回放。(App. C,pp. 14–15,Figs. 9–10。)
| Prompt 长度 | 请求占比 | 最大转换比例 |
|---|---|---|
| 小于 2K | 64.68% | 12.5% |
| 2K–4K | 16.16% | 25% |
| 4K–8K | 16.03% | 37.5% |
| 至少 8K | 3.10% | 50% |
原文 Table 4,p. 7。正文同段提到“25%–50%”,但表中的实际上限覆盖 12.5%–50%,应以表中策略为准。比例合计略少于 100% 属于所报告数值的舍入。
按 token 长度归一化的端到端平均延迟由 93.64 ms 降至 40.83 ms,$93.64/40.83\approx2.293$。这个指标包括系统条件下的请求处理,不能直接等同于某个固定 prompt 上的单层 kernel 加速,也不是 P99。论文没有给出相同回放中各转换动作的质量变化与控制开销明细。
Zamba 的 3.0 倍说法存在比较对象不一致:摘要和结论将其表述为 DSLA-Serve 相对 Zamba 的收益,而 Sec. 5.5,p. 8,写的是 A100 上 Zamba 的端到端延迟为 Llama2-7B 的 3.0 倍,预填充为 1.8 倍。Table 4 没有提供 Zamba 的同设置回放行,因此不宜把“相对 Zamba 3.0 倍”与可直接计算的 2.29 倍视为同等清晰的证据。
4.5 双状态是否分工,以及为何选择两个
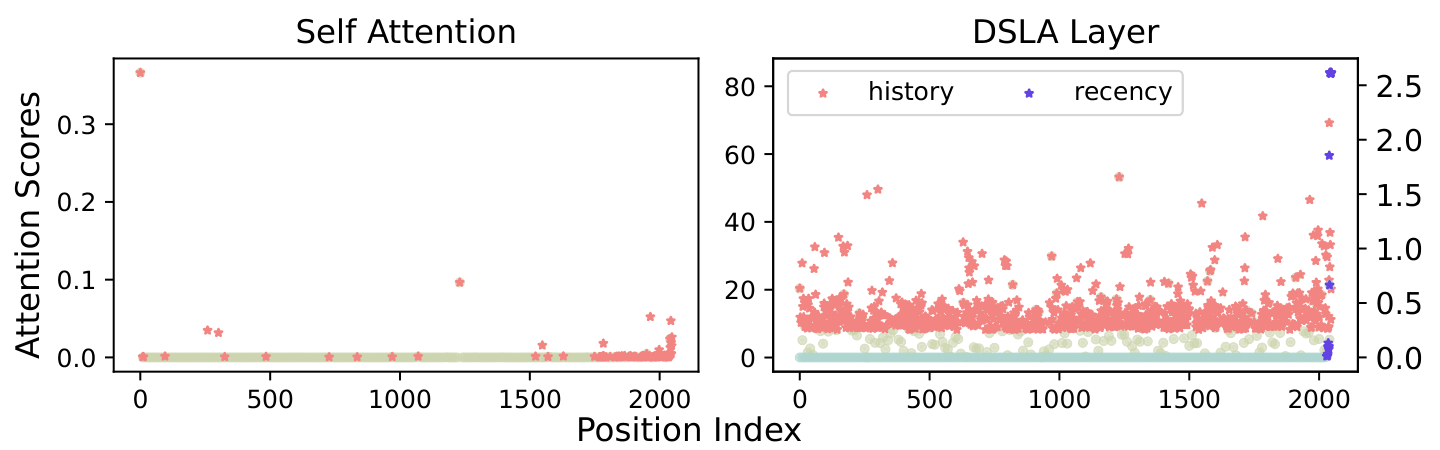
原文 Fig. 5,p. 8。横轴是 token 位置;左侧为 self-attention,右侧分别显示 history(红色)和 recency(蓝色)。右图两条状态使用不同纵轴尺度。history 覆盖较早位置,recency 更集中于末尾,支持它们具有不同遗忘特性;不能直接用红蓝点高度比较两个状态对输出的总贡献。
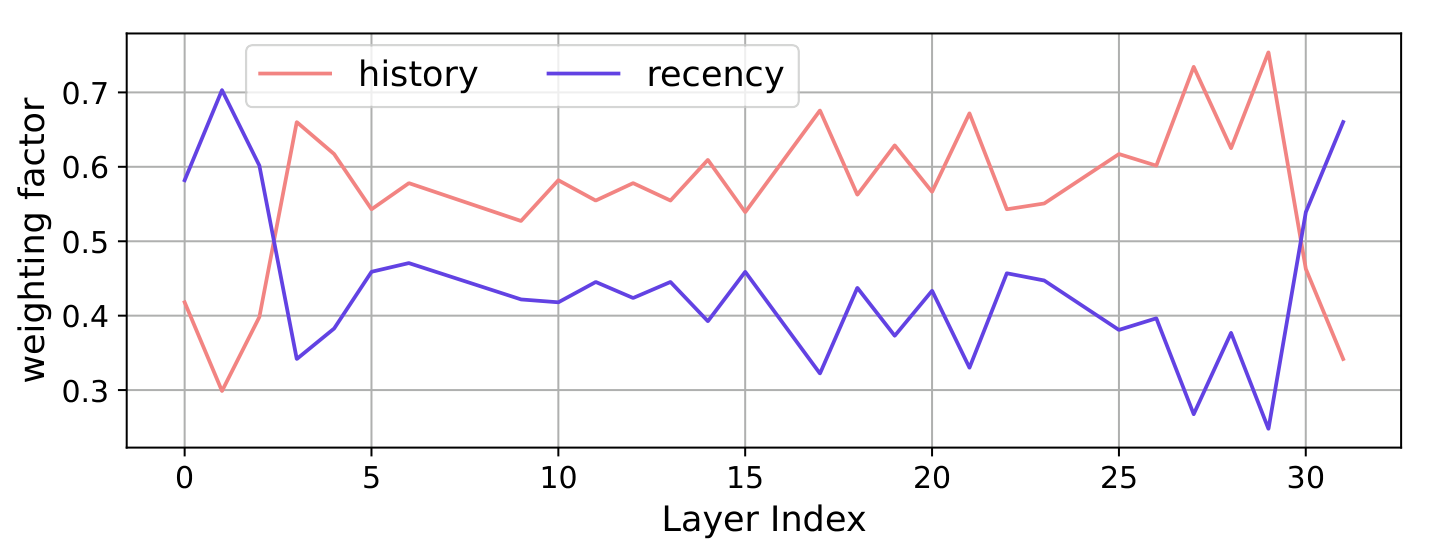
原文 Fig. 6,p. 8。横轴是层索引,纵轴是两份状态的混合权重。曲线显示层 0–2、30–31 更偏近期,3–29 更偏历史;正文写作 0–3 与 4–29,边界相差一层。稳妥的解释是开头和末尾偏近期、中间偏历史,而非“层越深越依赖历史”的单调图景;图上展示的是所训练参数的层间差异。
状态数实验另用 Llama-3.2-1B-Instruct 和 CoLA,不能当作 7B 长文本的直接消融。Table 5,p. 8:
| 状态数 | CoLA 验证准确率 ↑ | 相对单状态增量 |
|---|---|---|
| 1 | 78.97% | — |
| 2 | 81.19% | +2.22 个百分点 |
| 4 | 81.44% | +2.47 个百分点 |
| 8 | 80.96% | +1.99 个百分点 |
| 原始 Transformer | 82.83% | — |
两状态收回了相当部分损失;四状态只比两状态多 0.25 个百分点,八状态反而下降,所以选择两个有成本依据。这里同时改变了容量和状态结构,且没有单独报告去掉门相似度正则、去掉特殊初始化、或将单状态扩容到等容量的对照。因此实验支持“双状态配置有效”,但尚不足以分离额外容量、初始化和正则各自的贡献。
4.6 换教师、换规模后的表现
Llama2-7B-chat:Table 6,p. 9,使用 800M 额外 tokens。25% 配置的 HotpotQA 从 29.79 到 35.37,2WikiMQA 从 27.15 到 32.33;LCC 从 59.71 降到 58.11,RepoBench 从 48.96 降到 45.17。50% 时 TriviaQA 从教师 86.11 降到 73.04。更强的教师提高了若干绝对分数,转换比例带来的取舍仍存在。
Llama3-8B 与 LoLCATs:Table 7,p. 9,六项任务如下。DSLA 后的 ± 值为作者标注的标准差;表中没有足够的重复次数信息来另算置信区间。
| 任务 | 教师 | LoLCATs | DSLA |
|---|---|---|---|
| WG | 74.1 | 80.9 | 73.2 ± 1.3 |
| HS | 79.7 | 79.7 | 77.5 ± 0.5 |
| PIQA | 79.9 | 80.9 | 79.8 ± 1.0 |
| ARC-E | 80.1 | 81.7 | 80.7 ± 0.8 |
| ARC-C | 53.3 | 54.9 | 55.9 ± 1.5 |
| MMLU | 66.6 | 52.8 | 68.9 ± 3.2 |
| 原表 Avg. | 72.2 | 70.7 | 72.7 |
| 根据上面六列计算的等权均值 | 72.28 | 71.82 | 72.67 |
DSLA 的优势主要来自 MMLU,前四项低于 LoLCATs。原表 LoLCATs 平均 70.7 与展示的六列不一致;用可见数据算,DSLA 领先约 0.85 分,不是直接拿原表 Avg. 得到的 2.0 分。该表还没有明确 DSLA 的转换比例及与 LoLCATs 完全匹配的训练成本,适合解读为补充结果,不能单凭它下等预算优劣结论。
Phi-1.5:Table 8,p. 9:
| 模型 | WG | ARC-E | ARC-C | PIQA | HS |
|---|---|---|---|---|---|
| Phi-1.5 教师 | 73.4 | 75.0 | 48.0 | 76.6 | 62.6 |
| Phi-Mamba | 71.7 | 74.0 | 44.1 | 75.5 | 60.2 |
| DSLA | 72.9 | 74.5 | 44.5 | 75.9 | 60.5 |
DSLA 在五项上均高于 Phi-Mamba,同时均低于教师。正文“优于所有 baseline”的概括与此表不一致;准确结论是 DSLA 更接近教师,但没有超过教师。成本列为教师 150B、Phi-Mamba 3B、DSLA 800M tokens,仍要区分预训练与转换成本。
五:结论——有价值的设计,以及决定落地的条件
DSLA 最有启发的地方,是让记忆保留的时间尺度成为显式结构:相同 token 写进两条状态,通过不同遗忘门与学习到的混合比例保留互补信息。DSLA-Serve 则让注意力计算预算成为服务时的可调参数,并通过链式微调把预先准备的模块组织成一族可切换模型。
现有证据中,最扎实的三点是:25% 部分转换能保留许多任务的质量;CoLA 状态数实验显示两状态优于单状态且更多状态收益有限;指定 A6000 轨迹回放上可从表中直接得到 2.29 倍加速。选择替换比例时,要同时看到代码、分类和部分语言建模指标的损失。
落地时有三项实质条件值得优先解决:
- 总显存预算。论文实现同时保留原始注意力和 DSLA 权重。长序列的 KV 节省可能抵消额外权重,短序列时未必划算;权重 offload/prefetch 是作者提出的后续方案。
- 运行时状态连续性与质量控制。中途转换怎样获得历史状态、如何估计下一次转换的质量代价、重分批占多少时间,需要具体实现和成本分解。已报告的长度上限策略提供了一个起点。
- 确定双状态收益来自哪里。等容量单状态、去正则、去特殊初始化,以及独立训练与链式训练对照,能更清楚地区分机制贡献。原文在超过 75% 转换时观察到进一步退化,主结果集中于 25% 和 50%。
后续研究最值得延续的方向,是把互补记忆结构、按层敏感度分配预算、以及真实服务中的状态切换成本放到同一个可测量的框架内。