Test-Time Training Done Right:中文精读笔记
- 方法:Large Chunk Test-Time Training(LaCT,大块测试时训练)。
- 作者:Tianyuan Zhang、Sai Bi、Yicong Hong、Kai Zhang、Fujun Luan、Songlin Yang、Kalyan Sunkavalli、William T. Freeman、Hao Tan;MIT / Adobe Research。
- 版本:arXiv:2505.23884v1,2025-05-29;获取及研读日期:2026-09-21。
- 材料:arXiv 原文 · 本地 PDF · 英文汇报。
- 阅读范围:32 页 PDF,正文 §§1–8、附录 A–F;已读取同版本作者主文件
neurips_2025.tex、其引用的全部正文章节、tables/exp_view_synthesis.tex、supp.tex及必要符号定义,并以 PDF 核对图表和页码。参考文献作为定位材料,未逐篇阅读;未运行作者模型、复现实验或审阅网站视频样例。本文是分析而非全文翻译。以下页码均为 PDF 页码。
论文总览
LaCT 的贡献是一条系统与模型设计相互支持的链条:扩大在线更新块 → 提高矩阵乘法的计算强度和并行度 → 允许更大的非线性快权重与较复杂的更新算子 → 改善长上下文记忆。局部窗口注意力负责细粒度结构,快权重负责跨块历史;块的边界及读写顺序按任务设计。
这里的测试时训练不是临时给普通大模型做一次通用微调,而是模型架构内部的一种可学习记忆机制。每个样本的上下文被写入临时快权重,训练时也执行同样的更新过程,慢权重学习怎样产生适合记忆的 Q/K/V、初始化和更新控制量。
最扎实的结果之一来自新视角合成:48 张 512×512 输入图像、A100 测试下,LaCT 预填充 1.4 秒,全注意力 16.1 秒;渲染分别为 38.7 和 2.3 FPS(表2,p.8)。语言模型相对 GLA/DeltaNet 的部分长上下文指标更好,但复杂检索仍显著落后全注意力;不能据此声称全面替代 Transformer。
结构地图
| 原文章节 | 作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 长上下文与硬件瓶颈 | pp.1–2 |
| 2 Preliminary;2.1 Test-Time Training;2.2 Challenges in Efficient Implementation | 快权重基本操作、计算强度 | pp.2–3,图1,式1–3 |
| 3 LaCT Model Architecture;3.1–3.4 | SwiGLU、Muon、窗口注意力、上下文并行 | pp.3–6,图2–3,式4–11 |
| 4 LaCT for N-Dimensional Data;4.1–4.3 | 图像集合、语言和视频的依赖规则 | pp.6–7,式12 |
| 5 Experiments;5.1–5.4 | 三类任务及消融 | pp.7–11,表1–3、图4–8 |
| 6 Related Work | TTT、混合递归与视觉任务背景 | pp.12–13 |
| 7 Limitation;8 Conclusion | 适用范围与不足 | p.13 |
| A LaCT Model Implementation Details | 状态大小、Muon、动量、算法1–2 | pp.18–20 |
| B LaCT Architecture Details for N-Dimensional Data | 具体架构与掩码 | pp.20–23,图9–11 |
| C Experimental Details;C.1–C.4 | 详细配置、全部检索表与效率图设置 | pp.24–28,表4–9 |
| D Details for Mamba Baselines | Mamba 简化与公平比较设置 | p.29 |
| E / F Details of LaCT Context / Tensor Parallelism Implementation | 块内梯度归并 / 按头切分 | pp.29–32,算法3–4 |
一:动机——限制 TTT 的不只是算法复杂度
1.1 快权重如何替代 KV 历史
传统注意力保留每个历史 token 的 K/V,查询时逐项访问。TTT 使用神经网络 $f_W$ 的参数 $W$ 储存历史:以 K 为输入,以 V 为要记忆的关联目标,执行一次梯度写入,再通过 $f_W(q)$ 读出。固定状态避免缓存随历史长度线性增长,但信息压缩必然带来容量与检索精度约束(§2.1,p.2)。
慢权重是跨样本学习的模型参数;快权重是由可学习初值复制出的、随当前上下文变化的状态。推理仍有局部梯度计算,并非全模型重新训练。新序列需要独立状态,不能混用不同样本的记忆。
1.2 为什么小块更新难以利用 GPU
对 $h\times h$ 权重和 $b\times h$ 输入做 BF16 矩阵乘法,原文式3给出理想计算强度:
分子为 FLOPs,分母为两个输入和一个输出的字节数;$r$ 的单位为 FLOPs/byte。即使模型很大,只要每次更新仅用 16 或 64 个 token,矩阵乘法仍可能受内存带宽限制。小头维也构成上界。原文报告的最高约 70% A100 利用率属于特定层/测量设置,不等于所有任务整模型训练都达到该比例(§2.2,图1,p.3)。
大块让许多 token 并行访问同一快权重,摊薄搬运和更新开销,也使 Muon 的矩阵运算可以摊销。跨块非线性递归仍存在,不会因此变成任意跨时间完全并行的算法。
二:方法——把读写顺序、记忆容量与局部结构分开设计
2.1 基本模块与符号
LaCT block 含窗口注意力、TTT 和普通 FFN,并配残差与归一化(图2,p.4)。NVS 将窗口注意力独立成层;语言和视频主要采用同层并行分支,共享 Q/K/V 后相加(算法2,p.20)。
| 符号 | 含义 |
|---|---|
| $d$ | 整体模型宽度 |
| $h$、$n_h$ | 单头维度、TTT 头数,$d=n_hh$ |
| $r$ | SwiGLU 中间维倍数,中间维为 $rh$;与前节计算强度同字母但不同语境 |
| $b$ | 一次在线更新的 token 数,不是外层训练的样本 batch size |
| $q_i,k_i,v_i$ | 当前 token 的查询、键、值;单头向量维度 $h$ |
| $W_1,W_3,W_2$ | 按列向量记法,维度分别为 $rh\times h,rh\times h,h\times rh$ |
| $\eta_i$ | 从 token 预测的正更新权重;实现可对三个矩阵分别预测 |
| $M$ | 使用动量时的额外梯度状态 |
快权重为无偏置 SwiGLU:
原文式6–7(p.4)实际采用负点积目标,不是前文介绍 TTT 时举例的均方误差:
直觉是让键激活的输出沿相应值的方向变化。负点积本身无下界,不能称为天然有界的重建误差;稳定性还依赖 Q/K 归一化、快权重范数控制和输出 RMSNorm(算法1,p.19)。
2.2 从梯度写入到 Muon 写入
简化的梯度下降与 Muon 更新分别是:
每个权重矩阵沿输入维归一化。算法1更具体地将更新后方向缩放回原权重沿该维的范数;因此不宜把所有实现都理解成强制单位范数。
若 $g=U\Sigma V^\top$,Muon 近似得到 $UV^\top$,压低强奇异方向、相对增强弱方向。附录采用五轮 Newton–Schulz,系数为 3.4445、−4.7750、2.0315(附录A,p.18)。这是近似的矩阵正交化,不等于给任何秩亏矩阵凭空添加独立信息。
使用动量时:
再将 $M$ 输入更新算子(p.20;表3,p.9)。快权重参数量不包含所有运行时开销:动量、局部注意力缓存和训练激活都需要另计。Muon 对全局正比例缩放较不敏感,所以 $\eta_i$ 更多控制块内相对重要性;有限迭代和稳定项下不应将其表述为严格无条件不变性。
2.3 更新顺序决定可访问哪些 token
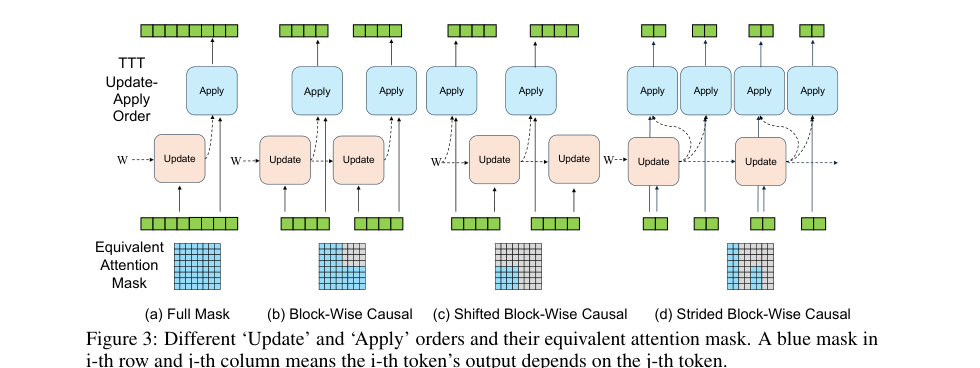
来源:图3,PDF p.5,原文裁切。蓝色格子表示行 token 的输出依赖列 token。它说明依赖范围,不意味着 LaCT 与 softmax 注意力数值等价。
| 任务/模式 | 快权重操作顺序 | 局部结构 |
|---|---|---|
| 全集合 / NVS 输入 | 先 update 全部允许的输入,再 apply | 每张图像内双向注意力 |
| 普通块因果 | 当前块先 update 再 apply | 块内可相互依赖 |
| 自回归语言 | 当前块先 apply 历史状态,再 update 当前块 | 因果滑窗,避免当前块未来泄漏 |
| 自回归视频 | 噪声块仅 apply,干净块才写入持久状态 | 块内双向、块间因果的窗口 |
教学例子:文本块长为4,处理 token 5–8 时,TTT 分支读取由 1–4 形成的状态;token 6 所需的当前块近邻由因果窗口提供。等到整个块处理结束,才把 5–8 写入状态。这里的4是演示用值,实际语言实验为2048/4096。
滑窗大小至少等于 TTT 块长时,历史块记忆与因果滑窗的依赖并集可覆盖完整因果区域(图10、附录B.2,p.22)。这只说明没有依赖“空洞”,不能证明历史细节被无损保存。
2.4 三种任务如何实例化
新视角合成(NVS):输入带相机位姿的 RGB 图像集合及目标位姿。位置编码用射线起点、方向及其叉积;patchify 后输入图像加 RGB 与位姿 embedding,目标只用位姿 embedding。每层从所有输入视图写入一次,再向输入和目标读出。目标图像互相独立,也不能写回场景状态。预填充后,快权重固定,渲染成本不随输入视图数增加(§4.1,pp.6–7;附录B.1,pp.20–21)。
语言:共享 Q/K/V 的 TTT 与 SWA 并行,TTT 输出经 RMSNorm 和每头缩放后加到窗口分支。默认4个 TTT 头;更少的头意味着更大的单头记忆。$W_1,W_3$ 的可学习初值用秩32分解加 $0.5I$,降低额外可训练参数,但在线状态仍是完整矩阵;低秩初始化不等于始终低秩的记忆(附录C.2,pp.25–26)。
视频:在预训练 Wan 2.1 上,将视觉双向注意力改为块因果窗口加 TTT。每块是3个潜变量帧、4680个 token,不是3张原始帧。训练序列交错为 $[X_1^{noise},X_1,X_2^{noise},X_2,\ldots]$,其中 $X_i^{noise}=(1-t_i)X_i+t_i\epsilon$。只有干净块更新持久记忆,噪声块只能访问过去干净历史及自身。1.3B 的5秒训练对噪声块重复两次以提高监督 token 比例;14B 不重复。视频实验不使用 Muon,因为作者未观察到明显验证损失收益(§4.3,p.7;附录B.3、C.3,pp.23、27–28)。
2.5 状态规模、计算量与并行
由三个矩阵的实际维度推导,每层快权重元素数应为:
例如 NVS 的 $d=768,n_h=1,r=2$ 得到 $S=6d^2$;24层约84.9M元素,与原文84M的近似报告相符。默认 NVS 的快权重占312M总参数约27%;论文“40%”对应另一状态扩展配置,不能当作默认值。语言默认4头、$r=1$ 对应 $0.75d^2$。
按附录列出的9个矩阵乘法估算,$n$ 个 token 的 update+apply 主体 FLOPs 为 $18nr d^2/n_h=6nS$,未计 Muon、投影、窗口注意力、逐元素操作及外层反传。固定状态、固定窗口时,成本随上下文长度线性增加;窗口扩大仍会增加成本。
上下文并行利用的是求和损失的梯度可相加:各设备在相同旧 $W$ 上得到 $g_j$,all-reduce 得到 $g=\sum_jg_j$,然后才做 Muon。由于 Muon 非线性,先各卡做 Muon 再求和通常不等价。NVS 采用块内切分,作者报告该设置吞吐额外开销约1%–3%。视频采用按头切分;这不同于把相邻时间块独立更新(§3.4,p.6;附录E–F,pp.29–32)。
三:实验——比较对象与协议
| 任务 | 数据、规模与训练 | 对照与指标 |
|---|---|---|
| 对象 NVS | Objaverse 训练;GSO 固定视角评估;256²/512²;4–48输入、8目标;约1.25T训练 token | 全注意力、4096 register 的 Perceiver;PSNR↑、SSIM↑、LPIPS↓ |
| 场景 NVS | DL3DV >11K训练场景、140测试场景;960×536;至128输入;正文报告约1.8T训练 token | LongLRM、逐场景优化3DGS;同类图像质量指标 |
| 语言 | Long-Data-Collections;760M/40B token,3B/60B token;训练长32768;块/窗2048或4096 | 全注意力、纯SWA、GLA+SWA、DeltaNet+SWA;逐位置损失↓、RULER检索准确率↑ |
| 视频 | 专有视频数据微调 Wan 2.1;1.3B/14B;先5秒,再10秒/8.8秒 | SWA、Mamba2+SWA、全块因果注意力;2000视频、5噪声时间点的去噪验证损失↓ |
PSNR 是以 dB 计的重建质量,SSIM 衡量结构相似度,LPIPS 衡量感知差异;三者不可混算。逐位置语言损失随位置降低支持利用较长上下文,但不直接证明复杂推理或任意信息无损检索。视频损失是条件去噪指标,并非人类对完整生成视频质量的评价。
GLA、DeltaNet、Mamba 对照补上与 LaCT 相同的局部窗口,以避免把“有无局部注意力”误当作递归模块差异。附录D给出的是作者实验使用的 Mamba2 变体,不是全部 Mamba 设计的穷尽比较。关键表和曲线没有提供多随机种子误差条或显著性检验,不能写作统计显著。
四:结果——性能提升在哪里成立
4.1 NVS:压缩历史显著降低预填充成本
速度条件固定:48张512×512输入、196,608输入 token、单目标约4096 token;A100(表2,p.8)。
| 模型 | 参数 | 预填充秒↓ | 渲染 FPS↑ |
|---|---|---|---|
| Full attention | 284M | 16.1 | 2.3 |
| Perceiver attention | 287M | 16.8 | 34.4 |
| LaCT | 312M | 1.4 | 38.7 |
本次计算:相对 full attention,预填充约11.5倍加速、渲染吞吐约16.8倍;这些是不同阶段的比值,不能当作全流程统一加速比。模型参数也不是严格相同。
表2将本文 Perceiver 对照预填充标为 $O(n^2)$,这是该具体实现的报告,不能据此声称所有 Perceiver 都有此复杂度。
| GSO 条件 | LaCT PSNR | 全注意力 PSNR | LaCT / 全注意力 LPIPS |
|---|---|---|---|
| 256²,48输入 | 37.6 | 37.9 | 0.014 / 0.013 |
| 512²,4输入 | 33.4 | 33.6 | 0.029 / 0.027 |
| 512²,48输入 | 39.1 | 39.3 | 0.015 / 0.012 |
来源:表4–5,p.25。LaCT 接近全注意力但不是图像质量全面领先。256²、48输入时 Perceiver 为33.7 dB,LaCT 高3.9 dB;与全注意力相差−0.3 dB。
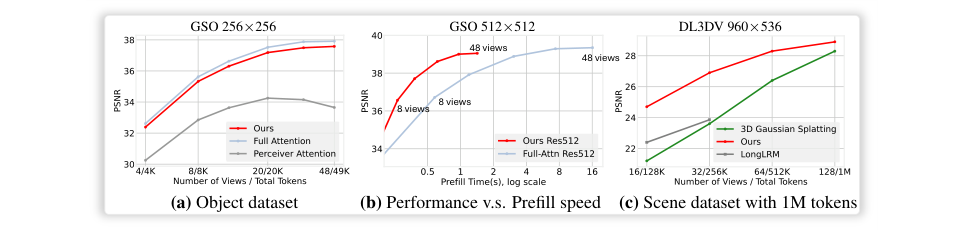
来源:图4,p.8。左图横轴输入视图数、纵轴PSNR;中图横轴预填充秒数(对数刻度)、纵轴PSNR;右图为 DL3DV 输入规模与PSNR。LaCT 的价值是质量与预填充成本的折中。右图显示稀疏视图对3DGS优势更明显、128视图时接近;不将摘要的概括放大为所有场景均胜出。
| DL3DV输入视图 | LaCT PSNR↑ | LPIPS↓ | SSIM↑ |
|---|---|---|---|
| 16 | 24.7 | 0.224 | 0.793 |
| 32 | 26.9 | 0.185 | 0.837 |
| 64 | 28.3 | 0.169 | 0.857 |
| 128 | 28.9 | 0.166 | 0.861 |
来源:表6,p.25。16到128视图提高4.2 dB,是更多输入信息与架构能力共同作用,不能归结为单一模块的因果效应。该百万 token 结果来自带位姿图像任务,不是百万 token 文本检索。
4.2 语言:长上下文利用更好,但检索仍存在明显容量边界
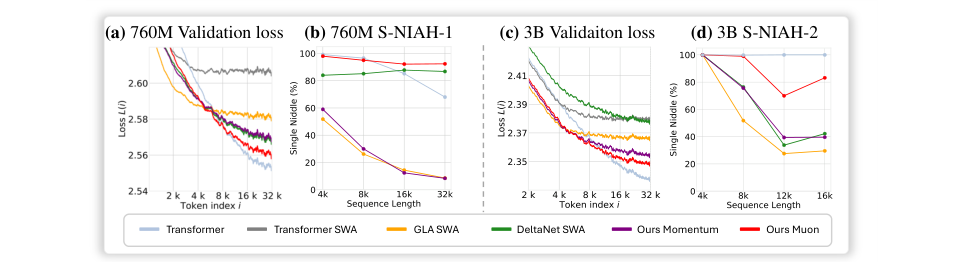
来源:图5,p.9。a/c 为760M和3B的 token位置—验证损失曲线;b/d 分别是S-NIAH-1与S-NIAH-2检索准确率。作者选择的图展示 Muon 的优势,必须再看附录完整任务表。
3B模型,32K长度,准确率百分数(表8–9,p.27):
| 模型 | 单针三项平均↑ | 多键/多问/多值平均↑ |
|---|---|---|
| Transformer | 91.2 | 43.0 |
| GLA+SWA | 13.3 | 11.7 |
| DeltaNet+SWA | 28.4 | 14.8 |
| LaCT Momentum | 40.6 | 14.2 |
| LaCT Muon | 48.0 | 21.2 |
Muon 相对 DeltaNet 的单针平均提高19.6个百分点,但仍落后 Transformer 43.2个百分点。单针中 S-NIAH-1/2/3 的 Muon 结果分别为93.4/30.8/19.8,说明简单检索强并不代表复杂检索也强。
“Muon consistently outperforms Momentum”不是对附录所有单元格都成立:760M、32K多针平均 Muon 7.5,而 Momentum 9.1;3B、4K多针平均 Muon 48.8,而 Momentum 90.4。原图中部分曲线的概括不能扩展为所有任务、所有长度的统一排序。
吞吐也有代价:表3与附录表7(pp.9、26),3B、32K,在8张A100-40GB、FSDP与激活检查点的测量下,单位为每 GPU tokens/s:
| 模型 | 训练吞吐↑ | 每层快权重元素数 |
|---|---|---|
| Transformer | 4.1K | — |
| Transformer SWA | 6.4K | — |
| GLA SWA | 5.0K | $384d$ |
| DeltaNet SWA | 5.1K | $128d$ |
| LaCT GD | 5.0K | $2304d$ |
| LaCT Momentum | 4.9K | $2304d$ |
| LaCT Muon | 4.3K | $2304d$ |
此处 $d=3072$。LaCT 状态是 GLA 的6倍、DeltaNet的18倍,Muon 比 DeltaNet 吞吐约低15.7%。论点是较高容量在可用吞吐下变得可行,并不是所有模型中最快。Muon 对固定状态空间的利用更好与状态本身更大,应分别理解。
4.3 视频:验证历史记忆有用,尚非无限长生成证明
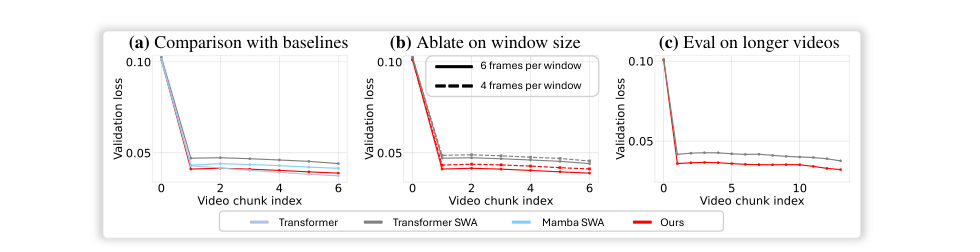
来源:图6,p.10。三组横轴均为视频块索引、纵轴为验证损失:a比较基线,b比较4/6潜变量帧窗口,c比较更长视频。LaCT 接近全块注意力,优于纯SWA及Mamba+SWA;增大局部窗口有益,但曲线显示引入历史记忆有额外收益。
验证用2000视频、训练5000次后的模型,噪声时间点550/650/750/850/950。10秒结果是在10秒视频进一步微调后的评估,作者明确仅测到训练长度。不能称作零样本长度外推。
14B、8.8秒样本含56,160个视觉 token;交错干净/噪声训练序列约107K token,两者统计口径不同。1.3B后续10秒设置约126K交错 token,也不能混作单段干净视频长度。专有训练集与以去噪损失为主的评估限制了可复现性和感知质量结论。
4.4 消融:大块是使容量扩展可行的条件,不是独立万能增益
图7(p.10)分别检验状态大小与在线优化器;图8(p.11)分别检验非线性和更新粒度。
- 更大状态:NVS固定宽度768、14层,训练167B token,SwiGLU中间维192→3072;语言使用760M设置,以减少头数、增大头维扩大状态。质量随状态增长改善,长序列差异更明显。固定模型宽度不等于参数量、状态内存和计算预算全部固定。
- 优化器:NVS与语言的主要曲线中 Muon 优于GD/动量;但完整检索表有反例,视频未见收益,不能跨模态一概而论。
- 非线性:NVS 的 SwiGLU $6d^2$ 对线性 $9d^2$,语言的 SwiGLU $0.375d^2$ 对线性 $0.5d^2$,较小非线性状态仍更好,支持表示形式的重要性。
- 块递归与逐 token 递归:NVS相同 $d^2$ 状态的线性大块模型优于双向Mamba2。语言在相同 $0.25d^2$ 状态下,线性大块模型反而落后GLA;改用大非线性状态 $1.5d^2$ 加Muon才超过对照。因此语言最终收益包含多个共同改变,不能单独归因为“大块更好”。
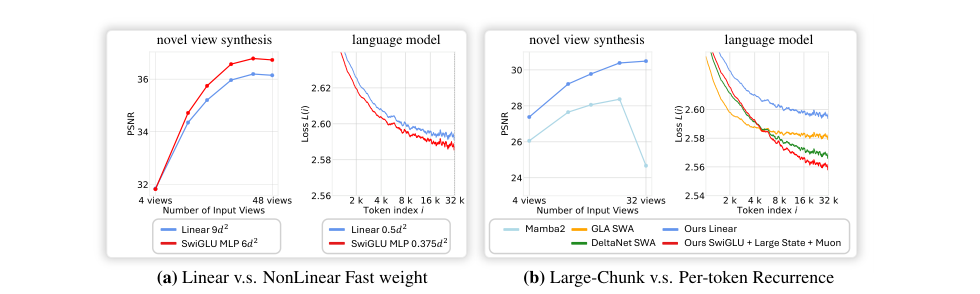
来源:图8,p.11。a左/右为NVS PSNR与语言损失,b比较块递归与逐token递归。纵轴方向不同:PSNR越高越好、损失越低越好。
五:结论、局限与阅读中的核对点
5.1 可以可靠带走什么
LaCT 提供一种可实现的混合架构:用较稀疏的大块写入换取更高计算效率,再把预算用于更大的非线性记忆;因果窗口与任务特定读写顺序使其适用于集合、文本和视频。NVS 的速度与质量证据最直接,语言体现对部分递归基线的改进,视频验证了从大型预训练模型迁移的可行性。
§6 的相关工作强调:LaCT 不是首次提出快权重、窗口与递归混合或块级记忆。相对线性块记忆,其重点是可扩展的非线性状态和更新规则,以及真实硬件上能够运行的大块设计。无需自写TTT专用kernel不意味着整个软件栈没有使用底层优化kernel。
5.2 原文承认及本次分析补充的边界
原文§7(p.13)指出快权重分支缺少普通注意力的共同Q/K旋转不变性,实际影响未充分研究;NVS依赖已知位姿,未研究无位姿重建;语言更大参数规模和推理能力未验证;视频缺少可靠区分长程生成质量的指标。
本次分析补充:固定状态不等于无限容量,训练吞吐不等于逐token生成延迟;块边界更新可能有延迟峰值,本文没有足够数据量化。低秩初值减少慢参数,不自动减少完整在线状态。不同模态的最大长度不能拼成“14B语言模型支持百万token”的结论。三个任务是不同实例化,不是同一个统一多模态模型。
5.3 原文内部不一致与采用原则
以下问题同时核对了作者源码与最终PDF,属于可定位的记号或报告问题;保留原始材料,不擅自改写作者结果。
| 位置 | 问题 | 本笔记处理 |
|---|---|---|
| §3.1,p.5,图3(a)说明段落 | 全集合情形写成“apply followed by update”,与图3及算法1相反 | 以图与NVS具体流程为准:先写入、后读出;标出文字颠倒 |
| 附录A,p.18,状态大小式及矩阵形状 | 三个SwiGLU矩阵的维度/总数表述不自洽,状态式漏掉因子3 | 给出按真实矩阵维度推导的 $S=3rd^2/n_h$,与表1、附录C.2配置核对 |
| 附录A,p.18,FLOPs末尾等式 | 总token计算量与“6×State Size”不一致,缺少token因子 | 用9次matmul推导 $6nS$,不将原式末尾直接引用为成本 |
| 表6,p.25 | 960×536、patch8意味着每图8040 token;64/128视图列出515,520/1,031,520,与乘法不符 | 原表质量数值照录;教学计算应为514,560/1,029,120。两者都约百万,不影响数量级结论 |
| §5.4,p.11,optimizer段落 | NVS训练量写作“671 tokens”,相邻实验写671B | 标记疑似漏B,不替作者确认更正 |
| 正文§5.1与附录C.1,pp.8、24 | 总量1.8T,与附录1.5T加四阶段各约100B不完全吻合 | 主文按原报告1.8T列出;精确复现需进一步查配置 |
| 图5图注与表8–9,pp.9、27 | “Muon始终更好”存在具体任务反例 | 按任务、模型规模和长度分别陈述 |
5.4 可用于组会的讨论问题
- 固定峰值显存和总训练FLOPs后,大状态+Muon还能保持多大收益?
- 随机事实检索、复杂推理与可压缩视觉场景,对最优状态大小是否有不同要求?
- 块长度、状态大小、滑窗长度是否应联合选择,而不是固定其中两项?
- 为何视频任务的Muon收益不明显:预训练迁移、在线目标还是数据冗余结构造成?本文未给出定论。
以上问题是本次分析提出的后续实验方向,均非论文已经证明的结论。