Understanding Transformer from the Perspective of Associative Memory:中文研读笔记
- 作者:Shu Zhong、Mingyu Xu、Tenglong Ao、Guang Shi(ByteDance Seed)
- 原文:arXiv:2505.19488v1 · 本地 PDF;2025-05-26 提交,本次于 2026-11-06 获取并研读
- 发表:截至 2026-11-06,未查到本篇的正式发表记录。arXiv 页面仅列预印本;同团队后来发表了题名、作者及实验范围均不同的 NeurIPS 2025 DeltaFormer 论文,不能把它的会议信息直接记到本篇 v1 上。
- 代码:本篇附录 E.4 给出作者的玩具任务参考代码,但未查到独立的作者仓库;Flash Linear Attention 的 DeltaFormer 实现是第三方公开实现,文件明确链接本篇论文。
论文总览
这篇论文把 Transformer 的注意力层和前馈网络(FFN)都解释成“以键找值”的关联记忆。作者沿两条主线展开:容量由检索时目标信号与其他键值对的干扰决定,核函数影响这种干扰;更新由新信息如何写入、覆盖旧信息决定。在线性记忆的高斯模型下,逆信噪比约为 $N/d_k$;指数核把它降到随 $d_k$ 指数衰减。作者再将 DeltaNet 的“先读出旧值、写入残差”与 Softmax 类核结合,提出 DeltaFormer,并在合成的交换与图可达性任务上展示优势。(Sec. 2–3,PDF pp. 3–21)
要抓住的区分:逆信噪比的推导建立在独立高斯键、值及特定检索设定上;DeltaFormer 的状态交换定理使用理想化核函数;实验报告的是有限规模合成任务的学习曲线。这三层证据各自支持不同的结论。
结构地图
| 原文章节 | 主要作用 | PDF 页码与定位 |
|---|---|---|
| 1 Introduction | 给出关联记忆视角与容量、更新两条问题线 | pp. 1–3 |
| 2 Associative Memory | 建立 $S$ 的写入与查询表示 | pp. 3–4 |
| 2.1 Memory Capacity | 逆 SNR、线性/指数/ReLU 核、FFN 解释及模块设计讨论 | pp. 4–10;Table 1,p. 7 |
| 2.2 Memory Update | 统一递推、DeltaFormer、表达能力与无限上下文讨论 | pp. 10–17;Table 2,p. 11;Fig. 1,p. 15 |
| 3 Experiments | 多头取舍、交换跟踪、图可达性 | pp. 17–21;Figs. 2–7 |
| 4 Conclusion | 长短期记忆整合和架构设计的开放问题 | pp. 21–22 |
| Appendices A–F | SNR/目标函数推导、分块实现、交换定理及玩具代码 | pp. 26–46;Theorem 1,p. 36;Fig. 8,p. 40 |
一:动机——把“记住多少”与“怎样改写”分开
经典外积记忆把在时刻 $i$ 到来的键 $k_i\in\mathbb R^{d_k}$ 与值 $v_i\in\mathbb R^{d_v}$ 写成 $v_i k_i^\top$,累计状态 $S_t\in\mathbb R^{d_v\times d_k}$。查询 $q$ 时计算 $S_tq$。这个形式既像线性注意力的状态,也暴露出两个独立问题:多个键靠近时会互相干扰;仅追加外积时,旧值无法按新目标改写。(Sec. 2,PDF p. 3)
作者将注意力视作上下文中的短期关联:当前序列的 KV 对在推理结束后丢弃;将无偏置两层 FFN 的权重视作训练后保留的长期关联。这是一种有用的代数视角,并非声称每个神经元都对应一条可独立读取的事实。随后论文分别研究检索核与写入规则,最后把两者组合成 DeltaFormer。(Sec. 1–2.1,PDF pp. 2–7)
二:方法——从检索信噪比到 DeltaFormer
2.1 基本记忆与检索噪声
把键映射到特征空间 $\phi(k)$,令 $\kappa(x,y)=\phi(x)^\top\phi(y)$,则
当 $q=k_i$,目标项是 $v_i\kappa(k_i,k_i)$,其他 $N-1$ 项是干扰。作者定义 $\mathrm{SNR}^{-1}=\mathbb E[\|r\|^2/(c^2\|v_i\|^2)]$,其中 $c=\kappa(k_i,k_i)$,$r=\sum_{j\ne i}v_j\kappa(k_j,k_i)$;越小越好。在键、值独立同分布标准高斯,且值长度近似一致、$N$ 足够大的条件下,交叉项期望消失,得到
它测的是给定随机存储模型中的检索干扰,不是实际语言模型的通用容量指标。(Sec. 2.1,Eqs. 5–10,PDF pp. 4–5;Appendix A,pp. 26–28)
| 检索核 $\kappa(x,y)$ | 论文给出的逆 SNR 近似 | 读法 |
|---|---|---|
| 线性 $x^\top y$ | $N/d_k$ | 固定维度时,存储对数增加会线性抬高干扰。 |
| ReLU $\max(0,x^\top y)$ | $N/(2d_k)$ | 去掉负相似度,干扰约减半。 |
| 指数 $\exp(x^\top y/\tau)$ | $N\exp[-2(\tau-1)d_k/\tau^2]$,$\tau>1$ | 自匹配相对随机交叉匹配更突出。 |
这里 $N$ 是存储对数、$d_k$ 是键维度、$\tau$ 是温度。取通常的 $\tau=\sqrt{d_k}$ 时,指数核的分母约为 $\exp[2(\sqrt{d_k}-1)]$;要在 $N$ 增大时维持常数量级的逆 SNR,文中的推论是 $d_k$ 随 $\log^2N$ 增长,而线性核需要约随 $N$ 增长。该结论针对上述高斯近似和未归一化的检索分解;真实 Softmax 的分母依赖查询,不能将它直接抹去再声称两个算子完全相同。(Sec. 2.1,PDF pp. 5–6;Appendix A,pp. 27–28)
2.2 FFN 也是键值匹配,但“核”只是一部分设计
对无偏置 ReLU FFN,$\mathrm{FFN}(x)=W_V^\top\mathrm{ReLU}(W_Kx)=\sum_{a=1}^{m}v_a\,\mathrm{ReLU}(k_a^\top x)$;$W_K$ 的行充当持久键,$W_V$ 的相应行充当值。这解释了为什么“注意力与 FFN 都可以按键取值”,也说明两者在权重来源、存储寿命和归一化上仍不同。(Sec. 2.1,Eq. 14、Table 1,PDF p. 7)
作者进一步假设:FFN 的较模糊检索利于多个信息片段叠加、压缩长期知识,注意力的指数核利于精准定位上下文 token。论文借 SoLU 的既有观察作旁证,但没有在本篇对相同 FFN 预算做核函数消融来验证这一因果解释。多头、稀疏路由和门控是作者提出的跨模块设计方向;Table 1 列出现有差异,后续大多是机制讨论和待检验建议。(Sec. 2.1.1,PDF pp. 7–10)
2.3 更新规则:直接相加与残差写入
作者用 $S_t=A_tS_{t-1}B_t+C_t$ 统合多种记忆更新。当 $A_t,B_t$ 对称时,可构造一个使单位步长梯度下降恰好给出该递推的标量目标;这是对给定更新式的代数解释,不意味着每个架构实际都在显式优化这个目标。(Sec. 2.2,Eq. 35;Appendix B.1,PDF pp. 10、29)
| 机制 | 写入形式 | 关键差别 |
|---|---|---|
| 线性注意力 | $S_t=S_{t-1}+v_tk_t^\top$ | 不检查同键已有内容;对应的内积目标无下界。 |
| Gated Linear Attention | $S_t=\operatorname{diag}(\lambda_t)S_{t-1}+v_tk_t^\top$ | 以门控衰减旧状态。 |
| DeltaNet | $S_t=S_{t-1}+(v_t-S_{t-1}k_t)k_t^\top$ | 先预测旧值,再写入误差;对应 $\tfrac12\|S_{t-1}k_t-v_t\|^2$。 |
| Softmax 类注意力 | $S_t\approx\tfrac{t-1}{t}S_{t-1}+\tfrac1t v_t\phi(k_t)^\top$ | 只在大 $t$ 且查询分母可按大数定律近似时,是归一化记忆的表示。 |
DeltaNet 的 $-S_{t-1}k_t$ 是按当前键选择性擦除,与所有旧内容同乘一个遗忘门不同。若 $\phi(k)$ 换成指数特征,这一步也要在特征空间计算;作者利用核技巧避免显式存储无限维向量。(Sec. 2.2,Table 2,PDF pp. 10–12;Appendices B–C,pp. 29–32)
2.4 DeltaFormer:先算增量值,再用核注意力读取
从特征空间的 delta 更新 $S_t=S_{t-1}+[v_t-S_{t-1}\phi(k_t)]\phi(k_t)^\top$ 出发,设 $S_t=\sum_{i\le t}u_i\phi(k_i)^\top$,即可逐步解出
直觉是:先用新键找出旧记忆会给出的值,再把差额 $u_t$ 写入。这个等价变换要求写入和读取使用同一个 $\phi$、对应的 $\kappa$,且此处省去了 Softmax 归一化。推广后的 DeltaFormer 允许两种核、两个门和写入查询 $w_t$ 分别选择:
$\alpha_t,\beta_t$ 决定写入与扣除强度。置 $\beta_t=0,\alpha_t=1$ 并为读取加 Softmax 归一化,可回到普通 Transformer 注意力;令 $w_t=k_t$ 且两个核均线性,则为 DeltaNet。一般化后 $\kappa_1\ne\kappa_2$ 的模型不再自动满足前述“同一核的精确等价”,但保留残差写入的设计思想。(Sec. 2.2.1,Eqs. 37–42,PDF pp. 12–14;Appendix C,pp. 31–32)
训练时 $u_t$ 依赖此前所有 $u_i$,朴素计算有 $O(T^2d)$ 乘法与 $O(T)$ 串行步;读取阶段仍是成对核计算。附录将严格下三角相似度矩阵记为 $A$,写成 $U=(I+A)^{-1}V$,每块并行求解、块间顺序推进。块长 $C$ 时作者给出 $O(T/C)$ 个串行块与 $O(T^2d+TCd+TC^2)$ 计算量,体现并行深度和算力开销之间的取舍;这不是已测得的实际吞吐提升。(Sec. 2.2.1,PDF pp. 15–16;Appendix D.3,pp. 33–35)
2.5 状态交换定理与无限上下文思辨
附录 Theorem 1 构造 $n$ 个近乎正交的单位键,要求任意两键内积绝对值 $\le\epsilon<1/8$;核函数 $f$ 必须把 $-1,0,1,2$ 各自 $4\epsilon$ 邻域的输入精确映回该整数。若模型能在一次交换时生成 $k_t=k_a-k_b,v_t=0$,则对 $k_a,k_b$ 的读取结果互换,其他键对应的值保持不变。论文由此讨论在 $d=O(\log n)$ 的构造下跟踪任意多次交换,并把五元素交换任务与 $NC^1$ 级表达能力联系起来。(Appendix E,PDF pp. 35–40)
这一结论是存在性构造:需要特定键、精确核和可实现的投影;Sec. 3 用的“round”按图注是保留两位小数,$\kappa_2$ 则取 Softmax,均不等同于定理中两处共用的理想 $f$。因此实验检验的是可学习性线索,不是定理条件在训练模型中逐项成立的证明。论文把超出 $TC^0$ 说成结论时,还应记住 $TC^0$ 与 $NC^1$ 的严格分离本身是复杂性假设。(Sec. 2.2.1,PDF pp. 14–15;Sec. 3.2,pp. 18–19;Appendix E,p. 36)
关于“无限上下文”,作者先研究固定 $W_k,W_v$ 的单头 DeltaNet:若 $W_k$ 方阵可逆、输入协方差正定且分布稳定,期望最小二乘的最优状态为 $S^*=W_vW_k^{-1}$。作者据此推想状态趋近固定映射,新的上下文贡献变弱;多头低秩投影会使最优解依赖协方差。对 Softmax,论文在“大 $t$ 分母近似”下得到单步系数 $1/t$,并推想更新逐渐停滞。这些是特定模型和近似下的机制推演;$1/t\to0$ 本身并不证明累计适应消失,也没有给出真实多层 Transformer 无限上下文的退化定理。(Sec. 2.2.2,PDF pp. 16–17;Appendices B.2、F,pp. 30–31、46)
三:实验——问题、对照和指标
| 原文小节 | 检验问题与设置 | 对照与指标 |
|---|---|---|
| 3.1 Multi-head Efficiency Trade-off | GPT-2 small:12 层、隐宽 768;比较 12 头与 1 头,头维随头数改变。 | 线性核注意力与指数核注意力;两者都改为每头 RMS 归一化,所以图中的 Softmax 对照并非原始标准归一化实现。指标是验证损失,越低越好。(Fig. 2,PDF pp. 17–18) |
| 3.2 Track the Exchange of Elements | 五个位置的元素依次交换,默认序列长度 16,预测位置 1 的当前元素;输入是 $\binom52=10$ 种交换、输出是 5 类。 | 1/2/4/8 层 Transformer 与不同 $\kappa_1$ 的 DeltaFormer;$\kappa_2$ 保持 Softmax。图示准确率对训练步数,越高越好。(Figs. 3–4,PDF pp. 18–19) |
| 3.2 压力及课程实验 | $d=128$,$n=128/256/512$,交换长度相应为 256/512/1024;另比从 32 逐步延长至 256 与直接用 256 训练。 | 线性核、两位小数 round 核;课程图比较 RoPE 与无位置编码 NoPE。指标为当前训练长度上的准确率。(Figs. 5–6,PDF pp. 19–20) |
| 3.3 Reachability of Directed Acyclic Graphs | 32 个节点,按拓扑序生成两类树结构,预测从指定根可达的节点。 | 多层 Transformer 与 1 层 DeltaFormer 的不同 $\kappa_1$;$\kappa_2$ 是 Softmax。指标为准确率,越高越好。(Fig. 7,PDF pp. 20–21) |
四:结果——哪些发现由图直接支持
4.1 多头数改变的是两种核的不同瓶颈
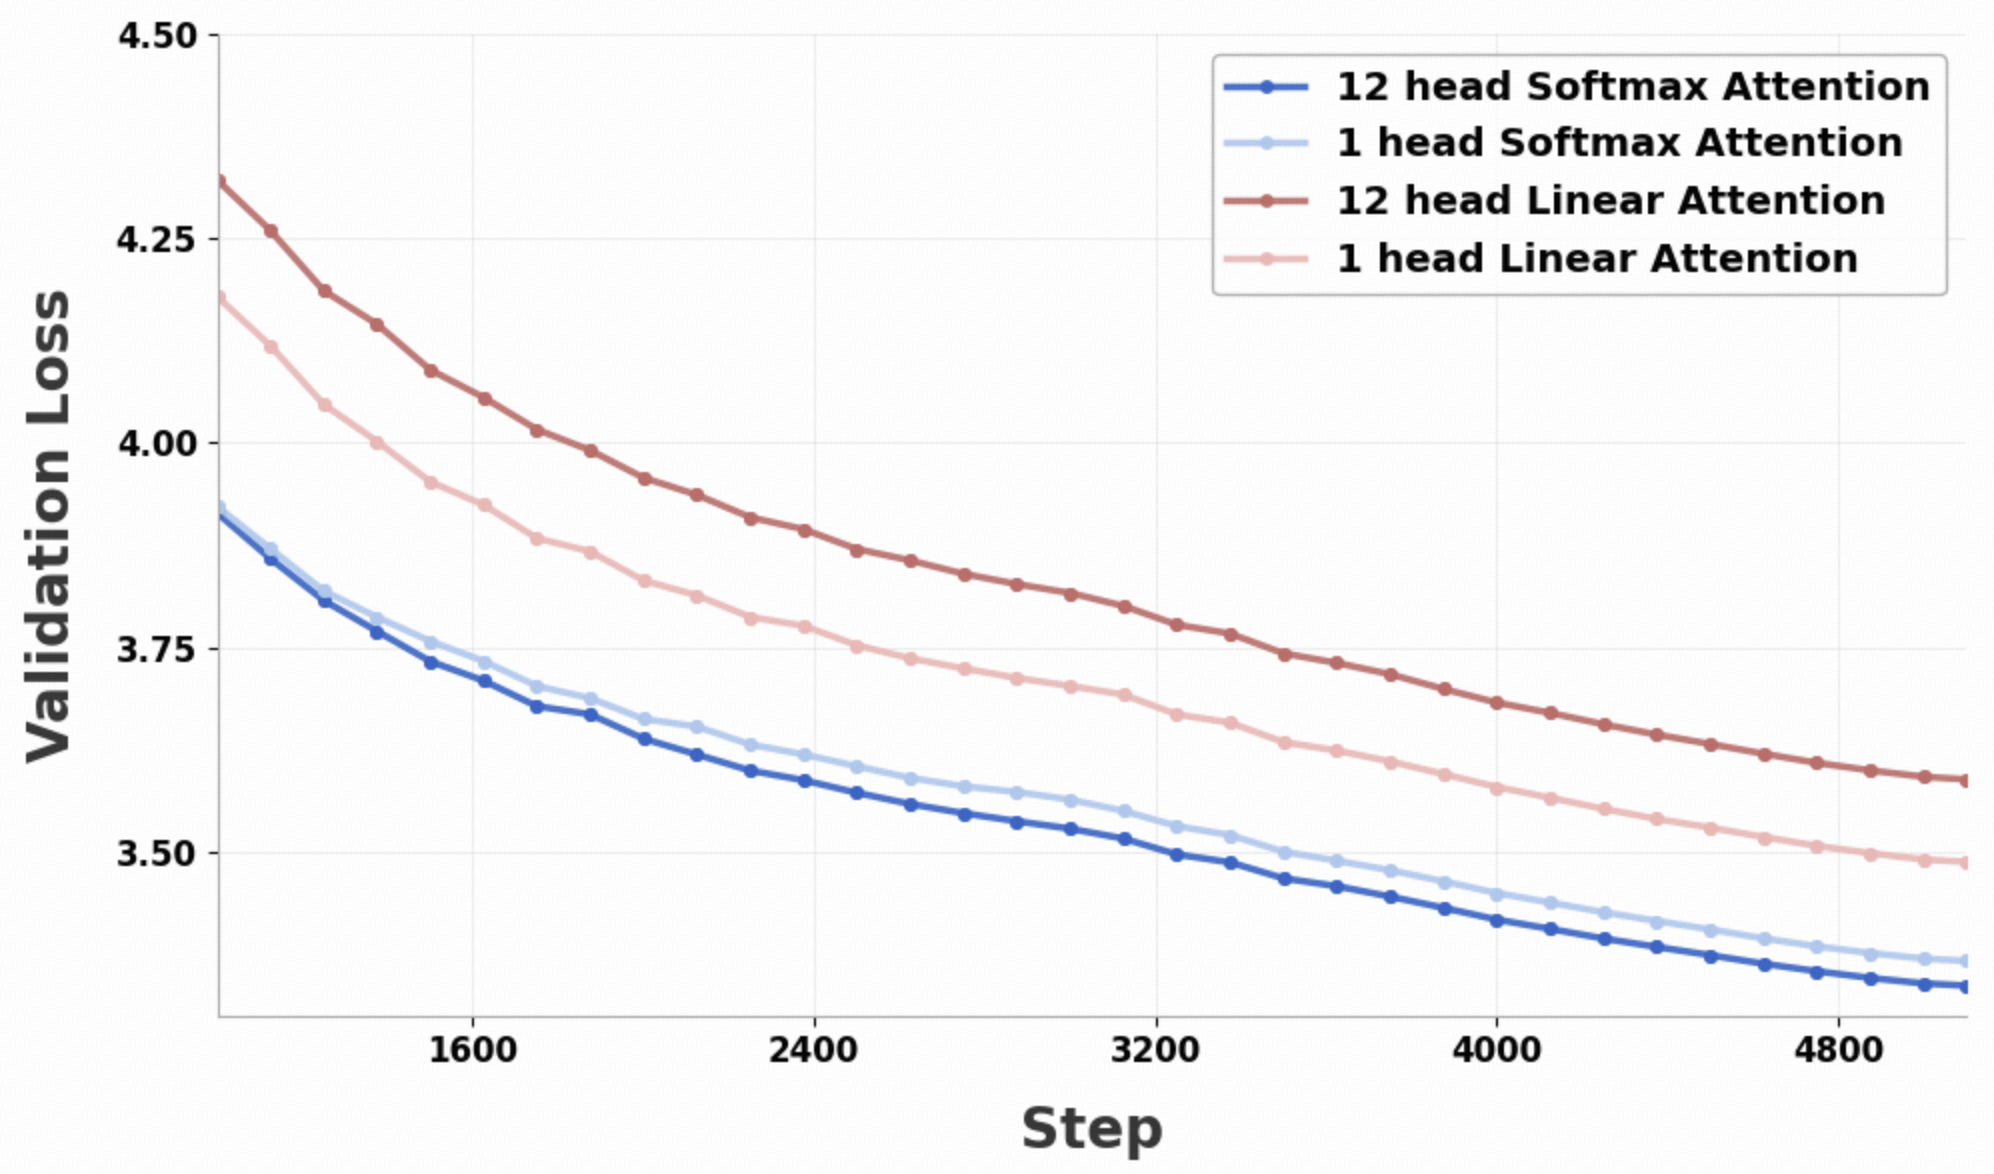
Fig. 2(PDF p. 17)的横轴为训练步数,纵轴为验证损失;蓝色对应指数核、红色对应线性核,深浅两条分别是 12 头和 1 头。在固定总隐宽 768 下,线性核从 12 头改成 1 头时曲线更低;指数核则略高。作者解释为线性核更需要每头维度降低检索噪声,而指数核可以把维度分给更多头以提高模式表达能力。这是对 SNR 直觉的间接支持:验证损失同时受优化、头间组合等因素影响,图没有直接测量推导中的检索 SNR。(Sec. 3.1,PDF pp. 17–18)
4.2 五元素交换:写入核比单纯加深 Transformer 更关键
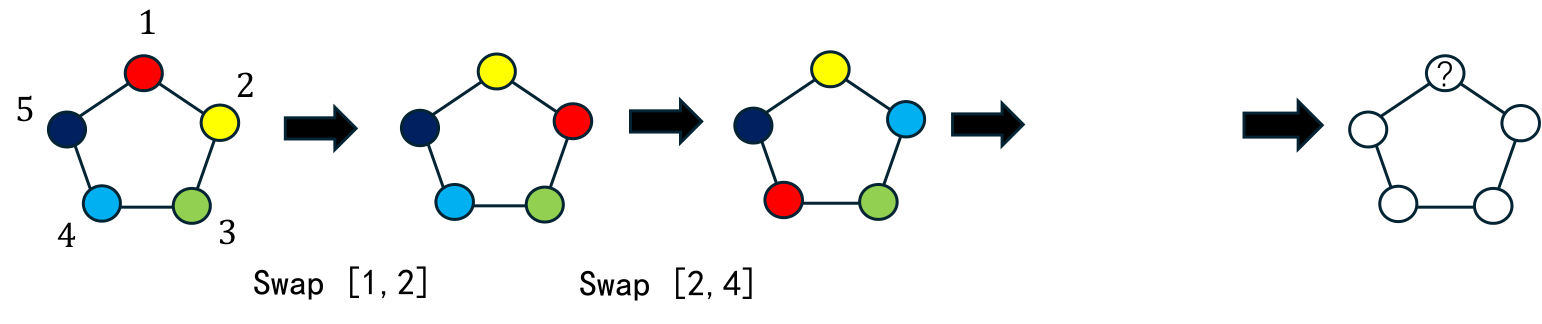
Fig. 3(PDF p. 18)把每次输入表示为两个位置的交换,模型每一步回答位置 1 当前是什么。下面两幅均取原 Fig. 4 的对应面板;纵轴刻度不同,应分别读准确率,而不是只比较曲线高度。
| Transformer 对照 | DeltaFormer:两位小数 round 写入核 |
|---|---|
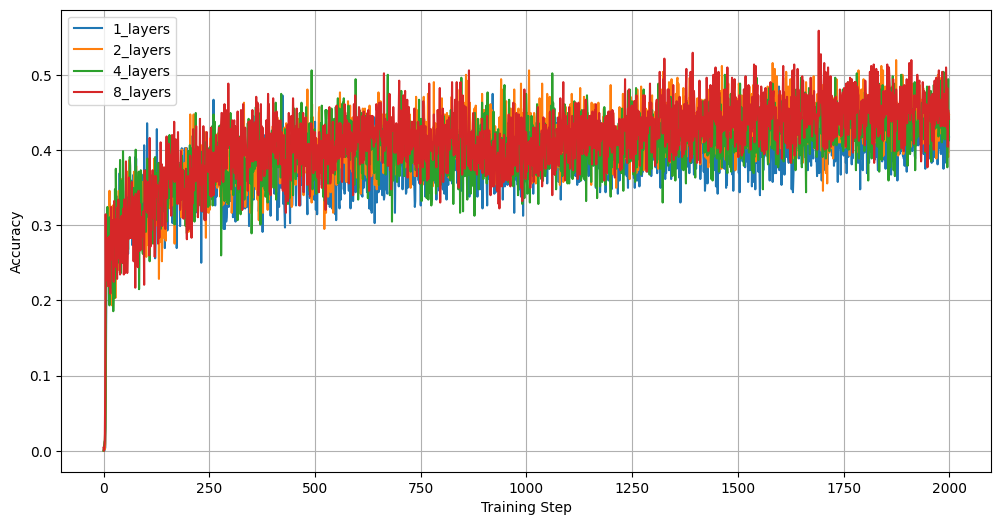 | 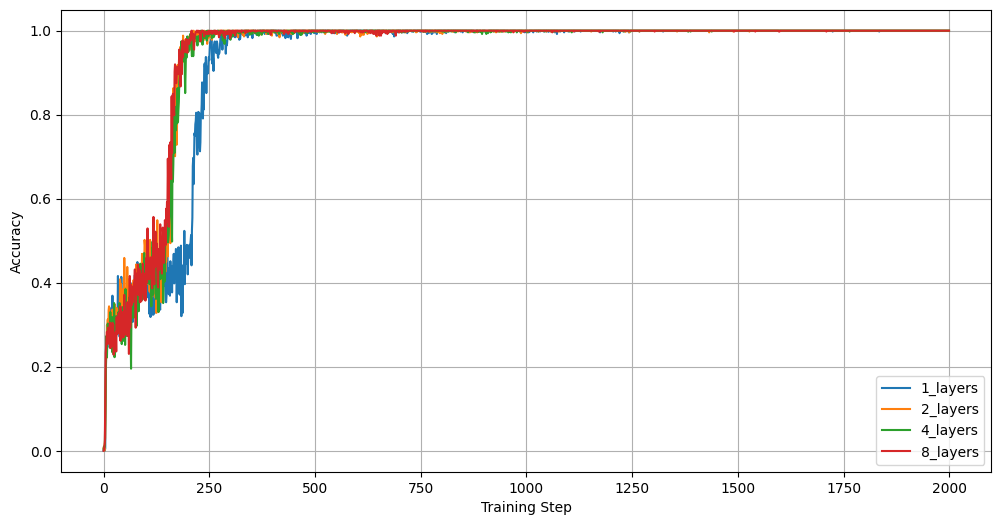 |
在长度 16 的任务中,图上的 1–8 层 Transformer 到 2000 步仍在约 0.4–0.45;round 或线性 $\kappa_1$ 的 DeltaFormer 多数曲线到约 250–300 步已接近 1.0。ReLU、Exp、Softmax 写入核的曲线各异,其中 Softmax 写入核并未出现同样的快速满分,说明残差写入的相似度函数本身显著影响优化。此图报告的是训练曲线;论文未在图注中给出独立测试集或多随机种子的区间。(Fig. 4,PDF pp. 18–19)
4.3 维度固定后的压力测试与课程学习
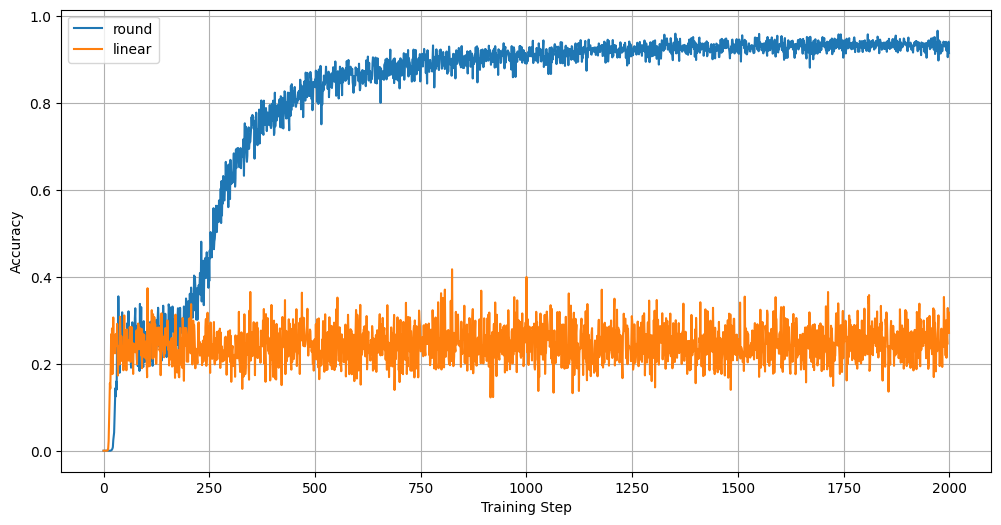
Fig. 5(PDF p. 19)将键维固定在 128、把状态数从 128 提到 512;在最难的 $n=512$ 面板中,round 曲线约达 0.9 以上,线性曲线徘徊在约 0.25。此组实验采用接近正交的预设键和值,模型主要学习读取,因此它更直接地检验核的区分能力,不能直接外推为端到端语言建模收益。(Sec. 3.2,PDF pp. 19–20)
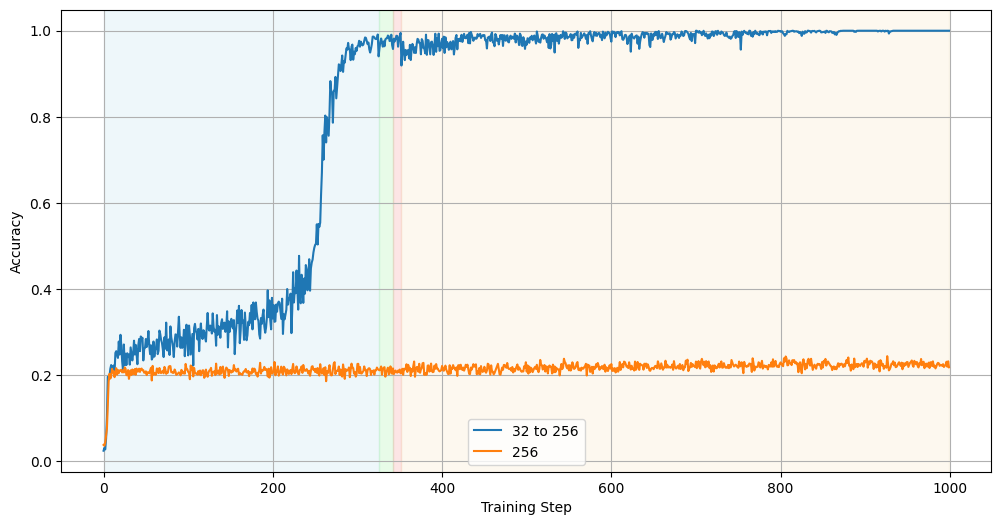
Fig. 6(PDF p. 20)把训练长度直接设为 256 与达到 0.99 后逐次从 32 翻倍至 256 比较。在 NoPE 面板,直接训练几乎保持在随机水平约 0.2,课程训练最终接近 1;RoPE 面板的直接训练后来也能上升。作者据跨长度跃迁处的跌落推测 NoPE 的长度泛化较好、RoPE 更易优化。图的纵轴是当前训练长度准确率,颜色区段表示长度变化,不是固定长度的统一测试集。(Sec. 3.2,PDF p. 20)
4.4 图可达性与附录的多查询结果
| Transformer | DeltaFormer |
|---|---|
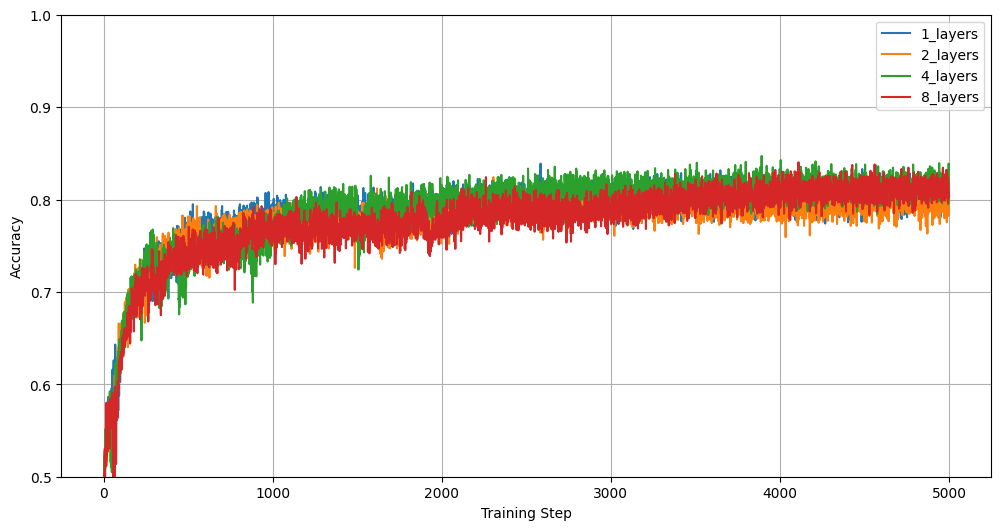 | 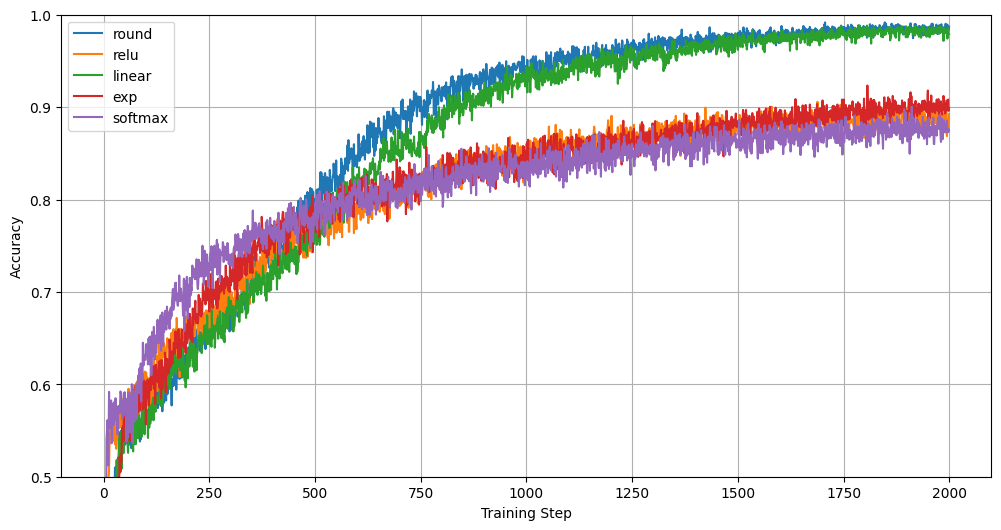 |
Fig. 7(PDF p. 21)在 32 节点构造任务上显示,多层 Transformer 到约 5000 步仍在 0.8 左右,而 1 层 DeltaFormer 的 round、ReLU、线性曲线在约 2000 步逼近 1;Exp 与 Softmax 写入核稍低。该图支持文中构造任务上的更易学习,但并不单独区分“模型能够表示”与“优化过程更快”两种原因。(Sec. 3.3,PDF pp. 20–21)
附录 Fig. 8(PDF p. 40)另用头维 3、五元素交换 16 次测试 GQA 类多写入查询。指数核配置随查询数从 1 提到 3、4,训练准确率从约 0.2 提至约 0.9、接近 1;线性核配置保持约 0.6。它为“多个查询组合出更复杂的非线性匹配”提供了局部实验线索,但不替代 Theorem 1 对精确 $f$ 的条件。(Appendix E.2,PDF pp. 40–41)
五:结论与研读判断
论文最有用的贡献是把 核选择影响检索干扰 与 delta rule 影响旧值改写 放到同一关联记忆框架里。指数核的逆 SNR 推导解释了为何精准检索可能以较少键维应付更多记忆项;DeltaFormer 的 $u_t$ 递推则给出一个可计算的“先抵消再写入”构造。有限规模的交换和图任务显示,写入核、课程训练及查询头数都会影响能否学到这个构造。(Sec. 2–3,PDF pp. 4–21)
理解其适用范围时,最关键的三点是:SNR 公式依赖理想随机键值模型;Theorem 1 的精确核与训练实验的核/读取规则有差别;无限上下文的退化论证是从单头稳态解和 Softmax 大 $t$ 近似作出的推想。因而后续最直接的问题是:在端到端语言建模、固定算力和真实长度外推下,残差写入能带来多少收益,以及怎样在保持可训练性的同时逼近定理所需的选择性核。(Sec. 2.2.1–2.2.2、3,PDF pp. 12–21;Appendix E,pp. 35–40)