LatentLLM:注意力感知联合张量压缩——中文精读笔记
- 原题:LatentLLM: Attention-Aware Joint Tensor Compression
- 作者:Toshiaki Koike-Akino、Xiangyu Chen、Jing Liu、Ye Wang、Pu (Perry) Wang、Matthew Brand;Mitsubishi Electric Research Laboratories(MERL)。作者姓名已按 PDF 首页与主 TeX 核对;抓取器将 Pu (Perry) Wang 拆成两项,本文不沿用该解析错误。
- 版本:arXiv:2505.18413v1,提交于 2025-05-23;获取与研读日期:2026-09-24。
- 原文:arXiv 版本页 · 本地 PDF · 作者主 TeX · 作者源码清单。
- 配套成品:英文组会幻灯片 · 可编辑 TeX。
- 材料与覆盖:实际下载同版本 PDF 和作者 TeX 源码包,源码状态为
available。沿main.tex、sections/{abst,intro,related}.tex、app.tex及其引用的weight/act/qkv/att/pe/vo/mlp/spa/model.tex阅读正文与附录 A–J;对照 PDF 检查主结果表及图 1–16。PDF 共 37 页,以下页码均从 1 开始,与印刷页码一致。本笔记是原文分析,没有运行作者模型实验,也不把公式推导视为独立复现实验。
论文总览
核心问题:如何将一个已经训练好的 Transformer 转换成低维潜在结构,减少权重和注意力相关开销,同时尽量保持原模型行为?
主线:低秩压缩有三个可分别改进的环节:用什么误差度量决定保留哪些方向;怎样表示同一个低秩矩阵以避免存储冗余;哪些相邻投影应当共同近似。LatentLLM 将平方根二阶统计预条件(RootCov)、含单位块的分解形式,以及 Q/K、V/O、MLP 上下投影的联合近似放进一个框架。
最有证据支持的结论:在论文评测的 OPT 125M–13B 与一个 LLaVA 模型上,完整方法相对局部 SVD/ASVD 变体提供更好的质量—压缩取舍。例如,标称 20% 压缩时,OPT-6.7B 在 WT2 的困惑度为 11.5,局部 RootCov 为 13.5,原模型为 10.9;ScienceQA 总体准确率为 63.85%,局部 RootCov 为 57.53%,原模型为 70.03%。(表 2,p.6;表 4,p.10)
阅读时要保留的边界:这里的“全局”主要是相邻投影/模块范围的联合目标;没有证明整网任务损失的全局最优。联合 VO 的简单目标没有表现出优于分别压缩的收益。效率结果主要是计算量统计,没有实测延迟、吞吐、显存或能耗表。无需微调也不意味着无需校准数据。
结构地图
| 原文章节 | 在论证中的作用 | PDF 定位 |
|---|---|---|
| 1. Introduction;2. Related work | 将预训练模型转为潜在结构,定位低秩压缩与相关路线 | pp.1–2 |
| 3.1 Reduced-dimension LLM/LMM | 局部与联合压缩架构 | p.2,图 1 |
| 3.2 Activation-aware SVD: Pre-conditioning | 从激活重构误差导出 RootCov | pp.2–3,式 (1)–(5)、表 1 |
| 3.3 Junction matrix for model compression | 分解自由度与单位块的参数节省 | pp.3–4,式 (6)–(9)、图 2 |
| 4.1 Multi-head latent attention: Joint QK SVD | 注意力分数误差、Tucker 近似、交替更新 | pp.4–5,式 (10)–(13)、图 3、算法 1 |
| 4.2 Multi-head latent attention: Joint VO SVD | V/O 联合目标及其不足 | p.5,式 (14)–(18)、Remark 11 |
| 4.3 Latent MLP: Joint UD SVD | 用辅助变量分解非线性模块目标 | pp.5–7,式 (19)–(22) |
| 5. Experiments | 校准、对照、困惑度、FLOPs、多模态结果 | pp.6–10,表 2–4、图 4–6 |
| 6. Summary | 作者总结 | p.9 |
| A–B. Weight-/Activation-Aware Compression | SVD、分解自由度、预条件与偏置修正 | pp.13–15,图 7 |
| C–D. Joint QKV / Split-Head Compression | 共享压缩空间和逐头压缩的对照 | pp.15–17,图 8–9 |
| E. Multi-Head Attention | QK 推导、激活统计、偏置、GQA | pp.17–26,图 10–11 |
| F. Positional Encoding | 加法、拼接、乘法编码与 RoPE | pp.26–28,图 12 |
| G. Joint Value-Output Compression | 偏置及使用真实注意力统计的替代目标 | pp.28–31 |
| H. MLP-Aware Joint Compression | 联合 UD 细节 | pp.31–32 |
| I. Sparse Matrix;I.1 Quantization-Aware Distillation | 稀疏、低秩加稀疏及量化扩展 | pp.32–36,图 13–16 |
| J. LLM Models | 模型结构列表;不等于全部经过实验验证 | pp.34–37,表 5–7 |
参考文献位于 pp.9、11–12;结果图表有跨页浮动,因此章节页码并非互斥区间。
一:动机——近似权重,不一定保住模型的计算
设线性层为 $Y=WX$。普通截断奇异值分解(singular value decomposition, SVD)寻找最接近 $W$ 的低秩矩阵,但模型只在具体输入分布上使用这些权重。若某个输入方向很常见,即使该方向的权重误差不大,也可能产生较大的输出误差;另一些输入方向几乎不用,精确保留它们可能浪费秩。
激活感知方法因此最小化 $\|WX-\hat W X\|_F^2$。但逐层输出接近仍不保证最终交互接近:注意力依赖 $Q^\top K$,MLP 依赖“上投影—非线性—下投影”的组合。Q 和 K 的误差可能抵消,也可能在内积中放大。LatentLLM 的关键转向,是把误差目标推进到这些组合所计算的量。
另外,维度缩小不自动意味着参数减少。把 $d\times d$ 矩阵拆成两个秩为 $r$ 的稠密因子,需要 $2dr$ 个参数;当 $r>d/2$ 时,反而比原矩阵更大。这正是 junction matrix 所处理的问题。(Sec.3,pp.2–4)
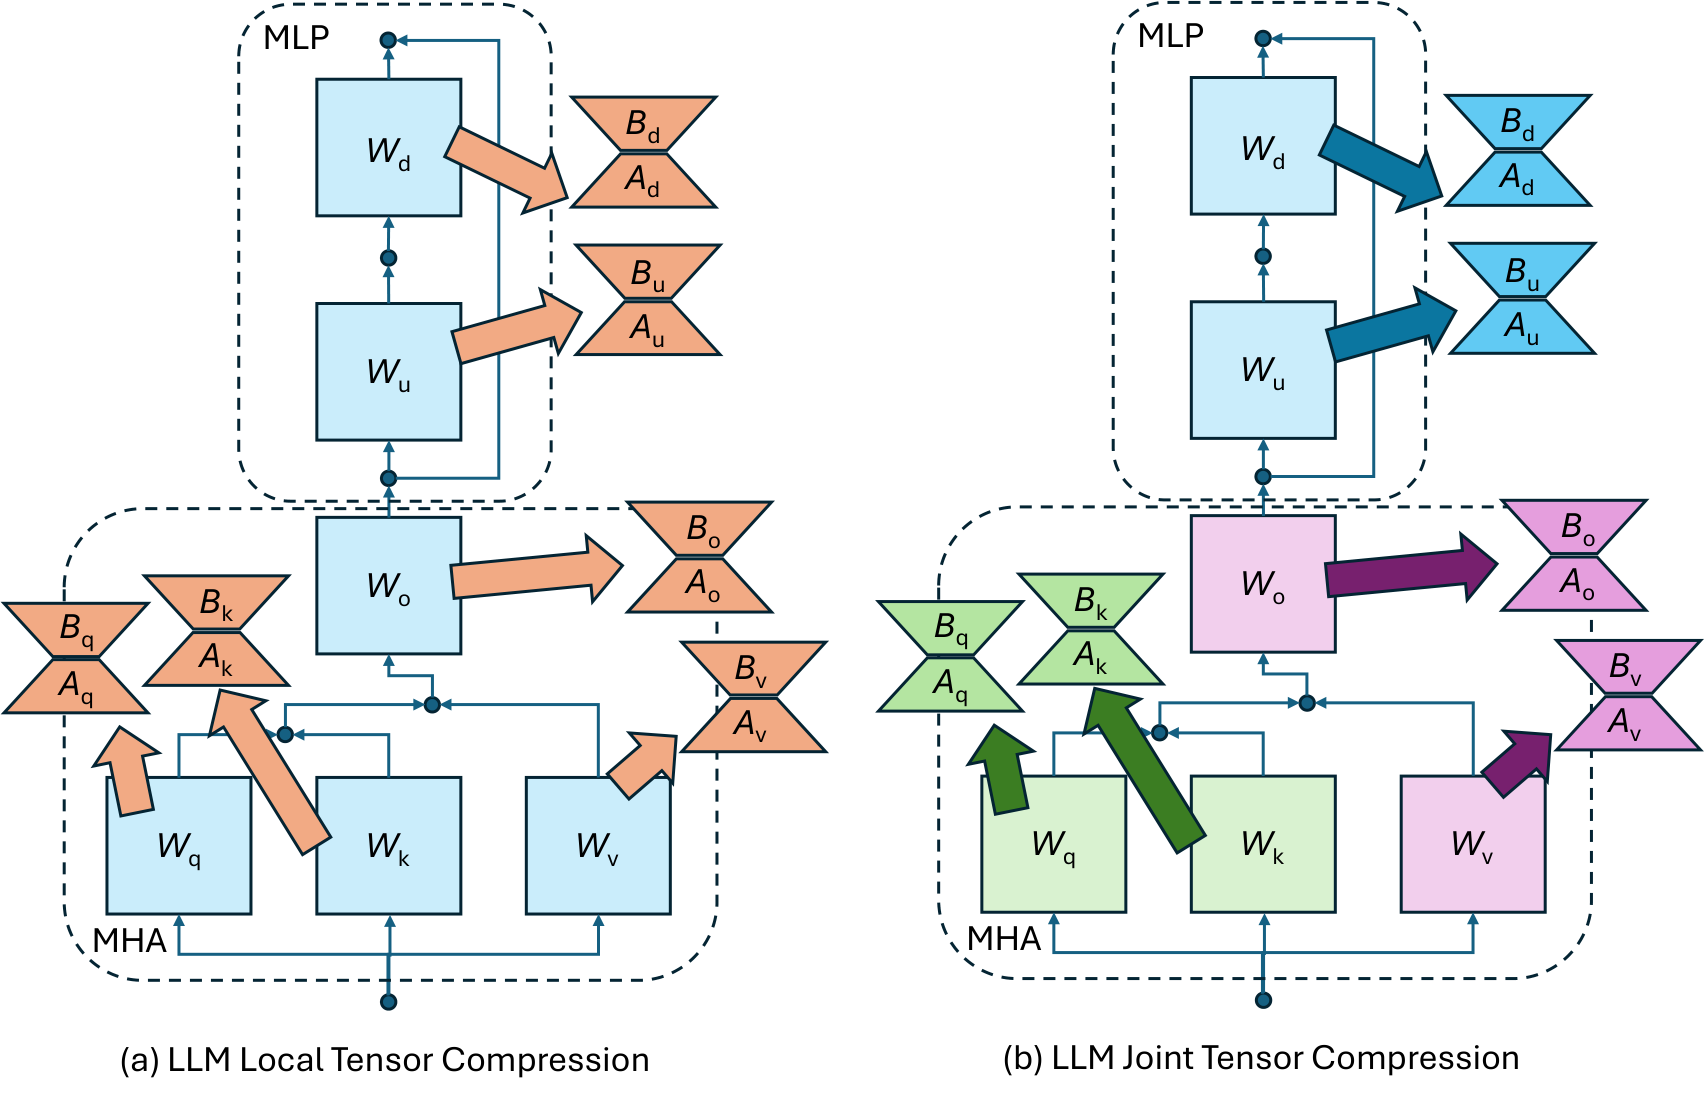
原图 1,PDF p.2;复用作者矢量图并转为 PNG。左侧分别压缩每个线性投影;右侧突出 Q/K、V/O、MLP 上下投影的组合。图中的连接表示联合处理关系,不表示所有模块都有独立的正向消融证据。
二:方法——统计、表示与联合目标
2.1 符号与输入输出
| 符号 | 含义 / 维度 |
|---|---|
| $X\in\mathbb R^{d\times l}$ | 校准输入;列为 token/样本 |
| $W\in\mathbb R^{d'\times d}$ | 待压缩线性层权重 |
| $A\in\mathbb R^{r\times d}$、$B\in\mathbb R^{d'\times r}$ | 压缩与解压因子,$\hat W=BA$ |
| $C$、$P$ | 输入二阶统计矩阵与预条件矩阵,均为 $d\times d$ |
| $J\in\mathbb R^{r\times r}$ | 改变因子表示的连接矩阵(junction matrix) |
| $h$、$d_{\mathrm h}$ | 头数、每头维度;标准 MHA 常有 $hd_{\mathrm h}=d$ |
| $r_{\mathrm q},r_{\mathrm k},r_{\mathrm v},r_{\mathrm o}$ | 各潜在空间维度,不必相等 |
| $[\cdot]^+$、$\|\cdot\|_F$ | 伪逆、Frobenius 范数 |
输入是预训练权重、少量校准样本与目标压缩预算;输出是低秩因子、必要的偏置修正和可省略单位块的结构。校准阶段涉及统计估计、SVD/特征分解、交替更新;推理阶段使用固定因子,不再执行这些求解步骤。论文没有进行端到端微调,但压缩本身包含优化计算。
2.2 RootCov:为什么是平方根,而非协方差本身?
原文式 (1)–(5),PDF p.2:
其中 $C=\mathbb E[XX^\top]$。这里严格说是未中心化的二阶矩/自相关,没有减去均值时不能直接叫中心化协方差。于是只需对 $WC^{1/2}$ 做截断 SVD:
令 $USV=\operatorname{svd}_r(WP)$,采用原文把右奇异向量存为“行”的 $V$ 记法,可取 $B=US$、$A=VP^+$,其中 $P=C^{1/2}$。
这给出的最优性有明确范围:固定统计矩阵、固定秩、单个线性层的平方重构误差。它不是困惑度最优或整网最优。有限数据时原文采用 $C\approx XX^\top+\lambda I$;阻尼让逆运算更稳定,同时把目标变成带正则的近似目标。统一乘一个正标量不改变理想解,但阻尼大小和样本估计误差会影响解。论文没有明确报告所有实验使用的 $\lambda$。
若改用 $P=C$,SVD 实际优化 $\|(W-BA)C\|_F^2$,相当于在误差中使用 $C^2$ 权重,和原激活误差不同。对角 $\ell_2$ 预条件只保留每个输入维度的能量,忽略维度间的相关性。表 1 是借用不同工作的预条件形式做比较,不能据此把这些行当成 GPTQ、AWQ、SparseGPT 的完整算法实现。(表 1,p.3;附录 B.1,pp.14–15)
2.3 Junction matrix:相同乘积可以更省存储
原文式 (7)–(9),PDF p.3:
只要满足 $SJJ^+=S$,乘积 $BA$ 不变。对于满秩 $J$,这就是对潜在空间作一次可逆换基。
将 $VP^+=[V_1\;V_2]$,$V_1\in\mathbb R^{r\times r}$。若 $V_1$ 可逆,选 $J=V_1$,就有
因此输入分块为 $x=[x_1;x_2]$ 时,潜在表示为 $Ax=x_1+V_1^{-1}V_2x_2$。单位块无需存成稠密参数,也无需做普通矩阵乘法;仍然有向量读取、加法及可能的置换成本。
若首个子块奇异,可选取其他线性无关列并保存置换索引。本次分析:数学上可逆不等于数值上稳定,还应检查子块条件数;要兑现参数与计算节省,实现必须识别并省去单位块,不能仍然存储两个完整稠密矩阵。
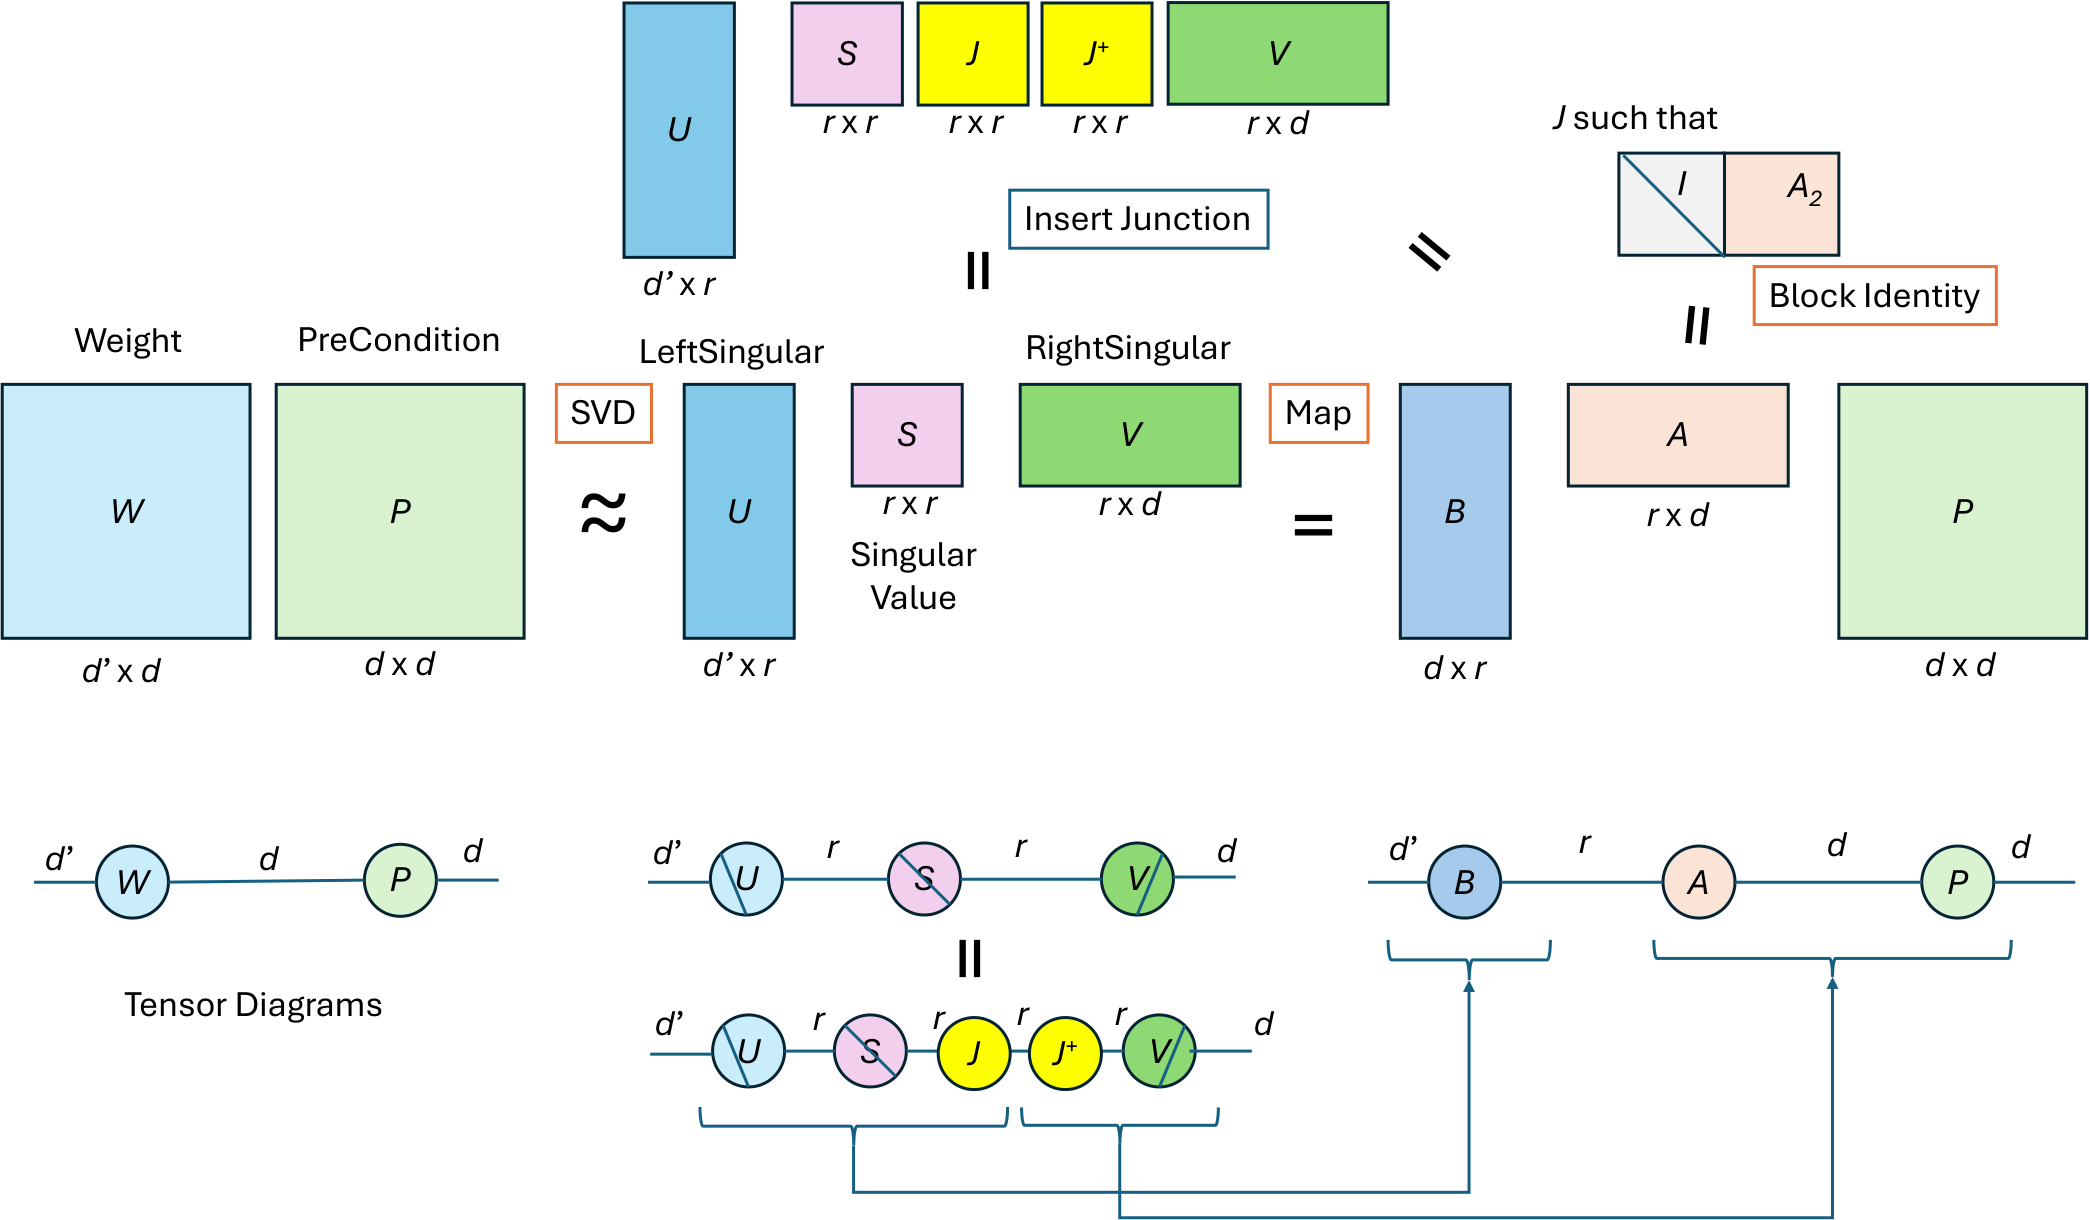
原图 2,PDF p.3。先做输入统计加权,再通过 $J$ 与 $J^+$ 改变分解内部表示。该操作在固定秩下保持精确算术中的近似结果;质量提升来自固定参数预算下可使用更高的秩。
教学算例:三个“压缩比例”不能混用。 对单个方阵令 $\rho=r/d$,则普通分解的参数保留率是 $2\rho$,单位块分解是 $2\rho-\rho^2$。
| 潜在维度保留率 | 普通分解参数保留率 | 单位块分解参数保留率 |
|---|---|---|
| $\rho=0.75$ | 150% | 93.75% |
| $\rho=0.50$ | 100% | 75% |
因此论文举的“潜在维度减少 25%”对应该方阵参数只减少 6.25%。若目标是单方阵参数减少 $c$,单位块形式给出 $\rho=1-\sqrt c$;这个公式仅用于上述单方阵算例,不能直接套作整网各层秩分配。实际表 3 中,标称 20% 压缩的 OPT-6.7B 参数为 5.53B,相对 6.66B 减少约 16.97%。
2.4 联合 QK:直接保留 softmax 前的注意力分数
对第 $i$ 个头,原文式 (10)–(12),PDF p.4:
$A_{\mathrm q}$、$A_{\mathrm k}$ 分别在所有头之间共享,解压矩阵 $B_{\mathrm q,i}$、$B_{\mathrm k,i}$ 按头区分。这里优化的是 softmax 之前的分数矩阵;原式省略常见的 $1/\sqrt{d_{\mathrm h}}$ 缩放。统一常数不会改变该无掩码平方目标的最小化解,但 softmax、因果掩码和后续网络会使它与真正任务损失不同。
对固定校准矩阵 $X$,取 $C=XX^\top$,可以精确重写为原文式 (13):
将 $h$ 个 $d\times d$ 矩阵堆叠,就是沿输入两个维度压缩的 Tucker 张量分解;头维度没有一并压缩。$H_i$ 为 $r_{\mathrm q}\times r_{\mathrm k}$,且原投影结构使其秩不超过 $d_{\mathrm h}$。
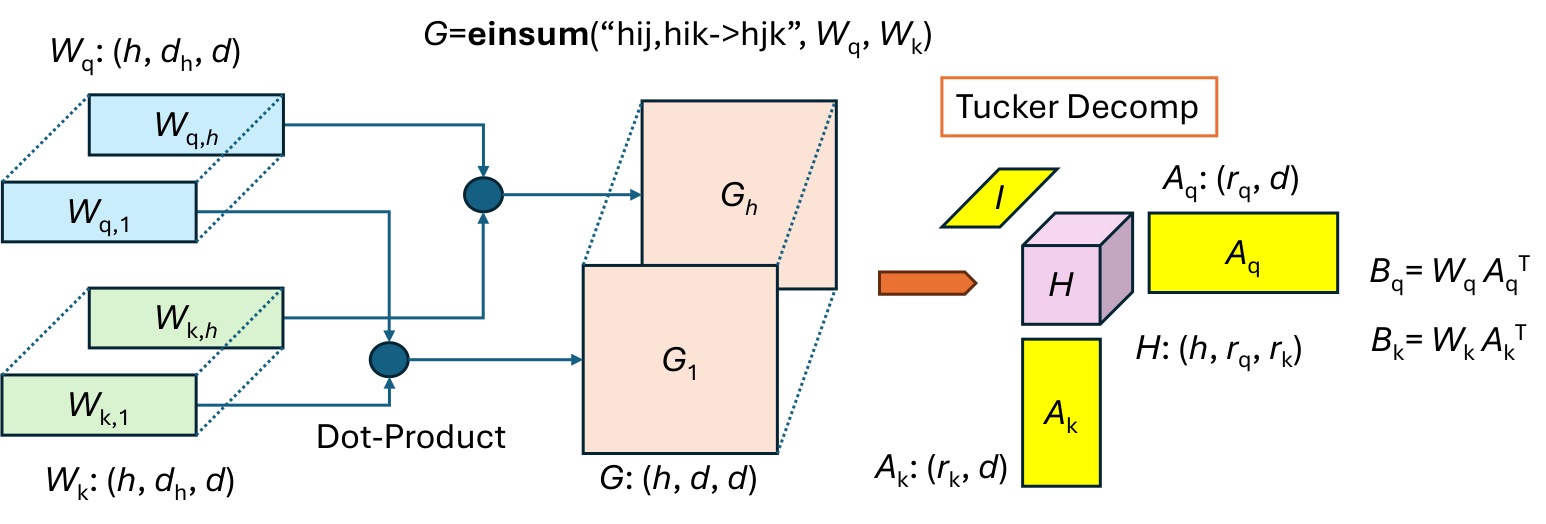
原图 3,PDF p.4。左侧将每头 $W_{\mathrm q,i}^\top W_{\mathrm k,i}$ 组成三阶张量,右侧用共享投影平面与每头核心表示。原图为了简洁省略预条件与 junction matrix,不能把图中的未加权符号和式 (13) 的加权符号混用。
2.5 QK 求解:每一步可最优,整体不保证全局最优
在加权坐标中,令 $Q=A'_{\mathrm q}\in\mathbb R^{r_q\times d}$、$K=A'_{\mathrm k}\in\mathbb R^{r_k\times d}$,可选成行正交。固定这两个平面时,$H_i=QG_iK^\top$;代回后等价于最大化 $\sum_i\|QG_iK^\top\|_F^2$。
于是交替更新为:
TopEigRows 表示将最大特征值对应的特征向量按行排列;上述符号是本笔记为解释引入的。之后恢复未加权坐标,并选 $J_q,J_k,J_i$ 重构各因子。实验使用 8 次 QK 迭代。(算法 1,p.5;附录 E,pp.18–20;实验说明 p.8)
注意原文算法 1 的 Q 更新写成 $G_iA_kA_k^\top G_i^\top$,与其声明的 $A_k\in\mathbb R^{r_k\times d}$ 不相容;附录 E 的对应推导使用 $G_iA_k^\top A_kG_i^\top$。上面采用附录中维度一致的形式,属于明确标注的公式校正,而非照抄算法 1。
这是耦合的非凸子空间问题。单个平面在另一个固定时有特征分解解,交替步骤可改善其代理目标,但论文没有给出联合全局最优或整网性能保证。所谓“attention-aware”描述目标所关心的对象,并不代表直接优化 softmax 后输出。
2.6 联合 VO:重要的负面结果
固定注意力权重记为 $S_i=\operatorname{softmax}(M_i^\top)$,原注意力输出为
Sec.4.2 的简单代理目标是
这也有 Tucker 形式,并允许调整乘法顺序,例如先在潜在 value 上执行注意力加权,再共享输出解压。
但它没有保留实际 $S_i$ 的非线性、不同头之间的相关性及误差抵消。作者在 Remark 11 明确说明,简单联合 VO 相比拆开 V/O 压缩并未取得有效改善。 附录 G.2 进一步使用输出投影输入的统计 $C_o$,构造注意力加权的替代目标、伪逆估计与交替求解式;这些推导没有对应的独立端到端收益表。(p.5;pp.28–31)
本次分析:通过 $W_v'^+C_o(W_v'^+)^\top$ 回推更高维统计只是一种受限恢复,不能一般地恢复投影丢掉的零空间信息。正文中乘法次序的复杂度表达也有需复核之处:每头都计算 $(A_vX)S_i$ 时,通常仍有 $h$ 个不同的 $S_i$,不能直接把这部分总成本当作单个 $r_vl^2$。因此本笔记不将该式换算为实测加速倍数。
2.7 联合 UD:以辅助变量协调 MLP 的两层
两层 MLP 写作 $Z=W_uX$、$Z'=\sigma(Z)$、$Y=W_dZ'$。为避免直接处理复合非线性目标,论文沿用 SparseLLM 的辅助变量思想:
$Z,Z'$ 在求解中是可调整的变量;$X,Y$ 是校准输入和教师模块输出。固定其余量时,
接着更新 $Z$,再用 $ZX^+$ 与 $YZ'^+$ 形成有效线性映射,对相应统计加权后做低秩分解,迭代协调 U/D 两层。论文实验使用 4 次 UD 迭代。(式 (19)–(22),p.5;p.7;附录 H,pp.31–32)
闭式 $Z$ 更新明确针对 ReLU。原文给出正负分支候选 $Z_-=W_uX$ 与 $Z_+=(\alpha Z_-+\beta Z')/(\alpha+\beta)$。复现时还要遵守分支符号约束、比较分段目标,不能无条件取某个候选。对 SiLU、GELU 或门控 MLP,不能直接沿用同一闭式结论;论文没有充分交代这些模块的具体处理或所有 $\alpha,\beta,\gamma$ 设置。
2.8 偏置、位置编码、GQA:哪些可以直接推广?
单线性层偏置:若 $Y=WX+b\mathbf1^\top$,令 $\mu=X\mathbf1/l$,最优补偿是
此时应以中心化数据 $X_c=X-\mu\mathbf1^\top$ 的统计 $C_0=X_cX_c^\top$ 做分解。联合 QK 的偏置要使用增广输入 $[X;\mathbf1^\top]$ 与带结构约束的核心,不能只在最后随意添加一个偏置。(附录 B.2,pp.14–15,式 (45)–(49);E.2,pp.21–25)
加法/拼接位置编码:加法编码可替换输入统计;拼接固定位置分量时,内积中的位置项可以与内容项分开。(F.1–F.2,pp.26–27)
旋转位置编码(RoPE):内积变为 $x_m^\top W_{q,i}^\top\Theta_{i,n-m}W_{k,i}x_n$,核心显式依赖相对位置。附录推导使用 token 独立假设,并建议截断到局部相对位置窗口降低代价。图 12 使用 10-token 窗口、$d=768$、RoPE 基数 $10^4$;作者称考虑 RoPE 约改善 1–2 dB 的代理误差。这不是长上下文检索或困惑度提高 1–2% 的结果。(F.3,pp.27–28)
分组查询注意力(GQA):附录 E.3 按 KV 组和 query 头累加误差,给出类似 HOSVD 形式。它提供了推导方向;论文未给出 GQA 模型上的主结果对照。表 5–7 列出的模型配置不能当作已验证的模型名单。
三:实验——先界定“零样本”和比较范围
3.1 实验协议
| 项目 | 原文报告 |
|---|---|
| 实现与硬件 | PyTorch、HuggingFace Transformers;基于 SparseLLM 设置/代码;NVIDIA A40 |
| 语言模型 | 表 2 实际报告 OPT-125M、350M、1.3B、2.7B、6.7B、13B |
| LLM 校准 | C4 第一分片随机抽取 64 段,每段 2048 token,共 131,072 token |
| LLM 压缩范围 | MLP 与 MHA 的所有线性层,按目标压缩档位处理 |
| 语言评测 | raw-WikiText2 测试集、PTB 测试集、C4 验证子集;困惑度越低越好 |
| 多模态模型 | liuhaotian/llava-v1.6-vicuna-7b,包含 Vicuna 与 CLIP 视觉编码器 |
| LMM 校准 | ScienceQA 训练集随机抽取 64 个样本 |
| 多模态评测 | ScienceQA 总体及学科/上下文/年级子组准确率,单位为 %,越高越好 |
| 分解迭代 | QK 8 次、UD 4 次 |
| 计算量统计 | OPT-6.7B,calflops,输入长度 128 token |
来源:Sec.5,pp.7–10。131,072 是根据 64×2048 计算的校准 token 数,不是另一条原文实验配置。表 3 的 128-token FLOPs 口径与校准样本的 2048-token 长度不同。
“零样本”在本文有两层用法:无需微调;LLM 校准未使用目标评测任务样本。第二层不能原样套到 ScienceQA,因为多模态校准使用了 ScienceQA 的训练数据。原文未完整报告 ScienceQA 评估划分/数量、提示和答案解析规则、随机种子、重复运行方差、校准耗时、逐层秩清单,以及 LLaVA 每类子模块的全部压缩细节。这些缺失限制可复现性,不应以领域惯例自行填充。
3.2 Baseline 应怎样理解?
主要对照是 局部低秩分解的预条件变体:Plain SVD、ASVD(Hessian)、ASVD($\ell_2$)、ASVD(Cov)、ASVD(RootCov)。其中 RootCov 是最重要的邻近对照,可以帮助区分“采用更合理的统计度量”与“完整方法加入结构节省及联合目标”的收益。
主表没有将 LatentLLM 与各种量化、剪枝、KV 压缩系统在匹配显存或延迟预算下全面比较。故可靠表述是“优于本文所测局部低秩对照”,而非“已经优于所有模型压缩方法”。RootCov 与 LatentLLM 的差额也不能全部归因于 QK 联合优化:单位块表示、可用秩与 UD 更新均可能贡献,主表没有完整的逐组件消融。
四:结果——质量、预算与解释要对应
4.1 Computational complexity:标称比例与实际参数节省不同
| 标称压缩率 | FLOPs | MACs | 参数量 | 相对 6.66B 的参数减少(本笔记计算) |
|---|---|---|---|---|
| 0% | 1.70T | 851G | 6.66B | 0% |
| 10% | 1.53T | 766G | 6.20B | 6.91% |
| 20% | 1.36T | 681G | 5.53B | 16.97% |
| 30% | 1.19T | 596G | 4.87B | 26.88% |
| 40% | 1.02T | 511G | 4.20B | 36.94% |
| 50% | 851G | 425G | 3.54B | 46.85% |
表 3,PDF p.7;OPT-6.7B、128-token 统计。T/G/B 分别表示 $10^{12}$ 次、$10^9$ 次或十亿参数,MAC 与 FLOP 不是相同计数单位。50% 档位的 FLOPs 约为原来一半,但不能称为“推理快两倍”。表 3 还有 60%–90% 档位,属于计算量数据,不能单独证明这些极高压缩模型仍然可用。
作者解释是线性模块压缩使总体计算量近似随压缩比例下降;本次判断是需要同时报告实际参数量,且进一步测量 prefill、decode、batch、上下文长度和实际 KV 存储布局,才能判断部署收益。本文没有这样的系统基准。
4.2 Compression over model size:更好的取舍,不是无损压缩
先看 OPT-6.7B。下表每个单元格依次为 WT2 / PTB / C4 困惑度,均越低越好。
| 标称压缩率 | ASVD(RootCov) | LatentLLM(RootCov) |
|---|---|---|
| 原模型 | — | 10.9 / 15.8 / 12.7 |
| 10% | 11.8 / 17.7 / 14.2 | 10.7 / 16.1 / 13.0 |
| 20% | 13.5 / 19.5 / 15.4 | 11.5 / 17.4 / 13.7 |
| 30% | 17.0 / 23.9 / 17.8 | 13.5 / 19.2 / 15.3 |
| 40% | 27.2 / 36.1 / 24.0 | 18.0 / 24.2 / 18.4 |
表 2,PDF p.6。20% 档位相对局部 RootCov,WT2 从 13.5 降到 11.5,是减少 2.0 个困惑度单位,相对减少约 14.81%;相对原模型 10.9 则仍上升约 5.50%。困惑度没有“百分点”含义。
RootCov 本身也很关键:同为 OPT-6.7B、20% 档位,WT2 困惑度依次为 Plain SVD 67517.7、Hessian 17.3、$\ell_2$ 14.6、Cov 9842.6、RootCov 13.5、LatentLLM 11.5。这些结果说明盲目近似权重、或者直接用 $C$ 做预条件,在该设定下可能失效;不能将每个变体都描述成有相同稳定性。
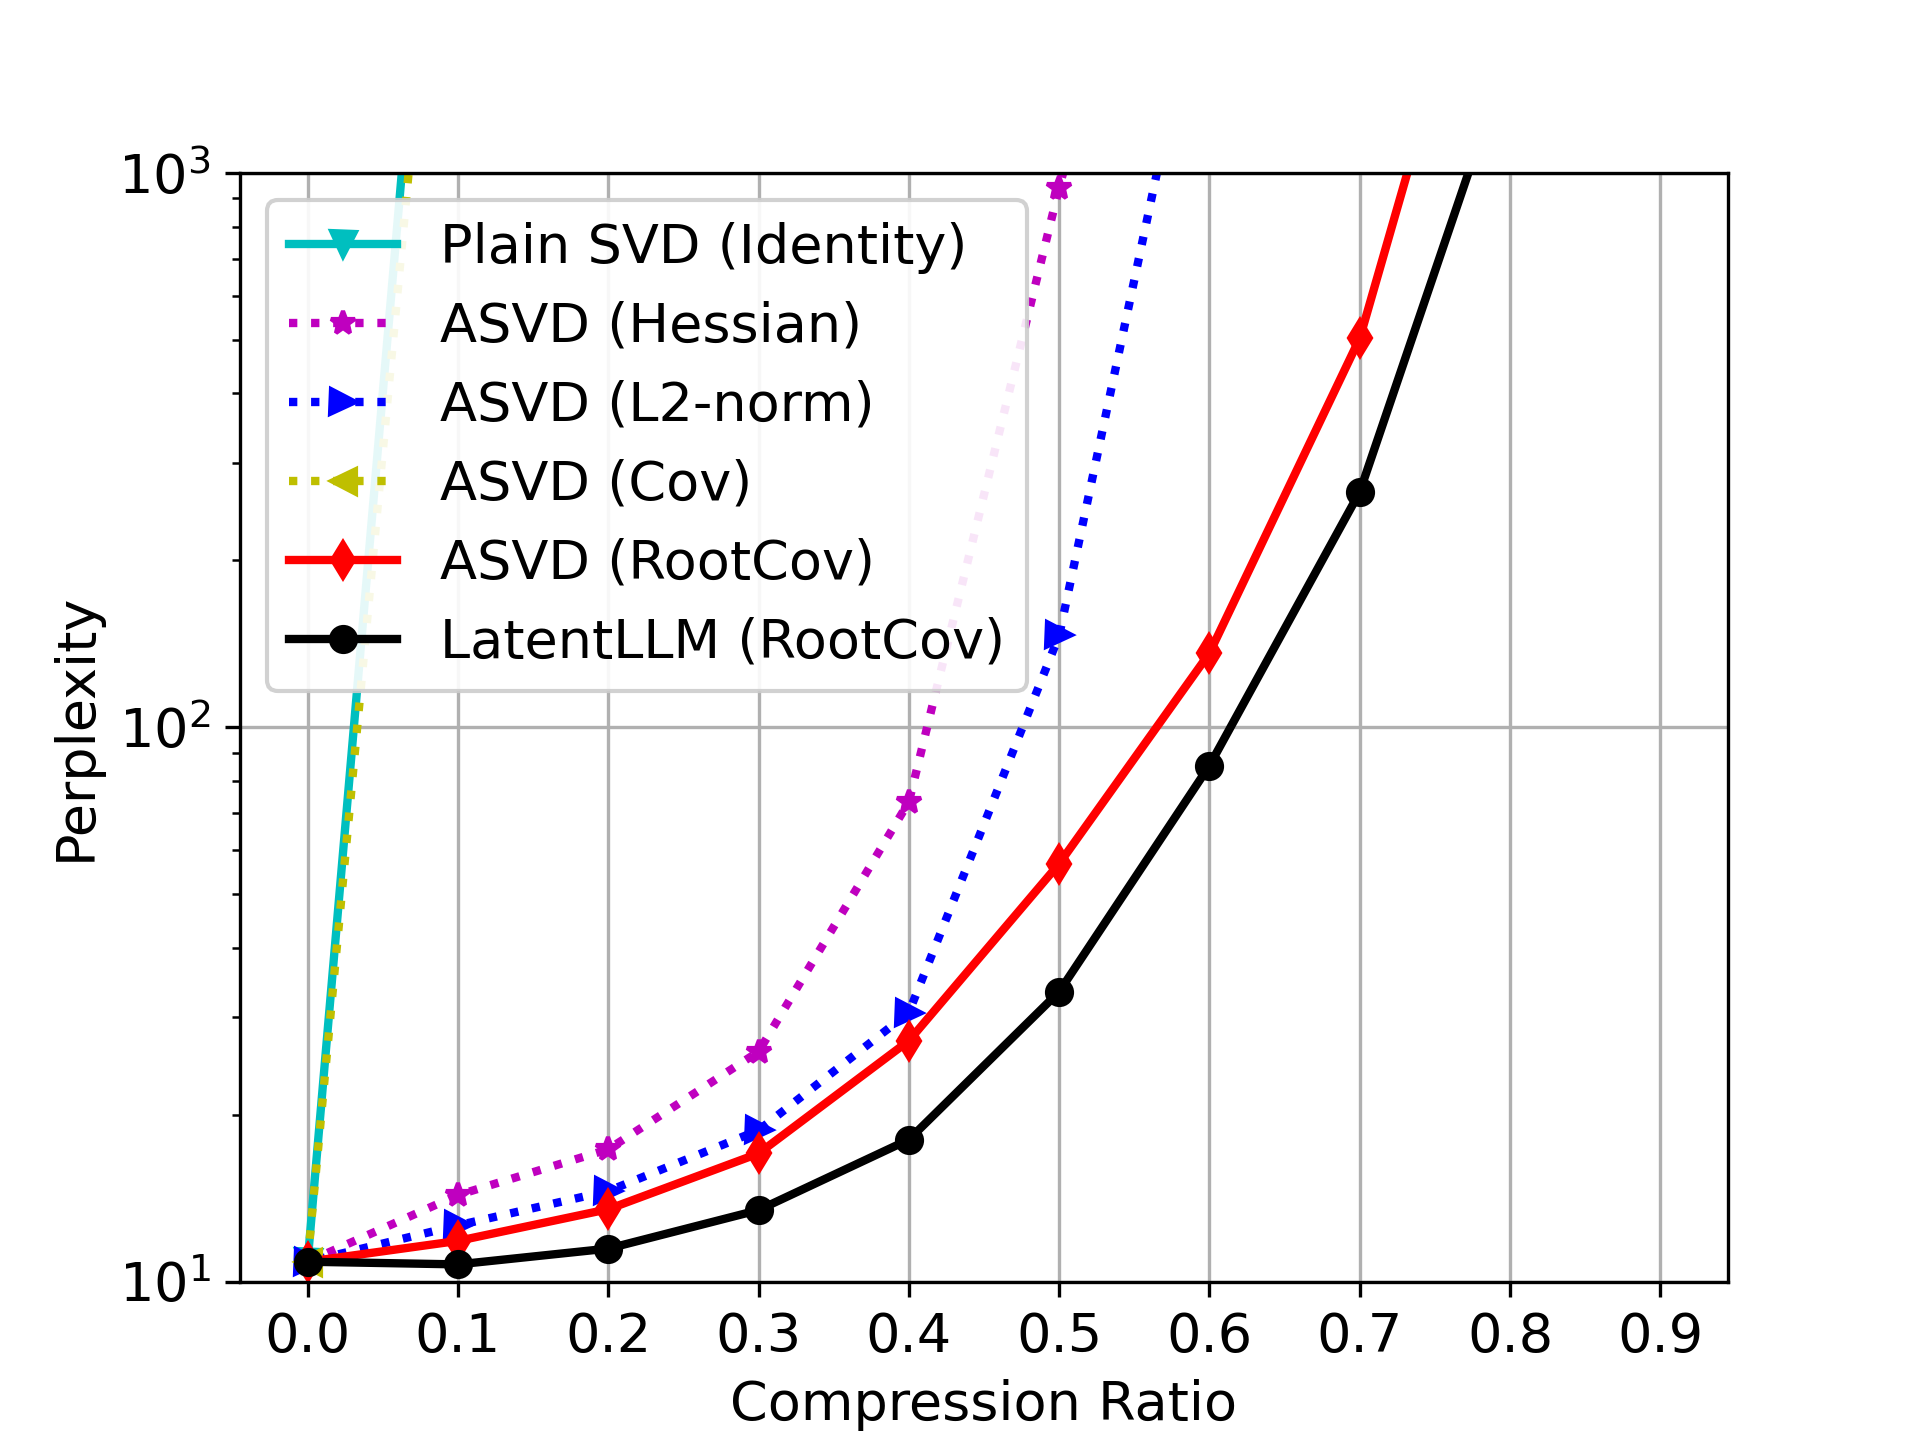
原图 4(j),PDF p.8;使用作者对应单面板原始图件。横轴是论文的 compression ratio,向右表示压缩增强;纵轴是困惑度,采用对数刻度,越低越好。黑线为 LatentLLM,红线为局部 RootCov,其余线为其他预条件变体。黑线在主要区间较低,但高压缩时也迅速上升;“能压得更多”不等于在任意档位保持原质量。
再看相同 30% 标称压缩 下的跨规模结果,以下仅取 WT2,避免混入不同指标:
| OPT 规模 | 原模型 | 局部 RootCov | LatentLLM |
|---|---|---|---|
| 125M | 27.7 | 88.8 | 43.4 |
| 350M | 22.0 | 71.6 | 32.9 |
| 1.3B | 14.6 | 33.9 | 20.2 |
| 2.7B | 12.5 | 24.1 | 16.5 |
| 6.7B | 10.9 | 17.0 | 13.5 |
| 13B | 10.1 | 14.3 | 12.0 |
表 2,p.6。更大模型在这组数据中表现出更强压缩容忍度,但这只是所测家族的经验观察,不是普适规模定律。图 4(p.8)按模型分行、按 WT2/PTB/C4 分列,支持上述曲线趋势;图 5(p.9)以 FLOPs 为横轴、困惑度为纵轴,展示跨规模的计算—质量取舍,而非设备实测吞吐曲线。
表 2 中,1.3B、2.7B、6.7B 在 10% 档位的 WT2 略优于原模型,例如 6.7B 的 10.9→10.7;同一配置 PTB/C4 仍变差。论文没有多随机种子置信区间,不能据此声称压缩普遍提高模型能力,也不能把小幅变化当作显著性检验结果。
数据可疑点:OPT-125M 的 LatentLLM 在 30% 与 40% 两档的 PTB 都写成 68.7、C4 都写成 37.4;TeX 与最终 PDF 一致重复。原文没有解释,本笔记不擅自修正,也不以这些重复单元格作主要结论依据。
4.3 Multi-modal reasoning capability:相对对照更好,绝对损失仍存在
LLaVA-v1.6-Vicuna-7B,ScienceQA,表 4 的 Avg 列:
| 标称压缩率 | 局部 RootCov 准确率 | LatentLLM 准确率 | 对局部 RootCov 增益 | 相对原模型损失 |
|---|---|---|---|---|
| 0% | — | 70.03% | — | — |
| 10% | 60.67% | 65.76% | +5.09 个百分点 | −4.27 个百分点 |
| 20% | 57.53% | 63.85% | +6.32 个百分点 | −6.18 个百分点 |
| 30% | 54.37% | 60.13% | +5.76 个百分点 | −9.90 个百分点 |
| 40% | 52.23% | 54.59% | +2.36 个百分点 | −15.44 个百分点 |
| 50% | 49.30% | 52.25% | +2.95 个百分点 | −17.78 个百分点 |
来源:表 4,PDF p.10;差值为本笔记计算。这里必须使用“百分点”。20% 档位相对局部 RootCov 的相对增幅约 10.99%,与 +6.32 个百分点是不同量。
Avg 按原表作为总体指标引用,不能把 NAT/SOC/LAN、TXT/IMG/NO、G1-6/G7-12 八列简单平均。这些列是对同一批题目按不同属性分组,且上下文类别可能重叠。论文没有给出每个子组的样本数及完整聚合实现。
20% 档位的部分子组能展示保留能力的具体差别:
| 子组 | 原模型 | LatentLLM 20% | 损失(百分点) |
|---|---|---|---|
| 自然科学 NAT | 72.47% | 66.39% | 6.08 |
| 社会科学 SOC | 69.18% | 61.19% | 7.99 |
| 语言科学 LAN | 65.73% | 60.82% | 4.91 |
| 图像上下文 IMG | 68.82% | 63.41% | 5.41 |
| 无上下文 NO | 65.99% | 60.62% | 5.37 |
| 1–6 年级 | 72.72% | 66.41% | 6.31 |
| 7–12 年级 | 65.19% | 59.26% | 5.93 |
表 4,p.10。图 6 的雷达图以学科、上下文、年级和总体准确率为辐射轴,分别画 10%、30%、50% 三档;它便于看轮廓,不能把雷达面积当综合分数。作者观察到无上下文、语言科学和高年级组通常准确率更低;这描述分组表现,不能单凭分组均值断言压缩损害某种独立“推理机制”。
部分弱 baseline 的准确率接近 0%,在多选题任务中尤其需要了解输出格式与答案解析才能解释。原文未充分说明,因此本笔记不将这些数字直接解释为“低于随机猜测多少倍”的能力结论。
4.4 附录机制证据与负结果
这些实验主要在随机矩阵或代理误差上进行,与主表的真实语言/多模态任务分开看。
| 图 / 位置 | 检验问题与结果 | 能支持的范围 |
|---|---|---|
| 图 7,p.15 | 随机权重、Wishart 输入统计;RootCov 相比直接 Cov 有更低激活误差,相关性强时优势更明显 | 支持局部加权目标的选择;纵轴为 loss(dB),越低越好,横轴为秩 |
| 图 8,p.16 | 联合 QKV 共享一个 $A$ 可改善一定预算下的局部激活近似 | Q/K/V 量级权衡可能损害最终任务;不等于本文联合 QK 的注意力目标 |
| 图 9,p.17 | 按头拆开近似比跨头共享潜在空间差 | 限于所测合成设定,不是所有逐头压缩均不可用 |
| 图 10,p.21 | 联合 attention-aware RootCov 比只匹配激活的 RootCov 更好地保留分数矩阵 | 随机 Q/K,Wishart 统计、0.9 衰减相关;不是端到端 QK-only 消融。该页横轴标注缺失,不据此读出精确横坐标数值 |
| 图 11,p.22 | 加入稀疏近似后,一些 attention-aware 稀疏解的代理误差更低 | 不能推导硬件速度或总存储更优;该页也缺完整横轴标注 |
| 图 12,p.28 | 显式 RoPE 感知约改善 1–2 dB | 10-token 窗口、$d=768$;不是长上下文结果 |
| 图 13,p.33 | 比较 hard/soft shrink、STE 等稀疏优化;作者报告 Hardshrink 表现最好 | 随机正态权重与指定 Wishart 统计 |
| 图 14,p.34 | 所测低秩加稀疏方案未超过纯稀疏近似 | 负结果;不能推广成一般不可能性结论 |
| 图 15,p.35 | 在初始秩 640/512 的因子上进一步稀疏化仍未超过纯稀疏方案 | 同样是近似误差而非 LLM 基准 |
| 图 16,p.36 | 完整统计的稀疏近似优于对角统计对照 | 非结构稀疏还需索引和内核支持 |
附录 I.1(p.34)给出利用直通估计器(straight-through estimator, STE)与分块均匀量化结合的表达式,但没有报告不同位宽的主模型质量/延迟对照。微调恢复质量也只是作者展望,不能写成已经完成的结果。
五:结论、局限与复现重点
5.1 可靠贡献
- 把低秩近似目标与模型实际使用的统计联系起来:RootCov 对指定激活平方误差有直接推导;这比凭经验选预条件更清晰。
- 利用分解自由度减少表示冗余:单位块揭示“相同低秩乘积”可用更少参数表示,对较高秩压缩尤其有价值。
- 从单层逼近推进到相邻计算的联合逼近:QK 目标直接关注注意力分数,UD 目标协调非线性两层;真实任务上完整方法优于论文所测局部低秩对照。
5.2 尚未解决的关键问题
- 贡献分离不充分:缺少匹配实际参数量/秩预算的完整组件消融,难以量化 RootCov、单位块、QK 与 UD 各自的净贡献。
- 优化目标仍是代理:QK 只匹配 softmax 前分数;VO 的简单代理已出现负结果;全网累积误差未被端到端控制。
- 统计与数值敏感性:样本量、阻尼、病态子块、伪逆阈值、校准分布偏移和压缩成本缺少系统评估。
- 架构泛化证据有限:GQA 与 RoPE 有推导,但主任务验证仍集中在 OPT 家族与一个 LLaVA;非 ReLU/门控 MLP 的实现细节不足。
- 系统收益尚待实测:缺少真实 KV-cache 字节、运行显存、prefill/decode 延迟、吞吐和能耗;单位块及潜在注意力要有对应执行实现才能兑现收益。
- 统计可靠性有限:没有充分的多次运行方差/显著性信息,尤其不能过度解释原模型附近 0.1–0.2 的困惑度改善。
5.3 原文中应注意的记号问题
这部分服务于复现,不改变原文结果,也不将笔记中的校正冒充作者勘误。
- 算法 1 的转置:p.5 的 Q 更新维度不一致;使用附录 E 的 $G_iA_k^\top A_kG_i^\top$ 形式。
- 单层因子中的奇异值重复:附录 B 的式 (42)(p.14)在 $A$ 中又出现 $S'$,而前面的 $B$ 已包含 $S'$;与主文式 (7) 不一致。笔记采用主文一致分解 $B=USJ,\ A=J^+VP^+$。
- attention 转置约定:式 (14) 用 $\operatorname{softmax}(M_i^\top)$,随后式 (16)–(18) 改写成 $\operatorname{softmax}(M_i)$。本文用统一的 $S_i$ 表示按 key 归一化、从右侧作用于列 token 的权重矩阵,复现时需明确归一化轴。
- VO 复杂度:正文重排乘法后列出的 $r_vl^2$ 项应结合每头注意力矩阵重新计数;不直接将该表达当作吞吐承诺。
- 表 2 重复数字:125M 在 30%/40% 的两个指标重复,见上文;保留原值且不据此作主要推断。
5.4 若要复现,先回答这些问题
先固定目标:比较同样潜在秩、同样实际参数量、同样 KV 字节还是同样延迟。随后保存校准样本和随机种子,记录统计归一化、阻尼、偏置处理、各层秩与奇异值截断规则。先验证单层输出和 QK 分数的重构误差,再做模块与整网指标;为各模块分别设置对照,特别保留简单 VO 的负结果。
最后测实际执行:单位块是否真正省存储;RoPE 是否需要解压 K;潜在 V 的注意力乘法是否引入额外逐头成本;校准与分解耗时是否可接受。主表只足以支持质量—压缩取舍,部署价值需要这些后续测量。
本次阅读判断:最值得带走的是“误差度量、参数表示、联合目标”这三个层次。论文提供了有解释力的组合和可信的主表优势;对整网全局最优、无损大比例压缩以及实际推理加速,则没有给出同等强度的证据。