PaTH Attention:通过累积 Householder 变换编码位置
论文:PaTH Attention: Position Encoding via Accumulating Householder Transformations
作者:Songlin Yang、Yikang Shen、Kaiyue Wen、Shawn Tan、Mayank Mishra、Liliang Ren、Rameswar Panda、Yoon Kim
版本:arXiv:2505.16381v2,2026-02-03 修订;NeurIPS 2025 camera ready。初稿发表于 2025-05-22。
获取与研读日期:2026-10-13
原文:arXiv v2 · 本地 PDF · 英文汇报
论文总览
PaTH 把位置关系表示为沿输入序列累积的、由内容决定的矩阵变换。位置 $j$ 的 key 与位置 $i$ 的 query 相遇之前,要经过 $j+1$ 到 $i$ 的一连串 Householder-like 变换。于是,写入、覆盖、交换等中间事件可以直接改变两者的匹配方式。模型继续使用 softmax 对历史 value 做加权读取,同时获得类似线性递归网络的状态变换结构。
这项工作的贡献连成三步:用单位阵加秩一修正构造便宜而富有表达力的转移;用 UT 紧凑表示和分块扫描把递归式乘积组织成 GPU 友好的计算;在合成状态追踪、760M 语言模型及预训练模型转换中验证效果。760M 模型以 50B tokens、4096 上下文训练时,PaTH 的六项常识推理平均分从 RoPE 的 52.7 提高到 54.2;加入 FoX 后,16K RULER 达到 22.6,而 RoPE、FoX 分别为 0.0、4.9。长距离精确检索更依赖组合设计:8K PhoneBook 上,PaTH 为 0.0,PaTH-FoX 为 66.6。(Sec. 4.2,PDF pp. 8–9,Tables 2–3)
理解这篇论文的关键,是同时看见路径中的状态变换和显式历史检索。前者解释状态追踪优势,后者保留 softmax attention 的读取方式;两者结合并未把训练复杂度降成关于序列长度的线性复杂度。
结构地图
以下页码均为从 1 开始的 PDF 页码,与本版本印刷页码一致。
| 原文章节 | 作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 从 RoPE 的静态位置变换引出状态追踪问题 | pp. 1–2 |
| 2 PaTH Attention | 乘法位置编码、Householder 参数化、RNN 关系、PaTH-FoX | pp. 2–3;Theorem 2.1 |
| 3 Efficient Training and Inference for PaTH Attention | UT 表示、全矩阵形式、分块训练、缓存更新、分布式讨论 | pp. 3–7;Fig. 1、Eq. (1) |
| 4.1 Synthetic Tasks | FFLM、$A_5$ 群字问题、MQRAR-$N$ | pp. 7–8;Table 1、Fig. 2 |
| 4.2 Language Modeling | 常规语言建模、长度外推、四组长上下文任务 | pp. 8–9;Tables 2–3、Figs. 3–4 |
| 4.3 Converting RoPE into PaTH | 两阶段蒸馏、继续预训练及模型转换结果 | pp. 9–10;Tables 4–5 |
| 5 Related Work;6 Limitation;7 Conclusion | 与动态位置编码的关系、数值与效率限制 | p. 10 |
| A Representation Power of Transformers with PaTH Attention | 置换追踪与 FFLM 的构造 | pp. 17–19 |
| B Experimental Setup & Additional Results | 训练参数、BABILONG 分项、LongBench-E 明细 | pp. 20–21;Fig. 5、Tables 6–7 |
一:动机——让位置变换反映途中发生的事件
RoPE 的注意力分数可以写成 $\mathbf q_i^\top\mathbf R^{i-j}\mathbf k_j$。其中 query 和 key 当然依赖内容;这里的限制是,作用在两端之间的位置变换 $\mathbf R^{i-j}$ 只依赖相对距离。距离相同的两段序列,无论中间发生多少次变量覆盖或对象交换,位置变换都相同。
状态追踪要求模型组合一连串操作。例如“写入 1—忽略若干位—写入 0—读取”要求保留最近一次写入并忽略旧值;置换任务要求按顺序组合交换,改变操作次序通常会改变答案。PaTH 将这些中间操作纳入 query–key 的双线性匹配,使相对关系具有输入依赖性。(Sec. 1–2,PDF pp. 1–3)
从表达能力看,论文借用固定深度、受限数值精度的 Transformer 电路分析作为背景,并构造 PaTH 可解的 $\mathsf{NC}^1$ 完全问题。在相应模型假设与 $\mathsf{TC}^0\ne\mathsf{NC}^1$ 的条件下,这给出与普通 RoPE Transformer 的表达能力区分。训练能否找到这种计算,则由后续合成实验单独检验。
二:方法——从秩一转移到 softmax 路径注意力
2.1 输入、符号与输出
| 符号 | 含义与维度 |
|---|---|
| $\mathbf x_t$ | 本层位置 $t$ 的输入表示 |
| $\mathbf q_t,\mathbf k_t,\mathbf v_t$ | 单个注意力头的 query、key、value;论文统一采用 $\mathbb R^d$ |
| $\mathbf w_t\in\mathbb R^d$ | 归一化的转移方向,$\|\mathbf w_t\|_2=1$ |
| $\beta_t\in(0,2)$ | 转移强度 |
| $\mathbf H_t\in\mathbb R^{d\times d}$ | 位置 $t$ 的内容相关转移 |
| $L,B$ | 序列长度与分块大小 |
为明确非交换矩阵的乘法顺序,本笔记定义
给定本层输入,先产生 query、key、value;额外分支通过低秩线性层、宽度为 3 的短卷积、$L_2$ 归一化产生 $\mathbf w_t$,并计算
随后,对因果位置 $j\le i$ 计算
这里沿用原文省略 attention scale 的记法。位置 $j$ 自身的转移不在路径内,位置 $i$ 的转移在路径内;$i=j$ 时路径为空,恢复 $\mathbf k_i^\top\mathbf q_i$。这两个端点决定分块公式中的严格下三角与非严格下三角掩码。(Sec. 2,PDF pp. 2–3)
2.2 Householder-like 转移为什么有效
将任意向量分为 $\mathbf z=\mathbf z_\perp+\alpha\mathbf w_t$,可直接得到
也就是每次只改变一个方向,其余方向保持不动。核心特征值为 $1-\beta_t$,其余为 1。
| 强度 | 沿 $\mathbf w_t$ 的作用 | 含义 |
|---|---|---|
| $0<\beta_t<1$ | 正向收缩 | 减弱旧信息的一部分 |
| $\beta_t=1$ | 投影为零 | 可以擦除该方向,转移不可逆 |
| $1<\beta_t<2$ | 变号并收缩 | 能表达普通正衰减不具备的状态变化 |
| $\beta_t=2$ | 精确反射 | 理论构造采用的端点;有限实数输入的 sigmoid 参数化不精确达到它 |
在精确运算和单位范数前提下,单步谱范数不超过 1。但不同 $\mathbf w_t$ 对应的转移通常不交换,因此它们的累计效果能够记录事件次序。原文 Related Work 将这些变换概括为“non-invertible”;准确地说,单步在 $\beta_t=1$ 时奇异,其他 $\beta_t\in(0,2)$ 通常可逆。方法允许擦除,而不是每一步都必须擦除。
教学例子:令 $\mathbf w=(\mathbf e_1-\mathbf e_2)/\sqrt2$,$\beta=2$,则
一次反射即可交换两个坐标;把这样的矩阵连乘,就得到对连续交换操作的追踪。另一方面,$\mathbf w=\mathbf e_1,\beta=1$ 会擦除第一个坐标,适合解释“新写入阻断旧记录”的机制。(参数化:Sec. 2.2,PDF p. 2;交换构造:Appendix A,p. 17)
2.3 与线性 RNN 的关系:共享路径,改变读取权重
考虑论文使用的线性递归形式
展开之后,历史 value 的系数为
线性 RNN 直接用 $c_{tj}$ 加权,PaTH 则使用 $\exp(c_{tj})/\sum_r\exp(c_{tr})$。这样,PaTH 引入了递归网络的转移代数,同时保留对各个历史 value 的 softmax 选择。它仍需显式历史 KV,不能沿用上述 $d\times d$ 状态就精确算出一般的 softmax 输出。(Sec. 2.2,PDF p. 3)
2.4 理论构造抓住了什么
Theorem 2.1 声明:一层、两头、$\log n$ 数值精度的 PaTH Transformer 可以解一个在 $\mathsf{AC}^0$ 归约下的 $\mathsf{NC}^1$ 完全问题。Appendix A 用五个元素的迭代交换是否构成恒等置换来实现它。(PDF pp. 3、17–18)
证明的关键链条是:每个交换 token 对应一次上述反射;累计乘积表示最终置换 $\pi$;设计起始 token 的 key 和末尾 query,使其 logit 为
恒等置换时总和为 55,$s_0=n/2$;非恒等置换时整数总和至多为 54,故 $s_0\le-n/2$。其他 token 的 logit 均设为零,于是第一头对起始 token 的注意力为 $e^{s_0}/(e^{s_0}+n)$。第二头输出均匀注意力参照 $1/(n+1)$,比较两者即可判定恒等性。这里使用精确 $\beta=2$ 的理想反射以及依赖 $n$ 的构造,不应直接等同于实际 BF16 训练的参数配置。
Theorem A.1 另声明两层 PaTH、$O(\log n)$ 精度可在长度至多 $n$ 的 FFLM 上实现高于 $1-1/n^{100}$ 的准确率。其构造意图是:第一层让 bit 识别紧邻的操作符;第二层在新写入处截断旧写入路径,从而只读取最近一次写入。实证部分则用一层模型取得极低错误率,理论层数与实验层数应分别理解。
附录 p. 19 的具体坐标公式有明显不一致:第一 FFN 用 $h_{10},h_{11}$ 表示 write-0/write-1,第二层 value 与 $\beta$ 却引用 $h_8,h_9$;末尾两个输出位也使用了相同判别式。因此上面的解释保留作者的构造思路,不把这些坐标公式当作可直接执行的实现。
2.5 PaTH-FoX:路径变换与遗忘可以分工
FoX 为每一步生成 $f_t=\sigma(\mathbf u_f^\top\mathbf x_t+b_f)\in(0,1)$,在 logits 中加入 $\sum_{s=j+1}^i\log f_s$。组合后为
PaTH 改变内容匹配的方向和结构,FoX 直接衰减旧位置的未归一化权重。两者的作用位置不同:$\prod f_s$ 位于指数函数外,不能与“先给 logit 乘一个衰减再取指数”混为一谈。这种分工解释了为何 PaTH 的状态追踪优势与 FoX 的长距离遗忘能力可以互补。(Sec. 2.2,PDF p. 3)
2.6 UT 表示:把很多秩一操作组织成矩阵乘法
直接为每个 $(i,j)$ 计算一遍路径乘积,会反复处理相同区间。设
$\mathbf U$ 对应原文简写的 $\mathbf T^{-1}$,是一个下三角系数矩阵,并不要求先逐个求 $\mathbf H_t^{-1}$。三角系统和矩阵乘法比许多零散的 rank-one 更新更适合 GPU。
按本笔记明示的乘法顺序,正确的两种方向是
例如两步展开中的交叉项分别为 $\beta_1\beta_2\mathbf w_2(\mathbf w_2^\top\mathbf w_1)\mathbf w_1^\top$ 及其转置;当转移不交换时,转置不能省略。
利用连续区间的三角结构,可以得到原文的全矩阵 logits 形式
第一个 lower 允许转移位置等于 query 位置;strictLower 则使转移严格晚于 key 位置。对标量而言,这一式计算的是 $\mathbf q_i^\top\mathbf H_i\cdots\mathbf H_{j+1}\mathbf k_j$,恰为原始 logit 的转置等值表达。上三角在做 softmax 前仍须设为 $-\infty$;代数中“置零”与概率归一化中的因果屏蔽有不同用途。
原文 p. 4 将下三角 UT 表示与未明示方向的乘积混用,单个区间的左右掩码式也与后面的全矩阵式不一致。一个避免歧义的区间写法是:令 $I=\{a,a+1,\ldots,b\}$,$\mathbf W_I$ 为这些行组成的子矩阵,则前向乘积为 $\mathbf I-\mathbf W_I^\top\mathbf U[I,I]^\top\mathbf W_I$;这里连续主子块的三角求解结构保证等式成立。以上方向说明和区间表达是根据定义整理的推导。(Sec. 3.1–3.2,PDF p. 4)
2.7 分块训练:当前块精确计算,历史块由右向左扫描
全序列三角求解在原文的常规复杂度计数下需要 $O(L^3)$,因此实际算法仅在长度为 $B$ 的块内建立 $\mathbf U_b$。每块预处理三类量:
前两项把 token 内部的路径分别折算到块的左、右边界;$\mathbf F_b$ 表示穿过整块的转移。固定 query 块 $b$ 后,算法可以理解为:
用局部全矩阵公式计算对角块,并纳入 online softmax
Qwork ← Qleft[b]
for c = b−1, b−2, …, 0:
    logits ← Qwork · Kright[c]^T
    更新 online softmax,累积对 V[c] 的加权输出
    Qwork ← Qwork · F[c]^T
归一化输出并写回显存
先计算当前历史块的贡献,再穿过该块继续向左,恰好避免将当前 key 之前的操作错误计入路径。不同 query 块可以并行,内部扫描使用 SRAM 中的小矩阵,不把完整 $L\times L$ attention 写回 HBM。(Sec. 3.3,PDF p. 5)
复杂度按块数展开:每对块的工作是 $O(B^2d+Bd^2)$,约有 $(L/B)^2$ 对,因此应为
局部三角求解及边界变换还需 $O(LB^2+LBd)$;若显式形成每块 $d\times d$ 转移,再计入 $O(Ld^2)$。当 $B\approx d$ 时,主导计算仍为 $O(L^2d)$,但常数和额外存储增加。
原文 p. 6 写成 $O(L^2d+Ld^2/B)$,第二项少了一个 $L$;p. 5 的块转移定义又漏写 $\mathbf I-$,并需与乘积方向统一。上述式子依据逐块操作重新整理,保留了作者关于“序列长度仍为二次复杂度”的结论。
2.8 解码:持续改写历史 key
到达新位置 $t$ 时,对所有历史 key 进行
并以 $\mathbf k_t^{(t)}=\mathbf k_t$ 加入新 key。于是
更新后的缓存可以交给普通 softmax 解码算子读取,无须单独保存全部 $\mathbf w_j$。prefill 完成后也必须将各 key 对齐到 prompt 末尾,可复用块级后缀乘积。(Sec. 3.4,PDF p. 6,Eq. (1))
代价是每一步要读取并改写历史 key:单头新增工作量 $O(td)$,KV 容量仍随长度增长。论文给出了与 FlashDecoding、PagedAttention 结合的路径,但 Fig. 1 的 kernel 测速不能直接证明完整在线服务中的吞吐优势。
分布式上下文并行也可发送变换后的 KV 及块转移,再沿与右到左逻辑一致的顺序累积。Sec. 3.5 讨论的是兼容方案,没有对应的多机扩展实验。(PDF pp. 6–7)
三:实验——每组对照检验什么
3.1 合成任务与对照角色
RoPE 提供静态乘法位置编码基线;SBA(Stick-Breaking Attention)通过有序 stick-breaking 构造注意力权重;FoX 以内容相关遗忘门调整 logits。SBA 只出现在合成实验,语言模型主表比较 RoPE、FoX、PaTH、PaTH-FoX。
| 任务 | 检验问题 | 配置与指标 |
|---|---|---|
| FFLM | 忽略干扰后能否读取最近一次写入 | 1 层、2 头、64 维;错误率越低越好;OOD sparse 的 ignore 占比 98%,dense 为 10% |
| $A_5$ word problem | 能否学习非交换操作的组合 | 判断操作序列是否为恒等;图示长度 5、10、15、20;记录准确率超过 90% 所需最少层数 |
| MQRAR-$N$ | 能否找回某变量倒数第 $N$ 次历史赋值 | 2 层、256 维、2 头;32 个 KV 对、长度 768;$N\in\{1,2,3,4\}$,准确率越高越好 |
MQRAR-2 的直觉例子是:某变量先后赋值 1、5,在下一次出现该变量时应找回 1;它要求跳过最近的 5。原文按查询位置之前已经发生的赋值计数。(Sec. 4.1,PDF pp. 7–8)
3.2 从头预训练协议
760M 模型统一在 FineWeb-Edu 上训练 50B tokens,使用 Mistral tokenizer,上下文为 4096。常规指标包括 WikiText/LAMBADA 困惑度及六项零样本准确率;HellaSwag 和 ARC-challenge 使用原表标注的 acc_n,即归一化准确率,不能与其他列的 acc 不加区分地解释为同一计算口径。
附录 B 给出的训练设置为 AdamW、cosine 学习率、1B-token warmup,峰值学习率 $10^{-3}$,初始和最终均为 $3\times10^{-5}$;batch 为 2M tokens,weight decay 0.01,梯度裁剪 1.0,初始化标准差 0.02。每个 760M 模型在 8 张 H100 上训练 2–3 天。合成任务使用 A100。(PDF pp. 8、20)
3.3 长上下文任务与统计口径
- RULER:13 个子任务的零样本平均准确率;Fig. 4 再分为 Single-NIAH、Multi-NIAH、Aggregation、Variable Tracking。
- BABILONG:在长篇干扰文本中嵌入事实或推理链,采用 few-shot 问答平均分。正文写“QA0–QA5”,附录 Fig. 5 和 Table 6 则只列 QA1–QA5;下文沿用 Table 3 汇总数值,这一任务集合记法差异在复现时需要确认。
- PhoneBook:高密度键值检索,帮助分辨“语言建模外推平稳”和“精确取回记录”两种能力。
- LongBench-E:不同类型任务评分的平均,涉及 QA、摘要、few-shot、代码。三列是 0–4K、4–8K、8–16K 长度区间,不是把同一输入固定截断为 4K、8K、16K 的三个实验。
3.4 模型转换协议
转换先用 100M DCLM tokens 最小化教师和学生 attention 层输出的 MSE,再用 3B DCLM tokens 做输出 KL 蒸馏。SmolLM2-1.7B 选用 WSD decay 前、尚未进入高质量数学与代码训练阶段的 checkpoint,转换后继续训练 21B tokens,DCLM、Python-Edu、MegaMathWeb 比例为 1:1:1。Qwen2.5-7B-Instruct 的实验只做蒸馏,没有这一步数学/代码混合继续预训练。(Sec. 4.3,PDF pp. 9–10)
四:结果——状态追踪、检索与遗忘的收益各不相同
4.1 合成任务:稀疏写入与较深历史读取最能拉开差距
| FFLM 错误率(%)↓ | ID | OOD sparse | OOD dense |
|---|---|---|---|
| RoPE | 6.9 | 40.3 | 0.01 |
| SBA | 9.6 | 38.9 | 0 |
| FoX | 8.3 | 36.3 | 0 |
| PaTH | 0 | 0.0001 | 0 |
来源:Table 1,PDF p. 7。0.0001 的单位是百分比,即比例 $10^{-6}$。密集操作时多数模型已经接近零错误;真正显著的差异在 98% 操作为 ignore 的 sparse 条件下,PaTH 能跨过长干扰保留状态。
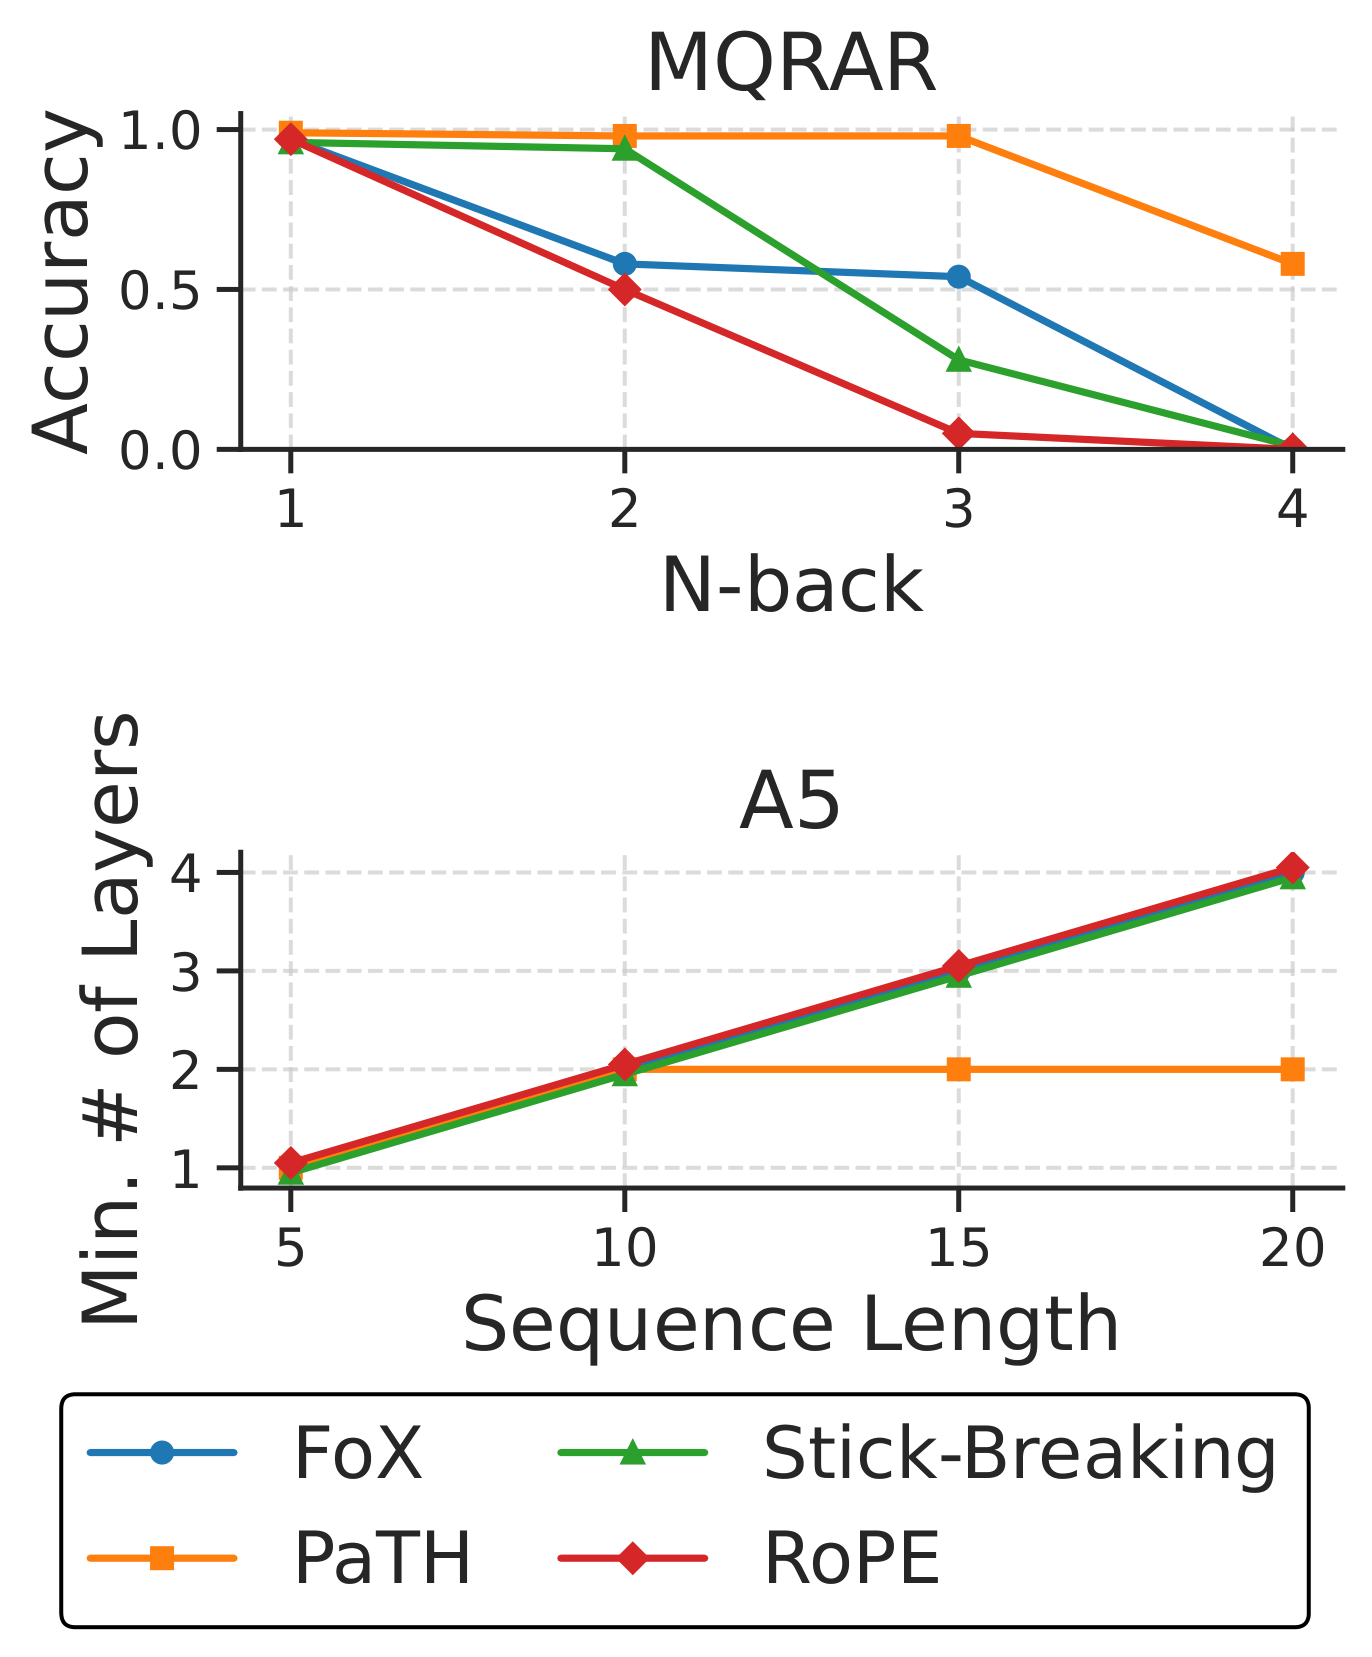
来源:原 Fig. 2,PDF p. 7,使用作者图件。上图横轴为 $N$,纵轴为准确率;下图横轴为序列长度,纵轴为超过 90% 准确率所需最少层数。上图显示 PaTH 在 $N=1,2,3$ 维持接近完整的回忆能力,$N=4$ 明显下降;其他机制更早退化。下图在长度 15、20 时,PaTH 约需 2 层,而对照分别约需 3、4 层。这里的深度优势对应特定合成长度范围,支持非交换路径组合易于表达此类任务的设计动机。
4.2 常规语言建模:收益稳定,组合模型困惑度更低
| 模型 | WikiText ppl↓ | LAMBADA ppl↓ | LAMBADA acc↑ | 六任务 Avg.↑ |
|---|---|---|---|---|
| RoPE | 19.01 | 19.77 | 40.4 | 52.7 |
| FoX | 18.33 | 18.28 | 41.7 | 53.1 |
| PaTH | 18.03 | 16.79 | 44.0 | 54.2 |
| PaTH-FoX | 17.35 | 16.23 | 44.1 | 54.2 |
来源:Table 2,PDF p. 8。六项平均包含 LAMBADA、PIQA、HellaSwag、WinoGrande、ARC-easy、ARC-challenge,不包含困惑度。
PaTH 相对 RoPE 的平均准确率提高 1.5 个百分点,WikiText 困惑度降低 0.98,约为 5.2% 相对下降。PaTH-FoX 的 WikiText 困惑度进一步到 17.35,相对 RoPE 约下降 8.7%,但六任务平均与 PaTH 同为 54.2。
PaTH 对 RoPE 的六项准确率均更高;对 FoX 则有任务差别。例如 PIQA 为 70.5 对 70.8、WinoGrande 为 56.0 对 57.1,PaTH 略低;ARC-easy 为 68.9 对 65.7,PaTH 较高。组合模型提供更好的总体语言建模损失,并未在每项下游任务上超过单独 PaTH。
4.3 长度外推:遗忘机制改善远距离的稳定性
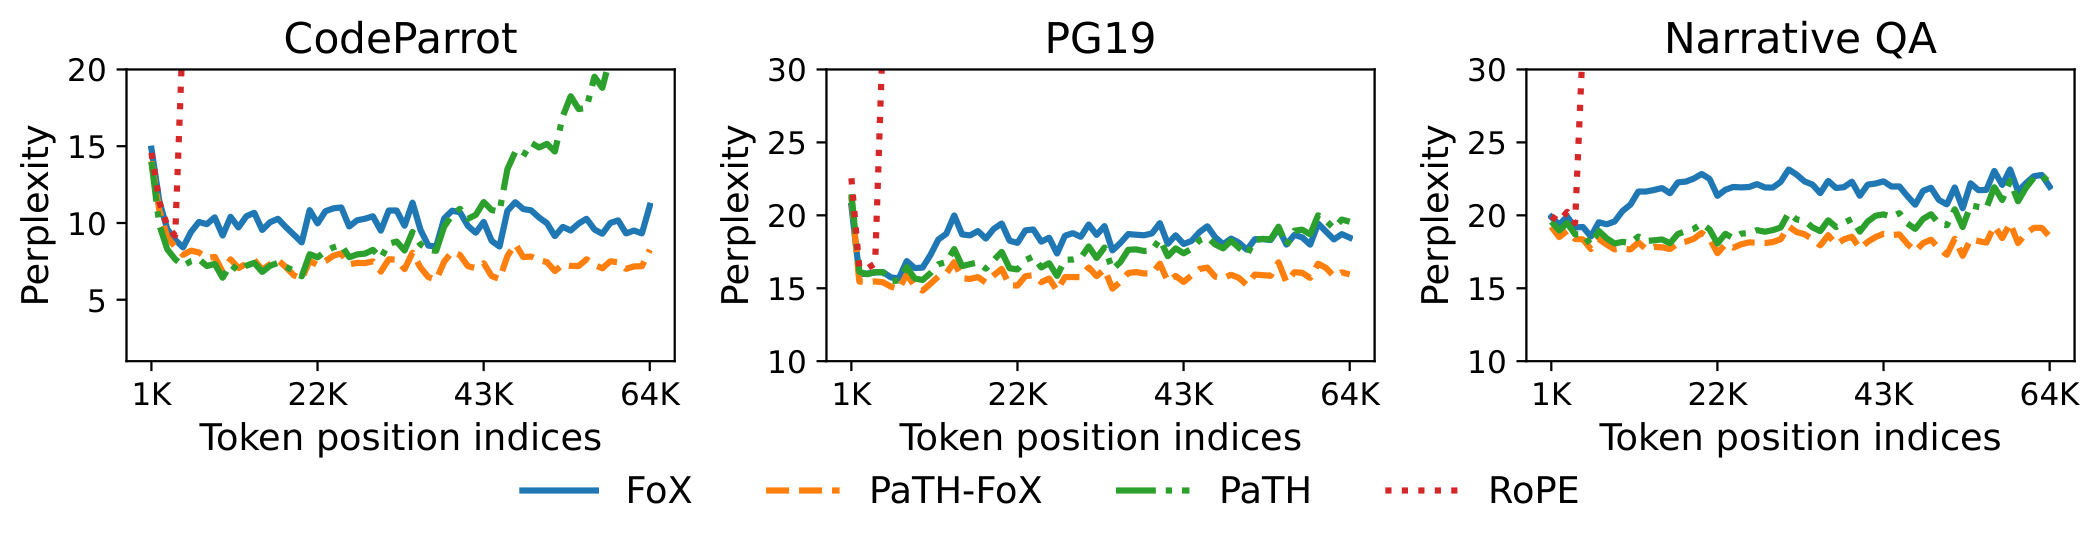
来源:原 Fig. 3,PDF p. 8,使用作者图件。三幅图依次为 CodeParrot、PG-19、NarrativeQA;横轴是长文本内 token 位置,延伸至 64K;纵轴是困惑度,越低越好。红色 RoPE 曲线在超过 4K 训练长度后迅速失效。蓝色 FoX 和橙色 PaTH-FoX 延伸到 64K,组合模型的困惑度更低。
单独 PaTH 在约 32K 内较平稳,但在 CodeParrot 的更远位置明显上升;其他域退化较轻。作者将代码域的改善与状态追踪联系起来,这是一种机制解释。图本身直接支持的是“组合模型的长距离困惑度更稳定”,其精确检索能力需要另看任务评测。
4.4 RULER 与 PhoneBook:组合收益和单独 PaTH 的失败点
| 模型 | RULER 4K↑ | 8K↑ | 16K↑ | PhoneBook 2K↑ | 4K↑ | 8K↑ |
|---|---|---|---|---|---|---|
| RoPE | 35.7 | 1.3 | 0.0 | 32.3 | 15.6 | 0.0 |
| FoX | 41.6 | 29.5 | 4.9 | 62.5 | 38.5 | 17.7 |
| PaTH | 44.6 | 34.8 | 18.7 | 55.2 | 20.8 | 0.0 |
| PaTH-FoX | 42.3 | 34.0 | 22.6 | 89.6 | 93.8 | 66.6 |
来源:Table 3,PDF p. 9;训练长度均为 4096。PaTH 在 RULER 的 4K、8K 汇总中最高,组合模型在 16K 最高。PhoneBook 的组合提升更大:4K 时相对 FoX 增加 55.3 个百分点,8K 时增加 48.9 个百分点。单独 PaTH 的 8K 分数却为零,说明一般语言建模外推和状态追踪优势不会自动转化为高密度精确检索。
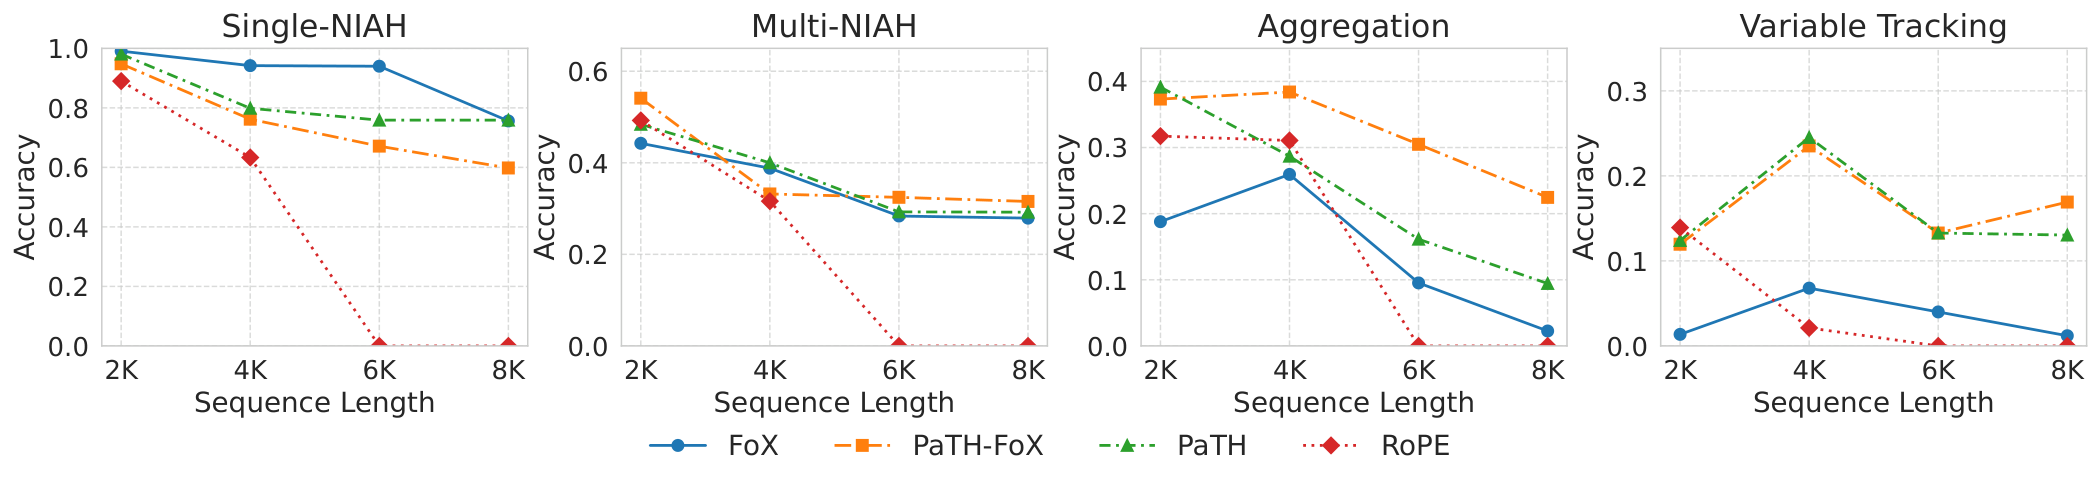
来源:原 Fig. 4,PDF p. 9,使用作者图件。四面板的纵轴均为准确率,刻度范围不同,须分别读取。Single-NIAH 上 FoX 在部分长度更高;Multi-NIAH、Aggregation 和 Variable Tracking 显示不同取舍。PaTH 系列在变量追踪中明显优于 RoPE 与 FoX,但最高曲线也只有约 0.25,任务仍很困难。因而“汇总分更高”不等于各类检索都已被解决。
4.5 BABILONG 与 LongBench-E:保留状态的价值随任务而变
| 模型 | BABILONG 0K↑ | 4K↑ | 8K↑ | 16K↑ |
|---|---|---|---|---|
| RoPE | 33.0 | 13.8 | 0.0 | 0.0 |
| FoX | 23.8 | 20.2 | 8.2 | 4.4 |
| PaTH | 33.8 | 24.6 | 16.8 | 11.6 |
| PaTH-FoX | 28.6 | 25.6 | 19.2 | 10.0 |
来源:Table 3,PDF p. 9。0K 是论文标注的无长篇干扰条件,不代表没有问答输入。组合模型在 4K、8K 最优,单独 PaTH 在 16K 更高。遗忘有助于抑制干扰,但其最佳强度取决于任务所需的远程事实。
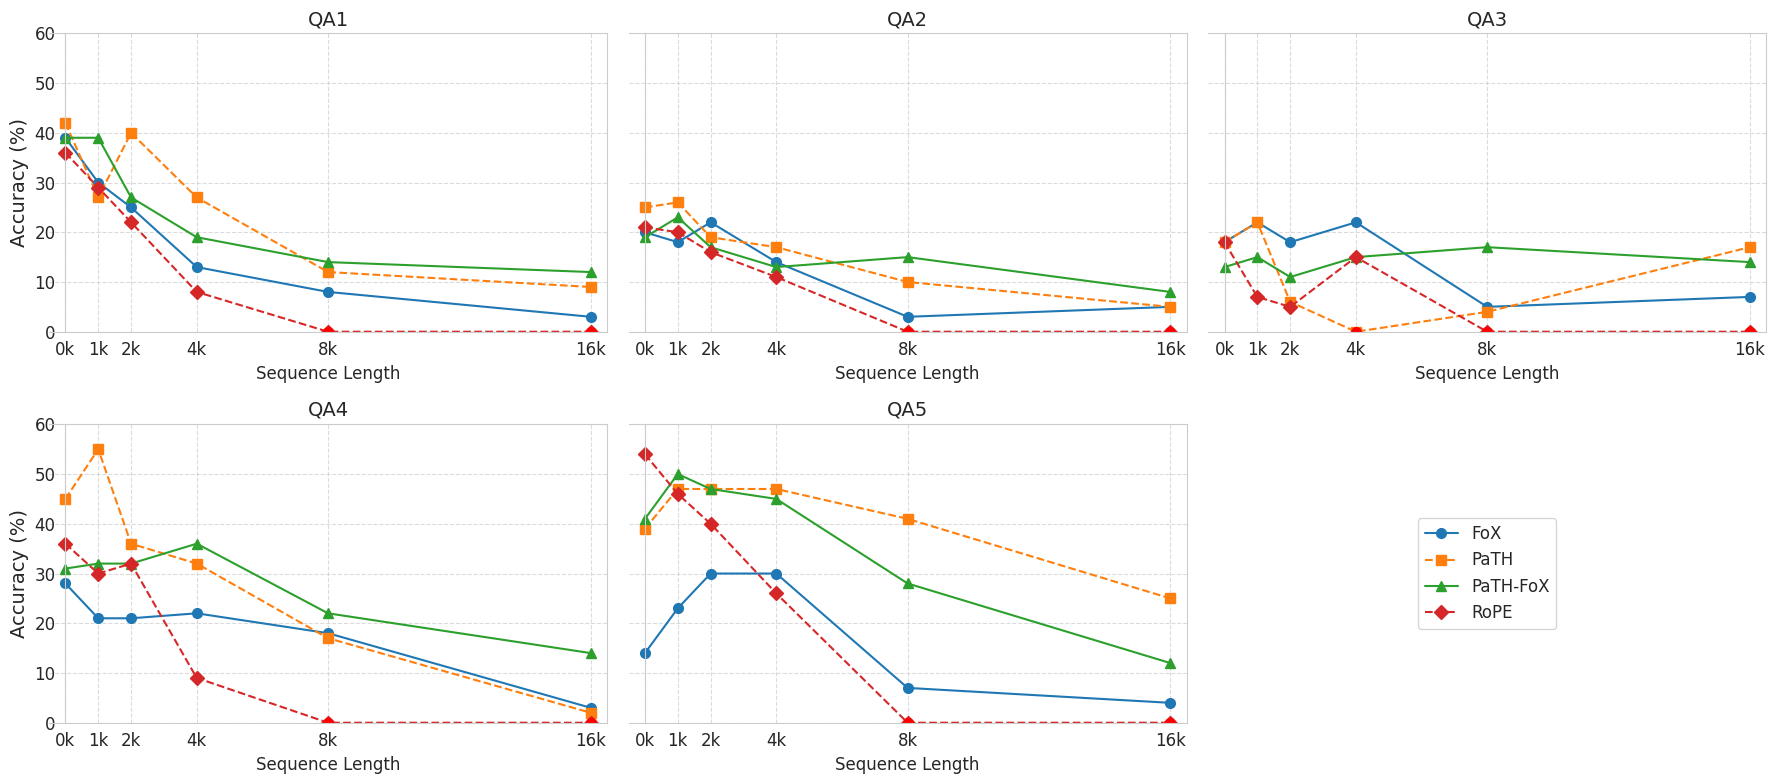
来源:原 Fig. 5,PDF p. 20,使用作者图件。五个面板分别检验单事实、双事实、三事实、双参数关系、三参数关系。纵轴为百分制准确率。PaTH 的优势在一些关系追踪任务上更明显,例如 QA5;QA3 中各模型分数都较低且曲线波动,不宜仅凭总分把收益概括为统一的多跳推理提升。
| 模型 | LongBench-E 0–4K↑ | 4–8K↑ | 8–16K↑ |
|---|---|---|---|
| RoPE | 18.7 | 3.7 | 2.0 |
| FoX | 23.4 | 16.9 | 11.7 |
| PaTH | 27.2 | 22.5 | 14.4 |
| PaTH-FoX | 23.4 | 21.8 | 16.1 |
来源:主文 Table 3,PDF p. 9。附录 Table 7(p. 21)把组合模型前两列写作 23.5、21.9,与主表各差 0.1;此处明确采用主表口径。
附录明细表揭示了平均分后的差异。0–4K 的 gov_report 中 PaTH 为 22.3、组合模型为 10.2,单独 PaTH 的短段摘要效果更好;8–16K 的 triviaqa 则组合模型为 31.6、PaTH 为 18.4;同区间 hotpotqa 为 7.7 对 8.8,组合模型并不占优。由此可见,遗忘对远程信息的选择存在任务依赖,不能用一个总平均替代具体任务判断。(Table 7,PDF p. 21)
4.6 转换预训练模型:SmolLM2 收益与 Qwen 的混合结果
| SmolLM2-1.7B 设置 | GSM8K↑ | HumanEval↑ | MBPP+↑ |
|---|---|---|---|
| Base,继续预训练之前 | 8.6 | 16.4 | 38.6 |
| RoPE,继续预训练之后 | 19.9 | 23.1 | 47.1 |
| FoX,转换及继续预训练之后 | 15.5 | 21.3 | 48.2 |
| PaTH,转换及继续预训练之后 | 20.1 | 25.6 | 51.3 |
来源:Table 4,PDF p. 9。PaTH 相比同表 RoPE 的增益为 GSM8K +0.2、HumanEval +2.5、MBPP+ +4.2 个百分点。Base 到最终模型的大幅提高还包含 21B tokens 的领域训练,不能全部归于注意力替换。
| Qwen2.5-7B-Instruct,仅蒸馏 | 教师 RoPE | 学生 PaTH | 差值(百分点) |
|---|---|---|---|
| MMLU | 74.21 | 73.28 | −0.93 |
| HellaSwag | 85.20 | 84.83 | −0.37 |
| WinoGrande | 71.51 | 68.90 | −2.61 |
| GPQA Diamond | 33.33 | 34.34 | +1.01 |
| TheoremQA | 18.12 | 21.88 | +3.76 |
| GSM8K | 80.29 | 80.67 | +0.38 |
| MATH | 69.10 | 65.38 | −3.72 |
| HumanEval | 82.32 | 77.44 | −4.88 |
| MBPP | 74.71 | 75.10 | +0.39 |
| RULER 4K | 94.37 | 93.24 | −1.13 |
来源:Table 5,PDF p. 9。成熟模型转换没有表现为全面提升。作者提出“较早转换可能更容易”的解释,但这里还同时改变了模型、训练历史和后续训练协议,因此这一解释仍是推测。
4.7 效率:与标准 attention 同阶,额外路径计算有实际成本
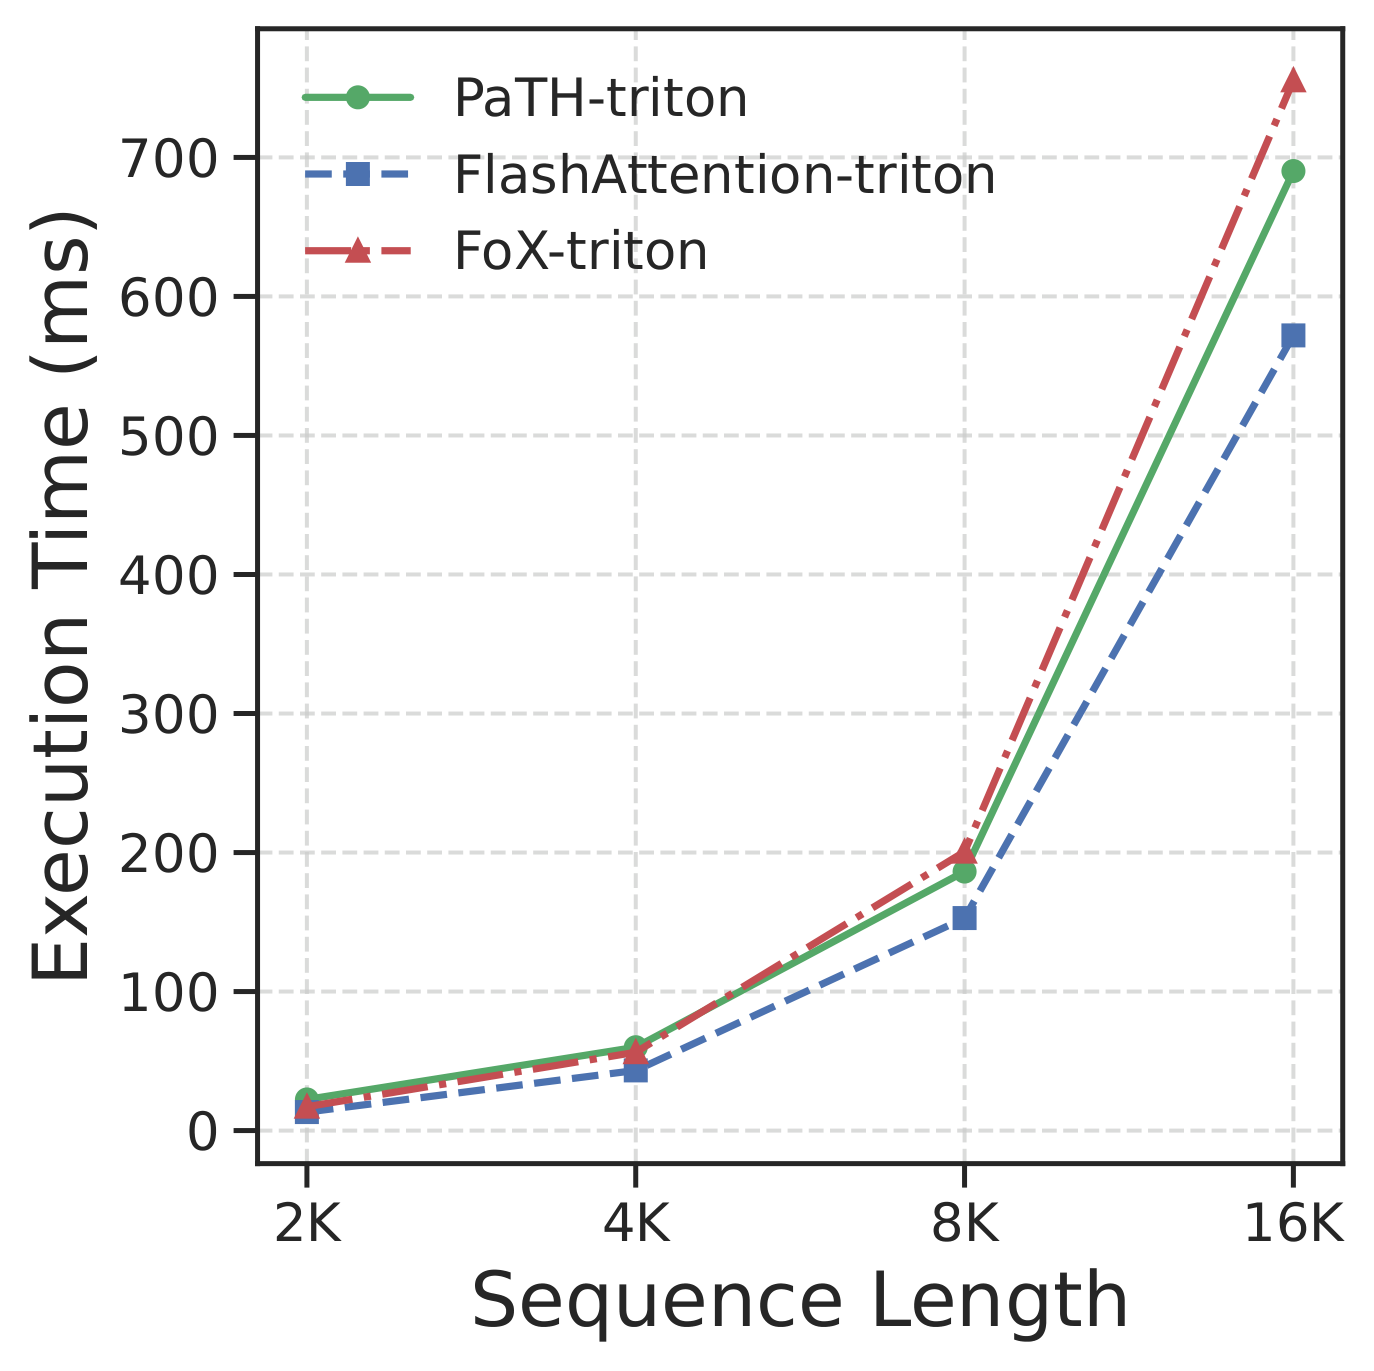
来源:原 Fig. 1,PDF p. 6,使用作者图件。横轴为 2K–16K 序列长度,纵轴为毫秒;单张 H100,batch 32、32 个 heads、head dimension 64。图中 PaTH 比 FlashAttention-triton 慢,在较长长度上比 FoX-triton 快。论文把它描述为相对 RoPE 的适度额外开销。该图是指定配置的 kernel 执行时间,不能换算成未报告的端到端训练或服务加速比。
五:结论——值得借鉴的设计与实际取舍
PaTH 提供了一种有力的设计方式:将历史操作的代数组合写进 attention 的内容匹配,再用 softmax 读取显式历史记录。单位阵减秩一项把“可以擦除、可以翻转、顺序敏感”三个性质放进一个可分块计算的基本单元。其最有说服力的证据是合成任务中的状态追踪优势,以及真实长上下文任务中 PaTH 与 FoX 的互补。
选择这一机制时,有三项会实际改变判断的代价。第一,训练仍是二次 attention,并增加每块 $d\times d$ 变换以及解码时历史 key 的改写;论文测速只覆盖 head dimension 64。第二,精确算术下的非扩张性不能保证 BF16 连乘稳定,作者要求把 $\beta$ 裁剪到低于 2,防止有限精度误差引发发散。第三,一次 rank-one 反射型转移无法直接覆盖一般 RoPE 旋转;“广义乘法位置编码包含 RoPE”与“本文单步 PaTH 参数化包含 RoPE”是不同命题。(Sec. 6,PDF p. 10)
后续最值得追问的是:如何在更大 head dimension 和完整解码服务中控制额外带宽成本;如何让遗忘门按任务保留必要的远程记录;以及能否用反射的组合兼顾状态追踪和旋转归纳偏置。论文已经给出相应机制线索,但当前实验最稳妥的结论仍是:PaTH 增强了状态追踪,PaTH-FoX 在多项长上下文任务上进一步改善结果,而模型转换与检索表现具有明确的任务和协议依赖。