Subquadratic Algorithms and Hardness for Attention with Any Temperature:中文研读笔记
作者:Shreya Gupta、Boyang Huang、Barna Saha、Yinzhan Xu、Christopher Ye,均来自 University of California, San Diego。
版本:arXiv:2505.14840v1,arXiv 提交日期 2025-05-20;获取与研读日期 2026-09-28。PDF 首页排版日期为 2025-06-09,侧边版本标识仍是 v1,本文按 arXiv 版本标识归档。
材料:原文 PDF、作者主 TeX、源码清单。源码获取成功。
配套:英文幻灯片 PDF、可编辑 TeX。本目录名 Attention-Temperature 是归档主题名,并非作者提出的方法缩写。
本次阅读覆盖正文 Sec. 1–6(PDF pp. 1–30)、Figure 1–2、Table 1,以及所有参与主文件编译的算法与证明章节。参考文献位于 pp. 30–34,核对了核心工具与相关工作的条目;没有独立附录。页码均为 PDF 页码,与印刷页码一致。阅读以作者 TeX 为主,PDF 用于核对最终公式、图示和位置。文中的“本次分析”与“教学例子”不是论文报告的实验或作者勘误。
论文总览
论文的主线是:先把每个 query 的有效 score 区间压缩到对数宽度,再通过几何范围查询计算局部多项式的加权矩,从而在固定维度下实现不依赖高温假设的次二次近似注意力。
这里的近似要求很强:输出矩阵的每一个元素都必须达到指定的绝对误差,而不是只要求平均误差较小。对于固定 $d=O(1)$,Theorem 1.3 给出
时间,其中 $n$ 是序列长度、$d$ 是 head dimension、$B$ 是输入元素绝对值上界,$\varepsilon$ 是最终输出误差。数值大小只以对数方式进入复杂度,这正是标题“任意温度”的算法意义。(Sec. 3,pp. 9–17。)
困难性部分把整数最大内积与正交向量问题归约到注意力。在 SETH 下,某些增长极慢但非常数的维度 $d=2^{C\log^*n}$ 已足以阻止固定幂次的次二次加速;在更强的广义高维 OV 假设下,多项式维度时得到矩阵乘法量级的下界。(Sec. 5,pp. 24–29。)
阅读时必须保留的限制:本稿没有运行速度或模型质量实验。固定维度算法不等于适用于任意实际 head dimension 的高效 GPU 内核;“最优”也不是已证明朴素 $O(n^2d)$ 在所有维度都最优。低秩、梯度以及部分下界证明另有可定位的公式或参数不一致,后文逐项说明,不能把所有摘要表述当成同等程度已核验的结论。
结构地图
| 原文章节 | 内容与作用 | PDF 页码 / 关键定位 |
|---|---|---|
| 1 Introduction | 定义问题、提出任意温度目标、汇总上下界 | pp. 1–5;Definitions 1.1–1.2、Theorems 1.3–1.7、Table 1 |
| 1.1 Technical Overview | 裁剪、舍入、局部多项式、半空间的直觉 | pp. 5–7;Figures 1–2 |
| 1.2 Related Work | 与近似注意力、KDE、表达能力及其他计算模型的关系 | pp. 7–8 |
| 2 Preliminaries | 范数、SETH、OV 与整数 Max-IP 下界 | pp. 8–9;Theorems 2.2–2.3 |
| 3.1 Warm-up: $d=1$ | 排序、相关 key、前缀矩与误差分析 | pp. 9–13;Algorithm 1、Eq. (1)–(2) |
| 3.2 Algorithm for Attention with Constant Head Dimension | 半空间加权查询、多重指数展开、低秩推广 | pp. 13–17;Theorem 3.7、Lemmas 3.10–3.14、Algorithm 2 |
| 4 The Complexity of Attention Gradient Computation | 4.1 符号;4.2 梯度归约与误差分析 | pp. 17–24;Theorem 4.3、Corollary 4.4 |
| 5 New Lower Bounds for Attention | 去归一化的通用构件 | pp. 24–26;Lemma 5.1、Claim 5.2 |
| 5.1 Lower Bound for Attention with Small Head Dimension | 整数 Max-IP 归约 | pp. 26–27;Lemma 5.3、Theorem 5.4 |
| 5.2 Lower Bound for Attention with Large Head Dimension | 高维 OV 下界、常数元素界下的奇偶性归约 | pp. 27–29;Theorems 5.5、5.7 |
| 6 Conclusion | 超慢增长维度、细粒度等价、完整 Transformer 的开放问题 | p. 30 |
| 7 Acknowledgments / References | 致谢与参考文献 | pp. 30–34 |
一:动机与问题设定
1.1 究竟要算什么
论文定义
$\exp$ 对每个元素作用;softmax 沿每一行归一化。给定 $Q,K,V\in[-B,B]^{n\times d}$,问题 $\mathsf{AttC}(n,d,B,\varepsilon)$ 要返回 $\widehat O$,满足
这里的 $\infty$ 范数是最大元素绝对值,不是最大行绝对值和。输出只有 $nd$ 个元素,所以没有必要仅因定义中存在 $n\times n$ 注意力矩阵,就接受二次时间。(Definitions 1.1–1.2,p. 2。)
| 符号 | 含义 / 维度 |
|---|---|
| $Q_i,K_j$ | 第 $i$ 个 query、第 $j$ 个 key,均为 $d$ 维行向量 |
| $V_{j,t}$ | 第 $j$ 个 value 的第 $t$ 个输出坐标,可正可负 |
| $s_{ij}=Q_i\cdot K_j$ | 未缩放 score,绝对值至多 $dB^2$ |
| $p_{ij}$ | 行 softmax 概率,$\sum_jp_{ij}=1$ |
| $\varepsilon$ | 用户要求的最终逐元素加性误差 |
| $\eta$ | 本笔记用于区分证明内部误差的符号;原文通常也写 $\varepsilon$ |
| $g$ | 近似指数函数的多项式次数 |
| $r$ | 原文低秩定理中 $\min(\operatorname{rank}Q,\operatorname{rank}K)$ |
| $T_{\rm MUL}(n,d,n)$ | $n\times d$ 与 $d\times n$ 矩阵相乘的时间 |
1.2 为什么要让复杂度只依赖 $\log B$
固定 $d$ 时,朴素算法用 $O(n^2d)$ 时间显式计算分数,再归一化并乘 $V$。已有全局多项式近似在 score 范围较小时有效,但如果直接在整个 $[-dB^2,dB^2]$ 上逼近指数,次数会随数值幅度显著增加。即使算法在小 $B$ 时很快,也可能在 $B=\operatorname{poly}(n)$ 时失去意义。
作者因此要求对数值幅度的时间依赖为 $\operatorname{polylog}B$。这里“真正次二次”指 $O(n^{2-\delta})$、$\delta>0$ 为不随 $n$ 变化的常数。把 $d$ 固定后,$1/d$ 就提供这个固定指数改善。(Introduction,pp. 2–4。)
1.3 “任意温度”与缩放约定
对于正温度 $T>0$,
因此可以把温度吸收入输入,统一元素界可取 $B_T=\max\{B,B/\sqrt T\}$,因为 $V$ 不随温度变化。算法对 $B_T$ 仍只付出多对数代价。此结论针对正的、可表示的温度及相应输入;$T=0$ 不在 softmax 定义内。它也不意味着从高温到低温,注意力数值和统计行为保持不变。
相关工作比较须统一归一化。 本文使用 $\exp(QK^\top)$;Alman–Song 的原始问题定义使用 $\exp(QK^\top/d)$,其 $B=\Theta(\sqrt{\log n})$ 阈值对应这一缩放。对 $Q,K$ 各除以 $\sqrt d$ 会改变元素上界,所以不能只对照两个论文写出的 $B$ 数字就认定改进。本文 p. 17 脚注 9 也明确提到前作的 $1/d$。外部核对仅用于确认这一约定,见 Alman–Song, 2302.13214v2 的定义与摘要。
二:方法——裁剪、平移、多项式与几何查询
2.1 先去掉概率总质量很小的 key
先用一维版本说明。设 $q_i\geq0$、$m_i=q_i k_{\max}$,定义
对于被丢弃的 key,
对保留项重新归一化得到 $p^{(r)}$,则原文证明输出变化至多 $3\eta B$,条件是 $\eta<1/2$。这里必须控制 总概率质量,而不仅是每个被删项都小;最终输出误差还要乘上 value 的幅度 $B$。(Sec. 3.1,pp. 10–11;一般维度见 pp. 13–14。)
该方法不是固定保留 top-$k$:相关集合可能包含所有 key。算法加速依赖对整个区域聚合求和,而不是承诺相关点的个数少。
2.2 一维直觉与原图 1
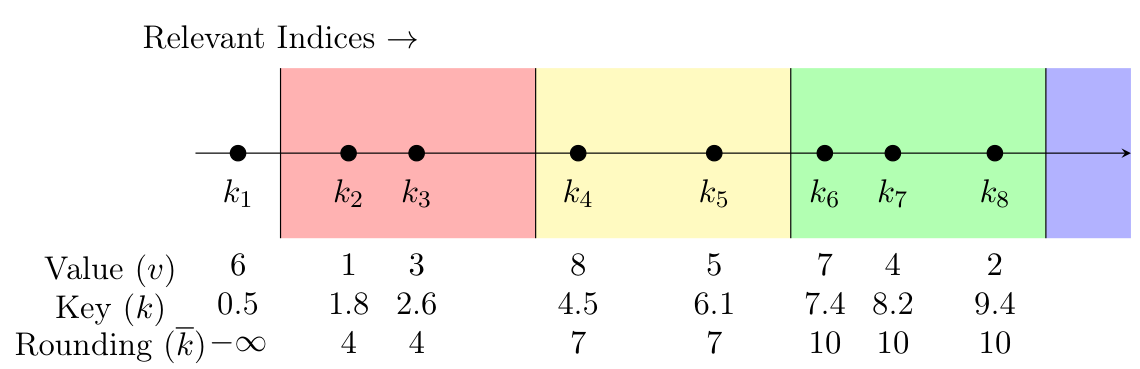
原图 1,PDF p. 5,完整保留 key、value 与 rounded-key 标签。横向位置是 $k_j$,上方箭头指向相关区间;下方三行依次给 value、key 和舍入值。$k_1$ 被丢弃,其他点按区间共享舍入值。图中没有实验坐标轴,也不表示测得的性能。
这幅图解释的是早期舍入算法:用宽度约为 $\log(1+\eta)$ 的 score 桶,桶数约为 $\log(n/\eta)/\eta$,最终会产生约 $\widetilde O(nB/\varepsilon)$ 的时间依赖。图中设定的桶宽 3 只是视觉示意,不满足后文小误差证明所需的参数范围。最终算法用多项式替换这些密集小桶,才把 $B/\varepsilon$ 的依赖压成对数。(Sec. 1.1,pp. 5–6。)
2.3 只在一个对数宽度的区间内近似指数
定义平移量
对相关 key,$q_i k_j-c_i\in[0,\log(n/\eta)]$。softmax 对同一行统一平移不变,所以可以在这个短区间构造次数
的多项式 $P$,使 $|P(x)-e^x|\leq\eta e^x$。相关概率的估计为
分子、分母的相对误差共同给出
因此这一阶段再贡献至多 $4\eta B$ 输出误差;加上裁剪误差得到 $7\eta B$。令 $\eta\leq\varepsilon/(7B)$ 即达到目标。需要时进一步限制 $\eta<0.1$;$B=0$ 的输出直接为零。(Lemma 3.3、Eq. (1),p. 11;Lemma 3.10,p. 14。)
为何创新不只是“用多项式近似 softmax”? 因为整体 score 的绝对值仍可能很大。真正改变次数的是先丢弃远离最大值的项,再对每行单独平移;局部近似区间宽度才与 $B^2$ 脱钩。原文系数有多项式位长保证,但没有给出 GPU 浮点实现的数值稳定性测试。
2.4 一维加速来自预先存好的矩
把 $P(x)=\sum_{\ell=0}^g m_\ell x^\ell$ 展开:
分母同理,只须将 $v_j$ 换成 1。排序后的 $R_i$ 是前缀或后缀,预存 $k_j^b$ 和 $k_j^b v_j$ 的前缀和,再二分区间端点即可回答查询。所有指数 $b=0,\ldots,g$ 都要包括;原文伪代码只列 $b\geq1$,实现时还须补上零次矩。
当 $q_i<0$ 时,使用反方向的 key 次序;原文等价地分别计算 $(|q|,k,v)$ 和 $(|q|,-k,v)$ 后取相应行。$q_i=0$ 时输出就是 value 均值,应单独处理,避免端点公式除以零。最终一维时间是 $\widetilde O(n\operatorname{polylog}(B/\varepsilon))$。(Lemmas 3.1、3.4–3.5,Algorithm 1,pp. 9–13。)
2.5 多维关键:相关集合是半空间
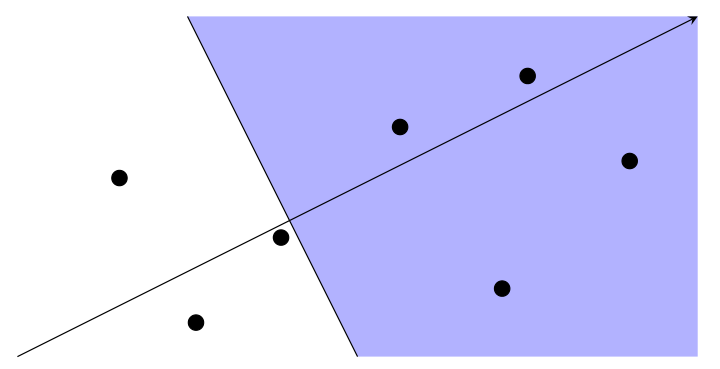
原图 2,PDF p. 7。每个黑点代表一个 key,箭头方向为示意 query $q_i=(2,1)$;斜线是 score 阈值的边界,蓝色区域是相关半空间,白色区域被丢弃。图没有数值坐标刻度,点的 value 权重被省略。
高维中无法用一个统一排序服务所有 query。原文不显式排序,而先通过半空间是否包含点的查询,二分得到整数 $s^{(i)}_{\max}$,满足
然后令
相关 score 平移后属于 $[0,\log(n/\eta)+\log(1+\eta)]$。因此仍然可以用对数次数的多项式。注意 $s^{(i)}_{\max}$ 是网格化的最大值估计,不是要求先精确求出所有内积。(Definition 3.8,p. 13;Lemma 3.12,pp. 15–16。)
2.6 多重指数把求和转成加权范围查询
设多重指数 $\alpha=(\alpha_1,\ldots,\alpha_d)$,$|\alpha|\leq g$。对每个 value 坐标 $t$,预存点 $K_j$ 的权重
范围查询返回
对分母再构造不乘 $V$ 的权重 $\phi_0$。利用多项式定理(multinomial theorem)展开,可把 $\widehat O_{i,t}$ 写成这些 $\phi$ 的线性组合;组合系数仅依赖当前 $Q_i,c_i$ 和 $P$。
Matoušek 的 simplex range searching 数据结构在固定维度下,用 $O(n\log n)$ 预处理支持 $\widetilde O(n^{1-1/d})$ 加权区域和查询。本文只查询半空间。单项式数可由 $\binom{g+d}{d}$ 控制,在固定 $d$ 下为 $g^{O(d)}$。查询最大值网格只需 $O(\log(dB/\eta))$ 次。因此累计时间为
这也是 $d$ 必须固定的重要原因:隐藏的 $g^{O(d)}$ 不是对任意大 $d$ 都便宜的常数。(Theorem 3.7,p. 13;Lemmas 3.11–3.13,pp. 14–16。)
2.7 教学伪代码
输入:Q、K、V,目标逐元素误差 eps;固定维度 d
eta = min(0.05, eps / (14 * max(1, B)))  # 留出严格误差余量
构造次数 O(log(n/eta)) 的指数近似多项式 P
为 K 建立半空间计数结构
对所有所需单项式和每个 value 坐标,建立加权半空间和结构
对每个 query Q_i:
    用计数查询二分 score 最大值所在的网格
    确定 c_i 及半空间 R_i
    查询各单项式的权重和,组合出分子 N_i 和分母 Z_i
    返回 N_i / Z_i
这是对 Algorithm 2 的教学整理,不是可直接用于训练的实现。它保留有符号 value、零次矩、内部误差与最终误差的区别。
2.8 低秩推广:几何降维成立,更强时间界需保留疑问
Theorem 1.4 声称:若 $r=\min(\operatorname{rank}Q,\operatorname{rank}K)=O(1)$,即使 $d$ 很大,也可在
时间内计算输出。(定理在 pp. 3、16,证明在 pp. 16–17。)
几何层面的正确直觉很清楚。若 $Q=U_QV_Q^\top$,其中 $U_Q\in\mathbb R^{n\times r}$、$V_Q\in\mathbb R^{d\times r}$,则令
便有 $Q'K'^\top=QK^\top$。因此 score 和相关半空间可以降至 $r$ 维。这里只需要低秩的一侧;若低秩的是 $K$,对称处理。
本次核对发现三点不能直接跳过:
- p. 17 印出的 $K'^\top=V_Q^\top U_KV_K^\top$ 一般不能相乘:$V_Q^\top$ 是 $r_Q\times d$,$U_K$ 是 $n\times r_K$。即使分解两侧,正确乘积也应从 $V_Q^\top V_KU_K^\top$ 得到。
- 同页把 $O(nd\max(r_Q,r_K))$ 化为 $O(nd)$,但定理只假设两秩的最小值为常数。上面的单侧分解可规避这一步,却不是原文写出的证明。
- 降维后 $V$ 仍为 $n\times d$。Sec. 3.2 的权重结构按 value 坐标 $t$ 构造,直接推广会带来输出列数的成本;原文没有解释如何只付 $nd$ 后消除其余 $d$ 依赖。直接逐列套用可得到较保守的 $\widetilde O(nd+d\,n^{2-1/r}\operatorname{polylog}(B/\varepsilon))$ 型界,不能自动推出定理声称的更强式子。
因此本笔记保留 Theorem 1.4 的作者陈述,确认精确 score 降维恒等式,但不把完整时间界标为已由给出的证明核实。这并非对该时间界作出不可能性判定。另外,定理针对精确低秩,没有给近似低秩残差传播的保证;低温下小 score 扰动可能影响注意力分配。
2.9 梯度:原文目标、正确恒等式与可复用的归约思想
原文研究单个注意力单元的平方损失:
其中 $A_1,A_2,A_3,E\in\mathbb R^{n\times d}$,$X,Y\in\mathbb R^{d\times d}$。Theorem 4.3 声称用 $O(d)$ 次精度为 $\varepsilon/\Theta(ndB^3)$ 的 attention 调用、加 $O(nd^2)$ 额外工作计算梯度;Corollary 4.4 给出固定 $d$ 的同阶次二次时间。(pp. 17–18。)
但 p. 18–19 的梯度第二项印为
按文中行 softmax 定义重新求导,设 $G=CH^\top$、$r=(F\circ G)\mathbf 1$,应当有
原因是将第 $i$ 行写成列向量 $f_i=F_i^\top$ 后,单行 softmax 的 Jacobian 为 $\operatorname{diag}(f_i)-f_if_i^\top$;每行减去的是本行的加权平均。原文的右侧对角乘法与这里的左侧行缩放不同。p. 18 对 $F$ 的文字表达式还漏掉逆归一化,不能据此修改它在 Definition 4.5 中明确的行概率定义。
下面的 本次重推导 保留作者“把梯度化成少量前向 attention”这一思路。对 $p=1,\ldots,d$,计算
则
求 $Z=FH$、$U=FA_2$ 和每个 $T_p$ 共需 $d+2$ 次对相同 $Q=A_1X,K=A_2$、不同 value 矩阵的 attention 调用。剩下的行缩放、求和和左乘 $A_1^\top$ 需要 $O(nd^2)$。这是精确算术恒等式,支持 $O(d)$ 次调用的结构性结论。
误差与幅度须重新记账:$\|H\|_\infty$ 一般达到 $dB^2$,$\|\operatorname{diag}(H_{*,p})A_2\|_\infty$ 可达 $dB^3$;$A_1X$ 的界也需要给定 $X$ 的幅度,而 Definition 4.2 未明确列出。若这些输入有多项式幅度界,可把 oracle 精度设为 $\varepsilon/[n\operatorname{poly}(d,B)]$,因前向仅依赖对数精度,固定维度的时间指数仍可保留。这里没有认证原文具体的 $\Theta(ndB^3)$ 常数幂误差式。
可重复的教学检查:取 $n=2,d=1$,$A_1=(1,2)^\top$、$A_2=(-1,1)^\top$、$H=(1,3)^\top$、$E=(0.2,-0.1)^\top$、$X=0.4$。中心差分步长从 $10^{-4}$ 到 $10^{-6}$ 得到约 $4.95574696$;上述正确恒等式给出 $4.955746964223348$,原文印出的式子给出 $-0.45201333971841007$。脚本:verify_math.py(本地核验附件);记录:math-check.json(本地核验附件)。这证明的是这一印刷公式与定义不一致,不是证明所有梯度加速结论都不成立。
三:理论分析与验证——困难性如何归约进注意力
本论文没有数据集、训练配置、吞吐量测试、显存测量、消融实验或统计显著性报告。其验证形式是构造性算法、误差界与条件归约。本文的数值检查只核对一个代数式,不补充或替代论文实验。
3.1 先明确下界的假设与量词
SETH(强指数时间假设)认为:对任何固定指数改善,都存在足够大的子句宽度,使 $k$-SAT 不能在相应加速的指数时间内解决。它是未证明的计算复杂性假设;据此导出的注意力下界也是条件下界。(Hypothesis 2.1,p. 8。)
两种中间问题:
- 整数双集合最大内积 Max-IP:给两个整数向量集合,各含 $n$ 个点,求 $\max_{a,b}a\cdot b$。引用的下界允许 $O(\log n)$ 位的整数输入,并在 $d=C^{\log^* n}$ 达到近二次困难性。(Theorem 2.3,p. 9。)
- 正交向量 OV:给两个 $\{0,1\}^d$ 集合,判断是否存在 $a\cdot b=0$。常规 SETH 推论作用于 $C\log n$ 维;多项式维度的矩阵乘法级下界依赖另外提出的广义高维 OV 假设,不能仅标注“由 SETH 得到”。(Theorem 2.2,p. 9;Introduction,p. 4。)
3.2 归一化没有隐藏行和:哨兵 key 构件
令 $S_i=\sum_j\exp(Q_i\cdot K_j)$。普通 softmax 输出看不到 $S_i$ 的绝对幅度。Lemma 5.1 为每个 query 增加一个坐标 $\ln c_i$,再加一个哨兵 key,使其 score 为 $\ln c_i$;原始 key 的 value 第一坐标设为 1,哨兵 value 设为 0。对应输出恰为
$o_i$ 在 $1/2$ 的哪一侧,揭示 $S_i$ 在 $c_i$ 的哪一侧。只需常数倍更精确的加性误差,就能区分 $S_i\geq(1+\eta)c_i$ 与 $S_i\leq(1-\eta)c_i$。对几何网格 $c_i=(1+\eta)^{f_i}$ 并行二分,即可恢复行和的相对近似;迭代次数为 $O(\log\log n+\log(dB/\eta))$。(Lemma 5.1、Claim 5.2,pp. 25–26。)
参数核对:Lemma 5.1 把 oracle 的元素界仍写成 $B$,但新坐标 $\ln c_i$ 可达 $O(\log n+dB^2)$。直接写出的构造需要扩大元素界,例如取 $B'=O(1+B+\log n+dB^2)$,或另外给出保持界的编码。对于允许 $B=\operatorname{poly}(n)$ 的 Max-IP 结论,扩大到多项式界仍符合目标;对于精确宣称的常数 $B$ 或 $O(\sqrt{\log n})$,不能不加论证地沿用这个通用引理。
3.3 小维度下界:softmax 的尖锐性编码整数最大值
给整数向量 $a_i,b_j$,取足够大的常数 $C_0$,构造 score
设 $M_i=\max_j a_i\cdot b_j$,则
因为 $M_i$ 是整数,取对数、除以 $C_0$ 后,常数相对误差也可以被四舍五入消除。结合行和构件,从近似注意力得到精确 Max-IP;$Q,K$ 及新增坐标仍可保持多项式幅度。(Lemma 5.3、Eq. (4),pp. 26–27。)
Theorem 5.4 的精确含义:固定足够小的常数误差和多项式元素界;对任意 $\delta>0$,存在依赖 $\delta$ 的常数 $C$,令 $d=2^{C\log^*n}$,该维度的注意力在 SETH 下需要 $n^{2-\delta}$ 量级时间。$\log^*n$ 是反复取对数到常数所需的次数,增长极慢,但仍非有界常数。
不能把这个量词简写成“所有 $d=\omega(1)$ 都被证明需要二次时间”,也不能据此说固定 $d=2$ 的 $n^{3/2}$ 指数已最优。论文仍留下 $1\ll d\ll2^{\Theta(\log^*n)}$ 区间与固定维度指数是否可改进的问题。(p. 27;Conclusion,p. 30。)
3.4 大维度下界:正交对在指数和中贡献一个 1
取固定常数 $0<\gamma<1$,令 $k=\gamma/n$,构造
存在正交对时,某个 $S_i\geq1$;没有正交对时,每个内积至少为 1,故所有 $S_i\leq nk$。两者是常数间隙,可用常数精度区分。(Eq. (5),p. 28。)
本次分析对参数的直接核对:可固定 $k=1/(10n)$,并只加一个阈值固定为 $c=1/2$ 的哨兵,无须通用二分。无正交对时 $S_i\leq0.1$,所以 $o_i\leq1/6$;存在时有 $o_i\geq2/3$。这给出只需一次常数精度 attention 调用的构造,新坐标仅为常数,保留 $B=O(\sqrt{\log n})$,尺寸为 $n+1,d+1$。它说明该高维下界的核心间隙能在所需幅度量级下实现;这段固定阈值写法是本次整理,原文 Lemma 5.6 的陈述写“一次调用”,证明却调用多轮去归一化引理。
Theorem 5.5 在 Generalized High-Dimensional OV Hypothesis 下给出
下界,$d=\operatorname{poly}(n)$、$B=O(\sqrt{\log n})$、$\varepsilon=O(1)$。(p. 27。)
其比较对象是使用快速矩阵乘法的标准计算路线。特别地,$d=n$ 时对应 $n^{\omega-o(1)}$,不是朴素 $n^3$ 下界。时间下界也不强制算法必须显式存储整张注意力矩阵;原文“requires explicitly computing”不能作为存储结构不可能性的证明。
3.5 常数元素界下界:整数行和的奇偶性及其问题
Theorem 5.7 声称:对所有 $\delta>0$,存在 $C$,在 $d=C\log n$、$B=\log2$、$\varepsilon=n^{-C}$ 时,需要 $\Omega(n^{2-\delta})$ 时间。(p. 28。)
证明意图是构造 $S_i=\sum_j2^{a_i\cdot b_j}$。非正交项都是偶数,正交项等于 1。以独立概率 $1/2$ 抽样 key,在至少有一个正交对象的行中,正交对象的个数为奇数的概率是 $1/2$;重复 $O(\log n)$ 次便能高概率发现。这里需要的是奇数个,不需要保证恰好一个。将行和恢复到小于 $1/2$ 的加性误差后可取整检查奇偶性。$S_i\leq n2^d$,解释了 $\varepsilon\asymp1/(n2^d)$ 的高精度要求。(Lemma 5.8,pp. 28–29。)
印出的参数证明未闭合:p. 29 同时把 $Q$ 和 $K$ 都乘以 $\log2$,实际 score 是 $(\log2)^2a_i\cdot b_j$,而非后面写的 $\log2\,a_i\cdot b_j$。当内积为 1,指数值约为 $1.61680667$,不是整数 2。把两侧改成 $\sqrt{\log2}$ 可修复这一乘积,却已经超过陈述的元素界 $\log2$。另外,通用行和引理新增的 $\ln c_i$ 与 value 1 也不满足原样宣称的界;Lemma 5.1 本身还假设 $B\geq1$。
因此,这里可以学习“整数化加奇偶性”的归约思路,但 本次阅读没有验证 Theorem 5.7 所写的精确 $B=\log2$ 参数。不能把它当成无保留成立的阈值改进,更不能忽略上一节提到的跨论文缩放约定。修正具体常数或改变维度编码需要另写完整证明。
四:结果——按适用域读,而不是只看摘要
下表整理作者的结果与本次核对边界。上界是运行时间,下界是条件困难性,两者并非都已在每个维度匹配。
| 结果 / 位置 | 条件与作者陈述 | 本次阅读的解释与核对状态 |
|---|---|---|
| 固定维度;Theorem 1.3,pp. 3、9、16 | $d=O(1)$;$\widetilde O(n^{2-1/d}\operatorname{polylog}(B/\varepsilon))$ | 核心裁剪、误差与范围查询论证已核对;不要求高温 |
| 一维;Lemma 3.1,p. 9 | $\widetilde O(n\operatorname{polylog}(B/\varepsilon))$ | 排序加前缀矩;需处理零 query、零次矩 |
| 低秩;Theorem 1.4,pp. 16–17 | $r=\min(\operatorname{rank}Q,\operatorname{rank}K)=O(1)$;$\widetilde O(nd+n^{2-1/r}\operatorname{polylog}(B/\varepsilon))$ | 精确 score 降维成立;原文维度、秩假设与输出列成本仍需补证 |
| 梯度;Theorem 4.3,p. 18 | $O(d)$ 次 oracle 调用,精度 $\varepsilon/\Theta(ndB^3)$,额外 $O(nd^2)$ | 已重推导正确的 $O(d)$ 调用结构;印刷梯度与具体误差参数不可直接照用 |
| 超慢增长维度;Theorem 5.4,p. 27 | $d=2^{C\log^*n}$、多项式幅度、常数误差;SETH 下近二次 | Max-IP 整数间隙是关键;修正哨兵幅度仍保留多项式参数域 |
| 多项式维度;Theorem 5.5,p. 27 | $B=O(\sqrt{\log n})$、常数误差;广义高维 OV 下 $T_{\rm MUL}^{1-o(1)}$ | 固定阈值哨兵可保持所需幅度;假设强于本稿采用的普通 SETH 推论 |
| 常数元素界;Theorem 5.7,p. 28 | $d=C\log n$、$B=\log2$、逆多项式误差;SETH 下近二次 | 精确参数未核实:两次缩放、哨兵与 value 上界不一致 |
固定维度上界中的序列长度指数可以直观看成:
| 固定 $d$ | $n$ 的主指数 | 含义 |
|---|---|---|
| 1 | 1 | 近线性,仍有多对数因子 |
| 2 | $3/2$ | 次二次 |
| 4 | $7/4$ | 指数改善变小 |
| 8 | $15/8$ | 更接近二次,且隐藏的维度依赖更大 |
这是从定理公式直接计算的教学表,不是运行时间测试。固定 $d$ 的已陈述基本下界仍只有输入/输出量级 $\Omega(n)$;Max-IP 归约说明大幅改善会推进另一经典问题,尚未证明每个固定 $d$ 下的 $2-1/d$ 指数最优。(Table 1,p. 5;Introduction,p. 4。)
五:结论、局限与组会讨论
5.1 最值得带走的贡献
这篇论文给出一条清晰的算法设计路径:全局指数函数难逼近,先用 softmax 尾部界得到局部窗口;窗口依赖 query,就把它表示为几何区域;区域求和再交给带多项式权重的范围数据结构。 加速对象是原注意力输出的高精度近似,不需要先写出所有 pairwise 分数。
它也说明低温本身不是固定维度上的二次时间障碍。更重要的条件是 score 的几何维度、允许的输出误差,以及是否要求在最坏情况上保证。上下界共同把这些条件联系起来,但并未完整解决所有维度区间。
5.2 落地时有哪些边界
- 渐近理论与实际速度:$g^{O(d)}$、几何结构的构建和查询、权重矩的数量都可能很大;论文没有实现结果来确定交叉点。不能据此预测 head dimension 64 或 128 时的速度收益。
- 数值稳定性:近似区间变窄并不消除多项式展开中大数幂与抵消的实现问题。需要另外设计稳定基、精度管理和加权范围和实现。
- 输出宽度与精确低秩:对 $Q,K$ 降维不自动对一般 $V$ 降维;近似秩、因果 mask、动态 KV 更新的适用性没有在本文给出对应定理。
- 训练的范围:正式目标是单注意力单元对 $X$ 的平方损失梯度。它不包含完整网络的收敛、跨层误差积累、优化器或训练步数分析。p. 30 明确把完整 Transformer 的计算复杂度列为开放问题,因此摘要“full LLM training process”应受这个范围限定。
- 下界的范围:条件、最坏情况、指定误差是结论的一部分。下界不否定在分布假设、较弱精度或其他误差指标下设计更快近似。
5.3 本稿复现前应确认的事项
| 核对事项 | 原文位置 | 应如何使用 |
|---|---|---|
| 低秩乘积维度与 value 输出成本 | p. 7;pp. 16–17 | 使用正确单侧投影恒等式;要求补全强时间界 |
| 行 softmax 梯度的对角项 | pp. 18–19 | 采用重新求导的逐行 Jacobian;附数值核验 |
| $H=A_3Y$ 等中间量幅度与 $X$ 输入界 | pp. 17–24,特别是 p. 22 | 重新分配 oracle 精度,不能沿用未核实的精确 $B$ 幂次 |
| 行和构件新增 $\ln c_i$ 的幅度 | pp. 25–26 | 多项式幅度场景扩大界;小幅度场景需特殊构造 |
| $B=\log2$ 的双重缩放与整数奇偶性 | pp. 28–29 | 保留归约意图,不认证原样常数阈值 |
| 与前作的 $1/d$ 缩放约定 | 本文 p. 17 脚注 9;前作定义 | 先统一 score 归一化,再比较元素界 |
这些是实际阅读中发现、且影响解释的事项,不是对其他版本的判断,也没有联系作者确认。正确推导与固定阈值示例均已明确标为本次分析,未改写作者源码。
5.4 可用于组会的讨论问题
- 是否能保留“每行局部 score 窗口”,用更简单的数据结构获得可测量的速度收益?此时愿意放弃哪种最坏情况保证?
- 当 query/key 的精确秩小、value 宽度大时,能否给出包含输出列成本的完整算法?
- 在 $1\ll d\ll2^{\Theta(\log^*n)}$ 的区间,attention 和整数 Max-IP 是否具有更紧的细粒度等价?
- 对多个注意力单元联合计算,能否共享几何预处理或矩信息,优于逐单元求解?
最后两项直接对应原文 Conclusion(p. 30)的开放方向;前两项是本次阅读据方法提出的讨论题。
原始材料与复核记录
主入口 main.tex 实际读取的正文链为 abstract.tex、intro.tex(含 arxiv/arxiv_technical_overview.tex)、prelim.tex、arxiv/arxiv_attention_algorithm.tex(含 arxiv/warmup-1-d.tex)、arxiv/backwards-pass.tex、hardness.tex、conclusion.tex;同时核对了符号宏、两份 TikZ 图源码和 main.bbl 的核心条目。没有执行或编译作者源码。
两幅插图直接裁切自同一版本 PDF;figures/manifest.json 记录页码、裁切坐标和文件名。正文中的渐近式、误差常数和定理号均回查 PDF。梯度与常数缩放检查可在本目录运行 python3 build/verify_math.py。幻灯片构建入口为 python3 build_slides.py slides.en.tex,使用 pdfLaTeX。