Lattice: Learning to Efficiently Compress the Memory — 中文精读笔记
- 作者:Mahdi Karami、Razvan Pascanu、Vahab Mirrokni;Google Research / Google DeepMind。
- 论文版本:arXiv:2504.05646v2,2025-12-30 修订;v1 提交于 2025-04-08。本次获取与研读日期:2026-09-14。
- 原始材料:本地论文 PDF、作者主 TeX、作者附录、源码清单。PDF 共 28 页,以下页码从 1 开始,与本版印刷页码一致。
- 阅读范围:正文 §§1–5,附录 A–D,包括理论推导、全部实质性实验、表 1–5、图 1–8、Listing 1;沿主文件读取实际引用的公式、图表数据与必要宏定义,查阅关键基线的参考文献条目。未将参考文献中的外部论文另作全文精读,未运行作者代码或重训模型。
- 本次成品:英文汇报 PDF、可编辑 TeX。这是分析性笔记,不是全文翻译。文中“本次分析”“教学例子”与作者结果分开标注。
论文总览
问题:固定大小的递归记忆可以摆脱随序列增长的 KV cache,但持续把新 token 的外积叠加进去,会造成信息干扰。能否在每次写入时先查看记忆槽已经存了什么,再决定写入什么?
核心方法:Lattice 把记忆矩阵看作随上下文在线学习的解码器或字典。外层训练学习投影参数,内层对每个 token 的压缩损失做一次梯度更新。关键操作是在解码器内部对记忆矩阵逐列归一化;它的导数自然产生正交投影,使每一列只沿自身的正交补方向更新。随后把状态投影回单位球面,以控制范数。作者将前者称为正交状态递推(Orthogonal State Recurrence, OSR),归一化后称为 NOSR。
最有代表性的证据:110M 模型在 FineWeb-Edu 上,Lattice 用 $m=16$ 个槽得到 15.52 的困惑度,TTT 用 $m=64$ 得到 15.60(表 3,p.10)。这支持在该设置下更有效地利用递归状态;它不表示整个模型显存减少 75%。760M 模型的 Lattice-DOT 在七项零样本任务上的平均准确率为 54.03%,比最强基线 Gated-DeltaNet 的 52.64% 高 1.39 个百分点。
理解时必须保留的边界:正交是相对于“当前单个槽”的局部几何性质,不是所有历史信息无损保存的保证;大部分高质量结果使用 $C=1$ 或 $C=4$,吞吐量图使用 $C=16/64$;附录归一化推导与示例代码存在应在复现前澄清的不一致。
结构地图
| 原文章节 | 作用 | PDF 页码与主要证据 |
|---|---|---|
| 1 Introduction | 固定状态容量、状态感知写入的动机 | pp.1–2;图 1 p.2 |
| 2 Background | Softmax cache、线性注意力和干扰 | pp.2–3;式 (1)–(2) |
| 3 Compression Layer / 3.1 Decoding Layer | 在线压缩、内外层训练 | pp.4–5;式 (3)–(4) |
| 3.1.1 State Normalization | DEC / DOT 目标与正交梯度 | pp.5–6;式 (5)–(9) |
| 3.2 Stabilizing Memory Updates via Normalization | 球面归一化与几何解释 | p.6;式 (10),命题 3.1 |
| 3.3 Forgetting by State Regularization | L2 遗忘、L1 近端更新 | pp.6–8;表 1 p.7,式 (11)–(13) |
| 3.4 Efficient Computation / 3.4.1 Parallel and Hardware Efficient Form | $O(dm)$ 更新、两种分块近似 | p.8;式 (14)–(17) |
| 4 Experiments | 上下文/规模、零样本任务、消融 | pp.9–10;图 2,表 2–3 |
| 5 Conclusion | 贡献与应用展望 | p.10 |
| References | 引用文献 | pp.10–16 |
| A Discussion and Related Works | 快权重、TTT、自适应滤波、Delta rule | pp.17–18;式 (18)–(19) |
| B Detailed Derivations and Model Variants | 分块细节、ENC、证明 | pp.18–21;式 (20)–(27),图 3 p.21 |
| C Experiment Details | 架构、训练、记忆与归一化消融 | pp.21–24;图 4–6,表 4–5 |
| C.1 Recall-Intensive Task: Multi-Query Associative Recall | 合成记忆容量实验 | pp.24–25;图 7 |
| C.2 Throughput Comparison | TPU 训练吞吐量 | pp.25–26;图 8 |
| D Implementation | JAX 示意实现、限制与展望 | pp.27–28;Listing 1 |
一:动机——固定容量记忆需要怎样的写入规则?
1.1 从保存 token 到保存可查询的状态
标准因果注意力在时间 $t$ 保存 $\mathcal K_t,\mathcal V_t\in\mathbb R^{d\times t}$,然后用查询从这些历史 token 中读取。忽略投影成本,生成长度 $T$ 的序列需要累计 $O(T^2d)$ 注意力运算;KV 状态随 $T$ 增长(§2,式 (1),pp.2–3)。这是算法级的缓存与计算描述,不应把它等同于所有注意力实现都必须显式存储完整 $T\times T$ 矩阵。
线性注意力将历史压成矩阵,例如
它对固定头维度有固定大小的递归状态,但新写入量 $v_tk_t^\top$ 不查看现有内容。旧信息和新信息可能写入相近方向,导致干扰。滑动窗口则直接丢弃窗口外 token,牺牲远距离可访问性。
Lattice 的选择是:保留固定矩阵状态,但让写入方向依赖已有状态。它借用 KV 矩阵低秩、字典学习和矩阵分解的动机,而没有在每步计算缓存 SVD,也没有给出任意历史缓存都可被无损低秩压缩的定理。
1.2 “记忆压缩”在本文中的准确含义
每个槽是一个 $d$ 维向量,并不一一对应某个旧 token;$m$ 个槽共同构成动态字典。目标是在有限状态中学习有用的表示,使当前与后续查询能读出相关信息。论文是新序列模型的设计与从头训练实验,并未展示把某个现成 Transformer 的 KV cache 原样压缩后保留等价输出的算法。把预训练 Transformer 转成 RNN 是 p.10 的应用展望,未在本文中实验验证。
二:方法——归一化的导数为什么会变成记忆更新?
2.1 符号与输入输出
下表遵循主体公式的列向量约定。作者示例代码将 $S$ 转置存成 $m\times d$,不能直接照抄矩阵乘法方向。
| 符号 | 维度 | 含义 |
|---|---|---|
| $x_t$ | $d_x$ | 当前 token 的层输入 |
| $v_t$ | $d$ | 要存入或重建的目标表示 |
| $k_t,q_t$ | $m$ | 写入系数与读取系数;来自输入投影 |
| $S_t=[s_{1,t},\ldots,s_{m,t}]$ | $d\times m$ | 递归记忆,列对应槽 |
| $\phi_i=s_i/\lVert s_i\rVert$,$\Phi=\phi(S)$ | $d$,$d\times m$ | 归一化槽与字典 |
| $e_t$ | DEC 为 $d$;ENC 为 $m$ | 重建误差,两种模式不能混用 |
| $\gamma_t$ | 标量(主体记法) | 内层步长,实验中输入依赖 |
| $\mu_t$ | 标量 | 显式遗忘/衰减系数 |
| $\beta_t$ | $m$ | 每个槽的状态重归一化系数 |
| $C,T$ | 正整数 | 分块大小、序列长度 |
math_commands.tex 将 \vrep 定义为 $\boldsymbol k$;它不是另一套独立的潜变量。本笔记统一写作 $k_t$。背景里的标准注意力采用 $d$ 维 key/query,但压缩层的 key/query 采用 $m$ 维,这是任务定义的变化。
2.2 内层适应与外层训练
内层把 $S$ 当作快速变化的参数。对每个 token,先评估压缩损失,再做一步
然后读取 $y_t=S_tq_t$(式 (3)–(4),pp.4–5;General Form,p.8)。由于只依赖当前及过去输入,更新是因果的。
外层在语料上优化整个语言模型,包括 $W_k,W_v,W_q$ 和产生内层步长的 $W_\gamma$。外层学到“如何编码、写入和读取”,内层用已经学好的规则为当前序列更新状态。推理时发生的内层更新不需要未来 token 的标签;它也不是对整套语言模型权重重新跑优化器。作者在附录 C 给出 $\gamma_t=\operatorname{sigmoid}(W_\gamma x_t)$(p.22)。
这是优化视角下的设计,而不是“每步求出了全历史最优压缩”。单步在线下降不保证旧样本重建误差不会增大,论文也没有给出这种保证。
2.3 三种压缩目标
为把梯度写得严格且易读,本笔记对平方误差使用 $\tfrac12\lVert \cdot\rVert^2$。作者主体式 (5)、(24) 未写 $1/2$,部分主体梯度省略常数 2,附录 B.3 又保留 2;该常数可以吸收到步长,但复现时必须统一。
| 变体 | 目标 | 被投影向量 $h_t$ | 槽系数 $c_{i,t}$ |
|---|---|---|---|
| Lattice-DEC | $\frac12\lVert \Phi k_t-v_t\rVert^2$ | $e_t=\Phi k_t-v_t$ | $k_{i,t}$ |
| Lattice-DOT / SIM | $-\langle\Phi k_t,v_t\rangle$ | $-v_t$ | $k_{i,t}$ |
| Lattice-ENC | $\frac12\lVert \Phi^\top v_t-k_t\rVert^2$ | $v_t$ | $e_{i,t}=\phi_i^\top v_t-k_{i,t}$ |
来源:式 (5)–(8),p.5;式 (24)–(26),pp.19–20;表 1,p.7。DOT 与 SIM 在不同图表中是相同相似度目标的命名,不是两种额外算法。
DEC 学习“代码怎样解码成 value”;ENC 学习“value 怎样编码成代码”。两者都具有归一化字典,但误差空间不同。DOT 不显式拟合欧氏重建误差,只鼓励目标相似度。DEC 的误差由全部槽共同产生,因而还带有槽间的间接耦合。
2.4 核心推导:把梯度投影到当前槽的正交补
对非零列向量 $s_i$,归一化函数的 Jacobian 为
对于 DEC,链式法则给出
因为 $s_i^\top P(s_i)=0$,梯度与该槽的当前方向正交。推广到三种模式,逐槽更新都可写成
这就是式 (9)、(26) 的 OSR,用逐列形式避免原文向量—张量乘法的转置歧义。$k_{i,t}$ 决定基本写入强度,$P(s_i)$ 决定方向;有效更新还受槽范数、步长、误差和后续归一化影响。因此不能简单说 $k_{i,t}$ 本身已经是状态依赖门。
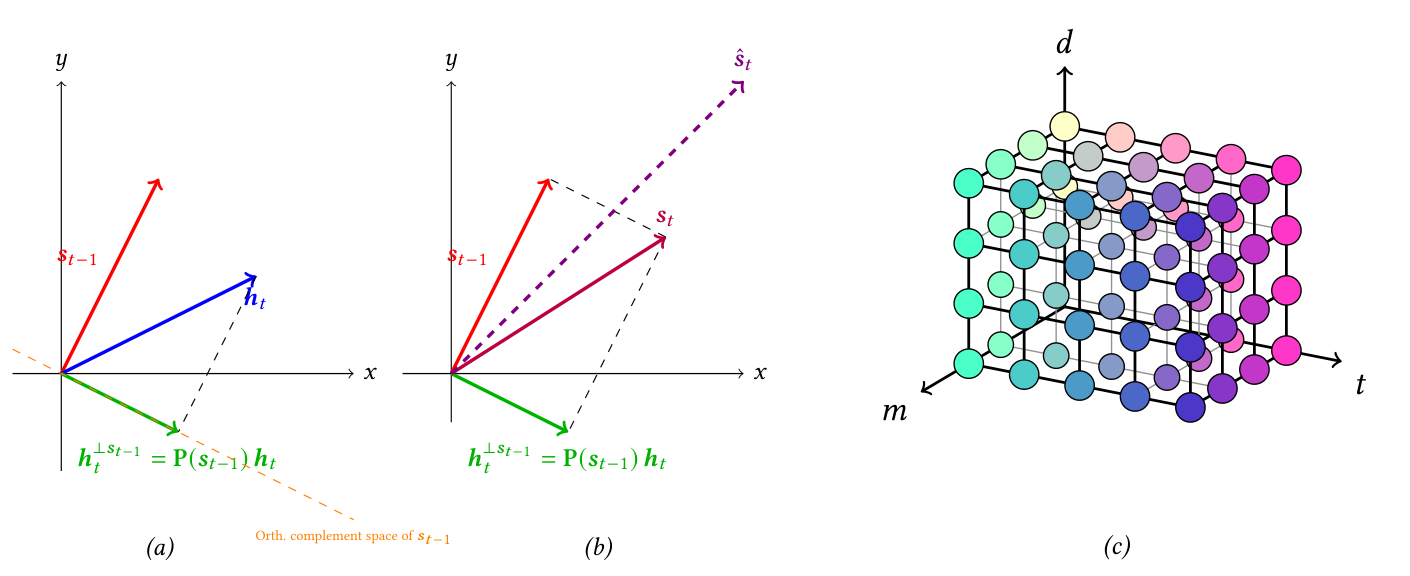
来源:原图 1,PDF p.2,准确裁切。先看 (a):蓝色输入拆成沿红色旧状态与垂直旧状态的成分;再看 (b):实线状态加入垂直成分,虚线表示直接叠加原输入;(c) 的 $d,m,t$ 展示状态矩阵的时间演化,不是需要显式存储整个三维张量的实现要求。图中的正号采用抽象写入强度;损失下降式中的符号已经包含在 $h,c,\gamma$ 中。
教学例子:设单位槽 $s=(1,0)^\top$,DOT 的目标 $v=(2,1)^\top$,$\gamma k=0.5$。普通叠加得到 $(2,0.5)^\top$;OSR 先去掉与旧槽平行的 $(2,0)^\top$,仅加入 $(0,0.5)^\top$,得到 $(1,0.5)^\top$。这是二维解释,不是论文实验数据。
“新信息”的边界:这里只去除了对当前槽平行的几何分量。不同槽之间仍可能重叠,槽内也可能混合多个历史项目;正交并不等价于语义不重复、全局独立或不遗忘。若某项信息只表现为已存方向上的幅值改变,归一化也会限制这种幅值编码。
2.5 两次归一化承担不同工作
第一处归一化 $\phi(S)$ 位于压缩损失内部,决定梯度方向;第二处在状态更新后进行,决定新状态的尺度。不能把它们当作同一次操作。
由于 $s_i\perp\Delta s_i$,没有重归一化时
如果旧状态已经是单位向量、没有显式衰减,式 (10) 写为
上述教学例子的最终状态约为 $(0.8944,0.4472)^\top$。旧方向的系数从 1 降至约 0.8944,说明稳定化本身就带有相对遗忘效果。这也说明“添加的是正交向量”不能推出“归一化后旧记忆读出完全不变”。
命题 3.1(p.6,证明 p.21)将此解释为单位球面上的黎曼梯度步:切空间是与当前状态垂直的子空间,在切空间下降后,以归一化作回缩(retraction)。它不是关于压缩全局最优、历史误差上界或长序列召回率的证明;回缩也不等于精确指数映射。
2.6 显式遗忘与稀疏化
在内层目标中加入 $\lambda_t\lVert S\rVert_F^2/2$,欧氏梯度步产生
作者令 $\mu_t\in[0,1]$(式 (11),p.7);这个范围需要参数化或约束支持,不是任意正步长和正正则系数都自动满足。
加入 $\ell_1$ 惩罚则可使用近端梯度与软阈值:
这是式 (12)–(13) 的变体,本文后续以 L2 衰减为主,没有给出 L1 稀疏状态带来的专门实测收益。
本次推导补充:若把 $\mu$ 衰减与单位球投影合并,正确的精确归一化系数应使用 $(\mu_t^2+\lVert \Delta s_i\rVert^2)^{-1/2}$,而非直接套用 $\mu=1$ 的式 (10)。若每槽始终在单位球上,L2 范数惩罚在约束集合内为常数;“先欧氏衰减、再投影”的作用主要体现在旧状态与新方向的相对比例,不能不加条件地理解为在球面上缩小状态范数。
2.7 高效递推与模型结构
不用构造 $d\times d$ 投影矩阵,因为
只需一次内积和向量缩放。每槽成本为 $O(d)$,每头更新与读取为 $O(dm)$;当 $d,m$ 固定时,序列混合部分的总算术成本为 $O(Tdm)$,递归状态占用 $O(dm)$。这是相对于长度的规模描述,不包含所有投影/MLP 成本,也不表示训练激活只占常量空间。
在单位槽约定下,作者式 (14)(p.8)令
得到
状态依赖体现在 $\hat h_t$、$\beta_t$,DEC 还体现在 $h_t$。这不是标准的固定系数线性递推。
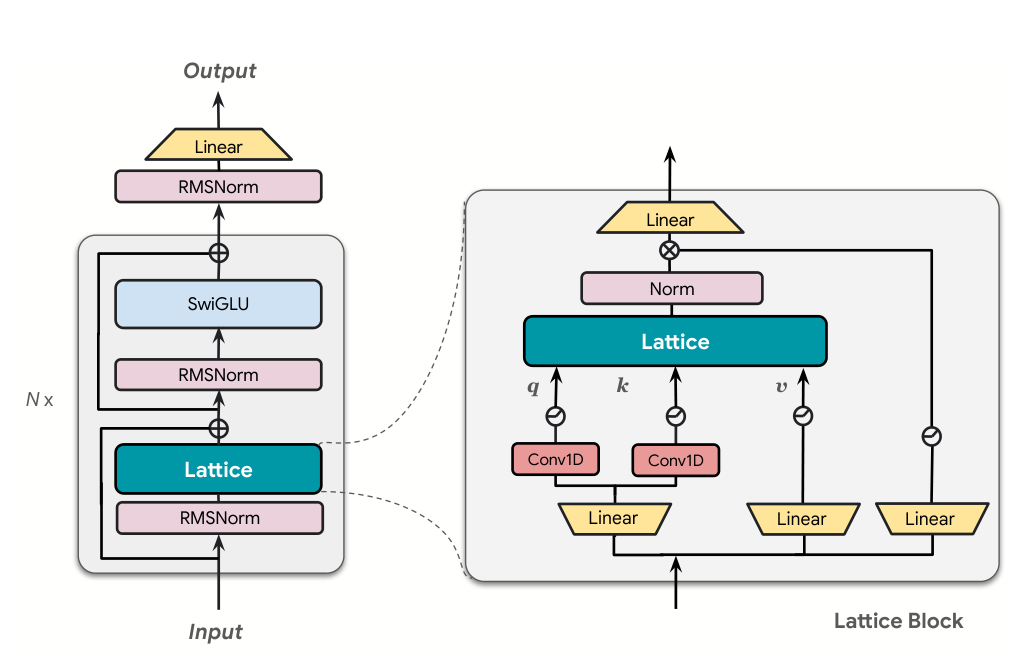
来源:原图 4,PDF p.22,准确裁切。左侧重复堆叠 RMSNorm、Lattice 序列混合与 SwiGLU 模块,并用残差连接;右侧是多头 Lattice 混合模块。附录说明 $q,k$ 共享线性投影并经过宽度为 4 的短卷积,输出带 GeLU 后门控;内层步长也由当前输入产生。论文评测的是这一整体架构,而不是孤立递推式。
2.8 分块并行:把非线性依赖冻结在块首
设 $S_0^b$ 是当前块开始时的状态。在大小为 $C$ 的块内,先用 $S_0^b$ 并行计算近似梯度的状态依赖量。DEC 模式中的误差也应基于块首状态,这一点在 Listing 1 的 H = K @ Phi - V 中很明确。
- 式 (15):冻结梯度中的状态,写入项使用 $S_0^b$,传播项仍作用于 $S_{t-1}$。
- 式 (17):把部分校正并入门控,得到 $S_t=\hat G_t\odot S_{t-1}-h_t\hat k_t^\top$,其中 $\hat G_t=\mathbf1(\mu_t\beta_t+\tilde h_t\odot\hat k_t)^\top$,$\tilde h_t=(S_0^b)^\top h_t$。系数在块内确定后,可借用 GLA 形式的并行运算。
两者在 $C>1$ 时都属于近似,不能把它们当作原非线性逐 token 更新的恒等变形。尤其式 (17) 的方向不再逐步精确正交于即时状态;逐 token 的精确单位范数保证也不能未经检查地搬到近似更新。
作者用累计门控乘积 $a_\tau^b=\prod_{i=1}^{\tau}\beta_i\mu_i$,构造因果下三角张量 $\Omega^b_{j,i,:}=a_j^b/a_i^b\,\mathbb I_{i\le j}$,把式 (15) 展开为块级矩阵乘法(式 (16)、(21),pp.8、19)。其意义是让一个块内的多次更新与读取复用矩阵运算,减少物化中间状态和 I/O。不能仅因写出了 $\Omega\in\mathbb R^{C\times C\times m}$ 就声称必须显式保存它;作者还讨论了分块计算。
块与块之间仍有非线性状态依赖,无法直接用完全线性递推的跨块关联扫描(associative scan)并行化。小 $C$ 更接近原算法,大 $C$ 提升块内并行度,但可能损失质量或稳定性。原文在 p.28 明确将跨块并行限制列为不足。
三:实验——各组设置实际检验什么?
3.1 语言模型与零样本评测
| 实验 | 数据与规模 | 长度/分块 | 指标与问题 |
|---|---|---|---|
| 主语言模型规模实验 | FineWeb-Edu;110M/340M/760M | 训练长度 4k;主任务默认 $C=4$,110M 消融另用 $C=1$ | 困惑度越低越好;参数与算力扩大后是否仍有收益 |
| 上下文长度实验 | Books3;110M | 分别训练于 512、1k、2k、4k、8k、16k;Lattice $C=1$ | 固定模型规模下,各训练长度的困惑度 |
| Pile 补充实验 | The Pile;110M | 2k、8k | 较短上下文与不同语料上的困惑度 |
| 零样本任务 | FineWeb-Edu 预训练的 340M/760M | 4k;表 2 指定例外除外,默认 $C=4$ | 七任务准确率与平均值 |
| 组件/容量消融 | FineWeb-Edu;110M | 默认 $C=1$,另列 $C=4$ 近似 | 哪些组件有效、较小记忆是否可用 |
| 归一化消融 | FineWeb-Edu;110M | $C=4/16$ | 每 token 与只在块边界归一化的差异 |
来源:§4,pp.9–10;附录 C,pp.21–24。主文的“全部实验 batch 为 0.5M tokens”在附录 MQAR 处另有明确配置,因此应理解为语言模型实验设置,不能覆盖 MQAR。
| 参数规模 / 训练 token 数 | 层数 | 模型宽度 | 头维度 | 峰值学习率 |
|---|---|---|---|---|
| 110M / 5B | 12 | 768 | 64 | $10^{-2}$ |
| 340M / 15B | 24 | 1024 | 64 | $1.5\times10^{-3}$ |
| 760M / 30B | 24 | 1536 | 64 | $1.25\times10^{-3}$ |
表 4,p.23。语言模型使用 AdamW、cosine schedule、1k 步 warm-up(约 0.5B tokens)、最终学习率 $3\times10^{-5}$、weight decay 0.1、gradient clipping 1.0;batch 固定 0.5M tokens。原文未充分报告 tokenizer、数据划分细节、重复种子/置信区间以及全套评测命令,不能按领域惯例补齐。
基线的比较角色:Transformer++ 是完整注意力参照;LA 是简单外积记忆;GLA/Mamba2 代表门控线性递推;DeltaNet/Gated-DeltaNet 使用误差校正式记忆;TTT 是内层优化及输出归一化的近邻。不同基线的总体架构、状态参数化和实现不同,表内结果支持所报告配置的比较,不等于控制了每个因素的因果实验。
零样本任务包括 PIQA、HellaSwag、WinoGrande、ARC-easy、ARC-challenge、CommonsenseQA、BoolQ。HellaSwag 和 ARC-challenge 的列为 acc_n(归一化准确率),其余列为 acc;均越高越好。平均值与七列算术平均一致。正文枚举漏掉了 BoolQ,但表 2 确实包括它。表题同时提及 LM,但表中实际只列任务准确率;困惑度要看图 2 等结果。
3.2 MQAR:直接测有限状态下的键值关联保存
给出键值对,再在后续多个位置重复键,预测对应 value。难点是相似查询、长间隔与高密度关联同时挤入有限状态;它是合成召回测试,不等于开放域问答或真实长文推理。
附录 C.1(pp.24–25)设置:训练样本 100,000,验证样本 3,000,词表 8192;两个 block,单头,$d\in\{32,64,128,256,512\}$;Lattice、TTT、DeltaNet、GLA 取 $m=d$,每块状态为 $d^2$,xLSTM 另有 $d$ 维 normalizer。训练 64 epochs,AdamW,cosine schedule,10% warm-up,weight decay 0.1。
| 长度 | KV 对数 | batch(样本数) | 扫描的学习率 |
|---|---|---|---|
| 1024 | 48、96、256 | 96 | 0.01、0.00316、0.001、0.000316、0.0001 |
| 2048 | 48、96、256 | 24 | 0.01、0.001、0.00022、0.00005、0.00001 |
作者训练 Lattice、TTT、DeltaNet、GatedDeltaNet 和 GLA;Transformer、Mamba、RWKV-5/6、xLSTM 两种配置的结果取自 xLSTM 论文(图 7 图注)。因此有跨论文结果借用的可比性限制。该小节未明确给出所有模型的 chunk 设置,也未提供多种子方差。
3.3 系统实验
图 8(p.26)测试 110M 参数模型在 $2\times2$ TPU Trillium 上的训练吞吐量,单位是千 token/s。Transformer++ 使用 FlashAttention-2,block size 256;TTT、Lattice 是纯 JAX 实现,图的两面板分别使用 $C=64$ 与 $C=16$。正文 p.25 只笼统写其余模型 $C=64$,以图 8 的两个面板配置为准。这不是单 token 解码延迟、GPU 性能或峰值显存的测试。
四:结果——哪些结论得到数据支持?
4.1 上下文与模型规模:优势存在,但并非长度越长越单调变好
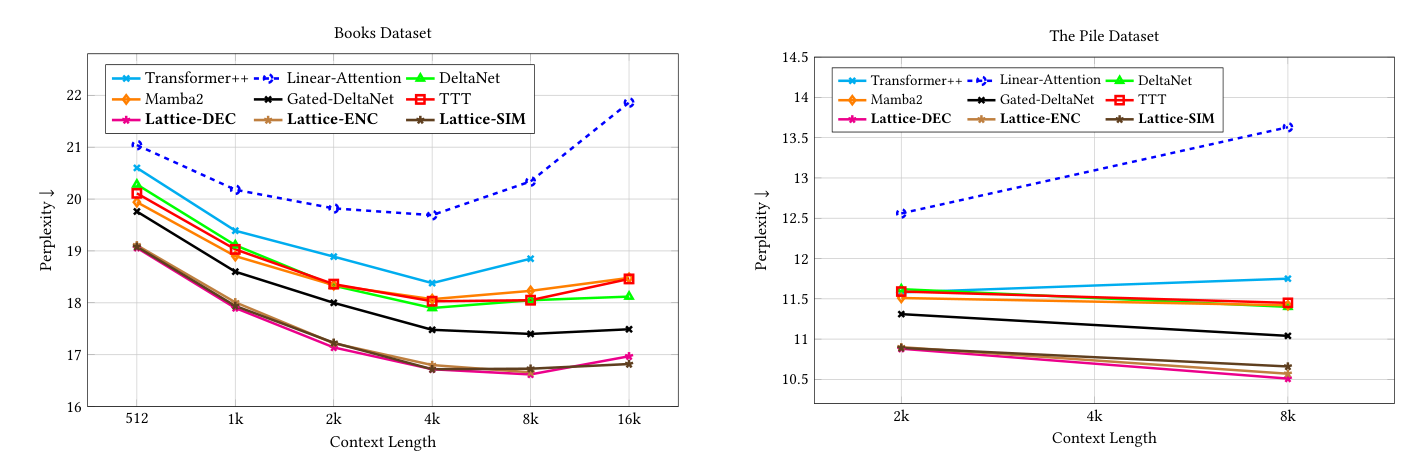
来源:原图 5,PDF p.23。横轴为训练上下文长度,对数刻度;纵轴为困惑度,越低越好。左图 Books 有六种长度,右图 Pile 只有 2k、8k 两个实测位置,连接线不代表测试了中间所有长度。Books 图也出现在主文图 2 左侧。
以下精确数值来自作者 books_plot.tex / pile_plot.tex 中实际绘图坐标,并与 PDF 曲线核对:
| 数据/长度 | Transformer++ | TTT | Gated-DeltaNet | Lattice-DEC | Lattice-DOT/SIM |
|---|---|---|---|---|---|
| Books 512 | 20.60 | 20.11 | 19.76 | 19.06 | 19.08 |
| Books 2k | 18.89 | 18.36 | 18.00 | 17.14 | 17.23 |
| Books 4k | 18.38 | 18.03 | 17.48 | 16.72 | 16.72 |
| Books 8k | 18.85 | 18.05 | 17.40 | 16.62 | 16.73 |
| Books 16k | 未报告 | 18.46 | 17.49 | 16.97 | 16.82 |
| Pile 2k | 11.58 | 11.59 | 11.31 | 10.88 | 10.89 |
| Pile 8k | 11.75 | 11.45 | 11.04 | 10.51 | 10.66 |
在 Books 8k,DEC 比 Gated-DeltaNet 低 0.78 ppl,约相对下降 4.48%;16k 时 DOT 的优势为 0.67 ppl,约 3.83%。这说明相对于强基线的优势并没有随长度严格单调扩大。DEC 从 8k 的 16.62 回升到 16k 的 16.97,DOT 也从 16.73 回升至 16.82。作者对其他较弱 RNN 的差距扩大会更明显,但不应推广为所有基线都单调如此。
Transformer++ 在 16k 没有点;作者将其解释为长上下文从头预训练表现不佳,并只报告到 8k。不能据此写出 Lattice 在 16k 对 Transformer 的精确改进。各长度单独训练的实验也不是“短长度训练后外推到 16k”的测试。
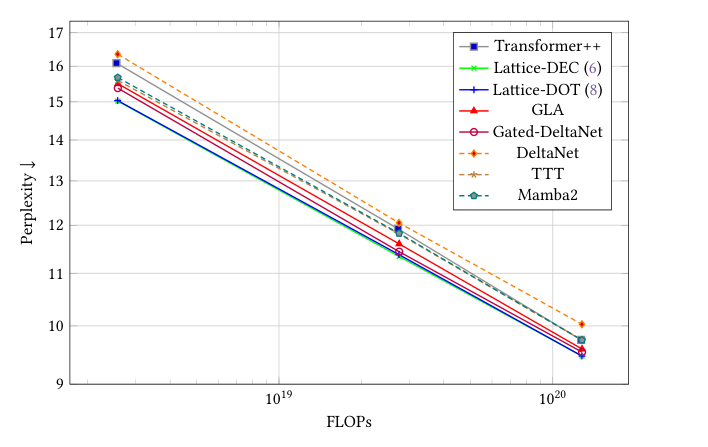
来源:原图 2 右面板,PDF p.9。图注谈模型规模,实际横轴是 FLOPs,两个轴都采用对数刻度。三个点对应规模递增、训练 token 数也增加的配置,而不是保持数据量不变只增参数。
| 方法 | 110M / 5B | 340M / 15B | 760M / 30B |
|---|---|---|---|
| Transformer++ | 16.09 | 11.92 | 9.75 |
| Gated-DeltaNet | 15.378 | 11.438 | 9.5378 |
| TTT | 15.596 | 11.81 | 9.7468 |
| Lattice-DEC | 15.021 | 11.339 | 9.47 |
| Lattice-DOT | 15.033 | 11.377 | 9.47 |
数值来自 Scalling_pattern.tex 的原图坐标,不是读图估计。各模型 FLOPs 略不同,例如最大规模 Transformer++ 为约 $1.2694\times10^{20}$,DEC 为约 $1.2791\times10^{20}$。结果支持所测三档规模下更低 ppl;最大档 DEC 对 Gated-DeltaNet 的差仅 0.0678 ppl,不能据此宣称已建立普遍 scaling law。110M 的精确块配置与其他质量实验的细粒度对应没有全部在图注明示,应结合附录 $C=1$ 消融与 $C=4$ 主任务说明阅读。
4.2 零样本任务:最优平均分,而非逐项全胜
| 方法 | 340M / 15B:平均准确率 % | 760M / 30B:平均准确率 % |
|---|---|---|
| Transformer++ | 46.93 | 51.94 |
| GLA | 48.68 | 52.57 |
| Mamba2 | 48.39 | 52.25 |
| DeltaNet | 48.05 | 51.34 |
| TTT | 47.88 | 52.42 |
| Gated-DeltaNet | 48.60 | 52.64 |
| Lattice-DEC,$C=1$ | 49.05 | 未单列 |
| Lattice-DEC,$C=4$ | 49.14 | 53.54 |
| Lattice-DOT,$C=4$ | 48.66 | 54.03 |
来源:表 2,p.10;760M 的 $C=4$ 取自附录默认配置。340M DEC $C=4$ 比最强基线 GLA 高 0.46 个百分点,比 Transformer++ 高 2.21 个百分点;760M DOT 比 Gated-DeltaNet 高 1.39 个百分点,比 Transformer++ 高 2.09 个百分点。相对百分比与百分点不能混用。
若看单项,760M DOT 的 ARC-c 为 36.57,Gated-DeltaNet 为 34.08,提升 2.49 个百分点;但 ARC-e 为 59.49,低于 Gated-DeltaNet 的 61.06。BoolQ 上 Transformer++ 的 62.11 也高于 DOT 的 60.73。340M DOT 的平均分略低于 GLA。结论应是 Lattice 最佳变体获得最优平均分,而非每种 Lattice 配置、每个任务都领先。论文未报告置信区间,不能把所有小差值称为统计显著。
4.3 组件消融:主要收益来自正交方向与归一化
表 3,p.10;110M、FineWeb-Edu、默认 $m=d=64$,ppl 越低越好。
| 配置 | ppl | 相邻步骤变化 |
|---|---|---|
| DeltaNet | 16.35 | 起点 |
| 加入正交递推,$C=1$ | 15.38 | −0.97 |
| 再加入状态归一化投影 | 15.07 | −0.31 |
| 再加入显式 forget gate,完整 Lattice | 15.02 | −0.05 |
| TTT,$C=1$ | 15.60 | 独立对照,不是累加链中的一步 |
| 完整 Lattice,$C=4$,式 (15) | 15.15 | 相比 $C=1$ 为 +0.13 |
| 完整 Lattice,$C=4$,式 (17) | 15.12 | 相比 $C=1$ 为 +0.10 |
原表说明每个 + 行是在上一配置上继续添加。它显示在该顺序下,正交机制和状态归一化贡献较大,显式遗忘的额外收益较小;它不是所有组件独立移除的完整析因实验。正文 p.9 提到正交更新时指向式 (8),但表 3 累加行具体引用式 (6),即 DEC 推导;不能据正文引文把此表全部当作 DOT 消融。
4.4 记忆槽数:四分之一状态的含义
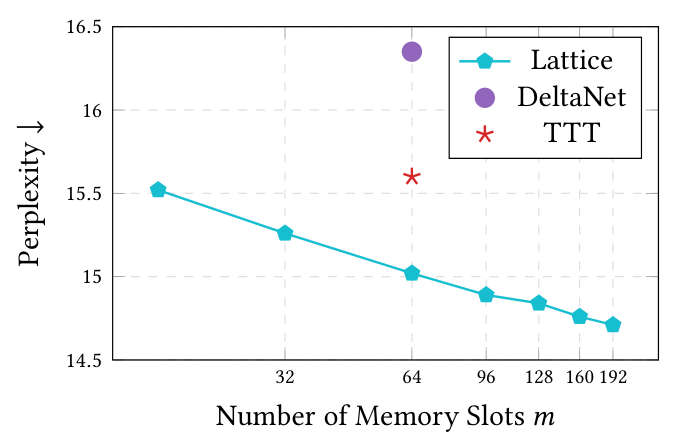
来源:原图 6,PDF p.23。横轴为 $m$ 的对数刻度,纵轴为 ppl;两个基线只有 $m=64$ 的点,不能推断它们缩小或扩大状态后的完整曲线。
| $m$ | 16 | 32 | 64 | 96 | 128 | 160 | 192 |
|---|---|---|---|---|---|---|---|
| Lattice ppl | 15.52 | 15.26 | 15.02 | 14.89 | 14.84 | 14.76 | 14.71 |
原始值见 ablation_m.tex;表 3 也列出大部分点。对于同一个 $d=64$ 的头,$64\times16=1024$ 个状态元素相对于 $64\times64=4096$ 是四分之一,且 15.52 略低于 TTT 的 15.60。作者称其为 $4\times$ compression gain,准确对象是这组实验中的递归矩阵状态。模型权重、卷积状态、激活、训练优化器状态与速度不能直接按四倍推断。
增大 $m$ 也改变 $W_q,W_k$ 的参数量,作者在 p.23 明说了这个代价。因此这些点并非全部严格等参数。图注写“半数容量也领先”,正文更强的四分之一说法与 $m=16$ 点一致,两者并不矛盾。
4.5 归一化与分块:近似成本开始显现
表 5,p.24,使用式 (15) 的分块近似:
| 分块大小 | 每 token 归一化 | 仅块边界归一化 | 后者增加的 ppl |
|---|---|---|---|
| $C=4$ | 15.15 | 15.17 | 0.02 |
| $C=16$ | 15.32 | 15.36 | 0.04 |
归一化位置的差异不大,但扩大 $C$ 本身也降低质量;每 token 归一化从 15.15 变为 15.32。作者另外报告 式 (17)、$C=16$、仅块边界归一化训练不稳定,这不是说表中式 (15) 的 15.36 那一项发散,也不是说所有 $C=16$ 都无法训练。
4.6 MQAR:高密度、有限宽度下优势明显
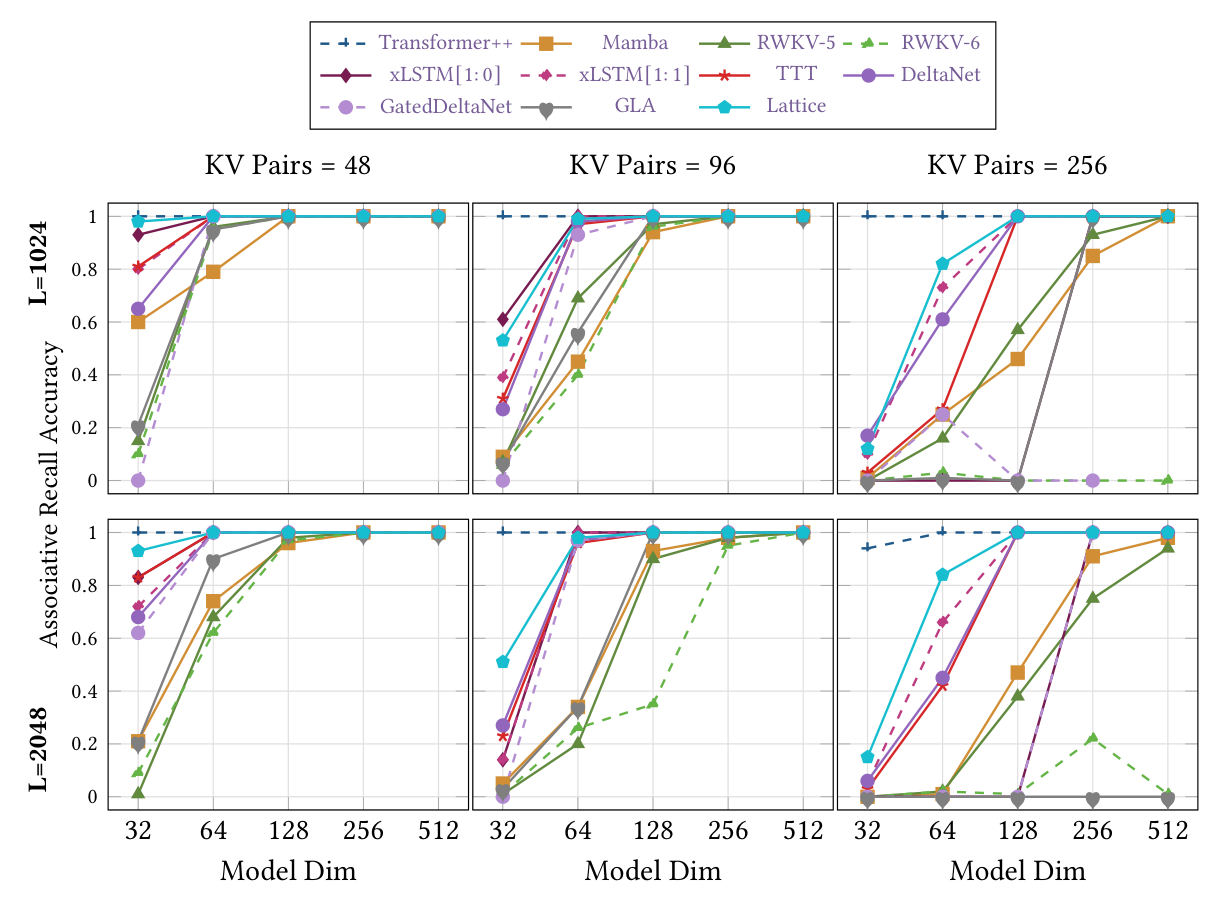
来源:原图 7,PDF p.25。行对应长度 1024 / 2048,列对应 48 / 96 / 256 个 KV 对;横轴是模型维度 $d$,纵轴实际绘成 0–1 的比例,图注却标 %。下面将比例乘 100 后统一为百分比,不能把原图 0.84 读成 0.84%。
从 MQAR_large.tex 中抽取难度较高的 $N_{KV}=256,d=m=64$:
| 方法 | $L=1024$:准确率 % | $L=2048$:准确率 % |
|---|---|---|
| Transformer++(外部论文结果) | 100 | 100 |
| xLSTM[1:1](外部论文结果) | 73 | 66 |
| TTT | 27 | 42 |
| DeltaNet | 61 | 45 |
| GatedDeltaNet | 25 | 0 |
| GLA | 1 | 0 |
| Lattice | 82 | 84 |
在 $L=2048$ 时 Lattice 比 TTT 高 42 个百分点,比 DeltaNet 高 39 个百分点;对这两个近邻模型是很强的固定状态召回证据。$d=128$ 时上述 Lattice、TTT、DeltaNet 都达到 100%,优势集中在容量紧张区间。
限制同样清楚:Transformer++ 在这些代表点仍为 100%;Lattice 并非所有维度最好,例如 $L=1024,N_{KV}=96,d=32$ 时其 53% 低于 xLSTM[1:0] 的 61%,$L=1024,N_{KV}=256,d=32$ 时其 12% 低于 DeltaNet 的 17%。低值或零值表示该训练设置下未学会,不能解释成架构原则上不具备能力。作者“更长上下文仍保持准确率”的表述是趋势总结,不是所有配置严格不降;例如 48 对、$d=32$ 时 Lattice 从 98% 降到 93%。
4.7 吞吐量:长序列胜过注意力,但仍慢于 TTT
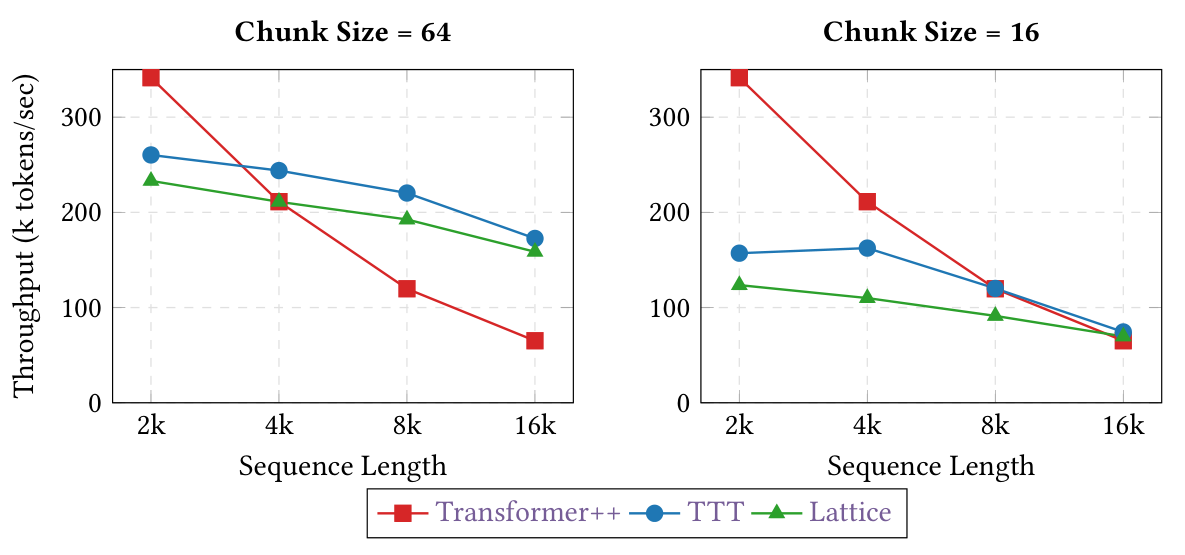
来源:原图 8,PDF p.26。横轴为序列长度,纵轴为千 token/s,越高越好;左 $C=64$、右 $C=16$,共享图例。Transformer 的曲线在两个面板相同,分块设置针对递归方法。
| 配置 | 2k | 4k | 8k | 16k |
|---|---|---|---|---|
| Transformer++ | 341.462 | 211.193 | 119.754 | 65.136 |
| TTT,$C=64$ | 260.307 | 243.906 | 220.304 | 172.597 |
| Lattice,$C=64$ | 233.099 | 211.111 | 192.537 | 158.582 |
| TTT,$C=16$ | 157.113 | 162.459 | 120.084 | 74.394 |
| Lattice,$C=16$ | 123.583 | 109.989 | 91.262 | 69.707 |
单位均为千 token/s;精确值来自 throughput_rbtl.tex。$C=64$、16k 时,Lattice 约是 Transformer++ 的 2.43 倍,但比 TTT 低约 8.12%。2k 时 Transformer++ 更快,4k 时与 Lattice 几乎相同。$C=16$ 时 Lattice 到 16k 才略高于 Transformer++,约 1.07 倍。
尤其不能将 $C=1$ 的最佳长上下文质量、$C=4$ 的主任务分数和 $C=64$ 的速度拼成一个已经验证的工作点。原文没有为所有这些配置给出同一组完整的质量—吞吐量曲线。
五:结论、限制与复现时应澄清的事项
5.1 可靠贡献
- 一个清楚的设计原则:在在线压缩目标内部归一化记忆槽,使梯度自然沿单槽的切空间更新,给状态感知写入提供具体构造。
- 一个可实现的代数形式:不物化投影 Jacobian,每 token 的状态运算为 $O(dm)$,并用分块近似转换为矩阵运算。
- 一组有条件的实证收益:所测语料上的困惑度、最佳变体的平均零样本准确率,以及容量紧张的 MQAR 设置均有优势;在一组 110M 实验中,用四分之一状态大小达到略优于 TTT 的 ppl。
这篇论文更适合被理解为“如何设计更有效的固定状态写入”,而不是任意长度历史的无损缓存方案。
5.2 理论与经验的界限
低秩是动机,球面回缩是几何解释,二者都没有推出任意序列的压缩误差或容量保证。逐槽正交没有让所有槽互相正交,也不保证读出保持不变。实验最大主模型为 760M,最长 Books 设置为 16k;没有百万 token、超大模型、多模态、实测部署显存或解码延迟的证据。跨块不能做全线性关联扫描,作者也承认每步有额外投影开销。
有限的种子与协议报告使小差值的稳健性难判断;MQAR 含外部结果,架构和实现比较也非完全同构。后续最有价值的实验是固定数据、参数与实现,联合扫描 $m,C$,同时报告 ppl、召回、训练速度、解码速度与总状态占用,而不只分别展示最好的一端。
5.3 原文推导与示例实现中的具体不一致
下面是本次独立核查,不是作者承认的勘误,也不能由此断言论文训练结果无效。作者提供的是简化 Listing,实际训练代码的对应实现未由本文证明。
(1)平方误差的常数 2。 主体式 (5)–(6)、附录式 (24)–(25) 写平方范数但梯度省略 2;B.3 的推导与式 (27) 又保留 2(pp.20–21)。采用半平方损失或重定义 $\gamma$ 可统一。本笔记已明确采用前者。
(2)分块更新平方范数的交叉项。 p.19 “Computing $\beta$”及式 (23) 用两个正项相加表达投影更新的平方范数。对单位槽,令 $a=s^\top h$,则
因此在一致符号下应是减去平行分量的平方,而不是相加。Listing 1 的第 89–91 行(p.28)实际上使用 Delta1_sq - Delta2_sq,与上述推导相符。原文在 $\hat k$ 是否已包含 $\gamma,\beta$ 的复用上也应厘清,避免计算 $\beta$ 时产生循环定义。
(3)分块代码的归一化分母。 compress_step 的 beta 使用 $\lVert \mu S\rVert^2+\lVert \eta\Delta\rVert^2$,但 compress_chunk 第 93 行写成 eta**2 * s_norm.T**2 + Delta_sq,同时第 95 行保留 mu。若目标是保持旧范数且投影增量正交,分母中旧状态部分应涉及 $\mu^2\lVert s\rVert^2$。这一行可能是示例代码笔误,需要作者或完整实现确认,不能静默将修正后的算法当作作者报告的实现。
(4)可执行性和边界。 Listing 调用 GLA_intra_chunk,但未提供其定义;虽然给出了 $S_0$ 参数,未完整说明其初始化策略。理想归一化导数要求 $s\ne0$,代码用 +1e-6 稳定分母,但这也让严格正交等式成为数值近似。分块式 (17) 是否严格保持范数更需要单独核对。不能将 Listing 描述成可直接运行的完整训练工程。
(5)分块索引排版。 p.8 / 附录 B.1 给出的 $t'=t-\operatorname{mod}(t,C)$ 在本文从 1 开始计 token 的写法下,整除位置会指向当前时刻;写出的块切片端点 $b(C+1)$ 也与长度 $C$ 的常规分块不一致。教学上应明确采用块 $b$ 的 token 为 $bC+1,\ldots,(b+1)C$,块首历史状态为 $S_{bC}$。Listing 的 reshape/scan 表达的是按长度 $C$ 划分。这是索引核查,不是新增实验结论。
本次用独立的标准库脚本检查了 DEC 半平方损失的有限差分梯度、投影正交性、范数恒等式和代表结果差值,详见 核查脚本(本地核验附件) 与 数值记录(本地核验附件)。梯度最大绝对差约 $2.3\times10^{-11}$。例如 $s=(0.6,0.8)$、$h=(2,-1)$ 时,正确投影范数平方为 4.84,正项相加得到 5.16;使用 $\eta=0.2,\mu=0.8,k=0.7$ 的同一槽示例,正确归一化后范数为 1,而 Listing 分母对应约 2.334。这些是公式检查,未验证论文的训练分数。
5.4 适合组会讨论的三个问题
- 当“重要的新信息”与已存槽方向接近平行时,仅依据几何正交性过滤是否会丢失有用的强度或重复统计?
- 同时匹配状态大小、投影参数数目、数据和内核实现后,Lattice 相对 TTT / Gated-DeltaNet 的优势有多少来自正交更新本身?
- 在满足同一质量目标的前提下,允许的最大 $C$ 是多少?其跨块串行成本与真实推理解码收益如何权衡?
材料与复核说明
正文与附录事实以本地 v2 PDF 和同版本作者 TeX 为依据;图件均为看过原页后裁切,未用生成式图像替代结果。数值从作者实际引用的表格或 PGFPlots 数据中转录,不从曲线目测补精度。完整裁切页码与 PDF 坐标见 图件清单。源码下载成功,无全文获取限制。
英文幻灯片以本 skill 的 Beamer 模板重新编写,使用本地 pdflatex,编译命令为 python3 build_slides.py slides.en.tex;必要时可加 --pdflatex /mnt/geogpt-doc-new/docparser/hyc/textlive/2026/bin/x86_64-linux/pdflatex。交付核验记录见 quality-checks.md。分享 Markdown 时请连同 figures/;分享幻灯片 PDF 可直接使用单文件。