SpargeAttention:中文精读笔记
论文:SpargeAttention: Accurate and Training-free Sparse Attention Accelerating Any Model Inference
作者:Jintao Zhang、Chendong Xiang、Haofeng Huang、Jia Wei、Haocheng Xi、Jun Zhu、Jianfei Chen。前三位共同一作。
版本:arXiv:2502.18137v8,2025-11-19 修订;本次获取与研读日期:2026-09-18。ICML 2025。
材料:本地原文 PDF、同版本作者 main.tex 及实际引用的六份章节/附录 TeX、原始图件。PDF 共 18 页;本文页码均从 PDF 第 1 页起计。已覆盖正文全部章节、附录 A.1–A.4 及主要图表;参考文献用于定位,没有逐篇阅读被引论文。未运行作者代码或复现实验。
论文总览
SpargeAttn 的核心是:只有块内 token 足够相似,才信任其均值代表;先据此跳过整块注意力计算,再利用在线 softmax 的最大值差跳过很小的 PV 贡献。 它在 SageAttention 的量化内核上实现,并用 Hilbert 曲线改善视觉 token 的局部性。
最有说服力的贡献是把保护异常块的策略和硬件可执行的块稀疏结合起来,在语言、图像、视频模型上给出质量与速度证据。标题中的 “Any Model” 是通用性目标,不是对任意输入、模型或硬件的数学保证。免训练不等于免校准;“无质量损失”也不等于所有指标完全不变。
表 2 的 Mochi/L40 端到端时间为 1897 → 1037 秒,约 1.83 倍;相对 SageAttn 的 1544 秒则约 1.49 倍。表 1 的 Llama3.1 128K 注意力速度比约 4.51 倍,不能当作整模型加速比。
结构地图
| 原文章节 | 作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 通用性与预测成本两难 | pp.1–2,图 1–2 |
| 2 Related Work | 固定模式、动态稀疏、训练式稀疏 | p.2 |
| 3.1 Sparse FlashAttention | 在线归一化与两个 mask | p.3,式 (1)–(3) |
| 3.2 Selective Token Compression for Sparse Prediction | 相似性判断、压缩、TopCdf | pp.3–5,图 3、算法 1、式 (4)–(5) |
| 3.3 Masking of the First Stage | 跳过 QK 与 PV | p.5,式 (6) |
| 3.4 Sparse Warp Online Softmax | warp 级 PV 筛选 | p.5 |
| 3.5 Combined with SageAttention | 量化与 CUDA 实现 | p.5 |
| 3.6 Hyper-parameters Determination for Model Layer | 五个输入上的阈值搜索 | pp.5–6 |
| 3.7 HilbertCurve Permutation | 视觉 token 重排 | p.6,图 5 |
| 4.1 Setup | 模型、数据、指标、基线 | pp.6–7 |
| 4.2 Quality and Efficiency Evaluation | 跨任务质量及内核速度 | pp.7–9,表 1、图 6–10 |
| 4.3 Ablation Study and key Insights | 成本、机制、稀疏性分析 | pp.7–9,表 2–7 |
| 5 Conclusion | 作者总结 | p.9 |
| A.1–A.2 | 重排细节与异常块消融 | pp.14–15,表 8–10 |
| A.3 Additional Experiments | 中长上下文与生成示例 | pp.15–16,表 11、图 11–13 |
| A.4 Sparsity analysis over diffusion model | 层、头、步数、样本的变化 | pp.17–18,图 14–17 |
一:动机
标准注意力先计算 $S=QK^\top/\sqrt d$,再计算 $P=\operatorname{softmax}(S)$ 和 $O=PV$。长度为 $N$ 时,两个主要矩阵乘法随 $N^2$ 增长。FlashAttention 减少访存,却仍需计算完整注意力;稀疏化则试图减少乘法本身。
困难在于:精确知道哪些注意力很小,往往要先算出它们。固定滑动窗口或 attention sink 的先验又不一定适合扩散模型。均值压缩虽然便宜,却会抹掉块内少数关键 token。作者的设计把“能否可靠压缩”作为前置判断:不可靠的块保留全算,可靠的块才参与筛选。这是方法区别于简单池化预测的关键(Sec.1–3.2,pp.1–5)。
二:方法
2.1 输入、状态与两个掩码
| 符号 | 含义/维度 |
|---|---|
| $Q,K,V$ | 单头输入,均为 $N\times d$ |
| $b_q,b_k$ | query/key 的块大小 |
| $Q_i,K_j,V_j$ | 分块输入;对应块分数为 $b_q\times b_k$ |
| $M_g$ | 整块筛选掩码,大小 $\lceil N/b_q\rceil\times\lceil N/b_k\rceil$ |
| $M_{pv}$ | PV 筛选概念掩码;实现细化到 query warp |
| $m_{ij},l_{ij}$ | 已扫描 key 块的逐行最大值与归一化累加量 |
| $\tau,\theta,\lambda$ | 累积质量阈值、块相似性阈值、负的最大值差阈值 |
在线 softmax 维护:
这里 $O_{ij}$ 是尚未最终归一化的累加状态,最终输出为 $\operatorname{diag}(l_{i,T_n})^{-1}O_{i,T_n}$。初始化 $m=-\infty,l=0,O=0$。第一阶段 $M_g=0$ 时跳过 QK 和 PV;第二阶段只跳过 PV,QK、softmax 和归一化量更新已发生(Sec.3.1、算法 1,pp.3–4)。
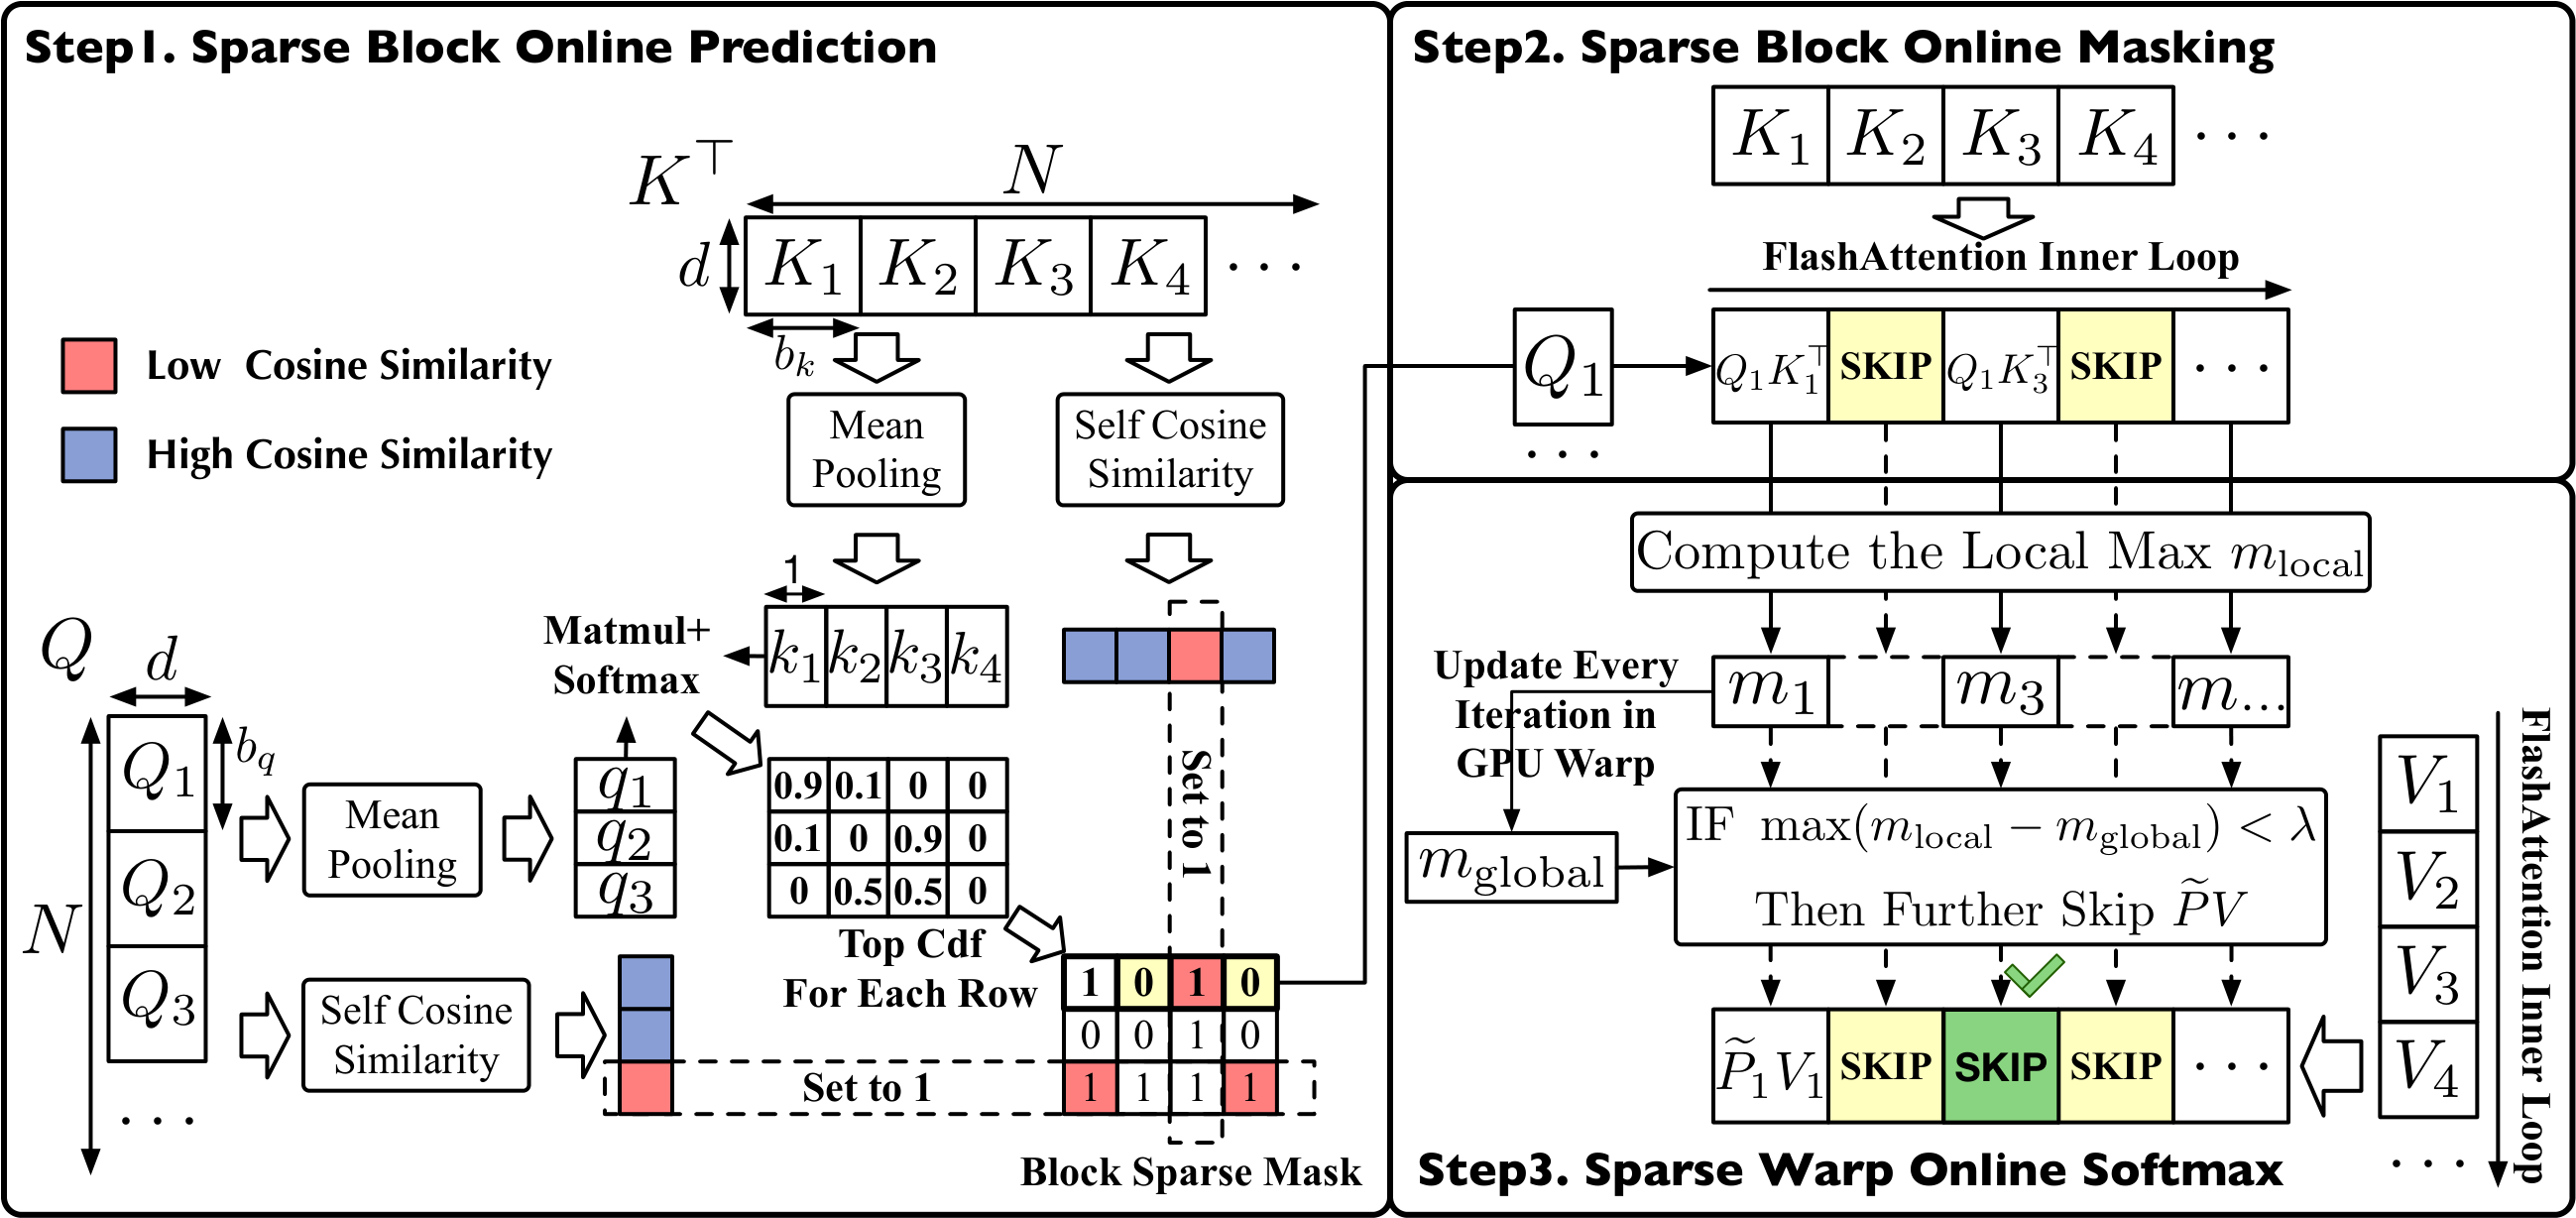
原图 3,PDF p.4,复用作者原始矢量图转为 PNG。按左上预测、右上整块跳过、右下 warp 级 PV 跳过阅读。红色表示低相似性块,必须保留对应 mask 行或列;黄色/绿色 SKIP 表示两种不同粒度的跳过。
2.2 第一阶段:选择性 token 压缩
先取 $q_i=\operatorname{mean}(Q_i,\mathrm{axis}=0)$、$k_j=\operatorname{mean}(K_j,\mathrm{axis}=0)$,并计算块内相似性。只对高相似性块信任这种代表。压缩注意力 $\hat P$ 的矩阵规模降为块数的平方。
原文写为 $\hat S=qk^\top$,对低相似性的 key 列先置 $-\infty$,再执行 softmax;然后逐行按降序累积选择主要概率位置。最后强制:
低相似性 key 先退出压缩 softmax 的竞争,但在真实注意力中仍全算。低相似性 query 整行全算。这保护了容易被均值掩盖的重要贡献(Sec.3.2,pp.3–5)。
原文与实现之间需核实的三点:
- 原文称块指标为 cosine similarity,却给出 $\mathrm{CosSim}(X)=\operatorname{mean}(XX^\top/|\max(XX^\top)|)$(p.4)。这不是通常逐对除以向量范数的余弦相似度;笔记保留原式,不擅自纠正为标准余弦公式。
- 文字说累计质量“达到” $\tau$,但 p.5 的 TopCdf 伪代码采用
cumsum <= tau * sum,不保留跨越阈值的那个元素。教学例子:概率[0.6,0.3,0.1]、$\tau=0.8$,该代码仅保留 0.6;“至少达到 0.8”的解释应保留前两个。若最大项已经超过阈值,代码甚至可能全不选。论文没有在此给出边界保护,复现时应核对公开实现。 - 正式注意力有 $1/\sqrt d$,压缩打分公式和算法部分省略了缩放的显式书写;不能仅根据排版断言实际内核漏掉缩放。所有 key 都退出压缩 softmax 等边界也需检查实际代码。
2.3 第二阶段:最大值差决定 PV 是否值得计算
令 $m_\mathrm{local}=\operatorname{rowmax}(S_{ij})$。对 warp 管理的 query 行集合 $I_w$,若
则当前 warp 内所有未归一化权重都小于 $e^\lambda$,跳过 $\widetilde P_{ij}[I_w]V_j$。此时新块没有抬高这些行的最大值,旧输出状态的缩放因子为 1。判断利用已有 rowmax,避免另做完整的概率扫描(Sec.3.4,p.5)。算法 1 使用 > lambda 才计算,正文用 < lambda 才跳过,恰好等于阈值的边界写法不同。
教学解释:若最大值差为 -10,最大未归一化权重约为 $4.54\times10^{-5}$。这说明单项小,却还不是严格的输出误差保证:被舍弃项的数量和 $V$ 的幅度也重要。论文没有给出覆盖任意 $V$ 的全局误差定理。它保留分母贡献但省略部分分子贡献,因此也不同于第一阶段将整块从 softmax 中移除。
2.4 量化与校准
算法 1 接收 FP16 的 Q/K/V,QK 路径采用 SageAttention 的逐块量化和反量化比例。论文核心实验基于 SageAttention;不能把结果解释成纯稀疏算法对同精度内核的收益,也不能理解为整个模型都变为 INT8。p.1 脚注提到基于 SageAttention2 的更新实现及额外约 30% 加速;这不是把所有实验表重新测了一遍。
Sec.3.6 在五个不同模型输入上逐 attention 层搜索参数:先选 $\tau,\theta$,在相对 L1 小于 $l_1$ 时尽量增加稀疏度;再搜索 $\lambda$,使总误差小于 $l_2$。
$$L1=\frac{\sum|O-O'|}{\sum|O|}.$$| 模型 | $l_1$ | $l_2$ |
|---|---|---|
| Llama3.1 | 0.08 | 0.09 |
| CogVideoX、Mochi | 0.05 | 0.06 |
| Flux、Stable Diffusion 3.5 | 0.07 | 0.08 |
| Open-Sora-Plan | 0.03 | 0.035 |
来源:Sec.4.1,p.6。这些是校准的 attention 输出误差阈值,不是最终任务质量下降上限。论文未完整报告参数网格、校准耗时和样本选择敏感性。Sec.3.6 描述逐层搜索,Sec.4.3 又主张层与头的差异需要不同参数;完整 head-wise 配置未列出。
2.5 Hilbert 曲线重排
视觉 token 具有 $T\times H\times W$ 空间结构。Hilbert 曲线使连续块更可能包含空间邻居,提高相似性,让更少块被迫全算。附录 A.1 明确:位置编码之后重排 Q/K/V,输出做逆置换;多模态联合注意力只重排视觉 token。消融使用 query 块 128、key 块 64,以 FlashAttention2 输出为精度参照(pp.14–15)。
严格说 attention 对一致重排是等变的,逆重排后恢复原序。本次分析:若存在 causal mask 或位置相关 bias,也必须保持其对应关系,不能把这项视觉重排直接套到任意因果序列。高相似性不是必然成立的假设;不满足时算法会退回更多全算,因此安全性与加速收益之间仍有取舍。
三:实验设计与指标
3.1 对象与比较角色
- 语言:Llama3.1-8B,WikiText、LongBench、InfiniteBench 的 En.MC、Needle-in-a-Haystack(NIAH)。Table 1 的速度/稀疏度来自 128K NIAH,不能认为所有语言指标都在同一 128K 协议下测得。
- 图像:Flux.1-dev、Stable Diffusion 3.5 large,COCO annotations。
- 视频:CogVideoX-2B、Mochi、Open-Sora-Plan,open-sora prompt set。
- Full-Attention 是质量基准;MInference 的 block-sparse 版本与 FlexPrefill 是动态稀疏对照;SageAttn 是端到端延迟表中的量化对照。不同方法的实际稀疏度并非完全匹配,应联合观察速度、质量和稀疏度。
原文 Sec.4.1 写 MInference 使用 30% 和 70%,表 1 大部分行实际标 0.3 和 0.5。此处引用表中标签,不将二者默认为同一配置。缺少足够信息确认该差异原因。
3.2 指标口径
| 指标 | 解释与方向 |
|---|---|
| WikiText PPL | 语言预测困惑度,低好 |
| LongBench / InfiniteBench / NIAH | 长上下文任务分数/选择题表现/检索准确性,高好;保持原表尺度 |
| CLIPSIM、CLIP-T | 视频的语义匹配与帧间一致性相关 CLIP 指标,原表均高好;正文将二者合写为对齐指标,未展开计算公式 |
| VQA-a、VQA-t | 视频美学与技术质量,高好 |
| FScore | 论文采用的视频时间一致性相关 flow 指标,按原表高好 |
| FID / CLIP / IR | 图像分布距离低好、文本图像匹配高好、人类偏好代理高好 |
| Speed | 正文定义为固定的 dense 运算量除以实测 attention 延迟;包含稀疏预测开销 |
| Sparsity | QK 与 PV 两类块乘法合计的跳过比例,不是 $P$ 的零元素比例 |
表头简写 speed 为 $1/t$,但 Sec.4.1 实际写 $O(\mathrm{attn})/t$;表 11 明确标 TOPS。表 1 本身没有明确写出单位,本文保留数值并主要计算相同输入下的比值,避免误称为 token/s 或生成吞吐。
端到端时间表明确了 GPU;主速度表没有逐行充分列出 GPU 和完整运行配置。生成评估的样本数、重复次数、随机种子、置信区间等未完整报告,不能补造。实验是论文报告结果,本次没有独立复现。
四:结果与证据
4.1 跨任务质量和注意力速度(Sec.4.2,表 1,p.7)
以下用 Full → Sparge 展示同一模型,速度倍数为本次用表值计算,均不是整模型倍数。
| 模型 / 长度 | 稀疏度 | 原表 speed | 注意力速度比 | 质量例子 |
|---|---|---|---|---|
| Llama3.1 / 128K | 0.54 | 156.9 → 708.1 | 4.51× | PPL 6.013 → 6.020;NIAH 0.907 → 0.909 |
| CogVideoX / 17K | 0.46 | 166.0 → 507.9 | 3.06× | VQA-a 80.384 → 78.276 |
| Mochi / 22K | 0.47 | 164.2 → 582.4 | 3.55× | VQA-a 56.472 → 54.179 |
| Flux / 4.5K | 0.38 | 158.2 → 280.3 | 1.77× | FID 166.103 → 163.982 |
| SD3.5 / 4.5K | 0.31 | 164.2 → 293.0 | 1.78× | FID 166.101 → 166.193 |
语言的 LongBench 为 38.682 → 39.058,差 0.376 个原表分数单位;InfiniteBench 为 0.6594 → 0.6638。NIAH 的 0.002 变化相当于准确率增加 0.2 个百分点。没有误差条,不应宣称统计显著改善。作者推测稀疏筛选减少无关信息,这是解释而非已证实因果机制。
对照能说明跨任务迁移的困难:Mochi 中 FlexPrefill 的 0.4 稀疏度配置 VQA-t 仅 0.7413,SpargeAttn 在 0.47 下为 67.219;但这是论文特定配置结果,不等于所有后续版本的基线都如此。
视频存在可测下降:CogVideoX 的 CLIPSIM 0.1819 → 0.1798、VQA-t 75.946 → 74.846、FScore 5.342 → 5.030;Mochi 的 FScore 则 1.681 → 1.807。Open-Sora-Plan 的 VQA-a 81.40 → 77.59、VQA-t 80.60 → 76.91,延迟 629 → 393 秒(1.60×)。因此更准确的总结是“在作者评估中多数指标较好保留,明显优于所选稀疏对照”,而非每项指标无损。
图 6–8、12–13 是视频帧/图像的定性比较,能看到所选示例的结构与纹理保留情况,无法替代总体分布评估或人类盲测。
4.2 内核速度与端到端速度不能混用
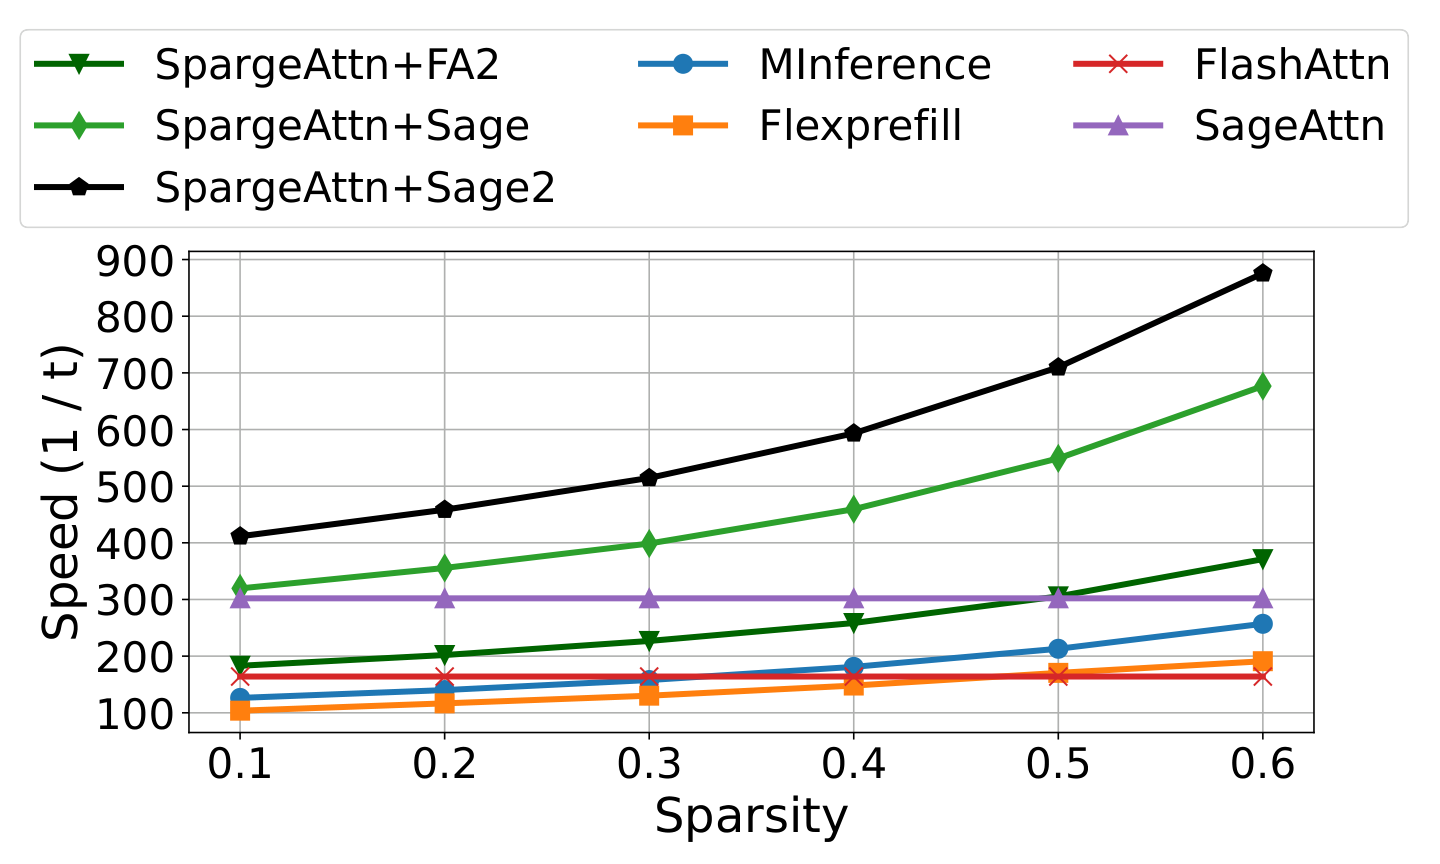
原图 10,PDF p.9。横轴为 sparsity,纵轴为原文 speed;固定序列长度 22K、head dimension 128。曲线区分 SpargeAttn+FA2、+Sage、+Sage2 与稠密/稀疏对照。它支持“稀疏与量化叠加有收益”;并未隔离所有软硬件因素,也不能从曲线直接外推整模型延迟。这里不从像素读取精确数据点。
| 模型 / GPU | Original | SageAttn | SpargeAttn | 对 Original / 对 Sage |
|---|---|---|---|---|
| CogVideoX / RTX4090 | 87 s | 68 s | 53 s | 1.64× / 1.28× |
| Mochi / L40 | 1897 s | 1544 s | 1037 s | 1.83× / 1.49× |
| Llama3.1 24K / RTX4090 | 4.01 s | 3.53 s | 2.60 s | 1.54× / 1.36× |
| Llama3.1 128K / L40 | 52 s | 42 s | 29.98 s | 1.73× / 1.40× |
来源:表 2,p.8;比值由本次计算。Mochi 时间降低约 45.3%,不是降低 83%。attention 之外的计算限制了端到端收益;没有证据说明单 token decode 也具有 128K attention 的同等加速。
4.3 预测开销(表 3,p.8)
| 长度 | 预测 ms | Full Attention ms | 相对 full 的开销 |
|---|---|---|---|
| 8K | 0.251 | 6.649 | 3.78% |
| 16K | 0.487 | 26.83 | 1.82% |
| 32K | 0.972 | 106.68 | 0.911% |
| 64K | 2.599 | 424.24 | 0.612% |
| 128K | 8.764 | 1696.2 | 0.516% |
长序列下比例下降,但预测绝对时间仍增加。分母是 full attention,不是加速后的总时间。“no extra overhead”适合描述第二阶段复用在线统计的设计意图,不应解释为整套稀疏预测成本为零。压缩注意力仍随块数平方增长,论文也未证明整体变成线性复杂度。
4.4 Hilbert 重排消融(表 4、9,pp.9、14)
Mochi 的 row-major → Hilbert:Sim-q 0.551 → 0.572,Sim-k 0.390 → 0.479,稀疏度 0.363 → 0.392(增加 2.9 个百分点,约 8.0% 相对增加),L1 0.0307 → 0.0389,误差反而增加。CogVideoX 稀疏度 0.242 → 0.265,L1 0.0265 → 0.0323。它改善的是质量约束下可利用的稀疏性,不是同时最小化 L1。
随机排列的 Mochi 稀疏度降至 0.048、CogVideoX 为 0.027,但 L1 仍为 0.0414、0.0348。解释是更多不相似块被保护,牺牲速度潜力维持准确性。注意这些是特定消融配置,不能直接替代主表的 0.47/0.46。
4.5 相似性判断保护长尾错误(表 5、10,pp.9、15)
Mochi 有/无判断的 VQA-a 为 54.179/34.664,VQA-t 为 67.219/44.722,FScore 为 1.807/1.138,支持这不是可有可无的模块。
附录更关键:全体 attention 张量平均 L1 变化不大,但筛选 $|L1^{judge}-L1^{no\ judge}|>0.05$ 的约 2% 案例后,CogVideoX 为 0.0843/0.214,Mochi 为 0.0555/0.154。这个子集是按误差差异选择的,不是全体样本平均,更不是正式显著性检验;它揭示少数错误大的层/输入可能被全局均值掩盖。
4.6 两个阶段、长度与扩散稀疏性
- 表 6(p.9):Llama3.1 128K NIAH 仅 $M_g$、仅 $M_{pv}$、组合的总稀疏度分别 51.2%、27.7%、54%。组合比第一阶段多 2.8 个百分点;不能将 51.2 与 27.7 相加,因为第二阶段只处理剩余路径且只省 PV。
- 表 7(p.9):8K/16K/24K/48K/128K 的稀疏度为 6.8%/26.4%/35.7%/49.8%/54%,支持该配置下长上下文冗余增加。不是任意文本都单调变稀疏的保证。
- 表 11(p.15):16–28K NIAH 评估、表内速度行标 24K,SpargeAttn 稀疏度 0.36;speed 156.9 → 443.6 TOPS(2.83×),NIAH 0.838 → 0.863(2.5 个百分点)。不能将整个长度区间写成单一 24K 质量测试。
- 图 14–17(pp.17–18):CogVideoX 稀疏度明显随 layer、head 变化;图 15 随绘制的采样步索引增加;图 16 不同 prompt 的均值波动较小。图中步索引不能无条件等同于噪声强度或训练时间。
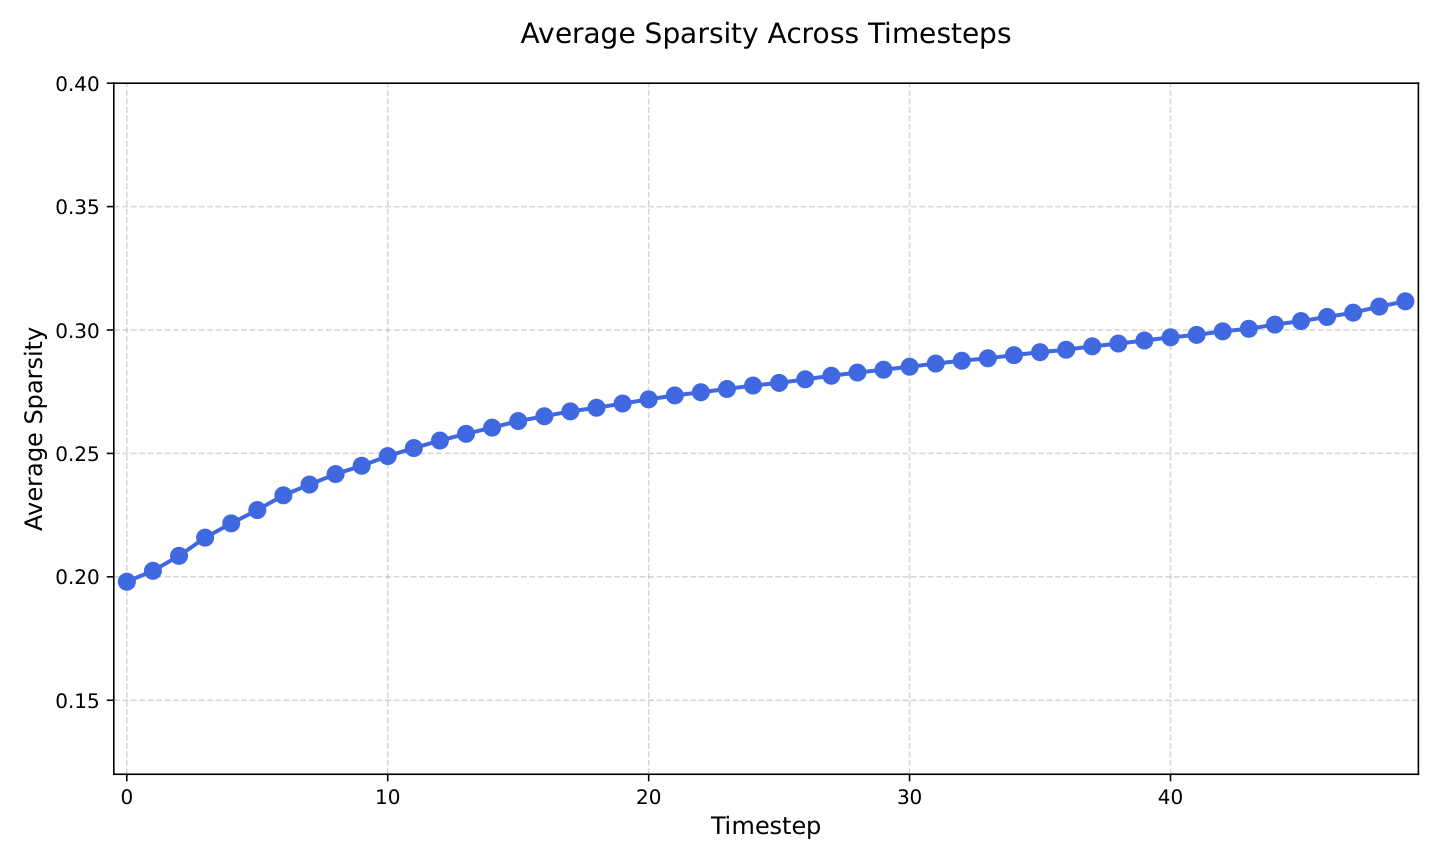
原图 15,PDF p.17,横轴 Timestep,纵轴平均 sparsity;支持该实验中从较早到较后采样步的上升趋势,不支持所有扩散模型/调度器的普遍定律。
五:结论、限制与后续问题
可靠贡献:选择性压缩将错误保护直接纳入稀疏预测;warp 级在线筛选进一步节省 PV;量化内核与视觉重排使算法具备系统级收益。跨六类具体模型配置的证据比仅在单个 LLM 上验证更有说服力。
边界:方法是近似计算;需校准;低相似性输入可能几乎不稀疏;质量小幅升降未提供置信区间;没有任意模型/任意输入无损保证;主要速度结果混合了量化与稀疏收益;主表的硬件/运行配置及部分伪代码细节不够完整。论文没有证明高稀疏度自动带来同幅度端到端提升。
适合组会讨论的后续问题(本次分析):
- 校准集外的输入、超长长度和不同提示词分布会怎样改变错误尾部?
- 能否用遗漏概率质量与 $V$ 范数构造可控误差界,而不只用最大值差?
- 在同一量化内核、相同 GPU、相近质量约束下,各模块分别贡献多少加速?
- Hilbert 重排本身的代价、causal mask 兼容性和短序列收益如何?
- 复现前应核对 TopCdf 边界、CosSim 定义、缩放、空选择保护、基线配置与具体 kernel 版本。
一句话记忆:先判断一个块是否值得相信其均值,再决定是否跳过;小权重的 PV 则留到在线 softmax 中二次判断。