HashAttention:用学习式二进制检索实现语义稀疏注意力
论文:HashAttention: Semantic Sparsity for Faster Inference
作者:Aditya Desai、Shuo Yang、Alejandro Cuadron、Matei Zaharia、Joseph E. Gonzalez、Ion Stoica
版本:arXiv:2412.14468v2,2025-06-03 修订,ICML 2025;研读日期:2026-10-12。
材料:arXiv · 本地原文 PDF · 英文幻灯片 · 可编辑 TeX。下文页码均为从 1 开始的 PDF 页码。
论文总览
HashAttention 研究长上下文解码中的一个具体问题:怎样不先计算完整的 query–key 点积,就找出当前 query 最应该关注的少数 token? 作者把它看成推荐系统式的检索问题,用两套独立的小网络,把 key 和 query 映射为 32 位二进制签名。每步解码先用 XOR 与 population count 计算签名距离,再选 top-k,最后只在被选中的原始 KV 上计算标准注意力。
关键贡献是把“筛选器的质量、筛选开销、辅助缓存”放在一起设计。更准的筛选器允许后续注意力读取更少的 KV;这里的收益不只来自位运算本身。32 位是每 token、每 attention head 的辅助索引成本,原始 KV cache 仍然保留。论文中的 16×/32× 稀疏主要描述检索 token 预算,不能直接解释为 KV 常驻显存缩小相同倍数。(§4,pp. 4–6;§6,p. 9)
通用 OpenWebText 训练的结果中,Llama-3.1-8B-Instruct 在 16× 稀疏下,LongBench 的 16 个非中文任务均分从 48.78 到 48.00,RULER@16K 的 13 个任务均分从 90.66 到 89.53。任务相关训练能进一步改善若干 LongBench 子集的 32× 稀疏结果。A100 上的效率实验报告最高 4.3× 的 GPT-FAST attention 加速、2.54× 的 FlashDecode attention 加速,以及 GPT-FAST 的 3.12× 模型吞吐提升;这些属于不同测量口径,不能互换。(表 2–3,p. 6;图 3,p. 7;图 4、§5.2,p. 8)
结构地图
| 原文章节 | 在论证中的作用 | PDF 页码与主要证据 |
|---|---|---|
| 1 Introduction | 长上下文瓶颈、检索视角、主要结果 | pp. 1–2;图 1 |
| 2 Related Work | 固定稀疏、淘汰、低维评分、近邻检索、哈希采样 | pp. 2–3 |
| 3 Background | SDPA 与推荐模型的对应关系 | p. 3 |
| 4 HashAttention | SCORE → TOPK → GATHER-ATT 的统一框架 | p. 4;图 2 |
| 4.1 The SCORE function for HashAttention | 学习签名与 Hamming 评分 | pp. 4–5;式 (1)–(2) |
| 4.2 HashAttention for adapting to pre-trained LLMs | 监督目标、类别加权、软二值化 | p. 5;Lemma 4.1、式 (3)–(4) |
| 4.3 Theoretical underpinnings of HashAttention | token 贡献、MIPS 与余弦检索 | p. 5;Lemma 4.2 |
| 4.4 Efficiency of token level sparsity | page size = 1 的索引访问 | pp. 5–6 |
| 5 Experiments;5.1 Quality with HashAttention | 实验协议、定预算、Pareto 与全任务评估 | pp. 6–8;表 1–3、图 3 |
| 5.2 Efficiency with HashAttention | attention 延迟与模型吞吐 | p. 8;图 4 |
| 5.3 Ablations | 学习式签名、分布、位宽、评分延迟 | p. 9;附录表 6–9 |
| 6 Limitations and Discussion;7 Conclusion | 训练依赖与 GPU KV cache 场景 | p. 9 |
| A Baselines | 各基线的机制与适用设置 | pp. 12–13 |
| B Lemma Proofs | 单 token 贡献与排序归约推导 | pp. 13–14;式 (5)–(14) |
| C Other ablations | 召回、分任务曲线、中文结果及其他消融 | pp. 14–17;图 5–6、表 4–9 |
一:动机——有稀疏性,还需要一个便宜且准确的筛选器
对单个解码 query,稠密注意力需要读取整个历史 KV。若长度为 $n$、每个 head 的维度为 $d$,计算全部 query–key 点积约需 $O(nd)$ 工作。即使事后发现只有少数 token 的权重大,完整扫描高维 key 的成本已经发生。HashAttention 要解决的正是这一步“为了省计算,先付出接近完整计算成本”的矛盾。(§3–4,pp. 3–4)
不同 query 可能依赖同一文档的不同位置,因此永久删除曾经不重要的 token,会限制未来检索。作者据此选择保留全部 KV、按 query 重新选择访问对象。相关方法的区别可以理解为“用什么信息估计重要性”:
| 方法 | 筛选依据 | 与本文比较时的关键取舍 |
|---|---|---|
| StreamingLLM | 开头 attention sink 与最近窗口 | 读取便宜,但远距离中间内容可能始终不可见 |
| H2O | 根据历史注意力累计重要性淘汰 | 能减少存储;被淘汰内容后续难以重新访问 |
| InfLLM | 每个块的代表 key | 减少评分对象,但代表 key 可能漏掉块内关键 token |
| Quest | 每块逐坐标最小值/最大值 | 为块估计重要性,但整块预算可能花在无关 token 上 |
| Double Sparsity,DS | 用校准选出的少数 key 通道估计点积 | 可在 GPU 上运行;通道数与量化精度影响辅助缓存和召回 |
| RetrievalAttention | 近邻图检索 | 目标接近本文,本文讨论其 CPU 检索与 KV 放置的系统代价 |
| HashAttention | 学习的二进制 key/query 表示 | 为模型额外训练小模块,以紧凑表示换取较高召回 |
来源:§2.2,p. 3;附录 A,pp. 12–13。H2O 的选择依赖历史,并非静态固定窗口;它和 StreamingLLM 在本文任务中表现较弱,原因也不完全相同。本文主要数值对照包括前五种方法,RetrievalAttention 属于机制讨论。
二:方法——学习“哪些 token 应该靠近这个 query”
2.1 输入、输出和三个计算阶段
下文用 $m$ 表示实际检索预算,以免与训练标签中的 top-$k$ 混淆。
| 符号 | 含义 |
|---|---|
| $n,d$ | 当前缓存长度、单头向量维度 |
| $\mathbf q,\mathbf k_i,\mathbf v_i\in\mathbb R^d$ | 当前 query、第 $i$ 个 key 和 value |
| $a_i$ | 完整注意力的 softmax 权重 |
| $b$ | 签名位数,主实验为 32 |
| $\phi_{kv},\phi_q$ | 独立学习的 KV 侧与 query 侧编码器 |
| $\mathcal I_m$ | 按签名评分选出的 $m$ 个位置 |
| $\mathcal I_{\mathrm{true},k}$ | 监督或召回评估所用的真实 top-$k$ 集合 |
保留标准 SDPA 的缩放,定义
原文后续单 query 公式省略了 $1/\sqrt d$,可通过把缩放吸收到 query 中理解。HashAttention 的推理过程为:
- SCORE:对所有缓存的二进制签名计算负 Hamming 距离。
- TOPK:选出最相似的 $m$ 个位置,并保留实验约定的开头与局部窗口。
- GATHER-ATT:直接按索引读取原始 KV,在所选集合上重新计算并归一化注意力。
对最终集合 $\mathcal I$,正确的稀疏注意力表达式为
这里修正了原文 p. 4 分母指示函数把索引 $j$ 写成 $i$ 的笔误。签名只负责选位置,最终 attention 使用原始浮点 KV。(§4,p. 4)
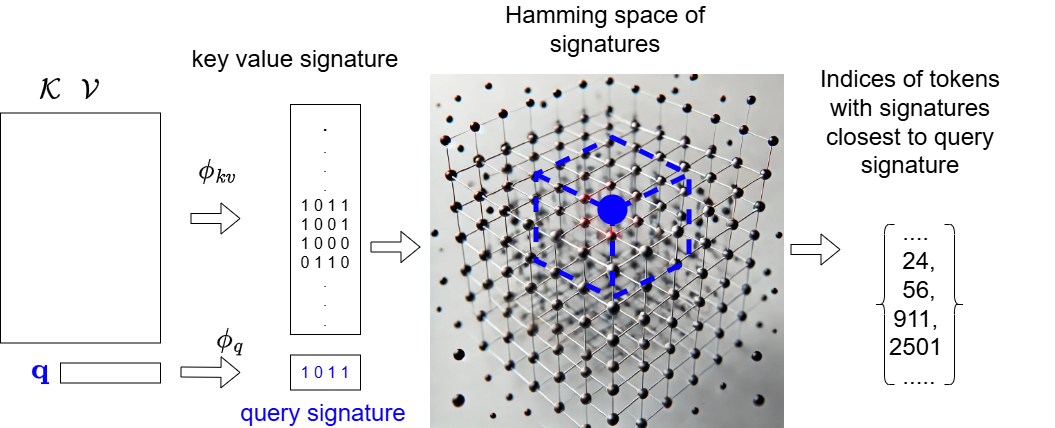
原图 2,PDF p. 4。从左往右看:历史 key 与 query 经过不同编码器成为 bit signature;中间的 Hamming 空间表示检索关系;输出是原始 KV 的索引。图中的 $\phi_{kv}$ 是一般写法,论文实际实验只输入 key,未输入 value 或其范数。(§4.1,p. 5)
2.2 二值编码与 GPU 评分
两套独立前馈网络后接二值化:
对 key 和 query 使用不同的 $\mathcal F$,允许它们的原始分布不同。评分为
将位串打包为整数 $h_i,h_q$ 后,
因此不需要先把每个 key 的 128 个浮点分量搬进评分过程。key 的签名随 KV 写入时计算并缓存;解码热路径生成当前 query 的签名,扫描缓存签名,再做 top-k。(式 (1)–(2),pp. 4–5)
教学例子:query 签名为 1011,三个 key 签名为 1011、1001、0110。XOR 的结果分别为 0000、0010、1101,Hamming 距离为 0、1、3,预算为 2 时选前两个位置。真实实验使用 32 位;二进制距离仅有 $b+1$ 种可能值,因此还会出现并列分数。
这不是通过哈希表只访问某个 bucket 的方案。按论文给出的实现,仍然要扫描 $n$ 个紧凑签名。若机器字宽为 $w$,评分工作约为 $O(n\lceil b/w\rceil)$,再加 TOPK 与 $O(md)$ 的稀疏 attention。复杂度仍随上下文增长,主要收益来自更小的读取量和便宜的运算。
2.3 训练:冻结 LLM,逐头学习重要 token 标签
LLM 保持推理模式,按 chunk 处理文本。每个 chunk 结束后,利用当前 chunk 的 query 与此前缓存 KV,为各 attention 模块进行独立的局部训练。作者用真实重要 token 构造二元标签,例如 top-64 为正类,其他位置为负类;训练小编码器,不更新 LLM 主体。(§4.2,p. 5)
三点设计决定训练能否有效:
- 正类极少:64,000 个候选中只有 64 个正例,比例为 0.1%。正类权重采用 $w_+(n)=\alpha+\beta n$,随上下文增长补偿类别失衡。
- 离散映射难以直接优化:训练时用 $\tanh$ 代替 $\operatorname{sign}$;推理时再转为真正的二进制签名。
- 学习对象有分布依赖:通用版本使用拼接的 OpenWebText;HashAttention$^*$ 进一步使用任务数据。作者明确观察到,使用不超过 64K 的序列训练并不会自然扩展到 128K,训练长度需要与部署长度匹配。
论文描述使用加权 binary cross-entropy 和 Adam。其抽象目标可写成下式;这是对文字协议的整理,原文没有给出从软嵌入到概率 $p_i$ 的完整计算式:
这是对每个候选做二元判别、一个 query 可以有多个正例的问题。论文所谓“multi-class setting”不应理解为只允许一个正确类别。训练的 top-64 标签数、召回评估的 top-32,以及推理时的 512 token/16×/32× 预算是三种不同概念。
2.4 理论链条:贡献分数、MIPS 与一个需修正的余弦公式
第一步:孤立贡献分数。 Lemma 4.1 给出
它是单项向量 $a_i\mathbf v_i$ 的范数。附录 B.1 用保留原权重的采样近似 $\mathbf a^\top S V$,分析输出残差。在忽略不同 value 的交叉项后,有
于是选最大的 $s_i$ 最能减少这一近似残差。将式 (9) 到式 (10) 写成严格等式,需要相关 value 的交叉内积为零,或在适当随机假设下取期望;“独立”本身不足以对任意固定样本消掉交叉项。此外,实际 GATHER-ATT 会重新归一化 softmax,而该证明保留原权重。因此这个论证支持一种重要性代理,不是任意相关 value 下、任意预算的稀疏注意力全局最优性定理。(Lemma 4.1,p. 5;附录 B.1,pp. 13–14)
第二步:贡献排序可精确转为 MIPS。 在 $\|\mathbf v_i\|_2>0$ 时,令 $\bar{\mathbf q}=\mathbf q/\sqrt d$,则
$Z$ 对固定 query 的所有 key 相同,因此
这是排序等价。附录式 (13) 的“正比于”符号应按保序关系理解,而不是声称指数函数与其指数线性成比例。零 value 的贡献为零,可单独处理。(Lemma 4.2,p. 5;附录 B.2,p. 14)
第三步:等范数提升到余弦检索。 令 $\mathbf x_i=[\mathbf k_i,\log\|\mathbf v_i\|_2]$、$\mathbf u=[\bar{\mathbf q},1]$,取正数 $M\ge\max_i\|\mathbf x_i\|_2$。可以使用
此时
分母与 $i$ 无关,所以保持 MIPS 排序。
原文公式问题:§4.3、p. 5 写的是 $\psi_q(\mathbf q)=[\mathbf q,1,1]$,最后一维为 1。这样点积会多出随 key 变化的 $\sqrt{M^2-\|\mathbf x_i\|^2}$,破坏保序。上式最后一维为 0 是本次推导的修正。例如 $q=1$、两个 key 为 2 和 1、value 范数均为 1、$M=2$,原始排序为 $2>1$,错误提升后的分子却是 $2<1+\sqrt3$。
HashAttention 的实际编码器是从数据学习的独立 MLP,没有直接执行上述手工提升。因此这个公式问题影响理论解释的严谨性,不会自动推翻实验。更实用的启发是:用不对称、可学习的编码去拟合与注意力有关的排序,然后将其压缩成便于硬件处理的位串。
2.5 为什么 token 级稀疏可以有效运行
作者用 page size = 1 的 paged attention,每个被选中的 token 对应一个页索引。虽然子过程叫 GATHER-ATT,实际实现不先把 KV 搬到新的连续缓冲区,而是让 kernel 按索引读取所选页。作者以 128-byte cache line 说明:只要单 token 内的连续读取足够大,就可以利用内存带宽;$d=128$ 的 FP16 向量本身有 256 bytes。(§4.4,pp. 5–6)
这种设计避免为获得局部访问连续性而强制检索整个 token 块,但仍受 top-k、编码器和稀疏访问效率影响。可把每步成本概括为
32 位签名占 4 bytes/token/head。作为量级对照,一个 128 维 FP16 key 为 256 bytes,所以单个签名仅为它的 $1/64$;这不包括编码器权重,也不表示原始 key 被替换。所有头、所有层与 KV 共享方式的总账需要另算。
三:实验——首先读清预算和应用范围
3.1 统一协议与指标
| 维度 | 原文设置及含义 |
|---|---|
| 模型 | Llama-3.1-8B-Instruct、Mistral-7B-Instruct-v0.3 |
| 注意力替换 | 稀疏阶段替换所有 attention heads |
| 预处理长上下文 | prompt 大部分使用完整注意力;仅最后 offset 个 token 及后续生成使用稀疏注意力 |
| offset | LongBench 为 128;RULER 为 32 |
| 固定保留位置 | 所有方法保留最初 128 与最近 128 token |
| 检索预算 | 指额外检索的 heavy/pivotal tokens;与固定窗口区别计数 |
| 辅助缓存 | 默认 32 bits per token per attention head,简称 PTPA;表 1 另有更高预算配置 |
| 长文本评估 | LongBench 多种下游任务;RULER 检索、追踪、聚合和 QA 等合成任务 |
| 效率评估 | A100;GPT-FAST 与 FlashDecode;模型吞吐图为 batch = 1 |
来源:§5,pp. 6–8。这个协议模拟“先预处理长文档,再接短问题并生成”的场景,不能把它解释为整段长 prompt 的稀疏 prefill 效果。
LongBench 表中是各任务自己的质量分数,RULER 表中是对应任务评分,均为越高越好。跨任务 AVG 是表列任务分数的算术平均,不是把所有样本合并计算出的统一正确率。attention kernel 延迟单位为 ms、越低越好;模型吞吐单位为 tokens/s、越高越好。top-k 召回率定义为
它衡量筛选器找回多少真实重要 token,既不同于下游问答分数,也不同于保留了多少 attention 概率质量。(§4,p. 4)
预算的教学换算:若 $n=16{,}384$,名义 16× 稀疏对应约 $m=1{,}024$ 个检索位置;若再加入 256 个固定位置且无重叠,总计为 1,280,实际读取比例约为 $7.81\%$。因此不能直接把 16× 当作完整 kernel 或整模型的加速倍数。
3.2 不同实验使用了不同训练口径
通用 HashAttention 使用 OpenWebText,HashAttention$^*$ 进一步针对任务训练。但表 1 的行名虽然没有星号,其表注明确写了 OpenWebText 与 LongBench 数据混合训练:通常每个数据集最后 25 条用于训练、前 175 条用于评估;MFQA 只有 150 条,不参与训练。表 1 应解释为任务相关训练下的定预算比较,不能拿来证明纯通用训练的跨任务泛化。(表 1,p. 6;§5.1,p. 7)
全任务 16× 结果见表 2–3,按实验总说明属于通用 HashAttention。图 3 的 LongBench 曲线只平均四个任务;其 RULER 曲线只包含六种选定任务,不能与完整 13 任务均分直接互换。
四:结果——召回、质量和系统开销如何连起来
4.1 固定 512 token:紧凑表示仍能竞争
表 1 以六类 LongBench 任务检验在相同检索 token 预算下,筛选器是否有效。下表保留关键配置;除完整模型外,检索预算均为 512:
| 方法 | 辅助 bits/token/head | 六任务平均分 ↑ |
|---|---|---|
| Full Model | — | 63.55 |
| Oracle:准确 top-k | — | 63.43 |
| H2O | — | 43.47 |
| StreamingLLM | — | 33.28 |
| InfLLM,pg=16、bit=16 | 256(原表标注) | 48.23 |
| DS,ch=16、bit=2 | 32 | 61.88 |
| DS,ch=16、bit=4 | 64 | 62.78 |
| Quest,pg=16、bit=2 | 32 | 62.36 |
| Quest,pg=16、bit=4 | 64 | 63.33 |
| HashAttention,含任务相关训练 | 32 | 64.15 |
来源:表 1,PDF p. 6。HashAttention 比同为 32-bit 的 DS 高 2.27 分、比 Quest 高 1.79 分;它用更小辅助表示取得了更好的平均下游效果。预算更高并不保证更好,具体通道数、量化与 page 配置同样重要。
HashAttention 高于 Oracle 的 63.43,并不矛盾:Oracle 只准确执行指定的 top-k 排序,它不是“下游任务分数的上界”。注意力截断改变了模型行为,代理排序与最终任务成绩之间并无严格单调关系。
4.2 通用训练的 16× 结果:平均损失小,但任务差异明显
| 评估范围 | Full ↑ | HashAttention-16× ↑ | 差值(分) |
|---|---|---|---|
| LongBench:16 个非中文任务 | 48.78 | 48.00 | −0.78 |
| 上述集合排除 passage-count | 51.48 | 51.08 | −0.40 |
| RULER@16K:13 个任务 | 90.66 | 89.53 | −1.13 |
| LongBench:5 个中文任务 | 50.888 | 48.228 | −2.660 |
来源:表 2–3,p. 6;表 5,p. 14。中文表缺少行名,结合紧邻表 4 的顺序和 §5.1 明确报告的 2.66 分下降,可将第一行对应 HashAttention、第二行对应 Full;上表按这个对应整理。
LongBench 中的代表性差异如下:
| 任务 | Full | 16× | 差值(分) | 含义 |
|---|---|---|---|---|
| passage-retrieval-en | 100.00 | 100.00 | 0.00 | 单个目标的检索可在稀疏预算下保留 |
| passage-count | 8.29 | 1.85 | −6.44 | 聚合/计数很容易受到信息丢失影响 |
| hotpotqa | 55.40 | 51.92 | −3.48 | 多跳任务存在可见代价 |
| qasper | 45.80 | 43.52 | −2.28 | 文档 QA 也并非完全无损 |
| triviaqa | 90.55 | 92.14 | +1.59 | 某些任务截断后反而改善 |
| lcc | 62.87 | 64.89 | +2.02 | 代码任务出现改善 |
| repobench-p | 55.31 | 60.49 | +5.18 | 代码补全改善较明显 |
来源:表 2,p. 6。作者将部分改善解释为减少 distractor token 的干扰;这里属于机制解释,实验没有直接操纵干扰项来识别因果。passage-count 的完整模型分数本身也低,因此应同时看绝对分数与下降值。
RULER 的三个 single-needle 任务均保持 100;但 niah_multikey_2 从 100 降至 90,variable tracking 从 99.2 降至 93,qa_1 从 87 降至 82。与此同时,cwe 从 50.5 升至 62.4,qa_2 从 54 升至 57。均分接近掩盖了这些相反方向的变化。(表 3,p. 6)
中文五任务的变化分别为:multifieldqa_zh −2.05、dureader −3.58、vcsum +0.34、passage-retrieval-zh −5.15、lsht −2.86 分。英语数据训练的编码器有一定迁移能力,中文检索与 QA 的损失则提示签名空间仍有语言分布依赖。(表 5,p. 14)
4.3 Pareto 曲线:更少 token 能否达到相近质量
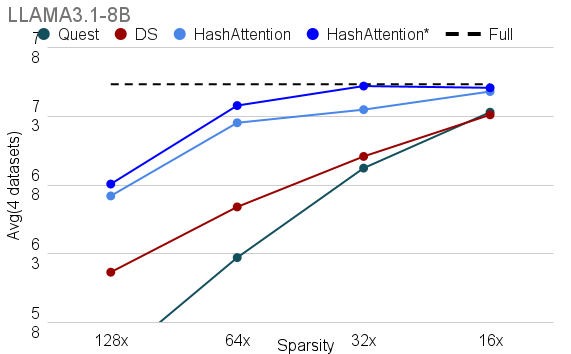
原图 3 左,PDF p. 7。横轴从 128× 到 16×,越往左读取越少;纵轴为 passage retrieval、TriviaQA、MultifieldQA、HotpotQA 四任务平均分。所有方法辅助预算为 32 bits PTPA;虚线为完整模型。通用 HashAttention 在 16× 接近完整模型;任务训练版本在约 32× 接近完整模型。DS、Quest 为达到相近质量需要更多 token,这是作者“约 4× 更高 token 效率”的主要经验依据,具体倍数依质量阈值和任务而变化。
Mistral 对应曲线显示,通用版本在该四任务子集约 32× 即接近完整模型。附录图 6 的逐任务曲线并非处处单调:任务微调不保证每个预算、每个任务都变好,所以聚合曲线应与逐任务结果一起理解。(图 3 中,p. 7;图 6,p. 17)
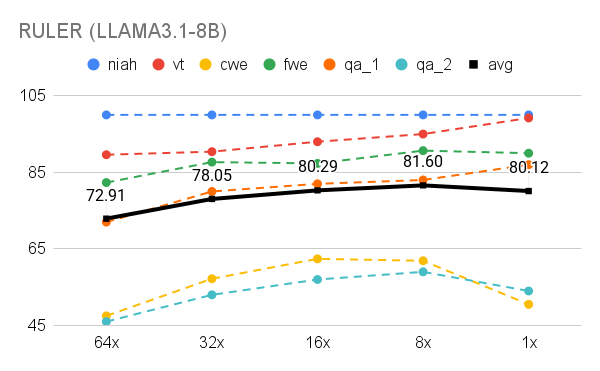
原图 3 右,PDF p. 7。黑线是所选六任务的平均,16× 为 80.29,完整注意力为 80.12;这与表 3 完整 13 任务的 89.53 对 90.66 使用不同集合。不能据前者写成“整个 RULER 在 16× 没有损失”。
4.4 召回微基准:质量优势确实伴随重要 token 检索改善
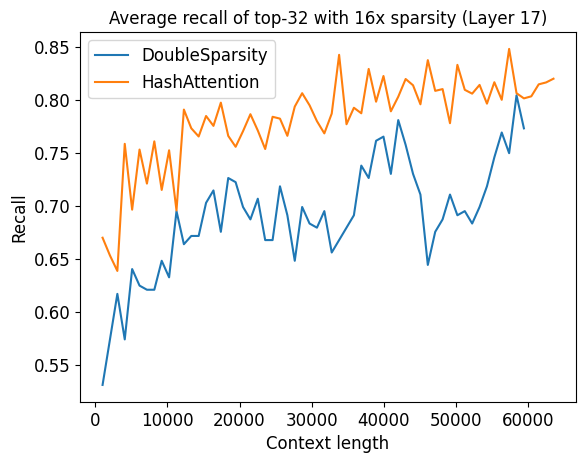
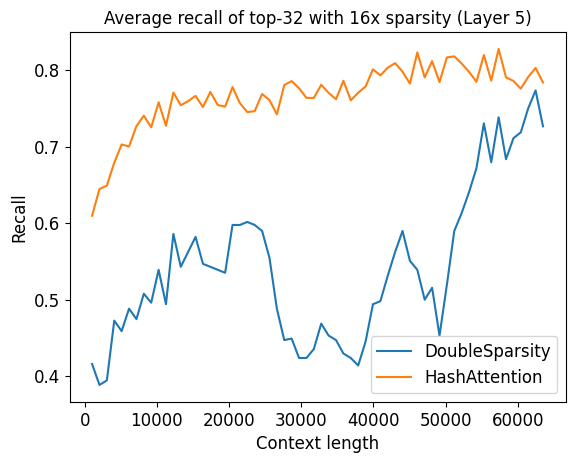
原图 5 的两个面板,PDF p. 14。横轴是上下文长度,纵轴是 top-32 召回率,检索预算采用 16× 稀疏。橙线为 HashAttention、蓝线为 DS。展示的第 17 层与第 5 层在多数长度下都具有更高召回,后者差距尤其明显。这支持“更好的筛选能在相同预算下保住更多重要 token”的解释;图中展示的是这两层的诊断,不是全模型每个 head 的完整统计。
4.5 效率:编码器、TOPK 与所选注意力共同决定收益
效率实验采用三层 MLP,维度为 $128\to128\to128\to32$,稀疏率为 32×。(§5.2,p. 8)
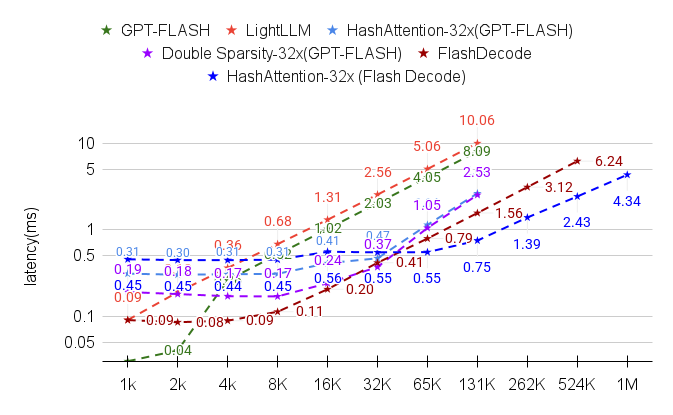
原图 4(a),PDF p. 8。横轴为上下文长度,纵轴为 ms,使用对数刻度。图中 GPT-FLASH 标签与正文 GPT-FAST 命名不一致,此处按正文的框架说明理解。较短上下文中,签名映射的固定成本可能大于节省的 KV 访问;上下文增长后,稀疏 attention 的收益才足以抵消这部分开销。正文报告 GPT-FAST attention 最高约 4.3×、FlashDecode 最高约 2.54× 加速。
图注把收益区域概括为 GPT-FAST 超过约 8K、FlashDecode 超过约 65K;正文还出现 GPT-FAST “4K 之后”的说法。更稳妥的解读是看具体曲线,并把这些长度视为该实现下的交叉区间。FlashDecode 采用序列并行,使其稠密基线更强,HashAttention 需要更长上下文才显现优势。
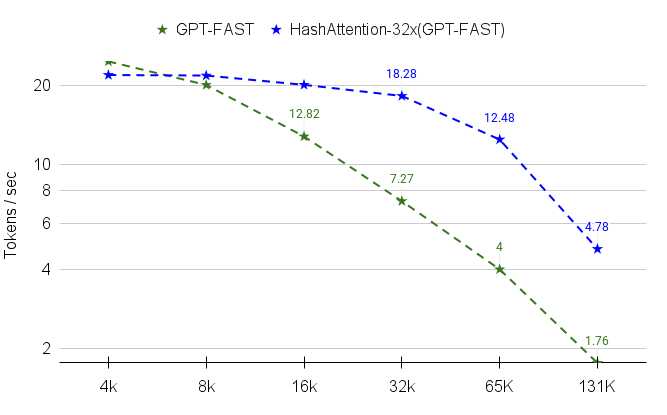
原图 4(b),PDF p. 8;A100,GPT-FAST,Llama-3.1-8B,batch = 1,32× 稀疏。下面的比值根据图中标出的数值计算:
| 图中上下文长度 | Full tokens/s ↑ | HashAttention tokens/s ↑ | 吞吐比 |
|---|---|---|---|
| 32K | 7.27 | 18.28 | 2.51× |
| 65K | 4.00 | 12.48 | 3.12× |
| 131K | 1.76 | 4.78 | 2.72× |
图文不一致:§5.2 将最高 3.12× 写在 32K,但图中 $18.28/7.27\approx2.51$,$12.48/4=3.12$ 对应 65K。这里保留“最高 3.12×”这一结果,并按图中数值定位到约 65K。再增长到 131K,收益比值下降;作者将其归因于 TOPK 越来越昂贵。吞吐图评估的是生成系统,未展示整段 prompt 的 prefill 耗时与完整请求延迟。
质量和速度还应在同一个工作点上看。图 1 的 RULER@32K 联合评估中,完整模型质量为 84.28,HashAttention 的两个工作点为 83.41 与 82.56,下降 0.87 与 1.72 分;正文对应约 1.3×/1.7× 吞吐提升、4×/8× 稀疏。它比单列 32× 的最高吞吐更直接地显示质量—速度折中。图 1 对 DS 的吞吐省略了量化/反量化成本,且未计辅助缓存对吞吐的影响,比较时需保留这一协议。(图 1,p. 1;§1,p. 2)
4.6 学习式签名对比随机 LSH
表 8 固定 16× 稀疏,比较 learned signatures 与随机 signed projection 的 LSH 签名:
| 签名方案 | 位数 | 四任务平均分 ↑ |
|---|---|---|
| HashAttention | 32 | 75.0675 |
| LSH | 32 | 48.8975 |
| LSH | 256 | 69.7875 |
| LSH | 512 | 68.6350 |
| LSH | 1024 | TriviaQA OOM,无完整均分 |
来源:表 8,PDF p. 16。32 位的质量差距为 26.17 分;增加随机投影位数可以改善表现,但 256 到 512 位不呈现稳定单调提升。即便给 LSH 8× 稀疏、512 位,其表中均分为 72.6075,仍低于 HashAttention 的 16×、32 位配置。
这个实验说明学习数据相关的映射很有价值。它不等价于对 MagicPig 整套算法的比较,因为 MagicPig 还包含 LSH 表检索与采样式 attention 估计;论文自己也做了这一区分。(§5.3,p. 9)
4.7 位宽、分布与评分延迟消融
相关 query–key 是否更接近? 表 7 对 query 和其 top-32 key 计算平均余弦相似度。所测层原始空间约为 −0.10 到 −0.12;训练用 tanh 空间约 0.13–0.49;sign 空间约 0.178–0.182。例如第 4 层依次为 −0.119951、0.4922、0.179186。相关配对变得更相近,支持学习映射建立有用检索空间的解释;该统计只看相关配对,不能单独证明整个 query/key 边缘分布已一致。(表 7,p. 15)
更多位数能否改善代理目标? 表 9 的结果为:
| 位数 | Cross-entropy ↓ |
|---|---|
| 16 | 0.243 |
| 32 | 0.212 |
| 64 | 0.204 |
来源:表 9,p. 16;评估量标为 $250\times32K$ samples。16 到 32 位带来的下降大于 32 到 64 位。正文 §5.3 称其为 top-32 预测,附录 C.6 则称 top-64;标签数存在不一致,因此这里将它解释为同一表内不同位宽的代理损失比较,不指定一个已确认的标签数。
位运算的收益到多大位宽仍存在? 表 6 比较 128 维 FP16 点积与 64/128/256/512 位签名评分。以 1,048,576 个候选为例,原表延迟数值依次为 0.619、0.087、0.129、0.226、0.429;64 位约为点积的 $1/7.11$,512 位仍更快。表内未标时间单位,所以不自行补为 ms。该表测的是评分运算,不能把比值直接当作包含映射、TOPK 和最终 attention 的总加速。(表 6,p. 15)
五:结论——把检索精度作为系统资源来设计
HashAttention 最有价值的观点是:注意力筛选器的预算,不只要看它自己有多便宜,还要看它能让后续 attention 少读多少 KV。 两个独立学习的编码器适应 query/key 的差异,bit signature 压低索引流量,token 级检索避免块预算浪费;三者共同形成质量、辅助缓存和速度的折中。
实际选用时,有三项条件直接改变结论。第一,当前结果适合完整 KV 位于 GPU、长文档已预处理的场景;本文未评估 CPU offload 下的系统收益。第二,每个 LLM 需要适配自己的映射,任务、语言和上下文长度的变化可能影响召回,不能只把它当作无训练的 kernel 替换。第三,计数、多键检索等需要分散证据的任务,在均分接近时仍可能承受明显损失,应按目标应用选择预算。
理论上,$a_i\|v_i\|$ 到 MIPS 的排序归约清楚地说明了重要 token 检索的结构;从该代理到最优重归一化 attention 之间仍有交叉项与归一化差异,原文余弦提升公式也需要上述修正。实验上的实际 key-only 编码器依然提供了有力的经验结果,但“引入 value 特征能否改善选择”是作者尚未验证的方向。
值得进一步讨论的研究问题是:能否在分散注意力的 head 上采用更大的自适应预算;能否利用仅有 33 个取值的 32-bit Hamming 距离设计更便宜的选择操作;以及在异步 CPU/GPU KV 读取中,较高召回是否仍能转化为端到端收益。这些是由本文机制推导出的后续问题,而非本论文已完成的实验。