Relaxed Recursive Transformers:用逐层 LoRA 放松层间共享
论文:Relaxed Recursive Transformers: Effective Parameter Sharing with Layer-wise LoRA
作者:Sangmin Bae、Adam Fisch、Hrayr Harutyunyan、Ziwei Ji、Seungyeon Kim、Tal Schuster。
版本:arXiv:2410.20672v3,arXiv 修订日期 2025-02-28,ICLR 2025;PDF 首页印有 2025-03-03。
本次获取与研读日期:2026-09-28。成品修订:r1。
原始材料:本地论文 PDF · 作者主 TeX · 源码清单。
配套成品:英文组会幻灯片 · 可编辑 TeX。
论文总览
这篇论文研究的是:已有一个训练充分的 Transformer,如何把它转换成存储参数更少、仍然保留较强能力的循环模型? 它不从零训练一种全新的循环架构,而是复用已有模型的权重和知识,再进行有限的继续训练(uptraining)。
方法包含三个相互衔接的部分:
- 把原来的 $L$ 层压成 $L/B$ 个独立层,循环执行 $B$ 次,保持原来的计算深度。
- 每个实际深度使用独立 LoRA,表达相对于共享权重的低秩差异;用原模型权重残差的截断 SVD 初始化。
- 共享层块使不同循环轮次的请求可以合批;配合早退,作者模拟了连续深度批处理(Continuous Depth-wise Batching,CDB)的吞吐潜力。
最有力的实证结果是:Gemma 的严格循环模型在 15B tokens 继续训练后,七任务平均准确率为 51.7%,同非 embedding 参数规模、从零训练 15B tokens 的非循环基线为 38.2%。加入逐层 LoRA、60B tokens 继续训练和蒸馏后,rank 512 模型达到 58.4%,接近接受同等继续训练的全尺寸基线 58.6%。这里的基线定义、参数口径和历史预训练成本都很重要。
阅读时应始终保留三个限定:
- 58.6% 是全尺寸模型继续训练 60B tokens 后的成绩;原始 Gemma 检查点为 61.7%。
- “约减半”主要指非 embedding 参数;循环计算深度和 KV cache 不会随之自动减半。
- 2–3 倍吞吐是实测组件耗时与 oracle 早退轨迹结合的模拟结果,未验证为端到端服务加速。
结构地图与阅读范围
下文页码均为从 1 开始的 PDF 页码,本版本与页脚页码一致。已阅读主 TeX 实际引用的正文、附录 A–K 及相关图表文件,并对照 PDF 的公式、关键结果表和原图;参考文献用于定位,不表示逐篇阅读了所有被引论文。没有运行作者模型或复现实验。
| 原文章节 | 论证作用 | PDF 定位 |
|---|---|---|
| 1. Introduction | 从预训练模型转换循环模型的动机 | pp.1–3;Fig.1 p.2 |
| 2.1 Basic Transformer Architecture | 层递推记号 | p.3;Eq.(1) |
| 2.2 Recursive Transformer: Looped Layer Tying | CYCLE 共享与三种初始化 | pp.3–4;Eq.(2),Fig.2 |
| 2.3 Relaxed Recursive Transformer: Multi-LoRA Layers | 深度专用 LoRA 与残差 SVD | pp.4–5;Eqs.(3)–(5) |
| 2.4 Continuous Depth-wise Batching and Early-Exiting | 跨循环轮次调度 | pp.5–6;Fig.3 p.5 |
| 3.1 Experimental Setup | 模型、训练和评价 | p.6;Table 1 |
| 3.2 Non-Recursive Model Baselines | 全尺寸与缩小模型的比较口径 | p.7;Table 2 |
| 3.3 Main Results | 最终精度与参数量关系 | pp.7–8;Fig.4 p.8 |
| 3.4 Initialization Techniques for Looped Layers | 严格共享初始化消融 | pp.8–9;Fig.5 p.9 |
| 3.5 Relaxation of Strict Parameter Sharing via LoRA Modules | Average、SVD、rank 消融 | pp.9–10;Fig.6 p.10、Fig.7a p.11 |
| 3.6 Extended Uptraining and Knowledge Distillation | 延长训练与知识蒸馏 | pp.10–11;Fig.7 |
| 3.7 Early-Exit Training Strategy for Recursive Transformer | 中间出口训练 | pp.11–12;Table 3 p.11 |
| 3.8 Hypothetical Generation Speedup via CDB | 假想吞吐评估 | pp.12–13;Fig.8 p.12 |
| 4. Related Work;5. Conclusion and Future Work | 定位与未解决的问题 | pp.13–15 |
| A–E | Transformer 组件、共享策略、SVD 示例、原始模型、实验协议 | pp.25–28 |
| F | 初始化完整消融和小规模 Pythia | pp.28–32;Tables F.1–F.3 |
| G–H | rank、零初始化、分模块 rank、prefix 替代 | pp.33–37;Tables G.1、G.2、H.1 |
| I–J | 长训练/KD 及早退完整结果 | pp.38–43;Tables I.1–I.2、J.1–J.3 |
| K | 计时、吞吐模拟与误差来源 | pp.44–49;Tables K.1–K.4 |
一:动机——把参数存储与计算深度分开
普通 Transformer 的每层都有独立权重。层数增加既增加计算步骤,也增加需要存储的参数。循环结构把这两者拆开:可以只保存半数独立层,却仍执行原来那么多层变换。这样首先减少的是权重存储;在某些部署条件下,节省的显存可容纳更多请求。
完全共享的代价是,每组权重需要同时适应多个深度的输入分布和功能。一套矩阵既要处理较浅的表征,又要处理经过一轮变换后的较深表征,可能形成优化冲突。作者因此把“共享还是不共享”的离散选择改成“共享主干,加多少深度专用容量”的连续折中。
与 Universal Transformer、ALBERT 等相关工作的关系是:循环和层间共享本身已有先例;本文的核心推进是从现成预训练 LLM 转换、初始化共享层及其低秩残差,并研究这种结构适合什么推理调度方式。论文也讨论潜在的 recurrent-depth reasoning,但没有用数学推理、代码生成或循环次数外推实验验证这些展望。见 Sec.4–5,pp.13–15。
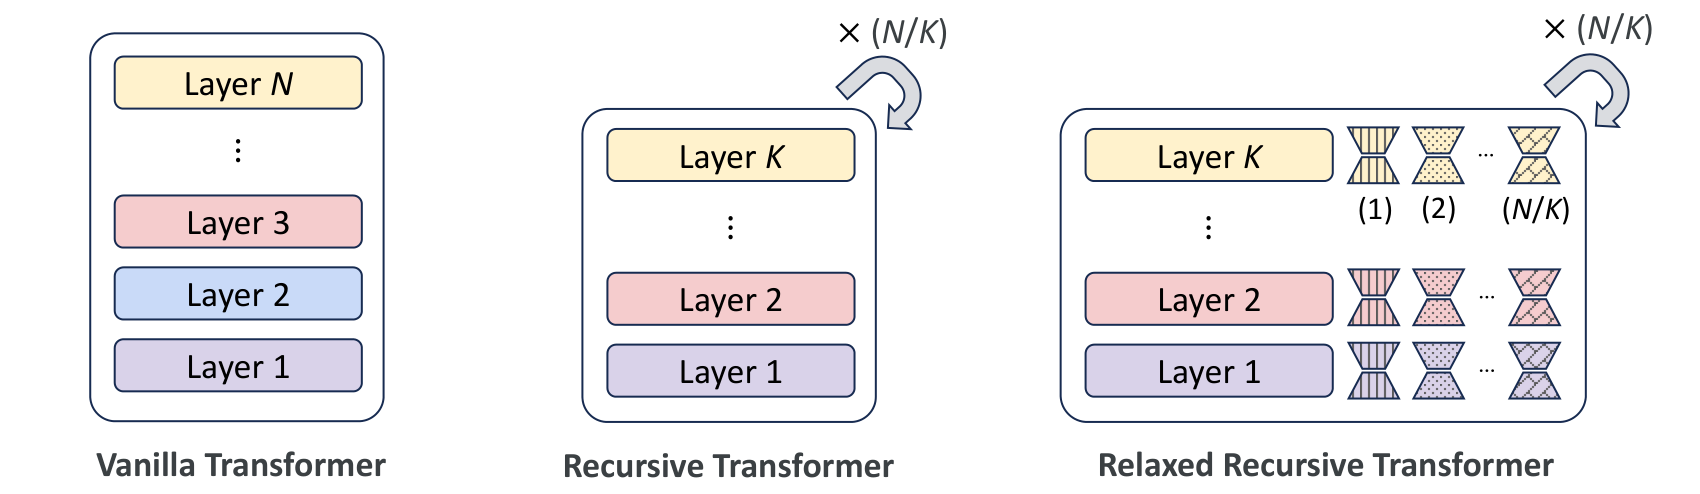
原文 Fig.1,PDF p.2,直接复用作者矢量图并生成 PNG。由左到右分别为独立层、共享层块重复执行、共享层块附加各轮专用 LoRA。图中 $N/K$ 对应正文循环次数 $B$;“只保存 $K$ 层”并不表示只计算 $K$ 层。
二:方法——共享主干、残差初始化与深度调度
2.1 记号与循环计算
| 记号 | 含义 |
|---|---|
| $L$ | 原模型及完整展开后的总深度 |
| $B$ | 共享块的循环次数,要求整除 $L$ |
| $K=L/B$ | 实际存储的独立层数;本文讲解中使用的简写 |
| $\ell$、$t$ | 展开后的层深与自回归时间步 |
| $\Phi_\ell$ | 原模型第 $\ell$ 层参数 |
| $\Phi'_j$ | 共享块中第 $j$ 层参数 |
| $\Delta\Phi'_\ell$ | 深度 $\ell$ 独有的 LoRA 参数 |
| $r$ | 某个 LoRA 矩阵分解的秩 |
普通模型按原文 Eq.(1) 计算:
其中 $f$ 还隐含了自注意力需要的上下文和缓存,不能理解成仅依赖当前 token 的无状态函数。令
严格循环模型将其替换为原文 Eq.(2):
例如 Gemma 2B 有 18 层,$B=2$ 时保存 9 个独立层,顺序执行这 9 层两次。共享覆盖 Transformer 块内的线性权重及 RMSNorm 等可训练参数。embedding 与输出头不因这种层块共享而减半。见 Sec.2.1–2.2,p.3。
本文采用 CYCLE:$[1,2,3,1,2,3]$。附录 B 还说明了 SEQUENCE:$[1,1,2,2,3,3]$ 和 CYCLE(REV):$[1,2,3,3,2,1]$。作者选择 CYCLE 的主要理由是它自然形成可用于早退和跨深度合批的重复块;本文没有对三种策略做全面的大模型等预算竞赛。见 p.25,Fig.B.1。
2.2 共享权重怎样从原模型得到?
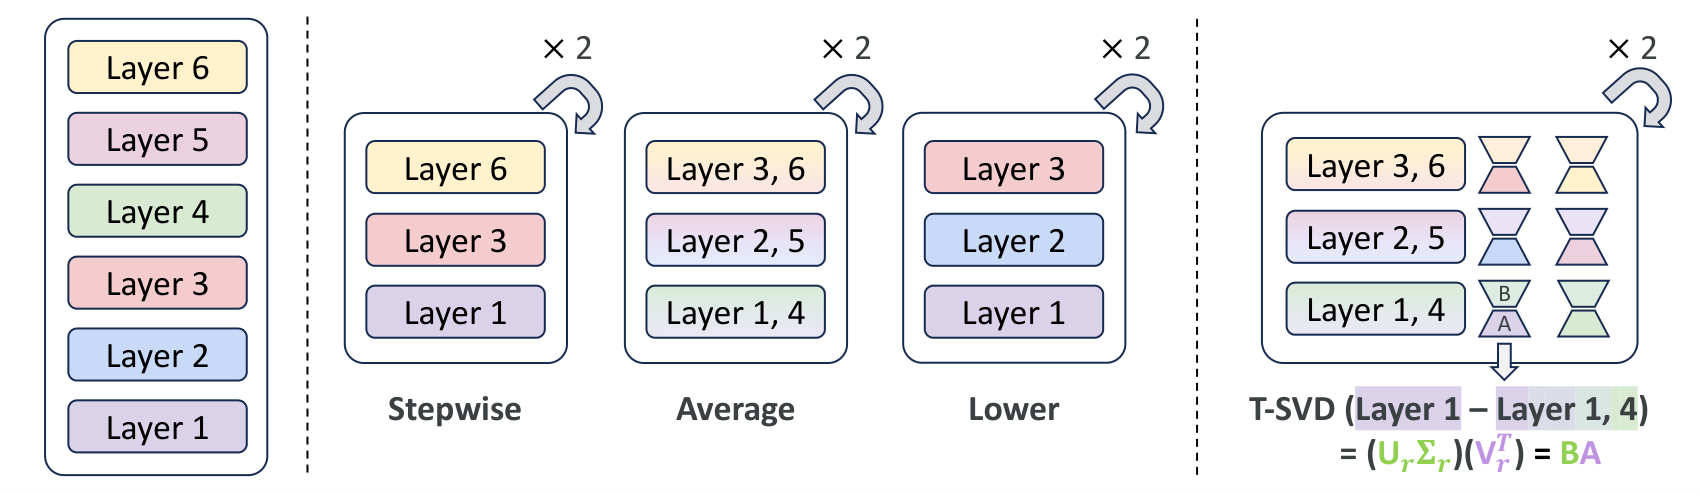
原文 Fig.2,PDF p.4。图中的 6 层模型压成 3 个独立层、循环两次;层号表示初始化取自原模型的哪个位置。
| 初始化 | 操作 | 原文 6 层示例 | 直觉 |
|---|---|---|---|
| Stepwise | 间隔选层,保留首尾层的来源 | $[W_1,W_3,W_6]$ | 保留预训练深度路径中的代表变换 |
| Average | 对循环对应位置的原始权重平均 | $[(W_1+W_4)/2,(W_2+W_5)/2,(W_3+W_6)/2]$ | 找一个各深度共用的中心 |
| Lower | 直接用原模型较低层 | $[W_1,W_2,W_3]$ | 保留输入侧的连续层块 |
“保留首尾层”说的是初始化时选取的来源,这些权重之后仍属于循环块,并不是额外留在循环外的两个独立层。Stepwise 对严格循环模型通常更好;Average 与后面的残差 LoRA 更匹配。
2.3 每个展开深度拥有自己的 LoRA
原文 Eq.(3) 将各深度差异加入共享层:
对一个输入维度为 $k$、输出维度为 $d$ 的线性变换:
这里矩阵 $B_\ell$ 与循环次数 $B$ 是不同概念。适配器附在线性权重上,包括注意力投影和 FFN;循环同一共享层时,根据展开深度选不同的适配器。共享主干和 LoRA 一起训练,并非通常“冻结底座、只调 LoRA”的参数高效微调。见 Sec.2.3,pp.4–5。
2.4 SVD 初始化拟合的是“原权重减共享权重”
对每个深度,计算残差:
做截断奇异值分解,对应原文 Eq.(4):
于是初始化时就有:
这解释了为什么先前各层学习到的差异不会全部被平均操作抹掉。它也提供了一个 rank 旋钮:$r=0$ 回到严格循环;增大 $r$ 可以保留更多残差信息。残差恰为零时,附录 C 使用通常的 LoRA 零增量初始化,即 $A$ 随机、$B$ 为零,而不是两者同时设零。
**教学补充,区别于论文报告的实验:**截断 SVD 最小化给定秩下的矩阵 Frobenius 重构误差:
但这不保证网络输出误差、继续训练后的 loss 或任务准确率随 $r$ 单调改善。激活分布、层间组合和共享参数共同更新都影响结果;Stepwise 的 rank 消融恰好展示了这种区别。
同样,“full rank 恢复原模型”应谨慎理解:Eq.(5) 直接保证的是相应线性矩阵的恢复。共享的归一化参数等仍可能不同,整个网络逐点等价还需要额外条件;高秩分解也未必继续节省存储。见 Sec.2.3 p.5、App.C p.26。
2.5 参数、FLOPs、缓存是三种不同的成本
下面是根据架构作的成本解释,不是作者额外测得的缩放定律。忽略少量特殊参数,若原模型层块参数为 $P_{\rm blocks}$、embedding 和输出头参数为 $P_{\rm emb}$:
第二个求和遍历全部展开深度 $\ell$ 及添加 LoRA 的矩阵 $m$。因此 LoRA 增量是按实际深度付费,不能再除一次 $B$。
- 不早退时仍执行 $L$ 层;严格共享不自动把计算次数减半。
- 不同深度输入的 hidden states 不同,即便使用同一 $W_K,W_V$,得到的 KV states 通常仍不同;权重共享不等于缓存共享。
- 若把每层 LoRA 都折叠进独立完整矩阵,推理算子可能简化,但会重新物化多份大权重,损害原来的存储优势。
- 权重更少是否允许更大 batch,取决于当时瓶颈究竟是参数、缓存、激活还是其他缓冲区。
2.6 训练链条与两种蒸馏
完整流程可以按以下顺序理解:
- 从预训练全尺寸模型选择/平均共享层。
- 若使用 relaxed 版本,以每个展开深度的原始权重为目标初始化 LoRA。
- 在 SlimPajama 上继续训练 15B 或 60B tokens,更新所有参数。
- 最终精度实验加入全尺寸教师的在线知识蒸馏,选用 forward KL。
- 若研究早退,在上述模型上额外训练 15B tokens,使各循环末端能预测 token。
第三、四步的教师是先在 SlimPajama 继续训练了 15B tokens 的全尺寸模型。一般形式的 forward KL 为 $D_{\rm KL}(p_T\|p_S)$,用教师分布约束学生分布;此式为概念解释。论文未给足所有蒸馏温度、混合系数和实现细节,不应自行补成一套确定配置。60B 是该组继续训练预算;早退阶段另加 15B,才形成对应的 75B 后处理链条。见 Sec.3.6、App.I,pp.10–11、38–39。
早退阶段还使用模型自身最终出口的停止梯度输出监督中间出口,属于 self-distillation,与前面的外部全尺寸教师不同。
2.7 连续深度批处理怎样工作?
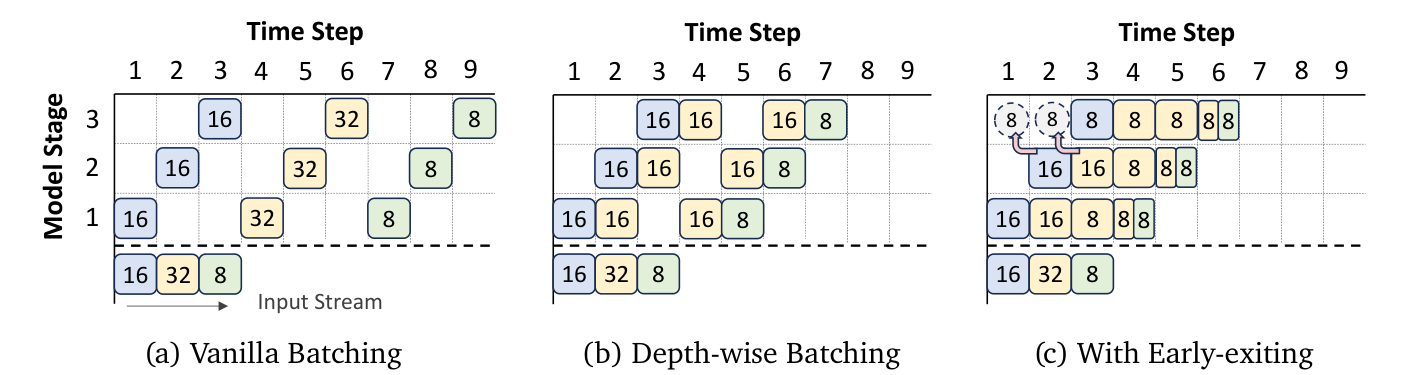
原文 Fig.3,PDF p.5,保留三个面板与坐标的准确裁切。横轴为调度时间步,纵轴为模型阶段,颜色区分到达批次,框内数字是样本数;最大 batch 为 32。
普通模型不同深度使用不同矩阵,难把正在第二阶段的 16 个样本与刚进入第一阶段的 16 个样本放进同一主干计算。循环模型每轮执行同一块,可以把它们组合起来:一个样本走第 2 轮,另一个走第 1 轮,但共享块内当前位置相同。若样本早退,释放的槽位可立即装入下一 token 或其他排队请求。
适用条件是同一共享块操作的对齐,不是任意两个深度都能合成一次矩阵运算。Relaxed 模型还要根据各样本所处轮次选择不同 LoRA;论文通过拼接 LoRA 权重并行执行,代价是冗余计算,尚未采用专门优化的服务内核。见 Sec.2.4、App.K,pp.5–6、44–45。
三:实验——先分清各组比较在检验什么
3.1 模型与训练配置
| 原始模型 | 层数 | 非 embedding / embedding 参数 | 注意力 | 起始检查点预训练量 |
|---|---|---|---|---|
| Gemma 2B | 18 | Table 1:1.98B / 0.52B | MQA,1 个 KV head | 3T tokens |
| TinyLlama 1.1B | 22 | 0.97B / 0.13B | GQA,4 个 KV heads | 105B,早期检查点 |
| Pythia 1B | 16 | 0.81B / 0.21B | MHA,8 个 KV heads | 300B |
来源:Table 1,p.6。Gemma 的后续结果表把非 embedding 参数记作 1.99B;下文数值比较沿用各结果表口径,不把 1.98B/1.99B 的细小差异解释成结构变化。
共同继续训练配置(App.E,pp.27–28):上下文 2048,batch 约 2M tokens;AdamW,学习率 $2\times10^{-4}$,cosine schedule;15B / 60B 训练分别 warmup 200 / 800 steps;8 张 H100,DeepSpeed ZeRO 与混合精度。默认 $B=2$,Gemma 另测 $B=3$。早退后训练基本沿用这些配置,另外消耗 15B tokens。小规模 Pythia 410M/160M 的附录实验使用 Pile,不能与主实验的 SlimPajama 混为一组。
3.2 指标与基线
准确率来自 LAMBADA、HellaSwag、PIQA、WinoGrande、ARC-easy、ARC-challenge、OpenBookQA 七个任务的平均,越高越好;它不是将所有测试样本合起来的总体准确率。除 LAMBADA 与 WinoGrande,作者说明按候选答案字节长度归一化打分。使用 LM Evaluation Harness;论文说遵循框架默认 shots,但未逐项给出 shots 数和完整版本配置。
困惑度(PPL)在 SlimPajama、RedPajama、PG19 上评估,越低越好。它衡量语言建模,不等价于七任务准确率。
| 比较对象 | 检验问题 | 需要保留的条件 |
|---|---|---|
| 原始全尺寸检查点 | 能保留多少原模型能力? | Gemma 原始值 61.7% |
| 同预算继续训练的全尺寸模型 | 在相同新数据分布下,压缩损失多大? | Gemma 15B 后 60.1%,60B 后 58.6% |
| 缩小的非循环模型,从零训练 | 有预训练起点的循环转换是否实用? | 与转换模型参数量相近,但历史预训练不同 |
| 随机初始化的循环模型 | 仅增加循环结构是否足够? | 分离“有循环”与“继承预训练”的作用 |
| 预训练选层、但不循环的模型 | 循环本身是否在继承权重之外提供增益? | 附录 F.3,Pythia 410M |
Gemma 在 SlimPajama 继续训练后七任务平均值下降,因此作者主要采用“继续训练后的全尺寸模型”作为目标。数据质量/分布差异是作者解释,实验未单独辨认所有因果因素。TinyLlama 采用 105B 的欠训练早期检查点作主要参照;并不是后来训练充分的 TinyLlama 3T,后者在 Table D.1 为 53.13%。见 Sec.3.2 p.7、App.D p.26。
3.3 速度协议与精度协议不同
速度分析在 A100 40GB 上使用 dummy 权重和输入测组件耗时,然后用 20K 个排队样本模拟 token 早退路径。主要配置为 prefix 512、decode 2048;另一配置为 16GB 显存限制、prefix 64、decode 256。轨迹来自三个语言建模测试集,假设它们是模型生成文本。
oracle 选择最早一个与最终出口预测相同的循环作为退出点。这是用于估计潜力的事后规则,真实部署时无法免费知道未来最终预测。少样本任务准确率与这些语料的吞吐轨迹不是同一实验,因此不能把表中的准确率直接称为“动态早退系统的生成质量”。见 Sec.3.8、App.E/K。
四:结果——按原文实验问题逐组解读
4.1 主结果:精度可沿参数预算调节,但目标线要读对
下表为 Gemma,$B=2$。准确率为七任务均值;参数为非 embedding 参数。最终模型列使用 60B tokens 与外部教师蒸馏,尚未进入额外的早退训练。
| 模型 | N-emb | 15B,无 KD | 60B,有 KD |
|---|---|---|---|
| 缩小非循环,从零训练 | 0.99B | 38.2% | 44.9% |
| 严格循环,Stepwise | 0.99B | 51.7% | 54.9% |
| Relaxed,Average+SVD,r=64 | 1.07B | 52.1% | 55.8% |
| Relaxed,Average+SVD,r=128 | 1.15B | 52.5% | 56.6% |
| Relaxed,Average+SVD,r=256 | 1.30B | 54.2% | 57.0% |
| Relaxed,Average+SVD,r=512 | 1.60B | 55.5% | 58.4% |
来源:Table I.2,p.39;主文 Fig.4,p.8。对应全尺寸基线为 1.99B N-emb:原始 61.7%,15B 后 60.1%,60B 后 58.6%(Table 2,p.7;全尺寸继续训练未加表中学生的 KD)。
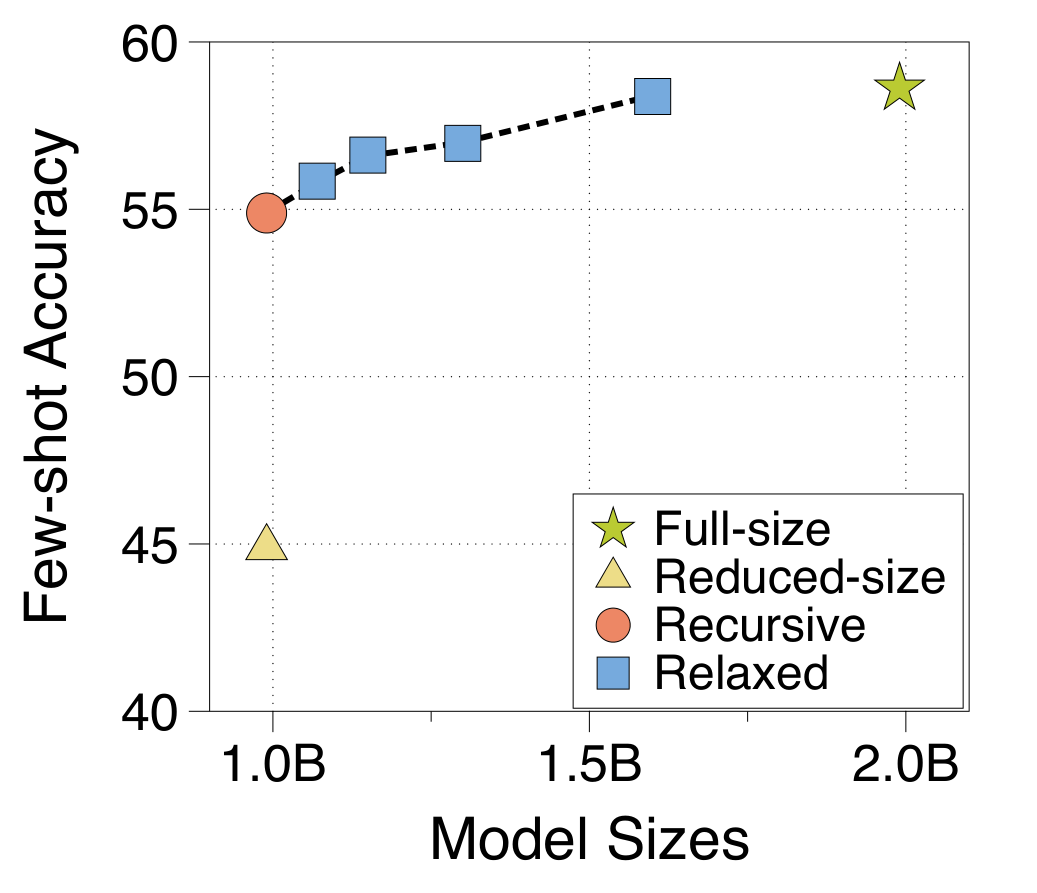
原文 Fig.4a,PDF p.8,作者单面板原图。横轴为非 embedding 模型规模,纵轴为平均 few-shot accuracy;星形为全尺寸目标,三角为缩小基线,圆点为严格循环,方形为不同 rank 的 relaxed 模型。星形在约 58.6%,不是原始 61.7%。
由表中数值可直接算出:
- 15B 时严格循环比同尺寸从零非循环高 13.5 个百分点;按均值计算的错误率相对减少约 21.8%,不是准确率提高 22 个百分点。
- 60B+KD 时严格循环比同尺寸非循环蒸馏基线高 10.0 个百分点。
- r=512 比同预算全尺寸低 0.2 个百分点,但比未继续训练的原始检查点低 3.3 个百分点。
- 严格循环的 0.99B N-emb 加上约 0.52B embedding/head,合计约 1.51B;原模型约 2.51B,总参数减少约 40%。r=512 则约 2.12B,总参数减少约 16%。这是依据表中四舍五入参数的估算。
因此,主文 p.8 将 58.6% 简称为原始模型表现,容易让人误读;按 Table 2 与 Table I.2 应表述为原始预训练模型经过同预算继续训练后的基线。
其他架构也有效,但边界不同。Table I.2 中,TinyLlama 严格循环 44.3%、r=512 为45.9%,高于起始 105B 检查点的43.3%,却低于全尺寸再训练60B后的47.4%,更低于3T检查点的53.13%。Pythia 严格循环45.2%、r=512为47.0%,全尺寸60B目标48.6%。不能将“超过起始 TinyLlama”泛化为超过充分训练的同系列模型。
4.2 初始化:预训练知识是主要增益来源,循环还有独立作用
Gemma,15B tokens,0.99B N-emb,$B=2$(Table F.1,p.30):
| 初始化/模型 | 平均准确率 |
|---|---|
| 非循环,从零训练 | 38.2% |
| 循环,随机初始化 | 37.6% |
| 循环,Lower | 47.1% |
| 循环,Average | 46.7% |
| 循环,Stepwise | 51.7% |
Stepwise 相比随机循环高14.1个百分点。单纯把随机模型变成循环,并没有在这里超过从零非循环模型。它说明“借到预训练知识”不可从贡献中省略。
附录 F.3 的 Pythia 410M 更直接分离两种因素:在相同150M N-emb、15B Pile tokens下,随机非循环37.63%,随机循环38.02%,预训练选层非循环40.35%,预训练选层循环41.54%。继承权重后,循环进一步提高1.19个百分点;但循环版本计算更深,这不是等 FLOPs 比较。见 p.32,Table F.3。
更细消融见 App.F pp.28–32:Gemma 的 Stepwise 保留首尾来源较好;Average 中归一化权重平均或选取单层差异较小,某些模型将 norm 设零则严重退化。Stepwise 是总体上可靠的选择,并非所有准确率列都严格第一:Pythia 1B 的 Lower 43.6% 略高于 Stepwise 43.5%,Pythia 160M 也有小幅逆序;其 PPL 更支持 Stepwise 的稳定优势。论文未报告支持这些微小差异的多种子显著性证据。
4.3 放松共享:初始化与 rank 必须一起选
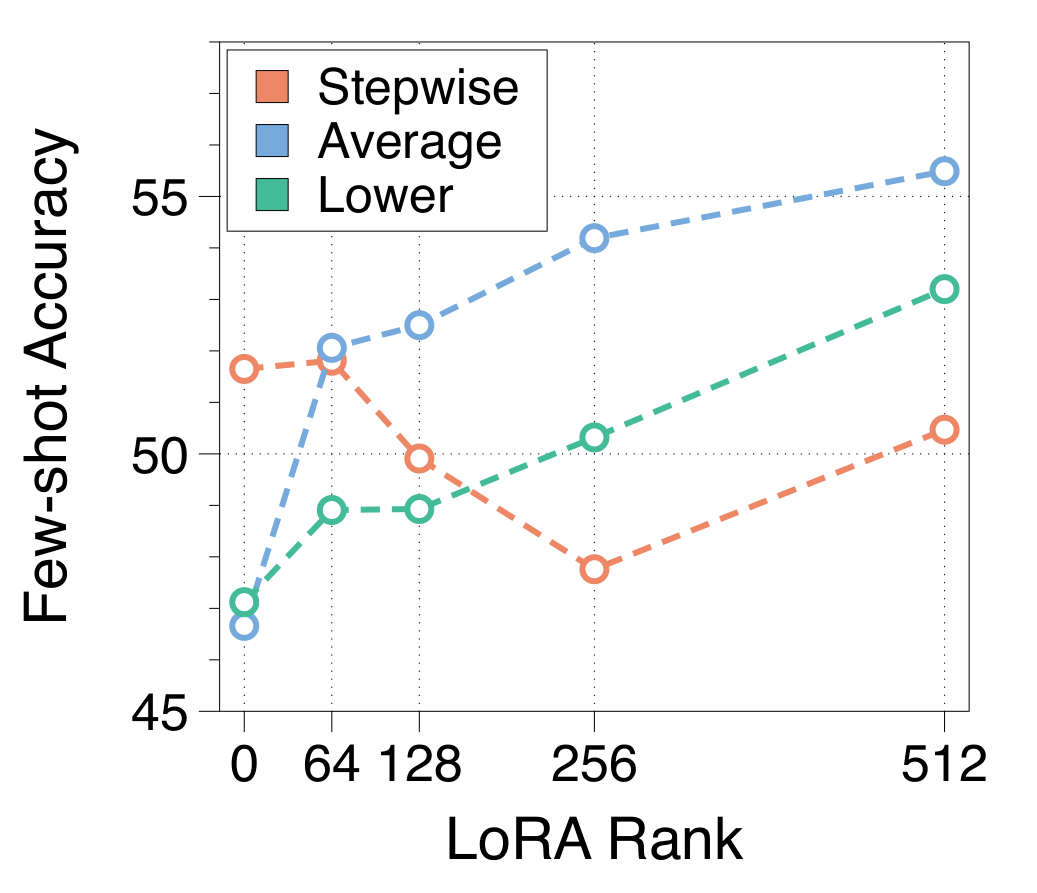
原文 Fig.7a,PDF p.11。横轴为 LoRA rank,纵轴为七任务均值;蓝色 Average、橙色 Stepwise、绿色 Lower,条件为 Gemma 15B 继续训练。Average 随 rank 增加总体改善,Stepwise 在中等 rank 出现明显低谷。
Table G.2(p.36)的关键对照:
| Gemma 配置 | 无 LoRA | r=512,零增量初始化 | r=512,SVD |
|---|---|---|---|
| Stepwise | 51.7% | 53.1% | 50.5% |
| Average | 46.7% | 49.0% | 55.5% |
| Lower | 47.1% | 49.5% | 53.2% |
Average+SVD 比 Average+Zero 高 6.5 个百分点;但 Stepwise+SVD 比 Stepwise+Zero 低2.6个百分点。不能只说“SVD 必然优于零初始化”。
作者解释是:Average 主干与各对应深度残差更适合由有限秩近似,Stepwise 则可能把对另一个深度不合适的部分变化引入网络。这个解释与结果相容,但论文没有完整的残差奇异值谱或因果机制实验加以证明。
教学推导:$B=2$ 时若 $W'=(W_1+W_2)/2$,两份残差恰为 $\pm(W_1-W_2)/2$。它给两个深度以对称的重构目标,而不天然保证差矩阵本身低秩。增大截断秩时矩阵重构误差必然不增;图上的非单调准确率反映的是网络和优化行为。
分模块 rank 实验(Table G.1,p.35)中,Gemma 从所有矩阵r=256的54.2%,改为FFN r=128后53.3%,参数1.30B→1.18B;只把KV r降到128则54.1%,参数1.29B。FFN降秩同时削掉更多参数,因此不能单独据此断言单位参数的 FFN 重要性更高。
替代方法 prefix relaxation(App.H,p.37)更便于并行,但增益较小。例如同为约1.07B N-emb、Average初始化,prefix版本47.6%,SVD LoRA r=64为52.1%。这一对照支持有效恢复预训练层差异的价值,未证明所有 prefix 设计都弱于 LoRA。
4.4 更长训练与外部蒸馏都有效
在严格循环 Gemma 的受控消融中(Table I.1,p.38):
| 预算与目标 | 平均准确率 | 相对15B无KD |
|---|---|---|
| 15B,无 KD | 51.7% | — |
| 60B,无 KD | 53.4% | +1.7个百分点 |
| 15B,forward KL | 53.4% | +1.7个百分点 |
| 15B,reverse KL | 53.3% | +1.6个百分点 |
| 15B,JSD | 52.9% | +1.2个百分点 |
| 15B,TVD | 53.0% | +1.3个百分点 |
| 60B,forward KL | 54.9% | +3.2个百分点 |
最后一行来自 Table I.2。两个单独的1.7不能直接相加,组合后实际提高3.2。Gemma r=128从52.5%到56.6%,提高4.1个百分点,这是正文重点报告的改善;附录中的严格循环 $B=3$ 还从47.8%到53.3%,提高5.5个百分点。因此“最多4.1”是正文所强调配置的表述,不是所有附录配置的全局最大值。
从成本角度,15B/60B只占Gemma原始3T的0.5%/2%,但模型已经继承原预训练成本,教师在线前向和教师继续训练也有成本。结果支持“低增量成本转换”,不支持“用2%训练成本从零得到原模型”。
4.5 早退训练:保住最终出口比同时强化所有出口更难
通常的多出口加权 CE:
对两轮模型给中间出口1/3、最终出口2/3。作者发现这样强调中间出口会损害最终表现,改用最终系数1、中间系数0.1的 aggressive 策略,再加入来自停止梯度最终输出的自蒸馏。论文没有在正文给出完整自蒸馏损失的所有系数,不在这里补造。
15B uptraining后的严格循环Gemma,再做15B早退训练,Table 3 p.11:
| 后训练方案 | 最终出口准确率 | 第一轮准确率 |
|---|---|---|
| Weighted CE | 50.5% | 49.8% |
| Aggressive 0.1 | 52.5% | 47.1% |
| Weighted CE + self-KD | 50.4% | 49.9% |
| Aggressive 0.1 + self-KD | 52.6% | 48.0% |
最终与中间差距4.6个百分点;这是每个出口固定退出的少样本评价,不是实际动态早退算法的质量损失。
更重要的后续结果在 Table J.2 p.42:对最终60B+KD模型做额外15B早退训练后,严格循环的最终输出从54.9%降至54.0%,r=512从58.4%降至56.2%。对应第一轮分别48.8%与41.7%。放松共享改善最终精度,却可能削弱中间出口的直接可读性。
因此,应把主结果58.4%与速度实验56.2%的模型状态分开。附录 J 还显示:从一开始联合训练出口比后训练更差;冻结主干只给分类头加LoRA效果弱;重用或更换SlimPajama tokens在所试设置中差异有限。$B=3$ relaxed 模型因显存不足未使用最终输出KD,不能假设所有早退配置都完全一致。见 pp.40–43。
4.6 吞吐:CDB 的结构价值与模拟假设同时成立
主文 Fig.8 / Table K.2(pp.12、47)的 Gemma 结果如下,均为A100 40GB、prefix512/decode2048的模拟;吞吐是三个语料的平均tokens/s,仅计Transformer块。
| 模型与批处理 | 早退训练后最终准确率 | 模拟吞吐 | 相对普通批处理 | 相对CSB |
|---|---|---|---|---|
| 全尺寸,无连续批处理 | 57.3% | 1080 | 1.00× | 0.71× |
| 全尺寸,连续序列批处理CSB | 57.3% | 1528 | 1.41× | 1.00× |
| 严格循环B=2,CDB+oracle | 54.0% | 2877 | 2.66× | 1.88× |
| Relaxed r=64,CDB+oracle | 54.0% | 2157 | 2.00× | 1.41× |
| Relaxed r=256,CDB+oracle | 55.2% | 1921 | 1.78× | 1.26× |
| Relaxed r=512,CDB+oracle | 56.2% | 1719 | 1.59× | 1.13× |
“2.66倍”比较的是无CSB的全尺寸Gemma。相对已采用连续序列批处理的基线是1.88倍;r=512仅为1.13倍。这也不是相同质量下的纯调度对照,因为模型和训练后精度都不同。附录B=3严格循环报告2.74倍,相应最终准确率为51.9%。
作者提到相对Pythia接近4倍:Table K.2的普通Pythia平均吞吐约770,2877/770约3.74。这是跨模型比较,Gemma与Pythia的MQA/MHA、KV大小和结构都不同,不能把倍率归结为循环单一因素。
App.K p.45明确列出模拟误差来源:
- 使用真实语料假装模型生成轨迹,尚未验证其与自由生成的早退分布一致。
- oracle不用承担现实置信度判断的失误与计算开销。
- 最终吞吐只统计Transformer块,排除了embedding/分类头及其调度与同步成本。
- 提前退出token在后续深度仍可能需要补KV,以支持未来token注意力;模拟计入了缓存内存,但没计入补算时间。
此外,短上下文时LoRA相对开销更突出。作者在Table K.4(p.49)给出16GB限制实验,但该表存在值得保留的核验问题:以Gemma B=2为例,普通模型三列吞吐为1740/3059/4796,循环行为3159/3050/2421,简单均值之比约0.90,却标注2.50×;循环行还与Table K.2重复。已同时核对PDF与作者TeX,无法仅依据论文消除这一不一致。因此本笔记采用Fig.8/Table K.2支持主吞吐数值,不从K.4推导额外的可靠短上下文倍率。
五:结论——哪些贡献可信,哪些问题仍开放
5.1 最可靠的贡献
本文提供了一条实用的预训练模型转换路线:严格共享时用Stepwise继承代表层;需要更多容量时采用Average主干与SVD残差LoRA;继续训练后在参数量与能力间得到多档选择。它用较充分的消融说明,好的预训练起点、共享初始化和增量初始化需要联合考虑。
第二个贡献是提出一种架构与调度之间的联系:重复使用同一层块,让不同循环轮次的token能在共同主干上合批。这是有价值的服务系统设计方向;现有证据支持其潜力,尚不足以兑现为现成的端到端吞吐保证。
5.2 主要局限与容易混淆的说法
| 容易产生的理解 | 原文证据允许的说法 |
|---|---|
| 减半参数而没有能力损失 | 严格循环约减半N-emb,能力仍下降;高rank恢复较多能力,节省参数也较少 |
| 用60B tokens追平3T训练 | 继承3T预训练权重后再训练60B;追平的是继续训练后的目标线 |
| 比TinyLlama 1.1B都好 | 主要比较105B早期检查点,非充分训练3T检查点 |
| SVD初始化总更好 | Average/Lower受益明显,Stepwise有反例 |
| rank更大,任务准确率必然更高 | 矩阵重构误差不增;网络准确率可能非单调 |
| 权重共享自然带来KV共享 | 不同深度的hidden states不同,仍需处理各深度KV |
| 论文实现了2–3倍实际服务加速 | oracle轨迹+组件计时的假想吞吐,成本统计不完整 |
| 参数更少意味着训练计算更少 | 不早退时仍计算完整深度,且KD有教师成本 |
主要模型规模仍为约1B–2B,另有更小Pythia消融;没有7B以上验证。任务主要是语言建模和七项少样本评价,未覆盖现代复杂推理、代码、多语种或长上下文质量。多种子方差、统计检验、完整wall-clock训练成本及所有可复现超参数未充分报告,因此不应把0.1–0.2个百分点差异视作确定优势。
5.3 由本次阅读得到的后续研究问题
以下是分析建议,不是论文已经证明的结论:
- 在保存同等总参数、训练FLOPs和teacher成本的条件下,循环转换与选层后非循环继续训练如何比较?
- 能否直接优化“共享中心+低秩残差”,使任务敏感的重构目标优于单独的矩阵SVD?
- 如何训练relaxed模型中间出口,同时避免最终出口下降,特别是B=3及以上?
- 真实置信度门控、补KV、多LoRA内核和端到端连续调度全部加入后,相对成熟CSB服务还能保留多少收益?
- 总参数、活跃计算、KV内存、平均吞吐和尾延迟分别在什么请求分布下成为瓶颈?
若用于组会,最值得讨论的不是单个倍率,而是:模型可由一套共享变换加上深度残差来表示;这种表示节省存储,也改变了可采用的推理调度方式,但精度、早退可用性和算子开销必须联合评估。
原始材料与交付说明
本次使用同一版本v3的PDF与成功下载的作者TeX,主入口为googledeepmind.tex,实际阅读其section下正文/附录以及引用的tables、figures文件。图1、图2、图4a、图7a直接复用作者PDF图件;图3从最终PDF准确裁切;图件来源清单保留文件名、页码和裁切坐标。没有以生成式图片替代实验结果。
英文幻灯片按约25分钟主讲组织,另附备份页;中文笔记保留更完整的消融、公式解释与证据限定。所有表格数字来自本版本,文中的百分点、比率及参数节省估算均明确区分于作者直接报告值。