Value Residual Learning:中文精读笔记
- 作者:Zhanchao Zhou、Tianyi Wu、Zhiyun Jiang、Fares Obeid、Zhenzhong Lan。
- 论文版本:arXiv:2410.17897v5,2025-06-08 修订;初稿提交于 2024-10-23。
- 获取与研读日期:2026-09-11;本次成品为
v5/r1。 - 原始材料:本地论文 PDF、作者主 TeX、作者
acl_latex.bbl与原始 PDF 图件。源码状态为available,身份、版本与 PDF 一致;主 TeX 无外部正文input/include。 - 阅读范围:正文 Sec. 1–5、Limitations,以及附录 A.1–A.3,包括全部实质性结果与训练配置。参考文献用于核对方法身份,未逐篇研读所引论文。源码中的注释掉的旧表格不作为 v5 结果。
- 定位约定:下文“p.”均指从 1 开始的 PDF 物理页码,共 16 页;该 PDF 没有连续显示的印刷页码。本文是分析笔记,不是全文翻译,也未运行作者训练代码。
论文总览
主张与核心操作:深层 Transformer 即使保留 hidden-state residual,也未必能有效利用最初的 token 信息。ResFormer 把首层 value $\mathbf V_1$ 直接送到后续层,与该层自己的 value 混合,然后一起乘以当前层的 attention 矩阵。这样,深层可以用当前的语义选择关系重新读取最初的 token 内容。进一步,SVFormer 让所有层只使用 $\mathbf V_1$,每层仍独立生成 query 和 key,从而减少 value 缓存。
最有证据支持的结果:在论文的语言模型预训练设置中,ResFormer 的验证损失与下游平均准确率优于 vanilla Transformer;468M、20B tokens 的 Learnable ResFormer 平均准确率从 40.6% 提高到 42.3%,即 +1.7 个百分点。作者根据 scaling 曲线分别报告等损失时约少用 16.11% 参数或 20.3% 训练 tokens。SVFormer 的缓存优势来自结构,但质量收益有明显条件:2,048 长度时损失更差,64,000 长度和报告的训练预算下可更好。(Sec. 4.2、4.6,pp. 4–5、9,Fig. 2、Tables 2、8)
阅读时应保留的区分:ResFormer 的混合残差主要改善建模;SVFormer 的完全共享主要改善 KV 存储。前者不是参数剪枝,后者不是无条件无损压缩。首层内容旁路是否是改善效果的唯一原因,论文没有给出理论证明。
结构地图
| 原文章节 | 论证作用 | PDF 位置与证据 |
|---|---|---|
| 1 Introduction | 局部信息传播问题,提出两个变体 | pp. 1–2;Fig. 1 |
| 2.1 Shortcut Connections | 对比 hidden residual、DenseFormer、NeuTRENO | pp. 2–3 |
| 2.2 KV cache compressing | 对比 head 与 layer 维度的共享 | p. 3 |
| 3.1 Preliminary | 基本符号、对照方法公式 | p. 3;Eqs. (1)–(4) |
| 3.2 ResFormer | value 混合、固定/可学习/稀疏/稠密变体 | p. 3;Eq. (5) |
| 3.3 SVFormer | 全层共享首层 value | pp. 3–4;Table 1 |
| 4.1 Setting | 数据、架构、优化与评估 | pp. 4–5 |
| 4.2 ResFormer vs. NeuTRENO, DenseFormer | scaling、下游与变体比较 | pp. 4–5;Figs. 2–3、Tables 2–3 |
| 4.3 Truly Better or Just Faster? | 学习率、梯度路径解释的控制实验 | pp. 5–6;Fig. 4 |
| 4.4 Ablation Study of Value Residual | 从哪里取、送到哪里、为何不直接改 hidden/Q/K/A | pp. 6–8;Figs. 5–7、Tables 4–7 |
| 4.5 Post-Analysis of ResFormer | value 相似度、模块移除与 PCA | pp. 8–9;Figs. 8–9 |
| 4.6 SVFormer vs. GQA,CLA | KV 压缩比较、长度与学习率条件 | p. 9;Tables 8–9、Figs. 10–11 |
| 5 Conclusion / Limitations | 结论及参数选择、规模限制 | p. 9 |
| Ethics Statement / Acknowledgments / References | 使用声明与文献 | pp. 10–12 |
| A.1 Attention pattern analysis | attention sinks、value drains、稀疏与重缩放 | pp. 12–14;Figs. 12–15、Tables 10–11 |
| A.2 Pre-train Dataset | 7 域数据比例 | pp. 14–15;Table 12 |
| A.3 Training Details | 长度、批量与模型尺寸 | pp. 14–16;Tables 13–14 |
一:动机——残差保留了路径,是否也保留了可用信息?
1.1 从“能到达”到“能被使用”
初始 embedding 主要表示每个 token 自身的信息;经过 attention,hidden states 融合上下文。普通残差累加保证早期信息存在直接传播路径,但并不保证后续层能从不断叠加的表示中有效提取它。作者把这个问题与过度平滑(over-smoothing)联系起来:不同 token 的表示越来越相似,局部细节可能被序列级语义淹没。(Sec. 1,pp. 1–2)
作者的进一步假设是,直接往深层 hidden states 加回初始 embedding,可能同时改变下一层的 Q、K、V,干扰已经形成的抽象语义 attention 分布。若只向 value 端补充原始内容,则可以沿用当前层的 attention 来决定读取哪些 token。这里“较少干扰”的论点是架构直觉,后文消融提供支持,但并非 Q/K 在整个网络训练中完全不受影响。
1.2 三种连接位置的区别
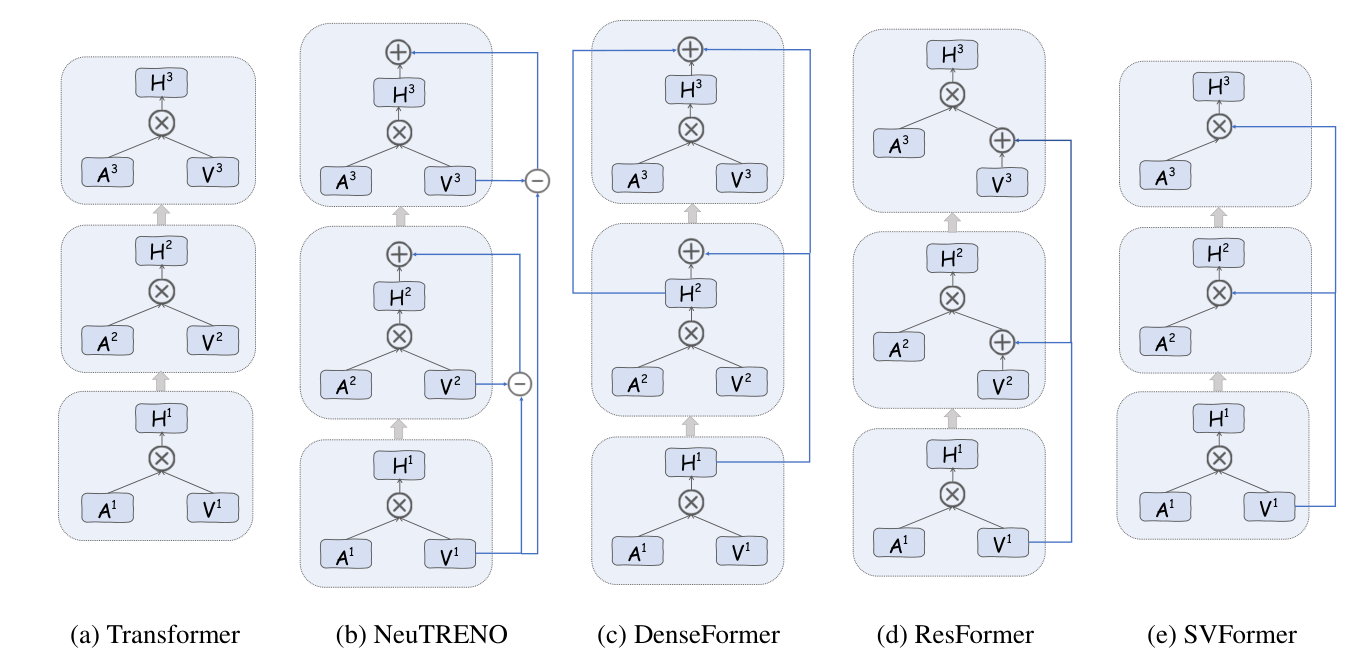
来源:原 Fig. 1,PDF p. 2,准确裁切,保留五个面板标签。箭头从下向上表示层次推进;蓝线为额外连接;图中省略 MLP、归一化等,不能当成完整网络实现。
| 方法 | 补充信息进入哪里 | 当前层如何使用首层信息 |
|---|---|---|
| DenseFormer | 层输出 hidden state | 学习组合历史 hidden,影响后续全部 Q/K/V |
| NeuTRENO | attention 输出 | 加上 $\lambda_n(\mathbf V_1-\mathbf V_n)$,该差值未经过当前 attention 聚合 |
| ResFormer | attention 输入的 value | 混合 $\mathbf V_1$ 与当前 value,再使用当前 $\mathbf A_n$ |
| SVFormer | attention 输入的 value | 只保留 $\mathbf V_1$;各层 $\mathbf A_n$ 仍不同 |
对应 Sec. 3,p. 3,Eqs. (3)–(5)。区别的重点是连接位置和映射方式,而非仅仅增加一条残差线。
二:方法——用当前层的选择关系读取首层内容
2.1 符号与计算流程
以下沿用原符号,并额外用 $\widetilde{\mathbf V}_n$ 表示混合后的 value,避免原 Eq. (5) 对 $\mathbf V_n$ 的覆写造成混淆。
| 符号 | 意义 | 论文简化维度 |
|---|---|---|
| $l,d,N$ | 序列长度、hidden 宽度、层数 | 正整数 |
| $\mathbf H_0,\mathbf H_n$ | token embedding、第 $n$ 层输出 | $l\times d$ |
| $\mathbf Q_n,\mathbf K_n,\mathbf V_n$ | 当前层投影得到的 query/key/value | $l\times d$ |
| $\mathbf W_n^{\mathbf Q},\mathbf W_n^{\mathbf K},\mathbf W_n^{\mathbf V},\mathbf W_n^{\mathbf O}$ | 四个通道投影 | $d\times d$ |
| $\mathbf A_n,\mathbf U_n$ | attention 权重、投影前 attention 输出 | $l\times l$、$l\times d$ |
| $\lambda_{n,1},\lambda_{n,2}$ | 首层 value 与当前 value 的系数 | 每层标量 |
原文在 Eq. (1)–(2) 中简写为
这组表达式省略了实际 Llama-like 模型的 pre-normalization、hidden residual、多头划分和 RoPE。完整理解仍须结合 Sec. 4.1;不能据此认为作者删除了普通残差。
为解释维度,按单头写出常见 attention 形式(教学展开,非论文新增编号公式):
其中 $d_h$ 是 head dimension,$\mathbf M$ 为因果 mask;多头时分别计算并拼接。$\mathbf A_n$ 负责“读取谁”,value 负责“读出什么”。
2.2 ResFormer 的关键公式
首层取标准 value $\mathbf V_1=\mathbf H_0\mathbf W_1^{\mathbf V}$。对 $n\ge2$,原 Eq. (5) 等价写成:
由于矩阵乘法对 value 线性,
这说明首层内容也被当前层的关注关系聚合,并不是原封不动加到 attention 输出上。实现可先混合 V 再调用一次 attention;上式只是解释,不要求计算两次完整 attention。(Sec. 3.2,p. 3;Table 7,p. 7)
“首层 value 是原始信息”的准确意思是:在论文的简化记号中,它只有通道线性投影,没有经过跨 token attention 混合;并非它等于原始 embedding,也并非输入前没有归一化。它由当前输入动态生成,不是跨样本共享的一张固定记忆表。
教学例子:当前 token 的 attention 权重为 $[0.2,0.8]$,首层标量 values 为 $[1,3]$,当前层为 $[10,20]$。固定 $\lambda_1=\lambda_2=0.5$ 后,混合 value 为 $[5.5,11.5]$,输出为 $0.2\times5.5+0.8\times11.5=10.3$。等价地,$0.5\times(0.2\times1+0.8\times3)+0.5\times(0.2\times10+0.8\times20)=10.3$。例中数据仅用于教学,与论文实验无关。
2.3 变体与初始化
| 变体 | 连接/参数方式 | 应注意的条件 |
|---|---|---|
| Constant-ResFormer | 两个系数固定 | 不要求和为 1;例如 $2\mathbf V_1+\mathbf V_n$ |
| Identity-ResFormer | 两个系数相等,默认均为 0.5 | 本文默认的简洁固定方案,不是将 $\mathbf V_1$ 经恒等映射加到输出 |
| Learnable-ResFormer | 每层两个可学习标量,均初始化 0.5 | 普通版本未给出非负或归一化约束 |
| Sparse-ResFormer | 部分层不接首层 value | 在小模型实验中人工搜索位置与系数 |
| Learnable ResFormer Plus | 跨层耦合首层 value 的系数 | 初始化/参数化细节不够完整,见下文 |
| Dense-ResFormer | 组合所有历史层的 value | 增加更多连接;实测不自动优于只接首层 |
Plus 在 Sec. 3.2 写为:$\lambda_{n,2}$ 初始化为 0.5;首层分支系数通过
得到。按公式求和可知首层分支系数之和为 $\lambda_{\mathrm{scale}}$。如果各 logits 初值相同,则每层首层分支初值为 1,而非 0.5;但论文没有明确给出 logits 初值,也没有充分区分“仅用于初始化”与“训练全程保持此参数化”。不能把“让后层更需要首层信息”的动机写成已规定的单调深度初始化。
Dense-ResFormer 的原文形式为
默认当前层系数为 1。源码重用 $\mathbf V_i$ 记号;若做精确复现,需要确认历史 V 缓存取混合前还是混合后,不能仅依据简写推定递归实现。
2.4 SVFormer:把混合退化为完全共享
SVFormer 第一层采用标准 attention,后续层为
它可理解为首层分支系数 1、当前层分支系数 0 的极端方案,但论文单独命名。各层 Q、K、attention 分布、输出投影和 MLP 仍可变化,因此“所有层共享 value”不等于“所有层输出相同”。高层仍能利用上下文相关 Q/K,从首层内容中选取不同组合。(Sec. 3.3,pp. 3–4)
训练/推理区别:训练时让梯度从所有相关层共同流向首层 value 投影;自回归推理时,为新增 token 计算一次首层 value,追加到共享缓存,各层只保留各自 K。ResFormer 仍需各层自己的混合 V 缓存,不能直接领取 SVFormer 的缓存节省。两者的改动需要在训练中学习,论文并未证明把现有 checkpoint 直接替换后仍保留性能。
2.5 “近半 KV cache”的精确含义
以下是根据架构推导的元素数量,不是论文实测显存/延迟。设批大小 $B$、缓存长度 $l$、每层 KV 宽度 $d_{kv}$、层数 $N$,忽略额外元数据,且 K/V 宽度相同:
因此剩余比例是 $\frac{N+1}{2N}$,节省比例是 $\frac{N-1}{2N}$。8 层时剩余 56.25%、节省 43.75%;24 层时剩余 52.08%、节省 47.92%。只有深度增大时才趋近 50%。缓存字节数再乘每个元素的字节数。
若在等深、等宽模型上再用 GQA 将 KV heads 减为原来的 $1/g$,SVFormer 相对原 MHA 的缓存比例为 $\frac{N+1}{2Ng}$。例如 $N=8,g=4$ 时是 14.06%,接近但并非恰好 12.5%。Table 8 用“nearly 1/2”和“nearly 1/8”,应保留其近似性。
ResFormer 的额外混合是每层 $O(Bld_{kv})$ 元素操作,attention 仍是原有复杂度;SVFormer 少了多数层的 V 投影,却仍需各层 QK 与 AV 运算。缓存容量、参数数量、FLOPs、训练速度和解码延迟是不同指标。论文未提供完整端到端吞吐或显存测量表,不能由缓存公式直接声称推理加速一倍。
三:实验——在哪些条件下检验了方法?
3.1 主实验协议
| 项目 | 原文报告 | 来源 |
|---|---|---|
| 模型 | Llama-like decoder;pre-norm、SwiGLU、RoPE、无 dropout | Sec. 4.1,p. 4 |
| 训练数据 | SlimPajama 抽样约 20B tokens,7 个域 | pp. 4、14–15 |
| tokenizer | RedPajama-INCITE-7B-Base,词表 50,277;输入输出 embedding 不绑定 | p. 4、Table 14,p. 16 |
| 尺度 | 82M、180M、320M、468M | Sec. 4.2,p. 5 |
| 默认长度/批量/步数 | 2,048;约 2M tokens/step;10,000 steps | Sec. 4.1,p. 4 |
| 优化 | AdamW,$\beta=(0.9,0.95)$,weight decay 0.1,grad clip 1.0 | p. 4 |
| 学习率 | 初始 $10^{-7}$、峰值 $6\times10^{-4}$,cosine 至峰值 10% | p. 4 |
| warmup | 正文 1,200 steps;Table 14 写 120,未能消解 | pp. 4、16 |
| 设备/计算 | 8×A100 80GB,FP16,DeepSpeed ZeRO-2,FlashAttention | p. 4 |
| 主指标 | 完整 SlimPajama validation split 上的七域平均 validation loss,越低越好 | Sec. 4.1,p. 4 |
| 可视化样本 | 随机选定的固定 1,000 条序列 | p. 4 |
| 下游 | zero-shot accuracy 与 WikiText/LAMBADA perplexity | Tables 2,p. 4;说明 pp. 4–5 |
七域 loss 的具体域权重、token 加权实现,以及下游评测 harness 版本、提示细节、随机种子与重复实验标准差未明确报告。不要把“七域平均”擅自补成某一种加权方式,也不要给微小差异添加统计显著性。
训练数据比例(Table 12,p. 15):CommonCrawl 50% / 10B,C4 20% / 4B,GitHub 10% / 2B,Books、arXiv、Wikipedia、StackExchange 各 5% / 1B。
Table 14(p. 16)给出的代表配置:
| 参数规模 | 层数 | attention heads | hidden 宽度 | FFN 宽度 |
|---|---|---|---|---|
| 82M | 8 | 8 | 512 | 1,792 |
| 180M | 12 | 12 | 768 | 2,688 |
| 468M | 24 | 16 | 1,024 | 3,584 |
表中另有 2M 配置,但没有正文 scaling 所用 320M 的完整配置。不能通过插值代填。
3.2 大规模验证单独理解
1.6B 实验使用约 200B 内部预训练 tokens、长度 8,192、学习率 $1.5\times10^{-4}$、批量约 2M tokens,每次运行约 3,584 H800 GPU 小时。这不是“同一份 20B SlimPajama 实验简单放大”,也不使用主实验的默认峰值学习率。Fig. 2 右每 10B tokens 评估一次,支持该设置下 loss 持续改善;不能从源码里已注释掉的 1.6B 下游表补出最终 PDF 没有报告的结果。(Sec. 4.1–4.2,pp. 4–5)
3.3 baseline 与指标的角色
- vanilla Transformer:同一 Llama-like 基础模型,衡量结构改动本身。
- NeuTRENO / DenseFormer:改善深层信息传播的不同连接方案;前者默认 $\lambda=0.4$,后者当前层初值 1、历史层初值 0。
- CLA2:每两层共享 K/V;GQA2/4/8:按论文记号分别将 KV heads 减少到 $1/2,1/4,1/8$。两者用于同量级缓存预算下比较 SVFormer。
- validation loss / PPL 越低越好;PPL 衡量序列预测的不确定性,不能与 accuracy 混合平均。Table 2 的 Avg. ACC 对应八个 accuracy 列,含 BoolQ 和 LAMBADA accuracy;同一 LAMBADA 的 PPL 列是另一个指标。
四:结果——从有效性到机制与边界
4.1 Sec. 4.2:等 loss 效率与下游表现
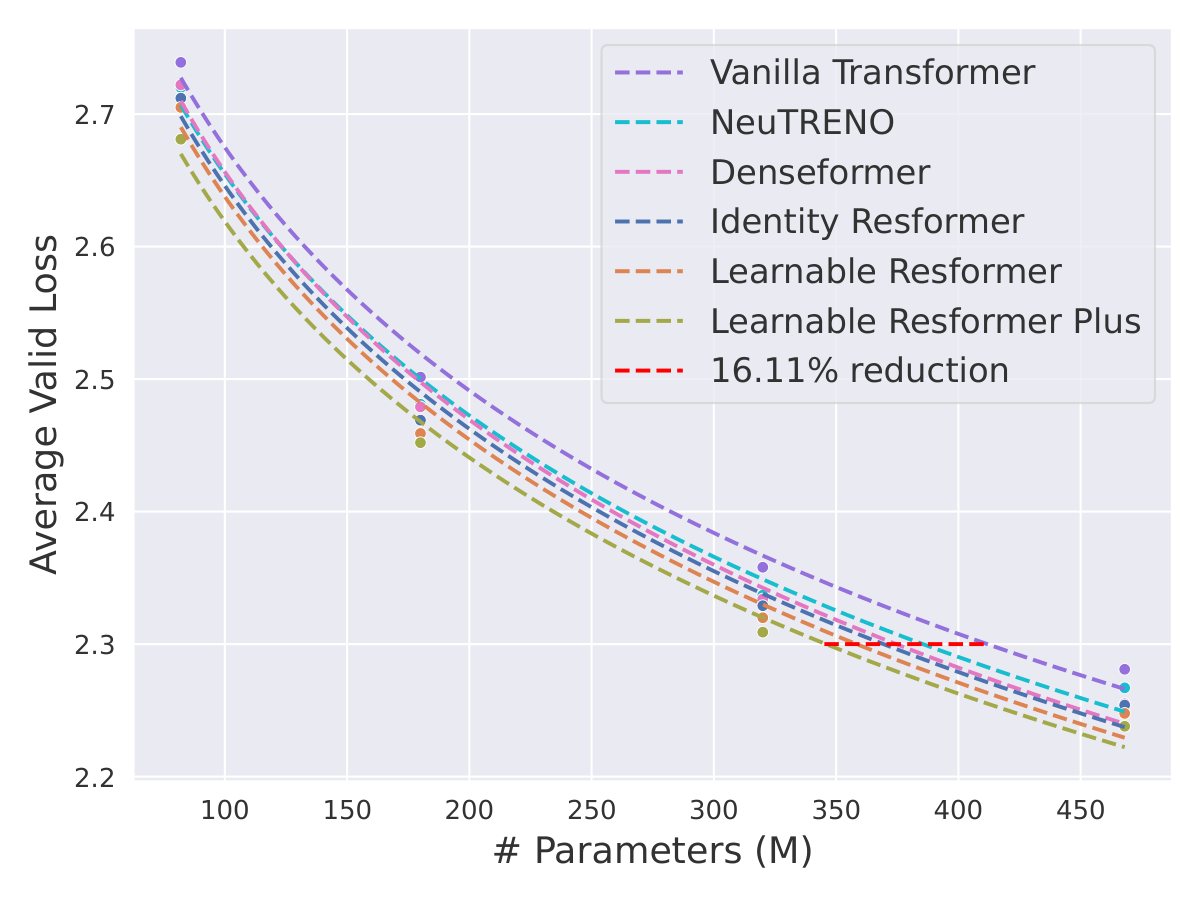
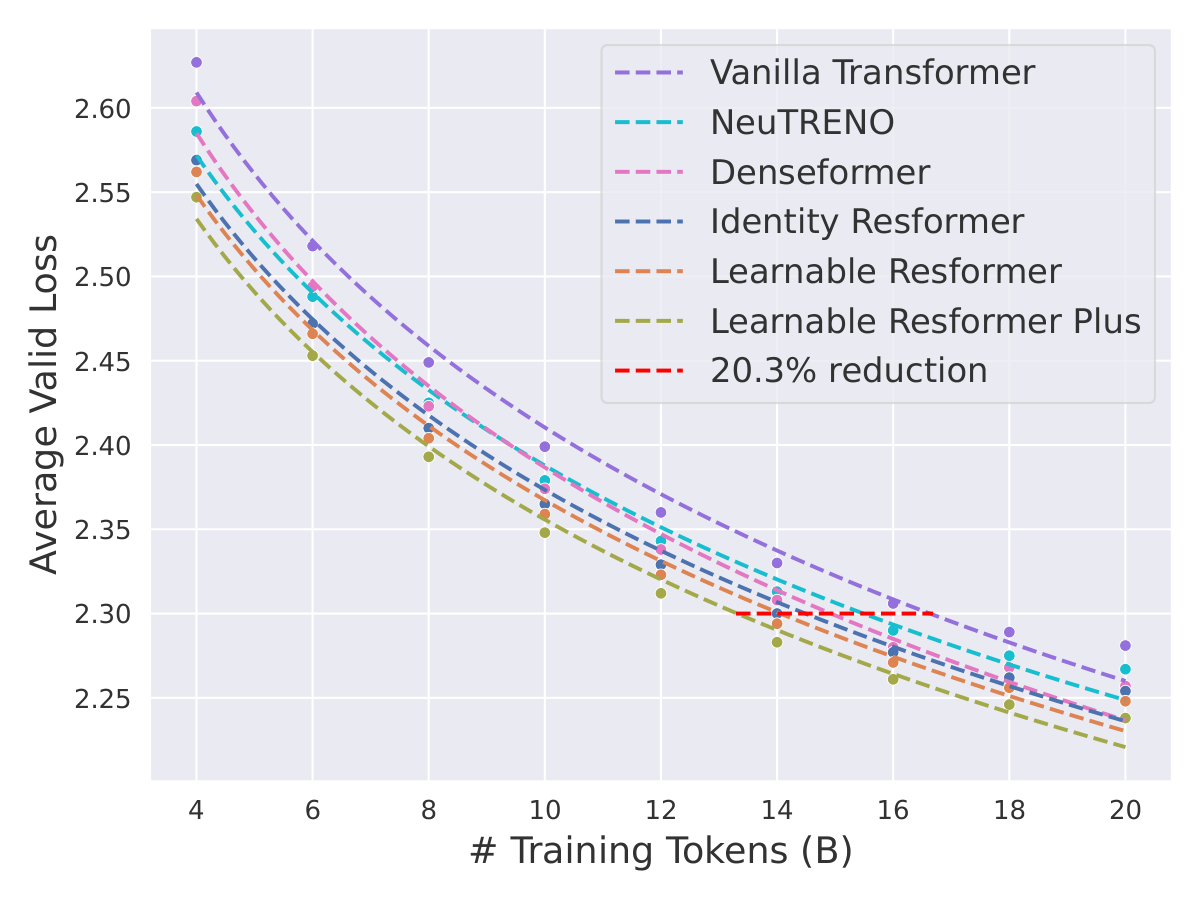
来源:Fig. 2 左、中,PDF p. 4。第一张横轴为参数量(M),第二张为训练 tokens(B),纵轴均为平均 validation loss,越低越好;不同线条表示结构。应在相同纵轴 loss 水平上读取横向距离,才能理解资源节省,不能把它读成 loss 降低 16.11% 或 20.3%。
作者报告的参数节省来自 82M–468M、20B tokens 的 scaling 曲线;数据节省来自 468M 模型每 2B tokens 的评估曲线。它们是两个比较维度上的等损失估计,没有证明同时减少这两个比例后仍达到同样 loss,也不是单次训练直接实测的总成本折扣。正文未提供足以独立重建这两个精确百分比的拟合公式和置信区间。
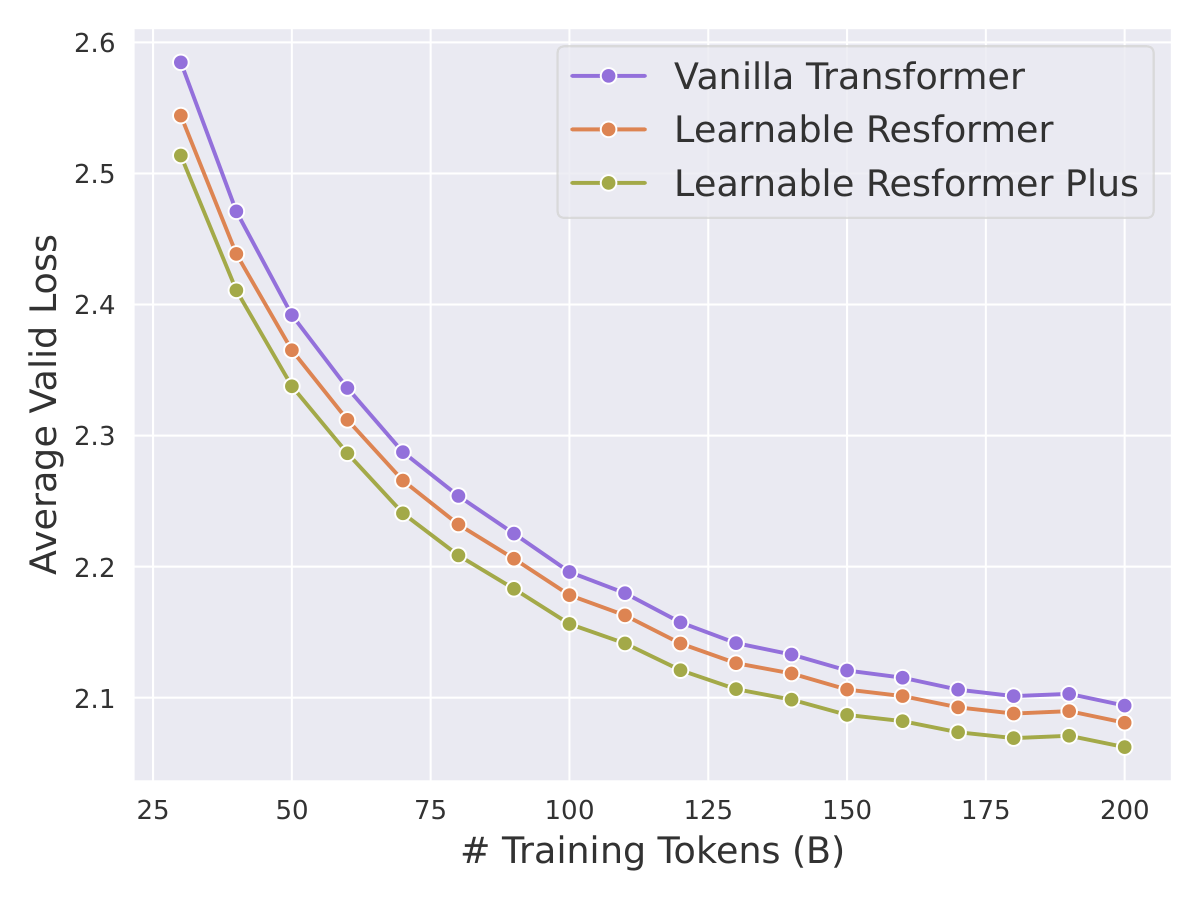
来源:Fig. 2 右,p. 4。横轴为训练 tokens,纵轴为 validation loss;Learnable 与 Plus 曲线在此 1.6B / 200B 内部数据协议下保持优势。它补充了较大尺度证据,但并不证明数十亿至更大尺寸、公开数据或全部下游任务上保持相同收益。
Table 2(p. 4)关键结果,468M / 20B tokens:
| 方法 | WikiText PPL ↓ | LAMBADA PPL ↓ | 八任务 Avg. ACC ↑ |
|---|---|---|---|
| Transformer | 24.8 | 33.4 | 40.6% |
| NeuTRENO | 24.3 | 36.3 | 41.4% |
| DenseFormer | 24.0 | 28.0 | 40.8% |
| Identity ResFormer | 23.8 | 32.9 | 41.3% |
| Learnable ResFormer | 23.7 | 32.5 | 42.3% |
| Learnable ResFormer Plus | 23.2 | 31.4 | 42.0% |
Learnable 比 Transformer 的平均 accuracy 高 1.7 个百分点,而非 1.7% 相对提升。Plus 的 WikiText PPL 最好,但平均 accuracy 略低于普通 Learnable。DenseFormer 的 LAMBADA PPL 更好,因此不能说 ResFormer 在每个指标上全面胜出。
八项 accuracy 原表值(单位 %),用于查看收益分布:
| 任务 | Transformer | Learnable ResFormer | 差值(百分点) |
|---|---|---|---|
| ARC-Challenge | 18.8 | 21.2 | +2.4 |
| ARC-Easy | 49.6 | 50.3 | +0.7 |
| BoolQ | 57.5 | 60.9 | +3.4 |
| HellaSwag | 31.1 | 32.3 | +1.2 |
| LAMBADA | 34.1 | 36.3 | +2.2 |
| OpenBookQA | 17.6 | 18.8 | +1.2 |
| WinoGrande | 49.8 | 51.2 | +1.4 |
| PIQA | 66.1 | 67.0 | +0.9 |
4.2 Sec. 4.2:系数与变体有影响
Table 3(p. 5),8 层 / 82M 模型的平均 validation loss:
| 方法/关键配置 | loss ↓ | 相对 2.739 的绝对变化 |
|---|---|---|
| Transformer | 2.739 | 0 |
| DenseFormer,可学习 | 2.722 | −0.017 |
| NeuTRENO,固定 0.4 | 2.720 | −0.019 |
| Identity,固定 0.5/0.5 | 2.712 | −0.027 |
| Dense-ResFormer,可学习 | 2.709 | −0.030 |
| Learnable,0.5/0.5 初始化 | 2.705 | −0.034 |
| Constant,$2\mathbf V_1+\mathbf V_n$ | 2.700 | −0.039 |
| Sparse,第 6–8 层只用 $\mathbf V_1$ | 2.696 | −0.043 |
| Sparse,第 6–8 层用 $5\mathbf V_1+\mathbf V_n$ | 2.687 | −0.052 |
| Learnable ResFormer Plus | 2.681 | −0.058 |
固定 0.5/0.5 已经有效,因此收益不依赖大量额外参数。不过,手调 Constant/Sparse 优于普通 Learnable,表明学习系数并没有自动找到最优连接方案。Sparse 仅用首层 value 的后 3 层还能省去对应 $\mathbf W_n^{\mathbf V}$,但它不是所有层都共享的 SVFormer。作者明确说 Constant/Sparse 系数经多次实验搜索,表格不是所有方法相同调参成本下的比较。
Fig. 3(p. 5)横轴是固定 $\lambda$,纵轴是 loss;Constant 采用 $\lambda\mathbf V_1+\mathbf V_n$,不能误读成 $\lambda\mathbf V_1+(1-\lambda)\mathbf V_n$。在报告区间内其最优点约为 2,对系数比 NeuTRENO 更稳健;不是任意大的系数都保证更好。
4.3 Sec. 4.3:只是学习更快吗?
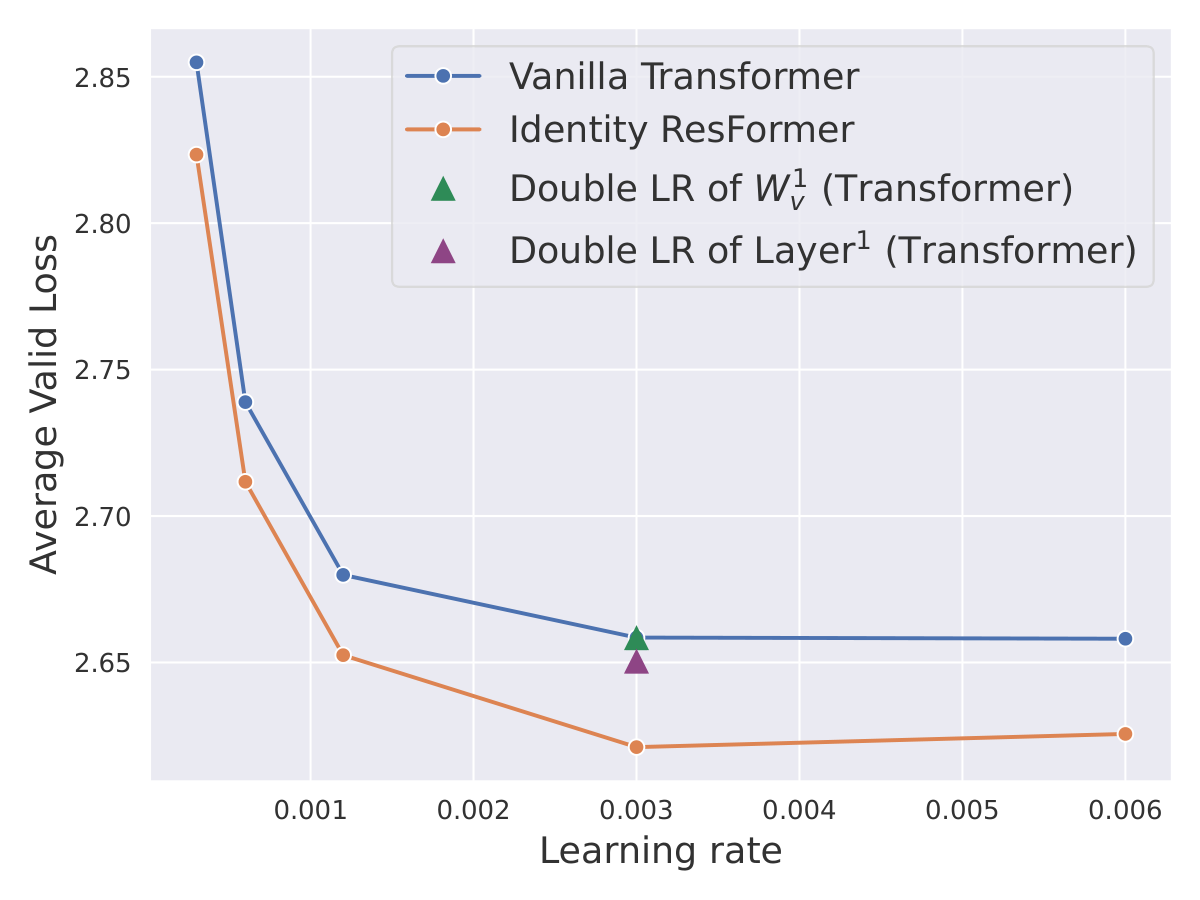
来源:Fig. 4 右,p. 5;解释见 Sec. 4.3,pp. 5–6。横轴学习率,纵轴平均 loss,比较 Transformer 与 Identity ResFormer,并标出两种首层局部提高学习率的对照。
作者检查了五种学习率,两种模型在约 0.003 附近最优,Identity 在各点均更好。这是专门的学习率消融,不能与默认 $6\times10^{-4}$ 混用。梯度分析(Fig. 4 左)发现,相较 Transformer,Identity 的首层 $\mathbf W_1^{\mathbf V}$ 的输出梯度范数约为两倍,$\mathbf W_1^{\mathbf O}$ 约为一半;作者认为部分梯度通过 value shortcut 绕过原 hidden 路径。
随后仅将 Transformer 首层、或仅 $\mathbf W_1^{\mathbf V}$ 的学习率加倍,都未重现提升。合理结论是收益不能由这些简单的学习率/梯度幅值改动解释;正文“与梯度变化无关”的说法更强,有限控制实验尚不能排除所有优化动力学解释,也没有证明训练无限延长后的全局最优差异。
4.4 Sec. 4.4:从哪里取,送到哪里?
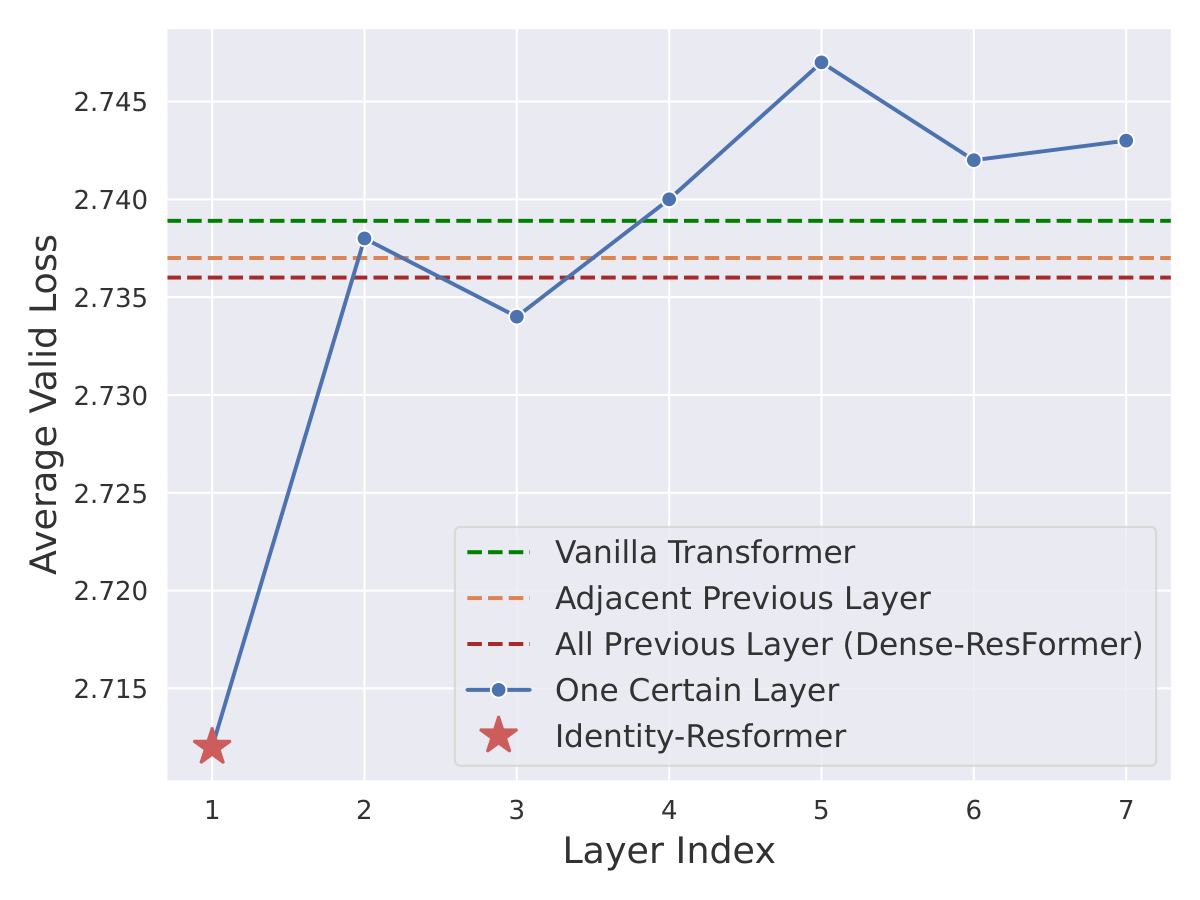
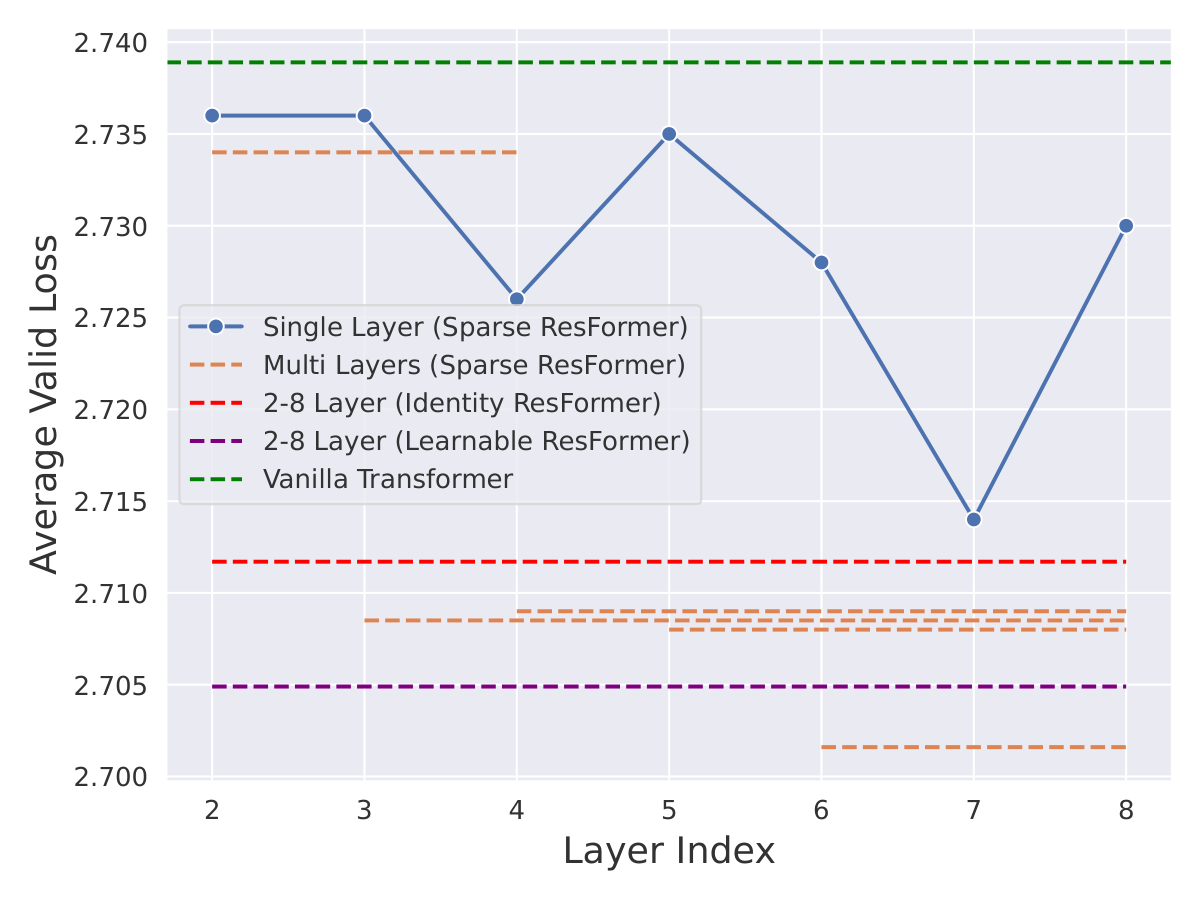
来源:Fig. 5,p. 6。左图横轴表示来源层,纵轴 loss;右图对比仅接一层和接一组层的 Sparse 配置,应结合图例区分“来源”与“接收层”。在 8 层模型中,首层 $\mathbf V_1$ 最有效,$\mathbf V_2$ 基本无增益;仅接单层时第 7 层最好,多层时第 6–8 层最好,再扩大到较浅层会削弱收益。
这组结果支持“深层更需要初始信息”,而非“任意跨层连接都有效”。相邻连接会让首层信息在多次混合中衰减;稠密连接可能稀释首层分支。后两句是作者对结果的解释,不是测得的独立因果量。
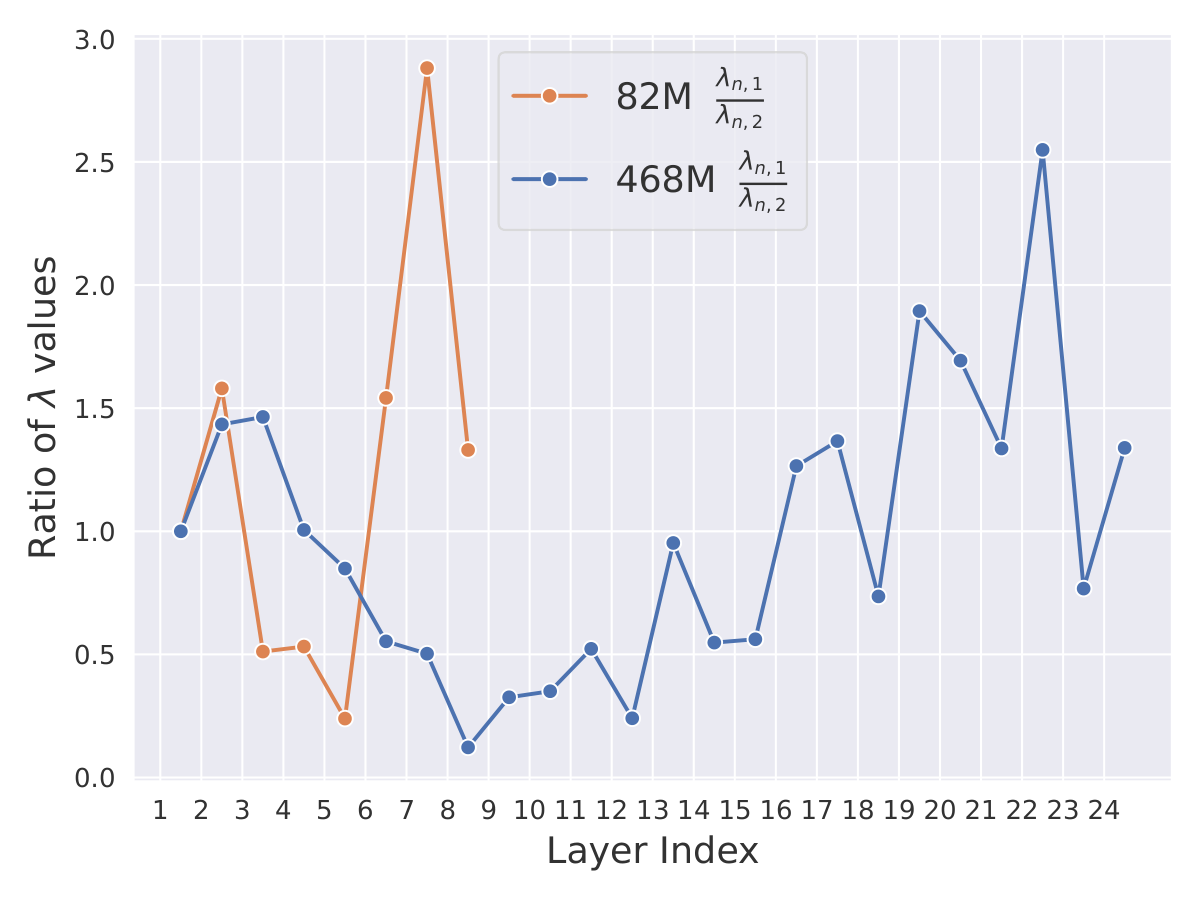
来源:Fig. 6 左,p. 6。横轴层号,纵轴 $\lambda_1/\lambda_2$,两条曲线对应 82M 和 468M;较后层整体更依赖首层分支,但曲线并非严格单调。右图 dense 系数热图也突出首层来源,不过原文对其模型尺寸存在矛盾,见后文核验表。
已有 hidden residual 为什么还不够? Table 4(p. 7)比较额外连接到初始 hidden 与首层 value,系数都是可学习的:
| 额外连接 | 系数初始化 | loss ↓ |
|---|---|---|
| 无 | — | 2.7389 |
| value | 0.5/0.5 | 2.705 |
| hidden | 0.5/0.5 | 2.781 |
| value | 0/1 | 2.730 |
| hidden | 0/1 | 2.722 |
强行一开始大量注入初始 hidden 会恶化效果;0/1 初始化的 hidden 方案却优于同样初始化的 value 方案。因此“value 在一切公平匹配初始化下都更好”不成立。原文支持的是精心选择的 value 配置效果最好,并且直接 hidden 混合有初始化敏感性。
为什么是 $\mathbf V_1$,而不是 $\mathbf V_2$? 作者通过删除早期 hidden residual 改变信息可达性(Table 5,p. 7):
| hidden residual 从何处开始 | 无额外 value | 加入来源 | 加入后的 loss |
|---|---|---|---|
| $\mathbf H_0$,默认 | 2.739 | $\mathbf V_1$ | 2.712 |
| $\mathbf H_0$,默认 | 2.739 | $\mathbf V_2$ | 2.738 |
| $\mathbf H_1$ | 2.780 | $\mathbf V_2$ | 2.780 |
| $\mathbf H_2$ | 2.820 | $\mathbf V_2$ | 2.787 |
| $\mathbf H_2$ | 2.820 | $\mathbf V_3$ | 2.833 |
| $\mathbf H_3$ | 3.057 | $\mathbf V_3$ | 2.883 |
一旦较早表示缺少普通残差通路,对应 value shortcut 才产生明显补偿效果。这支持“旁路补充通常难以获取的信息”的解释。它不表示 $\mathbf V_2$ 在所有架构下无用;恰恰相反,其作用依赖 hidden 路径设计。Fig. 7(p. 7)的 hidden 层间相似度显示 $\mathbf H_0$ 与深层差异较大;去掉跨层 hidden residual 后,dense value 比只接首层更好,说明两类路径有互补关系。
能否改接 Q/K/A,或不经过当前 attention? Tables 6–7(p. 7)分别回答:
| 残差位置(固定 0.5/0.5) | loss ↓ | 首层 value 的映射方式 | loss ↓ |
|---|---|---|---|
| 无 | 2.739 | 无 | 2.739 |
| Query | 2.742 | 恒等映射直接加到输出 | 3.137 |
| Key | 2.746 | 使用 $Q_n$ 与拼接的 $K_n,K_1$ 重算 attention | 2.729 |
| Attention matrix | 2.757 | 共用当前层 attention | 2.712 |
| Value | 2.712 | — | — |
重算 cross-layer attention 不增加投影参数,但扩大 attention 计算;直接加到输出损失很高。最有辨识度的结果是:在当前 attention 下混合 value,而非笼统地“首层信息加回来就好”。
4.5 Sec. 4.5:表示究竟发生了什么变化?
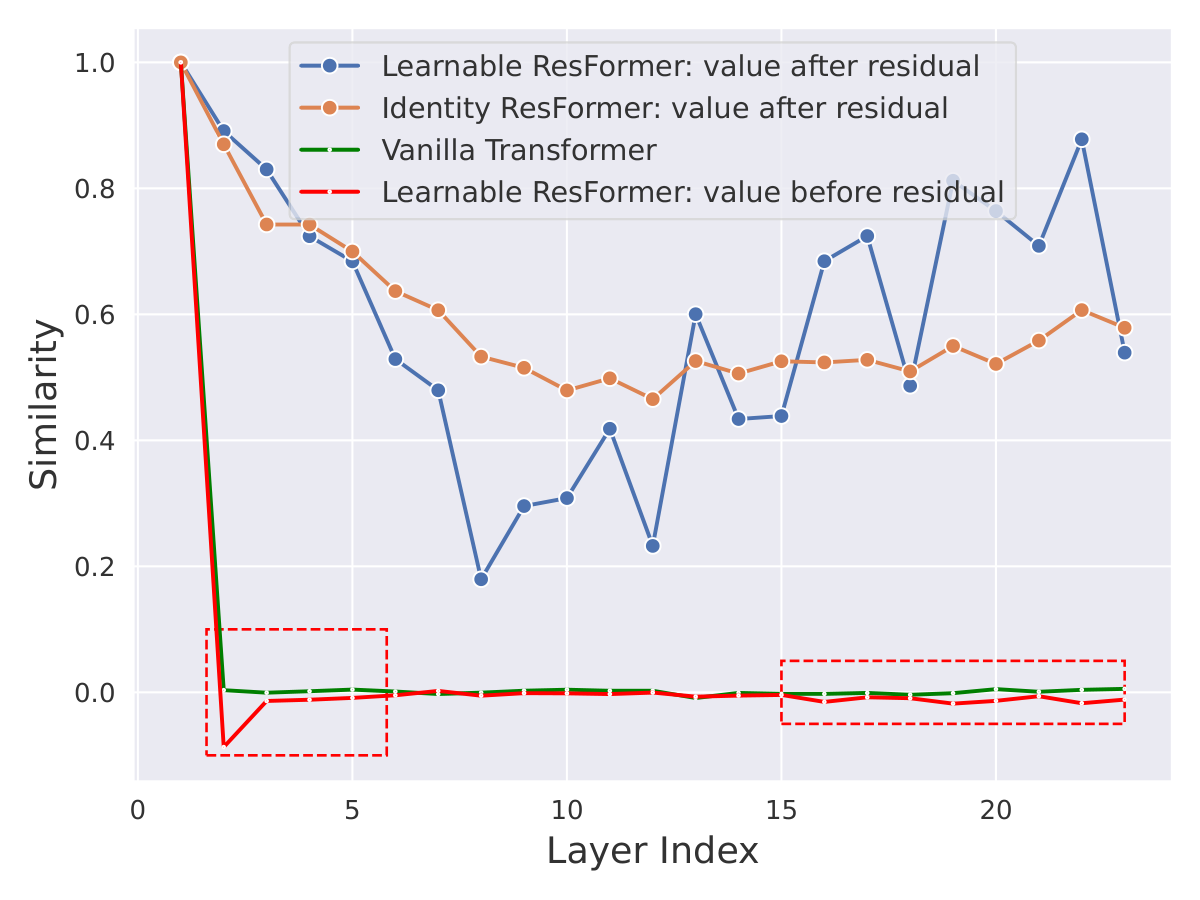
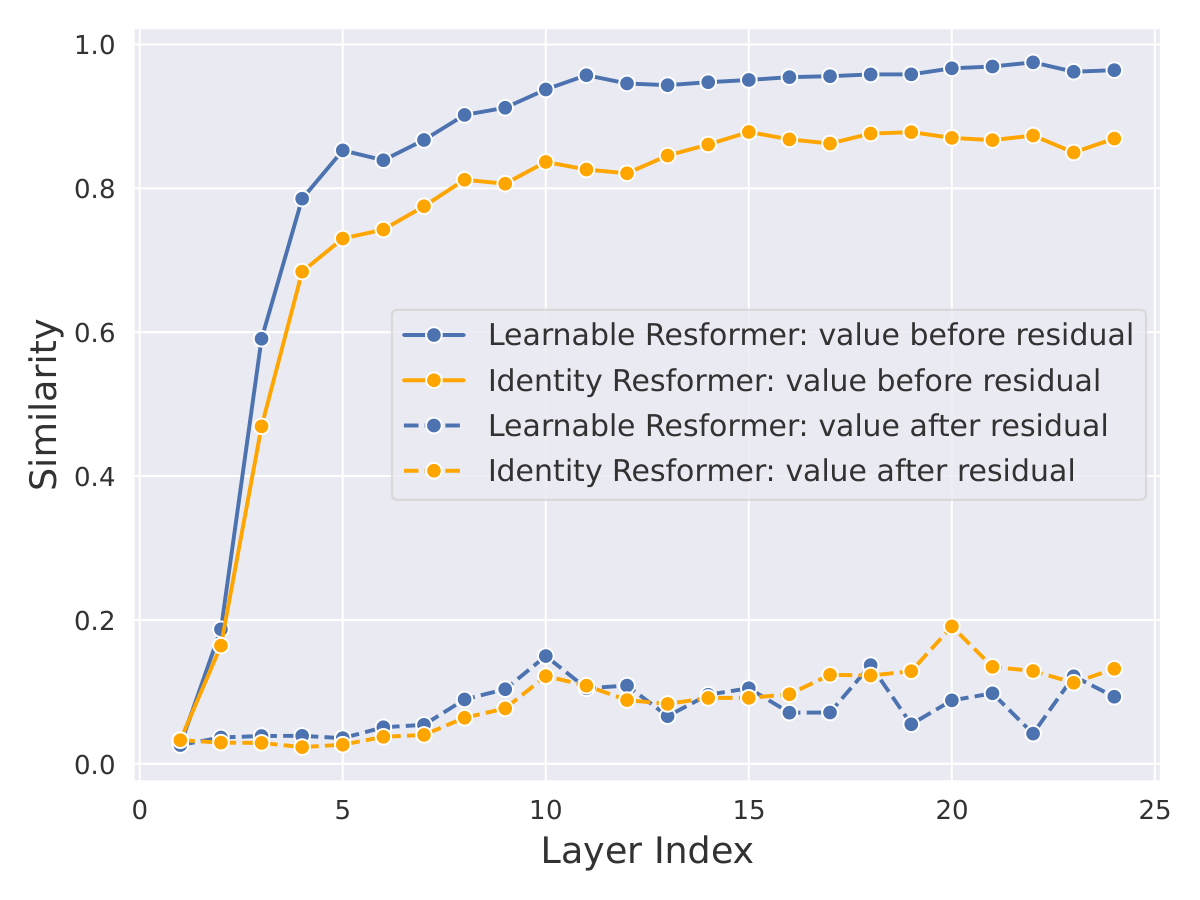
来源:Fig. 8 左,p. 8。横轴层号,纵轴余弦相似度;图例区分 vanilla、ResFormer 混合前和混合后。混合后 value 与首层更相似,其中一部分是加入 $\mathbf V_1$ 的直接代数结果;不能单靠这一现象证明泛化提升的原因。对首层依赖较大的层,混合前 value 常与 $\mathbf V_1$ 更不同,作者据此解释为当前层学习补充残差。
Fig. 8 右(原图面板)测的是不同 token 之间的 value 相似度,不是“层与首层相似度”。在 ResFormer 中,深层混合前 value 的 token 间相似度升高,作者假设它只需学习较小的 $\Delta\mathbf V$。但余弦相似度不测范数,也不能单独证明残差幅度下降。
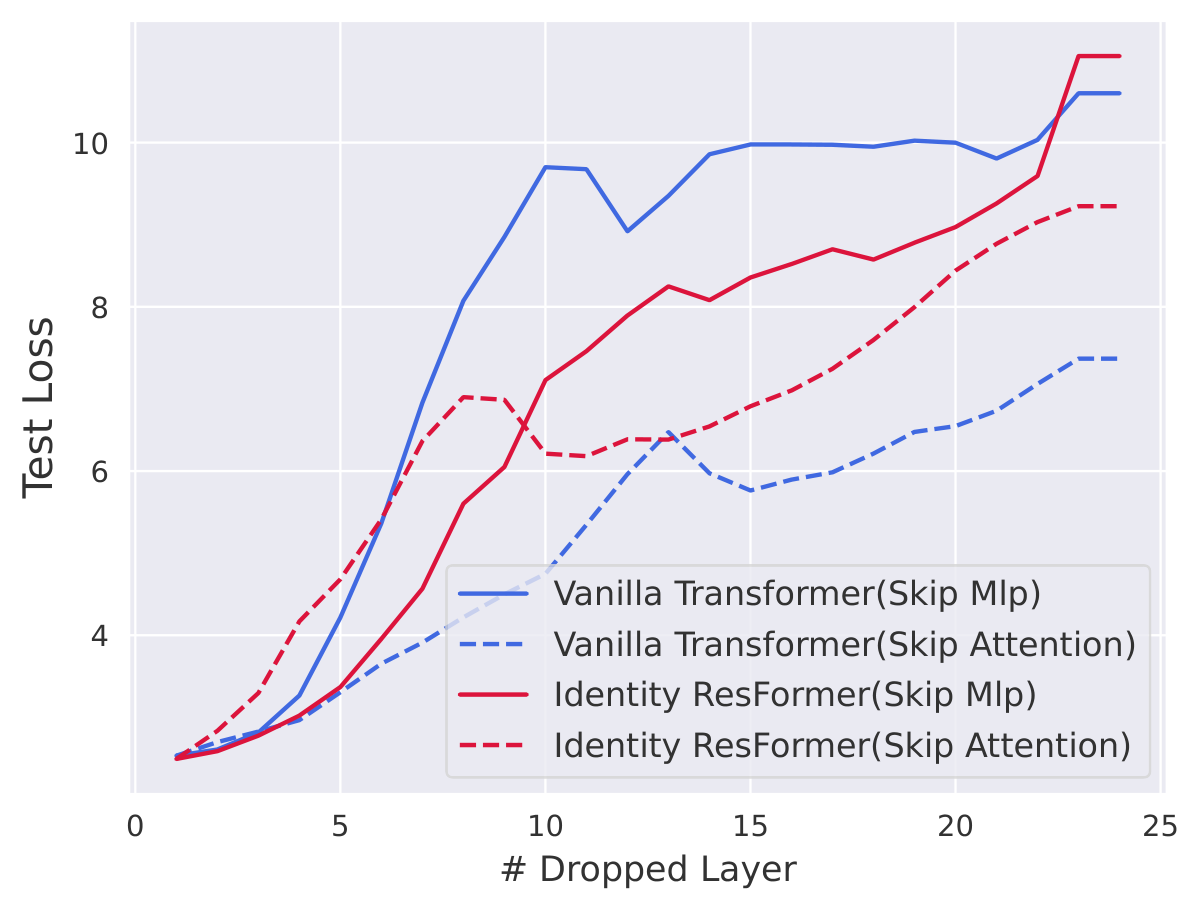
来源:Fig. 9 左,p. 8。横轴从后向前移除的层/模块数,始终保留首层;纵轴 test loss;图例分别表示移除 attention 或 MLP。ResFormer 移除 attention 的损害更接近移除 MLP 的损害,说明训练后的模型更依赖 attention 分支。它是扰动敏感性实验,不是可直接迁移的剪枝配方。
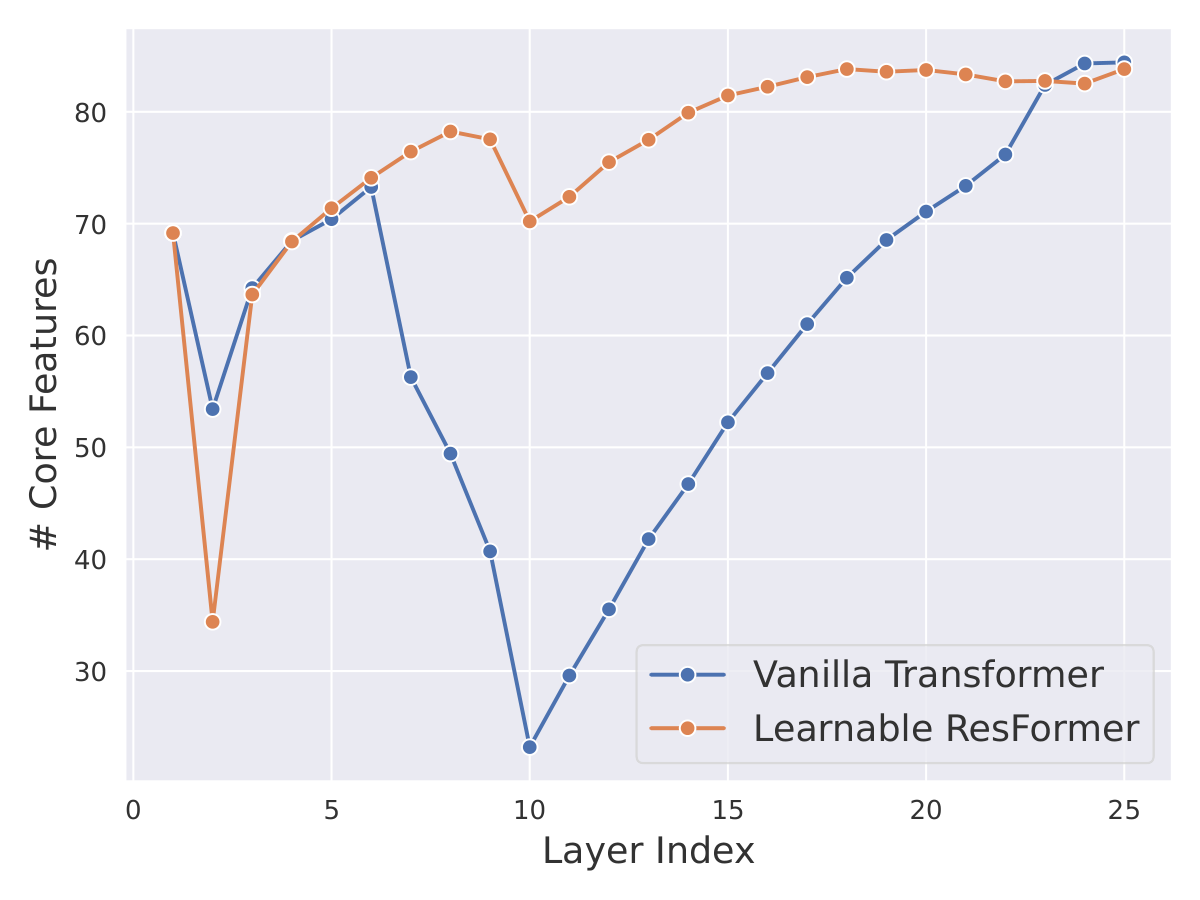
来源:Fig. 9 右,p. 8。横轴层号,纵轴解释 99% 方差所需的最少主成分数。从第 2 层起 ResFormer 通常需要更多主成分。作者称之为更高的信息密度;更保守的解释是这些样本上的表示方差分布在更多线性方向上,并不能将 PCA 维数直接等同于任务有效信息量。
4.6 Sec. 4.6:SVFormer 的缓存优势与质量边界
先看为什么只共享 V。Table 1(p. 3)在每两层共享的比较中,无共享 / 只共享 V / 只共享 K / 共享 K+V 的 loss 分别为 2.739 / 2.743 / 2.753 / 2.776。它支持“V 的跨层共享代价较小”,但只共享每两层 V 的结果不等于所有层使用首层 V 的结果。
Table 8 左(p. 9),近半 KV cache 的方法比较;Transformer 行为完整 KV 基线:
| 方法 | 训练长度 2,048:loss ↓ | 训练长度 64,000:loss ↓ |
|---|---|---|
| Transformer,全 KV | 2.739 | 2.753 |
| CLA2 | 2.776 | 2.793 |
| GQA2 | 2.748 | 2.773 |
| SVFormer | 2.774 | 2.7485 |
在短长度,SVFormer 比 Transformer 高 0.035,也比 GQA2 高 0.026;在 64,000 长度,SVFormer 比 Transformer 低 0.0045,比 GQA2 低 0.0245。没有误差条,所以不能把 0.0045 宣称为已证明的显著优势。这里是改变训练序列长度后的模型比较,不是一个短训练模型直接外推到 64k,也不是检索基准上的长上下文能力证据。
Table 8 右(p. 9),64,000 训练长度,近 1/8 KV cache 的方案:
| 方法 | loss ↓ |
|---|---|
| Transformer,全 KV | 2.753 |
| GQA8 | 2.807 |
| CLA2 + GQA4 | 2.815 |
| SVFormer + GQA4 | 2.741 |
SVFormer 能与 GQA 叠加,并在这个固定协议下保持较低 loss;其中 −0.012 是相对 Transformer 的绝对 loss 差,不是百分比。各压缩方法的有限层数缓存不完全相同,模型总参数也会因投影共享/移除改变,原文未给 Table 8 每一行的完整参数与实际缓存字节数。
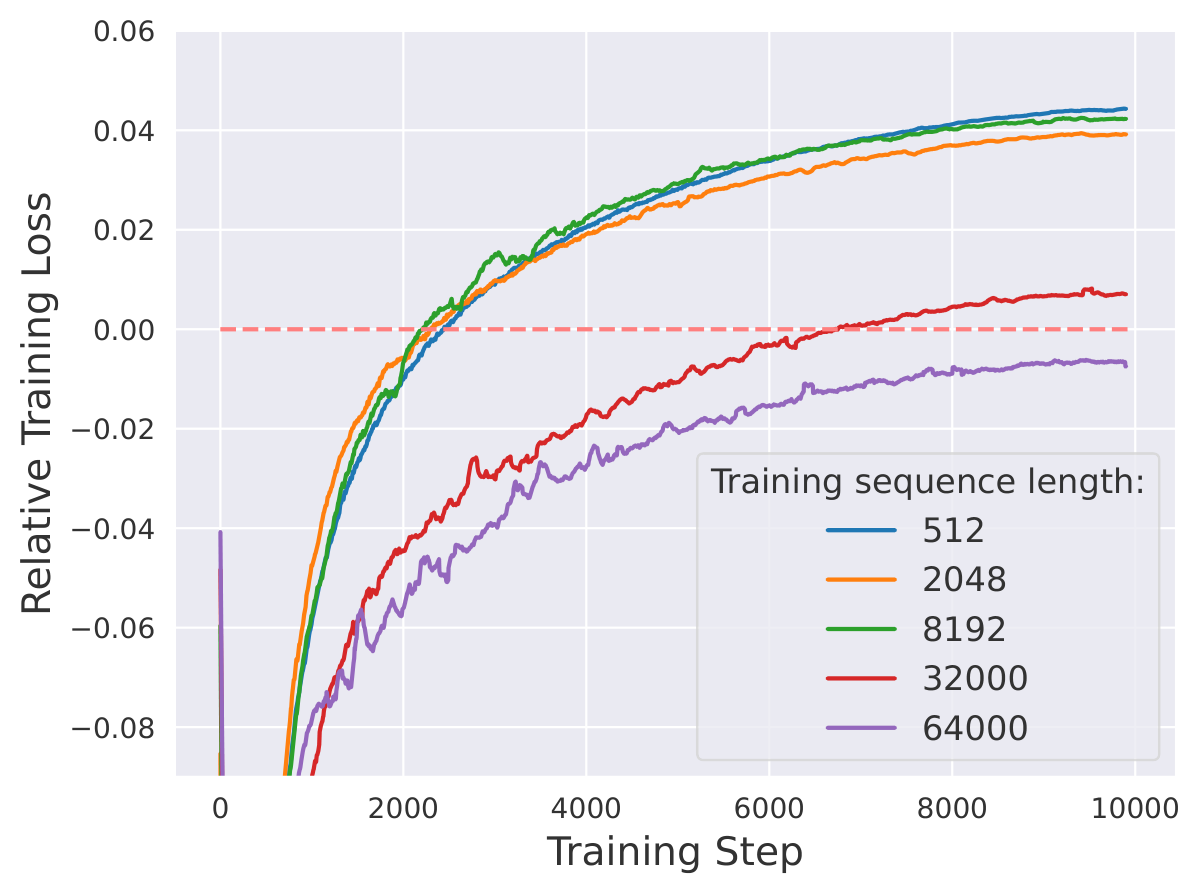
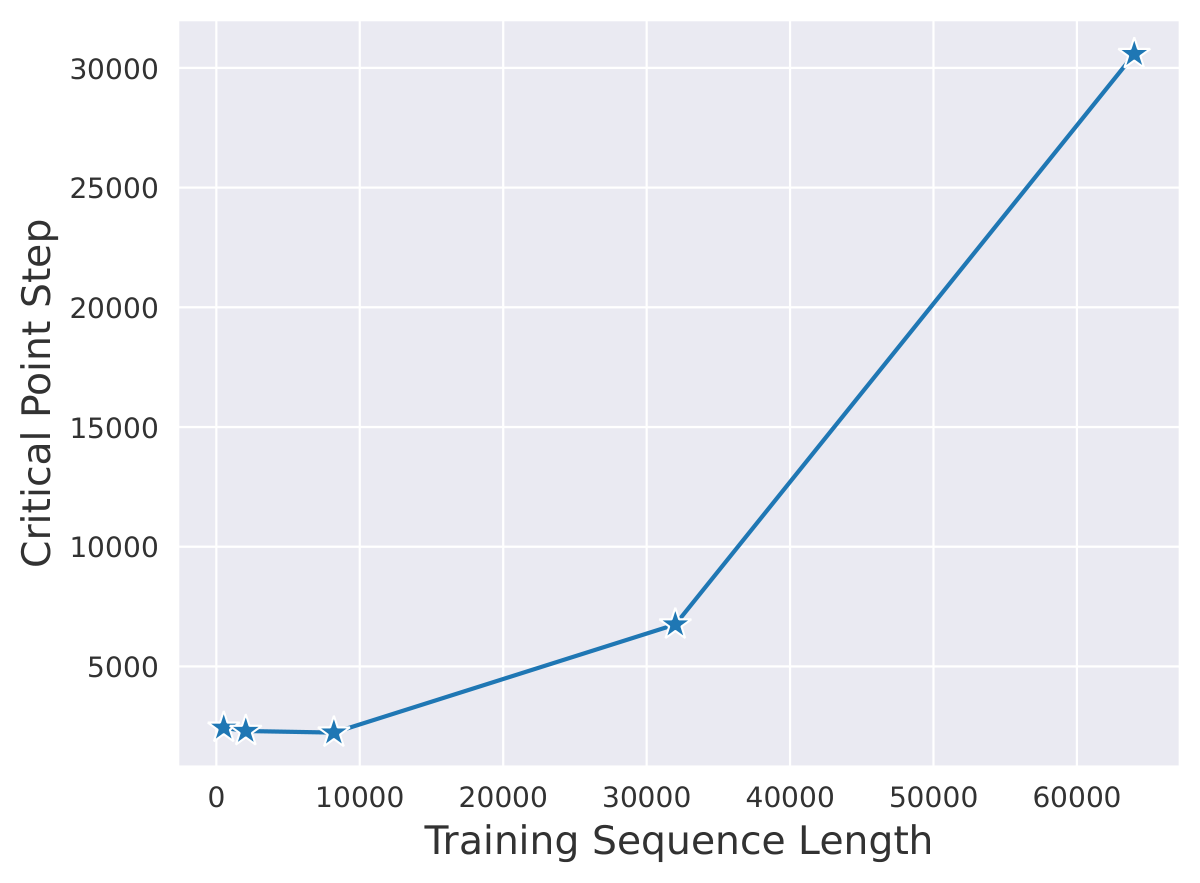
来源:Fig. 10,p. 9。左图横轴训练步数,纵轴 SVFormer 相对 vanilla 的 loss 差(负值更好);图例为训练长度 512、2,048、8,192、32,000、64,000。固定每步约 2M tokens,SVFormer 在早期更有优势,随训练推进差值逐渐上升。交叉点明显延后主要出现在 32k 和 64k;512、2,048、8,192 三个较短长度的交叉步数接近,并非严格单调。
右图横轴训练长度,纵轴交叉步数。64,000 的交叉点由最后 1,000 个数据点线性外推得到,不是已经训练观察到的交叉。正文用“exponential trend”描述长度关系,但图中趋势及少量点不足以构成可靠普遍 scaling law;“vanilla 最终一定超越”的全称表述也超出已观察范围。
作者将这种依赖解释为长序列下首层 value 更难充分优化。需要澄清:随长度增长的是 value 激活矩阵的 token 维度,不是 $\mathbf W_1^{\mathbf V}$ 的参数尺寸;论文没有分离上下文分布、每 batch 序列数、参数共享和学习率积分的全部混杂因素。
Table 9(p. 9),报告的是 $\Delta L=L_{\rm SVFormer}-L_{\rm Transformer}$,不是原始 loss:
| 架构 | 学习率 | warmup steps | $\Delta L$ ↓ |
|---|---|---|---|
| Llama-like | $10^{-4}$ | 120 | −0.033 |
| Llama-like | $3\times10^{-4}$ | 120 | +0.021 |
| Llama-like | $6\times10^{-4}$ | 120 | +0.035 |
| Llama-like | $6\times10^{-4}$ | 1,200 | +0.036 |
| GPT2 | $6\times10^{-4}$ | 120 | +0.029 |
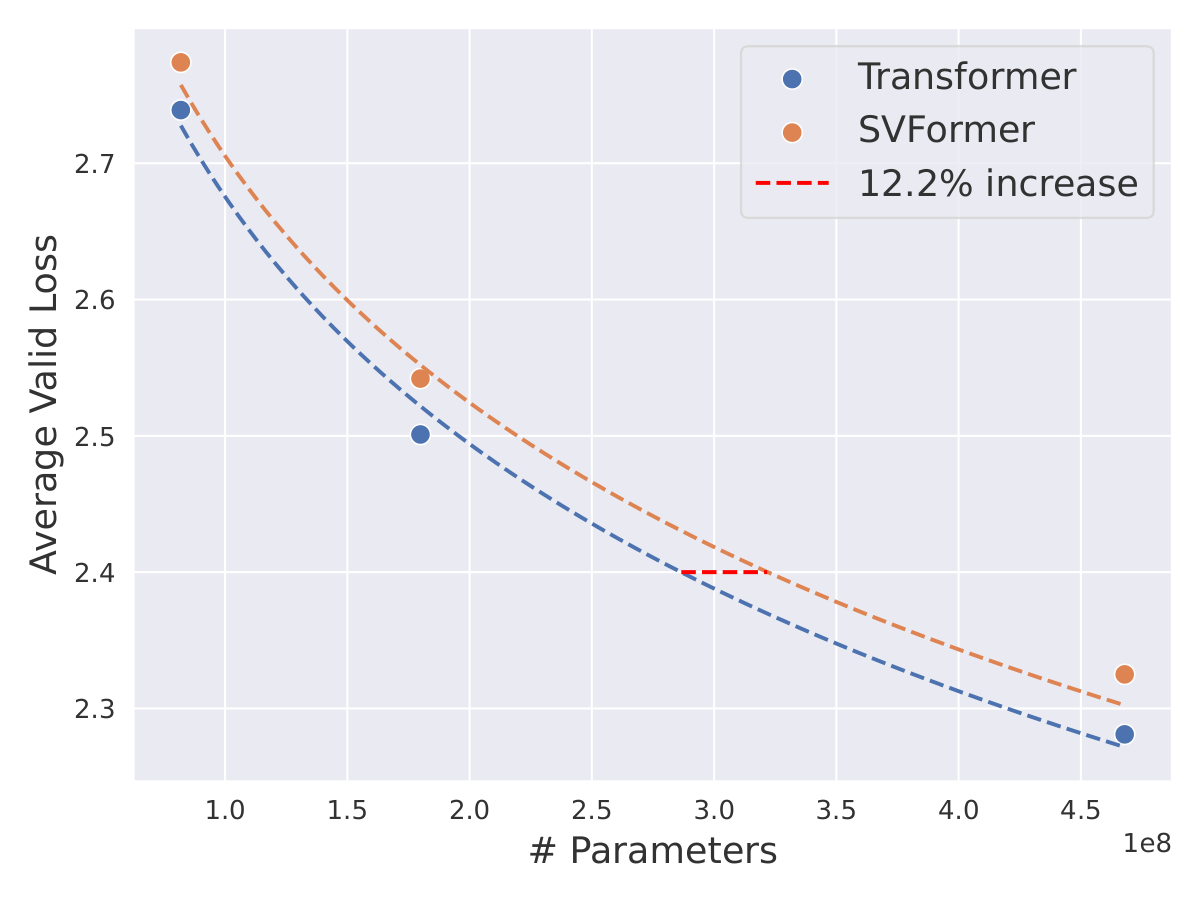
更小的学习率影响比这两种 warmup 差异大,作者联系到累积学习率 $\sum_t\eta_t$。这是经验解释,而非严格推导;仅有一个 GPT2 对照也不能证明完全不受架构影响。Fig. 11(p. 9,原图)报告在 82M–468M scaling 比较中,SVFormer 达到同样 loss 需约 多 12.2% 参数。这个参数补偿数字与“等深等宽下近半缓存”的结构推导应分开陈述。
4.7 Appendix A.1:attention sink、value drain 与潜在副作用
测量对象:attention sink 是少数 token(特别是首 token)吸收大量注意力;value drain 指对应 value 范数偏小;hidden/residual peak 指 hidden 范数异常大。它们和 over-smoothing 不是同一指标。Fig. 12(p. 12)显示随机初始化模型可以有 hidden 相似度随深度升高,却不呈现相同注意力集中;Llama 8B 和 Mistral 7B 的曲线只用于已有模型的模式分析,不是 ResFormer 已在这些尺度上训练验证。
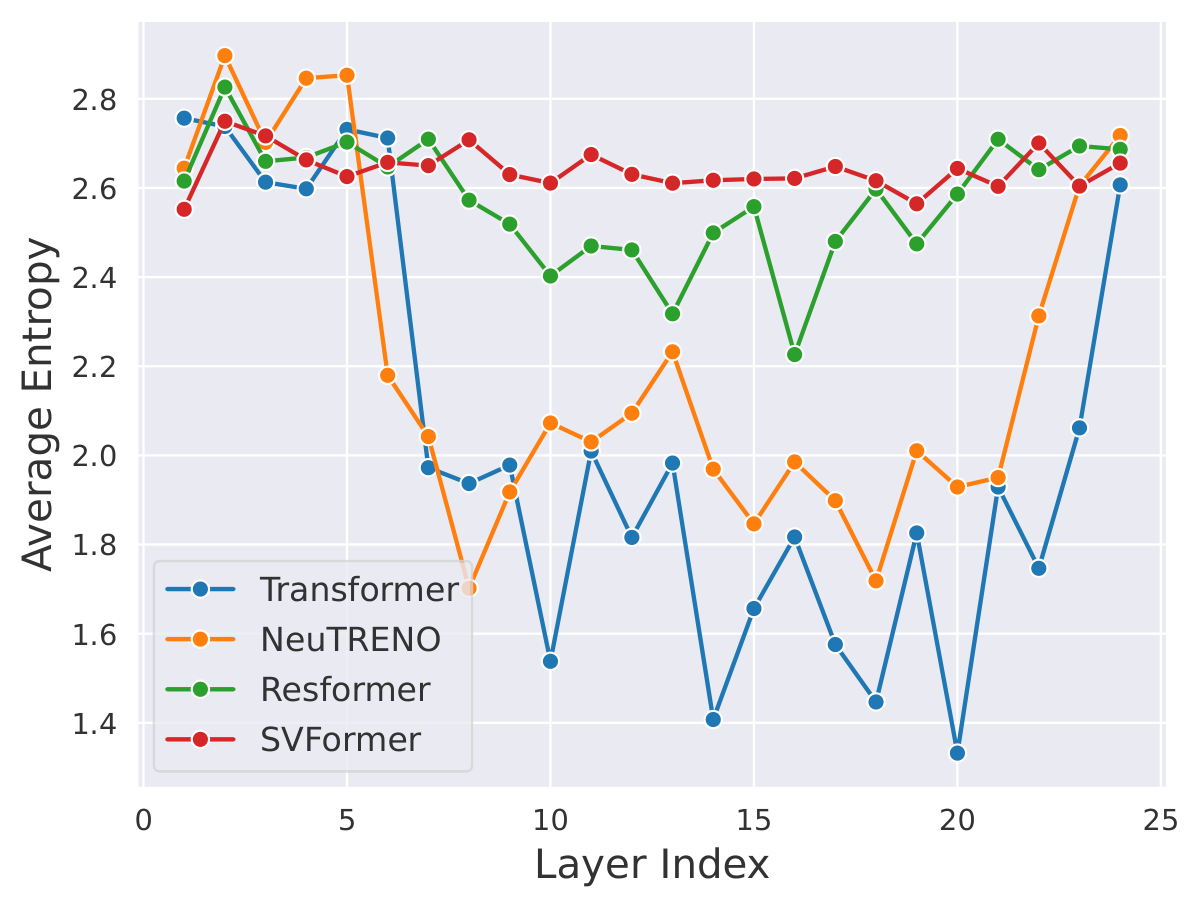
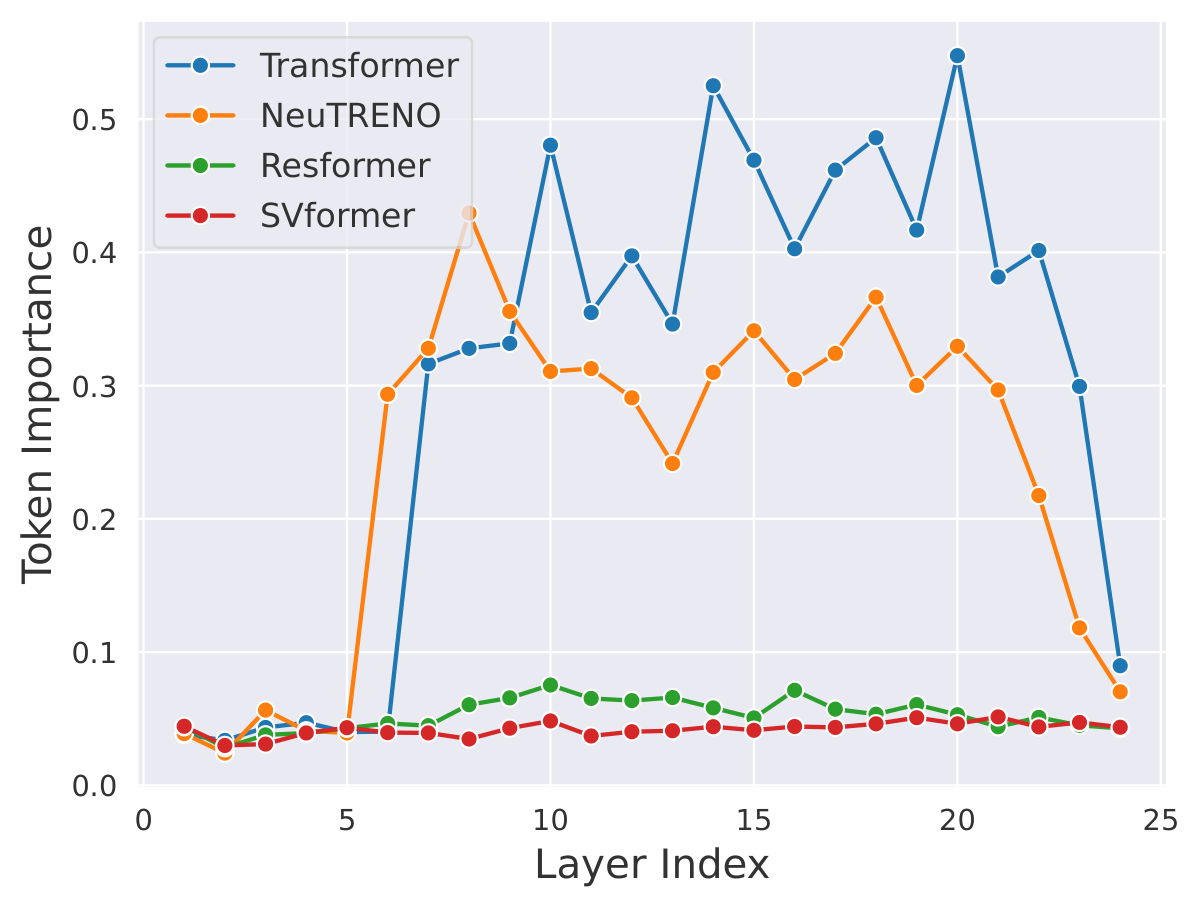
来源:Fig. 13,p. 12。横轴为层号。ResFormer/SVFormer 的 token importance entropy 整体更高、首 token importance 更低;其余面板显示 value drain 与 hidden peak 缓解。Fig. 14(p. 13)按模型行、importance/value norm/hidden norm 列展示热图;各图色条范围不同,不能只凭同一颜色跨模型比较绝对大小。Fig. 15(p. 14)的 Top-1/2/3/10/1% importance 曲线支持注意力分配较分散的观察,但不保证长上下文检索一定更好。
熵的关键校正(本次分析):附录定义 $e=-\sum_i a'_i\log a'_i$ 后,却写“熵越高越集中”。按该公式,均匀分布的熵最大,集中分布的熵更低。因此图和文字必须以“更高熵 = 更分散”理解,不能照抄方向。
另外,原式 $a_i=\frac1l\sum_j A_{ij}$ 的下标也有歧义。若按常规 $A_{ij}$ 表示 query $i$ 对 key $j$ 的权重,逐行和恒为 1,原式将使 $a_i$ 全部相等;统计 token 被多少 query 关注通常应累计列:$a_i=\frac1l\sum_j A_{ji}$。这是对符号一致性的检查,不是声称作者代码一定实现错了;实际实现需要单独核对。
作者的机制假设:首层没有同样的 value drain,将首层 value 注入后,模型不能再通过“很小的 V + 很大的 attention weight”维持同样输出,于是降低对低语义首 token 的过度关注。这与观测相容,但论文未通过独立干预充分证明唯一因果链。
稀疏/范数副作用:更分散的 attention 可能影响原先的稀疏性。Table 10(p. 14)固定后层组标为 5,6,7,$\lambda=1,2,5$ 时 loss 为 2.698、2.688、2.682;浅层 2,3,4 则为 2.724、2.728、2.732。较大首层权重有利于这一后层组,却损害浅层组;正文叙述把后层写成 6–8,与表格不一致,不能擅自统一。
Table 11(p. 14)使用 value 混合后范数重缩放:
论文没有明确范数沿 token、head 还是整个张量计算,复现时需要确认。全层 loss 2.712→2.701;浅层 2–4 2.734→2.727;深层 6–8 2.702→2.701。这说明缩放对浅层/全层设置更有帮助;不等于已经全面排除了 sparsity、速度或表达能力的副作用。
五:结论、复现边界与值得继续追问的问题
5.1 可以带走的三点
- 信息内容与读取关系可以分开设计。当前层的 Q/K 形成语义选择关系,首层 V 提供未经过跨 token 融合的内容旁路;value 连接的位置比“加更多残差”更关键。
- 初始信息对后层更有帮助,但最优强度依赖层与初始化。8 层消融、可学习系数及 hidden 路径删除实验相互支持这一结论,尚不能推广为所有架构都应固定接最后三层。
- 全层共享 V 是有条件的资源折中。缓存减少由结构保证,质量受训练长度、预算、学习率与模型参数补偿影响;长序列 loss 结果值得关注,但不是通用无损 KV 压缩证明。
5.2 原文报告中的不一致与本次处理
| 问题 | 可核验位置 | 本笔记处理 |
|---|---|---|
| warmup 1,200 vs 120 | Sec. 4.1 p. 4;Table 14 p. 16 | 同时记录,不猜哪一个用于全部训练 |
| batch 算术不一致 | Table 13 p. 15 | 2,048 长度列的 per-GPU 32 × 8 GPUs × accumulation 32 = 8,192 条,非表列总批量 1,024;差 8 倍,实际配置需核对 |
| hidden skip 的 $H_0/H_1$ 混写 | Table 4 与相邻正文 p. 7 | 表与实验目标明确写 $H_0$;解释按表,保留正文公式疑似笔误说明 |
| Dense learnable 尺寸 | Fig. 6 右图注 p. 6 写 468M;正文说 8-layer;热图亦仅显示 8 层 | 不将该热图当已确认的 24 层/468M 定量证据 |
| 后层 Sparse 的层号 | Table 10 p. 14 为 5–7;正文及 Table 11 为 6–8 | 各结果沿用其原表层号,不合并数值 |
| entropy 方向与下标 | A.1 p. 12 | 明确指出数学方向错误与求和下标歧义 |
| Plus / Dense 实现细节欠明确 | Sec. 3.2 p. 3 | 不臆造 logits 初始化、全程约束或缓存定义 |
| 规模配置不完整 | Sec. 4.2 p. 5 含 320M;Table 14 p. 16 未列 | 不补造 320M 架构;1.6B 按单独协议记录 |
这些问题影响精确复现与机制解读,但不自动推翻 Tables 2、3、8 报告的数值。论文也没有报告完整随机种子、多次运行误差、所有比较的调参成本、实际缓存字节数及推理吞吐。本文对“更好”的使用限于报告结果,不加上未测得的显著性或部署收益。
5.3 作者限制与本次分析
作者在 Limitations(p. 9)承认可学习系数仍停在相对较优而非最优设置,受算力限制未做更大规模验证。v5 已有 1.6B 实验,所以应理解为更大规模覆盖仍有限,不能说完全没有较大模型实验。主要机制消融仍集中在 82M,主下游结果在 468M;1.6B 使用内部数据,独立复现受数据可得性限制。
本次分析认为,最稳固的是结构对照与多组 loss 改善,较弱的是“准确的单一机制”与普遍效率比例。梯度范数、value 相似度、PCA 和 attention sink 提供互相呼应的线索,但尚未证明原始信息保留、sink 缓解与下游提升之间的完整因果链。
5.4 组会讨论或后续复现的具体问题
- 在一致的总参数、token、训练 FLOPs 和调参预算下,普通 Learnable、Plus、后层 Sparse 的优势是否稳定?
- 为何 Table 4 的 0/1 初始化下 hidden 优于 value,而 0.5/0.5 下顺序相反?这能否帮助区分优化与表示因素?
- 长训练后 SVFormer 的交叉点是否真实出现?在相同累积学习率下改变长度,现象是否仍在?
- 使用相同任务与样本,能否独立操纵首 token 的 value norm,检验 sink 缓解是否造成质量提升?
- 真实推理服务中,共享 V 的读取布局、kernel 支持、cache 带宽和并行策略是否把容量收益转化为延迟收益?
这些是根据本文证据提出的研究问题,不是已经开展或验证的实验。
5.5 使用这些成品
英文 Beamer PDF 与 可编辑 TeX 按约 25 分钟主讲组织,附备份页。图件为作者原图或原 PDF 裁切,来源与裁切坐标记录在 figures/manifest.json。重编译命令:
python3 build_slides.py slides.en.tex需要已安装的 pdflatex 与标准 Beamer;也可用 --pdflatex /absolute/path/to/pdflatex 指定路径。源码阅读、图表核对和幻灯片构建不等于复现论文训练结果。交付核验记录见 quality-checks.md,论文库导航见 总索引。