LightTransfer:从预训练 Transformer 中识别并利用层级局部性
论文:LightTransfer: Your Long-Context LLM is Secretly a Hybrid Model with Effortless Adaptation
作者:Xuan Zhang、Fengzhuo Zhang、Cunxiao Du、Chao Du、Tianyu Pang、Wei Gao、Min Lin
版本:arXiv:2410.13846v3,2026-05-18 修订;论文标注发表于 TMLR,09/2025。
研读日期:2026-10-21。
原文:arXiv v3 · 本地 PDF · 英文汇报 PDF · 可编辑 TeX
论文总览
LightTransfer 要解决的问题是:能否利用现成 Transformer 已经形成的层间分工,把部分全注意力层转换成固定窗口注意力,从而降低长序列生成的 KV 缓存成本?作者观察到,一些层主要关注开头的少量注意力汇聚 token(attention sinks)及最近 token,而且同一输入中的这种偏好通常能从预填充延续到解码。方法据此保留需要访问全局历史的层,将其余选中层改为流式注意力(streaming attention)。
论文提供两条路径。LightTransfer-Test 在长输入的预填充阶段逐层选取,不更新模型参数;LightTransfer-Train 针对短问题、长推理输出,在训练集的问答序列上预选层,再用约 5K 样本进行监督微调。层本身、前馈网络和残差通路均保留,改变的是部分层访问历史 KV 的范围。
三个主要结果需要连同条件理解:
- 长上下文质量:表 2 中,四种模型在所报告 LongBench 任务上的模型平均分,平均下降 1.45 个分数点;这是替换 50% 层的结果,不是相对下降 1.45%。
- 吞吐:Mistral-7B、16K 输入、保留 50% 全注意力层,并让各方法采用能容纳的最大批量时,相对完整缓存达到 2.17 倍 token 生成吞吐。
- 长推理:约 5K 样本的混合架构训练后,AIME24 从 QwQ-STILL 的 46.7% 到 53.3%;免训练版本为 40.0%,训练适配对这一场景有实质作用。
贡献主要在于把注意力分配、按层缓存预算和预填充期间的及时释放结合起来。其结果支持“预训练模型中存在可利用的层级局部性”,实际收益取决于模型、任务及保留全局访问的预算。原文 Secs. 5–6,PDF pp. 5–11。
结构地图
以下页码从 PDF 第 1 页开始计数,与正文页脚一致。
| 原文章节 | 论证作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 从 KV 成本提出轻量转换问题 | pp. 1–3,图 1 |
| 2 Related Works | 定位混合架构、转换训练与缓存压缩 | pp. 3–4 |
| 3 Preliminary | 区分预填充与逐 token 解码 | p. 4 |
| 4 Observations | 层级局部性及同一输入内的稳定性 | pp. 4–5,图 2 |
| 5.1 LightTransfer-Test | lazy ratio、优先队列与 FlashAttention 统计量 | pp. 5–6,式 (1)、图 3、表 1 |
| 5.2 LightTransfer-Train | 训练集预选层与监督适配 | p. 6 |
| 5.3 Theoretical Analysis | 隐状态递推及 logit 误差界 | pp. 6–7,定理 5.1 |
| 6.1 Long-Context Understanding | LongBench 与 NIAH | pp. 7–9,表 2、图 4 |
| 6.2 o1-like Long Reasoning | 约 5K 样本训练与数学评测 | pp. 9–10,表 3–4、图 5 |
| 6.3 Ablation Studies & Analysis | 保留比例、吞吐、选层策略 | pp. 10–12,图 6–7、表 5 |
| 7 Conclusion | 归纳转换收益 | p. 12 |
| A Settings | 精度、硬件、窗口和不同任务的预算 | p. 16 |
| B Discussions | 按层设计的系统理由、KL 实验与局限 | pp. 16–18,表 6–8 |
| C Additional Experiment Results | 超参数、SnapKV、按头基线、MoE 和选层比较 | pp. 19–21,图 8、表 9–11 |
| D More Examples | 更多输入内的注意力稳定性示例 | p. 21,图 9 |
| E Notation;F Theoretical Analysis;G Supporting Lemmas | 范数定义、正式定理和证明 | pp. 21–26,式 (2)–(12)、定理 F.3、引理 G.4 |
一:动机——全局访问是否需要每一层都承担?
自回归模型用 KV 缓存保存过去 token 的 key 和 value,避免每个生成步骤重新投影历史 token。缓存随序列长度与层数增长,长上下文时会限制可同时服务的请求数量。只保留固定窗口能显著降低缓存,但若所有层都无法访问中间历史,远距离检索和跨文档推理就容易受损。
混合架构把全局访问和局部处理分配给不同层。LightTransfer 的出发点是:预训练全注意力模型可能已经形成类似分工,因此可以从注意力行为中识别这种分工,减少转换所需训练。与依赖预设层位置的方案相比,关键问题是这一输入究竟需要哪些层保留完整历史。
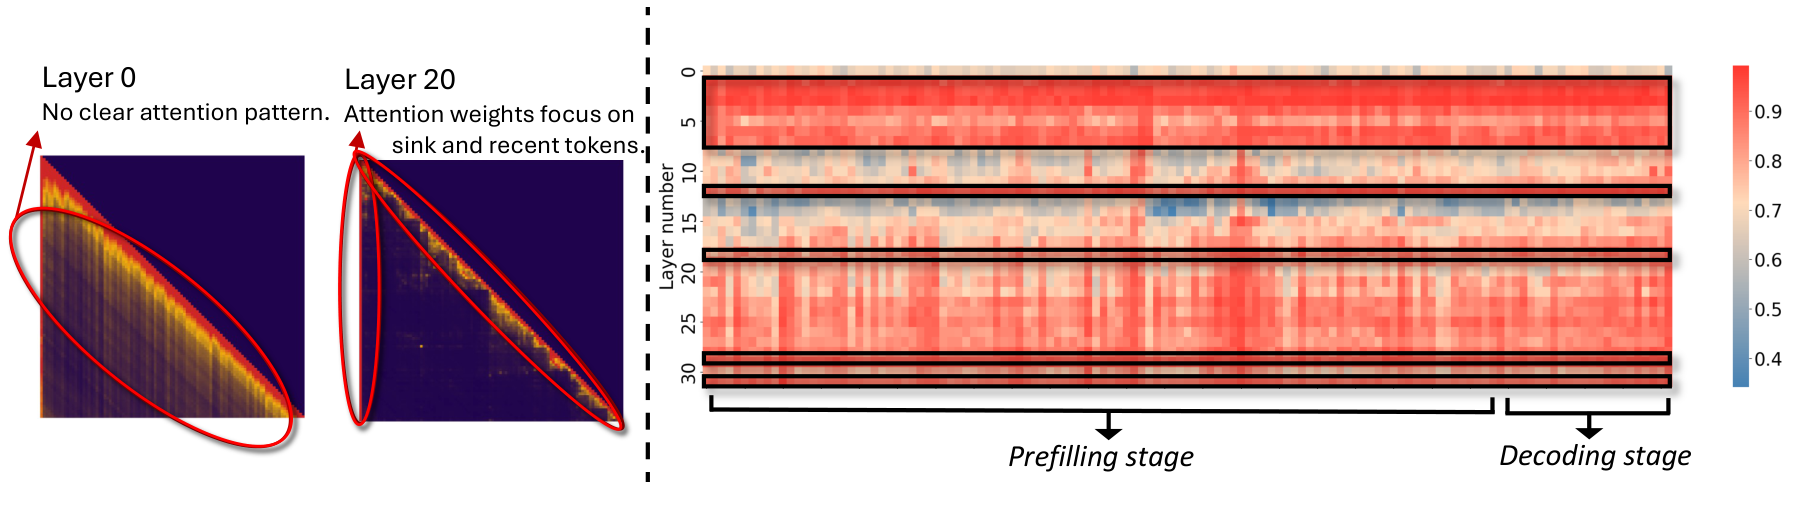
原图 2,PDF p. 4。左侧比较第 0 层与第 20 层的注意力图;右侧横轴为 token,纵轴为层号,颜色越红表示分配给开头与最近窗口的注意力总量越大。黑框标出持续呈现高占比的层。
第 20 层表现出明显的开头与局部窗口偏好;右图的一些横向高值区域跨越预填充与解码,支持用输入末尾的行为预测生成阶段的访问需求。附录图 9 又提供了两个输入示例。作者同时指出,lazy 层的位置会随输入改变,因此 Test 模式逐请求选层。这里的 lazy 描述的是历史访问局部性,并不意味着这个 Transformer 层整体没有计算价值。(Sec. 4,PDF pp. 4–5;App. D,p. 21。)
二:方法——从注意力质量到缓存释放
2.1 用 lazy ratio 衡量可安全截断的程度
令 $X_{\text{last}}$ 为输入末尾的 $w_{\text{last}}$ 个 query,$X_{\text{initial}}$ 为最初 $w_{\text{sink}}$ 个 token,$X_{\text{recent}}$ 为最近窗口。将式 (1) 中的 token 集合记作并集,可写成
$A_i(\hat{x},x)$ 是第 $i$ 层从 query $\hat{x}$ 到 key $x$ 的注意力权重,已对注意力头取平均;因果遮罩使未来位置权重为零。$r_i\in[0,1]$,数值越大,移除中间历史时删去的注意力质量越少。核心符号如下。
| 符号 | 含义 |
|---|---|
| $L$、$P$ | 总层数、保留全注意力的层数 |
| $w_{\text{sink}}$、$w_{\text{recent}}$ | 保留的开头 token 数、最近窗口大小;默认分别为 4、1020 |
| $w_{\text{last}}$ | 估计分数所用的末尾 query 数;附录比较 8、16、32、64 |
| $r_i$ | 第 $i$ 层分配给保留位置的平均注意力比例 |
| $\mathcal I$ | 最终改用流式注意力的层集合 |
固定替换层数时,算法优先替换 $r_i$ 最大的层,等价于最小化所选层的经验删除质量 $\sum_{i\in\mathcal I}(1-r_i)$。它是相对排序,不要求每个被选层都超过统一阈值;预算过紧时,即使某层分数并不高,也可能被替换。(Sec. 5.1,PDF pp. 5–6,式 (1)。)
2.2 优先队列让缓存释放发生在预填充过程中
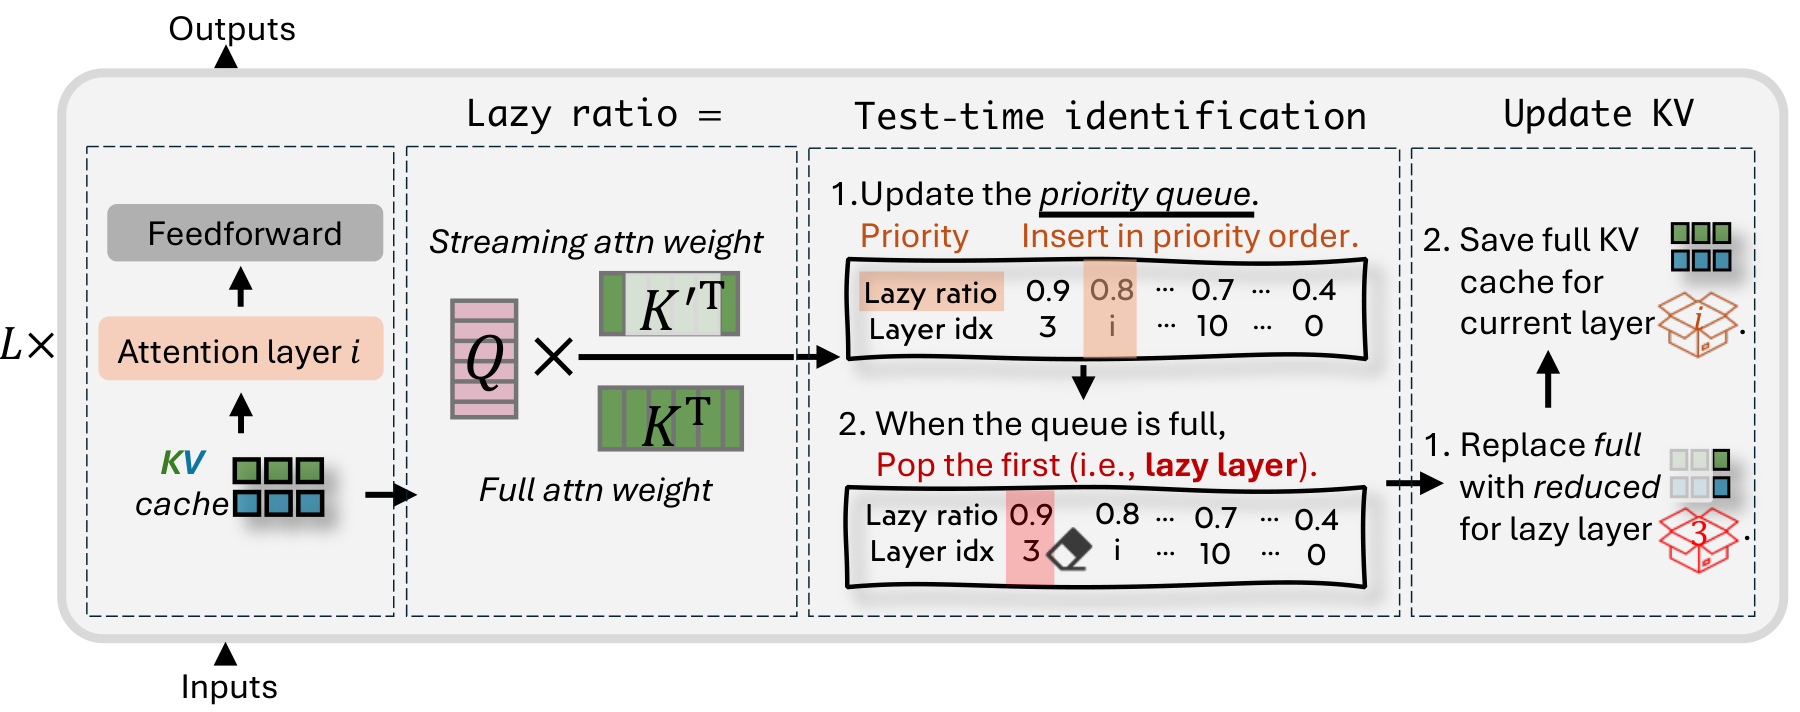
原图 3,PDF p. 5。从左向右依次是原层计算、lazy ratio 估计、队列选层和 KV 更新。
模型仍按顺序完成各层的预填充计算。每完成一层,就把其 $(r_i,i)$ 加入最大堆;堆中保留当前仍有资格维持全缓存的层。一旦超过容量 $P$,弹出分数最大的层,只留下该层开头及最近窗口的 KV。这个层可能是刚算完的当前层,也可能是先前的层。结束时,堆内恰好是分数最低的 $P$ 层,它们继续保留全注意力。
下面是按论文流程整理的教学伪代码:
heap = empty max-heap, capacity P
for layer i in model order:
    run full causal prefill for layer i; obtain KV and LSE
    r_i = mean attention mass on initial + recent positions
    push (r_i, i) into heap
    if heap size > P:
        j = pop layer with largest r
        trim cache[j] to initial + recent positions
        use streaming attention for layer j during decoding
decode with full caches for layers remaining in heap
例如 4 层的分数依次为 $0.93,0.40,0.86,0.60$,令 $P=2$,最终第 2、4 层保留全缓存,第 1、3 层转为流式访问。这个在线过程只需维护当前最低的 $P$ 个分数,不需要预先知道后续层的分数。
及时释放是系统收益的一部分:若等所有层预填充完成才压缩,峰值时仍要容纳所有完整缓存。在线队列则在前向过程中逐步释放。处理当前层时仍有临时 KV 和激活,不能把峰值简单视作精确的 $P$ 层缓存。进入解码后,流式层的最近窗口随生成位置前移,窗口外的旧 KV 持续淘汰。(Sec. 5.1,PDF p. 6;Sec. 6.3,p. 11。)
2.3 利用 FlashAttention 的归一化统计量降低识别成本
FlashAttention 不显式输出完整注意力矩阵,但能提供每个 query/head 的 log-sum-exp(LSE)归一化项。若只为得到 $r_i$ 重建全注意力矩阵,会损失原有计算优势。论文只重新计算末尾 query 到保留 key 集合的小矩阵,再复用全注意力的分母。
以下是对表 1 的数学展开。令 $z_{h,t,j}$ 为采用相同缩放及因果遮罩后的注意力 logit,$S_t$ 为该 query 可见的保留位置,则
新增矩阵乘的量级为 $O(Hw_{\text{last}}(w_{\text{sink}}+w_{\text{recent}})d_k)$。窗口大小和头维度固定时,该新增计算对输入长度是常数级。正文报告 4K–32K 输入下,识别造成的归一化吞吐损失为 0.0058–0.0014,即约 0.58%–0.14%。(Sec. 5.1,表 1,PDF p. 6。)
表 1 是示意代码:它只返回 log ratio,未完整写出式 (1) 所需的指数恢复和跨头、跨 query 平均;代码中的张量形状注释与切片约定也不完全一致。实现时需要统一张量布局,并与 FlashAttention 使用相同的缩放、位置变换、因果遮罩和对应 query 的 LSE;短输入下还要避免开头与最近集合重叠计数。对多个 query 的 log ratio 直接求平均并不等价于对其概率质量求平均。
2.4 缓存节约的计算方式
以下为根据方法得到的教学估算。令总历史长度为 $T$,流式窗口总长度为 $W=1024$,各层 KV 头数和维度相同,且 $T\ge W$。忽略临时工作区后,缓存保留比例约为
例如 $T=16384$、$\alpha=0.5$ 时,比例为 $0.53125$,即约减少 46.9% 的 KV 存储。替换一半层不等于恰好删除一半 KV:流式层仍保留固定窗口。全模型权重和前馈计算也没有随之减半。
全局层仍使总缓存随 $T$ 线性增长。Test 模式仍执行完整预填充注意力,因此主要改变的是持久 KV、后续解码访问量和可用批量;上述公式也不是总显存或端到端时延的预测式。
2.5 Train 模式解决短输入下分数不可辨识的问题
数学问题可能只有几十个词,而保留窗口有约 1K token。此时几乎所有输入位置都落在窗口内,各层 $r_i\approx1$,无法根据短 prompt 判断未来几万 token 推理应保留哪些全局层。
训练流程先把训练样本的问题和答案一起输入,用足够长的序列识别各样本的 lazy 层;统计每层被选中的频次,固定选用频次最高的层;再在这个混合结构上进行监督微调。测试时只使用固定层集合,不读取测试答案,也不重新逐请求识别。
Sec. 6.2 的具体实验采用 QwQ-STILL 公开数据与蒸馏流程,以 Qwen2.5-32B-Instruct 为基础模型,约 5K 样本,50% 层使用 streaming attention,并通过 Flex Attention 支持训练。因此更准确的理解是“沿公开长推理蒸馏流程训练一个适配后的混合模型”。论文没有将这个实验单独设计成一个完全分离的、仅测试已训练 QwQ 权重转换代价的对照。(Secs. 5.2、6.2,PDF pp. 6、9–10。)
2.6 理论主线:删除注意力质量如何传递成输出误差
单个注意力模块。 固定 query、key 和 value,令被删位置的注意力总量为 $\delta$,所有 value 向量范数不超过 $V_{\max}$。删除这些位置后,保留位置的权重会重新归一化。引理 G.4 给出
直觉是两种变化各贡献一次删除质量:被删 value 的直接贡献至多为 $\delta V_{\max}$;保留权重重新归一化的变化也至多为 $\delta V_{\max}$。这个结果直接说明,挑选保留质量大的层为何合理。(App. G,引理 G.4,PDF pp. 25–26。)
跨层误差。 论文分析具有预归一化和残差连接的 $L$ 层 Transformer。所有权重的 Frobenius 范数至多为 $B$,激活函数为 $L_{\mathrm{lip}}$-Lipschitz;归一化在证明中简化为投影到单位二范数球。定义
其中 $\|\cdot\|_{2,\infty}$ 表示先取每个 token 隐状态的二范数,再在 token 间取最大值。正式定理中的删除量为
$D_t$ 是 query $t$ 对应的被删位置集合,$A_{i,h}$ 来自原模型。令
则式 (4) 为
三项分别是残差传递的已有误差、当前层对已有误差的放大、当前层截断新增的误差。单位球归一化让两个归一化状态的距离至多为 2,产生截断项。对各层求和并乘上输出投影的范数界,得到式 (5):
证明的组织是先用三角不等式分解残差、MHA 和 FFN 的误差,再结合注意力的 Lipschitz 性与单层删除界,最后展开递推。(App. F,PDF pp. 21–25;定理 F.3 和式 (4)–(5) 在 p. 23。)
本次分析:如何理解理论与算法的关系。 正式 $s_i$ 取所有 query 中的最大删除质量,实际 $1-r_i$ 只取末尾少量 query 的平均值;二者通常并不相等。因而算法精确优化的是经验平均删除质量,而理论给出的是最坏 query 的误差控制动机;输入内稳定性观察为这两者提供经验联系。最终松弛界还含与删除量无关的加法项,其数值不能直接读成实际误差很小。单位球投影也与实际 RMSNorm/LayerNorm 的参数化不同,迁移常数需要另行控制。定理针对固定输入的网络输出;监督微调后的性能改善主要由实验支持。
三:实验——先分清任务、预算与评分
3.1 三组主实验的条件
| 实验 | 对象与任务 | LightTransfer 的预算与适配 | 评价 |
|---|---|---|---|
| LongBench | LLaMA2-7B-chat、Mistral-7B-Instruct、LLaMA3-8B/70B-Instruct;表 2 报告 16 个任务 | Test;50% 层保留全注意力 | 各任务官方分数及表内平均分,越高越好 |
| NIAH / RULER | Mistral-7B;单键、多键检索;4K、8K、16K、32K | Test;75% 层保留全注意力 | 检索得分,越高越好 |
| 长推理 | QwQ-STILL 公开训练流程;MATH-OAI、AIME24、GSM8K | Train;约 5K 样本;50% 全注意力层 | 数学答案准确率,越高越好;greedy,最多生成 32K token |
通用设置为 NVIDIA A100、BF16 权重/激活/KV,不做量化,采用 greedy decoding;默认保留开头 4 个和最近 1020 个 token。附录 A.1 为四个模型仅列出“4K、8K、32K”三个上下文窗口值,没有清楚给出四者逐一映射,因此不将其扩写成四模型精确配置。(App. A,PDF p. 16。)
LongBench 的平均分混合了不同任务指标。其官方评测映射包括问答 F1、摘要 ROUGE、类别匹配、检索/计数评分和代码相似度;例如 Qasper 使用 QA F1,GovReport 使用 ROUGE,TREC 使用分类评分,LCC 使用代码相似度。这些都映射到 0–100 分,但表内平均值不能统一解释为“答对题目的百分比”。指标说明参见 LongBench 官方评测代码。
3.2 对照方法各自在比较什么
| 对照 | 角色与关键差别 |
|---|---|
| Standard | 原始全缓存模型,衡量转换后的质量损失 |
| StreamingLLM | 所有层均只保留开头与局部窗口,检验保留全局层的必要性 |
| MiniCache | 对后半部分相邻层做 KV 合并;作者重实现,最大相当于压缩 25% 层的缓存 |
| SqueezeAttention | 按层分配缓存预算;论文将其设为与 LightTransfer 相同的名义压缩预算 |
| LongGen | 依据层位置预设混合结构,在长推理实验中检验数据驱动选层的价值 |
| DuoAttention、RazorAttention、HeadKV | 附录补充的按头策略,比较更细粒度选择与校准需求 |
MiniCache 与 LightTransfer 的主表预算不同,因此主表不能被视为所有方法严格等存储的比较。后文吞吐实验又涉及预填充峰值和最大可用批量,缓存预算与系统吞吐要联合分析。(Sec. 6.1,PDF p. 7;App. A.1,p. 16。)
四:结果——有效性、效率与失败边界
4.1 LongBench:平均损失较小,但模型与任务差异明显
表 2 的模型平均分如下,数值越高越好;最后一列按表中已四舍五入的平均分计算。
| 模型 | Standard | Streaming | MiniCache | SqueezeAtt. | LightTransfer | 相对 Standard 的分数变化 |
|---|---|---|---|---|---|---|
| LLaMA2-7B-chat | 31.8 | 28.3 | 27.7 | 28.7 | 29.5 | −2.3 |
| Mistral-7B-Instruct | 47.6 | 37.4 | 35.3 | 42.5 | 47.4 | −0.2 |
| LLaMA3-8B-Instruct | 40.8 | 36.1 | 31.7 | 36.5 | 38.7 | −2.1 |
| LLaMA3-70B-Instruct | 44.8 | 40.0 | 40.1 | 41.3 | 43.6 | −1.2 |
来源:表 2,PDF p. 8;LightTransfer 将 50% 层改为流式注意力。
四个模型平均下降 $(2.3+0.2+2.1+1.2)/4=1.45$ 个分数点。若以四模型 Standard 平均分 41.25 为分母,相对下降约为 3.52%。原文摘要和结论写作“低于 1.5%”,理解为平均绝对分差更符合表格。
Mistral 的总体表现几乎保持,同时全层 Streaming 从 47.6 降到 37.4,说明在这个模型上保留一部分全局层确实十分有效。LLaMA3-8B 的总体损失则掩盖了较大的任务差异:Qasper 从 32.8 降到 18.3,GovReport 从 28.8 降到 24.1,而 TriviaQA 从 90.6 到 91.1,LCC 从 58.1 到 60.2。任务级的远程信息需求比总体平均分更能决定部署取舍。
按表中模型平均分再平均,LightTransfer 比 SqueezeAttention 高 2.55 分、比 MiniCache 高 6.1 分;前者在论文设定的相同名义预算下比较,后者的可压缩缓存更少。实验支持选层比均匀地移除历史或按缓存相似性处理更适合这些测试模型,但并不是每个任务都优于所有基线。
4.2 NIAH:需要更多全局层,且多键结果存在原文矛盾
NIAH 将相关信息埋在长输入中,检验模型是否还能跨越局部窗口找到目标。论文在这里只替换 25% 层,保留 75% 层的完整注意力,预算比 LongBench 更保守。
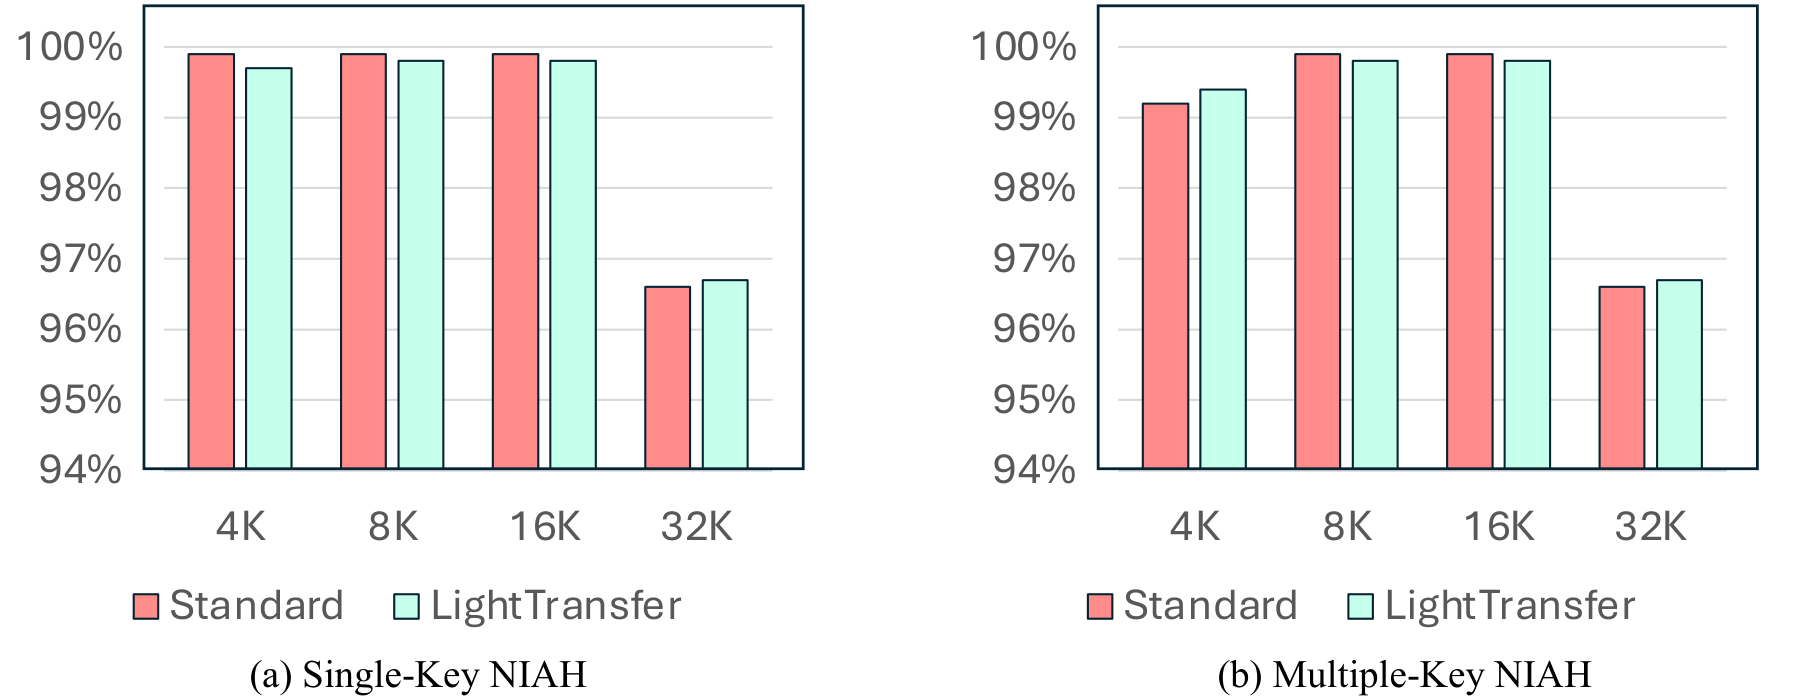
原图 4,PDF p. 9。横轴为 4K–32K 输入长度,纵轴为检索分数;两组面板分别标为单键、多键,粉色为 Standard,浅绿色为 LightTransfer。纵轴截断在 94% 以上。
正文报告 32K 单键结果为 LightTransfer 96.7%、Standard 96.6%,与图中趋势一致。正文同时报告多键为 78.2% 对 78.9%,但图 4 右面板在 32K 处画出的两根柱子都约为 96.6%–96.7%。这不是读取图像的微小误差,而是同一版本中的图文冲突。因此保留两组出处,引用 78.2/78.9 时应明确它们来自正文,无法由该图确认。两处均显示转换模型接近标准模型,但多键的绝对得分需要作者澄清。(Sec. 6.1.2、图 4,PDF p. 9;App. A.2,p. 16。)
4.3 长推理:训练适配比纯测试时转换更可靠
| 方法 | MATH-OAI ↑ | AIME24 ↑ | GSM8K ↑ |
|---|---|---|---|
| QwQ-STILL | 90.2 | 46.7 | 95.6 |
| LongGen | 78.2 | 16.7 | 95.4 |
| LightTransfer-Test | 85.0 | 40.0 | 未在表 4 中报告 |
| LightTransfer-Train | 90.7 | 53.3 | 95.5 |
来源:表 3–4,PDF pp. 9–10;准确率单位为百分比。Train 使用约 5K 样本及 50% 流式层。
Train 相对 QwQ-STILL 的变化是 MATH-OAI +0.5 个百分点、AIME24 +6.6 个百分点、GSM8K −0.1 个百分点。Test 在 MATH-OAI 和 AIME24 上仍分别低 5.2、6.7 个百分点,因此不能将 Train 的结果归为零训练转换收益。论文表 4 还报告 MiniCache 为 20.0/0.0、SqueezeAttention 为 82.6/15.0、DuoAttention 为 79.2/33.3(依次为 MATH-OAI/AIME24);这里的 DuoAttention 需要头选择校准。表题说“不调整 LLM 参数”,但表中也列入 LightTransfer-Train,对是否更新参数应依据方法定义区分。
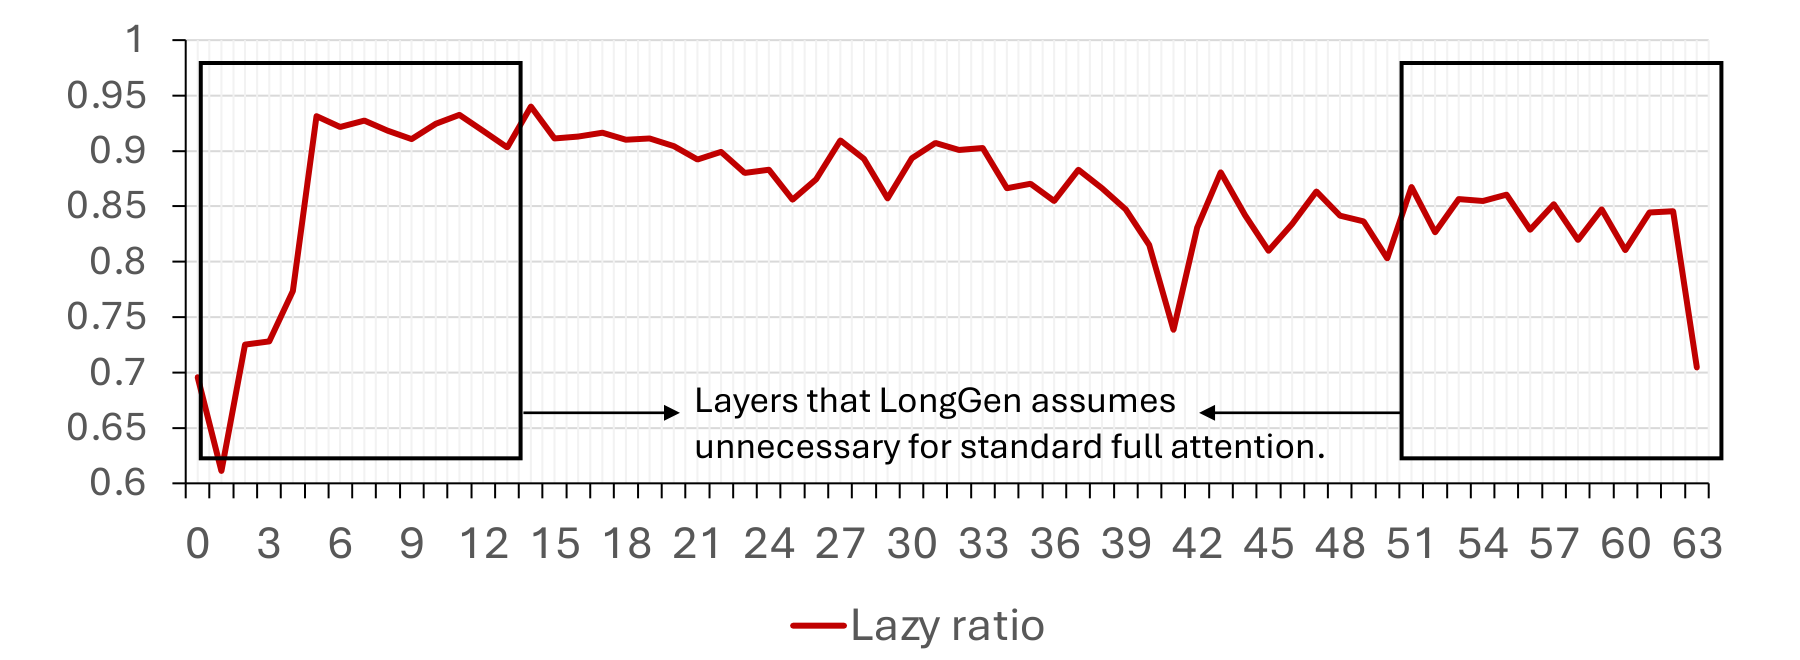
原图 5,PDF p. 10。横轴为层号 0–63,纵轴为 lazy ratio;黑框标出 LongGen 按位置预设为无需完整注意力的两端区域。
曲线显示层位置与局部性并不简单对应:部分起始层 lazy ratio 很低,说明它们仍有较多注意力分配给中间历史。把两端统一转换的策略会误伤这类层。这为 LongGen 在更难数学任务上的下降提供了机制解释,但单凭这张曲线不能把全部差距归因于一个因素。
论文没有给出这些数学分数的多次运行区间;AIME24 的单次分数提升适合解释为所报告设置中的结果,不足以估计稳定收益的大小。还应区分参数规模相同与训练成本相同:约 5K 样本可以含很长的推理轨迹,样本数本身不等于 token 或 GPU 时间预算。
4.4 保留比例、吞吐和选层策略
保留更多全局层有助于质量。 图 6 在 LLaMA3-8B/70B 上比较 25%、50%、75% 的全注意力层保留比例。两模型中 LightTransfer 的分数均随保留比例增大而提高,并在图示预算下高于 SqueezeAttention。这使 $P$ 成为直接的质量—缓存控制旋钮。(Sec. 6.3,图 6,PDF pp. 10–11。)
吞吐收益包含可容纳批量的变化。 表 5 的设置是 Mistral-7B、RULER 输入、50% 全注意力层,各方法使用各自最大批量,完整缓存吞吐归一化为 1。
| 方法 | 4K | 8K | 16K | 32K |
|---|---|---|---|---|
| SqueezeAttention | 1.03× | 1.09× | 1.12× | 1.04× |
| MiniCache | 1.26× | 1.29× | 1.52× | 1.41× |
| LightTransfer | 1.44× | 1.78× | 2.17× | 1.75× |
来源:表 5,PDF p. 11;越高越好。
作者将优势归因于预填充期间就释放缓存,使更大批量可行。SqueezeAttention 在完成所有层预填充后才压缩,受峰值显存限制;MiniCache 的缓存压缩上限更低。最高 2.17 倍出现在 16K,而不是 32K;这些是服务吞吐结果,不能直接转述成单请求逐 token 时延下降相同比例。NIAH 质量实验保留 75% 全局层,而这里为 50%,两者也不是同一预算下成对测得的质量和速度。
选择哪些层比只设定比例更重要。 图 7 比较全注意力、LightTransfer、Pyramid 和不同层区间内的随机选择。LightTransfer 在图示三项任务上优于其他替换策略,支持按实际注意力分配选择。附录表 11 给出更精确的额外比较:
| LLaMA3-8B 的选层方法 | HotpotQA | MuSiQue | NarrativeQA |
|---|---|---|---|
| Shapley value–based | 39.97 | 18.18 | 19.63 |
| BERTology | 42.48 | 18.13 | 20.91 |
| LightTransfer | 43.70 | 20.90 | 23.20 |
来源:App. C.5,表 11,PDF p. 21。
按表格,HotpotQA 超过最强基线 BERTology 的幅度为 1.22 分;正文所谓“超过次优方法 3.7%”实际上接近对 Shapley 的差值 3.73 分,不能按其文字直接引用。
4.5 附录补充:窗口、组合压缩与模型范围
注意力汇聚 token 很重要。 表 7 中,最近窗口从 252、508、1020 到 2044 时,分数依次为 39.5、39.8、39.8、40.1;$w_{\text{last}}$ 为 8、16、32、64 时,分数为 39.9、39.8、39.9、39.7。但 sink 数从 0 到 2、4、6 时,分数为 26.5、39.8、39.8、39.9。因此超参数较稳健的结论需要保留条件:完全去掉 sink 会产生显著损失。该表没有明确标注具体模型和聚合任务,适合用于比较其内部趋势,不能与表 2 的模型均分直接拼接。(App. C.1,PDF p. 19;表 7 在 p. 18。)
与 SnapKV 的组合分工清楚。 对 lazy 层使用 LightTransfer,对 non-lazy 层使用 SnapKV 做层内压缩;Qwen2.5-3B-chat-32K 的图 8 显示组合后的性能和压缩比均提高。图中浅绿柱对应左轴性能、红线对应右轴压缩比;这是按层分配与层内筛 token 的互补证据。原图未在数据点上标精确数值,本文只采用其趋势。(App. C.2、图 8,PDF p. 19。)
按头基线。 在 LLaMA3-8B-Instruct-Gradient-1048K、50% 稀疏度和表 9 所列 11 个任务上,Razor、HeadKV、LightTransfer、DuoAttention 的平均分分别为 31.63、35.33、40.64、40.98。LightTransfer 接近 DuoAttention,免去独立校准集。这里 Razor/HeadKV 使用了完整 LongBench 的输入作为校准,模型和任务集合也与主表不同,40.64 不能用来直接替换主表的 38.7。(App. C.3,PDF p. 19;表 9 在 p. 20。)
MoE。 Qwen1.5-MoE-14.3B-A2.7B 替换 50% 层后,表 10 平均分为 35.43,Standard 为 36.26,下降 0.83 分;MiniCache 和 SqueezeAttention 分别为 26.81、33.30。说明相同的层级缓存选择思路也能用于该 MoE 模型,其收益来源仍是注意力缓存,而不是专家数量变化。(App. C.4,表 10,PDF pp. 19–20。)
4.6 为什么采用按层设计,以及理论验证的实际含义
系统设计。 App. B.2 指出,张量并行中不同 GPU 处理同层的不同头,若各头缓存长度不均,快的一侧可能等待慢的一侧。作者还在 LLaMA3-70B、8×A100 40GB 上比较纯 TP 与“注意力数据并行+FFN 张量并行”:4K 时为 1981.9 对 145.6 tokens/s,后者在所列更长输入上 OOM。作者将其归因于注意力参数复制、单请求 KV 不再同样分片以及负载平衡困难。这解释了该实现选择按层统一缓存形状的动机;该对照直接比较的是并行策略,并非所有按头压缩实现的普遍效率上限。(表 6,PDF p. 17。)
理论验证。 App. B.3 的表 8 报告所谓 KL divergence 均为负数,平均值为不压缩时 $-7.1\times10^{-6}$、50% 层压缩时 $-1.2\times10^{-5}$。数学上的 KL 非负,这些近零负值可能涉及数值误差或计算实现,原文未澄清。该实验也没有将实测 logit 误差与式 (5) 的右侧实际数值对比。因此它不能支撑作者所说“验证上界在实践中紧”的强结论。理解论文理论时,以单层删除质量界及跨层递推的机制意义为主更稳妥。(App. B.3、表 8,PDF p. 18。)
五:结论——可以从这篇论文带走什么?
LightTransfer 最有价值的思路,是把模型已经学到的注意力分工转化为一个可执行的缓存配置:用低成本统计量判断哪里需要完整历史,在预填充阶段及时淘汰其余层的中间 KV,再让解码利用固定窗口。这样,准确率取舍与系统资源管理发生在同一条流程中。
实验中,长输入能够提供选层信号,Mistral 尤其容易在较小平均损失下压缩;短输入、长推理则需要利用训练序列预选和适配。对实际使用,首先应按任务检查细项损失,例如 LLaMA3-8B 的 Qasper 下降,再选择全局层预算;不应只依据跨模型平均分设置统一压缩比例。
值得继续研究的问题是:在流式生成中,是否能低成本监测层功能变化,并在需要时恢复更大的历史访问范围?当前方法的判断主要来自输入末尾,删掉的中间 KV 又不能直接恢复,这让“何时重评估”和“如何保留恢复信息”成为相互关联的设计问题。理论上,也可以研究用更稳健的分位数或最坏 query 指标选层,缩小经验平均分与正式误差界之间的差距。这些是由方法结构引出的后续方向,论文尚未验证。