LoLCATs:On Low-Rank Linearizing of Large Language Models
中文精读笔记|2410.10254v3|r1
- 作者:Michael Zhang、Simran Arora、Rahul Chalamala、Alan Wu、Benjamin Spector、Aaryan Singhal、Krithik Ramesh、Christopher Ré。
- 版本:arXiv v3,2025-03-05 修订;arXiv 页面标注 ICLR 2025。获取与研读日期:2026-09-28。
- 原始材料:arXiv 版本页 · 本地论文 PDF · 作者主 TeX · 源码清单。
- 配套:英文汇报 PDF · 可编辑 Beamer TeX。
- 阅读范围:正文 Sec. 1–5、局限讨论;附录 A 的训练配置、B.1–B.7 全部实质性实验、C 的伪代码和硬件实现、D 的相关工作;E 阅读示例说明并抽查生成示例及注意力图,不把这些样例视为系统评测。参考文献用于定位,没有逐篇阅读被引文献,也没有运行作者训练代码。
- 材料说明:PDF 与 TeX 均成功获取。实际 PDF 对应
main.tex及其引用文件;包中的main_iclr.tex、旧稿和未被引用的表格未用作最终结果。以下页码均为 PDF 页码,从 1 开始,本版本与印刷页码一致。
论文总览
LoLCATs(Low-rank Linear Conversion via Attention Transfer)的关键贡献是把“将预训练 Transformer 转成次二次模型”分为两个容易优化的子问题:先以原模型为教师训练注意力替代模块,再用很小的低秩权重更新适配替换后的整网。这让转换不必从头训练语言模型,也不必默认做全参数继续预训练。
作者的完整方案包含三个相互配合的设计:输出均方误差驱动的注意力迁移(attention transfer)、局部 softmax 与远端线性注意力的层内组合、以及大模型上的分块迁移。名称中的 low-rank 指第二阶段的 LoRA 更新,不代表把整个模型权重压缩为低秩矩阵。
最有说服力的结果是:在论文的低成本转换设置下,Llama 3 8B 的五项零样本任务平均分达到 74.2,原模型为 73.1;但 5-shot MMLU 从 66.6 降至 52.8。70B/405B 转换后的 MMLU 分别为 67.70/72.20,明显高于相同替代架构、无注意力迁移的对照,但仍低于原模型的 78.80/82.98。因此,更准确的结论是显著改善转换的质量与追加训练成本,而非全面无损替代 Transformer。(Table 3,p. 9;Table 6,p. 11)
结构地图
| 原文章节 | 作用与主要证据 | PDF 页码 |
|---|---|---|
| 1 Introduction | 转换目标:质量、参数/token 效率、规模;Fig. 1 框架 | 1–3 |
| 2 Preliminaries | softmax 与线性注意力、递归 KV 状态;Eq. (1)–(3) | 3–4 |
| 3.1 LoLCATs Part 1: A Framework for Low-cost Linearizing | 输出迁移与 LoRA;Eq. (4)–(5) | 4–5 |
| 3.2 Baseline Study: Attention Transfer and Low-rank Linearizing | 两阶段为何都需要;Table 1–2、Fig. 3–6 | 5–7,相关图延至 8 |
| 3.3 LoLCATs Part 2: Components to Improve Low-rank Linearizing | 局部窗口、分块迁移;Eq. (6)–(7)、Fig. 7、Algorithm 1–2 | 7–9 |
| 4.1 Main Results | 与已有转换方法、从头训练模型比较;Table 3–4 | 9–10 |
| 4.2 Component Properties and Ablations | 吞吐/显存;组件消融;Fig. 8、Table 5 | 10–11 |
| 4.3 Scaling Up Linearizing to 70B and 405B LLMs | 大模型结果;Table 6 | 11 |
| 5 Conclusion / Limitations and Future Work | 主张与适用边界 | 11–12 |
| A Experimental Details | 7B/8B、70B、405B 配置差异;Table 7–9、Fig. 9 | 18–21 |
| B.1–B.3 | 多种子、保留全注意力层、1B 规模;Table 10–15 | 22–24 |
| B.4 Study on Parameter-Efficient Training | LoRA 秩、投影选择、窗口;Table 16–18 | 23–27 |
| B.5 Study on Linearizing Data | 数据源、检索、有效序列长度;Table 19–22、Fig. 10–11 | 25–30 |
| B.6 Study on Linearizing Token Budget | 迁移/LoRA 步数;Table 23、Fig. 12–13 | 30–31 |
| B.7 Layer-wise Training Dynamics and Analysis | MSE、LoRA 更新、405B 分块;Table 24–26、Fig. 14–17 | 32–36 |
| C Implementation Details | 教学伪代码、ThunderKittens prefill | 37–44 |
| D / E | 相关工作;生成样例与注意力可视化 | 45–58 |
一:动机
1.1 真正要解决的是“转换成本”
softmax 注意力在逐 token 生成时需要保留不断增长的历史 key/value。线性注意力把历史压进固定大小的状态,适合长生成和大批量推理。但从头训练一个与开放权重大模型同等能力的线性模型仍然昂贵。
作者因此从现成的强 Transformer 出发,保留大部分预训练知识,只替换注意力算子。既有的 SUPRA、Mamba 系转换方案说明这条路线可行,却往往要更新大量参数、使用数十亿到上千亿转换 token,而且质量仍会下降。本文关心的是:架构改动能否先局部校准,使整网只需少量适配?(Sec. 1–2,pp. 1–4)
这里的成本比较必须带上前提:LoLCATs 使用了原模型已经投入巨量预训练得到的权重。“只用 40M tokens”是论文报告的追加转换训练量,不是这个模型从零获得语言能力的全部数据成本。
1.2 为什么不能直接替换后加 LoRA
每层注意力偏差会改变下一层输入分布,多层叠加后不一定能用少量低秩更新修复。反过来,逐层输出匹配也只在教师产生的输入上训练,整网实际运行时仍会遇到累积误差。LoLCATs 用两阶段分别处理这两个问题,而不是假设任一阶段单独足够。
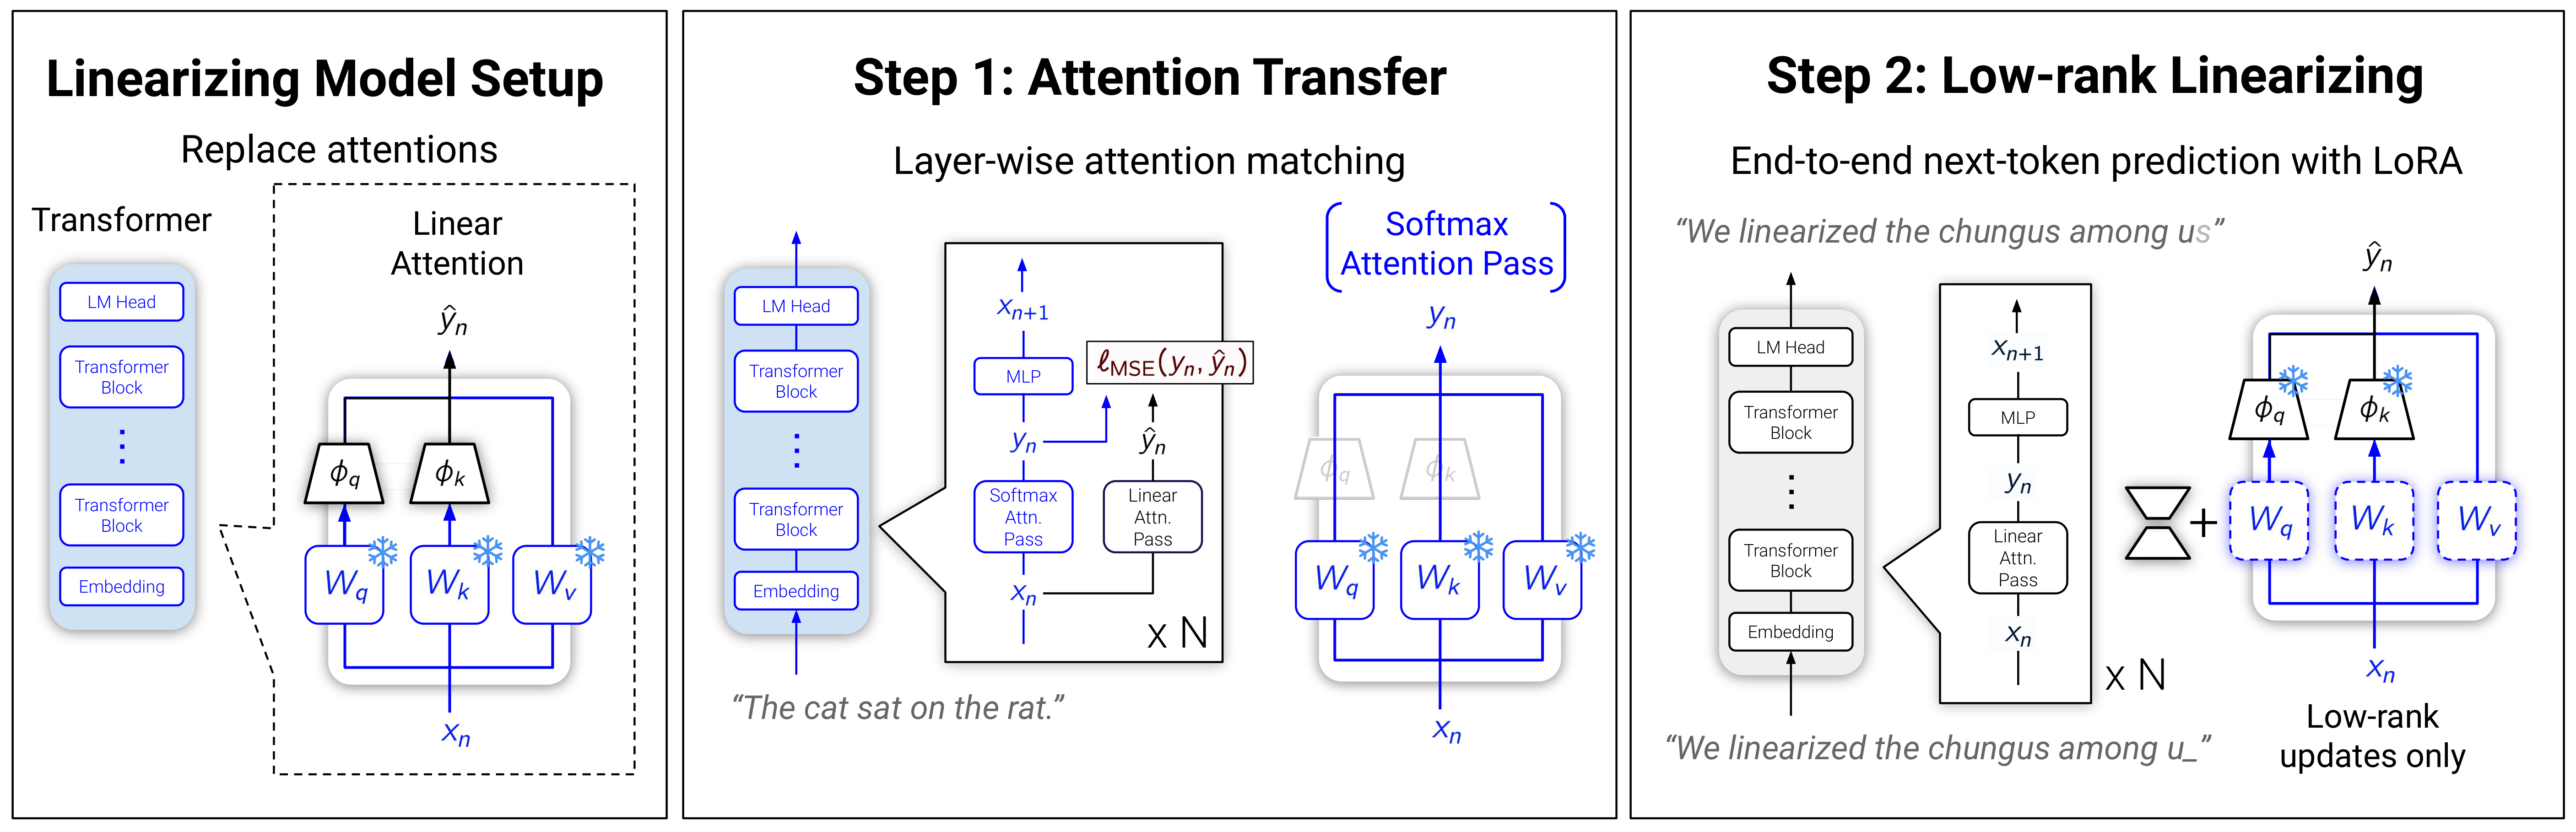
原图 Fig. 1,p. 2。 从左到右:复制预训练投影并加入特征映射;在教师路径上拟合替代注意力输出;切换到替代架构,用 next-token loss 训练 LoRA。第二阶段教师路径不再负责产生隐藏状态。
二:方法
2.1 从注意力矩阵到递归状态
先按单个注意力头理解。设序列长度为 $N$,头维度为 $d$;$q_n,k_i,v_i\in\mathbb R^d$。为避免原文对 $d'$ 的简写混淆,下面用 $F$ 表示特征映射最终输出维度。
| 符号 | 含义与维度 |
|---|---|
| $\phi_q,\phi_k$ | query/key 特征映射,$\mathbb R^d\to\mathbb R^F$ |
| $S_n$ | 历史 key–value 外积之和,$\mathbb R^{F\times d}$;对应原文 $\bm s_n$ |
| $z_n$ | 历史 key 特征之和,$\mathbb R^F$ |
| $H,M$ | 注意力头数、层数 |
| $w$ | 局部窗口大小,默认硬件实现的块尺寸为 64 |
| $r,\alpha$ | LoRA 秩、缩放参数,默认 7B/8B 为 $8,16$ |
| $b$ | 注意力迁移的层块大小;与序列窗口 $w$ 不同 |
因果 softmax 注意力为:
用可分离核 $\phi_q(q_n)^\top\phi_k(k_i)$ 替代指数核,就能改变乘法顺序:
这就是 Eq. (2)–(3) 的递归形式(p. 4)。固定 $d,F$ 时,每个生成 token 的注意力读写只需 $O(Fd)$ 运算,状态大小为 $O(Fd+F)$,不随历史长度增长。这里讨论的是注意力状态和算子成本;模型权重、MLP 与激活仍然存在。
2.2 第一阶段:只学习替代注意力如何工作
输入是预训练 Transformer 和少量自然语言样本;训练对象是新加的特征映射及混合系数;监督信号来自原注意力输出;输出是一组可替换原注意力的已校准模块。
每层都共享冻结的预训练 $W_q,W_k,W_v,W_o$,以同一份 query/key/value 分别计算教师 softmax 输出 $y$ 和学生输出 $\hat y$。给后续层传递的始终是教师结果,这种 teacher forcing 避免学生误差在迁移阶段污染后面各层的训练输入。(Sec. 3.1,pp. 4–5)
训练目标是注意力输出的均方误差。原文 Eq. (5) 对 token 轴和特征轴的写法比较简略;按正文与实现意图,可将归约显式写为:
其中 $B$ 为批大小。这是本笔记补全索引的教学写法,不是逐字转录原式。损失拟合的是输出向量,无需显式保存全部 $N\times N$ 注意力权重;使用适当内核时,序列相关中间存储可由二次降到线性。但教师 softmax 的计算量并没有因此自动变成线性。
为什么匹配输出不等于匹配权重? 输出是 $AV$。当不同历史位置的 value 相同或线性相关时,不同的注意力权重可以产生相同输出。MSE 因而约束的是当前输入分布上、当前 value 所体现的功能,而非唯一恢复原注意力矩阵。附录 E 的热图相似性是经验观察,不是等价性证明。
2.3 特征映射与 RoPE 的位置
论文比较 T2R 与 Hedgehog 两种可学习映射(Table 1,p. 5):
Hedgehog 的 softmax 沿特征维执行,$\oplus$ 表示拼接。7B/8B 设置中 $\widetilde W$ 是 $128\times64$,两侧拼接后 $F=128$;不能将中间投影宽度 64 误写成最终状态只有 64 维。query 和 key 使用各自的可学习映射。
对 Llama/Mistral,先应用旋转位置编码 RoPE,再应用 $\phi$。这样试图逼近的仍是含位置信息的原 query/key 点积核,而非先做非线性映射后再旋转其特征。
2.4 第二阶段:用 LoRA 适配整网误差
完成迁移后,模型真正切换到线性/局部混合注意力。冻结原权重和已训练的 $\phi,\gamma$,只对各层的 $W_q,W_k,W_v,W_o$ 加低秩更新:
这是包含实际缩放的通用形状;原文主体用简化方阵 $W+BA$ 讲解,附录 B.4.1 说明 $\alpha/r$,默认取 2。优化目标改为整网 next-token cross-entropy:
这一步面对的是学生自己产生的隐藏状态,因此能补偿局部校准未解决的整网分布变化。默认 7B/8B 的 LoRA 训练参数占比低于 0.09%,而第一阶段特征映射约 16.8M 参数、约占 8B 模型 0.2%。两者是不同阶段的可训练参数量,都不是完整模型驻留显存的比例。(Sec. 3.1,p. 5;App. A.1,pp. 18–19)
2.5 为什么还要在每层保留局部 softmax
纯线性注意力的迁移已经能改善困惑度,但 MMLU 仍接近随机选择水平。作者观察到:注意力熵低、分布更尖锐时,拟合误差通常更大;后面层的 MSE 也明显较大(Fig. 5–6,pp. 7–8)。于是,直接让局部精确注意力承担难以近似的近邻交互,将更早的历史交给固定状态。
令 $\mathcal W_n=\{\max(1,n-w+1),\ldots,n\}$,$c_n$ 是窗口内最大 scaled dot-product,定义局部分子/分母:
Eq. (6) 可整理为:
$S_{n-w},z_{n-w}$ 只压缩窗口外的早期 token;序列开头若无早期历史,取零状态。$\gamma$ 是可学习的分支权重。先合并两部分未归一化分子与质量,再统一归一化,不是简单地平均两个已归一化输出。(Sec. 3.3.1,p. 7)
教学例子:令 $w=2$,读到 token 5 时,局部缓存保存 token 4、5,而递归状态汇总 token 1–3;进入 token 6 时,把 token 4 从局部缓存移入递归状态,再由 token 5、6 构成局部窗口。这个例子说明历史不会被直接丢掉,但远端精细信息会被压缩。
归一化细节: 原式只在局部指数项减去 $c_n$,并未把同样因子乘到线性分支;所以它定义的是特定的可学习混合核。不能把整个式子理解成“与完整 softmax 完全等价,只做了数值稳定变换”。
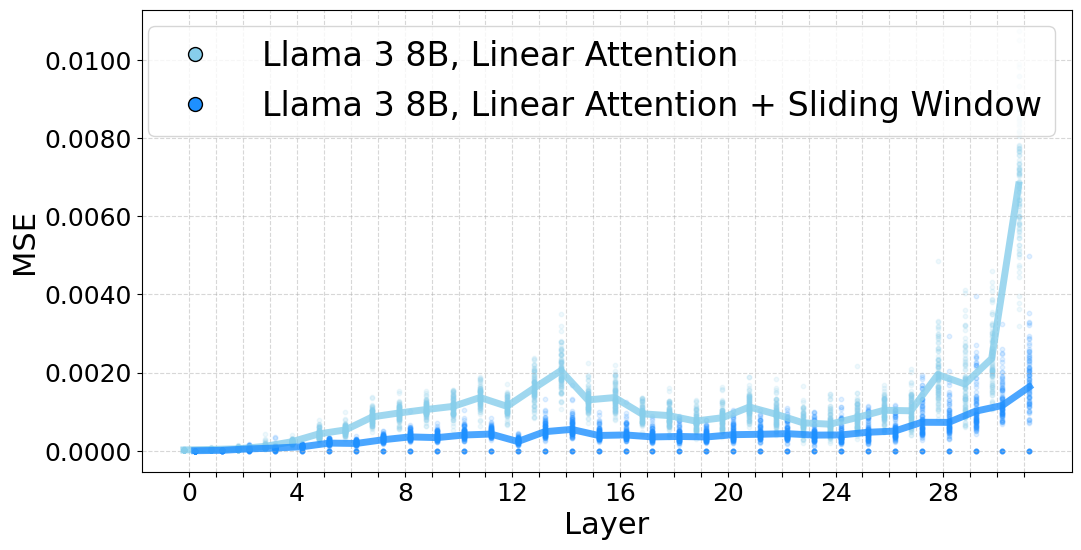
原图 Fig. 7 右面板,p. 8。 横轴是 Llama 3 8B 层号,纵轴是输出 MSE,越低越好。深色局部窗口+线性方案在后面层明显低于浅色纯线性方案。这支持该结构更容易迁移,但不足以单独证明任何下游任务都会改善。
固定 $w,F,d$ 时,缓存只含窗口内 KV 和窗口外压缩状态,生成所需存储不随总序列长度增长。直接计算一个新 query 的紧致复杂度可写为 $O(wd+Fd)$ 运算、$O(wd+Fd+F)$ 状态;这是按递归实现推得的表达。原文 p. 7 给出了较宽松的 $O(w^2d+dd')$ 形式,本笔记不将两者混写成同一个公式。
2.6 实际默认使用 terraced window
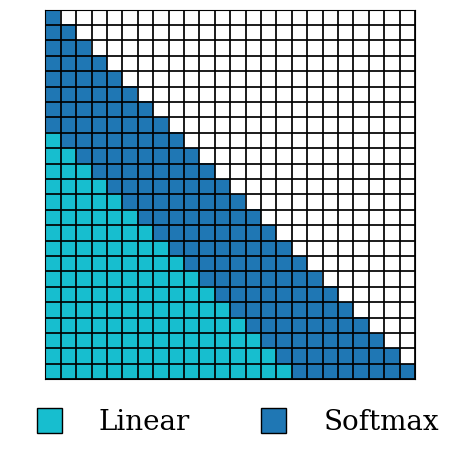
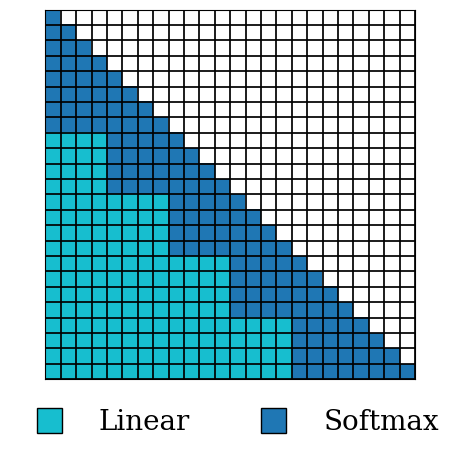
原图 Fig. 9 两面板,p. 18。 行是 query 位置、列是 key 位置,白色为未来不可见位置,蓝色为局部 softmax,青色为线性分支。常规滑窗的边界逐 token 移动,terrace 的边界按块移动,局部覆盖随 query 位置变化。论文主结果使用便于 GPU 连续块计算的 TK terrace 64,并非严格固定最近 64 个位置的滑窗。
App. C.2(pp. 43–44)的 ThunderKittens 内核针对 prefill:以 64-token tile 处理序列,两个 warpgroup 分担局部注意力与线性状态计算,利用 tensor cores,并尽量将递归状态留在寄存器、重叠访存与计算。应区分算子复杂度、prefill 内核设计和端到端生成吞吐,三者不是同一指标。
2.7 405B 的关键补充:分块迁移
输出 MSE 对数值尺度敏感,不同深度层的误差大小可差很多。作者把 $M$ 层分成每块 $b$ 层,分别优化块内平均 MSE;教师路径使块输入可预先计算,再分配到不同 GPU 训练。(Sec. 3.3.2,pp. 8–9)
采用不重叠的 $b$ 层块时,本笔记将求和范围写为 $m=i,\ldots,i+b-1$。原 Eq. (7) 写到 $i+b$,与“$b$ 层”及分母 $bH$ 不完全一致,属于需注意的索引问题。
代价在于保存中间隐藏状态。若总训练 token 为 $T$、模型宽度为 $D$、层数为 $M$、16 位存储,近似磁盘开销为:
它描述的是预计算训练状态,不是部署时的 KV cache。论文指出 405B 若逐层缓存 50M tokens,存储可超过 200TB;增大层块可减少磁盘开销。实际 70B 使用全部 80 层联合迁移;405B 使用 14 个 9 层块。分块在 405B 上改善质量的证据见 Table 24,而不是“任意模型分块都更好”。
此外,405B 实际第一阶段是 $1000\times$ 输出 MSE 加 $1\times$ 注意力权重 cross-entropy;LoRA 改为 $r=4,\alpha=8$、dropout 0.5、FP16。它不是默认 8B 纯输出 MSE、$r=8$ 配置的原样放大,因此不能把 405B 的全部结果归因于输出 MSE 单独奏效。(App. A.3,pp. 20–21,Table 9)
三:实验设计
3.1 比较对象和它们的角色
| 对照类别 | 具体对象 | 回答的问题与限制 |
|---|---|---|
| 原始 Transformer | Mistral 7B v0.1、Llama 3 8B、Llama 3.1 家族 | 替换架构损失了哪些能力? |
| 已有转换模型 | SUPRA、Mamba2-Llama 3、Hedgehog | 与已有转换路线相比是否更好、更省追加训练?部分数字引用既有论文,非统一重跑 |
| 从头训练的替代架构 | Mamba、RWKV、Hawk、Griffin、TransNormerLLM 等 | 转换能否快速获得有竞争力的模型?不能据此推出等总训练成本下架构更优 |
| 保留全注意力的混合模型 | Mamba2-Llama 3 50% attention、Zamba、StripedHyena;附录的 LoLCATs 50% | 更高质量是否伴随部分全注意力的缓存/复杂度成本? |
| 内部消融 | 无迁移、无窗口、T2R/Hedgehog、LoRA 秩与投影 | 哪个组件在指定协议下有效? |
| 70B/405B 内部基线 | 同一局部+线性架构,无迁移,联合训练特征映射、混合系数和 LoRA | 大模型有限预算下,增加迁移阶段的收益;并非原论文 SUPRA/Mamba 的完整复现 |
3.2 训练协议不能跨规模混用
| 项目 | 7B/8B 主实验 | 70B | 405B |
|---|---|---|---|
| 数据 | Alpaca-cleaned,约 50K 样本 | 随机采样的 RedPajama 20M tokens | 同类 RedPajama 20M tokens |
| 序列长度/全局 batch | 1024/8 | 1024/8 | 1024/8 |
| 特征映射/局部实现 | Hedgehog,投影 64、拼接 128;terrace 64 | 同左 | 同左 |
| 第一阶段 | 输出 MSE;通常联合所有层 | 输出 MSE;80 层联合 | 输出 MSE+权重 CE;9 层一块 |
| 第一阶段学习率 | 0.01 | 0.01 | 0.01 |
| 第二阶段 | Q/K/V/O LoRA;学习率 $10^{-4}$ | 同左 | 同左 |
| LoRA $(r,\alpha,\mathrm{dropout})$ | $(8,16,0)$ | $(8,16,0)$ | $(4,8,0.5)$ |
| 精度 | BF16 | BF16 | FP16 |
| 设备与报告训练时间 | 1×40GB A100,约 2h+4.5h | 8×80GB H100,4h+14h | 迁移每块 1×80GB H100×5h;LoRA 24×80GB H100×16h |
来源:App. A,pp. 18–21,Table 7–9。采用 AdamW、梯度裁剪 1.0、Reduce LR on Plateau;按验证表现选择 checkpoint。7B/8B 使用微批 1、梯度累积 8。主文报告总转换量 40M tokens,但 Table 7 的第二阶段“每 epoch 20M、2 epochs”与其他段落不一致,详见后面的核验记录;本笔记不会用该表静默改算主结果的预算。
70B/405B 的无迁移基线只做一次 20M-token 调整,LoLCATs 另有迁移阶段;因此其比较不应描述为完全相同训练 token 次数。405B 给出了接近的 GPU-hours 预算:基线 $24\times19.5=468$ GPU-hours;LoLCATs 约 $14\times5+24\times16=454$ GPU-hours。这是根据文中阶段时间的推算,未另计未拆分报告的预计算/I/O 开销,也不能把 A100 与 H100 的 GPU-hours 当成等价算力。
3.3 指标与读取规则
- PiQA、ARC-easy、Winogrande:准确率,越高越好;主结果为 zero-shot。
- ARC-challenge、HellaSwag:LM Evaluation Harness 的
acc_norm,按候选长度归一化的选择评分计算准确率,越高越好。 - MMLU:5-shot accuracy。它包含知识与上下文选项使用等因素,不是纯粹的“知识是否还存着”的独立测量。
- Avg.:六项任务百分数的算术平均;Avg. (no MMLU):前五项平均,不能互换。
- PPL:困惑度,越低越好;Alpaca 与 RedPajama 的 PPL 应分别在各自数据上比较。
- Attention MSE:输出拟合误差,越低越好;受输出尺度影响,不能直接当成归一化的跨层语义重要性。
- 生成吞吐:生成 token 数乘 batch、再除总时间,单位 tokens/s;不是每个请求的响应延迟。
- Passkey retrieval:输出 5 位 key 的 exact match,按 key 出现位置十分位分组。
除 Llama 3 8B 的三种子补充实验外,主要大模型表格未给出相应的重复训练方差和显著性检验。小幅超越原模型应保守解读。
四:结果与证据链
4.1 两阶段联合奏效,但纯线性架构仍有瓶颈
Sec. 3.2 首先只使用已有的 T2R/Hedgehog 纯线性注意力。下表摘录 Table 2(p. 6),指标为 Alpaca 验证 PPL,越低越好:
| 原模型/特征映射 | 随机替换,未调整 | 仅迁移,未 LoRA | 无迁移+LoRA | 迁移+LoRA |
|---|---|---|---|---|
| Llama 3 8B/T2R | 1539.39 | 79.33 | 16.05 | 4.11 |
| Llama 3 8B/Hedgehog | 2448.01 | 60.86 | 9.02 | 3.90 |
| Mistral 7B/T2R | 2497.13 | 32.78 | 8.85 | 3.29 |
| Mistral 7B/Hedgehog | 561.47 | 18.94 | 4.87 | 3.04 |
最后两列控制总训练步数:迁移+LoRA 各 2 epochs,无迁移方案 LoRA 4 epochs。注意力迁移让替代模块的起点明显改善;后续 LoRA 又把仅迁移后的高困惑度降下来。Fig. 3 的横轴计入迁移步骤,支持这种两阶段训练在该设置下更有效。
但 PPL 改善不代表全部能力恢复。纯线性 Hedgehog 的 Llama 3 8B 在 Table 3 中 MMLU 仅 24.2,而完整 LoLCATs 为 52.8。作者于是用局部窗口缓解难以拟合的尖锐注意力,而不是仅靠增大 LoRA。
4.2 7B/8B 主结果:平均质量接近,MMLU 仍落后
以下直接取 Table 3,p. 9;准确率/平均分越高越好,token 单位为十亿,LoLCATs 的 0.04B 是论文报告的追加转换预算。
| 模型与转换方法 | 转换 tokens (B) | 五项零样本均分 | MMLU 5-shot | 六项均分 |
|---|---|---|---|---|
| Mistral 7B 原模型 | — | 74.4 | 62.4 | 72.4 |
| Mistral 7B SUPRA | 100 | 69.9 | 34.2 | 64.0 |
| Mistral 7B LoLCATs | 0.04 | 74.5 | 51.4 | 70.7 |
| Llama 3 8B 原模型 | — | 73.1 | 66.6 | 72.0 |
| Mamba2-Llama 3 | 20 | 65.6 | 43.2 | 61.9 |
| Mamba2-Llama 3,保留 50% 全注意力 | 20 | 73.9 | 56.7 | 71.0 |
| Llama 3 8B Hedgehog | 0.04 | 62.0 | 24.2 | 55.7 |
| Llama 3 8B LoLCATs | 0.04 | 74.2 | 52.8 | 70.7 |
结果支持三个不同层次的判断:
- 相对已有完全次二次转换模型,提升很大。 Mistral 的 MMLU 相对 SUPRA 提高 17.2 个百分点;Llama 3 相对 Mamba2 提高 9.6 个百分点。不能笼统把这两组都写成“20+ 点”。
- 五项零样本平均分可以接近或略高于原模型。 但六项平均仍下降,尤其 MMLU 分别下降 11.0、13.8 个百分点。
- 保留全注意力是另一种成本/质量选择。 Mamba2 的 50% attention 版本在 MMLU 和六项平均上高于 LoLCATs,但保留了随长度增长的全注意力缓存需求。
作者报告 Mistral/Llama 3 的总体 Transformer–转换模型差距分别缩小 79.8%/86.6%。这是相对指定较弱基线的差距缩小比例,不是“保留原模型 79.8%/86.6% 的能力”。
Table 4(p. 10)进一步比较从头训练的模型:LoLCATs 六项均分为 70.7,Mamba 7B 为 64.7、Griffin 为 65.8、Zamba 为 69.5。这个结果展示利用强教师进行转换的实际价值;由于教师预训练投入和数据不同,它不是公平隔离架构优劣的从零训练比较。RWKV 该表未报告 MMLU,其平均分也不能直接当作完整六项平均。
4.3 组件消融:窗口和迁移相互补充
Table 5,p. 11;Table 10,p. 22,Llama 3 8B,1024-token 训练序列;所有列都包含替换后的调整训练。
| 特征映射 | 设置 | 六项均分 | MMLU |
|---|---|---|---|
| Hedgehog | 直接替换+调整 | 44.20 | 23.80 |
| Hedgehog | 加迁移,无窗口 | 55.32 | 23.80 |
| Hedgehog | 加窗口,无迁移 | 68.78 | 45.80 |
| Hedgehog | 迁移+窗口 | 70.66 | 52.77 |
| T2R | 直接替换+调整 | 38.84 | 23.20 |
| T2R | 加迁移,无窗口 | 54.83 | 23.10 |
| T2R | 加窗口,无迁移 | 39.52 | 23.80 |
| T2R | 迁移+窗口 | 68.28 | 40.70 |
Hedgehog 仅加迁移明显改善平均分,但 MMLU 不变;加窗口带来最大一段提升,迁移在此基础上再提高 MMLU 6.97 个百分点。T2R 未经迁移时,窗口本身几乎没有救回质量,因此不能提炼成“加局部注意力就够了”。该表是组件组合的实证,不是各组件作用可简单相加的证明。
Table 11(p. 22)的三次独立 seed 结果中,LoLCATs 六项均分为 $70.38\pm0.33$、MMLU 为 $52.74\pm0.64$;Hedgehog 对应 $55.72\pm0.35$、$24.22\pm0.62$。这支持相对于纯线性基线的大幅提升较稳定,但不能给所有其他比较附上同样的统计保证。
4.4 生成效率:优势主要来自更大的可用 batch
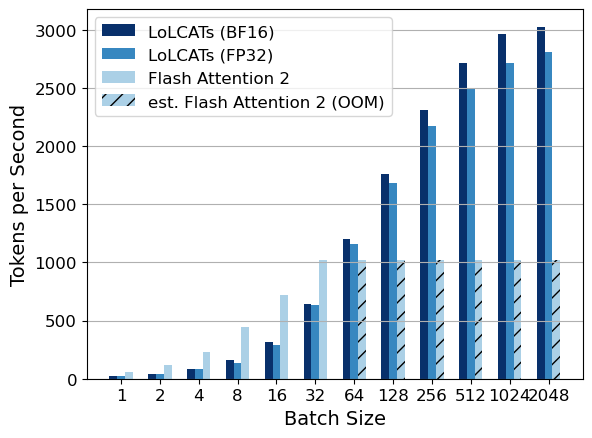
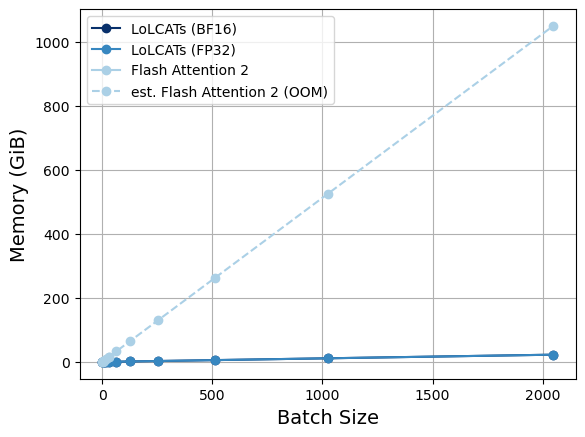
原图 Fig. 8 两面板,p. 10。 横轴为 batch size;第一张纵轴为总生成 tokens/s,第二张为 GPU 显存 GB。比较基于 Llama 3 8B、单张 80GB H100、128-token prompt、4096-token generation,包含 LoLCATs BF16/FP32 与 HuggingFace 支持的 FlashAttention-2。
FA2 在 batch 64 开始 OOM;LoLCATs 可运行到 batch 2048,BF16 达到约 3000 tokens/s。论文的约 3× 总吞吐和 64× 最大可用 batch 优势来自各自能承受的批量规模(2048/32)。图中 FA2 的斜线柱明确是 OOM 区间的估计值,不能写成实测。
值得一起读出的边界:在双方都能运行的小 batch 下,图中 FA2 反而更快。论文没有证明 LoLCATs 在所有 batch、所有上下文长度、所有服务内核上都有 3× 加速,更没有证明单请求延迟也改善 3×。
4.5 70B/405B:规模扩展成立,保真仍有边界
Table 6,p. 11,均为 Llama 3.1 的 MMLU 5-shot accuracy:
| 参数规模 | 原模型 | 同替代架构、无迁移 | LoLCATs | 相对无迁移增益 | 相对原模型缺口 |
|---|---|---|---|---|---|
| 8B | 66.11 | 51.44 | 54.88 | +3.44 点 | −11.23 点 |
| 70B | 78.80 | 28.74 | 67.70 | +38.96 点 | −11.10 点 |
| 405B | 82.98 | 33.86 | 72.20 | +38.34 点 | −10.78 点 |
按表中数值计算,差距缩小比例为:
70B 为 $38.96/50.06\approx77.8\%$;405B 为 $38.34/49.12\approx78.1\%$。这与论文摘要一致。405B 的其他五项任务达到或略高于原模型,但没有给出相应多种子误差条。
大规模实验最强的证据是在有限预算下,局部拟合再整网适配比直接端到端适配更可靠,且能扩展到 405B。对照采用相同替代模块和 LoRA 路线,不应被称为“击败在充分训练下的全部既有大模型转换算法”。
App. B.7.3 的 Table 24(p. 35)更直接支持分块方案:405B 在后续 LoRA 后,联合 126 层迁移的验证 PPL 为 4.23,14 个 9 层块为 3.21,降低 1.02。8B/70B 则报告联合与分块相近。MSE 在深层变大是观察到的相关现象;仅把各层损失重新分组,并不自动构成质量提升的理论保证,实际优化、训练停止与共享梯度处理也可能影响结果。
4.6 附录 B.2–B.4:混合比例、模型规模与适配参数
保留一半全注意力层。 Llama 3 8B 保留前 16 层全 softmax,只转换后 16 层,而且仅做 20M-token attention transfer,MMLU 达 65.8,接近原始 66.6,显著高于完全转换的 52.8(Table 12,p. 23)。这展示质量与架构效率的折中;由于仍有全注意力层,该模型不再具有所有层都固定历史状态的性质。作者所说的 94.2% 差距恢复,是相对完全转换版本的缺口计算。
1B 规模也有效。 Llama 3.2 1B 的 LoLCATs 五项均分为 59.6、原模型为 60.0,但 MMLU 为 27.3、原模型为 31.9;Phi 1.5 1.3B 对应五项均分 67.2/67.1,MMLU 39.2/43.6(Table 13–15,p. 24)。Phi-Mamba 和 Hybrid Phi-Mamba 的五项均分为 65.1、66.0,转换使用 3B tokens,LoLCATs 报告 0.04B。跨规模仍呈现“多数常用任务接近,MMLU 更难完全恢复”的模式。
更高 LoRA 秩不保证更好。 对 $r=4,8,16,32,64,128,256$ 的消融保持 $\alpha/r=2$。Table 16(p. 25)中,五项零样本均分在 $r=4$ 为 74.5、$r=8$ 为 74.2、$r=256$ 为 72.7、全参数微调为 73.7;MMLU 最高的 $r=128$ 为 53.4。作者提出小秩可能防止在小数据集上破坏预训练能力,但这只是解释假说,且 full finetuning 使用了不同学习率,不能推断 LoRA 在任何预算下都胜过全量训练。
value/output 的适配很关键。 Table 17(p. 26)只比较五项零样本任务:仅训练 $W_v$ 得 74.19、仅 $W_o$ 得 74.09,接近全部 Q/K/V/O 的 74.24;仅 $W_q$ 或 $W_k$ 则为 72.68、72.29。迁移完成后,调整被聚合的内容和输出读出方式已可恢复大量质量,进一步微调注意力权重并非唯一途径。不过这个消融没有报告 MMLU,不能将结论推广到该任务。
窗口大小也不是越大越好。 Table 18(p. 27)的固定滑窗 $w=4,16,64,256$,MMLU 分别为 40.8、50.3、50.3、41.5;terrace 64 为 52.8。常规 64 窗口六项均分为 70.3,terrace 64 为 70.7。大窗口在给定训练量下未必带来更好最终适配,这也提醒读者不能仅依据架构容量判断短程训练结果。
4.7 附录 B.5:数据决定保留下来的能力
数据来源。 在约 40M 总转换 tokens 的对照中,RedPajama 相比 Alpaca 让 Llama 3 8B 的 MMLU 从 52.8 提高到 55.2,但五项零样本平均从 74.2 降到 72.1。Mistral 的 MMLU 从 51.4 到 53.2,五项均分从 74.5 到 71.7(Table 19,p. 27)。这是任务取舍,不是某一种数据源全面更优。
与目标任务结构相近的数据。 加入 CommonsenseQA 的多选题样本后,Llama 3 8B MMLU 从 52.8 到 54.5;只用 CommonsenseQA 则为 43.9(Table 20,p. 27)。作者用与 MMLU 类似的 in-context 选择题格式构建数据;它支持任务相关数据有帮助,但没有彻底消除 MMLU 缺口。
检索反例尤其重要。 Table 21(p. 28)测试 8192-token 输入中的随机 5 位 passkey。使用 Alpaca 打包成 8192-token 序列做转换的 LoLCATs,在所有位置十分位上准确率均为 0%;改为使用 10K 条约 8192-token 的专门 passkey 样本做两阶段训练后,各位置均为 100%。原始 Transformer 或仅用 Alpaca LoRA 的 Transformer 仍表现很强。
因此,“模型有远端递归状态”不等于“自然语言转换数据能自动保留远端精确检索”。该实验说明这种混合结构有能力学会这个受控任务,也暴露了转换数据覆盖不足时的严重遗忘。专用训练使用了不同数据规模/序列长度,不能将其 100% 写成默认 40M Alpaca 模型的结果。论文报告中未明确给出每个测试 cell 的样本数,不应从 100% 推断普适检索保证。
Fig. 10(p. 29)横轴为 key 的位置十分位、纵轴为输入长度、颜色为 exact-match accuracy。专门训练的 LoLCATs 在原 8K 上限以内表现良好,但到 10240 tokens 时失败;只有额外 LoRA 过的 softmax 模型在图中部分位置仍有非零检索。这不足以支持任意长度外推。
有效序列长度 ESL。 把许多短样本拼成 1024 tokens,不一定产生 1024-token 的真实依赖。作者用注意力加权的回看距离描述有效依赖长度,并筛选 RedPajama 的高 ESL 样本。Table 22(p. 30)中 MMLU 从随机 RedPajama 的 55.2 到 56.5,但五项均分从 72.1 到 70.9。该结果再次体现目标能力取舍。
原 Eq. (8)(p. 29)分母写作 $\sum_{m\le j}$,随求和项 $j$ 变化,与标准因果注意力对固定 query $i$ 在所有 $m\le i$ 上归一化的写法不同。若按“注意力加权回看距离”的直觉,应是 $\sum_{j\le i}(i-j)a_{i,j}$;这里是本次解释,不能声称作者实际计算代码必然使用了此修正式。
4.8 附录 B.6:小量迁移已经有帮助,更多数据不单调改善任务分数
Table 23(p. 31)固定后续 2000 步 LoRA,只改变前面的迁移步数。0 步迁移的五项均分为 56.86,200 步后为 73.68,1800 步后为 73.66;域外 RedPajama PPL 对应 61.305、10.459、9.358。迁移因此有很大的早期收益,但零样本平均分不随步数单调增加。
Fig. 12 区分 Alpaca 域内与 RedPajama 域外 PPL;Fig. 13 则增加 RedPajama 独立样本,最高迁移 9000 步、LoRA 2000 步。更多训练常改善语言建模 PPL,但并不保证任务平均分更高。它支持在实际应用中分别监控困惑度、目标能力和遗忘,不应只按迁移 MSE 选最终模型。
4.9 附录 B.7 与 E:机制证据应如何理解
Fig. 14(p. 32)显示 LoRA 可以进一步降低注意力输出 MSE,且初始误差较大处可能下降更多。但这里的诊断实验让 LoRA 直接优化 MSE,并非默认第二阶段的语言模型 cross-entropy;不能用它直接证明默认 LoRA 的所有质量改善均来自更精确的注意力匹配。
Fig. 15–17(pp. 33–34)换回 next-token 训练,观察 LoRA 的累计参数更新。迁移后的模型在 value/output 投影上的更新轨迹更像 softmax 模型;无迁移时 query/key 投影变化更大。它与“先校准注意力,让后续训练少做结构补救”的解释一致,但没有建立唯一因果机制。
Table 25–26(pp. 35–36)列出大模型不同层块的 MSE,405B 最后一个块报告 48.66,次高块 3.62;它说明尺度不均衡问题可能随模型变大更显著。最后层块编号存在边界简写,理解时以 126 层、14 个 9 层块的实验描述为准。
附录 E(pp. 46–58)展示生成样例与注意力热图。抽查的分数化简示例中,完整 LoLCATs 比若干消融版本更连贯;Fig. 18(p. 51)中,输出 MSE 训练后的权重图可近似教师局部模式和部分远距模式。图只展示若干 head、layer、样本和 token 切片,不能替代总体生成评估或证明输出 MSE 唯一确定注意力权重。
五:结论、边界与复现要点
5.1 可以带走的结论
- 局部函数迁移与全局参数适配有互补性。 注意力替代先接近预训练计算,再用低秩更新调整整网,是本文最可迁移的方法论。
- 局部精确计算与远端压缩是有效结构折中。 同样的 Hedgehog 特征映射,加局部 softmax 后更容易拟合、最终质量明显更好。
- 低成本转换可以到 405B,但需实际工程与协议变化。 分块训练、磁盘隐藏状态、分布式 LoRA 以及 405B 的额外权重蒸馏损失都是结果的一部分。
- 转换数据决定能力保留的范围。 普通常识分数、MMLU 与精确检索可能出现不同方向的变化,平均分会掩盖严重局部退化。
5.2 尚未建立的结论
论文没有证明完全保留原模型能力,没有给出任意长上下文质量保证,也没有证明所有 batch 下的推理都更快。主要结果继承预训练教师的能力,不能用追加训练 token 与从头预训练 token 的比值宣称整体训练成本同幅度降低。405B 输出 MSE+权重 CE 的结果,也不能单独证明纯输出迁移在所有规模上都足够。
作者将更广泛的长上下文场景、推理时扩展、以及带 decay/gating 的更丰富次二次架构列为后续方向(Limitations,pp. 11–12)。附录的 passkey 实验提供了一个窄范围探查,但不能取代这些尚未完成的综合评测。
5.3 本次核验发现的原文不一致
以下仅列会影响复述或实现的地方;保留原始文件,不擅自更改作者内容。
| 位置 | 原文情况 | 本笔记采用的处理 |
|---|---|---|
| 摘要 p. 1、主文 pp. 3/9–10 | 摘要称训练 token 为既有方法 0.4%;正文及主表报告 40M 对 20B–100B | 按具体基线算:0.2%–0.04%,即 500–2500 倍追加 token 比;不复用统一的 0.4% |
| Sec. 4.1 p. 9 与 Table 3 | 文本给 MMLU 相对提升 60.9%/40.9%,但主表 34.2→51.4、43.2→52.8 不对应这两个比例 | 报绝对提升 17.2/9.6 点;如需相对值,分别约 50.3%/22.2% |
| Introduction p. 3 与 Table 3 p. 9 | 引言的 73.1/74.2 叙述容易误读对应关系 | 以主表为准:原 Llama 3 8B 五项均分 73.1,LoLCATs 74.2 |
| Table 7 p. 19 与 Sec. 3.2/App. B.5.1 | 表列第一阶段 2×10M、第二阶段 2×20M;正文多处称两阶段各约 20M、总 40M | 主结果保留“论文报告 40M”;严格复现需进一步核对训练配置和日志,不能断言表内 60M 是实际训练量 |
| Eq. (5)、(7)、(8) | MSE 索引简略、块求和边界多一项、ESL 分母索引不标准 | 解释处标注整理/推断,不把修正冒充原文公式 |
| Table 16 p. 25 | $r=4$ 的六项分数算术均值约 70.42,表的 Avg. 写 71.3;$r=64$ 也有均值不一致 | 讨论秩时使用可核实的五项均分和单项 MMLU,不据 Avg. 列强行排序 |
| Table 17 p. 26 | $W_k,W_o$ 行 Average 写 69.33,五项分数均值约 74.17 | 不用这处异常值得出该投影组合明显较差的结论 |
| App. C.1 pp. 37–42 | 示例代码有未定义变量、因果累积/next-token 切片及 LoRA 缩放等简写或错误 | 当作结构说明阅读,不当作可直接执行的复现代码 |
5.4 若要复现,优先落实哪些细节
先固定模型版本、分词器、Harness 评测配置与主指标;确认使用常规滑窗还是 terrace。第一阶段检查教师路径、冻结参数、RoPE 后特征映射、逐 head 输出匹配及因果状态更新;第二阶段确认只训练指定 LoRA,并冻结特征映射。GQA 的头共享、prefix state 的精度、局部与远端分母合并、padding mask 都不能从附录简化代码直接推定。
先在 8B 复核“随机替换/仅迁移/仅 LoRA/两阶段”四个点,再加入窗口和目标任务数据。同步评测 MMLU、域外 PPL 与检索,而不是只看 Alpaca PPL。大模型复现还要明确分块隐藏状态存储、额外 CE 蒸馏的显存代价,以及最终实际训练 tokens;这部分论文中的文字并非完全自洽。
作者公开了 HazyResearch/lolcats。本次阅读的实现证据来自同版本论文源码与 PDF,未审计仓库当前代码或复现实验。
5.5 适合组会讨论的问题
- 能否用归一化 MSE 或分层损失权重代替额外的分块存储,并维持 405B 质量?需要在相同训练预算下实测。
- 哪些数据或教师层信号最能预测“转换后还能检索”,而不只是低 PPL?
- 是否可以只适配 value/output,保留相近通用任务质量,并验证 MMLU 和长距任务不会额外受损?
- 保留少量全注意力层、扩大局部窗口、改进远端状态三条路线,哪条在目标服务负载下有更好的质量/吞吐/显存折中?
以上均为本次阅读提出的后续问题,不是本文已经验证的结论。