Learning Linear Attention in Polynomial Time:中文研读笔记
- 作者:Morris Yau、Ekin Akyürek、Jiayuan Mao、Joshua B. Tenenbaum、Stefanie Jegelka、Jacob Andreas。
- 原文:arXiv:2410.10101v4;本地 PDF。本文阅读的是 2025-10-23 更新的 v4,资料获取与本次研读日期为 2026-11-03。下文页码均指从 1 开始的 PDF 页码。
- 发表:已发表于 NeurIPS 2025 主会论文集(Advances in Neural Information Processing Systems 38)。
- 代码:截至 2026-11-03 未查到可核实的公开实现。论文附录的 checklist 声称提供代码,但原文与正式论文页面没有给出可核实的公开仓库链接。
论文总览
这篇论文研究一个比“Transformer 能否表示某种计算”更难的问题:**能否从输入输出样本中,在多项式时间内学到实现该计算的线性注意力模型,并判断训练数据是否足以唯一确定它的函数行为?**研究对象是单层、无 softmax 的多头线性注意力(multi-head linear attention,MHLA),以最后一个 token 的平方误差回归为主要学习任务;它不是一般的深层、带归一化和 MLP 的 Transformer。
核心转化是:虽然每个注意力头的参数以 $V_hQ_h$ 的双线性方式进入输出,整模型在固定的三次输入特征上却是线性的。把所有头的参数汇总成矩阵 $W$ 后,先对 $W$ 做普通最小二乘,再用奇异值分解(SVD)把它还原为至多 $d^2$ 个注意力头。另一方面,把输入映射到一组去重的三次特征 $\mathcal H(Z)$;如果训练集的特征二阶矩满秩,在可实现数据上,所有零误差经验风险最小化器都对应同一个输入输出函数,因而在任意输入上相同。论文还给出有界计算历史的通用图灵机(UTM)构造,并用合成回归、关联记忆与 DFA 执行任务提供经验观察。[Sec. 1–4,PDF pp. 1–8;Appendix A–G,pp. 13–31]
结构地图
| 原文位置 | 论证作用 | PDF 定位 |
|---|---|---|
| Sec. 1, Introduction | 区分表达能力、有效学习与函数可辨识性 | pp. 1–2 |
| Sec. 2.1, Polynomial-time learnability | MHLA 定义、三次特征、回归算法与 Theorem 2.2 | pp. 3–4;Algorithm 1 |
| Sec. 2.2, Identifiability | 满秩证书与函数等价类 | p. 5;Lemma 2.3 |
| Sec. 3, Application to learning Universal Turing Machines | 有界 UTM 的学习结论 | pp. 5–6;Lemma 3.1 |
| Sec. 4.1, Do extra heads help optimization with SGD? | 头数、层数与凸算法的合成数据比较 | pp. 6–7;Fig. 1 |
| Sec. 4.2, Does certifiable identifiability predict generalization? | 关联记忆中的满秩证书实验 | pp. 7–8;Fig. 2 |
| Sec. 5–6, Related Work; Conclusion and Limitations | 定位贡献与模型适用范围 | pp. 9–10 |
| Appendices A–E | 可辨识性、UTM、主定理及其证明 | pp. 13–22 |
| Appendices F–G | 注意力程序构造、训练细节与 DFA 实验 | pp. 23–31;Figs. 3–4 |
一:动机——表达能力与可学习性之间的缺口
已有的表达能力结论通常展示某组手工构造的权重能模拟自动机或图灵机,却没有说明给定观测样本后,怎样高效找回功能相同的权重。即使训练误差为零,样本也可能允许另一种只在训练输入上相同、在更长序列或新输入上不同的函数。作者因此分别研究两个问题:一是能否在任意给定数据集上高效找到最佳拟合 MHLA;二是能否直接从数据验证所有最优拟合模型的函数行为相同。[Sec. 1,PDF pp. 1–2]
前者是优化及分布内学习问题,后者是数据可辨识性问题。区分它们是读本文的关键:把一个非凸参数化问题转成线性回归,可以找到全局经验最优值;要推出所有输入上的同一计算,还需要特征覆盖条件。[Sec. 2.1–2.2,PDF pp. 3–5]
二:方法——从注意力头到线性回归
2.1 模型和输入特征
令 $Z=[z_1,\ldots,z_n]\in\mathbb R^{d\times n}$,其中每列是一个 $d$ 维 token;第 $h$ 个头的值矩阵与合并的 key–query 矩阵分别为 $V_h,Q_h\in\mathbb R^{d\times d}$。单层 MHLA 的全部输出及最后一列为
这里 $Y_\Theta\in\mathbb R^{d\times n}$,$\hat y_\Theta\in\mathbb R^d$;序列长度 $n$ 可因样本而异,嵌入维度 $d$ 固定。训练使用最后一列对应的 $d$ 维标签。没有 softmax、残差或层间非线性;“线性注意力”指注意力权重没有 softmax,并不表示输出对 $V_h,Q_h$ 线性。[Def. 2.1,Eqs. (4)–(5),PDF p. 3]
将 $S=ZZ^\top$ 记为行向量的 Gram 矩阵,则第 $a$ 个输出坐标可展开为
输入特征 $\mathcal X(Z)_{j,(k,\ell)}=S_{jk}z_{\ell n}=\langle z_{j:},z_{k:}\rangle z_{\ell n}$ 是 $Z$ 的三次多项式;其大小为 $d\times d^2$,与序列长度无关。把 $\mathcal X$ 放进输出坐标 $a$ 对应的块,可得到 $X_{i,a}\in\mathbb R^{d^2\times d^2}$。上式于是成为一个普通的线性内积 $\hat y_{i,a}=\langle W,X_{i,a}\rangle$。[Sec. 2.1,Eqs. (7)–(8),PDF p. 4;Algorithm 1,p. 3]
2.2 放宽头数,求解,再还原
全部头对应的系数矩阵为
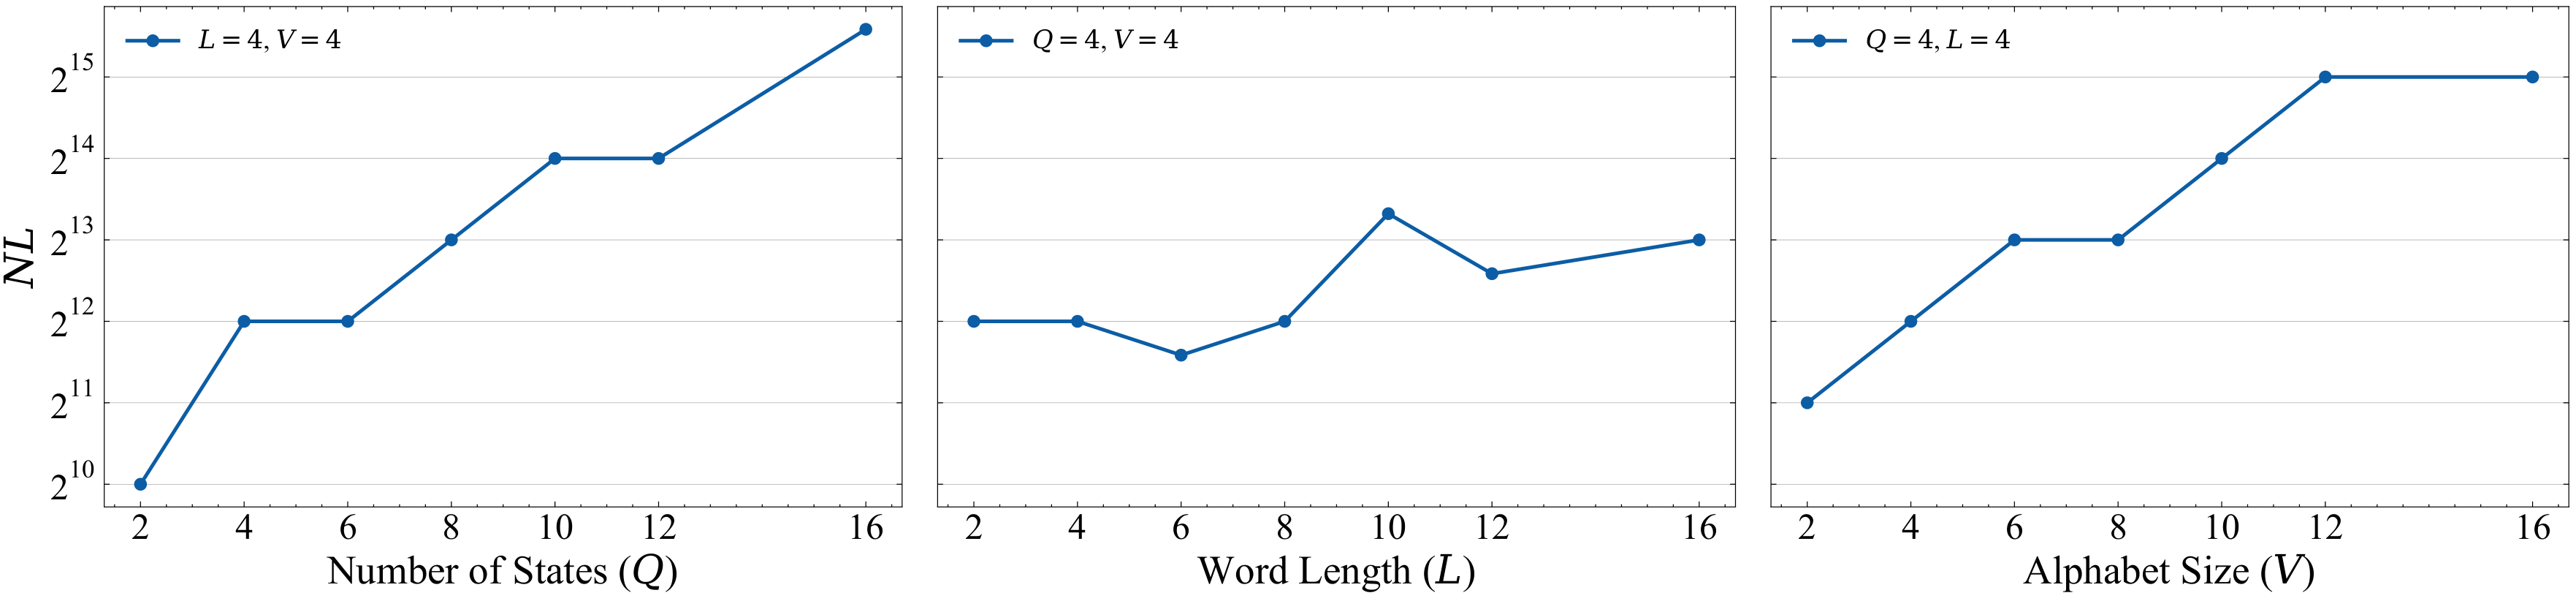
固定 $H 再对 $\widehat W$ 作 SVD,写成 $\sum_{h=1}^{\widehat H}u_hv_h^\top$,把向量折回 $d\times d$ 矩阵作为 $\widehat V_h,\widehat Q_h$(奇异值可分配给左右两侧)。由于 $\widehat H=\operatorname{rank}(\widehat W)\le d^2$,所得 MHLA 在所有输入上与线性回归解同函数。因此放宽并没有损失最优预测值,但输出模型可比一个指定的 $H$ 头比较对象更宽。这是论证“最优多头模型可学”的关键,不是声称固定少量头的非凸训练已被直接求解。[Algorithm 1,PDF p. 3;Sec. 2.1,p. 4;Appendix D,pp. 17–18] Theorem 2.2 给出的量化说法是:对独立同分布样本、平方误差,在概率至少 $1-\delta$ 下,输出模型相对最优 MHLA 的总体期望风险差不超过 $\epsilon$,样本量为 $O((d^4+\log(1/\delta))/\epsilon)$,运行时间为 $O(Nd^4n_{\max}/\epsilon)$。其中 $n_{\max}$ 是样本最大序列长度。无需假设标签由 MHLA 生成,是所谓 agnostic 部分;对一个固定训练集求经验最优值则不依赖独立同分布抽样。[Theorem 2.2,PDF pp. 3–4] 由于 $S_{jk}=S_{kj}$,用于可辨识性的特征需要把对称重复项合并。定义 $\mathcal H(Z)$:对每个 $j 模型输出可写为 $\hat y_{\Theta,a}(Z)=\langle p_a(\Theta),\mathcal H(Z)\rangle$。对非对角 $j 在数据可由某个 $\bar\Theta$ 精确生成时,$\lambda_{\min}(\Lambda_D)>0$ 使训练设计矩阵在上述特征空间列满秩。任意零经验误差解必须满足 $p_a(\Theta)=p_a(\bar\Theta)$,故对任意长度、任意输入 $Z$ 都有 $\hat y_\Theta(Z)=\hat y_{\bar\Theta}(Z)$。这是“可认证辨识性”:检查的是数据能否排除所有函数层面的歧义。在数据不可实现时,论文另证明,若允许至少 $d^2$ 个头,满秩仍使经验最优函数唯一,但它不再等于某个预设真函数。因为 $\Lambda_D$ 是 $N$ 个秩一矩阵之和,$N\ge\psi$ 是满秩的必要条件;实际还要这些样本提供足够多样的特征。[Lemma 2.3,PDF p. 5;Lemmas A.3、A.6,pp. 13–15] **教学例子。**若观测输入只落在一个狭窄子空间,某些三次特征始终为零;改变对应系数不会改变训练输出,却可能改变新输入输出。加入能激活这些特征的样本,使 $\Lambda_D$ 满秩,就消除了这种函数歧义。这个例子说明的是证书逻辑,并非论文的独立实验。 作者把图灵机转移表和输入串编码进初始 token,用正交基向量表示离散符号与位置;一个自回归 MHLA 反复生成下一个 token,利用注意力完成按键查值、复制邻近 tape 单元和条件分支。它将机器的每一步 tape、状态和读写头位置写成新的历史片段,使每次预测仍只需一个固定的单层模块。[Sec. 3,PDF pp. 5–6;Appendix F,pp. 23–28] 设状态数、字母表、输入长度和计算步数分别受 $\widehat{\mathcal Q},\widehat\Sigma,\widehat n,\widehat\Phi$ 限制。构造给出的头数为 $O(\widehat n\widehat\Phi\widehat\Sigma)$,嵌入维度为 $O(\widehat n\widehat\Phi\widehat\Sigma\max(\widehat\Sigma,\widehat{\mathcal Q}))$;第 $t$ 个 TM 状态在至多 $O((n+t)t)$ 个自回归步骤后出现,作者称可用 2 位精度实现。其规模随预先给定的边界增长;不能把该陈述读作对无限制运行的通用图灵机采用固定维度求解。[Lemma B.1,PDF pp. 16–17] 统计结论分两级:从独立同分布的计算轨迹样本学习,论文用逐 token 误差与 union bound 给出分布内整段轨迹误差 $O(\epsilon\widehat\Phi)$;若训练轨迹还满足可辨识性证书并精确匹配构造函数,则新模型在规定尺寸范围内的所有机器和输入上执行同一函数。后一结论依赖数据证书,不能从前一层的平均风险保证自动得到。[Appendix C,PDF pp. 16–17;Lemma 3.1,pp. 5–6] 作者用随机单层线性注意力生成长度 $T=100$ 的高斯序列及目标输出,比较 Algorithm 1 的凸回归结果、单层多头线性注意力、单头多层线性注意力和带 softmax、MLP、layer normalization 的完整 Transformer。图的横轴是训练 epoch,纵轴是预测均方误差(MSE,越低越好,对数坐标),阴影是三次运行的标准误。主文 Fig. 1 两组设置分别为 $(N,d)=(512,2)$ 和 $(2048,4)$。附录 G.1 的优化器表列为 AdamW,虽然正文把梯度训练统称 SGD。[Sec. 4.1,PDF pp. 6–7;Fig. 1,p. 7;Appendix G.1,p. 29] 在 $d=2$ 的图中,$m=d^2=4$ 个头的曲线于约 300–350 epoch 接近凸算法的数值精度水平($10^{-16}$ 附近);在 $d=4$ 中,$m=16$ 个头同样接近该水平。增加单头模型的层数及改用完整 Transformer 没有稳定带来同样的下降。这个比较支持“头数扩张与线性化的参数化相吻合,可能帮助此合成任务的优化”。它不表示头数越多必然越好:例如 $d=2$ 图中 8、16 头曲线反而高于 4 头。两图的 MSE 是该合成回归任务的指标,不是大规模语言建模性能。[Fig. 1,PDF p. 7] 单头模型用 $Z=\begin{bmatrix}k_1&\cdots&k_d&q\\v_1&\cdots&v_d&\zeta\end{bmatrix}$ 存储 key–value 对并查询 $q$,目标输出的下半部分为 $\sum_j\langle q,k_j\rangle v_j$。作者固定 $d=4$、每组 $2^{14}$ 个样本;在独立高斯 key/value 与每个样本重新生成的正交 key/value 之间调节混合比例(95%–100% 的正交数据),从而改变 $\lambda_{\min}(\Lambda_D)$。性能量不是原始权重距离,而是函数系数空间中的 $\|p(\Theta)-p(\widehat\Theta)\|_F$,越小表示越接近真函数。[Sec. 4.2,PDF pp. 7–8;Eqs. (13)–(15)] Fig. 2a 的横轴为最小特征值(以 $2$ 为底的对数标度),纵轴为上述距离。随着最小特征值从约 $2^{-13}$ 增至 $2^{-7}$,Algorithm 1 所得模型与真函数的距离从约 $3.5$ 降至约 $0.1$。误差棒显示不同运行的波动。图支持条件数改善与函数恢复更准确相关,不能从该曲线直接读取测试集误差。[Fig. 2a,PDF p. 8] Fig. 2b 比较满秩($\lambda_{\min}=0.06$,蓝色)与低秩($\lambda_{\min}=0$,橙色)数据。对于凸回归和 1、2、4、8 头模型,满秩组的 $p$ 空间距离约落在 $10^{-7}$ 到 $10^{-4}$,低秩组约为 $10^0$ 量级;纵轴同样为对数刻度,误差棒为三次运行的标准误。它直接展示函数系数差距,并通过论文的函数等价关系解释为何低秩组容许不同的输入输出函数;图本身未绘制 OOD 测试误差。[Fig. 2b,PDF p. 8] 附录 G.4 把 DFA 转移表、输入词和状态转移历史串接起来,以自回归交叉熵训练模型预测历史 token。实际训练的是 4 层、16 头、隐藏维度 2048 的 Llama 风格完整 Transformer,而不是前述单层 MHLA。横轴分别改变状态数 $Q$、词长 $L$ 和字母表大小 $V$,另两项固定为 4;纵轴是达到 99% 下一 token 准确率所需的训练 token 数(样本数乘以词长,记为 $NL$,越低越好)。[Appendix G.2、G.4,PDF pp. 30–31;Fig. 4,p. 31] 状态数从 2 增至 16 时需求约由 $2^{10}$ 升至 $2^{15}$ 以上;字母表增大时也整体上升,词长方向波动较大。作者把曲线称为“暗示次指数依赖”,但该范围的有限点并未拟合出严格的复杂度阶。这个实验说明某种完整 Transformer 在给定 DFA 描述时可以学会状态历史生成;它不能充当 Algorithm 1 或单层 MHLA 的直接经验验证。[Fig. 4 与 Appendix G.4,PDF p. 31] 本文最有价值的思路,是把“加宽模型”变成一个可计算的凸参数空间,并把“学到同一个算法吗”转成可检查的数据秩条件。前者解决这类单层线性注意力的经验优化,后者在条件成立时给出函数层面的、与具体权重重标定无关的证书。合成任务里的头数和特征值实验分别与这两段机制呼应。[Secs. 2、4、6,PDF pp. 3–9] 理解结论时有三个实质边界。第一,SVD 得到的宽模型可能需要 $d^2$ 个头,UTM 构造的维度也随事先给定的状态、字母和历史长度边界增长;该多项式时间结论并未给出现代大模型规模的实用训练方案。第二,Eq. (6) 的平方损失总体风险保证在定理陈述中未列输入、标签或损失的有界性/矩条件,Appendix D 对该样本复杂度只援引一般 VC 结果;要把其分布无关的强 agnostic PAC 数值界用于具体分布,仍需核对这一步所需的统计条件。第三,Appendix E 的近似可辨识性证明在平方范数与范数之间的记号及将两个 $\epsilon$ 近似解相减时的常数上写得较快,因而最稳妥的阅读重点是满秩且精确拟合时的函数唯一性,而非直接套用印出的近似误差式。[Theorem 2.2,PDF pp. 3–4;Appendix D,pp. 17–18;Lemma A.7 / Appendix E,pp. 21–22] 一个自然的后续问题是:能否在保留可检验的函数证书时,把这种重参数化推广到带归一化、门控或多层耦合的注意力,并给出明确的损失尾部条件与可实现的数值复杂度?这是从本文机制推得的研究方向,论文并未对此给出同等级保证。[Sec. 6,PDF p. 9]2.3 满秩证书究竟检查什么
2.4 有界 UTM:表达构造怎样接到学习结论
三:实验与理论验证
3.1 多头是否改善梯度训练?
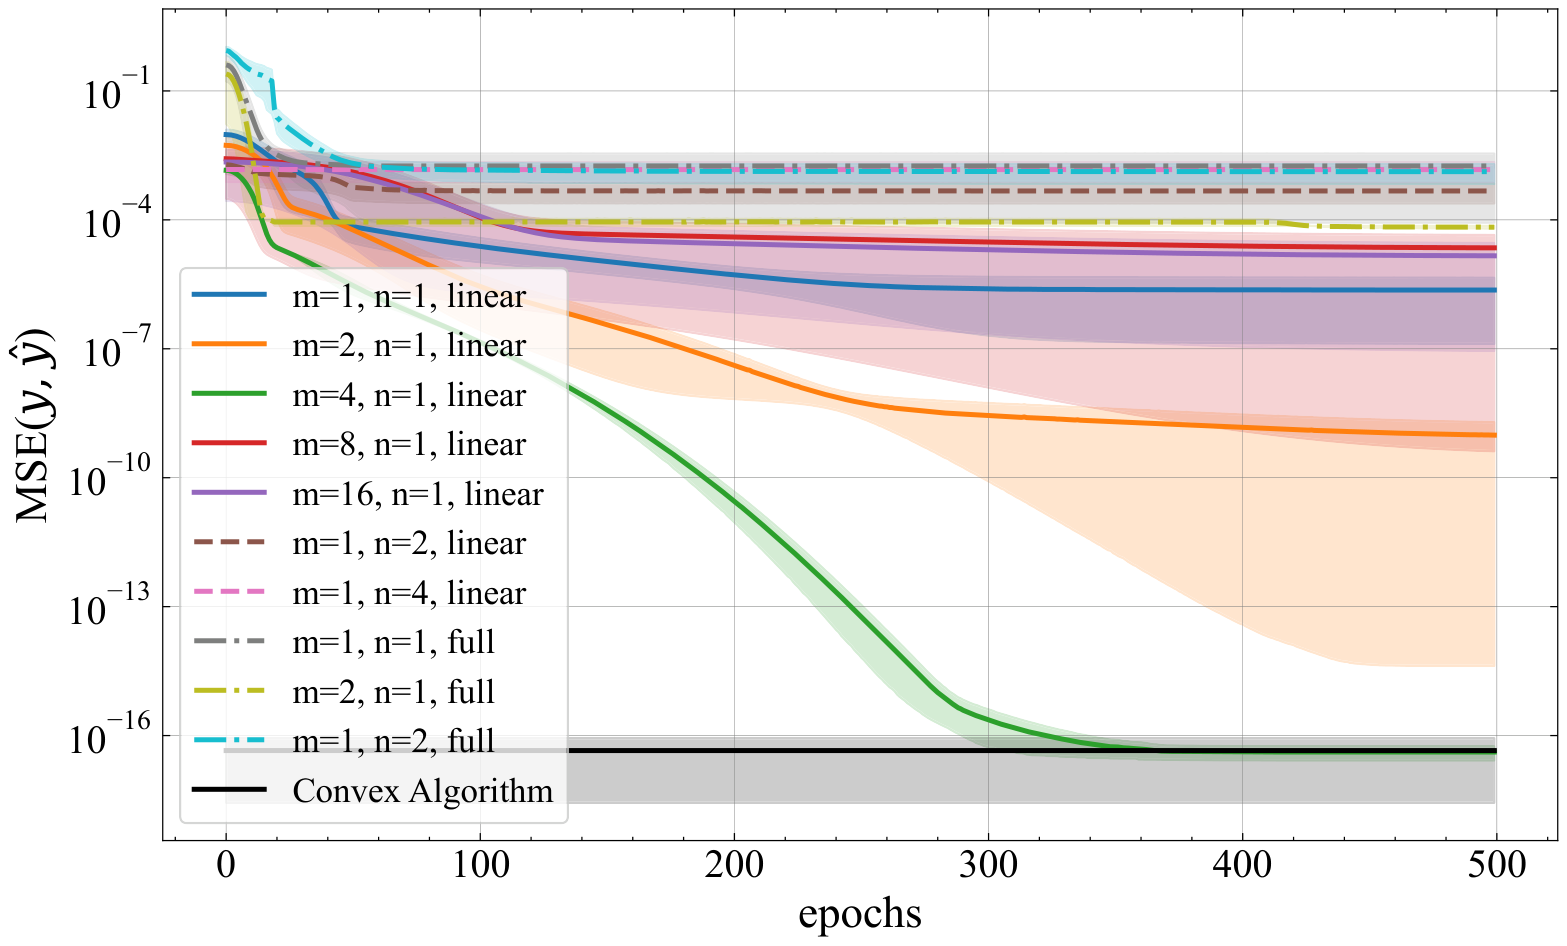
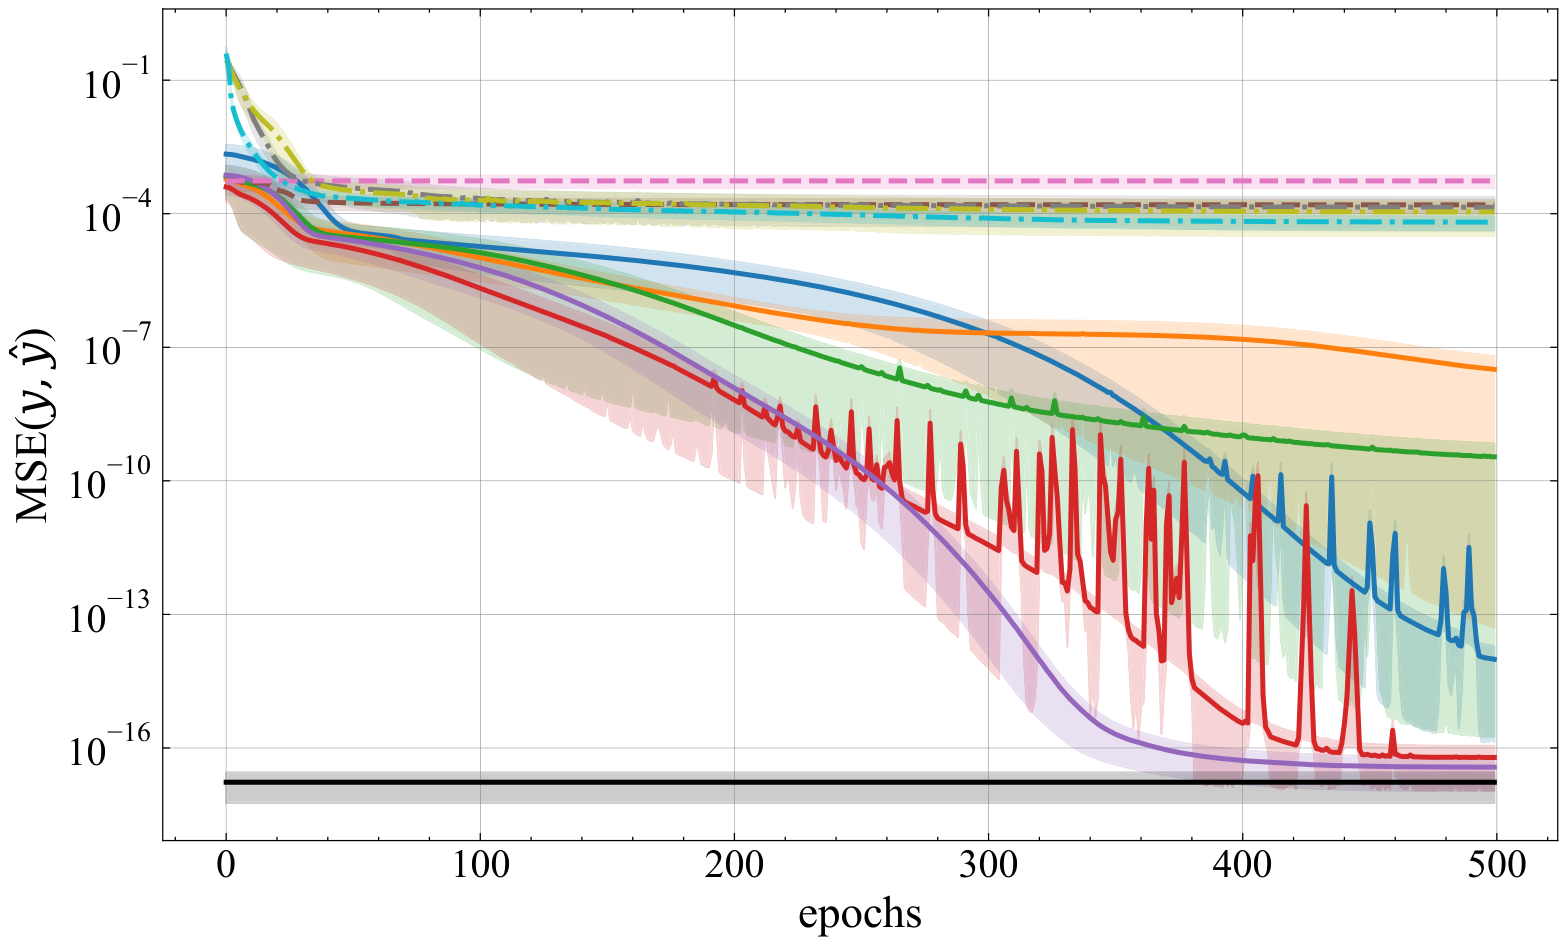
3.2 关联记忆中,证书值与函数差距是否对应?
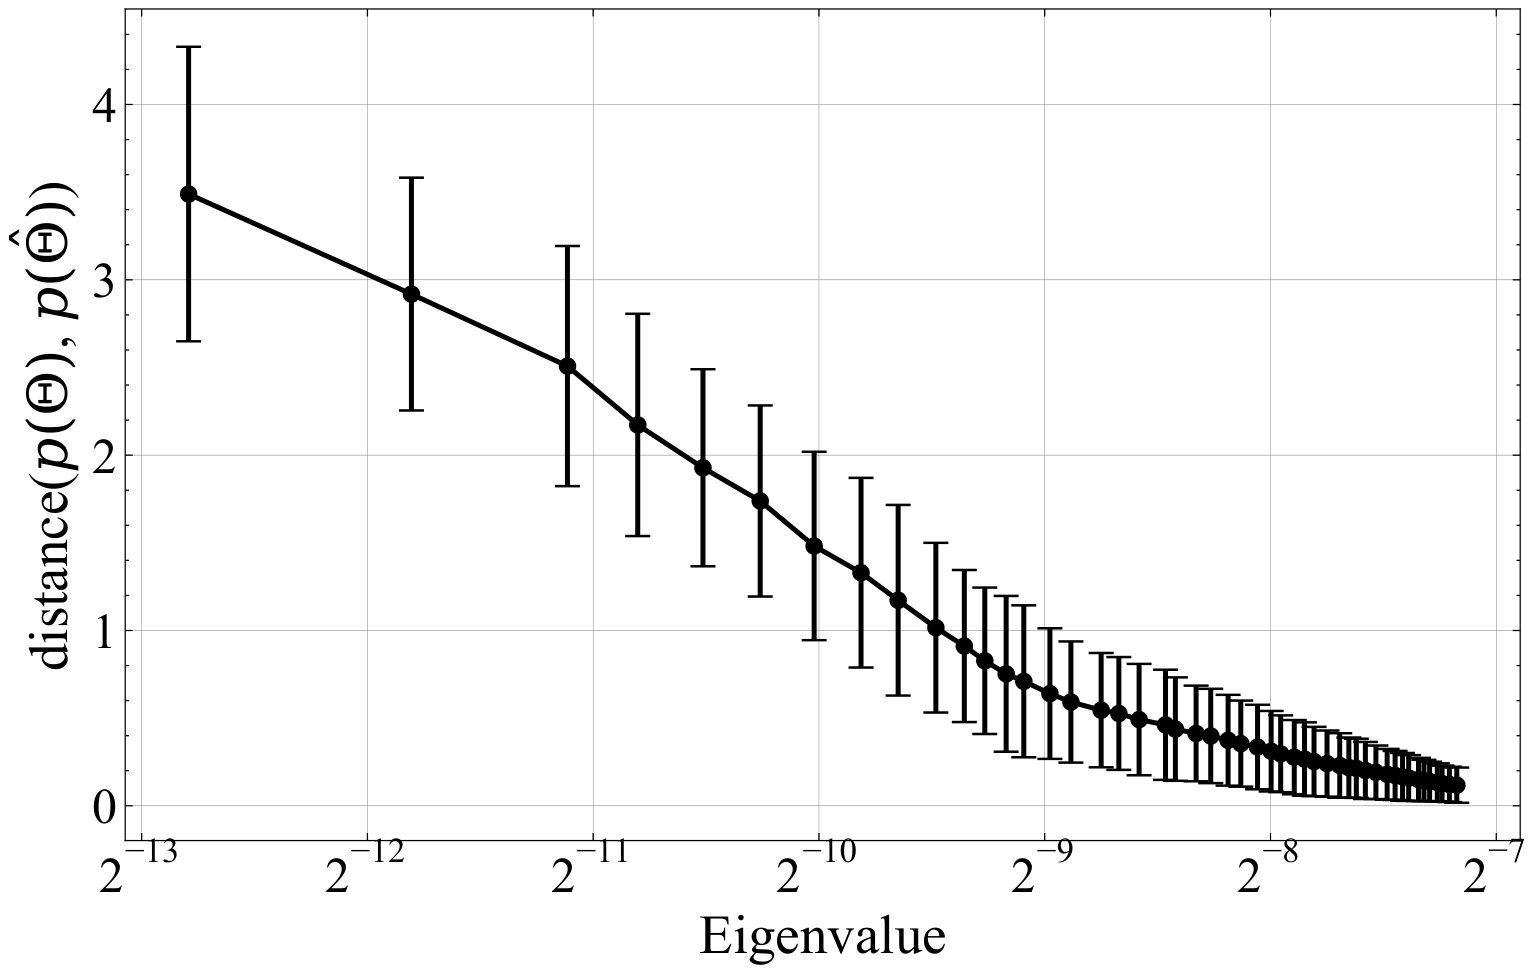
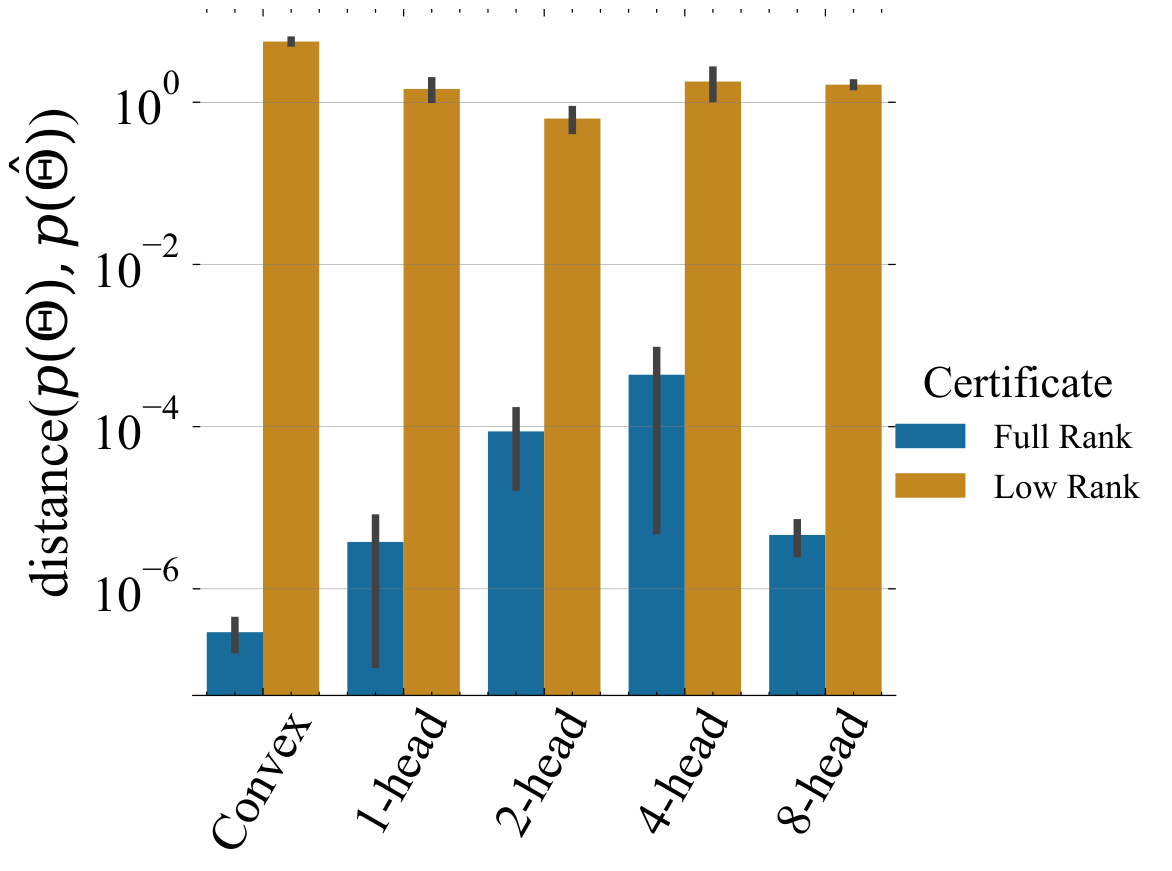
3.3 附录 DFA:哪一种模型被实际训练?
四:证明链与判断要点
五:结论、边界与值得追问之处