RetrievalAttention:通过向量检索加速长上下文大模型推理——中文研读笔记
论文:Di Liu、Meng Chen、Baotong Lu、Huiqiang Jiang、Zhenhua Han、Qianxi Zhang、Qi Chen、Chengruidong Zhang、Bailu Ding、Kai Zhang、Chen Chen、Fan Yang、Yuqing Yang、Lili Qiu,RetrievalAttention: Accelerating Long-Context LLM Inference via Vector Retrieval。
原文:arXiv:2409.10516v3(2024-12-31 修订,19 页);本地 PDF。本次研读:2026-10-28。以下页码均从 PDF 首页起计。
发表:已发表于 NeurIPS 2025 主会论文集。
代码:截至 2026-10-28,未查到可核实的 RetrievalAttention 原方法实现。Microsoft 同名仓库目前公开的是后续系统 RetroInfer,不能直接当作本文实现。
论文总览
长上下文解码既要保存不断增长的键值缓存(KV cache),又要在每一步读取相关历史 token。RetrievalAttention 的出发点是:对当前查询向量,真正承载主要注意力权重的历史 token 很少,但它们的位置随查询改变。因此,作者在 CPU 内存保存大部分 KV,并利用预填充阶段已有的查询向量构建面向注意力查询分布的近似最近邻索引;解码时从 CPU 动态检索关键 KV,与 GPU 常驻的少量固定位置 KV 分别计算注意力,再按各自的 softmax 归一化量合并。(Sec. 2–3,PDF 第 3–7 页)
核心结果是在论文的单请求、128K 上下文、RTX 4090(24 GB)设置下,Llama-3-8B 的延迟为 0.188 秒/词,而精确向量扫描 Flat 为 0.922 秒/词,普通 IVF 索引为 0.373 秒/词;搜索达到 0.95 以上 Recall@100 时,仅扫描约 1–3% 的 key。任务分数接近全注意力,但并非逐任务相等,复杂 KV retrieval 仍需要更高的检索预算。(Tables 2、4–5;Fig. 6,PDF 第 8–10 页)
结构地图
| 原文章节 | 在论证中承担的作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 长上下文的计算和存储压力;提出查询感知向量检索 | 第 1–3 页;Fig. 1、Table 1 |
| 2 Background and Motivation | 注意力公式、动态稀疏性、常规 ANNS 的分布外问题 | 第 3–5 页;Eq. (1)、Figs. 2–3 |
| 3 RetrievalAttention Design | 稀疏近似、查询感知索引、CPU–GPU 并行 | 第 5–7 页;Eq. (2)、Fig. 4 |
| 4 Evaluation | 任务精度、解码延迟、检索质量 | 第 7–10 页;Tables 2–5、Figs. 5–6 |
| 5 Related Works;6 Conclusion | 与缓存压缩、块检索、向量检索方法的区别及总结 | 第 10–11 页 |
| 附录 A–G | 模型和补充任务、A100 与百万 token、合并公式、实现、预算与 70B | 第 15–19 页;Figs. 7–8、Tables 6–11、Eqs. (3)–(5) |
一:动机——稀疏但位置不断变化
两种互相牵制的成本
有 KV cache 时,解码一步通常要访问长度为 $n$ 的历史 KV,读缓存的代价随 $n$ 增长;把完整缓存放在 GPU 又受显存限制。作者用 Llama-3-8B 举例:1M token 的 KV 缓存约需 125 GB;如果不缓存、每步重新处理上下文,单词生成延迟在其 A100 测试中达到 1,765 秒。这两个数字描述不同的瓶颈:125 GB 是完整缓存的容量需求,1,765 秒是无缓存重算的延迟,不能合并解读为同一种执行配置。(Table 1,PDF 第 2–3 页)
作者要解决的是已有长提示词的解码阶段。Sec. 3 明确假设长提示词的 prefill 已提前完成;在线解码延迟不含完整的索引建立和首轮 prefill 时间。因此,该方法尤其对应重复使用固定上下文或将 prefill 与解码分开的服务形态。(PDF 第 5 页)
为什么静态保留一批 token 不够
注意力分数是
这里 $\mathbf q_t$ 是当前 token 的查询,$\mathbf k_i,\mathbf v_i$ 是历史第 $i$ 个 token 的键和值,$d$ 是该注意力计算所用的向量维度。按 $a_{t,i}$ 从大到小选 token,其注意力权重之和叫作恢复率;它量化选中 token 覆盖了多少 softmax 权重质量。(Eq. (1),PDF 第 3 页)
在 Llama-3-8B 的 100K token KV retrieval 探针中,作者连续生成 20 个 token,每个注意力头保留动态 top-1000,平均恢复率为 89%;若固定采用生成第一个 token 时选出的 top-1000,后续平均只有 71%。这组探针支持“每步重新选关键位置”的设计,而不是仅用初始固定集合。(Fig. 2,PDF 第 3–4 页)
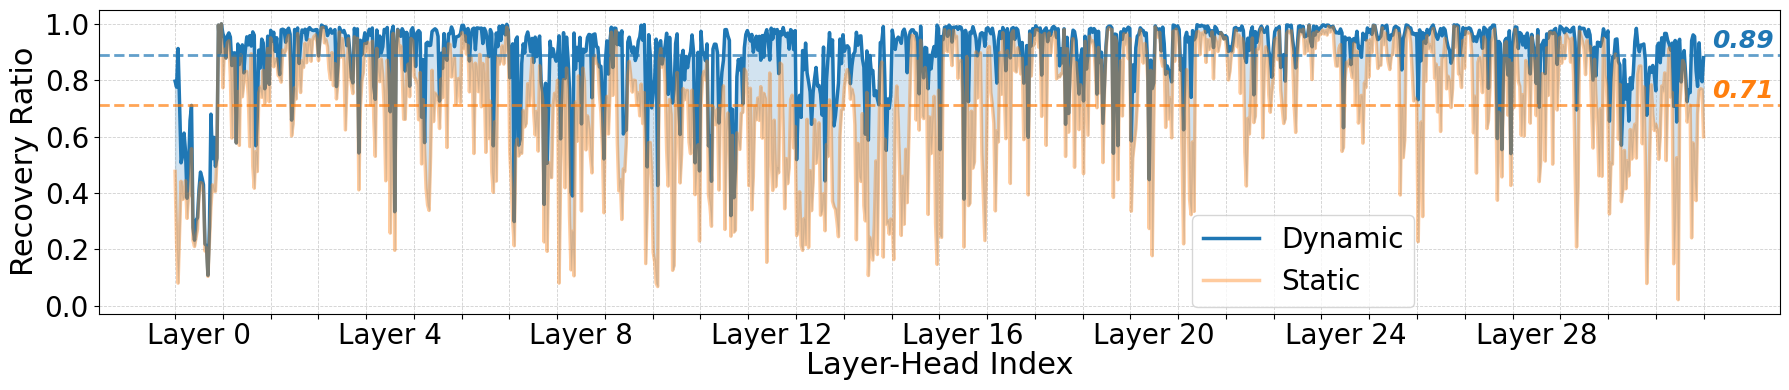
原文 Fig. 2,PDF 第 4 页。横轴按层和头展开;蓝线是每步动态 top-1000,橙线是第一个生成 token 决定的静态 top-1000。虚线标出跨头平均值。
为什么直接套普通向量索引也不够
按内积检索较大的 $\mathbf q_t\mathbf k_i^\top$,与寻找高注意力分数的目标一致。问题在于查询 $Q$ 和键 $K$ 由不同投影产生,普通按 $K$ 之间接近程度组织的索引,未必形成适合 $Q\!\to\!K$ 查询的访问路径。作者在 Yi-9B 和 Llama-3-8B 的 128K 向量上观察到,$Q\!\to\!K$ 的马氏距离分布远离 $K\!\to\!K$;以 IVF 做 $Q\!\to\!K$ 搜索,要达到高于 0.95 的 Recall@100,约需扫描 30–50% 的 key,而同分布的 $K\!\to\!K$ 搜索只需约 1–5%。HNSW 的 $Q\!\to\!K$ 曲线也停留在较低召回。(Fig. 3,PDF 第 4–5 页)
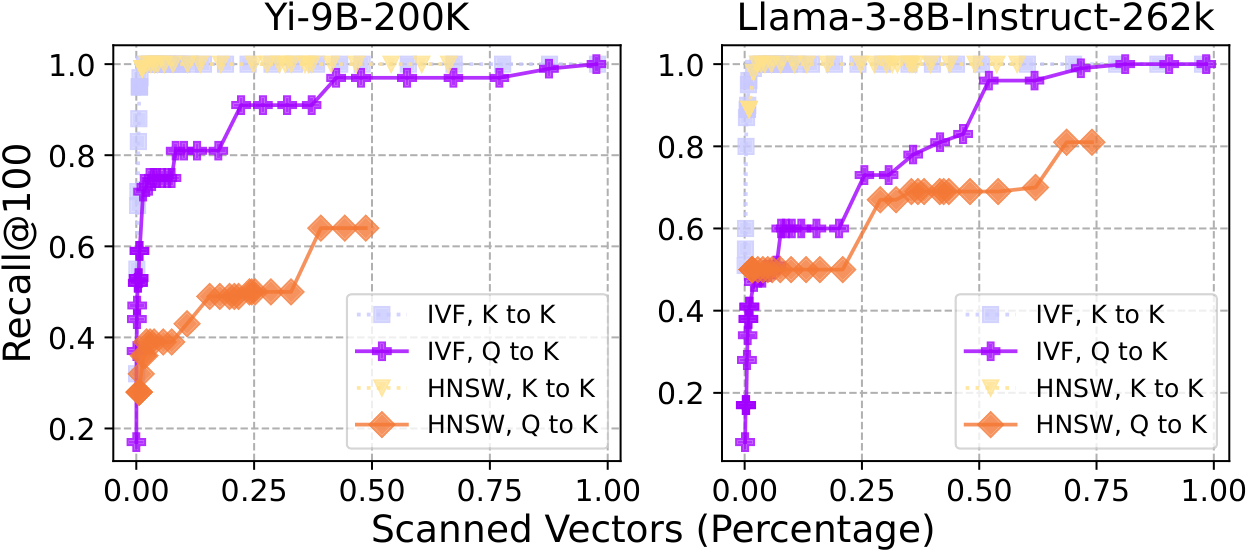
原文 Fig. 3a,PDF 第 4 页。横轴为扫描的 key 占比,纵轴为检索 top-100 与精确 top-100 的重合率。紫、橙曲线对应真正的 $Q\!\to\!K$ 查询。
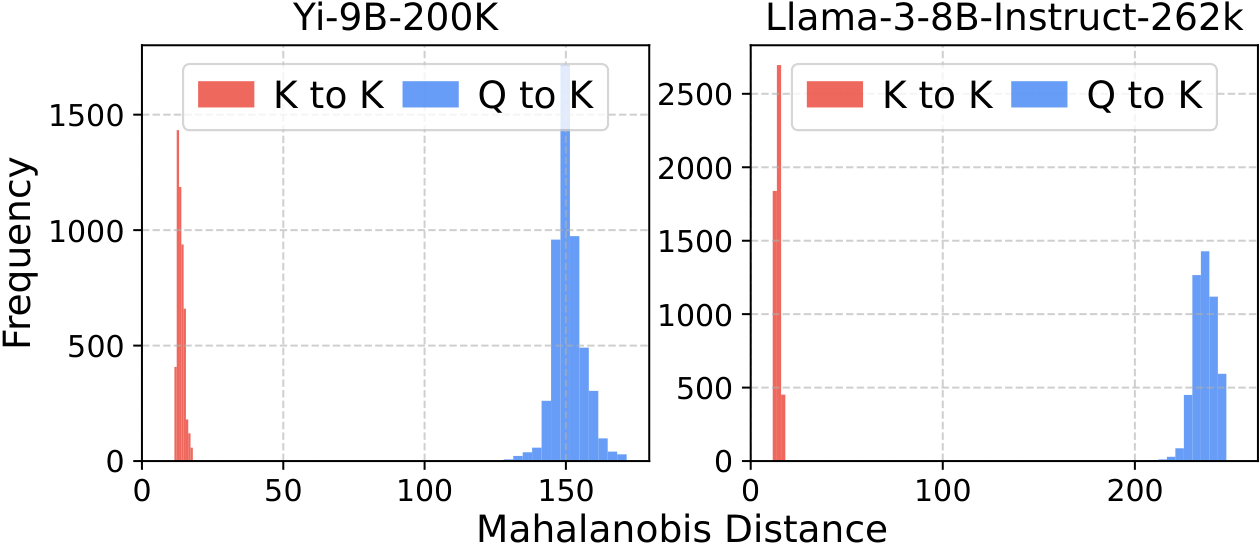
原文 Fig. 3b,PDF 第 4 页。蓝色 $Q\!\to\!K$ 距离分布明显远于红色 $K\!\to\!K$;这是本文索引设计的实测动机。
二:方法——用 prefill 查询塑造 key 索引
1. 从完整注意力到被选 token 的注意力
设 $\mathcal I_{t,\epsilon}=\{i:a_{t,i}>\epsilon\}$。作者把集合外的低权重项舍去,然后在集合内重新做 softmax:
这是 Sec. 3.1 的目标表达式(Eq. (2),PDF 第 6 页)。$\epsilon$ 描述理想的“重要 token”集合;实验实现则采用固定检索预算,例如默认动态 top-100,较难的 KV retrieval 试 top-2000,另有 GPU 常驻 token。两者不要混成“实现逐个检查 $a_{t,i}>\epsilon$”:后者需要先知道完整注意力。
恢复率解释为什么这种近似可能可行,但它只是权重质量,并非直接给出输出向量误差或任务精度的保证;最终效果要由任务实验检验。
2. 注意力感知图索引
建立索引时,作者利用 prefill 中已有的查询向量。对每个采样查询,先用 GPU 算它在 key 集合中的精确 top-$k$,连接“查询—其重要 key”。如此得到一个从 $Q$ 的视角观察 $K$ 的邻接关系,而不是仅用 key 与 key 的相似度。直接保存查询节点会增加内存和访问开销,于是借鉴 RoarGraph 的投影:如果两个 key 被相同查询连到,就把这种关系投影成 key 节点之间的边,最后搜索图只保留 key 节点。解码的新查询沿这张图搜索到相关 key。(Sec. 3.2,Fig. 4b,PDF 第 5–6 页)
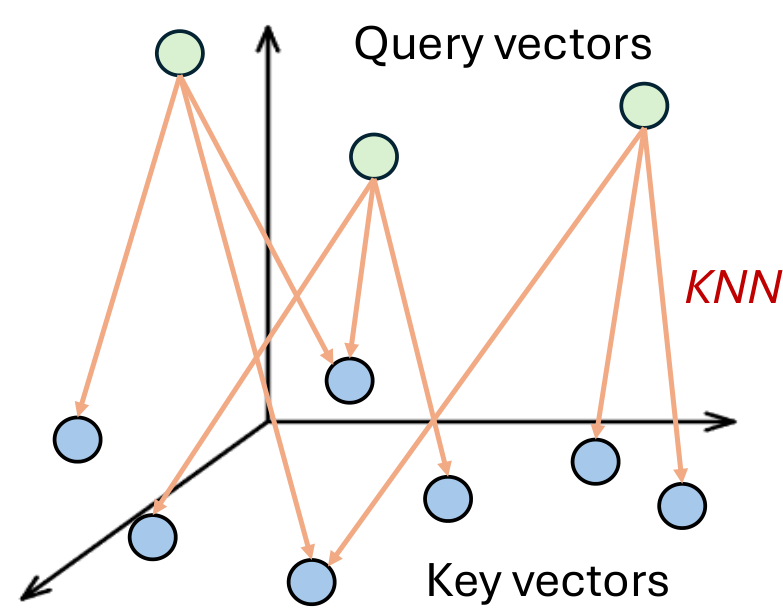
原文 Fig. 4b,PDF 第 5 页;图中画的是投影前的查询—key 连接。最终的 key 图把共享查询诱导的邻近关系保留下来。
索引的效果体现在“找得准且少扫描”:在三种模型的 $Q\!\to\!K$ 实测中,RetrievalAttention 扫描约 1–3% key 即达到超过 0.95 的 Recall@100。(Fig. 6,PDF 第 10 页)这里的扫描占比和最终参与注意力的 top-100 数量是两个不同指标:前者衡量搜索时读了多少 key,后者是输出的候选规模。
3. CPU–GPU 的两路计算
GPU 保留可预期的固定位置 KV:当前实验使用前 128 个 token 和最近 512 个 token,共 640 个。其余 KV 放到 CPU 内存的索引里,解码时按当前查询动态找 $\Omega$。GPU 对常驻集合 $\mathcal W$ 计算注意力;CPU 对检索结果 $\Omega$ 计算另一份注意力,两路可以并行。CPU 直接完成检索结果的注意力,避免把整份 KV 经 PCIe 搬回 GPU。(Sec. 3.3;Fig. 4a,PDF 第 5–7 页)
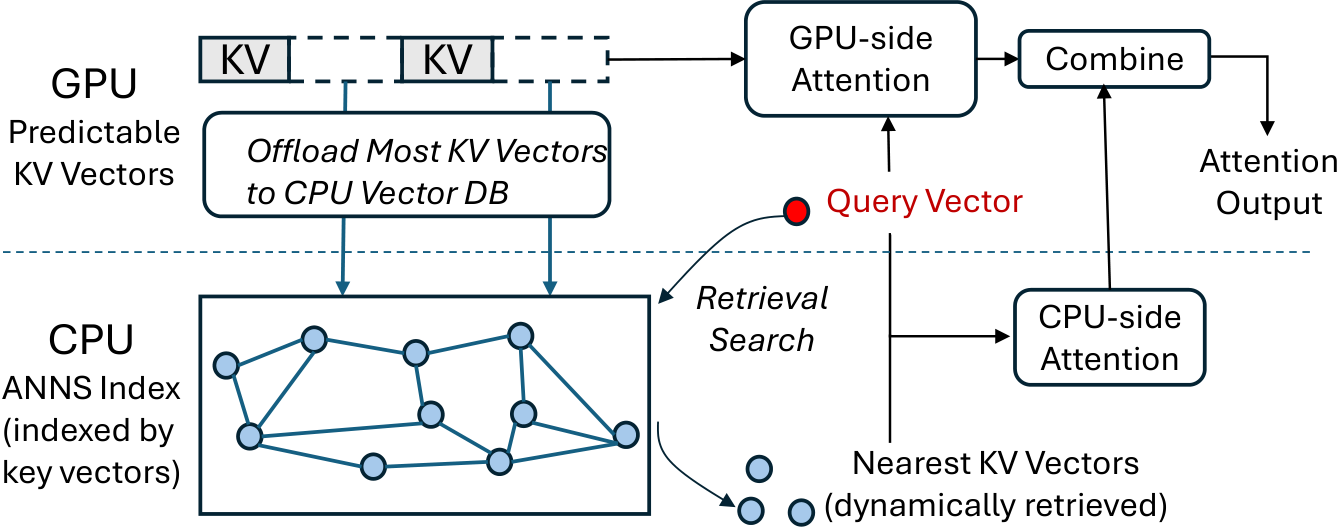
原文 Fig. 4a,PDF 第 5 页。上路计算固定模式的 KV,下路从 CPU 向量索引取关键 KV,两路结果在右侧合并。
两路的局部 softmax 不能直接把输出相加,因为各自的归一化分母不同。设
令 $m=\max(m_{\mathcal W},m_\Omega)$,两路在并集上的权重为
这与附录 B 的 Eqs. (3)–(5) 等价:只要两集合互不重叠且两路局部计算正确,合并结果精确等于在选中并集上重新做一次 softmax;相对于完整历史的误差只来自“漏掉了哪些 token”,而非两路合并的计算。(PDF 第 17 页)论文的 $\tilde z$ 未在文字中单独定义,上式用两路最大值显式写出数值稳定的共同基准。
4. 实现上的资源安排
预填充时作者让 KV 向 CPU 传输与 GPU 全注意力流水重叠,并按头处理以降低峰值显存。CPU 侧让不同注意力头并行检索。对分组查询注意力(GQA),同组查询头虽共享 KV,但查询分布不同,所以各查询头建独立索引;索引之间通过指针共享 KV 的物理存储。(附录 C,PDF 第 18 页)这些措施有助于解释解码数据流,但论文主要延迟表测的是已经完成 prefill 的解码阶段。
三:实验如何检验方法
主测试机是单张 RTX 4090(24 GB)、Intel i9-10900X(10 物理核)和 128 GB DRAM,单请求 batch size 1;模型为 Llama-3-8B-Instruct-262k、Yi-6B-200K、Yi-9B-200K。附录另用 A100 测试,不能把各机器的延迟数字直接横比。任务包括七项 $\infty$-Bench(平均输入超过 100K)、覆盖 4K–128K 的 RULER,以及 Needle-in-a-haystack。(Sec. 4.1,PDF 第 7–8 页)
对照组分三类:完整注意力(无缓存重算,以及 vLLM 的 GPU KV 缓存);丢弃或选择部分 KV 的 StreamingLLM、SnapKV、InfLLM、Quest、InfiniGen;向量检索的 Flat(精确线性扫描)和 IVF(按 key 聚类的近似检索)。Flat/IVF 与本文共享“保留 640 个固定位置 + 检索候选”的大体用法,较适合拆解索引设计的贡献。主表默认检索 top-100,$\infty$-Bench 的难题 KV retrieval 另列 top-2000。(Sec. 4.1;Table 2,PDF 第 7–8 页)
| 指标 | 读法 |
|---|---|
| $\infty$-Bench、RULER 分数 | 任务正确率/得分,越高越好;括号内是相对全注意力的百分点差值 |
| Recall@100 | 检索 top-100 与精确 top-100 的重合比例,越高越好 |
| Scanned vectors | 搜索过程访问的 key 占全部 key 比例,越低越省搜索开销 |
| 解码延迟 | 秒/生成 token,越低越快;不包括预先完成的整个 prefill |
| Act. Tokens | 一步注意力实际使用的 token 规模;与扫描比例不同 |
四:结果——准确率与解码成本的具体取舍
4.2 任务精度
下表摘自 $\infty$-Bench 的七任务平均分。斜杠左右分别是检索 top-100 与 top-2000;全注意力没有这个预算区分。(Table 2,PDF 第 8 页)
| 模型 | 全注意力 | RetrievalAttention top-100 | RetrievalAttention top-2000 |
|---|---|---|---|
| Llama-3-8B | 50.4 | 48.9 | 49.6 |
| Yi-9B | 52.8 | 50.8 | 52.2 |
| Yi-6B | 45.5 | 45.0 | 45.0 |
平均接近不代表每项接近。最难的 Retr.KV 项中,Llama-3-8B 是全注意力 17.5、本文 top-100 9.0、top-2000 14.0;Yi-9B 是 30.5 / 20.0 / 30.0。增加预算显著弥补差距,也增加实际参与注意力的 token 数。相对地,较简单的 passKey 和 number retrieval 在多组设置中已近满分。原文对“接近全注意力”的概括应按具体任务和预算理解。(Table 2,PDF 第 8 页)
RULER 在六个上下文长度的平均分,Llama-3-8B 为全注意力 86.54、本文 84.70;Yi-9B 为 76.87 / 76.43;Yi-6B 为 67.86 / 65.86。只看 128K 一列则分别是 78.74 / 74.70、60.51 / 59.15、55.77 / 51.44。主表的“Effective”列还给出模型本身有效上下文估计;例如 Llama-3-8B 全注意力为 32K,本文为 16K,说明其并非完全复制全注意力的长程行为。(Table 3,PDF 第 9 页)
Needle-in-a-haystack 的二维热图显示,在 Llama-3-8B 的 4K–128K 测试格点上,本文均取到正确目标;附录对 Llama-3-8B-1048K 的 250K–1M 格点也给出全通过的热图。这证明给定这些合成检索位置和提示长度时可以工作;复杂任务的实际差距仍以上述任务表为准。(Figs. 5、8,PDF 第 9、16 页)
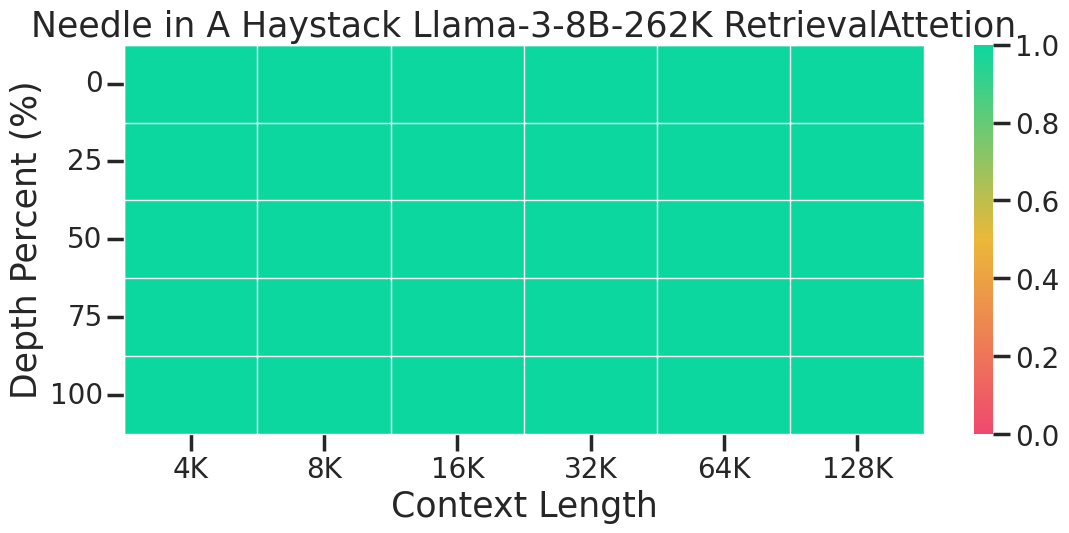
原文 Fig. 5,PDF 第 9 页。横轴是上下文长度,纵轴是目标插入深度;全绿表示该组格点全部通过。
4.3 RTX 4090 的解码延迟
在主机、Llama-3-8B、128K 上下文下,论文的逐词延迟如下。(Tables 4–5,PDF 第 9–10 页)
| 方法 | 检索 | 注意力 | 其他 | 总计(秒/词) |
|---|---|---|---|---|
| Flat(精确 KNN) | 0.798 | 0.083 | 0.041 | 0.922 |
| IVF(普通近似索引) | 0.250 | 0.084 | 0.039 | 0.373 |
| RetrievalAttention | 0.064 | 0.081 | 0.043 | 0.188 |
因而相对 Flat 和 IVF 的总延迟分别约降低 4.9 倍和 1.98 倍(按基线时间除以本文时间)。检索一项从 IVF 的 0.250 秒降到 0.064 秒,约低 74%;从 Flat 的 0.798 秒约低 92%(原文文字写 91%,取整口径略有差别)。注意力部分三者相近,主要收益来自少扫描且适合查询分布的索引,而不是把 softmax 算得更快。本文检索占总延迟约 34%。(Sec. 4.3;Table 5,PDF 第 9–10 页)
Table 4 中更快的 StreamingLLM(0.029 秒/词)和 SnapKV(0.028 秒/词)只处理固定数量 token,不能脱离前述任务精度表称本文“最快”。同表 vLLM 在作者 RTX 4090 配置中标为 OOM;这项硬件约束是 128K 单卡结论的重要条件。值得区分版本的是:NeurIPS 2025 出版版摘要写 0.107 秒/词,而本次所读 arXiv v3 的摘要和 Table 4 都写 0.188 秒/词;此笔记全部按 v3 原文讨论,没有将两个版本的数字混用。
4.4 索引本身是否解释了加速
Fig. 6 将检索质量与扫描开销直接画在一起:在 Yi-6B、Yi-9B 和 Llama-3-8B 的 $Q\!\to\!K$ 查询上,本文索引在约 1–3% 扫描比例时达到高于 0.95 的 Recall@100;普通 IVF、HNSW 和针对一般分布外检索的 RobustVamana 曲线在相同扫描开销下表现较差。$K\!\to\!K$ 的同分布查询则对多种索引都较容易。因此 Fig. 6 把 Fig. 3 的诊断与最终延迟表连接起来:重要的不是只换一个 CPU 索引,而是让图的邻接结构反映注意力查询看到的 key 关系。(Sec. 4.4,PDF 第 9–10 页)
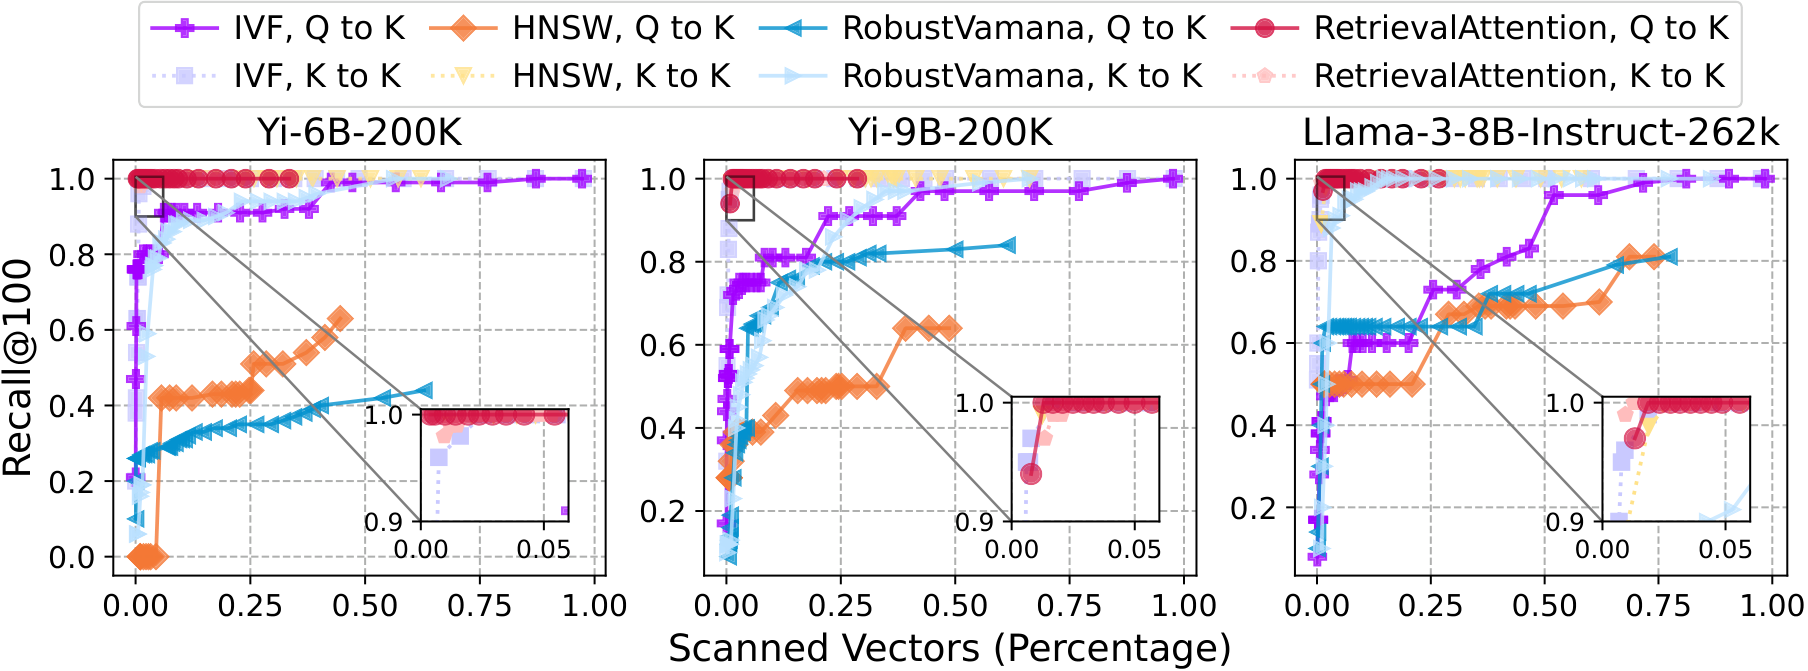
原文 Fig. 6,PDF 第 10 页。红色实线是本文的 $Q\!\to\!K$ 检索;小插图放大了低扫描比例且高召回的区域。横轴 0.05 对应全部 key 的 5%。
附录补充:更大长度、机器和模型
- A100(80 GB)+ 220 GB DRAM 的 128K Llama-3-8B 测试中,本文为 0.155 秒/词、IVF 为 0.345、Flat 为 0.564;完整 GPU KV 的 vLLM 为 0.033。这显示有足够显存时,精确 GPU KV 缓存仍可更快;本文主要处理显存不够而必须利用 CPU 的情况。(Table 7,PDF 第 16 页)
- 另一台 A100 + 1.72 TB DRAM 机器上,Llama-3-8B 从 100K 到 1M,本文延迟由 0.159 升至 0.172 秒/词,而 IVF 从 0.308 升至 1.889。百万 token 的延迟数字依赖这台大内存服务器,不是单张 RTX 4090 的结果。(Table 8,PDF 第 16 页)
- 附录 F 在 Llama-3-8B、$\infty$-Bench、128K、每头 2000 token 总预算的另一组实验中,按 PyramidKV 分层分配预算使平均分 49.9→50.1,Retr.KV 14.5→16.0,En.QA 8.7→8.5;说明预算分配有潜力,也有任务取舍。这是附录独立配置,不应与主 Table 2 的均分作直接差值。(Table 10,PDF 第 19 页)
- 70B 补充测试用 8 张 A100 40 GB、$\infty$-Bench 的 KV retrieval:本文精度 23.5,Flat 24.0,全注意力 35.0;本文延迟 1.62 秒/词,Flat 5.68。相对精确检索基线速度约快 3.5 倍,但对全注意力仍有明显任务精度差距。(Table 11,PDF 第 19 页)
五:结论与理解
RetrievalAttention 把长上下文解码中的“找重要历史 token”落实为面向当前查询的向量搜索:先利用 prefill 查询塑造 key 图,再让 CPU 的动态检索与 GPU 的常驻窗口各做一部分注意力,按局部归一化量正确合并。它的最有说服力的证据链是 Fig. 3 的查询/键分布差异 → Sec. 3.2 的查询感知图 → Fig. 6 的低扫描高召回 → Tables 4–5 的检索延迟下降。
实际采用时需同时考虑三个论文中可见的条件:其一,主延迟数字针对已完成 prefill 的解码,服务若频繁更换上下文还要计入索引构建成本;其二,KV 与索引主要占 CPU 内存,百万 token 结果使用 1.72 TB DRAM;其三,有限的 top-$k$ 预算在复杂 KV retrieval 和 70B 补充测试中未完全追上全注意力。由此,方法适合显存受限、可用 CPU 内存较多、长上下文可重复使用且允许按任务调节检索预算的场景。(Sec. 3–4;附录 A、G)