Just read twice:循环语言模型为何能从重读中受益
论文:Just read twice: closing the recall gap for recurrent language models
作者:Simran Arora, Aman Timalsina, Aaryan Singhal, Benjamin Spector, Sabri Eyuboglu, Xinyi Zhao, Ashish Rao, Atri Rudra, Christopher Ré。
版本:arXiv:2407.05483v1,提交于 2024-07-07;获取与研读日期:2026-09-29。
材料:arXiv · 原文 PDF · 作者主 TeX · 源码清单 · 英文幻灯片 · 幻灯片 TeX。
本次以同版本作者 TeX 为主要阅读材料,跟随主文件读取正文、实际引用的表格及附录 A–G,并用 56 页 PDF 核验公式、图表和页码。正文为 PDF pp. 1–12;附录实质内容为 pp. 20–53,训练配置为 pp. 54–56。参考文献用于辨认文中依据,未逐一研读外部论文,也未运行作者的训练或推理代码。下文页码均为从 1 开始的 PDF 页码,与本版本印刷页码一致。标为“本次分析”的内容是阅读者的推导或判断。
论文总览
核心问题不是循环模型是否知道足够多知识,而是它读到材料时,是否已经知道之后会被问什么。 固定状态只能保留部分上下文:先读长文档、后读问题时,模型必须提前猜哪些事实重要;知道问题之后再读一遍,就可以有针对性地更新状态。
论文给出两条实现路线。
| 路线 | 改动 | 如何使用未来已知的任务信息 | 代价 |
|---|---|---|---|
| JRT-Prompt | 更改现有模型的输入提示 | 第二次出现的材料可利用前一遍已出现的问题 | 输入变长,通常约两倍;不需重新训练 |
| JRT-RNN | 重新训练前缀线性注意力模型 | 前缀内部非因果读取,并与因果路径合并 | 额外 K/V 投影、前缀编码和训练目标变化 |
最有力的质量证据是 Table 2:约 360M 参数、30B 训练 token 时,JRT-RNN 的平均分为 42.9,Based 为 29.2,Transformer 为 43.4;1.3B/50B 时分别为 49.5、42.6、51.4。因此,相对 Based 的绝对提升为 13.7 和 6.9 个百分点。这里的平均分覆盖九个任务与长度组合,其中三个 512-token 条件还使用了 JRT-Prompt 填充,不能全归因于架构本身。〔Sec. 5.1,Table 2,p. 9〕
效率证据是 H100 上的预填充内核测试:原始长度 32768、batch 16 时,FlashAttention-2、JRT-Prompt、JRT-RNN 的延迟分别为 107.8、9.0、5.6 ms;论文报告后两者约 11.9×、19.2× 的吞吐优势。这不是完整模型的端到端生成加速,也不是 32k 长度上的质量评测。〔Sec. 5.3,Table 5,pp. 11–12〕
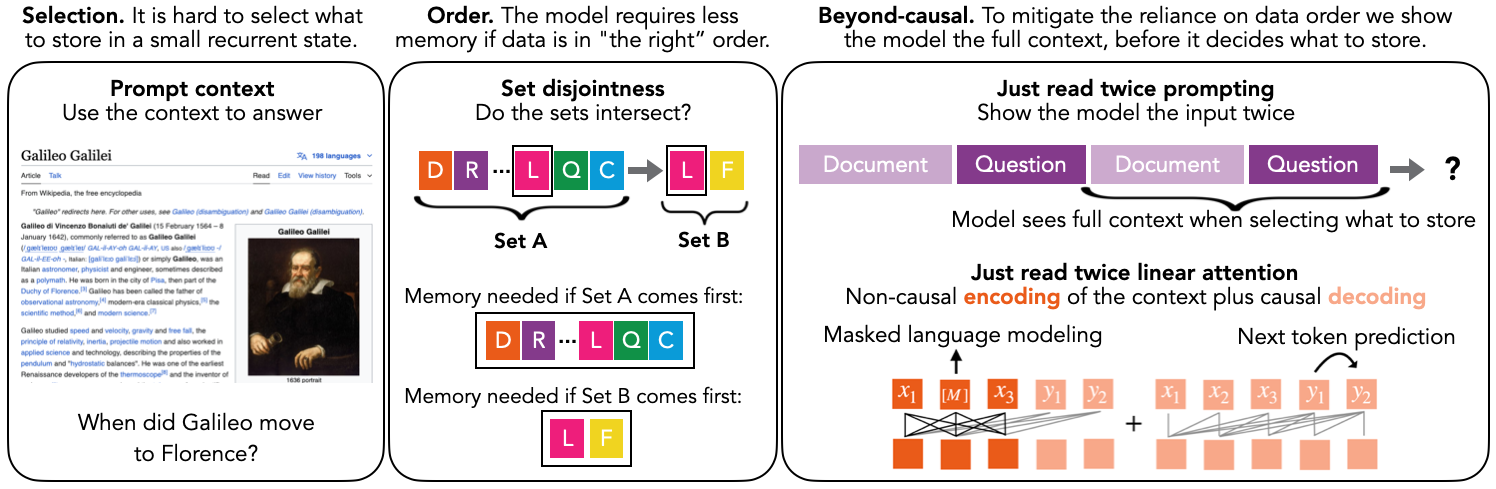
原图 1,p. 2。左:固定状态无法保留任意长文档的全部信息。中:先出现较小集合,可以减少需要保存的集合元素。右:重复提示与非因果前缀编码是两种应对方式。该图是方法示意,不是实验结果。
结构地图
| 原文章节 | 论证作用 | PDF 位置与关键证据 |
|---|---|---|
| 1 Introduction | 从记忆容量转向信息出现顺序 | pp. 1–3,Fig. 1 |
| 2 Background | 关联召回、ICL、记忆与质量的取舍 | pp. 3–4 |
| 3.1 Analysis of data order and communication complexity | 集合不相交实验及空间复杂度 | pp. 4–5,Fig. 2,Prop. 3.1,Thm. 3.2 |
| 3.2 Consequences … on downstream in-context learning | 无需训练的 JRT-Prompt | pp. 5–6,Table 1 |
| 4.1 Preliminaries | 线性注意力与 Prefix-LM | pp. 6–7,Eqs. (1)–(2) |
| 4.2 JRT-RNN architecture | 两套 K/V 与前缀状态合并 | pp. 7–8,Eqs. (3)–(4) |
| 4.3 JRT-RNN training objective | 前缀 MLM 加后缀 NTP | p. 8,Eq. (5) |
| 5.1 In-context learning quality | 主结果、2k 输入、填充策略 | pp. 9–10,Tables 2–4 |
| 5.2 Overall natural language understanding | 召回切片与一般语言理解 | pp. 10–11,Fig. 3;Tables 8–9 在 p. 27 |
| 5.3 Generation throughput;6 Conclusion | 内核效率与论文结论 | pp. 11–12,Table 5 |
| A Extended related work discussion | 与双向模型、Prefix-LM、CEPE 的关系 | pp. 20–21,Table 6 |
| B Experimental details | 合成数据、预训练、评测和指标 | pp. 22–26,Algorithm 1,Table 7 |
| C Additional experiments | SuperGLUE、MLM 与混合层消融 | pp. 27–28,Tables 8–12 |
| D JRT-RNN implementation details | 状态合并、mask、IO-aware CUDA | pp. 29–30,Listings 1–2,Algorithm 2 |
| E Analysis;F Prompts | 失败模式、few-shot、实际提示 | pp. 31–39,Tables 13–14 |
| G Theoretical results | BaseConv 下界、SD 构造、GAR 归约 | pp. 40–53,尤其 G.15、G.22、G.25–G.29 |
| 训练配置表 | 各模型超参数与层组成 | pp. 54–56,Tables 15–18 |
一:动机——先知道任务,再压缩材料
1.1 困惑度相近,不代表能同样利用上下文
循环语言模型将历史压缩进固定大小的状态;Transformer 则可保留随长度增长的 KV cache。两者可能有接近的整体语言建模困惑度,但循环模型对罕见事实、长距离键值对应的召回更弱。作者举出的跨规模例子是:Table 1 中 Mamba 2.8B/300B 的常规提示平均分为 42.8,Transformer++ 1.3B/50B 为 47.8。这个例子说明困惑度和召回评测并不等价,但由于模型规模、训练量不同,它不是严格的单变量架构对照。〔Introduction,p. 1;Table 1,p. 6〕
1.2 教学例子:同一记忆预算,顺序改变任务
假设文档包含 1000 个人物事实,问题是“某人在何年搬到某地”。
- 输入为“文档 → 问题”时,读文档期间还不知道需要哪条事实。
- 输入为“问题 → 文档”时,可以围绕人物、地点和迁居年份保留信息。
- 输入为“文档 → 问题 → 文档 → 问题”时,第二次读取文档具备任务条件。
这是对作者动机的教学解释,不是“任意问答只需记住一个 token”的定理。真正的任务可能同时需要很多事实,模型也可能在两次出现之间忘掉问题。
作者的贡献是在已有选择机制、门控和扩大状态之外,加入一个维度:改变可用信息的时间顺序。重复不会增加文档事实,却改变了事实被压缩时可利用的条件。〔Secs. 1–3,pp. 2–5〕
二:方法——从集合不相交到前缀线性注意力
2.1 集合不相交问题与关联召回
集合不相交(set disjointness,SD)给定集合 $A,B$,判断 $A\cap B$ 是否为空。广义关联召回(general associative recall,GAR)给定一组键值对和尾部查询,为每个查询返回匹配的 value 或 Null。与 MQAR 不同,GAR 允许键与查询数量不同,且查询集中在末尾。〔Def. G.24,p. 51〕
GAR 至少与 SD 一样难:把 SD 的 $A$ 转成键值对 $(a,a)$,把 $B$ 转成查询;若所有查询都输出 Null,则两集合不相交。这个方向足以把 SD 的通信下界迁移到 GAR。〔Prop. G.25,p. 52〕
原文还声称在唯一匹配等条件下可以反向归约。应注意 Prop. G.26 的证明实际上使用了每次调用返回的整个交集 $Q\cap K_\ell$,而不只是“是否相交”的一位布尔答案。因此,严格讨论时要区分判定版 SD 与交集报告版;不能直接把它理解成仅用 $\lceil\log_2(c+1)\rceil$ 个布尔答案恢复任意多个查询的 value。这个表述问题不影响上一段采用的 SD → GAR 下界方向。〔本次分析,Prop. G.26,p. 52〕
2.2 为什么两遍可以减少所需状态
设 $k=\min(|A|,|B|)$,每个集合元素用 $n$ 位表示。单遍按 $A\to B$ 读取时,在最坏情况中,需要保留足够多的 $A$ 信息供后续查询。两遍输入为 $A_1,B_1,A_2,B_2$ 后,若 $B$ 较小,可以先存 $B_1$,再扫描 $A_2$;若 $A$ 较小,可以在第二遍存 $A_2$,再扫描 $B_2$。
在已知输入总长度、集合边界可辨认的构造里,这给出 $O(nk)$ 的存储上界。Thm. G.15/Algorithm 3 形式化了“找到较小集合,再与另一个集合比较”的算法。它是可实现性构造,不代表任意已经训练好的 RNN 都会自动学到这个算法。〔pp. 44–45〕
多遍也不能让容量限制消失。设 $p$ 是重复遍数、$S$ 是最大状态位数。Alice 持有键值部分,Bob 持有查询部分;每读完一部分就把状态发送给另一方,总通信量至多约 $2pS$。在相应困难输入分布下,SD 通信量至少为 $\Omega(k)$,所以
这是 Prop. 3.1 / G.29 的核心证明。$p=2$ 是常数,因此较小集合随输入增长时,所需状态仍随之增长。上界含元素位宽 $n$,下界按 bits 计数;它们不是无条件、逐常数匹配的结论。〔p. 5;Thm. G.27、Prop. G.29,pp. 52–53〕
2.3 Based 构造还依赖什么
作者进一步构造 BaseConv + MLP + 线性注意力 + MLP:先用输入相关的卷积重排集合,使较小集合在前;再用近似正交的特征映射判断成员关系。若不同元素的特征内积绝对值不超过 $\epsilon$,取 $\epsilon\le1/(3|A|)$,匹配和不匹配的累加分数就能由阈值分开。〔Prop. G.18,pp. 46–47〕
Thm. 3.2 / G.22 的 $O(nk)$ 上界要求输入相关的 IP kernel,并需要输入相关的 BaseConv。作者在 Remark G.23 给出不使用输入相关 IP kernel 的另一上界 $O(nk^2)$。因此,这不是对实验中固定二阶 Taylor 映射和训练优化过程的直接保证。〔p. 5 脚注 3–4;pp. 48–51〕
附录 G.1 还给出数据无关 BaseConv 的深度下界:在规定词表、编码维度和参数精度下,AR 仍需要 $\Omega(\epsilon\log\log N)$ 层;二进制 MQAR 有 $\log(2d)$ 层下界,$p$-hot 编码对应至少 $\lfloor\log(2p)\rfloor$ 层。这里最后一个 $p$ 是编码参数,不是重复遍数。证明利用层数对可表示多项式次数的限制,重复相同输入不会产生新的独立变量。这些是特定架构与编码假设下的结果,不能概括为所有门控循环模型都无收益。〔Thms. G.6、G.7、G.11,pp. 41–43〕
2.4 JRT-Prompt:抽象方法与实际模板
正文的抽象写法为
$\mathcal C$ 是上下文,$\mathcal Q$ 是问题,$\mathcal A$ 是现有自回归模型。操作发生在提示中,没有梯度更新。第二份上下文可以利用第一遍已经看到的信息。“看到所有顺序”是直觉表述,并非枚举 token 的所有排列。〔Sec. 3.2,p. 5〕
复现时应按附录 F 的真实模板理解。 其中问答任务的 Twice 模板通常为“原问题 → 文档 → 文档 → cloze 补全提示”;信息抽取任务则额外在开头放置属性说明。Default 通常为“文档 → cloze/属性补全提示”。因此,Table 1 测的是作者完整的 JRT 提示策略,同时改变了问题前置和文档重复,不能仅靠该表分离“纯重复”与“先给问题”的独立作用。〔App. F,pp. 34–39;本次分析〕
2.5 线性注意力为何能在固定状态中解码
为避免原文的转置记号混用,以下统一使用行向量:$\phi(q_i),\phi(k_i)\in\mathbb R^{1\times\tilde d}$,$v_i\in\mathbb R^{1\times d_v}$。核心符号如下。
| 符号 | 含义 |
|---|---|
| $N$ | 训练序列总长度,实验为 2048 |
| $M$ | 非因果前缀长度,实验为 1024 |
| $l$ | 推理时输入 prompt 的长度 |
| $k_{e_i},v_{e_i}$ | encoder 路径的 key/value |
| $k_{d_i},v_{d_i}$ | decoder 路径的 key/value |
| $\phi$、$\tilde d$ | 特征映射与展开后的特征维度 |
| $s_i\in\mathbb R^{\tilde d\times d_v}$ | 累积 KV 状态 |
| $z_i\in\mathbb R^{\tilde d\times1}$ | 用于归一化的 K 状态 |
普通因果线性注意力可重写为:
分母是标量,分子是输出向量。关键是先把 key 与 value 的外积加到状态中,不必为每个新 query 回头遍历所有旧 token。固定模型宽度和特征维度时,每步解码的时间与状态量都不随上下文长度增长;更明确地,每头的主要状态量为 $O(\tilde d d_v)$,每步也要进行相应矩阵运算。这里的 $O(1)$ 只针对序列长度,不等于零成本。〔Eqs. (1)–(2),p. 7〕
2.6 JRT-RNN:非因果前缀状态加因果累积状态
定义两条路径:
前缀线性注意力(prefix linear attention,PLA)的输出为
这对应原文 Eq. (3),本式修正了其分母 query 的排版笔误。encoder 使用完整的前 $M$ 个位置,所以前缀内部可以看见后方 token;decoder 路径仍是截至当前位置的累积和。前缀 token 会通过两套不同 K/V 投影被编码两次:一次进入非因果总和,一次进入因果累积和。这比“把注意力 mask 改成前缀双向”多了一项结构变化。〔Sec. 4.2,p. 7;App. A,p. 21〕
该结构不是两个独立 Transformer 堆栈之间的普通 cross-attention,而是在相同层中划分两种读取路径。$i>M$ 时,前缀总和已经固定,不含尚未生成的后缀;因此可以继续因果生成。
prefill 结束于 $M$ 时,把两条状态合并:
之后只用 decoder 的新 $k_d,v_d$ 增量更新状态,不再每步添加一次 $s_E$。若 $l>M$,则概念上缓存 $s_E+s_{D,l}$:前 $M$ 个 token 得到非因果处理,余下 prompt 仍按因果路径继续。论文的“非因果前缀”不意味着任意长度 prompt 的全部 token 都具有双向可见性。〔Eq. (4),p. 7;App. B,p. 24〕
2.7 实验中的完整模型、训练目标与推理边界
实验将 Based 的线性注意力层替换成 PLA,保留短门控卷积与滑动窗口注意力的混合框架。线性注意力使用二阶 Taylor 特征,内积形式为
在 16 维输入特征下,未经对称压缩的展开维度为 $1+16+16^2=273$。这解释了为什么数学上“线性”仍可能有很大的常数,以及为什么需要专门管理矩阵状态的存取。上式隐含相应的 query/key 缩放,不能当成对任意 dot product 都准确的指数近似。〔App. B,p. 23〕
训练使用 Pile,GPT-2 BPE tokenizer,同组模型看到相同数据顺序,$N=2048,M=1024$。后半段做下一 token 预测(NTP),前半段随机 mask 15% 的 token 并做掩码语言建模(MLM):
MLM 为非因果前缀提供直接监督;推理时不插入训练用的 [MASK]。原文使用 Adam、BF16、global batch 256、基础学习率 $8\times10^{-4}$、最小学习率 $8\times10^{-5}$、1% warmup、cosine decay、weight decay 0.1。训练硬件为 A100-80GB;这与效率测试的 H100 不同。〔Eq. (5),p. 8;App. B,pp. 22–24;Table 15,p. 54〕
参数规模是近似分组:JRT 的小模型配置表写 356M。正文称保持 Based 的层类型与顺序,Table 15 的窗口大小却写 64/16,而 Table 16 的 Based 为 128;Table 15 的 26 总层数也与列出的 $5+5+17$ 不吻合。因此不应把配置视为已经完全核实的“只替换一个模块”实验,精确复现还需对照正式代码与 checkpoint。〔本次核对,Tables 15–16,pp. 54–55〕
推理策略有三种:短于 $M$ 时左填充到 $M$ 并在 PLA 中 mask 填充;用重复上下文替代部分填充;或者每生成一个 token 后重新非因果编码已有文本。第三种 iterative encoding 更昂贵,不能把常规递归解码的速度优势直接套在它身上。〔Table 4,Sec. 5.1,pp. 9–10〕
2.8 IO-aware 实现具体节省在哪里
作者从 Based 自定义 CUDA 内核出发,先累积 encoder 的 KV 状态,再把这一状态作为 decoder 扫描的初始寄存器状态。二阶 Taylor 的零阶、一阶、二阶项由不同寄存器片段保存,尽量避免把大中间状态反复写到 GPU 高带宽显存。〔Algorithm 2,p. 30〕
它增加了前缀的计算和投影,但最终解码可把状态相加,因而不必持有两份长期递归 KV 状态。论文报告 JRT-RNN prefill 约为优化 Based 的 1.24 倍耗时,JRT-Prompt 则按两倍 Based 成本计入。是否快于 softmax attention 同时取决于长度和实现;朴素 PyTorch PLA 本身并不快。〔Sec. 5.3,Table 5,pp. 11–12〕
三:实验——先把比较口径对齐
3.1 合成任务检验的是顺序敏感性
合成实验构造两个集合,保证它们只有一个相交 token,并要求模型输出该 token。它不是直接评测“相交/不相交”的二分类,所有样本也不包括无交集的均衡二分类设置。这样训练是为了避免模型停留在猜测二分类的行为。〔Sec. 3.1,p. 4;Algorithm 1,p. 22〕
Based 模型为四层,交替使用短卷积和线性注意力;非因果版本把累积和换成总和,并使用非因果循环卷积。扫宽度 $\{36,48,64,96,128\}$ 和线性注意力特征维度 $\{4,8,16,24\}$,以改变状态大小。词表大小为 2048,学习率扫三档;Fig. 2 说明每个配置报告跨学习率和两个随机种子的最大分,而不是均值与标准差。〔App. B.1,pp. 22–23;Fig. 2,p. 4〕
附录列出 12 个训练长度组合,每组 20000 条,最大单侧长度为 256;评测包括单侧长达 768 的组合,每组 1000 条。正文粗略称集合长度在 1–1024,精确复现应优先使用附录显式列表。
3.2 下游任务与指标
| 数据集 | 所测能力 | 评测样本数 | 原文报告的平均文档 token 数 |
|---|---|---|---|
| FDA | 从设备报告抽取属性 | 1102 | 1999.9 |
| SWDE | 从网页抽取电影、大学相关属性 | 1111 | 1036.1 |
| NQ | 根据文档回答搜索问题 | 3157 | 8857.7 |
| SQuADv2 变体 | 文档问答 | 2984 | 151.9 |
| TriviaQA | 文档支持的知识问答 | 1698 | 310.1 |
| DROP | 涉及段落信息及离散推理的问答 | 2084 | 236.6 |
来源:App. B.5、Table 7,pp. 24–26。这些样本经过论文的格式转换与筛选,不是直接搬用每个任务的完整官方测试集。
作者用 Llama-3-70B 将问题和答案改写成“答案位于句末”的陈述,再删去末尾答案,得到 cloze 补全提示。指标是模型输出是否包含指定的准确答案 span,越高越好;不是要求整段输出与标准答案完全相同,也不是默认的官方 EM/F1。生成遇到换行或达到 48 个 token 就停止。长文档截断时确保答案 span 仍在输入内。〔App. B,pp. 23、25–26〕
3.3 三组实验不能混为一组
| 实验 | 对照和协议 | 解释范围 |
|---|---|---|
| Table 1:JRT-Prompt | 现有模型;常规提示最多约 1k,重复后最多约 2k;相同文档信息 | 验证提示策略,不是等输入长度/等计算比较 |
| Table 2:JRT-RNN | 同组预训练数据与顺序;约 360M/30B、1.3B/10B、1.3B/50B | 比较完整训练与推理方案,含混合层及填充选择 |
| Table 5:效率 | H100;20 次平均;扫长度或 batch;FA2、Based 各种实现与 JRT | 内核 prefill 延迟,不能推导所有模型的生成速度 |
Table 1 包含不同训练语料的模型:GLA 用 100B SlimPajama,其余相应模型用 Pile。因此最清晰的效果是每一行“同一个模型换提示”前后比较;跨行比较还混合规模、语料和训练量差异。Table 2 的平均分是 FDA/SWDE/NQ 各两个长度,加三个 Full 任务,合计九列的算术平均;它不是六个数据集等权平均。〔Tables 1–2,pp. 6、9〕
四:结果——收益成立,但每条证据有自己的边界
4.1 顺序敏感性:非因果读取更稳定
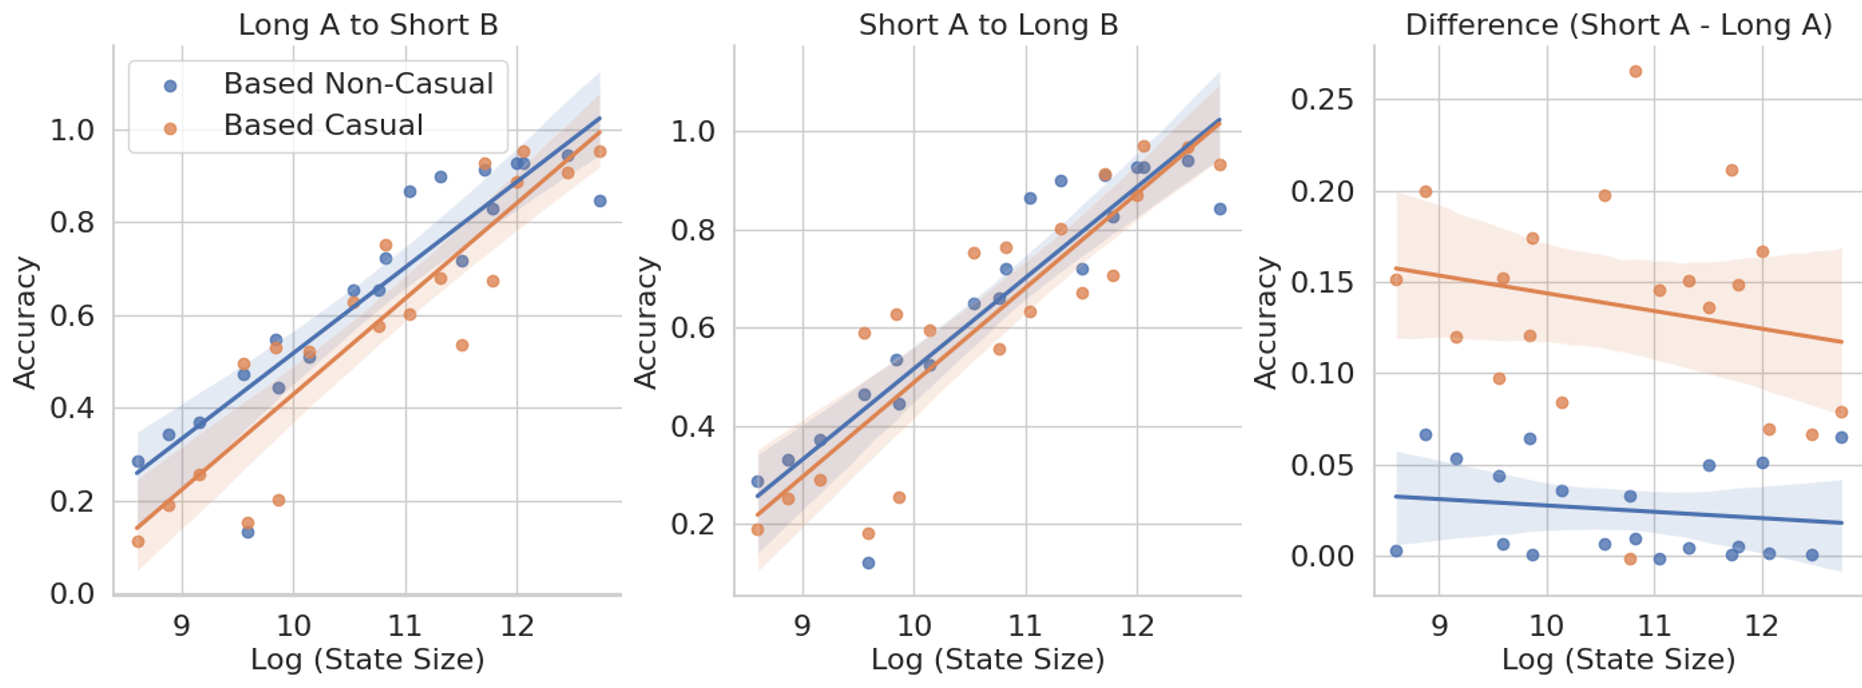
原图 2,p. 4。横轴实际标为 Log(State Size),状态原始单位为 bytes;左、中面板纵轴为 accuracy,右面板为“较小的 $A$ 在前”减去“较大的 $A$ 在前”的准确率差。蓝色为非因果 Based,橙色为因果 Based。
读取顺序为:先看左图,困难顺序下非因果模型总体较好;再看中图,两者在有利顺序下更接近;最后看右图,因果模型的顺序差异更大,小状态时尤其明显。证据支持“信息顺序影响有限记忆的有效使用”,并不证明全部自然语言召回差距都由顺序造成。图中点是择优结果,趋势线不能当作多次训练的置信区间来解释。
4.2 JRT-Prompt:多种现成模型均能受益
下表为 Table 1 的部分行,分数是六项任务的平均准确率,差值由表中已四舍五入的平均分相减。
| 模型/参数/训练 token | Default | JRT-Prompt | 增加百分点 |
|---|---|---|---|
| Transformer++ 1.3B/50B | 47.8 | 57.8 | 10.0 |
| Mamba 1.3B/50B | 34.7 | 46.5 | 11.8 |
| Based 1.3B/50B | 40.3 | 51.8 | 11.5 |
| GLA 1.3B/100B | 36.7 | 48.9 | 12.2 |
| GLA 2.7B/100B | 39.2 | 50.0 | 10.8 |
| Mamba 2.8B/300B | 42.8 | 52.6 | 9.8 |
| Mamba-2 1.3B/300B | 46.7 | 55.6 | 8.9 |
| Mamba-2 2.7B/300B | 48.9 | 58.8 | 9.9 |
来源:Sec. 3.2,Table 1,p. 6。
Based + JRT 在 1.3B/50B 时超过 Transformer 的常规提示分数,但仍低于 Transformer 自己使用 JRT 的 57.8。因此更准确的结论是“提示策略改善循环模型,并在部分比较中超过常规提示的 Transformer”,不能说“循环架构因此普遍优于 Transformer”。个别任务也会下降,例如 Mamba 2.8B 的 TriviaQA 从 66.2 降到 63.9。
对摘要 $11.0\pm1.3$ 的核对。 论文称其为 16 个 recurrent LMs 的结果,但 Table 1 实际列出 16 行模型配置,其中 2 行为 Transformer++,14 行为循环模型。按每行六项分数重算,全部 16 行平均提升约 11.04 个百分点,只算 14 行循环模型则约 11.28 个百分点;全部 16 行的跨配置总体标准差约 1.27。这个计算与摘要数值接近,但原文未清楚定义“±”的统计口径,故不能将其当成置信区间或多随机种子误差。〔本次核对;可追溯数据在 build/numeric-audit.json〕
4.3 JRT-RNN 主结果:平均差距收窄
| 参数/训练 token | Transformer | Mamba | Based | JRT-RNN | JRT − Based |
|---|---|---|---|---|---|
| 约 360M/30B | 43.4 | 24.0 | 29.2 | 42.9 | +13.7 |
| 约 1.3B/10B | 43.9 | 25.2 | 33.7 | 42.0 | +8.3 |
| 约 1.3B/50B | 51.4 | 36.8 | 42.6 | 49.5 | +6.9 |
来源:Sec. 5.1,Table 2,p. 9。每格为九个评测列的平均分,越高越好。
“99% 和 96% 的 Transformer quality”分别对应 $42.9/43.4\approx98.85\%$ 与 $49.5/51.4\approx96.30\%$,是该套平均分的比值,不是 99% 的正确率,也不是通用能力等价。
逐项看,1.3B/50B 的 JRT-RNN 在 SQuAD 上为 50.4,超过 Transformer 的 40.1;FDA-1024 则为 67.7,明显低于 Transformer 的 83.5,SWDE-1024 也为 45.7 对 56.0。平均接近掩盖了不同任务与长度上的差距。相对 Based,1.3B/50B 九列中八列改善,TriviaQA 由 54.3 降到 53.0。
4.4 2k 输入:可以外推部分收益,但未消除长输入差距
| 1.3B/50B,2k 文档 | FDA | SWDE | NQ |
|---|---|---|---|
| Transformer | 79.7 | 55.5 | 30.2 |
| Mamba | 21.0 | 29.9 | 23.1 |
| Based | 36.1 | 37.7 | 23.4 |
| JRT-RNN | 55.2 | 41.4 | 26.2 |
来源:Table 3,p. 9。JRT 超过两个循环基线,却仍低于 Transformer,尤其 FDA 还有 24.5 个百分点差距。这里的 extrapolation 是超过 1024 的 encoder 区域;约 2k 的输入并未超出 2048 的预训练总序列长度,不能称为已经验证的任意长上下文外推。
Table 3 的小模型行明确标 360M/10B,与主表的 360M/30B 不同;不要把两组数直接连成“同一模型随长度变化”的曲线。
4.5 填充策略是主要质量结果的一部分
| 设置,512-token 文档 | FDA | SWDE | NQ |
|---|---|---|---|
| 360M/30B,Left-pad | 61.9 | 38.1 | 24.6 |
| 360M/30B,Read-2× | 82.0 | 43.3 | 32.9 |
| 360M/30B,Iterate | 76.3 | 40.7 | 29.2 |
| 1.3B/50B,Left-pad | 75.8 | 49.3 | 30.9 |
| 1.3B/50B,Read-2× | 86.7 | 49.4 | 38.3 |
| 1.3B/50B,Iterate | 80.2 | 43.3 | 34.2 |
来源:Table 4,p. 9。主表采用 Read-2× 的三列。小模型 FDA 的 20.1 个百分点提升来自填充策略改变,这个幅度不能被“只是实现细节”略过。更贵的逐步重新编码也没有在这三个条件中胜过 Read-2×,所以“更多非因果计算”并非单调更好。
4.6 困惑度切片:上下文召回与参数知识有取舍
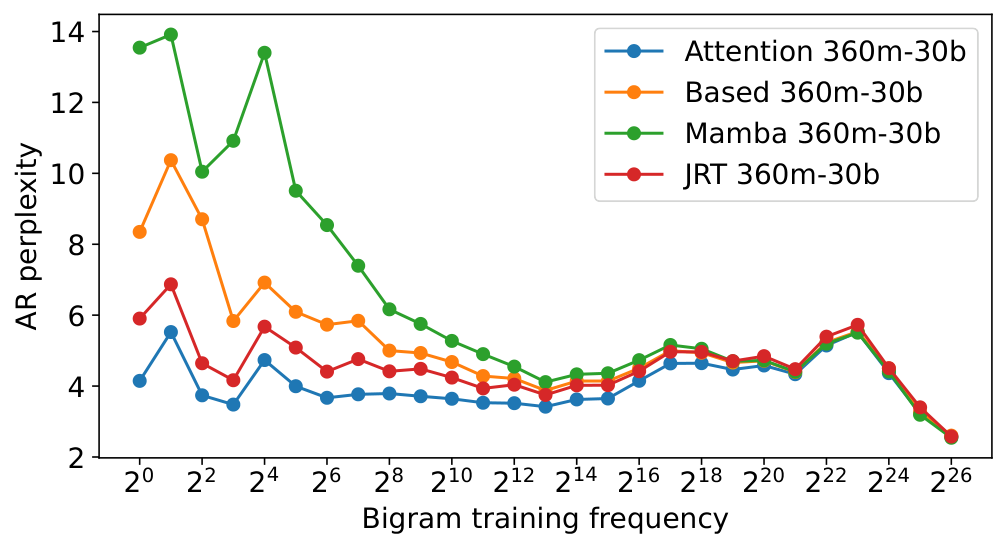
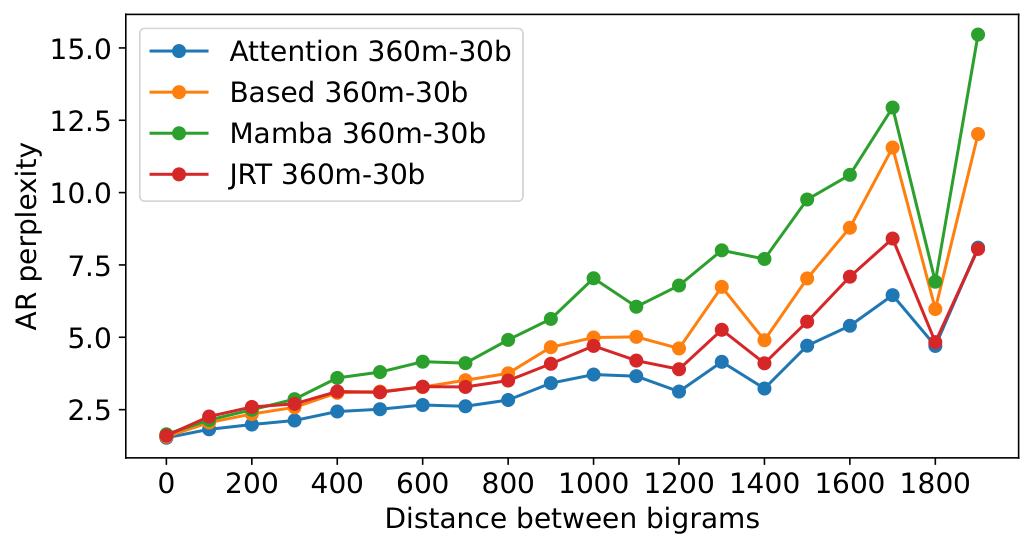
来源:Fig. 3,p. 10,使用作者原始矢量图渲染。两图纵轴为 AR perplexity,越低越好;颜色分别代表 Transformer、Based、Mamba、JRT。左上原面板按训练 bigram 频次切分,右上原面板按同一 bigram 两次出现的间距切分。JRT 在低频、长间距的召回 token 上总体优于两个循环基线,但 Transformer 在不少区域仍较低。
评测使用 3200 条长度 2048 的 Pile 测试序列,只计算最后 1024 个位置的困惑度,约 3.3M 个目标 token。训练频次来自 10M 条 Pile 训练文档。频次图限制重复间距至少 1024;间距图限制训练出现次数少于 1000。这个协议是比较重叠的因果后缀,不在可以偷看目标的前缀上做普通 NTP 困惑度比较。〔App. B.4,p. 24〕
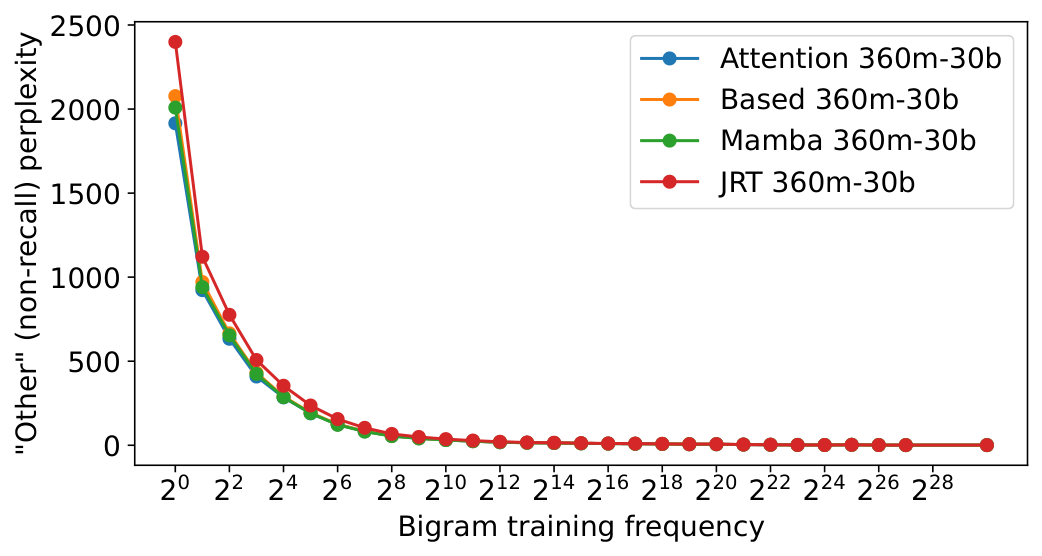
Fig. 3 下方,p. 10。纵轴为 Other perplexity;低频、非召回 token 上 JRT 较差。作者解释为 NTP 监督更少,参数知识学习不足,并猜测更大规模或更长训练可缓解。前者是实验观察,后者是解释与展望;“Other”也只是启发式切片,不是对纯参数知识的严格隔离。
训练监督数量存在一个算术问题:论文 Sec. 5.2 写 JRT 对 65% 的训练 token 计算 loss,但按 $M=N/2$、前缀 mask 比例 15% 计算,被监督位置比例应为
这是按原文所述目标位置计数的推导,不等于有效训练 FLOPs,也不能直接乘上 loss 权重解释质量变化。源码未提供足以消除“65%”差异的另一种计数定义,本笔记保留该不一致。〔本次核对,pp. 8、10、54〕
4.7 一般语言理解与消融
SuperGLUE 用 LM-Eval Harness 默认设置评测,作者认为总体相近。Table 8 的 360M/30B 五样本平均分为:JRT 45.3、Based 48.1、Transformer 45.3、Mamba 45.5;零样本时 JRT 为 39.6,而 Transformer 为 42.0、Mamba 为 43.7。因此可以说 JRT 保留了相近量级的通用任务能力,但“没有任何退化”并不成立。Table 9 的 1.3B 结果没有列出 ReCoRD,与 Table 8 口径不同;文中没有给出充分误差统计以证明等效。〔App. C.1,Table 8–9,p. 27〕
Table 10 报告去掉左填充 mask 后部分任务下降。但该表首行与 Table 8 的 JRT 行、以及其所列 Avg 不一致,不能直接据此计算一个精确可靠的整体损失。定性的实现启示仍清楚:短输入里的大量填充 token 必须正确屏蔽,避免进入线性注意力状态。
消融主要回答两个问题:
- 仅做 prefix LM、不加 MLM 是否足够? Table 11 的 360M/10B 无 MLM 模型在 FDA-512 为 38.7,低于 Based 的 51.0;在 FDA-1024 为 39.2,高于 Based 的 30.1。说明朴素前缀处理在短、长输入上的行为不同。但该表没有同训练预算的完整 JRT + MLM 行,不能单靠此表严格量化 MLM 的净贡献。〔p. 28〕
- 收益是否只存在于默认的混合架构? Table 12 的 360M/30B 纯 LA 与 prefix LA,在 FDA-1024 为 16.0 → 48.7;LA + 滑窗与 prefix LA + 滑窗为 8.1 → 46.5。前缀方案在这些变体中也有收益;但纯 prefix LA 的 FDA-2048 仅 8.2,说明局部结构和整体架构仍很重要。〔p. 28〕
这些实验未穷举投影共享、prefix 长度、mask 比例、训练算力等全部变量,也没有给出完整的独立 K/V 权重消融。
4.8 效率:优势出现在优化后的长序列 prefill
| H100,batch 16,延迟 ms ↓ | 2048 | 8192 | 16384 | 32768 |
|---|---|---|---|---|
| FlashAttention-2 | 0.5 | 6.8 | 26.6 | 107.8 |
| Based Triton (FLA) | 1.0 | 9.3 | 32.6 | 123.7 |
| Based Custom CUDA | 0.3 | 1.2 | 2.3 | 4.5 |
| JRT-Prompt Custom CUDA | 0.6 | 2.3 | 4.5 | 9.0 |
| JRT-RNN Custom CUDA | 0.4 | 1.5 | 2.8 | 5.6 |
来源:Table 5 上半部分,p. 11;20 次运行平均。JRT-Prompt 的长度成本按原始输入的两倍处理,并使用两倍 Based prefill 耗时。它并没有比“不重复的 Based”更快;其比较优势是相对于二次注意力,以及质量改善后的代价。
几个边界决定如何引用这个结果:
- 32768 时,论文报告 JRT-Prompt / JRT-RNN 相对 FA2 吞吐约 11.9× / 19.2×;从已舍入的延迟求比值约为 12.0× / 19.25×,属相同量级,不能要求末位严格一致。
- 2048 时,JRT-Prompt 的 0.6 ms 反而比 FA2 的 0.5 ms 慢;加速并非所有长度成立。
- 固定长度 16384、batch 64 时,JRT-RNN 11.1 ms 对 FA2 108.2 ms,约 9.7×;JRT-Prompt 17.8 ms,约 6.1×。这是另一组条件。
- 优势依赖自定义 CUDA;例如 JRT-RNN PyTorch 在 2048 时为 21.3 ms,在 8192 已 OOM。
- 报告对象是序列混合/注意力 prefill 实现,没有提供完整模型端到端吞吐、TTFT、能耗或所有头维度/编码长度等基准细节。现有表格不足以证明任意服务部署都获得 19.2× 加速。
4.9 错误分析与相邻方案
JRT-Prompt 可以减少“没有回看输入而生成无关续写”的错误,也可能增强重复倾向。Table 13 中 Mamba 2.8B 在 SQuAD 的无关输出占全体测试样本比例从 51.3% 降到 13.8%,重复错误却从 5.5% 升到 32.9%。原文的“通常增加不作答和重复”不能概括所有数据集:FDA、SWDE 的多项重复错误反而下降,应按任务读表。〔App. E,pp. 31–32〕
Table 14 的 two-shot 比较中,JRT 在 FDA 和 SQuAD 经常更有效,但 SWDE 的 Mamba 2.8B two-shot 为 51.9,高于 JRT 的 48.9。提示示例可能帮助理解任务,也可能让模型误提取示例中的答案;结果不支持“重读总能替代 few-shot”。〔p. 33〕
附录 A 的 CEPE 7B 小样本比较只用 50 个随机例子:encoder-decoder 模式 SWDE/FDA 为 51.0/5.9,而忽略 encoder、把完整提示送入 decoder 为 80.4/72.5。它说明某个现有 encoder-decoder checkpoint 的使用方式可能不适合这些任务,不足以否定所有 T5 式架构。〔Table 6,p. 21〕
五:结论——应保留的贡献与不能扩大的结论
5.1 可靠贡献
第一,论文把“记忆选择难不难”与“选择时知道多少任务信息”联系起来,并用合成实验和通信复杂度说明顺序的作用。第二,JRT-Prompt 在多个现成模型上提供了一种无需训练的改进方案。第三,JRT-RNN 展示了非因果前缀编码、因果线性状态与混合训练目标可以组合,在所测中小模型上明显改善召回,同时保持有效的递归解码形式。
最值得借鉴的设计原则是:在固定记忆预算下,可以增加材料的读取次数,或者让压缩过程更早获得任务条件。 这增加计算,却可能比无限扩大常驻记忆更划算;是否划算需要同时看质量、内核实现和真实端到端开销。
5.2 主要限制
- 两遍读取不突破信息容量下界;查询数量和需要保留的信息很多时仍可能失败。
- 提示实验混合了问题前置、重复和格式变化;主架构结果混合了训练目标、层配置与 Read-2× 推理。
- 训练到约 1.3B、50B token 的 JRT 原型,不等于已经验证大规模指令模型或开放式长输出场景。
- 质量测试主要是短上下文与约 2k 输入,32k 是内核速度测试;不能把二者拼成“32k 保持 99% 质量且快 19.2×”。
- “相近通用能力”有具体任务退化,并且下游结果大多没有置信区间或多训练种子统计。
- 源码和 PDF 存在记号、配置与统计口径不一致,复现需逐项固定版本和运行配置。
5.3 原文校核提示
为便于复读,将影响理解的差异集中列在这里;下文不是对所有源码的完整审计。
| 位置 | 原文问题 | 本笔记采用的解释 |
|---|---|---|
| Eq. (1)–(3),p. 7 | 分母转置、$s$ 的维度、$\phi(v_{q_i})$ 等记号混用 | 统一行向量,$s\in\mathbb R^{\tilde d\times d_v}$,分母使用同一 query |
| App. B,p. 23 | 第一条 Taylor 展开把二阶项写成 $x/2!$ | 下一公式明确是平方项,采用 $1+x+x^2/2$ |
| 摘要、Table 1,pp. 1、6 | “16 个循环模型”与表中两行 Transformer 不符 | 保留作者报告并分别重算 16 行与 14 行循环模型 |
| Sec. 5.2,pp. 10–11 | 监督位置写 65%;重叠区域写 non-causal;图面板引用错位 | 按定义推导 57.5%;评测因果后缀;以 Fig. 3 坐标与图注为准 |
| Tables 8–10,p. 27 | 表 10 基准行/平均数与表 8 不一致 | 不据此计算精确整体消融提升;不跨规模直接比较不同列的 Avg |
| Tables 15–16,pp. 54–55 | 窗口长度、层数合计与正文简述不同 | 参数按近似分组;精确复现配置仍待代码核验 |
| Prop. G.26,p. 52 | 从 SD 到 GAR 的证明使用了完整交集 | 区分判定 oracle 与交集报告 oracle,不把反向归约说成无条件等价 |
此外,G.3.2(p. 47)的输入相关 kernel 对 $A$ 内元素使用 one-hot,对 $A$ 外元素使用二进制编码;其声称的“所有不同元素全局正交”对两个 $A$ 外元素未必成立。不过相关成员匹配只需比较候选元素与存储的 $A$,这部分仍可正交。应把原文构造理解为集合相关匹配工具,不应把该式直接当成通用 IP-kernel 的完整证明。〔本次分析〕
5.4 值得进一步检验的问题
一个直接后续实验是固定同一模型、同一文档、同一预算,对比“文档→问题”“问题→文档”“文档→问题→文档→问题”和附录真实模板,分离重复、问题前置和格式的作用。另一个是匹配有效监督数量与训练 FLOPs,再比较独立 K/V、MLM 和非因果前缀各自的贡献。部署层面则需要同时测完整模型的 TTFT、生成吞吐、常驻状态和长输入质量;这些是后续工作建议,不是论文已经完成的验证。
资料与复现入口
- 版本固定的 arXiv 论文、本地 PDF、作者 TeX。
- 论文给出的官方代码仓库:本次未拉取或运行,不保证当前默认分支与 v1 实验完全一致。
- 原图来源清单:图 1、2 直接复制作者图件;图 3 的 PNG 由作者 PDF 图件渲染,未修改数据。
- 可编辑幻灯片与编译脚本(本地核验附件)。在本目录执行
python3 build_slides.py slides.en.tex,使用本机pdflatex编译。