Learning to (Learn at Test Time): RNNs with Expressive Hidden States:中文精读笔记
- 作者:Yu Sun、Xinhao Li、Karan Dalal、Jiarui Xu、Arjun Vikram、Genghan Zhang、Yann Dubois、Xinlei Chen、Xiaolong Wang、Sanmi Koyejo、Tatsunori Hashimoto、Carlos Guestrin。
- 版本:arXiv:2407.04620v4,修订于 2025-08-31;首版发表于 2024-07-05。作者明确说明:所有实验均在首版完成,当前版本更新相关工作与局限。
- 获取与研读日期:2026-09-21(Asia/Shanghai;归档获取时间为 2026-09-20 UTC)。本次成品修订:r1。
- 原始材料:原文 PDF、同版本作者 TeX(
arxiv.tex,实际引用的notations.tex、code.tex,以及figs/图件)。已阅读正文 §1–5、附录 A–C 与图 14–16;参考文献用作定位,未逐篇研读被引论文,也未运行作者训练代码。 - 定位约定:以下页码均为 PDF 从 1 开始的页码,与本文印刷页码一致,共 33 页。公式编号仅在核实后标注。图件取自作者源码,来源清单见 figures/sources.json。本文是分析,不是全文翻译或独立复现实验报告。
论文总览
一句话要点:把 RNN 的隐藏状态变成一个小模型的权重,用学习到的自监督任务更新它,使“记住上下文”成为序列内部的学习过程。
这篇论文提供的是一种构造序列建模层的框架。每个 token 到来时,小模型先根据当前 token 的特征做梯度更新,再生成输出;整套过程属于大语言模型的前向传播。外层训练仍做下一个 token 预测,但它同时学习内层重建任务的输入视图、目标视图、查询视图、初始化与学习率。
作者给出 TTT-Linear 与 TTT-MLP 两种实例,并用 token mini-batch 和对偶形式提高硬件效率。实验覆盖约 125M–1.3B 参数、最长 32k 上下文。在报告的长上下文语言建模条件下,TTT 比 Mamba 更能继续利用序列后部的上下文;但 TTT-MLP 的内存 I/O 与实际延迟仍是主要问题。该论文没有证明它在任意任务、模型规模或硬件上都优于 Transformer。
结构地图
| 原文结构 | 核心作用 | PDF 页码与主要证据 |
|---|---|---|
| §1 Introduction | 固定状态压缩与长上下文困境;贡献边界 | pp. 2–3,图 2 |
| §2.1 TTT as updating a hidden state | 状态是模型,更新是学习 | p. 4,式 (1)–(3) |
| §2.2 Training a network with TTT layers | 内外循环与可微训练 | p. 5;图 5 位于 p. 6 |
| §2.3 Learning a self-supervised task for TTT | 学习三种视图 | pp. 5–6,式 (4)–(5) |
| §2.4 Parallelization with mini-batch TTT | 并行梯度与因果前缀 | p. 7,图 6;图 7 位于 p. 8 |
| §2.5 Dual form | 将逐 token 外积改写为矩阵运算 | pp. 8–9,式 (7)–(8) |
| §2.6 Theoretical equivalences | 线性注意力与核回归解释 | pp. 9–11,定理 1–2,图 8–9 |
| §2.7 Implementation details | LN、残差、初始化、学习率与骨干 | pp. 11–12,表 1;图 13 位于 p. 29 |
| §3 Experiments;§3.1 Short context: the Pile | 训练协议和 2k/8k 比较 | pp. 12–14,图 10 |
| §3.2 Long context: Books | 1k–32k、长上下文微调对照 | pp. 14–15,图 11、图 2 右 |
| §3.3 Wall-clock time | TPU 训练与 GPU 推理时间 | pp. 15–16,图 12 |
| §4 Related Work | TTT、Fast Weights、现代 RNN、元学习 | pp. 16–18,表 2 |
| §5 Discussion | 扩展方向与未验证范围 | p. 18 |
| Appendix A Dual Form | 非线性 MLP 的对偶推导 | pp. 26–27 |
| Appendix B Nadaraya-Watson estimator | 核回归推导及非对称核 | p. 28 |
| Appendix C Experiment details | 架构、优化、匹配预算与 checkpoint | pp. 29–30,表 3 |
| 附录补充图 14–16 | 各层重建损失与完整 Books 结果 | pp. 31–33 |
一:动机——序列记忆应当怎样压缩?
自注意力把历史信息保存在不断增长的 KV cache 中。生成第 $t$ 个位置的表示时,它需要查询先前的键和值;固定模型宽度下,单步计算随 $t$ 增长,整段计算为二次量级。RNN 则用固定大小状态压缩历史,单步成本不随上下文长度增长,但状态更新规则必须决定保留什么、遗忘什么。
作者借用参数学习的经验:模型权重本来就能压缩训练数据,为什么不能把当前序列视作一个小型训练集?于是,原先手工指定的状态转换,被替换成一个显式学习问题的优化步骤。这里“更有表达力”指可选更丰富的隐藏模型及其更新机制,不意味着有限状态能够无损保存无限历史。
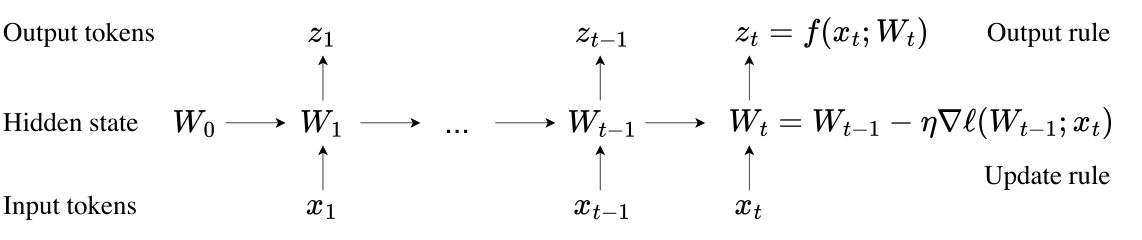
来源:原图 1,PDF p. 1。沿时间方向读:输入 $x_t$ 进入损失,梯度更新隐藏权重,再由更新后的模型产生 $z_t$。图中的梯度运算本身属于序列层的前向传播。
创新定位需要按 v4 的表述理解。 线性矩阵状态、快速权重(Fast Weights)以及以梯度更新状态都已有先例;原文 §4.1–4.2 承认早期 Fast Weight Programmer 已探索 MLP 快速权重,DeltaNet 也与特定 TTT-Linear 形式等价。本文较可靠的贡献,是把显式内层学习问题、可学习任务与高效执行组织成可扩展到神经网络状态的框架,并给出语言建模实证。
二:方法——两个嵌套的学习循环
2.1 输入、状态和输出
以下采用列向量,给出单个头的简化维度,便于理解;完整网络还有多头、投影与骨干结构。
| 符号 | 含义 | 维度或性质 |
|---|---|---|
| $x_t$ | 第 $t$ 个位置输入该层的连续表示 | $\mathbb R^D$,不是离散 token ID |
| $k_t=\theta_Kx_t$ | 内层训练视图 | $\mathbb R^d$ |
| $v_t=\theta_Vx_t$ | 内层重建目标/标签视图 | $\mathbb R^d$ |
| $q_t=\theta_Qx_t$ | 生成输出的测试/查询视图 | $\mathbb R^d$ |
| $W_t$ | 当前序列的快速权重,即隐藏状态 | 线性核心为 $d\times d$;MLP 为多组权重 |
| $\theta$ | 外层学习的慢参数 | 跨序列共享,常规推理时固定 |
| $\ell$ | 内层自监督重建损失 | 不是语言建模交叉熵 |
| $b$ | 内层 token mini-batch 大小 | 主实验取 16;不是训练序列 batch size |
原文先给出朴素的在线梯度更新(§2.1,p. 4),随后引入学习到的视图(§2.3,式 (4)–(5),pp. 5–6):
直觉上,$k_t$ 告诉模型“凭什么学习”,$v_t$ 告诉它“要记住什么”,$q_t$ 告诉它“现在问什么”。三个投影由外层任务共同优化,因此内层的“有用记忆”不是由人工完整规定的。
2.2 为什么测试时还能训练?会不会泄漏答案?
测试时更新的是每条序列内部的 $W_t$,其监督信号来自已经读到的 $x_t$,不需要未来 token 标签。$z_t$ 可以用于预测下一个 token,所以先吸收当前 token 再输出符合自回归因果性。不同序列从共享的 $W_0$ 开始,后续快速权重各自演化;本文不把跨用户、跨请求持续积累记忆作为已验证机制。
外层仍最小化标准 next-token loss。它通过展开后的 TTT 更新反向传播,优化 $\theta_K,\theta_V,\theta_Q$、其他网络参数,以及实际实现中的 $\theta_{\mathrm{init}}=W_0$ 和 $\theta_{\mathrm{lr}}$。这意味着训练会对内层梯度运算继续求导,概念上涉及“梯度的梯度”。常规推理不再做外层反传,但仍进行内层更新。
| 方面 | 内层 | 外层 |
|---|---|---|
| 数据单位 | token 表示 | 序列 |
| 学习数据 | 当前序列前缀 | 序列数据集 |
| 目标 | 学习到的多视图重建 | 下一个 token 预测 |
| 更新对象 | 当前序列的 $W$ | 共享的 $\theta$ |
| 测试时 | 继续执行 | 固定 |
对应原文表 2,p. 18。这也是标题中“Learning to (Learn at Test Time)”的两层含义。
2.3 TTT-Linear 与 TTT-MLP 的实际定义
原文 §2.7(pp. 11–12)并不直接把裸线性层当最终实现,而是使用:
TTT-Linear 的核心为 $f_{\mathrm{res}}(x)=Wx$;TTT-MLP 的核心为两层 MLP,中间宽度为输入的 4 倍,采用 GELU。LN 与残差用于稳定内层训练,因此不能把后续所有实验结果都归给最简单的线性更新公式。
学习率依赖输入:
TTT-Linear 的 $\eta_{\mathrm{base}}=1$,TTT-MLP 为 0.1;sigmoid 因子可看作控制写入强度的门。附录 C 说明搜索过 $\{0.01,0.1,1,10\}$,取不会引起不稳定的最大值;MLP 内层使用前 10% 步数的线性 warmup。
TTT 默认放入受 Mamba 启发、带时间卷积和门控的骨干。图 13(p. 29)还显示,Mamba 骨干版本共享 K/Q 的初始投影,以容纳额外门控参数,之后分别经过时间卷积。一般三视图解释与具体骨干的参数共享应区分开。图中 (T)、(M) 指骨干,不是说 TTT 层内部又含了一个 Mamba 状态空间层。
2.4 Mini-batch TTT:允许梯度使用块起点,但输出保持因果
在线 GD 的计算依赖很强:每次求梯度都需要最新状态。另一极端是整条序列所有梯度都在 $W_0$ 处求值;这样高度并行,但缺少逐步调整学习方向的能力。
作者折中为每 $b$ 个 token 共用一个求梯度的状态。为消除边界歧义,用一基 token 编号定义当前块起点:
上式用常数 $\eta$ 解释机制;输入相关学习率可放进对应的求和项。块内梯度可并行计算,输出只使用截至自身位置的前缀和;下一个块再以更新后的末状态为起点。$b=1$ 为在线 GD,$b=T$ 为全文单块 GD。主实验选 $b=16$。
原文记号提醒:§2.4 p. 7 写作 $t'=t-\operatorname{mod}(t,b)$,又将其描述为“前一个 mini-batch 的末位置”。按 $t=1,\ldots,T$ 直接实现时,在 $t=b$ 等位置存在边界不一致;上面用 $b\lfloor(t-1)/b\rfloor$ 明确表达正文和图 6 的意图。这是本笔记的索引澄清。
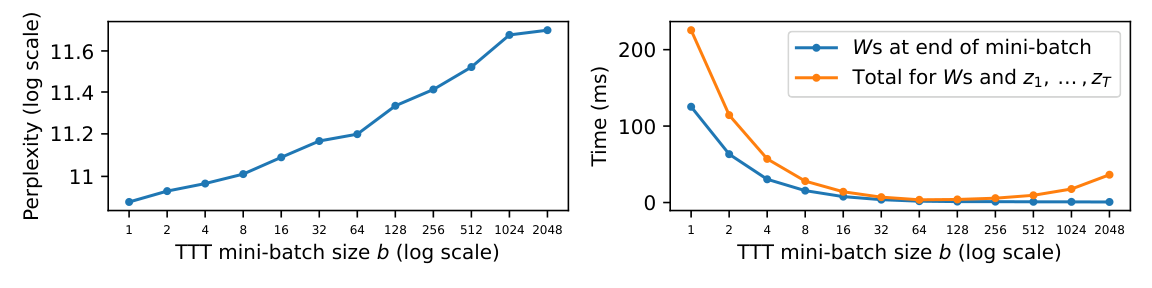
来源:原图 7,p. 8。左图横轴为 $b$、纵轴为困惑度(越低越好);较小 $b$ 在测试范围内更好,$b=16$ 对应 11.09。右图为 $T=2048$ 的 forward 时间:蓝线只计块末权重,橙线还包括所有输出。较大块先提高并行度,但块内输出的额外计算最终推高总时间。右图使用 TTT-Linear 1.3B 的单层、纯 PyTorch 实现,不能当作最终融合 kernel 的完整网络性能。
2.5 对偶形式:数学等价,执行方式不同
只做梯度并行仍会显式产生 $b$ 个 $d\times d$ 梯度矩阵和许多中间权重,导致大量内存读写。对偶形式只保留下一块需要的 $W_b$,直接求出当前块所有输出。
为看清机制,先按 §2.5 的简化设定取三视图为恒等映射、$f(x)=Wx$,只考虑第一块。令 $X=[x_1,\ldots,x_b]\in\mathbb R^{d\times b}$,$E=W_0X-X$,则:
这里保留上三角及对角线。因为 token 放在矩阵的列中,$(s,t)$ 表示源 token $s$ 对输出 $t$ 的贡献,因果条件是 $s\leq t$。不能机械套用常见行向量布局下的下三角掩码。
展开第 $t$ 列:
它与同一个 mini-batch 更新规则的 primal 形式等价;不意味着 $b=16$ 与在线 GD 的轨迹相同。前者是代数改写,后者改变了梯度求值点。
每块 primal 计算为 $O(bd^2)$;dual 保留该项,并增加输出计算的 $O(b^2d)$。总长 $T$ 下,对应 $O(Td^2+Tbd)$,固定 $b,d$ 时对 $T$ 为线性。多做一些运算换来矩阵乘法与更少 I/O,作者报告其 JAX/TPU 训练实现相对 primal 快超过 5 倍(p. 9);这不是相对 Transformer 或 Mamba 的 5 倍加速。
附录 A(pp. 26–27)将该推导推广到多层非线性网络。每层先在块起点做普通前向/反向,取得训练视图激活 $\hat X^k$ 和预激活梯度 $D^k=\nabla_{Z^k}l$,再计算:
这里按附录取 $\eta=1$、损失带 $1/2$,故没有主文平方损失的系数 2。带横杠的是更新后权重对应的查询路径,并按层顺序计算。归一化等非逐元素函数可以用 VJP 处理,但对偶形式不会自动加速它们内部的操作。
2.6 两个等价性结果究竟说明什么?
定理 1:线性注意力是特定 TTT 实例。 条件是裸线性模型、$W_0=0$、整条序列 batch GD、$\eta=1/2$,以及平方重建损失。于是(§2.6,p. 10):
这正是去掉 softmax 的基本线性注意力。原文脚注特别说明,其等价对象未包括原始线性注意力方案的归一化器与特征展开。最终 TTT-Linear 加了 LN、残差、可学习初始化和 mini-batch,不能继续简单称为同一个公式。
定理 2:自注意力可解释为非参数核回归。 Nadaraya–Watson 估计器对历史标签做归一化加权平均。把历史 key 与当前 query 的权重定义为 $\exp(k_s^\top q_t)$,就得到:
这是非参数 learner:它保存并查询不断增长的历史数据,因此仍具有注意力的存储与计算代价。此结论统一了概念,没有把精确 softmax attention 转成固定大小状态的线性时间算法。
记号核对:原文式 (9)–(10)(p. 10)对核的两个参数及 K/Q 的排列有不一致风险。若将式 (9) 的第一个参数理解为查询、第二个参数理解为历史样本,式 (10) 的投影顺序与常用 $k_s^\top q_t$ 相反;本笔记明确按“历史 key、当前 query”的配对写出上式,不机械照搬含混的参数次序。附录 B 的非对称核讨论也不能替代这个方向核对。
2.7 一个教学例子:状态如何改写记忆
以下是本次分析构造的标量示意,非论文实验。取 $f(k;w)=wk$、$\ell=(wk-v)^2$、$\eta=1/2$。第一次看到 $(k,v)=(1,2)$,$w_0=0$,在线更新后 $w_1=2$。第二次看到 $(1,3)$,梯度为 $2(2-3)=-2$,所以 $w_2=3$。同一个 key 对应的新证据改写了预测。
若两次梯度都在 $w_0=0$ 求值,则第二个梯度为 $-6$,前缀累积后 $w_2=5$。这解释了在线/mini-batch 更新中的误差反馈与简单累积关联的区别,也提示记忆干扰仍然存在:固定参数模型不保证精确保留彼此冲突的每一条事实。
三:实验——比较对象与统计口径
3.1 数据、模型与预算
| 项目 | 报告配置 | 定位 |
|---|---|---|
| 短上下文 | Pile,2k、8k | §3.1,图 10,p. 13 |
| 长上下文 | Books3(Pile 子集),1k、2k、4k、8k、16k、32k | §3.2;图 15,p. 32 |
| TTT/Transformer 参数规模 | 125M、350M、760M、1.3B | §3,p. 12 |
| Mamba 对应规模 | 130M、370M、790M、1.4B | 同上;不是严格等参数 |
| Transformer baseline | Llama 风格,RoPE、SwiGLU、RMSNorm | 附录 C,p. 29 |
| 默认 TTT 骨干 | Mamba 风格;另做 Transformer 骨干消融 | §2.7、图 13 |
| Tokenizer | 统一使用 Llama tokenizer | §3 脚注;附录 C |
| 外层 batch | 每批 0.5M tokens,不随上下文长度变化 | §3.2 脚注,p. 14 |
| 内层 batch | 主配置为 16 tokens;图 7 单独消融 | §2.4、图 7 |
训练采用论文从 Mamba 工作沿用的 Chinchilla 风格配方,不能据此宣称每一种架构、数据集与上下文长度都已被单独搜索到计算最优。
表 3(p. 30)的精确配置如下;不适用于结构不同的 Mamba:
| 参数量 | Blocks | 表示维度 | Heads | 外层训练步数 | 峰值 LR | 训练 tokens |
|---|---|---|---|---|---|---|
| 125M | 12 | 768 | 12 | 4,800 | 0.003 | 2.5B |
| 350M | 24 | 1,024 | 16 | 13,500 | 0.0015 | 7B |
| 760M | 24 | 1,536 | 16 | 29,000 | 0.00125 | 15B |
| 1.3B | 24 | 2,048 | 32 | 50,000 | 0.001 | 26B |
优化器为 AdamW,$\beta=(0.9,0.95)$,权重衰减 0.1,梯度裁剪 1.0,前 10% 步数 warmup,余弦衰减到 $10^{-5}$,无 dropout,混合精度。长 Books 实验从 4k 起还比较 RoPE 基数 10,000 与 500,000,并为 Transformer 选择更好的结果。
3.2 指标与三种“公平比较”
困惑度(perplexity,PPL)衡量预测不确定性,越低越好。常规定义是 $\exp(\text{平均负对数似然})$;图中 PPL 与 FLOPs 常用对数坐标。不要把 PPL 降低称为“准确率提高”。
- 相近参数量:各模型点对应相近规模,但 TTT-MLP 的每步算力开销不同。
- 训练 FLOPs:图 10–11、15 画 PPL 对训练 FLOPs 的折线;在同一横坐标比较的是计算效率,不能把同参数量的不同点当作已匹配算力。
- 实际延迟:图 12 依赖硬件、kernel、batch size 和 prefill/decode 阶段。FLOPs 更少不保证延迟更低。
论文未在主要结果中提供多随机种子误差条或显著性检验。正文对 8k 优势使用较强措辞,但图 2 的新版 caption 用“similar”;本笔记据曲线与实验设置描述趋势,不把差距写成已通过统计显著性检验的结论。
3.3 长上下文 Transformer baseline 的补强
TF finetune 从 Books 2k 模型开始,用额外 20% tokens 在目标长上下文微调。从 4k 起报告该方案;峰值学习率搜索 $10^{-5},10^{-4},10^{-3}$。125M 的最佳值为 $10^{-4}$,350M 及以上为 $10^{-5}$(附录 C,p. 30)。
图 2 右另做专门的匹配训练 FLOPs实验:以 Mamba 1.4B 为基准;Transformer 用 TF finetune 并改成 19 个 blocks,TTT-Linear 与 TTT-MLP 的外层 MLP 隐藏维度分别调整为 5808、5248。这里不是照搬表 3 的所有结构。该 Transformer 的推理 FLOPs 仍为对照的 2.8 倍,所以训练预算匹配不等于推理预算匹配。
四:结果——证据支持到哪一步?
4.1 内层学习确实在改变状态
图 4(p. 5)比较初始化状态、更新前状态、更新后状态的重建损失。一次内层更新降低当前重建损失,历史更新也让状态优于初始状态。但这只是机制证据,不等价于证明每步 next-token loss 都下降。
附录图 14(p. 31)补全 12 层:中间部分层的三个损失会随位置一起上升,作者解释为输入范数上升;更新状态与初始化之间的差距仍扩大。因此不能概括为“所有层重建损失随时间单调下降”。图 14 使用 125M、Pile、$T=2048$,对应 $b=1$ 在线 GD 的诊断,不应冒充所有主实验 $b=16$ 的逐层结果。
4.2 消融:关键增益来自更新方式和稳定化设计
以下精确复现表 1(p. 11)的数字。所有行 125M,按 Pile 短上下文配方训练;这是顺序累加消融。
| 配置 | PPL ↓ | 相对上一行的绝对变化 |
|---|---|---|
| 原始线性注意力 | 15.91 | — |
| 改进线性注意力 | 15.23 | −0.68 |
| 等价 TTT 形式 | 15.23 | 0 |
| 加可学习 $W_0$ | 15.27 | +0.04 |
| 加 LN 与残差 | 14.05 | −1.22 |
| 改为 mini-batch TTT | 12.35 | −1.70 |
| 加可学习 $\eta$ | 11.99 | −0.36 |
| 换 Mamba 骨干 | 11.09 | −0.90 |
最大单步改进来自 $b=T=2048\to16$,其次是 LN 与残差。$W_0$ 单独看稍微变差,但作者报告后续配置缺少它会训练不稳。顺序实验只能说明该路径上的边际变化,不能把每一行当作独立因果效应。
从改进线性注意力 15.23 到最终 11.09,PPL 绝对降低 4.14;本笔记计算的相对降幅约为 27.2%。它涵盖多个组件与骨干变化,不能全部归因于 mini-batch,也不是准确率提高 27.2 个百分点。
4.3 §3.1:Pile 2k 与 8k
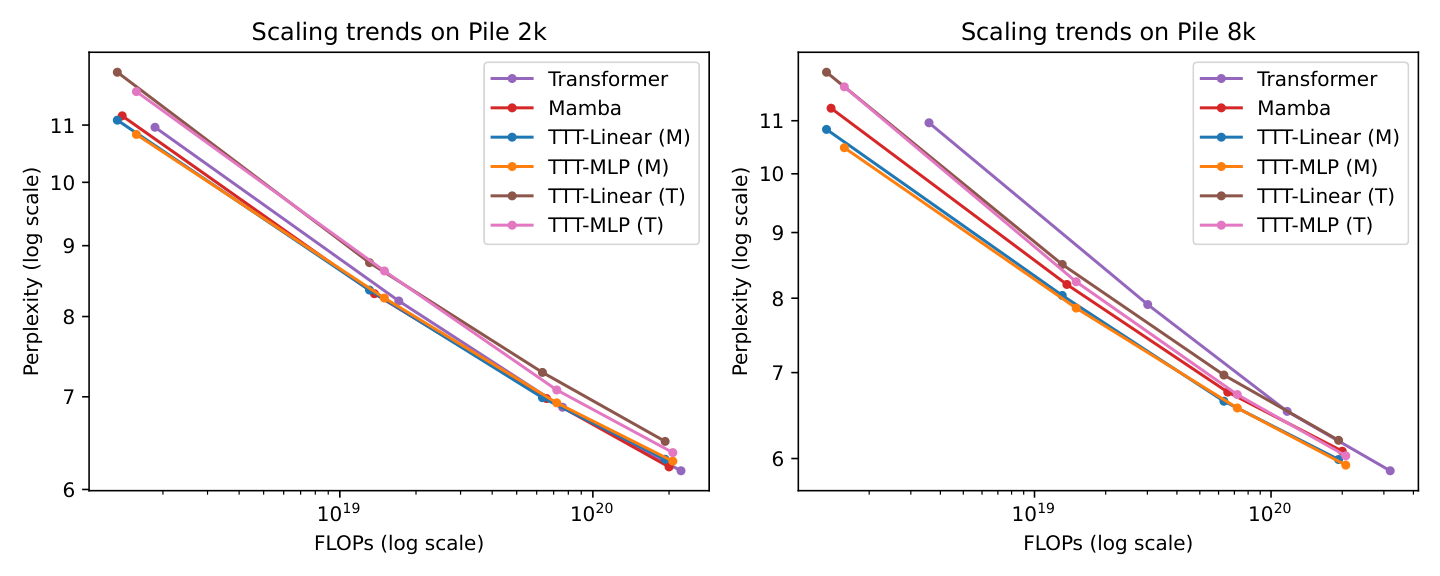
来源:原图 10,p. 13。左为 2k、右为 8k;横轴训练 FLOPs、纵轴 PPL,均为对数尺度。图例中的 (M)/(T) 是不同骨干。每条线连接四个规模。
- 2k:TTT-Linear (M)、Mamba 与 Transformer 大体接近。TTT-MLP 虽在同参数规模上有较好 PPL,其额外算力开销抵消部分收益,高 FLOPs 区间的曲线不占优。
- 8k:TTT 的 FLOPs–PPL 权衡相对 Mamba 改善。Transformer 在相同参数规模可有很好 PPL,但训练 FLOPs 更高,不能把其曲线右移误读成单纯“预测更差”。
- 骨干消融:Mamba 骨干总体更有利于 TTT;在 Transformer 骨干中 MLP 相对 Linear 的收益更明显。作者解释为时间卷积对较弱状态的补偿更大,这是合理假说,尚不是直接隔离卷积因素的机制证明。
- 缩放规律:这些点没有干净的 log-log 线性拟合,作者只连点,不给可靠外推的 scaling law。
4.4 §3.2:Books 与两种不同的长上下文问题
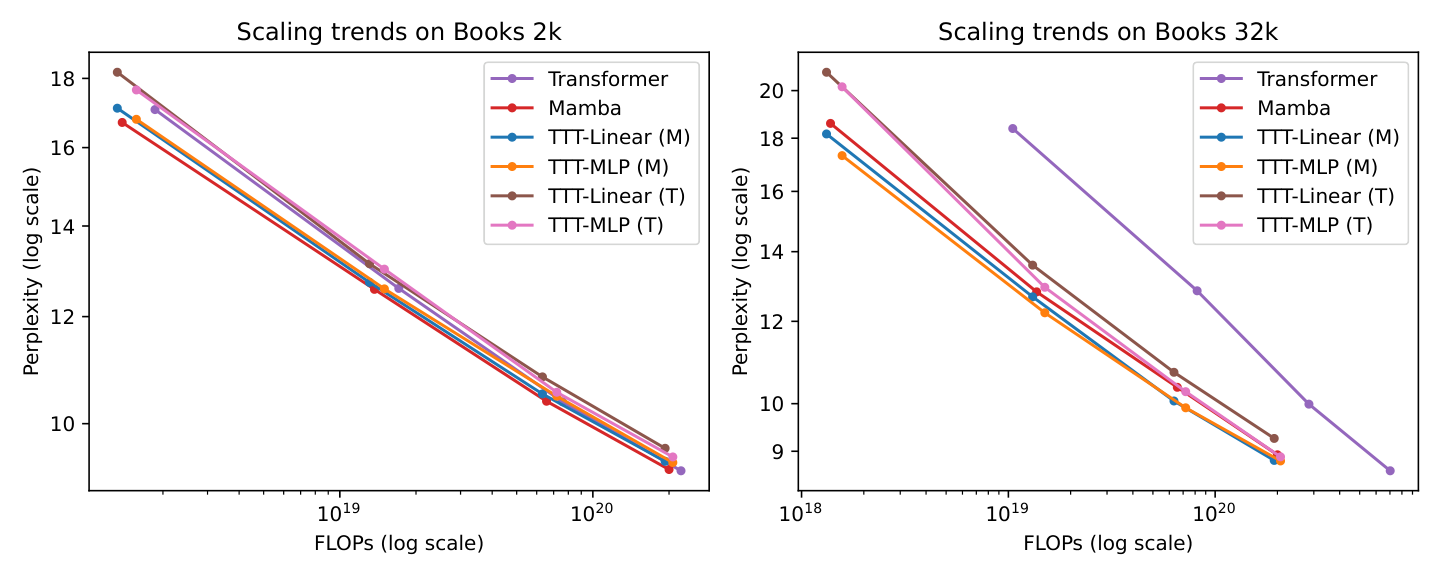
来源:原图 11,p. 14。轴与图例沿用 Pile 图。Books 2k 下 Mamba 略优于 TTT-Linear 的计算权衡;32k 下 TTT-Linear (M)、TTT-MLP (M) 均改善对 Mamba 的权衡,TTT-MLP (T) 也表现出潜力。此图的 Transformer 曲线不能代替附录中的 TF finetune 对照。
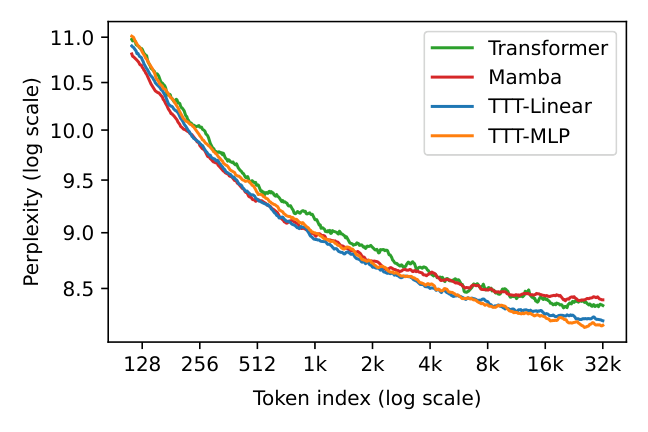
来源:原图 2 右,p. 2;匹配配置在附录 C,p. 30。横轴是 token 位置(对数尺度),纵轴是对应位置上跨测试序列平均的困惑度。Mamba 在约 16k 后趋于平台;TTT 两种实例与 Transformer 仍可继续下降。TTT-MLP 相对 Linear 在短前缀不占优,在长前缀更有优势。这支持“更丰富状态有助于使用额外上下文”,但不是精确检索、推理能力或无限记忆的直接测量。
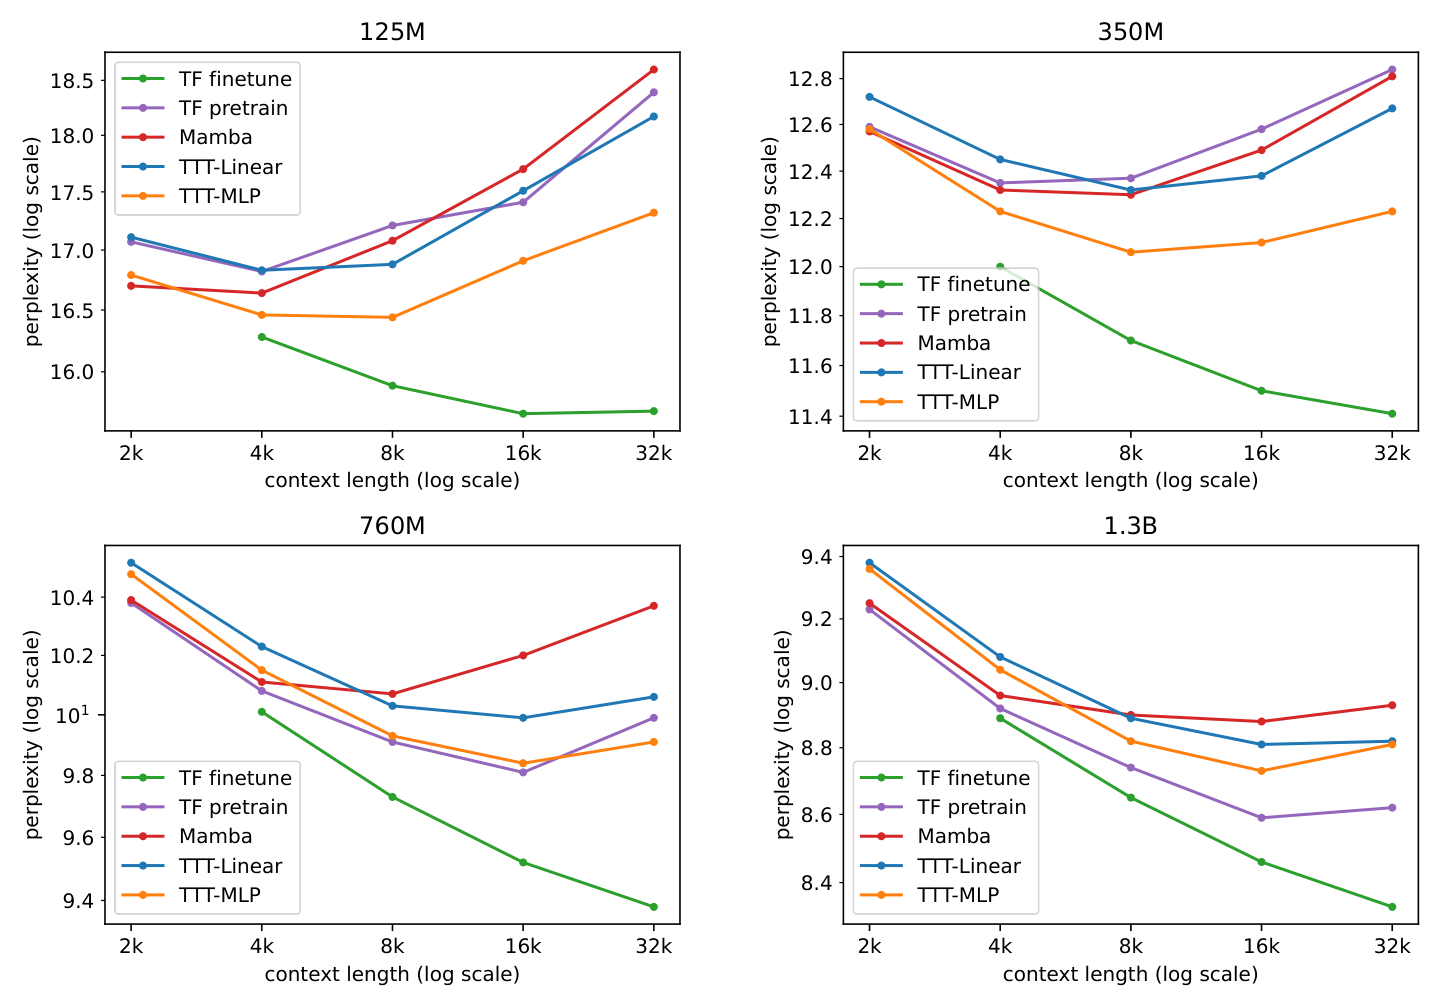
来源:原图 16,p. 33。四个面板是四种规模,横轴改成了不同模型的训练/评估上下文长度,不是固定模型内的位置。固定配方与规模下,从头训练的各类模型在上下文过长后 PPL 会变差;更大模型的最佳长度总体更长。TF finetune 大多没有这种反转,但它使用额外训练 tokens。
两个结论并不矛盾:模型可以在某条 32k 序列内部继续利用新信息,同时“把所有训练都改成 32k”在既定预算下并非最优。附录图 15(p. 32)给出 1k–32k 全部 FLOPs–PPL 曲线,显示长上下文微调显著改善 Transformer 对照;讨论长期优势时必须保留它。
4.5 §3.3:实际运行时间
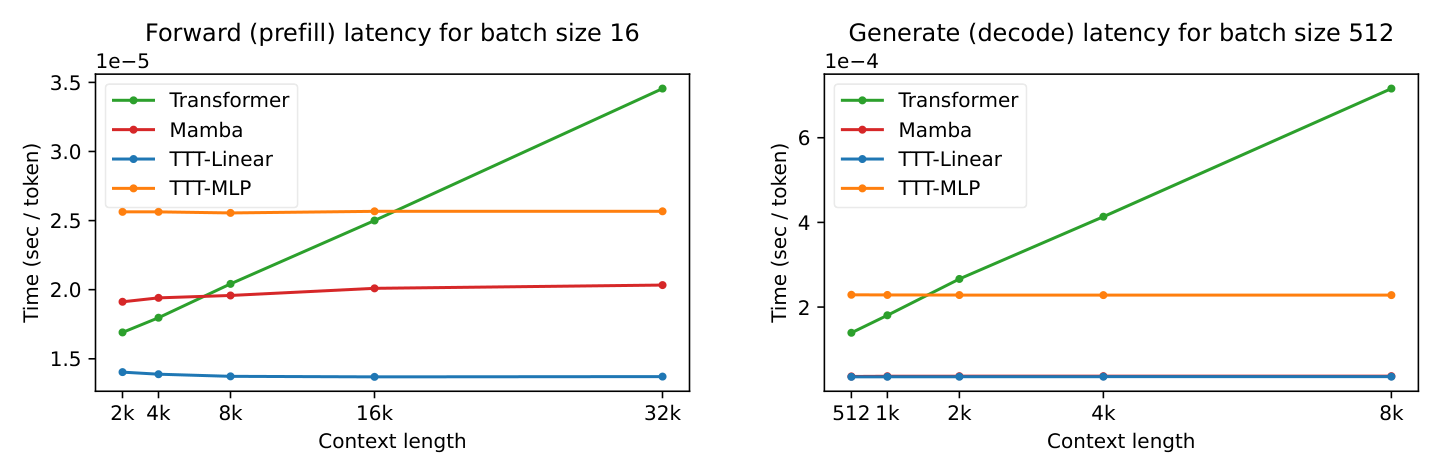
来源:原图 12,p. 15。NVIDIA A100、80GB HBM、PCIe;TTT/Transformer 为 1.3B,Mamba 为 1.4B。左图 prefill 的 batch size 为 16,右图 decode 为 512,不能跨左右面板直接比“哪个阶段更快”。纵轴单位是 sec/token,左图标度为 $10^{-5}$,右图为 $10^{-4}$。
图中 TTT-Linear 的 prefill 较快,decode 与 Mamba 曲线接近;TTT-MLP 明显更慢。Transformer 随上下文增长,其每 token 时间上升。作者使用 vLLM 构建 Transformer 推理对照,比 Mamba 原论文采用的 HuggingFace 实现更强。本笔记不从折线像素估计精确倍数。
另一个独立结果来自 TPU:在 v5e-256、2k 上下文训练时,Transformer 为 0.30 s/iteration,TTT-Linear 为 0.27 s/iteration,即单步延迟降低 10%。它不是 A100 测试,也不是对 Mamba 的训练加速。作者仅实现了用于该 GPU 比较的推理 kernel,不能据此推断完整 GPU 训练优势。
训练/prefill 可用 dual form,逐 token decode 用 primal form。固定大小推理状态也不意味着训练内存与序列长无关:反传仍需处理中间状态;附录 C 通过时间方向的 gradient checkpointing 节省内存。
五:结论——如何理解与使用这篇论文
最扎实的贡献有三层。 第一,显式自监督学习可以作为 RNN 的状态更新规则,而任务本身由外层训练学得;第二,mini-batch 与对偶形式让这一视角有了可训练的语言模型实例;第三,报告的 Books/Pile 实验展示了长上下文下相对 Mamba 的潜力,并揭示表达能力、算力和实际速度之间的取舍。
主要边界:
- 规模上限约 1.3B,训练上下文最长 32k;百万 token、超大模型与视频/具身智能属于展望。
- 核心指标是语言建模 PPL,未提供足以证明广泛推理、精确召回或下游任务优越性的基准。
- TTT-MLP 的 FLOPs 效率无法自动转化为真实运行速度,非线性状态的内存 I/O 仍待解决。
- v4 讨论了后续 Mamba 2、Gated DeltaNet 等,但没有新增相应实验。比较结论只覆盖实际测试的基线与配置。
- 固定容量状态依然有压缩与干扰问题;同一序列的快速权重更新不等于永久更新整个大模型。
- 缺少主要结果的多种子误差条;骨干与超参数搜索预算也未被完全独立控制,不宜外推细小差距。
本次分析建议的后续验证问题(未由论文完成):
- 在同等硬件延迟预算下,MLP 状态比线性状态多得到多少长程建模收益?
- 状态学习能否在真实检索任务中保持罕见但重要的事实,而不仅是降低平均 PPL?
- 若引入更强遗忘/优化机制,能否同时减少干扰和保持块并行?
- 给 Transformer 同等长上下文微调机会、给各 RNN 同等系统优化机会后,优劣区间如何变化?
组会讨论时最值得强调的是:TTT 重新定义了“状态是什么、如何更新”,而这项设计的价值必须同时用建模质量和执行成本来检验。
原始材料与复核入口
- 版本固定的 arXiv 页面、本地原文、作者主 TeX。
- 英文汇报 PDF、可编辑 Beamer TeX、构建脚本(本地核验附件)。
- 论文列出的实现:JAX、PyTorch。本次仅记录原文链接,未审阅仓库或执行实验。