Samba:以选择性状态与局部注意力构建长上下文语言模型
论文:Samba: Simple Hybrid State Space Models for Efficient Unlimited Context Language Modeling
作者:Liliang Ren、Yang Liu、Yadong Lu、Yelong Shen、Chen Liang、Weizhu Chen(Microsoft / UIUC)
版本:arXiv:2406.07522v3,2025-02-28 修订;ICLR 2025 会议论文
研读与获取日期:2026-10-16
材料:arXiv 页面 · 本地原文 PDF · 英文汇报 PDF · 可编辑 TeX · 作者代码入口
论文总览
Samba 要解决的问题是:能否用随序列长度线性增长的计算,把循环模型的长程信息压缩与注意力的精确读取结合起来,同时保持有竞争力的语言建模质量?它采用非常直接的层间混合:重复堆叠 Mamba → MLP → 滑动窗口注意力(SWA)→ MLP。Mamba 将过去压进固定大小的状态,SWA 保留最近 2,048 个位置的显式 KV,两个 MLP 分别变换两种信息混合器的输出。
论文的主要价值在于给出跨规模的实验证据,而非提出新的 SSM 更新公式。在相同数据与配方的 3.8B 对照中,Samba 基座模型的七项平均分从 TFM++ 的 60.1 提升到 64.2,GSM8K 从 51.5 提升到 69.6。约 1.7B 的模型在 4K 长度训练后,Proof-Pile 困惑度可以改善到 1M 上下文;128K 提示处理和 64K 生成分别报告相对 Llama-3 架构的 3.73×、3.64× 吞吐。(Table 7,PDF p.20;Fig.2、Fig.6,PDF pp.7–8、21。)
理解标题中的“unlimited context”需要区分三件事:流式计算可以持续、长输入上的语言预测可以稳定、任意旧信息可以被精确找回。Samba 在前两项上给出有力结果,第三项依赖任务训练与记忆负载。256K Passkey 的完美召回来自专门微调;这一能力没有自动迁移到多条目 Phonebook 检索,后者即使专门微调,准确率仍随条目数量增加而下降。(Sec.3.4,PDF pp.8–9。)
结构地图
以下页码均从 PDF 第一页起计数,与本版本印刷页码一致。
| 原文章节 | 论证作用 | 位置与关键证据 |
|---|---|---|
| 1 Introduction | 注意力与 SSM 的互补动机 | pp.1–2 |
| 2 Methodology / 2.1 Architecture | 层间组合、Mamba、SWA、MLP | pp.2–4;Fig.1;Eq.(1)–(2) |
| 3.1 Language Modeling on Textbook Quality Data | Phi 数据上的规模化与架构对照 | pp.4–5;Tables 1–2 |
| 3.2 Exploration on Hybridizing Attention and Linear Recurrence | SlimPajama 上的模块替换、困惑度、训练速度 | pp.5–7;Tables 3–4 |
| 3.3 Efficient Length Extrapolation | 百万长度预测与推理吞吐 | pp.7–8;Fig.2 |
| 3.4 Long-Context Understanding | Passkey、Phonebook 与跨任务迁移 | pp.8–9;Figs.3–4 |
| 4 Analysis | 全注意力、头数配置、模块分工 | pp.9–10;Tables 5–6;Fig.5 |
| 5 Conclusion | 汇总架构与效率结论 | p.10 |
| A Related Works | 混合循环架构、稀疏注意力、长度外推定位 | pp.19–20 |
| B Additional Evaluation Results | 3.8B 基座与 June 后训练结果、预填充吞吐 | pp.20–21;Tables 7–8;Fig.6 |
| C Additional Experiment Details | Passkey 的训练与评测协议 | p.22;训练曲线 Figs.7–8 位于 pp.21–22 |
| D Additional Analyses | 训练长度/批大小、短卷积 | pp.22–23;Tables 9–10 |
| E / F Details of Entropy Measurement / Downstream Long-context Evaluation | 熵定义、长文摘要评测 | p.23 |
| G Implementation Details | 四个规模与各基线的配置 | p.24;Tables 11–12 |
| H Limitations & Broader Impact | 基座检索与固定混合比例的不足 | p.25 |
一:动机——让不同形式的记忆承担不同工作
1.1 全注意力、局部注意力和循环状态各有什么代价
全注意力把历史 token 的 KV 显式保留下来,当前 query 可以直接访问任意位置。代价是预填充中的成对注意力计算随长度平方增长,自回归生成时 KV 缓存及每步读取量随历史长度增长。
选择性状态空间模型(Selective State Space Model),如 Mamba,则把整段历史递推地压进固定维度的状态。其流式推理没有不断扩大的历史缓存,但“形成有用的历史摘要”和“在许多无关内容后准确复述某个任意字符串”是不同要求。后者需要细粒度信息在压缩中保留下来,且不能与其他记忆严重干扰。
SWA 为每个位置提供一个固定宽度的注意力窗口,显式保存近期细节,成本随输入长度线性增长。单层只能直接读取窗口内的位置;多层堆叠能间接扩大感受野,因此不能简单把整个 SWA 模型的可用上下文硬性等同于 2K。Samba 在此之外增加循环状态通路,使远处信息能随时间向前传播。(Sec.1–2,PDF pp.1–4。)
1.2 贡献放在什么位置
作者把 Mamba 理解为循环序列结构的建模器,把 SWA 理解为精确信息读取器,把 MLP 理解为非线性变换与参数化知识的载体。这是设计出发点;后文的熵分析提供了支持“模块专业化”的观测。
SSM 与注意力混合本身已有先例。按论文 Appendix A 的定位,Griffin 同样交替使用循环层与 SWA,但循环单元是 RG-LRU;H3、Jamba 等包含全注意力;Mega 类方法更强调层内结合。Samba 的重点是 Mamba、SWA、独立 MLP 的层间配比,以及在短任务质量、实际吞吐、长度外推三个维度上共同验证它。(Appendix A,PDF pp.19–20。)
二:方法——逐层数据流与固定大小的长期状态
2.1 一个重复单元如何工作
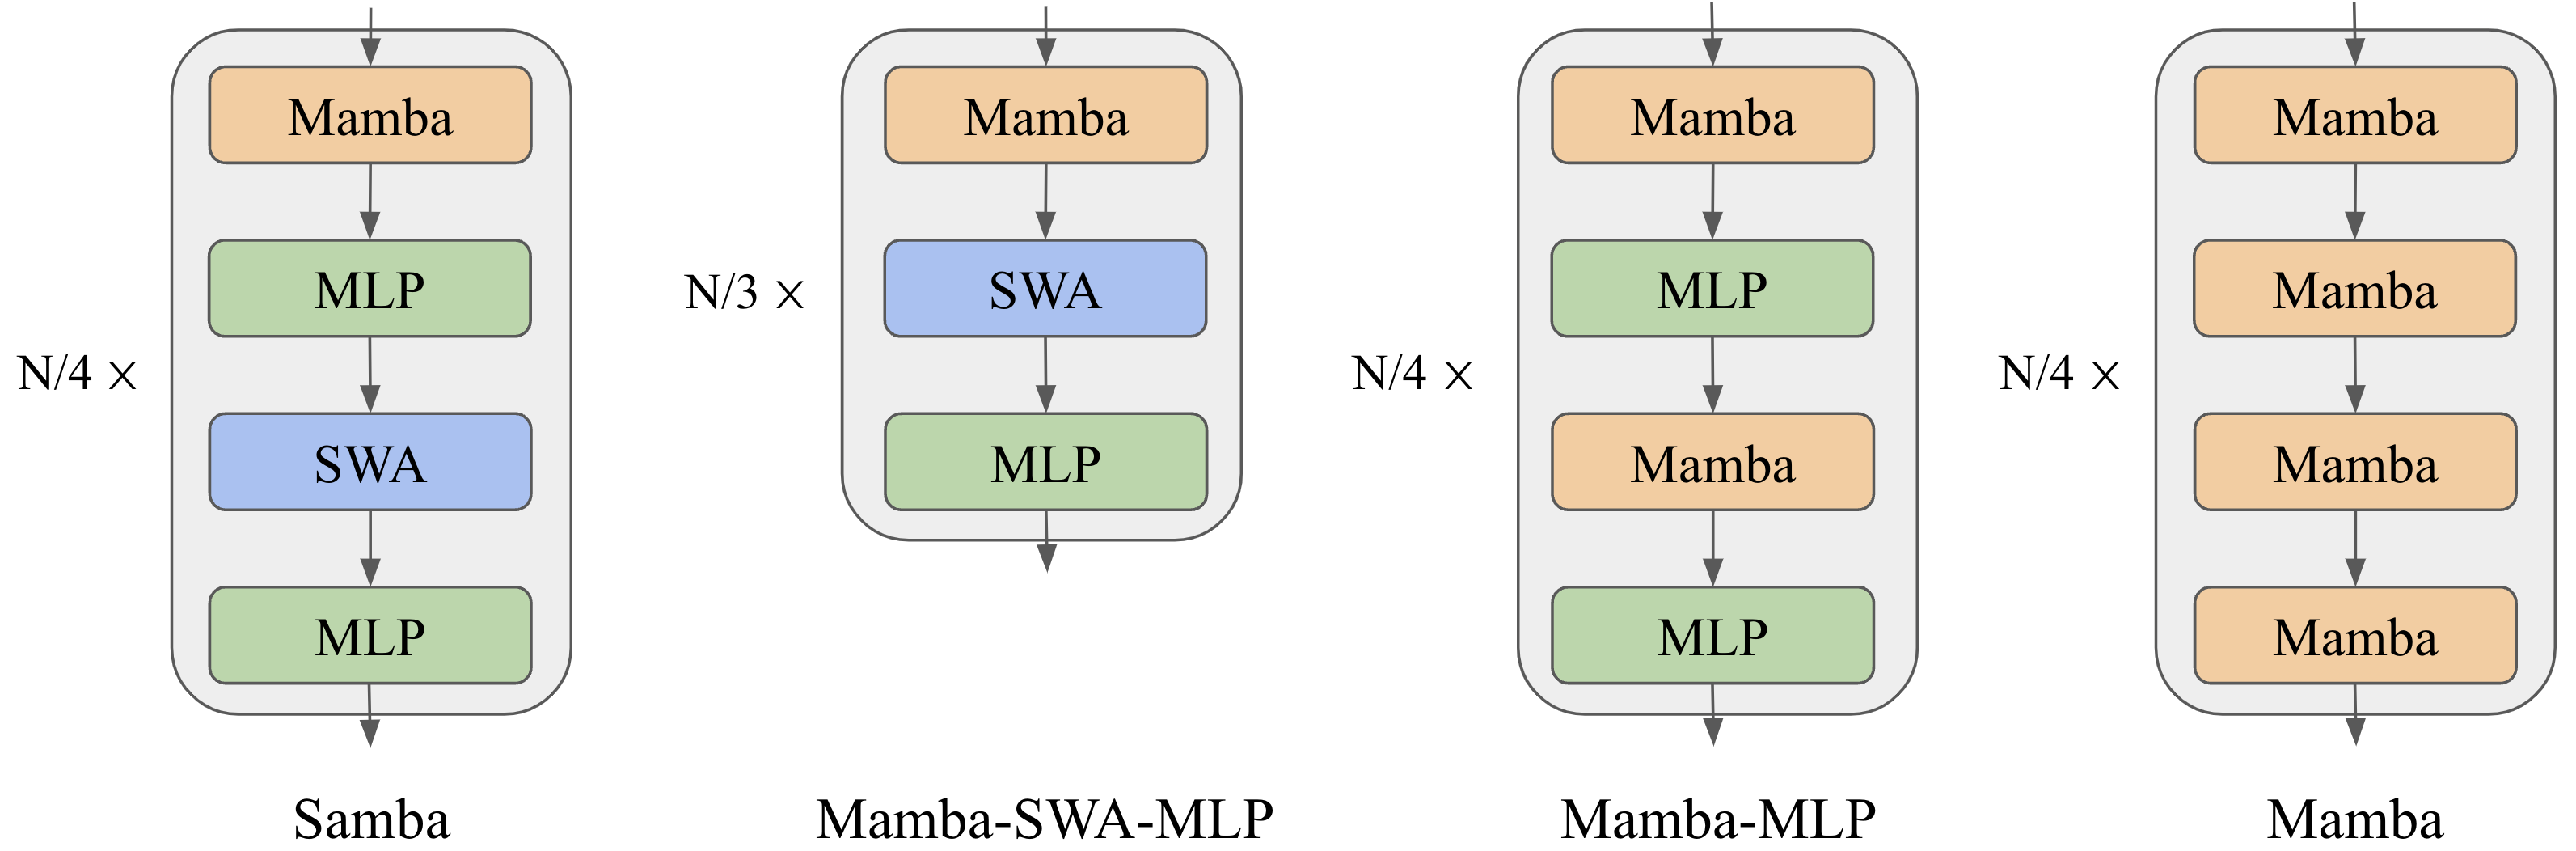
原文 Fig.1,PDF p.3,作者原图。阅读顺序为从左到右比较四种架构,从上到下跟踪每种架构的数据流。每层均带 Pre-Norm 与残差连接,图中省略嵌入与输出投影。
Samba 的重复单元是四个独立残差子层:
若总中间层数为 $N$,就有 $N/4$ 个 Mamba、$N/4$ 个 SWA 和 $N/2$ 个 MLP。例如 1.7B Samba 的 $N=48$,对应 12 个 Mamba、12 个 SWA、24 个 MLP;3.8B 的 $N=64$,对应 16、16、32 个。这里的“层”把 token mixer 和 MLP 分开计数,不等于常见 Transformer 中一个“注意力 + MLP”完整 block 的计数。(Fig.1、Table 12,PDF pp.3、24。)
其他排列用于检验配比:Mamba-SWA-MLP 每三个子层重复一次,减少 MLP 的比例;Mamba-MLP 不使用注意力;纯 Mamba 全部使用循环层。Samba 为两种信息混合器分别配置 MLP,既提供非线性加工,也将一部分参数放在执行效率较好的稠密矩阵运算上。
2.2 Mamba:从输入生成写入、衰减与读取信号
设输入为 $\mathbf X\in\mathbb R^{n\times d_m}$。核心符号如下:
| 符号 | 含义与维度 | 本文设定 |
|---|---|---|
| $n,d_m$ | 序列长度、模型宽度 | 训练 $n=4096$;宽度依模型规模而变 |
| $d_e$ | Mamba 扩展通道数 | $2d_m$ |
| $d_r$ | 门控的低秩中间维度 | $d_m/16$ |
| $d_s$ | 每个通道的状态维度 | 16 |
| $\mathbf U\in\mathbb R^{n\times d_e}$ | 短卷积后的输入特征 | 卷积核宽度 $k=4$ |
| $\Delta\in\mathbb R^{n\times d_e}$ | 正值、输入相关的步长/选择门 | 初始化范围 $[0.001,0.1]$ |
| $\mathbf B,\mathbf C\in\mathbb R^{n\times d_s}$ | 输入相关的写入与读取方向 | 由 $\mathbf U$ 线性投影 |
| $\mathbf Z_t\in\mathbb R^{d_e\times d_s}$ | 第 $t$ 步循环状态 | 初始为零 |
首先扩展通道并做沿时间轴的逐通道短卷积:
这一步先聚合很近的局部模式,再决定如何更新状态;它是原文 Eq.(1)。随后计算选择门和读写向量:
$\mathbf W_r\in\mathbb R^{d_e\times d_r}$、$\mathbf W_q\in\mathbb R^{d_r\times d_e}$ 使门控投影采用低秩参数化;Softplus 保证 $\Delta>0$。这是原文 Eq.(2),不是对 token 做 softmax 归一化。(Sec.2.1.1,PDF p.3。)
为把原文的广播与外积方向写清,下面按元素展开同一状态更新。$i$ 表示扩展通道、$j$ 表示状态坐标:
这里 $A_{i,j}$ 是可学习参数,初始化为 $\log j$;$D_i$ 初始化为 1。原文以 $\mathbf B_t\otimes\mathbf U_t$ 表示外积,同时指定结果为 $d_e\times d_s$;按上述索引写法可直接确认其维度。输出门与降维投影为:
直觉上,$\Delta$ 大时旧状态衰减更强,同时当前输入的写入因子更大;$\Delta$ 小时更倾向于保留旧状态并减少新写入。$\mathbf B$ 与 $\mathbf C$ 则控制写入和读出的方向。因此,“选择性”来自数据相关的状态更新,不能只用一个固定时间常数描述。
教学展开:令 $a_t=\exp[-\Delta_t\exp(A)]$、$b_t=\Delta_t U_tB_t$,省略坐标后有
这个展开说明历史信号依赖后续门控的连乘才能长期存在。固定状态可以把重要信息传递很远,但多个任意信息也要共用这些状态坐标。它解释了为什么“长距离保持单个显著 passkey”与“同时记住许多姓名—号码对”的难度不同;这是对更新机制的分析,论文的直接证据来自两类检索实验。
2.3 SWA:给压缩状态配一块可精确访问的局部记忆
SWA 的窗口 $w=2048$,采用 RoPE,基频为 10,000,并以 FlashAttention 2 实现。用教学记号写出单头的因果窗口读取:
其中 $q_t,k_j$ 已经过 RoPE,$d_h$ 是头维度。这是为解释 SWA 补写的公式,原文没有给它编号。窗口内直接读取 KV 能保留数字、名称等细节,而远处信息需要通过循环状态或逐层信息传播进入当前表示。SWA 看到的 KV 本身也已经经过前面的 Mamba 层处理,所以两种记忆并非互不交流的并联组件。(Sec.2.1.2,PDF p.4。)
窗口大小同时是系统选择:作者依据已有实现的测量,认为 2048 长度附近 FlashAttention 2 与 Mamba selective scan 的训练速度接近。后文也表明,单纯减少注意力不必然加快训练;MLP 比例、层数与内存读写同样重要。
2.4 MLP、训练并行与流式推理
两个 MLP 都使用 SwiGLU。其一般形式可写作 $[\operatorname{SiLU}(xW_1)\odot(xW_2)]W_3$,其中两条中间分支宽度为 $d_p$。这只是展开论文所用标准模块,Samba 的新意在于分别把 MLP 放在 Mamba 和 SWA 后。
训练时,Mamba 使用硬件感知的并行扫描,SWA 使用并行注意力内核;概念上的时间递推不意味着训练必须逐 token 串行执行。流式生成时,每个 Mamba 层保存状态和短卷积缓存,每个 SWA 层只保留最近 $w$ 个 KV。
以下为固定宽度、固定层数下的复杂度解释,省略线性投影等共同成本:
| 模块 | 长度 $n$ 的混合计算 | 流式生成需保留的历史信息 |
|---|---|---|
| 全注意力 | $O(n^2d_m)$ | $O(nh_{kv}d_h)$ 个 KV 元素 |
| SWA | $O(nwd_m)$ | $O(wh_{kv}d_h)$ 个 KV 元素 |
| Mamba 状态更新 | $O(nd_ed_s)$ | $O(d_ed_s+kd_e)$ 个状态/卷积元素 |
$w,d_s$ 固定时,Samba 对序列长度为线性复杂度,每个新 token 的历史访问预算不随已经处理的长度增长。这里的“固定内存”指每条序列的流式历史缓存,训练激活、模型权重、批大小和实际工作区仍要另算。无限流式处理也没有把有限状态变成无限容量的无损记忆。
三:实验——先把规模、数据和评测口径分开
3.1 四种预训练规模
| Samba 规模 | 数据 / token 数 | $N$ / $d_m$ / $d_p$ | Query / KV 头数 |
|---|---|---|---|
| 421M | SlimPajama / 20B | 24 / 1536 / 4096 | 12 / 12 |
| 1.3B | SlimPajama / 100B | 36 / 2304 / 6144 | 18 / 18 |
| 1.7B | Phi-2 / 230B | 48 / 2048 / 8196 | 32 / 4 |
| 3.8B | Phi-3 / 3.2T | 64 / 2816 / 9984 | 11 / 1 |
全部采用 4096 训练长度、2048 SWA 窗口,Mamba 的 $d_s=16$。3.8B 使用与 Phi-3 相同的多阶段预训练,并分别应用原始和 June 后训练配方,产生不同模型版本;不能把两版的最好指标拼成同一个模型的结果。Table 12 只列出 3.8B 第一阶段的优化设置。(PDF p.24。)
约 1.7B 的 Phi-2 对照实际参数量范围为 1.6B–1.9B,而非完全等参数。正文 Sec.2.1 写纯 Mamba 为 48 层,附录 Table 11 写为 64 层,并列出 64 个 Mamba 层;这里采用详细配置表的 64 层描述该基线。(PDF pp.2、24。)
3.2 各组实验分别回答什么
| 实验 | 关键对照 | 指标与含义 |
|---|---|---|
| 3.8B 基座 / 后训练 | 相同数据配方的 TFM++ / Phi-3 | 知识、数学、代码等得分,越高越好 |
| 1.7B Phi-2 六架构 | 全注意力、SWA、纯 Mamba、两种混合 | 15 项分数及等权平均;检验排列影响 |
| SlimPajama 替换实验 | RetNet、GLA、MLP 替换 Mamba;移除 RoPE | 困惑度 PPL 越低越好;训练 tokens/s 越高越好 |
| Proof-Pile | 约 1.7B 架构与 SelfExtend 基线 | 随上下文长度变化的 PPL;检验预测外推 |
| Passkey / Phonebook | SWA、全注意力与不同微调模型 | 精确检索准确率;检验记忆保持与负载 |
| 长文摘要 | Samba-3.8B-IT 与 Phi-3-mini | ROUGE-L;检验真实长文摘要输出 |
PPL 是 token 平均负对数似然的指数,更低表示预测更好;它不会直接告诉我们任意位置的信息是否都可检索。ROUGE-L 衡量与参考摘要的最长公共子序列重叠,也不同于精确事实召回。论文的“Average”是各表所列任务分数的平均,不宜跨表混用,因为任务组成、few-shot 设置和归一化口径不同。
四:结果——沿原文实验顺序解读
4.1 Textbook 数据:质量提升与任务取舍
原始后训练配方,Table 1,PDF p.4。 两个模型使用相同数据与配方;表中 Phi-3 行带有技术报告来源标记。MMLU 是 5-shot、按类别平均;GSM8K 是 8-shot CoT;HumanEval 是 0-shot pass@1。
| 指标(↑) | Phi-3-mini-4K-instruct | Samba-3.8B-IT | Samba − Phi-3 |
|---|---|---|---|
| MMLU | 68.8 | 71.9 | +3.1 个百分点 |
| GSM8K | 82.5 | 87.6 | +5.1 个百分点 |
| HumanEval | 58.5 | 62.8 | +4.3 个百分点 |
| GovReport ROUGE-L | 14.4 | 18.9 | +4.5 分 |
| SQuALITY ROUGE-L | 21.6 | 21.2 | −0.4 分 |
因此短任务提升明确,长文摘要则是 GovReport 明显改善、SQuALITY 略降,不能概括为两项摘要任务都获益。Appendix F 报告 GovReport 平均 11,533 token、最长 40,592;SQuALITY 平均 7,974、最长 10,757。两项都贪心解码,生成上限分别为 450 和 600 token。(PDF p.23。)
约 1.7B 的排列实验,Table 2,PDF p.5。 六个模型均在 Phi-2 数据训练 230B token。下表选取总体分数以及能区分记忆、知识和数学能力的指标;这些列都是越高越好。
| 架构 / 参数量 | 15 项平均 | SQuAD | MMLU | GSM8K |
|---|---|---|---|---|
| Llama-3 / 1.6B | 51.17 | 74.88 | 43.84 | 32.68 |
| Mistral / 1.6B | 51.12 | 72.82 | 43.54 | 32.45 |
| Mamba / 1.8B | 52.31 | 67.66 | 45.28 | 32.07 |
| Mamba-SWA-MLP / 1.6B | 53.77 | 76.73 | 47.39 | 44.05 |
| Mamba-MLP / 1.9B | 51.38 | 63.86 | 43.68 | 27.52 |
| Samba / 1.7B | 54.33 | 77.64 | 48.01 | 38.97 |
Samba 相对 Llama-3 的平均分提高 3.16 分,相对纯 Mamba 提高 2.02 分。纯 Mamba 的 SQuAD 明显较弱,而加入注意力后的两种混合结构更强,支持“显式读取补足压缩状态”的解释。Samba 的 SQuAD 比 Mamba 高 9.98 分;表注未将这项任务分数细分为 EM/F1。
另一方面,Mamba-SWA-MLP 的 GSM8K 高于 Samba 5.08 个百分点,并在 WinoGrande、SIQA 上领先。这说明最优混合比例依任务而变。Table 2 的选择题使用未归一化准确率,GSM8K 为 5-shot,其余为 zero-shot;这与下文 SlimPajama 表中的 HellaSwag 归一化分数不同。
4.2 SlimPajama:循环模块、位置编码与效率都重要
Table 3,PDF p.6:1.3B 量级,100B token,训练长度 4096。 速度为 64×H100 上的峰值训练吞吐,单位为 $10^5$ token/s。GLA 实际为 1.2B、RetNet 为 1.4B。
| 架构 | PPL @4K ↓ | PPL @8K ↓ | PPL @16K ↓ | 训练吞吐 ↑ |
|---|---|---|---|---|
| Llama-2 | 7.60 | 44.32 | 249.64 | 25.9 |
| Llama-2-SWA | 7.60 | 7.37 | 7.21 | 26.2 |
| Mamba | 7.47 | 7.26 | 7.15 | 17.8 |
| Sliding GLA | 7.58 | 7.35 | 7.19 | 25.9 |
| Sliding RetNet | 7.56 | 7.35 | 7.56 | 23.0 |
| Mega-S6 | 9.01 | 8.81 | 8.68 | 17.9 |
| Mamba-SWA-MLP | 7.37 | 7.16 | 7.00 | 23.5 |
| MLP2-SWA-MLP | 7.81 | 7.58 | 7.42 | 26.6 |
| Samba-NoPE | 7.33 | 20.40 | 326.17 | 25.2 |
| Samba | 7.32 | 7.11 | 6.96 | 25.2 |
可以从三个层次读这张表。
第一,循环信息通路有质量收益。把 Mamba 换成同量级参数的 MLP,4K PPL 从 7.32 恶化到 7.81。GLA 是输入相关门控的线性注意力,RetNet 使用输入无关的固定衰减,二者替换 Mamba 后也落后于 Samba。Mega-S6 在层内顺序结合 S6 与注意力,表现说明“有两种模块”本身还不够,组合方式很重要。
第二,外推需要合适的位置与窗口行为。Samba-NoPE 在 4K 几乎不损失质量,却在 16K 达到 326.17 PPL;Samba 为 6.96。局部窗口和循环状态并不能自动消除长度分布变化带来的问题。普通 Llama-2 的结果对应未加额外长度适配的配置,应理解为这套训练/位置设置下的失效。
第三,线性递推不自动意味着训练最快。Samba 的吞吐约为纯 Mamba 的 $25.2/17.8=1.42$ 倍,但略低于 Llama-2-SWA 的 26.2。纯 Mamba 为达到相似参数规模需要更多循环层;Samba 中更多参数位于 MLP,有利于硬件执行。Mamba-SWA-MLP 减少 MLP 比例后,吞吐降到 23.5。
421M 量级结果方向一致:Samba 的 4K/16K PPL 为 10.06/9.57,Llama-2-SWA 为 11.12/10.57,纯 Mamba 为 10.70/10.24。此组速度在 8×A100 测量,Samba 为 $4.46\times10^5$ token/s,不能直接与上一组的 25.2 比较。小规模 Samba 与 Mamba-SWA-MLP 的 4K 差值只有 0.01,低于论文所述约 ±0.3% 的 PPL 波动量级,不宜据此强调质量排名;其训练速度差异更清晰。
下游任务,Table 4,PDF p.7。 相同 100B SlimPajama 训练后,五项 zero-shot 平均分为 Samba 58.54、Samba-NoPE 58.52、Mamba-SWA-MLP 58.19、Mamba 56.99、Llama-2-SWA 56.67、Llama-2 56.08。Samba 在 LAMBADA 达到 51.68,纯 Mamba 为 45.97;但 HellaSwag 上纯 Mamba 的 54.93 略高于 Samba 的 54.73。训练内短任务上几乎相同的平均分,可能掩盖很大的长度外推差异,NoPE 是最直接的例子。
4.3 Efficient Length Extrapolation:预测质量与实际吞吐
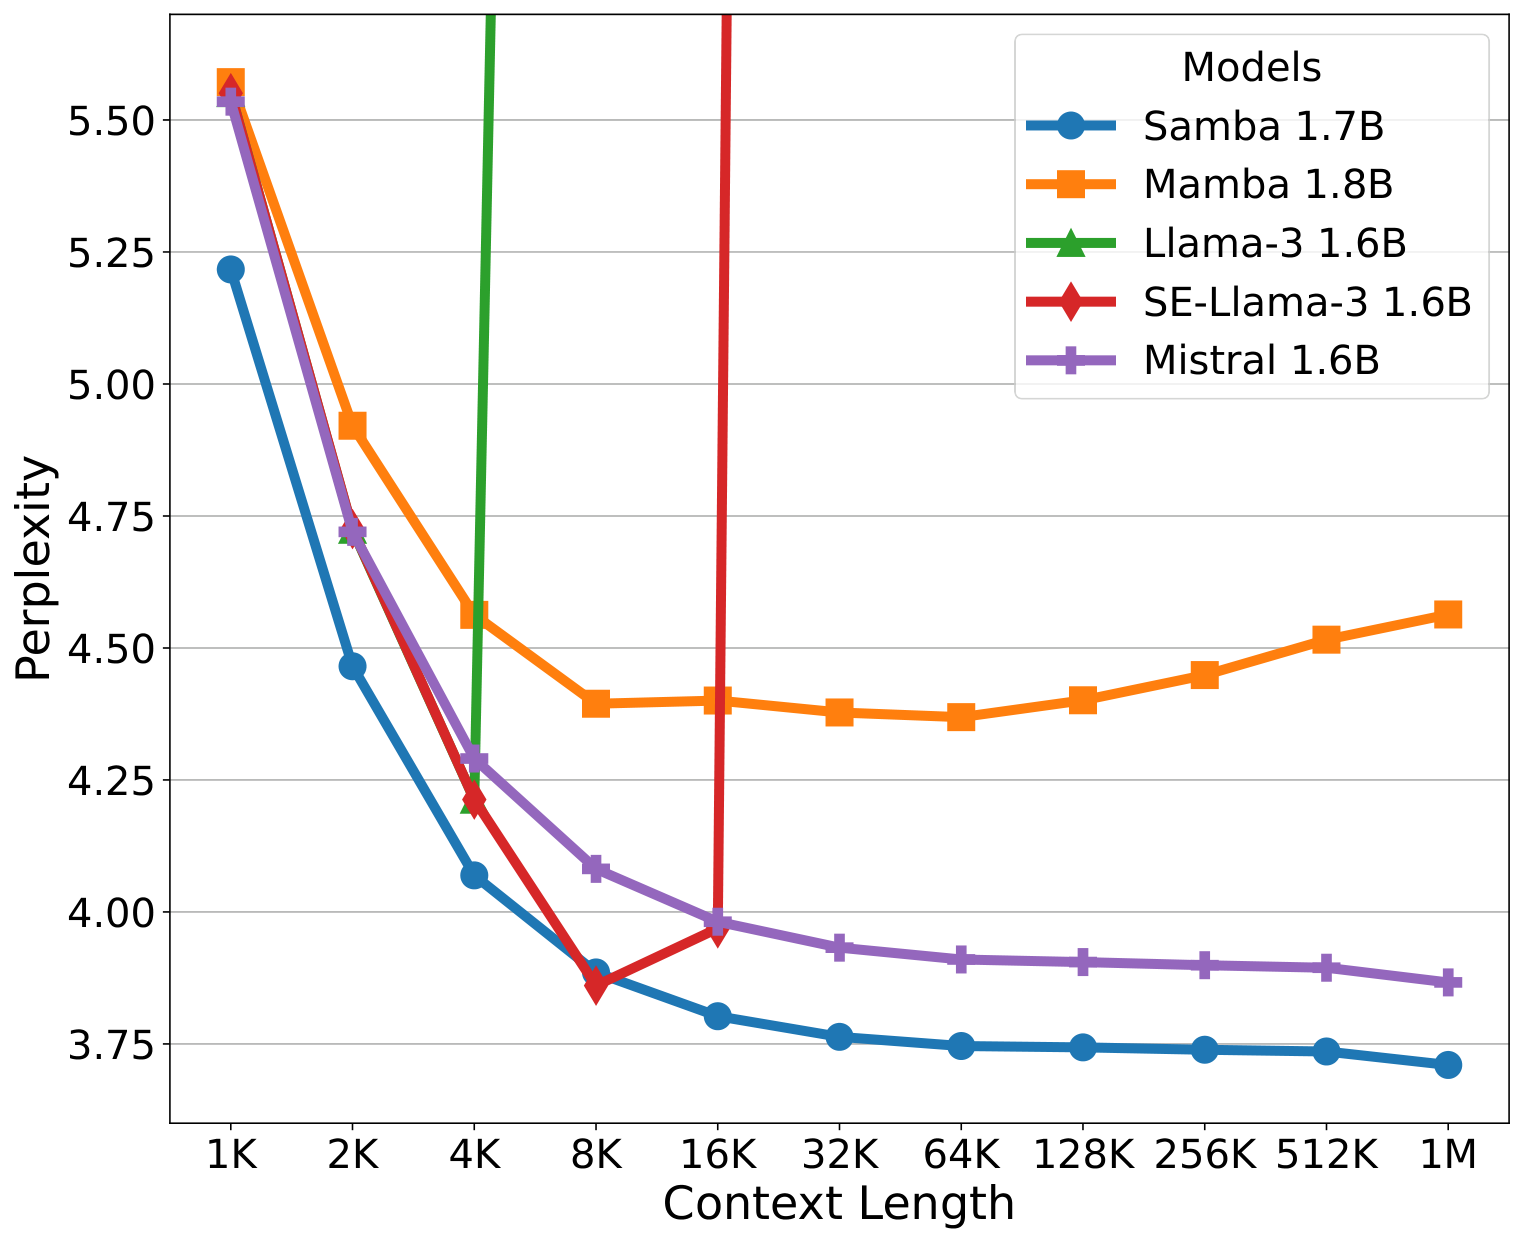
原文 Fig.2a,PDF p.7,作者原图。横轴从 1K 到 1M,为倍增长度;纵轴为 PPL,越低越好。蓝色为 Samba 1.7B,橙色为 Mamba 1.8B,紫色为 Mistral 1.6B;两条全注意力相关曲线在超过适用长度后迅速升高。
该实验使用约 1.7B 的 Phi-2 系列模型,均在 4K 长度训练。Samba 的 PPL 随上下文增长降低,在极长输入上保持稳定;Mistral 的 SWA 也能稳定外推,但 PPL 更高;纯 Mamba 在长端逐渐恶化。SelfExtend 基线的 group size 为 4,neighborhood window 为 1024。(Sec.3.3,PDF pp.7–8。)
原文写明 PPL 评测采用 window size 4096 的 sliding-window approach,这个评测设置应与模型内部的 SWA=2048 分开理解。论文没有在此详细给出所有跨窗口状态衔接实现。该图测量的是长上下文预测表现,精确召回需要另外的任务评测。
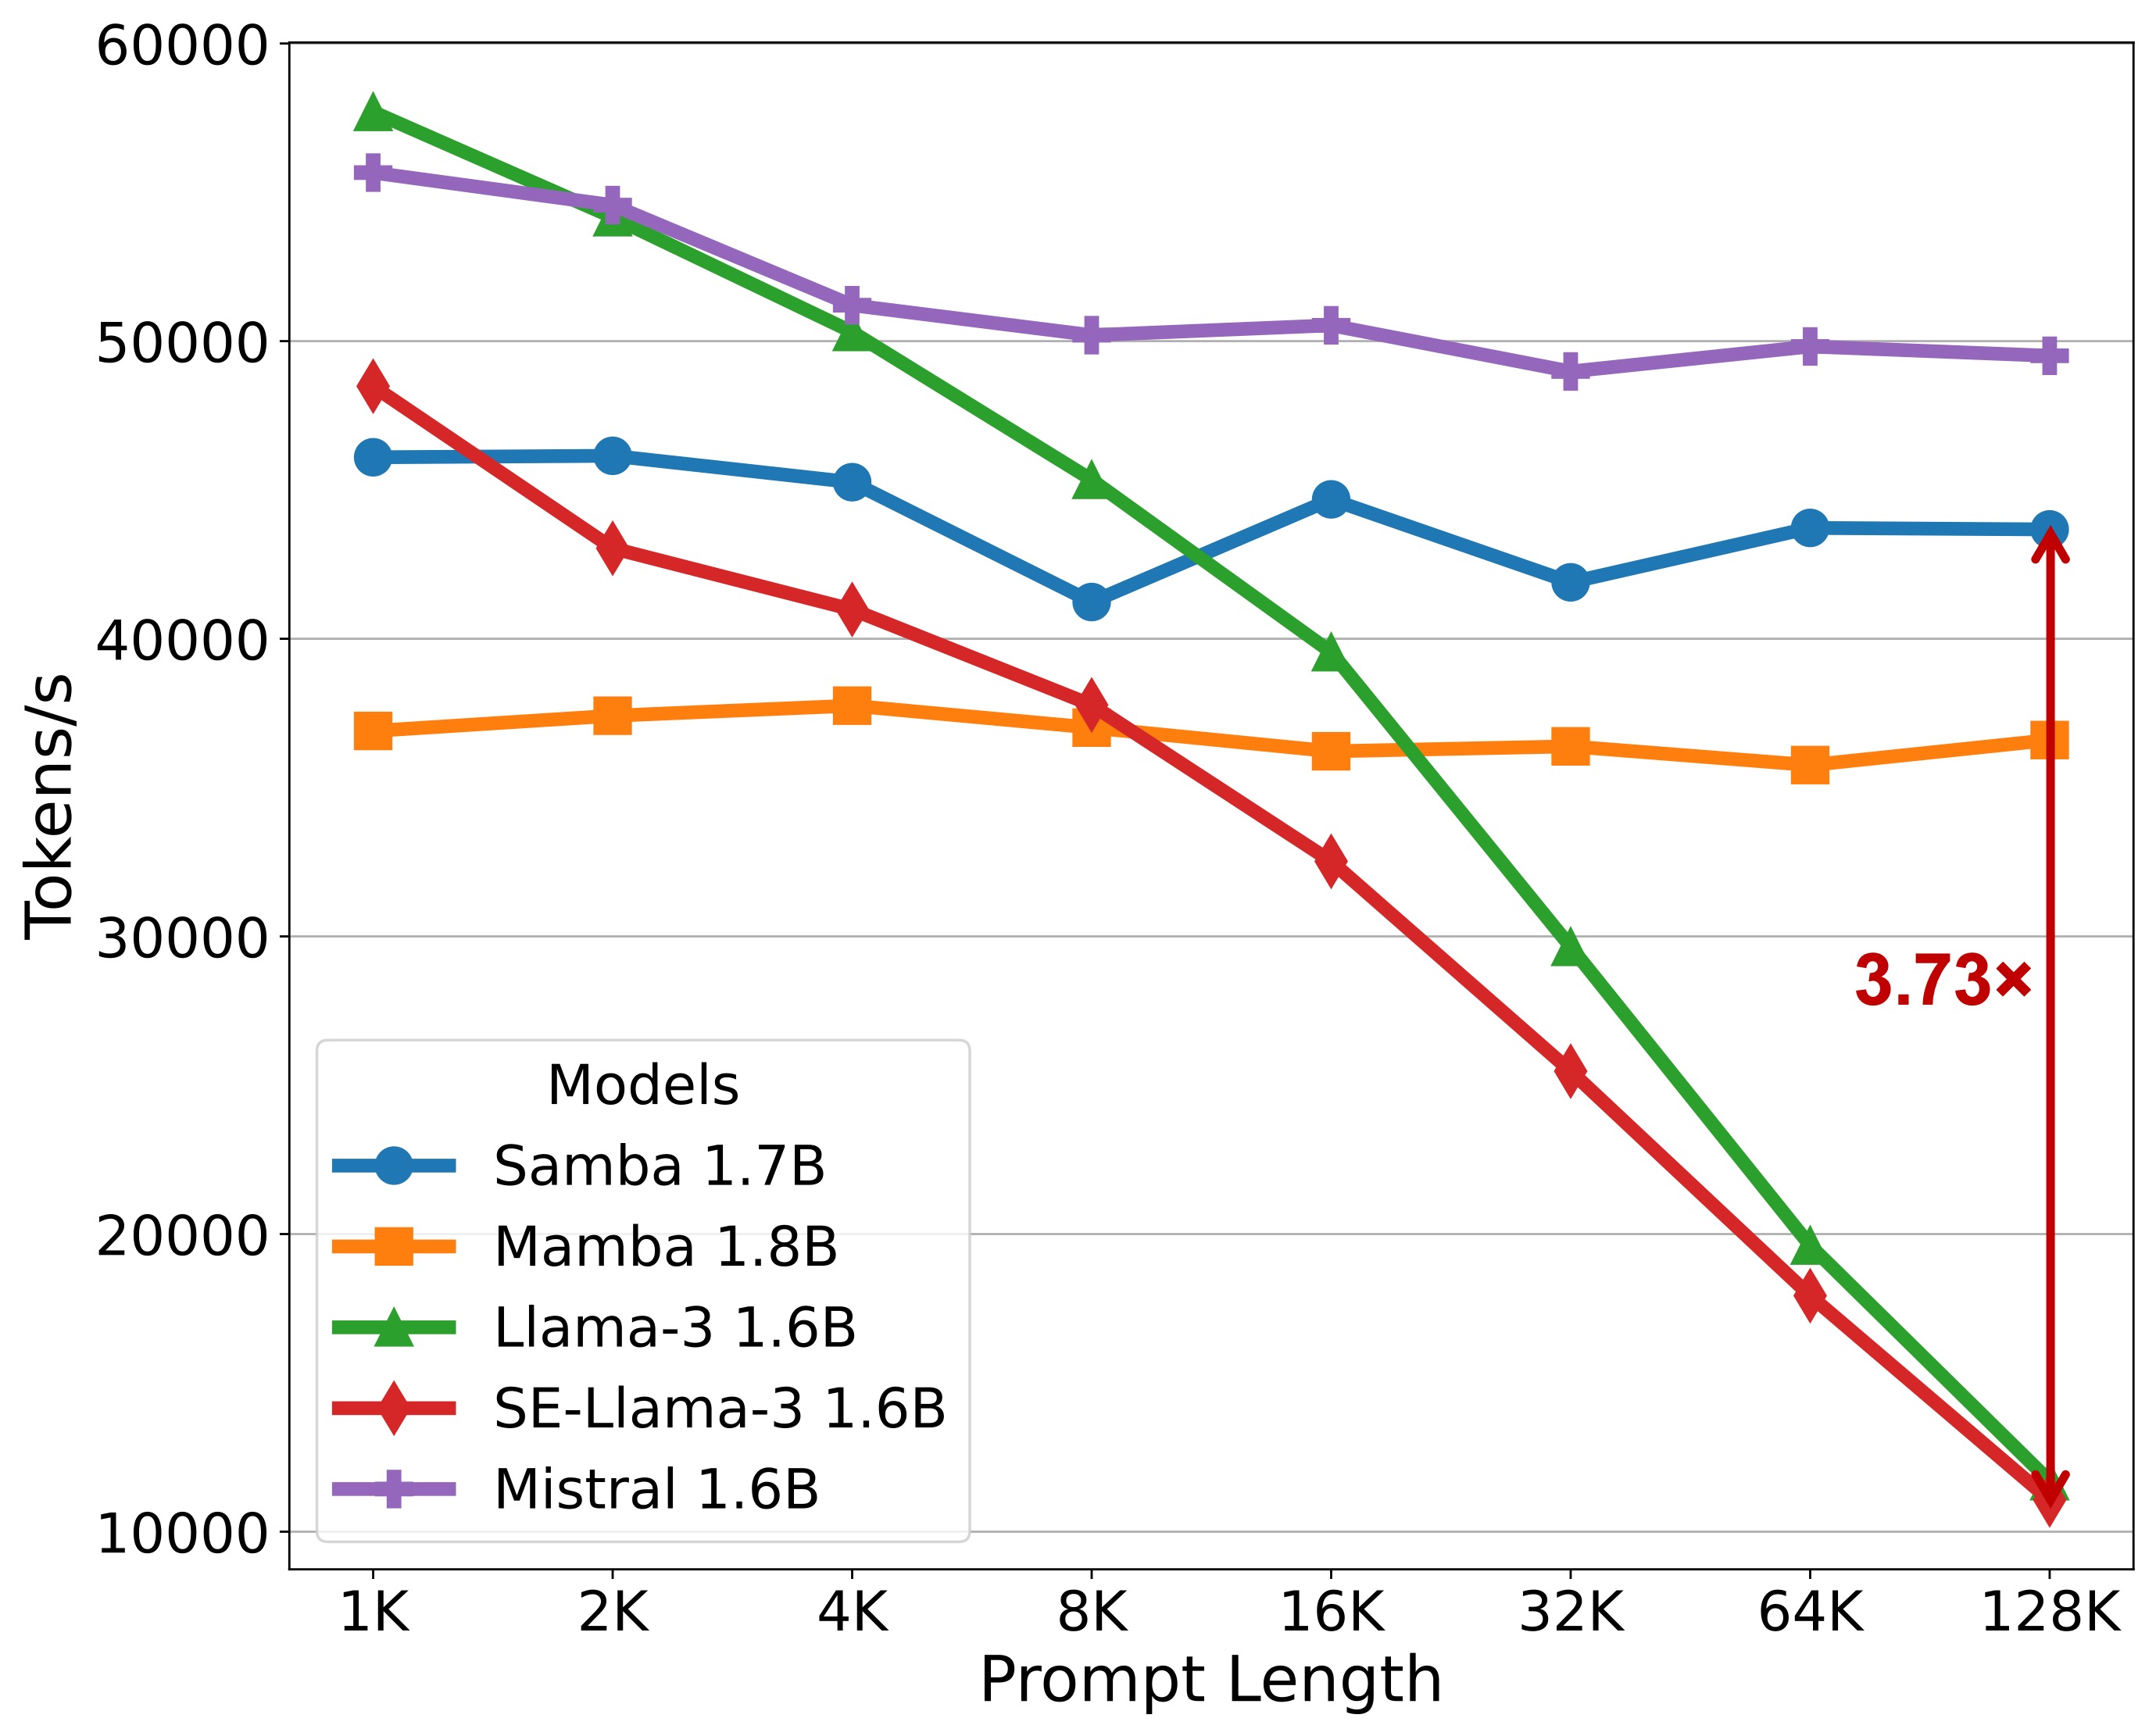
原文 Fig.6,PDF p.21。横轴为 prompt 长度,纵轴为 token/s。Samba 的吞吐相对稳定,Llama-3 和 SelfExtend 的吞吐随长度明显下降。
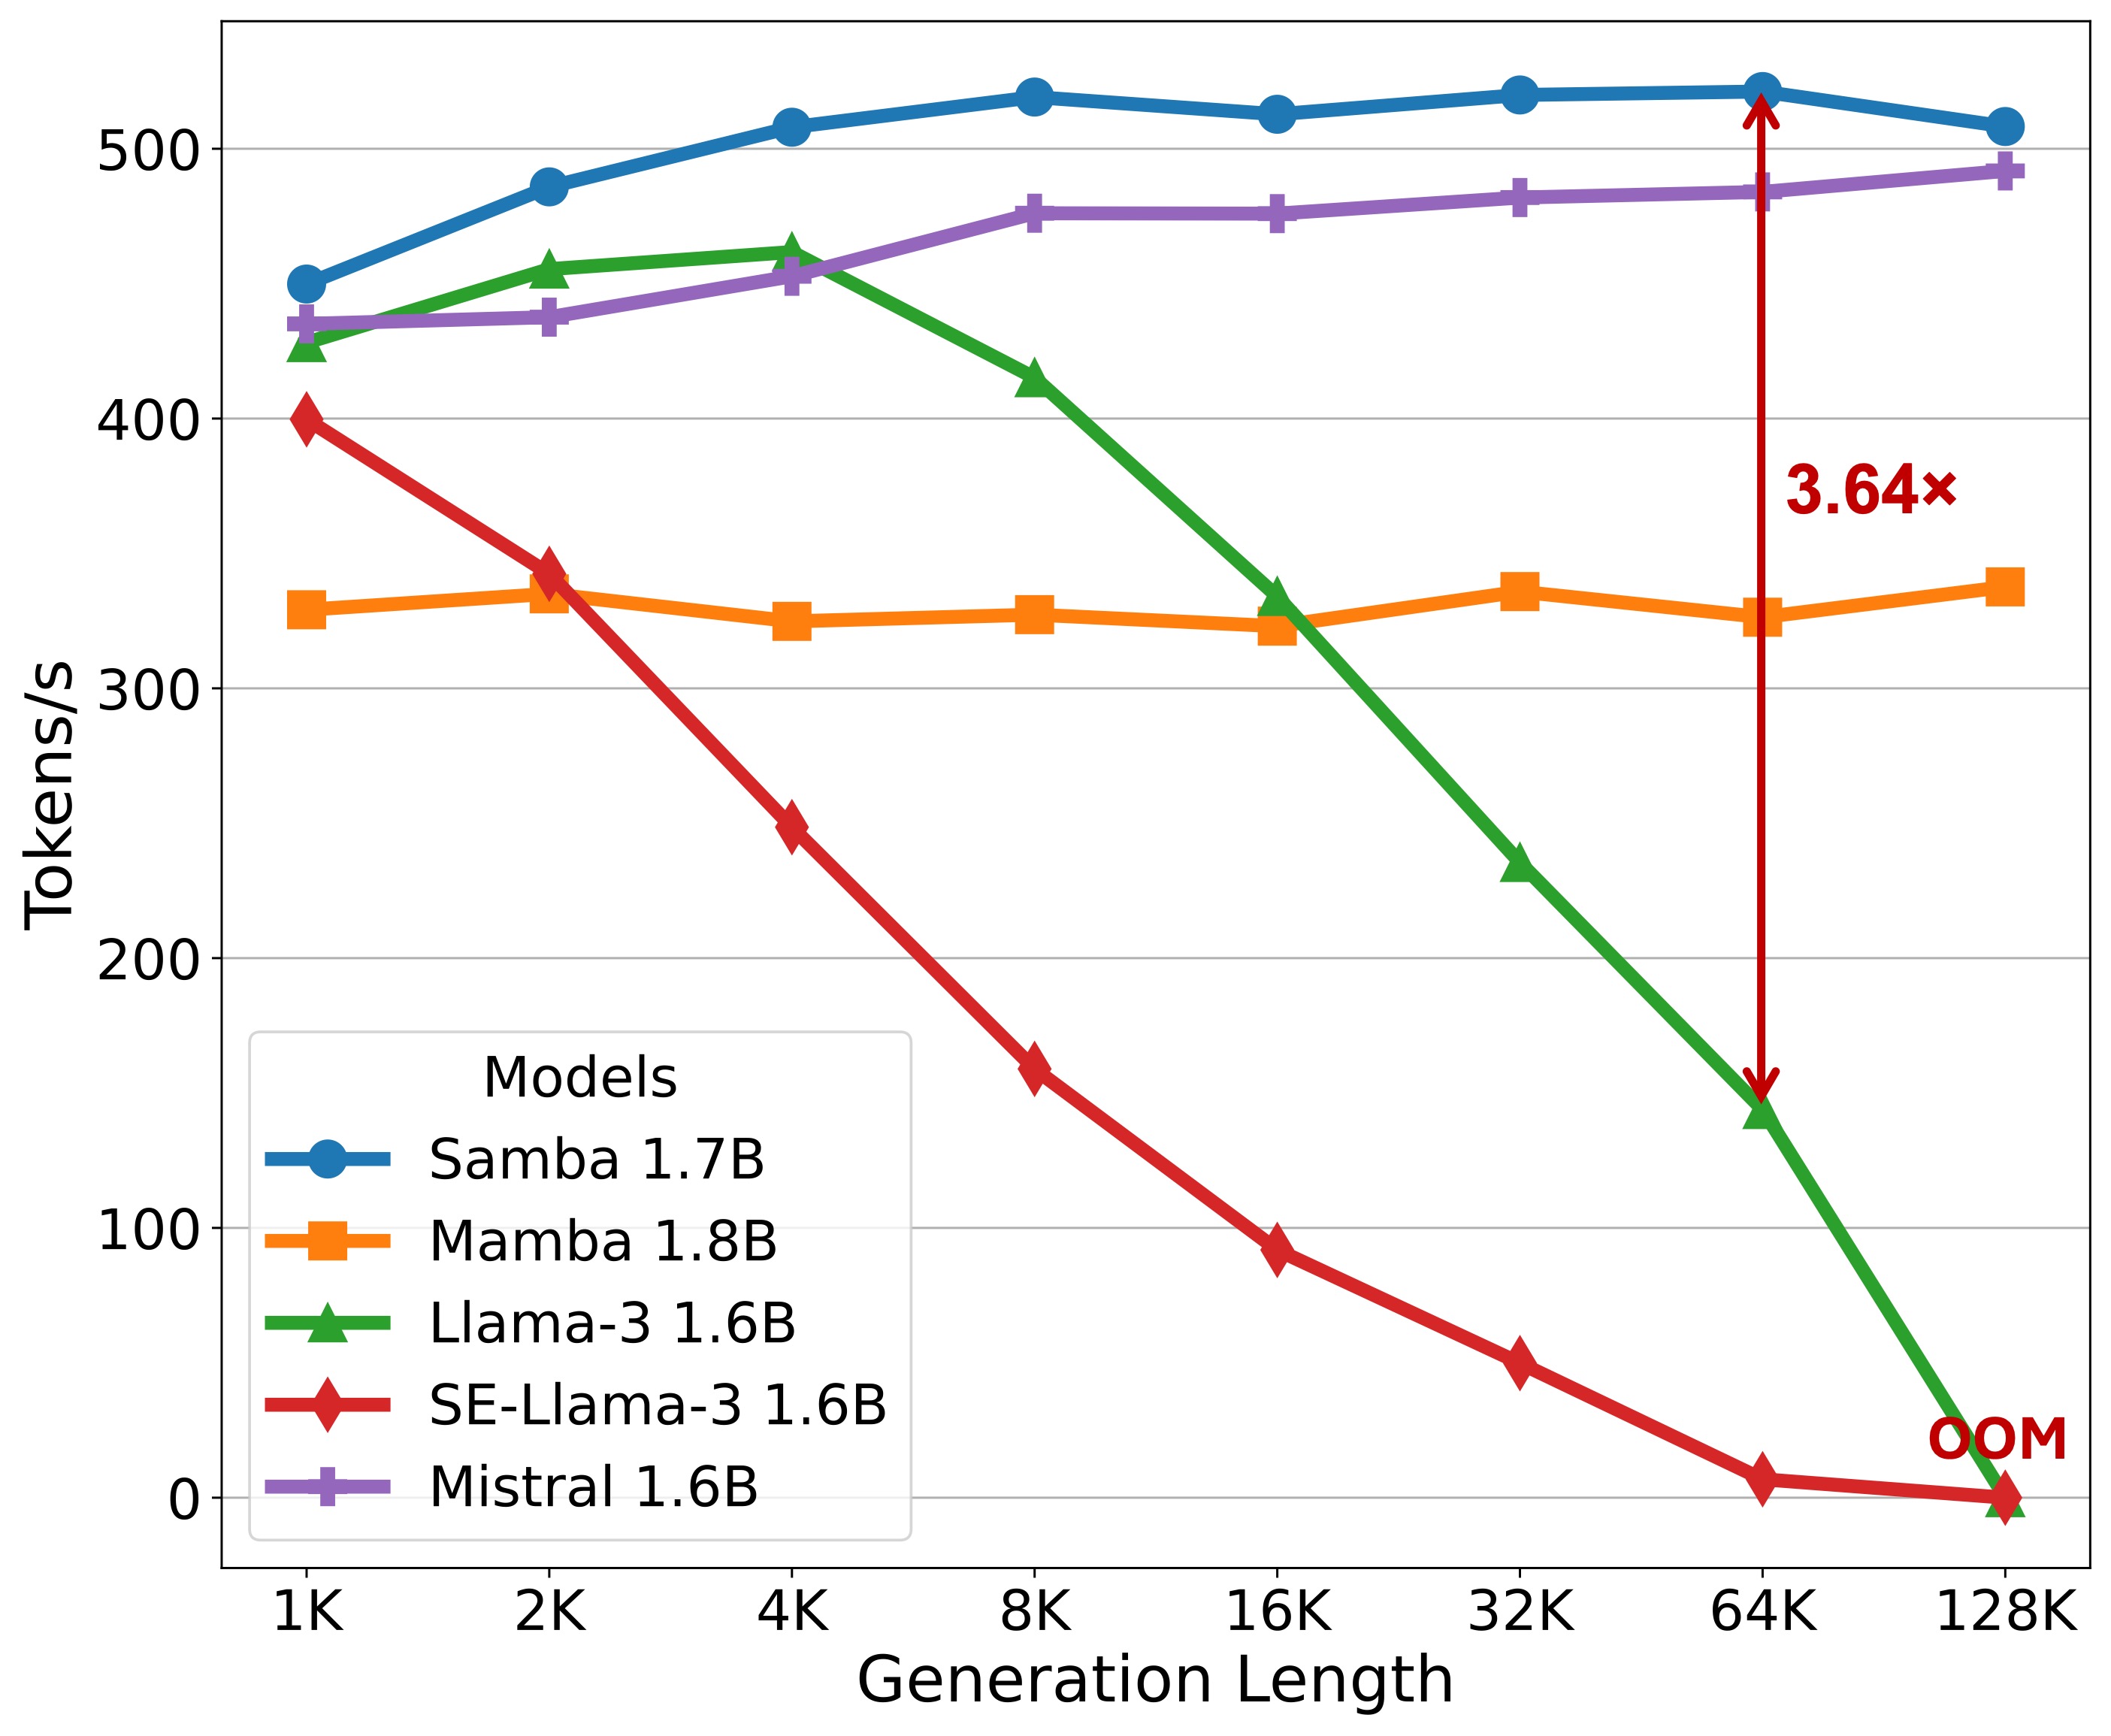
原文 Fig.2b,PDF p.7。横轴为生成长度,纵轴为 token/s,batch size 固定为 16。Samba 在 64K 生成长度的标注为相对 Llama-3 的 3.64×。
两种速度实验的条件不同:
| 阶段 | 协议 | 报告的比较 |
|---|---|---|
| 提示处理 / prefill | 长度 1K–128K,每次总处理 token 数固定 128K,随长度调整 batch | 128K 时 Samba 1.7B / Llama-3 1.6B = 3.73× |
| 自回归生成 / decoding | batch=16,扫描生成长度 | 64K 时 Samba / Llama-3 = 3.64× |
Sec.3.3 报告吞吐采用单张 A100、bfloat16、10 次测量平均。两个比率分别针对不同阶段,不能相乘得到端到端收益。SWA 基线也有长度稳定的速度,而且在 prefill 图中高于 Samba;因此这些结果说明 Samba 相对全注意力获得良好的质量—效率组合,并非它在所有阶段都最快。
4.4 Long-Context Understanding:长度外推与容量外推的差别
Passkey:学习保留一个显著目标。 Samba 1.7B 与 Mistral 1.6B 均在 4096 长度样本上微调 500 步,随机插入五位整数。训练 batch=2048,AdamW 峰值学习率 $10^{-4}$,warm-up=250 步,weight decay=0.1。若按完整序列预算计算,$500\times2048\times4096\approx4.19$B 输入 token,因此“500 步”并不等于很小的 token 预算。(Appendix C,PDF p.22;预算为本次分析。)
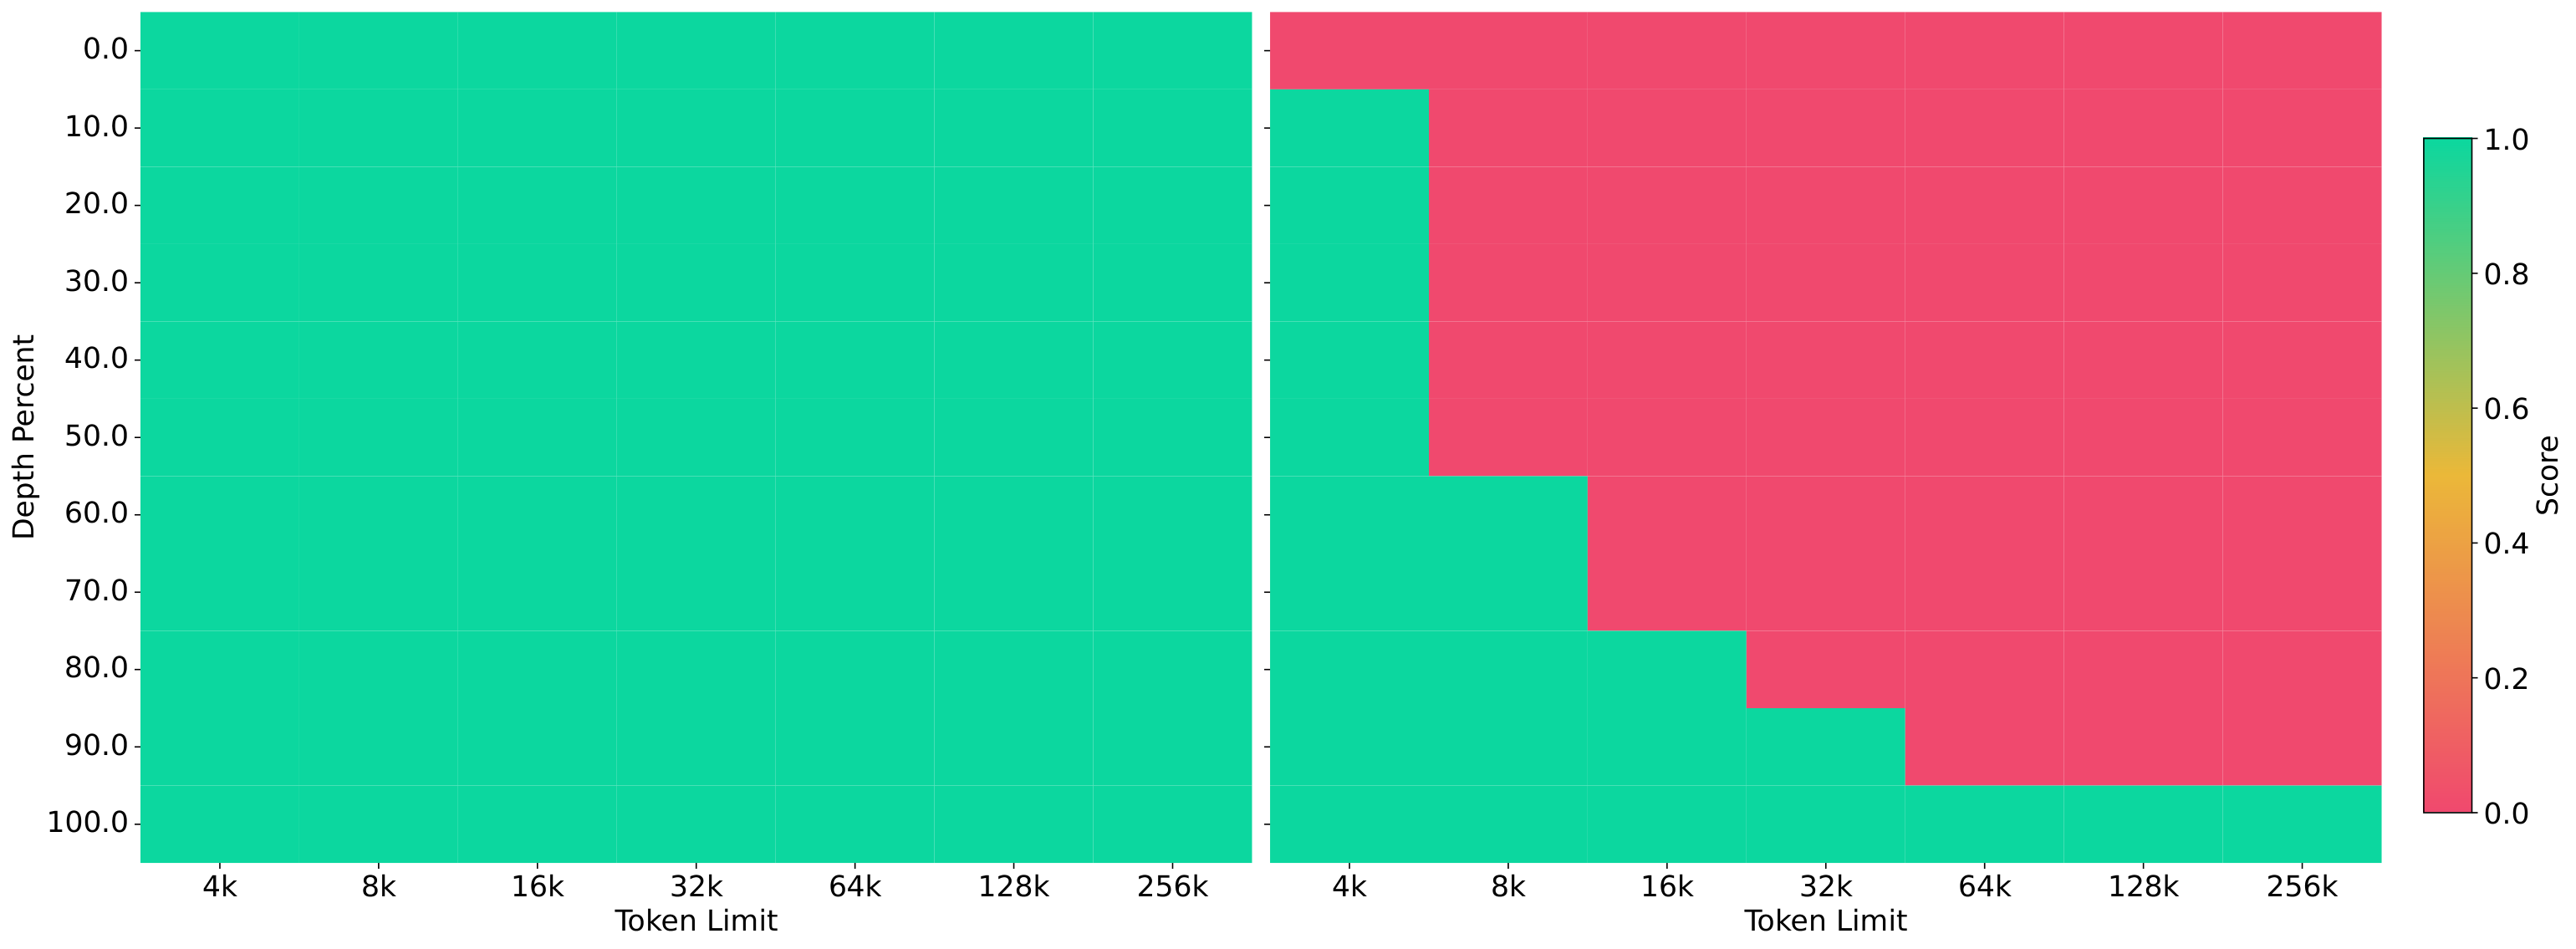
原文 Fig.3,PDF p.8。左为 Samba、右为 Mistral;横轴为 4K–256K 文档长度,纵轴为插入深度,颜色越接近绿色表示准确率越高。Samba 的已测网格达到完美召回,Mistral 随位置和长度出现大量失败。
评测为 7 种长度 × 11 个深度(0、0.1、…、1.0),每个格子使用 5 个随机 passkey,共 385 次测试。Samba 在这张最终热图上全部成功。学习曲线显示它约在 150 步时接近满分,而 Mistral 的曲线约为 30%;两者的训练损失却都能很快接近零。(Figs.7–8,PDF pp.21–22。)这说明相近的训练内拟合可以对应很不同的长距离策略。
Fig.8 的图注将曲线标为 256K 文档上的准确率,但 Appendix C 同时描述了七种长度的平均评测。这里的约 30% 指图中的汇总曲线,不将其解释为已明确核定的 256K 单点结果。
Phonebook:同时容纳很多姓名—号码映射。 任务包含 20–480 对姓名与电话号码,长度约 400–8400,查询随机条目。Samba-3.8B-FT 在 4K 样本上专门训练 100 步后,4K 内接近 Llama2 7B 的检索表现,越过训练长度后也比图中其他模型更强。(Fig.4,PDF p.8。)
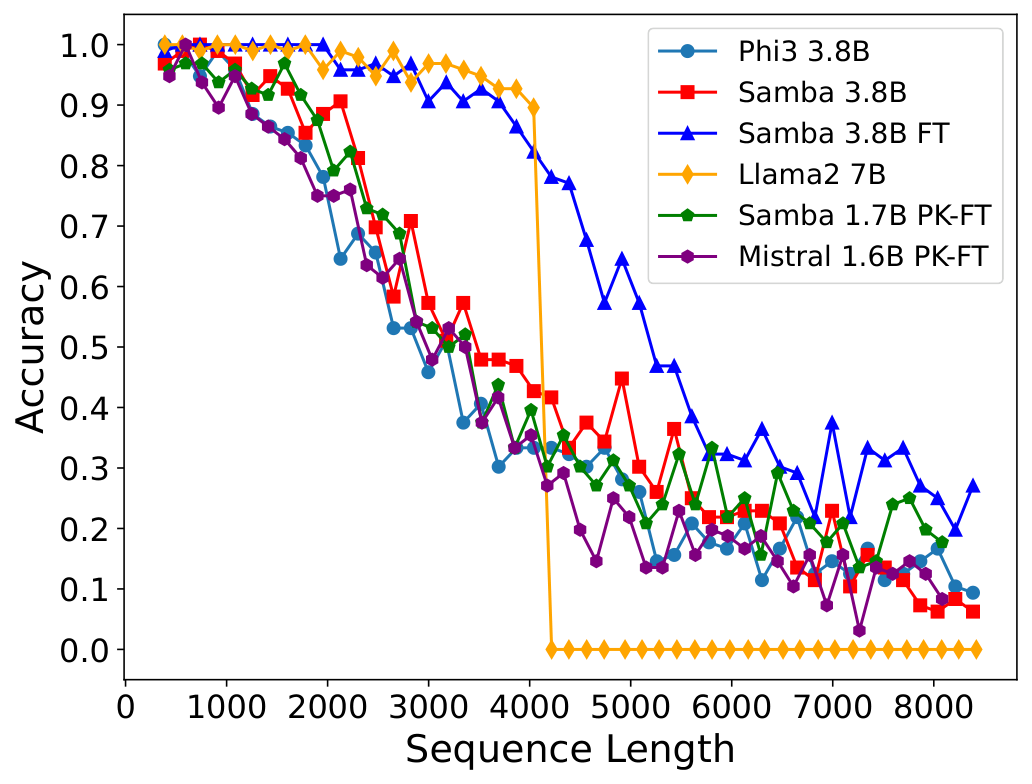
原文 Fig.4,PDF p.8。横轴是输入长度,同时对应更多条目;纵轴是检索准确率。蓝色 Samba-3.8B-FT 在长端保持相对优势,但准确率仍明显下降。图例区分基座、Phonebook 微调,以及 Passkey 微调(PK-FT)。
最有解释力的结果是 Passkey → Phonebook 迁移失败:把已经在 Passkey 上微调的 Samba 1.7B 直接用于 Phonebook,它虽然略好于相应 Mistral,但超过窗口范围后仍不能维持良好召回。单个显著标记的远程保存,没有自动变成在大量相似记录之间做随机访问的能力。预训练基座模型在检索上也没有自然出现微调后那样的优势。(Sec.3.4,PDF pp.8–9;Appendix H,PDF p.25。)
4.5 架构分析:为什么保留 SWA、RoPE 与较小的 KV 头数
全注意力替换,Table 5,PDF p.9。 在 12 个“mixer + MLP”block 中,用全注意力替换不同位置的 Mamba。放在 block 1、5 时,4K PPL=10.06,与 Samba 相同,但 16K 变为 13.57,Samba 为 9.57。放在 block 11 或 5 时,16K 分别为 13.66、12.83。
这里原文叙述有一处需要收窄:正文称即便全注意力放在开头,16K PPL 也会“爆炸”;Table 5 的 block 0 行实际为 10.89 → 10.55 → 10.63。它比 Samba 差,却不符合通常所说的数值爆炸。由表可以得出的结论是:这些全注意力混合配置的外推整体不及 Samba,而且任何保留全注意力的方案仍含随长度增长的全局注意力成本。
注意力参数分配,Table 6,PDF p.10。 约 430M 规模下,纯 Llama-2-SWA 最好的一行是 12 个 query 头、1 个 KV 头、head dim=128,4K PPL=10.89;Samba 最好的一行是 6 个 query 头、1 个 KV 头、head dim=256,PPL=9.99。作者在减少 KV 投影参数时增大 MLP 中间宽度以近似保持参数预算。结果支持在这些配置中采用较少的注意力头,但不是跨规模通用的最优比例。
SWA 训练长度,Table 9,PDF p.22。 固定窗口 2048、每步约 2M token,训练长度从 4096 增到 32768 时,batch 从 512 降到 64,16K 验证 PPL 从 10.61 变差到 11.86。在 2048 长度训练时,窗口等同于训练内全注意力,外推也明显失效。这个实验支持该预算下取训练长度为窗口的两倍;由于序列长度与 batch 同时变化,不能把性能变化完全归因于其中一个变量。
短卷积贡献,Table 10,PDF p.23。 给 q/k/v 加短卷积后,Llama-2-SWA 的 4K PPL 从 11.12 降到 10.83,Sliding RetNet 从 10.38 降到 10.25,Sliding GLA 从 10.43 降到 10.39;训练吞吐均有所下降。混合模型中这些卷积只加在线性注意力层;即使如此,它们仍落后于 Samba 421M 的 10.06。作者还报告同时给混合结构的 SWA 和线性层加卷积出现负结果,表明局部归纳偏置并非越多越好。
4.6 熵分析:支持模块分工的观测
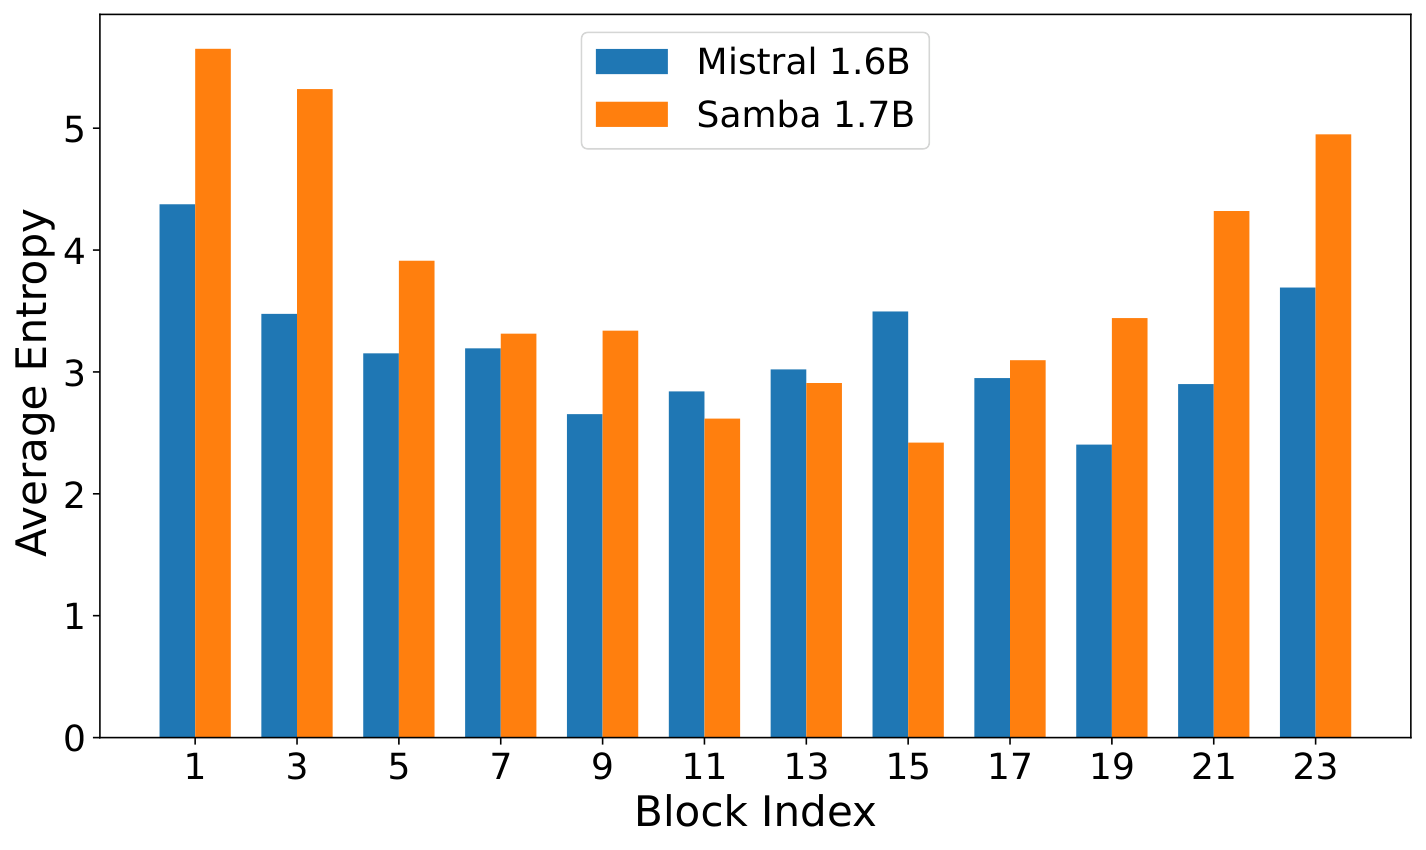
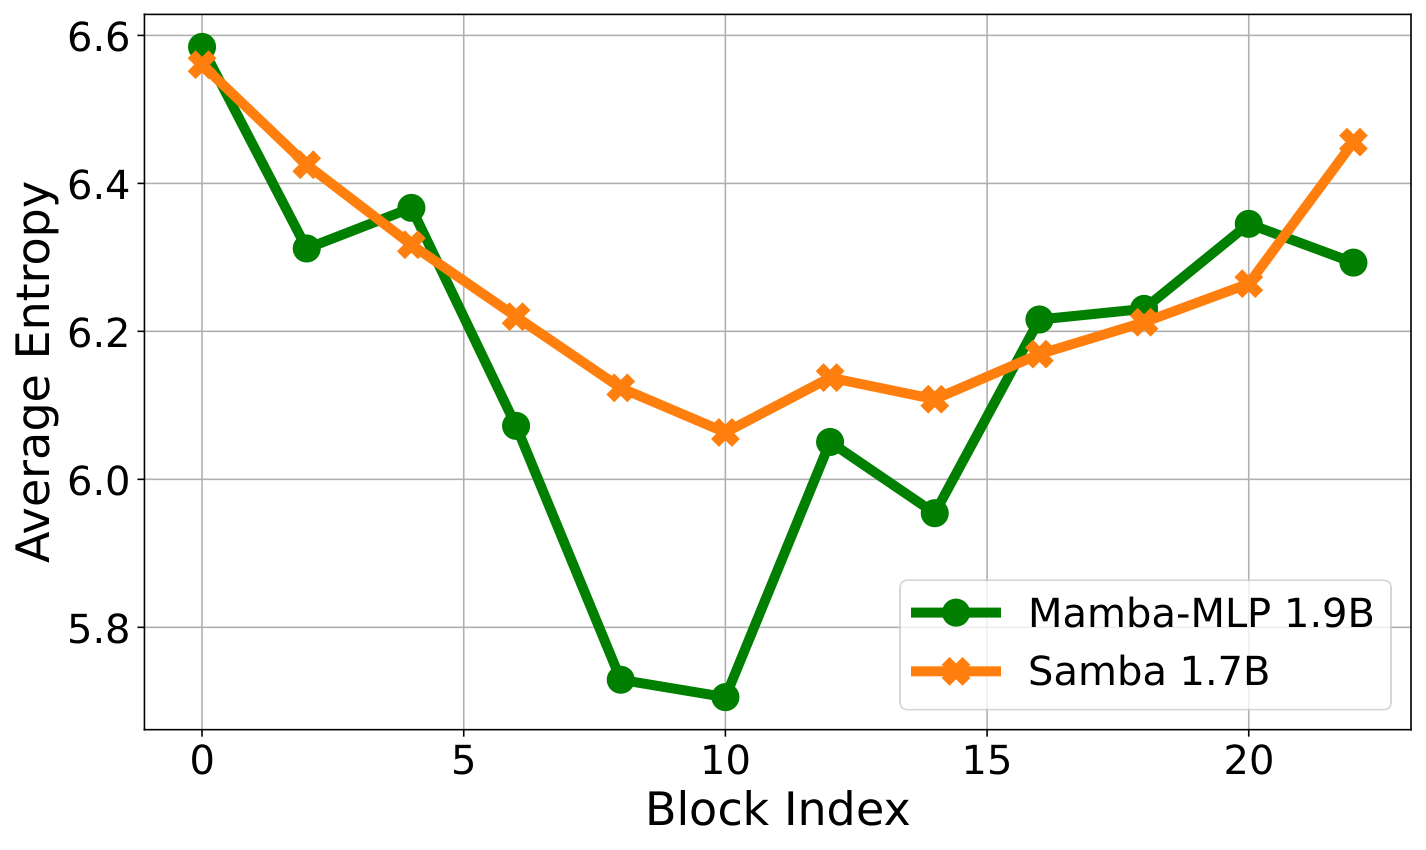
原文 Fig.5a–b,PDF p.10;100 个随机 GSM8K 样本。横轴为 block index,纵轴分别为注意力熵、S6 选择熵。
注意力熵在解码位置和头之间平均。沿用附录的符号 $A_{ijk}$ 表示第 $i$ 个头、第 $j$ 个 query 对第 $k$ 个位置的注意力概率(此处 $A$ 不同于 Mamba 的衰减参数):
$h$ 是头数、$l$ 是生成长度。选择熵则先在时间维对每个通道的 $\Delta$ 归一化:
因此选择熵是从门控值构造的统计量,不是 SSM 实际保存信息量的直接度量,也没有包含所有后续衰减乘积。(Appendix E,PDF p.23。)
Samba 的注意力熵跨层变化较大,中间层较低、两端较高;相对 Mamba-MLP,它的中间 Mamba 层选择熵更高。作者的解释是:中间注意力层承担较精确的读取,使 Mamba 的输入选择可以更分散,专注于循环结构建模。这一解释与总体结果一致,但图中熵分布没有单独确定每个模块的因果功能。
4.7 附录补充:基座收益与 June 配方需要分别看
3.8B 基座,Table 7,PDF p.20。 TFM++ 与 Samba 使用相同数据、3.2T token 和预训练配方,是该表用于判断架构差异的关键对照。其他公开模型的数据和预算不同,只提供能力参照。
| 指标(↑) | TFM++ 3.8B | Samba 3.8B | 差值(分) |
|---|---|---|---|
| MMLU | 67.2 | 71.2 | +4.0 |
| HellaSwag | 76.6 | 77.4 | +0.8 |
| ARC-C | 53.8 | 55.7 | +1.9 |
| WinoGrande | 72.6 | 77.1 | +4.5 |
| TruthfulQA MC2 | 47.3 | 43.4 | −3.9 |
| GSM8K | 51.5 | 69.6 | +18.1 |
| HumanEval | 51.8 | 54.9 | +3.1 |
| 平均 | 60.1 | 64.2 | +4.1 |
GSM8K 提升为 18.1 个百分点,不是相对提升 18.1%;TruthfulQA 则有下降。此表 MMLU、GSM8K 为 5-shot,ARC-C 与 HellaSwag 使用 character-normalized accuracy,HumanEval 为 pass@1。表注将 GSM8K 标为 maj@1,附录生成配置采用贪心解码,不能与 Table 1 的 8-shot CoT 后训练数值混为一谈。
June 后训练,Table 8,PDF p.21。 两个 3.8B 模型采用相同 June 配方,在 chat mode 测试:
| 指标 | Samba (June) | Phi3 (June) |
|---|---|---|
| MMLU,5-shot | 69.0 | 67.2 |
| MMLU-Pro,0-shot CoT | 47.9 | 46.5 |
| ARC-C,10-shot | 87.8 | 86.8 |
| GPQA,0-shot CoT | 29.5 | 29.0 |
| GSM8K,8-shot CoT | 86.4 | 84.8 |
| HumanEval,0-shot | 70.1 | 66.5 |
| MBPP,3-shot | 71.7 | 70.0 |
| 平均 | 66.1 | 64.4 |
七项都改善,平均提高 1.7 分。原始配方的 Samba-3.8B-IT 在 MMLU 为 71.9、HumanEval 为 62.8,而 June 版分别为 69.0、70.1:两组结果反映不同后训练配方,不是同一个模型的重复测量。
五:结论——这篇论文真正改变了什么认识
Samba 给出的可复用设计是:以固定状态承载跨时间的信息,以有限窗口保留可精确读取的细节,再为两种混合器分别提供非线性变换。 在论文匹配数据与配方的实验中,这种组合能提高多项下游质量,并把相对全注意力的长序列推理成本显著降低。训练效率的分析还说明,模块配比和矩阵运算密度与渐近复杂度一样值得关注。
它最有价值的边界也很具体:更好的 PPL 外推没有自动产生更好的零样本检索;单条信息的远距离保留没有自动产生多条信息的容量与迁移能力;固定排列也没有在每个任务上优于其他混合方式。标题中的“unlimited”适合用来描述固定历史缓存的流式计算路径,实验上则应分别记住 1M 的预测评测、256K 的专门微调 Passkey、约 8K 的高负载 Phonebook,并保留三者不同的模型规模与训练条件。
从方法研究角度,后续最值得区分的两个问题是:怎样在普通预训练中自然学到有效的选择性记忆,以及怎样让这种记忆在目标数量和查询形式变化时仍能复用。论文的 Passkey—Phonebook 对照为这两个问题提供了比单一长上下文数字更有信息量的起点。