YOCO:You Only Cache Once 中文精读笔记
- 论文:You Only Cache Once: Decoder-Decoder Architectures for Language Models。
- 作者:Yutao Sun、Li Dong、Yi Zhu、Shaohan Huang、Wenhui Wang、Shuming Ma、Quanlu Zhang、Jianyong Wang、Furu Wei;Microsoft Research / Tsinghua University。
- 版本:arXiv:2405.05254v2,2024-05-09;获取与研读日期:2026-09-20。
- 材料:同版本原文 PDF;作者
main.tex、引用的settings.tex与符号宏、原始图件。已阅读正文 §§1–5 和附录 A–G,并用 PDF 核对编号、公式及结果。PDF 共 20 页,以下页码均为从 1 起计的 PDF 页码,与印刷页码一致。未执行作者源码,也未复现实验。
论文总览
YOCO 将语言模型分成前后两个因果解码器:前半段 self-decoder 用高效序列模块生成上下文化表示,再投影出唯一一份全局 KV 缓存;后半段 cross-decoder 的所有层共享这份缓存,各层只更新自己的 query 和隐状态。这样仍可对全部历史 token 做精确的 softmax attention,却不必给每一层保存独立的全长 KV。
这里的“once”指全局 KV 只保存一份,不是整个模型没有其他状态,也不是生成时只计算一次 attention。self-decoder 仍维护各层的固定大小递推状态或滑窗缓存;每个新 token 都要经过两部分,并把新 KV 追加到共享缓存。
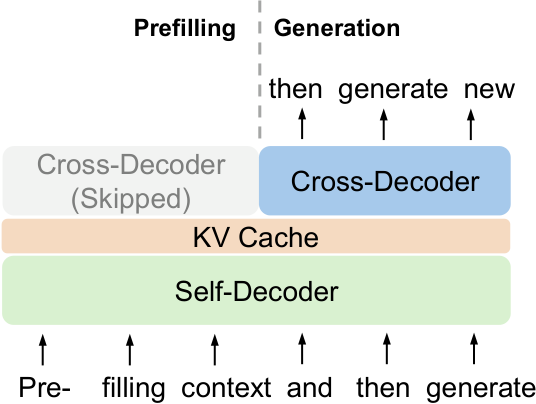
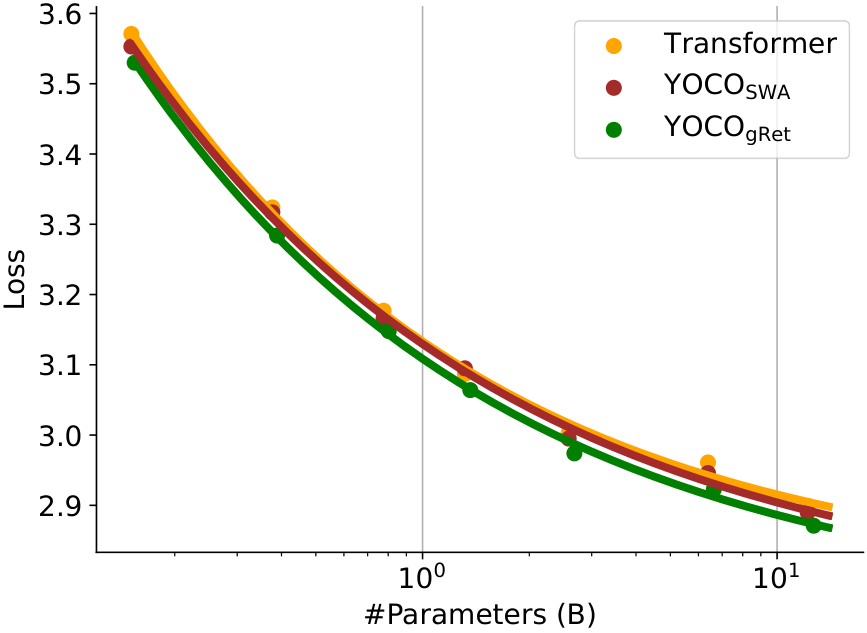
最有力的贡献是计算依赖关系的改变:历史 token 的 cross-decoder 输出不再是未来生成所需的缓存,所以构建提示词缓存时可跳过这些输出。默认 3B 配置下,作者报告 1M 长度总推理显存约 12.4 GB,相对 Transformer 降低约 9.4 倍;512K 情境下预填充从约 180 秒降到不足 6 秒。与此同时,3B 下游任务与 160M–13B 的固定 token 预算实验显示质量具有竞争力。这些结果分别来自不同实验,不能合并成“任意规模、任意任务均更快更准”。
结构地图
| 原文章节 | 解决的问题 | PDF 定位 |
|---|---|---|
| 1 Introduction | KV 内存和长提示词延迟瓶颈 | p.2 |
| 2 You Only Cache Once (YOCO) | 双解码器、共享缓存、推理依赖 | pp.3–5;图2–3、表1–2、式1–3 |
| 3 Design Choices of Self-Decoder | gRet 的三种形式与滑窗替代 | pp.5–6;式4–8 |
| 4.1 Language Modeling Evaluation | 3B、万亿 token 训练后的质量 | p.7;表3 |
| 4.2 Scalability Compared with Transformers | 160M–13B 扩展曲线 | pp.7–8;图4 |
| 4.3 Long-Context Evaluation | 单针、多针和长序列 NLL | pp.8–9;图5–6、表4 |
| 4.4 Inference Advantages | 显存、容量、prefill、吞吐 | pp.9–11;图7–10 |
| 5 Conclusion | 总结与尚未验证的应用设想 | pp.11–12 |
| A Chunk Parallelism for Long-Sequence Training of YOCO | 分块通信 | p.16;图11 |
| B Chunk-wise Representation of Gated Retention | 等价展开 | pp.16–17;式9–11 |
| C / D / E Hyperparameters… | 3B / 扩展曲线 / 长度扩展配置 | pp.17–18;表5–7 |
| F Pseudo Code of Gated Retention | 三种计算形式的伪代码 | pp.18–19 |
| G Comparisons with Transformer Variants | 联想召回与长任务诊断 | pp.19–20;表8、图12 |
一:动机——把逐层存储的历史改成共享记忆
常规自回归 Transformer 缓存每层历史 token 的 K、V,使下一步不用重算前缀。但随上下文长度 $N$ 和层数 $L$ 增长,缓存近似按 $LN$ 增长。GQA 降低 KV 头数,却没有移除层数因子。长提示词还需要在许多层中进行大规模因果 attention,导致很长的首次响应等待。
纯递推模型能够用固定大小状态压缩历史,但精确记住具体历史细节并非无代价。YOCO 的取舍是让前半部分使用高效递推或局部处理,同时为后半部分保留逐 token 的全局可寻址记忆。因此它不是把整个上下文都压成一个状态,也不是普通 encoder-decoder:两个部分都施加因果约束,输入和生成 token 都使用整套参数。(§§1–2,pp.2–4)
二:方法——先建一次记忆,再多层查询
2.1 数据流与基本块
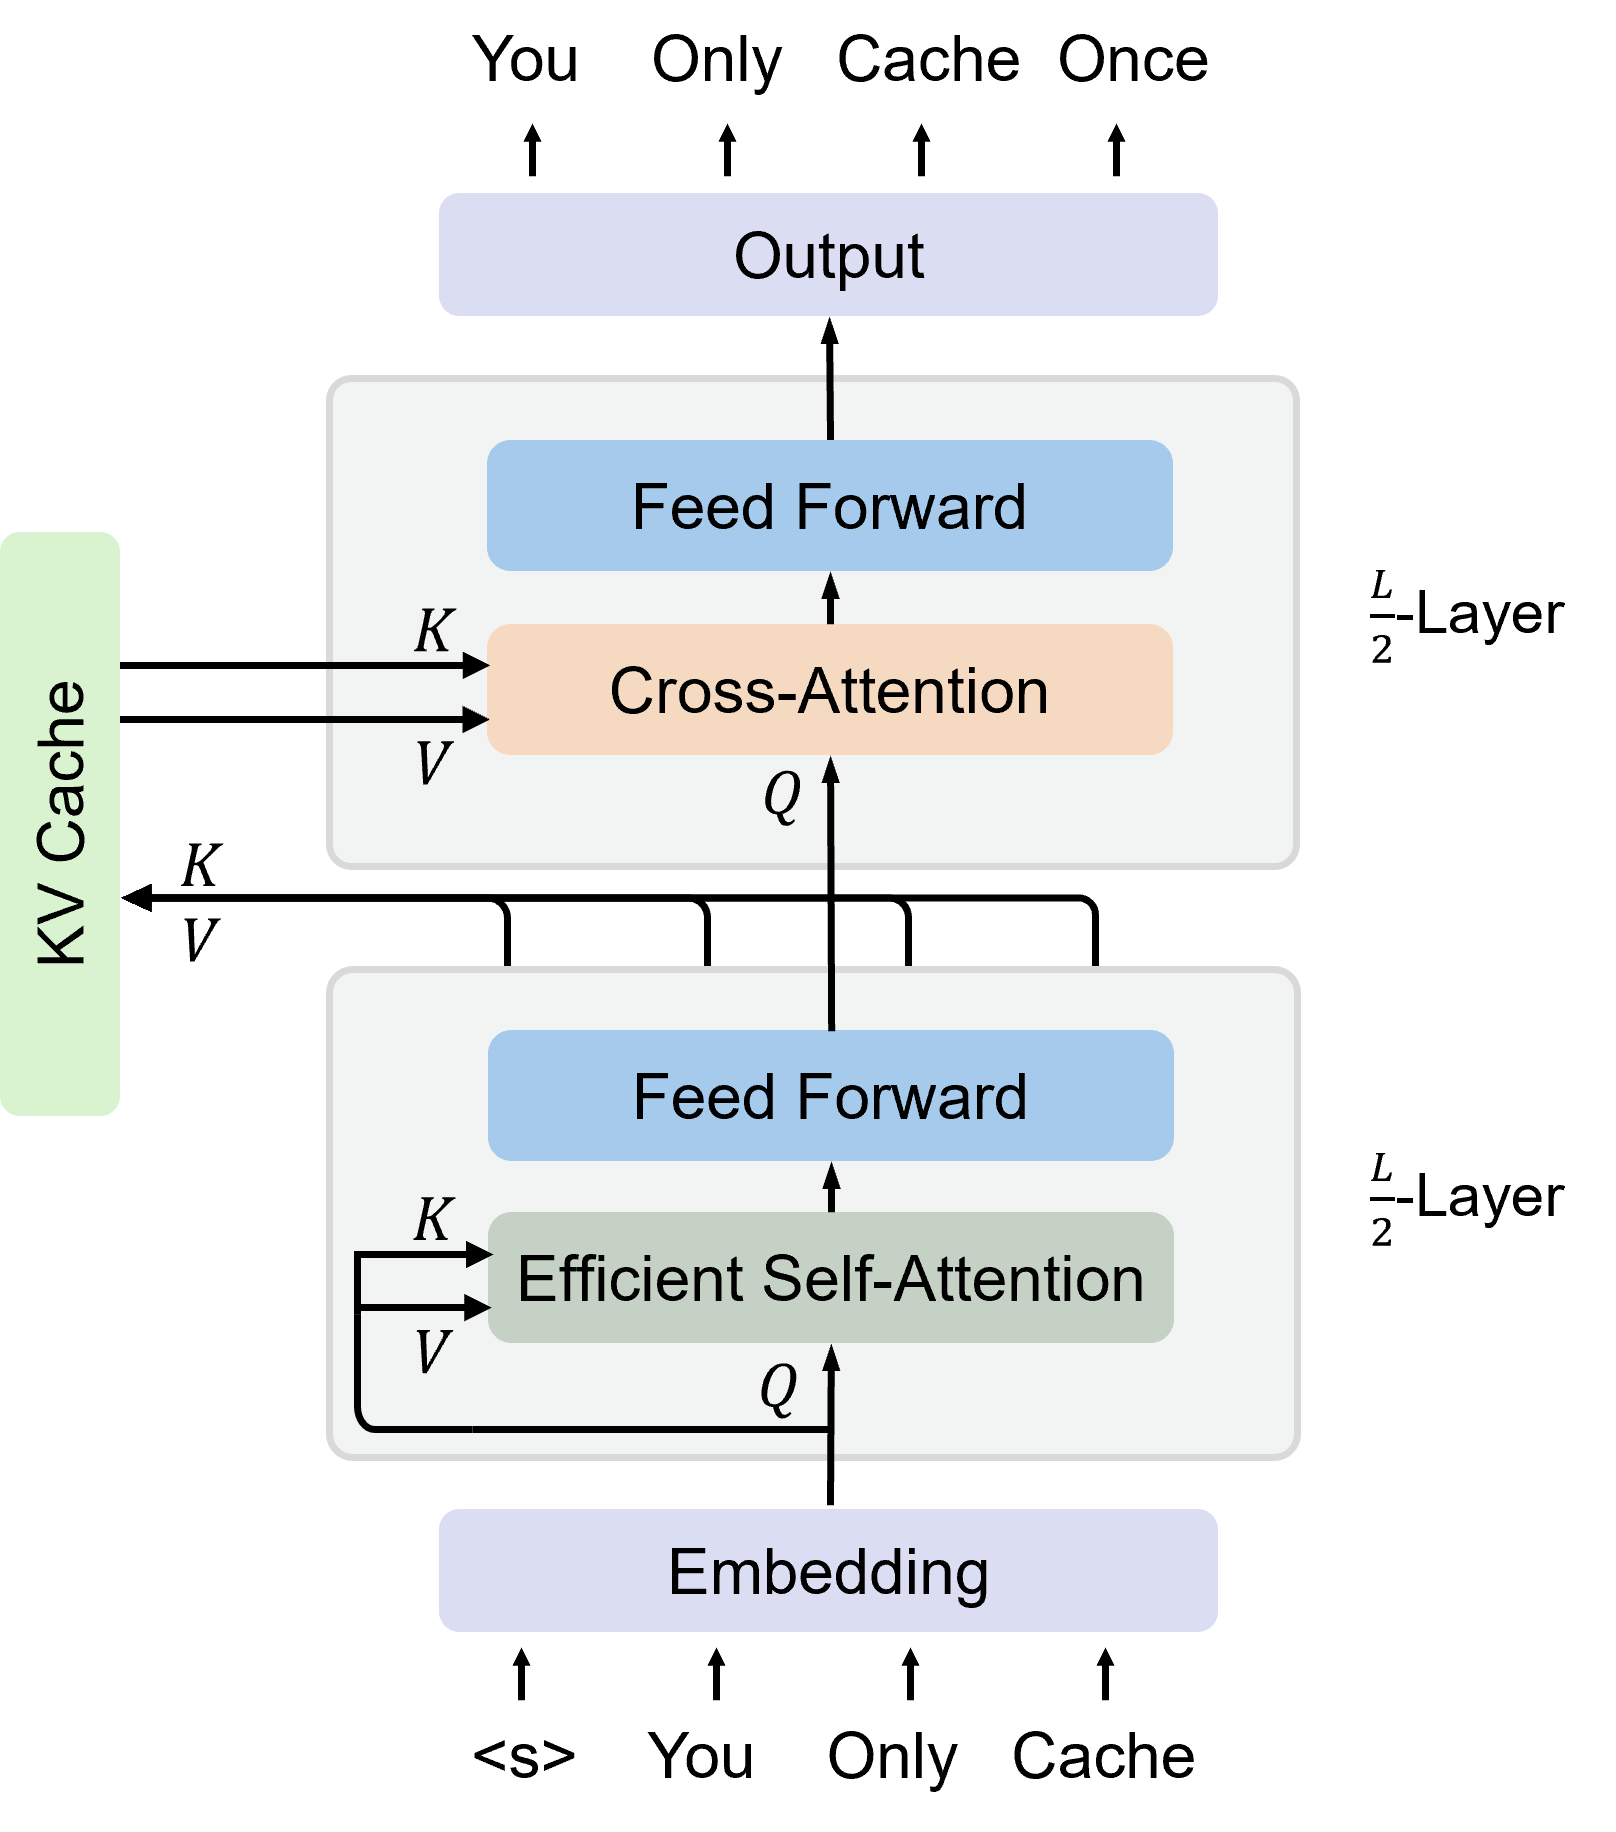
来源:图2,PDF p.3,作者原始图件。自下向上看,前 $L/2$ 层产生共享 KV,后 $L/2$ 层的 query 随深度改变,K/V 则来自同一位置的 self-decoder 输出。图中的“共享”不表示各层的 attention 分布相同。
| 符号 | 含义与形状(简化为未展开多头) |
|---|---|
| $X^0$ | $N\times d$ 的 token embedding |
| $L$ | 总层数,前后各半 |
| $M=X^{L/2}$ | self-decoder 输出,$N\times d$ |
| $\hat K,\hat V$ | 全局共享 KV;采用 GQA 时实际宽度由 KV 头数决定 |
| $\hat Q^l$ | cross-decoder 第 $l$ 层独立计算的 query |
| $C$ | 滑动窗口长度,固定超参数 |
| $S_n$ | gRet 单头递推状态,形状 $d_k\times d_v$ |
前半部分是 pre-RMSNorm + efficient self-attention(ESA)+ 残差,再接 RMSNorm + SwiGLU + 残差:
$$Y^l=\operatorname{ESA}(\operatorname{LN}(X^l))+X^l,$$$$X^{l+1}=\operatorname{SwiGLU}(\operatorname{LN}(Y^l))+Y^l.$$这里 LN 实际使用 RMSNorm。SwiGLU 为 $(\operatorname{swish}(XW_G)\odot XW_1)W_2$。前半部分的关键约束是推理状态不随 $N$ 增长。(式1,p.3)
交界处只投影一次:
$$\hat K=\operatorname{LN}(M)W_K,\qquad \hat V=\operatorname{LN}(M)W_V.$$后半部分每层计算:
$$\hat Q^l=\operatorname{LN}(X^l)W_Q^l,$$$$Y^l=\operatorname{Attention}(\hat Q^l,\hat K,\hat V)+X^l,$$$$X^{l+1}=\operatorname{SwiGLU}(\operatorname{LN}(Y^l))+Y^l.$$Attention 使用因果 mask,且支持 GQA。顶层输出接 next-token 分类器。因果 mask 必不可少:训练时虽然把整段 KV 都算出来,位置 $n$ 仍只能读取 $m\le n$ 的缓存。(式2–3,p.4)
2.2 默认 self-decoder:门控保留机制(gated retention, gRet)
gRet 给 Retention 加上由当前输入决定的逐头衰减门。忽略 batch 和 head 维度,原文式4定义:
$$Q=(XW_Q)\odot\Theta,\quad K=(XW_K)\odot\bar\Theta,\quad V=XW_V,$$$$\Theta_n=e^{in\theta},\qquad \gamma=\operatorname{sigmoid}(XW_\gamma)^{1/\tau},$$$$D_{nm}=\begin{cases}\prod_{i=m+1}^{n}\gamma_i,&n\ge m,\\0,&n同一运算可递推计算(式5,p.5):
$$S_n=\gamma_nS_{n-1}+K_n^\top V_n,\qquad O_n=Q_nS_n.$$状态的维度不随序列长度增长,但每层每头都需要一份。固定内存指固定于长度,不是与层数和头维度都无关。 展开递推可见,旧 token 的外积恰好乘上从它之后到当前的所有门值,因此与并行形式等价。
教学例子:$S_0=0$ 时,$S_2=\gamma_2K_1^\top V_1+K_2^\top V_2$。第一个 token 被遗忘多少取决于第二步门值;当前 token 没有额外衰减。
多头实现将各头结果拼接,做逐头 GroupNorm,再通过 swish 输出门和 $W_O$。这些归一化与门控也是完整模块的一部分,单写 $Q_nS_n$ 不是完整网络层。(式7,p.6)
2.3 分块计算:训练并行与推理递推的桥梁
逐 token 递推不利于 GPU 并行;直接构造整个 $N\times N$ 衰减矩阵又昂贵。分块做法在块内并行、块间递推,prefill 和长序列训练采用这一形式;逐 token generation 使用递推形式。
下面是本次从式4–5重新推导、统一行列约定后的教学写法,不是逐字照抄式6。块起点为 $a=(i-1)B$,定义 $\beta_j=\prod_{t=1}^{j}\gamma_{a+t}$,并令 query 对应行 $j$、key 对应列 $k$:
$$D^{(i)}_{jk}=\mathbf1_{k\le j}\frac{\beta_j}{\beta_k},$$$$O_{[i]}=(Q_{[i]}K_{[i]}^\top\odot D^{(i)})V_{[i]}+\operatorname{diag}(\beta)Q_{[i]}R_{i-1},$$$$R_i=\beta_B R_{i-1}+\sum_{k=1}^{B}\frac{\beta_B}{\beta_k}K_{a+k}^\top V_{a+k}.$$第一项是当前块内的因果历史,第二项是前面所有块的压缩状态。状态更新中,每个块内 token 需衰减到块末。这样 $R_i=S_{iB}$,等价性直接来自把总和按当前块与旧块拆开。
原文核验提醒:式6(p.6)把 $D_{[i]}(j,k)$ 写成 $j\le k$ 时 $\beta_k/\beta_j$;按紧随其后的 $QK^\top$ 常规行列约定,这与式4的因果方向不一致。附录 B(pp.16–17)还有 $n$ 与 $n-1$ 乘积上界及指标混用;附录 F(p.18)伪代码把已赋值的 gt 写成了未定义的 g。这些材料适合理解思路,不能直接当作已验证实现。重实现时应以式4–5为依据,对三种形式做数值等价测试;本次未运行作者实现验证。
2.4 替代选择:滑动窗口 attention(SWA)
只允许 $i-C 来源:图3,PDF p.4,作者原始图件。提示词首先经过 self-decoder 填充共享 KV;历史提示词位置的 cross-decoder 输出无需保存。生成时,当前位置的 query 在上半部分逐层更新并读取全局 KV。 通常 next-token logits 仍需要提示词最后一个位置的 cross-decoder 计算。省掉的是全部历史位置的上半段批量计算,不是完全不用上半段就能预测第一个 token。 训练若要对所有位置计算 loss,也仍需所有相应输出。原文 §1 p.2 有一句写成“进入 self-decoder 前退出”,与图3和 §2.3 相矛盾;此处依据具体计算图与 §2.3,正确位置是进入 cross-decoder 前。 表1–2(p.4)是简化复杂度,不能把 $D$ 当成包含全部实现细节的精确字节公式。gRet 状态实际为逐头矩阵;若头维度也视为变量,必须显式计入它的乘积。参数、FFN、临时激活和通信同样影响实际成本。YOCO 没有消除 generation 阶段读取长 KV 的成本,也没有把训练中的全局 attention 自动变成线性。 把序列分块放在不同设备。self-decoder 在设备边界传递递推状态或必要的局部窗口;cross-decoder 的共享 KV 只需一次 all-gather,而非每一层重复收集。图11解释了通信依赖的简化,但正文未提供独立的通信带宽或端到端训练加速消融,不能直接赋予一个训练加速倍数。 3B 模型:26层、隐藏维度3072、FFN8192、24个Q头/8个KV头、head dimension 128,非embedding参数2.83B;训练长度4096、batch 4M token、AdamW $(0.9,0.95)$、峰值学习率 $3.2\times10^{-4}$。5T 是学习率日程目标,实际只训练1.6T。(表5,p.17;§4.1) 参数扩展实验不是上述3B训练的缩小版:长度2048、batch 0.25M token、40k steps、AdamW $(0.9,0.98)$,通过 FFN 宽度对齐参数:Transformer 为 $8d/3$,YOCO 为 $3d$;gRet head dimension 为256。图4不能被解释成各规模均训练充分的 compute-optimal scaling 证明。(附录D,pp.17–18) 推理 baseline 已包含 GQA、Flash-Decoding 和 kernel fusion;YOCO 的 gRet 使用 Triton 内核,chunk size 256,在 H100-80GB 硬件上测试。论文未给出足以完全重建每个长度的 batch、并行设备配置、计时重复次数及误差区间。引言的7B、4卡背景例子不能当成§4.4默认3B实验配置。 八项是 ARC-C、ARC-E、BoolQ、HellaSwag、OBQA、PIQA、Winogrande、SciQ;表中为原文分数口径,未充分注明各任务的归一化细节。StableLM-3B-4E1T 的多项结果缺失,因此没有可比的完整平均分,不能补算成0分。 质量并非每项都赢:1T 时 YOCO 的 BoolQ 为0.645,低于 OpenLLaMA 的0.657;HellaSwag 为0.689,低于0.700。1T到1.6T也有个别任务回落。公开模型的数据、tokenizer与训练过程不是严格统一的,所以这些结果支持“有竞争力”,不能单独隔离出架构的因果收益。延长上下文后的0.645也混合了额外训练效应。 横轴为非embedding参数规模,纵轴为验证loss,越低越好;不同曲线分别对应 Llama 风格 Transformer、YOCO-SWA 和 YOCO-gRet。相同10B token条件下,YOCO在160M–13B保持竞争力,gRet变体整体更好。作者把收益解释为 attention 与 retention 的归纳偏置互补,并提到1:3交错混合也有类似现象;这不是共享缓存本身带来所有质量收益的严格消融证明。图中未配完整原始点表或多种子误差线,本笔记不从图像臆造精确差值。 长度扩展配置(表7,p.18): 共额外11.5B token;上采样超过目标训练长度的长文档。不是直接把4K模型零训练外推到1M。 来源:图5,p.8。横轴为上下文长度,纵轴为插入深度,颜色为准确率;城市名与magic number组成needle,每个深度/长度配置重复10次取均值。近乎全绿说明此合成单针任务表现接近满分,不等于百万长度的多步推理或文档综合理解已解决。 多针结果是在 128K 下测得(表4,p.8),$N$ 为needle数而不是上下文长度: YOCO在4针上突出,但8针低于LWM且与MiniCPM持平;因此作者“优于”部分模型的整体概括不能解释为每个needle数都严格更好。不同模型规模、长度训练与数据也不同。 图6(p.9)的书籍和repository-level代码实验选择超过1M token的验证样本,报告随已处理长度变化的累积平均负对数似然 NLL,越低越好。两组总体下降,支持模型利用长距离信息的解释;但这不是固定同一预测位置、只改变可见历史的受控曲线,累积平均还混入位置与样本难度的变化。原文段落标题提到perplexity,实际图注指标是NLL,两者不能直接混用。 来源:图7a,p.10。横轴长度、纵轴GB;绿色YOCO随长度增长较慢,橙色Transformer增长明显。插图显示32K也有收益。这里是权重、激活和缓存的总量,不是只测KV。 65B 情况下,1GB缓存约能容纳YOCO的128K token,对比Transformer的1.6K;这不是说1GB就能加载65B模型权重。总显存收益小于KV倍数,因为权重等部分还存在。 prefill优势来自跳过历史位置的cross-decoder,以及self-decoder高效计算。吞吐优势还来自显存节省允许更大batch。9.6×不是固定batch的单步decode加速,也不等于每个生成token延迟缩短9.6×。 论文的测量细节不足以脱离其内核和硬件直接外推服务SLA。 附录G.1(p.19)比较160M、12层、隐藏维度768的模型。H3是含两层attention的混合版;Mamba采用其double-SSM布局;RetNet和gRetNet调整value及FFN维度以匹配参数。 原文表8将这些指标称为perplexity,此处保留原名与数值,不自行取指数或改标loss。AR-Hit针对上下文中出现过的bigram续写,衡量联想召回;First-Occur偏向不能直接从上下文重现的预测。YOCO两种分组均有竞争力,且相对纯gRetNet的AR-Hit差距更明显,支持“保留可寻址全局记忆有用”的解释;仍不构成对所有状态空间模型的普遍判断。 附录G.2(p.20)继续训练2B token、长度16,384,考察ZeroSCROLLS的Qasper、GovReport、QMSum、NarrativeQA。图12横轴为输入长度、纵轴为答案perplexity;YOCO与Transformer整体较好。Sparse Transformer保持2,048窗口且不改RoPE base,这个对照与其他模型长度扩展方案不同。评估的是答案语言建模分数,不是四项任务的生成准确率或ROUGE。 可靠结论是:共享跨层全局KV在保持全局attention的同时,改变了缓存与prefill的依赖结构;在本论文评估范围内,质量具有竞争力,长序列部署成本显著下降。论文把“高效压缩状态”和“逐token外部记忆”组合起来,而非只选择其中之一。 主要边界如下: 作者提出YOCO+BitNet+Groq、多模态多self-decoder、KV压缩/索引以及预缓存支持RAG等方向(§5,pp.11–12)。这些是展望,不是本论文已经完成的实验。 本次分析建议的后续实验:在同数据与token预算下单独消融“共享KV”和“gRet混合”;固定batch测prefill、首token与单步decode;在固定目标位置比较不同可见历史长度;用小张量检查并行、递推、分块形式及梯度的一致性。这些建议未在本次研读中执行。 本笔记基于同版本作者源码与PDF,不是全文翻译;英文幻灯片见 slides.en.pdf,可编辑源文件见 slides.en.tex。图件来自作者原始资源,PDF图仅转为PNG供Markdown显示,没有生成或修改实验数据。2.5 为什么可以提前结束 prefill
项目 Transformer YOCO 适用前提 KV / 状态内存 $O(LND)$ 原文表1:$O((N+L)D)$ 固定窗口、头维度等隐藏常数 更明确的缓存数量 $O(LN)$ $O(N+CL)$ SWA 情况,且长序列时 $N\gg CL$ prefill attention 计算 $O(LN^2D)$ 表2:$O(LND)$ 使用高效模块和提前退出 2.6 分布式训练(附录 A,p.16)
三:实验——分清四种不同证据
实验 对象和协议 指标及比较角色 §4.1 训练 token 扩展 3B gRet,训练至1.6T,保留1T checkpoint 8项 LM Eval Harness zero-shot 分数,越高越好;与公开预训练模型比实用质量 §4.2 参数扩展 160M、400M、830M、1.4B、2.7B、6.8B、13B,各10B训练token validation LM loss,越低越好;相同数据/训练设置的架构比较 §4.3 长上下文 3B继续训练到64K、256K、1M;无长指令微调数据 检索准确率↑、累积平均NLL↓ §4.4 部署 profiling 默认采用§4.1的3B配置,32K–1M,最后1,024 token作为生成 总推理显存↓、prefill秒数↓、含prefill与生成的吞吐↑ 四:结果——有效性与边界一起读
4.1 语言模型质量(表3,p.7)
模型 / 训练token 八项平均分↑ 对应比较 OpenLLaMA-3B-v2 / 1T 0.619 公开Transformer baseline StableLM-base-alpha-3B-v2 / 1T 0.612 公开Transformer baseline YOCO-3B / 1T 0.634 对以上分别高1.5和2.2个百分点 YOCO-3B / 1.6T 0.636 对自身1T高0.2个百分点 YOCO-3B-1M / 长度扩展后 0.645 又增加了长序列继续训练 4.2 参数规模扩展(图4,pp.7–8)
4.3 长上下文:检索、聚合、预测要分别判断
长度 继续训练token 学习率 RoPE θ 65,536 6B $8\times10^{-5}$ 640K 262,144 4B $4\times10^{-5}$ 5M 1,048,576 1.5B $2\times10^{-5}$ 80M 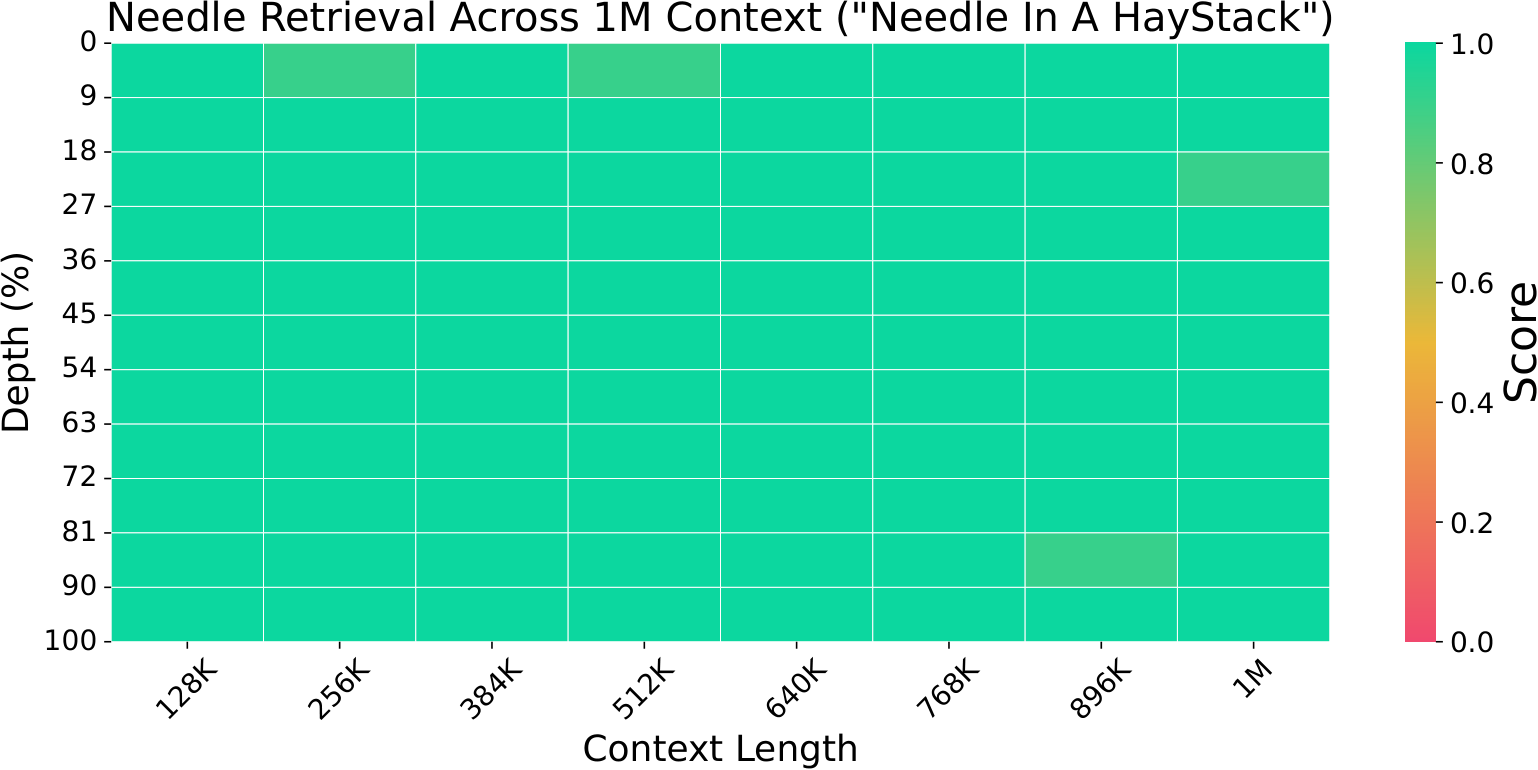
模型 1针 2针 4针 8针 YaRN-Mistral-128K 7B 0.02 0.12 0.08 0.20 LWM-1M-text 7B 1.00 0.90 0.76 0.62 MiniCPM-128K 2.4B 1.00 1.00 0.54 0.56 ChatGLM3-128K 6B 0.94 0.72 0.52 0.44 YOCO-3B-1M 3B 0.98 0.98 0.84 0.56 4.4 推理:最大的收益来自长提示词和缓存容量
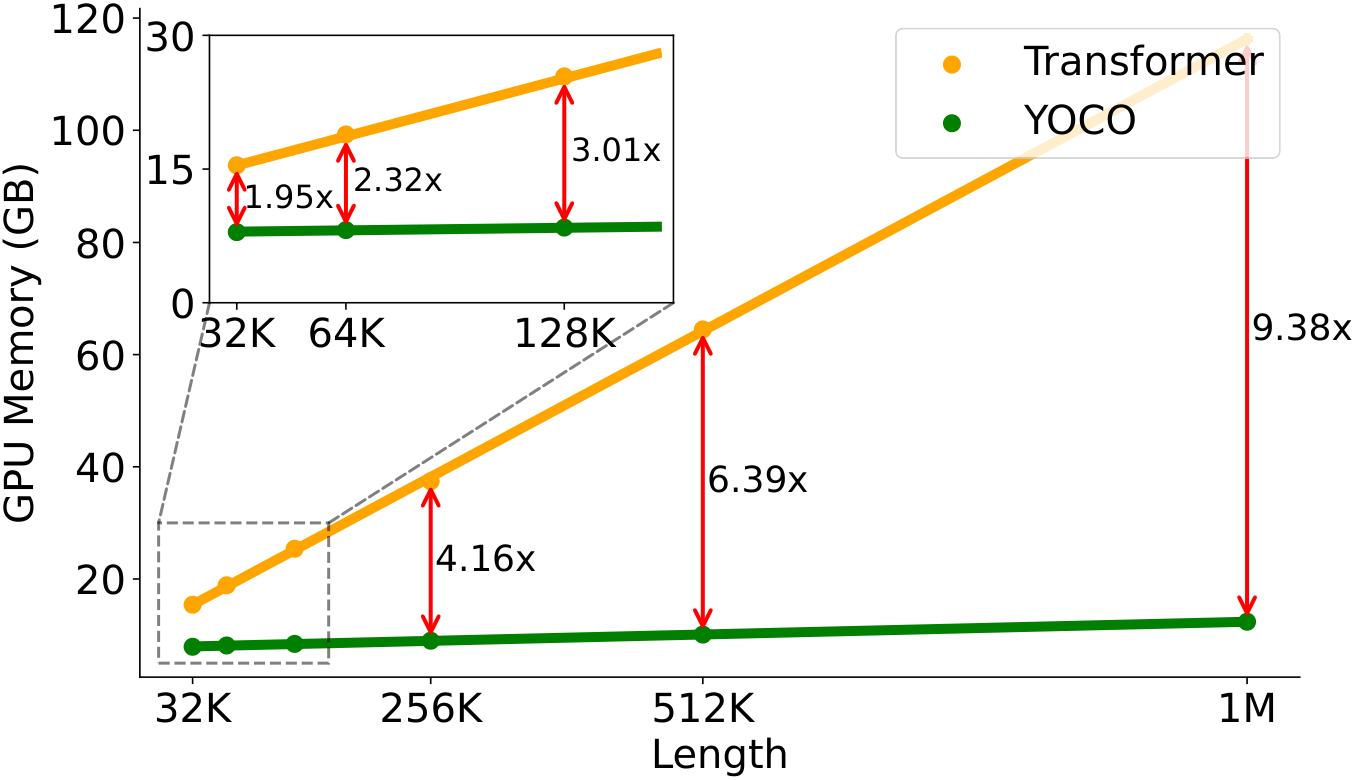
条件 原文结果 位置与注意点 3B、1M,总推理显存 YOCO 12.4GB;Transformer约9.4倍 图7/§4.4 p.10;图标注9.38× 3B、32K,总推理显存 约1.95×差距 图7插图;不等于26× 65B、每token KV内存 约80×减少 图8 p.10;是层数相关的缓存指标,不是总内存 32K,prefill 2.87×加速 图9 p.11 512K,prefill 约180秒→不足6秒 §4.4 p.10,图9标30.3× 1M,prefill 图9标71.82× p.11;引言四舍五入为71.8× 512K,总推理吞吐 4.5→43.1 token/s,约9.6× §4.4 p.11;包含prefill与生成 4.5 附录诊断:全局记忆为何有价值
模型 Valid. Set↓ AR-Hit↓ First-Occur↓ Mamba 3.645 1.555 4.126 RetNet 3.633 1.466 4.131 Hybrid H3 3.591 1.251 4.130 gRetNet 3.600 1.354 4.116 Transformer 3.564 1.219 4.104 YOCO-SWA 3.553 1.202 4.094 YOCO-gRet 3.530 1.199 4.067 五:结论、局限与值得继续追问的问题
研读交付范围