Mixture-of-Depths:动态分配 Transformer 计算的中文精读笔记
- 题名:Mixture-of-Depths: Dynamically allocating compute in transformer-based language models
- 作者:David Raposo、Sam Ritter、Blake Richards、Timothy Lillicrap、Peter Conway Humphreys、Adam Santoro。单位为 Google DeepMind;Blake Richards 同时署名 McGill University & Mila。Raposo 与 Santoro 标注 equal contribution。
- 版本:arXiv:2404.02258v1,提交于 2024-04-02;2026-09-08 查询时最新版本仍为 v1。本次获取与研读日期:2026-09-08。
- 材料:原文 PDF、作者主 TeX、源码清单。源码状态为
available,实际下载/src/2404.02258v1的源码包;读取唯一主文件main.tex的全部正文,并核对其图件和相关main.bbl条目。未执行或编译作者源码。 - 覆盖范围:正文 Sec. 1–5,Eq. (1),Fig. 1–7;PDF 共 14 页,正文至第 13 页,参考文献在第 13–14 页,无附录。本文页码均从 PDF 第 1 页开始,后续印刷页码与之相同。没有另行精读被引论文,也未进行训练复现。
- 配套成品:英文组会幻灯片 PDF、可编辑 Beamer TeX。下文公式推导、例子和评价性讨论均明确区分于原文结果。
论文总览
MoD(Mixture-of-Depths,混合深度)提出:给每个路由层固定数量的计算名额,再由可学习路由器决定哪些 token 使用这些名额。入选 token 参与该层的自注意力与 MLP;其余 token 保留残差状态,继续流向后续层。这样,每个 token 经历的有效计算深度随内容变化,而训练时昂贵计算的张量大小保持固定。
这篇论文最有说服力的结果不是“所有模型都能无损跳过绝大多数层”,而是:在给定训练总 FLOPs 的模型搜索中,交替使用完整层和低容量路由层,可以获得比最优稠密基线更好的损失—单次前向计算量折中。 最优损失点往往对应更大的 MoD;若目标是加快单步,则可以选较小的 MoD 工作点,维持与最优基线相近的损失。(Sec. 4.1,PDF pp. 7–10,Fig. 3–5。)
必须同时记住三项限定:训练 top-k 使用整段序列,直接用于逐 token 生成会违反因果性;12.5% 容量只作用于交替出现的路由层;主要效果指标是语言建模损失,论文未报告通用下游任务能力提升。
结构地图
| 原文章节 | 在论证中的作用 | PDF 页码与关键证据 |
|---|---|---|
| 1. Introduction | 静态预算、动态 token 分配的目标 | pp. 1–2;Fig. 1 在 p. 3 |
| 2. Background | 与 early exit、MoE、其他条件计算区分 | pp. 2–3 |
| 3. Implementing Mixture-of-Depths Transformers | 总体算法流程 | pp. 3–4 |
| 3.1. Defining a compute budget | 用 capacity 固定昂贵计算的输入规模 | p. 4 |
| 3.2. Routing around transformer blocks | 完整计算或残差旁路 | pp. 4–5 |
| 3.3. Routing schemes | token-choice 与 expert-choice | p. 5;Fig. 2 在 p. 6 |
| 3.4. Routing implementation | 线性路由器、top-k、加权残差更新 | pp. 6–7;Eq. (1) 在 p. 6 |
| 3.5. Sampling | 非因果 top-k 的两种预测替代方案 | p. 7 |
| 3.6. Training methods | 公开的基本训练设置 | p. 7 |
| 4.1. Training, isoFLOP comparisons | 容量消融、规模扫描、速度与路由分析 | pp. 7–10;Fig. 3 p. 8、Fig. 4 p. 9、Fig. 5 p. 10 |
| 4.2. Auto-regressive Evaluation | 因果预测路由的留出集效果 | p. 10;Fig. 6 在 p. 11 |
| 4.3. Mixture-of-Depths-and-Experts (MoDE) | 与 MoE 组合的两种方式 | pp. 10–11;Fig. 7 在 p. 12 |
| 5. Discussion | 计算分配的含义、Q/K/V 与记忆扩展 | pp. 11–13 |
| References | 相关工作来源 | pp. 13–14 |
一:动机
1.1 要解决的是计算分配,不只是减小参数量
标准 Transformer 对各位置执行相同的层结构,即使不同位置的预测难度、对后续上下文的贡献可能不同。作者希望减少不必要的计算,同时保留可预先规划的容量和张量形状。这里的“均匀计算”主要指相同的逐层处理方式;因果注意力中不同位置可访问的历史长度仍然不同。(Sec. 1,PDF pp. 1–2。)
MoD 把问题分为两部分:用户事先决定“总共处理多少个 token”,模型学习“选择哪几个 token”。这避免了把全局预算完全交给逐 token 决策,但仍保留了内容相关的分配自由度。
1.2 与相邻方法有什么差别
| 方法 | token 的选择 | 对理解 MoD 的帮助 |
|---|---|---|
| 稠密 Transformer | 每个 token 都执行每个 block | 基准计算模式 |
| Early exit | 一旦退出,后续层不再处理该 token | MoD 可跳过中间层、再进入更深层 |
| 常见 MoE | 路由至不同参数的 MLP expert | MoD 的主要选择是执行 block 或走恒等旁路 |
| MoD | 选定 token 执行注意力和 MLP | 同时改变哪些位置被更新、哪些位置能在该层提供 K/V |
这些是作者在 Sec. 2 中的概念定位,不是本文对所有相关方法的统一实测排名。CoLT5 也使用条件计算和 top-k,但本文聚焦 decoder-only 模型的顺序生成问题。(Sec. 2,PDF pp. 2–3。)
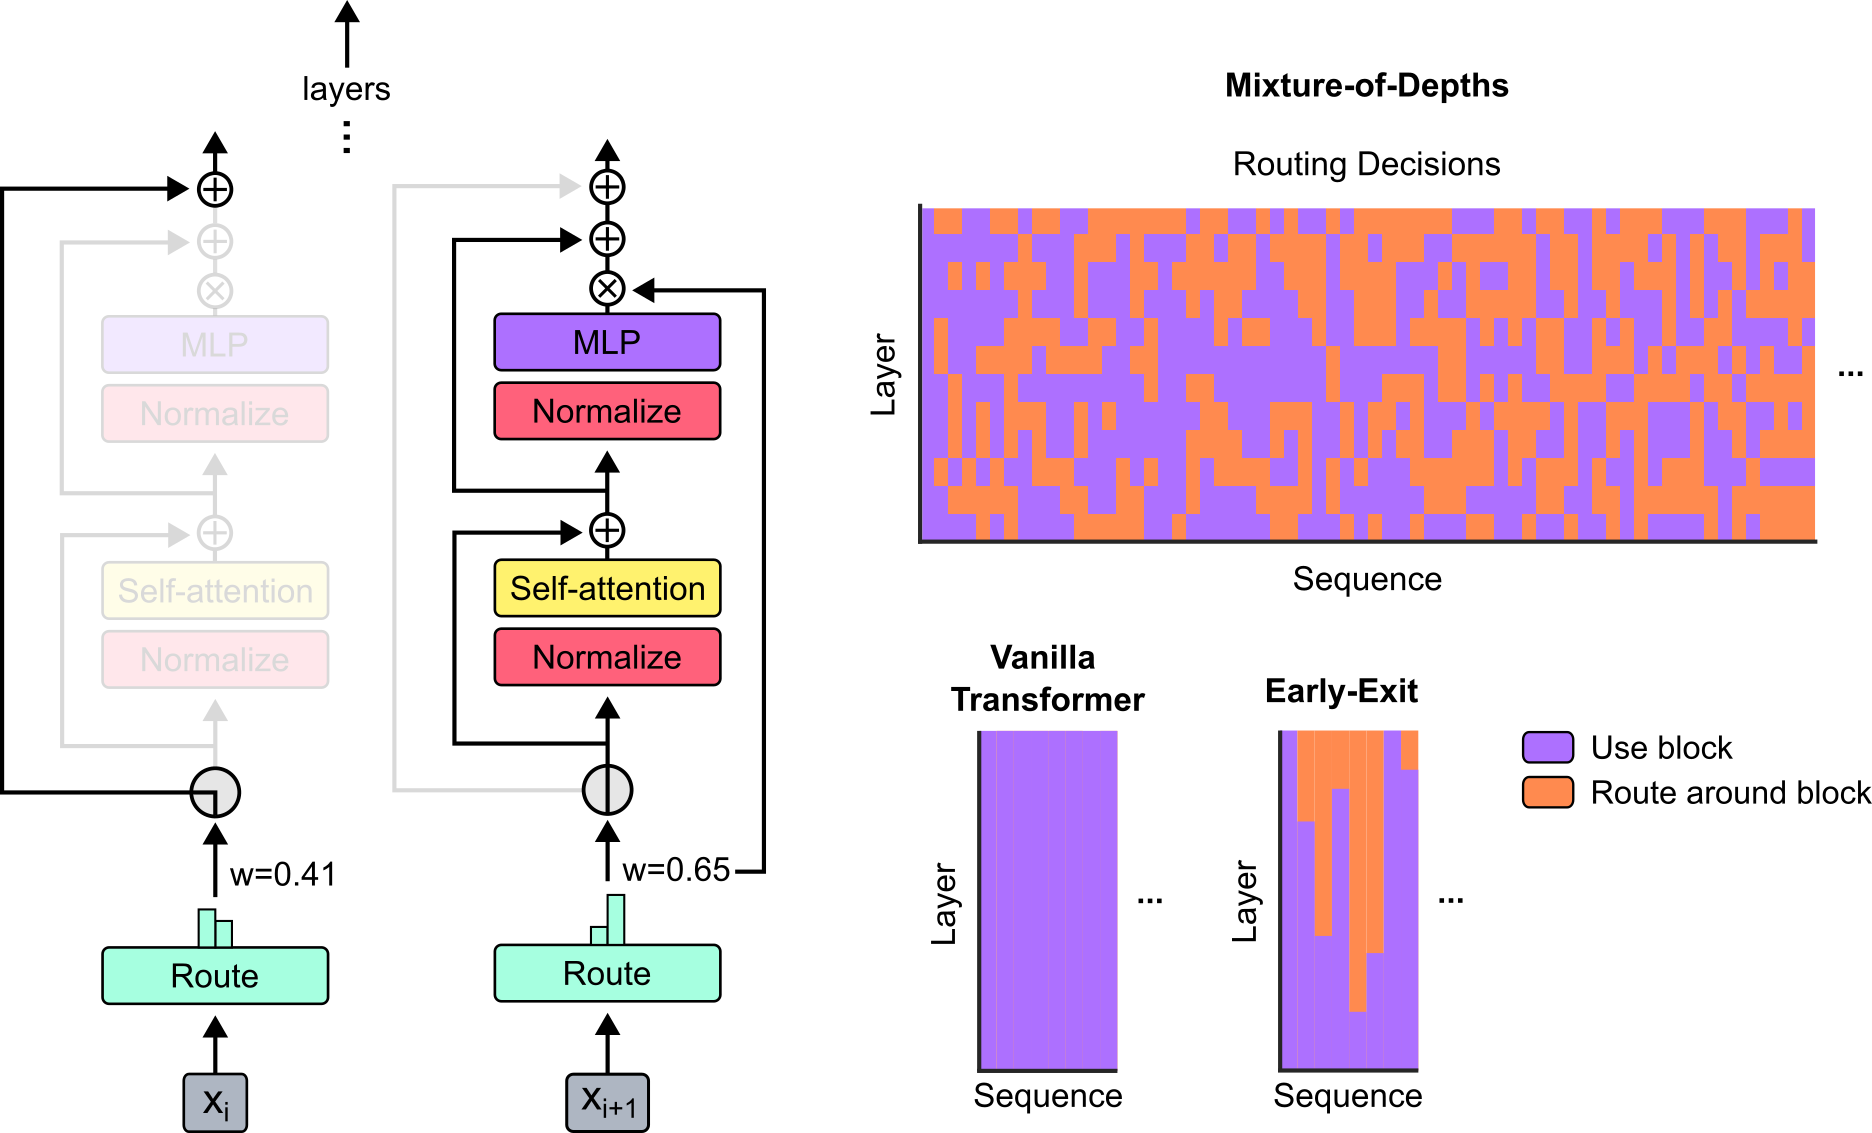
原 Fig. 1,PDF p. 3,作者原图。 左侧比较旁路与执行 block;右上横轴是序列位置、纵轴是层,紫色代表执行,橙色代表旁路。沿同一列观察,可看到一个 token 在跳过中间层后仍进入后层。右下是稠密处理和 early exit 的对照示意。该图展示结构差异,不能单独证明路由学到的是语义重要性。
二:方法
2.1 输入、计算和输出
每个路由层接收完整序列的隐状态,执行以下过程:
- 对所有位置计算一个标量路由分数。
- 在每条序列、每个路由层内部选取分数最高的 $C=k$ 个 token。
- 收集这些 token,执行该层的因果自注意力和 MLP;只在入选集合内部构造该层的注意力。
- 将更新乘以路由权重,加回入选位置;未入选位置保持输入状态。
- 输出仍包含原序列的全部位置,后续层重新作出路由决定。
因此,“没有参与该层计算”不等于“从序列中永久删除”。跳过的 token 仍保留隐状态,但不会在这一层贡献新的 K/V;完整层及后续入选层提供再次交换信息的机会。(Sec. 3.2–3.4,PDF pp. 4–7;Sec. 5,p. 12。)
2.2 关键符号与原文公式
| 符号 | 含义与维度 |
|---|---|
| $S$ | 单条序列长度 |
| $l,i$ | 层索引、序列位置 |
| $x_i^l\in\mathbb R^d$ | 位置 $i$ 的输入隐状态;$d$ 表示隐维度 |
| $X^l$ | 全部 $S$ 个 token 的隐状态,可视为 $S\times d$ 张量 |
| $w_\theta\in\mathbb R^d$ | 该层线性路由器参数;原文未显式给它添加层上标 |
| $r_i^l=w_\theta^T x_i^l$ | 标量路由分数,原式不是概率分布 |
| $C=k$ | 每条序列的容量,即入选 token 数 |
| $R^l$ | 本层全部路由分数的集合 |
| $\beta=1-C/S$,$P_\beta(R^l)$ | 用于刻画 top-k 的分位数阈值 |
| $\tilde X^l$ | 入选的 $C$ 个 token 的状态 |
| $f_i(\tilde X^l)$ | 注意力与后续 MLP 对应的 block 更新,维度为 $d$ |
原文 Eq. (1) 为:
它表达的是“是否更新”和“更新多大”两个作用:top-k 决定离散参与集合,$r_i^l$ 乘在更新上,让语言建模损失能够沿连续路径优化路由器。这不意味着 top-k 的排序和索引操作本身变成可微。 对固定入选集合的局部分析,入选位置有 $\partial x_i^{l+1}/\partial r_i^l=f_i(\tilde X^l)$;这是解释梯度路径的教学推导。(Sec. 3.4,PDF pp. 6–7。)
原式没有写出分数等于阈值的分支,也没有给出并列分数规则。实现时需要确定的 top-k 索引和 tie-breaking;本笔记不将分位数写法当作完整边界处理。原文 Sec. 3.1 的 $T$ 包含批内 token 总数,Sec. 3.4 则明确按单序列的 $S,C$ 定义路由。下文按后者解释,避免误以为不同样本之间执行自注意力。
2.3 为什么采用 expert-choice
Token-choice 让各 token 独立选择路径,可能出现大量 token 同时选择昂贵路径;静态实现需要容量、填充或丢弃策略。Expert-choice 让计算路径选取 top-k,直接填满预定容量,无需另设负载均衡损失。
一般多 expert 的 expert-choice 可能让同一 token 被多个 expert 选择,或一个都没选中。MoD 只有一个昂贵路径,其余位置全部走残差,因此计算与旁路构成互斥且完整的划分。后面为生成加入的辅助分类损失不属于负载均衡损失;“无需负载均衡损失”不等于“训练没有任何辅助损失”。(Sec. 3.3,PDF p. 5。)
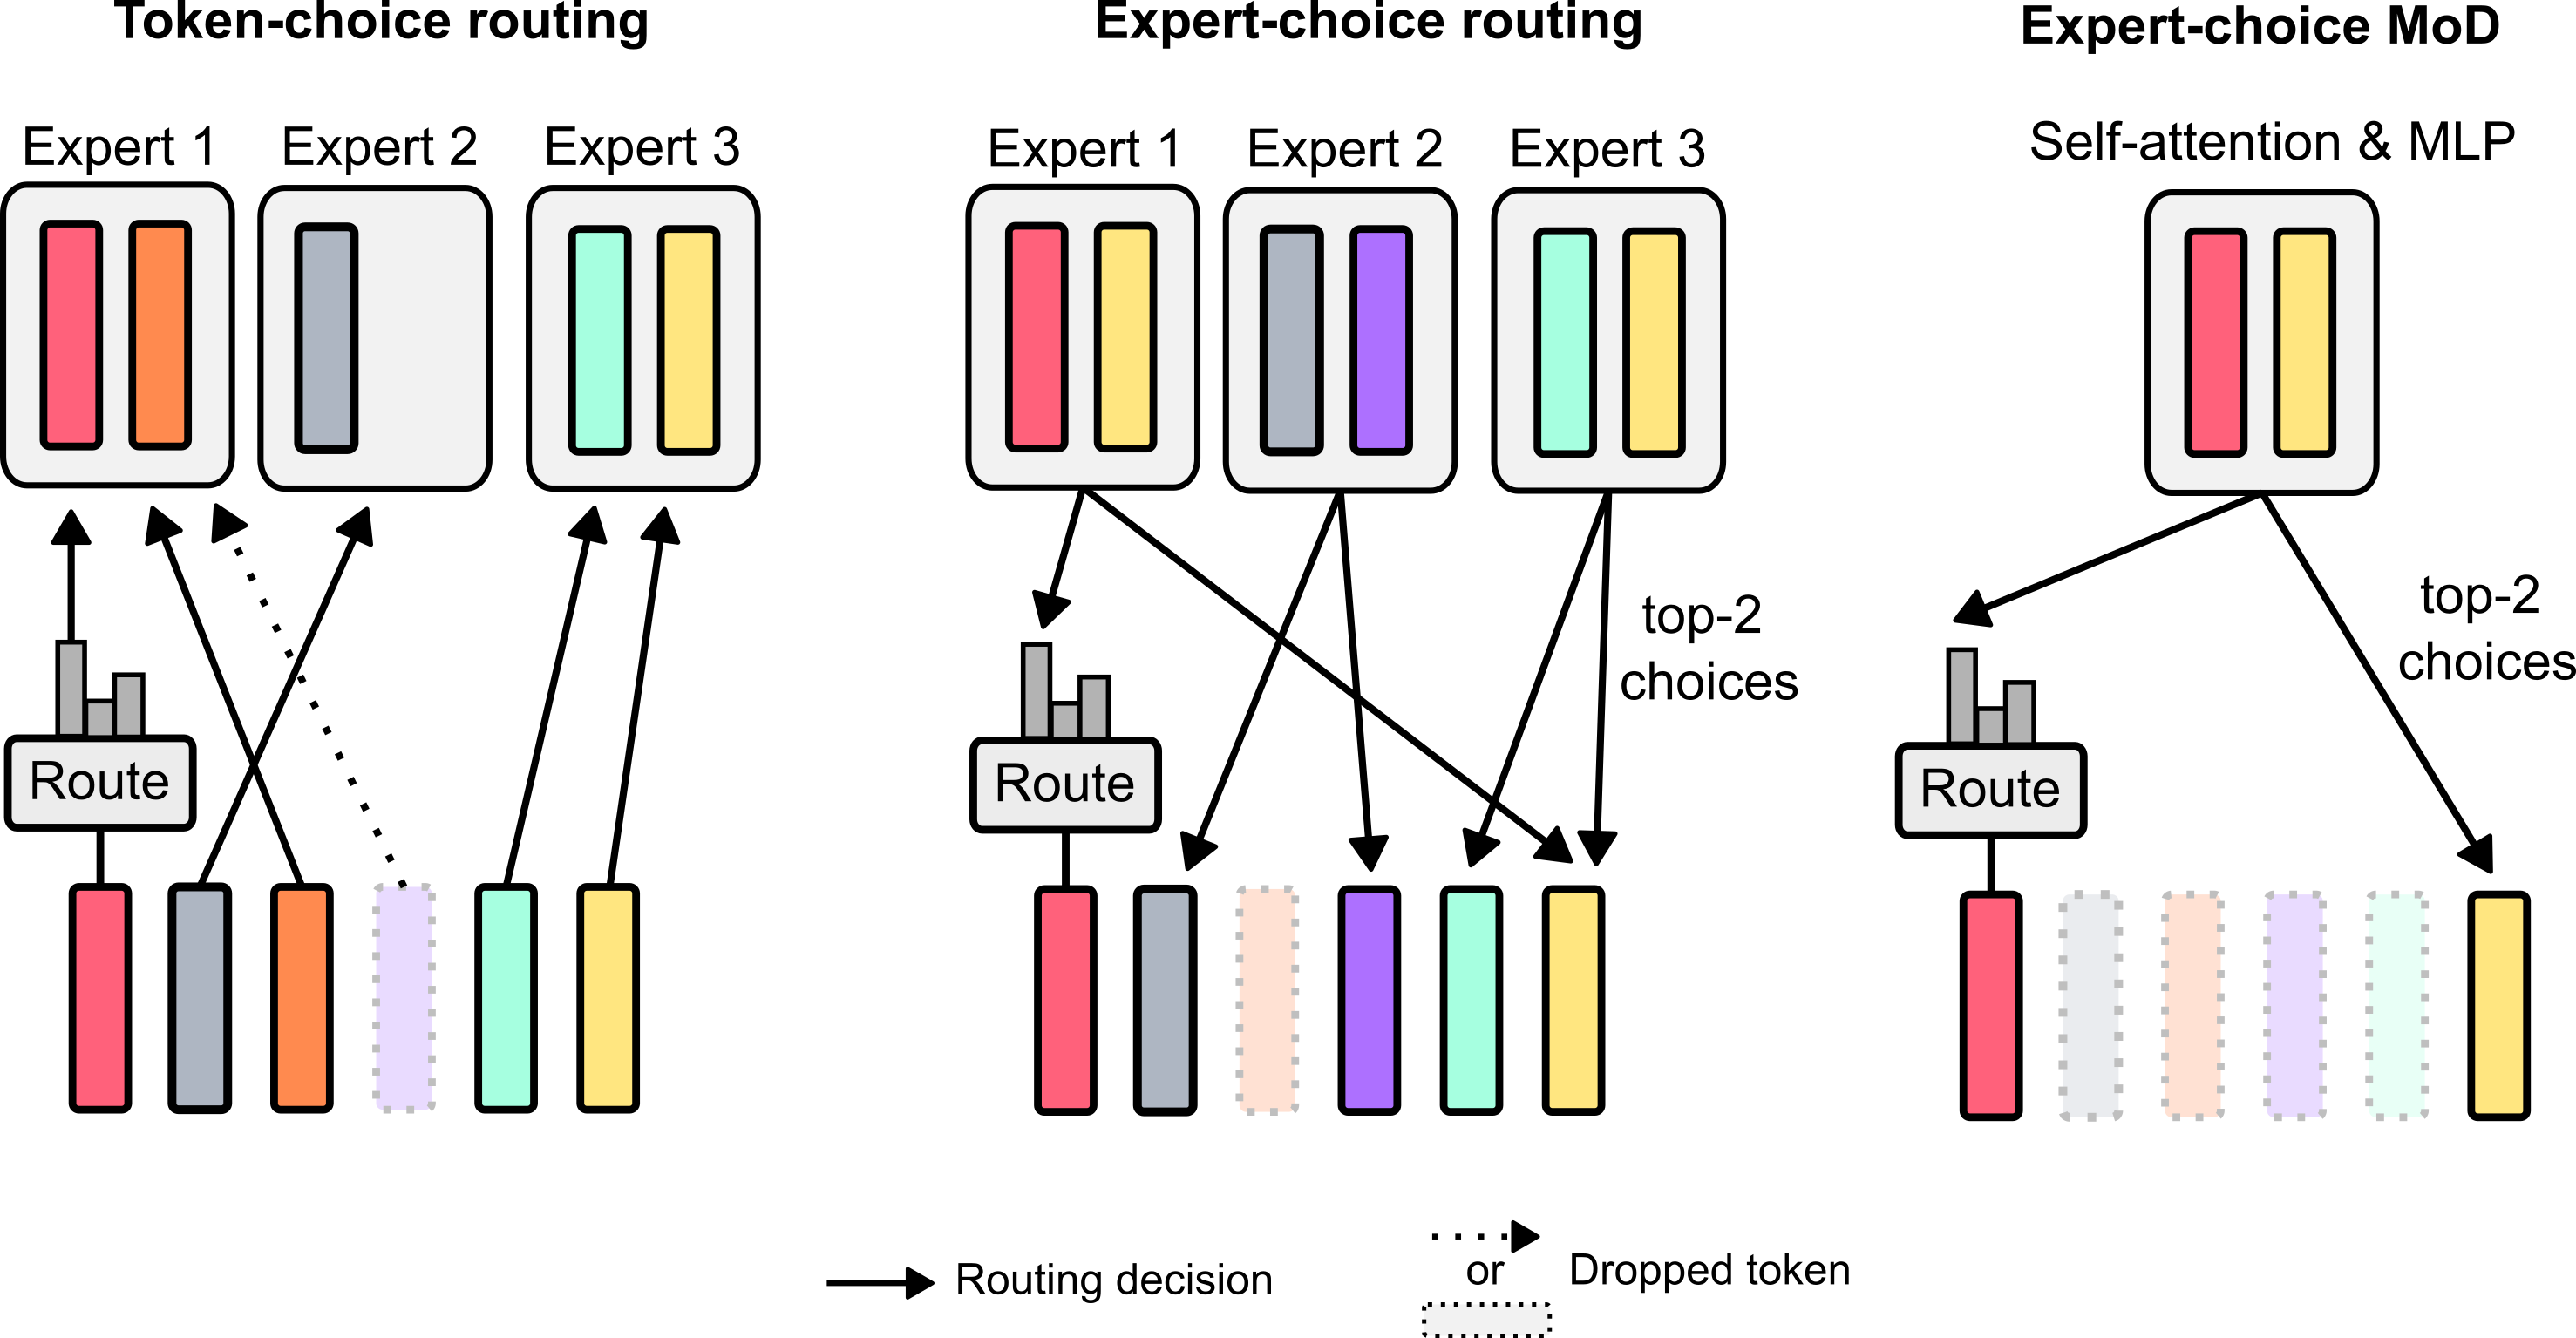
原 Fig. 2,PDF p. 6,作者原图。 从左至右读:独立选 expert 会溢出;expert 选 token 能固定各 expert 的容量,但可能重复选中或漏选;MoD 只需划分计算与旁路。图中的 top-2 是说明性例子,实际最佳配置的 $k$ 为 256。
2.4 容量如何转化为计算节省
令 $\rho=C/S$。在固定宽度、相同 block 结构下,逐 token 投影和 MLP 的主要计算量随 token 数线性变化,注意力的 token 两两交互部分随其平方变化。教学近似可写为:
$a,b$ 汇总架构相关常数;此式用于理解数量级,不是原文公布的 FLOPs 计数器。$\rho=1/2$ 时,$QK^T$ 部分为原来的 $1/4$,这是原文 Sec. 3.2 的示例。不能因此推断整个模型成本降为 $1/4$。
对最佳配置 $S=2048,C=256$,$\rho=12.5\%$。只有路由层的 1792 个 token(87.5%)走旁路;完整层仍处理 2048 个。若作“一半完整层、一半路由层、忽略其他开销”的教学估算:
这两个数是不同子计算的比例,不是端到端实测 FLOPs 或速度。真实值还取决于模型宽深、嵌入/输出层、路由与数据搬运、硬件利用率。短序列、逐 token 解码和批处理下的瓶颈也不相同。
2.5 教学例子:跳过后仍能重新进入
设一条长度为 8 的序列在某层得到分数:
| 位置 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
|---|---|---|---|---|---|---|---|---|
| 分数 | 0.1 | 0.9 | 0.2 | 0.3 | 0.8 | 0.4 | 0.05 | 0.6 |
若 $C=2$,入选位置为 2 和 5。在该层的因果注意力中,位置 2 不能看未来位置 5,位置 5 可以看位置 2;其他位置保持自身状态。下一层重新打分,位置 3 完全可能入选。这里的数字仅供教学,不是论文实验。
实现时不能按照分数排序后的顺序直接套普通三角 mask 而遗失真实位置;需要保留原始位置及因果关系。论文未提供完整实现代码,以上属于从 decoder-only 语义出发的实现检查点。
2.6 自回归生成:最关键的训练—推理区别
即使注意力使用因果 mask,全序列 top-k 本身仍然非因果。上例中位置 2 的分数是 0.9;若未来两个 token 的分数变成 1.0 和 1.1,它就不再属于 top-2。只依赖当前前缀,无法知道未来所有竞争者,因此无法原样作出训练时的决定。(Sec. 3.5,PDF p. 7。)
作者测试两种办法:
| 方案 | 训练信号 | 生成时的选择 | 原文报告 |
|---|---|---|---|
| 给原路由器添加 BCE 辅助损失 | logit 为 $r_i^l$;是否属于 top-k 为二元目标 | 用当前 token 的局部分数作阈值判断 | 主语言目标受影响约 0.2–0.3%,未给完整损失权重配置 |
| 单独训练小型 MLP predictor | 输入与原路由器相同,但 stop-gradient;预测是否入选 | 用预测器作局部二分类 | 作者称不影响主语言目标,实测步速影响不显著 |
将第一种方法的文字说明写成教学公式,令 $z_i=\mathbf{1}\{i\in\operatorname{TopK}(R^l,C)\}$、$p_i=\sigma(r_i^l)$,则:
这是对 Sec. 3.5 的数学展开,不是原文编号公式;整体训练目标中该项的权重未报告。第二种方法可记为 $\hat p_i=g_\phi(\operatorname{sg}(x_i^l))$,其中 $g_\phi$ 表示输出二分类概率的小型 MLP,$\operatorname{sg}$ 表示停止梯度,避免辅助分类梯度直接更新其输入表征。
按照上述定义,概率阈值 0.5 对应 logit 阈值 0,不是 raw logit 阈值 0.5。图 5 把横轴称为 Router Weight 且取值 0–1,正文的 $r_i^l$ 却定义为线性分数;本文将这个图按 sigmoid 后的路由量理解,避免混淆二者。原文的措辞没有始终严格区分这两种量。
两种方法都是学习模仿 top-k 选择,而非证明两种路由逐点相等。局部预测不再自动保证每段序列恰好选中 $C$ 个 token。因此,训练时的精确容量和固定张量形状不能原封不动推广成生成阶段的逐步恒定开销保证;预测路由下的容量波动、缓存和批调度需要另外处理,论文未给出完整系统细节。
三:实验
3.1 问题与比较协议
| 原文结果组 | 检验问题 | 主要对照 |
|---|---|---|
| Sec. 4.1 / Fig. 3 | 容量多小合适?需要学习路由吗? | 稠密基线、不同容量 MoD、随机路由 |
| Sec. 4.1 / Fig. 4 | 固定总训练算力时,规模和单次成本怎样折中? | 各 FLOP 预算下的最优稠密模型 |
| Sec. 4.1 / Fig. 5 | 路由模式和权重是否出现结构? | 路由热图、路由量分布的描述性分析 |
| Sec. 4.2 / Fig. 6 | 因果 predictor 替代 top-k 后,效果是否保持? | 同一留出集上的 baseline、top-k MoD、predictor MoD |
| Sec. 4.3 / Fig. 7 | MoD 与 MoE 能否组合? | baseline、MoE、MoDE;正文讨论降低 expert 容量的替代做法 |
isoFLOP 固定的是总训练 FLOPs,不是参数量、训练步数或看到的 token 数。 单步成本降低,可以在同一预算内训练更多步;也可以扩大模型。概念上 $F_{\mathrm{train}}\approx N_{\mathrm{steps}}F_{\mathrm{train\ step}}$,其中训练步包括反向传播,不能直接拿“单次前向 FLOPs”冒充训练步成本。
3.2 已公开配置与缺项
| 项目 | 原文报告 | 定位 |
|---|---|---|
| 模型类型 | decoder-only Transformer;改变层数、头数、嵌入维度来扫描规模 | Sec. 2–3.6,pp. 3、7 |
| batch size / sequence length | 128 / 2048 | Sec. 3.6,p. 7 |
| 学习率调度 | cosine,周期覆盖该次完整训练步数 | Sec. 3.6,p. 7 |
| 调参训练总预算 | $6\times10^{18}$ FLOPs | Sec. 4.1,pp. 7–8 |
| 更广的 isoFLOP 预算 | $6\times10^{18},2\times10^{19},10^{20}$ FLOPs | Fig. 4,p. 9 |
| 规模范围 | 60M–3B 参数 | Fig. 4 caption,p. 9 |
| 容量和路由频率 | 比较每层/隔层路由;正文称测试 12.5%–95%,并称继续低于 12.5% 后退化,但未逐项列出更低容量设置 | Sec. 4.1,p. 8 |
| 最佳容量配置 | 隔层路由,路由层容量 12.5%,$k=256$ | Fig. 3,p. 8 |
| 留出集规模 | 256,000 条序列,约 500M tokens | Sec. 4.2,p. 10 |
| 硬件 | 相同硬件比较;Fig. 3 步速轴标注 TPUv5 | Fig. 3,p. 8 |
| 训练/留出语料名称、混合比例、tokenizer | 论文未报告 | 已检查全文 |
| 优化器、峰值学习率、warmup、权重衰减、逐模型完整结构与步数 | 论文未报告完整配置 | Sec. 3.6 仅给出概要 |
| predictor 的具体宽度、完整辅助损失配置、MoDE expert 数和逐配置设置 | 论文未报告完整配置;图中 expert 图标不能充当实验配置 | Sec. 3.5、4.3 |
| 随机种子、重复次数、置信区间、显著性检验 | 论文未报告 | 图中没有对应误差说明 |
256,000×2048 为 524,288,000,因此“500M”应理解为论文采用的约数,而不是另一个精确测试集大小。
3.3 指标怎样读
- Loss / normalized loss:语言建模目标,图中越低越好。1.5% 是作者概述的相对目标改善,不是准确率提高 1.5 个百分点;无原始数值表,本文不反算精确 perplexity 改善。
- FLOPs per forward pass:单次前向计算量,越低越好。Fig. 4 的归一化分母是该预算下 isoFLOP 最优稠密基线,并非任意同参数模型。
- Steps/s:每秒训练步数,越高越好;Fig. 3 给出同硬件训练比较。总 wall-clock 是另一指标。
- Top-k prediction accuracy:逐 token 的路由二分类正确率,越高越好;它不等于语言模型任务准确率。
- Fig. 6 的纵轴措辞:原图写 Normalized log-likelihood,正文和阴影优区将较小值解释为更好。若模型与基线的对数似然都为负,则二者之比与对应负对数似然之比相同,小于 1 完全可以表示更好;这与“未归一化对数似然越大越好”并不矛盾。论文未给出该轴的明确归一化公式,本文沿用作者的比较方向,不从标签反推新的指标定义。
四:结果
4.1 训练、isoFLOP 和路由分析
A. 容量消融:学习选择与完整层都重要
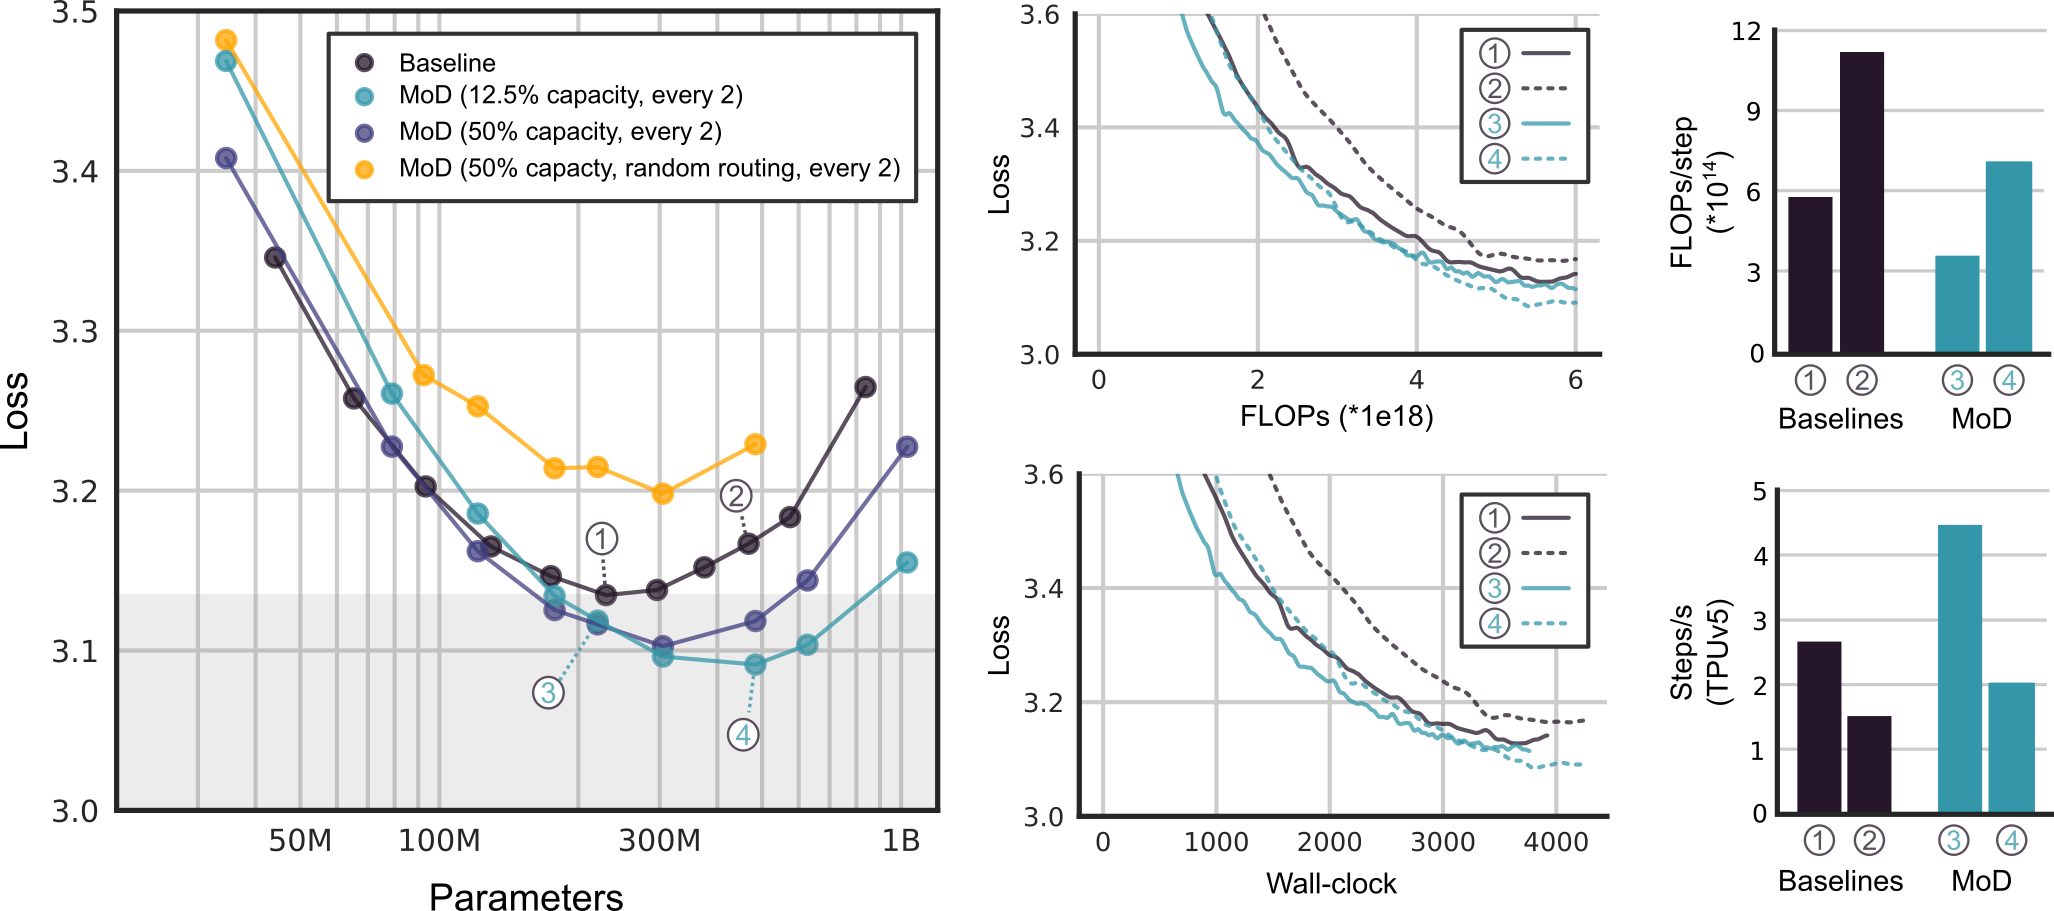
原 Fig. 3,PDF p. 8,作者原图。 左图横轴为参数量、纵轴为 loss;黑色为 baseline,蓝绿色为隔层路由的 12.5% 容量 MoD,另有 50% 容量 MoD 与随机路由对照。中间两图分别把学习曲线画在训练 FLOPs、wall-clock 上;最右分别显示 FLOPs/step 和 Steps/s(TPUv5)。
检验问题是:相同训练预算下,降低 capacity 是否只能损害效果?结果显示,学习路由可使 isoFLOP 曲线向更低损失、更大最优参数量移动;但随机路由明显变差。最优配置保留每隔一层的完整计算,并在路由层仅处理 12.5% token。作者称继续降低容量后会退化。因此 12.5% 是其搜索中的经验最佳值,不能提升为所有规模和数据的定律。(Sec. 4.1,PDF pp. 7–8。)
随机路由对照用高斯随机分数再做 top-k,说明同样节省 token 计算,选谁仍然重要。不过 Fig. 3 图例中的随机对照是 50% 容量,不能声称它直接测出了“12.5% 学习路由相对同容量随机路由”的精确增益。
B. 220M 示例:66% 更快对应吞吐,不是训练时间减少 66%
| 比较项 | 原文结论 | 正确解释 |
|---|---|---|
| 模型 #1 vs #3 | 稠密基线与 MoD 均约 220M 参数 | 这是明确的同规模例子 |
| 训练总预算 | 都为 $6\times10^{18}$ FLOPs | 单步成本不同,步数可以不同 |
| 效果 | Fig. 3 caption 称持平;正文称 MoD 略优 | 不扩写为有显著性保证的提升 |
| 训练步速 | Fig. 3 caption 报告 #3 比最优 baseline 快 66%;正文称超过 60% | 对应 Steps/s 提高约 66% |
| 总训练 wall-clock | 相近 | 不代表完整训练少用 66% 时间 |
若按步速增幅 66% 计算,单步耗时比例为 $1/1.66\approx0.602$,即耗时约减少 39.8%。这是比例换算,不是新增实测数据。摘要另称采样可达到超过 50% 的步速提升,但正文 Fig. 6 主要给出 FLOPs 与效果曲线,没有完整逐配置解码时延表,不能把训练的 66% 直接当作所有采样场景的加速值。
C. 更大预算:优质且低成本的工作点存在
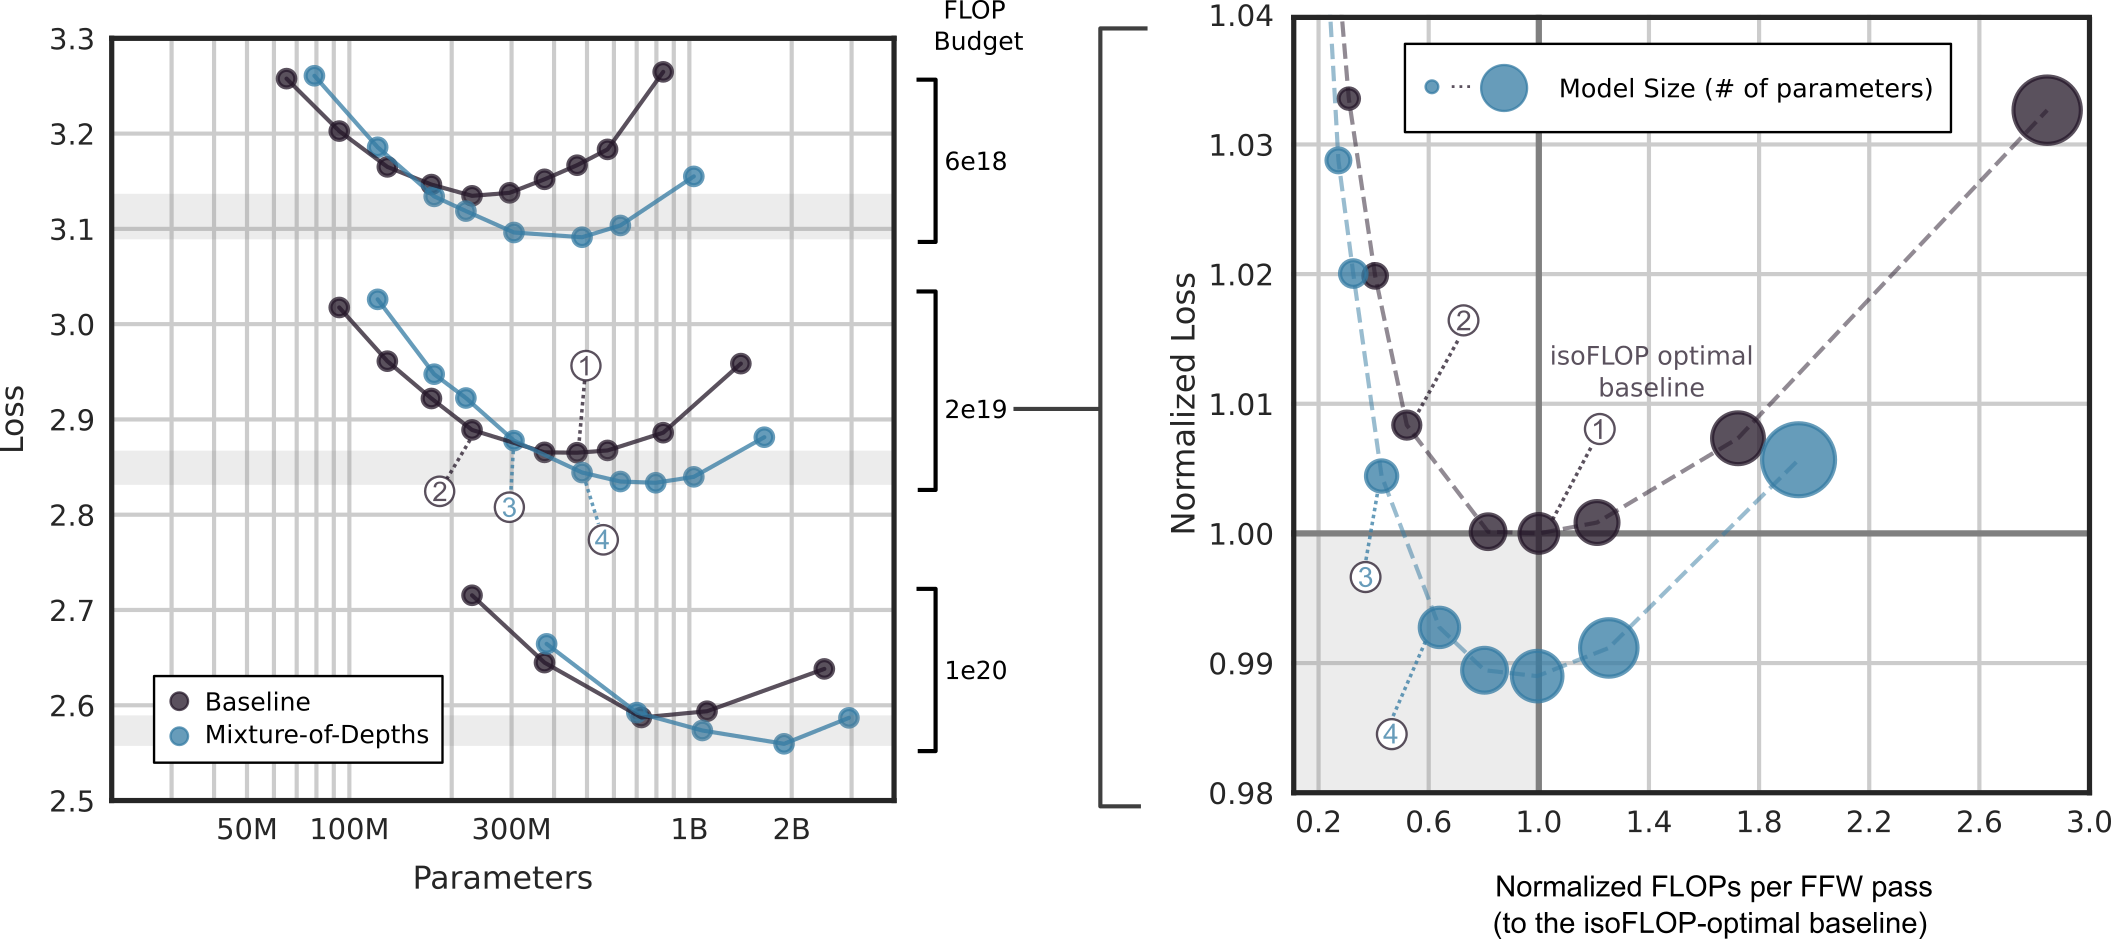
原 Fig. 4,PDF p. 9,作者原图。 左侧三个预算分别为 $6\times10^{18}$、$2\times10^{19}$、$10^{20}$ FLOPs,横轴参数量、纵轴 loss;每个预算下蓝色 MoD 的最低点通常位于黑色 baseline 的右下方。右侧展示中间预算对应的归一化关系:横轴为相对单次前向 FLOPs,纵轴为相对 loss,气泡大小表示参数量。$(1,1)$ 是最优基线;左下区域代表更少前向计算且更低损失。
关键发现有两个,服务于不同目标:
- 最低损失优先:最优 MoD 通常更大,并使用与最优 baseline 近似相同的单次前向 FLOPs。作者提出可据此调节 MoD 规模,并报告增加深度比增加宽度更有利;这都是实验经验,不是理论最优性保证。
- 单步成本优先:选用低于 MoD 自身最优规模的模型,仍可能达到最优 baseline 的质量,同时减少单次前向 FLOPs。这里不能把“更小”一律理解成“小于稠密基线参数量”;220M 示例就与 baseline 同规模。
作者在引言汇总最高约 1.5% 的语言目标改善。Fig. 4 的曲线支持更好的折中,但没有提供全套原始点值;不从栅格图中编造高精度结果表。文中提到大模型的设备/内存节省,但明确未系统研究,KV cache 的潜在收益属于展望。(Sec. 4.1,PDF pp. 8–9。)
D. 路由学到了什么:模式证据强于机制结论
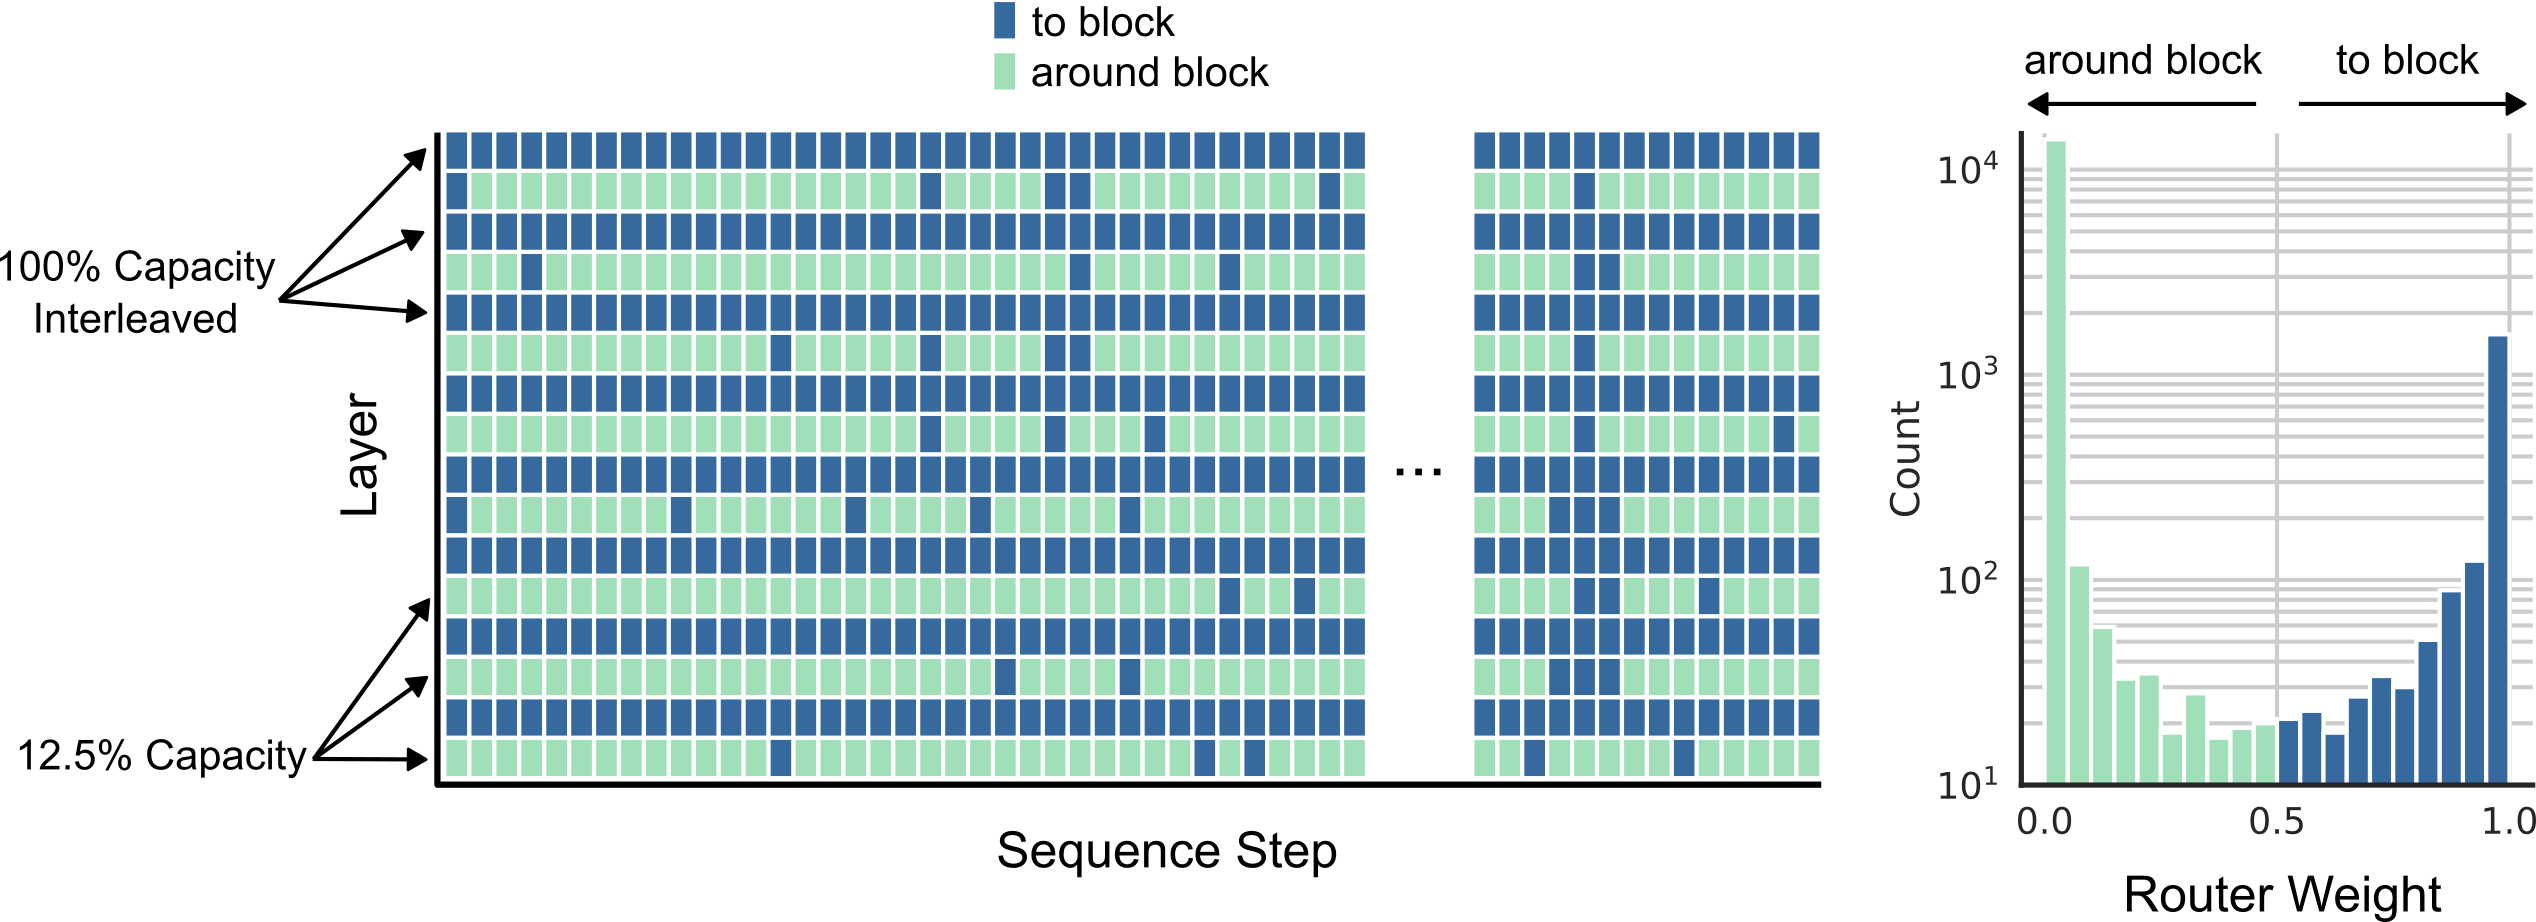
原 Fig. 5,PDF p. 10,作者原图。 左侧横轴为序列步、纵轴为层,深蓝是参与 block、浅绿是旁路。完整层形成连续深蓝横带,路由层更稀疏;某些位置形成跨多层的深蓝竖带。右侧横轴 Router Weight、纵轴 Count 为对数刻度,显示辅助监督把路由量推向两侧。
原文观察到部分 token 更频繁地执行层计算,并初步发现这种行为与更高预测熵相关。这支持路由具有输入依赖的结构,但没有报告关联强度、显著性或因果干预,不能下结论说 MoD 已准确识别“语义重要 token”或“推理难点”。而且 token 还可能因为对后续位置提供有价值的 K/V而被保留,并非只因当前预测困难。(Sec. 4.1,pp. 9–10;Sec. 5,p. 12。)
4.2 自回归评估:预测路由大体保留质量
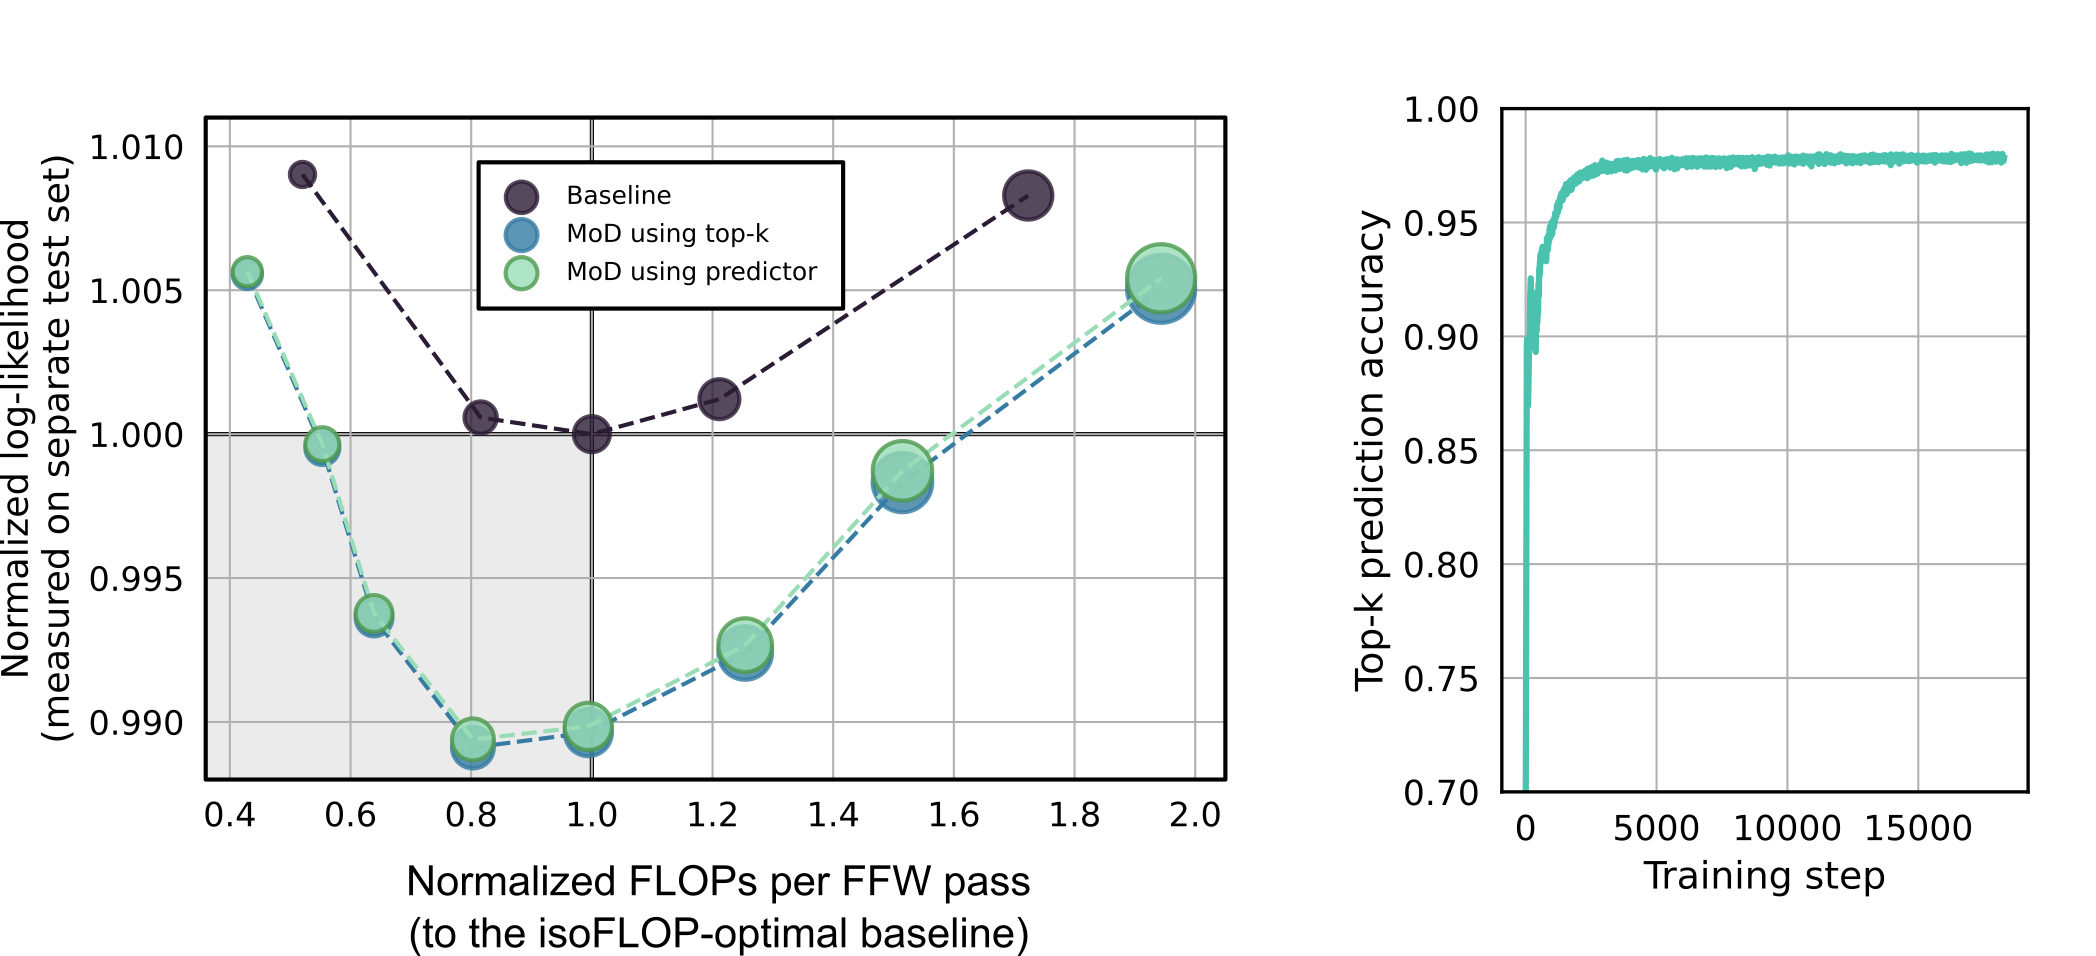
原 Fig. 6,PDF p. 11,作者原图。 左图横轴为归一化前向 FLOPs;黑色 baseline、蓝色 top-k MoD、绿色 predictor MoD。绿色与蓝色点非常接近,支持切换路由后效果退化较小。纵轴归一化口径的说明见 3.3 节。右图横轴训练步、纵轴路由分类准确率,曲线很快超过 97%,后期图示约 98%;Sec. 3.5 概述称可达 99%。这些描述来自不同文字/图示位置,不应合并成“图中所有配置准确率都为 99%”。
所有模型在同一留出集上比较:256,000 条序列、约 500M tokens。此结果补上了非因果训练指标不能直接代表生成表现的缺口,但并未证明所有路由决策完全一致,也未证明所有长文本生成或下游任务都无退化。(Sec. 4.2,PDF p. 10。)
本次分析:类别不平衡需要考虑。 路由层的正类比例仅 12.5%,总预测“旁路”就能达到 87.5% accuracy。97%–99% 仍高于该基线,但 accuracy 不能替代正类 recall/precision,也不能告诉我们被误跳过的 token 是否恰好很关键。另一方面,真正相关的模型损失也被评估了,因此不能仅凭类别不平衡否定 Fig. 6 的质量证据。更充分的验证应同时检查类别指标、实际执行比例、生成质量和缓存/延迟表现。
4.3 MoDE:与专家混合组合
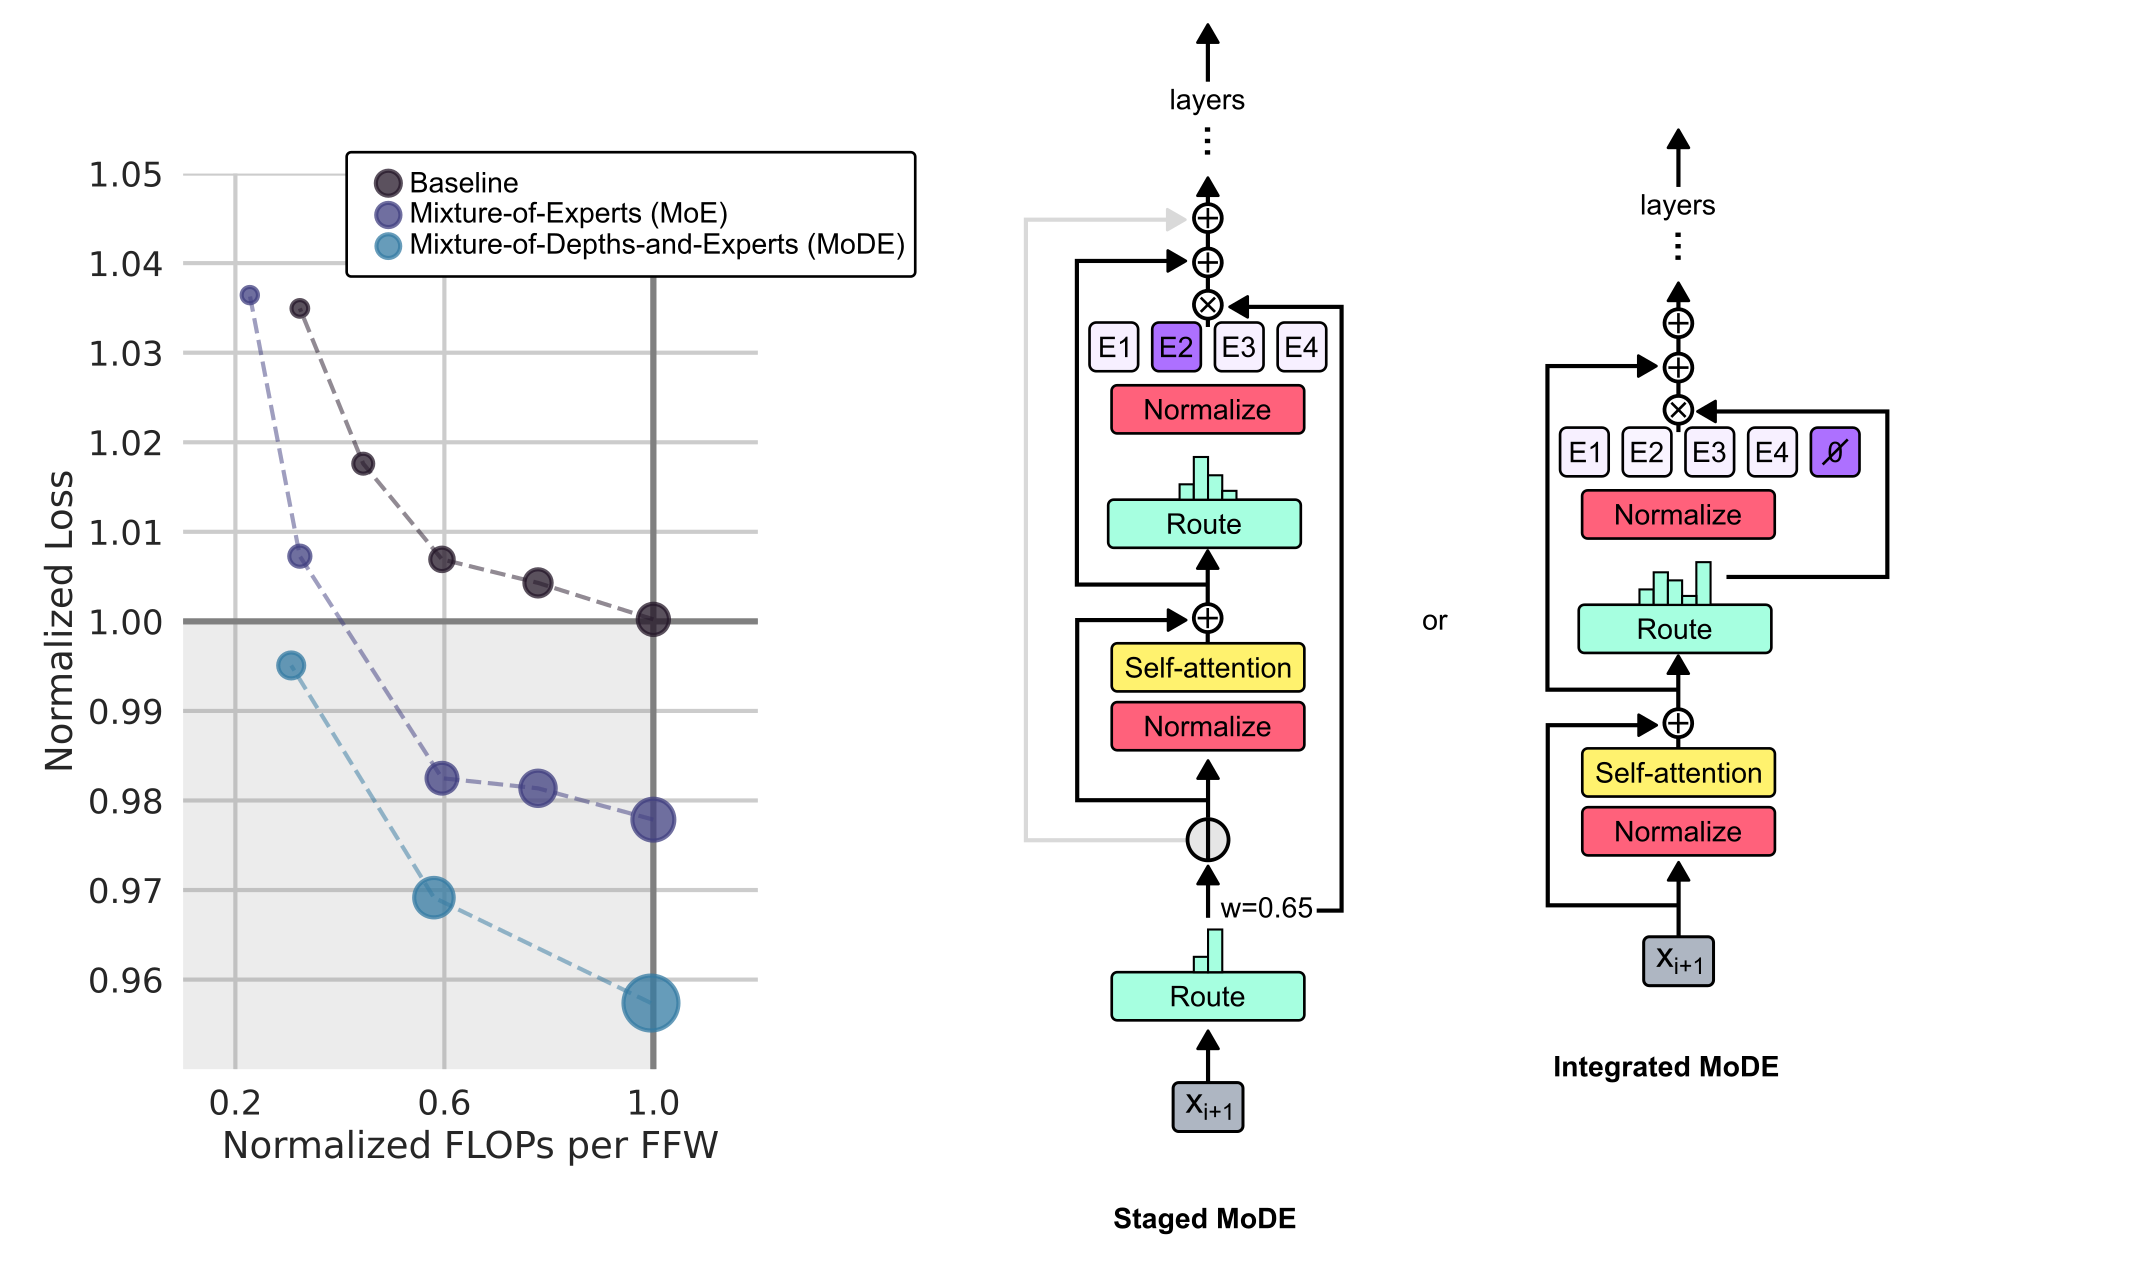
原 Fig. 7,PDF p. 12,作者原图。 左侧横轴是归一化前向 FLOPs、纵轴归一化 loss,黑色 baseline、紫色 MoE、蓝色 MoDE。蓝色曲线的更低位置支持二者收益可组合。中间是 staged MoDE,右侧是 integrated MoDE。
- Staged MoDE:先由 MoD 选择是否进入 block;入选后计算注意力,再进行 MoE 路由。优点是注意力也能被跳过,代价是两阶段路由。
- Integrated MoDE:在 MLP experts 中加入 no-op 路径,统一路由决定去真实 expert 还是不作 MLP 更新。路由更简单,但图示结构中所有 token 仍先经过注意力,不能将其注意力成本视为 staged 方案一样被削减。
作者还称,显式 no-op 路由好于简单缩小 expert 容量后让 token 因溢出而被丢弃。作者解释是:前者学会主动选旁路,后者想选 expert 却被容量拒绝。这个解释合理,但文中没有完整的逐变体消融表,Fig. 7 也没有把两种 MoDE 曲线分别标出;本文不从中给出精确 staged-vs-integrated 排名。(Sec. 4.3,PDF pp. 10–11,Fig. 7 p. 12。)
五:结论、边界与讨论
5.1 最可靠的贡献
MoD 展示了一个可训练的计算分配接口:以固定 capacity 管理昂贵计算的规模,以学习路由分配 token 的有效深度。对其报告的预算和模型范围,稠密模型并非唯一有效的质量—计算折中;通过保留完整层、让部分层只处理少数 token,可以改进这一折中。因果预测器让非因果 top-k 训练方案具备了生成阶段的替代路径。
5.2 不能超出证据的地方
| 边界 | 原因与影响 |
|---|---|
| “87.5% token 跳过”不等于总计算减少 87.5% | 只针对路由层;完整层和其他开销仍在 |
| 步速提升不等于相同比例减少总训练时间 | isoFLOP 下可增加训练步数;Fig. 3 总时长相近 |
| 训练 top-k 的固定容量不等于推理预测路由固定容量 | 局部二分类无法天然执行全序列精确 top-k |
| 标题中的动态计算不表示总训练预算随输入任意增减 | 核心训练设置是预算固定、token 分配动态 |
| 语言损失改善不等于下游能力全面提升 | 无推理、问答、代码等标准任务结果 |
| 较低 FLOPs 不保证部署时同等幅度加速 | 缺少完整解码批量、缓存、硬件拓扑和端到端时延说明 |
| 3B 范围内的观察不能直接推广至任意大规模 | 本文规模扫描为 60M–3B |
| 原文不是足够完整的复现规格 | 缺少语料、优化器和完整配置、重复实验统计 |
5.3 讨论中的设想与可继续追问的问题
作者提出将 Q、K、V 的路由解耦:一个 token 或许不值得继续更新自身,但值得保留为未来可检索的记忆;也可把路径扩展到记忆检索、工具调用等不同计算类型。这些是 Sec. 5(PDF pp. 12–13)的方向性设想,本文没有实现和验证相应长时记忆或工具系统。
适合组会进一步讨论的问题:
- 能否从训练开始就使用完全因果的容量控制,同时保留 top-k 的预算稳定性和质量?
- 路由误判中,漏掉关键 K/V 提供者是否比多执行一个普通 token 更有害?应如何设计评估?
- 交替完整层的重要性来自信息交换、优化稳定性还是其他机制?当前消融不足以分离这些原因。
- 在固定推理时延或固定 KV cache 内存预算下重新选模型,MoD 的最佳工作点是否仍与 isoFLOP 最优点一致?
5.4 关键事实核验表
| 事实或数值 | 核验位置 | 性质 |
|---|---|---|
| $r_i^l=w_\theta^T x_i^l$;加权残差更新 | Sec. 3.4,PDF pp. 6–7,Eq. (1) | 原文方法 |
| $S=2048$,batch=128 | Sec. 3.6,p. 7 | 原文设置 |
| $C=256$,12.5% 入选,1792/87.5% 旁路 | Fig. 3 caption,p. 8 | 原文设置,仅路由层 |
| $6\times10^{18},2\times10^{19},10^{20}$ FLOPs;60M–3B | Fig. 4 caption,p. 9 | 原文预算与范围 |
| 220M 对照、训练步速 +66%、总时长相近 | Sec. 4.1 / Fig. 3,pp. 7–8 | 原文报告,+66% 来自图注 |
| 单步耗时约下降 39.8% | 由 $1-1/1.66$ 计算 | 教学换算 |
| 最高约 1.5% 的语言目标改善 | Sec. 1,p. 2 | 作者汇总,非准确率百分点 |
| 辅助 BCE 对主目标约 0.2–0.3% 的影响 | Sec. 3.5,p. 7 | 作者报告,非准确率变化 |
| 256,000 序列、约 500M tokens | Sec. 4.2,p. 10 | 原文留出集规模 |
| 路由 accuracy:正文 99%,图注 >97%,图示约98% | Sec. 3.5 p. 7 / Fig. 6 p. 11 | 保留报告口径差异 |
| 56.25%、50.78125% | 2.4 节的隔层计算近似 | 教学推导,非实测 |
图件均为作者源码中实际被主 TeX 引用的 PNG 原图,已与同版本 PDF 对照;来源清单记录图号与页码。未使用生成式图像、未添加虚构实验数据。