Linear Attention via Orthogonal Memory:中文研读笔记
论文:Linear Attention via Orthogonal Memory(LAVO)
作者:Jun Zhang、Shuyang Jiang、Jiangtao Feng、Lin Zheng、Lingpeng Kong
机构:Shark-NLP / 香港大学;复旦大学
版本:arXiv:2312.11135v1,2023-12-18;获取与研读日期:2026-10-13
原文:arXiv v1 · 本地 PDF · 英文幻灯片
论文总览
LAVO 研究一个具体问题:当自回归模型的历史不断增长时,怎样让每个新 token 查询的记忆大小保持固定,同时保留局部细节和部分全局信息?作者把上下文投影到一组正交方向,对每个方向上的投影取均值,再用这些均值缩放正交基,形成固定大小的记忆。查询仍通过 softmax 读取记忆,但读取对象从所有历史 token 变成了 $r$ 个记忆向量。
完整方法还包含两个关键部分:用局部注意力保留细粒度内容,并在压缩前聚合窗口信息;在局部注意力分数中加入相对位置偏置。固定基数 $r$ 和窗口大小 $w$ 后,作者报告的序列长度复杂度为 $O(n(r+w))$。这里的“线性注意力”来自压缩检索对象,而非去掉 softmax。(§3,PDF pp. 3–5)
最有说服力的语言建模结果是长度外推时的稳定性:训练长度为 8,192 时,LAVO 在 8,192 / 12,288 / 16,384 的 PPL 分别为 19.43 / 19.41 / 19.40;FlashAttention + RoPE 为 15.09 / 20.11 / 34.84。因此,LAVO 在训练长度内有明显精度代价,在更长测试长度下体现优势。另一个独立实验使用 2,048 长度训练,在单张 80GB A100 上测试到 128K,曲线略有改善后趋于平稳。(表 2,PDF p. 6;图 4,PDF p. 8)
理解这篇论文最关键的取舍是:**正交记忆提供了低成本、可递推的全局统计,但平均投影的内容容量很有限;局部注意力承担了大量细节建模工作。**下文将用公式说明这一点,再对照各项实验。
结构地图
以下页码均为从 1 开始的 PDF 页码,与本文印刷页码一致。
| 原文章节 | 作用 | 位置 |
|---|---|---|
| 1 Introduction | 从因果语言建模提出效率问题 | pp. 1–2;图 1 |
| 2 Efficiency Degradation of Causal Linear Attention | 区分非因果/因果计算,分析长历史的代价 | pp. 2–3;式 (1)–(2) |
| 3.1 Context Compression via Orthogonal Decomposition | CODE 压缩与在线递推 | pp. 3–4;式 (3)–(4) |
| 3.2 Enhancing LAVO with Context Dissection | 局部窗口与全局记忆结合 | p. 4;图 2 |
| 3.3 Embedded Position Encoding | 局部相对位置偏置 | pp. 4–5;图 3 |
| 3.4 Extension to Cross Attention | 压缩源序列供目标序列读取 | p. 5;式 (5)–(6) |
| 4.1 Self Attention | PG-19、语音合成、摘要 | pp. 6–7;表 2–6 |
| 4.2 Cross Attention | 点云补全、时间序列预测 | p. 8;结果表 7–8 在 p. 7 |
| 4.3 Discussion | 128K 外推与模块消融 | pp. 8–9;图 4、表 9 |
| 5 Related Work | 高效注意力与有界记忆方法的关系 | p. 9 |
| 6 Limitation;7 Conclusions | 短序列效率限制与贡献归纳 | p. 9 |
| Appendix A Efficiency Degradation | RFA 与 LongShort 的计算展开 | p. 15;式 (7)–(11) |
| Appendix B Speedup in Autoregressive Generation | 自回归生成的模拟速度实验 | p. 15;表 10 |
| Appendix C Results on Long-Range Arena | 五项长序列任务结果 | p. 16;表 11 |
一:动机——因果计算为什么改变压缩的成本?
1.1 非因果模型可以共享一次全局压缩
标准注意力让查询与所有 key 比较,再加权求和 value。忽略投影层和固定特征维度时,长度 $n$ 的全注意力需要 $O(n^2)$ 次位置间交互。
非因果模型可以先把整个上下文压缩成一个较小的表示,再让所有查询共享它。因果模型中,第 $t$ 个位置只能依赖前缀 $\mathbf X_{\le t}$,因此每个位置需要合法的前缀状态。压缩算子是否支持快速增量更新,就成为决定效率的关键。(§2.1,PDF p. 2)
1.2 原文中的“效率退化”包含两种不同情况
**历史摘要越来越多,导致渐近复杂度退化。**原文分析 LongShort:若每个固定长度 $l$ 的分块保存一份摘要,后续查询读取越来越多的块摘要,代价与
同阶。EVA 的讨论也使用相同逻辑:若块大小固定,块数随 $n$ 增长,$O(nc)$ 中的 $c$ 就不再是常数。(§2.2,PDF p. 3;附录 A,PDF p. 15)
**复杂度仍然线性,但状态维度和实现常数变大。**附录 A 中 RFA 的更新为
它本身仍有线性递推形式;训练时保存各位置的状态会增加开销。因此,不能把论文的动机概括成“所有线性注意力遇到因果掩码都会变成平方复杂度”。LAVO 选择的是一种更小、更简单的上下文统计量,具体效果还要由精度和运行速度共同判断。(附录 A,式 (8)–(9),PDF p. 15)
二:方法——先理解记忆里到底存了什么
2.1 符号与数据流
| 符号 | 含义与形状 |
|---|---|
| $n,d$ | 输入长度、特征维度 |
| $\mathbf X\in\mathbb R^{n\times d}$ | 上下文特征;第 $t$ 个向量为 $\mathbf x_t$ |
| $r$ | 正交方向数量,即记忆槽数量 |
| $\mathbf B\in\mathbb R^{r\times d}$ | 每行对应一个基向量 $\mathbf b_i^\top$ |
| $\mathbf H\in\mathbb R^{r\times1}$ | 各方向上的平均投影系数 |
| $\widetilde{\mathbf X}\in\mathbb R^{r\times d}$ | 用系数缩放基向量得到的记忆 |
| $w$ | 局部注意力窗口大小 |
| $\mathbf P\in\mathbb R^{2w-1}$ | 局部相对位置偏置表 |
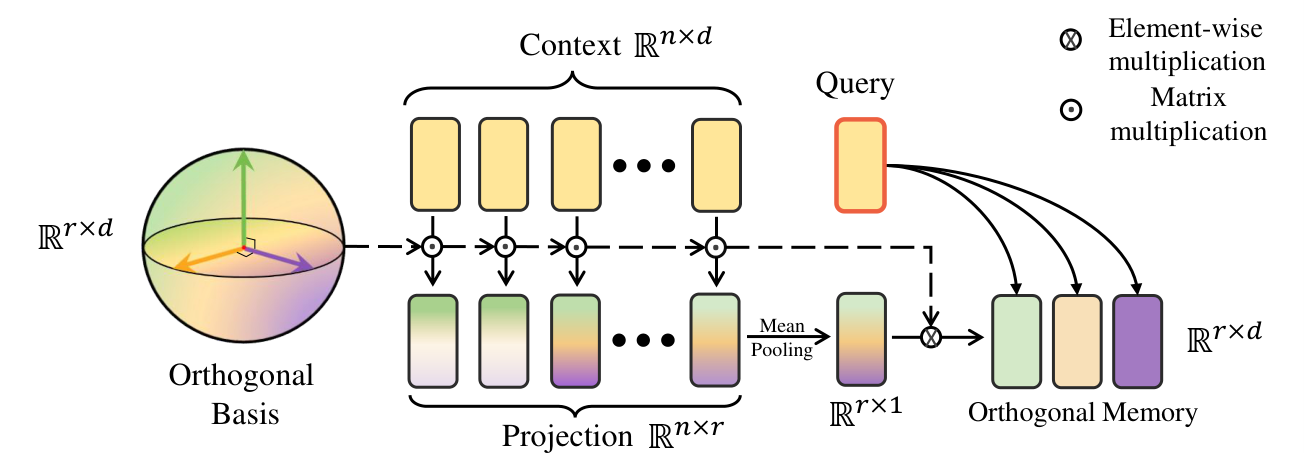
原图 1,PDF p. 2。按从左到右的顺序看:选定正交基 → 投影各个 token → 沿序列取均值 → 用均值缩放基向量 → 查询读取记忆。图中的每个记忆槽对应一个特征方向,而非某个历史 token 或时间区间。
2.2 CODE:每个正交方向存一个平均系数
原文式 (3) 为
$\odot$ 在这里按行广播:第 $i$ 个记忆向量是 $\widetilde{\mathbf x}_i=H_i\mathbf b_i$。等价地,可以写成
随后查询使用
softmax 的维度是 $r$ 个槽;同一个压缩记忆同时充当 key 和 value。与分别保存完整 $\mathbf K,\mathbf V$ 相比,这显著降低了查询对象的数量。(§3.1,PDF pp. 3–4)
**正交性为什么能够保留?**在基向量仍相互正交的条件下,
这是对式 (3) 的直接推导:不同槽的几何方向互不重合。它不意味着这些系数在统计上独立,也不意味着压缩无损。非零的两两正交行还要求 $r\le d$;原文强调的 $r 以下是本次分析,由原文式 (3) 的线性性直接得到: 所以在给定 $\mathbf B$ 时,基本 CODE 的上下文依赖完全通过 $r$ 个平均投影系数进入。$r\times d$ 的记忆矩阵并不拥有 $rd$ 个独立的上下文自由度。扩大 $n$ 不会增加记忆槽数量,也不会自动增加记忆所能区分的历史模式。 一个教学例子:取 $\mathbf B=\mathbf I_2$,比较 二者均值都是 $(1,1)$,因此 $\mathbf H=(1,1)^\top$,记忆都是 $\mathbf I_2$;任意相同查询都得到相同的基本 CODE 输出。不同历史在压缩后发生了碰撞。相反方向的投影还可能在平均中抵消。 这个例子解释了局部模块为什么重要。它针对的是相同输入特征层面的 CODE:完整网络在压缩前可以用局部注意力和前面各层把顺序、局部组合等信息编码进特征,因此不能据此断言整个 LAVO 模型完全不感知顺序。 对前缀长度 $t$,原文式 (4) 写成 它是普通的在线均值:新 token 贡献 $1/t$,此前均值贡献 $(t-1)/t$。每步只需更新 $r$ 个系数,不需要重新扫描历史。(§3.1,PDF p. 4) 下面是基本 CODE 的教学伪代码,省略多头、投影层与局部模块: 这一更新没有内容相关的写入门或遗忘门。持续累积的均值适合维护稳定的全局背景,新出现但罕见的事件在极长前缀中占比会很小;局部分支则为近期细节保留更直接的通路。这是公式所揭示的机制取舍。 原图 2,PDF p. 4。每个括号表示一个窗口,箭头表示窗口内部交互;当前查询位于最右侧。 §3.2 包含两项作用,不能只理解为“在 CODE 旁边加一个局部注意力”: 两路结果取简单平均: 因此,局部分支负责细粒度关系,经过局部聚合的全局记忆负责背景统计。原文式 (4) 展示的是基本 CODE 的逐 token 递推;加入分窗后,压缩输入和历史窗口划分也必须按 §3.2 处理,不能把前面的教学伪代码直接当作完整实现。(§3.2,PDF p. 4) 原图 3,PDF p. 4。矩阵格子的数表示 $j-i$ 的相对偏移;右侧偏置表按距离索引。 对局部查询位置 $i$ 和 key 位置 $j$,原文定义 这里使用从 0 开始的偏置表索引。即使整段输入更长,局部相对距离仍在训练时见过的有限范围内。这提供了一个解释长度外推稳定性的机制,但远距离 token 之间的精确相对位置并没有直接保存在该偏置表中。 原文给出的时间代价为 $O(nw)$,位置参数空间为 $O(w)$。后一个量描述的是偏置表,不能解释成整层训练激活只需 $O(w)$ 内存;局部注意力分数等中间量仍随序列长度增长。(§3.3,PDF pp. 4–5) 源序列 $\mathbf X\in\mathbb R^{n\times d}$ 与目标序列 $\mathbf Y\in\mathbb R^{m\times d}$ 没有天然的局部位置对齐。LAVO 因而去掉局部分支,让目标查询直接读取源记忆: 按原文行向量的形状约定,这里将式 (5) 的 $W_q\mathbf Y$ 写成维度一致的 $\mathbf YW_q$。压缩源序列的代价对应 $nr$,目标查询读取记忆对应 $mr$;原文这两个分项的文字次序颠倒了,但总复杂度 $O(r(n+m))$ 不变。(§3.4,式 (5)–(6),PDF p. 5) 表中省略了通常还存在的线性投影层,例如 $O(nd^2)$。论文将 $d$ 视为固定,故写为 $O(n(r+w))$。 在线推理时,上下文相关的基本统计量 $\mathbf H_t$ 只需 $O(r)$ 空间;基矩阵及显式记忆为 $O(rd)$,局部缓存为 $O(wd)$,这些量不随历史长度增长。训练时还需要各位置的中间状态和反向传播激活,整体显存仍可能随 $n$ 线性增长。并行训练可以从前缀和得到所有 $\mathbf H_t$;这是一种由公式导出的计算方式,原文没有进一步给出专用并行内核的实现分析。 作者在各任务骨干中替换注意力模块,并沿用 CAB 的比较设置。模型参数量并不完全相同,例如语言建模中 LAVO 为 122.91M,LongShort 为 136.61M,S4D 为 155.41M。(§4;表 1–2,PDF pp. 5–6) 理解这些指标时,PPL 是平均 token 负对数似然的指数,衡量模型给真实后续 token 分配的概率;ROUGE-1/2 比较词元及相邻二元组重合,ROUGE-L 基于最长公共子序列。点云的 Chamfer Distance 衡量两个点集之间的最近邻距离,F-score 综合点匹配的精确率与召回率;MSE 对预测误差平方后平均,MAE 对绝对误差平均。这些指标分别反映预测质量、内容重合、几何匹配和数值误差。 语言建模采用 batch size 16、125K 步、10K warmup、峰值学习率 $5\times10^{-4}$、AdamW;每批 $2^{17}$ 个 token。表 1 给出 LAVO 的 $r=64$,时间序列任务则为 $r=16$。其中窗口大小一行明确标为 local/LongShort,不能直接把该行当成所有 LAVO 实验的窗口配置。(表 1,PDF p. 5) 时间序列的最终分数是单变量与多变量结果的平均;ETT 还平均 ETT-h1、ETT-h2、ETT-m1 三个子数据集。这个统计口径决定了表 8 的分数不能被当成其中某个单独数据集、单一设置的结果。(§4.2,PDF p. 8) 来源:表 2,PDF p. 6;所有模型在 8,192 长度训练。LAVO 在同为线性复杂度的 ABC、local 中表现最好,但 8K 时明显落后于全注意力、LongShort 和 S4D。12K 时 LongShort 仍略好于 LAVO。LAVO 的 19.43 → 19.40 只下降了 0.03,最准确的表述是“在更长上下文中保持稳定”,而非“大幅提升语言建模质量”。 主表的效率数据如下,速度均以同长度 vanilla 为 1: 来源:表 2,PDF p. 6,测量硬件为 1×80GB A100。16K 时 LAVO 的表内速度约为 FlashAttention 的 $22/18.7\approx1.18$ 倍,显存则比它稍高;8K 时 FlashAttention 更快。由此可见,较低渐近复杂度在较长序列才更容易体现为运行优势。 原文同页正文把 16K 加速写成 20.3×,表 2 则为 22.0×;本笔记采用表中数值。主表未充分交代速度计时范围,因此不把它换称为端到端训练吞吐或逐 token 生成吞吐。表注称 vanilla 在 LM 任务中 OOM,但仍列出了速度/显存基准,表明两类结果也不能直接混为同一次完整训练测量。 来源:表 3、5,PDF p. 7。因果 TTS 中 LAVO 的 MCD 比 vanilla 低 0.085,两个指标均为表中最佳;非因果 TTS 中则为第二。后者明确替换编码器的自注意力。结果说明方法不只适用于文本语言建模,但其最突出的优势仍取决于注意力模式和任务。 来源:表 4、6,PDF p. 7。非因果模式下,LAVO 相对 vanilla 提高 4.40 / 4.42 / 4.04 个 ROUGE 分值;相对 local 则只提高 0.51 / 0.23 / 0.31。这使“局部信息本身很重要”成为理解收益来源的必要背景。 因果模式中,LAVO 的 R-1、R-L 是表内 $O(n)$ 方法中最佳,但 R-2 为 6.16,低于 local 的 6.27。原表将 LAVO 的 R-2 也标为线性方法最佳,正文作了概括性最优描述;按实际数值不能得出三项都最优的结论。 **点云补全。**表 7 的全部比较如下: 来源:表 7,PDF p. 7;配置说明在 p. 8。LAVO 三项均最佳。相对 vanilla,CDL1 下降 0.225,CDL2 下降 0.015,F-score 增加 0.015。这里保留原表的 Chamfer 数值尺度,不自行添加原文未标注的缩放单位。 时间序列预测。 来源:表 8,PDF p. 7;平均方式见 §4.2,PDF p. 8。相对 vanilla,ETT MSE 下降 0.015(约 1.32%),Weather MSE 下降 0.034(约 7.11%)。这些是跨设置的平均改善。 这两组实验使用去掉局部分支的 cross-attention 形式,因而支持了 CODE 作为独立源序列压缩机制的可用性。不过比较并未单独控制“正交”与其他同容量记忆设计,不能将全部优势归因于正交性一个因素。 原图 4,PDF p. 8。横轴为上下文长度,每个刻度翻倍;纵轴为 PPL,越低越好。蓝、橙、绿分别对应 $w=16,32,64$。 这一组使用独立的 2,048 长度训练配置,batch size 为 64,测试长度由 2K 增至 128K;不能与表 2 的 8K 训练混用。三个窗口配置的 PPL 均随长度增加略降,约 16K 后变化很小;$w=64$ 始终最低。图中窗口大小带来的差别比继续拉长上下文带来的改善更显著。 作者报告:在其测试实现中,LAVO 是未做 IO 优化、仍能在单张 80GB A100 上处理 128K 的方法。图 4 展示的是 LAVO 的窗口比较,没有给出所有基线在 128K 的逐项数值。实验支持有限状态模型的长度扩展能力和 PPL 稳定性;由于评价的是整段语言建模 PPL,它没有直接测量 128K 距离上的精确事实检索能力。结合平均投影机制,这是判断“unbounded”含义时最重要的区别。 来源:表 9,PDF p. 8;解释在 §4.3,PDF p. 9。去掉 EPE 的差值为 −0.18 / −0.05 / −0.25;在已去掉 EPE 的基础上再去掉 CD,差值为 −3.72 / −3.97 / −3.41。后者是条件消融,不能当作 EPE 与 CD 完全独立的贡献分解。 原文明确说最后一行仍保留 local feature,所以它强调的是分窗聚合及其与全局压缩的结合,而非仅仅“有没有局部注意力”。 这里存在实质性的报告冲突:表题是 Summarization,指标也是 ROUGE;正文却说沿用 unbounded language modeling 设置并在 2,048 长度测试。按表题和指标,本笔记将其作为摘要结果解读,无法据正文确定完整训练协议。此外,表 6 的主结果恰好等于表 9 的“去掉 EPE”一行,配置标签未解释清楚,因此不把 39.19 和 39.01 当成同一明确配置的可直接替换数值。 附录使用虚拟序列,依次计算从长度 1 到目标长度的前缀,模拟自回归生成。原文说明速度受增量解码等实现方式影响;由于未找到所需官方推理实现,未纳入 S4D。 来源:表 10,PDF p. 15。16K 时 LAVO 为 FlashAttention 的约 $20.81/15.01=1.39$ 倍;8K 时则明显更慢。20.81× 属于这组生成模拟;22.0× 属于主表 2,两者不应混写成一个速度结果。这里也没有给出端到端服务吞吐或每 token 延迟。 LAVO 的 $r=32,w=256$,五项分数为: 来源:表 11,PDF p. 16;粗体表示该表最佳。平均分比 vanilla 的 57.37 高 2.37 分,比 Skyformer 的 59.39 高 0.35 分。Retrieval 最佳为 Skyformer 的 82.06,Image 最佳为 Reformer 的 48.87。LAVO 因而是该组基线中平均表现最好、优势集中在三项任务的方案。 **第一,固定大小的可更新统计量,是避免历史检索成本持续增长的一条直接路线。**LAVO 用在线均值更新正交方向上的系数,使每次全局读取的槽数固定。它展示了保留 softmax、同时获得关于序列长度的线性复杂度的方法。 **第二,正交性和信息保留能力需要分别理解。**正交方向减少槽间几何重合,但基本 CODE 仍只保留平均投影;不同历史会发生压缩碰撞,罕见远处信息容易被稀释。原文关于提高信息丰富度的解释没有配套的熵最优证明,也没有单独的同容量正交/非正交消融。其价值应结合完整模型结果判断。 **第三,完整方法的有效性来自全局统计与局部结构的配合。**局部注意力既输出近期细节,也改善压缩输入;局部相对位置偏置保持有限距离范围。摘要结果和消融都表明局部结构的重要性,而交叉注意力实验则说明单独的源压缩也能有用。 **第四,论文最强的长文本证据是长度外推稳定,而训练长度内的最佳精度仍属于其他方案。**8K 训练下的 19.43 → 19.40,以及 2K 训练后测试到 128K 的平稳曲线,适合支撑“可扩展、稳定”的结论。固定记忆造成的精度取舍、约 123M 参数的验证规模,以及消融配置不一致,会影响将这些结果推广到更大模型或精确长程检索任务时的判断。 如果继续研究,一个有针对性的方向是比较同状态预算下的均值写入、内容选择写入与正交约束:在局部窗口和位置编码保持一致时,观察哪些设计真正提升远处稀有信息的保留。它直接针对 LAVO 的核心瓶颈,也能帮助分离记忆几何与更新规则的作用。2.3 一个决定记忆容量的等价式
2.4 因果递推:状态大小固定,新信息权重逐渐减小
H = zeros(r)
for t = 1, 2, ...:
    H = H + (B @ x[t] - H) / t
    M = diag(H) @ B
global_output[t] = softmax(q[t]^T @ M^T) @ M2.5 Context dissection:既保留局部,也改进全局压缩的输入
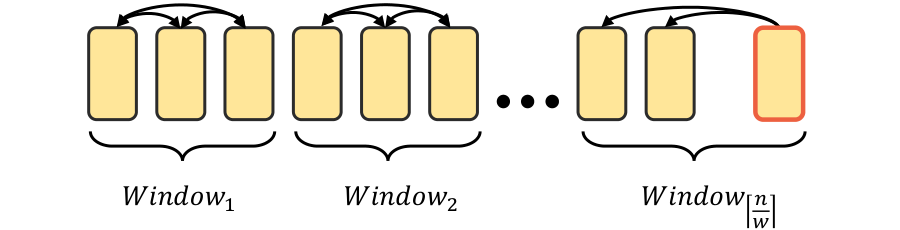
2.6 Embedded position encoding:将相对距离限制在局部范围
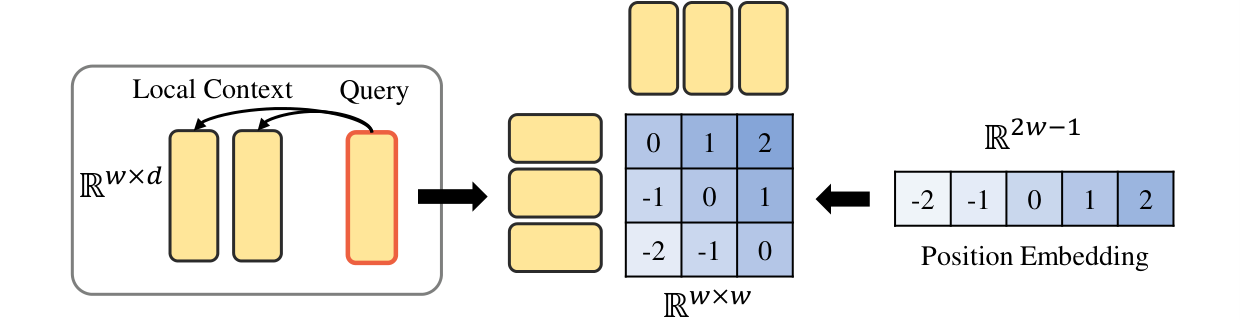
2.7 Cross attention:只压缩源序列
2.8 “线性时间”和“固定记忆”的准确含义
环节 保留特征维度后的主要计算量 投影到 $r$ 个基并聚合 $O(nrd)$ 所有查询读取 $r$ 个记忆槽 $O(nrd)$ 宽度 $w$ 的局部注意力 $O(nwd)$ 自注意力总计 $O(nd(r+w))$ 交叉注意力压缩与读取 $O(rd(n+m))$ 三:实验——比较的对象与指标
3.1 对照模型分别回答什么问题?
对照 在实验中的作用 Vanilla / FlashAttention 全注意力质量参照;FlashAttention 还检验 IO 优化能否胜过较低理论复杂度 FlashAttention + RoPE 检验使用相对位置机制后,全注意力的长度外推表现 Local attention 检验局部信息本身的作用,以及增加全局压缩后是否有收益 ABC 有界记忆的直接参照;记忆槽不被要求两两正交 LongShort 局部与压缩信息结合的参照;其因果与非因果复杂度不同 S4D 状态空间序列模型参照,表中采用的训练计算为 $O(n\log n)$ Performer、cosFormer、LARA、Nyströmformer、ProbSparse 不同核化、近似或稀疏策略的参照,参与其支持的注意力模式 3.2 任务配置与指标
任务 数据、骨干与主要配置 指标 语言建模 PG-19;训练/验证/测试为 28,602/50/100 本书;12 层 GPT-2 骨干,隐藏维 768,12 个头;GPT-2 BPE 词表 50,257;训练长度 8,192 token 级 PPL,越低越好 文本到语音 LJSpeech,平均序列长度 559;Transformer-TTS;分别测试因果/非因果自注意力 MCD、MSD:声学特征失真,越低越好 摘要 Multi-News;6 层编码器、6 层解码器;输入上限 4,096,摘要上限 400 ROUGE-1/2/L,越高越好 点云补全 PCN、PoinTr;输入下采样至 1,536 点,解码器 3,584 个 point proxies;替换交叉注意力 CDL1、CDL2 越低越好;F-score 越高越好 时间序列预测 Informer;Weather 输入/输出 720/720;ETT 为 336/720 MSE、MAE,越低越好 LRA 五项长序列任务;LAVO 的 $r=32,w=256$ 各任务得分及平均值,越高越好 四:结果——按原文实验顺序解读
4.1 语言建模:训练长度内损失精度,外推更稳定
模型 PPL ↓,8,192 PPL ↓,12,288 PPL ↓,16,384 FlashAttention 16.02 40.33 94.34 FlashAttention + RoPE 15.09 20.11 34.84 LongShort 15.52 19.17 26.06 S4D 15.78 51.96 — ABC 31.53 86.78 147.43 Local 19.73 21.24 22.16 LAVO 19.43 19.41 19.40 模型 8K 速度倍数 ↑ 16K 速度倍数 ↑ 16K 显存(MB)↓ Vanilla 1.00× 1.00× 25,747 FlashAttention 14.00× 18.70× 9,133 FlashAttention + RoPE 12.40× 16.96× 9,193 LongShort 3.50× 5.70× 10,929 ABC 2.20× 4.10× 12,669 Local 5.00× 9.10× 11,909 LAVO 11.49× 22.00× 9,337 4.2 文本到语音:因果模式最优,非因果模式次于 LongShort
注意力模式 模型 MCD ↓ MSD ↓ 因果 Vanilla 4.095 2.199 因果 S4D 4.030 2.189 因果 LAVO 4.010 2.179 非因果 LongShort 3.913 2.136 非因果 Local 4.015 2.164 非因果 LAVO 3.964 2.155 4.3 摘要:非因果收益很大,其中大部分已由局部注意力获得
模式 模型 R-1 ↑ R-2 ↑ R-L ↑ 因果 Vanilla 34.61 6.35 31.66 因果 S4D 34.90 6.65 31.98 因果 Local 33.50 6.27 30.74 因果 LAVO 34.16 6.16 31.16 非因果 Vanilla 34.61 6.35 31.66 非因果 Local 38.50 10.54 35.39 非因果 LAVO 39.01 10.77 35.70 4.4 交叉注意力:固定源记忆在两种异构任务中有效
模型 CDL1 ↓ CDL2 ↓ F-score ↑ Vanilla 7.425 0.231 0.779 ABC 7.344 0.227 0.784 Performer 7.368 0.235 0.783 cosFormer 8.673 0.298 0.704 LAVO 7.200 0.216 0.794 模型 ETT MSE ↓ ETT MAE ↓ Weather MSE ↓ Weather MAE ↓ Vanilla 1.138 0.775 0.478 0.508 ABC 1.147 0.809 0.489 0.520 Performer 1.254 0.819 0.463 0.508 cosFormer 1.219 0.823 0.474 0.509 LAVO 1.123 0.765 0.444 0.492 4.5 128K 实验:较短训练后仍能稳定处理长输入
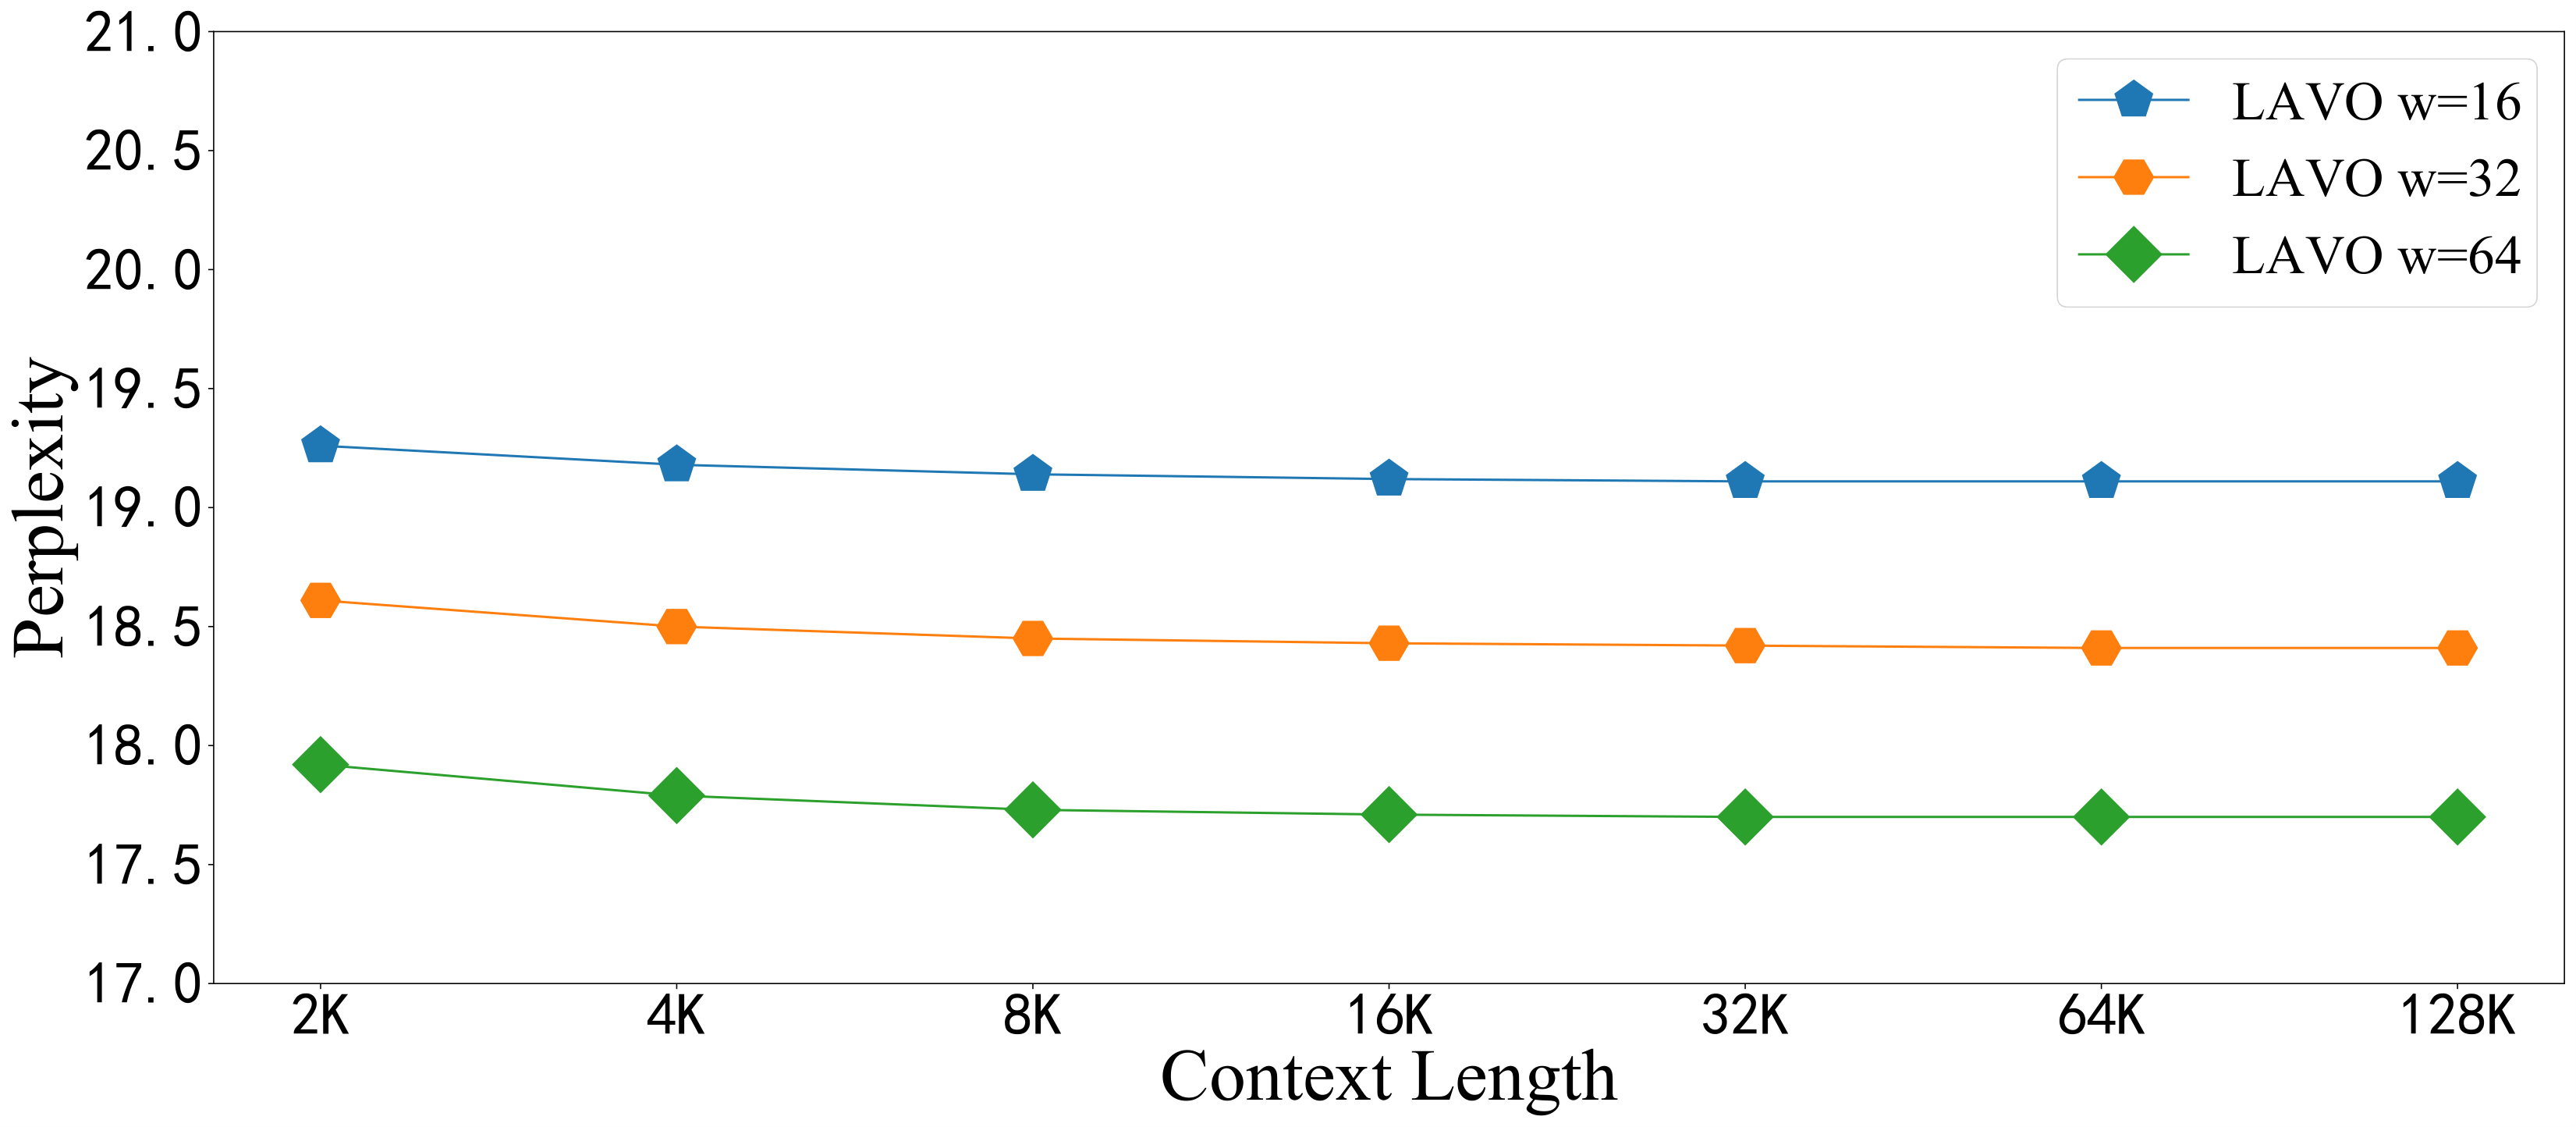
4.6 消融:分窗聚合的收益大于位置偏置,但配置说明有冲突
表 9 的配置 R-1 ↑ R-2 ↑ R-L ↑ LAVO 39.19 10.82 35.95 去掉 embedded position encoding(EPE) 39.01 10.77 35.70 再去掉 context dissection(CD) 35.29 6.80 32.29 4.7 附录 B:生成模拟速度要与主表分开
模型 8,192 速度倍数 ↑ 12,288 ↑ 16,384 ↑ Vanilla 1.00 1.00 1.00 ABC 1.18 2.29 3.30 Local 3.35 6.86 10.34 LongShort 0.70 1.71 2.94 FlashAttention 7.94 13.10 15.01 FlashAttention + RoPE 5.73 10.28 12.66 LAVO 3.71 10.80 20.81 4.8 附录 C:LRA 平均分领先,但并非所有任务最优
Text ↑ ListOps ↑ Retrieval ↑ Pathfinder ↑ Image ↑ AVG ↑ 65.28 40.57 80.17 72.14 40.55 59.74 五:结论——这篇论文最值得保留的认识